📚 小白篇:从零开始理解 JEPA
这一节不讲任何公式,只用最直白的语言帮你建立直觉。如果你对"自监督学习"“表征"“编码器"这些词不熟,先读这里。
先搞清楚:AI 是怎么"学习"的?
所有 AI 学习本质上都是同一件事:给模型看大量例子,让它找到"输入→输出"的规律。区别只在于"例子"长什么样。
三种学习方式
| 学习方式 | 例子长什么样 | 人类类比 | 代表 |
|---|---|---|---|
| 监督学习 | 输入 + 正确答案 | 上学做题,老师给标准答案 | 图像分类(图片+标签) |
| 无监督学习 | 只有输入,没有答案 | 自学看书,没有老师 | 聚类(把相似的东西分组) |
| 自监督学习 | 从数据本身构造"伪答案” | 玩填空游戏,自己给自己出题 | BERT、GPT、JEPA |
自监督学习的核心 trick 是:数据本身藏着答案,只需要设计一个"游戏规则"把答案藏起来,让模型去猜。
例子:
- BERT:把句子中的一个词遮住,让模型猜被遮的词(完形填空)
- GPT:给模型一句话的前半段,让它猜下一个词
- MAE:把图片遮住一半,让模型把被遮的像素补回来
- JEPA:把图片遮住一块,让模型预测被遮那块的"抽象表征”
JEPA 的训练"游戏":三步走
JEPA 的训练就像一个精心设计的"填空游戏":
关键点:模型从来没有"看到"被遮住的那块长什么样! 它只能根据上下文(周围的 patch)去"猜"那一块的抽象表征。这就是"预测"的含义——不是画出像素,而是预测抽象概念。
什么是"表征"?为什么不在像素空间预测?
这是理解 JEPA 最关键的一步。
什么是表征(Representation)?
一张图片是 224×224×3 = 150,528 个数字(像素)。但这些数字里有大量冗余——背景的渐变色、光照的微小变化、压缩噪声……对"理解这张图"几乎没用。
表征 = 把冗余的像素压缩成紧凑的"概念向量"。
这 1,024 个数字就是"概念"——它编码了"这是一只狗"“它在跑"“朝左"等语义信息,但丢掉了"毛的具体纹理"“光照角度"等无关细节。
为什么不在像素空间预测?
| 预测方式 | 预测什么 | 问题 |
|---|---|---|
| 像素预测(MAE) | 被遮那块的每个像素值 | 花 99% 算力去猜无关细节(光照、纹理) |
| 表征预测(JEPA) | 被遮那块的抽象概念 | 只猜"那一块是什么”,自动忽略细节 |
类比:考试时,老师问你"图中被遮住的是什么动物?”
- 像素预测 = 你要把被遮住的每个像素都画出来(太难了,而且很多像素跟"是什么动物"无关)
- 表征预测 = 你只需要回答"是狗”(抓住核心语义,忽略无关细节)
两个编码器为什么要用 EMA?——防止"抄答案"
这是 JEPA 最精巧的设计,也是最反直觉的。
问题:如果两个编码器一起学,会怎样?
假设上下文编码器和目标编码器都被梯度更新——它们可以"串通":
这就是表征坍缩(representation collapse)——模型找到了一个"捷径",让 loss 变成 0 但表征毫无意义。
解法:EMA + stop-gradient
类比:想象一个学生(Student)和一个老师(Teacher)玩猜谜游戏:
- 如果老师配合学生(一起被训练)→ 老师会悄悄把谜底放简单 → 学生什么都没学到
- 如果老师不动(EMA + stop-grad)→ 学生只能真正去猜 → 才能学到东西
完整训练流程:一张图走一遍
训练完之后,模型学会了什么?
训练完成后,你得到了一个学会了"理解图片语义"的编码器。
它学会的是:“看到图片的一部分,就能推断另一部分的概念”。这意味着它理解了:
- 物体的形状和类别(“这是狗的腿,所以那块应该是狗的身体”)
- 空间关系(“那块在狗的上方,所以应该是天空”)
- 物理规律(“球在空中,下一步会往下掉”)
这种"理解"被编码在表征向量里——可以直接用在下游任务(检测、跟踪、规划),而不需要从头训练。
自监督 vs 监督:为什么 JEPA 不需要标签?
| 监督学习 | JEPA(自监督) | |
|---|---|---|
| 需要人工标注? | ✅ 每张图都要标"这是狗" | ❌ 不需要任何标签 |
| 训练信号来源 | 人工标签 | 数据本身(遮住一块,预测它) |
| 数据成本 | 极高(每张图都要人标) | 极低(只要有图片就行) |
| 可用数据量 | 受限于标注数据 | 互联网上所有的图片/视频 |
这就是自监督的威力:不需要任何人工标注,就能从海量无标签数据中学到强大的表征。JEPA 的训练数据可以是互联网上所有的图片——这是监督学习永远做不到的。
为什么 JEPA 叫"世界模型"?——它到底"世界"在哪?
你可能会困惑:JEPA 不就是遮住一块然后预测吗?这跟"世界模型"有什么关系?哪里"世界"了?
先搞清楚:什么是"世界模型"?
世界模型的核心定义是:
给定当前状态和动作,预测下一个状态会怎样。
人类每天都在用世界模型:
- 你把球抛出去之前,脑子里已经"模拟"了球的飞行轨迹
- 你踩刹车之前,已经"预测"了车会减速
- 你推一个杯子,已经"想象"了杯子会滑动
关键:世界模型不需要"画出"未来的画面,只需要"理解"未来会变成什么样。
JEPA = 在表征空间里的世界模型
JEPA 的训练目标恰恰就是"预测下一个状态的表征":
在图像任务中,“上下文"是一张图的一部分,“目标"是被遮住的部分。但在视频任务中,这个框架自然扩展成:
⚠️ 重要区分:I-JEPA 不是世界模型,V-JEPA 才是
很多人(包括这篇文章前面的表述)会搞混这一点,必须澄清:
| I-JEPA(图像版,2023) | V-JEPA(视频版,2024-2025) | |
|---|---|---|
| 输入 | 一张图片,挖掉一块 | 一段视频的前几帧 |
| 预测什么 | 被挖掉的那块的表征(现在的缺失部分) | 下一帧的表征(未来) |
| 是世界模型吗? | ❌ 不是,只是表征学习工具 | ✅ 是,在表征空间预测未来 |
| 类比 | 完形填空(补全当前句子) | 预言(预测下一句话) |
I-JEPA 做的事:看到一张图的 75%,预测被遮住的 25%——这是补全现在,不是预测未来。它只是一个"学表征的工具”,让编码器学会理解图片语义。
V-JEPA 做的事:看到视频的前 4 帧,预测第 5 帧的表征——这才是预测未来,才是世界模型。
那 I-JEPA 和 V-JEPA 什么关系?
I-JEPA 是地基,V-JEPA 是房子。文章后面说的"JEPA 世界模型"都是指 V-JEPA 系列,不是 I-JEPA。
这就是世界模型! 它在做"给定当前状态(过去帧的表征)和动作(你的操作),预测未来状态(未来帧的表征)"——只是预测是在表征空间做的,不是在像素空间。
对比:三种"世界模型"的区别
| 像素世界模型(DriveDreamer) | JEPA 世界模型 | 人类大脑 | |
|---|---|---|---|
| 预测什么 | 未来帧的像素 | 未来帧的表征 | 未来会发生什么(抽象) |
| 需要画出来? | ✅ 必须生成视频 | ❌ 只输出一个向量 | ❌ 你不会在脑子里"渲染"画面 |
| 计算量 | 巨大(要生成每个像素) | 小(只预测一个向量) | 小(直觉判断很快) |
| 物理理解 | 弱(可能画出穿墙) | 强(表征编码物理规律) | 强 |
打个比方:
- 像素世界模型 = 你在脑子里画出未来每一帧画面(太慢了)
- JEPA 世界模型 = 你在脑子里直觉判断“前面那车要减速了”(快,抽象)
- 人类开车用的是后者——你不会在脑子里渲染高清视频,你只需要"感觉到"未来会怎样
一句话总结
JEPA 之所以叫世界模型,是因为它在做世界模型最核心的事:预测未来。只不过它预测的不是像素(太贵),而是表征(高效且语义丰富)。
JEPA 的公式:每个符号是什么意思?
给它一张图的大部分(上下文),让它去预测被遮住那一块的抽象表征——注意,不是把像素补出来,而是预测"那一块经过编码器后长什么样”。这种在嵌入空间(embedding space)做预测的思路,正是图灵奖得主 Yann LeCun 力推的通往自主智能(autonomous intelligence)的核心架构。
$$\min_\theta \; \big\|\; P_\theta\big(\,s_x,\ z\,\big) \;-\; \text{sg}\big(\,T_{\bar\theta}(y)\,\big) \;\big\|^2$$其中 $s_x$ 是上下文编码,$z$ 是位置/动作条件,$P_\theta$ 是预测器,$T_{\bar\theta}$ 是目标编码器(用 EMA 更新、stop-gradient)。整个损失只在表征空间里算,不碰像素。
🎯 LeCun 的野心:为什么需要世界模型,为什么生成式不够
LeCun 在 2022 年的论文《A Path Towards Autonomous Machine Intelligence》里给出了一张被反复引用的自主智能系统蓝图:感知模块把高维观测压缩成抽象表征,世界模型在表征空间里预测"如果我执行动作 $a$,下一步世界会变成什么样",最后由actor / critic 基于这些预测做规划。他认为,这才是接近人类/动物学习的路径。
为什么生成式方法不够? 这是最关键的一问。LeCun 反复强调一个观点:
“预测一架从地毯上弹起的球的像素,是浪费且几乎不可能的。”
理由有三:
- 像素冗余太多:一只猫下一帧每个位置的纹理、光照、阴影都在变,但它的"猫属性"没变。逐像素重建逼着模型花 99% 的算力去拟合那些与决策无关的细节。
- 预测概率不可行:世界本质是多模态的——前方路口下一秒可能直行、可能左转、可能急停。在像素空间对每一种未来做精确概率建模,是高维积分灾难;而"许多答案都对"的情形下,回归到平均像素只会得到糊掉的鬼影。
- 生成式 ≠ 理解:能画出逼真图像(如 Diffusion)不等于理解物理因果。一个会画穿墙小轿车的模型,照样没掌握"墙是撞不过去的"。
JEPA 的破局之道:主动丢掉那些预测不准、也对决策无用的细节,只保留抽象的、可预测的、语义层面的表征。这正是 LeCun 口中"世界模型应有的样子"。
🔑 JEPA 的核心思想:在嵌入空间预测
JEPA 的名字拆开就揭示了它的本质——Joint-Embedding Predictive Architecture(联合嵌入预测架构):
- Joint-Embedding(联合嵌入):用两个编码器分别处理"上下文"和"目标",把它们都映射到同一个表征空间;
- Predictive(预测):训练目标不是"重建目标长什么样",而是"用一个 predictor 去预测目标的表征"。
为什么这样更高效?
| 维度 | 像素空间重建(MAE/Diffusion) | 嵌入空间预测(JEPA) |
|---|---|---|
| 监督信号 | 逐像素回归,所有细节一视同仁 | 只监督抽象表征,自动忽略无关纹理 |
| 算力 | 解码全部像素,开销大 | 在压缩表征上预测,省算力 |
| 多模态未来 | 回归到均值像素 → 糊 | 可学分布或条件预测 |
| 学到的东西 | “怎么画” | “会发生什么” |
| 语义层级 | 偏低层纹理 | 偏高层语义 |
打个比方:学开车时,你脑子里预测的是"前面那辆车会减速",而不是"它牌照左下角的反光会从 RGB(120,45,30) 变成 RGB(140,50,35)"。JEPA 逼着模型像前者那样思考。
🏗️ 架构详解:Context Encoder + Target Encoder + Predictor
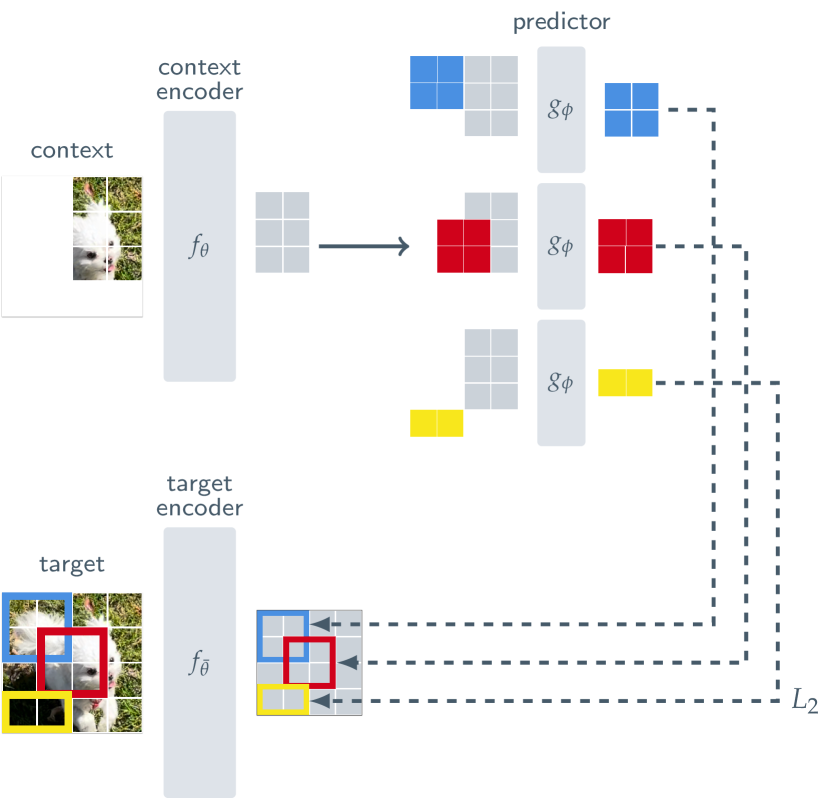
JEPA 由三件套组成。以图像版 I-JEPA 为例(结构如图 1 所示),三者全是 Vision Transformer(ViT):
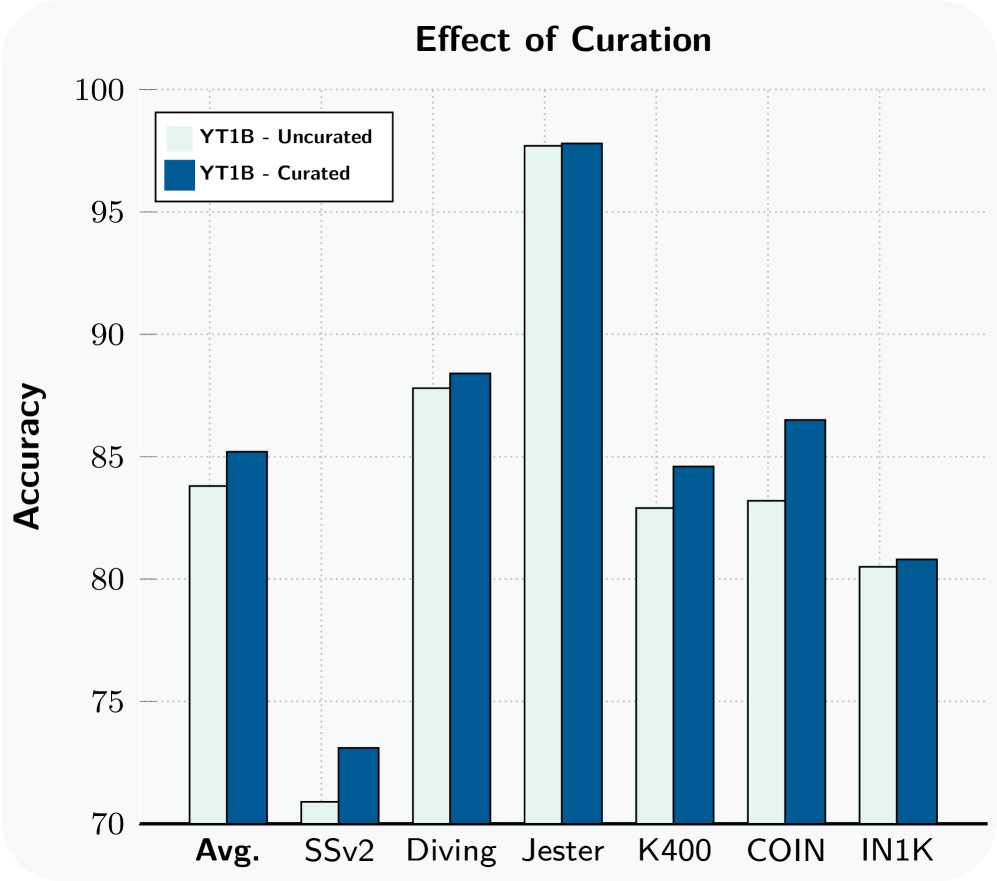
1️⃣ Context Encoder(上下文编码器)
输入:一张图随机挖掉几块后剩下的可见 patch(context block)。 输出:上下文的表征 $s_x$。 特点:因为只处理可见 patch,所以天然高效(类似 MAE 的稀疏计算)。这个编码器是可学习、有梯度回传的主干。
2️⃣ Target Encoder(目标编码器)
输入:被遮住的目标块(target block,通常采样多个)。 输出:目标的"真值表征" $T_{\bar\theta}(y)$,作为 predictor 要拟合的目标。 特点:这是 JEPA 的灵魂设计——它的权重不靠梯度更新,而是用**上下文编码器权重的指数滑动平均(EMA)来更新,并在计算损失时加 stop-gradient。这条不对称的设计是防止表征坍缩(representation collapse)**的关键。
3️⃣ Predictor(预测器)
输入:上下文表征 $s_x$ + 位置/条件 token $z$(告诉你"要预测哪个位置的目标")。 输出:预测的目标表征 $\hat{s}_y = P_\theta(s_x, z)$。 损失:$\ell = \|\hat{s}_y - \text{sg}(T_{\bar\theta}(y))\|^2$。
为什么用 EMA + stop-grad? 如果两个编码器一起被梯度更新,最简单的捷径就是让所有输入都输出同一个常向量——损失立刻变 0,但表征毫无意义(这就是"坍缩")。EMA 让目标侧变化慢、且无梯度,于是预测器只能乖乖去"真正预测",而不是"把目标拉过来"。
掩码策略:大目标块 + 信息丰富的上下文
论文里反复强调,掩码采样方式决定了表征的语义层级(见图 2 掩码示意):
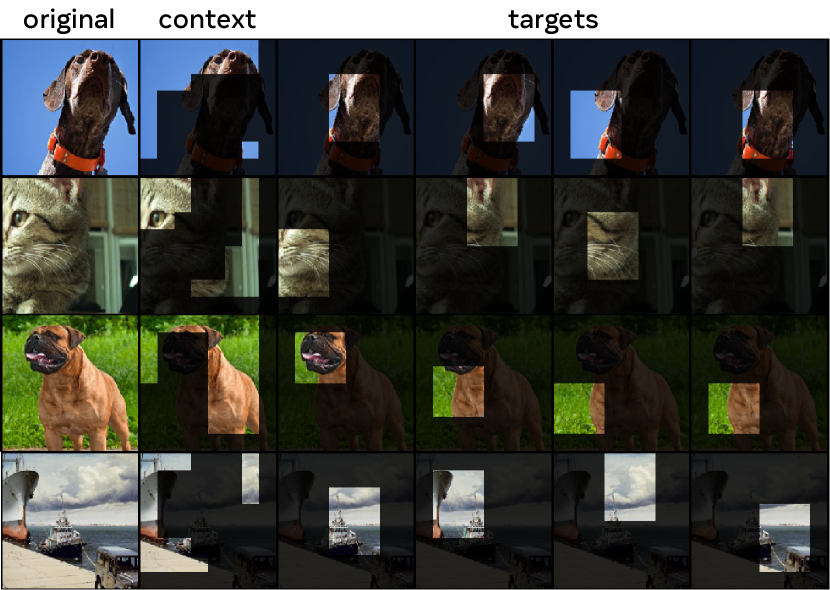
- 目标块要够大(scale 0.15–0.2):太小的块只是"填纹理",逼不出语义;块够大,模型才必须理解"这是一只狗的腿"才能预测。
- 上下文要够信息丰富(scale 0.85–1.0,但稀疏):上下文要保留全局结构线索,又不能太密否则省不了算力。
这条"大目标 + 稀疏上下文“的经验,是 I-JEPA 比早期掩码方法学到更语义化表征的直接原因。
代码走一遍:JEPA 训练和推理到底在干什么?
光看架构图还是抽象,下面用伪代码把训练和推理的每一行都拆开。
训练代码:一个 batch 的完整流程
import torch
import torch.nn as nn

# ========== 第 0 步:定义三个组件 ==========

# Context Encoder:把可见 patch 编码成表征(Student,有梯度)
context_encoder = ViT(patch_size=16, embed_dim=1024, num_layers=12)

# Target Encoder:把目标块编码成表征(Teacher,EMA 更新,无梯度)
target_encoder = ViT(patch_size=16, embed_dim=1024, num_layers=12)

# Predictor:接收上下文表征 + 位置 token,预测目标表征
predictor = MLP(input_dim=1024 + pos_dim, hidden_dim=4096, output_dim=1024)

# EMA 更新器:让 Teacher 缓慢追随 Student
ema_momentum = 0.996  # 越大越慢,通常 0.99~0.999

# ========== 第 1 步:准备数据 ==========

# 一批图片,形状 (B, 3, 224, 224),B=256
images = load_batch()  # (256, 3, 224, 224)

# 切成 patch:224/16 = 14,共 14×14=196 个 patch
patches = patchify(images)  # (256, 196, 768)

# 随机掩码:挖掉 75% 的 patch,留 25% 作上下文
mask = generate_mask(num_patches=196, mask_ratio=0.75)  # (256, 196) bool
# mask[i][j] = True 表示第 i 张图的第 j 个 patch 被挖掉

context_patches = patches[~mask]  # 可见 patch(上下文)
target_patches = patches[mask]    # 被挖掉的 patch(目标)

# ========== 第 2 步:编码 ==========

# 上下文编码(Student,有梯度)
s_x = context_encoder(context_patches)  # (B, num_context, 1024)

# 目标编码(Teacher,无梯度,EMA 更新)
with torch.no_grad():  # ← stop-gradient!梯度不传给 Teacher
    T_y = target_encoder(target_patches)  # (B, num_target, 1024)

# ========== 第 3 步:预测 ==========

# 给每个目标块加位置 token(告诉预测器"你要预测哪个位置")
pos_tokens = get_position_embeddings(target_positions)  # (B, num_target, pos_dim)

# 预测器:输入 = 上下文表征(全局池化)+ 位置 token
s_x_pooled = s_x.mean(dim=1)  # (B, 1024) 全局平均池化
s_x_expanded = s_x_pooled.unsqueeze(1).expand(-1, num_target, -1)  # (B, num_target, 1024)

predictor_input = torch.cat([s_x_expanded, pos_tokens], dim=-1)  # (B, num_target, 1024+pos_dim)
s_y_pred = predictor(predictor_input)  # (B, num_target, 1024) 预测的目标表征

# ========== 第 4 步:算 loss ==========

# 只在表征空间算 MSE,不碰像素!
loss = ((s_y_pred - T_y) ** 2).mean()

# ========== 第 5 步:反向传播 ==========

loss.backward()
optimizer.step()  # 只更新 context_encoder + predictor
optimizer.zero_grad()

# ========== 第 6 步:EMA 更新 Teacher ==========

# Teacher 不靠梯度,而是缓慢"抄"Student 的权重
for param_t, param_s in zip(target_encoder.parameters(),
                             context_encoder.parameters()):
    param_t.data = ema_momentum * param_t.data + (1 - ema_momentum) * param_s.data

# 循环以上步骤,模型逐渐学会"根据上下文预测被遮部分的语义"
逐行拆解:关键设计对应的代码
| 代码行 | 对应的设计 | 为什么这么写 |
|---|---|---|
with torch.no_grad() | stop-gradient | 梯度不传给 Teacher,防止坍缩 |
ema_momentum = 0.996 | EMA 更新 | Teacher 变化很慢,Student 必须真正预测 |
predictor 是独立 MLP | 预测器和编码器分离 | 预测器可以很深(4层),但编码器不变 |
mask_ratio=0.75 | 掩码 75% | 上下文只有 25%,迫使模型学高级语义 |
pos_tokens | 位置 token | 告诉预测器"预测哪个位置”,否则它不知道该猜哪 |
loss = (pred - target)² | 表征空间 MSE | 不碰像素,只在抽象空间算差距 |
推理代码:训练好的 JEPA 怎么用?
训练完成后,JEPA 有两种使用方式:
用法一:特征提取器(最常见)
# 训练完成后,只用 Context Encoder 当特征提取器
# Target Encoder 和 Predictor 全部扔掉!

# 输入一张新图片
image = load_image("car_on_road.jpg")  # (3, 224, 224)

# 用训练好的 Context Encoder 编码
with torch.no_grad():
    features = context_encoder(image)  # (1, num_patches, 1024)

# features 就是这张图的"语义表征"
# 可以直接喂给下游任务:
# - 检测:features → 检测头 → 3D bbox
# - 分类:features.mean() → 分类头 → 类别
# - 规划:features → 规划头 → 轨迹
用法二:世界模型预测(V-JEPA 2)
# 用 V-JEPA 2 做"预测未来"
# 给定过去几帧 + 动作,预测未来帧的表征

# 过去 4 帧的表征
past_frames = [encoder(frame_t_i) for i in range(4)]  # 4 × (1, 1024)

# 自车动作(方向盘、油门)
action = torch.tensor([0.3, 0.5])  # 轻微左转 + 中等油门

# 用预测器逐帧预测未来
future_representations = []
current_state = past_frames[-1]  # 最近一帧的表征

for t in range(10):  # 预测未来 10 步
    # 预测下一步的表征
    next_state = predictor(current_state, action)  # (1, 1024)
    future_representations.append(next_state)
    current_state = next_state  # 自回归:把预测结果当输入

# future_representations 就是"想象中"的未来 10 步表征
# 可以用来:
# - 选轨迹:rollout 多条动作,选未来表征最好的那条
# - 安全检查:预测的表征是否包含"碰撞"概念
# - 异常检测:预测表征和实际表征差距大 → 世界模型没预测到的情况
训练 vs 推理的完整对比
| 训练时 | 推理时 | |
|---|---|---|
| 用哪些组件 | Context Encoder + Target Encoder + Predictor | 只用 Context Encoder(+ Predictor 如果做世界模型) |
| 输入 | 掩码后的图片(上下文 + 目标) | 完整图片(不需要掩码) |
| 输出 | 预测的目标表征 ŝᵧ | 图片的语义表征 sₓ |
| 算 loss? | ✅ 和 Teacher 的输出比较 | ❌ 不算 loss |
| EMA 更新? | ✅ 每步更新 Teacher | ❌ Teacher 不参与 |
| 用途 | 学习表征 | 用表征做下游任务 |
🧠 世界模型从入门到深入:概念、数学、训练、推理全拆解
这一节面向对世界模型不熟悉的读者,从最基础的概念讲起,逐步深入到数学定义、与扩散模型的关系、自动驾驶中的训练与推理全流程,最后给出完整伪代码。如果你已经熟悉 VLA 但对世界模型陌生,这一节帮你建立完整认知。
一、世界模型到底是什么?——从人类直觉到数学定义
人类每天都在用"世界模型"
你不需要学过 AI 就已经在用世界模型了:
数学定义:一句话概括
世界模型的核心是一个条件概率分布:
$$p(s_{t+1} \mid s_t, a_t)$$翻译成人话:
| 符号 | 含义 | 自动驾驶举例 |
|---|---|---|
| $s_t$ | 当前状态 | 当前时刻的感知结果(车辆位置、速度、车道线) |
| $a_t$ | 当前动作 | 自车的转向角 + 加速度 |
| $s_{t+1}$ | 下一个状态 | 1 秒后所有车辆的位置和速度 |
世界模型 = 给定"现在世界是什么样" + “我做了什么”,预测"下一秒世界会变成什么样"。
世界模型 vs VLA:本质区别
| 世界模型(World Model) | VLA(Vision-Language-Action) | |
|---|---|---|
| 输入 | 状态 $s_t$ + 动作 $a_t$ | 图像 + 语言指令 |
| 输出 | 下一个状态 $s_{t+1}$(预测世界) | 动作 $a_t$(控制机器人) |
| 核心能力 | 想象/预测未来 | 决策/执行动作 |
| 类比 | 你脑子里的"预演器" | 你手上的"操纵杆" |
| 训练目标 | 预测世界变化 | 预测正确动作 |
关键区别:VLA 直接输出动作,世界模型输出"如果我这么做,世界会变成怎样"。世界模型不直接控制,而是为决策提供"想象力"。
世界模型的三种存在形式
自动驾驶目前的主流趋势:从像素世界模型(贵)转向表征世界模型(快且够用),这正是 JEPA 的核心价值。
二、世界模型为什么和扩散模型有关?——历史脉络
扩散模型的兴起如何催生了世界模型
很多人以为世界模型和扩散模型是两个独立的东西,其实它们有深刻的历史关联:
所以时间线是:
为什么扩散模型特别适合做世界模型?
扩散模型做世界模型有三个天然优势:
| 优势 | 原因 | 举例 |
|---|---|---|
| 多模态建模 | 未来有多种可能(左转/右转/直行),扩散模型能生成多种未来 | “前方路口可能左转也可能右转” |
| 高质量生成 | 去噪过程逐步精细化,生成的未来画面清晰逼真 | 生成的未来驾驶场景像素级真实 |
| 条件控制 | 可以用动作条件控制生成的未来(“如果我左转…") | 给定左转动作,生成左转后的场景 |
但扩散模型做世界模型也有致命缺点:
| 缺点 | 原因 | 后果 |
|---|---|---|
| 推理太慢 | 多步去噪(5-50 步) | 车端实时性差 |
| 计算太贵 | 要生成每个像素 | 需要高端 GPU |
| 不保证物理一致 | 像素级生成没有物理约束 | 可能画出穿墙的车 |
这就是 JEPA 的机会:用表征空间预测替代像素空间生成,保留扩散模型的多模态优势,同时解决速度和计算量问题。
三、自动驾驶中世界模型的训练:从数据到模型
训练数据长什么样?
世界模型的训练数据是驾驶视频 + 自车动作:
训练的两种范式
范式一:像素世界模型(扩散模型驱动)
范式二:表征世界模型(JEPA 驱动)
对比:
| 像素世界模型 | 表征世界模型(JEPA) | |
|---|---|---|
| 训练数据 | 需要高分辨率视频 | 同样数据,但可压缩 |
| 模型大小 | 编码器 + 扩散模型 + 解码器 | 编码器 + 预测器(更小) |
| 训练速度 | 慢(扩散多步) | 快(单次前向) |
| 推理速度 | 慢(5-50 步去噪) | 快(1 步) |
| 生成质量 | 高(像素级真实) | 不生成像素 |
| 物理一致性 | 弱 | 可注入先验 |
四、世界模型的推理:怎么做"想象"和规划
推理流程:从"看到现在"到"想象未来”
规划:世界模型如何帮自动驾驶做决策
这是世界模型最核心的应用——在"想象"中试错,而不是在真实世界中试错:
关键insight:世界模型让自动驾驶可以在"脑子里"大量试错,而不需要在真实道路上冒险。这和人类开车的方式一样——你不会真的去撞墙来验证"撞墙会怎样"。
五、完整伪代码:世界模型的训练与推理
像素世界模型(扩散模型版)训练伪代码
import torch
import torch.nn as nn

# ========== 组件定义 ==========

# 视频编码器:把图像帧编码成潜变量
encoder = VideoEncoder(in_channels=3, latent_dim=256)

# 视频解码器:把潜变量还原成图像帧
decoder = VideoDecoder(latent_dim=256, out_channels=3)

# 动作编码器:把自车动作编码成向量
action_encoder = MLP(input_dim=2, hidden_dim=128, output_dim=256)

# 扩散模型:以当前潜变量和动作为条件,预测未来潜变量
diffusion = DiffusionUNet(
    in_channels=256,      # 潜变量通道
    cond_channels=256,    # 条件(当前状态+动作)通道
    num_timesteps=1000    # 扩散时间步数
)

# ========== 训练循环 ==========

for epoch in range(num_epochs):
    for video, actions in dataloader:
        # video: (B, T, 3, H, W) — 连续 T 帧驾驶视频
        # actions: (B, T, 2) — 每帧的 [转向角, 加速度]

        for t in range(T - 1):
            # 当前帧和动作
            frame_t = video[:, t]        # (B, 3, H, W)
            action_t = actions[:, t]     # (B, 2)
            frame_next = video[:, t+1]   # (B, 3, H, W) — 真实未来帧

            # 编码当前帧
            z_t = encoder(frame_t)       # (B, 256, h, w)

            # 编码动作
            a_t = action_encoder(action_t)  # (B, 256)
            a_t = a_t.unsqueeze(-1).unsqueeze(-1)  # 扩展空间维度

            # 条件 = 当前状态 + 动作
            cond = z_t + a_t  # (B, 256, h, w)

            # 编码真实未来帧(作为扩散目标)
            z_next = encoder(frame_next)  # (B, 256, h, w)

            # 扩散训练:给 z_next 加噪,训练模型去噪
            timestep = torch.randint(0, 1000, (B,))
            noise = torch.randn_like(z_next)
            z_noisy = add_noise(z_next, noise, timestep)

            # 模型预测噪声
            noise_pred = diffusion(z_noisy, cond, timestep)

            # 计算损失
            loss = F.mse_loss(noise_pred, noise)

            # 反向传播
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()
表征世界模型(JEPA 版)训练伪代码
import torch
import torch.nn as nn

# ========== 组件定义 ==========

# 视频编码器(Student,有梯度)
encoder = ViT(patch_size=16, embed_dim=1024, num_layers=12)

# 目标编码器(Teacher,EMA 更新,无梯度)
target_encoder = ViT(patch_size=16, embed_dim=1024, num_layers=12)

# 动作编码器:把自车动作编码成向量
action_encoder = MLP(input_dim=2, hidden_dim=256, output_dim=1024)

# 世界模型预测器:预测下一帧的表征
world_predictor = Transformer(
    input_dim=1024,
    cond_dim=1024,  # 动作条件维度
    num_layers=6,
    num_heads=16
)

# EMA 更新器
ema_momentum = 0.996

# ========== 训练循环 ==========

for epoch in range(num_epochs):
    for video, actions in dataloader:
        # video: (B, T, 3, H, W)
        # actions: (B, T, 2)

        for t in range(T - 1):
            frame_t = video[:, t]
            action_t = actions[:, t]
            frame_next = video[:, t+1]

            # Student 编码当前帧(有梯度)
            z_t = encoder(frame_t)  # (B, num_patches, 1024)

            # Teacher 编码未来帧(无梯度,作为目标)
            with torch.no_grad():
                z_next_target = target_encoder(frame_next)  # (B, num_patches, 1024)
                # 全局平均池化得到单个向量
                z_next_target = z_next_target.mean(dim=1)   # (B, 1024)

            # 编码动作
            a_t = action_encoder(action_t)  # (B, 1024)

            # Student 当前帧也做全局池化
            z_t_pooled = z_t.mean(dim=1)  # (B, 1024)

            # 预测器:预测下一帧的表征
            # 输入 = 当前状态 + 动作条件
            z_next_pred = world_predictor(z_t_pooled, a_t)  # (B, 1024)

            # 计算损失:预测的表征 vs 真实的表征
            loss = F.mse_loss(z_next_pred, z_next_target)

            # 反向传播:只更新 Student + Predictor
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()

            # EMA 更新 Teacher
            for param_t, param_s in zip(target_encoder.parameters(),
                                         encoder.parameters()):
                param_t.data = (ema_momentum * param_t.data +
                               (1 - ema_momentum) * param_s.data)
世界模型推理伪代码(用于规划)
def rollout_plan(world_model, encoder, current_frame, candidate_actions, horizon=10):
    """
    用世界模型 rollout 多条候选轨迹,选最优动作

    参数:
      world_model: 训练好的预测器
      encoder: 训练好的编码器
      current_frame: 当前图像帧
      candidate_actions: (N, horizon, 2) — N 条候选轨迹,每条 horizon 步
      horizon: 预测时域

    返回:
      best_action: 最优的下一步动作
    """

    # 第 1 步:编码当前状态
    with torch.no_grad():
        z_current = encoder(current_frame)  # (1, 1024)
        z_current = z_current.mean(dim=1)

    # 第 2 步:对每条候选轨迹做 rollout
    scores = []
    for i in range(candidate_actions.shape[0]):
        z = z_current.clone()
        trajectory_score = 0

        for t in range(horizon):
            # 编码这一步的动作
            a_t = action_encoder(candidate_actions[i, t])

            # 世界模型预测下一步的表征
            z_next = world_model(z, a_t)

            # 用 critic 评估这个状态的好坏
            score = critic(z_next)  # 越高越好
            trajectory_score += score

            z = z_next  # 自回归:把预测结果当输入

        scores.append(trajectory_score)

    # 第 3 步:选得分最高的轨迹
    scores = torch.stack(scores)
    best_idx = scores.argmax()
    best_action = candidate_actions[best_idx, 0]  # 只执行第一步

    return best_action
六、世界模型 vs VLA:什么时候用哪个?
这是很多人困惑的问题——VLA 直接输出动作,世界模型预测未来状态,那到底该用哪个?
核心区别:直接决策 vs 间接想象
对比表
| 维度 | VLA(如 RT-2、OpenVLA) | 世界模型(如 Dreamer、JEPA-AD) |
|---|---|---|
| 输出 | 动作 $a_t$ | 未来状态 $s_{t+1}$ |
| 决策方式 | 端到端,直接从感知到动作 | 两步:先想象未来,再选最优动作 |
| 可解释性 | 弱(黑盒输出动作) | 强(可以检查"想象"的未来是否合理) |
| 安全验证 | 难(不知道为什么输出这个动作) | 容易(可以验证想象的未来没有碰撞) |
| 训练数据 | 需要动作标签(监督学习) | 可以用无标签视频(自监督) |
| 长尾场景 | 弱(没见过的场景可能输出错误动作) | 强(可以在想象中模拟罕见场景) |
| 推理速度 | 快(单次前向) | 取决于 rollout 长度(可能较慢) |
| 典型架构 | ViT + LLM + 动作头 | 编码器 + 世界模型 + 规划器 |
什么时候用哪个?
自动驾驶中的融合趋势
七、一句话总结
世界模型 = 有条件的"未来预测器"。给定当前状态和动作,预测下一个状态。它不直接控制,而是为决策提供"想象力"——让 AI 在"脑子里"试错,而不是在真实世界中冒险。扩散模型提供了生成多种未来的能力,JEPA 提供了高效预测表征的能力,两者共同构成了自动驾驶世界模型的技术基础。
⚔️ 与主流路线的区别:对比学习 vs 生成模型 vs JEPA
自监督视觉学习大致三条路,理解它们的差异是抓住 JEPA 价值的关键。LeCun 用**基于能量的模型(EBM)**框架把它们统一描述:目标是给"相容的输入对"低能量、给"不相容的输入对"高能量。
| 维度 | 对比学习(CLIP / SimCLR / DINO) | 生成模型(MAE / Diffusion / VAE) | JEPA |
|---|---|---|---|
| 核心操作 | 让两视图编码尽量相似 | 重建/生成像素或 token | 预测目标的嵌入 |
| 损失空间 | 表征空间(相似度) | 像素/输入空间 | 表征空间(预测) |
| 需要什么"配对" | 同图的两个增强视图 | 原图 + 被遮部分 | 上下文 + 目标块 |
| 是否依赖人工增强 | ✅ 重度依赖(裁剪、变色…) | ❌ 不依赖 | ❌ 不依赖 |
| 是否建模"预测关系" | ❌ 只求不变性 | ✅ 重建关系 | ✅ 条件预测关系 |
| 坍缩风险 | 用负样本/聚类缓解 | 几乎没有 | 需 EMA + stop-grad 防护 |
| 语义层级 | 高(线性可分强) | 偏低(需 finetune) | 高,且兼顾低层任务 |
| 扩展性 | 受增强策略限制 | 计算昂贵 | 算力友好、易扩展 |
三条要点对比:
- vs 对比学习:CLIP/SimCLR/DINO 需要"正负样本对“和人工数据增强(裁剪、颜色抖动)。这些增强是为人造的"不变性先验”,对不同任务可能有害,且难迁移到视频/音频。JEPA 不用任何增强,靠掩码和预测目标本身就能学。
- vs MAE:MAE 也是"掩码 + ViT",但它在像素空间重建被遮 patch——因此表征偏低层、linear probing 不如对比学习,需 finetune 才发力。JEPA 把损失换到表征空间,linear probing 直接逼近对比学习,同时在计数、深度预测等低层任务上反超。
- vs Diffusion/VAE:生成模型擅长"画出"未来,但贵、且多模态未来会被回归成糊图。JEPA 不画,只预测抽象状态,天然适合做世界模型的"想象力引擎"。
I-JEPA 实测:在 ImageNet 上训 ViT-H/14 只需 16 张 A100、72 小时内,比 iBOT 快约 2.5×,比 MAE 训同尺寸模型快约 10×,还能省掉全部数据增强。
📈 演进:I-JEPA → V-JEPA → V-JEPA 2
JEPA 是一个架构家族,按模态和时间线一路进化:
| 版本 | 时间 | 模态 | 关键贡献 |
|---|---|---|---|
| JEPA 概念 | 2022 | 抽象 | LeCun 在蓝图论文里首次系统阐述 |
| I-JEPA | 2023 (CVPR) | 图像 | 首个落地实例,证明"表征空间预测 + 大目标块"有效,无需数据增强 |
| V-JEPA | 2024 | 视频 | 把 I-JEPA 扩展到时序:用过去几帧预测未来帧的表征,引入时空掩码,在 Kinetics、Something-Something 上拿下 SOTA,首次逼近或超越视频版 MAE/对比方法 |
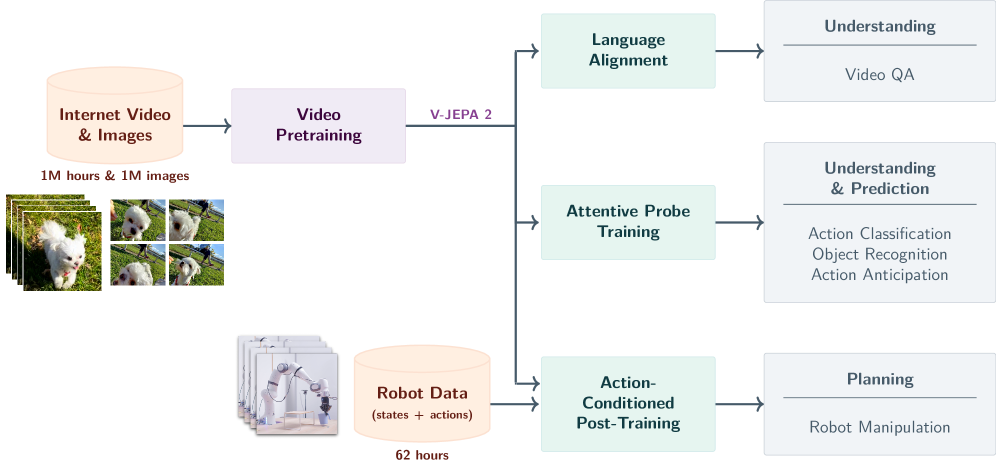
| V-JEPA 2 | 2025 | 视频 + 世界模型 | 关键飞跃:引入自回归预测器,让模型在表征空间逐帧预测未来,并在大规模无标注视频上预训练。它展示出理解物理、动作可控生成、机器人规划能力,被 Meta 定位为"物理世界的基础模型" |
V-JEPA 2 为什么是个里程碑
V-JEPA 2 把 JEPA 从"学表征的工具“升级成”能预测、能规划的世界模型":
- 学到了物理直觉:能判断"物体能不能叠起来"“球会不会滚落"这类直觉物理(intuitive physics),这是像素生成模型长期做不好的事。
- 动作条件预测:给一个机器人动作 token,它能预测操作后环境的下一状态表征,从而做model-based planning。
- 规模即能力:在大规模无标注视频上预训练后,表征直接迁移到下游,验证了”少标注、多预测“的 Scaling Law 路线。
这正是 LeCun 蓝图里”世界模型 + Actor-Critic“架构的第一次规模化兑现。
📈 V-JEPA 2 的详细架构:双重损失设计
V-JEPA 2 最大的工程创新在于其两阶段训练策略,特别是第二阶段中动作条件预测器(Action-Conditioned Predictor) 的设计:
Teacher Forcing + Rollout 双重损失
V-JEPA 2-AC 的训练使用两种互补的损失函数:
教师强迫损失(Teacher Forcing Loss):每一步使用真实的前一帧编码 $z_t$ 作为输入,预测下一帧编码 $\hat{z}_{t+1}$。这给预测器提供最干净的逐帧训练信号:
$$\mathcal{L}_{\text{tf}} = \|\hat{z}_{t+1} - z_{t+1}\|_1$$Rollout 损失(Rollout Loss):从初始帧 $z_0$ 开始,将预测器的输出反馈作为下一步的输入,进行多步自回归预测,最后一步的预测值与真实值对比。这惩罚了预测误差的累积:
$$\mathcal{L}_{\text{roll}} = \|\hat{z}_K - z_K\|_1, \quad \hat{z}_{1:K} = \text{rollout}_\psi(z_0, a_{1:K}, s_{0:K-1})$$联合损失为两者加权和:
$$\mathcal{L} = \mathcal{L}_{\text{tf}} + \lambda \cdot \mathcal{L}_{\text{roll}}$$其中 $\lambda$ 控制多步预测的惩罚强度。实验表明,单独使用教师强迫会导致 rollout 时误差指数级累积;单独使用 rollout 则训练信号太稀疏。两者的组合是 V-JEPA 2-AC 训练稳定的关键。
冻结编码器 + 小量动作数据
V-JEPA 2 的一个关键设计原则:第二阶段冻结编码器。编码器已经在第一阶段学到了稳定、通用的视频表征;第二阶段只训练一个轻量的预测器(约 300M 参数),在冻结的表征空间上学习动力学。这意味着只需要 62 小时的机器人遥操作数据就能实现零样本控制——因为空间理解已经在第一阶段从互联网视频中获得了,第二阶段只需学会"在这个空间里如何动”。
🚗 JEPA 在自动驾驶中的应用
自动驾驶天然适合 JEPA:多路相机视频是时序的、高度结构化的、且决策只关心语义——路的几何、车的运动、人的意图,而不是广告牌的渐变色。
应用一:用 JEPA 做场景表征预训练
把 I-JEPA / V-JEPA 当自监督预训练骨干,在大量无标注驾驶视频上学通用表征,再迁移到下游:
| 下游任务 | JEPA 表征带来的好处 |
|---|---|
| 3D 检测 / 跟踪 | 抽象表征抑制无关纹理,目标更可分 |
| BEV 感知 | 时序表征编码了运动线索,利于时序融合 |
| 占用预测(Occupancy) | 表征天然具备几何/语义抽象 |
| 在线 HDMap 构建 | 少标注甚至零标注迁移 |
相比从 ImageNet 预训练迁移,在驾驶域视频上做 V-JEPA 式预训练能显著缩小域差距(domain gap)。
应用二:JEPA-AD 与潜空间世界模型
近期出现的 JEPA-AD 等工作,把 JEPA 思想直接搬进驾驶世界模型:
- 编码历史观测:环视多相机 + BEV 特征作为上下文 $s_t$;
- 注入自车动作:油门/转向/轨迹作为条件 token $z$;
- 预测未来表征:预测 $s_{t+1}, s_{t+2}, \dots$ 的抽象表征,而非生成未来视频帧;
- 服务规划:在潜空间里 rollout 候选轨迹,选最优动作。
这条路线相比 Diffusion 世界模型(如 Drive-WM、Sora 式生成)有显著优势:
| 维度 | Diffusion 世界模型 | JEPA 世界模型(JEPA-AD 等) |
|---|---|---|
| 推理速度 | 多步去噪,慢 | 单次前向,快,适合车端 |
| 物理一致性 | 不保证,可能穿墙 | 可注入几何/运动先验 |
| 服务规划 | 需先解码像素再读语义 | 表征可直接喂规划头 |
| 可解释性 | 弱 | 可接可解释安全度量 |
| 多模态未来 | 易回归到均值 | 可学潜空间分布 |
应用三:闭环仿真与长尾学习
用 JEPA 学到的潜在动力学,可作为"软仿真器":给定当前场景 + 候选动作,在表征空间快速推演未来,无需渲染像素。这让长尾场景的闭环训练既快又安全——智能体在"想象"里大量试错,避开了真实路测风险和渲染开销。
🌍 JEPA 作为世界模型的潜力
把 JEPA 和 model-based RL 串起来,就接上了 LeCun 蓝图里最关键的一环——可预测的世界模型:
$$s_{t+1} = \text{Predictor}_\theta(s_t,\ a_t)$$- 学习信号:用大量无标注驾驶视频(无动作标签时,可用"未来帧表征"做目标;有动作标签时,把动作注入条件)。
- 规划方式:在潜空间 rollout 多条候选轨迹,用 critic / 安全约束选最优——类似 Dreamer 在潜空间想象,但丢弃了像素重建这一昂贵环节。
- 可注入先验:BEV 几何、运动学约束、碰撞检测都可作为预测器结构或额外损失,保证物理可信。
这条路线如果跑通,自动驾驶系统将拥有一个长程稳定、物理可信、可被规划直接调用的"脑子里的预演器"——这正是行业公认的通往 L4 的关键拼图。
与本博客另一篇《什么是世界模型》对照:那里把世界模型分为生成式和表征式两派,JEPA 正是"表征式"流派的旗舰架构。
🧱 当前挑战与局限
JEPA 不是银弹,落地驾驶还面临几道硬坎:
- 表征坍缩是悬顶之剑:EMA + stop-grad 是经验解,不是理论保证。架构稍变、学习率稍错,就可能坍缩成常向量,训练需要小心调参。
- 缺动作标签的难题:驾驶视频海量,但带精确自车动作的相对少。无动作条件下的时序预测容易学到"相机抖动"这类捷径,而非真正动力学。
- 多相机 / 3D 一致性:V-JEPA 原生面向单镜头视频,迁移到环视 6 路相机需要显式的 3D / BEV 几何对齐,否则跨视角表征会矛盾。
- 长程预测误差累积:和所有世界模型一样,预测越远越飘。潜空间虽比像素稳,但仍需分层预测、记忆增强来抑制指数级漂移。
- 可解释性与安全度量:潜空间表征里读不出"碰撞时间 TTC"“距前车距离”,而驾驶决策必须可解释、可验证——需要把抽象表征和可读安全度量对齐。
- 评测体系缺失:JEPA 表征好不好,目前主要靠 linear probing / 下游 finetune,缺少面向驾驶的闭环评测基准(预测轨迹误差、碰撞率、动作可控度)。
- 算力虽省但门槛仍高:ViT-H 级骨干 + EMA 目标编码器,显存与工程复杂度不低,中小团队复现不易。
🧭 小结
JEPA 的哲学很纯粹:让 AI 学"会发生什么",而不是"画得像什么"。它用一个上下文编码器 + 目标编码器 + 预测器的极简三件套,把自监督学习从"重建像素 / 对比增强"推进到"在抽象表征上做条件预测",顺带省掉了数据增强、绕开了像素灾难。
对自动驾驶而言,JEPA 提供了一条有别于 Diffusion 世界模型的技术路线:更轻、更快、更关注语义和物理因果,天然适合做潜空间动力学和 model-based planning。从 I-JEPA 到 V-JEPA 2,从图像表征到物理世界基础模型,LeCun 的蓝图正在被一块块兑现。
一句话定位:如果 Diffusion 世界模型是"把未来画出来“的画家,那 JEPA 世界模型就是”在脑子里推演未来“的战略家。自动驾驶最终需要的,是后者那种能直接喂给决策的抽象预测。
挑战依旧——坍缩、长程一致性、可解释性、闭环评测——但方向清晰。谁能率先造出一个稳定、可信、可被规划调用的 JEPA 式驾驶世界模型,谁就拿到了通往 L4 的另一张门票。
💡 扩展阅读:本博客《什么是世界模型》讲了两派世界模型的全景,《Flow-Matching 入门详解》讲了生成式路线的另一条主流。把它们和这篇放一起,就能拼出”自动驾驶世界模型“的完整技术地图。