🎯 NAVSIM 是什么?
NAVSIM = Non-reactive Autonomous Vehicle Simulation,一个"非反应式"的自动驾驶开环评测框架与基准。
如果你这两年读端到端自动驾驶的论文,几乎每一篇都会报一个叫 PDMS 的分数,这个分数就来自 NAVSIM。它由图宾根大学、NVIDIA Research、OpenDriveLab 联合提出(Daniel Dauner 等,NeurIPS 2024),目前已经是端到端规划领域事实上的标准评测,也是智驾挑战赛(AGC)的官方赛道。
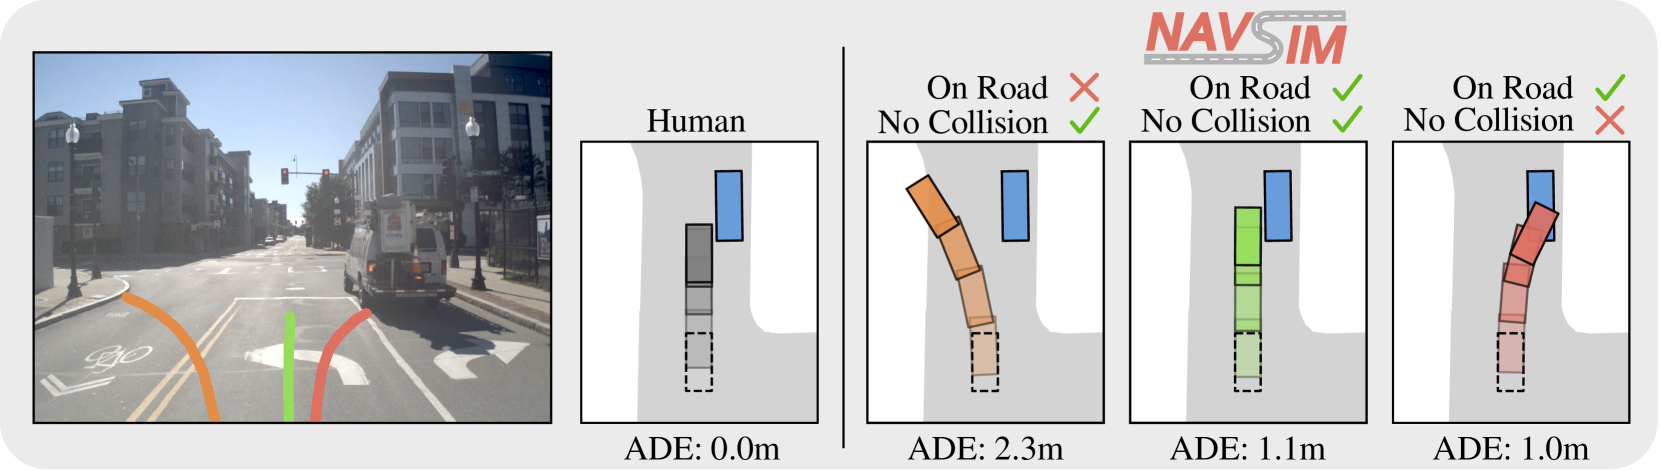
NAVSIM 的几个关键事实:
| 维度 | 说明 |
|---|---|
| 数据来源 | OpenScene 数据集,本质上是 nuPlan 日志降采样到 2 Hz 的子集 |
| 任务 | 给定历史观测(多相机/LiDAR),预测自车未来 4 秒轨迹 |
| 仿真方式 | 非反应式(non-reactive):背景车按录制轨迹走,自车用 LQR 控制器执行预测轨迹 |
| 核心指标 | PDMS(v1)/ EPDMS(v2) |
| 发表 | NeurIPS 2024 Datasets & Benchmarks |
理解 NAVSIM 的关键在于"非反应式“三个字:自车虽然会把轨迹"开出来”(4 秒前向仿真),但周围车辆、行人不会因为自车的动作而改变行为——它们只是回放历史轨迹。这是一种"半开环"设计:既比纯位移误差更接近真实(轨迹要经过物理执行和碰撞检查),又避免了闭环仿真的高昂成本。
一句话定位:NAVSIM 用开环的代价,换取尽可能接近闭环的信号。
📏 核心指标 PDMS 怎么算?
PDMS(Predictive Driver Model Score,预测驾驶模型得分) 是 NAVSIM v1 的核心分数,它最大的贡献是抛弃了与人类轨迹比 L2 误差的思路,转而直接衡量规划的"质量"。
传统 L2 指标的致命缺陷
在 nuScenes 上,规划指标是 L2 位移误差 / 碰撞率。但驾驶本质是多模态的——前方有障碍时,左变道和右变道都合理。如果你预测了"绕行",而人类 GT 是"刹车",L2 会判你错,可你其实开得很好。更糟的是,“原地不动"几乎永远 L2 最低,于是模型学会了"躺平"刷分。
PDMS 的设计哲学
PDMS 的思路是:不跟人比像不像,而是看这条轨迹本身安不安全、舒不舒服、有没有往前走。 它由两部分组成——乘性惩罚(multiplier) 和 加权子分(weighted)。NAVSIM 官方文档(docs/metrics.md)给出的 v1 定义是:
- 乘性部分:一旦发生无责碰撞或驶出可驾驶区域,整条轨迹直接得 0 分——这是"安全一票否决”。
- 加权部分:在安全的前提下,再综合"是否前进、是否留有安全距离、是否舒适"给出质量分。
这样设计的好处非常明显:“原地不动"虽然不撞,但 EP(前进量)极低,拿不到高分;合理的绕行即便偏离人类 GT,只要安全舒适、有进展,照样得高分。
🔧 一次评测到底发生了什么?从模型输出到 PDMS 的完整链路
这是整篇最关键的一节。很多文章只告诉你"NAVSIM 用 LQR 把轨迹开出来再打分”,但没有讲清楚几何轨迹是怎么变成物理运动、又怎么变成分数的。 下面我们完全依据 NAVSIM 官方源码逐段还原,从你的模型吐出一条轨迹开始,到它拿到 PDMS 结束。
第 0 步:模型输出什么?
你的模型输出的东西非常朴素——一个 Trajectory 数据类(navsim/common/dataclasses.py:280):
@dataclass
class Trajectory:
    poses: npt.NDArray[np.float32]        # (T, 3) 局部坐标
    trajectory_sampling: TrajectorySampling = TrajectorySampling(time_horizon=4, interval_length=0.5)
也就是说:未来 4 秒、每 0.5 秒一个点,共 8 个点,每个点是 (x, y, heading),全部是以自车当前后轴为原点的局部坐标。注意这里不含速度、不含加速度——模型只需要给出几何形状。
第 1 步:评测脚本拿到轨迹 → 转全局帧(transform_trajectory)
评测入口在 navsim/planning/script/run_pdm_score.py,它从 MetricCacheLoader 读每条样本的缓存,让模型推理出 Trajectory 后,调用 navsim/evaluate/pdm_score.py 的 pdm_score()。第一步是 transform_trajectory()(pdm_score.py:26):
- 用
relative_to_absolute_poses(initial_ego_state.rear_axle, relative_states)把 8 个相对点转换到全局坐标系; - 通过
_se2_vel_acc_to_ego_state把每个点包装成EgoState,速度与加速度都显式设为 0——源码注释写着 “velocity and acceleration ignored by LQR + bicycle model”,即这两个量反正会被控制器和运动学模型重算,干脆忽略; - 最终拼成一个 nuPlan 的
InterpolatedTrajectory(包含 t=0 的初始自车状态 + 8 个未来状态)。
第 2 步:插值到评测分辨率(get_trajectory_as_array)
get_trajectory_as_array()(pdm_score.py:57)按 future_sampling(评测用的 proposal_sampling)把轨迹重采样成状态数组。看 default_common.yaml:
proposal_sampling:
  num_poses: 40
  interval_length: 0.1
也就是说,实际打分是在 4 秒、0.1 秒步长(40 个点)的分辨率上进行的——模型那 8 个粗点会被插值成 40 个细点。每个状态是一个 11 维向量(pdm_enums.py 的 StateIndex):
| 下标 | 含义 | 单位 |
|---|---|---|
| 0–2 | x, y, heading | m, m, rad |
| 3–4 | velocity_x, velocity_y | m/s |
| 5–6 | acceleration_x, acceleration_y | m/s² |
| 7–8 | steering_angle, steering_rate | rad, rad/s |
| 9–10 | angular_velocity, angular_acceleration | rad/s, rad/s² |
同时,缓存里的 PDM 参考轨迹(metric_cache.trajectory) 也被同样处理。两条轨迹被拼成 (2, 41, 11) 的 batch——第 0 条是参考、第 1 条是你的模型轨迹(pdm_score.py:144)。
第 3 步:LQR 控制器把轨迹翻译成"开出来"(PDMSimulator + BatchLQRTracker)
两条轨迹一起送进 PDMSimulator.simulate_proposals()(pdm_simulator.py:31)。它的核心是两个组件:
BatchLQRTracker(batch_lqr.py)——控制器,负责计算每条轨迹在每个时刻该给什么"指令";BatchKinematicBicycleModel(batch_kinematic_bicycle.py)——车辆运动模型,负责把指令积分成真实状态。
仿真是逐时刻循环的:tracker.track_trajectory() 先根据当前状态和参考轨迹算出控制指令,再用 motion_model.propagate_state() 把状态推进 0.1 秒,如此往复 40 次。
LQR 控制器如何工作?
BatchLQRTracker 把控制问题分解成纵向、横向两个子系统(batch_lqr.py:27 注释明说):
纵向子系统(决定加不加速):
$$\text{State: }[v] \qquad \text{Input: }[a] \qquad v{\_dot} = a$$- 权重:
q_longitudinal = [10.0],r_longitudinal = [1.0]; - 假设整个
tracking_horizon(默认 10 步 × 0.1s = 1 秒)内加速度恒定,于是velocity_N = v_0 + (N·dt)·a; - 这是一个单步 LQR:直接解
min a·(r + B²q)·a...的闭式解得到加速度指令(_solve_one_step_longitudinal_lqr)。
横向子系统(决定转不转方向),状态向量 3 维(LateralStateIndex):
| 下标 | 状态 | 含义 |
|---|---|---|
| 0 | LATERAL_ERROR | 相对参考线的横向偏差(在后轴处) |
| 1 | HEADING_ERROR | 相对参考线的航向偏差 |
| 2 | STEERING_ANGLE | 当前前轮转角 |
其连续动力学(做了小角度线性化):
$$\dot{e}_{lat} = v \cdot e_{head} \qquad \dot{e}_{head} = v \cdot \left(\frac{\delta}{L} - \kappa\right) \qquad \dot{\delta} = \dot{\delta}_{cmd}$$其中 $L$ 是轴距、$\kappa$ 是参考线曲率。权重 q_lateral = [1.0, 10.0, 0.0]、r_lateral = [1.0],输入是转向速率 $\dot\delta$。由于速度、曲率随时间变化,这是一个线性时变(LTV)系统:控制器会先把 tracking_horizon 步的状态转移矩阵 $A$、输入矩阵 $B$、仿射项 $g$ 逐步前推(_lateral_lqr_controller 里的 einsum 累乘),再解一个单步 LQR 得到转向速率指令。
💡 细节:当参考速度和当前速度都低于
stopping_velocity = 0.2 m/s时,LQR 会被一个更简单的停车 P 控制器取代:a = -0.5·(v - v_ref),转向速率归零。这在等红灯场景非常常见。
运动模型如何积分?
BatchKinematicBicycleModel(batch_kinematic_bicycle.py)使用经典自行车模型(后轴为参考点):
关键参数(全部可在源码确认):
- 车辆使用 Pacifica(克莱斯勒大捷龙)参数:轴距
wheel_base = 3.089 m、半长2.588 m、半宽1.1485 m; - 指令不是立即生效:加速和转向各经过一个一阶低通/控制延迟(
accel_time_constant=0.2s、steering_angle_time_constant=0.05s),模拟真实执行器滞后; - 转向角被 clip 到 $\pm \pi/3$,heading 用
principal_value归一化到 $[-\pi, \pi]$。
最终 simulate_proposals 返回 (2, 41, 11) 的仿真后真实状态——这才是打分器看到的"自车实际轨迹"。
第 4 步:背景交通流(traffic agents policy)
pdm_score_from_interpolated_trajectory 里,仿真出的自车轨迹会交给一个 traffic_agents_policy 生成背景车序列(pdm_score.py:149):
simulated_agent_detections_tracks = traffic_agents_policy.simulate_environment(simulated_states[1], metric_cache)
- 默认(v1 风格,
log_replay_traffic_agents.py):直接取metric_cache.observation里录制好的未来目标轨迹,只把与初始自车重叠的车辆去掉——这就是"非反应式"的字面实现; - 反应式(
navsim_IDM_traffic_agents.py):让背景车用 IDM 跟车模型对自车的动作做出反应(v2 两阶段评测采用)。IDM 参数可见navsim_IDM_traffic_agents.yaml:目标速度 10 m/s、最小间距 1.0 m、车头时距 1.5 s、a_max=1.0、d_max=2.0。
⚠️ 注意:NAVSIM v2(navhard)的背景车其实是反应式的。论文标题里的"non-reactive"描述的是自车评测流程(不开环做多步递归仿真),而背景车可以用 IDM 响应——这是很多人理解的误区。
第 5 步:打分器算各子分(PDMScorer)
scorer.score_proposals()(pdm_scorer.py:130)拿到的就是仿真后状态。它先把自车每个时刻的位姿转成车辆包围盒多边形(state_array_to_coords_array),然后算两组指标:
乘性指标(MultiMetricIndex)——任何一个违规整条得 0:
| 子指标 | 含义 | 取值 |
|---|---|---|
| NC No at-fault Collisions | 是否发生有责碰撞(区分前撞/侧撞,撞静止车与动态车责任不同) | {0, ½, 1} |
| DAC Drivable Area Compliance | 车辆是否始终在可驾驶区域内(车道/路口/泊车区) | {0, 1} |
| DDC Driving Direction Compliance | 是否逆行(沿前进方向投影距离衡量) | {0, ½, 1} |
| TLC Traffic Light Compliance | 是否闯红灯(与红灯多边形相交) | {0, 1} |
v1 只有前两个(NC、DAC),v2 新增 DDC、TLC(
docs/metrics.md明确标注)。
加权指标(WeightedMetricIndex)——在安全前提下给出质量分:
| 子指标 | 权重 | 含义 |
|---|---|---|
| EP Ego Progress | 5 | 沿参考中线前进的距离,归一化到 [0,1](反"躺平"的关键) |
| TTC Time-to-Collision | 5 | 未来 1s 内是否始终保留碰撞时间余量(投影 1s 后的车体做前瞻检查) |
| LK Lane Keeping | 2 | 连续 2s 偏离车道中心线 > 0.5m 则失败(路口不判) |
| HC History Comfort | 2 | 舒适度,把人类历史轨迹拼在前面一起算体感(急加急刹/急转都扣) |
| EC Extended Comfort | 2 | 相邻帧输出轨迹的动态一致性,防止"忽左忽右"抖动 |
v1 的加权项是
{EP, TTC, C}(权重 5/5/2),v2 把 C 拆成 HC + EC,并新增 LK。所有权重、阈值都在pdm_scorer.yaml里:progress 5, ttc 5, lane_keeping 2, history_comfort 2, two_frame_extended_comfort 2。
最终在 _aggregate_pdm_scores()(pdm_scorer.py:223)里合成:
注意 EP 是相对归一化的:以当前 batch 里所有候选轨迹的最大前进量为基准做 clip 归一化(norm_constant_progress = np.max(masked_progress)),这样"敢开"的候选相对占优。而 EC(两帧扩展舒适)这一步先不参与——它是 v2 在后处理阶段单独注入的(见下文两阶段聚合)。
第 6 步:v2 的 EPDMS —— 两阶段伪闭环聚合
上面算出来的是"单场景 PDMS"。EPDMS(v2 / navhard) 在其之上加了 SceneAggregator(scene_aggregator.py)做两阶段聚合:
- 第一阶段:在初始场景上按上面的流程打一次分(记录你的轨迹终点
endpoint_x/y); - 第二阶段:对每个初始场景,评测集里额外准备了一组预滚动的 follow-up 场景(每条对应一种不同的 4 秒规划结果:偏左/偏右/快慢不一)。你的模型在这些 follow-up 场景上各打一次分;
- 加权:用高斯核衡量"第一阶段终点"和"第二阶段起点"的距离(
scene_aggregator.py:36):
即你的轨迹最终停在哪,离哪条 follow-up 起点越近,那条 follow-up 的权重越高——近似模拟"偏离之后会怎样",却完全不用交互式仿真;
4. EC 注入:SceneAggregator 还比较相邻两帧的仿真状态重叠段(_compute_two_frame_comfort),把 two_frame_extended_comfort 填进加权指标(run_pdm_score.py:compute_final_scores),最终:
- 误报惩罚过滤(human_penalty_filter):当人类驾驶员在该场景也违规时(如借对向车道绕障),把对应子分强制置 1(
pdm_score.py:171起),避免"按规矩开车反而被扣分"。
🔍 子指标详解(速查表)
| 子指标 | 全称 | 类型 | 取值 | 权重 | 衡量什么 |
|---|---|---|---|---|---|
| NC | No at-fault Collisions | 乘性 | {0, ½, 1} | — | 是否与障碍发生有责碰撞 |
| DAC | Drivable Area Compliance | 乘性 | {0, 1} | — | 是否始终在可驾驶区域内 |
| DDC ⭐v2 | Driving Direction Compliance | 乘性 | {0, ½, 1} | — | 是否逆行 |
| TLC ⭐v2 | Traffic Light Compliance | 乘性 | {0, 1} | — | 是否闯红灯 |
| EP | Ego Progress | 加权 | [0, 1] | 5 | 前进量(相对 batch 归一化) |
| TTC | Time-to-Collision | 加权 | {0, 1} | 5 | 是否保留足够碰撞时间余量 |
| LK ⭐v2 | Lane Keeping | 加权 | {0, 1} | 2 | 是否长时间偏离车道中心 |
| HC ⭐v2 | History Comfort | 加权 | {0, 1} | 2 | 含历史运动一致性的舒适度 |
| EC ⭐v2 | Extended Comfort | 加权 | {0, 1} | 2 | 相邻帧输出的动态一致性 |
⭐ = v2(EPDMS)新增;v1 加权项为 {EP, TTC, C}。
几个要点深入解读:
- NC 的"无责"很关键:NAVSIM 区分"责任"。如果碰撞是背景车突然冲出来造成的(自车无法避免),不算自车的错。实现上靠
get_collision_type区分ACTIVE_FRONT_COLLISION(正面追尾,有责)/ACTIVE_LATERAL_COLLISION(侧向,需结合是否在多车道判定)/STOPPED_TRACK_COLLISION等(pdm_scorer_utils.py)。撞动态车扣到 0,撞静态物只扣到 0.5。 - EP 是反"躺平"的利器:它正比于自车沿参考线的前进距离。原地不动 EP→0,直接压低加权平均分。这也是 NAVSIM 区别于 L2 的核心。
- TTC 是前瞻安全:
future_collision_horizon_window = 1.0s,把自车包围盒按当前速度外推 1 秒,再与未来背景车做碰撞检查,鼓励"留余地"的规划。 - LK 是连续犯规才算:
lane_keeping_horizon_window = 2.0s、偏差限0.5m,必须连续超限才失败,路口豁免——避免把正常变道误判。 - EC 专治"抖动":比较相邻两帧模型的输出,若加速度、jerk 等动态量在重叠时间段不一致就扣分。
📂 navtrain / navtest / navhard 数据划分
NAVSIM 的评测公平性,很大程度上来自它精心设计的 split(数据划分)。这些 split 都是对 OpenScene(nuPlan 2Hz)做场景过滤得到的。官方 docs/splits.md 和 config/common/train_test_split/*.yaml 给出了完整定义:
| Split | 来源 | 用途 | 帧数(tokens) | 特点 |
|---|---|---|---|---|
| navtrain | trainval | 训练 | 104,480 | 过滤掉无聊场景,只保留有挑战性的非平凡驾驶;传感器 445GB(带历史,无历史 300GB) |
| navtest | test | NAVSIM v1 标准测试 | 12,282 | 过滤为有挑战场景,是 v1 排行榜(PDMS)的评测集 |
| navhard_two_stage | test + 合成帧 | NAVSIM v2 标准测试 | 5,988 原始 + 合成 | 含合成观测的伪闭环两阶段评测,对应 EPDMS 排行榜 |
| warmup / private_test | — | 挑战赛 | 227 / 1,872 | 热身赛与私有测试集,禁止用于训练 |
这些数字直接来自 scene_filter/navtrain.yaml(tokens: 列表 104,480 条)、navtest.yaml(12,282 条)等配置。
为什么要"过滤"?
nuPlan 原始日志里,绝大多数场景是直道匀速、无交互的"无聊"片段。如果直接拿来评测,模型只要输出"恒速直行"就能拿高分。NAVSIM 的 scene filter 专门挑选那些**“恒速恒向"会失败**的场景——比如路口转弯、变道、减速避让、应对行人。这样刷出来的分数才有区分度。
每个 split 的过滤配置(源码级)
以 navtest.yaml / navtrain.yaml 为例(train_test_split/scene_filter/):
num_history_frames: 4   # 取 4 帧历史(2 秒 @2Hz)
num_future_frames: 10   # 取 10 帧未来(5 秒 @2Hz)
frame_interval: 1       # 滑窗步长,每 1 帧滑一次(所以场景高度重叠)
has_route: true         # 只保留有有效路由的场景
navtrain与navtest完全独立、无重叠:一个基于 trainval、一个基于 test 数据 split,navtest 禁止用于训练。navhard_two_stage不同:它num_future_frames: 8(4 秒),且include_synthetic_scenes: true、带reactive_synthetic_initial_tokens——即在原始场景基础上掺入合成观测做两阶段伪闭环。
navtrain vs navtest 的本质区别
- navtrain 是给模型学习用的,场景丰富但分布相对平缓;
- navtest 是只评不训的盲测集,分布更偏安全关键与长尾。
- 两者都来自过滤,但完全独立、无重叠,navtest 禁止用于训练,否则成绩无效。
一句话:navtrain 教模型"怎么开”,navtest 考模型"关键时刻开不开得对"。
值得一提的是三者之间的演进逻辑:navtest 是 v1 时代的"一锤定音";navhard 则是 v2 为治理"开环刷榜"而引入的升级版——它不仅包含真实帧,还掺入合成观测,并要求两阶段伪闭环评测,专门用来暴露纯开环看不到的规划脆弱性。所以当你看到论文报分时,一定要分清是 PDMS(navtest,v1) 还是 EPDMS(navhard,v2),后者通常比前者低 3–10 分,含金量更高。
🗃️ NAVSIM 数据到底长什么样?从源码看一个 scene
上面说了切分,但真正的难点在于一个"样本"(scene)具体包含哪些数据、模型训练时又能看到什么。这一节全部依据 NAVSIM 官方源码 navsim/common/dataclasses.py、navsim/common/dataloader.py 逐行还原。
数据的三层组织:log → frame → scene
数据不是整卷倒给模型的,而是按三层组织:
关键点:
- log 是下载/切分的最小单位:
train_logs、val_logs、test_logs都按整段 log 分,不按帧切。这样同一段行车记录不会泄漏到训练和验证两边。表:trainval 日志 14GB / 传感器 >2000GB;test 日志 1GB / 传感器 217GB;navtrain 传感器 445GB。 - scene 是训练/评测的最小单位:训练 batch 里装的是一个个 scene。一个 scene 由
SceneMetadata(log 名、scene token、地图名、初始帧 token、历史/未来帧数)+map_api(地图)+ 一列Frame组成。 - scene 由滑窗采样生成:
filter_scenes()(dataloader.py:16)里的split_list(input_list, num_frames, frame_interval)会从 log 里每frame_interval帧取一个长度为num_frames的窗口。默认frame_interval=1、num_frames = 4 + 10 = 14(4 历史 + 10 未来),所以重叠的帧可以出现在多个 scene,这正是 navtrain 104,480 个 scene 远高于 log 数(13,180)的原因。
帧类型:Original vs Synthetic(token 的秘密)
navsim/common/enums.py 定义了帧类型:
class SceneFrameType(IntEnum):
    ORIGINAL = 0   # 来自 nuPlan/OpenScene 真实日志
    SYNTHETIC = 1  # v2 生成的合成观测帧
如何区分?metric_cache_processor.py:317 有一行很妙的 trick:
is_synthetic_scene = len(scenario.token) == 17
真实帧的 token 是 16 位十六进制,合成帧的 token 是 17 位(多一位前缀用于标识)。合成帧来自 v2 的"预滚动"流程:把某条 4 秒规划用仿真器 rollout 到 t=4s,以该时刻为起点生成新的传感器观测(Scene.save_to_disk / load_from_disk 实现了这套落盘/加载)。所以合成帧天然携带 corresponding_original_scene 与 corresponding_original_initial_token 两个元数据字段(SceneMetadata),用于第二阶段回链到原始场景。
一个 frame 里的内容块
每个 Frame(dataclasses.py:318)包含五类字段,可用 Scene.from_scene_dict_list() 从 log 装载:
| 内容块 | 类型 | 作用(是观测还是特权) |
|---|---|---|
token / timestamp | 基础 | 唯一标识(即该帧 LiDAR 点数的 token) |
roadblock_ids | List[str] | 该帧自车所在车道,后续导出路由(特权) |
traffic_lights | List[(lane_connector, bool)] | 路口信号灯状态,True=红(特权) |
annotations | Annotations | 包围框真值标定(特权) |
ego_status / lidar / cameras | 观测 | 模型可见输入 |
标定信息(Annotations)——“人类专家标注了什么”
Annotations 类(dataclasses.py:260)在一个场景里携带五段等长数组,逐对象对齐:
boxes:3D 包围框,姿态用BoundingBoxIndex索引:(x, y, z, len, width, height, heading)。names:类别标签List[str],包含 vehicle、pedestrian、bicycle、traffic_cone、barrier、czone、general 等。velocity_3d:3D 速度向量。instance_tokens/track_tokens:跨帧计数与追踪的恒定 ID,供时序关联。
评测/训练用这些真值框前后对齐成跟踪轨迹。但注意 NAVSIM v1/v2 评测不直接要求模型做感知:打分时碰撞、车道内等用这些真值框离线算,模型自己只需输出未来的自车几何轨迹。
观测数据(AgentInput)——模型真正拿到的东西
Scene.get_agent_input() 从 scene 里抽出模型可见的观测,组成一个 AgentInput,不包含任何特权信息:
- EgoStatus(当前帧 + 历史帧):自车
ego_pose(3 维)、ego_velocity与ego_acceleration(各 2 维),都转到局部坐标系。 - Cameras × 8:
cam_f0 / cam_l0 / cam_l1 / cam_l2 / cam_r0 / cam_r1 / cam_r2 / cam_b0,每个含 image +sensor2lidar外参 + 内参 + 畸变。 - LiDAR 合并点云:5 个 LiDAR 融合为一次
(6, n)数组+x,y,z,intensity,ring,lidar_id,频率对标 2Hz。 - driving_command 离散意图:左变道 / 直行 / 右变道(由期望路由推出,
EgoStatus装载),另有第 4 档"未知"用于训练时过滤歧义样本。
NAVSIM 的观测设计很克制:相机+LiDAR 只覆盖 2 秒过去 / 2Hz(每帧 4 帧历史观测);并刻意用一张图说明了:排列在图里的这些只有测试帧才释放——地图、tracks、occupancy 等你在训练可以用,但排行榜提交时拿不到,防止做题式作弊。
训练标签:人类专家 GT 轨迹
训练时由 TrajectoryTargetBuilder 通过 Scene.get_future_trajectory() 取出人类驾驶员真车未来轨迹作为回归目标:把未来 5s(10 帧)自车 GEOM 姿态转换到当前后轴为原点的局部坐标。这正是 EgoStatusMLP、TransFuser 等 baseline 做行为克隆(behavior cloning)时监督的标签——“人类专家开成了什么样”。
🏭 MetricCache:评测的工程基石
评测时我们不可能每帧都重新解析日志、抽中心线、算可驾驶区域——那会慢一个数量级。NAVSIM 的做法是离线预计算 MetricCache(metric_caching/metric_cache_processor.py),每个场景 token 一个 lzma 压缩的 pkl 文件,评测时直接读入(.pkl 是什么、目录怎么组织,见下下小节「.pkl 是什么?」)。
缓存里有什么?
compute_metric_cache()(metric_cache_processor.py:313)返回的 MetricCache 字段:
| 字段 | 内容 |
|---|---|
trajectory | PDM-Closed 参考轨迹(用 PDMClosedPlanner 在离线仿真实时生成) |
human_trajectory | 人类专家 GT 轨迹(合成帧为 None) |
past_human_trajectory | 人类历史轨迹(用于 HC 舒适度) |
observation | PDMObservation:插值到 10Hz 的未来检测轨迹 + 信号灯(TTC 需要 1s 额外前瞻) |
centerline | 参考中线(PDMPath,来自 Dijkstra 搜索的路由) |
route_lane_ids / drivable_area_map | 路由车道 + 可驾驶区域多边形 |
past/current/future_tracked_objects | 过去(2Hz)/当前/未来(10Hz)目标轨迹 |
ego_state / map_parameters | 初始自车状态 + 地图参数 |
scene_type / timepoint | Original/Synthetic 与起始时刻 |
🔑 关键性质:缓存里没有一条字段依赖任何特定模型。 全部是"场景本身长什么样 + 参考轨迹 + 真值"——这决定了它天然可以被所有模型共享。至于"模型自己的输入(相机图/LiDAR)该从哪来、要不要缓存",是另一条完全独立的线(AgentInput),详见下节「MetricCache 到底建几份?」。
注意缓存里的 observation 目标轨迹是从 2Hz 真值插值到 10Hz 的(_interpolate_gt_observation,metric_cache_processor.py:99),因为打分的仿真步长是 0.1s——背景车也要有逐 0.1s 的状态才能做碰撞检测。
预计算为何重要?
评测时我们要对整个 navtest(12k 帧) 或 navhard(真实+合成) 逐帧算 PDMS。地图解析、中心线抽取、可驾驶区域这些与模型无关的昂贵计算,多跑一次只会浪费算力。NAVSIM 改成一次 cache、多次评测复用,这是它评测高效、可大规模并行的工程基石。
.pkl 是什么?MetricCache 就是每个场景 token 一个 pkl 文件吗?
是的,正是如此——MetricCache 本质上就是"每个场景 token 一个 .pkl 文件"。 下面把它讲透。
① 什么是 .pkl?
.pkl 是 Python pickle 序列化的标准文件后缀(全称 “pickle file”)。pickle 是 Python 把内存里的对象(字典、列表、类实例……)变成字节流保存到磁盘的机制,要用时再反序列化还原成对象。
- 能存什么:几乎任意 Python 对象——NAVSIM 的
MetricCache就是个@dataclass类,里面嵌套了PDMPath、PDMObservation、Polygon等自定义对象,pickle 可以原样整套序列化; - 为什么用 pkl 不用 JSON:JSON 只能存基础类型(字典/列表/字符串/数字),遇到
Polygon、PDMPath这种带方法和类型信息的对象就得手写序列化逻辑;pickle 直接"整体封存",反序列化后拿到的是类型完整的原始对象,评测代码读出来就能直接用; - 为什么"每条样本一个文件":pickle 按对象序列化,天然适合"一个对象存一个文件"的布局——评测按 token 随机取样本时,只读需要的那一个文件,不用像一个大 JSON 那样全量加载。
② MetricCache 在磁盘上长什么样?
- 目录结构按
log → token → metric_cache.pkl三级组织((log_name)是 log 名、(token)是场景 token,写代码时替换为实际值即可); - 每个
token一个目录,目录里是metric_cache.pkl(默认文件名见dataloader.py的MetricCacheLoader(cache_path, file_name="metric_cache.pkl")); - token 就是场景的唯一 ID(一条帧级样本)。有多少个评测 token,就有多少个 pkl 文件——navtest 约 12k 个、navhard 还要再加上合成帧;
- 上面提到 lzma,是指存的时候用 LZMA 压缩(
lzma.open+pickle.load)。因为目标轨迹、可驾驶区域多边形这些数据量不小,压缩后能省一大半磁盘,读的时候自动解压,速度影响很小。
③ 评测时怎么"读"它?
MetricCacheLoader(dataloader.py)在初始化时先扫描 metadata/ 里的索引,建立 {token: pkl路径} 的字典;评测循环里对每个 token 调用:
metric_cache = metric_cache_loader.get_from_token(token) # 按 token 找到对应 pkl → lzma 解压 → pickle 还原
注意这个函数只按 token 查文件——不涉及任何模型。所以前面说的"所有模型共享同一份 MetricCache"在落盘层面就是:同一个 token 只存在一个 metric_cache.pkl,谁评测谁读它。
💡 一句话总结:pkl 是 Python 的"对象封存"格式;MetricCache = 每个场景 token 一个 lzma 压缩的 pkl 文件;评测按 token 索引读取,与模型无关。
❓ 高频疑问:MetricCache 到底建几份?雨雪雾呢?
这是几乎所有第一次用 NAVSIM 的人都会绕进去的问题。直觉是对的:MetricCache 本质上建一份就够,所有模型应该共享。 但你会觉得"每个模型都要建自己的 cache",是因为把两件完全不同的事混在了一起。下面彻底讲清楚。
先分清两个完全不同的东西:MetricCache ≠ 模型的输入
NAVSIM 里有两套并行的数据通路,一套与模型无关、全模型共享,另一套与模型强相关、每个模型各自定制。它们唯一的共同点是"都从同一个 scene 派生"。
| MetricCache(打分缓存) | AgentInput(模型输入) | |
|---|---|---|
| 服务于 | 打分器(PDMS 怎么算) | 模型(怎么出轨迹) |
| 内容 | 参考轨迹、人类 GT、中心线、可驾驶区域、路由、未来目标、初始自车状态、地图参数 | 历史 ego 状态 + 相机图像 + LiDAR 点云(+ driving_command) |
| 生成方式 | 离线预计算,每个 scene 一份 | 评测时实时从原始传感器按需加载 |
| 依赖模型吗 | ❌ 完全不依赖 | ✅ 依赖:模型声明用哪些传感器(SensorConfig) |
| 谁复用 | 所有模型共用同一份 | 每个模型用自己的配置加载 |
| 在代码里的入口 | MetricCacheLoader.get_from_token() | SceneLoader.get_agent_input_from_token() |
看官方评测入口 run_pdm_score.py 的实际循环(这是最硬的证据):
metric_cache = metric_cache_loader.get_from_token(token)      # ① 共享缓存:同一份给所有模型
agent_input  = scene_loader.get_agent_input_from_token(token) # ② 专属输入:每个模型按需加载
trajectory   = agent.compute_trajectory(agent_input)          # ③ 模型只用 AgentInput 推理
score = pdm_score(metric_cache=metric_cache, model_trajectory=trajectory, ...)
注意第 ③ 行:模型推理时只碰 agent_input,根本不读 cache。 而打分时用的是 cache 里的地图/真值/参考轨迹。也就是说——你的模型从头到尾看不到 cache 里有什么,cache 也完全不关心你的模型长什么样。
💡 一句话记忆:MetricCache 是"考卷的标准答案和阅卷标准",AgentInput 是"发给考生的考题材料"。 全年级考生共用同一份标准答案;但每个考生拿到什么考题材料(只给单目前视?还是八路环视+激光雷达?),取决于他"报考"时声明要哪些传感器。
那"每个模型建自己的 cache"的错觉是从哪来的?
你的观察不是空穴来风,工程上确实常常看到"每个模型各跑一遍 cache"。原因有四个,但没有一个是"cache 必须按模型建":
每个模型要准备自己的 AgentInput,容易被误记成"建 cache"。真正的模型专属工作量在于:从原始传感器数据里提取并预处理该模型需要的输入(裁哪几个摄像头、LiDAR 要不要 BEV、分辨率、历史帧数、归一化、token 化……)。这是模型的数据加载器干的活,不是 MetricCache。
AgentInput.from_scene_dict_list()(dataclasses.py:157)就是干这个的,它按模型的SensorConfig从 sensor 目录里挑传感器。训练侧的"cache"确实要按模型重新算。注意区分两层:评测用的 MetricCache 共享;但训练侧有两类 cache 都跟模型有关——一是DataCache(training_cache):每个模型注册自己的 feature/target builders,把
agent_input变成输入张量、把 scene 变成监督标签并缓存(见下节「data cache」),这部分确实按模型各建一份;二是很多模型训练时把 PDM-Closed 参考轨迹、可驾驶区域、未来 GT 目标当监督标签(比如 Scoring 类方法),是否用、怎么用取决于模型自己——如果你要离线打分给候选轨迹当训练标签,那确实得自己再算一份(参见 排行榜深度分析 里 Hydra-MDP 的"30 小时预计算 PDM 分数")。这些是"训练标签/输入张量的 cache",不是"评测的 MetricCache",别混为一谈。合成帧(navhard)的 cache 需要单独补。navhard 掺了 3DGS 合成帧,合成帧没有人类 GT(
compute_metric_cache里human_trajectory = None),且需要额外预滚动。但这也是按场景建的,不是按模型建的——同一份合成帧 cache,所有模型照常共享。工程上"懒得复用"。很多人为了省事,直接给每个新模型重跑一遍完整 cache 流程(反正 scene 过滤配置一样就能算)。这不是必需,只是偷懒——代价是白白多算几千上万条场景的地图解析和 PDM-Closed,纯浪费算力。
✅ 结论:只要评测集相同、评测配置(scene filter、proposal sampling、LQR 参数)相同,一份 MetricCache 就够所有模型复用。 官方设计初衷就是"一次缓存、多模型复用"。你真正要为每个模型单独准备的,是 AgentInput 那条线。
雨雪雾数据集:建一份雨的 cache,雪和雾还要建吗?
分两种情况,答案完全不同——关键看"雨雪雾"是改了什么:
情况一:同一个 scene,只换天气渲染(外观不变)——一份就够,而且不需要另建。
假设你对同一个 navtest 场景,用渲染管线把相机图换成雨天版。此时:
- MetricCache 完全不变。因为 cache 里存的是几何/语义信息:参考轨迹、中心线、可驾驶区域、未来目标框(坐标+速度+类别)、路由、初始自车状态。这些内容在雨天、雪天、雾天都是一样的——车还是那辆车、路还是那条路、目标还是那个目标,变的只是"相机拍到的那张图"。
- 模型输入才变。雨天相机图像变模糊、有雨滴;雪天白茫茫、对比度低;雾天能见度低。这些是 AgentInput 里的 cameras,属于模型感知要处理的。
所以如果雨/雪/雾只是同一批 scene 的不同视觉渲染,那么建一份 cache,三个天气的评测全都能用——评测循环里 metric_cache_loader.get_from_token(token) 完全不变,你只需要在 agent_input 那一步加载不同天气下的相机图。cache 不感知天气,因为天气只影响图像像素,不影响几何真值。
情况二:雨雪雾是不同场景(不同日志/不同路径)——每个场景都要 cache,但这是"场景维度",不是"天气维度"。
如果雨天的 1000 个场景和雾天的 1000 个场景是不同的行车日志(不同地点、不同车流、不同路段),那它们本来就是不同的 scene,自然各有一份 cache。但注意:这不是因为"雨天"需要单独的 cache,而是因为"不同场景"需要各自的 cache——哪怕都是晴天,两个不同场景也得各自建一份。天气在这里只是"这些场景碰巧在雨天拍的",cache 照旧按 scene 一份一份建。
💡 判断准则:MetricCache 只跟"场景内容"绑定,跟"场景长什么样(外观)“无关。 换个天气、换个光照、换个渲染风格,只要几何真值和地图没变,cache 就复用;换个地点、换段车流、换个交叉口,那就是新场景,就得新 cache。而"每个模型"这个维度,从头到尾都不影响 cache。
那 MetricCache 里的东西到底是谁"提供"的?
拆开看,cache 里的字段来自四个不同的提供方——不是单纯"数据集给的”:
| MetricCache 字段 | 提供方 | 说明 |
|---|---|---|
past_human_trajectory / human_trajectory | 数据集(OpenScene 日志) | 人类司机真实轨迹,日志标注里就有 |
past/current/future_tracked_objects | 数据集 | 检测目标轨迹,来自日志真值(含类别/尺寸) |
ego_state / map_parameters | 数据集 | 自车起始状态(位置/朝向/速度)+ 场景地图元数据 |
centerline / route_lane_ids / drivable_area_map | 地图 + PDM 规划器 | 从 nuPlan 地图 API 拉取路网,Dijkstra 搜出路由、抽取中心线、切出可驾驶区 |
trajectory(PDM-Closed 参考轨迹) | NAVSIM 自带的 PDM 规划器 | PDMClosedPlanner 在离线仿真里算出的"满分答案" |
observation(插值到 10Hz 的目标+信号灯) | 数据集 + scorer 版本 | 目标轨迹来自真值,插值方式由 scorer 的仿真分辨率决定 |
所以更准确的说法是:MetricCache = 数据集(场景/真值)× 地图 × NAVSIM/PDM scorer 版本 × 评测配置 四者的共同产物,而不是"数据集直接提供的"。
那"按数据集提取 MetricCache"具体指什么?
指对每一个 scene(一个 token)跑一遍 compute_metric_cache(scenario)(metric_cache_processor.py:313):
# 输入是一个 NavSimScenario = OpenScene 数据(自车/目标/标注) + nuPlan 地图(MapAPI)
metric_cache = metric_cache_processor.compute_metric_cache(scenario)
# 按 token 存成 metric_cache_path 下 (log)/(token)/metric_cache.pkl 三个层级
metric_cache_loader.dump_all_caches()
数据流是:原始日志 → scene(pickle)→ 场景 + 地图喂给 compute_metric_cache → 逐字段算出 → 按 token 落盘一份。评测时所有模型从同一份落盘文件 get_from_token(token) 读。所以"提取"的对象是"场景",不是"模型"——你为 11 个模型服务时,这段代码也只该跑一遍。
那"data cache"又是什么?和 MetricCache 什么关系?
这是刚才那句"别混为一谈"的关键另一半。NAVSIM 里确实存在第二种 cache,官方叫 training_cache(见 default_training.yaml 里的 cache_path: ${NAVSIM_EXP_ROOT}/training_cache),你同事说的 “data cache” 基本就是这个。它和 MetricCache 是两种完全不同的东西:
| MetricCache(打分缓存) | DataCache / training_cache(训练数据缓存) | |
|---|---|---|
| 官方配置项 | metric_cache_path | cache_path(training_cache) |
| 缓存什么 | PDM scorer 要用的场景指标(参考轨迹/中心线/可驾驶区/真值) | 模型的输入张量 + 监督标签(feature/target builders 的输出) |
| 谁生成 | MetricCacheProcessor(与模型无关) | Dataset.cache_dataset()(按模型注册的 builders) |
| 落盘形式 | 每个 scene 一个 metric_cache.pkl | 每个 scene 下 token/(builder_unique_name).gz |
| 依赖模型吗 | ❌ 不依赖,全模型共享 | ✅ 依赖:不同模型注册不同的 feature/target builders |
| 用途 | 评测打分(PDMS) | 训练时避免反复从原始传感器重算输入 |
看训练数据集源码 dataset.py 的缓存逻辑就一目了然——_cache_scene_with_token 对每个 builder 单独存一份:
scene      = scene_loader.get_scene_from_token(token)   # 从原始数据读场景
agent_input = scene.get_agent_input()                   # 读传感器 → AgentInput
# feature_builders:把 agent_input 变成模型输入张量
builder.compute_features(agent_input)  → 存成 token/(name).gz
# target_builders:把 scene 变成监督标签张量
builder.compute_targets(scene)         → 存成 token/(name).gz
注意上面 builder.get_unique_name() 生成的唯一名——这个唯一名里带着模型特征。所以:
- DataCache 才是"按模型不同"的那个 cache:你的模型要 8 个摄像头、另一个模型只要前视,它们的 feature builder 不同 →
unique_name不同 → 各存各的.gz,不能混用。这就是"每个模型都建 cache"这个说法在训练侧是真的的原因。 - MetricCache 是"按场景不同"的那个 cache:跟模型零关系,评测侧全模型共享。
一句话总结两种 cache 的分工:MetricCache 管"怎么打分"(评测共享);DataCache 管"怎么喂模型"(训练按模型各自建)。 前者缓存场景指标,后者缓存输入张量和标签。你之前看到"每张图像都建 cache",说的其实是 DataCache 这条线;而 MetricCache 从算法上讲就该是大家共用一份的。
一个真实例子:同事的雨天数据为什么得重建 cache?
把上面所有规则套到一个具体场景,能帮你彻底固化理解。假设同事用渲染管线做了雨天版本,你问"雨天能复用官方 NAVTEST 的 metric cache 吗?"——答案取决于雨天数据动了哪些东西:
如果能复用:如果只是把同一批场景的相机图像换成雨天渲染,而 scene token、scene pickle(自车/目标/地图真值)、以及动态目标信息全都不变——那么完全可以复用官方 NAVTEST 的 metric cache。因为天气只影响 agent_input.cameras 的像素,MetricCache 里没有一个字段被它碰到。
必须重建的情况:你同事给的雨天数据实际上引入了这些变化——
- 新的日志目录、新的 scene pickle 目录;
- 新的 token(带
_rain_multi后缀,token 本身变了); - 场景集合变了:12370 个场景 ≠ 官方 12146 个;
- 还需要做 token 映射 + lidar 字段兼容处理。
token 一变,MetricCacheLoader 的索引就找不到了(它按 {token: path} 建立索引,dataloader.py:316)。而这些新场景本质上是一批"新场景"——哪怕内容长得和官方场景几乎一样,只要 token/scene pickle/场景集合变了,就得为它们重建对应场景的 metric cache。将来做雪天、雾天同理:
- 只做"原 token 对应的图像替换" → 复用官方 cache;
- token、scene pickle 或场景集合变了 → 必须重建。
但注意这跟模型数量无关——不管 11 个模型还是 1 个模型,只要大家用同一批场景、同一个 NAVSIM v1 scorer,就该共享同一份(雨天)metric cache。模型真正不同的,只是 checkpoint 推理和 trajectory 输出。
那每个模型的输入到底从哪"提取"?
这正是 SceneLoader + AgentInput 干的活。模型不直接从 cache 里拿输入,而是从原始日志的传感器数据里提取:
提取的关键是 SensorConfig(dataclasses.py:782)——每个模型自己声明:cam_f0=True(只要前视)、cam_l0=[0,1](要左前且要历史两帧)、lidar_pc=True(要激光雷达)……SceneLoader 就按这份声明去 sensor 目录里读对应的 blob,拼成 AgentInput。所以:
- 换模型 = 换 SensorConfig + 换预处理(图像 resize、LiDAR 转 BEV、token 化),这是模型自己的数据加载器逻辑;
- 不换 scene = cache 不变(共享那份);不换场景内容 = 天气变了 cache 也不变。
一句话收束本节:MetricCache 建一份给所有人用;AgentInput 每个模型按自己的 SensorConfig 从原始传感器里现取。 把这两条线分开,你看到的所有"每个模型都要……“的困惑就都解开了。
🆚 为什么 NAVSIM 比 nuScenes 的 L2 更好?
这要从 L2 误差的根本问题说起。
| 对比维度 | nuScenes L2 误差 | NAVSIM PDMS |
|---|---|---|
| 衡量对象 | 与人类 GT 的位移差 | 轨迹本身的安全/舒适/进展 |
| 多模态 | ❌ 把合理替代方案判为错 | ✅ 只要合理就给分 |
| “躺平"问题 | ❌ 原地不动 L2 最低,最"优” | ✅ EP 惩罚,不动拿低分 |
| 分布偏移 | 严重:自车轨迹几乎总在 GT 流形上 | 缓解:不要求贴合 GT |
| 与闭环相关性 | 几乎无相关 | 有正相关 |
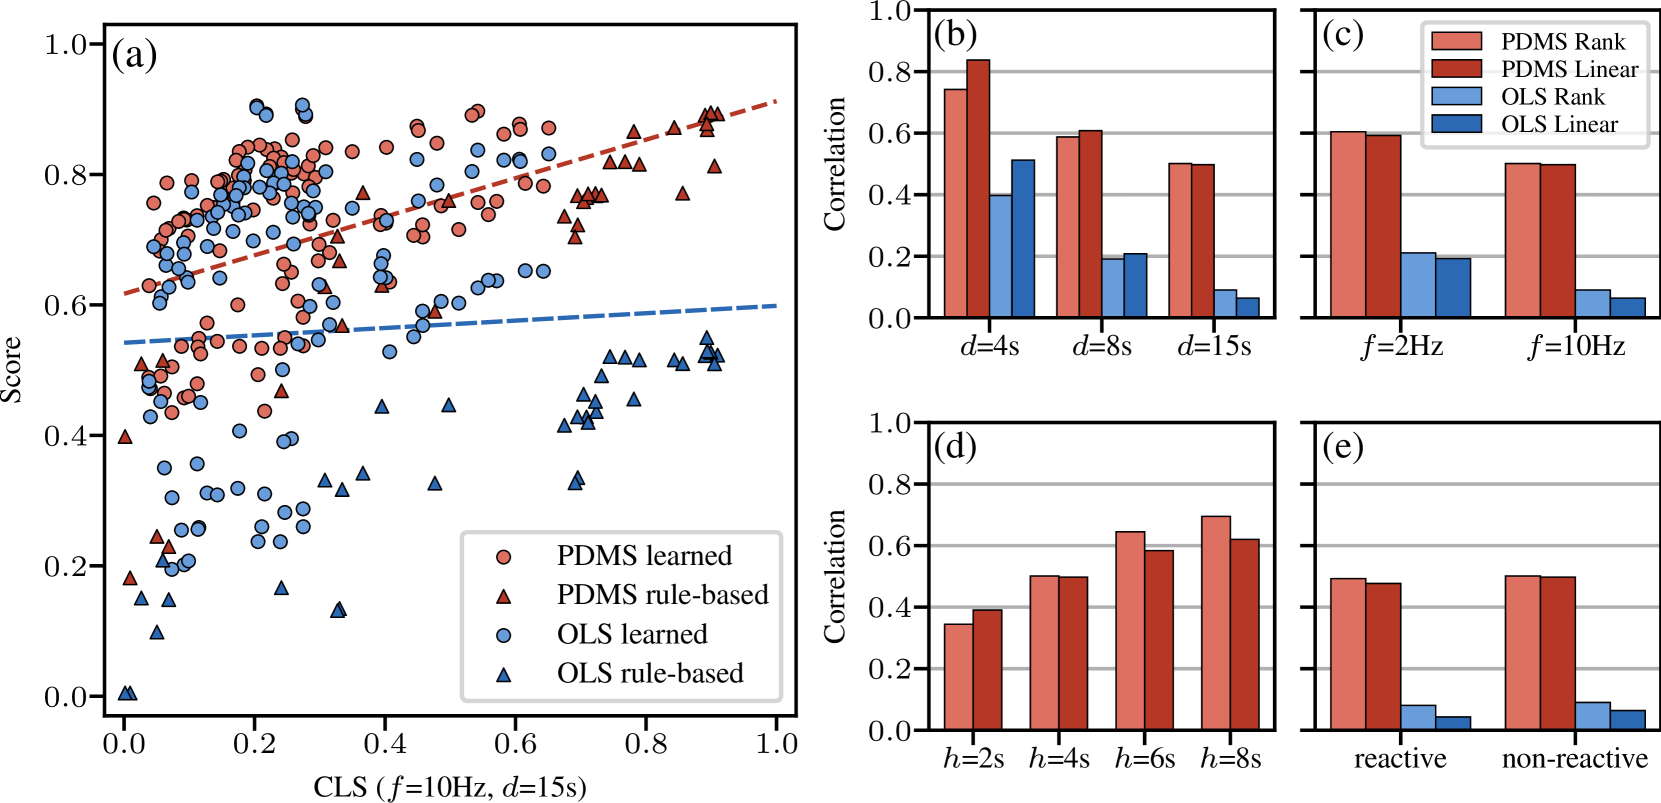
NAVSIM 论文里一个核心实验(见上图):他们把多个规划器放进真正的闭环仿真,发现传统 L2/OLS 指标和闭环分数几乎零相关——一个 nuScenes 上 L2 最低的模型,闭环里可能是个马路杀手;而 PDMS 与闭环分数呈现明显的正相关。这正是 NAVSIM 迅速取代 nuScenes、成为端到端规划标配的原因:它在开环代价下,给出了一个真正"预言"驾驶能力的信号。
💡 一句话:nuScenes 的 L2 衡量"像不像人开”,NAVSIM 的 PDMS 衡量"开得好不好"——后者才是我们真正关心的。
🏆 当前 NAVSIM 排行榜 Top(2025–2026)
下面是 NAVSIM 上有代表性的 SOTA 工作(分数为公开报告值,含 v1 的 PDMS 与 v2 的 EPDMS)。注意榜单迭代极快,半年就有新王者。
| 排名 | 模型 | PDMS(v1) ↑ | EPDMS(v2) ↑ | 关键技术 |
|---|---|---|---|---|
| 1 | CLOVER | 94.5 | 90.4 | 候选生成+打分器闭环自蒸馏 |
| 2 | CLEAR | 93.7 | — | VAE 单步漂移 + Drive-JEPA + 小 LLM |
| 3 | DriveVLA-W0 | 93.0 | 86.1 | 世界模型预训练 + AR 动作头(单目) |
| 4 | LWDrive | 92.0 | 89.6 | 世界模型引导的层级化规划 |
| 5 | ASSCG | 91.4 | — | 快慢系统自适应 Query 门控 |
| 6 | D³-MoE | 91.3* | 87.5* | 解耦扩散 MoE + 风格控制 |
| 7 | HiST-VLA | — | 88.6 | 层次化时空 VLA |
| 8 | WoTE | 88.3 | — | 面向思考的端到端 |
| 9 | DiffusionDrive | 88.1 | 84.5 | 扩散头多模态轨迹生成 |
| 10 | S-squared-VLA | 87.1 | — | 语义/空间解耦 VLA |
| — | OneDrive | 86.8 | — | 统一多范式 VLA |
| — | UniAD | 83.4 | — | 经典基线(2023) |
| 参考 | 人类驾驶 | ~94.8 | — | 性能天花板 |
* D³-MoE 为 Best-of-Three 集成分数。
几点趋势观察:
- 天花板逼近人类:头部工作(CLOVER 94.5)已非常接近人类参考分(~94.8),navtest 上的 PDMS 几乎快要刷满。
- 战场转移到 v2/navhard:因为 v1 接近饱和,2025 年起竞争焦点转向 EPDMS 和伪闭环 navhard(更难、含分布外场景),顶尖模型的 EPDMS 仍在 90 上下挣扎。
- 方法论收敛:榜单前列几乎全是 “生成式多模态候选 + 打分挑选” + 大模型/世界模型" 的组合,纯确定性回归已被淘汰。
- 安全类子分饱和:NC、TTC、Comfort 在 SOTA 模型上普遍接近满分,真正拉开差距的是 EP(前进量)——敢不敢开得快、开得远。
⚠️ NAVSIM 的局限性
NAVSIM 再好用,也不是闭环。认清它的边界,才能正确解读分数。
| 局限 | 说明 | 后果 |
|---|---|---|
| 非反应式(自车层面) | 只评测单次 4 秒前向仿真,不递归 | 看不到"小偏差滚雪球成大事故"的复合误差 |
| 背景车可反应、但不交互学习 | v2 背景车是 IDM 反应式 | 仍无法覆盖"自车与背景互相博弈"的完整闭环 |
| 无误差恢复 | 只仿真 4 秒,不递归 | 复合误差根本触发不了 |
| 分布偏移 | 评测仍在数据集分布内 | OOD(真正长尾)场景的失败完全暴露不出来 |
| 传感器固定 | 无天气/光照/对抗扰动 | 感知鲁棒性测不到 |
| 开环打分本质 | 仍是非交互式 | “刷榜技巧”(针对指标过拟合)依然可能 |
最典型的反例:一个在 NAVSIM 上拿 90+ 分的模型,闭环里可能因为第一次轻微偏离车道后,场景就跑出训练分布而彻底崩溃——这就是所谓的 compounding error(误差累积) 雪球效应。NAVSIM 的非反应式设计根本触发不了这种失败模式。
⚠️ 记牢:NAVSIM 高分是"能规划"的必要条件,远非"能开车"的充分条件。
🔗 与 Bench2Drive 等闭环评测的互补关系
正因为 NAVSIM 有上述局限,社区形成了"开环 + 闭环“双轨评测的共识,而 Bench2Drive 正是闭环侧的代表。
| 维度 | NAVSIM(开环/半开环) | Bench2Drive(闭环) |
|---|---|---|
| 底层 | OpenScene / nuPlan 真实日志 | CARLA 仿真器 |
| 交互 | 自车非反应式,背景车 v2 起可 IDM 反应 | 完全反应式,交通流实时响应 |
| 指标 | PDMS / EPDMS | Driving Score(完成率×合规) |
| 成本 | 低,提交预测即可 | 高,需模型在线推理 rollout |
| 覆盖 | 真实数据分布 | 44 条预定义路线、9 类能力的场景库 |
| 强项 | 真实感、大规模、快速迭代 | 真能跑通、能暴露累积误差与交互失败 |
两者的互补关系可以这样理解:
- NAVSIM 负责"快速筛选”:成本低、迭代快,适合算法研发的日常打磨。一个新想法先在 NAVSIM 上验证有没有前途。
- Bench2Drive 负责"终极考核":只有在闭环里真正跑通 44 条路线、低碰撞高完成率,才算"能开车"。
有意思的是,2026 年的一项跨基准研究(arXiv:2605.00066)系统比较了两者,得出三个关键结论:
- PDMS 与闭环 Driving Score 强正相关但不单调——存在明显的排名反转;
- EP(前进量)是闭环成功最强的单项预测器,甚至比碰撞指标 NC 更能预言闭环表现;
- TTC 和 Comfort 在 SOTA 上已接近饱和,对区分模型贡献很小。
这恰好印证了"开环负责精度与质量、闭环负责行为与交互"的分工。
理想的评测组合拳
三者缺一不可:开环看精度 + 闭环看行为 + 实路看长尾。NAVSIM 不是终点,而是这条评测链上最关键、最高效的第一环。
✅ 小结
抓住这三点,你就抓住了 NAVSIM 的精髓:
- 本质 = 基于 nuPlan/OpenScene 的非反应式开环评测,用 4 秒前向仿真让轨迹"开出来"再做碰撞/合规检查,成本远低于闭环。
- 链路 = 模型输出
(8,3)局部坐标轨迹 → 转全局帧 → 插值到 0.1s → LQR 控制器(纵向+横向双子系统) 生成加减速/转向指令 → 自行车运动模型 逐 0.1s 积分 → 与背景交通流做碰撞/合规检查 → 乘性×加权合成 PDMS,v2 再经两阶段伪闭环聚合得到 EPDMS。 - 定位 = 当前端到端规划的事实标准,navtest 接近饱和、战场转向 v2 的 EPDMS 与 navhard;但它仍非闭环,必须与 Bench2Drive、实路测试互补。
一句话总结:NAVSIM 让"规划好不好"第一次变得可量化、可复现、可比拼——它是端到端驾驶走向科学的基石。
💡 这是「知识点拆解」系列的第 6 篇。结合前面讲过的端到端演进、DiffusionDrive、Flow Matching,你就能完整理解一篇端到端论文里"PDMS 88→92"到底意味着什么。下期我们继续拆解闭环评测与强化学习在规划里的落地。