过去一年,具身智能(Embodied AI)领域出现了一个明显的范式转向:只输出动作的 VLA 正在被"边想象世界、边规划动作"的 WAM(World-Action Model,世界行动模型)挑战。从 NVIDIA 在 2026 年 2 月提出 “WAM” 这个词并做出 DreamZero,到 9 月 Black Forest Labs 的 FLUX 3 Action 登顶 RoboLab-120、斯坦福系的 OpenWAM 把 46 个检查点全部开源,再到 RoboDojo 基准把 ECCV 2026 挑战赛的主题直接定为"安全世界模型"——这条赛道在十个月内从一篇论文变成了一整个生态。
本文是对这条赛道的一次全景式调研:谁在做(厂商与高校地图)、做了什么(六大架构流派)、打出了什么成绩(RoboDojo / RoboLab-120 等榜单逐条分析)、以及接下来会怎么走(七条趋势判断)。调研以 arXiv 原文、官方技术报告、官方排行榜为一手来源(微信公众号等二手转述不在采信范围内),文中所有数字都注明出处与评测口径。
本文是《前沿VLA模型全景速览》的姊妹篇。如果说 VLA 篇回答的是"端到端动作模型长什么样",这篇回答的就是"把世界模型和动作模型焊在一起之后,世界变成了什么样"。操作方向的模型在FLUX 3 Action 精读里有逐图深挖,本文负责把它们放进同一张地图。
30秒结论
- WAM = 世界模型 + 动作模型的联合分布:一个模型同时预测"接下来画面怎么变"(视频/世界流)和"我该怎么动"(动作流),用视频预测给策略注入物理先验。
- “WAM"一词是 NVIDIA 发明的(DreamZero,2026年2月),但技术谱系更早:UniPi 的"先想象再执行”、GR 系列、WorldVLA、Cosmos Policy、Motus 都是前身;学术圈也常叫 VAM(Video-Action Model)。
- 两篇加长详解值得精读(4.3/4.4):Cosmos Policy——latent frame injection 三模式 + 价值头 best-of-N,185条真机数据做到93.6%,证明"微调视频生成器就是SOTA策略";DreamDojo——44k小时人类视频 + 连续latent action 预训练的基础世界模型,蒸馏到10.8 FPS,把 WAM 的用途从涨点扩展到"策略评测与规划的模拟器"。
- 六大架构流派已经分化:两段式(想象→执行)、联合双向、因果可选视频、训练用推理弃、异步双频、动作即视觉token——效率与统一性的取舍是分野主线。
- 榜单现状(截至2026年10月):RoboDojo 仿真榜(官方 2026-08-26 版)前 15 名中 WAM 只占 4 席(X-WAM #10、GigaWorld-Policy-0 #13、LingBot-VLA #15、AHA-WAM #17、Fast-WAM #19),但新一波(PatchWAM 29.39、OpenWAM-α)已经杀到前列;RoboLab-120 上 WAM 则全线上位(FLUX 3 Action 42.92 > OASIS 39.0 > Cosmos-3-Nano-Policy 36.8 > π0.5 28.0 > DreamZero 25.7)。
- 训练时建模正在取代测试时想象:Fast-WAM、GigaWorld-Policy、ABot-M0 一代都不再在推理时跑视频扩散,延迟压到 190–225ms,和 π0.5 一个量级。
- 中国团队密度极高:NVIDIA、BFL、蚂蚁(Robbyant)、GigaAI 之外,Motus(清华+生数+北大+地平线)、AHA-WAM(上交)、Fast-WAM(清华)、RoboDojo(港大+北大+清华 XPolicyLab)全是国内团队;OpenWAM 背后是 NUS/清华/北大/港大/浙大/港中文/上交七校联盟。
一、WAM是什么:把"世界怎么变"和"我该怎么动"装进同一个模型
###1.1 一句话定义
VLA 学的是条件分布 p(动作 | 观测, 指令)——看一眼图,吐出动作。WAM 学的是联合分布:
p(未来视频, 动作 | 历史观测, 指令)
  ├── 世界流(world stream):预测未来若干帧的视觉 latent → "世界会怎么变"
  └── 动作流(action stream):输出可执行的动作块   → "我该怎么动"
两条流不是各干各的:世界流给动作流提供"物理上接下来会发生什么"的上下文(这就是物理先验),动作流反过来告诉世界流"在我这个动作下环境会怎么变"(这就是因果性)。2026年9月的综述 arXiv 2609.16074(World-Action Models for Robot Learning and Control: A Survey)把这条路线与 VAM(Video-Action Model)概念并置讨论;更早的教程 arXiv 2607.00836 则把从世界模型到世界行动模型的演进梳理成了短教程。两家的共同判断是:WAM 不是世界模型和 VLA 的简单串联,而是一种新的建模对象。
###1.2 和 VLA 比,赢在哪、输在哪
| 维度 | VLA(如π0.5) | WAM(如Motus、DreamZero) |
|---|---|---|
| 建模对象 | p(动作|观测,指令) | p(未来视频,动作|观测,指令) |
| 物理先验 | 隐式(靠数据规模) | 显式(视频预测就是物理模拟) |
| 数据复用 | 只能用带动作标注的机器人数据 | 大量无动作的互联网视频也能学 |
| 长程任务 | 无内部"预演",靠外挂记忆模块 | 世界流天然是滚动记忆/预演 |
| 推理延迟 | 低(一次前向出动作) | 高(视频扩散很贵)→ 需蒸馏/异步 |
| 可解释性 | 黑盒动作 | 可以"看"模型想象的未来 |
代价也很清楚:延迟和算力。这也是为什么2026年下半年几乎所有 WAM 论文都在卷"推理时视频可以不跑"——详见第四、十节。
###1.3 谱系:WAM 不是从石头里蹦出来的
2023  UniPi          两段式鼻祖:先用视频扩散"想象",再用视觉伺服/IDM执行
2023-24 GR-1/GR-2    视频预训练的VLM接动作头,"以视频理解带动作"
2024   WorldVLA      把世界模型与VLA装进一个自回归框架
2024-25 UWM等        观测token与动作token直接拼接,单流联合建模
2025   mimic/VAM     视频动作模型(Video-Action Model)口径
2025.12 Motus        MoT三专家统一五种模式,latent action解锁动作预训练
2026.01 Cosmos Policy 微调视频生成器(Cosmos Predict2)直接出动作,三模式+价值头
2026.02 DreamDojo     44k小时人类视频+连续latent action预训练基础世界模型
2026.02 DreamZero    NVIDIA正式命名"World-Action Model"
2026下半年  快速分化  训练用推理弃 / 异步双频 / Action-as-Patch / 开源基建
注意两个容易混淆的名字:VAM(Video-Action Model) 和 WAM 在多数论文里指同一件事(比如 OpenWAM 的论文里 LingBot-VA 既是 VAM 也是 WAM),区别主要是各家选的旗号;而 VWM(Video World Model) 只有世界流、没有动作流,不算 WAM。
二、六大架构流派:同一道题的六种解法
所有 WAM 都在回答同一个问题——**“世界预测"和"动作执行"应该以什么方式耦合?**2026年的答案已经分化成六个流派:
流派A 两段式(Imagine-then-Execute)
  视频扩散想象未来 → 视觉伺服/IDM读图执行
  代表:UniPi、mimic-video          优点:直观  缺点:延迟爆炸、开环

流派B 联合双向(Joint Bidirectional)
  视频与动作token放进同一个Transformer,双向注意力联合去噪
  代表:DreamZero、Motus、LingBot-VA、FLUX 3 Action、Cosmos-3
  优点:耦合最深  缺点:视频与动作互相拖慢

流派C 因果可选(Causal, Video-Optional)
  因果mask保证"未来视频token不许影响动作";推理时视频可整个跳过
  代表:GigaWorld-Policy、LingBot-VA(自回归版)
  优点:训练有物理先验、推理免费  缺点:训练配方讲究

流派D 训练用、推理弃(Train-Time World, No Test Imagination)
  训练时视频辅助收敛,部署时只跑动作头
  代表:Fast-WAM、ABot-M0、Rift(future token免rollout)
  优点:延迟最低  缺点:推理时"想象力"只剩参数

流派E 异步双频(Asynchronous Dual-Rate)
  视频分支低频"慢规划"(带滚动KV记忆),动作分支高频"快执行"
  代表:AHA-WAM、X-WAM(异步去噪)、LingBot-VA(异步执行)
  优点:规划与执行解耦  缺点:两套时钟的工程复杂度

流派F 动作即视觉token(Action-as-Patch)
  不再给动作单独的DiT,把动作步映射成视觉latent空间里的一个"patch"
  代表:PatchWAM          优点:架构极简  缺点:路线很新、证据少
一个很有信息量的旁证来自 OpenWAM(斯坦福/NUS系开源框架,详见4.10):它把"世界与动作以何种注意力结构交互"做成受控消融,结论是视频→动作的单向信息流 + 专门的动作容量 + 联合去噪三者缺一不可——纯两段式(先看视频再IDM)反而掉点。这解释了为什么流派B/C成为了2026年的主流。
三、发展时间线:十个月,从一篇论文到一个生态
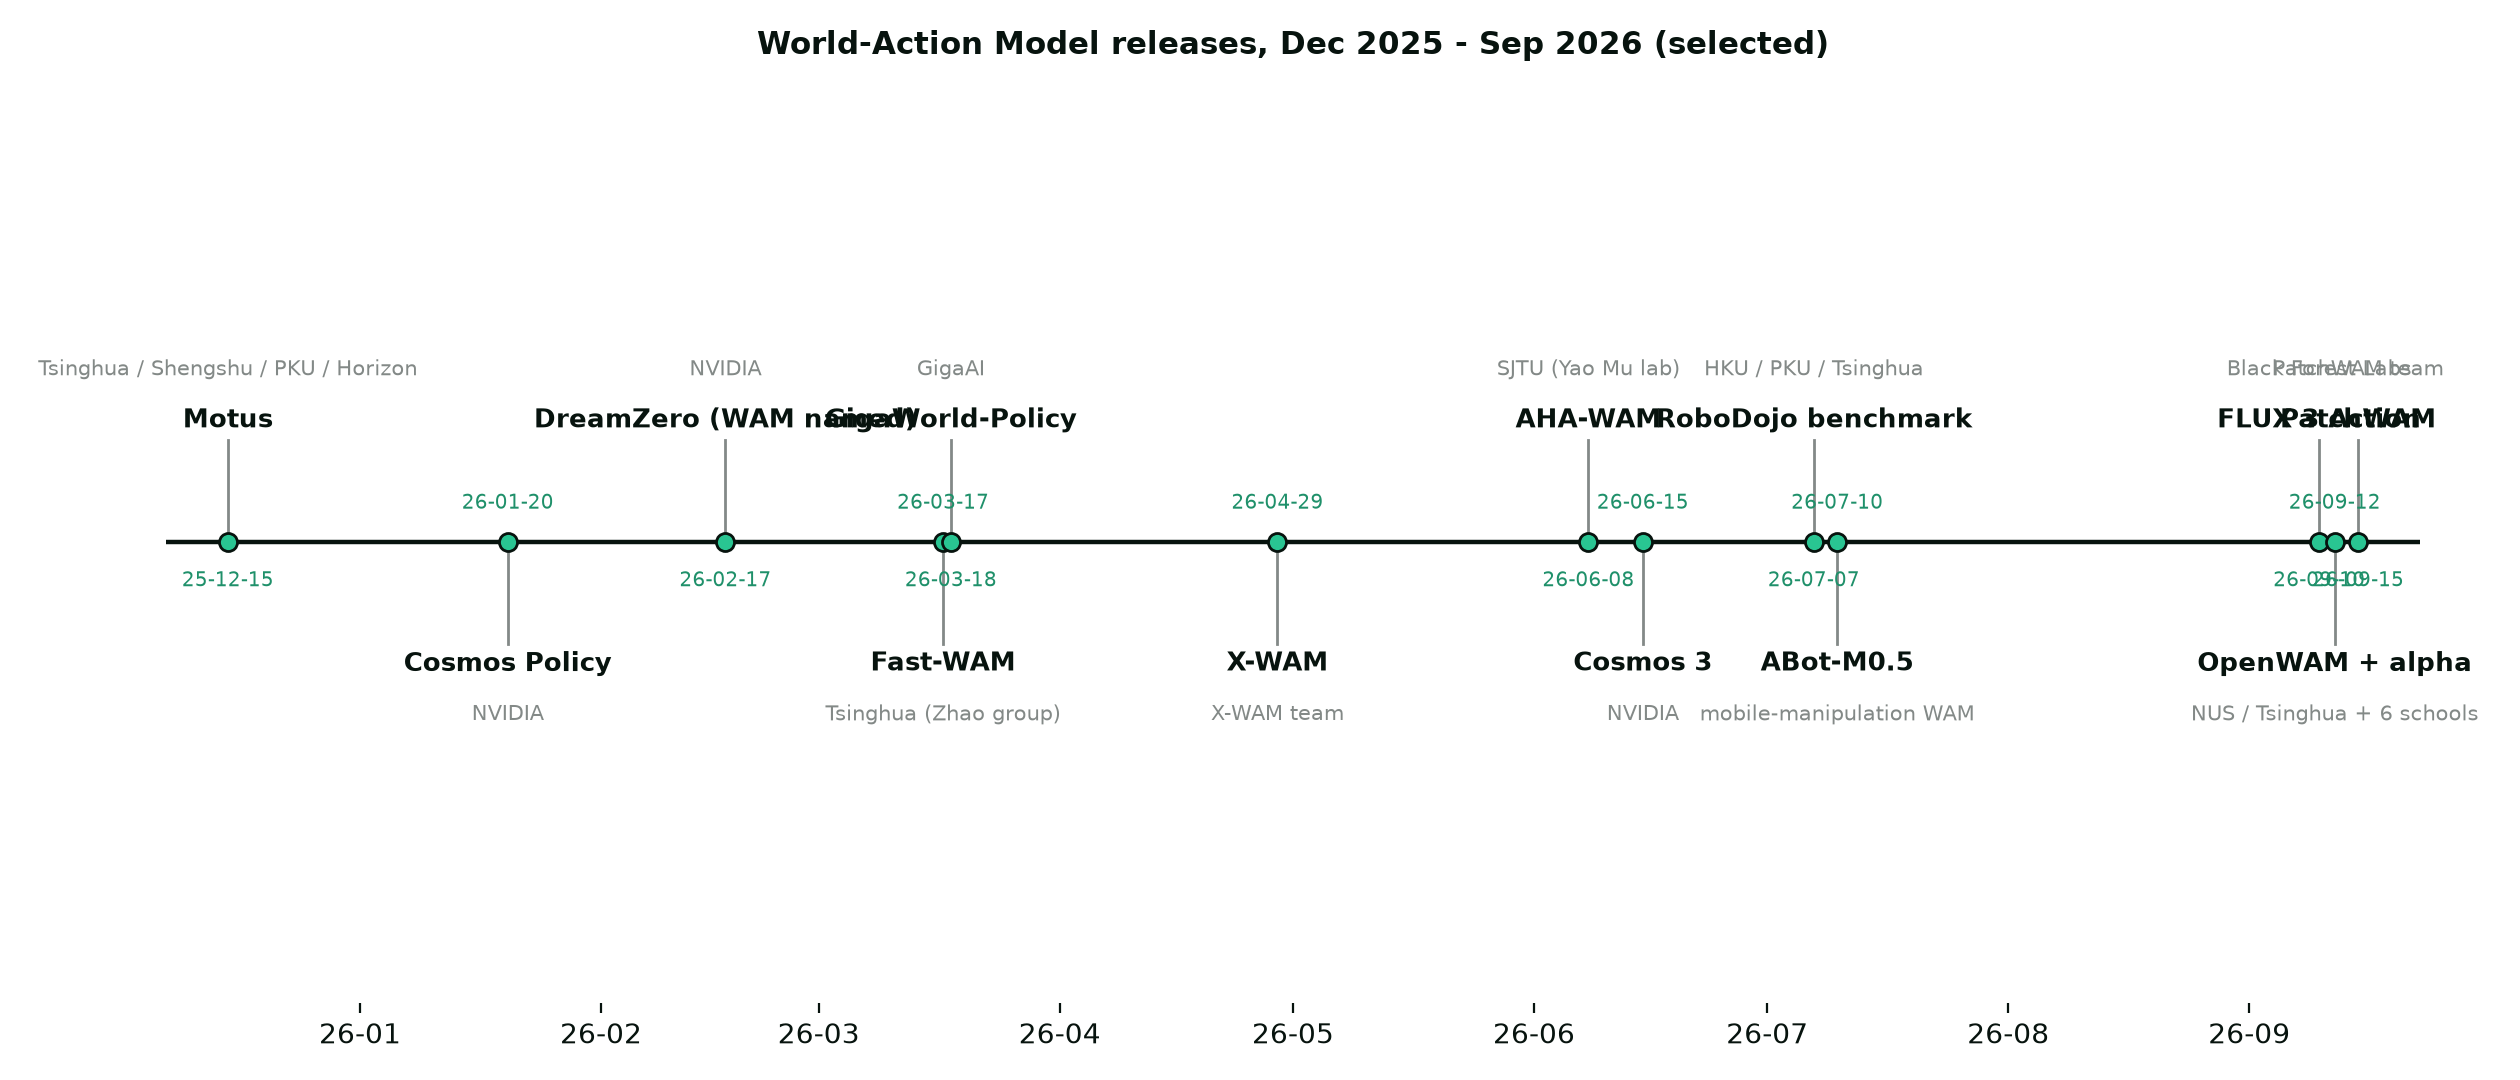
2025年12月—2026年9月主要WAM发布时间线(按arXiv/官方发布时间排列)。Motus是引爆点,NVIDIA用DreamZero完成命名,2026年9月是密集发布期(FLUX 3 Action、OpenWAM、PatchWAM)。
三个节奏值得注意:
- 2025年12月—2026年2月:奠基期。Motus(12月15日)证明MoT统一框架能同时拿到世界模型、VLA、IDM五种模式;一个月后 Cosmos Policy 首次证明"微调视频生成器直接出动作"可行;2月6日 DreamDojo 用44k小时人类视频把世界模型推到"基础模型"量级;再十天后 NVIDIA 用 DreamZero 正式命名 WAM 并立下"实时7Hz闭环"的标杆。
- 2026年3月—6月:效率革命期。Fast-WAM(3月)和 GigaWorld-Policy(3月)先后证明推理时不必跑视频;AHA-WAM(6月)用异步双频把闭环推到24Hz;同期 NVIDIA 发布 Cosmos 3 全家桶。
- 2026年7月—9月:基建与榜单期。RoboDojo(7月,港大/北大/清华)给了统一的仿真+真机战场;ABot-M0.5 把 WAM 带进移动操作;9月三个星:FLUX 3 Action 登顶 RoboLab-120、OpenWAM 开源46个检查点、PatchWAM 用"动作即patch"拿下 RoboDojo 当时最高分。
四、重点模型逐个看:团队、架构、成绩、一句话点评
以下按时间与重要性讲13个工作。每个模型给出:团队与时间、arXiv/报告出处、架构要点、训练配方、报告成绩、一句话点评(4.3 Cosmos Policy 与 4.4 DreamDojo 为加长版详解)。所有成绩均带评测口径;不同基准之间不可直接比较(第五、七节详述)。
###4.1 DreamZero(NVIDIA,2026年2月)——“WAM"这个词的发明者
- 出处:arXiv 2602.15922
- 架构:以14B参数的 Wan 图生视频(image-to-video)扩散模型为骨干,把动作latent和视频latent放进同一个去噪过程联合生成——不是先出视频再抽动作,而是一把噪点里同时"雕"出视频和动作(流派B)。
- 成绩:闭环控制7Hz(真机实时);对最强VLA基线泛化能力提升约2倍;只用视频(完全不给目标本体动作数据)的跨本体迁移能力相对提升42%;30分钟少样本适配即可学会新任务。RoboLab-120 上 DreamZero 得分25.7。
- 点评:历史地位类似 GPT 之于"大模型"这个词——命名者。但它不是终点:14B的视频骨干让它落在"泛化强但打分和速度一般"的位置,后续所有工作都在它的两个短板(延迟、动作精度)上做文章。有趣的是,它的14B在 RoboLab-120 上不敌 FLUX 3 Action 的7B和 π0.5 的3.3B,说明"视频模型越大越好"在动作精度上不成立。
###4.2 Motus(清华+生数+北大+地平线,2025年12月)——统一五种模式的开山之作
- 出处:arXiv 2512.13030,CVPR 2026;一作 Hongzhe Bi、Hengkai Tan,通讯朱军组(THU);合作者包括生数科技(Shengshu)、地平线机器人。项目页 motus-robotics.github.io。
- 架构:Mixture-of-Transformers(MoT)三专家——理解专家(VLM)、视频专家(VGM)、动作专家——共享注意力但各管各的token流;再用 UniDiffuser 式调度器给视频和动作分配不同的时间步与噪声强度,从而在同一个模型里切换五种模式:世界模型、VLA、逆动力学(IDM)、视频生成、视频-动作联合预测。
- 训练:三阶段(①各专家继承预训练;②用光流学 latent action,冻结VLM全模型预训练动作表征;③目标机器人SFT)+ 六层数据金字塔(从网络视频到目标机器人轨迹逐层收窄)。光流latent action是关键手筋:从像素级"delta"里学动作,让海量无动作标注的视频也能给动作专家上课。
- 成绩:RoboTwin 2.0 随机化多任务设置下相对 π0.5 绝对提升超45%,相对 X-VLA 提升15%;真机相对提升11~48%。在 LingBot-VA 的对比表里 Motus 在 RoboTwin 2.0 上是88.7(easy)/87.0(hard),排在 LingBot-VA(92.9/91.6)之后、π0.5(82.7/76.8)之前。推理代价:约3231ms/动作块(GigaWorld-Policy 论文实测),是效率侧的反面教材。
- 点评:学术上的开山之作,证明了"统一建模五种范式"不但可行还涨点,latent action + 数据金字塔成了后续所有 WAM 的标准配方。短板是慢——3.2秒一个动作块,真机部署需要大改。RoboDojo 榜上没有以 Motus 命名的条目,但多款后继工作(如 Spatial Forcing、各校复现)都站在它的肩膀上。
###4.3 Cosmos Policy 与 Cosmos 3(NVIDIA,2026年1月/6月)——视频基座的工业化路线
- 出处:Cosmos Policy(arXiv 2601.16163,Kim et al.,NVIDIA+Stanford,ICLR 2026;代码 NVlabs/cosmos-policy,Cosmos Cookbook 配方,HF 检查点
nvidia/Cosmos-Policy-ALOHA-Predict2-2B);Cosmos 3:arXiv 2606.02800。本地有《Cosmos 3 世界基础模型精读》逐章拆解,以及《Cosmos3微调真机落地路线图》把这套配方落到真机的逐项拆解。
核心机制:latent frame injection(把视频生成器"改造成"策略的最小手术)
Cosmos Policy 不给动作造独立专家,而是把观测、动作、未来本体、未来图像、价值全部摆进同一条 latent 画布,靠"哪段干净、哪段加噪"在同一个模型里切换三种模式:
策略模式  [s]              → [a, s', V]     ← 部署只跑这个(当前观测出动作)
世界模式  [s, a]           → [s', V]        ← 给定动作想象世界(训练用)
价值模式  [s, a, s']       → [V]            ← 判定一条轨迹会不会成功
训练 batch 配比: 策略50% / 世界25% / 价值25%
三个被反复引用的设计细节:
- 动作分支不读"预测出来的视频”:策略模式下动作从当前观测直接条件生成,未来图像是同一次去噪的兄弟输出——视频画错不连坐动作,“视频说抓到了但动作没抓到"在这个框架里是正常现象。
- 不对称去噪:动作5~10步、未来图像1步——视频只需粗轮廓,不需要精细去噪;这是"联合出动作+视频又不慢"的官方答案。
- 价值头替代"看视频判断”:V(s) 用648条混合策略 rollout 单独微调,推理时做 best-of-N 规划——用学出来的价值判断成败,而不是解读生成的视频(视频幻觉的制度性解法)。
训练配方(官方超参,可直接平移的起点)
| 项 | 官方值 |
|---|---|
| 数据 | 真机 ALOHA 四任务共约185条(叠衬衫15/糖果入碗45/糖果入袋45/茄子摆盘80);LIBERO、RoboCasa 均为每任务50条 |
| 规模 | batch 200、5万步、lr 1e-4、chunk 50、8×H100×48小时(≈1000万样本访问) |
| 噪声 | 训练 70% log-normal + 30% 均匀混合;推理 σ∈[4,80] |
| 图像 | 随机增广 + JPEG压缩 + 翻转全开(trained_with_image_aug、use_jpeg_compression) |
| 收敛判据 | 动作L1 0.010~0.015、未来本体L1≈0.007、未来图像latent L1 0.05~0.09、价值L1≈0.007 |
成绩
| 场景 | 数据量 | 结果 |
|---|---|---|
| LIBERO(仿真40任务) | 约2000条(每任务50) | 平均 98.5%,超 π0.5 |
| RoboCasa | 每任务50条 | 67.1%(P2)/ 71.1%(P2.5),官方口径”6×更少演示" |
| 真机 ALOHA(4任务) | 185条 | 平均 93.6%;价值规划 best-of-N 再 +12.5pp |
| 推理代价 | — | 1413ms/动作块(GigaWorld 论文实测口径)、仅6GB显存 |
- 架构(Cosmos 3 侧):升级为 Mixture-of-Transformers 双塔(Reasoner 理解塔 + Generator 生成塔),支持文本/图像/视频/音频/机器人动作五模态,配套 OpenMDW-1.1 许可证;Nano-Policy(16B)继承这套基座。Cosmos-3-Nano-Policy 在 RoboLab-120 上 36.8%(仅次于 F3A 与 OASIS,高于 π0.5 的28.0),Edge-Policy 22.9%。
- 点评:NVIDIA 的打法是基座工业化:一套视频基座通吃世界模型、合成数据、策略三条产品线。Cosmos Policy 的历史意义是第一次证明"微调现成视频生成器"就能拿到 SOTA 真机策略——不用从头训 VLA,latent frame injection 此后成为 Cosmos 3、F3A 等一串后继工作的模板;它的三模式 batch 配比则是"一个模型多任务共训"的标准答案。短板也在榜单上摆着:真机平均0.58(GigaWorld口径)低于 Motus 0.76,说明配方会随基准进化。Nano-Policy 用16B打36.8、FLUX 3 Action 用7B打42.9——“以大打小"的效率账在 WAM 时代变得非常微妙。对 MOT/Flow-GRPO 方向的读者,Cosmos 系列最值得精读的是"生成塔如何为动作专家供血"的数据管线。
###4.4 DreamDojo(NVIDIA+HKUST+Berkeley+UT Austin 等,2026年2月)——44k小时人类视频喂出来的基础世界模型
- 出处:arXiv 2602.06949(2026-02-06 提交,ICML 2026);项目页 dreamdojo-world.github.io;作者含 Linxi “Jim” Fan、Yuke Zhu、Joel Jang、Pieter Abbeel、Jitendra Malik(NVIDIA/UT Austin 系),与 HKUST、Berkeley、UW、Stanford、KAIST、UofT、UCSD 联合。
- 定位:本文里"世界流压倒动作流"的极端样本。其他 WAM 都是"为了更好的策略顺带建模世界”,DreamDojo 反过来:先造一个能被动作操控的通用世界模型,策略与评测只是它的下游应用。骨干直接初始化自 Cosmos-Predict2.5——它同时也是 NVIDIA Cosmos 生态的上游变体。
- 数据(全文盘点里的规模之最):DreamDojo-HV 44,711小时第一人称人类视频,世界模型预训练史上最大视频混合——相对此前最大数据集:时长15×、技能96×、场景2000×;与 In-lab、EgoDex 按 1:2:10 采样比混合预训练。
- 机制:连续 latent action 当"世界语"(解决"人类视频没有动作标签"):
- 训练一个 VAE 式时空 Transformer 潜动作模型:编码器吃两帧 (f_t, f_{t+1}),经信息瓶颈压出低维潜动作 â_t;解码器用 â_t + 首帧重构下一帧。
- 这个本体无关的潜动作与时间步 embedding 一起注入骨干 DiT 的各块——人手和夹爪长得再不一样,“怎么动"被统一编码,本体鸿沟(embodiment gap)由此跨过,44k 小时无标注视频全部变成可教的监督信号。
- 与 Motus 的光流 latent action、LingBot-VA 2.0 的共享 latent 空间殊途同归:让视频携带动作监督,是 WAM 数据飞轮的共同答案。
- 后训练与蒸馏:适配新本体时重置动作条件层、在小规模目标机器人数据上微调(GR-1、宇树 G1、AgiBot、YAM;视频采样~10Hz、13帧一窗=首帧条件帧+12步相对动作);蒸馏管线把生成加速到 10.81 FPS 实时,自回归长程生成稳定运行超过1分钟且上下文一致性更好。
- 成绩与用途:首个在未见物体/新环境上表现出零样本 OOD 泛化的灵巧操作级世界模型(同底座 Cosmos-Predict2.5 直接后训练的对照明显更弱);后训练后兼具物理理解与精确动作可控性。三类应用:实时遥操(live teleoperation)、策略评测(不碰真机就能评策略)、基于模型的规划(model-based planning)。
- 点评:① 44k 小时人类视频是本文第一节"数据复用优势"的最强证据——VLA 只能吃带动作标注的机器人数据,世界模型能把整个人类活动视频库变成预训练语料;② 它把 WAM 的价值从"涨点工具"扩展成”评测与规划的模拟器"——策略评测不占真机、可反复重放,这是榜单分数之外的第二条价值链(与真机项目"先建回归台再谈训练"的思路同构);③ 短板同样清晰:没有动作真值的世界模型,精细控制仍必须靠目标机器人后训练+蒸馏——“世界的想象可以零样本,控制的精度不能”。在六大流派里它最接近"世界模型+潜动作"的纯正血统,读它是为了理解 WAM 的另一半天空。
###4.5 GigaWorld-Policy(GigaAI,2026年3月)——“动作为中心"的因果设计
- 出处:arXiv 2603.17240(Ye et al.);同门姊妹工作 GigaWorld-0 是纯合成数据引擎(本地有《GigaWorld-0 数据引擎精读》),VLA 只吃合成数据训练。
- 架构:因果WAM(流派C):用因果注意力mask死死保证"未来视频token不许影响当前动作”;预测顺序是先动作、后视频——视频以动作为条件生成,物理因果链在架构里显式成立。推理时视频分支可整个关闭:9×快于 Motus(对齐 π0.5 的225ms量级),机器人操作成功率反超7%。视频基座 Wan2.2-5B DiT。
- 成绩:RoboTwin 2.0 相对 π0.5 提升95%;真机四任务平均:Motus 0.76 > π0.5 0.69 ≈ GigaBrain-0(配套VLA)0.68 > Cosmos Policy 0.58。RoboDojo 榜:GigaWorld-Policy-0 得分6.2(#13)。
- 点评:训练时有想象力、推理时零成本的旗手,也是"视频辅助可以只发生在训练期"这一论点的最强证据。因果mask这个细节看似小,实则解决了联合建模的污染问题——这条经验已被 Fast-WAM、ABot-M0 等多篇工作印证。
###4.6 Fast-WAM(清华朱军/赵航系,2026年3月)——“测试时想象力是必需品吗?”
- 出处:arXiv 2603.16666(Tianyuan Yuan 等,清华)。
- 架构:以 Wan2.2-5B 视频DiT为骨干做视频-动作训练期共训,但部署时完全不跑视频去噪(流派D)——未来视频只在训练中作为中间监督,推理时模型"参数化地"记住了想象能力。190ms/动作块,比"先想象再执行"快4倍。
- 成绩:LIBERO、RoboTwin 2.0、真机任务上与想象式方法打平或更好(RIFT 论文复测其 LIBERO 为96.8);RoboDojo 得分3.5(#19)。
- 点评:思想实验式的一篇:把"测试时想象"从 WAM 的必要条件降级为可选项,直接引爆了下半年的效率竞赛。它在 RoboDojo 上的3.5和在 LIBERO 上的~97 形成刺眼反差——同一个模型,换个战场就从学霸变学渣,这正好引出第五节的"基准口径"问题。后续 Rift(arXiv 2608.11521)用学习式 anticipation token 一次前向构建未来KV缓存,把 LIBERO 推到98.8且保持247ms,可视为该流派的精修版。
###4.7 AHA-WAM(上海交大姚望/穆瑶组,2026年6月)——异步双频:慢规划,快执行
- 出处:arXiv 2606.09811;一作 Jisong Cai,通讯含 Yao Mu(上交)。
- 架构:双DiT异步(流派E)。视频DiT(4.99B,Wan2.2-5B初始化)当低频世界规划器:带滚动KV记忆,维护长程场景演化的可复用层间latent上下文;动作DiT(1.02B)当高频执行器:每次闭环只查询这份上下文、不去噪视频;再加1.22B的OVCR(观测引导视频上下文路由)模块让复用的上下文跟上最新观测,总计约7.23B。配套 horizon-adaptive offset 训练让规划器与执行器的相位差被显式建模。
- 成绩:RoboTwin 2.0 平均92.80%(clean 93.4 / randomized 92.2),且完全不用机器人数据预训练;真机4任务78.3%(同表:π0.5 76.7、Fast-WAM 68.3、Motus 21.7);闭环24.17Hz,比 Fast-WAM 快4.59倍。RoboDojo 得分4.8(#17)。
- 点评:把"世界模型的算力摊销"这件事做成了显式架构——视频分支算一次、动作分支用多次,这是异步派的核心经济账。真机上压过 π0.5 但 RoboDojo 只有4.8分,说明它的强项是"视频预训练零机器人数据"的冷启动,弱项是长程开放任务。GitHub(SereneC/AHA-WAM)与HF检查点已开源。
###4.8 X-WAM(2026年4月)——统一4D:视频之外还要几何
- 出处:arXiv 2604.26694(Unified 4D World Action Modeling from Video Priors with Asynchronous Denoising)。
- 架构:在视频先验之上做多视角RGB-D视频+动作的统一生成(流派B+E混合):把预训练DiT最后几个block复制出一个深度预测分支,用最小代价把2D像素模型升级为带几何的4D世界;去噪过程异步化,优先保证动作快速交付、视频慢工出细活。
- 成绩:预训练5800+小时机器人数据;RoboCasa 79.2%(对照:Cosmos Policy 67.1、UWM 60.8);RoboTwin 2.0 平均90.7%。RoboDojo 得分7.7(#10,WAM里的最高名次之一)。
- 点评:回答了"像素世界够不够"——操作本质是接触动力学,没有几何的想象是纸上谈兵。深度分支只复制DiT尾部block的轻量设计很经济,值得做 MOT 相关工作的读者借鉴。
###4.9 LingBot-VA / LingBot-VA 2.0(蚂蚁 Robbyant,2026年1月/7月)——自回归因果世界模型
- 出处:LingBot-VA:arXiv 2601.21998,RSS 2026;LingBot-VA 2.0:arXiv 2607.08639。Robbyant(蚂蚁集团旗下具身智能公司)出品,代码开源在 Robbyant/lingbot-va,HF 上已有 LeRobot 格式检查点。
- 架构:自回归扩散(流派C/E):5.3B双流MoT建在 Wan2.2-5B 栈上(causal视频VAE + UMT5文本编码器),视频latent与动作token交错排成一条自回归序列,跨chunk用KV缓存接力;推理时视频流与动作流各用独立的流匹配调度器,支持异步执行。2.0版进一步原生化:先建观测与动作共享的语义latent空间,再在上面学因果动力学,并用自监督latent action让无动作标注的网络视频也携带动作监督。
- 成绩:RoboTwin 2.0 上首批冲过90+:50任务平均92.9(easy)/91.6(hard),领先 Motus(88.7/87.0)与 π0.5(82.7/76.8);LIBERO 平均98.5(其中Object 99.6)。代价:约2270ms/动作块(RIFT 论文实测,约为 Fast-WAM 的9.6倍)——自回归世界建模的延迟账单很厚。
- 点评:“世界模型作为长程记忆"路线的代表:KV缓存让长任务不漂移,长程任务指标(LIBERO-Long 98.5)确实受益。2.0的"共享latent空间+latent action"与 Motus 的光流latent action殊途同归——让视频数据携带动作监督,是WAM数据飞轮的核心。RoboDojo 上 LingBot-VLA 得分5.5(#15)。
###4.10 OpenWAM 与 OpenWAM-α(NUS/清华/北大/港大/浙大/港中文/上交,2026年9月)——WAM的"检测器"与开源基建
- 出处:arXiv 2609.07398;项目 openwam-official.github.io;Lin Shao(NUS)与 Hang Zhao(清华)共同指导;46个检查点在 HF 的 OpenWAM org 开源。
- 架构:两件套。OpenWAM-Infra:把WAM设计空间拆成可组合模块——6种架构变体、5种视频骨干、4种视觉编码器、4种注意力mask,统一训练/推理/部署/评测接口。OpenWAM-α:用受控实验蒸馏出的三原则(①上游知识要经由足够强的生成骨干与紧凑latent空间迁移;②世界-动作协同需要专门的动作容量+显式世界→动作信息流+同步联合去噪;③具身预训练主要改善分布外泛化)拼装出来的双系统模型:世界与动作互相可见、单阶段共训、80维统一动作空间。
- 数据:约6400小时(518.5M帧)第一人称人类+机器人数据,70%机器人/30%人类。
- 成绩:LIBERO 99.3(超过 Fast-WAM 97.6、LingBot-VA 98.5、π0.5 96.9);RoboTwin 2.0-Full 93.85;RoboDojo 仿真榜17.18分/11.92% SR;RoboDojo 真机榜37.6分/24.4% SR——直接把 π0.5 保持的22.9/12.8%纪录翻了近一倍。
- 点评:这个领域最缺的不是又一个SOTA,而是"到底什么有效"的受控答案——OpenWAM 补的就是这个空。它的受控消融给第六节"训练配方共性"提供了最硬的证据;真机榜的断层领先则说明双系统+共训的上限远未到头。想自己复现/魔改WAM的团队,从它的46个检查点入手是当前性价比最高的路径。
###4.11 PatchWAM(2026年9月)——“动作即视觉token"的极简主义
- 出处:arXiv 2609.25961;站在 ImageWAM 肩膀上。
- 架构:Action-as-Patch(流派F):设计一个固定的动作-视觉latent映射,把每个动作步直接当成视觉latent序列里的一个"patch”,彻底删掉专门的动作DiT——一个视频模型通吃想象与控制。
- 成绩:截至2026年9月15日 RoboDojo 得分29.39(当时全榜最高);RoboTwin 平均96.12(增广演示口径);LIBERO-Plus 91.8。论文顺带列了各基准WAM侧SoTA:RoboTwin全量-MotuBrain、RoboTwin C2R-4D-WAM、LIBERO-ABot-M0.5、LIBERO-Plus-ImageWAM、RoboDojo-OpenWAM-α(本文写作时已被PatchWAM自身超越)。
- 点评:“世界与动作还需要两套专家吗"的终极一问。删掉动作DiT之后速度与简洁性双赢,但动作的控制精度是否会退化成"像素级近似"仍待真机检验。9月15日之后榜单又添了数轮更新,29.39的王座未必坐得久——盯榜时要带时间戳思维。
###4.12 FLUX 3 Action(Black Forest Labs,2026年9月)——RoboLab-120的新王
- 出处:官方技术报告(bfl.ai,无arXiv编号);本地有《FLUX 3 Action 世界行动模型精读》,20张图逐图拆解。
- 架构:7B WAM,由图像生成模型 FLUX 3 骨干改造;Guided Distillation 与 Logit Distillation 双管齐下把教师多步去噪压成单步策略(控制循环图见精读);另有与 Astra VLA 组成的混合策略(WAM管高风险决策、VLA管高频控制),整机成本低至8.77美元/月。
- 成绩:RoboLab-120(F3A口径)42.92总分登顶——高于 OASIS 39.0、Cosmos-3-Nano-Policy 36.8、π0.5 28.0、DreamZero 25.7;蒸馏后引导式42.2、单步38.3仍保持第一;推理加速1.34
2.28倍于 π0.5、1.523.95倍于 Cosmos FP8。 - 点评:把FLUX图像生成栈的蒸馏手艺平移到具身的胜利,也是"7B打赢16B和14B"的效率样本。它与 π0.5 的混合策略说明:厂商最终交付的不会是单一范式,而是WAM+VLA的组合产品——这可能是本赛道的终局形态之一。
###4.13 其他值得知道的名字
- ABot-M0 / M0.5(2026年7月,arXiv 2607.00678):移动操作方向的统一WAM(本地有逐图精读);在 LIBERO 上被 PatchWAM 引为 WAM 侧SoTA;RoboDojo 得分3.7(#18)。WAM 从桌面双臂走向"腿+臂+导航"是2026年中的重要扩散。
- LingBot-VA 2.0 / RIFT / 4D-WAM / MotuBrain / ImageWAM:分别代表原生预训练、免rollout未来缓存、4D几何、RoboTwin全量冠军、LIBERO-Plus冠军等细分旗号,名字会反复出现在各论文的SoTA引用里,读榜时认得出即可。
- 国内高校的"世界模型+“分支:BrainWAM(语义/预测双通路,本地精读)、Percept-WAM(世界token直接进VLM感知,本地精读)走的是"WAM反哺VLA"路线;驾驶侧的 SimWAM(世界模型当 Flow-GRPO 训练教师,精读)、ReWorld(驾驶WAM表征学习,精读)则证明同一范式在自动驾驶上同样成立——“世界+动作"的耦合是跨域的,方法论可以直接互相搬运。
- VLA 阵营的对照组:π0.5、X-VLA、InternVLA-A1.5、GalaxeaVLA、Xiaomi-Robotics 等在各榜与 WAM 同场竞技;《前沿VLA模型全景速览》有它们的完整画像。
五、主战场:RoboDojo 榜单逐条分析
###5.1 RoboDojo 是什么
RoboDojo(港大+北大+清华 XPolicyLab,2026年7月发布,MIT协议,ECCV 2026)是目前唯一把仿真和真机统一在一个框架下的WAM友好基准:
- 规模:42个仿真任务 + 18个真机任务,覆盖3种本体(双臂、单臂、移动操作);
- 五维评分:Generalization(泛化)、Memory(记忆)、Precision(精度)、Long-Horizon(长程)、Open(开放性)——每维再分 clean / random 两档;
- 综合分:五维加权得到官方 Score,同时公布 SR%(成功率);
- 反作弊设计:隐藏布局与干扰物,杜绝"背题”;
- 官方赛会:ECCV 2026 挑战赛主题即 “Safe World Models for Trustworthy Embodied AI”,提交WAM类方法可获1.2倍评分乘数——赛道地位由赛会制度直接背书。
###5.2 仿真榜(官方 2026-08-26 版 Top 15)
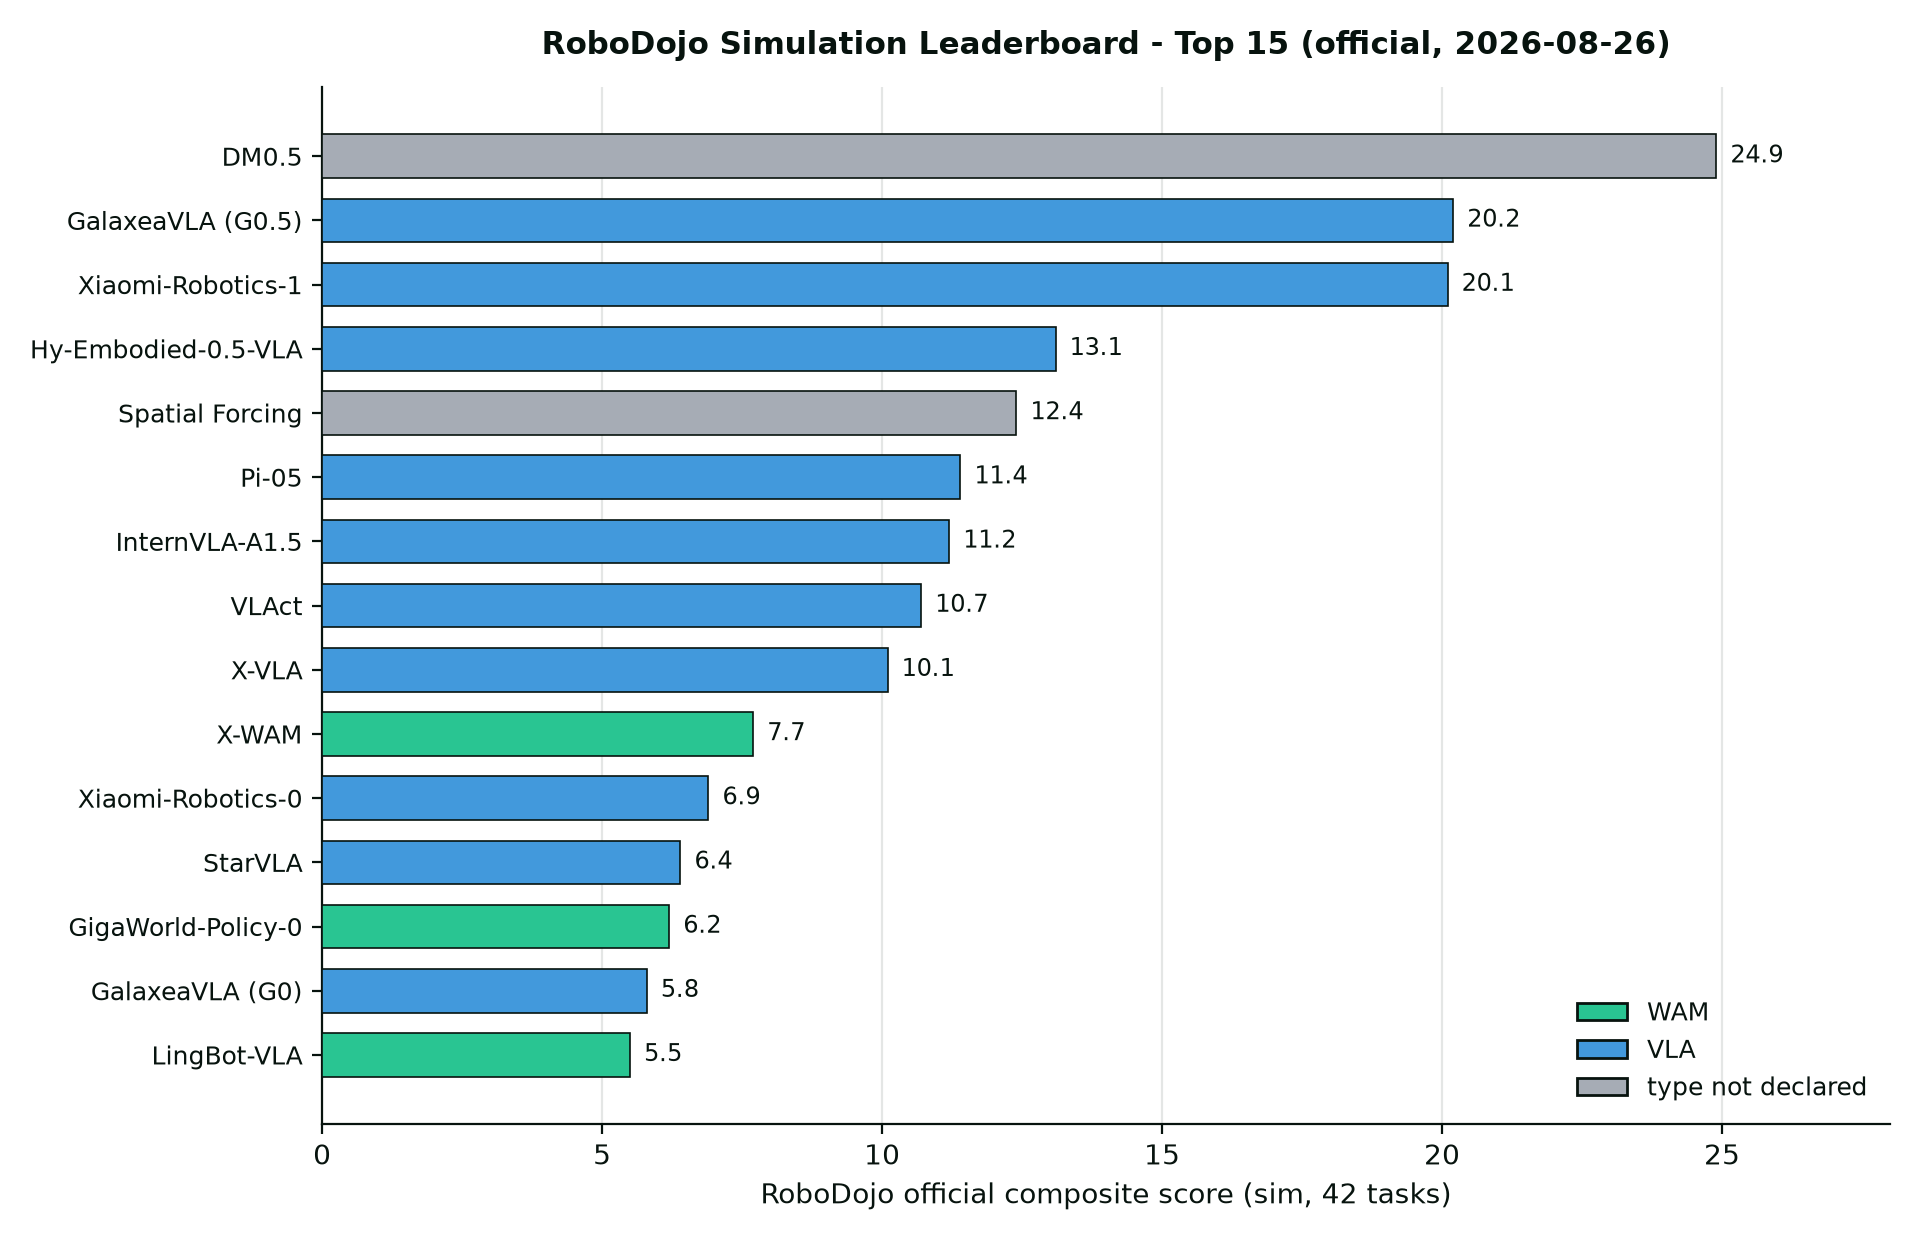
RoboDojo官方仿真榜(2026-08-26)Top 15。绿色为WAM、蓝色为VLA、灰色为未标注类型。WAM占据中游(X-WAM #10、GigaWorld-Policy-0 #13、LingBot-VLA #15),榜首仍由DM0.5、GalaxeaVLA、Xiaomi-Robotics-1等VLA把持。
| 排名 | 模型 | 团队/厂商 | Score | 类型 |
|---|---|---|---|---|
| 1 | DM0.5 | Dexmal | 24.9 | 未标注 |
| 2 | GalaxeaVLA G0.5 | Galaxea AI | 20.2 | VLA |
| 3 | Xiaomi-Robotics-1 | 小米 | 20.1 | VLA |
| 4 | Hy-Embodied-0.5-VLA | 腾讯Robotics X | 13.1 | VLA |
| 5 | Spatial Forcing | OpenHelix | 12.4 | 未标注 |
| 6 | Pi-0.5 | Physical Intelligence | 11.4 | VLA |
| 7 | InternVLA-A1.5 | InternVLA | 11.2 | VLA |
| 8 | VLAct | — | 10.7 | VLA |
| 9 | X-VLA | — | 10.1 | VLA |
| 10 | X-WAM | — | 7.7 | WAM |
| 11 | Xiaomi-Robotics-0 | 小米 | 6.9 | VLA |
| 12 | StarVLA | — | 6.4 | VLA |
| 13 | GigaWorld-Policy-0 | GigaAI | 6.2 | WAM |
| 14 | GalaxeaVLA G0 | Galaxea AI | 5.8 | VLA |
| 15 | LingBot-VLA | 蚂蚁Robbyant | 5.5 | WAM |
(其后还有 AHA-WAM 4.8 #17、ABot-M0 3.7 #18、Fast-WAM 3.5 #19、π0 3.5、GROOT-N1.7 2.9、InternVLA-A1 2.5、SmolVLA 1.8、LDA-1B 1.6、MolmoAct2 1.0。完整维度分解见官方镜像榜。)
###5.3 快照之后的新王:别用旧快照做判断
官方镜像是8月26日的快照,而9月以来榜单已经变天(依据官方首页/论文自报,取最高分排序):
| 模型 | Score / SR | 备注 |
|---|---|---|
| PhysicalRSI | 36.27 / 31.38% | 榜首新势力(机构未标注;命名疑似与递归自我改进路线相关,未证实) |
| Simate-beta | 33.95 / 27.96% | — |
| VPP2-Preview | 31.40 / 25.62% | — |
| PatchWAM | 29.39 | 论文自报(9月15日口径,当时最高) |
| OpenWAM-α | 17.18 / 11.92% | 团队提交 |
| Meituan-Robotics-0 | 14.95 / 10.14% | 美团 |
读榜方法论:RoboDojo 的分数必须带时间戳引用;“当时最高"这类表述在9月的榜单上平均寿命不到一周;且机构标注不全,跨来源拼表要谨慎。
###5.4 真机榜:OpenWAM-α 的断层领先
真机榜(18任务)上,π0.5 以22.9分/12.8% SR 长期领跑,直到 OpenWAM-α 以37.6分/24.4% SR 接近翻倍的纪录登顶(9月新增条目)。真机榜条目稀少(官方口径约10个)反而凸显一件事:仿真刷分容易,真机难于上青天——五维评分下大多数模型的真机SR仍在个位数到十几之间。
###5.5 榜单观察:WAM 在 RoboDojo 上为什么"打得不好”
- 开放性与记忆是全场死亡谷:五维中的 Open 与 Memory 几乎所有参赛者都是个位数——这正是 WAM 理论上应该赢的地方(滚动记忆、世界预演),但目前的 WAM 记忆窗口和规划深度还撑不起开放指令任务。
- 同一个模型,不同基准天差地别:Fast-WAM 在 LIBERO ~97、RoboTwin 强势,RoboDojo 只有3.5;AHA-WAM 在 RoboTwin 92.8、RoboTwin真机78.3,RoboDojo 4.8。“SOTA"这个词在不指明基准时没有意义。
- VLA 仍握着精度与工程成熟度:Precision 维度上 VLA 阵营(尤其 π0.5 系)保持优势;WAM 的视频噪声天然不利于毫米级接触任务。
- 新一波 WAM 正在改写:PatchWAM 29.39、OpenWAM-α 17.18 已进入第一集团——8月快照里"WAM都在中游"的结论正在过期。
六、另一个主战场:RoboLab-120 与基准全景
###6.1 RoboLab-120:FLUX 3 Action 报告采用的口径
F3A 官方报告中的 RoboLab-120 对照表(F3A = FLUX 3 Action 口径):
| 模型 | 类型/规模 | RoboLab-120 |
|---|---|---|
| F3A(FLUX 3 Action) | WAM,7B | 42.92(蒸馏引导式42.2、单步38.3) |
| OASIS | — | 39.0 |
| Cosmos-3-Nano-Policy | WAM,16B | 36.8 |
| Phoenix | — | 34.4 |
| BiMind | — | 33.3 |
| π0.5 | VLA,3.3B | 28.0 |
| DreamZero | WAM,14B | 25.7 |
| Cosmos-3-Edge-Policy | WAM | 22.9 |
| π0-FAST | VLA | 15.5 |
| GR00T N1.6 | VLA | 7.2 |
| π0 | VLA | 5.0 |
三个信号:①WAM在该基准全线上位(前三里两个WAM);②参数量与分数脱钩(7B>16B>14B>3.3B);③蒸馏不伤分(F3A单步38.3仍高于Nano-Policy 16B)。
###6.2 基准地图与指标口径
| 基准 | 领域 | 规模 | 主指标 | 备注 |
|---|---|---|---|---|
| RoboDojo | 操作 | 42仿真+18真机 | 五维综合Score+SR | 唯一仿真真机统一;ECCV26挑战;WAM乘数1.2× |
| RoboLab-120 | 操作 | 120任务集 | F3A口径总分 | FLUX 3 Action等采用 |
| LIBERO / LIBERO-Plus | 操作 | 4套/40任务/Plus增强 | 平均SR% | 最老牌;已近饱和(97-99),Plus重新拉开差距 |
| RoboTwin 2.0 / -Plus | 操作(双臂仿真) | 50任务 | easy/hard SR | Motus/LingBot/AHA主战场;Plus加鲁棒性 |
| RoboCasa / RoboCasa365 | 厨房操作 | 365任务集 | SR% | X-WAM、Cosmos Policy对比地 |
| NAVSIM | 驾驶 | — | PDMS | SimWAM等驾驶WAM采用(91.5 PDMS) |
七、跨基准成绩对照表(谨慎阅读)
下表汇总各模型自报或官方榜的代表成绩。不同基准、不同演示数据量、不同评测协议之间严禁直接比较——这张表的价值是"每个模型在自己的主场打成什么样”:
| 模型 | RoboDojo(sim) | RoboLab-120 | LIBERO | RoboTwin 2.0 | 真机代表作 | 速度 |
|---|---|---|---|---|---|---|
| FLUX 3 Action | — | 42.92 | — | — | 混合策略真机验证 | 1.34~2.28× π0.5 |
| DreamZero | — | 25.7 | — | — | 7Hz闭环,泛化2× | 7Hz |
| Motus | — | — | — | 88.7(e)/87.0(h) | 相对+11~48% | ~3231ms/块 |
| GigaWorld-Policy-0 | 6.2 | — | — | 相对π0.5 +95% | 四任务均0.68~0.76 | ~225ms |
| Fast-WAM | 3.5 | — | ~96.8 | 强 | 竞争力持平 | 190ms |
| AHA-WAM | 4.8 | — | — | 92.80 | 78.3%(4任务) | 24.17Hz |
| X-WAM | 7.7 | — | — | 90.7 | — | 异步去噪 |
| LingBot-VA | 5.5 | — | 98.5 | 92.9(e)/91.6(h) | 少样本泛化 | ~2270ms/块 |
| OpenWAM-α | 17.18 | — | 99.3 | 93.85(Full) | RoboDojo真机37.6 | — |
| PatchWAM | 29.39 | — | 91.8(Plus) | 96.12 | — | 无动作DiT |
| Cosmos-3-Nano | — | 36.8 | — | — | — | — |
| π0.5(VLA对照) | 11.4 | 28.0 | 96.9 | 82.7(e)/76.8(h) | RoboDojo真机22.9 | ~225ms |
另一个值得关注的第三方视角:鲁棒性专项研究 arXiv 2603.22078(Do World Action Models Generalize Better than VLAs?)在 RoboTwin 2.0-Plus 上同场评测 X-VLA、Motus、LingBot-VA,专门考察初始状态扰动下的表现——WAM的泛化优势需要在扰动协议下才显形,干净评测里很多差距会被抹平。
八、训练配方的共性:2026年的WAM标准件
把第四节12个工作拆开看,训练配方高度收敛,基本可以写成一条"标准流水线”:
① 骨干继承   视频侧:Wan2.2-5B为事实标准(Fast-WAM/AHA/LingBot/GigaWorld)
             图像侧:FLUX系(FLUX 3 Action)
             语义侧:VLM(Qwen/PaliGemma系)做理解塔
② 共训阶段   视频-动作联合去噪/联合流匹配;注意两件事:
             a) 因果mask或先动作后视频,防"未来污染动作"(GigaWorld/ABot)
             b) 动作专家要有专门容量与显式信息流(OpenWAM消融结论)
③ 潜在动作   latent action从无标注视频里榨动作监督:
             光流delta(Motus)、共享语义空间(LingBot-VA 2.0)、
             80维统一动作空间(OpenWAM)
④ 数据金字塔 网络视频 → 合成数据(GigaWorld-0/GR00T Dreams路线)→
             多机器人遥操作 → 目标机器人演示,逐层收窄
⑤ 蒸馏部署   多步→少步→单步蒸馏(F3A guided/logit distillation);
             ODE蒸馏(AHA-WAM-Flash);EMA + CFG 仍是标配
⑥ 混合系统   WAM与VLA组合交付:F3A+Astra、Reasoner/Generator双塔(Cosmos 3)、
             双系统互见(OpenWAM-α)
其中②③是 WAM 区别于普通视频微调的两条护城河:信息流方向决定动作会不会被视频噪声带偏,latent action 决定动作预训练能否吃到视频规模的数据红利。对做 Flow-GRPO/MOT 的读者,⑤是最直接可复用的工程环节——动作专家的少步蒸馏与世界模型教师的接口设计,和 Flow Matching 策略蒸馏是同构问题。
九、厂商与高校地图:谁在牌桌上
| 阵营 | 选手 | 代表作 | 定位 |
|---|---|---|---|
| 国际巨头 | NVIDIA | DreamZero、Cosmos 3、Cosmos Policy | 基座工业化:视频基座通吃世界模型/合成数据/策略 |
| 图像生成厂商 | Black Forest Labs | FLUX 3 Action | 把图像生成栈的蒸馏手艺平移到具身 |
| 具身创业 | GigaAI | GigaWorld-Policy、GigaWorld-0 | 动作为中心的因果WAM + 合成数据引擎 |
| 具身创业 | Robbyant(蚂蚁) | LingBot-VA / 2.0 | 自回归因果世界模型,长程记忆 |
| VLA头部 | Physical Intelligence | π0 / π0.5 | WAM时代的最强对照组与"被超越对象” |
| 高校(新) | 清华+生数+北大+地平线 | Motus | 统一五模式开山之作,latent action |
| 高校(新) | 清华(朱军/赵航) | Fast-WAM | 测试时想象可弃 |
| 高校(新) | 上交(姚望/穆瑶) | AHA-WAM | 异步双频24Hz |
| 高校(新) | NUS/清华/北大/港大/浙大/港中文/上交 | OpenWAM | 受控消融+46检查点开源基建 |
| 高校(新) | 港大+北大+清华(XPolicyLab) | RoboDojo | 仿真+真机统一基准,ECCV26挑战 |
| 中国大厂 | 腾讯Robotics X、小米、美团 | Hy-Embodied、Xiaomi-Robotics、Meituan-Robotics | 榜单第一集团(多为VLA口径) |
| 移动操作 | ABot团队 | ABot-M0/M0.5 | WAM从桌面走向移动本体 |
| 驾驶分支 | SimWAM/ReWorld/DriveFuture等 | 世界模型当教师/表征 | 方法论跨域搬运(本地有系列精读) |
一个结构性观察:这份名单里中国团队占比超过一半,且在"基准与基建”(RoboDojo、OpenWAM、生数、GigaAI)这一层的布局密度高于"单点模型"层——这与VLA时代以美欧创业公司为主导的格局明显不同。
十、趋势与判断
- 训练时建模全面取代测试时想象。Fast-WAM、GigaWorld-Policy、ABot-M0 一代已把"推理时跑视频扩散"扫进了历史;Rift 证明连"显式rollout未来缓存"都可以用学习式token替代。视频监督的价值留在梯度里,不留在推理图里。
- 速度军备竞赛进入"对齐π0.5"阶段。190ms(Fast-WAM)、225ms(GigaWorld)、单步蒸馏38.3(F3A)、24Hz(AHA-WAM)——“和最强VLA同速"成为WAM发布的基本门槛,慢4倍的方案(自回归全量视频)正在退守长程任务细分市场。
- 开源基建成为胜负手。OpenWAM一次放出46个检查点、RoboDojo提供统一评测协议、LingBot接入LeRobot——可复现性正在从论文附件变成赛道基础设施。闭源报告(F3A、DreamZero)与开源阵营的拉锯会长期存在。
- 基准正在变难,且"跨基准不可比"是常态。LIBERO逼近饱和(97-99)后被 Plus 与 RoboDojo 接棒;RoboDojo 的 Open/Memory 维度全场个位数,是下一个值得投入的攻坚方向。引用任何"XX提升Y%“都必须同时引用基准与协议。
- 统一性与专用性的钟摆。Motus/LingBot/OpenWAM-α赌"一个模型多种模式”,GigaWorld-Policy/FLUX 3 Action赌"动作为中心的专用设计”——两派在各自主场都赢了,说明统一性红利在分布外,专用性红利在分布内。
- latent action 是数据飞轮的轴心。光流delta(Motus)、共享语义空间(LingBot-VA 2.0)、统一动作空间(OpenWAM)三条路线殊途同归:让万亿级无标注视频为动作监督供血。这条线的上限可能比架构创新更高。
- 赛道从操作外溢到全本体。移动操作(ABot)、驾驶(SimWAM/ReWorld)、全模态基座(Cosmos 3 五模态)、甚至递归自我改进(PhysicalRSI 命名疑似相关)——“世界+动作"的耦合是跨域通用的,操作只是第一个打穿的战场。
十一、自测5问
- WAM一定比VLA强吗?——不一定。RoboDojo 8月快照前15里VLA占11席;WAM的优势(泛化、记忆、数据复用)要在一个扰动+长程+开放的协议下才显形,且要支付延迟税。
- 为什么各家自报的数字不能横比?——基准(LIBERO vs RoboTwin vs RoboDojo)、演示数据量、蒸馏与否、评测协议(clean/randomized/easy/hard)四个维度都可能不同;跨表比较前先对齐口径。
- WAM推理时必须生成视频吗?——2026年下半年的答案是"不必须”:训练时共训+因果mask(GigaWorld)、训练用推理弃(Fast-WAM)、anticipation token(Rift)三条路都成立;视频生成降级为训练监督或可选调试功能。
- 我做 Flow-GRPO/MOT 动作专家,怎么切入WAM?——三个切入点:①世界模型当教师的稠密监督(驾驶侧SimWAM路线,与Flow-GRPO天然兼容);②动作专家的少步蒸馏与日志蒸馏(F3A配方);③MoT双专家的信息流设计(OpenWAM消融结论:显式世界→动作流+联合去噪)。
- 怎么跟住这个领域?——盯三个信源:RoboDojo官方榜(带时间戳)、arXiv cs.RO 的 WAM 关键词(2609.16074综述做地图)、OpenWAM与LingBot的开源仓库(可跑的真相)。
十二、参考与延伸阅读
一手论文与报告(按引用顺序):
- 综述:World-Action Models for Robot Learning and Control: A Survey(2609.16074);WAM短教程(2607.00836)
- Cosmos Policy:2601.16163(ICLR 2026)|代码 NVlabs/cosmos-policy|Cookbook 配方
- DreamDojo:2602.06949(ICML 2026)|项目页 dreamdojo-world.github.io
- DreamZero:2602.15922|Motus:2512.13030(CVPR 2026)|Cosmos 3:2606.02800
- GigaWorld-Policy:2603.17240|Fast-WAM:2603.16666|Rift:2608.11521
- AHA-WAM:2606.09811|X-WAM:2604.26694
- LingBot-VA:2601.21998(RSS 2026)|LingBot-VA 2.0:2607.08639
- OpenWAM:2609.07398|PatchWAM:2609.25961|ABot-M0.5:2607.00678
- 鲁棒性研究:2603.22078
- RoboDojo:官方仓库(ECCV 2026挑战:Safe World Models for Trustworthy Embodied AI)
- FLUX 3 Action:BFL官方报告(无arXiv编号)
站内延伸(全部有逐图精读):
- VLA全景:前沿VLA模型全景速览|世界模型底座:什么是世界模型|驾驶世界模型:驾驶世界模型全景详解
- 本文主角的深挖:FLUX 3 Action精读、Cosmos 3精读、GigaWorld-0数据引擎精读、ABot-M0.5精读
- 高校WAM分支:BrainWAM精读、Percept-WAM精读、SimWAM精读、ReWorld精读
- 入门与背景:具身智能入门指南
信息来源说明:本文调研以 arXiv 原文、官方技术报告、官方排行榜为一手来源;微信公众号等二手转述未直接采信(写作环境无法访问微信文章正文)。榜单数据均标注了快照时间;如需引用某个具体分数,请回查对应官方页面的时间戳。