📄 论文信息
- 标题:$π_{0.5}$: a Vision-Language-Action Model with Open-World Generalization
- 团队:Physical Intelligence(PI),Kevin Black、Noah Brown、James Darpinian 等 36 位作者;Chelsea Finn、Sergey Levine、Karol Hausman、Brian Ichter、Quan Vuong 等在列
- 发表:arXiv 2504.16054v1 [cs.LG],2025-04-22,arXiv 非独占许可
- 关键词:两级推理(hierarchical inference)、co-training 混合训练、FAST 离散动作 + Flow Matching 连续动作、开放世界泛化、移动操作
- 一句话总结:在 π0 的「VLM + Flow Matching 动作专家」骨架上,加了三件事——先训离散再加连续动作头的两阶段配方、「先想子任务再出动作」的两级推理、机器人数据 × 网页数据 × 高层语义标注的混合 co-training——第一次让端到端策略在训练没见过的真实家里完成 2~5 分钟的多阶段清洁任务。
配图说明:本文摘录了论文全部 20 张插图(Fig 2 ~ Fig 18,含子图)放进站内 /images/pi05/,逐张讲解;文末附图表总索引表。
📌 读前 5 分钟:四个前置概念
不熟悉具身方向的读者,先记住这四个词(详见《具身智能入门指南》):
- VLA:看图像 + 听指令直接输出机器人动作的端到端策略;π0.5 就是一个 VLA。
- 动作块(action chunk):一次输出未来 50 步动作(本文 H=49,即 50 步),而不是一步一算——降低推理频率、平滑轨迹。
- FAST 与 Flow Matching:动作的两种「写法」。FAST 把动作压缩成离散 token(像分词一样,训练快);Flow Matching 把动作当连续向量场迭代去噪生成(推理快、精度高)。π0.5 的核心架构创新就是两阶段把两种写法塞进同一个模型。
- co-training:机器人数据和网页图文数据(描述、问答、检测框)混在一起训同一个模型——这是 π0.5 泛化能力的来源。
🎯 一句话版本
π0.5 = π0 的骨架 + 一个「会先想后做」的两级推理头 + 一套「先离散后连续」的两阶段训练法 + 一大锅网页数据。
- 架构:2B 级 PaliGemma VLM 骨干(SigLIP 400M + Gemma 2.6B)+ 300M Flow Matching 动作专家,共用一个 Transformer,用注意力掩码划定各自的地盘;
- 两级推理:同一个模型先输出高层子任务(“pick up the pillow”),再以子任务为条件输出低层动作——把长程任务的「想」和「做」解耦到同一张网络的两次前向;
- 训练:预训练 280k 步全用离散 token(动作也走 FAST),后训练 80k 步挂上随机初始化的动作专家、用 Flow Matching 继续训(α=10);
- 结果:在训练没见过的 3 个真实家庭的厨房/卧室里,完成「放抽屉、洗碗池、洗衣篮、铺床」等 2~5 分钟多阶段任务,配方消融和高层推理消融每拆掉一块都明显掉点。
🧠 架构总览:先把 Fig 3 读透
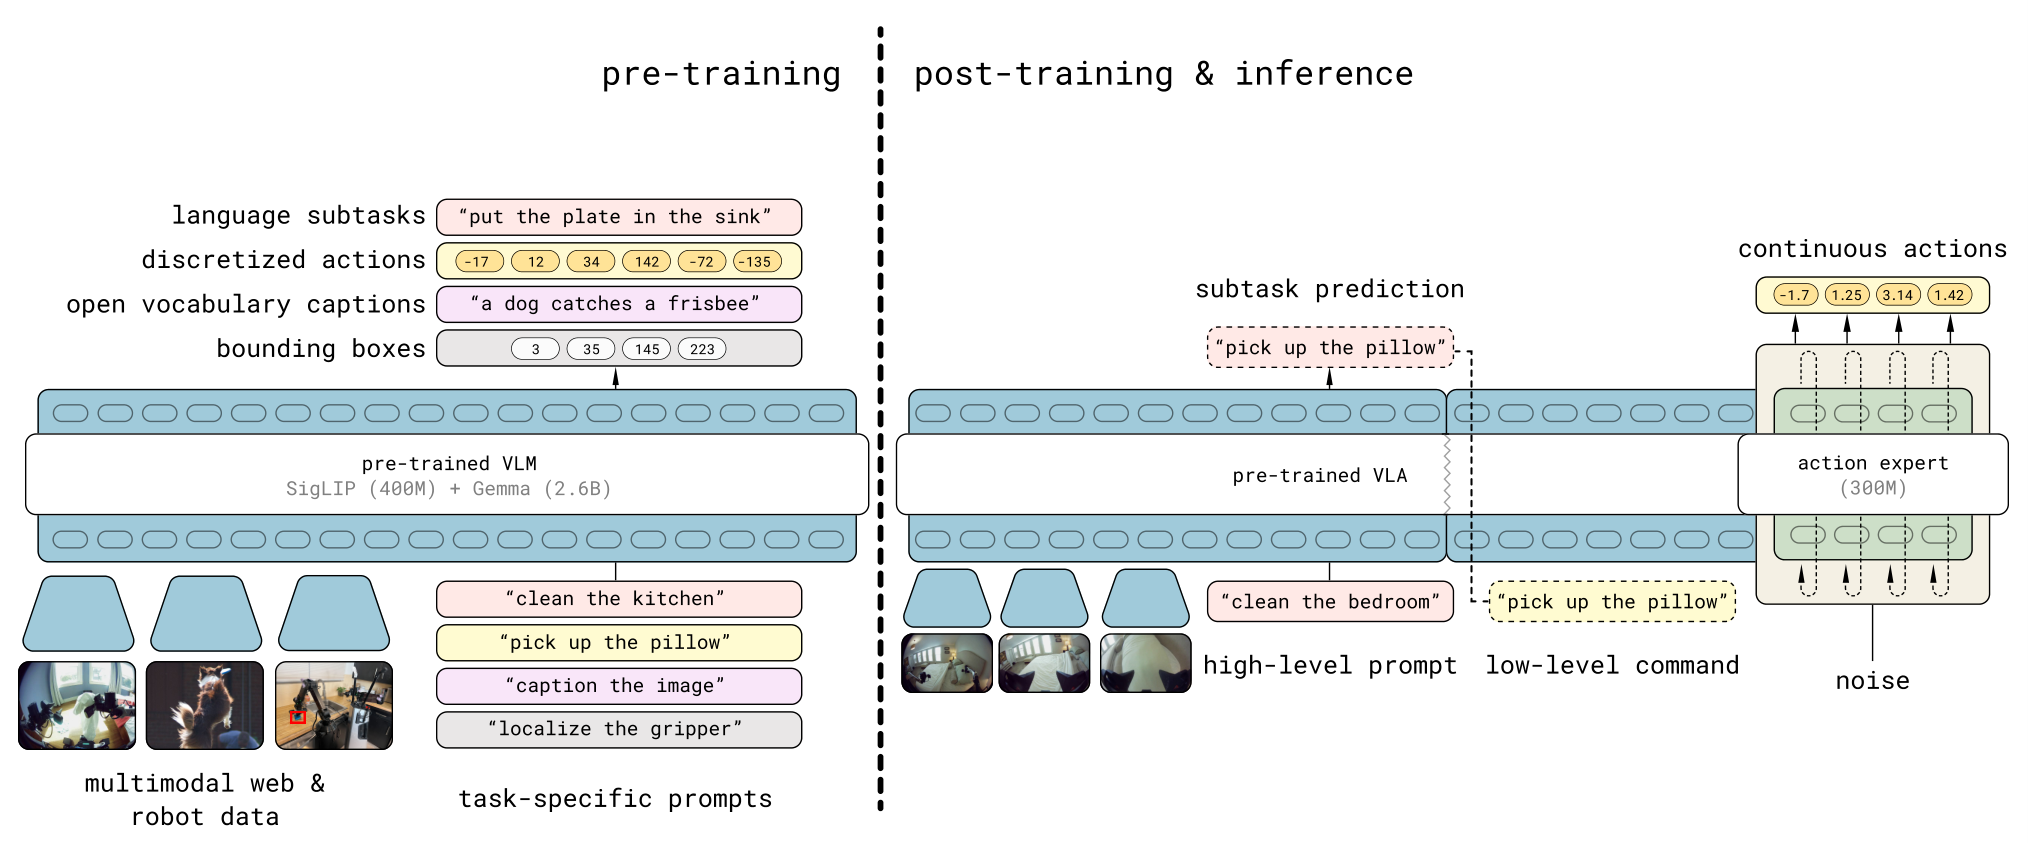
Fig 3 是全文的题眼,左右两半正好对应训练的两个阶段。逐栏拆解:
左半:pre-training(预训练)
- 底部输入:三路图像(网页图 + 机器人相机帧,示意为狗接飞盘、街景、带红框的机械臂)+ task-specific prompts——四种提示词对应四类任务:
"clean the kitchen"(机器人任务)、"pick up the pillow"(高层子任务)、"caption the image"(图像描述)、"localize the gripper"(目标定位)。一个 prompt 决定这次前向干什么,这就是 co-training 的实现方式:数据集混在一起,靠提示词区分任务。 - 中间骨干:pre-trained VLM = SigLIP(400M 视觉编码器)+ Gemma(2.6B 语言模型),从现成 VLM 初始化。
- 顶部输出(全部是离散 token):
language subtasks:“put the plate in the sink”(高层子任务文本);discretized actions:-17, 12, 34, 142, -72, -135——动作被 FAST 分词器编成了普通 token,和文字一样走自回归预测;open vocabulary captions:“a dog catches a frisbee”(网页数据);bounding boxes:3, 35, 145, 223(检测框坐标,也是 token)。
预训练阶段没有动作专家,一切都是 next-token prediction——这就是论文说的「以简单、可扩展、高效的方式把模仿学习变成文本预测」。
右半:post-training & inference(后训练与推理)
- 底部输入:机器人相机帧 + high-level prompt
"clean the bedroom"; - subtask prediction:骨干先自回归吐出子任务
"pick up the pillow",虚线回环把它作为 low-level command 再喂回模型——这就是两级推理的第二步输入; - 右侧 action expert(300M):贴在骨干尾部的独立小 Transformer,吃
noise,迭代 10 步 Flow Matching 去噪,输出continuous actions:-1.7, 1.25, 3.14, 1.42——同一行虚线穿过骨干与专家,表示注意力连接(骨干的表征通过注意力喂给专家,详见 Fig 18); - 注意右半骨干标注的是 pre-trained VLA(不再是 VLM)——预训练权重 + 后训练的动作专家与高层数据,共同构成了推理期的完整 π0.5。
架构的形式化(论文 IV-A 节)
模型建模的分布是:
pi_theta(a_{t:t+H}, l_hat | o_t, l) = pi_theta(a_{t:t+H} | o_t, l_hat) * pi_theta(l_hat | o_t, l)
o_t = [I^1_t, ..., I^n_t, q_t]:所有相机图像 + 本体状态(关节角、夹爪位姿、躯干升降、底盘速度——本体状态被离散化后当文本 token 输入);l:总指令(“put away the dishes”);l_hat:模型的文本输出——要么是高层子任务,要么是网页问答的答案;a_{t:t+H}:动作块。
关键分解:动作分布不依赖总指令 l,只依赖子任务 l_hat。也就是说"收拾厨房"这种大局由高层推理消化,低层动作头只管执行"把盘子放进水槽"——两级各自受益于不同的数据(低层吃跨机器人动作数据,高层吃网页语义数据和人类口头指令)。
模型本体是一个 Transformer:y_{1:N} = f(x_{1:N}, A(x_{1:N}), ρ(x_{1:N}))——输入 token 按类型 ρ 路由到不同编码器(图像走 SigLIP、文本走嵌入表、动作线性投影),注意力矩阵 A 决定谁能看谁(Fig 18 讲这个)。输出劈成两半:前 M 个文本 logits + 后 H 个动作专家输出(M + H ≤ N,不是所有位置都算损失)。
硬件规格表(附录 A-E):
| 组件 | 规格 | 说明 |
|---|---|---|
| VLM 骨干 | width 2048 / depth 18 / mlp 16384 / 18 头 / head_dim 256 | 论文称 2B 级,PaliGemma 初始化(Fig 3 标注 SigLIP 400M + Gemma 2.6B) |
| 动作专家 | width 1024 / mlp 4096,同深度同头数 | 300M,约为骨干的 1/7,post-training 时随机初始化 |
| 动作块长度 | H = 49(共 50 步) | 50 Hz 直接下发目标位姿 |
| τ 注入方式 | 独立 MLP + 每层 adaptive RMSNorm | 与 π0 不同:π0 把 τ 和噪声动作拼在一起,π0.5 单独走一路 |
🔀 核心机制一:离散 + 连续的混合动作表示
这是 π0.5 相对 π0 最重要的工程决策,动机是一对矛盾:
| FAST 离散 token | Flow Matching 连续 | |
|---|---|---|
| 训练 | 快(压缩式分词,普通 next-token loss) | 相对慢(要采样 τ、回归流场) |
| 推理 | 慢(要自回归逐 token 解码,延迟高) | 快(10 步并行去噪,适合实时控制) |
| 精度 | 受分词压缩损失 | 连续高精度 |
理想的模型应该训练时享受离散的快,推理时享受连续的快。π0.5 的做法(论文 IV-B 节):
- 预训练阶段:动作全部走 FAST 离散 token,等价于 α=0 的标准 VLM 训练——简单稳定,还顺带保留了语言能力;
- 后训练阶段:挂上随机初始化的动作专家,同时优化两个损失(论文式 1):
E[ H(x_{1:M}, f^ell(o,l))                              # 文本(含FAST动作token)的交叉熵
   + alpha * || omega - a_{t:t+H} - f^a(a^{tau,omega}, o, l) ||^2 ]   # 动作专家的流匹配回归
其中 a^{τ,ω} = τ·a + (1−τ)·ω(ω 为噪声),α = 10.0,再训 80k 步;交叉熵那一项保证「文本预测能力不退化」。
- 两套动作表示靠注意力掩码隔离——FAST token 和动作专家互相看不见,避免信息泄漏。这就是下一张图。
Fig 18:注意力掩码——整张图怎么读
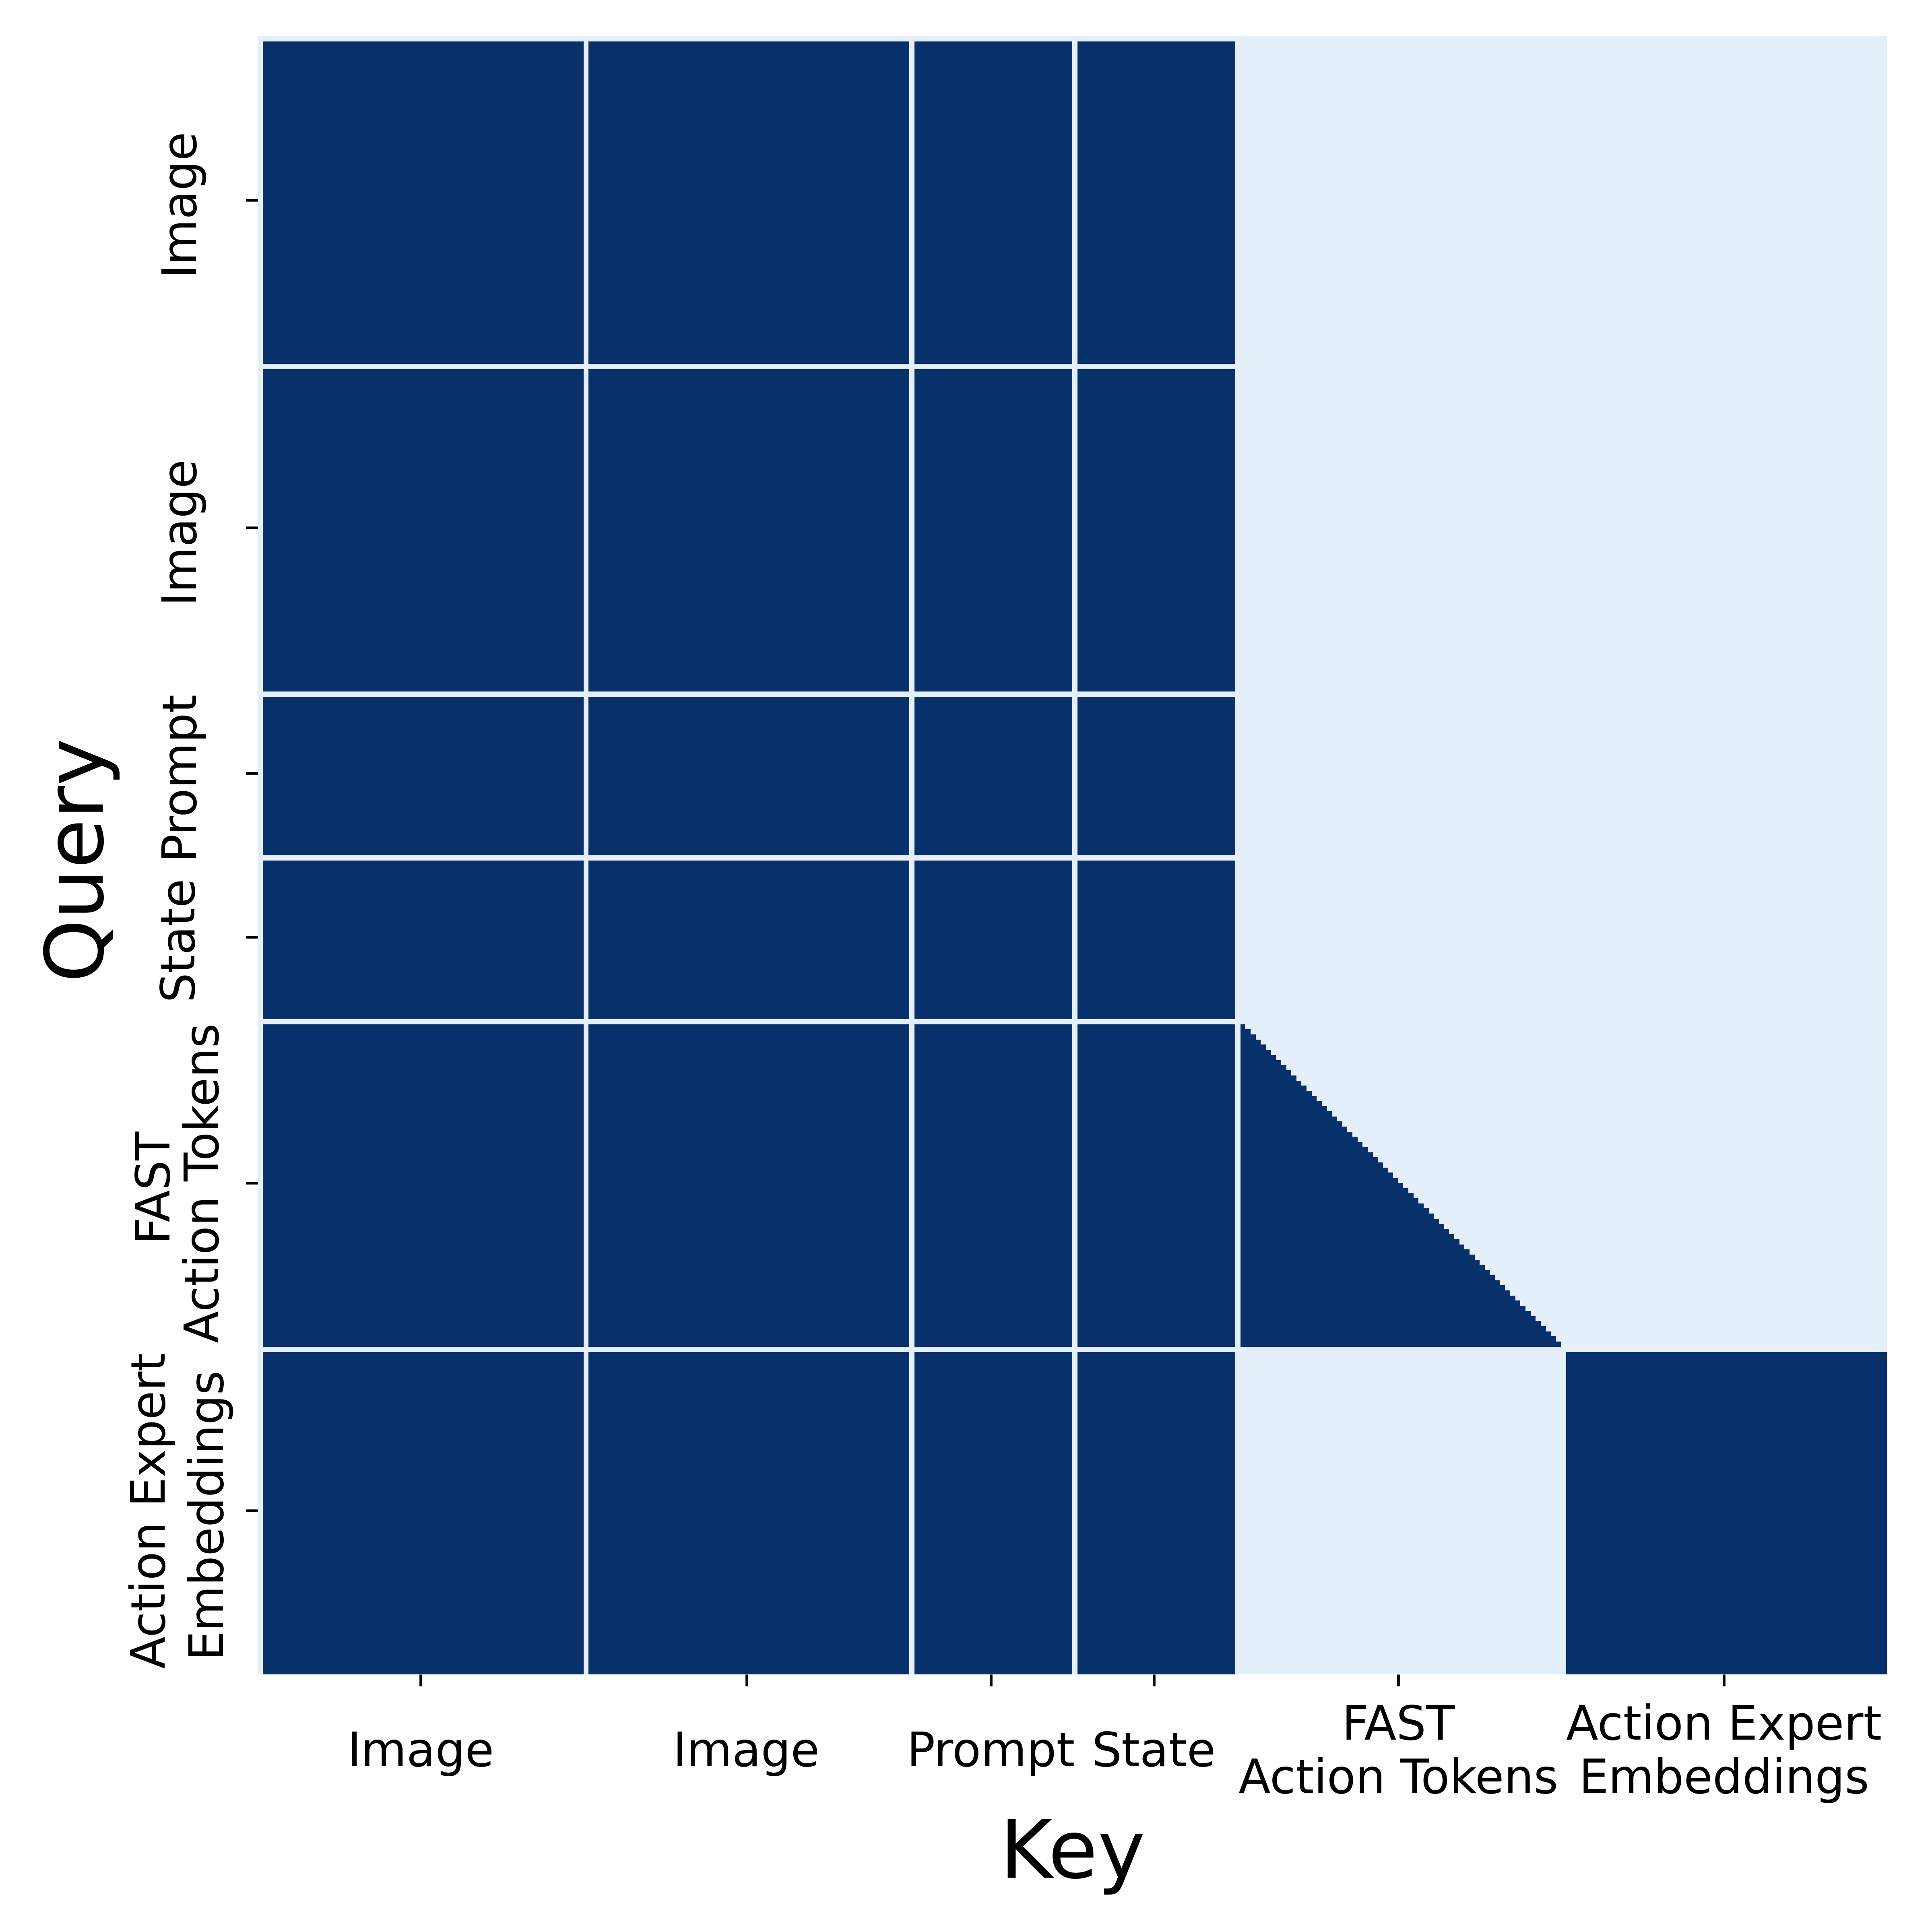
读图方法:横轴 Key(被看的)、纵轴 Query(发起看的),深蓝格 = 允许注意,浅色格 = 屏蔽。行按块从上到下是:Image、Prompt、State、FAST Action Tokens、Action Expert Embeddings。逐块读:
- 前缀块(Image / Prompt / State):对整个前缀全双向可见——图像块之间、图像看文本、文本看图像都行(注意:不是 LLM 的因果掩码,因为前缀是一次性给全的);但对 FAST 和动作专家两列全浅色 = 完全失明。
- FAST Action Tokens 行:前缀深蓝(看得见观测和指令),自身块是下三角——自回归生成,只能看之前的动作 token;对动作专家列浅色(看不见专家)。
- Action Expert Embeddings 行:前缀深蓝(专家读骨干表征——这就是 VLM→专家的信息通道),自身块全深蓝(专家内部是双向的,50 步动作一次并行去噪,不需要因果顺序);对 FAST 列浅色(两套动作表示互不干扰)。
- 反向不存在:前缀行对专家列全浅色 = 没有任何 VLM token 注意到动作专家。信息单向流动:骨干 → 专家,专家不污染骨干。
一句话:一个 Transformer 里住着两套居民,前缀是公共广场(双向开放),FAST 是排队买票(因果序),动作专家是内部会议(双向但只出不进),三者互不串门。
推理时怎么跑
输入: 4路/3路相机图 + 本体状态(离散化) + "clean the bedroom"
  └─ ① 高级推理: 自回归解码文本 → 子任务 "pick up the pillow"     [VLM骨干]
       └─ ② 把子任务拼回 prompt, 再次前向                          [VLM骨干]
            └─ ③ 动作专家接 10 步 Flow Matching 去噪              [300M专家]
                 → 连续动作块 a_{t:t+H} (50步, 50Hz下发)
                      └─ PD 控制器跟踪目标位姿 (无轨迹规划/无碰撞检测)
τ 的采样沿用 π0 的低时间步偏好:p(τ) = Beta((s−τ)/s; α=1.5, β=1),s=0.999——训练时偏向低 τ,配合推理期 δ > 1−s 的积分步长,最多支持 1000 步积分,实际只用 10 步。
🪜 核心机制二:两级推理——同一个模型「先想后做」
高层推理 π(l_hat | o, l) 和低层推理 π(a | o, l_hat) 是同一个模型的两次前向,不是两个模型的流水线。这样设计的好处:
- 长程推理:「打扫卧室」被自动拆成「整理毯子 → 捡起枕头 → …」,相当于机器人的 chain-of-thought;
- 各取所需的数据:低层吃跨本体动作数据(别的机器人采的也行),高层吃网页语义、检测框标注、人类口头指令演示(VI)——VI 是专家用语言「遥控」已训好的低层策略,逐步示范「好的子任务序列长什么样」,只占高层移动操作数据的 11%,但消融显示掉它显著变差;
- 相机分工:高层推理看全部 4 路相机(前后 + 双腕),低层只看腕部 + 前向相机(省算力,动作只需局部视野)。
对照消融(Fig 13)里最反直觉的一条:implicit HL(不做运行时高层推理、但训练时见过子任务数据)排第二,说明「子任务数据进训练配方」本身就贡献了大半收益;GPT-4 零样本当高层反而垫底——领域数据比通用大模型的零样本能力更值钱。
🤖 机器人系统:Fig 5
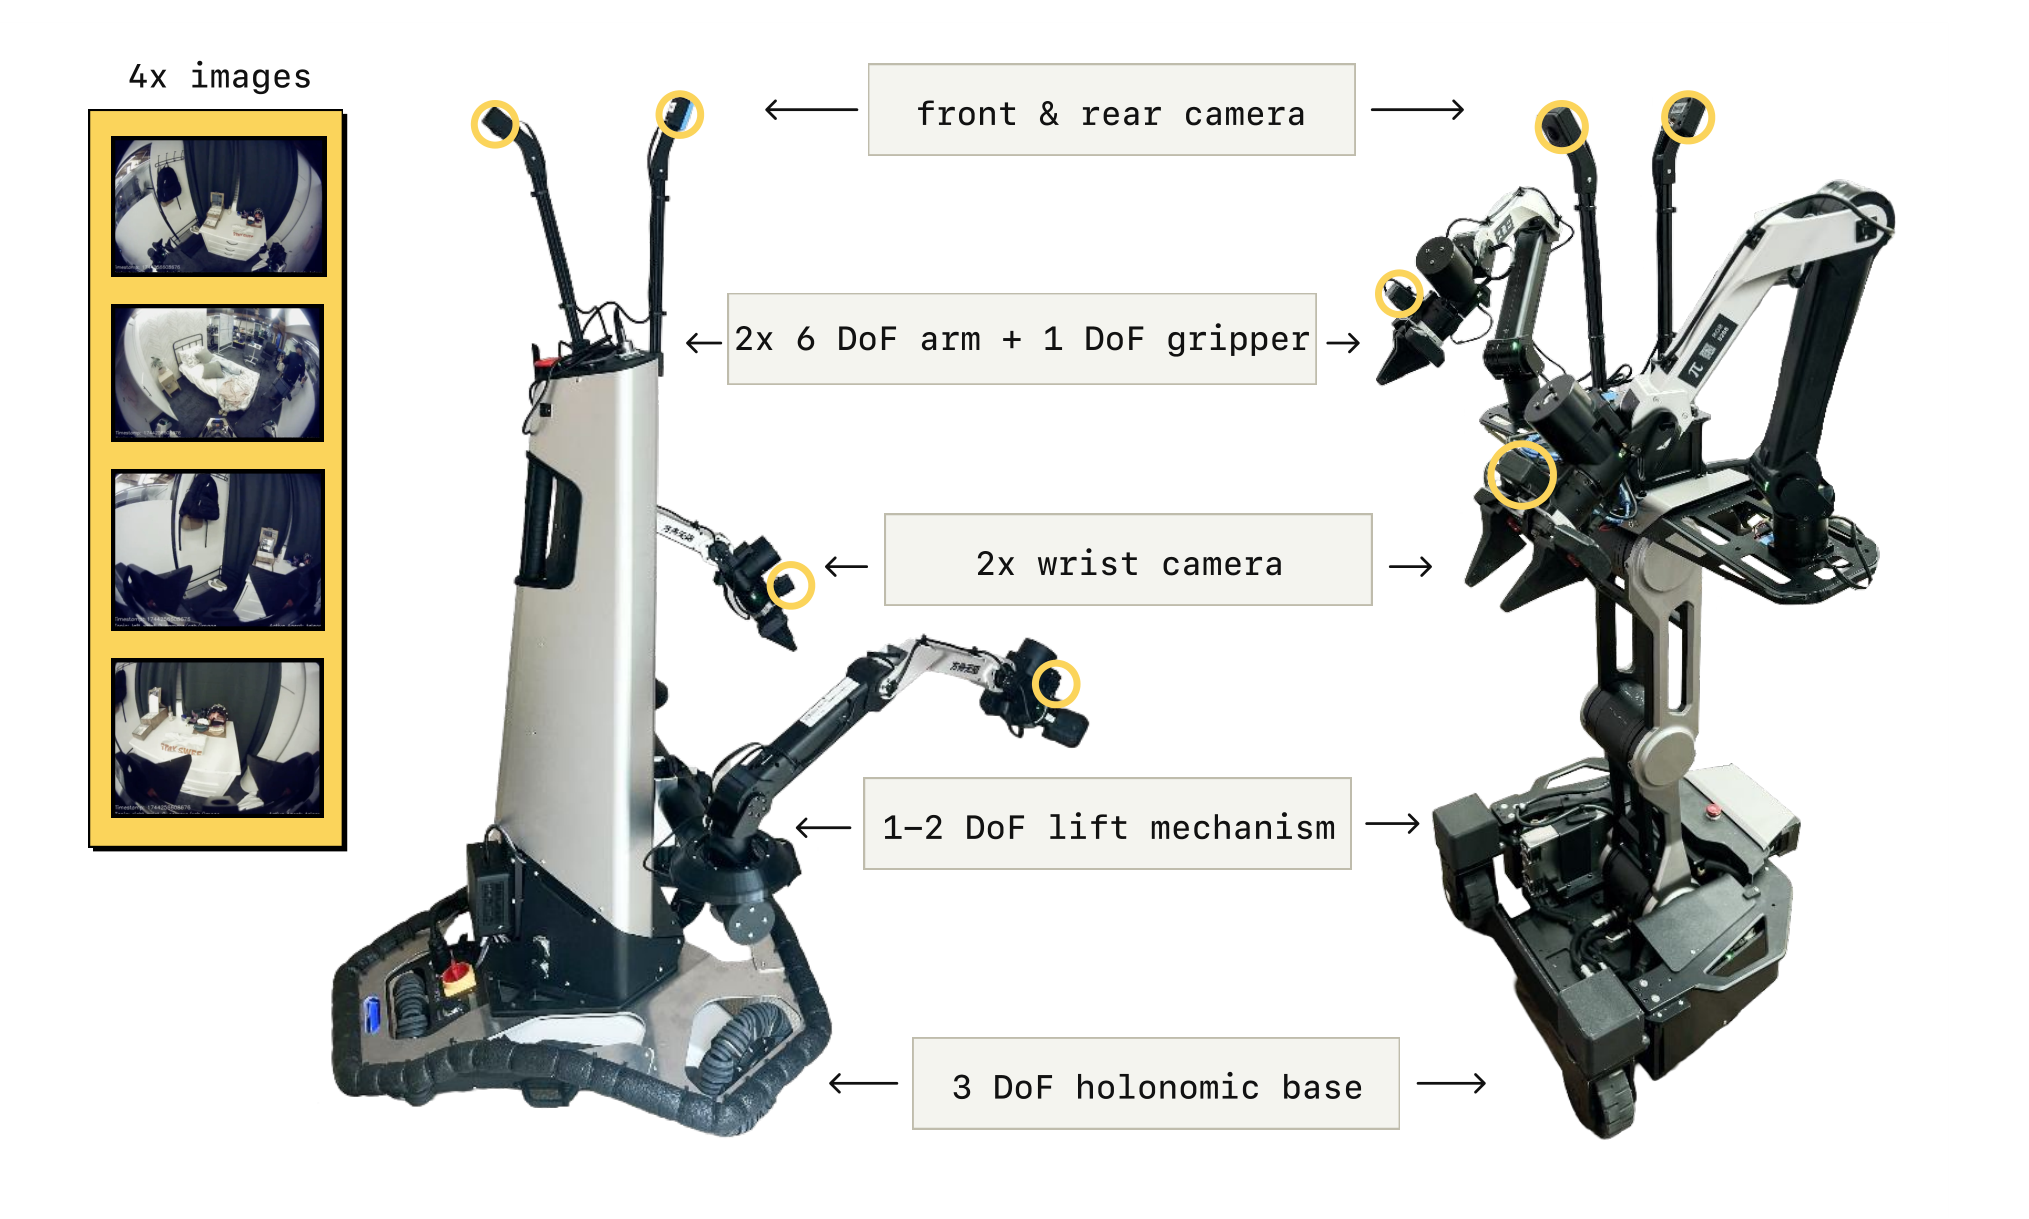
Fig 5 标注拆解(从上到下):
- 4x images:左侧黄色框展示四路鱼眼视角——前向、后向、左右腕部各一;
- front & rear camera:两根桅杆顶端的前后相机(黄圈标出);
- 2x 6 DoF arm + 1 DoF gripper:每只手臂 6 自由度 + 1 自由度平行夹爪;
- 2x wrist camera:手腕处的单目 RGB 相机(黄圈标出);
- 1–2 DoF lift mechanism:躯干升降(有的平台只升降,有的能升降+前后);
- 3 DoF holonomic base:全向移动底盘(线速度 x、y + 角速度,共 3 维)。
状态/动作空间合计 18~19 维(随平台略有差异)。控制极简:π0.5 直接在 50 Hz 下发手臂目标位姿、夹爪、升降位置和底盘目标速度,用 PD 控制器跟踪——没有轨迹规划器、没有碰撞检测,导航和操作全端到端。 这句话值得反复读:它说明 π0.5 的「智能」是真的长在策略网络里的,工程上只留了一层最薄的执行器接口。
📚 数据配方:Fig 4 逐栏讲解
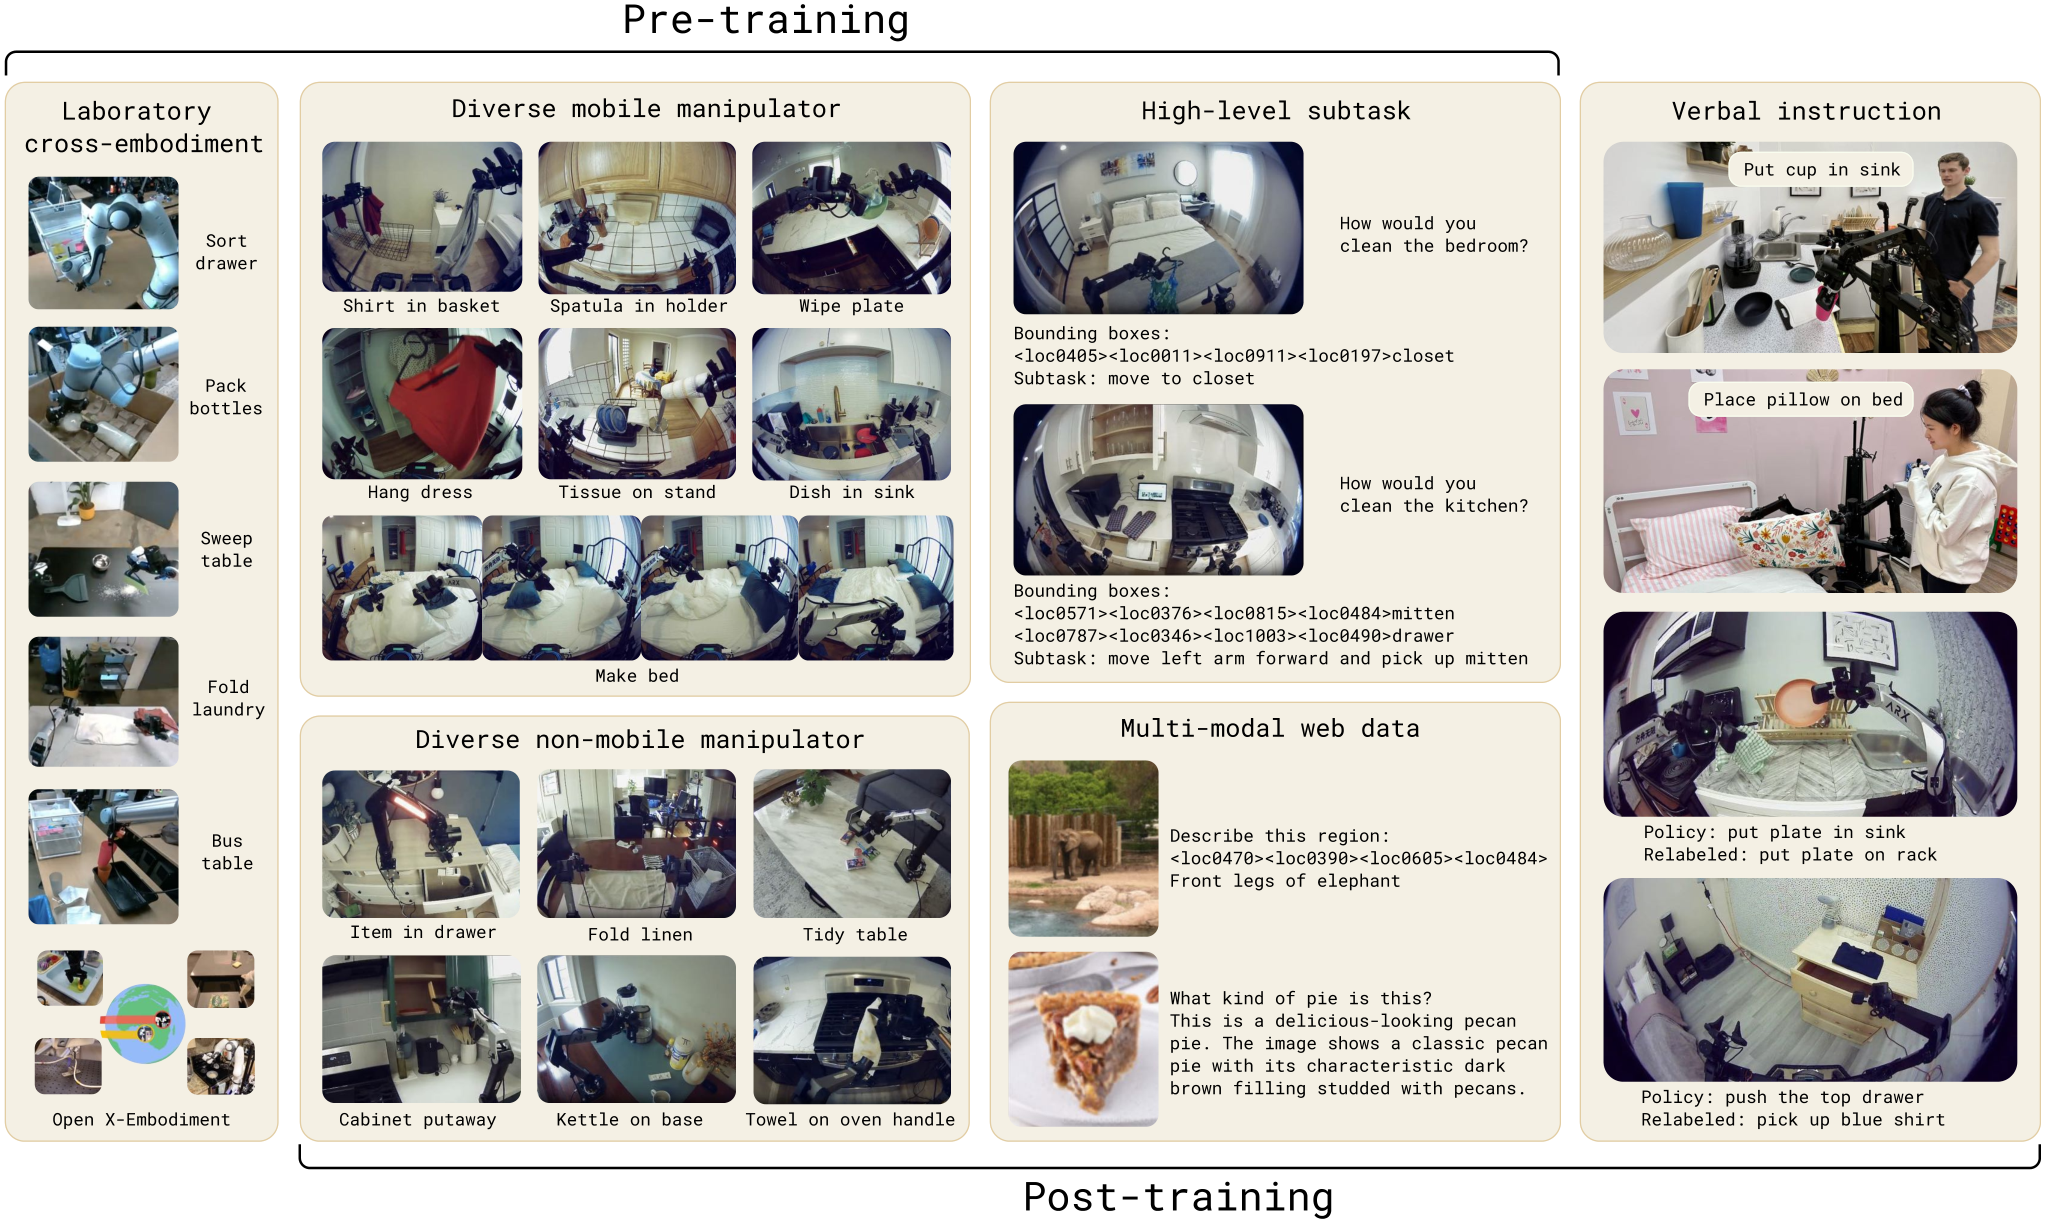
Fig 4 的读法:上方大括号 = Pre-training 覆盖的五类数据,下方大括号 = Post-training 也用的子集(多了 Verbal instruction,去掉了实验室 CE)。逐栏:
| 栏位 | 内容(图中示例) | 论文口径 |
|---|---|---|
| Laboratory cross-embodiment(CE) | Sort drawer、Pack bottles、Sweep table、Fold laundry、Bus table + Open X-Embodiment 图标 | 实验室桌面环境、多种机器人(单臂/双臂、固定/移动),π0 数据集的扩展版;后训练阶段被剔除 |
| Diverse mobile manipulator(MM) | Shirt in basket、Spatula in holder、Wipe plate、Hang dress、Tissue on stand、Dish in sink、Make bed(四帧床铺序列) | 约 400 小时、约 100 个真实家庭——最贴近评测任务的数据 |
| Diverse non-mobile manipulator(ME) | Item in drawer、Fold linen、Tidy table、Cabinet putaway、Kettle on base、Towel on oven handle | 固定臂在不同家庭采的数据——本体和 MM 不同,跨本体迁移的原料 |
| High-level subtask(HL) | 「How would you clean the bedroom?」→ 检测框 <loc0405>...closet + Subtask: move to closet | 对 MM/ME/CE 的多子任务数据人工标注语义子任务,并标检测框,训练「先报框、再报子任务、再出动作」 |
| Multi-modal web data(WD) | 大象区域描述(检测框定位)、核桃派问答 | CapsFusion/COCO 描述、Cambrian-7M/PixMo/VQAv2 问答 + 室内物体检测框扩展 |
| Verbal instruction(VI) | Put cup in sink、Place pillow on bed;Policy: put plate in sink → Relabeled: put plate on rack | 仅后训练:专家用语言逐步遥控训好的低层策略,示范「好的子任务序列」;含对已有轨迹的子任务重标注 |
训练两阶段的参数(论文 IV-C/IV-D 节):
- 预训练:280k 步,标准自回归 Transformer,预测文本、物体位置、FAST 动作 token(α=0);
- 后训练:80k 步,α=10.0,动作专家随机初始化;数据 = MM + ME(只留成功且不超长的 episode)+ WD(保语义)+ HL(多环境切片)+ VI;
- 动作归一化:按每个数据集各维度的 1%/99% 分位压到 [−1,1];动作维度按全集最大者定长,低维本体补零;提示词里加
joint/end effector区分预测关节位姿还是末端位姿。
🏠 实验:全部 14 张实验图逐张讲解
论文图号从 Fig 2 起(无 Fig 1)。所有实验都在训练没见过的环境里做,先看开胃菜和评测设置。
Fig 2:π0.5 在新厨房里打扫卫生
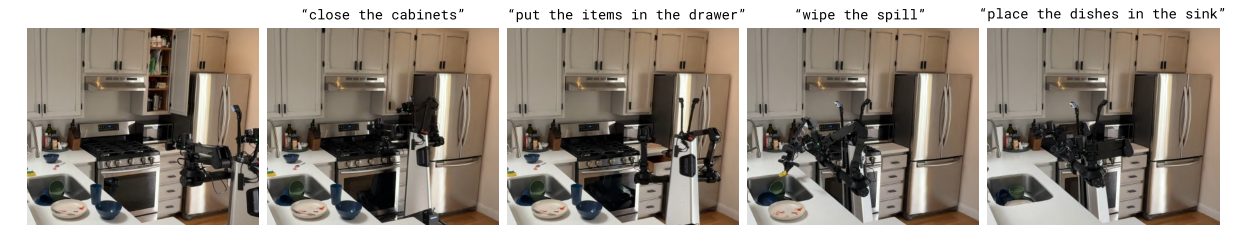
开篇演示图:任务是清洁一个训练数据里没有的家的厨房,指令是笼统的四条——关柜门、把物品收进抽屉、擦掉污渍、把碗放进水槽。每一帧下方蓝色小字是模型自己预测的高层子任务(如 “pick up the plate”)。这张图同时展示了两级推理在真实任务中的形态:人只给大局,子任务全是模型现想的。
Fig 6:评测环境设置
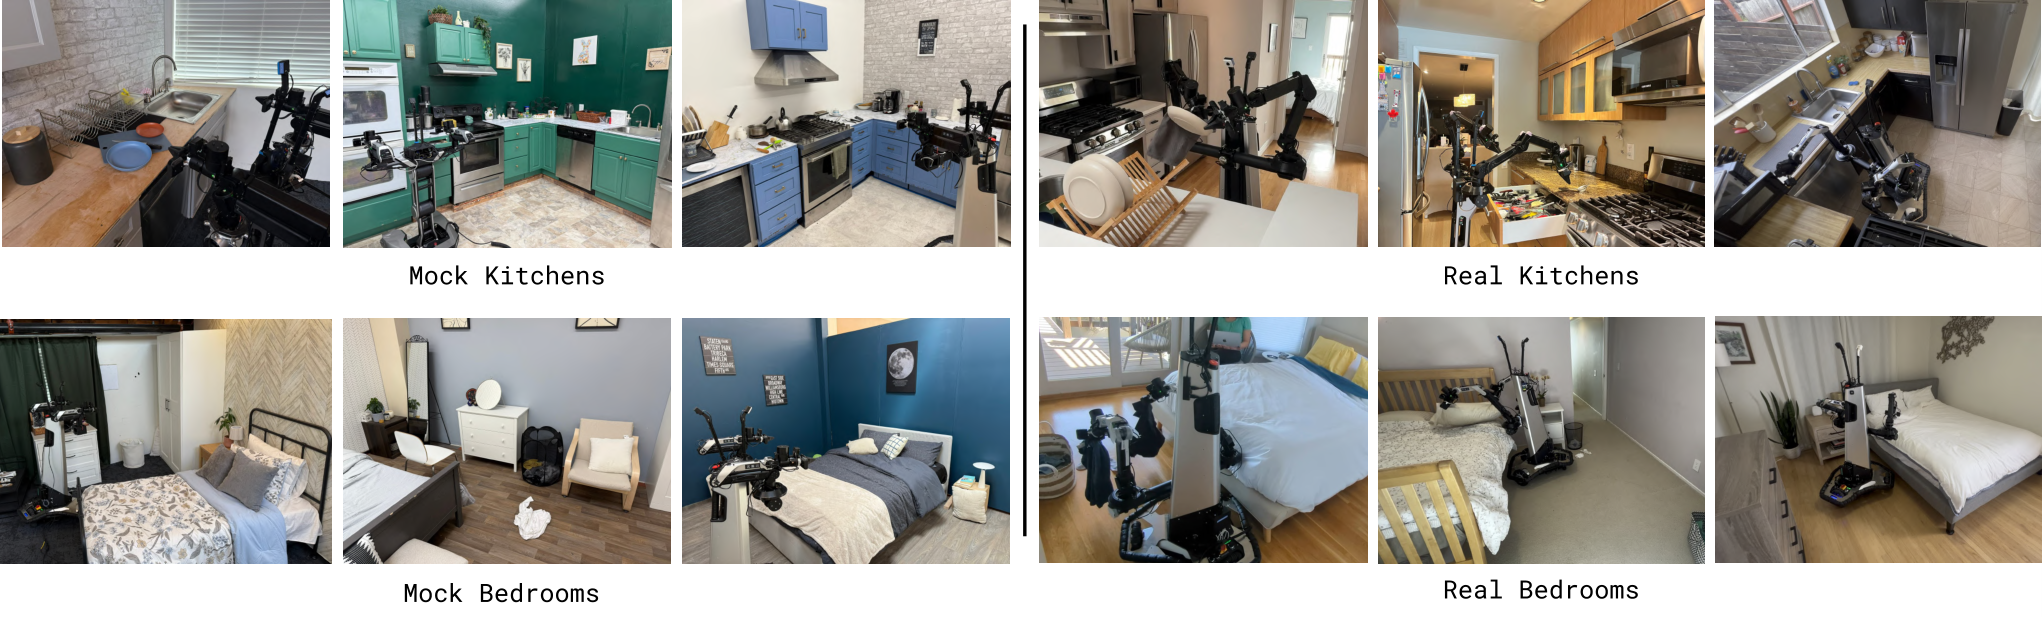
两类考场:左 = mock homes(可控、可复现的模拟房间,做定量对比);右 = real homes(3 个真实家庭,做最终检验)。物品、背景、布局全是训练没见过的。
Fig 7a:真实家庭评测——三个家庭的任务过程
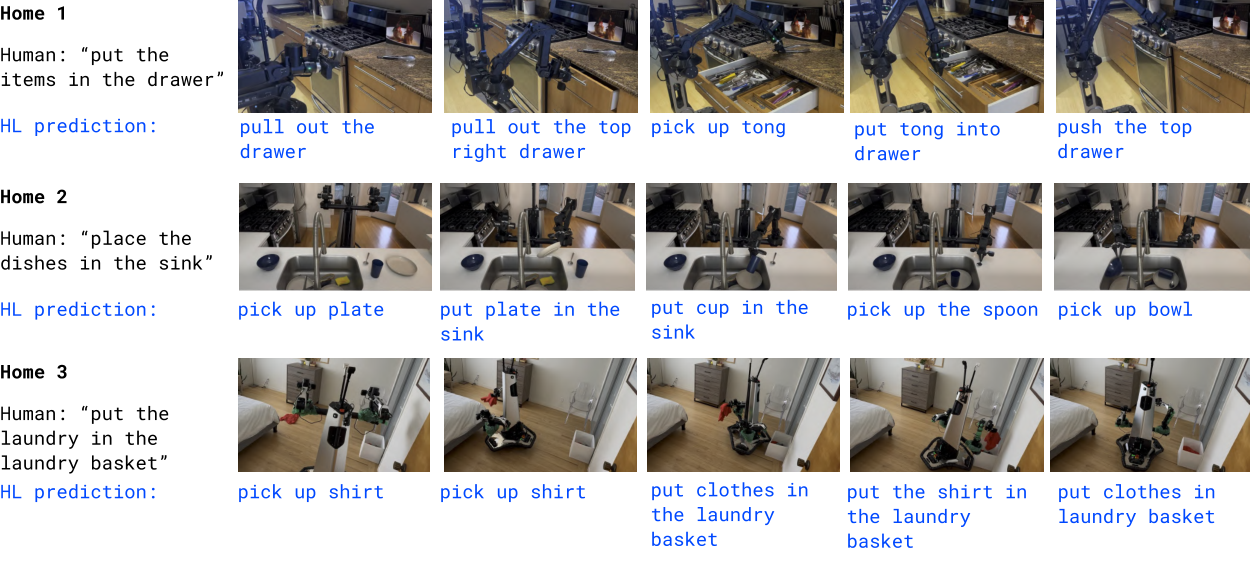
Fig 7a 是三条时间线胶片:Home 1 放物品进抽屉、Home 2 洗碗池收碗、Home 3 衣物进洗衣篮。左侧是人类指令,每帧下方蓝色字是 π0.5 的子任务预测。大多数任务 2~5 分钟、多个阶段,全程只给一条笼统指令。
Fig 7b:真实家庭评测——定量结果
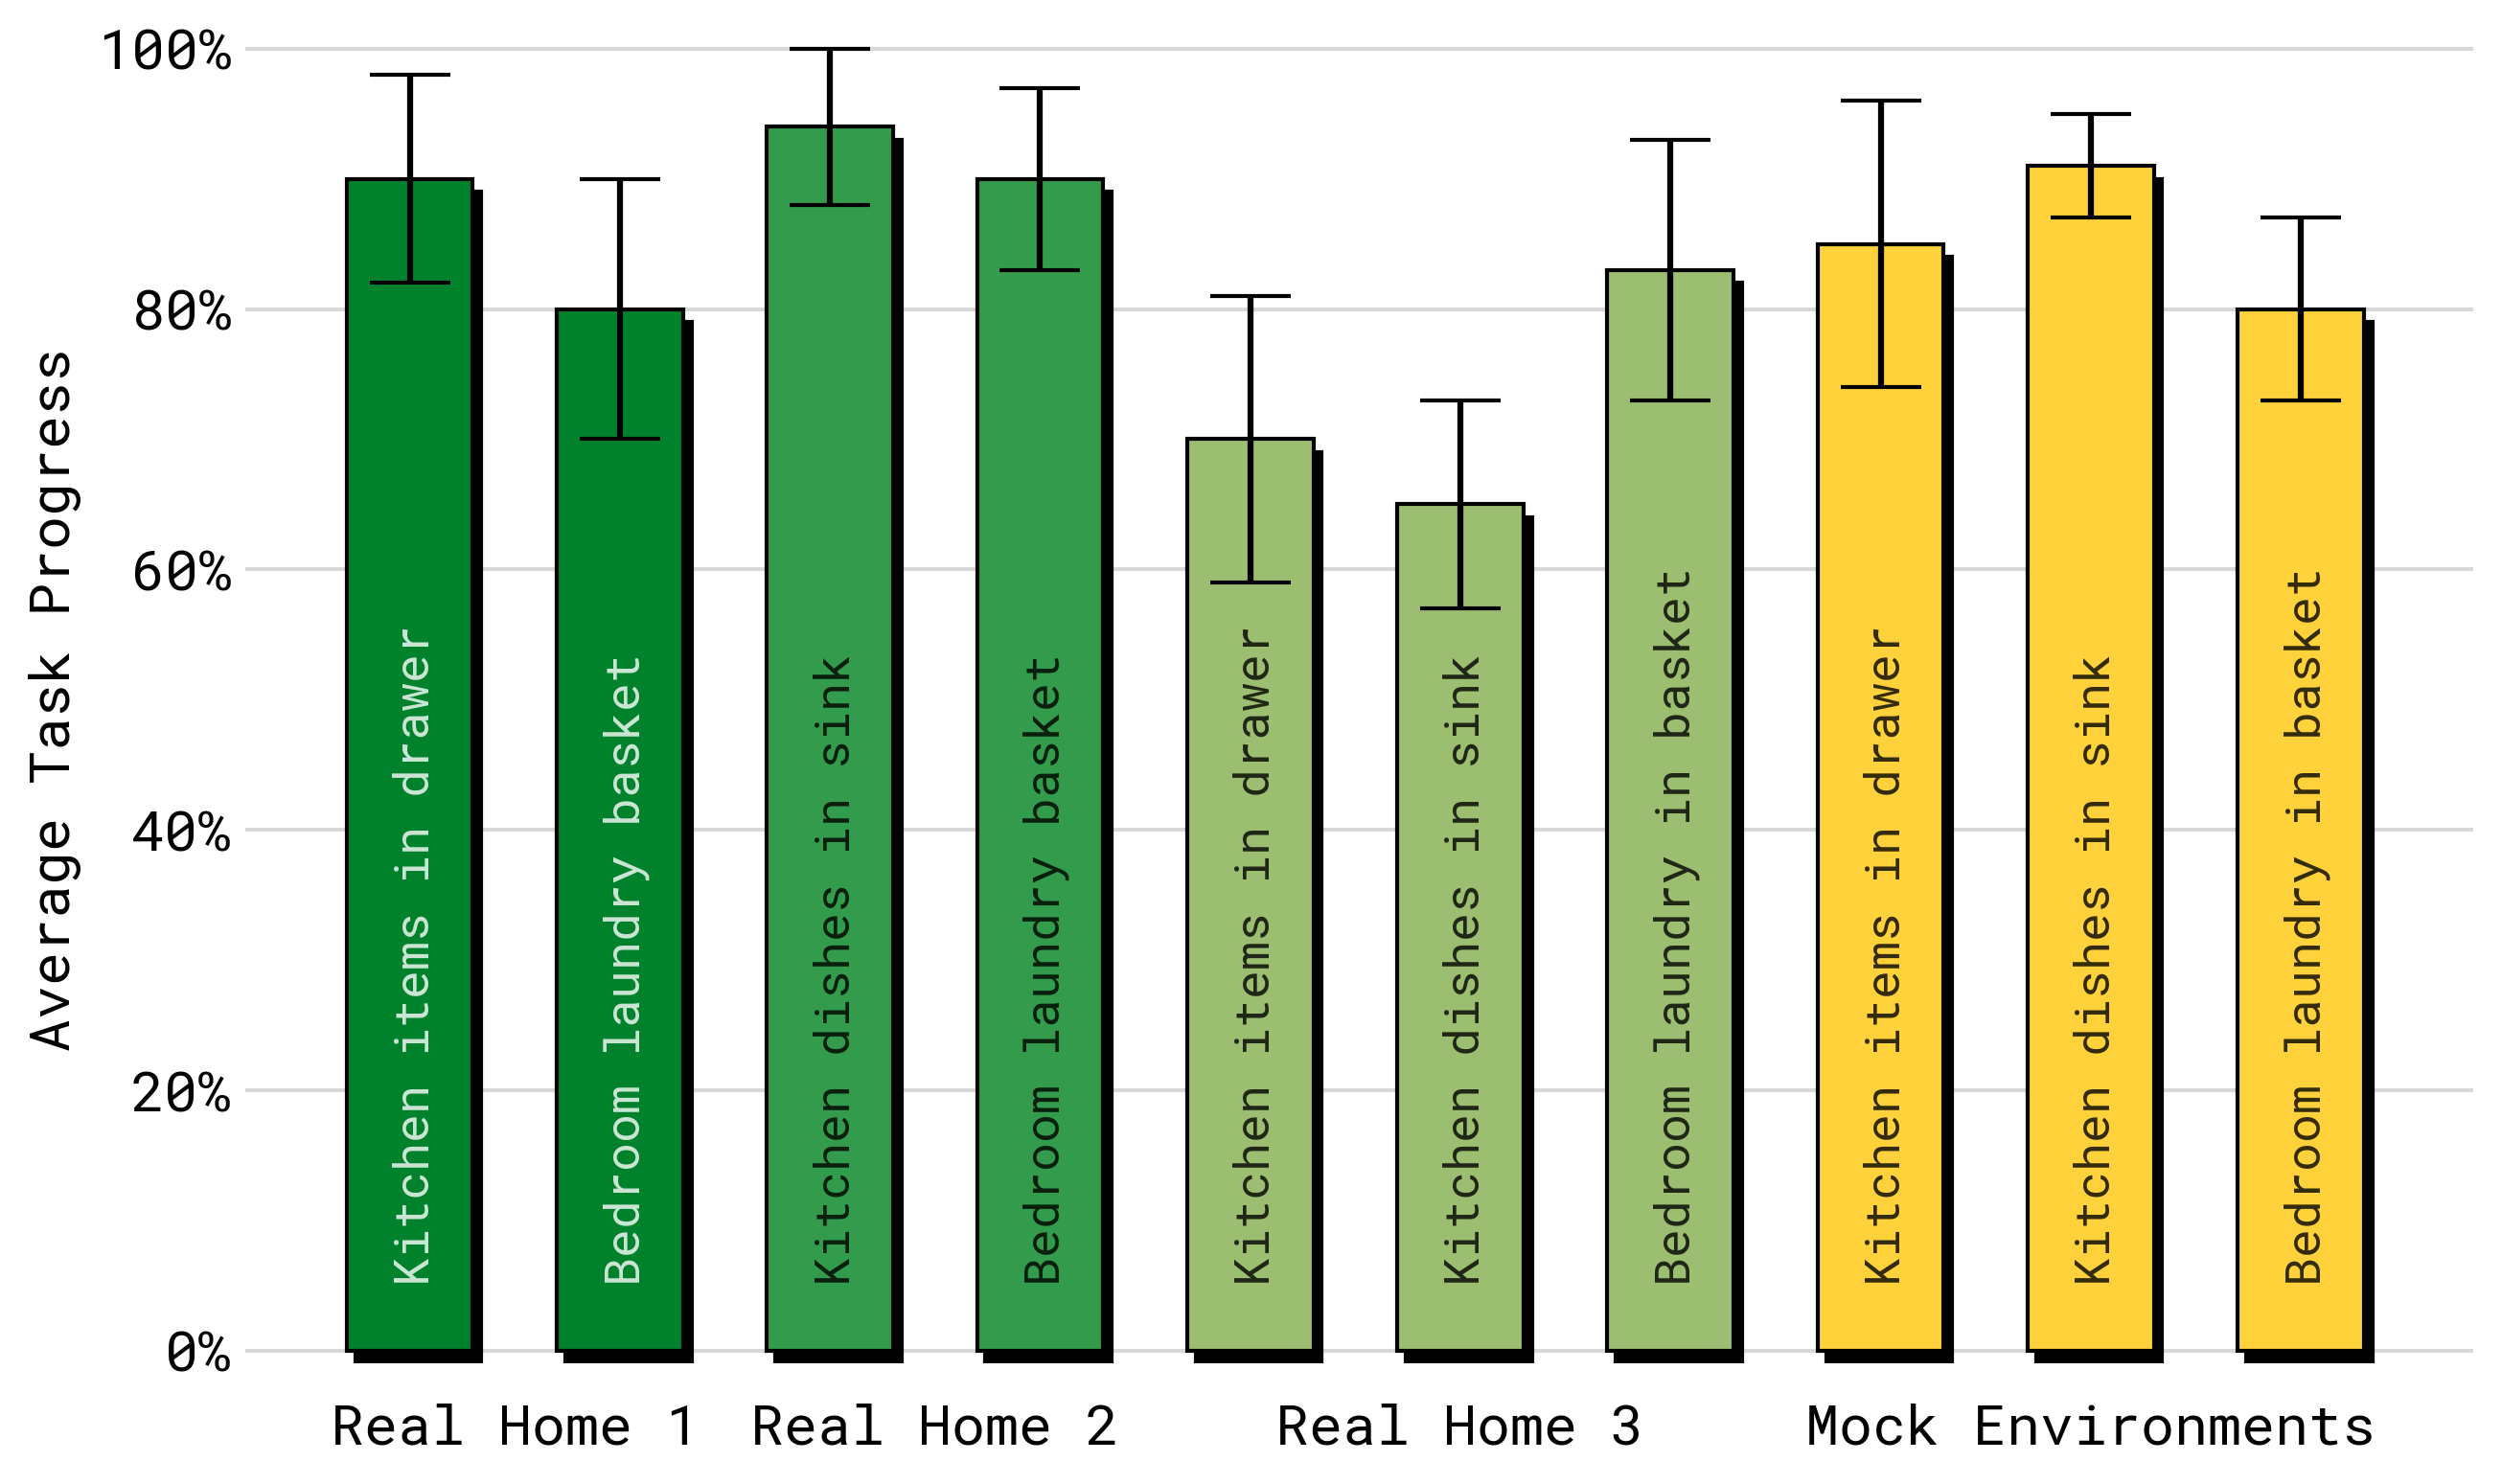
Fig 7b:每任务 × 每环境 10 次试验,纵轴是任务完成度(rubric 按步骤完成比例打分,比如一半碗进水槽 ≈ 50%)。关键结论:mock 环境里的成绩能代表真实家庭的表现——所以后面用 mock 做大规模定量实验是可信的。
Fig 8:泛化随训练环境数怎么涨(104 个地点的故事)
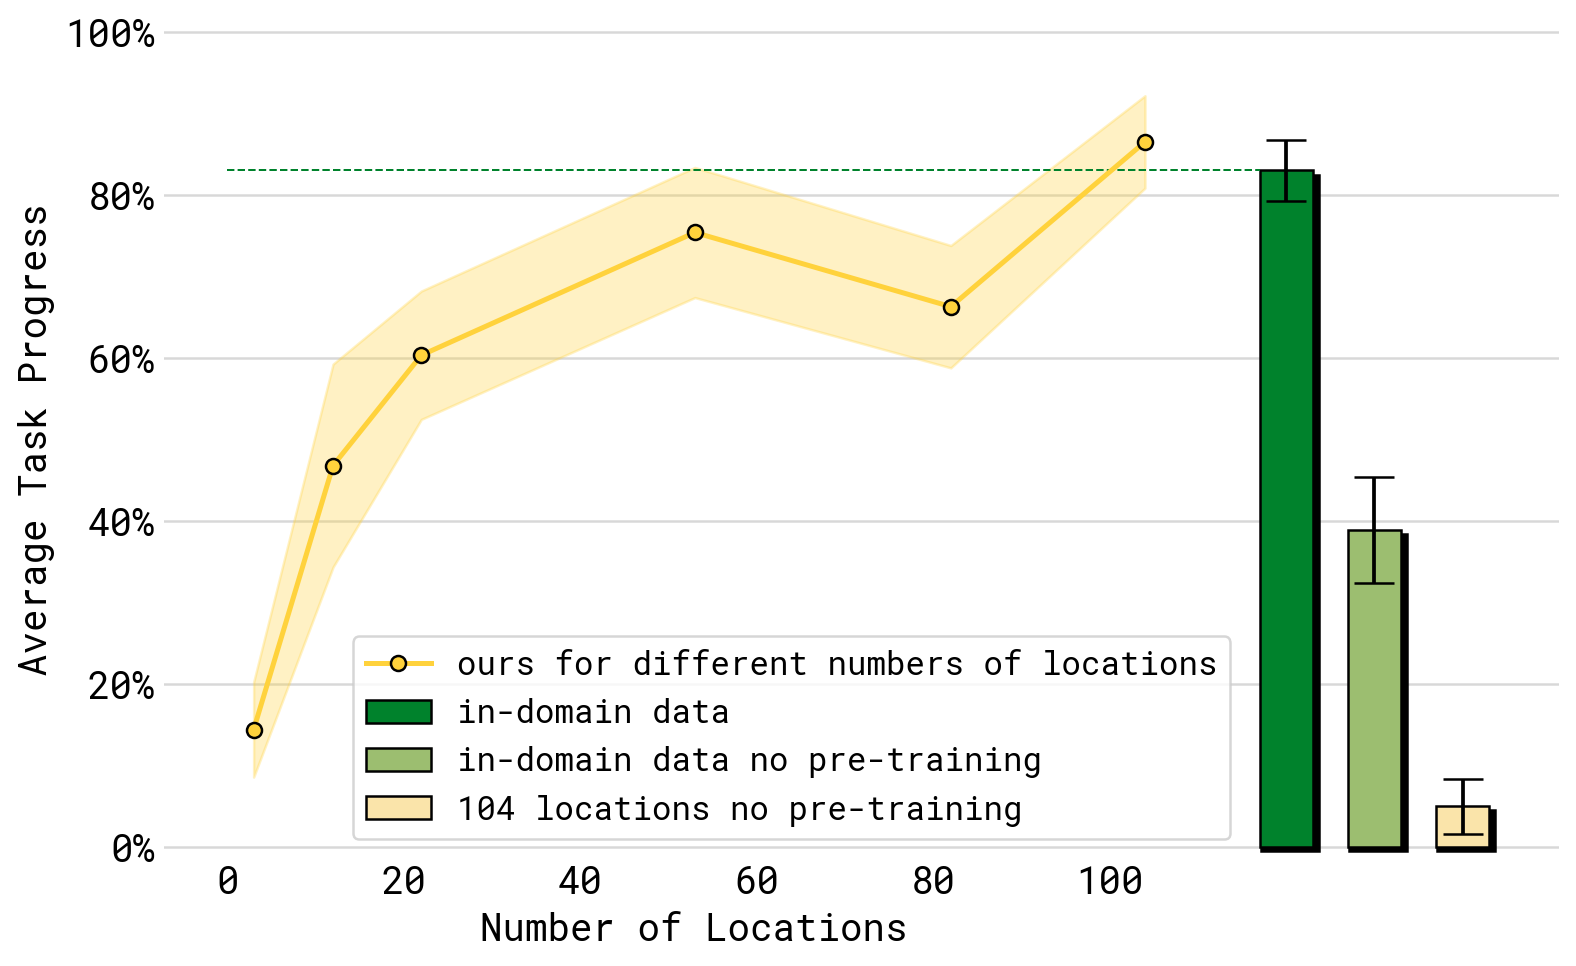
Fig 8 是全文最重要的实验之一:训练的移动操作数据从 3 → 12 → 22 → 53 → 82 → 104 个地点递增(每个模型都见同样多的数据样本,控制数据量),四个任务(放碗进水池、物品进抽屉、洗衣篮、铺床)的平均分随地点数稳步上涨。两条基线:
- 绿色实线:直接在测试家庭数据上训练的对照模型——104 地点模型追平了它,尽管从未见过测试家;
- 浅黄条:只用 104 地点机器人数据、不做其他 co-training 的模型——显著更差,哪怕它见过测试家庭数据(浅绿条)。
结论狠话:光堆机器人数据没用,co-training 配方才是泛化的本体。
Fig 9:语言跟随能力随地点数的变化
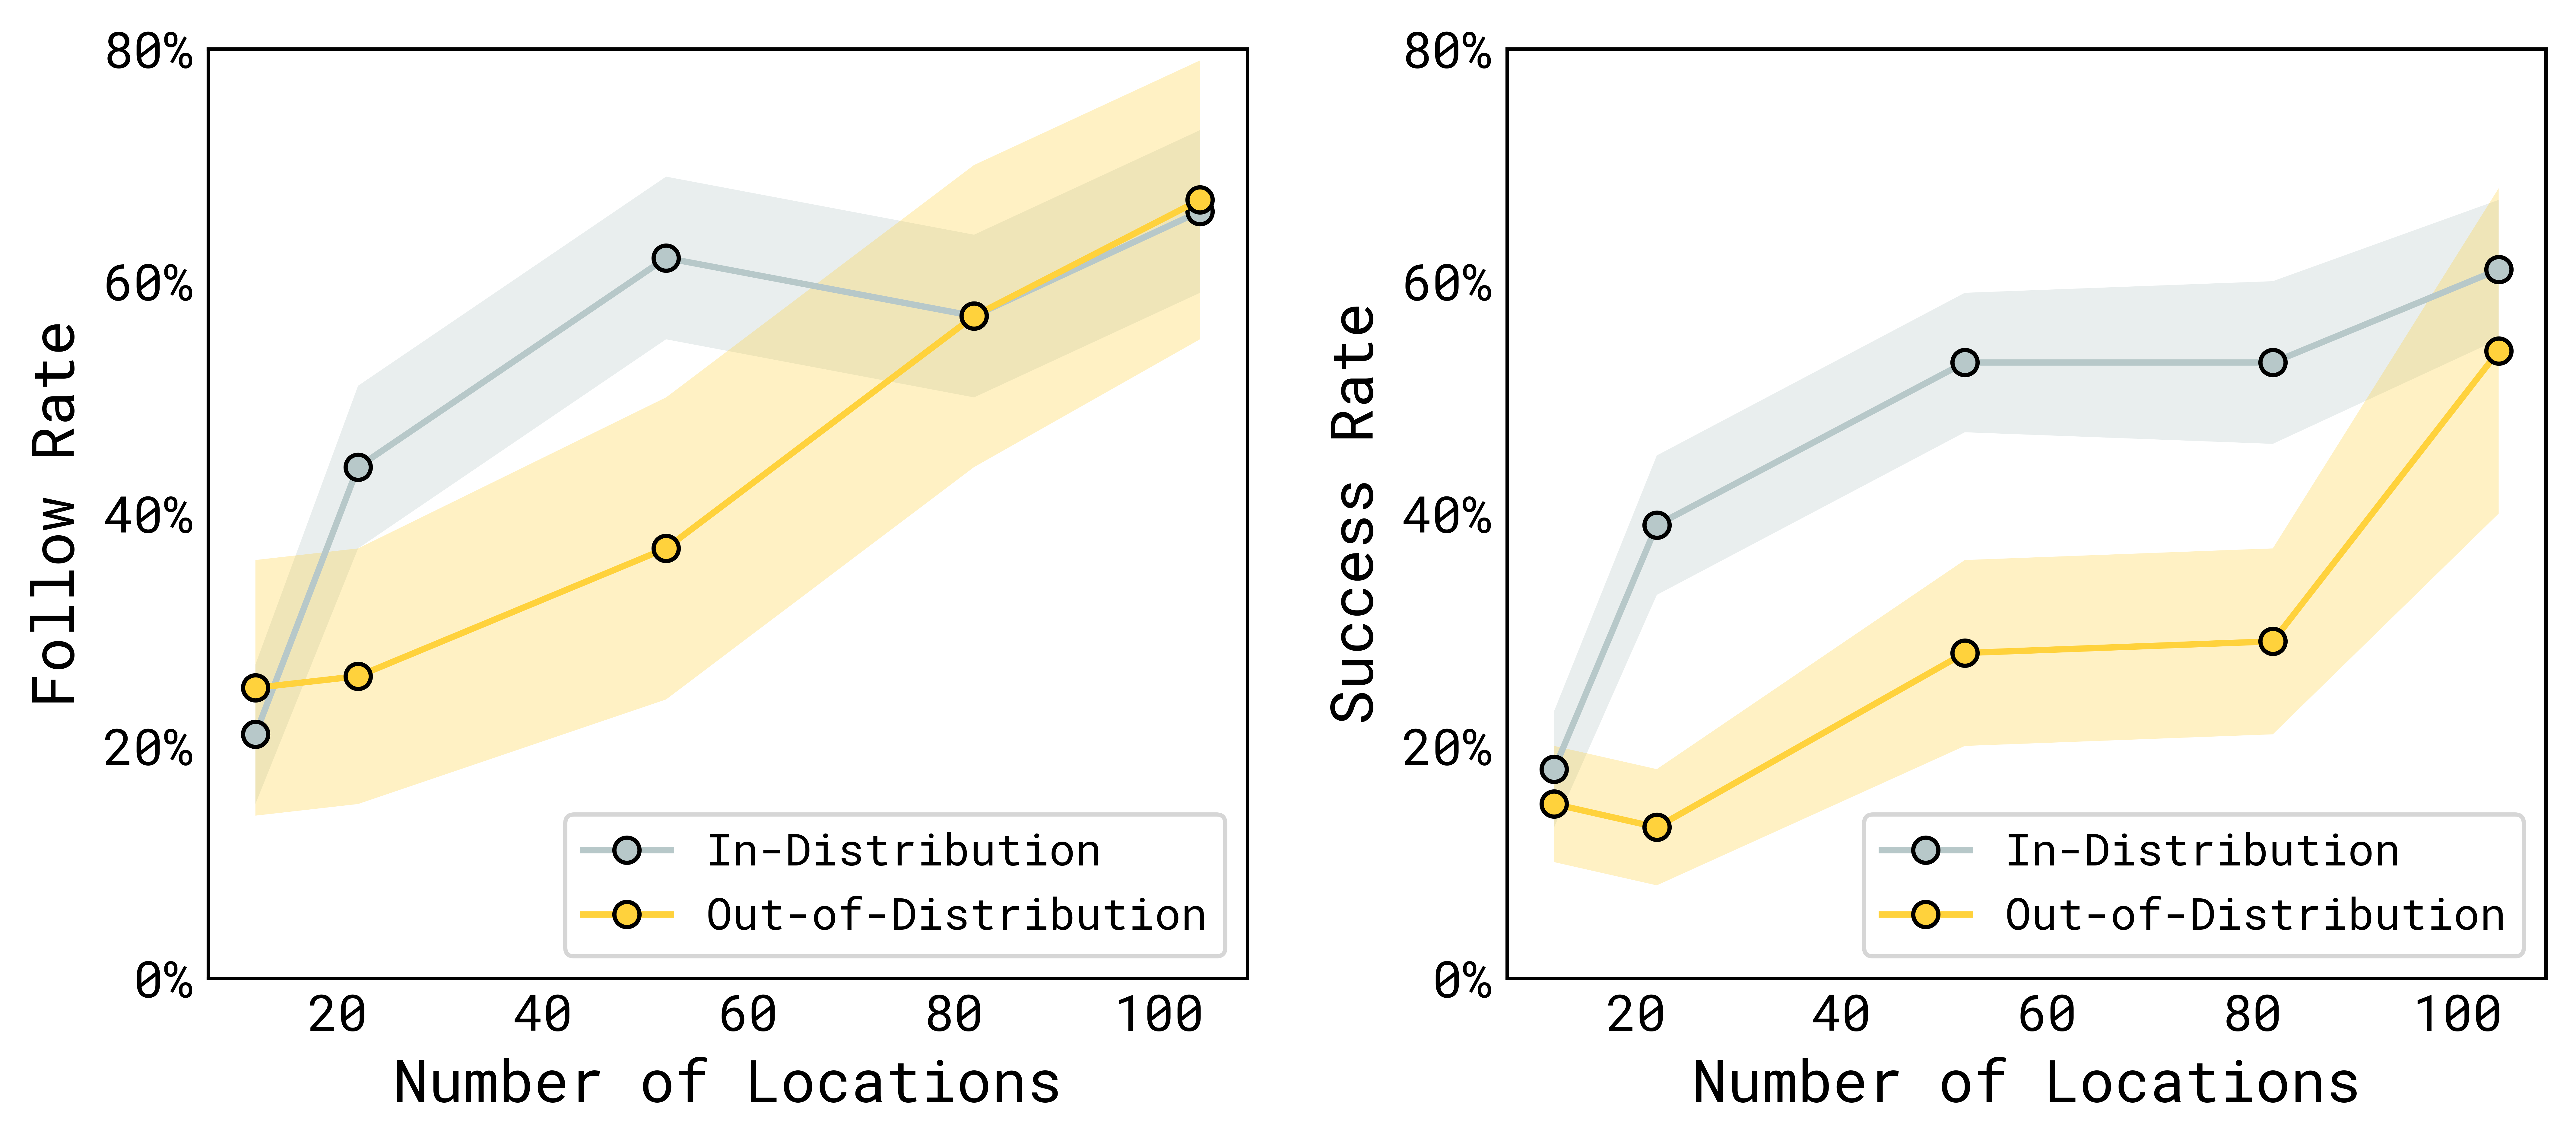
Fig 9 换一个更细的考法:让机器人按语音指令「拿起 X 放进抽屉/水槽」,报两个指标——语言跟随率(选对物体了吗)和成功率(放对位置了吗),分分布内物体(训练见过同类、新实例)与分布外物体(没见过的类别)。两条曲线都随地点数上升,分布内涨得更快;每多一个家庭 = 多见识一批家居物品,模型对没见过的类别也越稳。
Fig 10:训练配方消融——拆掉哪块掉得最狠(mock homes)
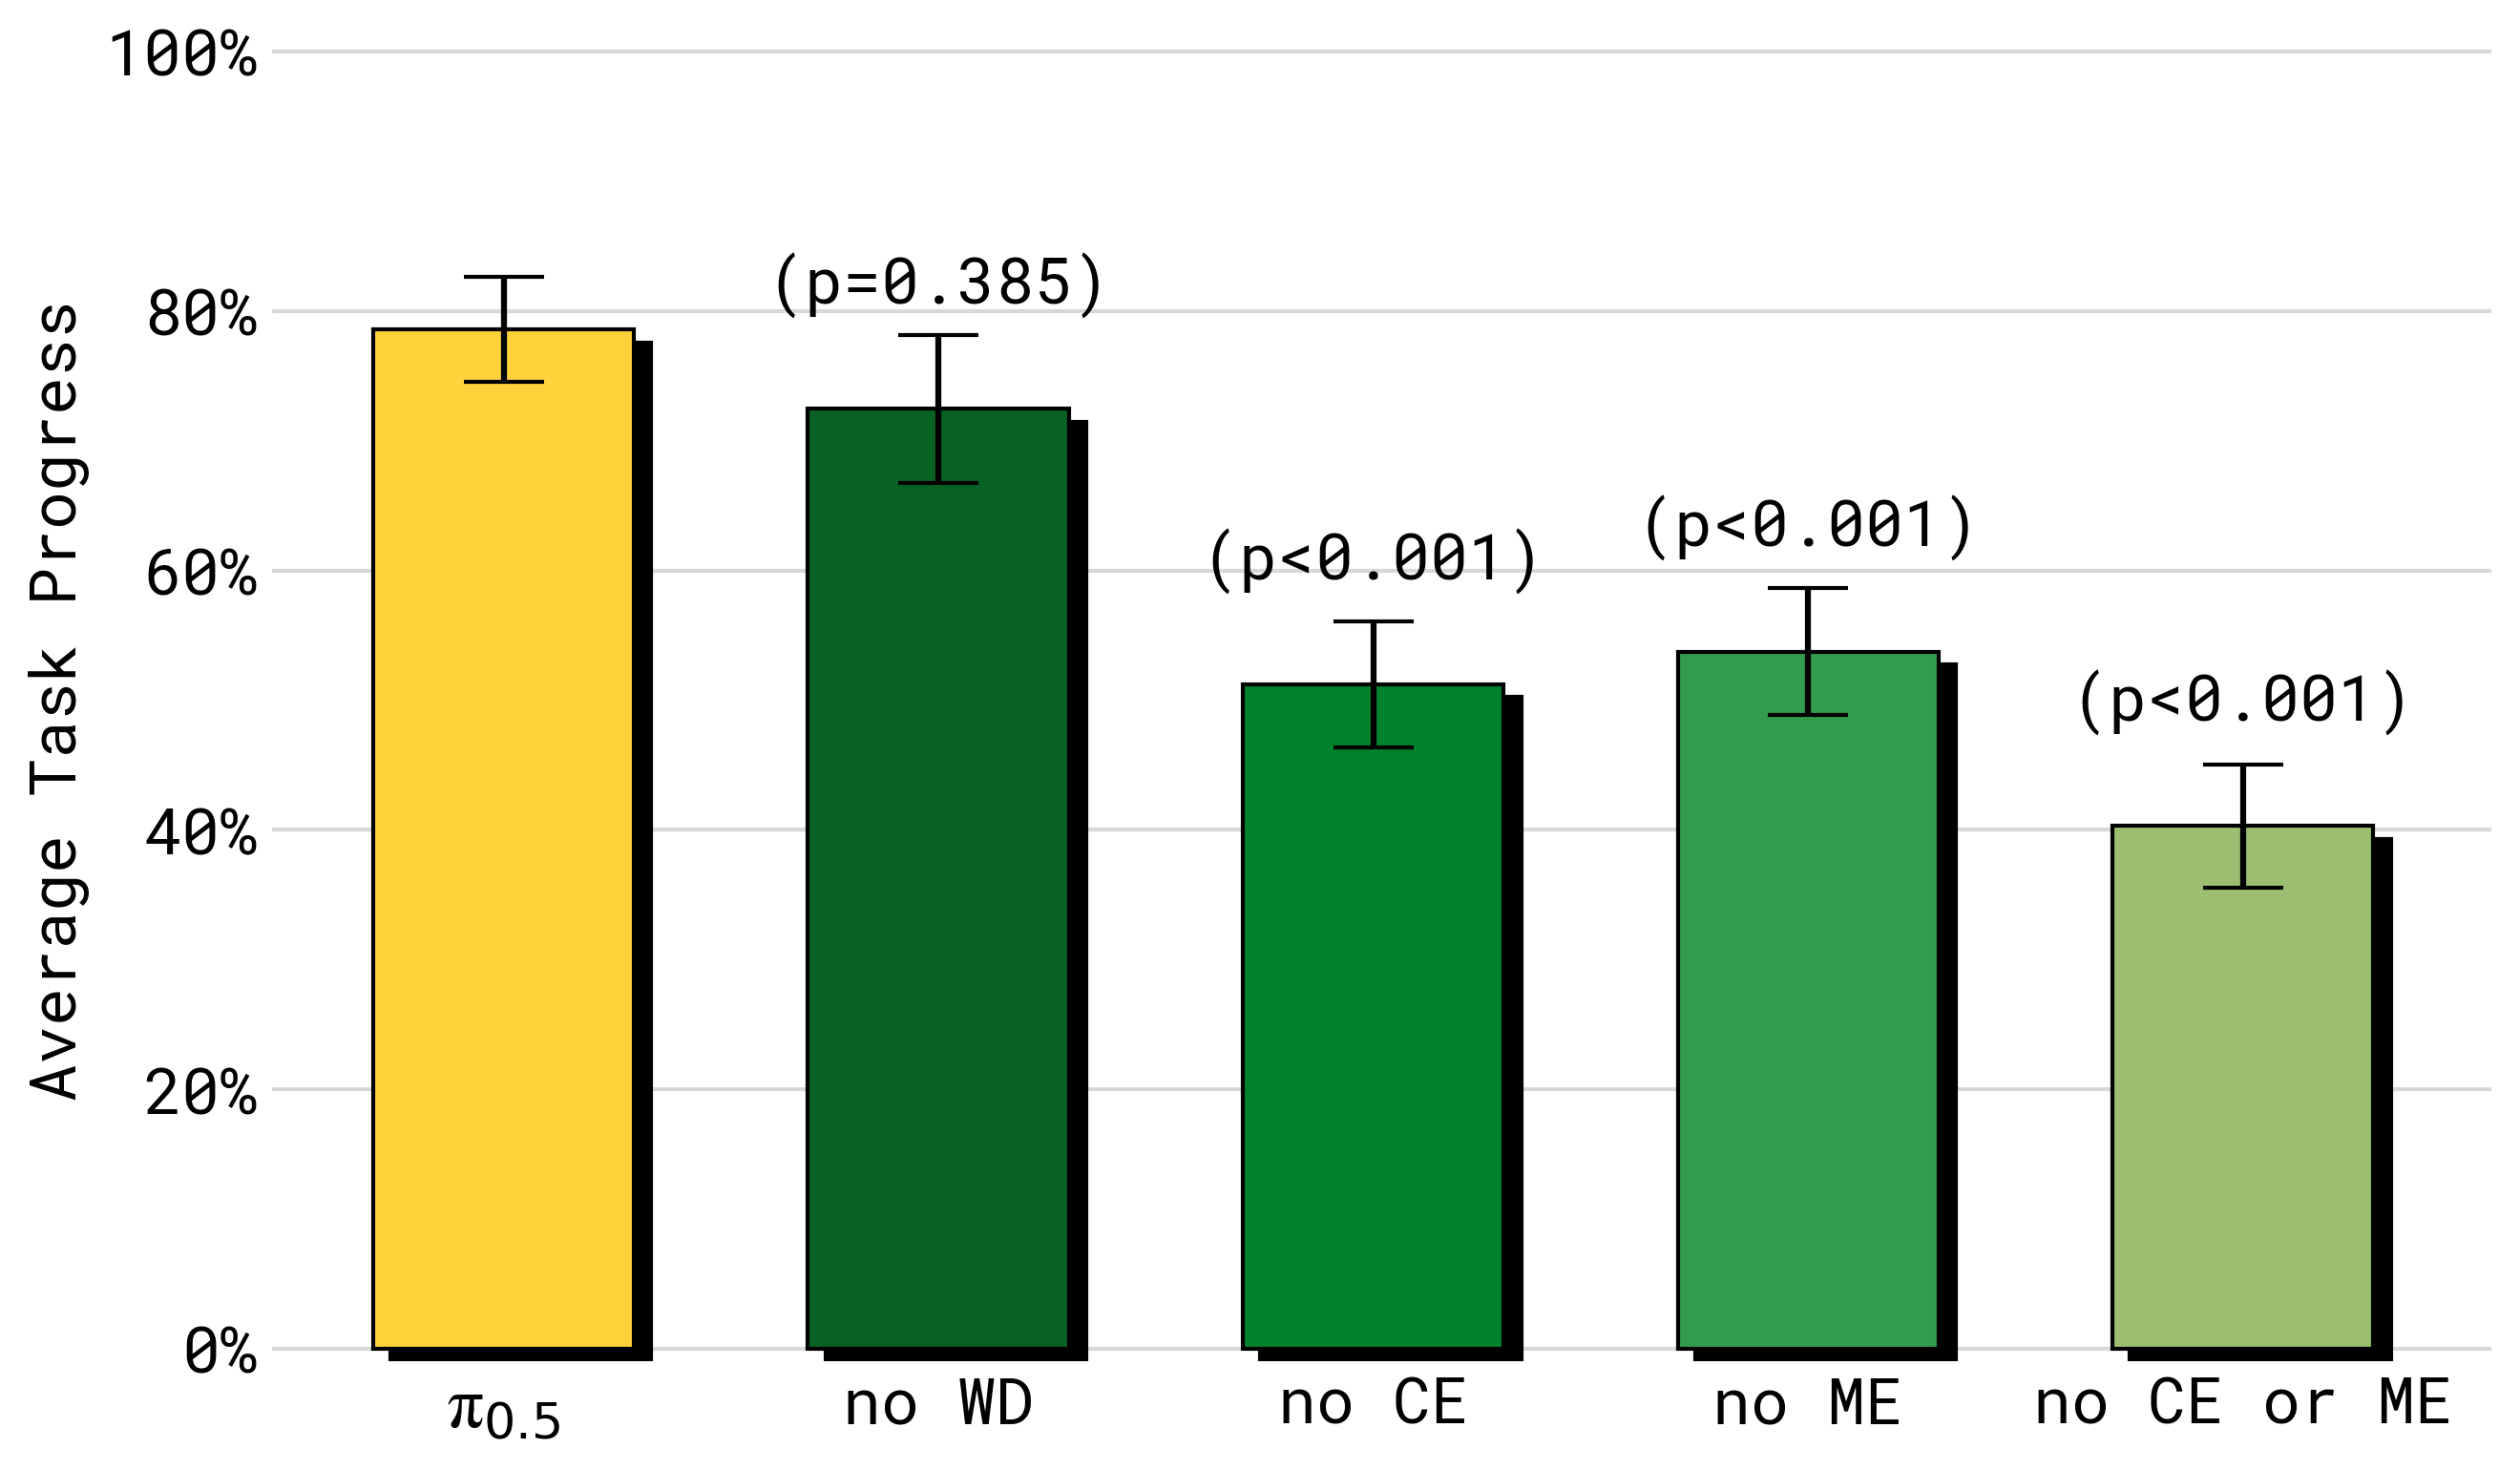
Fig 10 四个任务 × 四个变体(每设置 10 次试验):
- no ME / no CE / no ME+CE:去掉任一跨本体数据源都显著掉点,两者都去更惨——跨本体迁移(别的机器人、别的环境的数据)是刚需;
- no WD(去网页数据):在这个实验里统计上不显著——但别急,看 Fig 11 和 Fig 13,网页数据的功劳在别处。
Fig 11:训练配方消融——语言跟随版(分布外物体见真章)
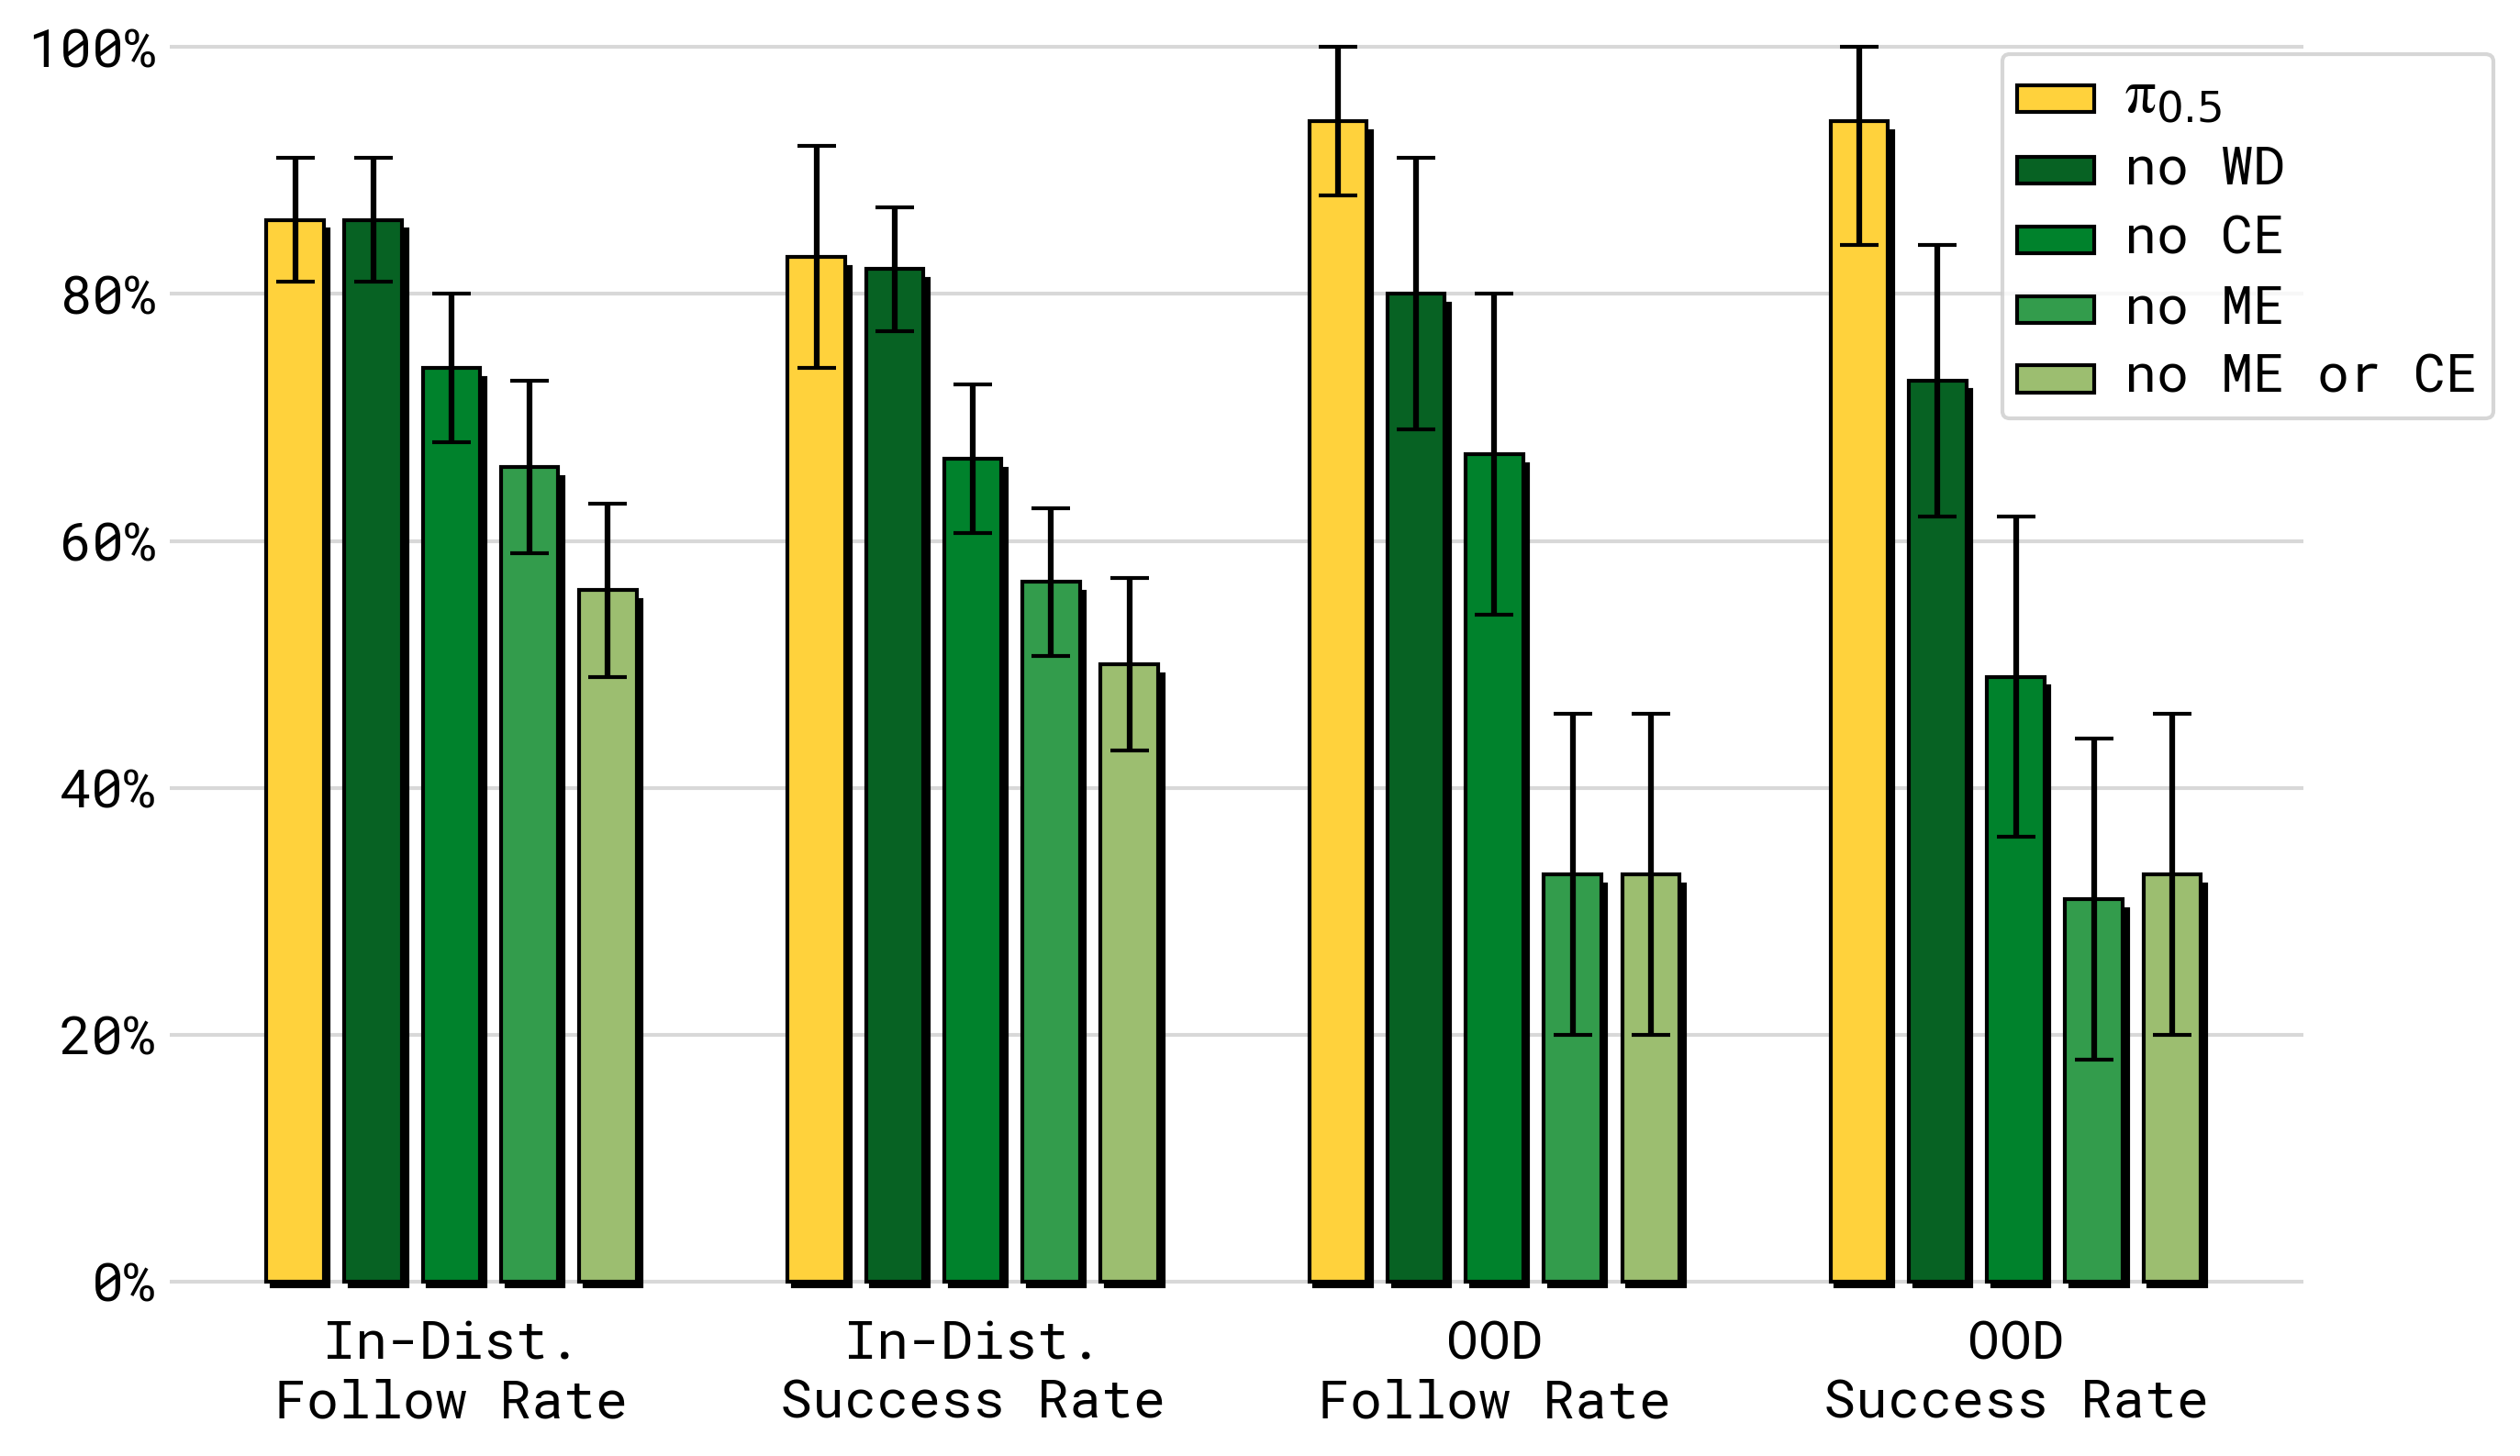
Fig 11 把消融搬到语言跟随实验:趋势和 Fig 10 类似(ME/CE 缺一不可),但新看点是 no WD——去掉网页数据后,分布外(OOD)物体的表现显著变差。论文的解释:网页数据里有极广的物理世界物体知识,模型靠它才听得懂「拿起没听过的 XX」。两个消融合起来 = 网页数据不扛任务分、但扛语义泛化。
Fig 12:和 π0 家族的正面对决
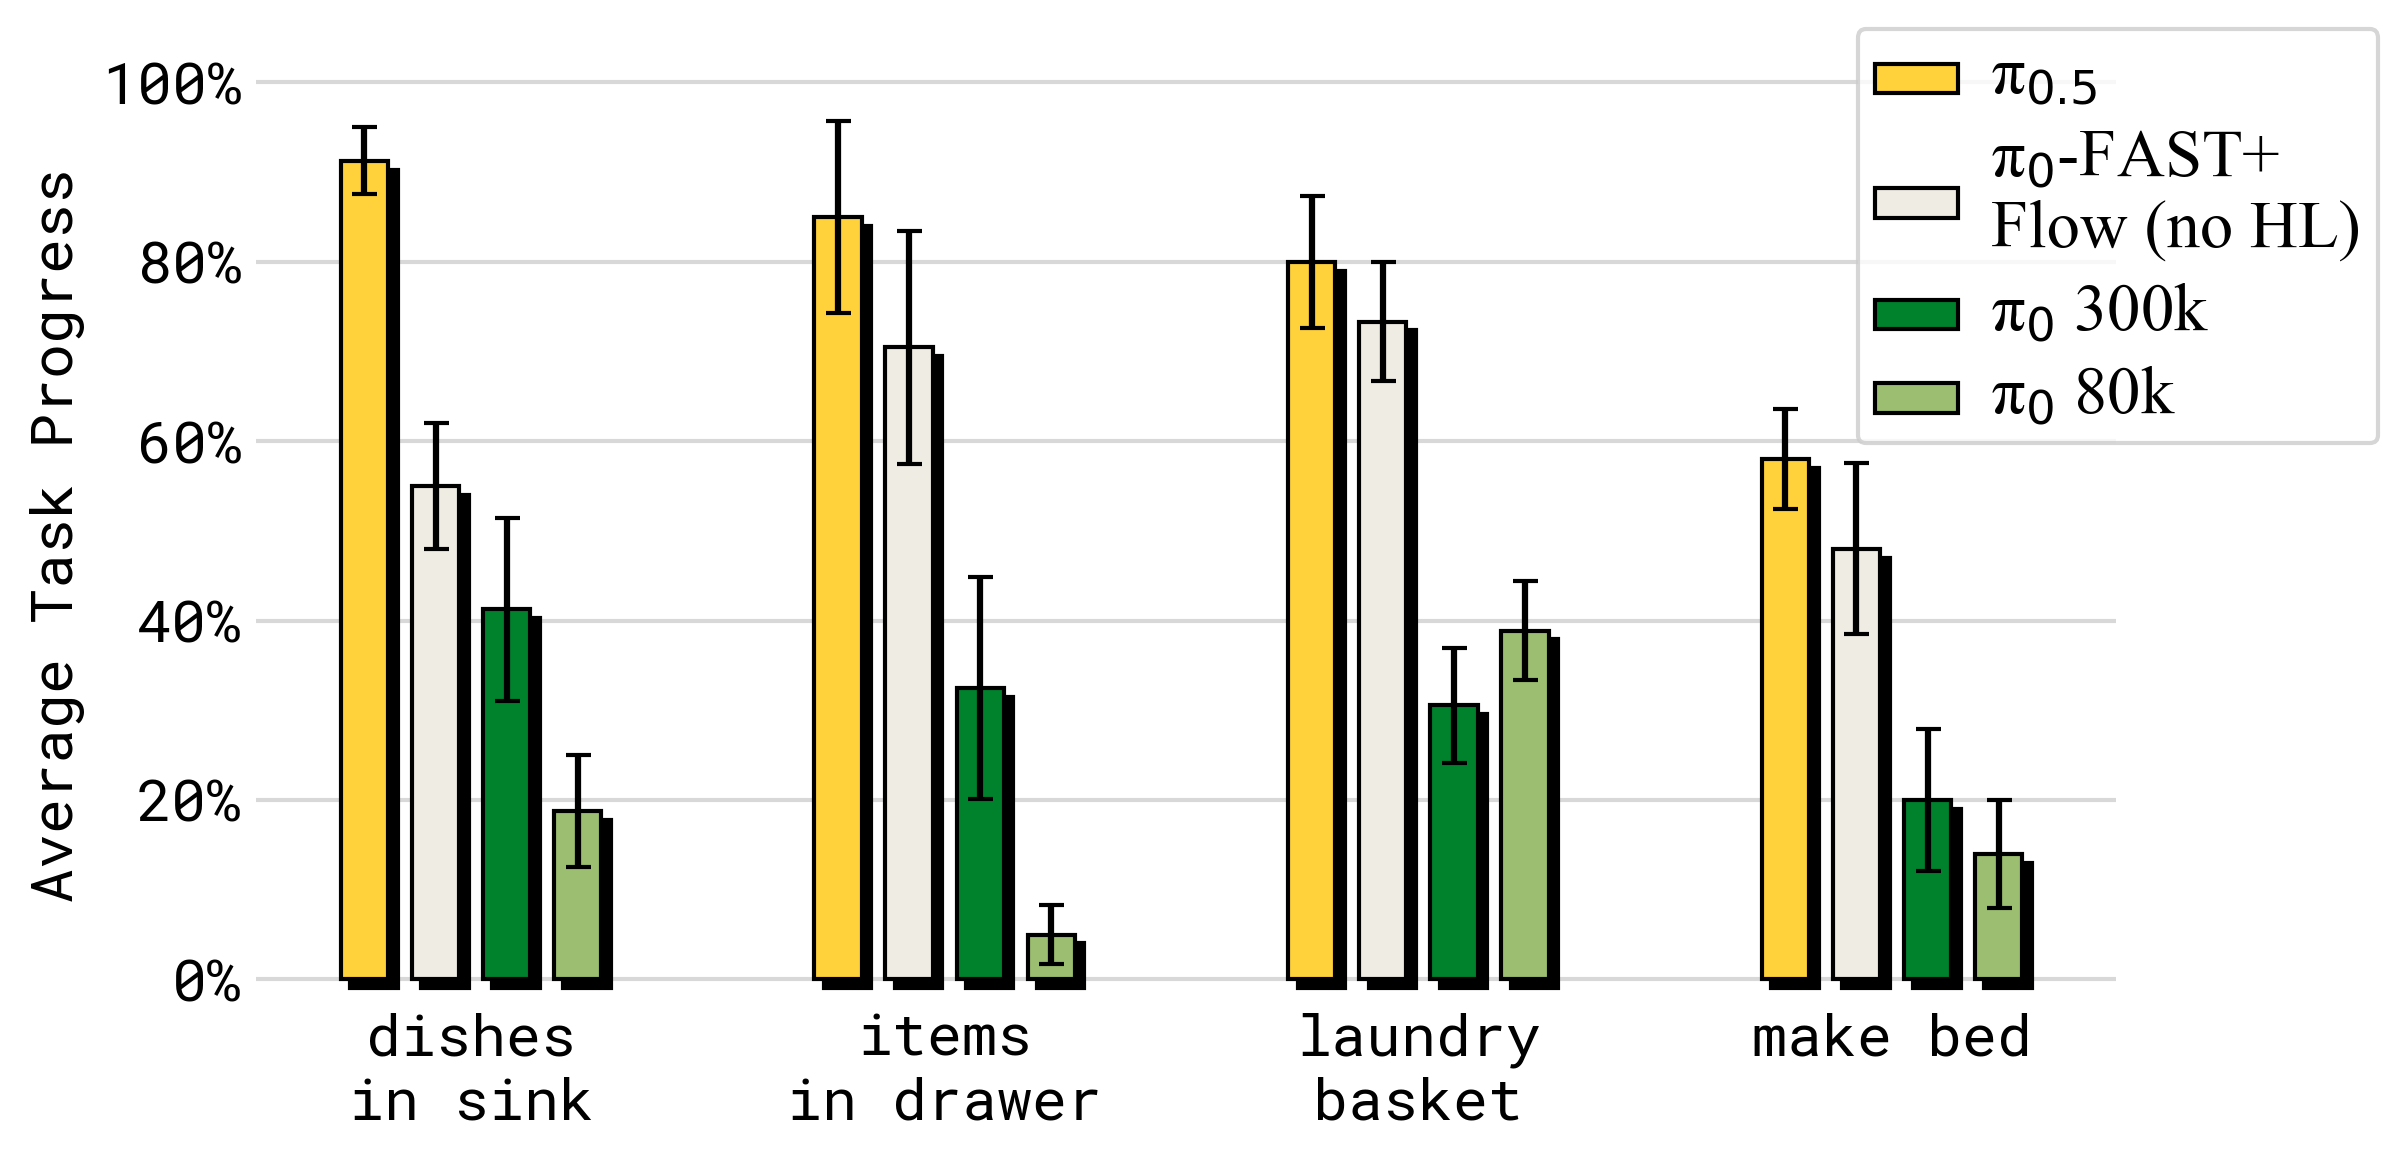
Fig 12 对比三个模型(同样的跨本体数据、可比的训练步数):
- π0:原版(全程动作专家 + Flow Matching);
- π0-FAST+Flow:按式(1)的混合目标重训、但只用动作数据(无 HL、无 WD)的加强版;
- π0.5:完整配方。
结果:π0.5 显著胜出两者,且把 π0 拉长到 300k 步也追不上——FAST token 训练的算力效率优于纯扩散/流匹配训练(与 Pertsch et al. 2025 结论一致)。差异被归因为两点:(1) π0.5 多了 HL + WD 数据;(2) π0.5 用「先离散后连续」的混合两阶段,而 π0 一直只有动作专家。
Fig 13:高层推理消融——最重要的消融图
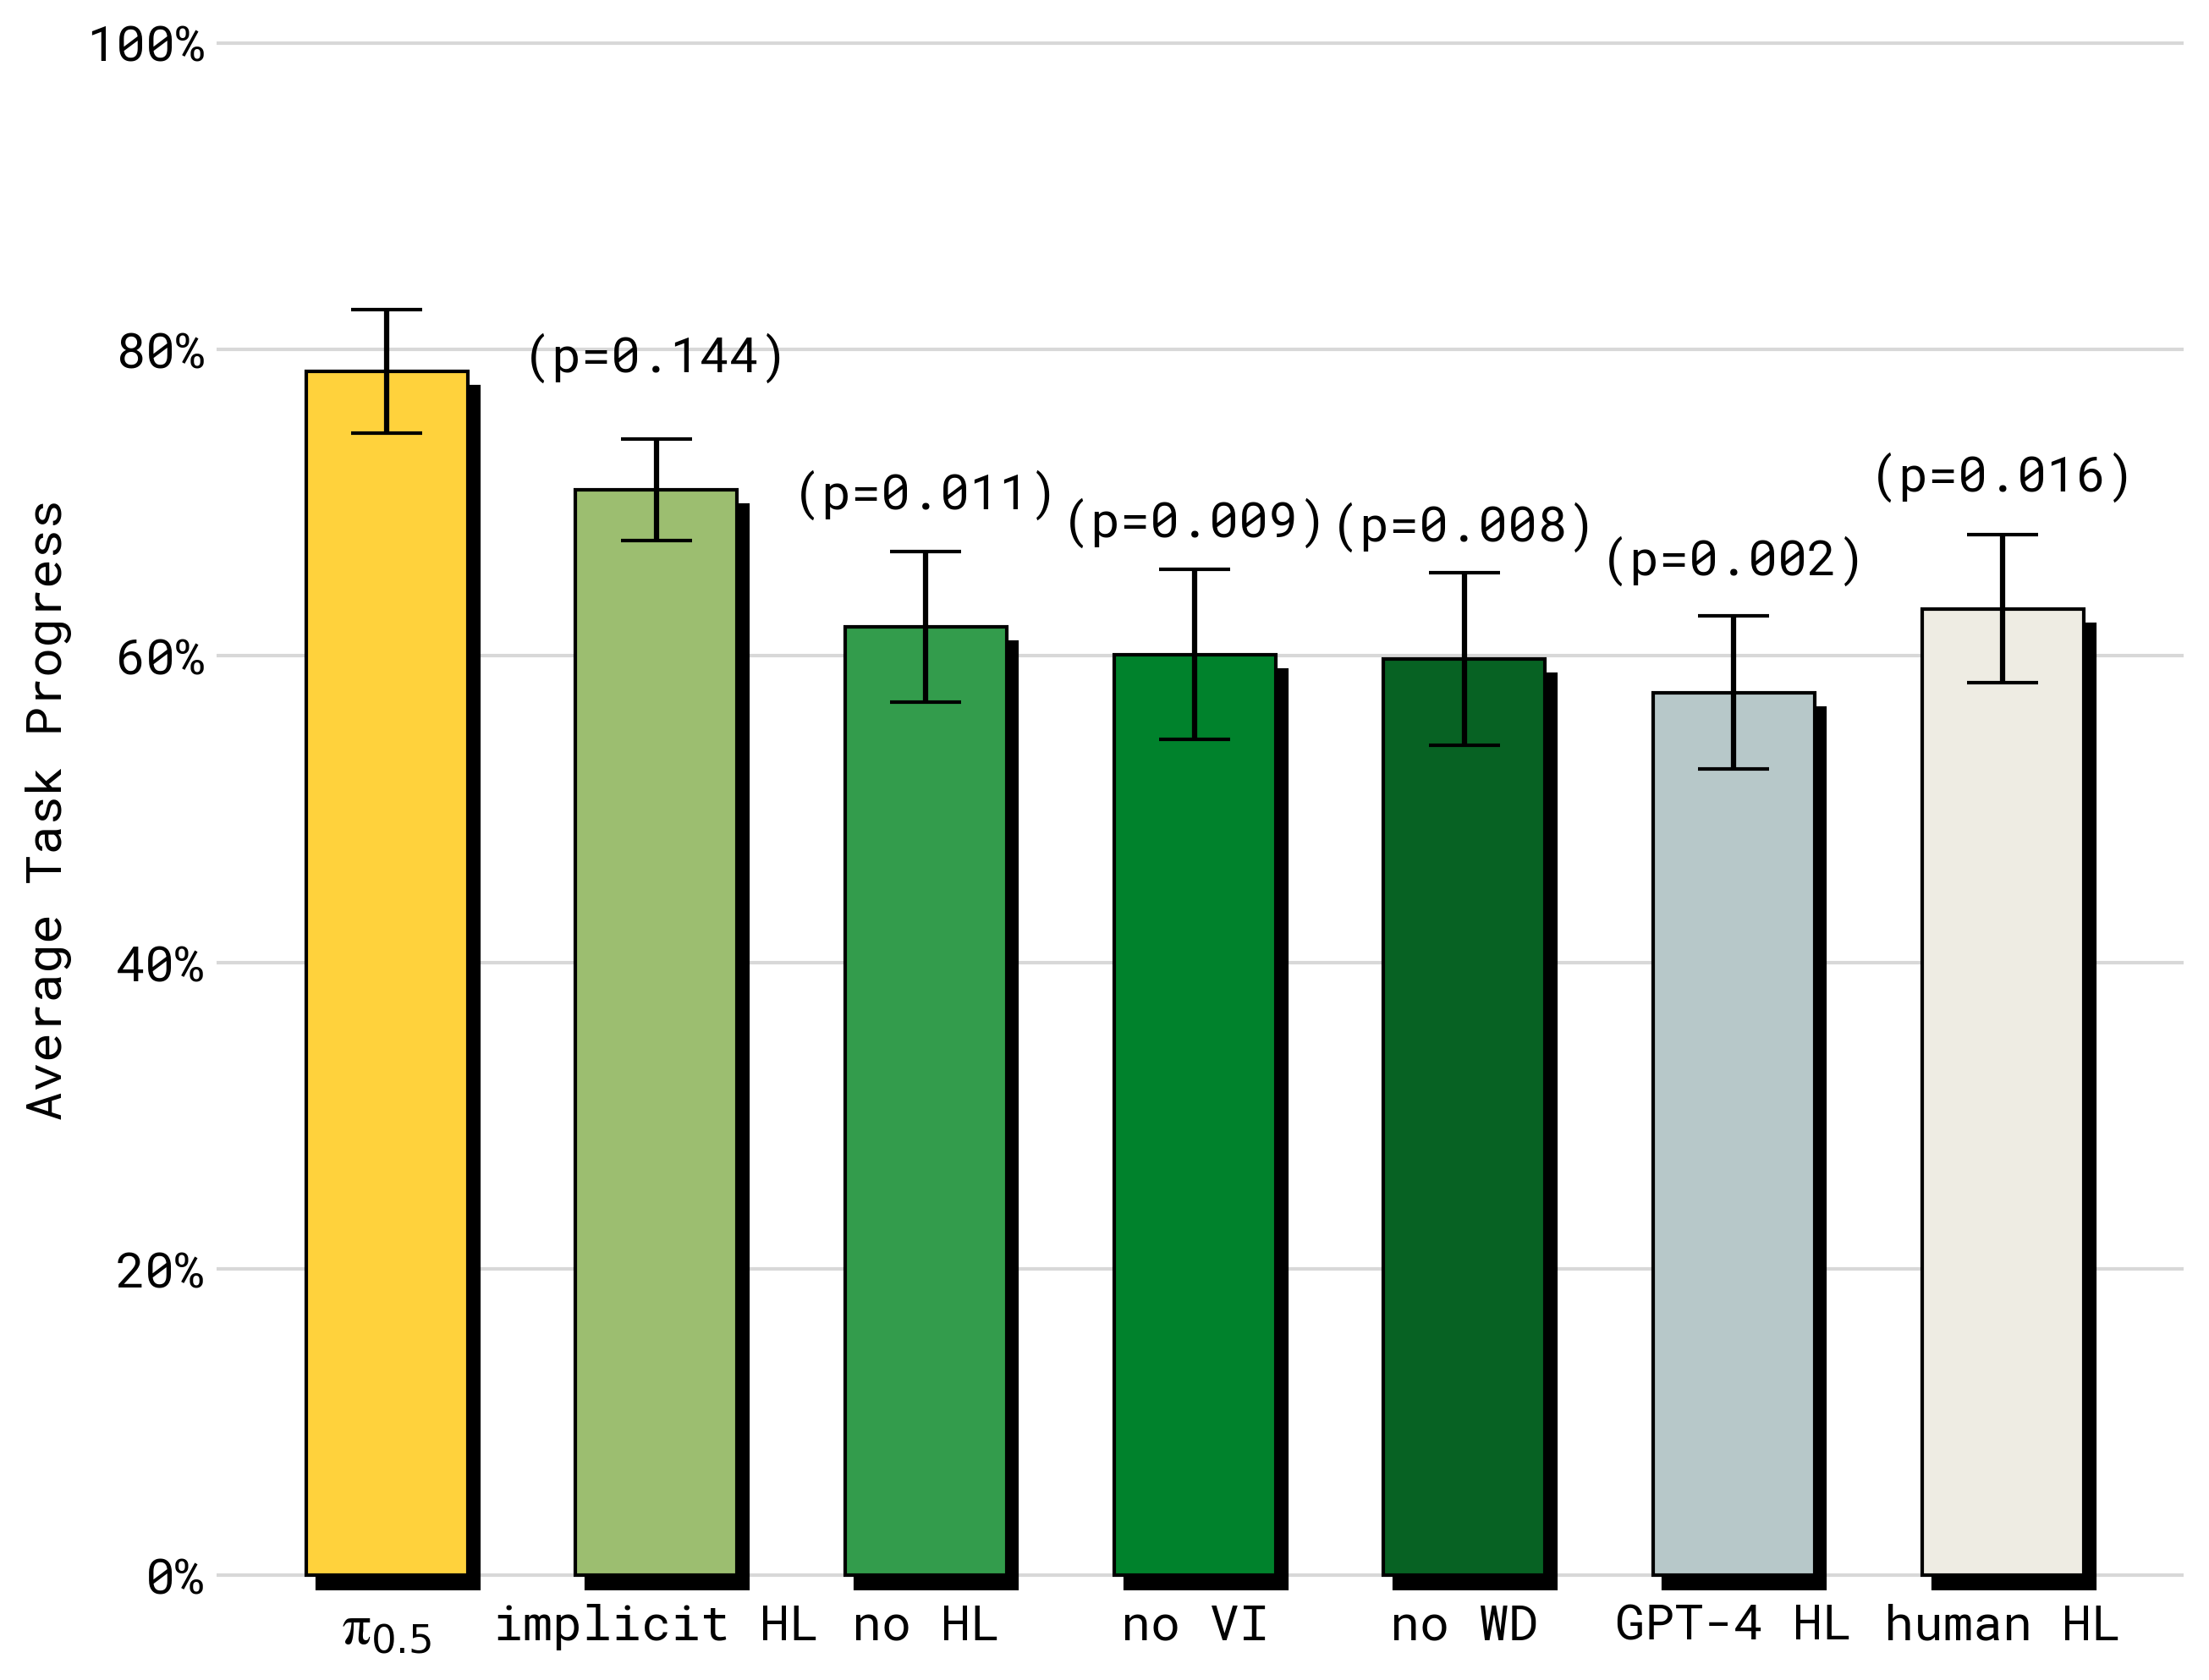
Fig 13 固定完整的低层推理,只换「子任务由谁出」七种方案:
| 方案 | 是什么 | 结果定位 |
|---|---|---|
| full π0.5 | 自己出子任务 + 自己出动作 | 最佳,甚至超过人类 oracle |
| implicit HL | 运行时不推理子任务,但训练见过子任务数据 | 第二名(收益的大头来自数据而非推理) |
| no VI | 去掉口头指令数据 | 显著变差(VI 只占 11% 却关键) |
| no WD | 去掉网页数据 | 显著变差(网页数据主要贡献在高层) |
| no HL | 训练也没见过子任务数据 | 明显更差 |
| GPT-4 | 通用大模型零样本当高层 | 垫底 |
| human HL | 人类专家当子任务 oracle | 上界参照,被 full π0.5 超过 |
三个结论:① 领域 co-training > 通用大模型零样本;② 显式两级推理确实有用,但一半以上的收益其实在训练数据里;③ 人类 oracle 被超说明「合适的子任务边界」不等于人类直觉,模型可能找到了更贴合自身低层能力的切分点。
Fig 14a/b/c:语言跟随实验的初始状态


Fig 14 三张实拍展示 Fig 9/11/15 实验的考题长相:(a) 台面上摆分布内日用品、要求放进抽屉;(b) 同样的分布内物体、要求放进洗碗池;(c) 一堆稀有/未见类别的物体(分布外)要进抽屉。三种设置共用同一套指令-物体-目的地范式,唯一变量是物体类别是否在训练分布内——这是把「语义泛化」变成可量化实验的设计。
Fig 15:语言跟随的模型对比
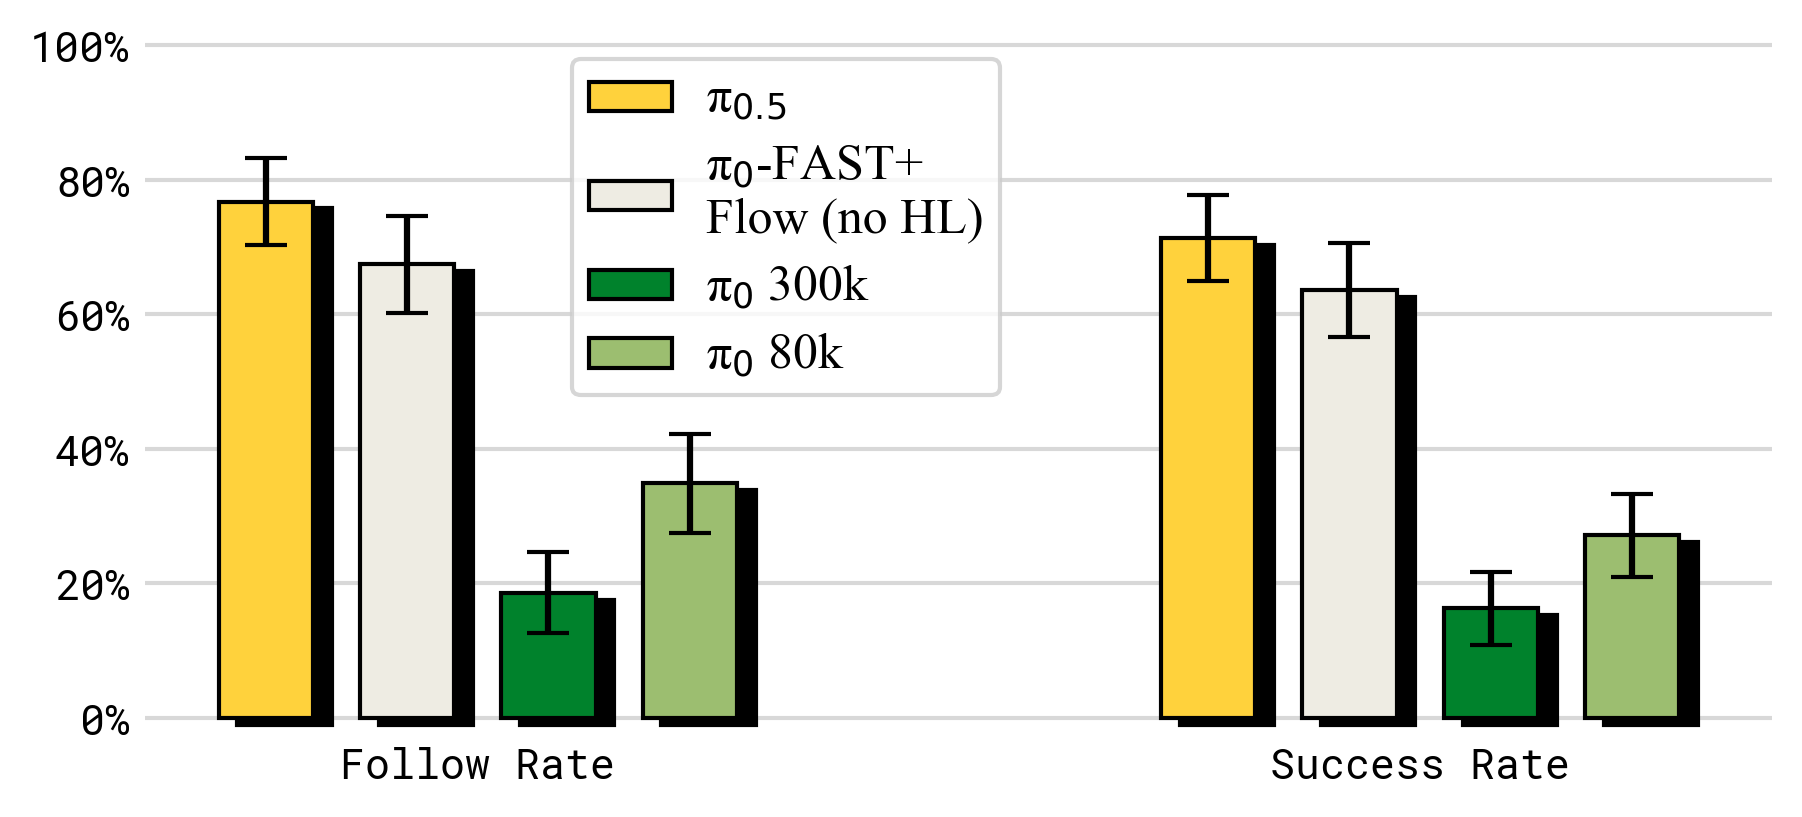
Fig 15 把 Fig 12 的对手拉到语言跟随考场重赛:π0.5 在分布内和分布外物体上都领先 π0 与 π0-FAST+Flow,分布外差距更大——co-training(尤其网页数据)的收益在语义端比在任务端更明显。
Fig 16:按任务拆开的配方消融
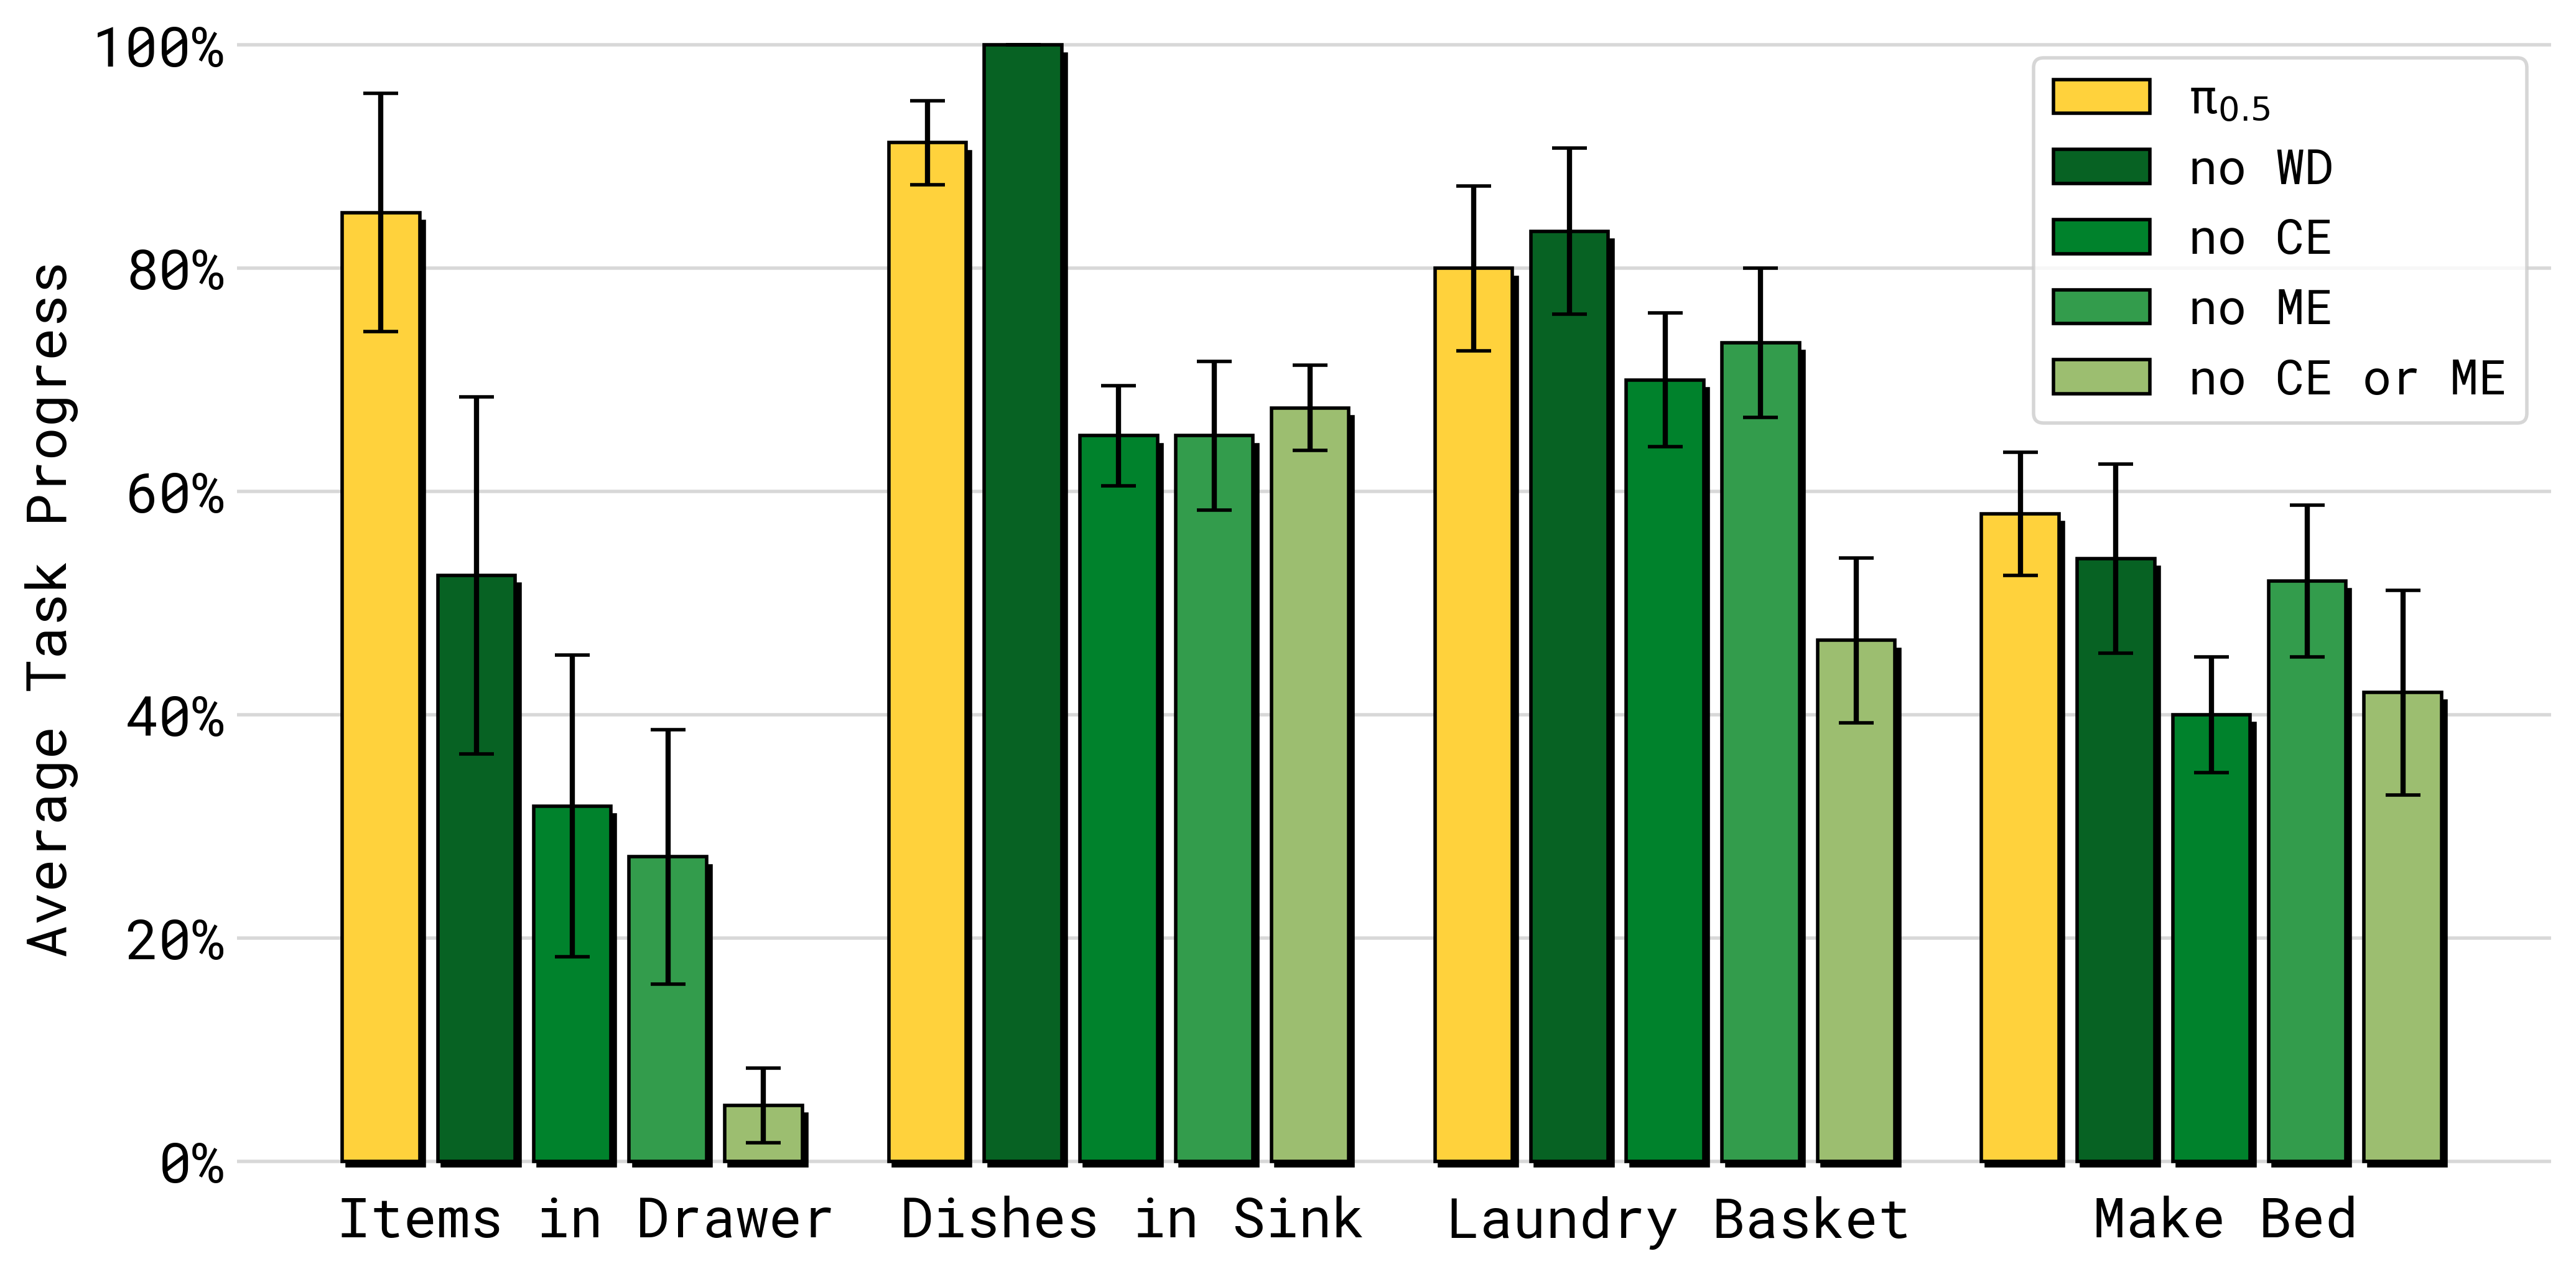
Fig 16 是 Fig 10 的细粒度版(Items in Drawer / Dishes in Sink / Laundry Basket / Make Bed 四任务分开看):去掉跨本体数据(ME/CE)的退化集中在特定任务上——比如高度依赖环境多样性的任务伤得最重。逐任务拆分防止「平均数掩盖局部崩塌」。
Fig 17:按任务拆开的高层推理消融
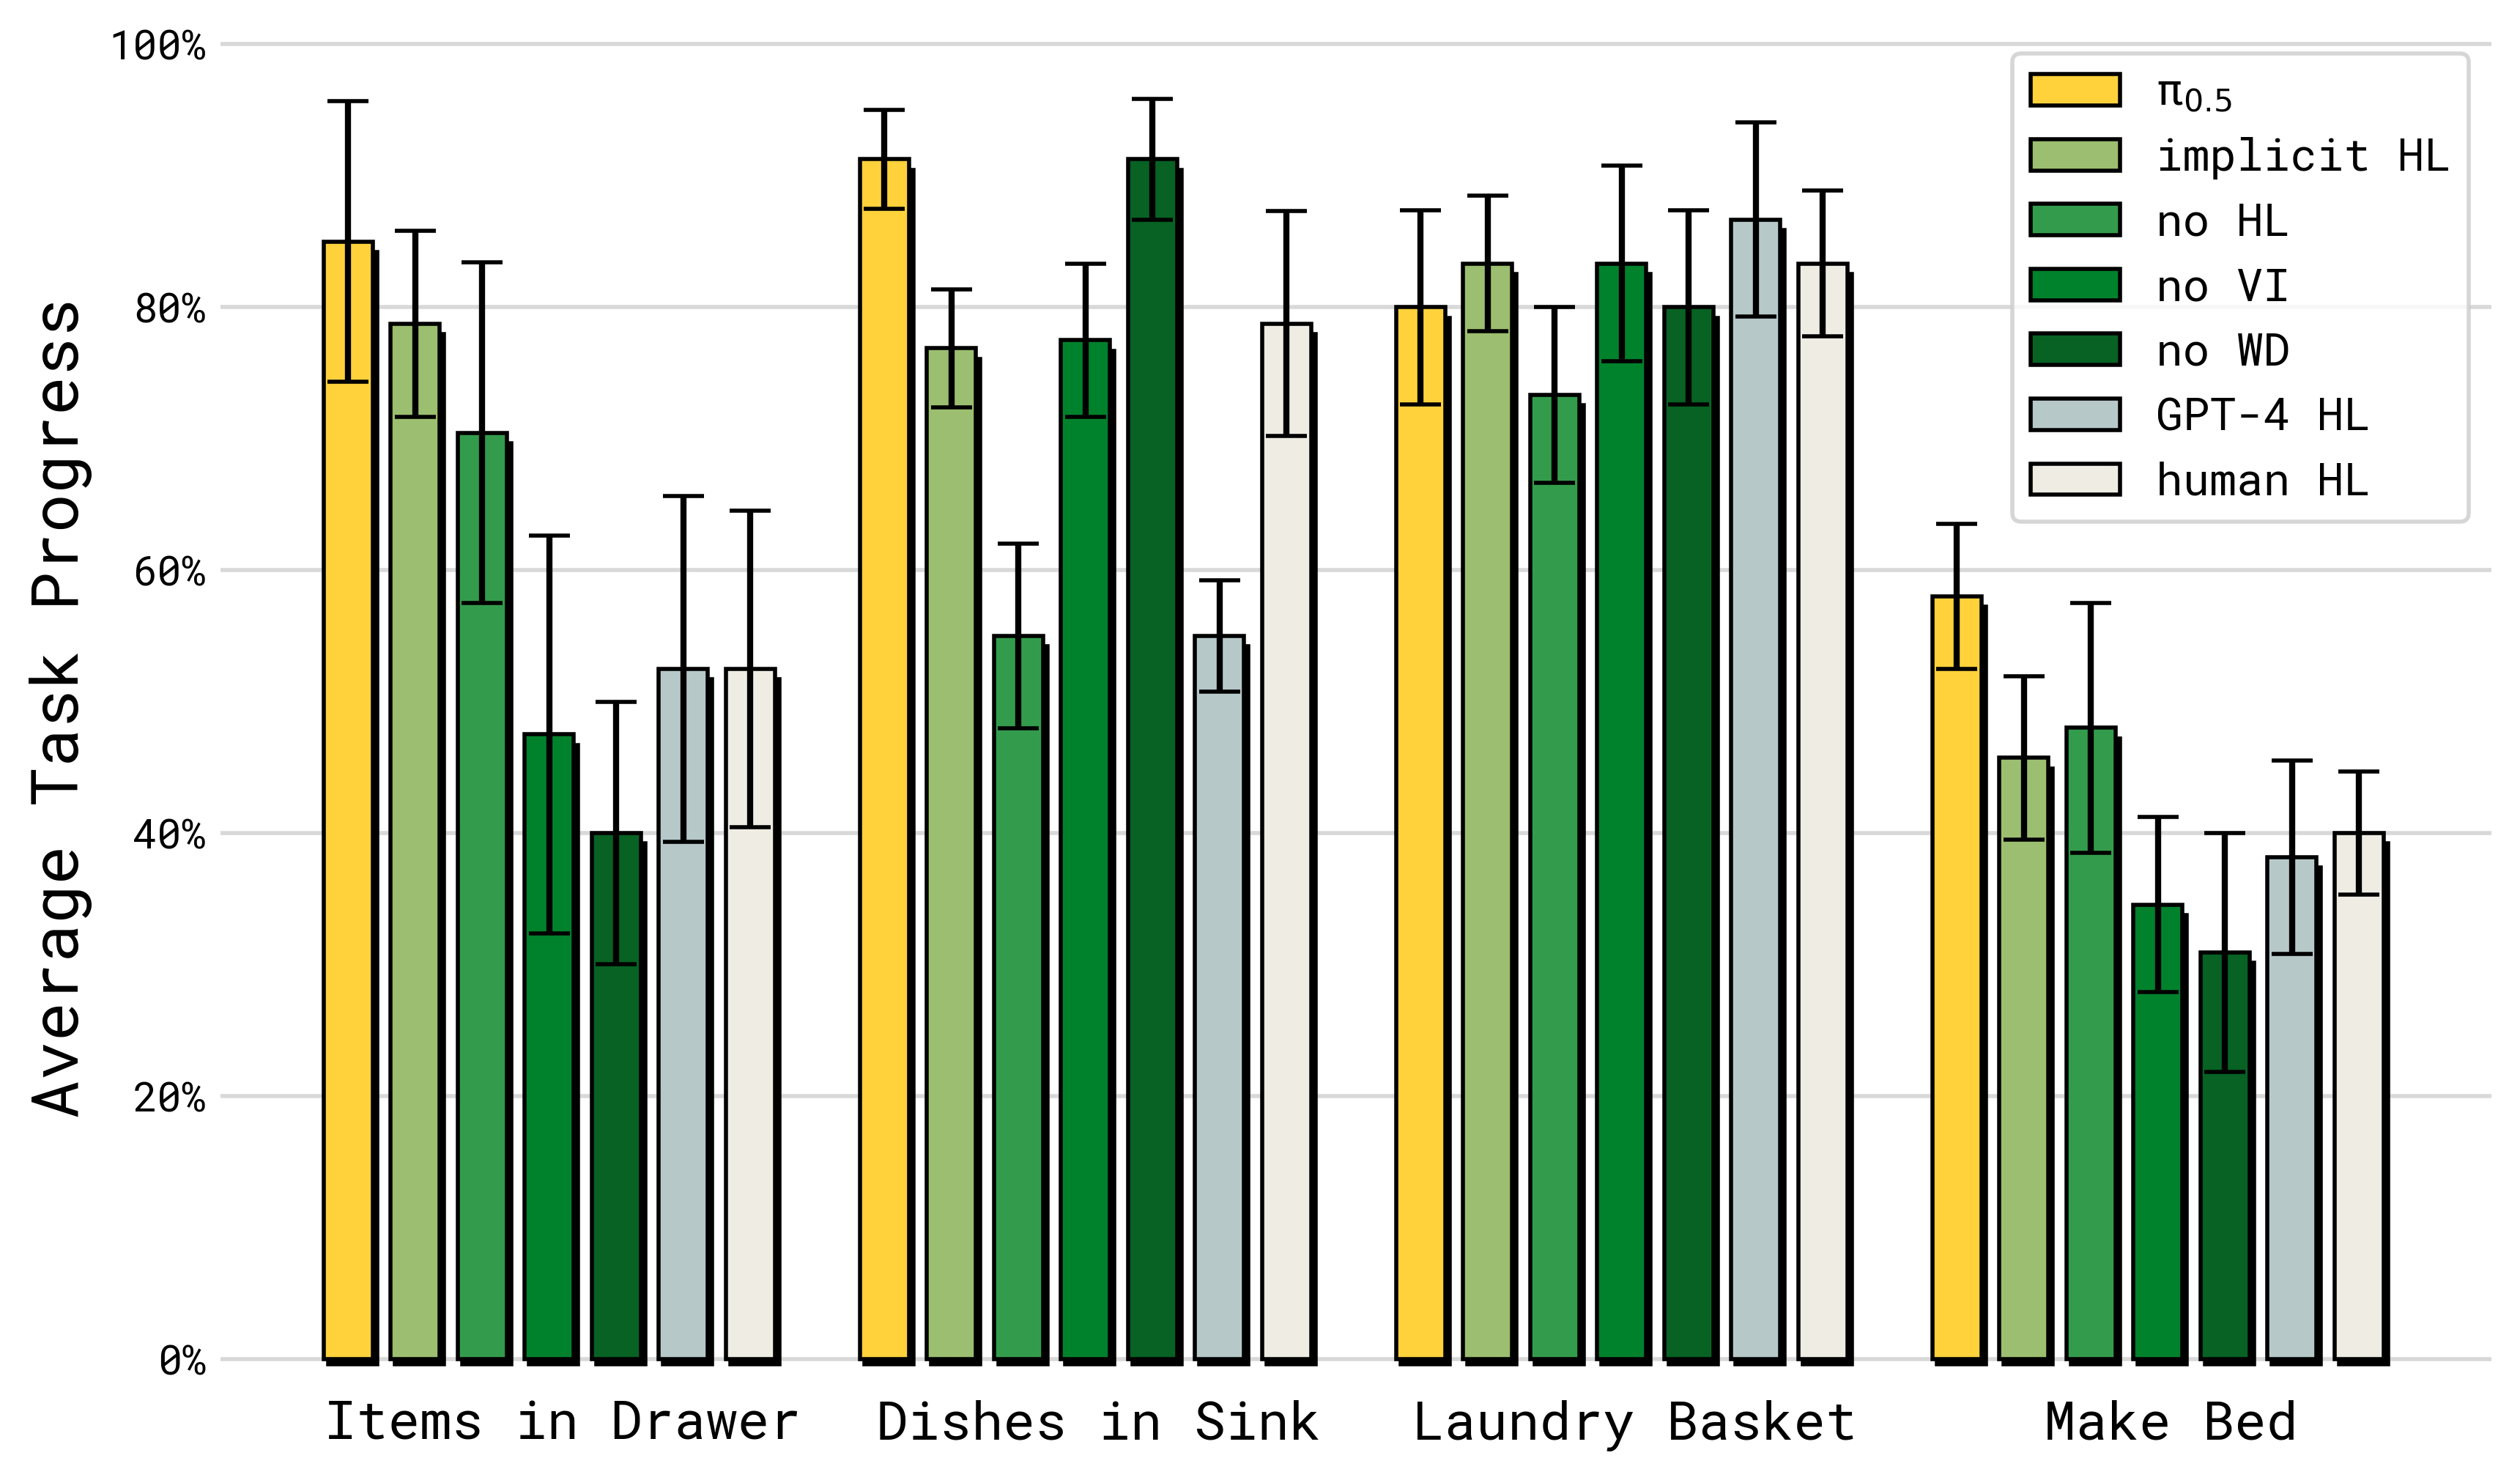
Fig 17 同理,把 Fig 13 的七种高层方案拆到四个任务:全模型的领先与 implicit HL 的「体面第二」在各任务上是否一致、GPT-4 的垫底栽在哪个任务——高层推理的收益并非任务均质(多阶段、子任务边界模糊的任务收益更大)。
🗂️ 论文图表总索引(20 张全收录)
| 图号 | 文件 | 一句话 |
|---|---|---|
| Fig 2 | final_fig2.png | 在训练没见过的厨房里完成四条笼统指令的清洁 |
| Fig 3 | Figure_3.png | 架构总览:左预训练(全离散)/ 右后训练与推理(子任务 + 动作专家) |
| Fig 4 | pretraining-finetuning-tasks.png | 预训练/后训练六类数据(CE/MM/ME/HL/WD/VI)示例 |
| Fig 5 | robot_system_overview.png | 两种移动操作平台硬件:4 相机、双 6DoF 臂、升降、全向底盘 |
| Fig 6 | visualize_eval_envs.png | 评测环境:mock homes(定量)+ real homes(最终) |
| Fig 7a | final_real_home_eval_filmstrip.png | 三个真实家庭任务的逐帧过程 + 蓝色子任务预测 |
| Fig 7b | real_home_quantitative_eval_plot.png | 真实家庭定量结果:mock 成绩能代表真实家庭 |
| Fig 8 | env_scaling.png | 3→104 个训练地点,任务分上涨并追平「见过测试家」对照 |
| Fig 9 | env_scaling_results0.png | 语言跟随率/成功率随地点数上升,分布内外分开报 |
| Fig 10 | performance_vs_ll_data.png | 配方消融(任务):ME/CE 缺一不可,no WD 不显著 |
| Fig 11 | data_vs_generalization.png | 配方消融(语言):no WD 在分布外物体上显著掉点 |
| Fig 12 | performance_vs_ll_model.png | π0.5 显著胜过 π0 与 π0-FAST+Flow(含 300k 步 π0) |
| Fig 13 | performance_vs_hl_data.png | 七种高层推理方案:full > implicit HL > … > GPT-4 |
| Fig 14a | ll_drawer.jpg | 语言跟随考题:分布内物体 → 抽屉 |
| Fig 14b | ll_sink.jpg | 语言跟随考题:分布内物体 → 洗碗池 |
| Fig 14c | rare_objects.jpg | 语言跟随考题:稀有(分布外)物体 → 抽屉 |
| Fig 15 | language_vs_model.png | 语言跟随的模型对比,分布外差距更大 |
| Fig 16 | overall_breakdown.png | 配方消融逐任务细分 |
| Fig 17 | HL_breakdowns.png | 高层推理消融逐任务细分 |
| Fig 18 | attention_mask.png | 注意力掩码:前缀双向 / FAST 因果 / 专家双向,互不串门 |
💡 架构评析:三个最妙的设计,三条边界
三个最妙的设计
- 「先离散后连续」把训练稳定性与推理实时性拆开解决。很多 VLA 的尴尬是:想训得稳就要简单目标,想部署快就要流匹配头。π0.5 用两阶段 + α 从 0 到 10 的损失配比,让预训练像训一个普通 VLM,后训练再「外挂」动作专家——动作专家随机初始化都能接得上,因为掩码保证了它只读不写、不干扰骨干。对做训练配方的人,这是可以直接抄的稳定性技巧。
- 注意力掩码级别的「双动作表示共存」。离散和连续两套动作住在同一个 Transformer 里,靠一张精心设计的掩码(Fig 18)实现「公共前缀双向、FAST 因果、专家双向、两套动作互不可见、信息单向 VLM→专家」——没有引入第二张网络、没有 MoE 路由,只用 mask 就划清了地盘。这是对「架构创新不必是新结构,可以是新的连接方式」的漂亮注解。
- 两级推理是数据问题,不只是结构问题。Fig 13 最有价值的发现不是「显式拆子任务好」,而是 implicit HL 居然第二——大半收益来自「训练时见过子任务标注」,运行时推理只占小头;而 GPT-4 零样本垫底再次证明:通用大模型不补领域数据,连子任务都拆不好。这直接改写了「要不要给 VLA 加规划器」的讨论方式:先看你的数据里有没有语义层监督。
三条边界
- 仍是纯模仿 + 配方驱动,没有在线改进闭环。π0.5 的泛化上限由「预设的数据混合」决定,失败不会自动变成下一轮的补丁——这正是 Zetta/EmbodiRSI 那条 RSI 线要补的另一半拼图。
- 高层推理的天花板与上下文长度。论文自陈:prompt 相对简单、上下文较短,缺乏跨房间记忆——「记住东西放在哪」这类部分可观测任务会难倒它;子任务推理也偶发「反复开关抽屉」的分心。
- 全部结论站在 400 小时自采移动操作数据 + 自有双臂平台上。MM/ME/CE 的采集工程量极大,普通团队复制不了完整配方;no WD 在任务分上不显著也提醒:配方里每一味料的真实作用要靠消融才能说清,不能照单全收。
和 π0 的对照(一表总结)
| 维度 | π0 | π0.5 |
|---|---|---|
| 动作表示 | 全程 Flow Matching 动作专家 | 预训练 FAST 离散 → 后训练加 FM 专家(混合) |
| 推理结构 | 单级:观测+指令 → 动作 | 两级:先子任务文本,再条件化出动作 |
| 训练数据 | 机器人动作数据(+ 少量共训) | MM/ME/CE/HL/WD/VI 六路混合 co-training |
| 高层语义 | 无 | 子任务预测 + 检测框 + 口头指令演示 |
| τ 注入 | 与噪声动作融合 | 独立 MLP + 每层 adaptive RMSNorm |
| 骨干/专家 | PaliGemma 系 + 专家 | 同规格(2B 级 + 300M),附录给出完整超参 |
| 目标 | 灵巧操作的通用控制 | 开放世界泛化:训练没见过的家、没见过的物体 |
| 控制接口 | 50Hz 动作块 | 同,且明确 18-19 维全端到端、无规划器无碰撞检测 |
🗺️ 在 VLA 谱系里的位置
RT-2 (2023): 动作=文本token ──→ OpenVLA (2024): 开源7B基线
        │
        ├── π0 (2024/10): VLM + Flow Matching 动作专家   ← [站内精读](/posts/paper-reading/pi0-通用vla模型精读/)
        │        │
        │        ├── π0-FAST: FAST 离散动作 token 化
        │        │
        │        └── ★ π0.5 (2025/04): 两阶段混合动作 + 两级推理 + 六路co-training
        │                  │            ← 本文
        │                  └── π0.7 (2026): 可引导的通用机器人基础模型
        │
        └── GR00T N1.5 / RDT / Qwen-VLA: 并行的骨干与动作头路线
三步读法建议:先读π0 精读搞懂 Flow Matching 动作专家(π0.5 的地基),再读本文抓「两阶段 + 两级 + co-training」三个增量,最后按需要跳到 RDT 与 RDT2 看双臂扩散路线的分野。配套代码阅读用π0 代码讲解。
🎤 汇报口述稿
30 秒版:
π0.5 是 Physical Intelligence 在 π0 上加了三个东西:一是两阶段训练,预训练把所有动作都编成 FAST 离散 token、像训普通 VLM 一样稳,后训练再挂一个 300M 的 Flow Matching 动作专家负责实时出动作,两套动作表示用注意力掩码隔开;二是两级推理,同一个模型先输出子任务"pick up the pillow",再条件化输出 50 步动作块;三是六路数据 co-training,机器人数据混网页数据、子任务标注和口头指令。结果是第一次在训练没见过的真实家里完成两到五分钟的多阶段清洁,消融证明跨本体数据和网页数据缺一不可,GPT-4 零样本当规划器反而垫底。
2 分钟版(分四段):
问题:VLA 在自家实验室好用,换个没见过的家就抓瞎——泛化靠什么?
架构:骨干是 PaliGemma 系 2B 级 VLM(SigLIP + Gemma),动作专家 300M。分布分解成高层 π(子任务|观测,指令) × 低层 π(动作|观测,子任务),两次前向都是同一个模型。预训练 280k 步全离散(动作也走 FAST),后训练 80k 步 α=10 联合优化交叉熵和流匹配,推理时先自回归解码子任务、再 10 步去噪出 50 步动作块,50Hz 下发给 PD 控制器——没有轨迹规划、没有碰撞检测,全端到端。Fig 18 的掩码是关键:前缀双向、FAST 因果、专家双向,互不可见,信息只从骨干流向专家。
数据:六路混合——400 小时移动操作(100 个家)、多环境固定臂、实验室跨本体含 OXE、人工标注的子任务+检测框、网页描述问答、口头指令演示。消融显示 ME/CE 是任务分的刚需,网页数据扛分布外语义,口头指令只占 11% 却关键。
结果与评价:104 个训练地点后,未见家庭的多阶段任务追平「见过测试家」的对照;真实 3 家 10 次试验的 mock-真实一致性验证了评测可信度;高层消融里 implicit HL 第二、GPT-4 垫底。它证明 co-training 配方 + 两级推理能把 VLA 推到开放世界,但仍是纯模仿闭环——失败不会自动反哺,这是 RSI 线要接的下一块。
❓ 自测 Q&A
Q1:π0.5 的动作为什么要在训练里搞两套表示? 因为训练和推理的最优表示不同:FAST 离散 token 训练高效稳定(预训练用),Flow Matching 推理快、连续精度高(部署用)。两套同住一个 Transformer,用注意力掩码隔离(互不可见、单向 VLM→专家),既共享了骨干表征又不互相污染。
Q2:高层推理的分布分解公式是什么意思? π(a, l̂|o,l) = π(a|o,l̂)·π(l̂|o,l):动作不直接依赖总指令,只依赖模型自己先吐出的子任务。大局由文本消化、执行只看子任务——这让两级各自能吃不同的数据(低层吃动作、高层吃语义),也是 Fig 13 消融能分层归因的数学前提。
Q3:Fig 18 里为什么动作专家对 FAST token 完全失明? 防信息泄漏:FAST 和专家是同一段动作的两种编码,若专家能读 FAST,就等于变相把答案抄给回归任务,两套表示的独立性与消融解释都会失效。反过来 FAST 也读不到专家。
Q4:为什么说「implicit HL 排第二」这个结果重要? 它把两级推理的收益拆成两半:数据(训练见过子任务标注)贡献大半,运行时显式推理贡献小半——说明想提升高层能力,先补语义标注数据,而不是急着加外挂规划器;GPT-4 零样本垫底进一步佐证领域数据不可替代。
Q5:网页数据(WD)在两个消融里表现矛盾吗? 不矛盾:Fig 10(端到端任务分)里 no WD 不显著,Fig 11(语言跟随,OOD 物体)和 Fig 13(高层推理)里 no WD 显著变差——WD 的贡献集中在语义泛化与高层推理,不在低层执行。这正是「每味料要单独消融」的教科书案例。
Q6:π0.5 的控制系统简单到什么程度?为什么敢这么简单? 50Hz 直接下发目标位姿/速度,PD 跟踪,无轨迹规划、无碰撞检测,18-19 维全端到端。敢这样是因为智能全在策略里——风险也在此:碰撞、安全全靠数据分布兜底,没有模块化系统的最后一道防线(这也是 VLA 安全方向的入口)。
📚 资源与延伸
论文本体
- π0.5:
arxiv.org/abs/2504.16054(2025-04-22),HTML 版含全部图表 - 站内图片:
/images/pi05/(20 张,Fig 2~18 全量)
顺着读:π0 精读(骨架来源)· π0 代码讲解(动作专家代码)· Flow-Matching 入门(数学底子)· VLA 大模型训练技巧(FAST/co-training 配方语境)· 前沿 VLA 模型全景速览(族谱定位)· RDT 与 RDT2 精读(扩散路线对照)· Zetta 与 EmbodiRSI 精读(π0.5 缺的自我改进闭环)
一句话结论:π0.5 教你把「训练稳定、推理实时、语义泛化」三个目标拆进三个不同的机制——两阶段损失、掩码隔离的双动作头、六路 co-training——而三者共用同一个 Transformer。