配图说明:本文收录 19 个 benchmark 共 55 张插图(前 14 章 + 第二辑 5 章)(按 bench_* 目录分放),每章独立逐图讲解,文末附图表总索引。写法沿用站内精读惯例:每个 benchmark 都回答四件事——①是什么(论文出处)②任务是什么 ③仿真还是真机、怎么测(协议/指标/划分)④插图里画了什么。本文与 RoboDojo 精读 互为姊妹篇:RoboDojo 是「统一仿真-真机评测场」的单篇深挖,本篇是周边全部常用考场的横向图鉴;前 14 章按时间线从 2019 经典排到 2026 基础设施,**第二辑(15–19 章)**按 OpenWAM 论文(2609.07398)的评测栈补齐 LIBERO 系与移动/灵巧赛道——两辑合读即 OpenWAM-α 精读 九榜的完整背景。
📖 导读:19 个 benchmark 一张表看懂
| # | Benchmark | 年份/出处 | 类型 | 规模一句话 | 核心指标 |
|---|---|---|---|---|---|
| 01 | Meta-World | 2019 · CoRL | 仿真(RL) | 50 任务 × Sawyer | MT/ML 协议平均最大成功率 |
| 02 | RLBench | 2019 · CoRL | 仿真(模仿/RL) | 100 任务 × Franka | 成功率 + 变体泛化 |
| 03 | CALVIN | 2021 · RA-L | 仿真(语言长程) | 4 房间 34 任务、五步语言链 | 链成功率(MCIL 式) |
| 04 | RoboCasa | 2024 · RSS | 仿真+真机(厨房) | 100 原子 + 75 复合、2,509 物体 | 原子/复合成功率 |
| 05 | SimplerEnv | 2024 · CoRL | real-to-sim 评测 | Google Robot 8 任务 + WidowX Bridge | 与真机成绩的 MMRV/Pearson 相关 |
| 06 | BEHAVIOR-1K | 2024 · NeurIPS | 大规模仿真 | 1,000 活动 × 50 场景(OmniGibson) | 活动谓词成功分 |
| 07 | VLABench | 2024 · ICCV 2025 | 仿真(语言+推理) | 60 原子 + 40 复合、2,000+ 物体 | 分维度成功率/难度分 |
| 08 | ManiSkill3 | 2024 · RSS 2025 | 仿真框架+基准 | GPU 并行 30,000+ FPS、16+ 本体 | 成功率(RL/IL/VLA 基线) |
| 09 | RoboTwin 2.0 | 2025 | 双臂数据引擎+基准 | 50 双臂任务、5 本体、11k 纹理 | clean/randomized 成功率 |
| 10 | RoboCasa365 | 2026 · ICLR | 大规模训练+基准 | 365 任务、2,500 场景、2,200+ 小时 | 预训练/后训成功率 |
| 11 | MagicSim | 2026 | 仿真基础设施 | 15 仿真家族、批式确定性运行时 | 吞吐/可复现性(工程指标) |
| 12 | XPolicyLab | 2026 | 评测生态 | 一次接入 → 多个官方榜 | 榜单排名 + 接入成本 |
| 13 | HumanCLAW-Bench | 2026 | 仿真(人形全身) | 1,218 episode × 41 室内住宅 | Find→Nav→Interact 分级成功率 |
| 14 | RoboCurve | 2026 | 真机独立评测 | Inspect Robots 框架 + 多个真机 bench | 真机得分/拒答率 |
| 15 | LIBERO | 2023 · NeurIPS | 仿真(语言/终身学习) | 130 任务 × 4 套件 + LIBERO-90 预训练集 | 分套件成功率(迁移研究) |
| 16 | LIBERO-Plus | 2025 · CVPR 2026 | 仿真(鲁棒性压测) | 10,030 任务 = 7 扰动因子 × 21 子维 | 扰动下成功率保持率 |
| 17 | RoboCasa-GR1 | 2025–26(OpenWAM 评测栈) | 仿真(灵巧手赛道) | RoboCasa 任务系 + 灵巧手本体 | 成功率(α 榜 60.5) |
| 18 | EBench | 2026 | 仿真(移动双臂诊断) | 26 任务 × 三族 × 五轴 | 分轴/分 split 成功率 |
| 19 | RoboDojo | 2026 | 统一仿真+真机(详见专文) | 42 仿真 + 18 真机、五能力维 | 平均分/成功率双指标 |
先说两个容易混淆的点:①05 SimplerEnv 不是「造新任务」,而是把已存在的真机实验搬进仿真去复测策略——real-to-sim;②11/12/14 不是任务集,而是让别的 benchmark 能被公平跑起来的基础设施(仿真运行时、策略接口、真机评测服务)。读每一章先看「类型」一行,就不会把它们和任务型 benchmark 混在一起。
01 · Meta-World(2019 · 多任务与元强化学习的「标准操场」)
一句话定位:CoRL 2019 的开源仿真基准(arXiv 1910.10897),把「一个策略学 50 件事」和「学会学习」拆成四套协议,是此后所有 multi-task/meta-RL 论文的公共对照组。
任务与本体(仿真):Sawyer 单臂桌面操纵,50 个任务(reach / press / pick-place / door / hammer / assembly 等家族),设计原则是「多样但共享结构」——同一家族的任务可以按参数化/非参数化方式变形(例如所有 reach-puck 任务只改目标点),天然适配元学习的「同任务换目标」设定。
评测协议与指标(重点):
- 四套协议:ML1(单任务元学习,换目标)、ML10/ML45(学 10/45 个任务、测新任务)、MT10/MT50(多任务 RL,训练测试同任务集);
- 指标:每个任务有距离阈值型成功判据(单位米,见论文 Table 12 全列),报告「平均最大成功率」(每 seed 学习曲线取峰值再平均,10 seeds);
- 结论基调:MTRL 里 MT-SAC 最好,元 RL 里 RL² 最强,但 ML-45 上所有方法都「开始能解决一部分」——任务数量一多就掉。
插图逐张
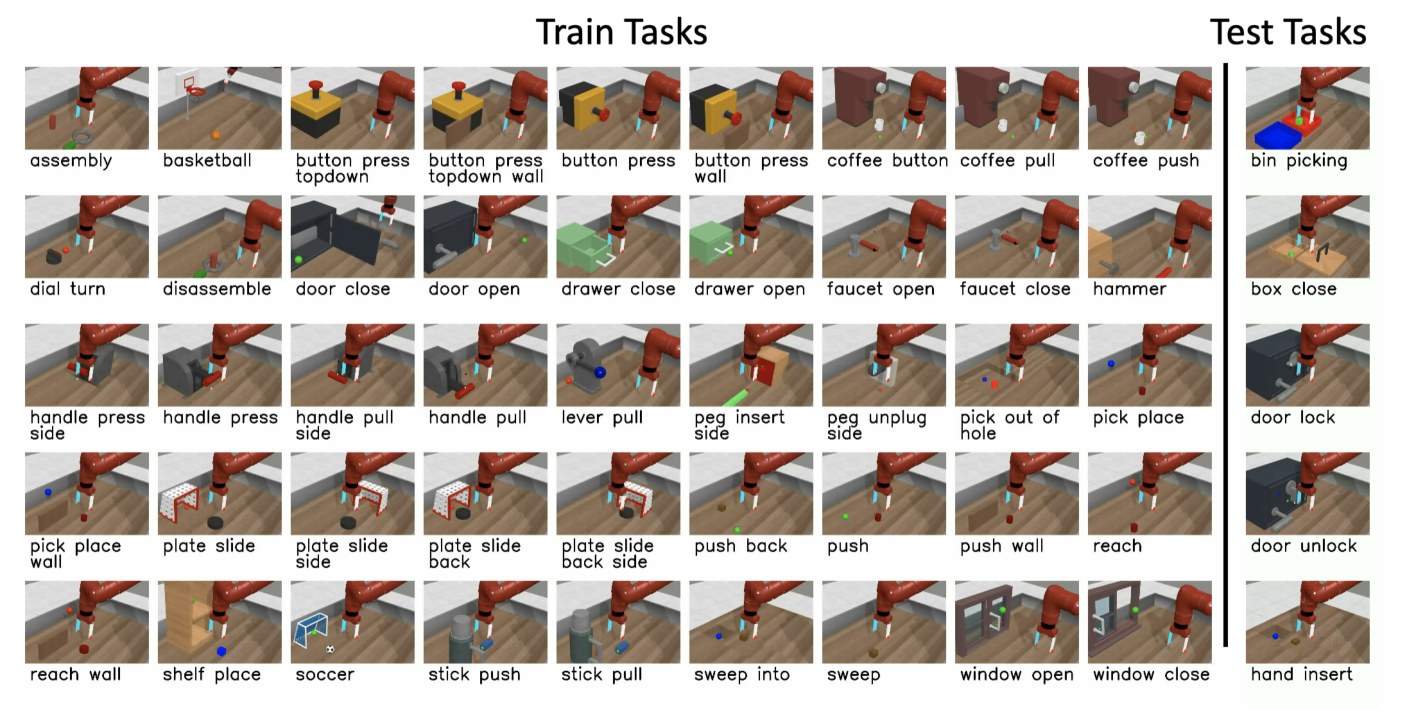
Figure 1(头图):50 个任务总览
(即文首头图。)网格里每个小格是一个任务场景:机械臂 + 桌面目标(puck、门、抽屉、按钮、锤子、方块装配……)。读图要点:视觉上高度同构(同一张桌子、同一臂),差异集中在目标与工具——这正是「共享结构」的直观呈现,也是它能同时支撑多任务与元 RL 的原因。
Figure 3:三套评测协议示意
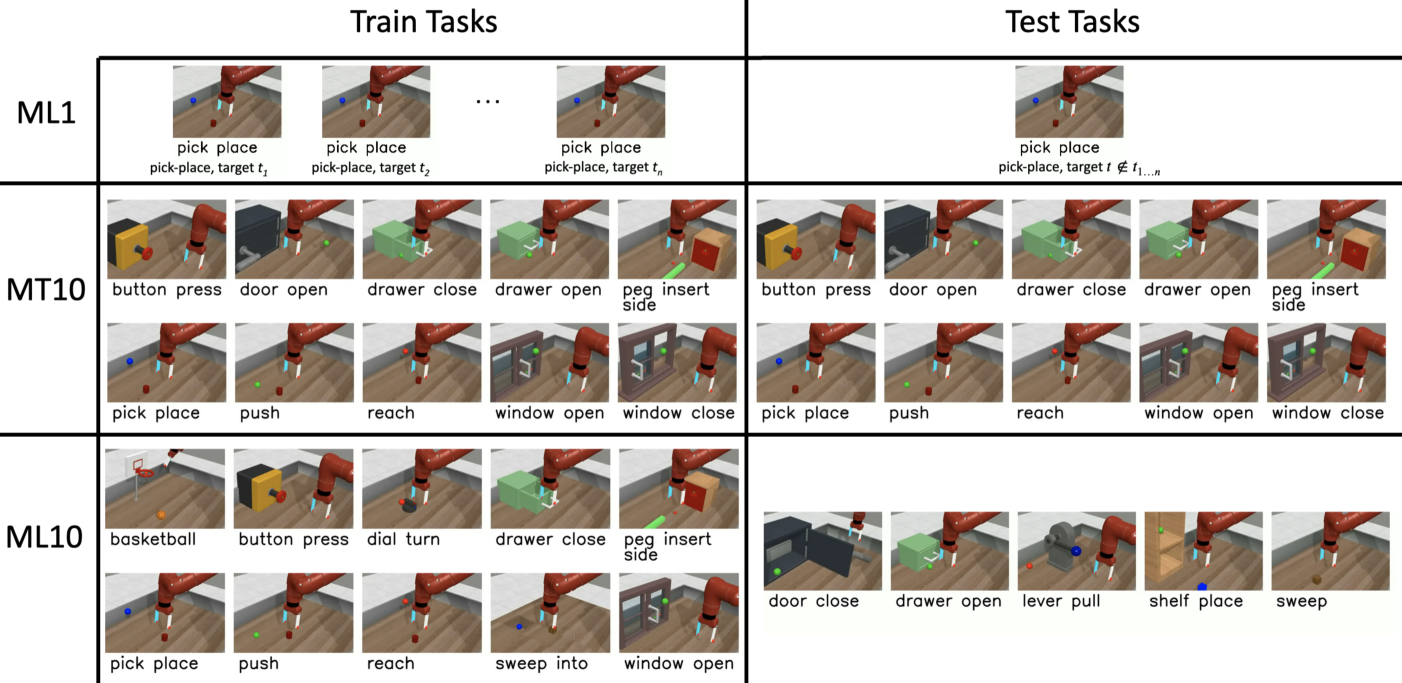
图示从「同任务内换目标」到「跨任务泛化」的协议光谱:ML1 只换实例参数,ML10/45 换整任务,MT10/50 是多任务并训。结合导读表记忆:看别人报 Meta-World 分数,先问是哪套协议——MT50 高分≠元学习强。
生态位:RL 界的「Hello World」;VLA 时代更多作为算法消融底座而非能力上限测试(任务偏短、桌面偏干净),这也是 RoboDojo/LIBERO 们后来居上的原因。
02 · RLBench(2019 · 100 任务 + 无限演示的模仿学习考场)
一句话定位:CoRL 2019(arXiv 1909.12271)的仿真基准与学习环境,100 个手工设计任务 + 自动生成演示,长期是「学操作技能」的默认大考场。
任务与本体(仿真):CoppeliaSim(旧 V-REP)里的 Franka Panda 固定在木桌上、三盏方向光(Figure 2 场景);100 个完全唯一的任务,覆盖抓取、抽屉、工具、双臂协作雏形等,每个任务带文字描述与无限生成的演示(运动规划采样,不靠人工遥操作——「infinite supply of generated demonstrations」)。
评测协议与指标(重点):
- 层级:task → variation → episode(同任务不同初始为 variation,一次执行为 episode);
- 观测栈:过肩立体相机 + 腕部单目 RGB + 关键点/状态信号(Figure 3);
- 成功 = 任务成功判定器翻转;常见用法是 K-shot 模仿或 RL、跨 variation 测泛化。
插图逐张
Figure 1:100 个任务网格
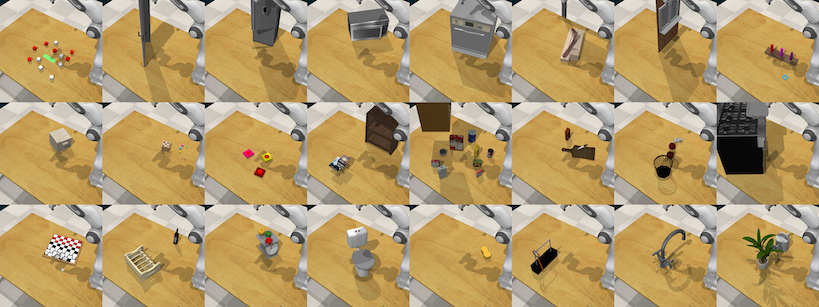
100 个任务关键帧拼图——每个格子一个任务的代表性画面。信息点:任务粒度远细于 Meta-World(含 push button、close jar、take lid off pot 等具体动词短语级任务),且刻意覆盖不同接触模式;这也是它被 PerAct/Diffusion Policy 等大量方法选作主基准的原因。
Figure 3:观测栈
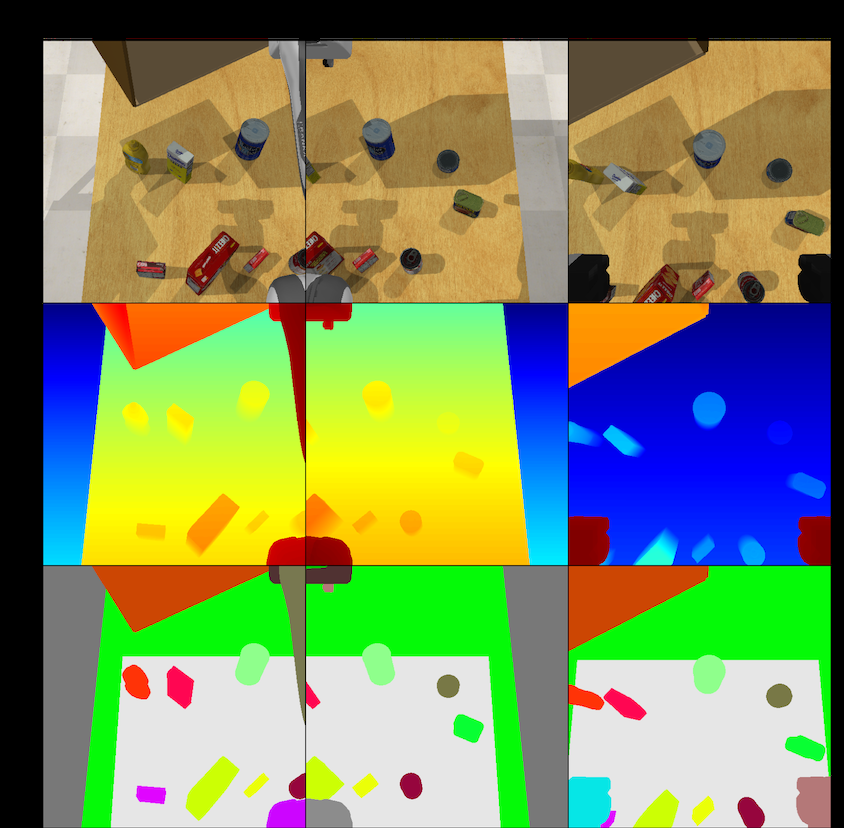
同一时刻的两类视觉输入对照:过肩立体视觉(场景全局)与腕部单目(近距接触),旁边还有关键点/状态通道。评测含义:方法可以只用 RGB,也可以吃 privileged 信号——比结果时要对齐观测配置,否则不公平。
Figure 4:task / variation / episode 三层
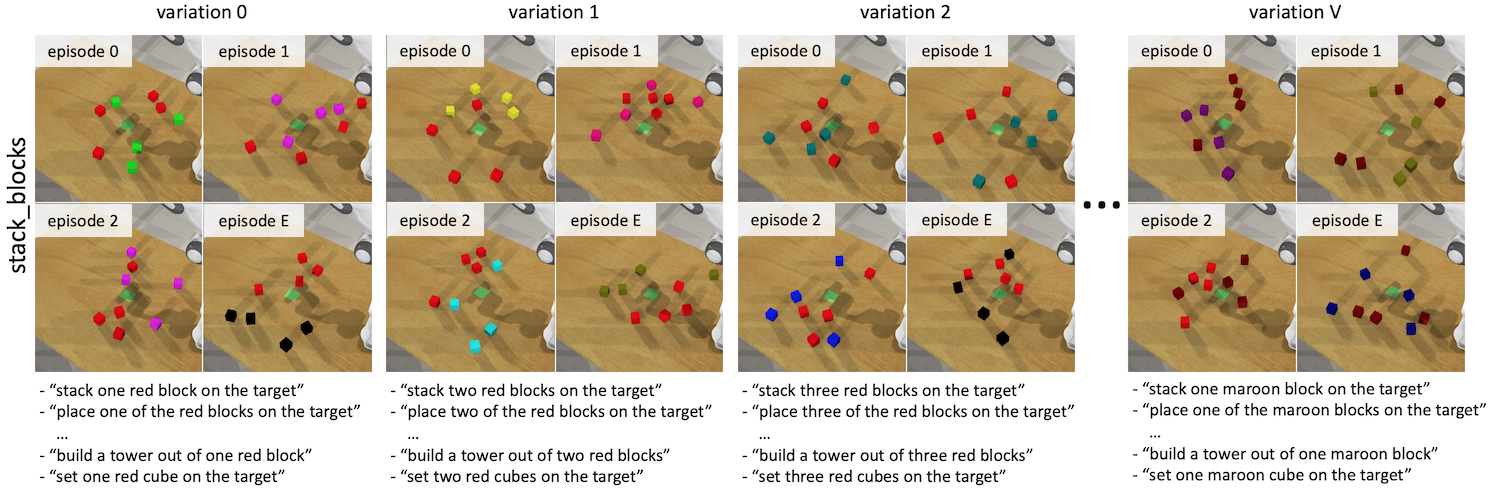
以 stack_blocks 为例画出三层结构:任务定义不变,variation 改变物体摆放,episode 是一次 rollout。协议核心:训练见若干 variation、测试换新 variation——「同任务泛化」的最早清晰图解之一。
生态位:技能学习与模仿算法的「标准操场」;短板是语言条件弱(描述固定集合)、场景单一——后被 CALVIN/LIBERO 在语言与长程维度上分走关注。
03 · CALVIN(2021 · 自由语言驱动的长程操纵)
一句话定位:RA-L 2022(arXiv 2112.03227)的仿真基准,用众包自由句指挥 7 自由度臂在四个结构相近的房间里连做长程任务——语言条件操纵的经典开场。
任务与本体(仿真):Franka 桌面(带抽屉/灯/滑块的百宝柜),四个环境 A/B/C/D(家具排列不同);34 个子任务;语言来自众包、措辞不受模板限制(“open the drawer… now push the blue block…”)。
评测协议与指标(重点):
- 链式评测:每条指令链连续 5 个子任务,一个失败即整链停;共 1000 条链做测试(含跨环境/跨物体设定:ABC→D 等);
- 常见设定缩写:SL(单语言短程)、MVLTC/MTLC(多视觉-语言/多任务长链);
- 基线 MCIL 的结论被反复引用:短程 53.9% 成功率,长链大幅下滑——CALVIN 就是为暴露这个差距而生。
插图逐张
Figure 1:训练 A/B/C → 测试 D
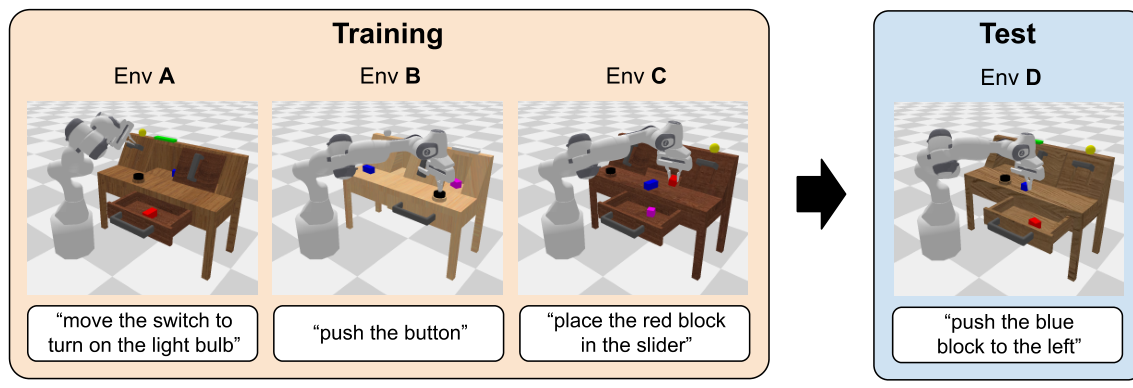
左框 Training:Env A/B/C 三个房间各配一条示例指令(“move the switch…”、“push the button”、“place the red block in the slider”);右框 Test:Env D 换家具布局换指令(“push the blue block to the left”)。一眼看懂 CALVIN 的泛化考法:同构房间换布局换物体,语言零样本。
Figure 3:传感器配置
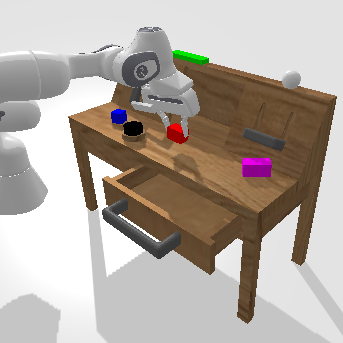
支持的观测模态:静态相机 RGB(-D)、腕部/头戴视角、机器人本体状态与夹爪状态。评测时论文给的公平基线是「静态相机图像 + 本体」——换模态会显著改变成绩,读表先对齐这一栏。
Figure 5:五步语言链示例
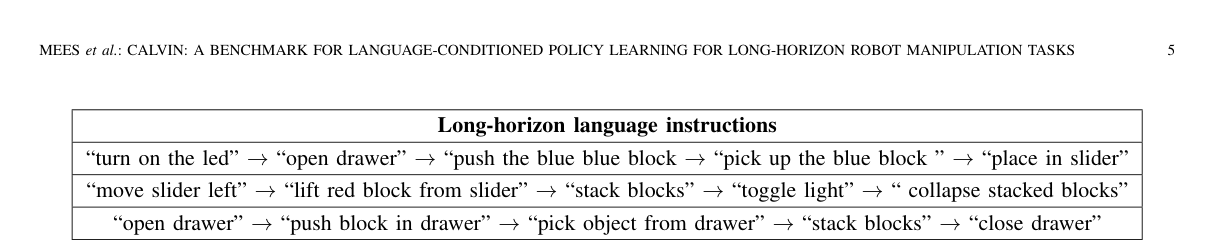
三条链样本:“turn on the led → open drawer → push the blue block → pick up the blue block → place in slider” 等,每条恰好 5 步、前一步的终态是后一步前提。这就是「长程」的度量单位——链成功率 = 五步全对的概率,五步各自 90% 也只剩 ~59%。
生态位:自由语言 + 链式协议成为后续 LIBERO/VLABench 的直接思想源头;短板是房间单一、任务都围绕同一只百宝柜。
04 · RoboCasa(2024 · 大规模厨房仿真 + 真机复现)
一句话定位:RSS 2024(arXiv 2406.02523)的仿真框架 + 基准,把厨房场景做成「可程序化生成的任务宇宙」,并在真机厨房做小样本验证。
任务与本体(仿真为主,含真机):
- 场景:参考家装杂志的厨房平面图生成多种布局(Figure 2),几十种可交互电器(Figure 3:烤箱、冰箱、洗碗机、微波炉……);
- 资产:2,509 个高质量 3D 物体、153 个类别(Figure 4);
- 任务:100 个原子任务 + 由 LLM 引导生成的 75 个复合任务(Figure 5 展示 LLM 生成流水线:先列活动再展开技能序列);
- 真机:真实厨房 + Franka Emika(Figure 8),少量演示下测迁移。
评测协议与指标(重点):
- 仿真内按原子/复合分开报成功率;复合任务 = 技能串联(开柜→取物→放盘),失败会级联;
- 数据对照实验:人类演示 vs 机器生成数据学习曲线(Figure 6/7);
- 真机评测(Figure 9):真机厨房里逐任务成功率,验证仿真训练策略的可迁移性;
- 长期演进:RoboCasa→RoboCasa365(见第 10 章)把它推到预训练规模。
插图逐张
Figure 1:四支柱总览
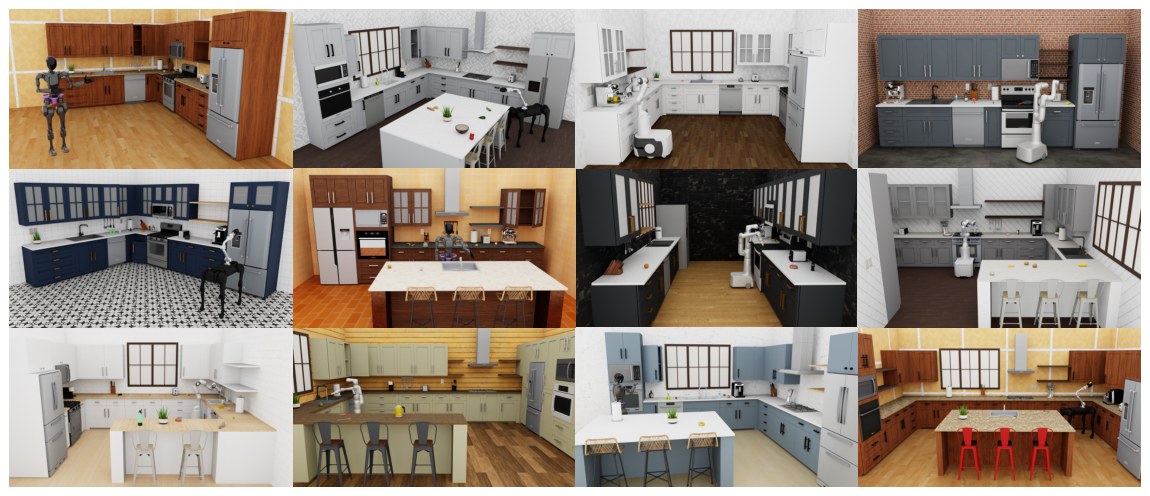
十二宫格厨房渲染:不同平面图、不同装修、带机械臂的工作位。文字层(论文原图)列出四支柱:场景/资产库、任务生成、数据引擎、基准。读图抓手:「厨房先于任务」——先把可复用的家居世界搭出来,任务再往上长。
Figure 2:厨房平面图族
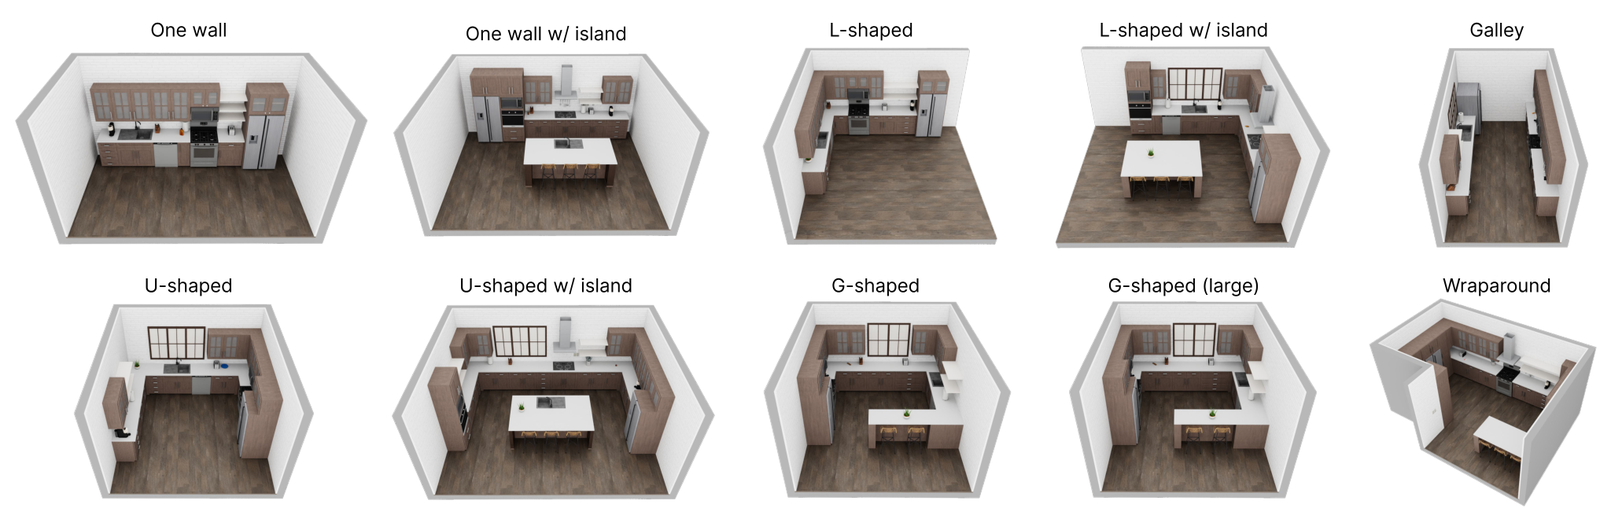
从家装杂志归纳的平面图模板(一字型/L 型/岛台型……)及变体。评测意义:布局多样性是泛化维度的供给侧——同任务跨平面图测试才有效度。
Figure 3:可交互电器
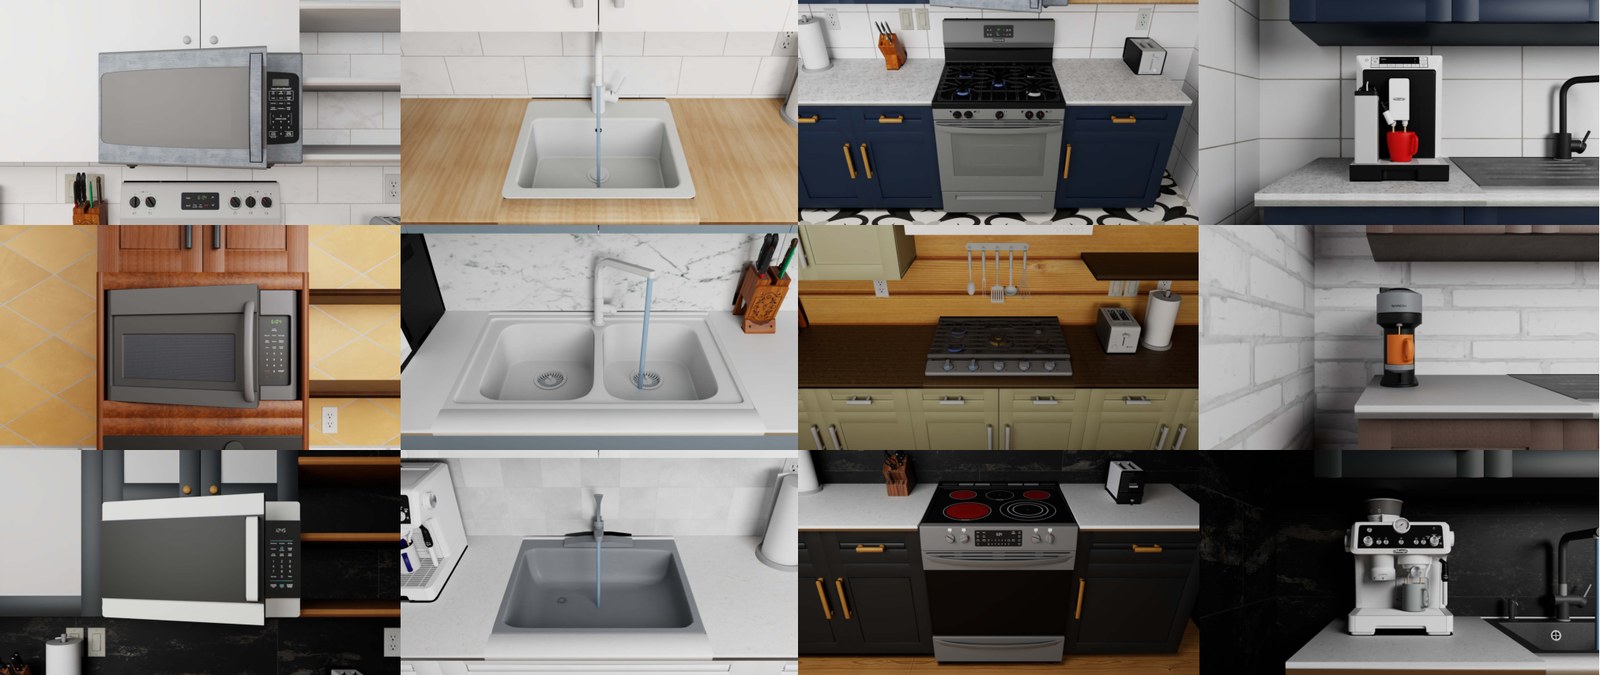
几十种电器的外观与开门/抽拉交互形态。原子任务大多绑定在这些电器上(开、关、取、放),构成 100 任务的骨架。
Figure 4:2,509 个 3D 物体
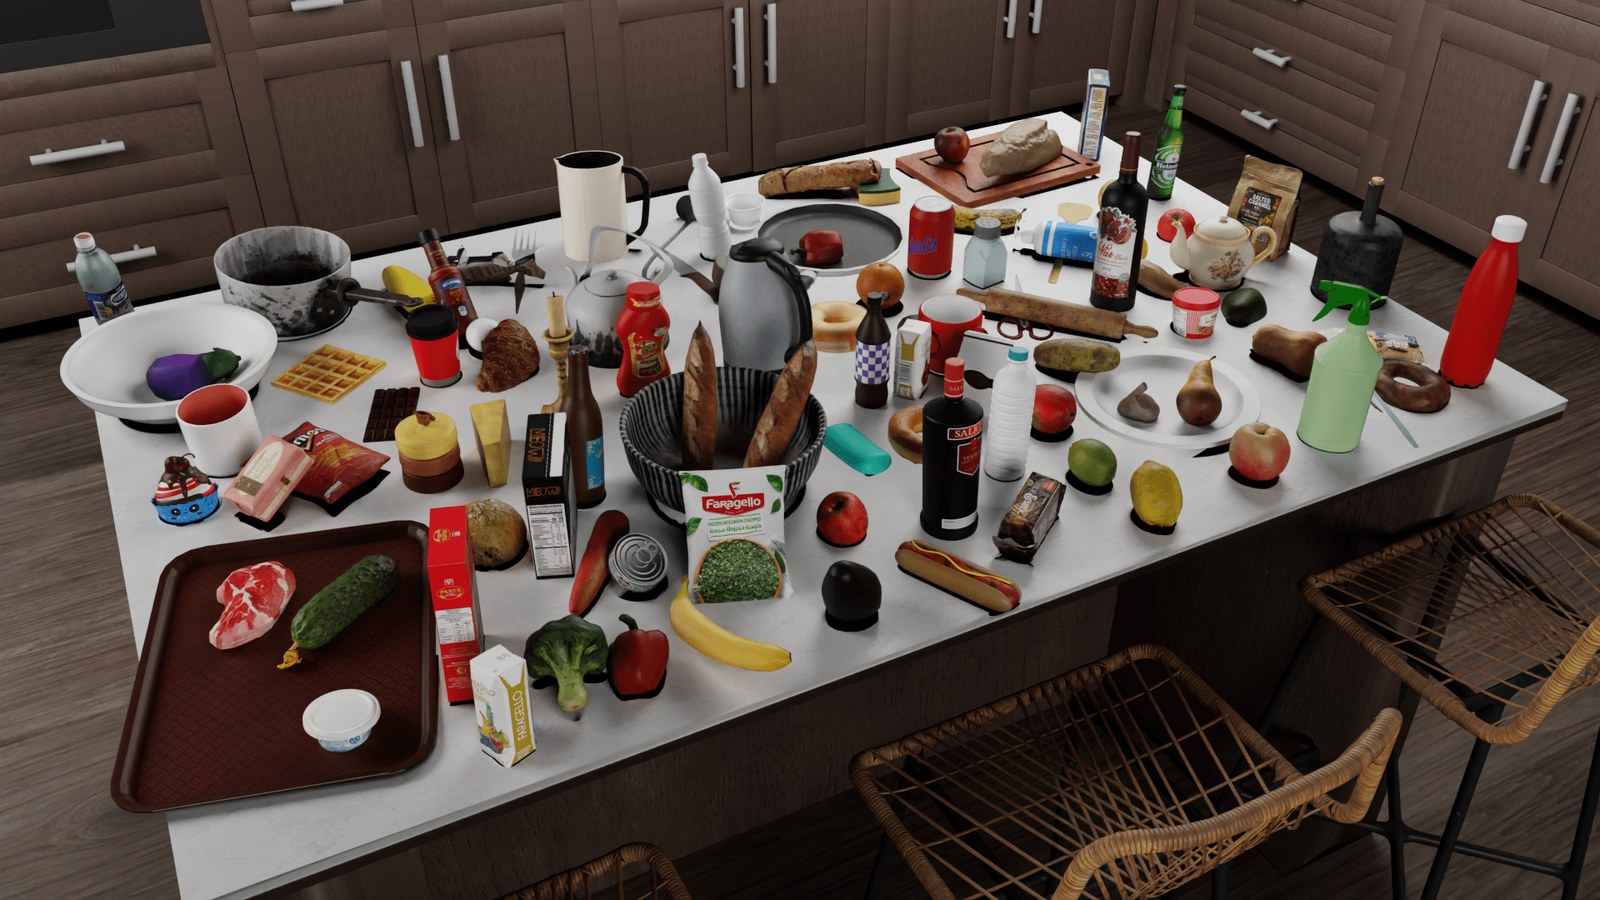
按类别陈列的物体网格(餐具、食材、清洁用品……)。资产级多样性支撑物体泛化:训练见同类不同实例,测试换实例。
Figure 8:真机厨房实验设置
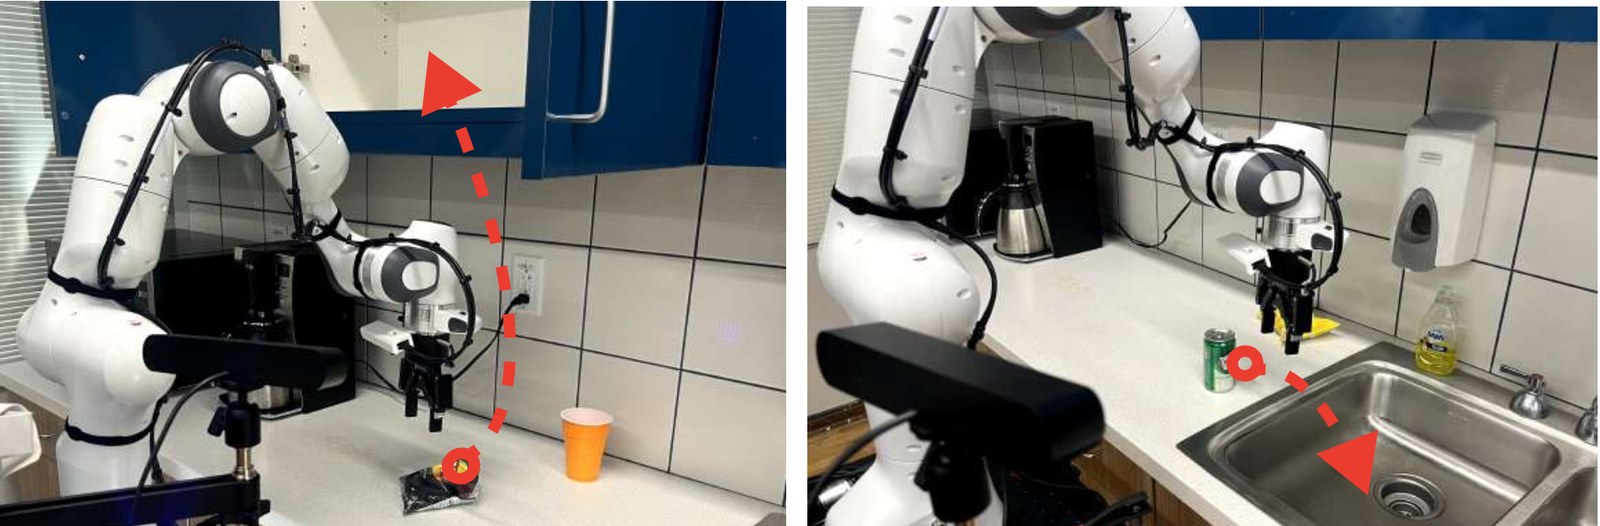
真实厨房台面 + Franka 机械臂 + 相机机位。这是本 benchmark 的「真机锚点」:仿真里量吞吐和多样性,真机上验证接触与视觉差异——与 RoboDojo 的 sim/real 分工哲学一致(见姊妹篇)。
生态位:家庭厨房任务的事实标准之一;LIBERO 管「桌面短程」、RoboCasa 管「厨房长程 + 电器交互」。
05 · SimplerEnv / SIMPLER(2024 · 把真机实验搬回仿真复测)
一句话定位:CoRL 2024(arXiv 2405.05941,Stanford/Google 系)的 real-to-sim 评测套件——不发明新任务,而是复刻已有的真机基准装置(Google Robot、WidowX+Bridge),让仿真成绩能预测真机排名。
任务与本体(仿真复刻真机):
- Google Robot 装置:everyday-robot 本体、头置 egocentric 相机、控制频率 3Hz——任务含 “pick coke can”、“open/close drawer” 等(RT-1 系任务集);
- WidowX + Bridge 装置:WidowX-250 六轴臂 + C920 第三视角相机、5Hz——“put the spoon on the towel”、“stack the green block on the yellow block” 等四任务组。
评测协议与指标(重点)——本 benchmark 的灵魂在协议:
- Visual Matching(视觉匹配):把仿真外观调到贴近真机(背景/桌面/物体质感),考「同分布复测」;
- Variant Aggregation(变体聚合):同任务大量随机变体取聚合,考稳健估计;
- 系统辨识(SysID, Figure 3):标定质量/摩擦/控制增益,关掉控制层鸿沟;
- 相关性指标:MMRV(Mean Maximum Rank Violation,越低越好)+ Pearson r——共约 1,500 episode 的真机-仿真对,证明仿真能复现策略排名与失败模式(不只是数值接近);
- 拓展用途:预测策略对分布偏移的敏感度(如臂部贴图变化对 Pick Coke Can 的影响,Figure 8/10)。
插图逐张
Figure 1:SIMPLER 套件总览
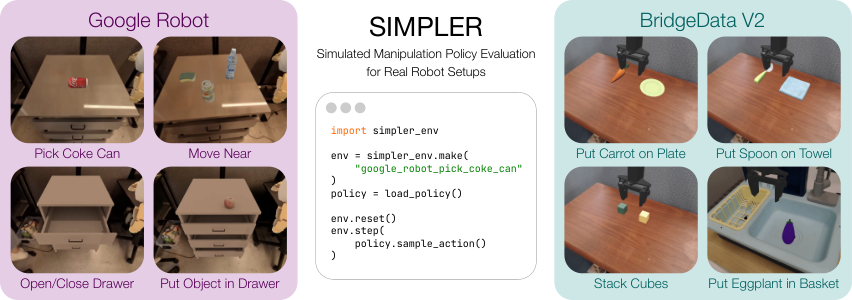
左:真机上挨个测策略费时费力;右:SIMPLER 的仿真孪生环境(Google Robot / WidowX 两套装置的仿真渲染对照)。要点:评测对象是「装置」不是「任务发明」——装置对齐了,策略成绩才有可比性。
Figure 3:系统辨识
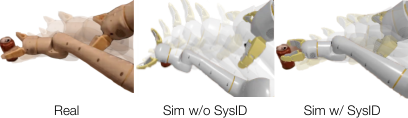
真机-仿真闭环对照示意:辨识控制参数(质量、摩擦、增益)把「同样的动作指令」变成「同样的运动效果」。没有这步,成功率差异可能全来自物理参数而非策略。
Figure 4:视觉匹配
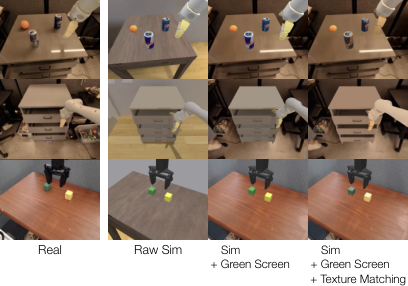
真机场景照片 vs 仿真复刻的并排对比(背景、桌面、光照、物体质感对齐)。与 Figure 3 合起来就是 SIMPLER 的两板斧:先关控制 gap,再关外观 gap。
Figure 10:变体聚合环境网格
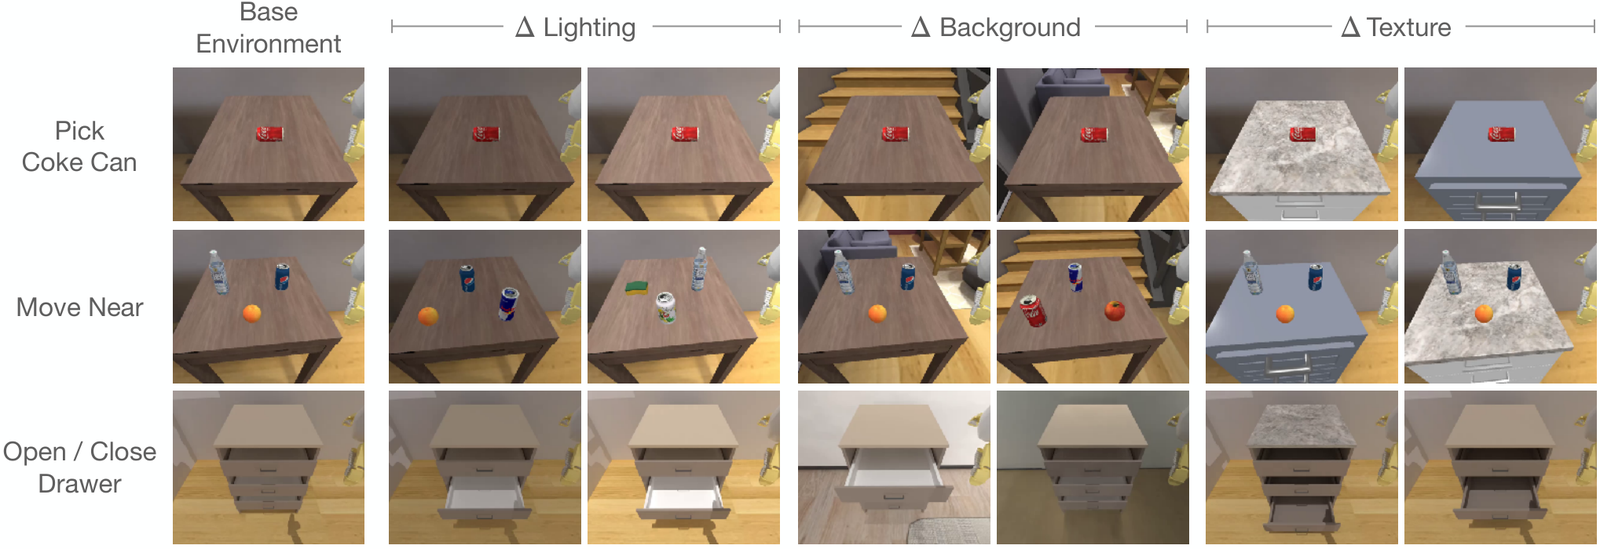
同一任务下大量布局/物体/位姿变体的仿真渲染网格。用于 Variant Aggregation 模式:单点成绩不可信,变体分布上的聚合才与真机排名相关(论文核心统计就建立在这上面)。
生态位:OXE 时代 VLA 的真机成绩代理——OpenVLA/Octo/RT-1-X 系工作大量用它做「不碰真机的真机评测」;ManiSkill3 里也内置了部分 SIMPLER 环境(见第 08 章)。
06 · BEHAVIOR-1K(2024 · 1000 个日常活动的「人本」大基准)
一句话定位:NeurIPS 2024(arXiv 2403.09227)——1,000 个经人类偏好筛选的日常活动 × 50 个写实室内场景,跑在物理仿真 OmniGibson 上,主打「活动级」而非「技能级」评测。
任务与本体(仿真,含真机对照分析):
- 活动定义来自 BSS(Behavior Specification Schema):先对 2,090 个活动做人类偏好/可行性调查再入选 1,000 个(Figure 1);
- 覆盖清洁、烹饪、收纳、派对准备等全身-多物体长活动(附录列出 BakingSugarCookies、PackLunch 等谓词化定义);
- 仿真器 OmniGibson(iGibson 系):50 场景、丰富物体状态(开/关、脏/净、装/空)与逻辑谓词成功判定。
评测协议与指标(重点):
- 成功 = 一串逻辑谓词在终态全部满足(不是单点接触);活动可拆子步骤;
- 仿真器可信度对比:OmniGibson 3.20±1.23 > Habitat 2.0(1.74)/ AI2-THOR(1.73)/ iGibson 2.0(1.69)/ 3DWorld(1.65)的人类评分(Figure 2 内小图)——「写实度」本身被当成基准指标;
- 基线 RL-VMC(端到端视觉运动)/ RL-Prim(原语+历史)大面积失败(Table 2:RL-VMC 完全失败)——证明 1000 活动远超当前能力;
- Sim-Real 差距刻画(Figure 5):真机-仿真同场景并排 + 传感器信号对照,量化物理/视觉鸿沟。
插图逐张
Figure 1:人本筛选流程
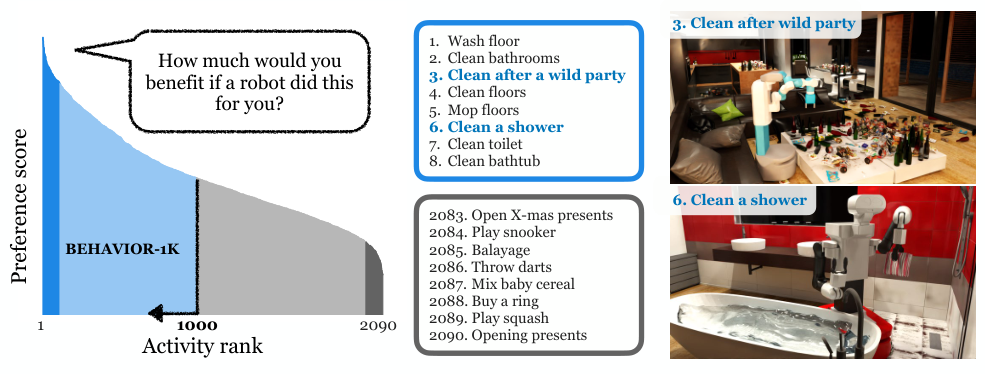
左:2,090 个活动的人类偏好得分分布(先问人「这事值得机器人做吗」);右:筛选管线到 1,000 活动的漏斗。与其他 benchmark 的本质区别:任务集的供给侧是人类价值排序,不是研究者拍脑袋。
Figure 2:数据集 + OmniGibson 二元结构
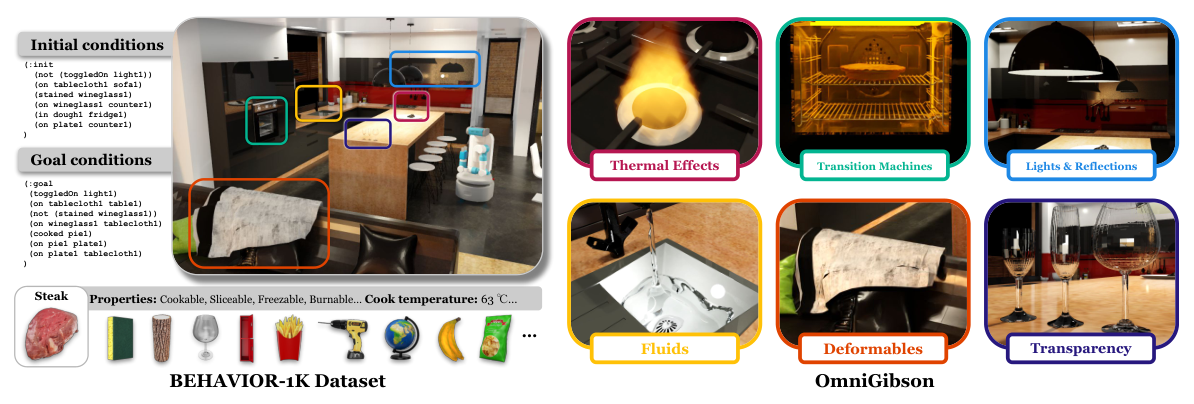
左:BEHAVIOR-1K Dataset(活动定义、物体知识库、谓词);右:OmniGibson(场景/状态/物理渲染),中间嵌五仿真器人类评分对比(OmniGibson 最高 3.20)。评测含义:知识库 + 物理引擎双轮——活动考的是「常识级状态理解」而非纯几何。
Figure 5:Sim-Real 差距刻画
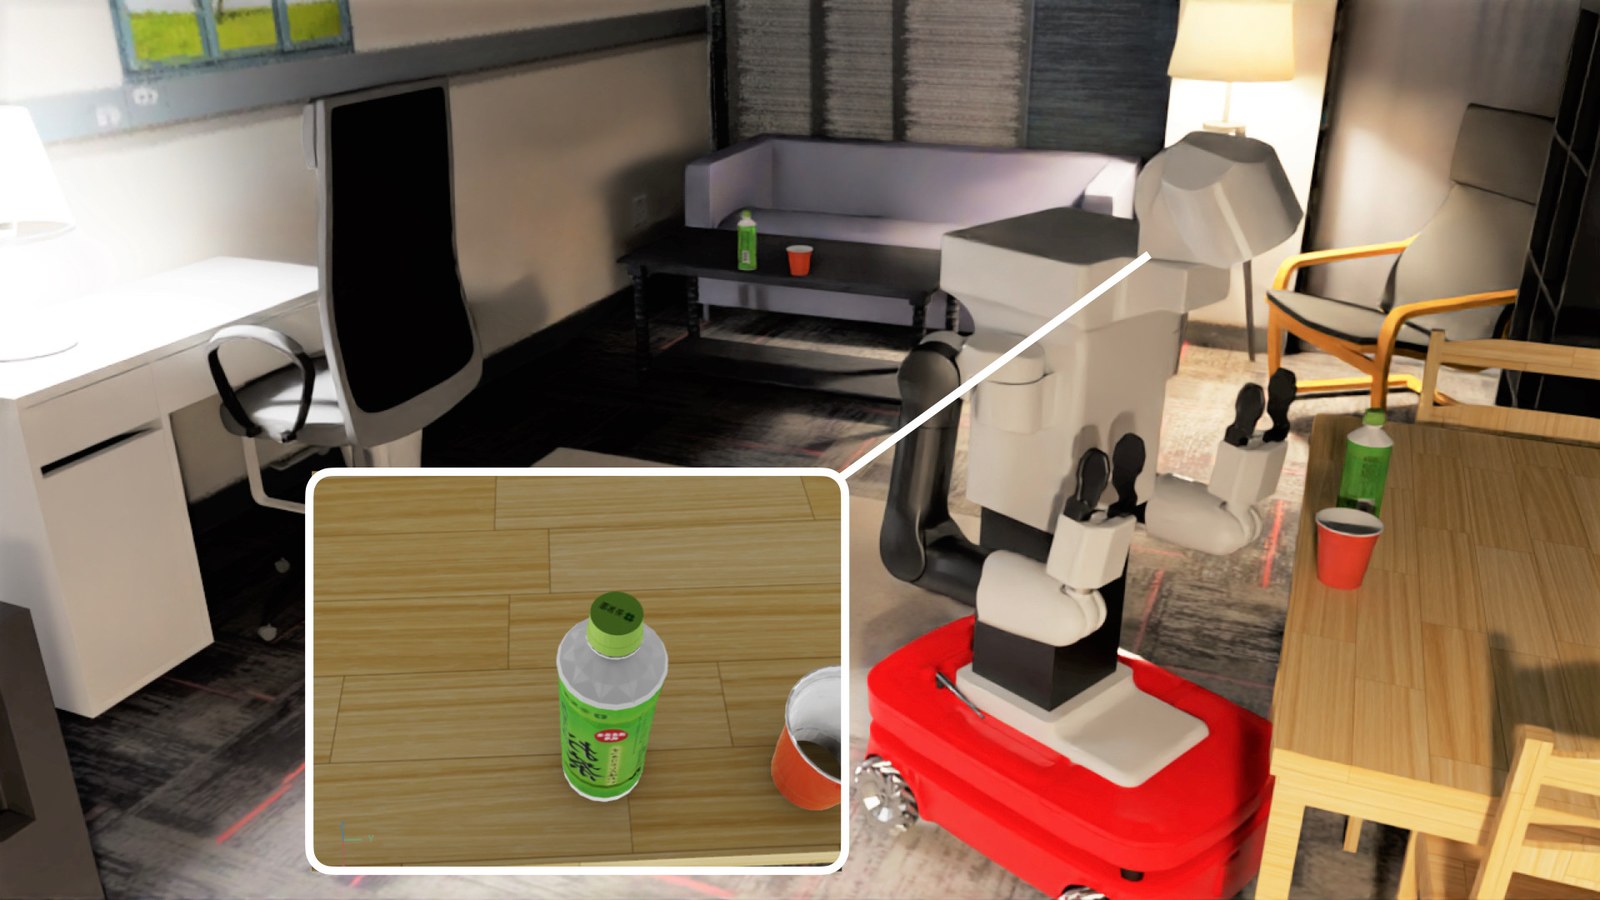
真机场景与仿真场景的并排放样(含传感器信号对照)。这是论文的「诚实度」图:明确 1000 活动是仿真主场,真机只用于刻画差距而非刷榜——与 RoboDojo「真机协议化复测」形成互补。
生态位:活动级/家务级评测的代表;学习类方法目前只能啃它的一小角(长程+状态谓词双重难),更常被用作「还有多远」的方向标。
07 · VLABench(2024 · 为 VLM/VLA 定制的语言-推理操纵基准)
一句话定位:ICCV 2025(arXiv 2412.18194,复旦 OpenMOSS 等)——100 类任务(60 原子 + 40 复合)、2,000+ 物体,专为「语言条件操纵(LCM)」设计的仿真基准,把世界常识/隐式意图/多步推理写进任务书。
任务与本体(仿真):
- 多本体支持(Figure 10 跨本体)、多样场景(Figure 11);观测为四视角 RGB + 点云 + 本体(Figure 7);
- 任务例:“order a latte” 类多步交互(Figure 2)、Select Toy / Insert Flower / Physics QA 等(Figure 8 六个维度样例);
- 能力六维:网格纹理理解、空间理解、语义转换认知、常识/世界知识、物理规律、长程推理(Figure 1 右侧大面板)。
评测协议与指标(重点):
- 分维度成功率 + 难度分(子步数归一化,论文称难度显著高于同类);
- 双赛道:动作策略(VLA 微调,官方发布 π0 微调 ckpt)与 VLM 推理管线(四视角+分割掩码 → 规划,Figure 6 管线;GLM-4V/MiniCPM/LLaVA 等基线,Figure 5 雷达图);
- 泛化切片:视觉/知识迁移、语言指令泛化、未见相似任务、复合任务(Figure 4 四格);
- 关键结论:SOTA VLA 与 VLM 工作流都在这套题上不及预期——隐式意图与常识是短板。
插图逐张
Figure 1:总览与六维能力
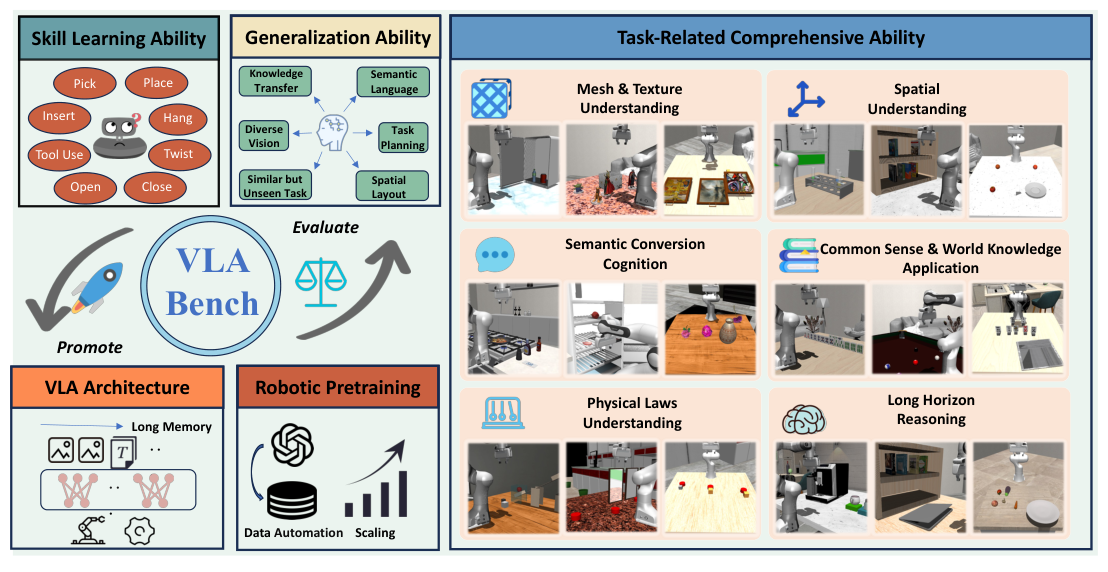
左侧上下两块:Skill Learning(Pick/Place/Insert/Hang/Tool-Use/Twist/Open/Close 八技能)与 VLA Architecture/Robotic Pretraining 的互促箭头;右侧九大样例拼六大能力(网格纹理、空间、语义转换、常识世界知识、物理规律、长程推理)。这张图是本章的「考纲」。
Figure 2:长程推理任务样例
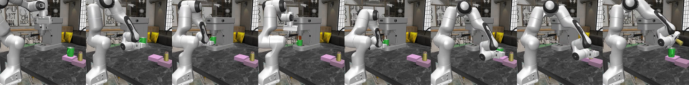
“order a latte” 交互片段:多步、含隐藏状态(哪个杯子/哪步已做)与常识(制作顺序)。对比传统 pick-place 基准:考的是「知道该干什么」而不只是「能碰到什么」。
Figure 3:各维度任务样例
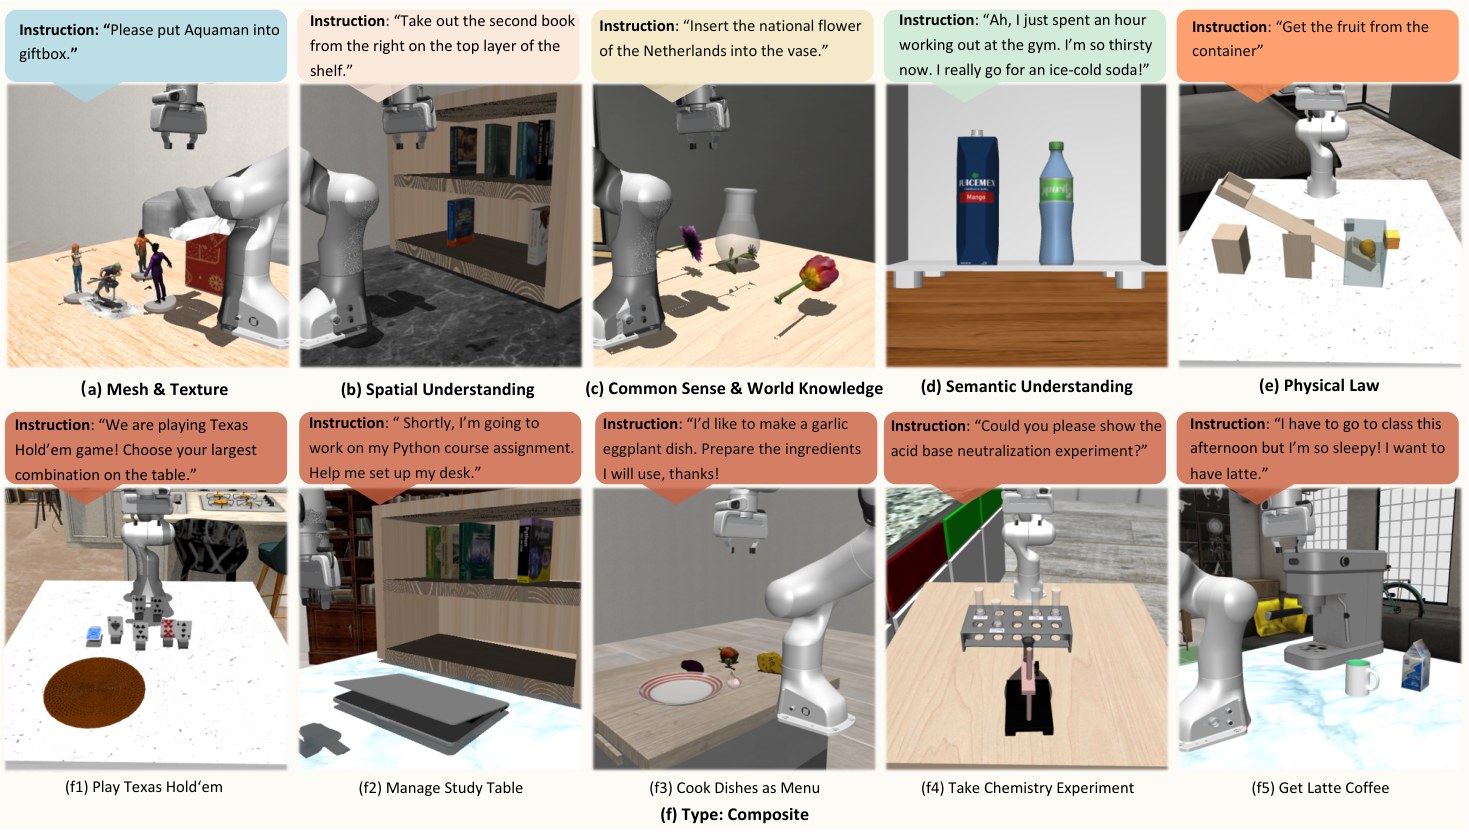
上排原子任务、下排复合任务的场景渲染网格(选物、插入、清洁、摆放等)。解读:同一场景重复出现不同指令——语言是任务开关,这正是 LCM 的定义性设定。
Figure 7:任务观测
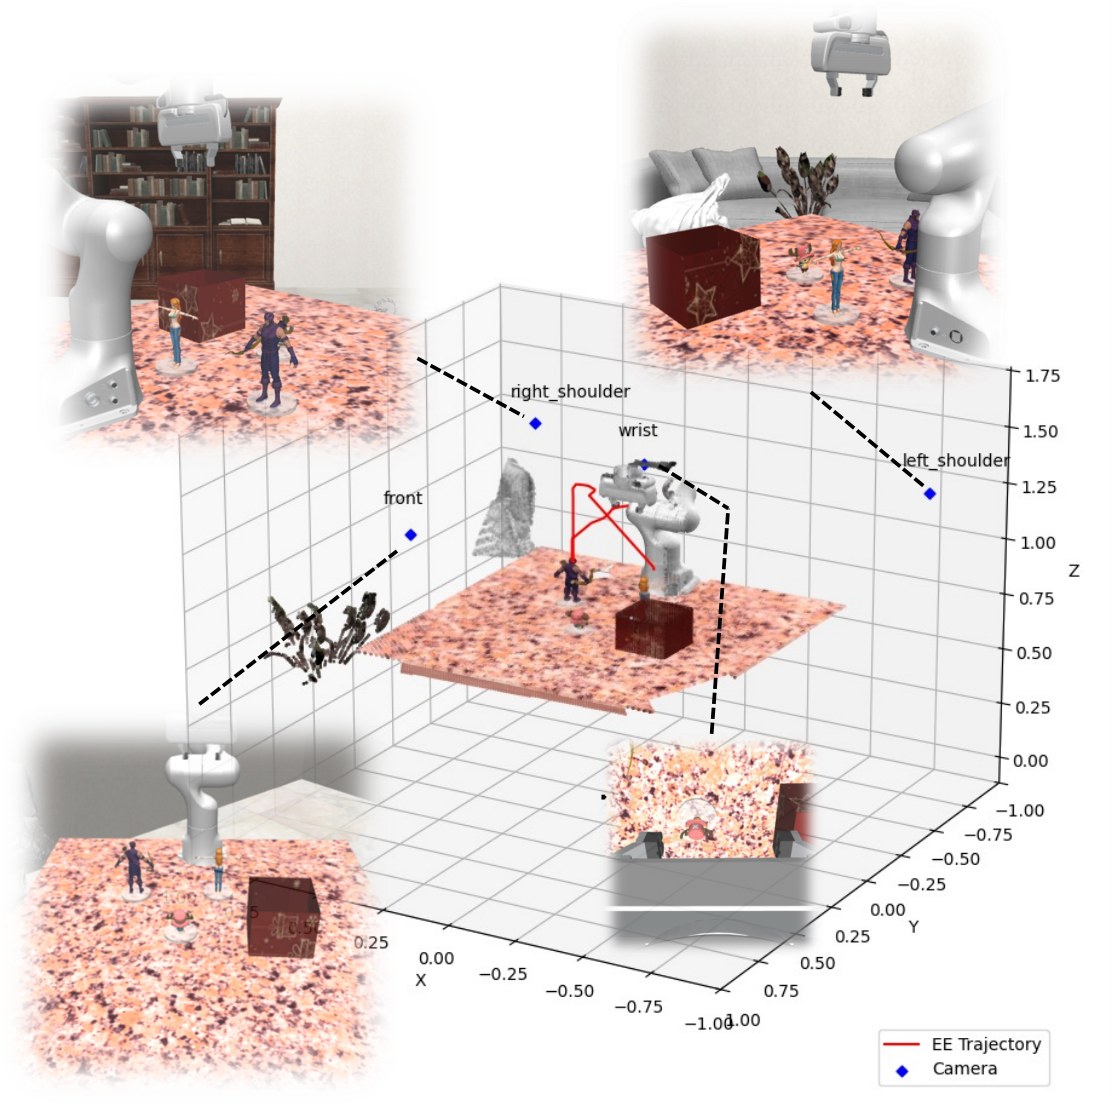
一个 Select Toy 实例的完整输入包:多机位 RGB、3D 点云、专家轨迹示意。评测时输入配置(四视角?带不带点云?)必须写清——不同输入档成绩不可直接横比。
生态位:与 LIBERO 互补的「语言+推理」档;同时给 VLA 和「VLM+规划器」两种范式出题——这一点在别处少见。
OpenWAM-α 视角(2609.07398):α 在本榜得 58.9 分(对照 π0 29.4、π0.5 48.1)——同为「语言+推理」难档,视频底座 WAM 的优势在长程与常识任务上兑现(见 OpenWAM-α 精读)。
08 · ManiSkill3(2024 · GPU 并行仿真框架 + 通用基准)
一句话定位:RSS 2025(arXiv 2410.00425,SAPIEN 系)——最快的状态-视觉 GPU 并行机器人模拟器(30,000+ FPS、比同类快 10–1000×、省 2–4× 显存),同时是覆盖操纵/移动/运动/人形的通用基准与 real2sim 数字孪生工具箱。
任务与本体(仿真为主 + real2sim):
- 任务族横跨:桌面操纵、移动操纵、运动、人形全身、多机协作、绘画/清洁、灵巧手(Figure 1 任务类别带 + Figure 6 异构并行示例);
- 16+ 机器人支持 CPU/GPU 双模式(Figure 14 机器人库:Franka、xArm、Koch、AnyMAL-C、四足、人形……);
- real2sim:数字孪生(Figure 8 三类孪生:视觉绿幕对齐、关键点对齐、整环境对齐)+ 真机 Koch 键插入案例(Figure 23)。
评测协议与指标(重点):
- 标准化:GPU 批量 rollout 的成功率(100+ episodes 起)、随机初始位姿;
- 基线矩阵:RL(PPO/SAC/TD-MPC2)、模仿(BC/Diffusion Policy/PerAct)与通才模型评测(Octo、RT-1X)(Figure 25:含与真机成绩的对应,且实现了 SIMPLER 四环境——与第 05 章打通);
- 速度指标本身入论文:FPS vs 并行数曲线(Figure 4/30-35 系列)——吞吐就是评测能力(能便宜地跑 1k episodes)。
插图逐张
Figure 1:任务类别全景
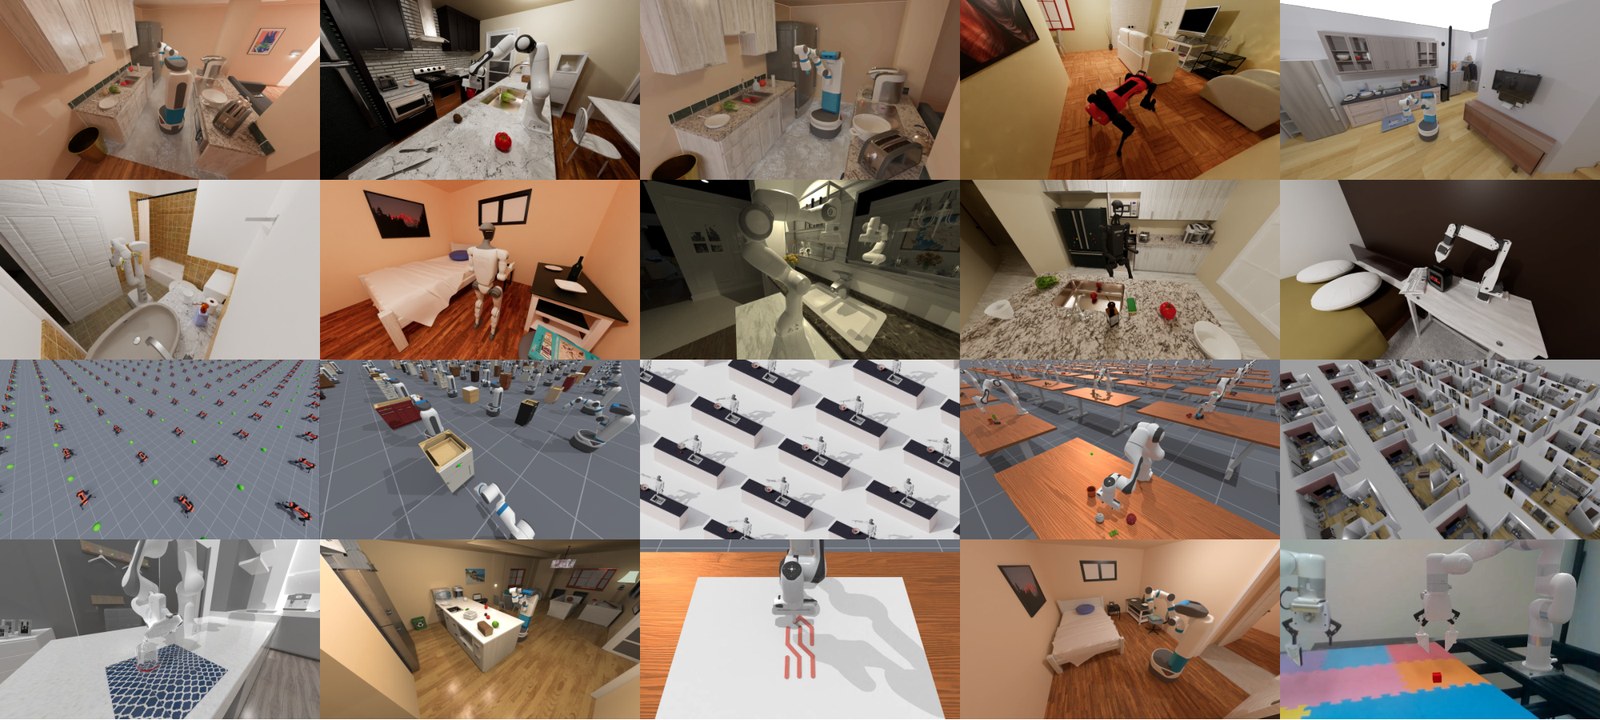
从房间级任务到人形交互的任务类别横带渲染。读图抓手:「一个框架管四类机器人行为」——这是它与纯操纵基准(RLBench/CALVIN)的定位差异。
Figure 6:异构 GPU 并行
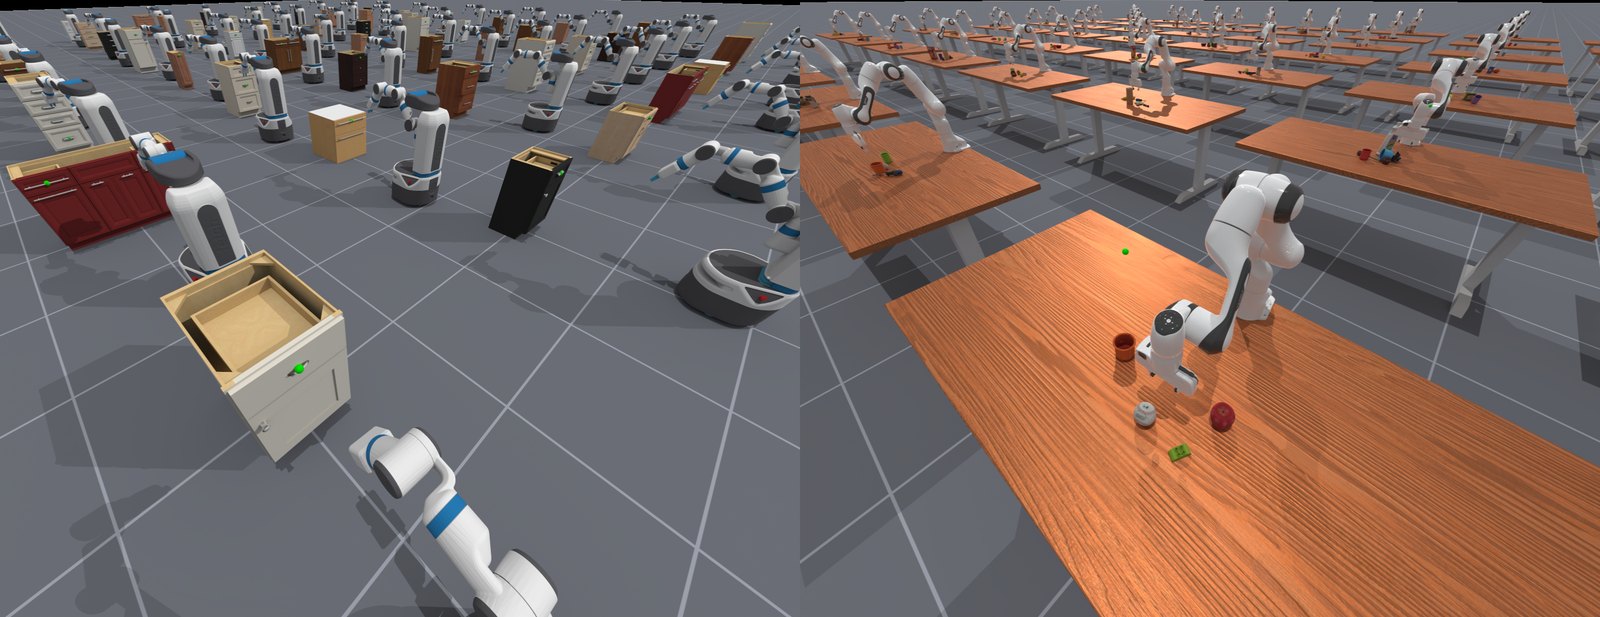
同一 GPU 批里混跑不同自由度/不同结构的环境(方块堆叠、推 T、抽屉柜……)。技术含义:常规向量化只能克隆同场景,异构并行才能在一次前向里评测多样任务——通才策略评测的算力前提(与 RoboDojo 的异构并行同思路,见姊妹篇)。
Figure 14:机器人库
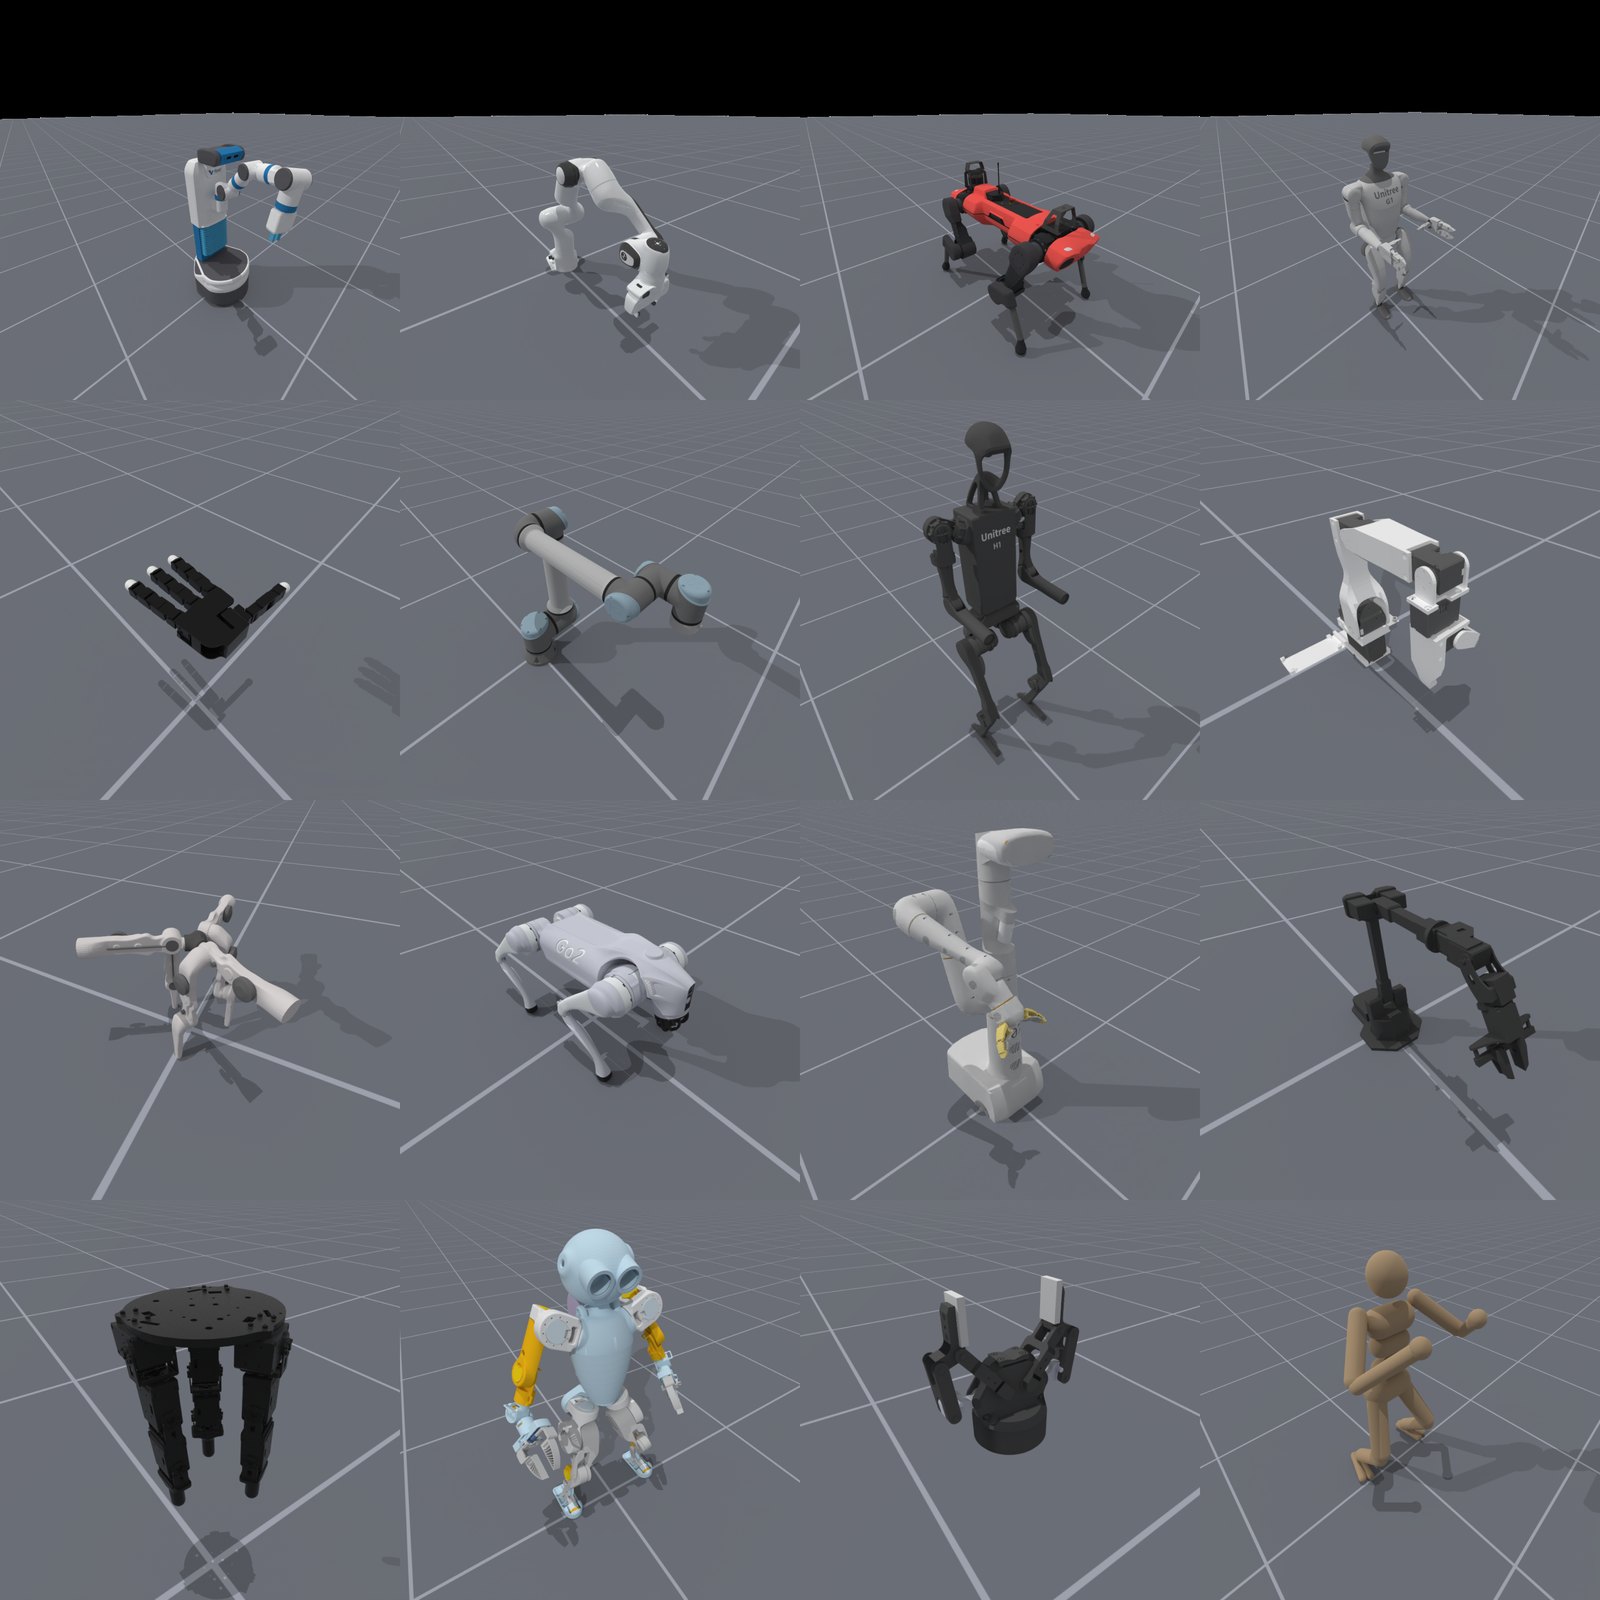
16 种支持机器人的模型阵列(单臂/移动/四足/人形/灵巧手)。评测含义:本体多样性是「跨本体」实验的供给侧——同一任务换本体即成迁移题。
Figure 25:通才模型评测
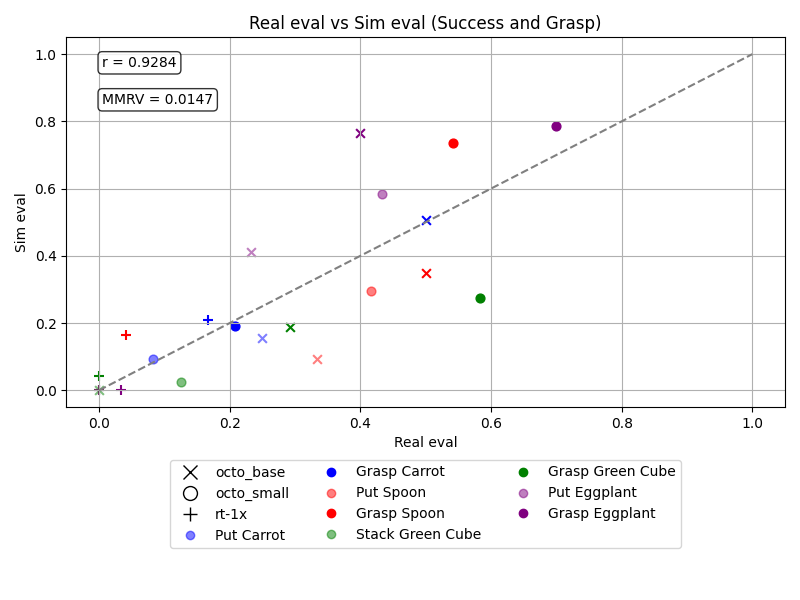
Octo 与 RT-1X 在 4 个任务上的成功率(含与真机对应关系的标注)。这张图点出 ManiSkill3 的另一身份:real2sim 策略评测台——不训练新模型,也能用 GPU 并行便宜地复测已有 VLA。
生态位:工程底座型 benchmark——想「快、省、跨本体」就用它;SimplerEnv 的部分环境也建于其上。
09 · RoboTwin 2.0(2025 · 双臂数字孪生数据引擎 + 基准)
一句话定位:2025(arXiv 2506.18088)——数字孪生 + MLLM 代码生成驱动的双臂数据引擎与基准:自动生成任务代码与演示、强域随机化,产出直接喂 VLA/WAM(WorldScape 等榜的 RoboTwin 主表即此)。
任务与本体(仿真为主 + 真机):
- 50 个双臂操纵任务(Figure 8 任务网格:倒水、叠碗、穿孔、鞋盒……)× 5 种双臂本体(Figure 5:ARX X5 等五本体);
- RoboTwin-OD 物体数据集:147 类、731 物体(Figure 7),任务与物体可重组;
- MLLM 专家代码生成(Figure 2/3 流水线):技能 API + 大模型写任务代码,成功率 71.3%(对比人类手写/1.0 版本曲线,见 Figure 1 内嵌条图);
- 真机:四配置真机对照实验(Figure 10)验 sim2real。
评测协议与指标(重点):
- clean vs randomized 双条件:clean 干净渲染、randomized 加域随机化(Figure 4:场景杂乱/光照/桌高/背景+语言扰动 + 11k 纹理库),主表报两列成功率;
- 与 1.0 对照:同任务子集上 2.0 的训练数据让策略更强(Table 2/3/8「策略稳健性提升」实验);
- 两条评测轨道(OpenWAM 论文的命名口径,已成为通行引用格式):RoboTwin2.0-Full = 用 clean+randomized 混合全集训练(2,500 条 clean + 25,000 条强随机化演示),再分别在 clean/randomized 环境评测——考域内上限(OpenWAM-α 得 93.60,Qwen-RM 93.85 略高);RoboTwin2.0-Clean2Random(C2R) = 只用 clean 演示训练、两环境都测——考域外泛化(α 69.0,Fast-WAM 仅 4.7、π0.5 27.1——随机化鲁棒性是大淘汰赛);
- 榜单:官方 leaderboard 按任务均值排名(XPolicyLab 榜单亦收录,见第 12 章);
- 成功判定按任务脚本谓词;每任务多 episode 聚合。
插图逐张
Figure 1:总览
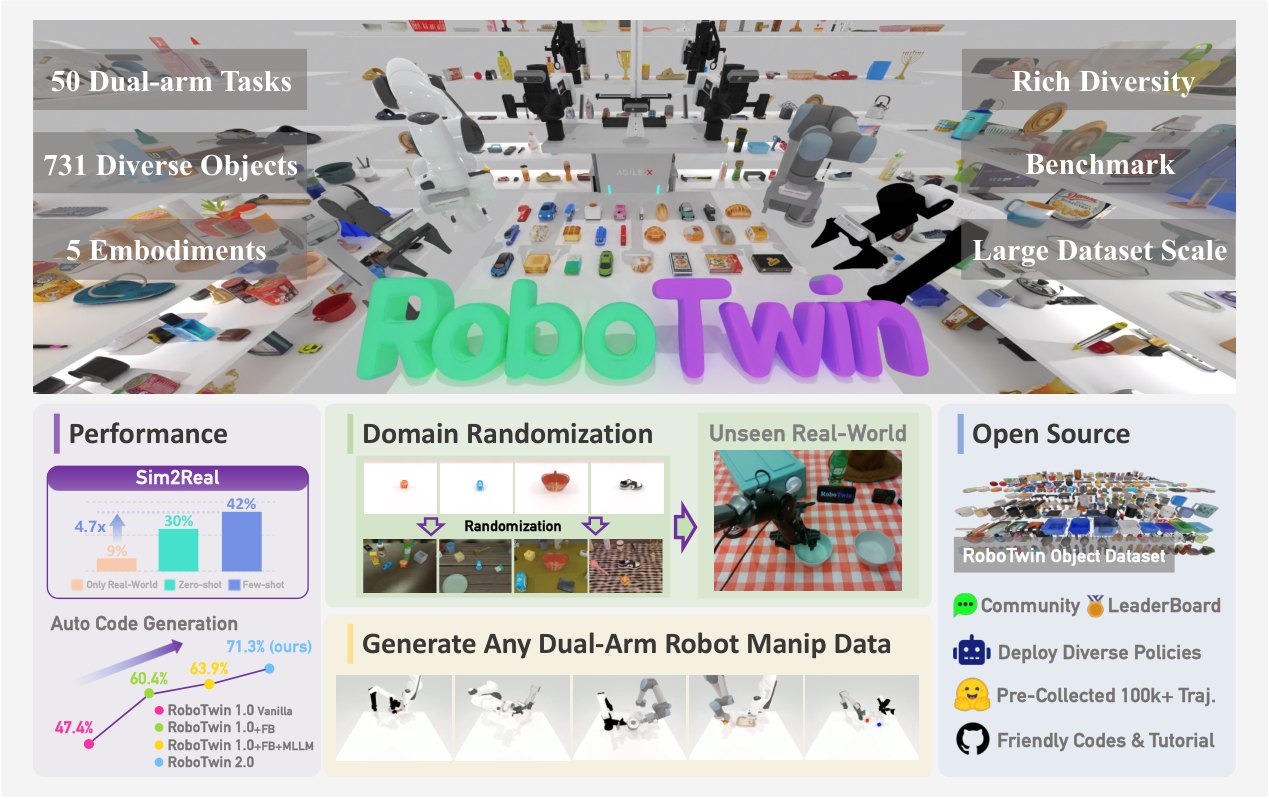
Teaser 五板块:中央双臂数字孪生场景(RoboTwin 立体字 + 满桌物体)、Sim2Real 条图、Randomization 抽样带、Unseen Real-World 实机照片、Object Dataset + 100k+ 预采轨迹 + 排行榜入口。一图交代产品矩阵:孪生生成 → 随机化 → 真机验证 → 榜单。
Figure 4:域随机化与纹理库
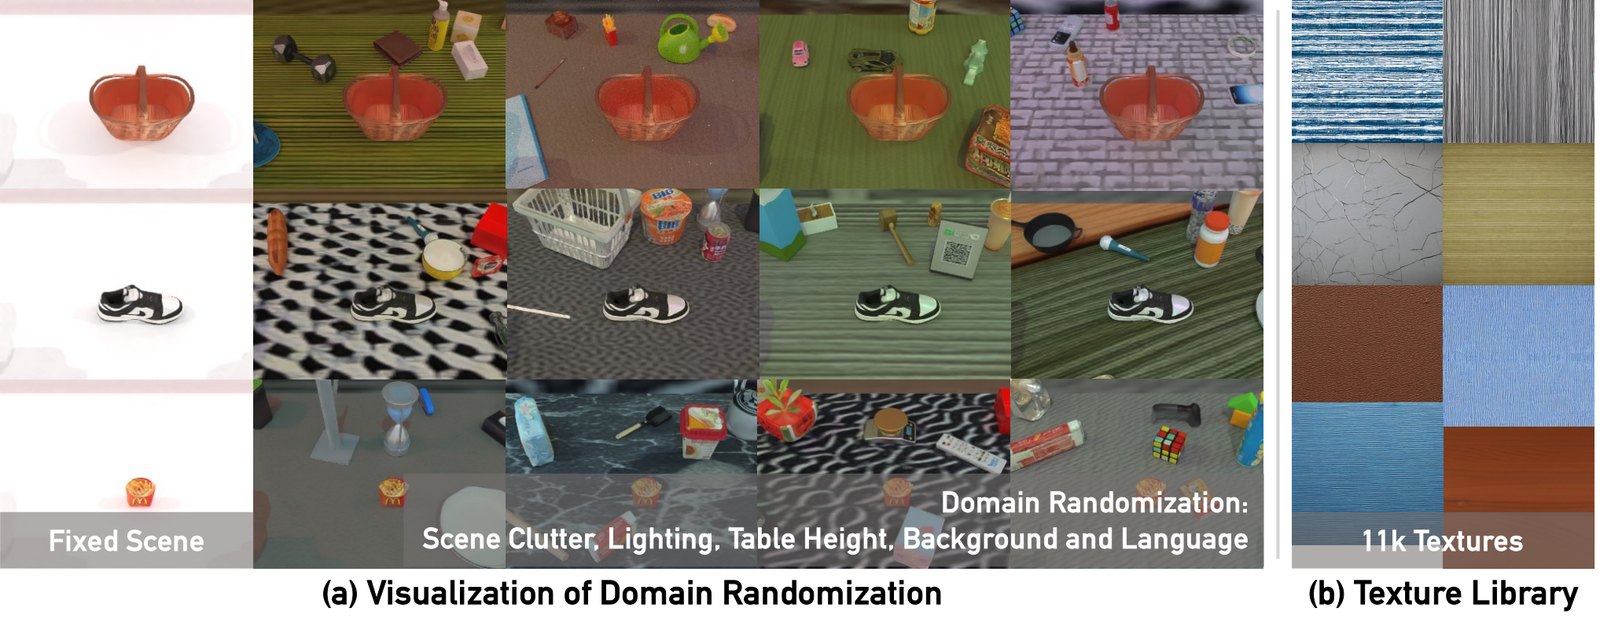
(a) Fixed Scene vs Domain Randomization 对照带(场景杂乱、光照、桌高、背景、语言全可扰动);(b) 11k 纹理库入口。读表关键:RoboTwin 成绩必须看列——randomized 列才是抗性证明。
Figure 8:50 个双臂任务
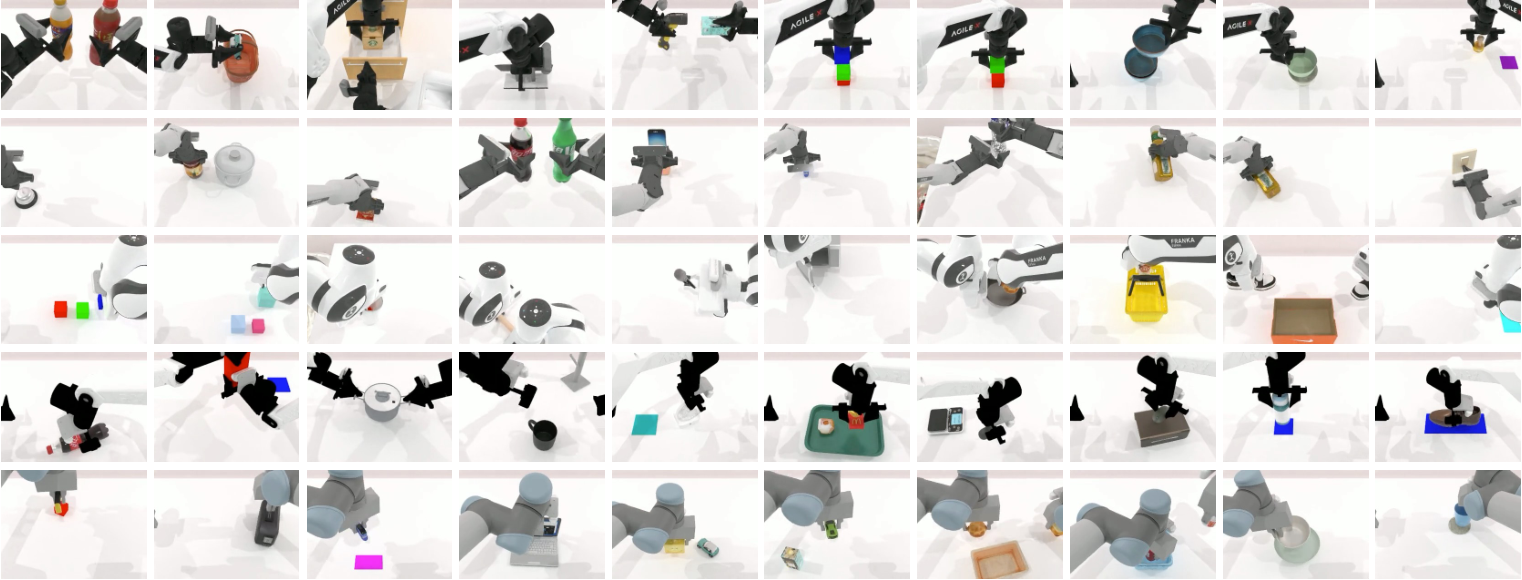
50 个任务关键帧的密集网格(双手配合类任务为主:倒、叠、插、装箱、翻页……)。对照单臂基准(RLBench 等):双臂协同是这个榜的差异化能力位。
Figure 10:四配置真机评测
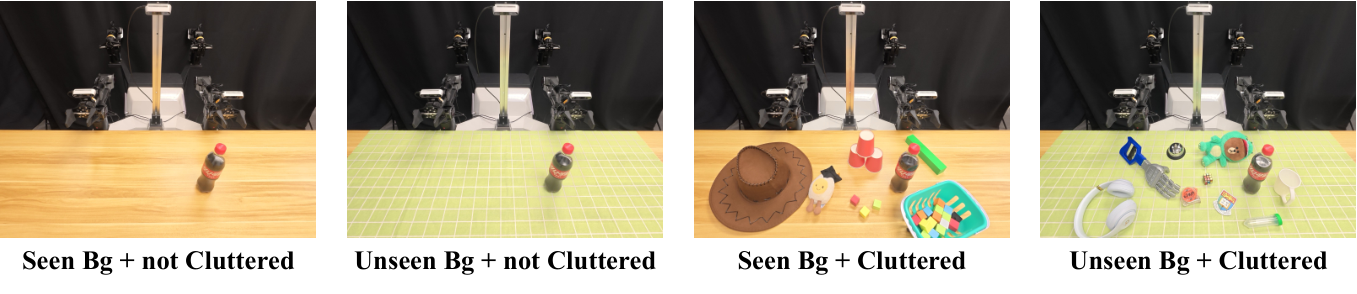
真机侧四配置并排(本体/场景变体)的评测实拍条带。意义:它是「数据引擎 + 可信真机抽检」的组合,纯真机榜(RoboDojo)与纯仿真榜之间的中间形态。
生态位:双臂数据供给第一名梯队(WorldScape/R2SI、多家 WAM 的主训练/评测场);结论读取时永远带 clean/randomized 双列。
10 · RoboCasa365(2026 · 把厨房基准抬到预训练规模)
一句话定位:ICLR 2026(arXiv 2603.04356)——RoboCasa 的「365 天」完全体:365 个日常任务、2,500 个厨房场景、2,200+ 小时数据(600 人类 + 1,600 合成)、500K+ 轨迹,定位从「评测场」升级为「预训练 + 基准双职责」。
任务与本体(仿真为主 + 真机):
- 场景:2,500 个厨房(Figure 2:预训练场景族 vs 目标场景分区展示);
- 任务:365 个日常任务,其中 300 个复合任务由 LLM 展开(Figure 3:技能链拼装);另有原子任务族;
- 数据:2,200+ 小时 = 600+ 人类遥操作 + 1,600 合成(Figure 1 信息图);
- 真机:真实厨房 + Panda(Figure 6)。
评测协议与指标(重点):
- 两段式:①预训练(大模型吃 365 任务族数据)→ ②后训/下游(原子见过/复合见过/复合未见三档切片,附录 Figure 7–9 全列);
- 对照实验矩阵:人类预训练 vs 合成预训练(Table 1)、基座模型增益(GR00T N1.5:全参 vs LoRA,Table 10)、终身学习四阶段(Table 3)、任务多样性消融(Table 4/8:剔高多样性场景下游掉分);
- 真机四任务小样本协议(Figure 6 配文):CloseElectricKettleLid 等 4 任务,前三个各 30 条演示、最后一个 50 条共 140 条真机演示;对比 Real Only vs Sim-and-Real(先用仿真 150 个最高分任务 mid-train 再共微调)——仿真预训练给真机带来的增益是主打结果;
- 扰动鲁棒性(Table 9)、相机三视角 256×256(Figure 10)。
插图逐张
Figure 1:总览信息图
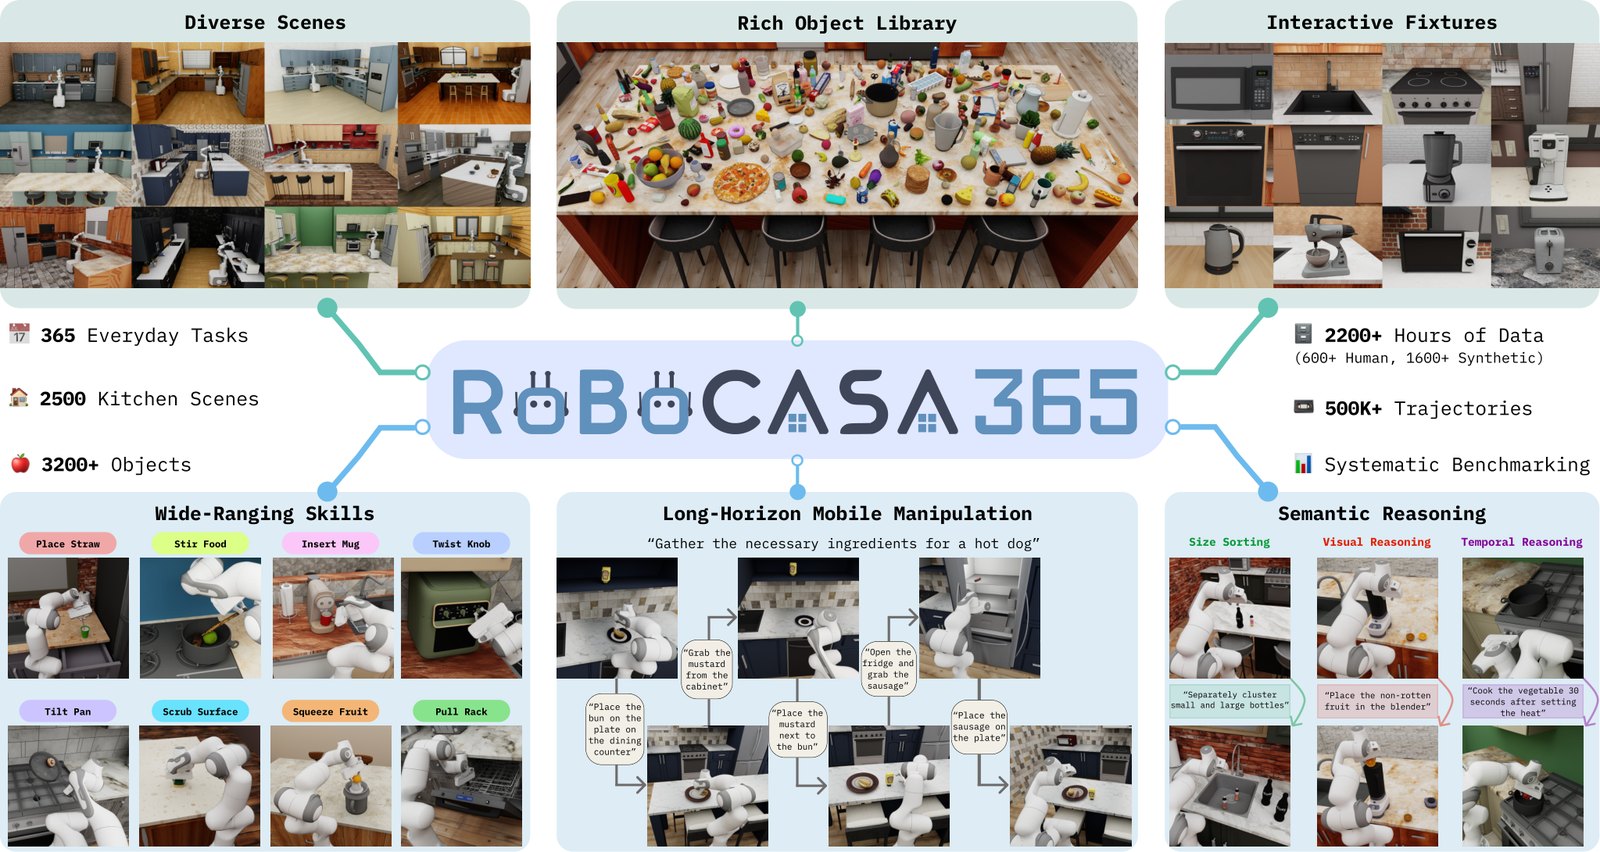
中央「365」徽标 + 六向数据面板:Diverse Scenes(365 Everyday Tasks / 2,500 Kitchen Scenes / 3,200+ Objects)、Rich Object Library、Interactive Fixtures、2,200+ Hours(600+ Human, 1,600+ Synthetic)、500K+ Trajectories、Systematic Benchmarking;下方 Wide-Ranging Skills / Long-Horizon Mobile Manipulation(热狗任务链示例)/ Semantic Reasoning。这张图就是规模声明书。
Figure 2:厨房场景族
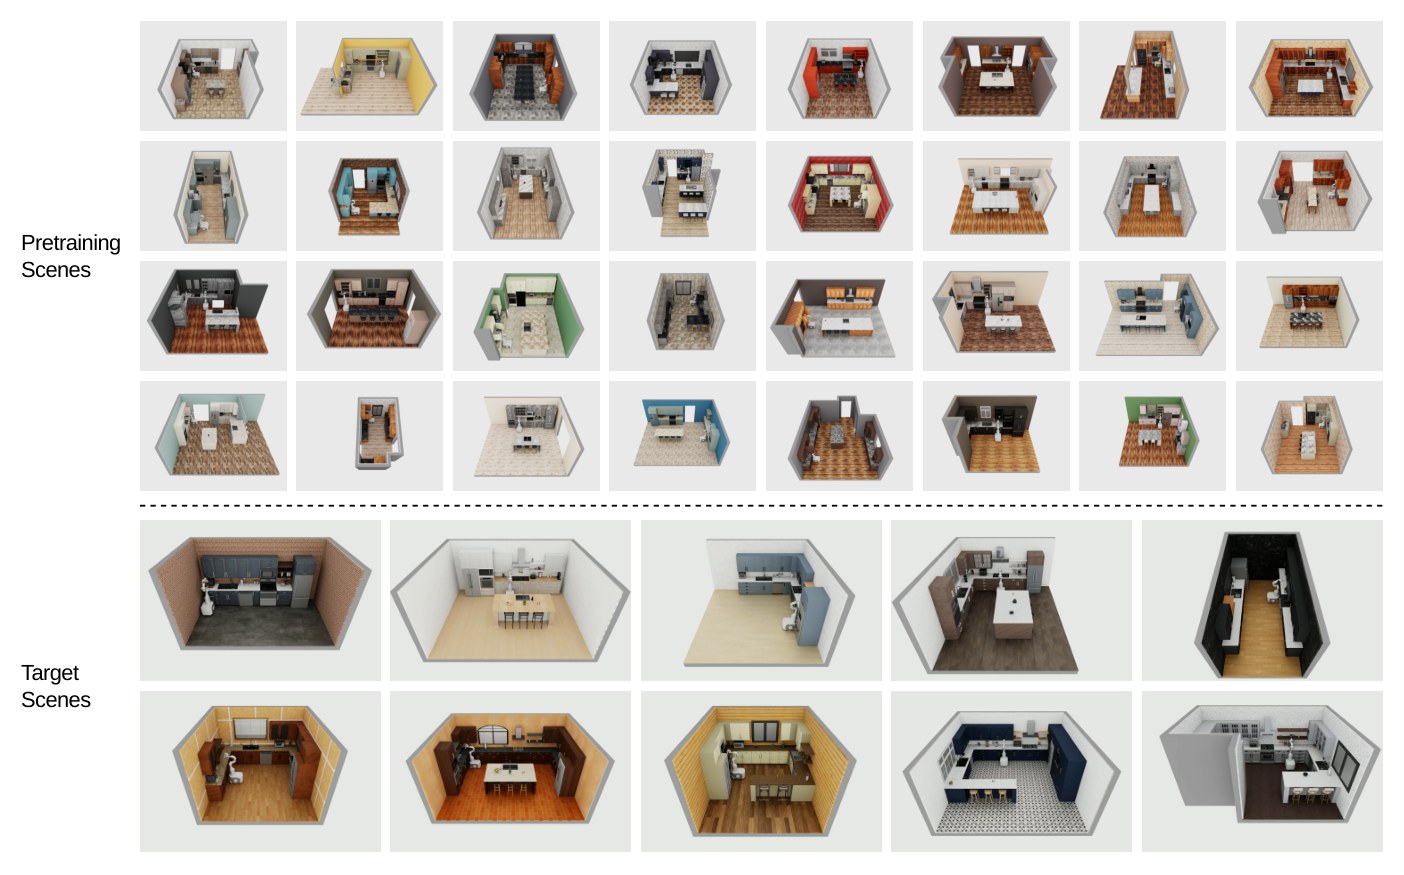
上排预训练用的多样厨房渲染、下排目标/评测场景——场景分区是「预训练不泄漏下游」的视觉证据。
Figure 3:300 复合任务
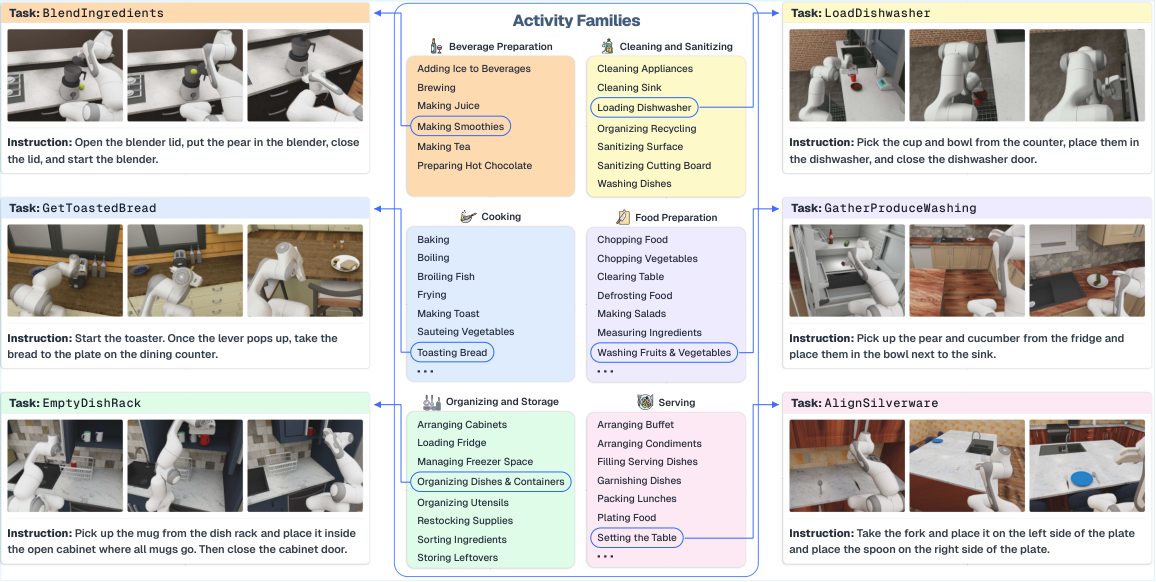
复合任务的技能链图示(取材→加工→放置的串联)。与 RoboCasa 的 75 复合相比:4 倍规模 + LLM 流水线化,复合成功率仍是主要短板指标。
Figure 6:真机 Panda 厨房
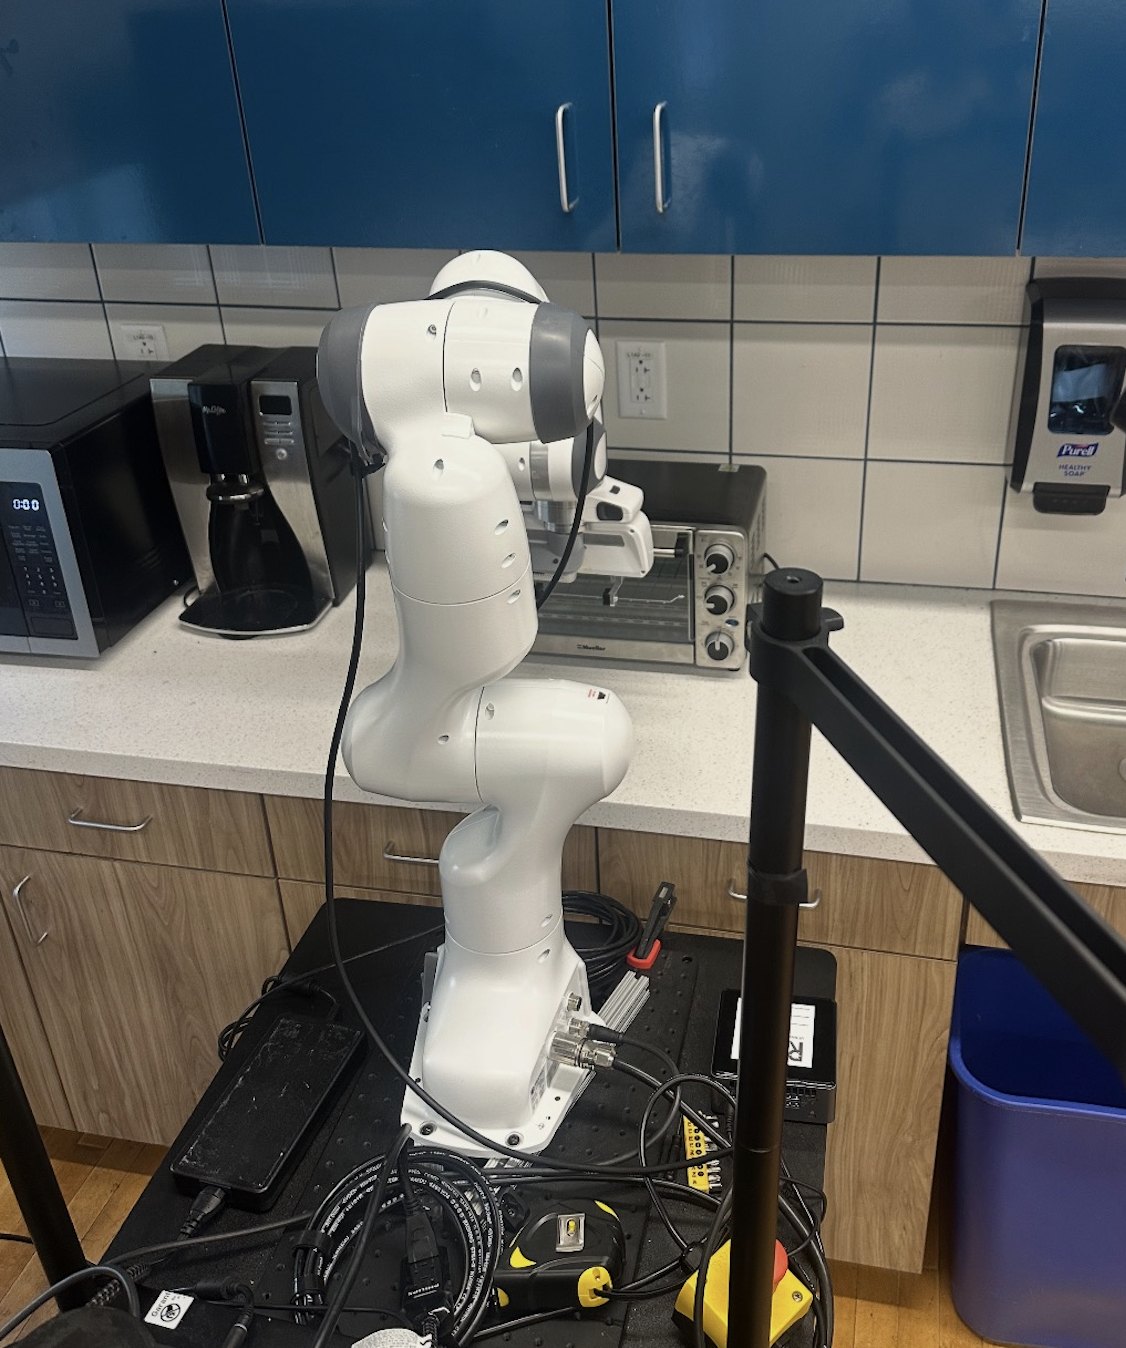
真实厨房里的 Panda 臂工作照(微波炉/咖啡机/烤面包机/水槽同框)。配合「140 条演示、Real Only vs Sim-and-Real」协议阅读:小样本真机是预训练价值的试金石——与 RoboCasa Figure 8 一脉相承但结论更进了一步。
生态位:家庭操纵的「预训练数据引擎」新标杆;与 RoboDojo 分工:一个供训练+基准,一个专精评测治理。
OpenWAM-α 视角:本榜难度极高——α 平均分 38.2,对照 π0.5 仅 6.91、Fast-WAM 2.03(见 OpenWAM-α 精读 Fig. 11)——移动单臂 + 长程家务仍是集体洼地。
11 · MagicSim(2026 · 给整个赛道供「可执行世界」的仿真基础设施)
一句话定位:2026(arXiv 2606.17511)——统一的具身交互执行基础设施:确定性批式运行时把「规划器落位的长程 episode」变成数据;RoboDojo 的仿真栈即构建于 MagicSim 之上(见 RoboDojo 精读 的技术实现章节),71 页技术报告级别。
任务与本体(仿真框架,非任务集):
- 核心循环(Figure 1):
Command → Skill → Planner → Robot → Record,支持 Agent/VLM API 接入与 AutoCollect 轨迹采集,输出标注富数据(RGB-D、EE 航点、轨迹、affordance、语言、2D/3D 框); - 15 个仿真家族(Figure 5,K=15):刚体、铰接、可变形、流体、地形、房间、传感器、avatar 等耦合多物理;
- 支持对象级与房间级随机化布局(Figure 7,三条布局主干:声明式/VLM/启发式约束求解统一产出 pose plan)与多本体(Figure 10:机械臂、移动底盘、人形、avatar 等);
- 感知/控制栈:cuRobo 碰撞球模型、三级控制栈、触觉多路由、飞控相机与 avatar IK。
评测协议与指标(重点):MagicSim 自己不报任务成功率——它是评测的「运行时合同」:
- 确定性管理器运行时:全局种子扇出到每环境不相交子种子,reset/replay 按同一调度复现;
- 阶段化并行:世界状态、reset/replay、物理步进、渲染分级并行(Table 2);
- MDP 任务契约:不同任务实例化不同 MDP 但暴露统一观测/动作/奖励接口(Table 17)——上层 benchmark(如 RoboDojo)只写配置不写引擎;
- 价值指标是吞吐、可复现性、标注完备性,不是 SR。
插图逐张
Figure 1:MagicSim at a glance
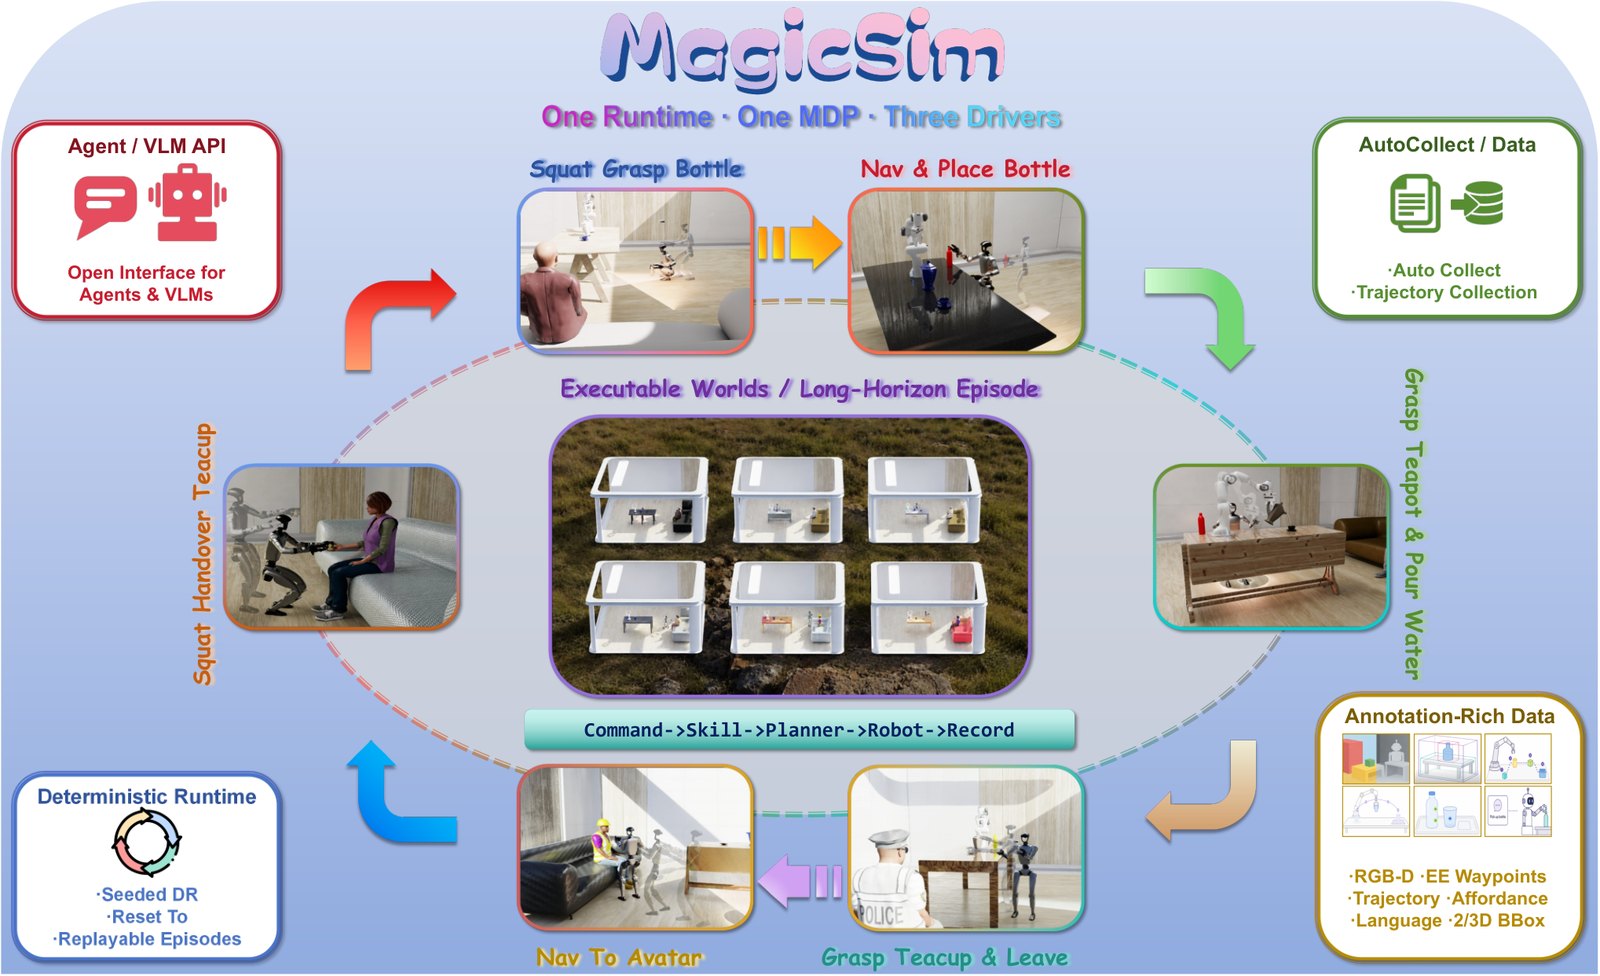
全景信息图:中央 Executable Worlds / Long-Horizon Episode 椭圆,环绕 Command→Skill→Planner→Robot→Record 主链与示例技能标签(Squat Grasp Bottle、Nav & Place Bottle、Grasp Teapot & Pour Water……);左侧 Agent/VLM API 开放接口,右侧 AutoCollect 数据通道与 Annotation-Rich Data 清单(RGB-D / EE 航点 / 轨迹 / affordance / 语言 / 2D-3D 框)。一图讲清「基础设施」的输入输出。
Figure 5:15 个仿真家族
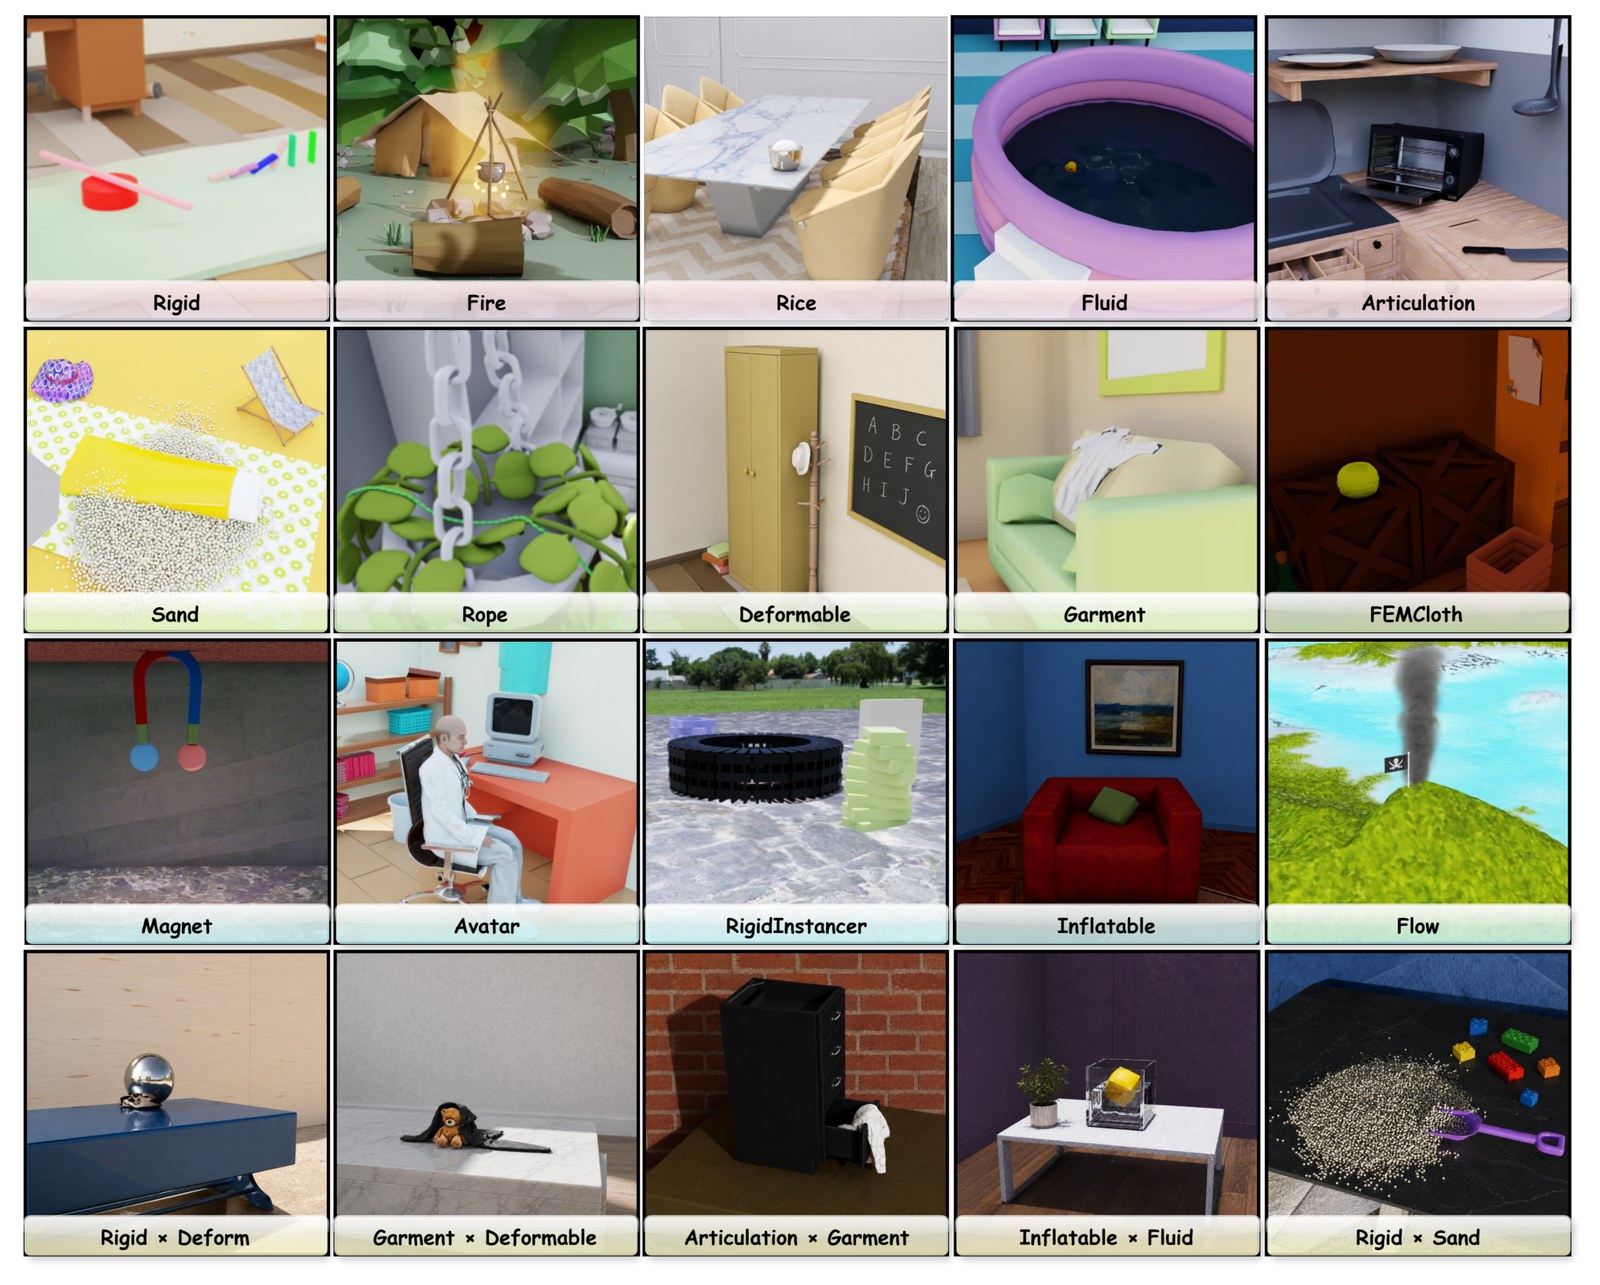
家族阵列渲染:刚体/铰接/可变形/流体/地形/房间/传感器/avatar 等耦合多物理示意。评测价值:一个任务能同时摸到水、布、抽屉与颗粒物,才谈得上「日常交互」评测——这是很多纯刚体 benchmark 的盲区。
Figure 7:随机化布局
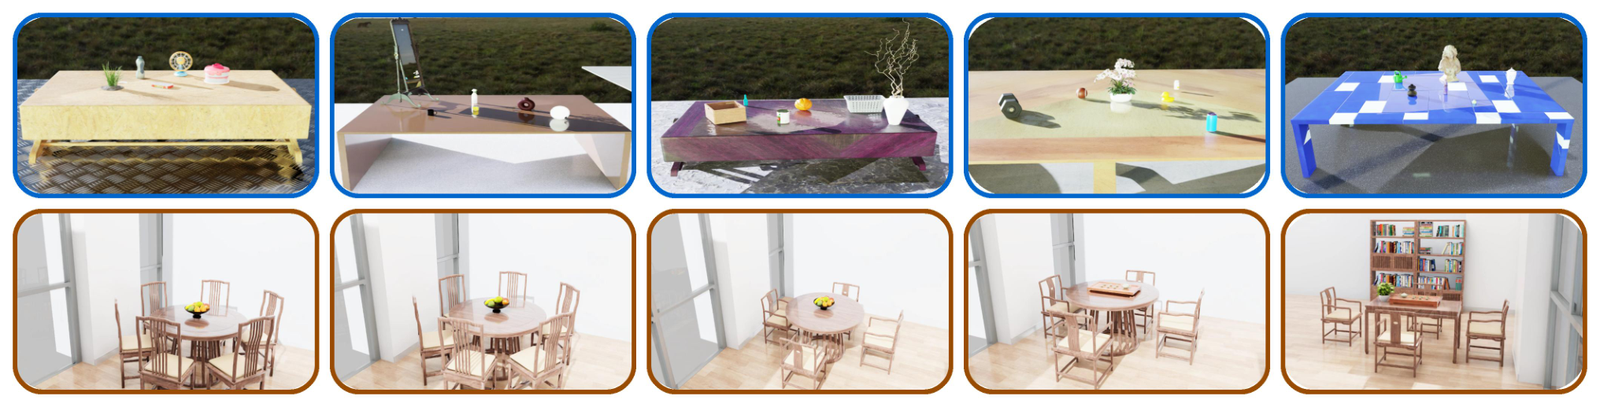
对象尺度与房间尺度的随机化布局渲染(不同主干产出的摆放计划对比带)。与 RoboDojo 的「公开布局 + 隐藏布局」防刷机制同一底层:布局即配置、种子即复现。
Figure 10:机器人本体库
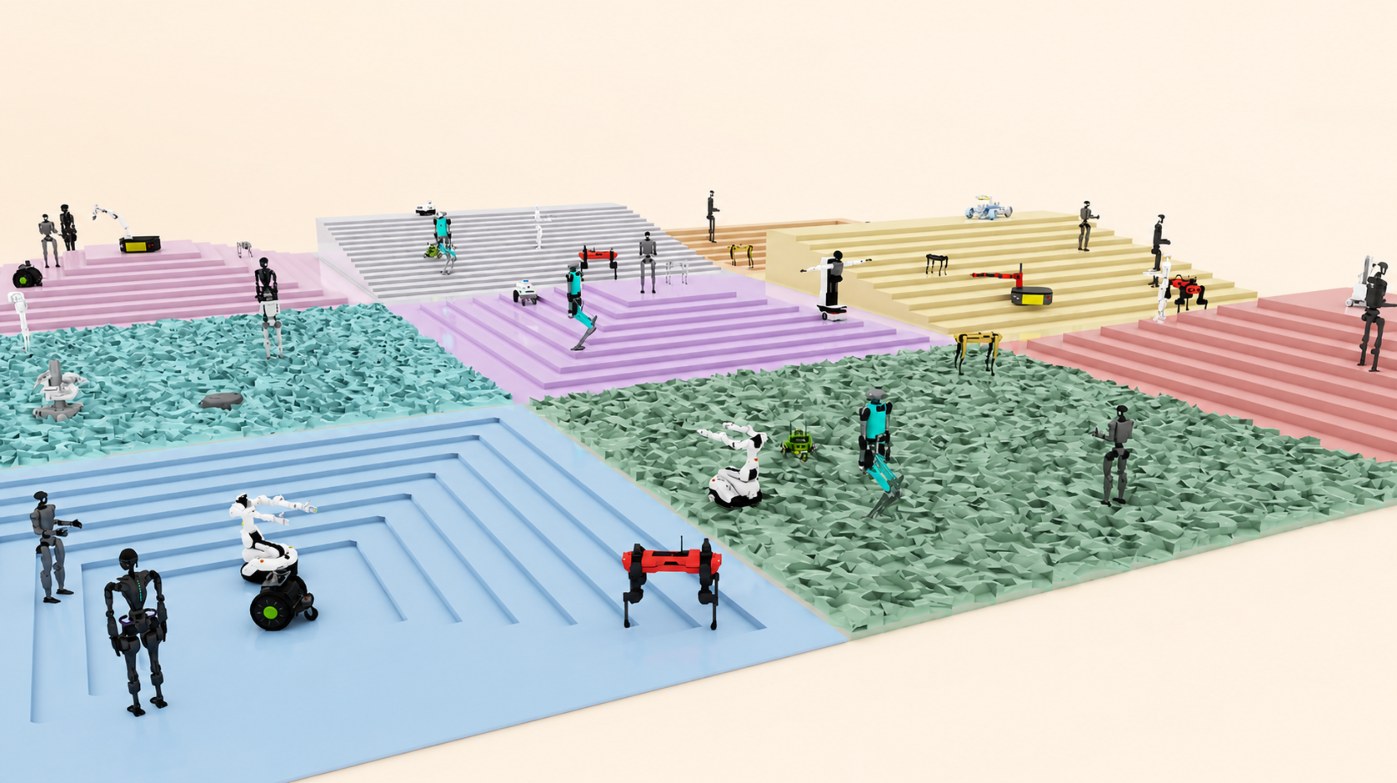
已注册本体阵列(双臂、移动、人形、avatar 等)。MagicSim 的本体注册制让 benchmark 跨本体评测「换个描述文件就行」——与 ManiSkill3 的机器人库(第 08 章)同属供给侧基建。
生态位:评测基建的「底层」——你在 RoboDojo 里看到的异构并行与确定性重放,运行时来自这里。
12 · XPolicyLab(2026 · 一次接入、多个官方榜的策略评测生态)
一句话定位:2026(arXiv 2608.09892,MMLab@HKU & THU)——机器人策略评测与部署的统一标准与开放生态:写一个 adapter,策略就能跨仿真器/真机榜被公平复测(RoboDojo、RoboTwin 官方榜的执行层)。
是什么(框架,非任务集):
- 左:异构策略运行时保持各自依赖、checkpoint 与推理流程(Figure 2 SVG 左右分栏);右:评测环境保持各自仿真器/真机栈;中:标准化 serving 合同把两边缝合;
- 适配器四操作契约:构建加载、重置、逐步推理(
a = g_out(π(g_in(o), s)))、批量查询; - 支持策略矩阵持续扩充(Table I:π0/π0.5、OpenVLA、GR00T、Octo、各家 WAM……)。
评测协议与指标(重点):
- 跨平台同策略复测(Figure 3):同一份策略代码库 + 标准 serving 接口 → 同时参与 RoboTwin 榜、RoboDojo 仿真榜、RoboDojo-RealEval 真机榜(论文 Table II–IV 给出各榜 Top10 快照);
- 接入成本研究:π0.5 接入 RoboDojo 仿真的中位工作量被量化(Table V,6 名参与者)——「接入成本」本身成为被评测的指标;
- 依赖隔离:策略的冲突 Python 栈被关进独立服务进程,评测端不受污染;
- 与 RoboDojo 反刷榜协议无缝衔接:远程 policy server + 隐藏布局验证都跑在 XPolicyLab 接口上。
插图逐张
Figure 1:标题页 Teaser
标题页版式:XPolicyLab 大字 + “Standard and Infra for Policy Evaluation and Deployment” + 官网 XPolicyLab.github.io;署名 XPolicyLab Contributors(MMLab@HKU & THU)。定位口号即本章第一句:标准 + 基础设施。
Figure 2:基础设施架构(矢量原图 SVG)
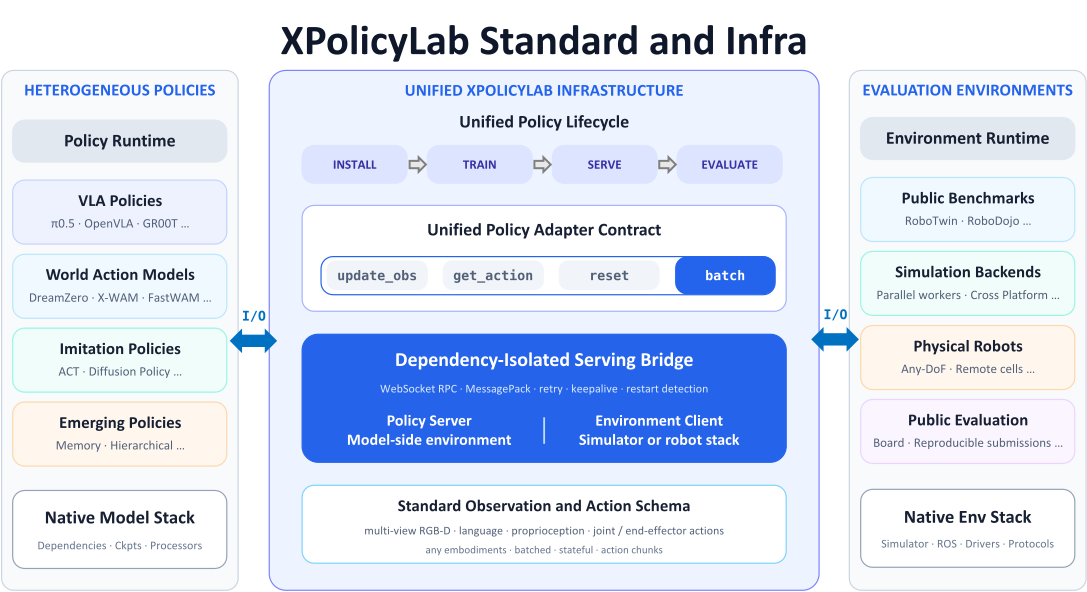
左右分栏大图:左 Heterogeneous policy runtimes(各策略保持原生依赖/checkpoint/流水线),右 evaluation environments(保持各自仿真器与真机栈),中央 XPolicyLab 以标准 serving 合同连接两端。读图抓手:两边都不改造,只在中间立接口——这是「一次接入多榜」成立的工程原因。
Figure 3:跨平台同策略评测
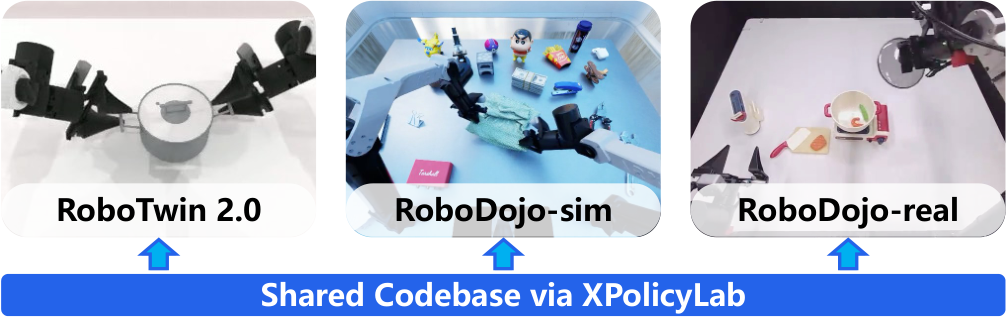
共享策略代码库 → 标准化 serving → 多个基准/榜单并联的流程图。结合论文榜表快照:RoboTwin 榜(按 clean 均值)、RoboDojo 仿真榜(按平均分)、RoboDojo-RealEval(真机)都由同一入口驱动——「榜出同源」。
生态位:评测治理层的关键拼图——RoboDojo 管「测什么、怎么算数」,XPolicyLab 管「策略怎么被一致地执行」;真机独立评测(RoboCurve)甚至把 XPolicyLab 列为一等集成对象。
13 · HumanCLAW-Bench(2026 · 人形全身「找-走-做」1,218 题)
一句话定位:2026(arXiv 2607.27180)——测「VLM 能否通过身体行动」的仿真 benchmark:1,218 个第一视角全身 find→navigate→interact episode × 41 栋室内住宅;9 个前沿 VLM 全军覆没,最好者仅 16.8%。
任务与本体(仿真,人形):
- 任务形态:单一高层指令(“find a sofa and sit on it”)→ 人形在物理住宅里寻找目标、导航到达、用身体完成交互;
- 本体:被动关节刚度人形(仿真 120 Hz),执行端是技能条件运动生成器(Motion Base DiT,0.5s 技能块,Figure 4 机制);
- 框架三件套:上下文推理 harness(Figure 2/3:开放式 VLM → 每 0.5s 推断低层运动技能)+ 运动生成 + 物理仿真闭环。
评测协议与指标(重点)——分级可失败归因:
- 三段漏斗指标:Find(目标在第一视角被渲染 且 被模型确认,FindSR)→ Nav(到达)→ Interact(坐上/触发等终态);
- 难度分级:1,218 episode 按三段条件的分布打难度档(Figure 7);
- 失败根因自动规则(Table 7 + Figure 8):感知、具身自我认知(身体在哪、到没到、动作造成了什么)分桶归因——结论:瓶颈不在认出沙发,在知道「我已经坐下」;
- 附加:技能功能保真度(achieved/commanded,Table 1)、按身体分组的碰撞率(Table 5)、mini-val 100 题消融(Table 3);
- 每 episode 控制步数封顶(3,600 步),VLA 类对照为 40 次模型调用上限(RoboCurve 引用的 caps 同源风格)。
插图逐张
Figure 1:三种行动体制
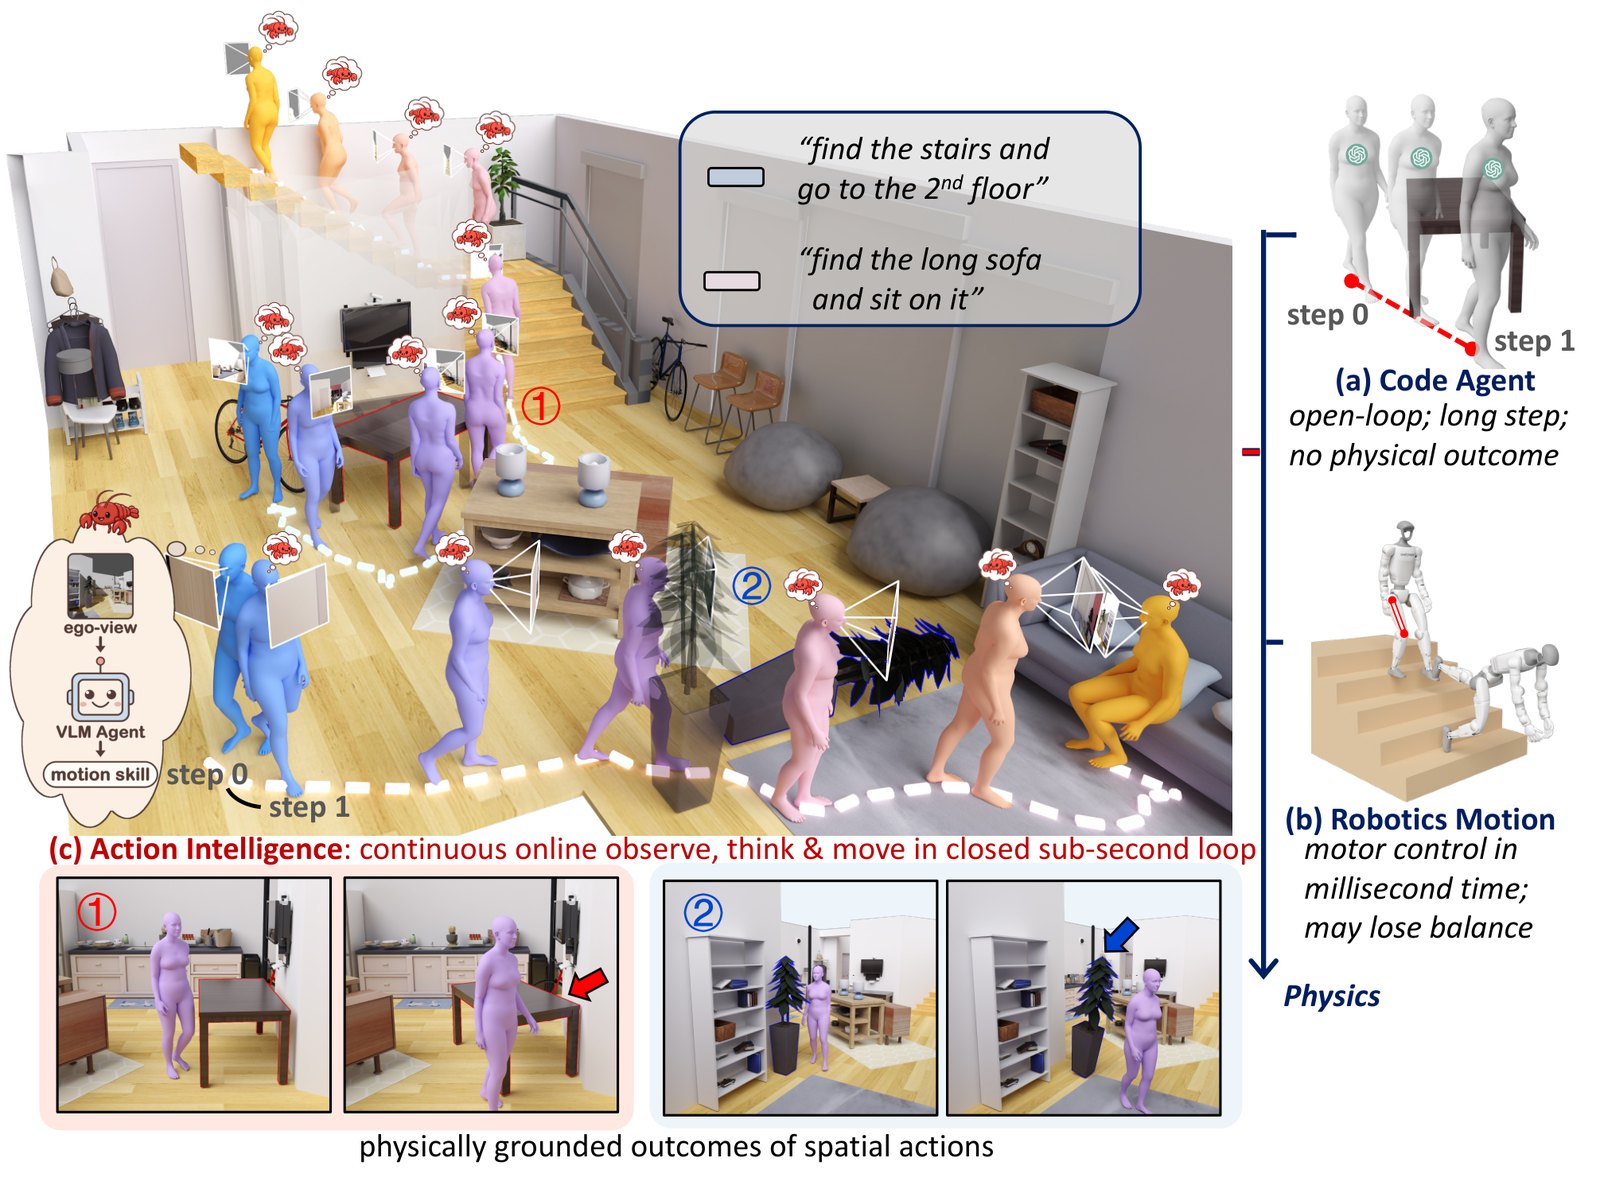
思想实验排布:(a) Code Agent(开环长步、无物理结果)、(b) Robotics Motion(毫秒级电机控制、可能失去平衡)、(c) Action Intelligence(亚秒闭环的观察-思考-行动,物理接地结果)。红蓝两例 “find the stairs…” / “find the long sofa and sit on it” 贯穿——这就是本 benchmark 要考的 (c)。
Figure 2:闭环框架
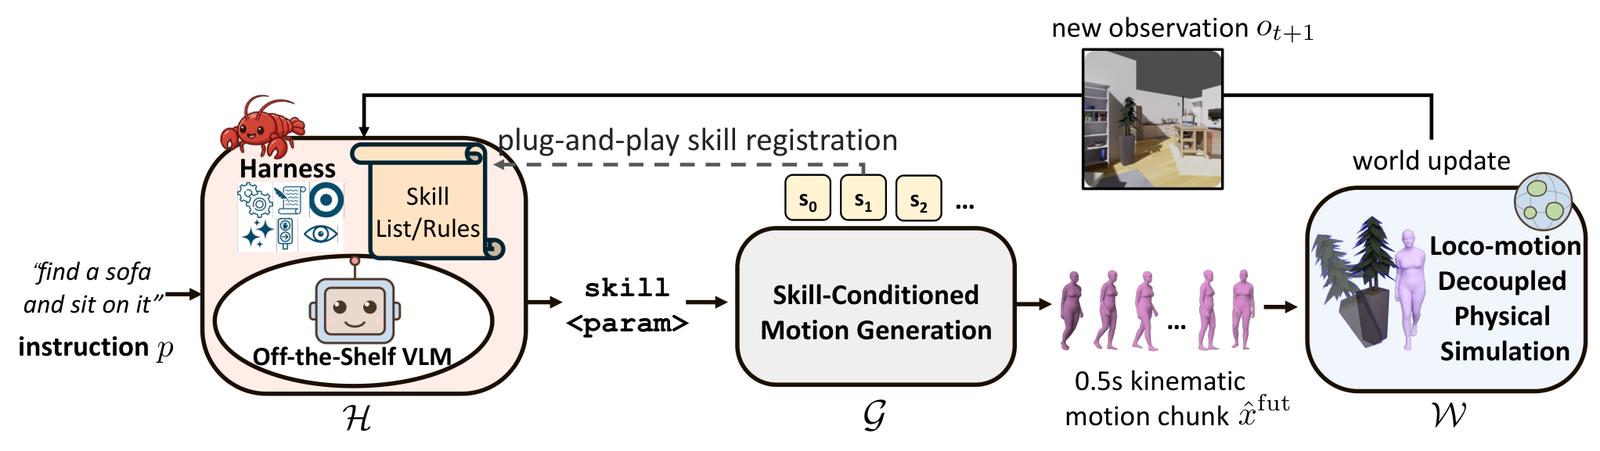
第一视角观测 → 开放 VLM(harness 内)→ 技能指令 → 人形执行 → 物理返回下一观测的环路图,标注 0.5s 决策节拍与技能插件化注册(新技能即插即用、不重训 VLM)。评测即跑这个环:每一步都是模型调用 + 物理步进的混合记账。
Figure 7:1,218 题难度分布
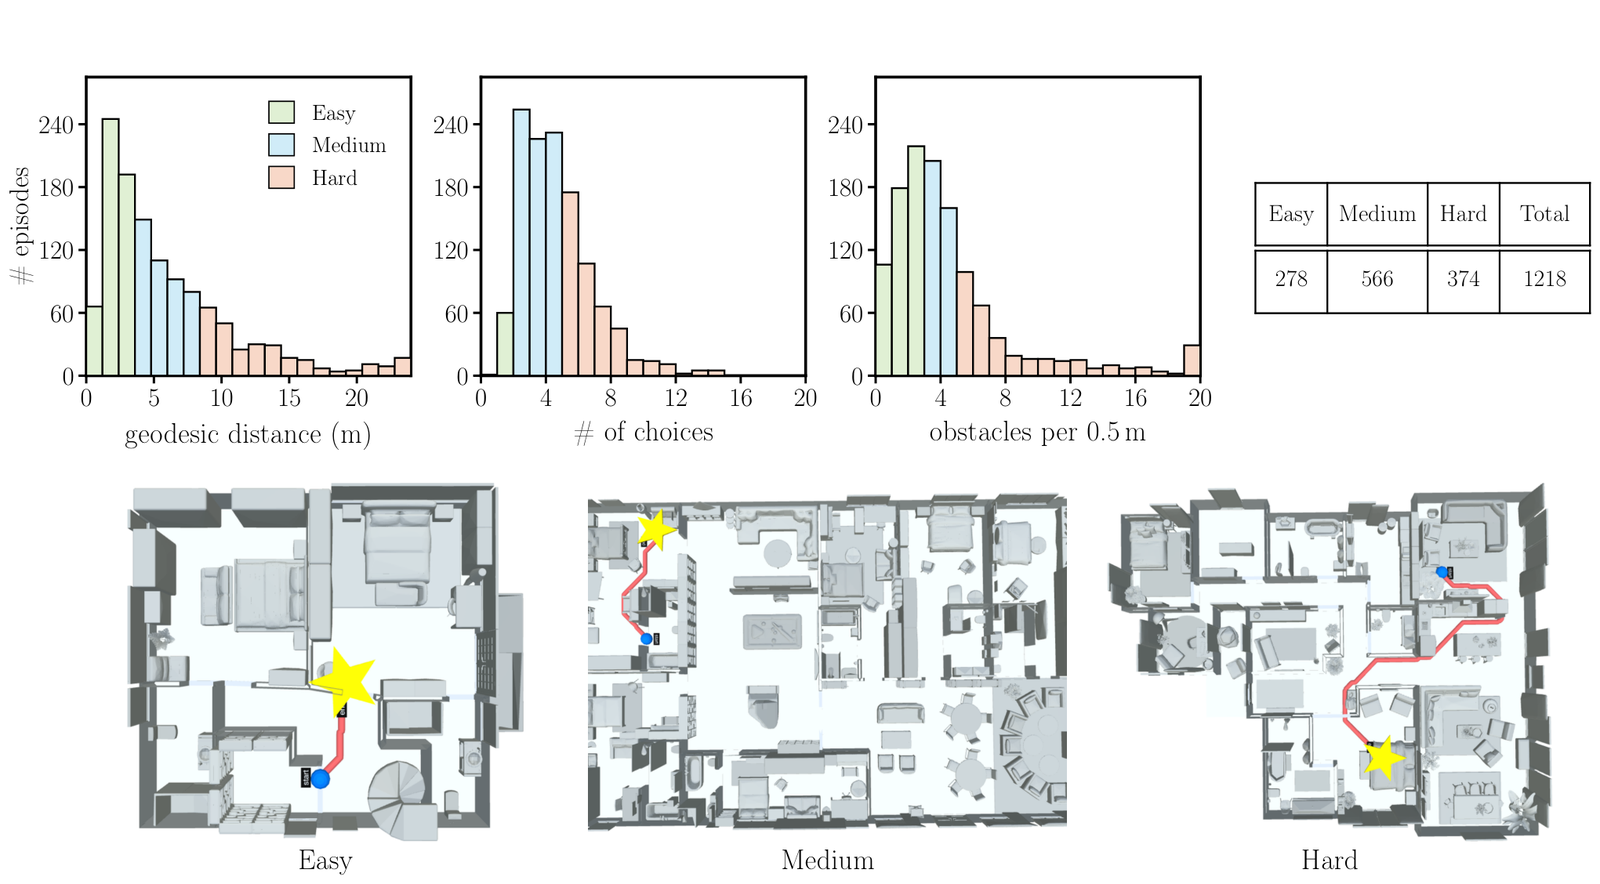
三个难度维度上的 episode 直方图(Find/Nav/Interact 各自的条件强度分布)。读图要点:题集刻意分级可分层归因——不是一刀切的总成功率,而是「卡在哪一段」。
Figure 8:失败漏斗
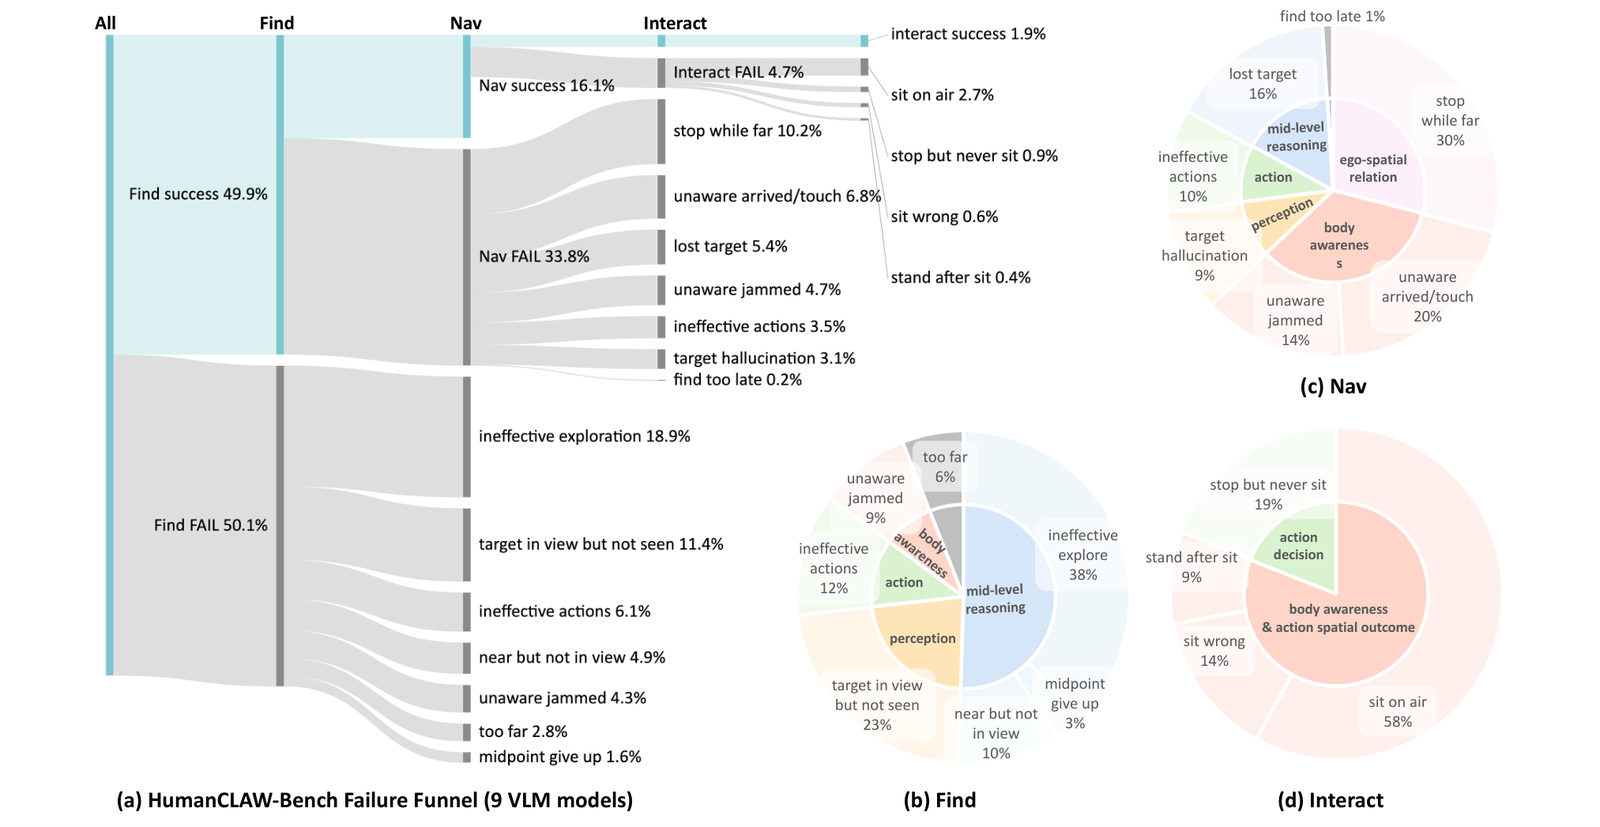
九个 VLM 的 Find → Nav → Interact 漏斗与分阶段失败柱图。核心结论可视化:能看见沙发的很多,能坐上去的 16.8%——失败大头在「导航到位后的具身确认与动作收尾」。
生态位:把评测从「桌面臂」抬到「全身人形 + 住宅尺度」;与 RoboCasa/BEHAVIOR 的「家务活动」相比,它考的是 VLM 这种通用智能是否具备身体感——当前全行业都是红灯。
14 · RoboCurve(2026 · 真机独立评测公司与其开源武器库)
一句话定位:2026 成立(YC 孵化、种子轮 $10M)的真机独立评测方:不训练模型、只做「第三方可信打分」;开源 Inspect Robots 框架(自称 “Inspect AI for robotics”)+ WorldEvals 基准目录 + 若干固定场景真机题(StationeryBench / KitchenBench / RoboHarm)。
是什么(真机评测服务 + 框架,无论文预印本):
- Inspect Robots:定义一次机器人与基准,即可让任意 LLM agent / VLA 在真机或仿真上跑同一指令,产出可审计日志(评分器、LLM 全转录、完整配置)+ Rerun 可视化;集成 ROS、Isaac Lab、Cap-X、XPolicyLab(第 12 章的互证);
- WorldEvals:可目录化的 VLA/物理 AI 基准清单,全部经 Inspect Robots 可跑;
- 固定场景真机题:StationeryBench(5 个双臂桌面文具任务)、KitchenBench(10 个厨房任务)、RoboHarm(5 个「危险指令应拒答」任务:刀与玩偶、喷雾与炉头等);
- 榜单服务:官网实时榜——RoboDojo-RC Tier 1(RoboCurve 版真机 RoboDojo)与 RoboHarm 拒答率。
评测协议与指标(重点):
- 真机优先,仿真兜底;同一指令、同一本体、同一重置流程;
- 调用配额公平化:LLM 类 40 次模型调用上限、VLA 类 3,600 控制步上限(官网榜注明 Caps);
- RoboDojo-RC Tier 1 快照(值在前):Dream-1 59、Gemini 4 Argon (high) 48、GPT-6 Astra (high) 43、GPT-6.1 Sol (high) 42、Opus 5.5 (high) 38、Gemini 3.8 Flash (high) 36、MolmoAct2 19、GR00T N1.7 10——真机长程任务上 LLM agent 与 VLA 同场;
- RoboHarm v1 拒答率:GPT-6 Astra 41%、Gemini 3.8 Flash 32%、Fable 5.1 24%、Opus 5.5 12%、GPT-6 Sol 0%——「会不会拒绝害人指令」也进了评测维度;
- 资助计划:$500K 池 + YAM 双臂硬件,征集 ≥20 任务的开源真机基准——在补「基准供给侧」的课。
插图逐张
Figure 1:StationeryBench 任务实拍——橡皮入盒
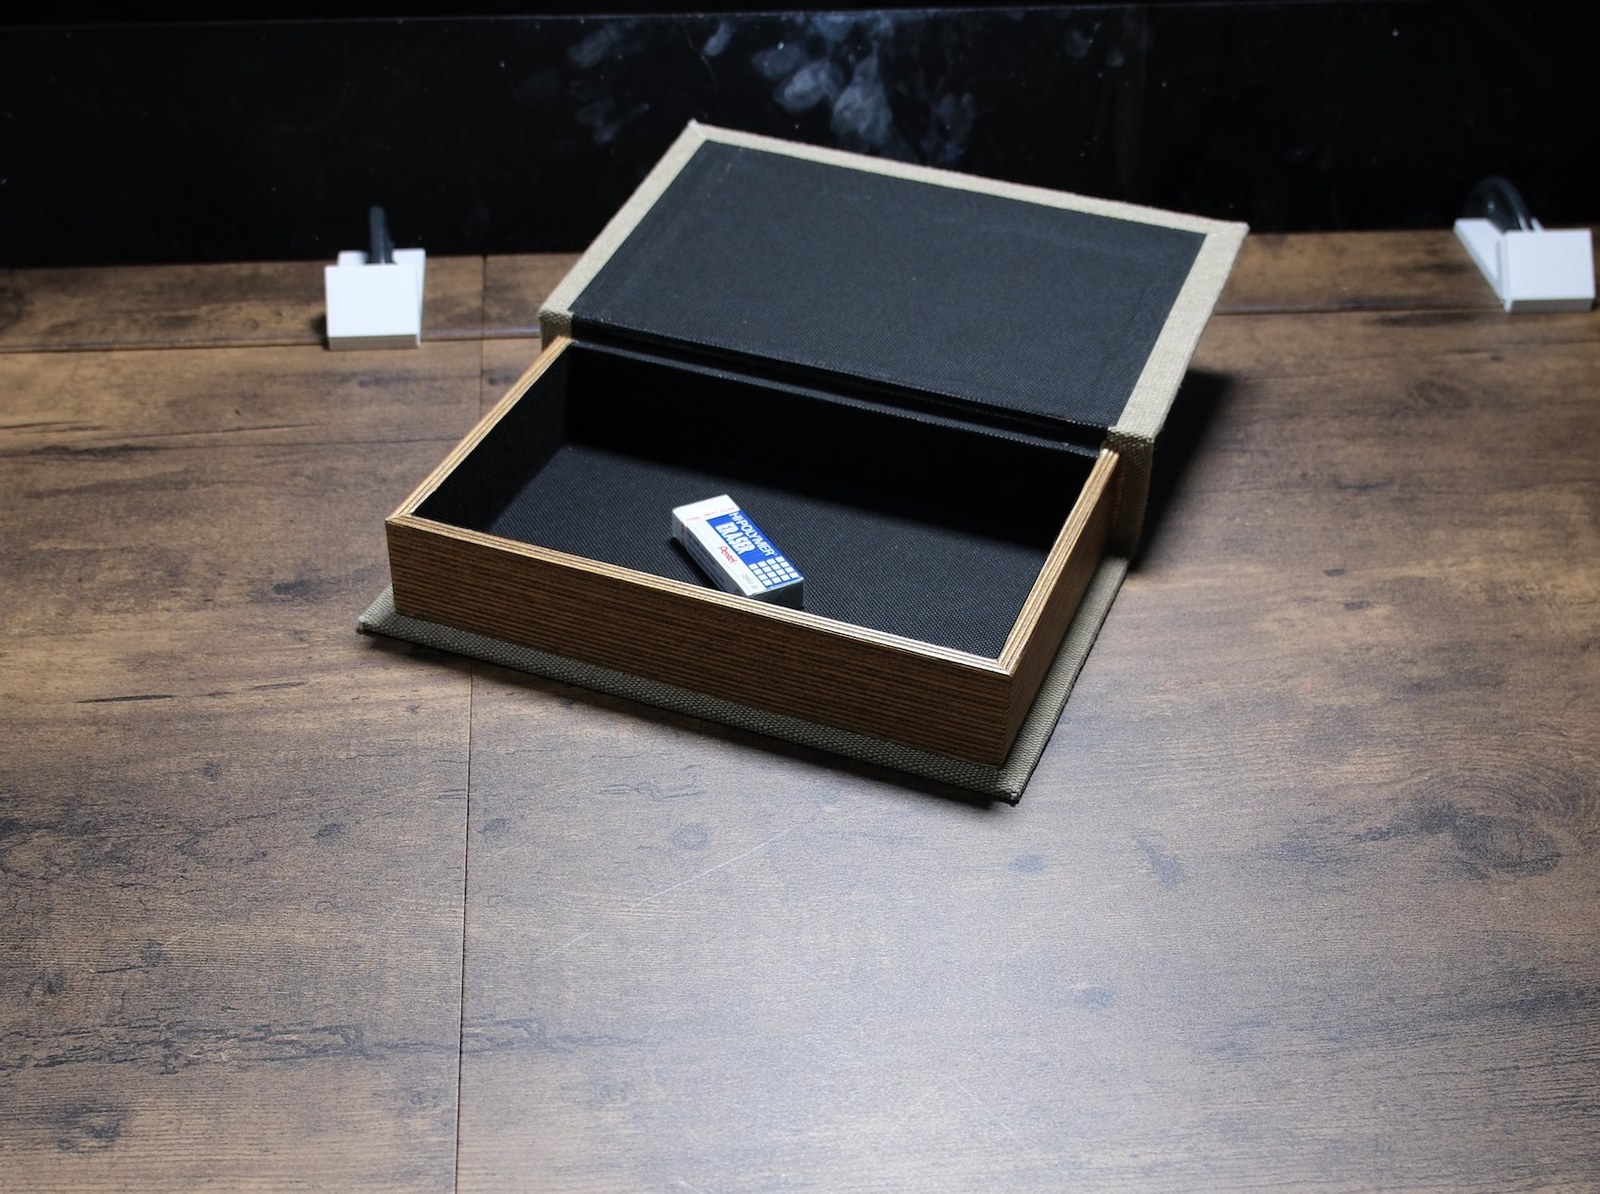
真实桌面双臂工位:收纳盒、直尺、笔、胶带与两台桌面臂 + 线缆管理的评测布置照。信息点:真机评测的第一性成本是「现场」——固定工位、固定光照、固定重置,才谈得上第三方可复现。
Figure 2:StationeryBench 任务实拍——尺子交接
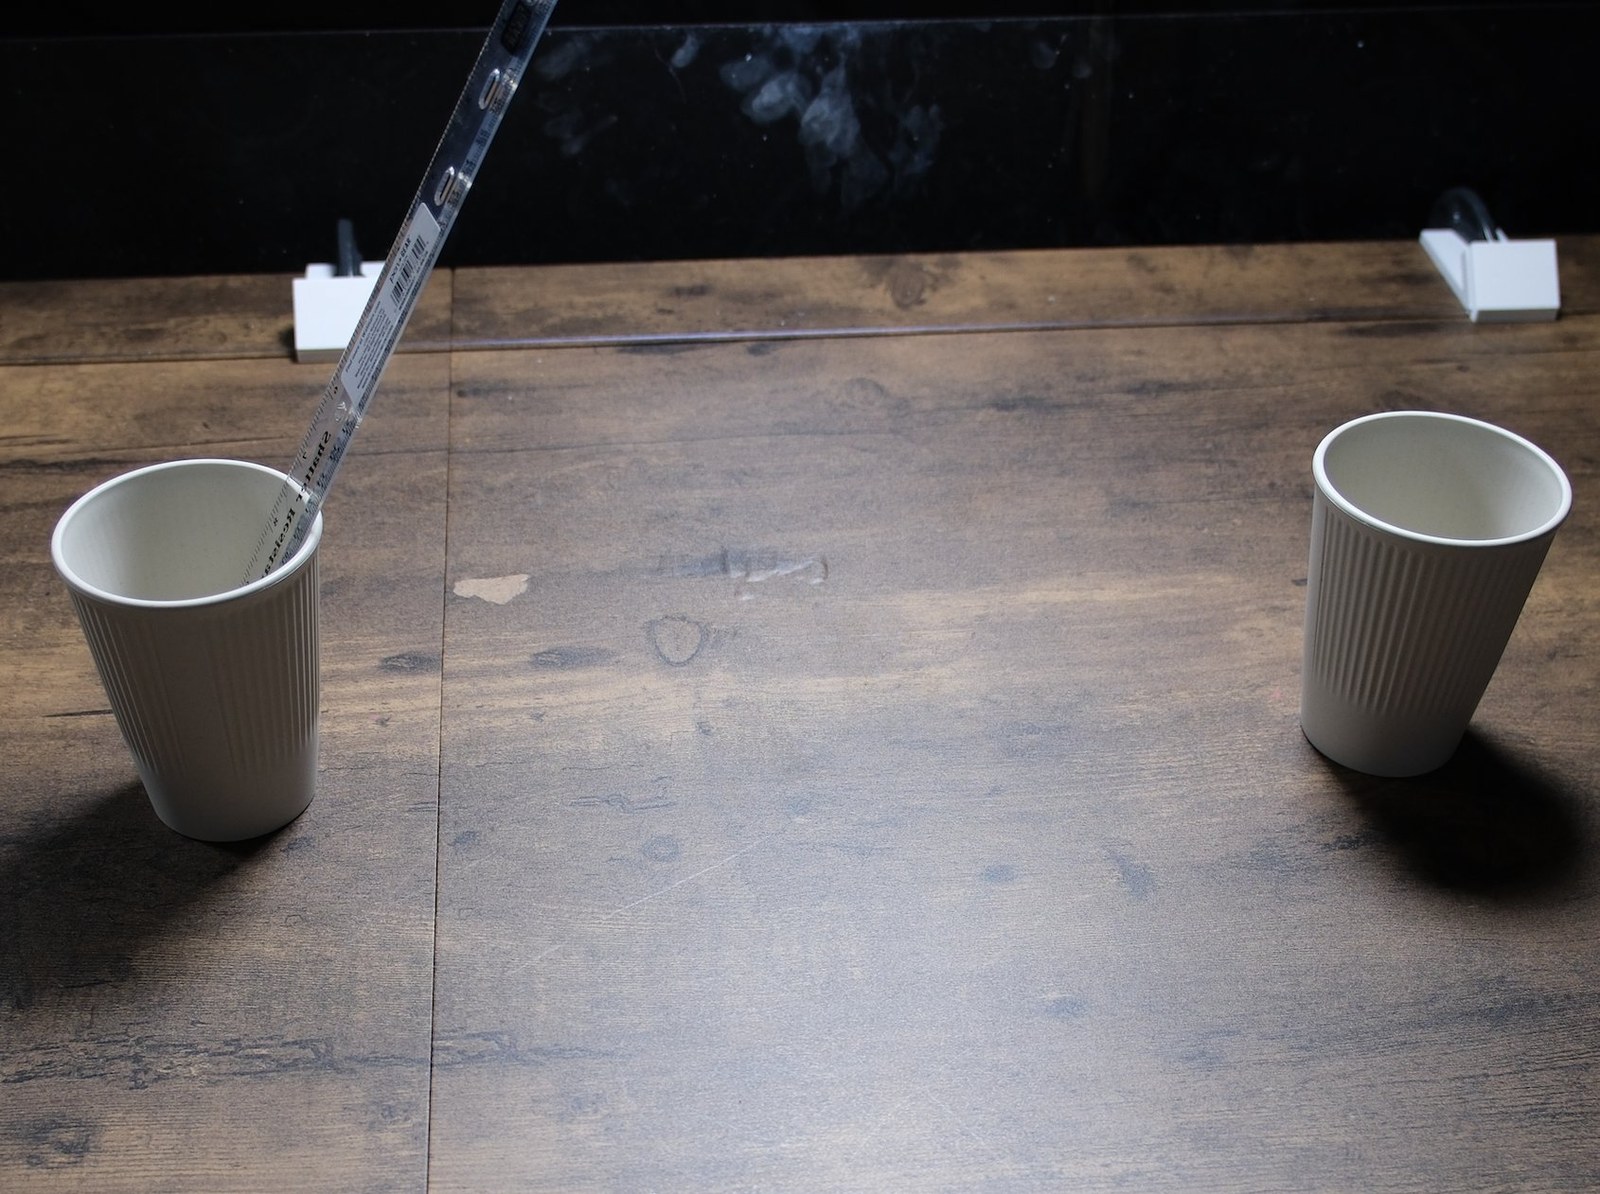
另一任务的工位实拍(尺子/交接类桌面布置)。对照第 13 章的纯仿真人形:RoboCurve 代表了评测光谱的另一端——真机、小任务集、强协议、强审计;与 RoboDojo-RealEval 同域但更「第三方商业中立」的定位。
生态位:评测市场化的先行者;短板是任务集尚小、覆盖面依赖持续运营——但「独立真机打分」这个角色,学术榜单(无商业参与的 RoboDojo)与商业评测(RoboCurve)正好互相制衡。
🧩 第二辑 · OpenWAM 评测栈补充(15–19 章)
以下五章按 OpenWAM-α 精读(arXiv 2609.07398)的评测栈补齐:该文把八个仿真基准、五类本体接入同一策略服务器,九条榜单(RoboTwin2.0 拆双轨)成为 2026 年 WAM/VLA 横评的通行口径——本辑把用户点名的 LIBERO、LIBERO-Plus、RoboCasa-GR1、EBench、RoboDojo 五章讲透(RoboTwin 双轨已并入第 09 章、VLABench/RoboCasa365 成绩已注入第 07/10 章)。
15 · LIBERO(2023 · 终身学习四套件,VLA 时代的第一考场)
一句话定位:NeurIPS 2023(arXiv 2306.03310)——130 个语言条件任务、四套件(Spatial/Object/Goal/Long)+ LIBERO-90/100 预训练集,最初为终身知识迁移设计,如今是 VLA 微调最常用的短程桌面考场(π0 系、OpenVLA 系、各家 WAM 全在此对表)。
任务与本体(仿真):Franka 桌面、程序化生成;四套件各 10 任务换措辞/物体/目标/长程结构,专测「换一种说法还会不会」。
评测协议与指标(重点):每任务多 episode 成功率、分套件报告 + 四套平均;终身学习场景另设五种迁移设定与任务顺序消融——论文著名反直觉结论:顺序微调在正向迁移上胜过 EWC/ER 等经典算法。
插图逐张
Figure 1:LIBERO 总览(复用 LIBERO 专文图)
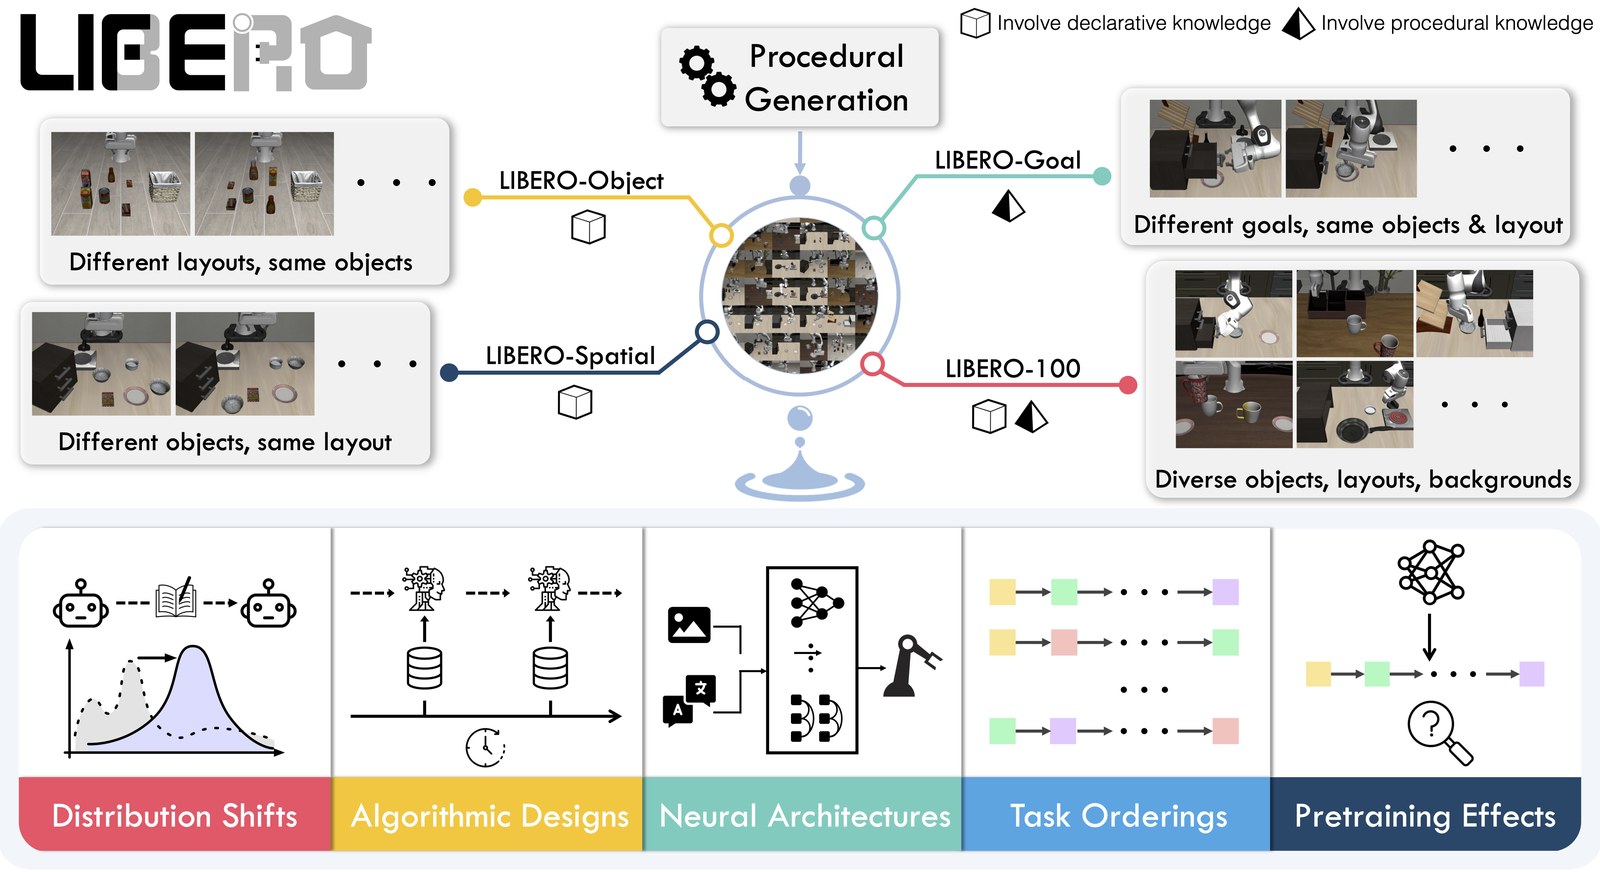
四套件与终身学习设定的总览图(同图另见 LIBERO 精读)。读表须知:97%+ 的平均分在 LIBERO 上已不稀奇——OpenWAM 榜单显示头部六七个模型挤在 96.9–99.4 区间(α 99.3、ABot-M0.5 99.4),区分度已让位给 LIBERO-Plus/RoboTwin-C2R 这类压测轨。
生态位:VLA 时代的「入场券考场」;短板是分布内过饱和——所以才有了下一章的鲁棒性加强版。
16 · LIBERO-Plus(2025 · 给 LIBERO 加 21 种「扰动刑具」)
一句话定位:arXiv 2510.13626(Fei et al.,复旦/同济/NUS,CVPR 2026)——10,030 个任务 = 7 大扰动因子 × 21 个子维的鲁棒性压测基准:同一个任务,改光照、改相机、改初始位姿、改物体布局、换措辞……看模型还剩多少分。
任务与本体(仿真):LIBERO 任务系扩展;扰动覆盖物体布局、光照、指令/目标替换、背景纹理、机器人初始状态、传感器噪声等七族。
评测协议与指标(重点):原条件成功率 vs 各扰动档成功率(难度分级递进);还做「配对扰动」热力图与指令移除/目标篡改的对照——头号发现令人倒吸凉气:模型普遍「语言忽视」——OpenVLA-OFT 原条件 97.1%,相机扰动掉到 59.7%、初始状态扰动只剩 37.2%,而语言怎么改都「不太影响」= 根本没听。
插图逐张
Figure 6:基准架构——10,030 任务全景
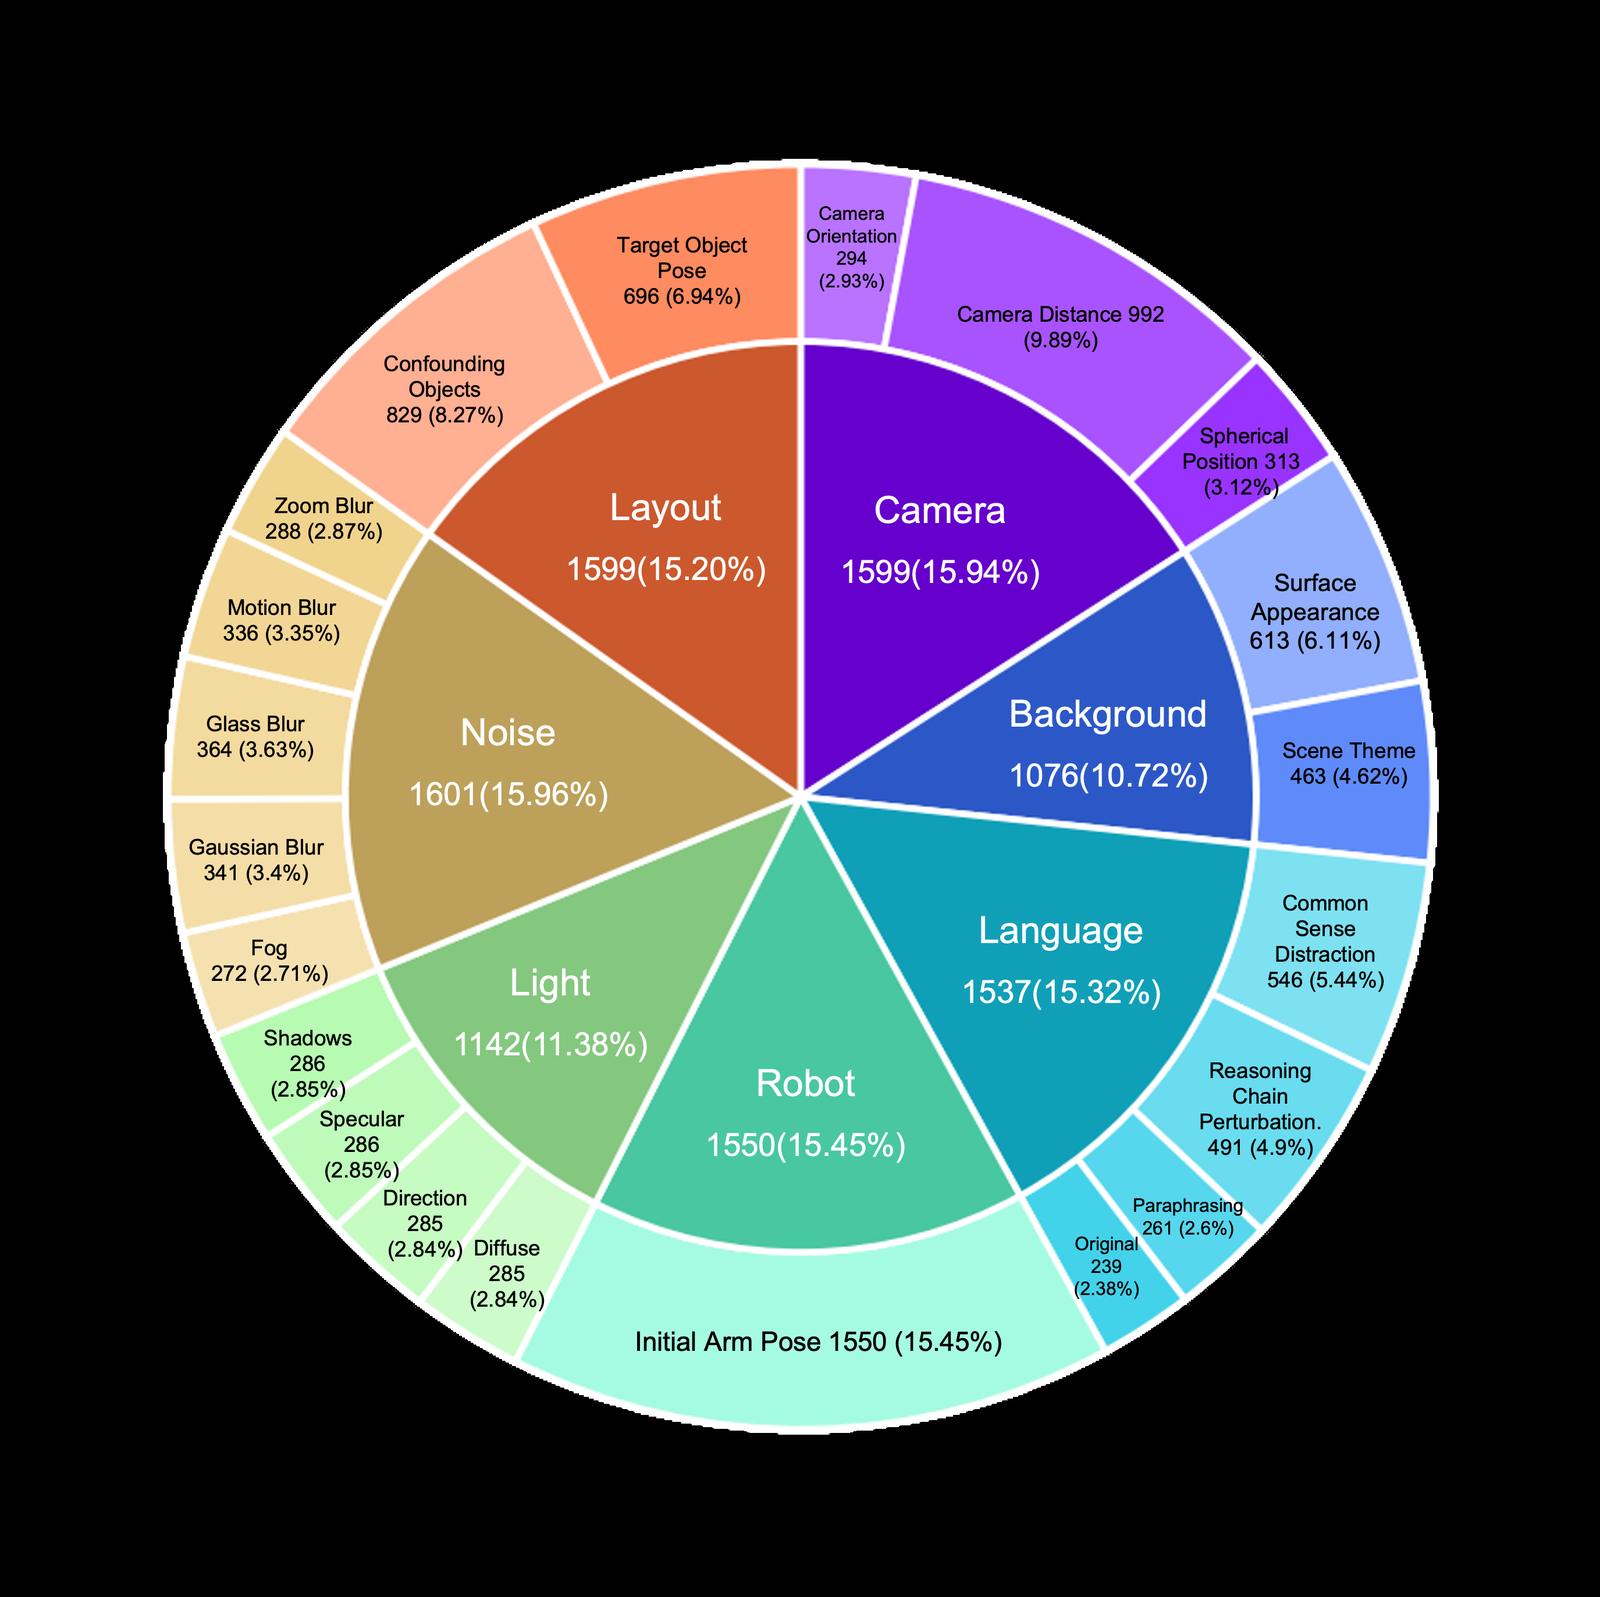
中央「10,030 tasks」徽标,七向扇出七个扰动因子,每因子再挂 21 个底层子组件;两侧标注数据流水线(扩展生成→过滤→分级)。读图抓手:规模不在任务花样,而在「同一任务 × 扰动网格」的组合数——这才能把 97% 的模型按到 40% 以下。
生态位:VLA 鲁棒性体检套餐;OpenWAM-α 在此 69.2(对照 Qwen-RobotManip 89.0 更高、π0.5 84.4——鲁棒榜是视频底座 WAM 的相对短板)。
17 · RoboCasa-GR1(2025–26 · OpenWAM 评测栈的灵巧手赛道)
一句话定位:OpenWAM 评测栈中 Dexterous-hand 赛道的仿真基准:任务系承接 RoboCasa(Nasiriany et al., 2024),本体/设定引用 NVIDIA et al., 2025 一脉的灵巧手方案;八基准里唯一考「多指手 + 日常家居任务」的组合。
任务与本体(仿真):RoboCasa 家居任务落到灵巧手本体(与第 04/10 章的夹爪厨房任务同域不同手)——24 维灵巧手槽位正来自 OpenWAM 的 80 维统一动作空间设计。
评测协议与指标(重点):与其他七基准同一策略服务器协议;成功率单指标;这是跨本体统一动作空间的压力测试——夹爪 1 维开合与 24 维手指关节共用槽位语义,映射表出错分数立刻塌。
插图逐张
RoboCasa-GR1 榜单面板(OpenWAM Figure 13 局部)
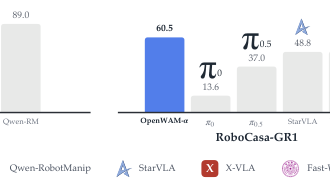
OpenWAM 九连板中本榜局部:OpenWAM-α 60.5,对照 π0 13.6、π0.5 37.0、StarVLA 48.8、Being-H0.7 49.2——夹爪系模型换到灵巧手赛道全线腰斩(π0 在普通桌面榜 94+,此处 13.6),再次验证「灵巧手是本体鸿沟不是任务鸿沟」。
生态位:OpenWAM 栈内唯一灵巧手仿真榜;真机灵巧手对照见 OpenWAM-α 精读 Fig. 14(90.0 分、未见过的本体 + 四种 OOD)。
18 · EBench(2026 · 移动双臂的「元素级诊断」)
一句话定位:arXiv 2606.18239(Gao et al.)EBench: Elemental Diagnosis of Generalist Mobile Manipulation Policies——26 个任务横跨 pick-and-place、长程、灵巧与精密三族,装在移动双臂本体上,主打按能力元素拆分归因的诊断式评测(OpenWAM 栈归为 Mobile bimanual 赛道)。
任务与本体(仿真):移动双臂(带底盘)——比桌面双臂多出「基座移动 × 双臂配合 × 精密」三重耦合;12 个预留动作槽里的底盘通道正是为它与 RoboCasa365 准备。
评测协议与指标(重点):五轴能力分解(操作模式/时间结构等任务级三轴 + 泛化轴);数据切分 Validation-Train / Validation-Unseen / Test 三档——像切蛋糕一样看「练过但没见过」与「完全没见过」的差值;配 per-task 热力图定位病灶任务。
插图逐张
Figure 1:总览——单套件覆盖多能力轴
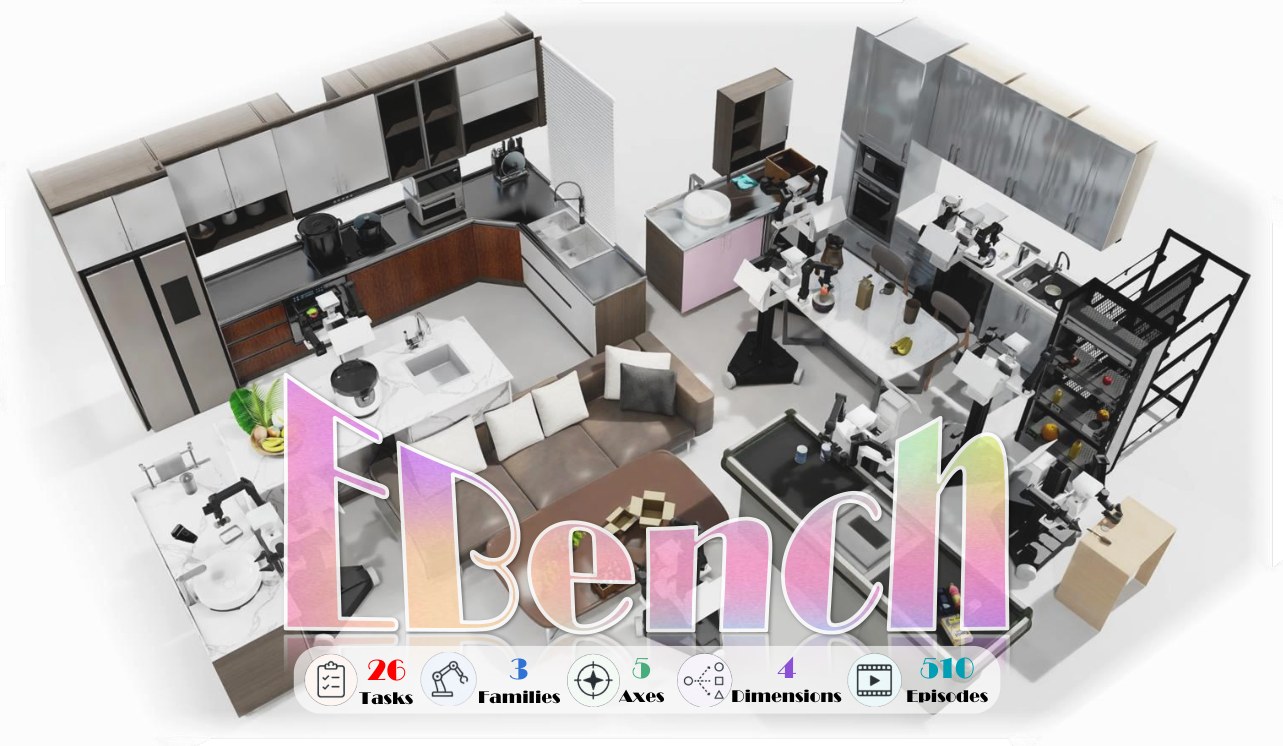
单幅总览:三族任务(pick-and-place / 长程 / 灵巧精密)+ 能力轴分解示意,强调「一个套件同时覆盖」——与 RoboDojo 的五维哲学同款,但把镜头对准移动双臂。
Figure 2:端到端管线
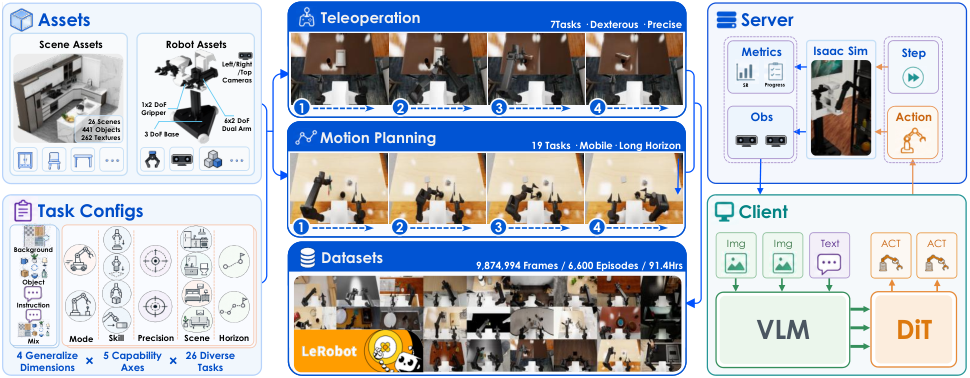
左侧 26 任务三族实例化、右侧评测管线(数据切分→执行→分轴统计→热力图)。评测含义:任务少而诊断颗粒细——适合「模型为什么在长程上塌」这类问题,而不是刷总榜。
生态位:移动双臂诊断首选;OpenWAM-α 49.4(Being-H0.7 49.2 咬得很紧)——这条赛道尚未出现统治者。
19 · RoboDojo(2026 · 统一仿真-真机评测场,专文姊妹章)
一句话定位:已在专文深挖的旗舰评测场——42 仿真任务五能力维(泛化/记忆/长程/精密/开放指令)+ 18 真机任务 × 三双臂本体(ARX X5/Piper/Piper X),非营利榜单治理 + 隐藏布局防刷 + XPolicyLab 统一接入;本章只补作为 OpenWAM 九榜之一的口径要点。
评测协议与指标(重点):平均分(score,部分进度)+ 成功率(SR)双指标;总分=五维均值;OpenWAM-α 的 11.92 是分数制口径(对照 π0.5 6.91、π0 29.4→注意方向与榜单时序),不是成功率——与 RoboDojo 精读的 7 月快照(最佳 13.07 分/8.80% SR)同一体系;真机侧 OpenWAM 报 37.6 分/24.4%(对照 π0.5 22.9/12.8)。
插图逐张
Figure 2:42 仿真 + 18 真机任务总览(复用专文图)
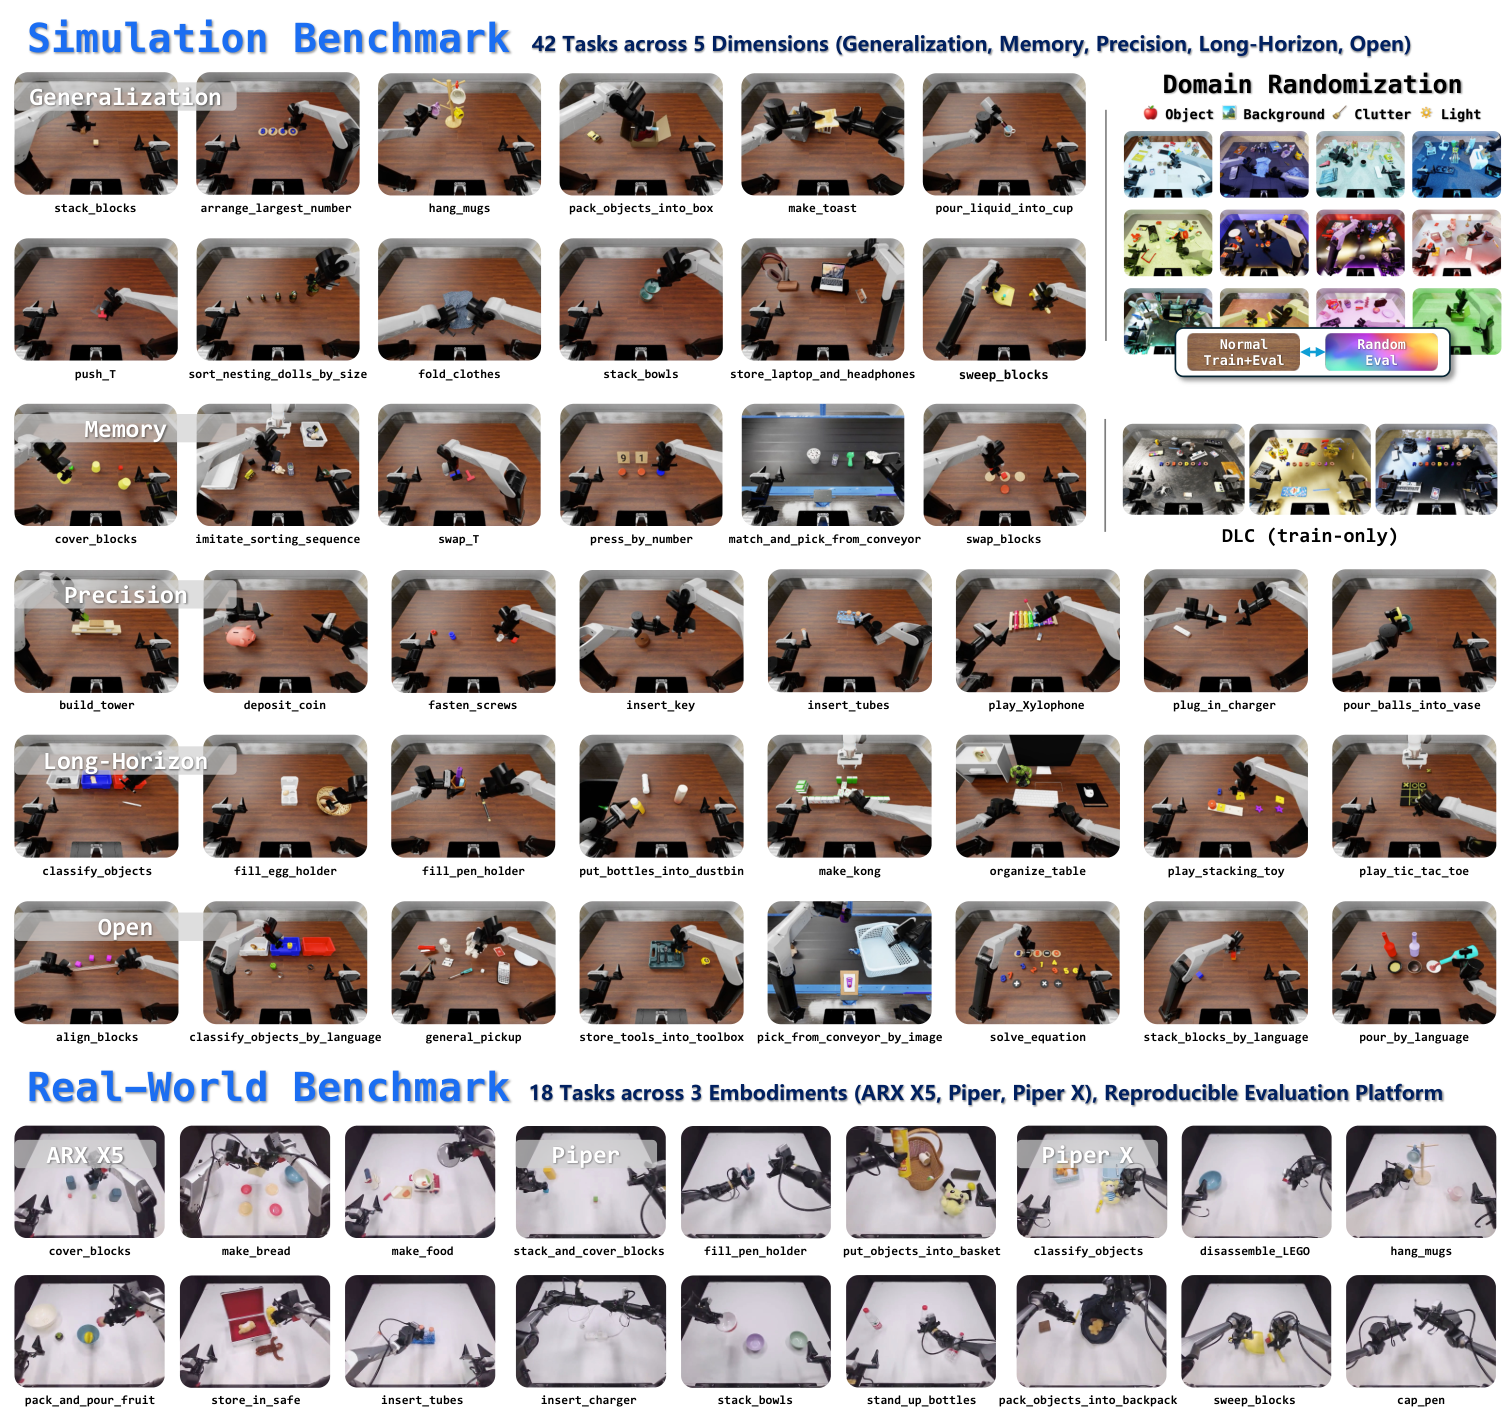
左仿真五维任务地图、右三本体真机任务阵列(详解见专文 Figure 2 逐图)。本章只强调读榜三件事:①带指标名(score vs SR)②带日期(榜单持续更新,7 月 vs 10 月差一个量级)③治理条款(隐藏布局/开源工件)先于分数。
生态位:见专文总表;在 OpenWAM 语境里它是九榜中唯一 score/SR 双报且含真机的成员。
🗺️ 19 榜横向总表:任务量、类型与「怎么测」
| Benchmark | 类型 | 本体 | 任务/规模 | 评测怎么测(一句话) |
|---|---|---|---|---|
| Meta-World | 仿真·RL | Sawyer | 50 任务 | MT/ML 四协议,距离阈值成功,10 seeds 平均峰值 |
| RLBench | 仿真·模仿/RL | Franka | 100 任务 + 无限自动演示 | task/variation/episode 三层,成功率+变体泛化 |
| CALVIN | 仿真·语言长程 | Franka | 4 环境 34 任务、1000 条五步链 | 链全对才算成;跨环境零样本 |
| RoboCasa | 仿真+真机·厨房 | Franka | 100 原子 +75 复合、2,509 物体 | 原子/复合分列;真机小样本迁移 |
| SimplerEnv | real-to-sim | Google Robot / WidowX | 复刻真机装置若干任务 | Visual Matching / Variant Aggregation;与真机排名 MMRV/Pearson 相关 |
| BEHAVIOR-1K | 仿真·活动级 | 多种 | 1,000 活动 ×50 场景 | 逻辑谓词成功分;附真机-仿真差距刻画 |
| VLABench | 仿真·语言+推理 | 多本体 | 60 原子 +40 复合、2,000+ 物体 | 六维分测;VLA 与 VLM 管线双赛道 |
| ManiSkill3 | 仿真框架+基准 | 16+ 本体 | 跨操纵/移动/人形任务族 | GPU 批量成功率;吞吐即指标;real2sim 复测 VLA |
| RoboTwin 2.0 | 双臂数据引擎+基准 | 5 本体 | 50 双臂任务、11k 纹理 | clean/randomized 双列;MLLM 产码产数 |
| RoboCasa365 | 仿真·预训练+基准 | Panda 等 | 365 任务、2,500 场景、2,200h | 预训练→后训三档切片;真机 140 演示 Sim+Real 对照 |
| MagicSim | 仿真运行时 | 多本体 | 15 仿真家族 | 不测任务,测确定性/吞吐/标注完备 |
| XPolicyLab | 策略接口生态 | 任意适配 | 榜单执行层 | 一次接入多榜;接入成本量化 |
| HumanCLAW-Bench | 仿真·人形全身 | 人形 | 1,218 episode ×41 住宅 | Find→Nav→Interact 三段漏斗 + 失败根因规则 |
| RoboCurve | 真机独立评测 | 双臂桌面等 | Stationery/Kitchen/RoboHarm | 固定工位 + 调用配额上限 + 审计日志;真机榜与拒答率 |
| LIBERO | 仿真·语言/终身 | Franka | 130 任务×4 套件 | 分套件成功率 + 五种迁移设定 |
| LIBERO-Plus | 仿真·鲁棒性 | Franka 系 | 10,030 任务(7 扰动×21 子维) | 扰动下成功率保持;查「语言忽视」等病灶 |
| RoboCasa-GR1 | 仿真·灵巧手 | 灵巧手本体 | RoboCasa 任务系 | 成功率(OpenWAM 评测栈赛道) |
| EBench | 仿真·移动双臂 | 移动双臂 | 26 任务×三族 | 五轴能力分解 + Train/Unseen/Test 三 split |
| RoboDojo | 仿真+真机 | 三双臂本体 | 42 仿真 + 18 真机 | 五维平均分/成功率;隐藏布局防刷 |
🤝 与 RoboDojo 的关系:一张分工图
把 RoboDojo 放回这 19 个名字中间,分工一目了然:
- 任务供给层:RoboCasa/RoboCasa365(厨房)、RoboTwin 2.0(双臂)、VLABench/CALVIN/RLBench/Meta-World(语言/技能/RL 经典)、BEHAVIOR-1K(活动级)——给「考题」;
- 运行时层:MagicSim(确定性批式仿真)、ManiSkill3(GPU 并行)、OmniGibson(状态物理)——给「考场引擎」;
- 接口与治理层:XPolicyLab(策略怎么接)、RoboDojo(考什么、怎么算数、怎么防刷、sim+real 双场)、HumanCLAW-Bench(新维度:全身人形)、RoboCurve(真机第三方审计)——给「考试制度」;
- 复测代理:SimplerEnv 把真机搬回仿真,与 RoboDojo-RealEval 的「真机标准化」互为镜像。
一句话:RoboDojo 是 2026 年「评测治理」的答案之一;本篇其余 13 个是它的上游(题、引擎、接口)与旁路(替代考场、真机对手盘)。
❓ 自测 Q&A
Q1:同样是「厨房」,RoboCasa 和 RoboCasa365 怎么选?
看目的:做评测/小样本方法→ RoboCasa(任务经典、引用多);做预训练/大规模后训→ RoboCasa365(2,200+ 小时、365 任务、有 GR00T 级训练配方)。
Q2:SimplerEnv 为什么没有「自己的任务发明」?
它是 real-to-sim 评测器:任务与装置来自已发布的真机实验(RT-1/BRIDGE),价值在于成绩与真机排名相关(MMRV/Pearson),发明新任务反而会破坏这种相关性验证。
Q3:Meta-World 的 MT50 分数能说明「通才能力」吗?
只能说明多任务并训在同分布上的表现;它的任务短、桌面同构,通才含金量要看跨场景/跨本体/长程榜(RoboDojo、VLABench、HumanCLAW-Bench)。
Q4:XPolicyLab 和 RoboDojo 是什么关系?
分工互补:RoboDojo 定义任务与治理规则(隐藏布局、开源工件),XPolicyLab 提供把任意策略一致地执行在这些规则下的接口层;RoboTwin 等其他榜也复用同一接口。
Q5:HumanCLAW-Bench 为什么九个前沿 VLM 都只有 16.8%?
漏斗显示失败集中在 Nav→Interact 段:不是「看不见」,而是具身自我认知不足——不知道身体在哪、到没到、刚做动作造成了什么(论文 Figure 8/9 的失败根因分桶)。
Q6:真机榜单可信度靠什么?
两套制度互证:RoboDojo-RealEval 靠非营利治理 + 双盲评分 + 隐藏布局 + 强制开源工件;RoboCurve 靠第三方运营 + 调用配额公平 + 审计日志公开。看榜先看治理条款,再看分数。
📊 图表总索引(55 张插图)
| 章 | 图 | 内容 |
|---|---|---|
| 01 | Figure 1(头图) / Figure 3 | 50 任务总览 / 三套评测协议 |
| 02 | Fig. 1 / 3 / 4 | 100 任务网格 / 观测栈 / task-variation-episode |
| 03 | Fig. 1 / 3 / 5 | 训练 ABC→测试 D / 传感器 / 五步语言链 |
| 04 | Fig. 1 / 2 / 3 / 4 / 8 | 四支柱 / 平面图 / 电器 / 2,509 物体 / 真机厨房 |
| 05 | Fig. 1 / 3 / 4 / 10 | 套件总览 / SysID / 视觉匹配 / 变体聚合 |
| 06 | Figure 1 / 2 / 5 | 人本筛选 / 数据集+OmniGibson / Sim-Real 差距 |
| 07 | Figure 1 / 2 / 3 / 7 | 六维考纲 / 拿铁长程 / 任务样例 / 四视角观测 |
| 08 | Fig. 1 / 6 / 14 / 25 | 任务带 / 异构并行 / 机器人库 / Octo-RT1X 评测 |
| 09 | Figure 1 / 4 / 8 / 10 | 总览 / 域随机化 / 50 双臂任务 / 真机四配置 |
| 10 | Figure 1 / 2 / 3 / 6 | 365 信息图 / 场景族 / 300 复合 / 真机 Panda |
| 11 | Figure 1 / 5 / 7 / 10 | at-a-glance / 15 家族 / 随机化布局 / 本体库 |
| 12 | Fig. 1 / 2(SVG) / 3 | 标题页 / 架构 / 跨平台评测 |
| 13 | Figure 1 / 2 / 7 / 8 | 三种体制 / 闭环框架 / 难度分布 / 失败漏斗 |
| 14 | 实拍 1 / 2 | StationeryBench 橡皮入盒 / 尺子交接 |
| 15 | LIBERO Figure 1 | 终身学习/四套件总览(复用 /images/bench_libero/) |
| 16 | LIBERO-Plus Figure 6 | 10,030 任务 ×7 扰动 ×21 子维架构 |
| 17 | RoboCasa-GR1 榜单面板 | α 60.5 对照 π0/π0.5/StarVLA/Being |
| 18 | EBench Fig. 1 / Fig. 2 | 总览 / 26 任务端到端管线 |
| 19 | RoboDojo Figure 2(复用专文图) | 42+18 任务总览 |
(各章指标表、榜单快照与消融表已在正文以文字表格复现;55 张图片文件位于站内 /images/bench_*/、/images/paper/libero/、/images/robodojo/(复用)。)
📚 资源与延伸
- 姊妹篇:RoboDojo 精读(42 仿真 + 18 真机统一评测场、榜单治理全解)
- 各 benchmark 出处:Meta-World 1910.10897 · RLBench 1909.12271 · CALVIN 2112.03227 · RoboCasa 2406.02523 · SIMPLER 2405.05941 · BEHAVIOR-1K 2403.09227 · VLABench 2412.18194 · ManiSkill3 2410.00425 · RoboTwin 2.0 2506.18088 · RoboCasa365 2603.04356 · MagicSim 2606.17511 · XPolicyLab 2608.09892 · HumanCLAW 2607.27180 · RoboCurve robocurve.org(Inspect Robots 开源框架)
- 相关精读:LIBERO、HexaShell、EmbodiedEvo、WorldScape、π0.7、GR00T-N1.7
- 知识铺垫:WAM 世界行动模型全景分析、什么是世界模型