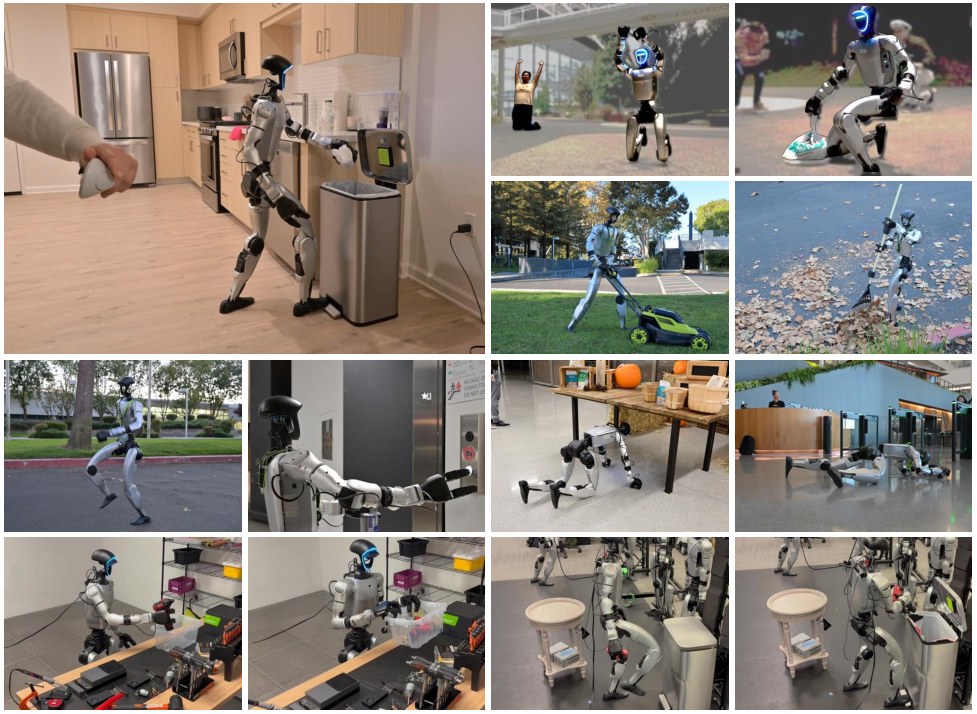
配图说明:本文收录 3 篇论文共 11 张插图(/images/sonic/ 4 张、/images/fluxvla/ 4 张、/images/findrl/ 3 张),逐张讲解,文末附图表总索引。本篇是调研型精读:主体三章分别深挖 SONIC(人形运动跟踪 RL 基础模型,NVIDIA+UT Austin,Science Robotics 2026 / arXiv 2511.07820)、VLA 强化学习后训练谱系(含真机自主练习的 FIND)、FluxVLA Engine(一站式 VLA 工程平台,arXiv 2609.17210),其余代表作以地图与总表覆盖。相关旧文:GR00T-N1.7 精读、π0.7 精读、仿真 Benchmark 全精读。
🧒 小白 5 分钟:具身智能的「强化学习」到底在学什么?
一句话:模仿学习(IL)是「看老师做,照着学」;强化学习(RL)是「自己试,按打分改」——试错拿奖励(reward),把「怎么做得分高」压进模型。
奖励从哪来?三条常见路线:
- 稀疏任务奖励:整件事做完 = 1 分,中途 = 0(最真实,也最难学);
- 密集跟踪奖励:给一条参考动作(如人跳舞的动捕),每一步「像不像」都有分(SONIC 走这条,免手工设计奖励);
- 过程奖励/评委模型:用一个模型给中间步骤打分(VLA-RL 用 VLM 当过程奖励模型;ABot-AgentOS 的 LLM-as-Judge 同思路)。
具身 RL 为什么比下棋难?四个坑:
- 重置难:游戏死了按重开;机器人要把碗放回原位才能下一局(真机上这就是人工成本);
- 奖励稀疏 + 接触物理:抓歪 1 毫米就失败,信号极稀;
- sim2real:仿真里练成的策略,真机摩擦光照一变就废;
- 模型太大不稳:几 B 的 VLA 直接上在线 RL,训练说崩就崩(iRe-VLA 就是为这个提出的)。
在 VLA 时代,RL 通常不是从零学,而是后训练(post-training):SFT 打底 → RL 在交互/评测数据上继续拔高(π*0.6 的 Recap、ConRFT 的离线+在线两段都是这个配方)。本文接下来按四条战线展开:底层运动控制 RL(SONIC)→ VLA 后训练算法谱系 → 工程框架(FluxVLA Engine)→ 仿真 RL 底座(一句带过,详见 Benchmark 篇)。
🗺️ 全景地图:具身 RL 的四条战线
| 战线 | 解决什么 | 代表作(出处) | 奖励来源 |
|---|---|---|---|
| A. 底层运动控制 RL | 人形怎么全身动得像人 | SONIC(Sci. Robot. 2026 / 2511.07820)、PHC/H2O 一脉 | 密集运动跟踪奖励 |
| B. VLA 在线 RL 后训练 | 预训练策略在任务上继续变强 | iRe-VLA(2501.16664, ICRA'25)、VLA-RL(2505.18719)、FIND(2609.32069)、π*0.6 Recap/RL Token | 任务成功 + 过程奖励/奖励模型 |
| C. 离线/混合与蒸馏 | 不碰环境或少碰环境地吃奖励 | RLDG(RSS'25)、ConRFT(RSS'25)、BORA(2605.30226,离线→在线残差)、FluxVLA 的 reward/advantage-weighted | 离线轨迹打分、优势加权 |
| D. 工程框架/底座 | 把上面这些跑起来、可复现 | FluxVLA Engine(2609.17210)、RLinf(在线 RL 集成)、Isaac Lab / ManiSkill3(PPO/SAC,见基准篇) | 框架无关 |
怎么读本文:第 1 章深挖 A(SONIC,4 图);第 2 章串讲 B/C 的算法谱系(配 FIND 3 图);第 3 章深挖 D 的 FluxVLA Engine(4 图);最后总表 + 选型。
1️⃣ 战线 A:SONIC——把「运动跟踪」练成 RL 基础模型
一句话定位:NVIDIA + UT Austin 等(Zhengyi Luo、Ye Yuan…Jim Fan/Yuke Zhu 组),Science Robotics 2026(arXiv 2511.07820)——用 RL 的运动跟踪任务当「可扩展训练目标」:动捕数据密集监督 + PPO,免手工奖励工程;沿**参数量(1.2M→42M)、数据(1 亿+帧 / 700 小时动捕)、算力(2.1 万 GPU 时、最多 128 GPU)**三轴 scaling,得到单个通用人形控制器。
为什么它算「具身 RL」的样板
- 奖励 = 跟踪参考动作的密集项(论文奖励表 Tab. S3;明确反对「每个场景手工设计奖励」——跳舞和走路的奖励信号完全不同,手写奖励没法 scaling);
- 训练算法 = PPO 系(正文多处提及,动捕参考轨迹提供每个状态的监督);
- 统一 token 空间:SMPL 人体动作 → 潜在命令,VR 遥操作、视频动捕、VLA(GR00T) 共用同一策略接口——RL 学的不是一个任务,而是一个**「听得懂多种指挥的运动接口」**。
插图逐张(SONIC 4 张)
Figure 1:通用控制策略总览(头图)
(即文首头图。)一个通用控制策略居中,周围是它支持的多样任务与接口:不同输入模态、不同控制指令、多种人形行为。读图抓手:「一个策略 × 多种指挥方式」——这正是统一 token 空间的卖点:动作、VR、VLA 都翻译成同一套潜在指令再跟踪。
Figure 2:缩放定律与基准
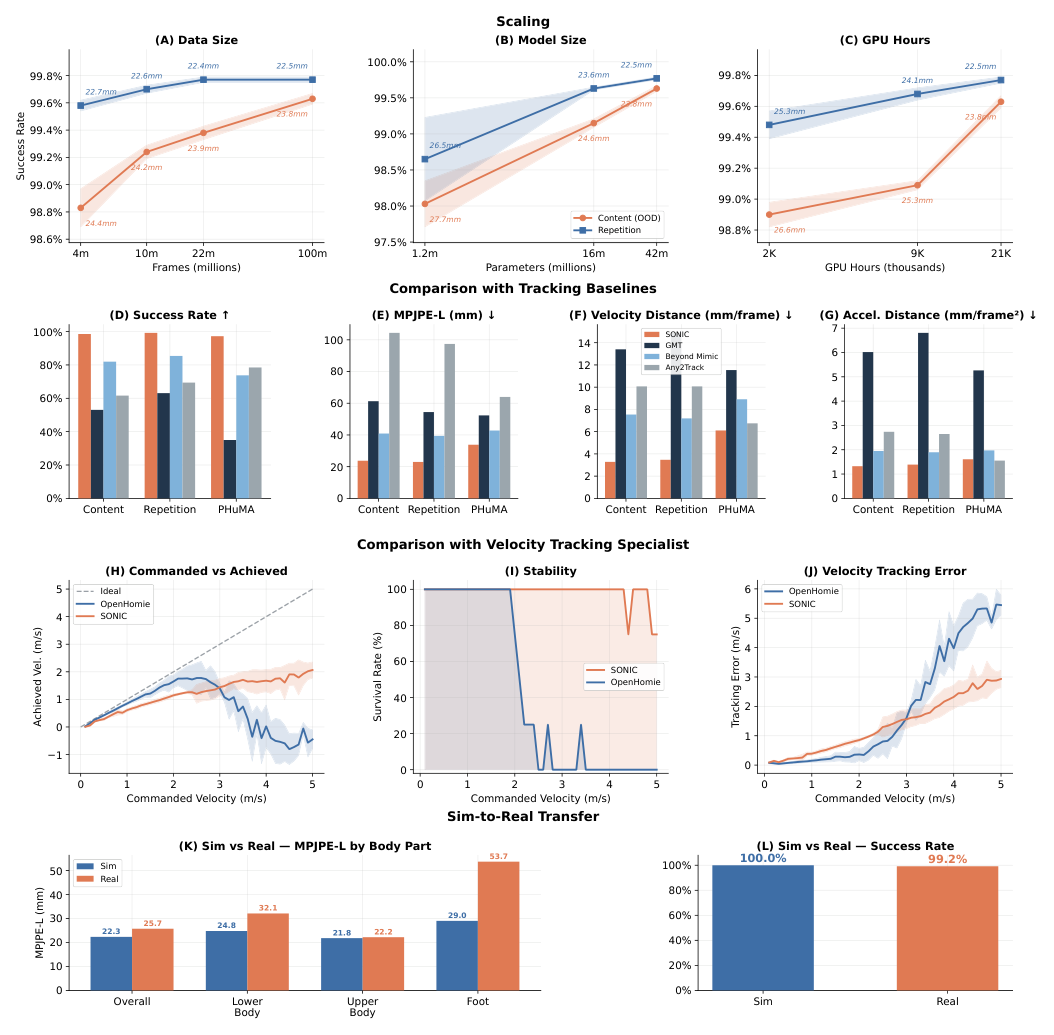
三格曲线 (A–C):数据量、模型量(1.2M→42M)、算力对测试跟踪误差的影响——误差随三轴上升持续下降,首次把人形 RL 的 scaling law 画清楚。右侧/下半是基准对照(对 OpenHomie 等专用控制器的跟踪误差与生存率)。这张图是全文方法论核心:运动跟踪 = 密集奖励 → RL 可以像预训练一样 scaling。
Figure 4:多模态实时控制
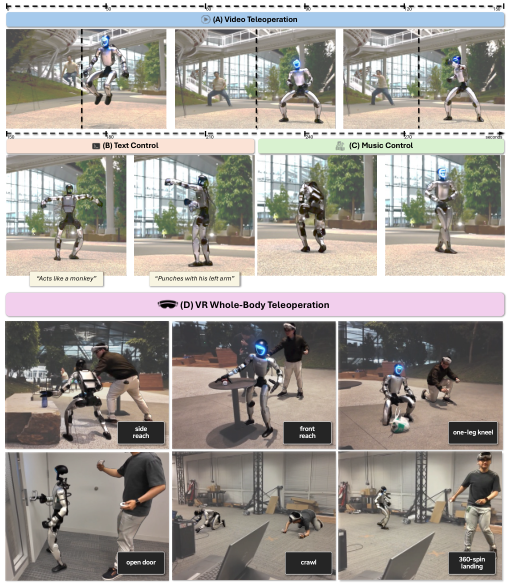
单个策略被异构输入驱动的分栏示意:(A) 视频动捕(RGB 视频→姿态→策略)、VR 头显全身追踪、文本/其他指令通道(细节见论文)。工程含义:策略即接口——下游系统(遥操作、VLA、模仿)都通过它落地,控制频率与延迟在 Jetson 部署图(Fig. S1)里专门优化。
Figure 5:VLA 驱动的移动操作
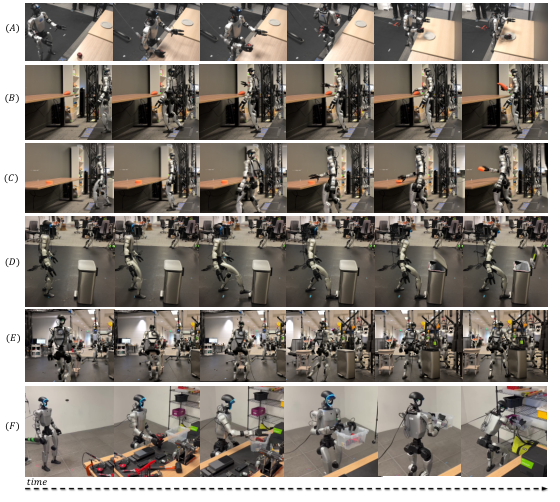
时序帧带(时间从左到右):(A) 苹果放盘 等 5 个 loco-manipulation 任务——GR00T 类 VLA 输出紧凑潜在动作 token → SONIC 解码成全身关节指令(腿+臂+手协调,走过去+操作)。这是战线 A 与 B 的接缝图:VLA 负责「想哪一步」,SONIC 负责「全身怎么动」——GR00T-N1.7 精读里的 UNITREE_G1_SONIC 本体标签指的就是这条链路。
部署与真机:Jetson Orin 全板载推理;124 条动作序列真机评测集(Fig. S4)、11kg 重物砸落鲁棒性测试(Fig. S5)——RL 训出的跟踪策略直接上真机 G1。
生态位:给「人形全身控制」提供了 RL 版答案;与 IL 保数据(遥操作克隆)互补——跟踪奖励让海量动捕视频变成可训练的监督,这是数据侧的 scaling。
2️⃣ 战线 B/C:VLA 的 RL 后训练谱系——八种打法
预训练 VLA 是「冻结的通才」,RL 后训练负责让它在自己的失败上变强。按「谁来打分、碰不碰环境」分八路(全部为调研后核实的代表作):
2.1 iRe-VLA(2501.16664, ICRA 2025)——RL 与 SFT 交替,专治在线 RL 不稳
核心观察:几 B 的 VLA 直接上在线 RL,训练严重不稳。解法是 RL 段与监督(SFT/专家蒸馏)段迭代交替:RL 提供探索收益,SFT 把模型拉回稳定流形。仿真两套基准 + 真机验证。这是「大模型 RL 后训练」工程配方的早期标准答案。
2.2 VLA-RL(2505.18719, 清华/南洋理工)——轨迹级 RL + 过程奖励模型
把自回归 VLA 的整条轨迹形式化为多模态多轮对话的轨迹级 RL;稀疏奖励用微调 VLM 当机器人过程奖励模型(伪奖励标注)解决;系统侧给向量化环境、批量解码、critic 预热。结果:OpenVLA-7B 在 LIBERO 40 任务上平均 81.0%,超 SFT 微调基线 76.5%(四套 90.2/91.8/82.2/59.8)。注意这个数字口径——同为 LIBERO,协议不同勿与基准篇的其他表直接横比。
2.3 RLDG(RSS 2025)——RL 当「数据厂」,蒸馏给通才
每任务先训 RL 专家策略 → 用专家批量采数据 → 再用这些数据微调单个通才策略(OpenVLA/Octo 等)。与直接 RL 微调通才相比,成功率高 30–50%——把「RL 的高上限」和「通才的可部署性」用蒸馏缝合,真机重置成本也被 RL 专家阶段吸收。
2.4 ConRFT(RSS 2025)——离线 + 在线两段,一致性策略当桥
离线段先用一致性策略(consistency policy)做稳定初始化,在线段再用交互数据强化微调;统一的一致性动作表示让两段共享目标。结论强调:微调预训练 VLA 比从零 RL 强得多(从零 RL 的样本需求对真机不现实)。
2.5 RLVLA 实证研究(rlvla.github.io)——PPO / GRPO / DPO 到底谁有用?
对 OpenVLA+LoRA 做 RL vs SFT 的系统对照:RL 主要提升执行类泛化(Execution),语义泛化中等受益,视觉泛化与 SFT 持平;工程上给出共享 critic 省 45% 显存、加速 53%、VLA warm-up 少 50% 环境步等实用结论——给「该不该上 RL」提供了实证决策树。
2.6 π*0.6 Recap / RL Token(Physical Intelligence, 2025-11 博客)——从经验中学习再蒸馏进通才
与 π0.7 直接相关的官方路线(见 π0.7 精读):用 RL(Recap 算法)在特定任务上优化鲁棒性与吞吐,把训练中产生的经验数据蒸馏回通才模型——π0.7 能单模型匹敌各任务 RL 专家,靠的正是把这条 RL 管线产出的数据带元数据吃进预训练。**「RL 不直接上机、而是当数据发动机」**的代表打法。
2.7 BORA(2605.30226)——离线 token-动作 RL → 真机在线残差
两段式:离线阶段用整合 critic(语义锚定 + 时间信用分配 + IQL)在 token-动作空间做离线 RL;在线阶段只学残差策略修正基础策略——把「离线 RL 的安全」与「在线 RL 的适应」装进灵巧 VLA,真机只需学小残差。
2.8 FIND(2609.32069)——真机自主练习的 Agent 化 RL(3 图详解)
一句话:让 VLA 自己找自己不会的题并反复练——场景理解 → 自我练习 → 自评 → 改进的持久工作区闭环;基础策略 π0.5 + 残差离策略 RL(critic 式修正动作),8 个可逆真机任务上人工评估成功率 55% → 71.9%;单次代表 6 小时真机自主运行(含人工仅做场景重置的统计,Table II)。
插图逐张(FIND 3 张)
Figure 1:FIND 总览——四环节自主闭环
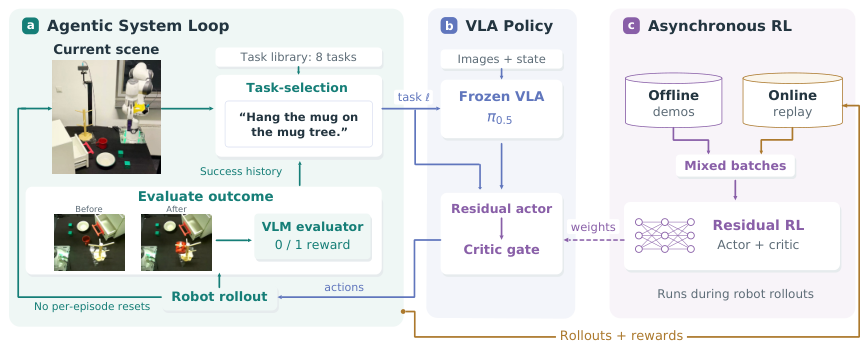
环路四站:(a) Agent 循环在持久工作区里识别可行任务(按近期表现排练习优先级)→ 练习执行 → 自评(VLM 监督组件核对前后图像对)→ 策略改进(残差 RL 更新)。读图抓手:重置难题被「可逆任务 + 持久工作区」绕开——这是真机 RL 最大的人力黑洞,FIND 用任务设计与 agent 排程把它自动化。
Figure 2:场景条件、表现感知的任务采样
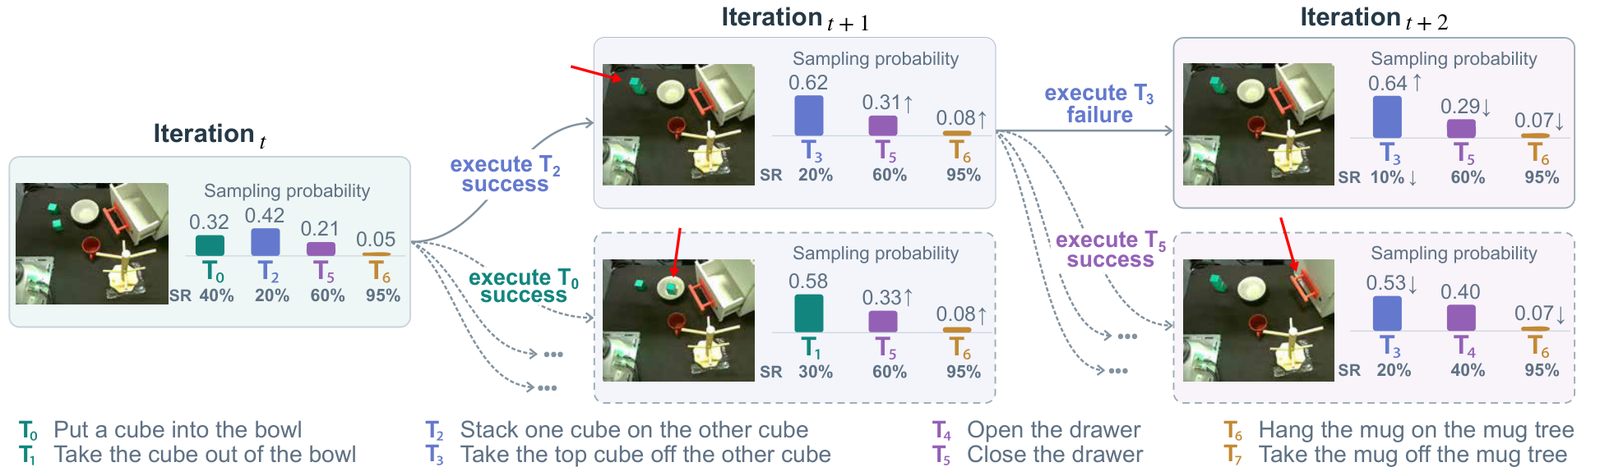
每次迭代:当前工作区决定哪些任务可行,再按近期任务表现挑「最该练的」——本质是把「课程学习 + 探索-利用」搬进真机调度。与 RoboOS-NeXT/ABot-AgentOS 的大脑调度不同:这里调度的不是多机器人,而是练习题。
Figure 3:多任务自主自我提升曲线
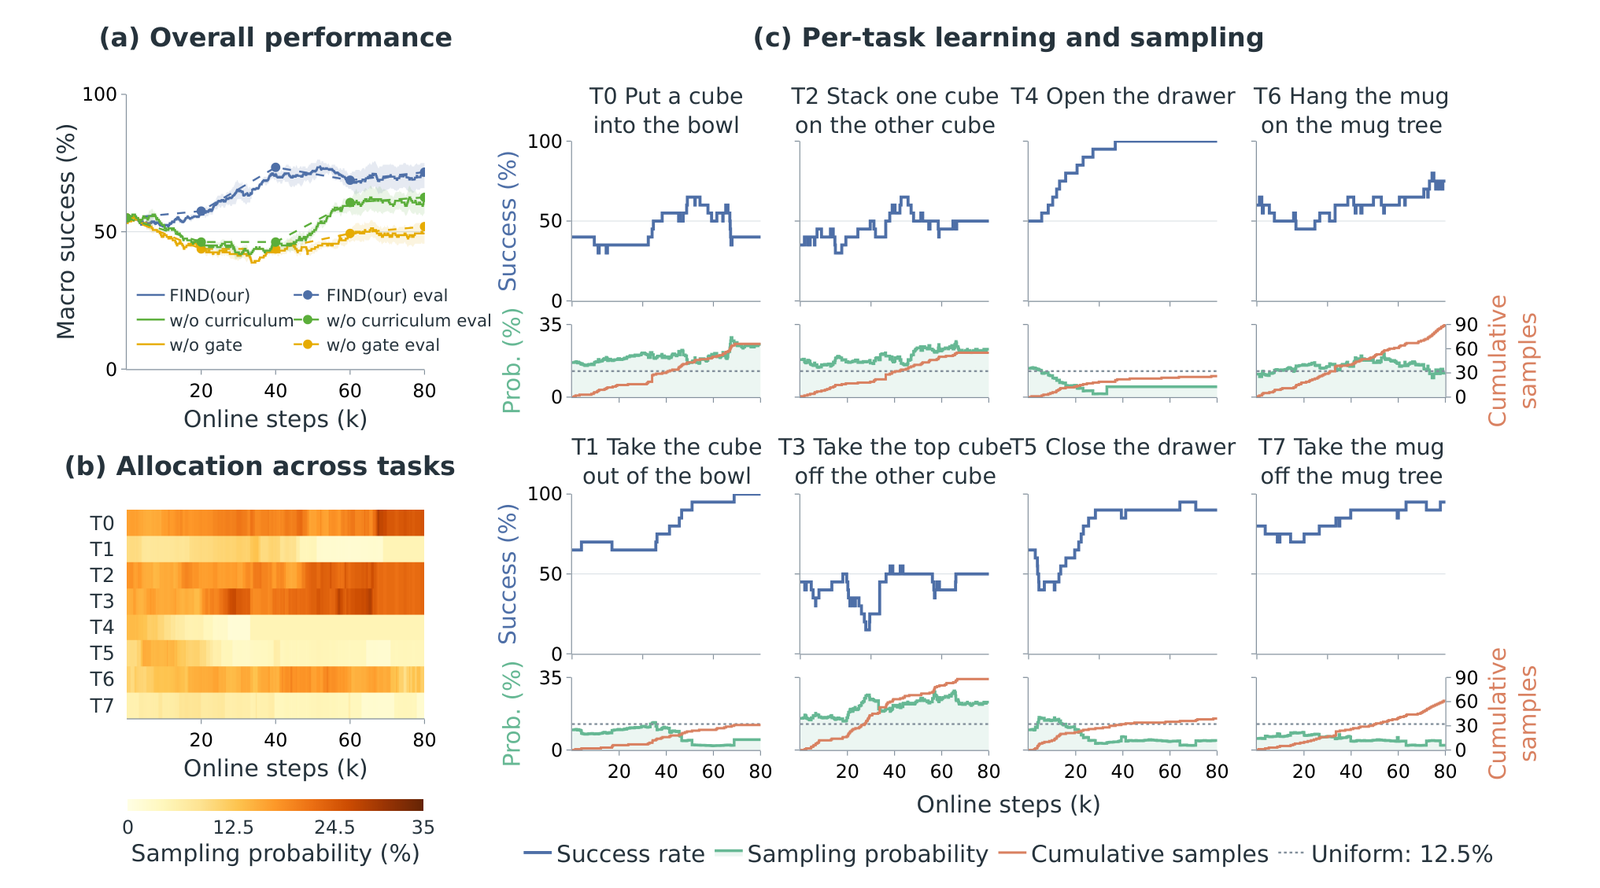
(a) 在线滚动成功率(5 次独立运行均值,随练习单调抬升);(b) 任务级汇总。核心数字即 55%→71.9%——不是仿真,是真机上「越练越强」的 RL 曲线,也是本调研里真机自主 RL 闭环最完整的实例。
谱系一句话:B/C 战线的共同主题是**「奖励稀缺、重置昂贵、模型巨大」三个约束下的妥协艺术**——交替训练(iRe-VLA)、过程奖励(VLA-RL)、数据蒸馏(RLDG/Recap)、离线+残差(BORA/FIND)各赢一头。
3️⃣ 战线 D:FluxVLA Engine——把 RL 之后的一整条工程线标准化
一句话定位:LimX Dynamics 等(arXiv 2609.17210, CC BY 4.0,GitHub FluxVLA/FluxVLA)——不发明新策略,发明接口:配置驱动地把异构组件(数据、VLA/WAM、动作头、reward/advantage-weighted 学习、分布式训练、仿真评测、推理加速、机器人操作器)拼成可复现的 data-to-deployment 工作流;可选 RLinf 集成把兼容的预训练流匹配策略扩到在线 RL 后训练,且保留其原生接口。
它在 RL 谱系里的位置
- C 战线的货架化:论文训练栈原生支持 reward- 或 advantage-weighted 目标(离线 RL 一族的 AWR/IQL 式打法)与世界模型组件;
- B 战线的可选件:RLinf 集成 = 在线 RL 后训练插槽(flow 策略可插拔接入);
- 已支持模型家族:π0、π0.5、GR00T、OpenVLA、SmolVLA、DreamZero、LlavaVLA;分布式 FSDP/DDP + LoRA;评测覆盖 LIBERO / RoboCasa GR-1 / RoboTwin / RoboDojo;推理侧 RTC(实时分块) 多路由 + 加速。
插图逐张(FluxVLA 4 张)
Figure 1:总览——四层栈 + 成绩单
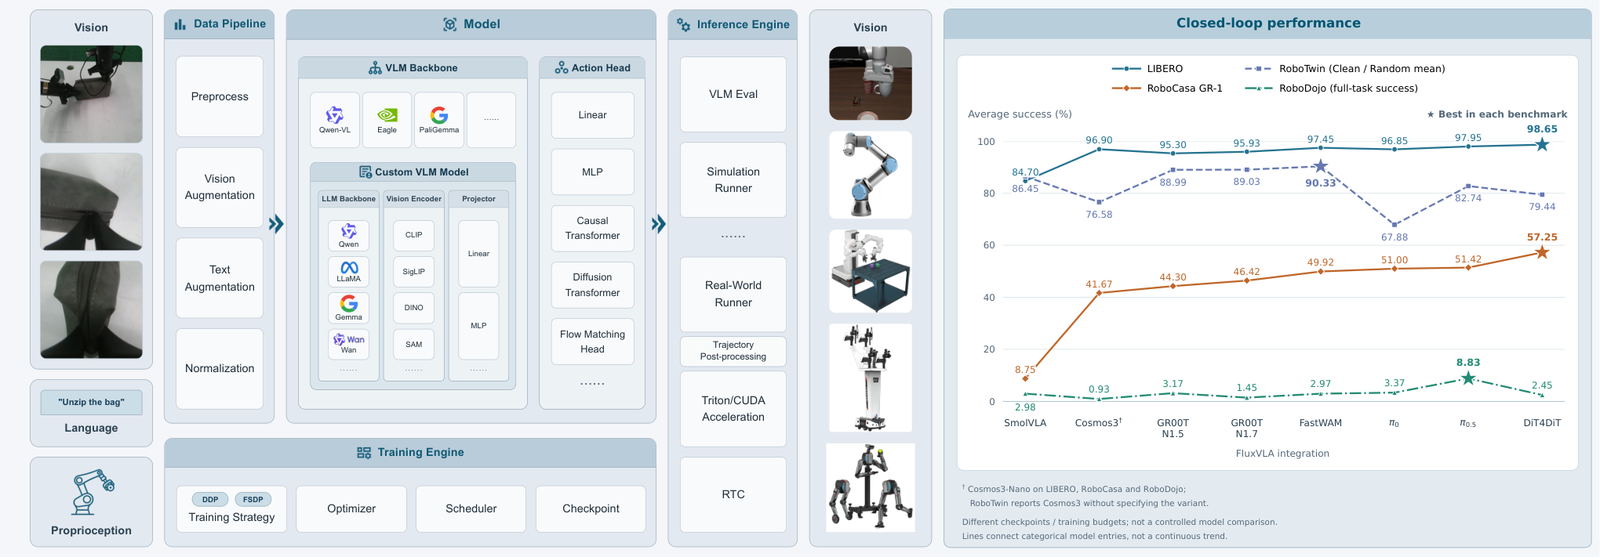
左侧模块化四层栈:数据(data)→ 模型(model)→ 训练(training)→ 推理(inference),各层可替换组件按配置组装;右侧是跨基准平均闭环成功率柱状图(LIBERO 等,含消融/加速后对比)。读图抓手:这是**「算法货架」**——RL 后训练只是 training 层的一个可换件,选型视角一目了然。
Figure 2:配置驱动的数据管线
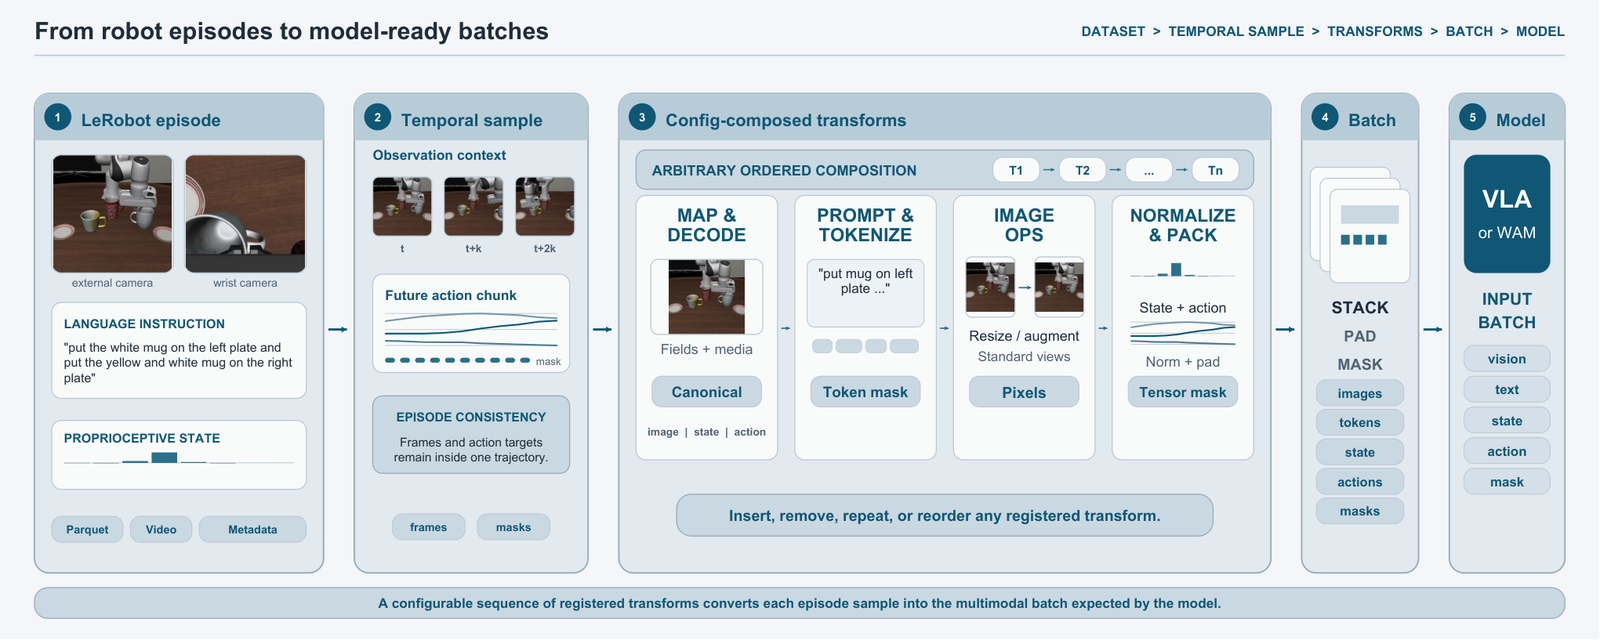
离线轨迹与在线观测共用面向模型的变换与归一化——这一点对 RL 至关重要:在线 RL 采的观测和离线演示必须同一套预处理,否则 off-policy 数据一进训练就漂。含自动数据生成与质量校验入口(配套 FluxMimir 数据工具)。
Figure 3:模型组合——骨干 × 动作头自由拼
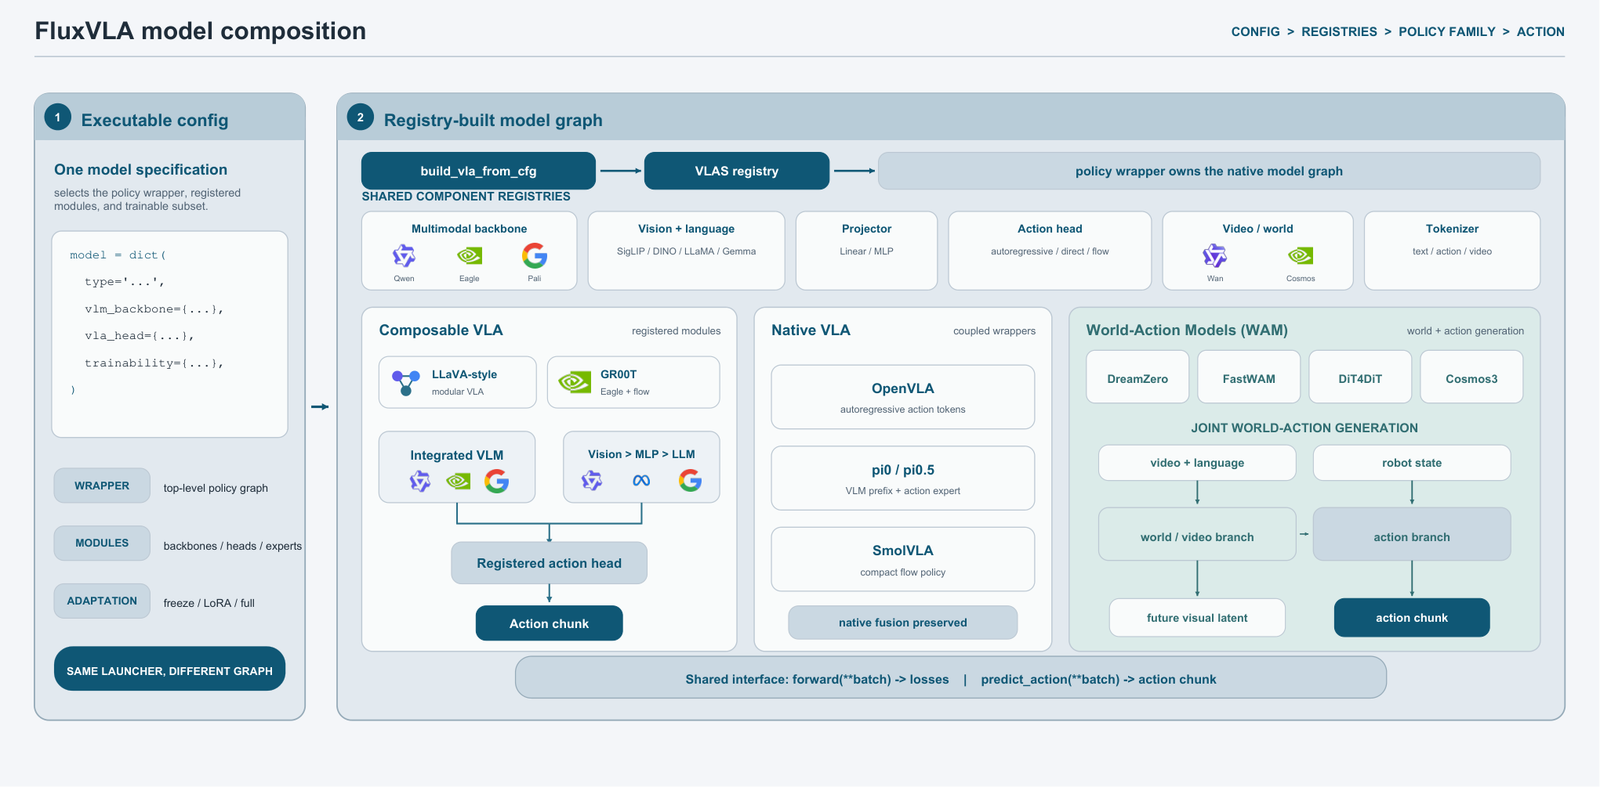
注册的视觉-语言骨干与动作头按兼容性组合,原生 wrapper 兜底各家实现差异(flow-matching 头、自回归头……)。RL 视角:换动作头不用重写 RL 循环——critic/奖励打分挂在统一动作接口上即可(这对 BORA 式 token-动作 RL、一致性策略 RL 都是前提)。
Figure 4:闭环仿真评测
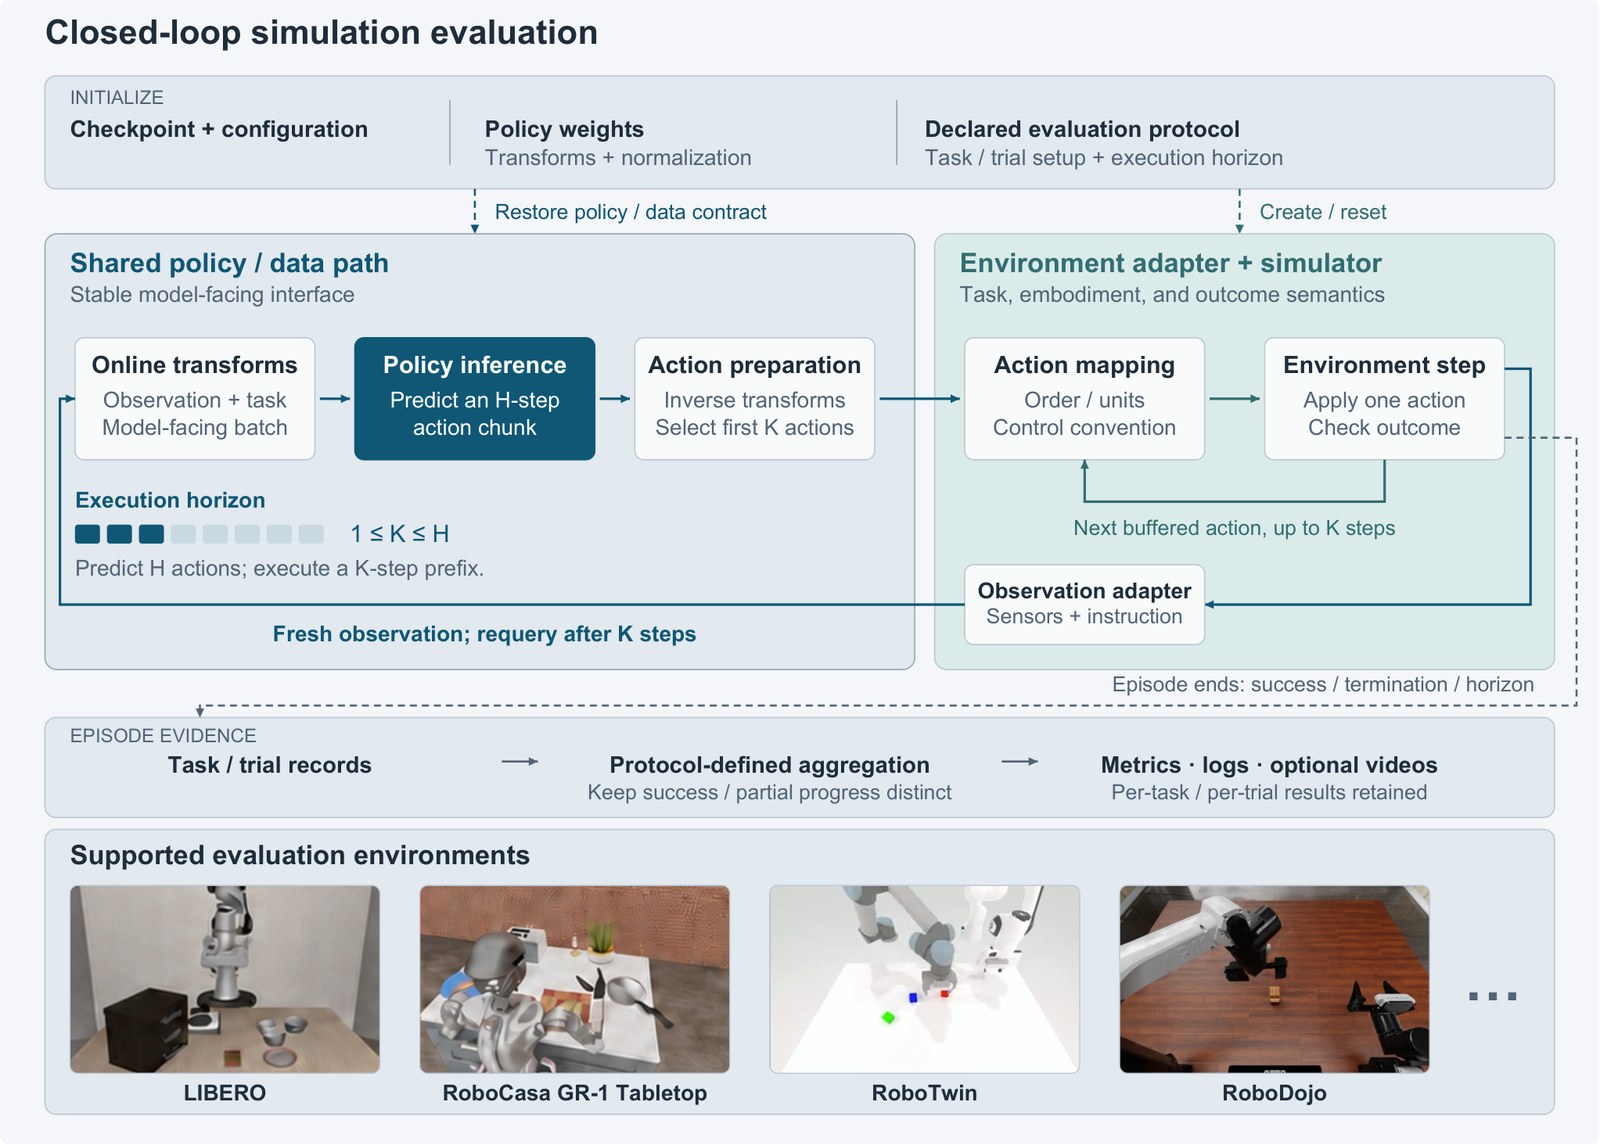
共享的策略推理与数据处理同环境交互解耦:同一个 runner 能对接 LIBERO、RoboTwin、RoboDojo 等 operator——RL 后训练完直接在标准化闭环里验收,评测与训练不脱节。加上 Figure 2/3,构成「训练有 RL、验收有榜」的完整回路(榜单语境见 RoboDojo 精读)。
一句话总结本章:FluxVLA Engine 不生产 RL 算法,它让「reward-weighted / RLinf 在线 RL / 分布式 / RTC 推理 / 多榜评测」都变成改配置就能换的零件——工程栈正是战线 A/B/C 能被反复复现的地基。
📊 方法对比总表:具身 RL 全景速查
| 方法 | 战线 | 在线/离线 | 奖励/打分来源 | 一句话机制 | 出处 |
|---|---|---|---|---|---|
| SONIC | A 底层控制 | 在线(仿真) | 密集运动跟踪奖励 | PPO + 动捕参考,三轴 scaling 出人形基础控制器 | 2511.07820 |
| iRe-VLA | B 在线后训练 | 在线+SFT 交替 | 任务奖励 | RL/SFT 迭代稳住大模型训练 | 2501.16664 |
| VLA-RL | B 在线后训练 | 在线 | 过程奖励模型(VLM) | 轨迹级 RL + 向量化环境;LIBERO 81.0% | 2505.18719 |
| RLDG | C 蒸馏 | 离线(吃 RL 数据) | RL 专家轨迹 | 每任务 RL 专家 → 数据蒸馏通才(+30–50%) | RSS'25 |
| ConRFT | C 混合 | 离线→在线 | 任务奖励 | 一致性策略桥接两段 RFT | RSS'25 |
| RLVLA 研究 | B 实证 | 在线 | PPO/GRPO/DPO | RL 主要涨执行泛化;省显存技巧 | rlvla.github.io |
| Recap/RL Token | C 蒸馏 | 在线(RL 产数) | 吞吐+成功优化 | RL 专家经验带元数据回灌通才(π0.7 靠它) | PI 博客 2025-11 |
| BORA | C 混合 | 离线→在线残差 | critic + 离线 IQL | token-动作离线 RL + 真机只学残差 | 2605.30226 |
| FIND | B 真机自主 | 在线(真机) | 残差离策略 RL + 自评 | 自己找题练;55%→71.9% | 2609.32069 |
| FluxVLA Engine | D 框架 | 配置化 | reward/advantage-weighted + RLinf 插槽 | 一站式 data→deployment | 2609.17210 |
| Isaac Lab / ManiSkill3 | D 仿真底座 | 在线(仿真) | 稀疏任务+ shaping | PPO/SAC 批量训练(见基准篇) | 2410.00425 等 |
💡 综合评析:三个判断 + 三个坑
三个判断
- 「密集奖励可 scaling」与「稀疏奖励要靠模型」正在合流:SONIC 证明密集跟踪奖励能练出基础控制器;VLA 侧则用过程奖励模型/自评给稀疏任务补信号——两边都在把「奖励工程」变成「数据与模型工程」。
- 真机 RL 的出路是减少人:FIND 的可逆任务+自主重置、Recap 的「RL 只当数据厂」、BORA 的「在线只学残差」——都是在绕开人工重置与安全这两个最大成本项。
- 框架层开始收敛:FluxVLA Engine 这类平台把 reward-weighted、在线 RL、分布式、多榜评测做成可插拔件——与 XPolicyLab(评测接口)合起来,RL 后训练的「可复现性」问题正在被系统解决。
三个坑
- 协议不一致的分数不可横比(同是 LIBERO,任务子集/输入视角/episode 数都不同);
- sim RL ≠ 真机能力:仿真奖励塑形在真机常失效——看结果先问战线 A/B/C;
- 在线 RL 的安全与分布漂移未被多数论文充分披露(FIND 的 6 小时统计与人工干预列是好样板)。
❓ 自测 Q&A
Q1:SONIC 和 π*0.6 的 Recap 都叫 RL,差在哪?
SONIC 是底层控制 RL:奖励=跟踪人动作,直接产出可部署控制器;Recap 是任务级优化 + 蒸馏:RL 产出的是数据与专家,最后回灌通才模型。一个练「身体」,一个练「经验」。
Q2:为什么 VLA 不直接从零 RL?
样本效率与安全都不可接受——ConRFT 明确实验说明微调预训练 VLA 远优于从零 RL;通用配方是 SFT 打底再 RL。
Q3:离线 RL 在具身里怎么用?
离线轨迹 + 打分(IQL/AWR 式 advantage-weighted)先吃免费数据(BORA 前半段、FluxVLA 默认能力),需要适应时再上小规模在线或残差段。
Q4:想复现一条真机 RL 线,最短路径?
仿真底座用 Isaac Lab/ManiSkill(PPO/SAC)或 FluxVLA Engine 跑通闭环 → 离线 advantage-weighted 起步 → 有安全重置条件再上 FIND 式自主在线;VLA 主干优先考虑带稳定化设计的(iRe-VLA 交替式)。
Q5:奖励模型(PRM/Judge)靠谱吗?
VLA-RL 用伪标注微调 VLM 做过程奖励拿到 +4.5pp 级收益,但奖励模型误差会直接变成策略漏洞——需配验证器与人工抽检(参考 ABot-AgentOS 三阶段验证思路)。
📊 图表总索引(11 张)
| 章 | 图 | 内容 | 文件 |
|---|---|---|---|
| 1 SONIC | Figure 1(头图) | 通用控制策略与多接口 | 本文插图 |
| 1 SONIC | Figure 2 | 数据/模型/算力三轴缩放定律 | 本文插图 |
| 1 SONIC | Figure 4 | 多模态实时控制 | 本文插图 |
| 1 SONIC | Figure 5 | VLA 驱动 loco-manipulation | 本文插图 |
| 2 FIND | Fig. 1 | 自主练习闭环总览 | 本文插图 |
| 2 FIND | Fig. 2 | 场景/表现感知任务采样 | 本文插图 |
| 2 FIND | Fig. 3 | 55%→71.9% 自我提升曲线 | 本文插图 |
| 3 FluxVLA | Figure 1 | 四层栈总览 + 成绩单 | 本文插图 |
| 3 FluxVLA | Figure 2 | 数据管线(离线在线同归一化) | 本文插图 |
| 3 FluxVLA | Figure 3 | 骨干×动作头组合 | 本文插图 |
| 3 FluxVLA | Figure 4 | 闭环仿真评测 | 本文插图 |
(iRe-VLA/VLA-RL/RLDG/ConRFT/Recap/BORA 以正文与总表覆盖,未嵌图。)
📚 资源与延伸
- 本文三主源:SONIC arXiv 2511.07820(Sci. Robot. 2026,代码 NVlabs/GR00T-WholeBodyControl)· FluxVLA Engine arXiv 2609.17210(github.com/FluxVLA/FluxVLA)· FIND arXiv 2609.32069
- 谱系代表作:iRe-VLA 2501.16664 · VLA-RL 2505.18719 · BORA 2605.30226 · RLDG/ConRFT(RSS 2025)· RLVLA 实证 rlvla.github.io · π*0.6 Recap(PI 博客)
- 同站相关:GR00T-N1.7 精读(动作头与加速)、π0.7 精读(Recap 蒸馏进通才)、具身仿真 Benchmark 全精读(PPO/SAC 底座)、RoboDojo 精读(验收榜)、ABot-AgentOS 精读(LLM-as-Judge 与自进化)
- 知识铺垫:GRPO 强化学习方法详解、PPO 强化学习方法详解、[Scaling Law 与数据策略](/posts/knowledge/Scaling Law与数据策略.md)