📄 论文信息
- 标题:DiffusionDriveV2: Reinforcement Learning-Constrained Truncated Diffusion Modeling in End-to-End Autonomous Driving
- 团队:华中科技大学(hustvl)× 地平线(Horizon Robotics)
- arXiv:2512.07745(Dec 2025)
- 代码:https://github.com/hustvl/DiffusionDriveV2
- 关键词:截断扩散模型、GRPO、强化学习、多模态轨迹规划、端到端自动驾驶
- 一句话总结:用 RL 约束扩散生成的低质量模式,保留高多样性的同时大幅拉升整体轨迹质量下限——这是第一篇直面"多样性 vs 一致性质量"困境并提出完整解法的工作。
🤔 要解决什么问题:扩散规划的多样性-质量两难
扩散规划的困境
DiffusionDrive 通过锚定高斯混合先验(GMM prior)将轨迹空间按驾驶意图分区,成功让扩散模型生成高度多样化的多模态轨迹。但这个成功暴露了一个更深的矛盾:
模仿学习的监督不完备——训练时只优化离专家轨迹最近的正锚点模式,对其余负模式(占采样的绝大多数)没有任何约束。结果是"好的真好,差的真差":Top-1 轨迹质量极高,但大量候选(尤其 Top-5/10)夹杂着碰撞、偏离道路的低质量轨迹。
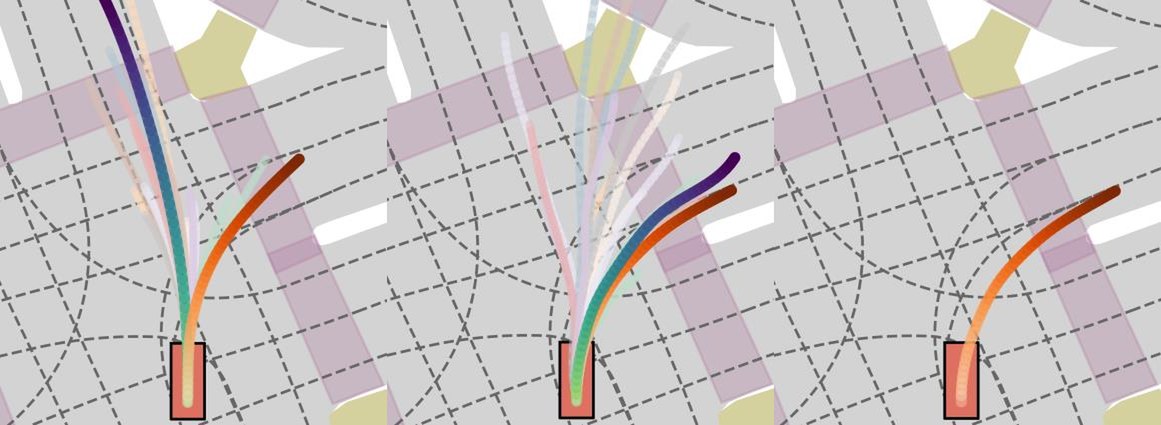
图 1:三种扩散规划范式对比。(a) Vanilla Diffusion 陷入模式崩溃,所有候选归为一条保守轨迹。(b) DiffusionDrive 生成高度多样的候选,但红色圆圈标注了大量碰撞的低质量轨迹。(c) DiffusionDriveV2 用 RL 约束约束所有模式,在保持多模态的同时让每条轨迹都高质量。
为什么这很危险
这迫使系统过度依赖下游选择器(selector/classifier)来筛选低质量候选。但选择器通常参数量远小于生成器,OOD 场景下泛化能力不可靠——低质量轨迹稍有遗漏就是一起事故。
GRPO 的引入契机
DeepSeek-R1 带火的 GRPO(Group Relative Policy Optimization)天然适合解决这个问题:它不依赖价值网络,在组内做相对优势评估,完美适配扩散规划的"每组候选 = 一个组的政策样本"设定。但直接把 GRPO 挪到锚定截断扩散模型上会碰上新问题——不同的锚(如左转 vs 直行)对应不同的驾驶意图,放在同一组里做相对优势比较会引发模式崩溃。
🧠 方法详解
1. 截断扩散生成器回顾
DiffusionDriveV2 继承了 DiffusionDrive 的锚定截断扩散框架。“截断"指扩散去噪过程只执行最后 2 步(而非完整的 100/1000 步),因为锚定高斯混合先验已经提供了良好的初始分布,大量早期去噪步骤变得冗余。每个锚 $\mathbf{a}^k$ 对应一种驾驶意图(变道、转弯、直行),轨迹分布建模为 GMM:
$$p(\tau^k \mid \mathbf{a}^k, z) = \mathcal{N}(\tau^k \mid \mathbf{a}^k + \mu^k(z), \Sigma^k(z))$$其中 $\mu^k(z)$ 和 $\Sigma^k(z)$ 是以场景特征 $z$ 为条件的 MLP 输出,分别预测相对于锚的残差位移和不确定性。场景特征来自稀疏感知骨干(MapTRv2 风格),从多相机图像中提取 BEV 特征和智能体/地图 query。
整体分布为各锚分布的加权和:
$$p(\tau \mid z) = \sum_{k=1}^{N_{\text{anchor}}} s(\mathbf{a}^k \mid z) \, p(\tau^k \mid \mathbf{a}^k, z)$$$s(\mathbf{a}^k \mid z)$ 是一个轻量分类头,输出每个锚的先验权重(anchor scoring),在推理时作为各锚候选的初始排序依据。这个设计使得模型能够根据场景自动选择合适的驾驶意图组合——在直道上直行锚权重大,在交叉口转弯锚权重上升。
模仿学习的根本缺陷:训练时使用标准扩散 loss $\mathcal{L}_{\text{diff}}$,只优化与专家 GT 轨迹最近的锚对应的正模式,其他 $N_{\text{anchor}}-1$ 个负锚模式完全不受监督。这意味着模型在正锚附近生成高质量轨迹,但在负锚附近可以"任意发挥”——包括碰撞、偏离道路等危险行为。
2. 尺度自适应乘性探索噪声(Scale-Adaptive Multiplicative Noise)
RL 微调需要探索——模型必须尝试与模仿学习策略不同的动作才能发现更好的轨迹。标准做法是用 DDPM 的随机采样($\eta = 1$)在去噪过程中注入加性高斯噪声 $\epsilon \sim \mathcal{N}(0, \sigma^2 I)$,但轨迹的近端和远端尺度不一致:前沿 waypoint(如 $t=1$)位移仅几米,而远端 waypoint(如 $t=40$)位移可达数十米。固定方差的加性噪声在近端基本无扰动效果,在远端却产生剧烈抖动,破坏轨迹的几何平滑性。
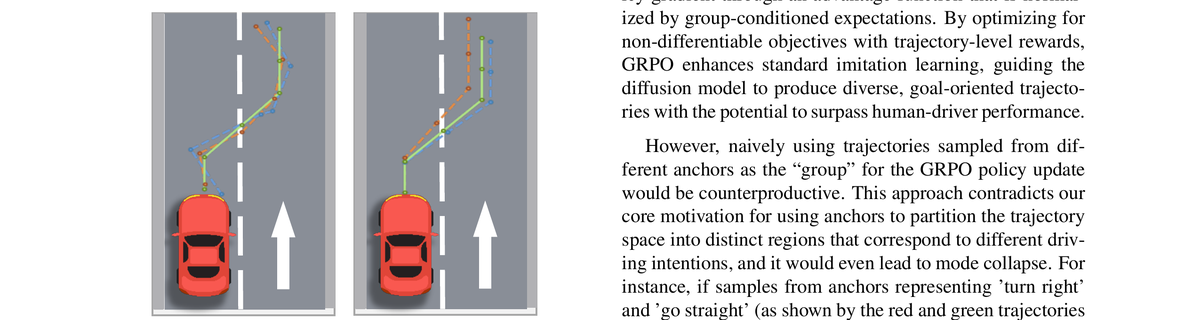
图 3:探索噪声对比。 绿色为原始轨迹。加性高斯噪声(蓝虚线)在近端(前几个 waypoint)几乎看不见扰动,远端(后几个 waypoint)却剧烈摆动——这种不一致源于加性噪声对所有 waypoint 施加相同绝对方差,但轨迹本身各点位移量级差了一个数量级。尺度自适应乘性噪声(红虚线)的扰动幅度与各 waypoint 位移成正比——近端小扰动、远端大扰动但保持几何比例——整条轨迹的几何形状更合理。
乘性噪声对每个 waypoint 施加与位移成比例的扰动:
$$\epsilon_{\text{mult}} = \left\{ \left( \epsilon_{x,n} \cdot \max(|x_n|, \sigma_{\min}),\, \epsilon_{y,n} \cdot \max(|y_n|, \sigma_{\min}) \right) \right\}_{n=1}^{N_f}$$其中 $\sigma_{\min}$ 是防止近端点扰动消失的最小标准差(论文设为 1.0),$\epsilon_{x,n}, \epsilon_{y,n} \sim \mathcal{N}(0, 1)$。对比标准 DDPM 的加性噪声 $\epsilon_{\text{add}} = \{\epsilon_{x,n}, \epsilon_{y,n}\}_{n=1}^{N_f}$,乘性噪声的核心区别在于乘以了位移绝对值 $\max(|x_n|, \sigma_{\min})$,使得每个 waypoint 的噪声方差 $\text{Var}(\epsilon_{\text{mult}, n}) \propto |x_n|^2$ ——近端点噪声小(避免过度扰动初始位置),远端点噪声大(保持足够的探索幅度),且整体轨迹的曲率和平滑性得到天然保持。
3. Intra-Anchor GRPO(锚内 GRPO)
核心洞察:同一锚内的轨迹共享相同的驾驶意图,可以在组内做相对优势比较;不同锚的轨迹不可直接比较(左转 vs 直行没有优劣之分,只是选择不同)。如果强行将所有 $N_{\text{anchor}} \times G$ 条轨迹放在一起做组间比较,模型会倾向于收敛到最常见意图(通常是直行),丧失的多样性恰恰是 DiffusionDrive 最宝贵的特性。
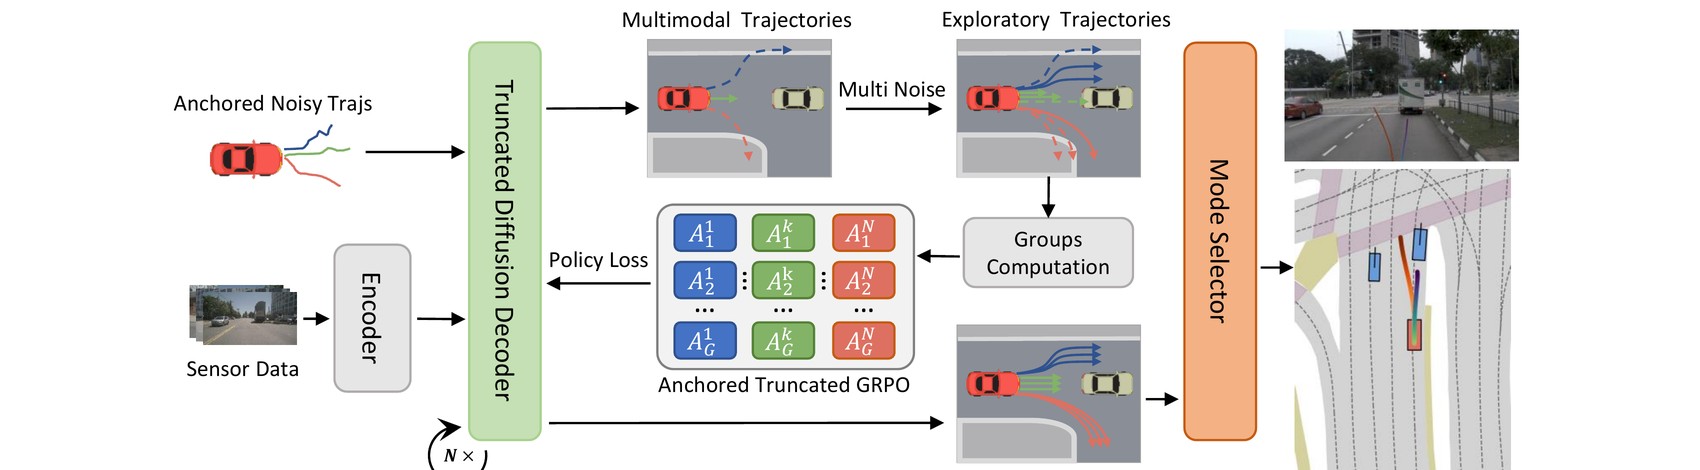
图 2:DiffusionDriveV2 整体架构。 截断扩散解码器在模仿学习约束下生成的轨迹"好坏参半"(好的直行、差的超车/右转)。乘性探索噪声推动模型探索附近的动作空间。Anchored Truncated GRPO 在锚内进行组间优势评估:直行锚内比较各条直行候选,右转锚内比较各条右转候选——绝不跨锚比较。Inter-Anchor Truncation 进一步对碰撞轨迹施以 -1 硬惩罚,对非碰撞负优势截断为 0。最终模式选择器从精修后的全高质量候选集中挑选最优轨迹。
训练流程上,每个锚 $k$ 采样 $G$ 条候选轨迹(论文默认 $G=4$),构成该锚的"策略组"。每条轨迹由 NAVSIM 的 PDM 驾驶分数给出奖励 $r^{k,i}$(闭环指标的综合评分)。对每个锚内部做组内标准化:
$$A^{k,i} = \frac{r^{k,i} - \text{mean}(\{r^{k,1}, \dots, r^{k,G}\})}{\text{std}(\{r^{k,1}, \dots, r^{k,G}\})}$$这等价于在每个锚内独立计算 Z-score,正优势表示该候选在锚内表现优于平均水平,负优势表示低于平均水平。相比于 PPO 依赖价值网络估计优势(需要额外训练 critic 且容易过拟合),这种无参数组内标准化的优势估计更简单稳定——而且天然适配多候选扩散架构。
RL loss 定义为:
$$L_{RL} = -\frac{1}{N_{\text{anchor}}} \sum_{k=1}^{N_{\text{anchor}}} \frac{1}{G} \sum_{i=1}^{G} \frac{1}{T_{\text{trunc}}} \sum_{t=1}^{T_{\text{trunc}}} \gamma_{t-1} \log \pi_\theta(\tau_{t-1}^{k,i} \mid \tau_t^{k,i}) A^{k,i}$$其中 $\log \pi_\theta$ 是截断扩散过程中每一步反向去噪的对数概率,$T_{\text{trunc}}$ 是截断步数(论文设 2),$\gamma$ 是折扣因子(论文设 0.99)。注意 loss 对 $T_{\text{trunc}}$ 步取平均,而不是对所有 100/1000 步——这是截断扩散带来的效率优势:只需对最后两步的反向过程求梯度。
加上模仿学习 loss 做稳定性正则:
$$L = L_{RL} + \lambda L_{IL}$$$\lambda$ 的调度很讲究:当某锚内所有候选都为正优势(即该锚整体表现好)时 $\lambda=0.1$,保留 RL 的主要优化方向;但若某锚全为负优势(该锚整体表现差),$\lambda=1.0$,退化为纯模仿学习——避免 RL 让一个本已糟糕的锚彻底崩坏。
4. Inter-Anchor Truncated GRPO(锚间截断 GRPO)
纯 Intra-Anchor GRPO 有一个隐患:某锚内最好的轨迹可能全局很差(比如在一个全部碰撞的锚里,“最好"的那条仍然撞了),而另一锚内最差的轨迹在全局视角下可能还算安全——但纯局部标准化给不出这个跨锚的安全信号。
解决方法极其优雅:奖励相对改进,只惩罚绝对失败。
$$A_{\text{trunc}}^{k,i} = \begin{cases} -1 & \text{if collision,} \\ \max(0, A^{k,i}) & \text{otherwise.} \end{cases}$$三种情况的具体含义:
- 碰撞轨迹($r^{k,i}$ 中 PDM collision 检测为 True):无论组内排名如何,直接施加 -1 硬惩罚。这确保碰撞永远不会被模型认为是可接受的行为。
- 非碰撞但组内负优势($A^{k,i} < 0$):截断为 0,即既不鼓励也不惩罚。背后的逻辑是:这条轨迹虽然比同锚的其他候选差,但至少没撞,不值得额外惩罚——它只是锚内相对表现不好而已。
- 非碰撞且组内正优势($A^{k,i} > 0$):保留原值,作为 RL 梯度更新的正向信号,鼓励模型朝向更好的轨迹探索。
这个设计的精妙之处在于:碰撞检测是一个绝对的、跨锚可比的安全信号(撞了就是撞了,不论哪个意图),而轨迹质量则是锚内相对的。Inter-Anchor Truncated 将两者结合——碰撞硬约束来自全局安全视角,质量优化保留在局部比较中。论文实验显示,加上 Inter-Anchor Truncated 后 PDMS 从 89.5 提升到 90.1。
5. 模式选择器(Mode Selector)
两阶段粗到细选择器,替代 DiffusionDrive 中简单的单阶段 classifier。第一阶段(粗选)使用 BCE loss 训练的轻量头对所有候选做二分类(可通行 vs 不可通行),过滤掉明显不可行的轨迹。第二阶段(精细评分)对粗选后的候选用 Margin-Rank loss 排序:
$$\mathcal{L}_{\text{rank}} = \frac{1}{N} \sum_{i,j} \max(0, -\text{sign}(s_i - s_j) \cdot (\hat{s}_i - \hat{s}_j) + m)$$其中 $s_i$ 是 PDM 分数(ground-truth 排序标签),$\hat{s}_i$ 是选择器预测分数,$m$ 是边界值(margin)。这个 loss 避免了直接回归连续分数值的困难——让模型只学会比较轨迹的相对质量,而不是精确拟合某个绝对分数。训练时还用 GTRS(Ground-Truth Trajectory Re-sampling)做数据增强:在推理时如果 GT 轨迹不在生成的候选集里,就把 GT 轨迹混入候选一起排序,提升选择器的泛化能力。
消融实验显示,DiffusionDrive 换上 V2 的选择器后 PDMS 从 88.1 提升至 89.1(+1.0),说明选择器改进本身也有贡献,但主要增益(+2.1)来自生成器的 RL 训练。
🏗️ 架构流程总览
推理阶段
| 步骤 | 操作 | 说明 |
|---|---|---|
| ① | 稀疏感知骨干提取场景特征 | 多相机图像 ➜ BEV 特征 + 智能体/地图 query |
| ② | 从 6 个锚中采样初始噪声 | 每个锚对应一种驾驶意图 |
| ③ | 2 步截断去噪 | DDIM 确定性采样($\eta = 0$),生成 6 条候选轨迹 |
| ④ | 模式选择器打分排序 | 粗选 top-k ➜ 精细评分 |
| ⑤ | 输出最优轨迹 | 分数最高的一条下发控制 |
训练阶段
| 阶段 | Loss | 教师信号 | 说明 |
|---|---|---|---|
| Stage 1 (IL 预训练) | $\mathcal{L}_{\text{diff}}$ | 人类专家轨迹 | 继承 DiffusionDrive 预训练权重 |
| Stage 2 (RL 微调) | $L = L_{RL} + \lambda L_{IL}$ | NAVSIM 闭环奖励 | 乘性噪声探索 + Intra-Anchor GRPO + Inter-Anchor Truncated |
| Stage 3 (选择器) | $\mathcal{L}_{\text{BCE}} + \mathcal{L}_{\text{rank}}$ | PDM 分数标签 | 粗到细两阶段,数据增强 + GTRS 词汇采样 |
🖼️ 图片解析
架构与机制
粗体图 1:三种扩散模型对比——从模式崩溃到多样性困境再到 RL 约束的高质量多模态。 左侧 Vanilla Diffusion 的所有候选轨迹挤在一起,完全丧失多样性。中间 DiffusionDrive 虽然锚定到左转、直行、右转等不同意图(用蓝、绿、红线表示),大量轨迹却冲向路肩或与障碍物重叠(红色圆圈标注)。右侧 DiffusionDriveV2 的轨迹不仅保持了多意图覆盖,更在所有候选上都避免了碰撞和偏离道路。注意 V2 的候选轨迹"收束"到安全区域内的程度远超 V1——这正是 RL 约束的作用。
粗体图 2:DiffusionDriveV2 架构全景。 截断扩散解码器在模仿学习约束下生成的轨迹"好坏参半”(好的直行、差的超车/右转)。乘性探索噪声推动模型探索附近的动作空间。Anchored Truncated GRPO 在锚内进行组间优势评估:直行锚内比较各条直行候选,右转锚内比较各条右转候选——绝不跨锚比较。Inter-Anchor Truncation 进一步对碰撞轨迹施以 -1 硬惩罚,对非碰撞负优势截断为 0。最终模式选择器从精修后的全高质量候选集中挑选最优轨迹。
粗体图 3:探索噪声类型对比。 绿色为原始轨迹,蓝色虚线为加性噪声扰动后的轨迹,红色虚线为乘性噪声扰动后的轨迹。加性噪声在各 waypoint 施加固定方差的扰动,导致远端 waypoint(位移大)的抖动在视觉上比近端 waypoint(位移小)剧烈得多——这是尺度不一致的体现。乘性噪声使扰动幅度与位移成正比,在整体轨迹几何上保持一致的相对扰动,生成更合理的探索轨迹。
定性结果
下图展示了 Vanilla Diffusion(上)、DiffusionDrive(中)、DiffusionDriveV2(下)在 NAVSIM navtest 上的定性对比。每种方法生成 20 条候选轨迹(浅色),突出显示 Top-1(深色实线)和 Top-10(深色虚线)。
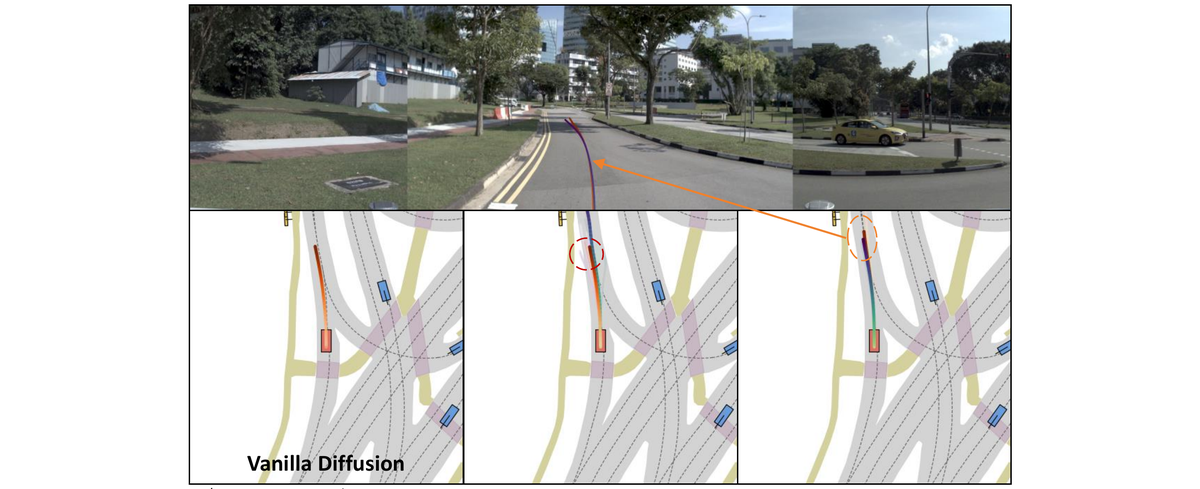
粗体图 4(a):直行场景 1。 Vanilla Diffusion 所有候选几乎重合,只能输出一条"无聊"的直行轨迹。DiffusionDrive 候选覆盖很宽,但出现了大量向左偏离车道的碰撞轨迹(红圈)。DiffusionDriveV2 的候选全部集中在车道内,Top-1 和 Top-10 都保持安全和高效。
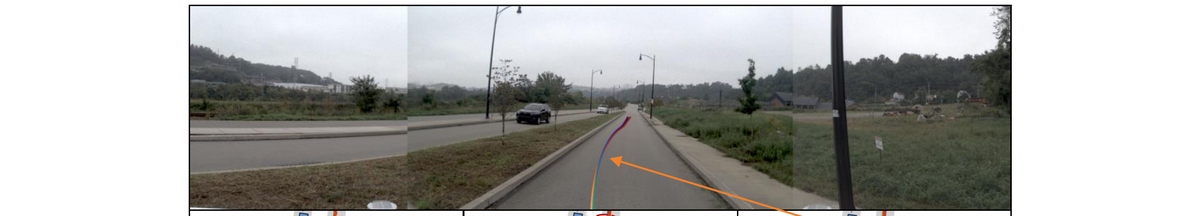
粗体图 4(b):直行场景 2。 DiffusionDrive 的 Top-1 轨迹表现良好,但 Top-10 和一些候选出现了显著偏移;V2 的所有候选都紧密贴合本车道,体现了 RL 约束对全体模式的提升效果。
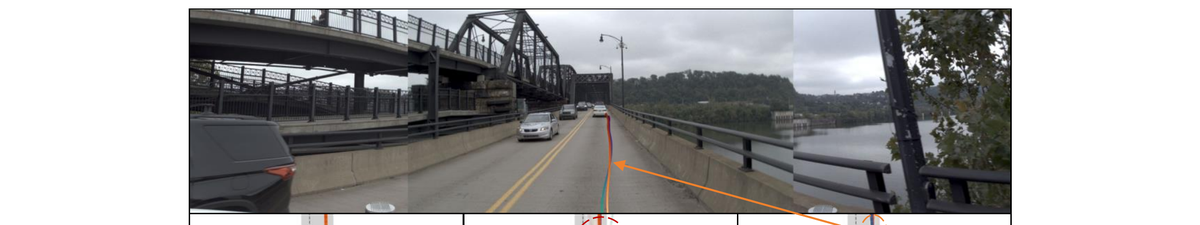
粗体图 5:直行场景 3。 这是更具挑战性的弯道直行场景。DiffusionDrive 的轨迹分散且部分冲出道路边界。DiffusionDriveV2 的候选轨迹均保持在高概率区域,展示了更好的道路自适应能力。
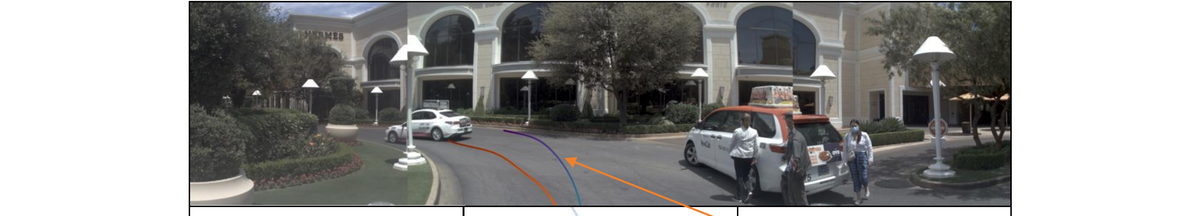
粗体图 6(a):转弯场景 1。 交叉口右转场景。Vanilla Diffusion 再次崩溃到单条轨迹。DiffusionDrive 虽然 Top-1 勉强完成了右转,但 Top-10 轨迹出现"转弯过迟"从而导致碰撞。V2 的候选轨迹全部平滑完成右转,且没有碰撞风险。
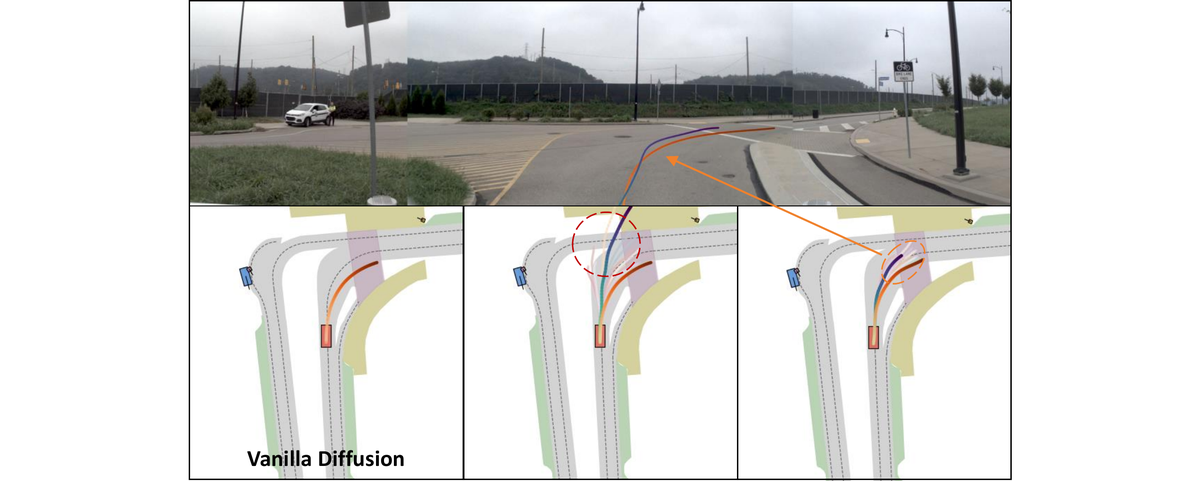
粗体图 7(a):转弯场景 2——弯道超车。 这是证明 V2 多样性保持能力的绝佳示例:Top-1 轨迹选择了保守跟车(缓弯),Top-10 轨迹选择了激进的弯道超车——两者都安全且高质量。这说明 RL 约束并没有抹杀多样性,只是抬高了质量底线。
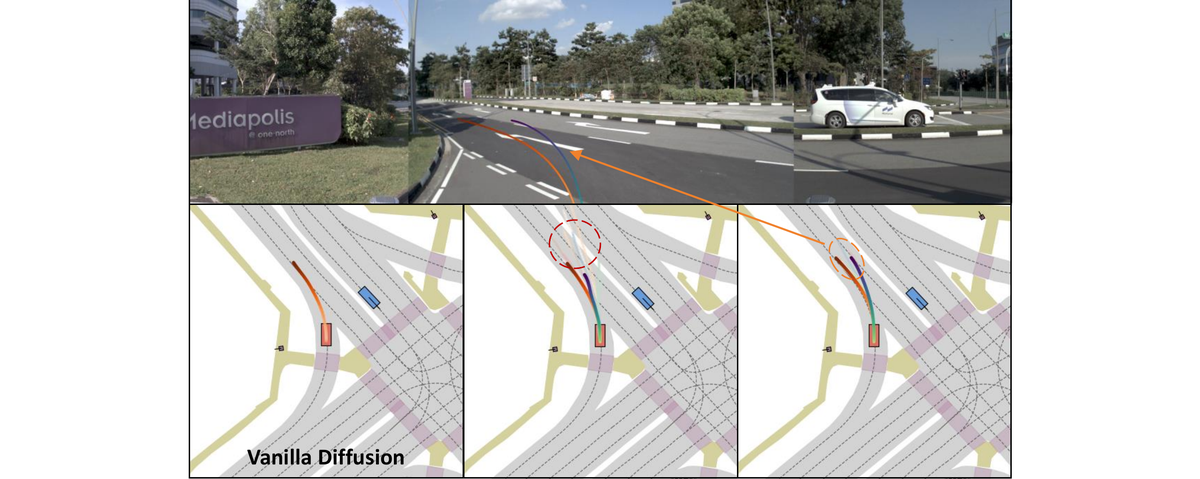
粗体图 7(b):转弯场景 3。 另一个交叉口场景。V2 再次在所有候选上保持安全,而 DiffusionDrive 仍有候选冲出路沿。
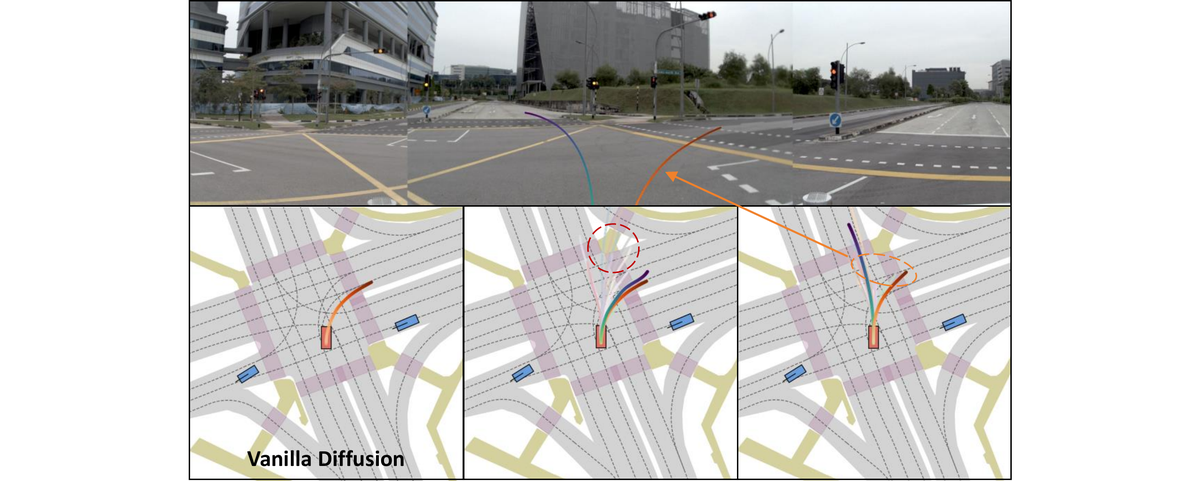
粗体图 8(a):多模态场景 1——交叉口选道。 在此场景中,车辆可以直行也可以右转(多模态选择)。Vanilla Diffusion 无法给出这两种选择。DiffusionDrive 提供了直行和右转两种轨迹,但右转候选中有碰撞风险。V2 同样提供两种意图,且所有候选都保持安全。
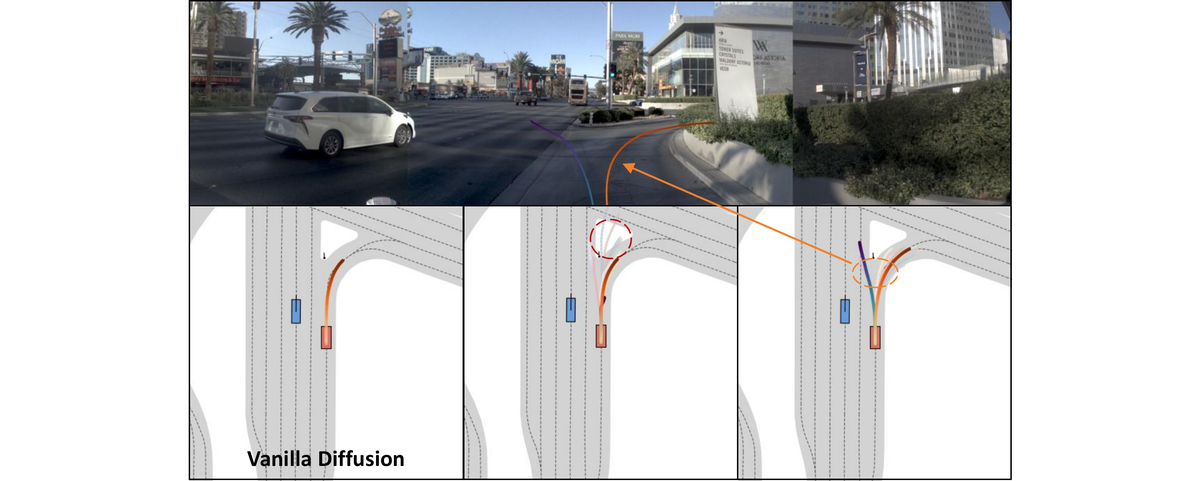
粗体图 8(b):多模态场景 2。 另一个复杂的交叉口场景。V2 的左转和直行候选都严格遵守车道和路权,展示了在真正多模态场景下同时保持多样性和高质量的能力。
🔬 实验与结果
NAVSIM v1 主结果
| Method | Backbone | PDMS $\uparrow$ |
|---|---|---|
| VADv2 | ResNet-34 | 80.9 |
| UniAD | ResNet-34 | 83.4 |
| Transfuser | ResNet-34 | 84.0 |
| PARA-Drive | ResNet-34 | 84.0 |
| DRAMA | ResNet-34 | 85.5 |
| GoalFlow* | ResNet-34 | 85.7 |
| Hydra-MDP* | ResNet-34 | 86.5 |
| Hydra-MDP++* | ResNet-34 | 86.6 |
| ARTEMIS | ResNet-34 | 87.0 |
| DiffusionDrive | ResNet-34 | 88.1 |
| WoTE | ResNet-34 | 88.3 |
| DIVER | ResNet-34 | 88.3 |
| DriveSuprim | ResNet-34 | 89.9 |
| DiffusionDriveV2 (Ours) | ResNet-34 | 91.2 |
*带 * 为官方分数(与其原 backbone 一致)。
NAVSIM v2 主结果
| Method | Backbone | EPDMS $\uparrow$ |
|---|---|---|
| Ego Status MLP | ResNet-34 | 64.0 |
| Transfuser | ResNet-34 | 76.7 |
| Hydra-MDP++ | ResNet-34 | 81.4 |
| DriveSuprim | ResNet-34 | 83.1 |
| ARTEMIS | ResNet-34 | 83.1 |
| DiffusionDriveV2 (Ours) | ResNet-34 | 85.5 |
多样性与质量权衡
| Method | $Div.$ $\uparrow$ | PDMS@1 $\uparrow$ | PDMS@5 $\uparrow$ | PDMS@10 $\uparrow$ |
|---|---|---|---|---|
| Transfuser$_{\text{TD}}$ | 0.1 | 85.7 | 85.7 | 85.7 |
| DiffusionDrive | 42.3 | 93.5 | 84.3 | 75.3 |
| DiffusionDriveV2 | 30.3 | 94.9 | 91.1 | 84.4 |
关键发现:DiffusionDrive 多样性极高(42.3),但 Top-10 PDMS 暴跌到 75.3(大量低质量候选拉低均值)。DiffusionDriveV2 多样性适中(30.3),但 Top-1 和 Top-10 的差距极小(94.9 → 84.4),说明 RL 约束成功抬升了整体的质量下限。
消融实验
| 消融项 | Variant | PDMS $\uparrow$ |
|---|---|---|
| 探索噪声类型 | 加性 | 89.7 |
| 探索噪声类型 | 乘性 | 90.1 |
| Intra-Anchor GRPO | ✗ | 89.2 |
| Intra-Anchor GRPO | ✓ | 90.1 |
| Inter-Anchor Truncated | ✗ | 89.5 |
| Inter-Anchor Truncated | ✓ | 90.1 |
方法对比总览
| 方法 | 生成方式 | 多样性 | 质量一致性 | RL 训练 | 锚定机制 | NAVSIM v1 (PDMS) |
|---|---|---|---|---|---|---|
| DiffusionDrive | 截断扩散 | 高 | 低 | ✗ | ✓ | 88.1 |
| DIVER | 标准扩散 | 中 | 中 | GRPO | ✗ | 88.3 |
| Hydra-MDP | 词表采样 | 中 | 中 | ✗ | ✓ | 86.5 |
| DriveSuprim | 词表采样 + score | 低 | 高 | ✗ | ✓ | 89.9 |
| GoalFlow | Flow Matching | 低 | 高 | ✗ | ✗ | 85.7 |
| DiffusionDriveV2 | 截断扩散 + RL | 高 | 高 | Intra/Inter GRPO | ✓ | 91.2 |
💡 个人思考
1. “多样性 vs 质量"是一个被长期低估的自动驾驶规划核心矛盾。 DiffusionDrive 展示了多模态扩散规划的潜力,但也暴露了模仿学习的根本局限:它只保证"正模式"拟合得好,对"负模式"毫无约束。V2 的工作提醒我们,在多候选规划框架中,候选集的整体质量比 Top-1 质量更重要——因为下游选择器总会犯错,如果候选集里全是"好"轨迹,选错也不至于差到哪里去;反之如果候选是"好+差"混杂,选错一次就是事故。
2. Intra-Anchor GRPO 是"锚定架构 + GRPO"天作之合的完美体现。 不同驾驶意图(左转、直行、右转)的轨迹之间做优势比较就像比较苹果和橘子——没有意义且会破坏多样性。在锚内部做 GRPO 既保留了锚定机制意图分区的好处,又引入了组内相对优势的 RL 信号,两者完美互补。这是对 GRPO 在非 LLM 领域最聪明的适配之一。
3. Inter-Anchor Truncated 的思路值得在其他 RL 场景推广。 “奖励相对改进,只惩罚绝对失败”——这个简单规则解决了锚间比较的困局,本质上是一种全局安全硬约束 + 局部相对优化的混合范式。很多多智能体/多任务 RL 场景中,不同任务之间也有类似"不可直接比较但需要全局安全线"的需求。
4. 乘性噪声的设计体现工程直觉。 轨迹的近端和远端位移尺度差了一个数量级,加性噪声要么近了噪声太小、要么远了噪声太暴力。乘性噪声让扰动幅度与位移成比例,这种"各向异性尺度自适应"的设计在 trajectory-level 的 RL 探索中近乎标准——每个 waypoint 的噪声方差正比于其长度,天然保持几何结构。
5. 两阶段训练(IL → RL)是生成式驾驶规划的黄金范式。 DiffusionDriveV2 先用模仿学习获得基本能力(冷启动),再用 RL 在闭环奖励上微调提升。这种"先学得像,再学得好"的路线和 LLM 的 SFT → RLHF 如出一辙。可以预见,未来绝大多数端到端规划器都会走这个路线。
6. 给未来工作的清晰路标。 V2 证明了 RL 可以解决扩散规划的核心矛盾,但依赖 NAVSIM 的 PDM 分数做奖励。更强大的奖励模型(如基于世界模型的 reward model)和探索策略(如纳入交通参与者交互的联合探索)是下一个层次的问题。此外,把这套框架搬到真车上需要解决奖励设计的安全泛化——仿真里的"完美安全"在真实世界中可能并不完美。
一点质疑:论文在表 9 中展示了 DiffusionDrive 换上 V2 的选择器后 PDMS 从 88.1 升至 89.1(+1.0),而 V2 比 V1 高 3.1 PDMS。作者以此论证增益主要来自生成器的 RL 改进而非选择器提升。这个结论基本站得住,但值得注意:选择器的 1.0 提升是在 V1 生成器上测的,V2 生成器产生的轨迹质量更高、分布与 V1 不同,选择器在 V2 上的实际增益可能也不同。一个更严格的消融应该是把 V2 的选择器换成 V1 的 classifier,看掉多少分——虽然推测掉分幅度不会很大。
📖 这是论文精读系列的第 40 篇。扩散规划 + 强化学习的结合正在成为端到端驾驶的新范式,你怎么看这个方向?欢迎留言讨论。