论文信息
- 标题:VADv2: End-to-End Vectorized Autonomous Driving via Probabilistic Planning
- 作者机构:华中科技大学(HUST) × 地平线机器人(Horizon Robotics)(Bo Jiang, Shaoyu Chen, Hao Gao, Bencheng Liao, Qian Zhang, Wenyu Liu, Xinggang Wang)
- arXiv:2402.13243(ICLR 2026)
- 代码:github.com/hustvl/VAD
- 一句话总结:把驾驶规划从"我猜唯一最优动作"改成"我算所有动作的概率分布再采样",用规划词表(4096 条轨迹)离散化连续动作空间,用概率场函数学习场景与动作的关联,在 CARLA Town05 跑出 85.1 DS,比 DriveMLM 高 9.0,而且只用相机、不用规则后处理。
要解决什么问题:规划的不确定性被忽视了
端到端自动驾驶已经证明"从大量人类驾驶数据中模仿学习"是可行的路线。但 VADv2 抓到了一个被忽视的根本问题:驾驶规划本质上是高度不确定的。
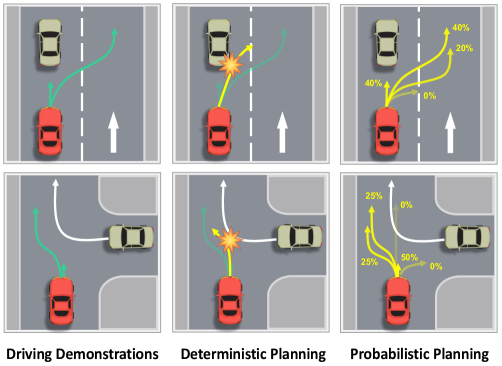
图 1:驾驶规划的不确定性。 左图:跟车时,人类司机的合理操作包括保持车道、变道超车、减速让行,多条轨迹都合理;右图:对向来车时,让行或加速超越都是可行选择。确定性回归模型会取"均值"——输出一条哪里都不靠的危险轨迹。VADv2 不再强制回归单一路径,而是学习整个动作空间的概率分布。
作者举了两个直观的场景:
| 场景 | 人类司机的合理选择 | 核心问题 |
|---|---|---|
| 跟车时 | 继续跟、变道超车、减速让行 | 多个动作都合理,没有唯一正确答案 |
| 对面来车 | 减速让行、加速抢道 | 取决于无数隐变量,无法精确建模 |
现有的学习方法(VAD、UniAD、ThinkTwice、Diffusion Planner 等)全都在做一件事:确定性回归——给一个场景,直接回归出一条轨迹或一组控制信号。这隐含地假设了"场景到动作"存在确定性的映射关系,但实际情况完全不是这样。当可行解空间是非凸的(比如多条合理轨迹在空间上不相邻),确定性回归会"取中间值",输出一个哪里都不靠的危险动作——作者把这个叫做 “regression to the mean” 问题。
这个痛点和 LLM 面临的挑战是类似的——给定上文,下一个词也不是唯一的。但 LLM 的做法是学一个条件概率分布 \(p(\text{next\_word} \mid \text{context})\),然后采样。VADv2 的核心洞察就是把 LLM 这套哲学搬到驾驶规划里:不猜唯一答案,而算概率分布。
核心思想:概率规划(Probabilistic Planning)
VADv2 的核心主张:
把规划建模为场景条件随机过程 \(p(\bm{a} \mid \bm{o})\),其中 \(\bm{o}\) 是观测,\(\bm{a}\) 是候选动作。学分布,而不是直接回归动作值。
这个转变带来三个关键好处:
| 优势 | 解释 |
|---|---|
| 天然处理非凸解空间 | 分布可以呈现多峰,每条合理轨迹都可以有高概率,不需要被迫取舍 |
| 更丰富的监督信号 | 确定性回归只监督最优动作;概率规划给每个候选动作都提供监督 |
| 推理灵活 | 输出整个动作空间的分布,可灵活结合规则或优化方法做后处理筛选 |
实现的技术难点是:如何在一个高维连续时空里高效地表达和计算这个概率分布?
VADv2 的答案:离散化动作空间 → 规划词表 → 概率场函数 → Transformer 打分 → softmax/sigmoid 归一化 → 采样。
整体架构
VADv2 的整体框架如下:
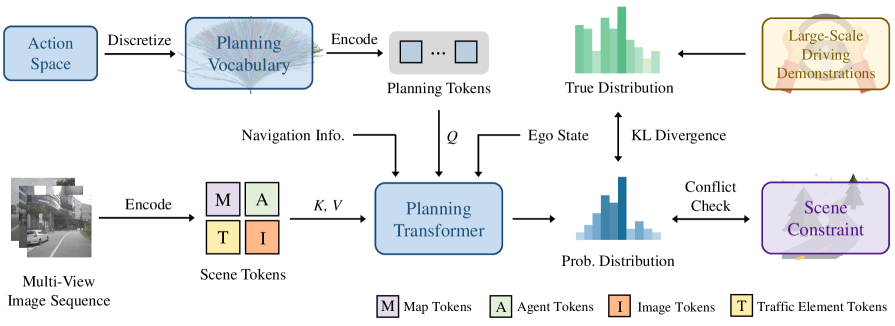
图 2:VADv2 整体架构。 输入为多视图图像序列(Streaming 方式),经过场景编码器提取实例级 token(地图 token、智能体 token、交通元素 token、图像 token),与规划词表的规划 token 通过 Transformer Decoder 做交叉注意力交互,输出每个动作的概率值,采样最高分动作后用 PID 控制器转为控制信号。大规模驾驶演示数据 + 场景约束共同监督概率分布。
整条数据流可以拆成四大步:
- 场景编码:多视图图像 → BEVFormer → BEV 特征 → MapTR 提取向量化地图 + Agent Query 检测追踪 + 交通信号编码 → 场景 token 序列
- 规划词表构建:从训练集轨迹中 FPS 采样 4096 条代表性轨迹 → 可学习 embedding → 规划 token 序列
- 概率场计算:规划 token 作为 query,场景 token 作为 key/value,在 Transformer Decoder 中交叉注意力交互 → 每个规划 token 得到一个概率值 → softmax 归一化为分布
- 采样与控制:从分布中采样一条轨迹 → PID 控制器映射为方向盘、油门、刹车
下面逐块详细拆解。
方法详解
一、场景编码器(Scene Encoder)
VADv2 的场景编码器把传感器数据转换成实例级 token 嵌入 \(E_{\text{scene}} \in \mathbb{R}^{M \times D}\),其中 M 是场景 token 数量,D=256 是特征维度。它包含四种 token:
1. BEV 编码器
先用 BEVFormer 把多视图图像特征从透视图(perspective view)转换为鸟瞰图(BEV),得到 BEV 空间中的特征图。这个特征图是后续所有实例级 token 学习的基础。
2. 地图 Token(Map Tokens)
一组 MapTRv2 风格的 query 从 BEV 特征图中学习向量化地图元素,包括:
- 车道中心线(lane centerlines)
- 车道分隔线(lane dividers)
- 道路边界(road boundaries)
- 人行横道(pedestrian crossings)
每个地图元素被编码为一个 token,显式表达了道路拓扑结构。
3. 智能体 Token(Agent Tokens)
一组 agent query(继承自 VAD)检测并追踪周围的交通参与者,输出:
- 3D 位置、朝向、尺寸
- 速度
- 未来轨迹预测
- 类别(车辆、行人、自行车等)
每个智能体被编码为一个 token,包含运动和语义信息。
4. 交通元素 Token(Traffic Element Tokens)
交通信号在规划中至关重要。在 CARLA 中考虑两类:
- 交通灯:编码前视图图像特征 → MLP 预测交通灯状态(黄/红/绿)以及该灯是否影响自车
- 停止标志:预测停止标志区域与自车的重叠情况
5. 图像 Token(Image Tokens)
除了以上实例级 token,前视图图像特征还被保留为图像 token,提供更稠密的场景特征,补足实例级 token 可能遗漏的细节信息。
此外,导航信息(路线指引)和自车状态(速度、加速度等)也通过 MLP 编码为嵌入向量 \(E_{\text{navi}}, E_{\text{state}}\)。
关键认知:场景编码器的核心是把稀疏的传感器数据压缩成紧凑的高维语义 token。地图、agent、交通元素 token 各自有独立的监督信号,确保它们显式编码了对应的高层信息。这和 VAD 的向量化范式一脉相承,但 VADv2 新增了图像 token 和交通元素 token,场景表达能力更强。
二、概率规划(Probabilistic Planning)
这是 VADv2 最核心的创新。整个模块解决一个问题:给定场景 token,怎么算出每个候选动作的概率?
2.1 问题形式化
将规划策略建模为场景条件随机过程:
\[ p(\bm{a} \mid \bm{o}), \quad \bm{o} = (E_{\text{scene}}, E_{\text{navi}}, E_{\text{state}}), \quad \bm{a} = (x_1, y_1, x_2, y_2, \dots, x_T, y_T) \]T=6 是轨迹 waypoint 数量(3 秒,间隔 0.5 秒),每个 waypoint 是自车在 BEV 空间中的 (x, y) 坐标。
2.2 规划词表构建(Planning Vocabulary)
连续动作空间没法直接算概率分布——那就离散化。VADv2 的做法:
- 收集:从所有训练集的人类驾驶轨迹中提取动作集合 S。每个动作是一条 3 秒的完整轨迹(6 个 waypoint)。
- 最远点采样(Farthest Point Sampling, FPS):从 S 中选出 N 条最具多样性的轨迹作为规划词表 V。
- 词表大小:默认 N = 4096(消融实验表明这是最佳平衡点)。
- 物理可行性:每条轨迹来自真实驾驶数据,天然满足车辆运动学约束,不需要后处理修正。
最远点采样(Farthest Point Sampling, FPS) 是一种贪心多样性最大化算法:每次从剩余候选中挑出离已选集合最远的点加入,保证选出的子集在整个空间上均匀覆盖。与 k-means 这类密度自适应方法不同,FPS 不受数据分布偏态影响——即使在直行轨迹占 90% 的数据中,它也会优先保留稀有的转弯/变道样本。
FPS 的算法流程(Algorithm 1):
输入:动作集合 S,词表大小 N
输出:规划词表 V = {a¹, a², ..., a^N}

1. 从 S 中随机选一条轨迹 a¹,加入 V
2. for i = 2 to N:
     a. 对 S \ V 中的每条轨迹 s,计算它到 V 中所有轨迹的最小 L2 距离
        d(s) = min_{v∈V} ||s - v||₂
     b. 选出 d(s) 最大的轨迹 aⁱ = argmax d(s)
     c. 把 aⁱ 加入 V
3. return V
为什么用 FPS 而不是 k-means?因为驾驶轨迹分布天然不均匀——直行轨迹占绝大多数,k-means 聚类会浪费大量词表容量在细微的直行变体上,而转弯、变道等关键动作反而得不到足够的表征。FPS 保证了词表在整个动作空间上均匀覆盖。
与 MotionLM 那种单步离散化(每步拆成纵向+横向)不同,VADv2 的每个词条是一条完整的轨迹序列,避免了迭代 rollout 带来的误差累积。同时,词表本身就是一组物理可行的运动基元,采样出来的轨迹不需要后处理修正。
2.3 规划 Token 化(Tokenization)
每个词表中的轨迹 \(a\) 被编码成高维嵌入 \(E(a)\)。关键技巧:坐标编码函数。
VADv2 采用类似 NeRF 的位置编码策略,把连续的 (x, y) 坐标映射到高维空间:
\[ E(a) = \left( \Gamma(x_i), \Gamma(y_i) \right)_{i=1}^{T} \]\[ \Gamma(pos) = \left( \gamma(pos, j) \right)_{j=0}^{L-1} \]\[ \gamma(pos, j) = \left( \cos(\frac{pos}{10000^{2\pi j / L}}), \sin(\frac{pos}{10000^{2\pi j / L}}) \right) \]\(\Gamma\) 把每个坐标从 \(\mathbb{R}\) 映射到 \(\mathbb{R}^{2L}\),让模型能近似更高频的场函数。这和 NeRF 中 positional encoding 的原理一样——高频编码让网络更容易学习高频变化的函数,而驾驶轨迹恰好需要在不同场景下有精细的分布差异。
直观理解:两个相似的轨迹(比如直行但速度略有不同)在原始坐标空间里距离很近,编码后在嵌入空间中保留距离关系的同时,还引入了周期性模式,让 Transformer 能更精细地区分它们。
每个词条有一个可学习的 token embedding,与位置编码叠加后作为 Transformer Decoder 中的 query。
2.4 概率场函数(Probabilistic Field Function)
VADv2 假设概率 \(p(a)\) 关于 \(a\) 是连续的,且对微小扰动不敏感。受 NeRF 启发——NeRF 在 5D 空间(3D 位置 + 2D 视角方向)上建模连续辐射场——VADv2 在动作空间上建模连续概率场。
具体实现是一个级联的 Transformer Decoder:
\[ p(a) = \sigma\left( \text{MLP}\left( \phi(E(a), E_{\text{scene}}) + E_{\text{navi}} + E_{\text{state}} \right) \right) \]- \(\phi\):Transformer Decoder,\(E(a)\) 作为 query,\(E_{\text{scene}}\) 作为 key/value
- 交叉注意力输出的特征 + 导航嵌入 + 自车状态嵌入 → MLP → sigmoid 输出概率
- \(\sigma\) 是 sigmoid 函数,输出 (0,1) 之间的概率值
所有嵌入维度统一为 D=256。整个计算过程可以用下图总结:
规划词表 V ─→ 坐标编码 Γ ─→ E(a) (query) ─┐
                                            ├→ Transformer Decoder φ → MLP → sigmoid → p(a)
场景 token E_scene (key/value) ────────────┘
                                            ↑
导航 E_navi + 自车状态 E_state ──────────────┘
关键认知:这里没有用 softmax,而是用 sigmoid——每个动作的概率是独立计算的(multi-label 而非 multi-class)。这很重要,因为动作空间不是互斥的——多个合理动作都可以有高概率。用 sigmoid 允许分布呈现任意形状,不受"概率和为 1"的约束(实际上 VADv2 在损失函数中用了 KL 散度 + 交叉熵来归一化分布)。
三、训练(Training)
VADv2 的训练损失包含三个部分:
\[ \mathcal{L} = \mathcal{L}_{\text{distribution}} + \mathcal{L}_{\text{conflict}} + \mathcal{L}_{\text{token}} \]3.1 分布损失(Distribution Loss)
从大规模驾驶演示中学习概率分布。用 KL 散度最小化预测分布和数据分布的差异:
\[ \mathcal{L}_{\text{distribution}} = D_{\text{KL}}(p_{\text{data}} \parallel p_{\text{pred}}) = \sum_{a \in V} p_{\text{data}}(a) \cdot \log \frac{p_{\text{data}}(a)}{p_{\text{pred}}(a)} \]\(p_{\text{data}}(a)\) 通过演示数据中每个动作的出现频率估算。具体做法:
- 对每一帧演示数据,从规划词表中选出与 ground-truth 轨迹 L2 距离最小的词条(最佳匹配)
- 该词条标签为 1,其余为 0
- 对所有帧统计每个词条成为最佳匹配的频率 → \(p_{\text{data}}(a)\)
由于 \(p_{\text{data}}(a)\) 固定,\(\sum p_{\text{data}}(a) \log p_{\text{data}}(a)\) 是常数,最小化 KL 等价于优化交叉熵损失:
\[ \mathcal{L}_{\text{distribution}} = -\sum_{a \in V} p_{\text{data}}(a) \cdot \log p_{\text{pred}}(a) \]这与 LLM 的标准做法完全一致——ground-truth token 标签为 1,其他为 0,用交叉熵监督。
3.2 冲突损失(Conflict Loss)
场景约束帮助模型学习重要的驾驶先验知识。如果一个动作与以下情况冲突,该动作被标记为负样本,其概率被压低:
- 与其他智能体的 ground-truth 未来运动轨迹冲突(碰撞)
- 偏离道路边界
\(\mathbb{1}_{\text{conflict}}(a)\) 是指示函数——冲突时为 1,否则为 0。这个损失确保模型不仅模仿人类行为,还学会避免不安全的动作。
3.3 场景 Token 损失(Scene Token Loss)
地图、agent 和交通元素 token 各自有独立的监督信号:
- 地图 token(MapTRv2):L1 回归损失(地图点坐标)+ Focal 分类损失
- Agent token(VAD):L1 回归损失(位置/朝向/尺寸)+ Focal 分类损失 + minFDE 轨迹回归损失 + 多模态轨迹分类损失
- 交通元素 token:Focal 损失(交通灯状态 + 停止标志重叠预测)
四、推理(Inference)
VADv2 的推理有两种模式:
纯神经网络模式(端到端)
在闭环测试中的标准做法:
- 每时间步从前视图图像序列中提取场景 token
- 用 Transformer Decoder 计算 4096 个动作的概率
- 选择概率最高的动作(top-1 采样)
- 用 PID 控制器将轨迹转换为控制信号(steer, throttle, brake)
- 完全不需要规则后处理——这是 VADv2 的重要亮点
混合模式(实际部署)
在真实世界应用中的推荐做法:
- 采样 top-K 动作作为候选提案
- 用规则wrapper过滤掉不安全提案
- 用优化后处理器做细粒度轨迹微调
- 概率值可以作为置信度——低概率时切换回传统规则方法(human takeover)
混合模式展示了概率规划的一个被低估的优势:模型自带"自知之明"。如果某个场景下分布特别均匀(熵很高),模型就知道"我不确定该怎么开",可以请求人类接管。这是通往 L4 的核心能力之一。
实验亮点
CARLA Town05 闭环:纯相机超越跨模态方案
| 方法 | 传感器 | Drive Score | Route Completion | Infraction Score |
|---|---|---|---|---|
| Interfuser | C | 68.3 | 95.0 | - |
| ST-P3 | C | 11.5 | 83.2 | - |
| VAD | C | 30.3 | 75.2 | - |
| UniAD | C | 31.0 | 47.5 | 0.77 |
| MILE | C | 61.1 | 97.4 | 0.63 |
| DriveAdapter+TCP | C+L | 71.9 | 97.3 | 0.74 |
| ThinkTwice | C+L | 70.9 | 95.5 | 0.75 |
| DriveMLM | C+L | 76.1 | 98.1 | 0.78 |
| VADv2 | C | 85.1 | 98.4 | 0.87 |
VADv2 只用相机在 Drive Score 上比用相机+激光雷达的 DriveMLM 高 9 分(+11.8%),比纯相机方案 Interfuser 高 16.8 分。Route Completion 达到 98.4%,几乎在所有路线上都能跑完全程。Infraction Score 0.87 也是最优。
最关键的一点:VADv2 不需要规则后处理。此前几乎所有方法都要在模型输出后面挂一套 hand-crafted 规则来修正碰撞和偏离——用规则判断轨迹是否安全、再用优化方法调整。VADv2 直接在模型内部通过 conflict loss 学了约束,端到端全程神经网络搞定。
Bench2Drive 基准:同样领先
在最新提出的 Bench2Drive 基准(包含更多交互场景和复杂路线)上,VADv2 的 Drive Score 达到 76.15,同样以显著优势领先所有方法。
NAVSIM + 3DGS 真实场景:鲁棒性验证
| 方法 | Collision Ratio (CR) ↓ | Deviation Ratio (DR) ↓ |
|---|---|---|
| TransFuser (C+L) | 0.320 | - |
| VADv2 (C) | 0.270 | 0.243 |
在 337 个 3DGS 重建的真实环境(2000 小时真实驾驶数据)上,VADv2 的碰撞率 0.270 比 TransFuser(0.320)降低 15.6%,偏离率 0.243 也接近最优。这证明了 VADv2 不只是仿真环境里的"高分玩家",在真实场景迁移上也有实质优势。
消融实验:核心贡献验证
1. 概率规划 vs 确定性回归
| 规划范式 | NAVSIM PDMS | 分析 |
|---|---|---|
| 确定性回归 | 85.8 | 高密度场景下明显退化 |
| 概率规划 | 87.7 | 各密度场景下稳定表现 |
在控制场景编码完全一致的条件下,概率规划在所有密度等级上都优于确定性回归。尤其在高密度交通下差距最大(+1.9 PDMS),说明多模态分布建模在复杂场景中的优势最明显。
2. 词表大小消融
| 词表大小 | Town05 DS | 分析 |
|---|---|---|
| 256 | 70.2 | 容量严重不足,多样性受限 |
| 1024 | 78.1 | 离散化太粗,表达能力不足 |
| 4096 | 85.1 | 最佳平衡点 |
| 16384 | 84.5 | 词表过大引入稀疏噪声,收益饱和 |
4096 是 sweet spot——足够覆盖驾驶动作的多样性,又不至于让学习过于稀疏。当词表增加到 16384 时性能反而略有下降,因为大量词条在训练中很少被激活,梯度信号稀疏。
3. 各模块消融
| ID | Distribution Loss | Conflict Loss | Agent Token | Map Token | Traffic Token | Image Token | L2 3s ↓ | Collision 3s ↓ |
|---|---|---|---|---|---|---|---|---|
| 1 | ✗ | ✓ | ✓ | ✓ | ✓ | ✓ | 0.595 | 0.078 |
| 2 | ✓ | ✗ | ✓ | ✓ | ✓ | ✓ | 0.380 | 0.058 |
| 3 | ✓ | ✓ | ✗ | ✓ | ✓ | ✓ | 0.386 | 0.052 |
| 4 | ✓ | ✓ | ✓ | ✗ | ✓ | ✓ | 0.359 | 0.053 |
| 5 | ✓ | ✓ | ✓ | ✓ | ✗ | ✓ | 0.347 | 0.046 |
| 6 | ✓ | ✓ | ✓ | ✓ | ✓ | ✗ | 0.338 | 0.045 |
| 7 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | 0.290 | 0.039 |
- Distribution Loss 最重要(ID 1 → L2 3s 从 0.290 涨到 0.595,翻倍)
- Conflict Loss 提供关键安全先验(ID 2 → Collision 3s 从 0.039 涨到 0.058)
- 四种场景 token 各有贡献,全量使用(ID 7)达到最优
多模态输出质量
VADv2 的 top-1 到 top-5 轨迹规划性能基本持平,证明它真正学到了多模态分布——多个候选轨迹质量都很高,不只是"赌对一个"。
个人思考
VADv2 让我最兴奋的不是它刷了多少分,而是它把自动驾驶的认知范式从"确定性"升级到了"概率性"。
回顾这条线的演进:
- UniAD(CVPR 2023 最佳论文)证明"以规划为中心做联合优化"可行,开创了端到端范式
- VAD(ICCV 2023)证明"向量化替代稠密栅格"效率更高,速度提升数倍
- VADv2(ICLR 2026)证明"概率分布替代确定性回归"更能应对真实世界的模糊性
这个思路和最近 GRPO/RL 方向的进展遥相呼应——AlphaDrive-GRPO 也是用群体相对策略优化搜索动作空间。两者共同的趋势是:不再假设一个场景只有一个最优解,而是承认多解性,再去学怎么从候选里挑出好的。
从架构看 VADv2 的三个关键设计选择
1. 为什么用 FPS 而不是 k-means?
驾驶轨迹分布是高度偏态的——直行占绝大多数,转弯/变道是少数的关键样本。k-means 会把有限容量浪费在细微的直行变体上,而 FPS 保证词表均匀覆盖动作空间。这和 NLP 中 subword tokenization 的"覆盖所有常见模式且不浪费容量"的思路是相通的。
2. 为什么用 sigmoid 而不是 softmax?
多个合理动作不是互斥的。用 softmax 强制所有概率和为 1,意味着一个动作概率高了其他必然低——这在多模态场景下不合适。sigmoid 允许每个动作独立获得高概率,分布可以呈现任意形状。
3. 为什么需要 conflict loss?
单纯模仿人类驾驶数据只能学到"人类做了什么",但不知道"什么绝对不能做"。conflict loss 显式告诉模型碰撞和偏离路线是不安全的,即使人类演示中从未出现过。这是从"行为克隆"向"安全约束学习"的关键一步。
局限与展望
第一,VADv2 的词表需要预定义且大小固定(4096),这意味着它无法在推理中动态创建新的动作模式,上限受限于词表的覆盖范围。对于长尾场景中极端罕见的操作,词表可能没有覆盖。未来可以探索动态扩展词表或结合连续优化做微调。
第二,目前的高分还集中在仿真环境,虽然 3DGS 基准往前迈了一大步,但离真正开放道路部署还有距离。从 CARLA 到真实世界的 domain gap 仍然是端到端方法的头号挑战。
第三,VADv2 的概率建模只覆盖了规划阶段。如果能把感知的不确定性也纳入概率框架——比如对遮挡区域的目标位置输出概率分布而不是单一检测框——整个系统的鲁棒性可能会再上一个台阶。这也许是"全概率端到端"的方向。
第四,VADv2 的 Transformer Decoder 每次对所有 4096 个动作做交叉注意力,计算量是 O(N) 的。未来可以探索用 ANN 或层级过滤先缩小候选集再做精细打分,进一步提高效率。
和本系列其他论文的关系
VADv2 在"端到端驾驶规划"这条线上是一个非常特殊的位置:
- 对比 UniAD / VAD(确定性规划派):VADv2 用概率分布替代了直接回归,解决了非凸解空间的问题。但场景编码部分继承自 VAD 的向量化范式——说明"向量化场景表示"和"概率规划"是两个正交的创新点,可以叠加。
- 对比 Diffusion Planner / DriveDiffusion(扩散规划派):扩散模型也是从噪声逐步去噪到轨迹,本质上也建模了分布。但扩散需要多步迭代(通常 10-50 步),VADv2 是一步推理。两者互补——扩散适合高质量但延迟不敏感的场景,VADv2 适合低延迟实时控制。
- 对比 DriveMLM / DriveCoT(LLM 规划派):VADv2 和 DriveMLM 都从 LLM 得到启发(分布建模 + 采样),但 VADv2 用离散词表 + 概率场替代了 token by token 自回归生成。前者是 One-shot 分类,后者是 Seq-to-seq 生成。VADv2 更快,但 DriveMLM 的可解释性和推理能力更强。
- 对比 AlphaDrive-GRPO / Flow-GRPO(RL 规划派):这些方法用强化学习搜索动作空间。VADv2 用监督学习学分布。两者理论上可以结合——VADv2 提供先验分布,GRPO 在这个分布上做探索。
一句话总结:VADv2 = 向量化场景编码(VAD 继承)+ FPS 规划词表(4096 条完整轨迹)+ NeRF 风格坐标编码(高频位置编码)+ Transformer Decoder 交叉注意力(规划 token query, 场景 token key/value)+ 概率场函数(sigmoid 输出)+ 三重损失(KL 分布 + 冲突约束 + token 监督)。它最核心的贡献是:把"这个场景该走哪条路"从回归问题变成了分类问题,从而天然获得了处理多模态不确定性、输出置信度、无需规则后处理这三个关键能力。