论文信息
- 标题:DriveTransformer: Unified Transformer for Scalable End-to-End Autonomous Driving
- 作者机构:上海交通大学 × 上海人工智能实验室(Xiaosong Jia, Junqi You, Zhiyuan Zhang, Junchi Yan)
- arXiv:2503.07656(ICLR 2025)
- 代码:github.com/Thinklab-SJTU/DriveTransformer
- 一句话总结:抛弃稠密 BEV 表示,用三种注意力(SCA + TSA + TCA)让任务 query 直接与原始传感器特征交互、与同级任务交互、与历史帧交互,实现真正的并行、稀疏、流式 Transformer。单阶段端到端训练,闭环 Bench2Drive 63.46 DS,开环 nuScenes 0.40 L2。
要解决什么问题:BEV 的三大瓶颈
在 DriveTransformer 之前,UniAD / VAD 系列已经证明了"端到端多任务统一"的可行性。但它们都依赖一个共同的基础构件:稠密 BEV 特征。DriveTransformer 指出,BEV-based 方法存在三个根本问题:
| 问题 | 表现 | 后果 |
|---|---|---|
| 计算浪费 | BEV 是稠密栅格(如 200×200),但 3D 空间本质上是稀疏的——大部分格子是空的 | 大量算力花在了空网格上,长距离感知时问题更严重 |
| 梯度弱化 | 图像 backbone → BEVFormer(交叉注意力) → 任务 head,梯度回传路径长 | backbone 收到的梯度信号太弱,优化不充分,拖累扩展性 |
| 时序代价高 | 存储多帧历史 BEV 特征做时序融合 | 显存和算力开销大,Park et al. (2023) 指出这是 BEV 方案的效率瓶颈 |
这三个问题本质上都源于同一个根源:用稠密栅格表示稀疏的 3D 空间。BEV 栅格的每个格子都要计算 attention,但车辆、行人、车道线只覆盖了栅格的一小部分。当感知范围扩展到 100m+ 时,200×200 的 BEV 特征根本无法覆盖(只能覆盖 ~60m)。
此外,UniAD/VAD 的串行依赖(感知→预测→规划)也带来训练不稳定问题:
| 串行依赖的后果 | 具体表现 |
|---|---|
| 多阶段训练 | UniAD 必须先预训练 BEVFormer → 再训 TrackFormer + MapFormer → 最后训 MotionFormer + Planner |
| 累积误差 | 上游检测漏了某个目标,下游预测/规划根本不知道它的存在 |
| 联合优化困难 | 每个任务都需要先收敛到一定程度,否则早期的不稳定预测会互相拖累导致训练崩溃 |
ParaDrive(2024)尝试通过切断所有任务连接来缓解不稳定问题,但仍然保留了昂贵的 BEV 表示,只解决了串行依赖的问题,没解决 BEV 本身的问题。
DriveTransformer 的终极问题:如果 Transformer 本身就是万能的信息交换器,为什么还需要 BEV 这个"中间人"?直接让任务 query 和 sensor feature 说话不行吗?
核心思想:统一、并行、稀疏、流式
DriveTransformer 的核心主张是:
丢掉 BEV,让每个任务拥有一组 query token,这些 token 通过三种标准注意力直接与原始传感器特征交互、与同级任务交互、与历史帧交互。所有任务并行、所有操作统一为 Transformer 注意力。
四个设计原则:
| 原则 | 含义 | 实现 |
|---|---|---|
| Task Parallelism | 所有任务(检测/预测/建图/规划)的 query 在每个 block 中直接互相交互 | 没有显式的任务层级依赖 |
| Sparse Representation | 任务 query 直接与原始传感器特征交互,没有中间 BEV 表示 | Sensor Cross-Attention |
| Streaming Processing | 历史帧的任务 query 存入 FIFO 队列,当前帧通过 cross-attention 参考 | Temporal Cross-Attention + 运动补偿 |
整体架构
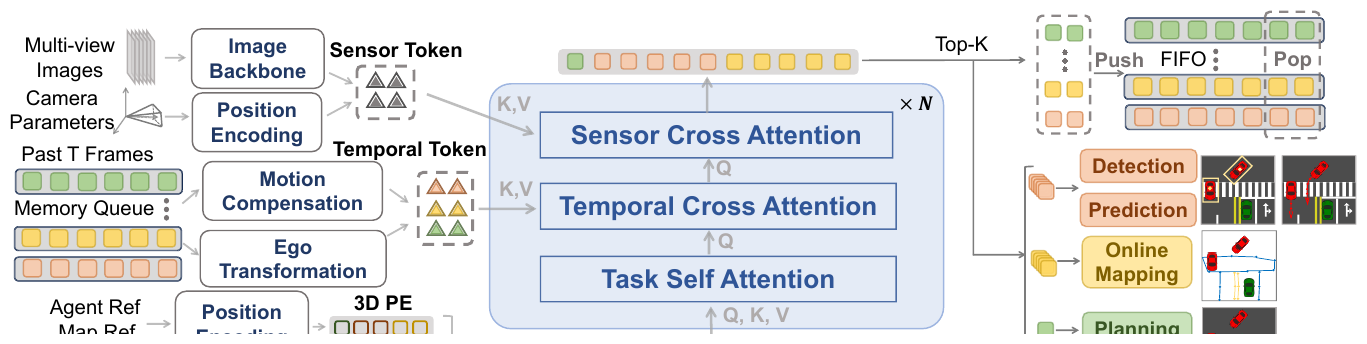
图 1:DriveTransformer 整体架构。 输入多视图图像经 backbone 提取特征 → 生成 sensor token(3D PE 编码) + 任务 token(Agent/Map/Ego)。每个 Transformer block 包含三种注意力:Sensor Cross-Attention(与原始传感器特征交互)、Task Self-Attention(任务间交互)、Temporal Cross-Attention(与历史 FIFO 队列交互)。最终经过任务头输出检测框、地图元素、运动轨迹、规划轨迹。
整条数据流:
关键认知:整个 pipeline 只有一个统一的 Transformer 结构,没有专门的 BEV encoder、没有专门的时序融合模块,一切都只是注意力。
值得注意的细节:DriveTransformer 的 sensor token 和 task token 之间的交互跨越了整个 pipeline。Sensor token 作为 key/value 被所有 block 共享,这意味着高分辨率 sensor feature 只需要提取一次,不像 BEVFormer 那样每层都要从 2D 特征投影到 BEV 空间。这显著节省了计算量。
方法详解
一、初始化与 Token 化
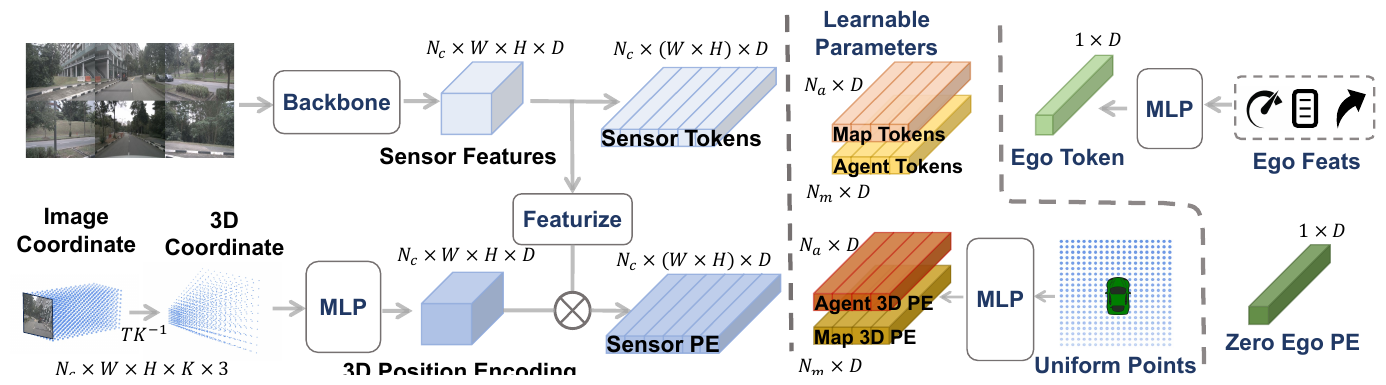
图 2:Token 化与初始化过程。 所有输入被统一为 token(语义嵌入 + 位置编码)。Sensor token 通过 3D PE 注入几何信息;Agent/Map token 从可学习参数初始化,PE 在感知范围内均匀初始化;Ego token 从 canbus 信息经 MLP 编码。
Sensor Token
每张相机图经 backbone 提取为 \(H_{\text{sensor}} \in \mathbb{R}^{N_c \times H \times W \times D}\) 的特征图。每个 patch 的 3D 位置编码借鉴 PETRv2:对于图像坐标 \((i, j)\) 处的 patch,沿其相机射线采样 K 个等间距 3D 点:
\[ \text{Ray}_{i,j} = \{ \mathbf{T}^{-1}_K [i, j, d_k] \mid k = 1, 2, ..., K \} \]其中 \(\mathbf{T}\) 和 \(\mathbf{K}\) 分别是该相机的外参和内参矩阵,\(d_k\) 是第 k 个采样点的深度值。同一射线上 K 个点的 3D 坐标拼接后经 MLP 编码为位置编码 \(PE_{\text{sensor}} \in \mathbb{R}^{N_c \times H \times W \times D}\)。
关键意义:sensor token 自带 3D 几何信息。当任务 query 做 cross-attention 时,它可以根据 3D 位置匹配到特定的 sensor patch——比如一个在 BEV 坐标 (10m, 2m) 处的 agent query,会去关注所有相机图中那条射线经过 (10m, 2m) 的 patch。这种匹配是在连续的 3D 空间中完成的,没有 BEV 栅格化带来的量化误差。
与 BEVFormer 的对比:
| BEVFormer | DriveTransformer | |
|---|---|---|
| 几何编码方式 | BEV 栅格(每个格子对应固定 3D 区域) | 3D PE(每个 patch 编码连续射线) |
| 空间分辨率 | 受栅格大小限制(~0.5m/格) | 连续(不受量化) |
| 特征提取 | 需要专门构建 BEV 特征图 | 直接在 2D 特征图上操作 |
任务 Token
三种任务 token 对应三种场景元素:
| Token 类型 | 数量 | 语义嵌入 | 位置编码 | 职责 |
|---|---|---|---|---|
| Agent Token | \(N_a\)(~300) | 随机可学习参数 | 感知范围内均匀初始化的 3D 点 + 逐层 refine | 检测 + 运动预测 |
| Map Token | \(N_m\)(~100) | 随机可学习参数 | 感知范围内均匀初始化的 3D 点 | 在线建图(车道线、边界等) |
| Ego Token | 1 | MLP(Canbus) 编码速度/加速度等 | 全零(自车永远是原点) | 规划 |
Agent 和 Map token 的设计遵循 DAB-DETR 的关键思想:语义嵌入和位置编码分离。语义嵌入 \(H\) 表示"这类型的物体是什么",位置编码 \(PE\) 表示"它在哪里"。两者通过 attention 中的相加融合。
一个关键细节:Agent 和 Map token 的 PE 不是固定不变的。在每个 Transformer block 之后,任务 head 会输出当前预测结果(检测框/车道线/轨迹),PE 会根据预测结果更新:
- Agent PE: MLP(预测的 3D 位置 + 语义类别) → 更精确地定位 agent
- Map PE: MLP(预测的 polyline 点集) → 更精确地定位地图元素
- Ego PE: MLP(预测的规划轨迹) → 表达自车意图
这种 coarse-to-fine 优化(从粗略定位到精确定位逐 block 细化)是 DAB-DETR 中 iterative box refinement 的推广,也是 DriveTransformer 能单阶段训练的保证——每个 block 都产生可用的预测,早期 block 即使预测不准也不至于让整个训练崩溃。
二、Token 交互——三种注意力
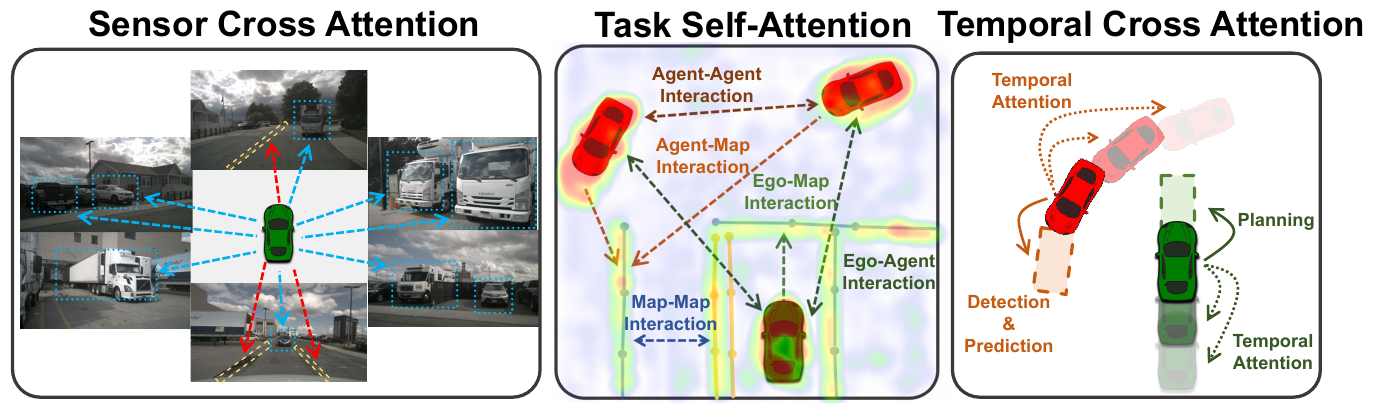
图 3:三种注意力类型。 Sensor Cross-Attention 让任务直接访问原始 sensor 特征;Task Self-Attention 实现任意任务间的信息交换(Agent-Agent、Agent-Map、Ego-Map、Ego-Agent、Map-Map);Temporal Cross-Attention 利用历史队列 FPS 筛选的 Top-K query 提供时序先验。
1. Sensor Cross-Attention(SCA)
任务 token 直接与 sensor token 做 cross-attention,query 来自所有任务 token 的和,key/value 来自 sensor token:
这替代了 BEVFormer 的 cross-attention——任务 token 直接在 2D 特征图上做 attention,不需要先渲染成稠密 BEV 栅格。由于 sensor token 自带了 3D PE,attention 可以按 3D 位置匹配,效果等价甚至优于 BEV 方案(消除了栅格化后的量化误差)。
2. Task Self-Attention(TSA)
所有任务 token 之间做 full self-attention。这意味着:Agent token 可以看到 Map token(“这条路属于哪个车道?"),Map token 可以看到 Agent token(“这个车道的车要干嘛?"),Ego token 可以看到 Agent 和 Map(“我应该怎么根据周围车和路来决定?")。
与 UniAD 的串行 query 传递不同,DriveTransformer 的 TSA 没有固定顺序——所有关系由 attention 自动学习。这使得模型天然支持 planning-aware perception(规划知道感知需要什么)和 game-theoretic planning(规划知道预测会如何响应)。
3. Temporal Cross-Attention(TCA)
DriveTransformer 维护一个 FIFO 队列存储历史帧的 task query。当前帧通过 cross-attention 参考历史帧:
历史 PE 需要经过两步校正:
- Ego Transformation:将历史帧的自车坐标系转换到当前帧(MLP(T_t0 * Pos_t))
- Motion Compensation:对 agent token,根据其预测速度和时间间隔运动补偿(ada-LN)
历史 agent/map query 只保留 Top-K 高置信度的(DETR 中有大量冗余 query)。
与 UniAD/VAD 存储历史 BEV 特征(稠密栅格,每帧 200×200×C)不同,TCA 存储的是历史任务 query——query 本身携带了高层语义信息(“这是那辆车、这是那条车道”),数量只有几百个 token,比稠密栅格高效得多。
流式时序处理
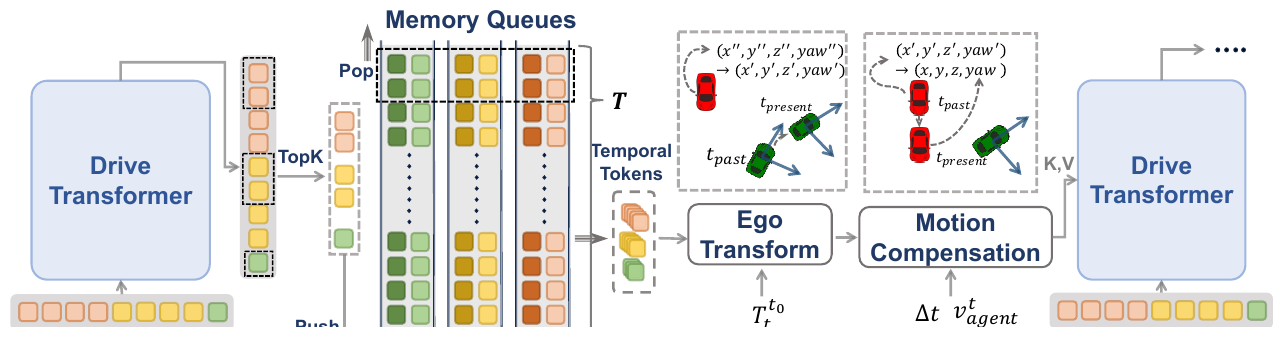
图 4:流式时序处理机制。 每个时间步结束后,当前帧最后一层的 Top-K 任务 query 被推入 FIFO 队列。历史 query 的 PE 经过自车坐标系变换和运动补偿后,作为 Temporal Cross-Attention 的 key/value 使用。
流式处理的关键工程设计:
- FIFO 队列:每个任务类型(agent/map/ego)维护一个独立队列,长度 \(T_{\text{queue}}\) 可配置
- Top-K 筛选:agent 和 map 的 DETR 风格 query 有大量冗余(~300 个 agent token 中大部分是背景),只保留置信度最高的 K 个
- 自车坐标系变换:历史帧的 PE 通过 MLP(T_{t0}^{t} · Pos_t) 变换到当前帧的自车坐标系
- 运动补偿:对 agent token,根据预测速度和时间间隔做 adaLN 风格的运动补偿,补偿后的坐标为 PE^{t}_{comp} = LayerNorm(PE^{t}, [γ, β] = MLP(v^{t} · Δt))
这种设计的优势:计算量不随时间窗口线性增长。传统方案存储 K 帧历史 BEV 特征需要 O(K·H·W·C) 的显存,而 DriveTransformer 只需要 O(K·N_query·D),其中 N_query « H·W。
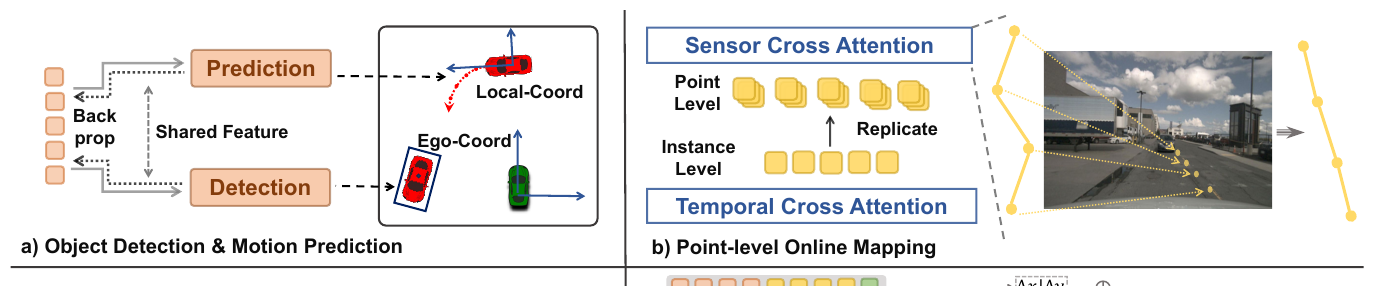
图 5:任务头设计。 (a) 检测与运动预测共享 Agent 特征,无需显式跟踪(同一 query 自然关联检测和预测);运动预测在局部坐标系输出,解耦两个任务。(b) 在线建图在每个 map query 上复制 N 个 point PE,实现点级特征检索。(c) 规划头用 6 个模式嵌入生成多模态轨迹。(d) Coarse-to-Fine 优化,逐 block refine PE。
检测与运动预测
DriveTransformer 的关键设计:不做显式跟踪。
传统方法(如 UniAD)的流程是:检测 → 帧间关联(TrackFormer) → 运动预测(MotionFormer)。关联模块是训练不稳定的一大根源——帧间匹配本身就是一个困难问题(遮挡、ID switch、新目标出现/消失),且关联错误会直接污染后续预测。
DriveTransformer 彻底绕过了关联问题:同一个 agent query 同时接入 detection head 和 prediction head。对于同一帧,同一 query 自然关联了检测和预测——不需要匈牙利匹配。
对于帧间关联,Temporal Cross-Attention 隐式地建立了对应关系:当前帧的 agent query 通过 attention 从历史 agent query 中拉取特征,历史中同一辆车自然会在 attention 权重中高于其他车。
另一个关键设计:局部坐标系预测。运动预测的 ground truth 轨迹转换到 agent 自身的局部坐标系(以 agent 当前位置为原点、朝向为 x 轴):
| 属性 | 全局坐标系预测(UniAD) | 局部坐标系预测(DriveTransformer) |
|---|---|---|
| Loss 影响因素 | 受检测框位置 + 航向误差影响 | 完全不受检测结果影响 |
| 训练稳定 | ❌ 检测一歪预测也跟着歪 | ✅ 检测和预测完全解耦 |
| 推理 | 直接输出全局轨迹 | 需要将局部轨迹变换回全局 |
这种解耦使得 motion loss 在训练中独立于 detection loss 优化,联合训练时不会互相干扰。消融实验证明,局部坐标系预测的 minADE 仅为 1.34,而全局坐标系的 2.68——好了一倍。
在线建图
Map token 在 Sensor Cross-Attention 中复制 \(N_{\text{point}}\) 份,每份搭配一个点级 PE。这样长车道线的每个点都能独立从 sensor 特征中检索局部信息。之后通过 PointNet + max-pooling 聚合成实例级 token。
规划
规划头使用高斯混合模型输出多模态轨迹。训练集中所有轨迹按方向和距离聚类为 6 类:直行、停车、左转、急左转、右转、急右转。每个模式有一个可学习的嵌入向量,与 ego query 相加后预测该模式的轨迹。训练时 winner-take-all——只有 ground truth 对应模式的轨迹参与回归。同时训练一个分类头预测当前模式,推理时选择置信度最高的模式。
四、Loss 与单阶段训练
整体 loss 是各任务 loss 的加权和:
\[ \mathcal{L}_{\text{overall}} = w_{\text{det}} \mathcal{L}_{\text{det}} + w_{\text{motion}} \mathcal{L}_{\text{motion}} + w_{\text{map}} \mathcal{L}_{\text{map}} + w_{\text{plan}} \mathcal{L}_{\text{plan}} \]- 检测:DETR 风格匈牙利匹配 loss
- 运动:winner-take-all loss
- 建图:MapTR 风格匈牙利匹配 loss
- 规划:winner-take-all loss
关键优势:单阶段端到端训练。由于没有任务间的手工依赖,所有任务同时从 sensor 输入和历史信息中学习,不会互相影响收敛。
具体来说,每个 loss 的权重 \(w\) 经过调整使得各 loss 量级在 1 左右。总 loss 在单次前向传播中计算、单次反向传播更新所有参数。这与 UniAD 的多阶段策略形成鲜明对比:
| UniAD | VAD | DriveTransformer | |
|---|---|---|---|
| 训练阶段数 | 4 阶段 | 2 阶段 | 1 阶段 |
| 阶段1 | 预训练 BEVFormer | 预训练 backbone | 端到端 |
| 阶段2 | 训 TrackFormer + MapFormer | 端到端联合训练 | - |
| 阶段3 | 训 MotionFormer | - | - |
| 阶段4 | 端到端联合微调 | - | - |
| Batch Size (A800) | 1 | 4 | 12 |
消融实验证明:感知预训练(pretrain perception)不带来增益——预训练后训练 vs 直接端到端训练的 DS 分别为 60.22 和 60.45,几乎一样。这是 BEV 方案做不到的(UniAD 不预训练 BEVFormer 根本无法收敛)。
四种范式对比
图 5:端到端自动驾驶范式对比。 (a) Direct Planning(端到端黑盒,只输出规划,训练稳定但无中间表示);(b) BEV Sequential(BEV串行,UniAD/VAD 为代表,中间表示完整但训练复杂);(c) Parallel BEV(BEV 并行,ParaDrive 为代表,任务并行但仍有 BEV 瓶颈);(d) Pure Transformer(本文,完全抛弃 BEV,注意力统一所有交互)。
从图中可以看出四种范式在三个维度的权衡:
| 范式 | 训练稳定性 | 任务关联性 | 效率 |
|---|---|---|---|
| Direct Planning | ⭐⭐⭐ | ⭐ | ⭐⭐⭐⭐ |
| BEV Sequential | ⭐ | ⭐⭐⭐ | ⭐⭐ |
| Parallel BEV | ⭐⭐⭐⭐ | ⭐ | ⭐⭐ |
| DriveTransformer | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
DriveTransformer 通过移除 BEV、并行化任务、注意力统一设计,在三个维度上都达到了最优。
实验
Bench2Drive 闭环评测(CARLA Leaderboard 2.0)
| 方法 | Driving Score ↑ | Success Rate ↑ | Avg. L2 ↓ | Latency |
|---|---|---|---|---|
| UniAD-Tiny | 40.73 | 13.18 | 0.80 | 420.4ms |
| UniAD-Base | 45.81 | 16.36 | 0.73 | 663.4ms |
| VAD | 42.35 | 15.00 | 0.91 | 278.3ms |
| DriveTransformer-Large | 63.46 | 35.01 | 0.62 | 211.7ms |
| TCP*(专家蒸馏) | 59.90 | 30.00 | 1.96 | 83ms |
| DriveAdapter*(专家蒸馏) | 64.22 | 33.08 | 1.01 | 931ms |
DriveTransformer 在**纯端到端(无专家蒸馏)**方法中全面领先,DS 比 UniAD-Base 高出 17.65、比 VAD 高出 21.11。注意延时也比 UniAD/VAD 更低——更快更准。
多能力细分
| 能力 | UniAD-Base | VAD | DriveTransformer |
|---|---|---|---|
| 并道(Merging) | 12.16 | 7.14 | 17.57 |
| 超车(Overtaking) | 20.00 | 20.00 | 35.00 |
| 紧急刹车 | 23.64 | 16.36 | 48.36 |
| 让行(Give Way) | 10.00 | 20.00 | 40.00 |
| 交通标志 | 13.89 | 20.22 | 52.10 |
| 平均 | 15.94 | 16.75 | 38.60 |
紧急刹车和交通标志场景下 DriveTransformer 提升最大——这两个任务正是 BEV 方案容易出问题的场景(需要快速反应、精确几何)。
nuScenes 开环评测
| 方法 | Avg. L2 ↓ | Avg. Collision ↓ |
|---|---|---|
| ST-P3 | 2.11 | 0.71 |
| UniAD | 0.76 | 0.17 |
| VAD-Base(仅视觉) | 0.72 | 0.22 |
| BEVPlanner | 0.57 | 0.11 |
| DriveTransformer-Large | 0.40 | 0.11 |
| VAD-Base*(+自车状态) | 0.37 | 0.14 |
| ParaDrive* | 0.48 | 0.07 |
| DriveTransformer-Large* | 0.33 | 0.13 |
DriveTransformer 在所有设置下都达到 SOTA,Avg. L2 0.40 比 BEVPlanner 低 0.17,比 UniAD 低 0.36。
消融实验
三种注意力都是必要的
| 设置 | Driving Score | Success Rate |
|---|---|---|
| Full Attention | 60.45 | 30.00 |
| w/o Sensor Cross-Attention | 8.41 | 0.00 |
| w/o Task Self-Attention | 52.37 | 20.00 |
| w/o Temporal Cross-Attention | 56.22 | 20.00 |
没有 SCA 模型直接盲驾(DS 8.41)。TSA 和 TCA 也各自贡献显著。
单阶段训练足够了
| 设置 | Driving Score |
|---|---|
| DriveTransformer(单阶段) | 60.45 |
| Planning Only(无辅助任务) | 54.22 |
| Pretrain Perception(两阶段) | 60.22 |
| w/o Middle Supervision | 51.67 |
感知预训练不带来增益——这是 BEV 方案做不到的(UniAD/VAD 必须预训练 backbone/BEVFormer)。证明 DriveTransformer 的并行设计确实消除了多阶段训练的必要。
Scaling 研究
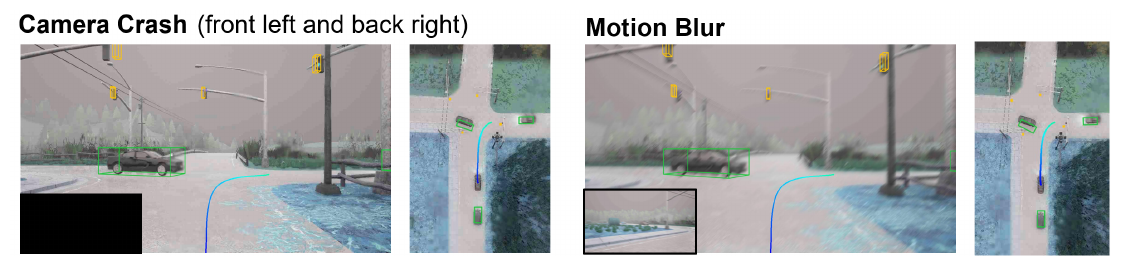
图 6:Scaling 研究。 (a) 对规划的影响:增大 decoder 层数/宽度比增大 image backbone 收益更大;(b) 对感知的影响:两者趋势相似,但大規模 VLM 预训练 backbone(EVA02-CLIP-L)仍在感知上占优。
DriveTransformer 通过统一 Transformer 结构展现了良好的 scaling law——更大的 decoder(12 层、768 隐藏维度)持续提升规划性能。模型配置从 Small(47M,3 层)到 Large(646M,12 层)的 Driving Score 从 45.04 提升到 68.22。
鲁棒性分析
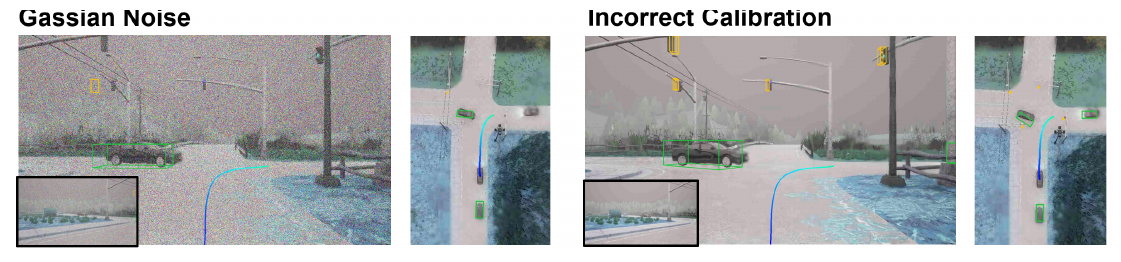
图 7:不同鲁棒挑战下的检测和规划可视化。 DriveTransformer 在相机崩溃、标定偏差、运动模糊、高斯噪声下仍保持合理规划;VAD 的 BEV 方案在这些条件下严重退化。
| 条件 | VAD-Base DS | DriveTransformer DS |
|---|---|---|
| Regular | 53.45 | 60.45 |
| Camera Crash | 48.54(-9.2%) | 58.67(-2.9%) |
| Incorrect Calibration | 38.46(-28.0%) | 56.53(-5.9%) |
| Motion Blur | 45.47(-14.9%) | 54.04(-10.6%) |
| Gaussian Noise | 44.53(-16.7%) | 56.94(-6.0%) |
关键发现:BEV 方案对标定误差极度敏感(DS 下降 28%),而 DriveTransformer 直接在 2D 特征上做 attention,对标定误差容忍度高得多(仅下降 5.9%)。这是不要中间表示带来的鲁棒性红利。
总结与讨论
DriveTransformer 的核心贡献
- 丢掉了 BEV——用 3D PE + Sensor Cross-Attention 替代了 BEVFormer 的稠密 BEV 构建,算力省了、梯度好了、标定鲁棒了
- 任务全并行——Task Self-Attention 代替了串行 query 传递,单阶段训练成为可能
- 流式处理——Temporal Cross-Attention + 历史 query 队列代替了历史 BEV 特征存储,更高效且保留了语义信息
- 极致简单——三种标准注意力堆叠,没有定制模块、没有多阶段训练、没有规则后处理
DriveTransformer 在 E2E-AD 路线中的位置
如果把端到端自动驾驶的发展看作一条时间线:
DriveTransformer 是"抛弃 BEV"这条路线上的里程碑。它证明了:稠密 BEV 不是端到端驾驶的必需品。直接用 3D PE + cross-attention 可以实现等价甚至更好的空间理解。
与 VLM 的关系
论文在 scaling study 中有一个值得注意的发现:EVA02-CLIP-L 这种大规模视觉语言预训练 backbone 仍然在感知上大幅领先于 randomly initialized backbone。这意味着:
- DriveTransformer 的架构本身具有良好的 scaling property——更大的模型 = 更好的结果
- VLM 的视觉 backbone(如 InternViT、SigLIP、EVA-02)可以作为 DriveTransformer 的 image backbone 直接使用
- 但 VLM 的 LLM 部分如何与 DriveTransformer 的稀疏 query 机制结合,仍然是一个开放问题
一个可能的方向:让 DriveTransformer 的 ego token 在经过注意力交互后,同时输入一个轻量 LLM 做推理和解释输出,而主路径(检测/建图/规划)仍由 DriveTransformer 的 task head 处理。
局限
| 局限 | 分析 |
|---|---|
| 开环→闭环 gap | nuScenes 开环评测中性能与闭环存在差异——这是整个端到端领域的普遍问题 |
| 模式数量固定 | 6 种驾驶模式的聚类数量是硬编码的,可能不足以覆盖所有场景(如掉头、泊车) |
| 无显式安全约束 | 与 VAD 的三个向量化规划约束(碰撞/越界/方向)不同,DriveTransformer 的规划 head 缺乏硬编码安全先验 |
| 纯视觉替代 LiDAR | DriveTransformer 目前只支持相机输入,而 TransFuser/MMFN 利用了 LiDAR 的精确深度 |
| 仅在仿真中验证 | Bench2Drive 是 CARLA 仿真评测,实车性能未知 |
对 Flow-GRPO 的启示
DriveTransformer 的"稀疏 query + 并行交互"范式为强化学习提供了天然的状态空间表示:
- Agent token 集合:编码周围所有车辆的位置、速度和运动意图
- Map token 集合:编码道路拓扑(车道线、路口、人行横道)
- Ego token:编码自车状态和当前规划意图
- 三种注意力:提供了这些状态之间的交互关系
相比 VAD 的向量化场景表示(检测框 + 车道线 polyline + 运动矢量),DriveTransformer 的 token 空间更高维但信息更丰富,且 attention weight 可以作为交互关系的显式表示。在 GRPO 中,可以用这些 token 作为 policy 网络的状态输入,attention weight 作为策略可解释性的依据。