论文信息
- 标题:PARA-Drive: Parallelized Architecture for Real-time Autonomous Driving
- 作者机构:NVIDIA Research × USC × Stanford University(Xinshuo Weng, Boris Ivanovic, Yan Wang, Yue Wang, Marco Pavone)
- 会议:CVPR 2024
- 论文:openaccess.thecvf.com
- 项目页:xinshuoweng.github.io/paradrive
- 一句话总结:系统探索了端到端模块化自动驾驶的架构设计空间,发现"模块间依赖越少越好"——提出完全并行的 PARA-Drive,在 nuScenes 上用纯相机达到 SOTA 规划性能,同时推理速度提升 3 倍。
要解决什么问题:模块化端到端架构的设计空间从没人系统分析过
UniAD、VAD、OccNet 证明了"模块化端到端"这条路走得通——把感知、预测、规划拆成不同模块,但统一在一个网络中联合训练。但问题是:这些方法的架构设计五花八门,没人系统分析过到底什么设计是对的。
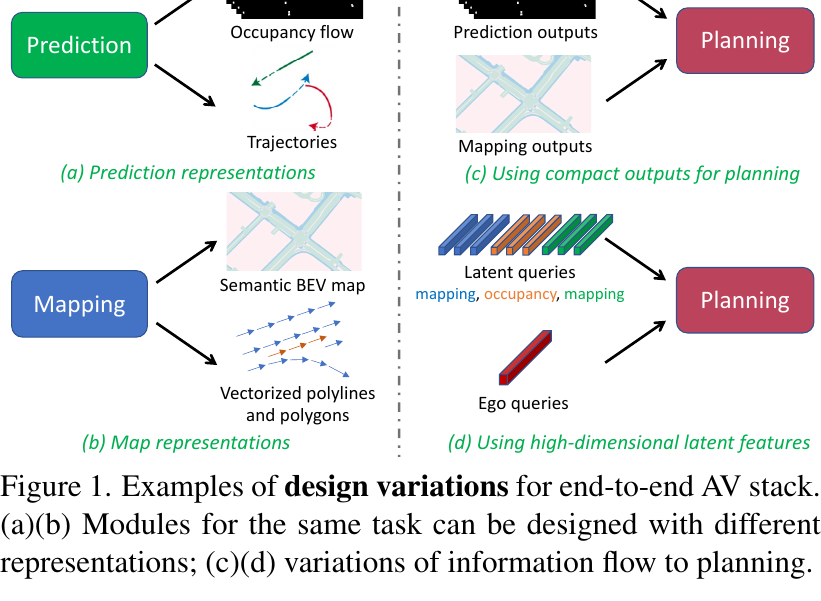
图 1:现有端到端 AV 架构的设计差异。 不同方法对相同的任务选择了完全不同的设计:(a) 预测任务用轨迹 vs 占用栅格;(b) 地图任务用语义 BEV vs 向量化折线;(c) 传给规划的可以是紧凑输出(框/栅格)或高维隐式特征;(d) 模块间串行 vs 并行连接。到底哪种设计最优?没人知道。
具体来说,三个问题没有被回答过:
| 问题 | 举例 |
|---|---|
| 哪些模块是必要的? | 同时用轨迹预测 + 占用预测是冗余还是互补? |
| 模块怎么放? | 串行?并行?还是混合(像 UniAD 那样部分串行部分并行)? |
| 信息怎么传? | 传紧凑输出(边界框/BEV 栅格)还是高维 query 特征? |
PARA-Drive 的核心贡献就是对这三个问题做了系统性的设计空间探索,并基于发现的规律提出最优架构。
核心思想:模块之间依赖越少越好,让 BEV 特征做"共享黑板"
PARA-Drive 的核心发现可以概括为一句话:
在端到端模块化架构中,模块间的依赖关系带来的副作用(错误传播、优化冲突)往往超过了它们带来的收益。最优设计是完全并行——所有模块共享同一个 BEV 特征,独立完成各自任务,互不干涉。
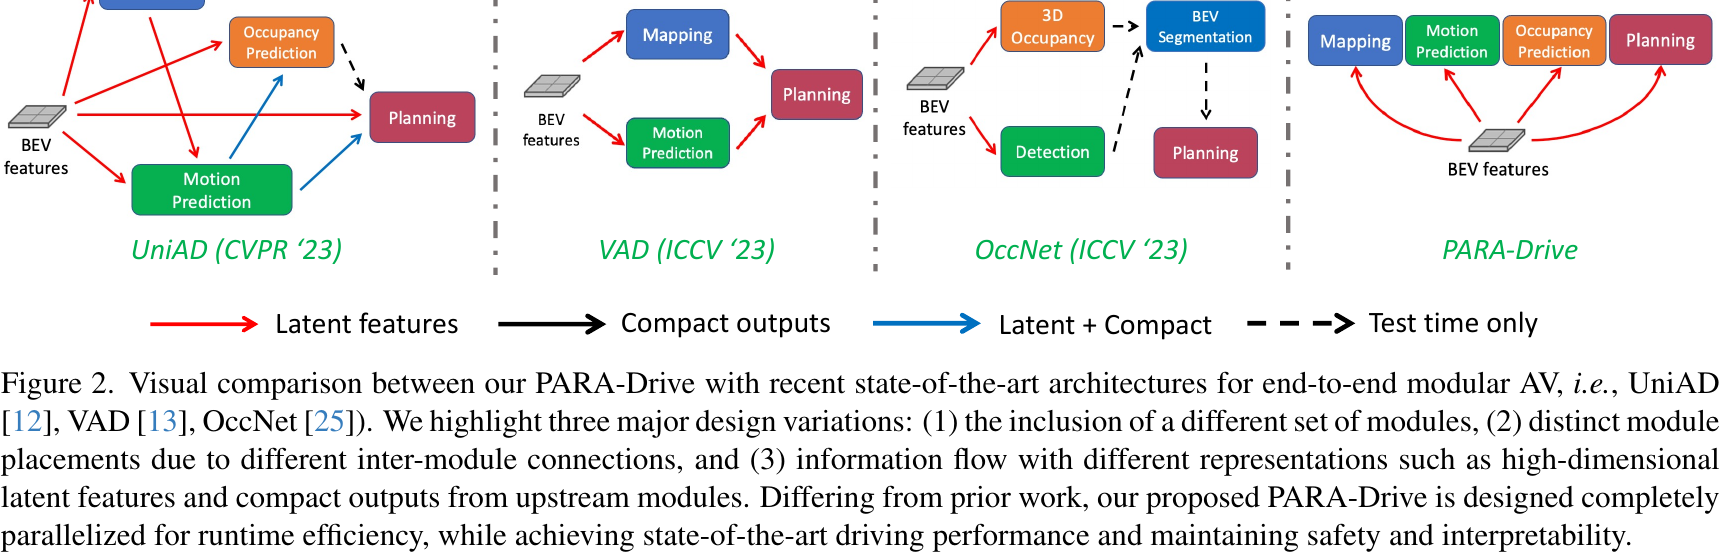
图 2:PARA-Drive 与现有 SOTA 方法的对比。 UniAD 是混合设计(部分串行部分并行),VAD 简化了串行依赖但仍保留了部分连接,OccNet 引入了占用预测但没有实例级预测。PARA-Drive 是完全并行——所有模块同时从 BEV 特征中读取信息,模块间没有直接信息传递。
方法详解
一、先系统探索设计空间(论文前三章的核心贡献)
PARA-Drive 先建了一个灵活的模块化框架,可以自由组合/连接不同模块。然后在这框架上做了大量消融实验。
1.1 模块必要性分析
| 包含的模块 | Collision ↓ | L2 ↓ | 结论 |
|---|---|---|---|
| 仅规划 | 高 | 高 | 基线,无感知 |
| + 在线地图 | 中 | 中 | 地图提供道路结构 |
| + 运动预测 | 中低 | 中低 | 实例级运动信息有助避碰 |
| + 占用预测 | 中低 | 中低 | 场景级占用信息补充运动预测 |
| 地图 + 运动 + 占用 | 最低 | 最低 | 三者互补,全部需要 |
关键发现:轨迹预测(实例级)和占用预测(场景级)不是冗余的,而是互补的——轨迹预测告诉模型"那个车会怎么走",占用预测告诉模型"整个可通行空间长啥样"。两者一起才能达到最优规划。
1.2 模块连接方式分析(串行 vs 并行)
这是最重要的消融。UniAD 的架构中有一些串行连接,比如地图模块的输出传给运动预测模块(边缘 1),运动预测再传给规划(边缘 2)。
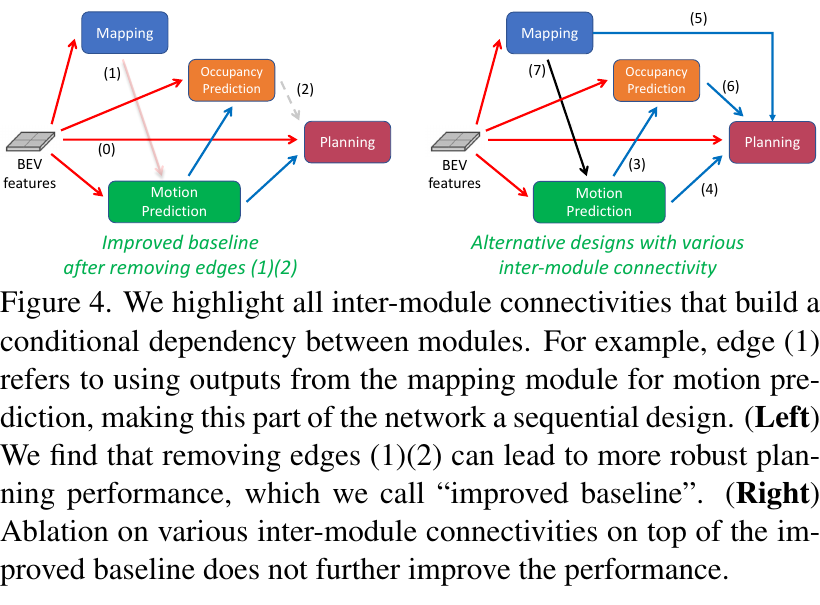
图 3:模块间连接方式消融。(左)在基线中,边缘 (1)(地图→运动)和 (2)(运动→规划 TTO)的串行连接反而降低了性能。(右)在去除 (1)(2) 后,其他串行连接也不能带来提升。结论:并行设计是最优的。
具体消融发现:
- 边缘 (1) 地图→运动:去除后性能反而提升。原因是地图 query 和运动 query 的交互引入了噪声
- 边缘 (2) 运动→规划(TTO):测试时优化(TTO)会产生 zigzag 轨迹,增加 L2 误差
- 边缘 (3)-(7):在去除 (1)(2) 的基础上,加上任何其他串行连接都不能再提升性能
核心结论:在端到端模块化架构中,并行设计优于串行和混合设计。模块间没有依赖意味着:(a) 没有错误传播,(b) 每个模块可以独立优化,(c) 推理时可以按需开关模块。
#还需要特别提到一个反直觉的发现:在线地图模块对规划的贡献并不在于它的输出被直接使用,而在于它提供的监督信号帮助 BEV 特征学到了更好的道路拓扑表示。即使规划模块从不直接读取地图输出,只要地图模块在联合训练中存在,BEV 特征就会编码更丰富的道路结构信息,规划性能就更好。这是"共享 BEV"设计的关键原理。
1.3 信息传递方式消融(传递什么给规划)
为了验证不同信息传递方式的影响,作者做了一个详细的消融实验:去掉 BEV 特征,仅通过不同接口向规划模块传递信息。结果如下:
| 传给规划的信息 | 1.0s Col ↓ | 2.0s Col ↓ | 3.0s Col ↓ | Ave Col ↓ | 1.0s L2 ↓ | 2.0s L2 ↓ | 3.0s L2 ↓ | Ave L2 ↓ |
|---|---|---|---|---|---|---|---|---|
| 基线(含 BEV) | 0.00 | 0.07 | 0.51 | 0.13 | 0.24 | 0.55 | 1.07 | 0.53 |
| 无 BEV(仅自车状态) | 3.41 | 8.09 | 7.91 | 5.88 | 2.83 | 5.37 | 7.61 | 4.66 |
| + 运动→规划 bbox | 0.00 | 0.29 | 3.94 | 0.97 | 0.34 | 1.15 | 2.53 | 1.10 |
| + 运动→规划 query | 0.00 | 0.10 | 0.46 | 0.14 | 0.24 | 0.58 | 1.09 | 0.54 |
| + 地图→规划 BEV | 0.12 | 1.07 | 3.44 | 1.22 | 0.95 | 1.82 | 2.63 | 1.59 |
| + 地图→规划 query | 0.02 | 0.20 | 0.65 | 0.20 | 0.28 | 0.62 | 1.15 | 0.58 |
| + 占用→规划 BEV | 0.48 | 1.75 | 4.84 | 1.85 | 1.96 | 3.75 | 5.41 | 3.26 |
| + 占用→规划 query | 0.14 | 0.27 | 1.00 | 0.38 | 0.42 | 0.82 | 1.47 | 0.78 |
核心发现:
- 没有 BEV 特征时,仅靠自车状态+compact 输出(bbox/BEV)性能极差
- query 特征显著优于 compact 输出——高维隐式特征保留了更多信息
- 即使只传 query,也不如直接用 BEV 特征——BEV 特征经过联合训练已经足够好
- 结论:BEV 特征 + 充分联合训练 = 最优信息传递方式
| 传什么给规划 | Collision ↓ | L2 ↓ | 分析 |
|---|---|---|---|
| 仅 BEV 特征 | 最优 | 最优 | BEV 特征本身已包含丰富信息 |
| 仅紧凑输出(框/栅格) | 差 | 差 | 信息瓶颈,丢失细节 |
| query 特征(无 BEV) | 中 | 中 | 比紧凑输出好,但不如直接用 BEV |
关键发现:如果 BEV 特征经过充分的联合训练,直接用 BEV 特征作为规划的唯一输入就够用了——不需要上游模块再额外传递信息。
二、PARA-Drive 架构
基于以上发现,作者设计了 PARA-Drive——一个完全并行的端到端架构。
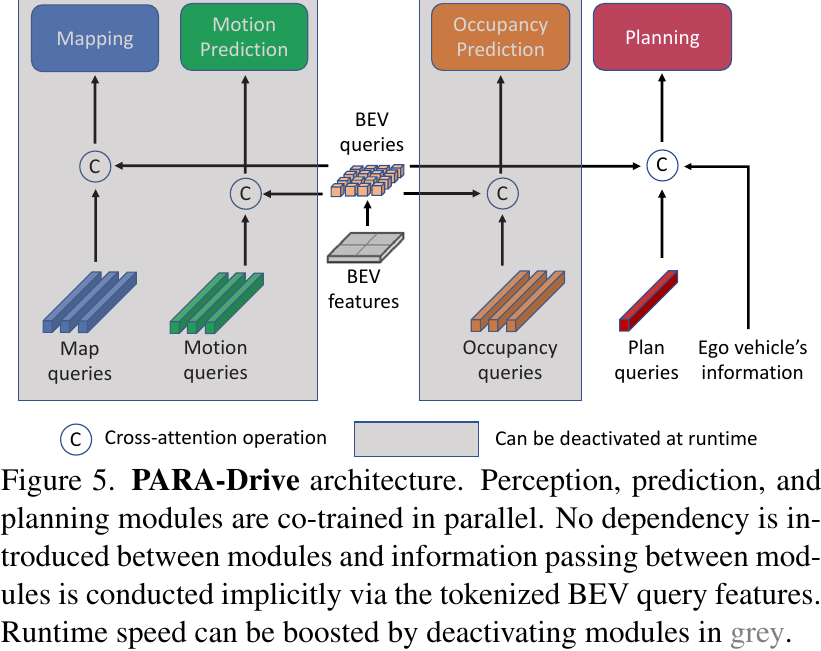
图 4:PARA-Drive 架构。 所有模块(在线地图、运动预测、占用预测、规划)完全并行,共享 BEV 特征。每个模块通过交叉注意力读取 BEV 特征中的信息。灰色模块(地图、运动、占用)在推理时可以按需关闭以提升速度。值得注意的是:模块之间没有任何直接连接——它们的唯一交互是通过共享的 BEV 特征和联合训练间接完成的。
2.1 整体数据流
多视图图像序列
       ↓
BEVFormer → BEV 特征(共享)
       ↓
    ┌────┬────┬────┬────┐
    │    │    │    │    │
  Map   Motion Occupancy Plan
  query query  query   query
    │    │    │    │
    ↓    ↓    ↓    ↓
  地图特征 轨迹  占用场  最终轨迹
   (可关) (可关) (可关)  (必须)
2.2 四个并行模块
1. 在线地图模块(Online Mapping)
- 用 Panoptic Segformer 风格的 query 从 BEV 特征中学习栅格化地图元素
- 输出:4 通道语义 BEV(road boundary, lane divider, pedestrian crossing, drivable area)
- 任务:保持模型对道路拓扑结构的感知
2. 运动预测模块(Motion Prediction)
- 用 agent query(~100 个)检测和追踪周围交通参与者
- 内部结构:agent query 先做 self-attention(建模 agent 间交互),再与 BEV 特征做 cross-attention
- 输出:每个目标的过去/未来轨迹、速度、朝向(检测框)
- 任务:理解动态目标的运动意图(实例级,稀疏)
3. 占用预测模块(Occupancy Prediction)
- 用 occ query 预测 BEV 空间中的当前帧 + 未来 3 帧占用栅格
- 输出:场景级占用场(200×200×4 栅格)
- 任务:提供运动预测之外的稠密空间约束(场景级,稠密)
4. 规划模块(Planning)
- 使用专有的规划 query,通过 cross-attention 从 BEV 特征中提取信息
- 自车状态嵌入:高层指令(直行/左转/右转)+ CAN bus 数据 + 历史轨迹
- 输出:未来 3 秒的 6 个 waypoint(每 0.5s 一个)
- ⚡ 独特优势:不需要从感知模块接收任何中间结果,BEV 特征就足够了
关键设计:这四个模块之间没有任何直接的信息传递。它们的唯一"对话"是在联合训练中通过共享的 BEV 特征间接完成的。规划模块接收的唯一感知信息就是 BEV 特征——不依赖地图输出、不依赖运动输出、不依赖占用输出。这完全消除了错误传播。
2.3 训练
所有模块同时训练(joint training),总损失是各模块损失之和:
\[ \mathcal{L} = \mathcal{L}_{map} + \mathcal{L}_{motion} + \mathcal{L}_{occ} + \mathcal{L}_{plan} \]各模块的损失设计继承自对应领域的标准做法:
地图模块损失(同 MapTRv2):
- 地图点坐标回归:L1 损失
- 地图元素分类:Focal 损失
- 输出类别:车道线、道路边界、人行横道等
运动预测模块损失(同 VAD):
- 检测 head:Focal 损失(分类)+ L1 损失(bbox 回归)
- 跟踪 head:匈牙利匹配 + 轨迹回归 L1 损失
- 未来轨迹预测:L1 损失 + 多模态分类损失
- 输出:每个智能体的位置、朝向、速度、未来轨迹
占用预测模块损失(同 OccNet):
- 当前帧占用分类:Focal 损失
- 未来帧占用分类:Focal 损失
- 占用边界细化:Lovász 损失
- 输出:当前 + 未来 3 秒的 BEV 占用栅格
规划模块损失:
- 未来轨迹 waypoint L1 损失(与 GT 轨迹的 L2 距离)
- 输出:未来 3 秒的 6 个 waypoint(同 UniAD/VAD)
梯度反向传播路径(这是理解并行训练的关键):
注意每条梯度路径是独立的——地图 loss 只回传到 BEV 特征和 backbone,不经过运动/占用/规划模块。规划 loss 也只回传到 BEV 特征和 backbone。这种并行梯度路径避免了串行设计中"规划 loss 要穿过运动模块再穿过地图模块"的深层反向传播问题。
训练细节:
- 骨干网络:ResNet-50 或 ResNet-101
- BEV 特征分辨率:200×200
- 输入图像分辨率:256×704(6 视图)
- 优化器:AdamW,学习率 2×10⁻⁴
- batch size:16
- 训练 epoch:36
- 数据增强:随机翻转、色彩抖动
2.4 推理(Inference)流程
PARA-Drive 的推理流程根据是否关闭辅助模块有两种模式:
全量模式(Full Mode):
轻量模式(Lightweight Mode):
2.5 推理时的灵活性
这是 PARA-Drive 的一个独特优势:推理时可以根据需要开关模块。
- 全量模式:所有模块都跑,性能最高,可解释性最好
- 轻量模式:关闭地图/运动/占用模块,仅保留规划和 BEV 特征提取。速度提升 2.7×,性能几乎不下降
- 混合模式:占用和运动每隔几帧跑一次,中间帧只做规划
这个灵活性来自并行设计——模块间没有依赖,关掉一个不影响其他的。
实验与结果
评估方法论贡献
在报结果之前,PARA-Drive 先做了一件非常重要的事:标准化了开放环规划评估方法。
之前 UniAD 和 VAD 的评估方法有显著的不一致:
| 不一致点 | UniAD 做法 | VAD 做法 | 影响 |
|---|---|---|---|
| L2 计算方式 | 对样本取平均 | 对样本和时间同时取平均 | VAD 的 L2 看起来更小 |
| 行人处理 | 排除行人 | 排除行人 | 不一致 |
| 碰撞检测 | 用中心点 | 用带朝向的 bbox | 中心点法会误报碰撞 |
PARA-Drive 提出了标准化评估协议,包括:
- 使用带朝向的 ego 车辆 bounding box 做碰撞检测
- 使用 finer-resolution BEV 离散化(消除 GT 轨迹的误报碰撞)
- 排除行人(只考虑车辆碰撞)
- 引入地图合规率(off-road rate + off-lane rate)
- 引入目标场景评估(仅包含转弯/变道等复杂场景)
主要结果
| 方法 | Collision Rates (%) ↓ | L2 (m) ↓ | Map Comp. (%) ↓ |
|---|---|---|---|
| Ave1,2,3s | Aveall | Ave1,2,3s | |
| UniAD | 0.45 | 0.40 | 0.9474 |
| VAD | 0.37 | 0.30 | 0.9086 |
| AD-MLP | 0.28 | 0.20 | 0.6632 |
| PARA-Drive | 0.26 | 0.17 | 0.6568 |
| PARA-Drive+ | 0.19 | 0.13 | 0.5885 |
(PARA-Drive+ 额外使用自车状态信息如 CAN bus、历史轨迹等)
关键结果:
- Collision 比 UniAD 降低 57.5%(0.40 → 0.17)
- L2 比 UniAD 降低 33.0%(0.8317 → 0.5574)
- Offroad 比 UniAD 降低 86.8%(0.91 → 0.12)
- Offlane 比 UniAD 降低 52.3%(1.74 → 0.83)
目标场景评估(转弯/变道)
在仅包含转弯和变道的 686 帧复杂场景上:
| 方法 | Collision ↓ | L2 ↓ |
|---|---|---|
| UniAD | 0.15 | 0.9935 |
| VAD | 0.34 | 1.0840 |
| AD-MLP | 0.94 | 0.9360 |
| PARA-Drive | 0.14 | 0.9082 |
| PARA-Drive+ | 0.05 | 0.7018 |
PARA-Drive+ 在复杂场景下的碰撞率仅 0.05%,几乎可以忽略不计。
推理速度
| 配置 | 推理时间 (ms) | FPS | 相对速度 |
|---|---|---|---|
| UniAD (R101) | ~400 | ~2.5 | 1× |
| VAD (R50) | ~50 | ~20 | 8× vs UniAD |
| PARA-Drive 全量 | ~135 | ~7.4 | 3× vs UniAD |
| PARA-Drive 轻量 (关其他模块) | ~50 | ~20 | 8× vs UniAD |
PARA-Drive 全量模式比 UniAD 快 3 倍,轻量模式快 8 倍。
感知和预测性能
| 方法 | 检测 mAP ↑ | NDS ↑ | 跟踪 AMOTA ↑ | 预测 minADE ↓ | 地图 IoU-lane ↑ |
|---|---|---|---|---|---|
| UniAD (R101) | 0.38 | 0.50 | 0.36 | 0.73 | 0.30 |
| PARA-Drive (R101) | 0.37 | 0.48 | 0.35 | 0.72 | 0.33 |
PARA-Drive 的感知预测性能与 UniAD 基本持平,甚至在地图任务上略有领先——并行设计没有损失感知质量。
关键设计分析
1. 为什么并行设计优于串行?
有三个原因:
错误传播消失:串行设计中,上游模块的误差(比如地图模块漏了一条车道线)会直接传给下游(运动预测和规划)。在并行设计中,每个模块直接从 BEV 特征中读取信息,一个模块的失误不会影响其他模块。
优化冲突减少:串行连接让梯度必须流经多个模块,可能导致梯度消失/爆炸或优化目标冲突。并行连接的梯度路径更短、更独立。
推理灵活性:串行模式下所有模块都必须跑(不然下游没输入)。并行模式下可以按需开关。
2. 为什么 BEV 特征比 query 特征更适合传给规划?
如果 BEV 特征经过充分的联合训练(所有模块都在 BEV 上做交叉注意力),它已经编码了场景的各方面信息——地图拓扑、目标位置、占用空间。规划模块直接用 BEV 特征就够了,不需要上游模块再"翻译"一遍。
这就像共享黑板:所有模块往黑板上写各自的信息,规划模块直接看黑板,不需要每个模块单独传纸条。
3. 为什么需要同时用运动预测和占用预测?
两者编码了互补的信息:
运动预测(轨迹):"那辆车会在第 3 秒到位置 (10, 20)"
占用预测(栅格):"位置 (10, 20) 在第 3 秒被占用"
运动预测提供了稀疏但实例级的信息,占用预测提供了稠密但场景级的信息。两者同时使用时,模型既知道"哪个物体在动",也知道"整个空间是否安全"。
4. 这个工作为什么重要?
PARA-Drive 最大的贡献不是架构本身,而是它做了之前没人做的事情——系统性地比较了不同设计选择。它通过消融实验告诉社区:
- 哪些模块是必要的(地图 + 运动 + 占用都需要)
- 模块应该怎么放(并行 > 串行 > 混合)
- 信息应该怎么传(BEV 特征 > query 特征 > 紧凑输出)
- 评估应该怎么做(标准化协议减少不公平对比)
这些结论在 PARA-Drive 之外也有很强的指导意义——后续任何端到端方法都可以用这些原则来指导自己的架构设计。
局限与反思
局限
第一,实验只在 nuScenes 开放环上做的,没有 CARLA 闭环评估。开放环评估只能验证"模型预测的轨迹和 GT 有多接近",不能验证"模型在真实交互中能不能安全驾驶"。这和 VADv2 在 CARLA 上做闭环是完全不同的验证维度。
第二,占用预测在 nuScenes 上的标注质量有限——占用栅格是从 3D 检测框渲染出来的,本身就有噪声。用这些标签训练的占用预测模块到底能学到多少真正的"场景理解"存疑。
第三,推理时关掉感知模块后,规划模块的输入只有 BEV 特征 + 自车状态——BEV 特征本质上还是从图像算出来的,所以感知模块关了之后 BEV 特征还在跑,实际节省的计算量并没有那么多。
和本系列其他论文的关系
PARA-Drive 在"端到端模块化架构"这条线上是一个承上启下的系统性工作——它不是提出了革命性的新模块,而是第一次系统回答了"这些模块该怎么连":
对比 UniAD(CVPR 2023,混合设计代表):UniAD 是以规划为中心的混合设计——TrackFormer→MapFormer→MotionFormer→OccFormer→Planner,部分串行部分并行。PARA-Drive 证明了完全并行更好——去除 TrackFormer→MapFormer 和 MotionFormer→Planner 的串行依赖后性能反而提升。但 UniAD 有两个 PARA-Drive 没有的东西:(1) 显式可解释性——每个中间模块的输出都可以可视化(检测框、轨迹、占用),而 PARA-Drive 的规划只依赖 BEV 黑盒特征;(2) 闭环验证——UniAD 在 CARLA 上做了闭环测试,PARA-Drive 只在 nuScenes 开放环上验证。
对比 VAD(ICCV 2023,向量化场景代表):VAD 用向量化场景 token 替代 UniAD 的稠密 BEV,简化了架构。PARA-Drive 在 VAD 的思路上更进一步——不仅简化场景表示,还简化了模块间连接。VAD 的推理速度已经很快(~50ms),PARA-Drive 的轻量模式与之接近,但全量模式提供了更好的可解释性和感知输出。
对比 OccNet(ICCV 2023,占用预测代表):OccNet 引入了显式占用预测模块,但没有实例级运动预测。PARA-Drive 通过消融实验证明两者都需要——占用预测提供场景级稠密约束,运动预测提供实例级稀疏信息,缺一不可。
对比 TransFuser(NeurIPS 2022,传感器融合代表):TransFuser 关注的是"不同传感器(相机 + LiDAR)的特征怎么融合",PARA-Drive 关注的是"不同任务模块之间怎么连接"。两者解决的问题完全正交,可以组合——把 TransFuser 的融合策略用在 PARA-Drive 的 BEV 特征提取上应该是有效的。
对比 BEVerse(arXiv 2022,多任务 BEV 代表):BEVerse 也是多任务 BEV 架构(检测+地图+运动预测),但它没有占用预测和规划模块,且各任务之间没有像 PARA-Drive 这样系统性地考虑连接方式。
对比 AD-MLP(arXiv 2023,纯状态规划代表):AD-MLP 证明了"只用自车状态(不看任何图像)就能达到不错的开放环规划指标",这对当时的社区是一个冲击。PARA-Drive 的标准化评估揭示了 AD-MLP 的真相——它在整体指标上确实不差,但在复杂场景(转弯/变道) 中 L2 误差和碰撞率远高于含感知的方法。AD-MLP 学到的是"统计平均轨迹"而不是"场景感知的轨迹",这在直行占多数的 nuScenes 中够用,但在真实部署中远远不够。
对比后续工作(VADv2, DriveTransformer, AutoMoT 等):PARA-Drive 的设计空间探索方法论影响了后续几乎所有端到端架构的设计——VADv2 继承了并行设计的思路(BEV 特征 + 独立任务 query),DriveTransformer 借鉴了模块化可组合的思想。可以说,PARA-Drive 为"怎么设计端到端模块化架构"建立了一个分析框架。
个人思考
一个被低估的贡献:评估标准化
PARA-Drive 的评估标准化工作很可能比架构本身更有长期影响力。在论文发表前,社区里 UniAD 和 VAD 比拼时使用的评估指标是不一致的——L2 计算方式不同、碰撞检测方式不同、过滤策略不同。这导致"VAD 比 UniAD 好"这个结论本身就不牢靠。PARA-Drive 把它们拉到同一基准下重新比较,发现差异远没有之前宣传的那么大。
这提醒我们:在自动驾驶开放环评估中,指标定义比模型设计更值得关注。 一个评估方法的不一致就可能完全颠覆结论。
为什么这个工作值得关注?
在 2023-2024 年,端到端自动驾驶的论文已经很多了,但大多数都在"加模块"——UniAD 加预测、OccNet 加占用、VAD 向量化。PARA-Drive 做了一个很少人做的事:做减法。它发现很多被认为是"必须"的模块间连接,去掉之后反而更好。
这给社区一个重要的启示:不是模块越多越好,而是模块之间的交互设计越合理越好。
并行设计的哲学
PARA-Drive 的核心理念——模块间依赖越少越好——其实是对软件工程"高内聚低耦合"原则的呼应。在传统自动驾驶中,模块间解耦是为了工程便利(可以独立开发/测试/部署);在端到端学习中,模块间解耦是为了训练稳定(梯度路径更短、不串扰)和推理灵活(按需开关)。这个发现对未来的架构设计有长远的指导意义。
另一个值得注意的点是:PARA-Drive 的并行设计实际上是一种"隐式集成"。每个模块从 BEV 特征中独立提取各自需要的信息,但它们的训练信号都反馈到 BEV 特征上,让 BEV 特征学习到"什么信息对所有人都有用"。这和集成学习中"多个弱学习器共同训练一个共享表示"的思路是相通的。
评估标准化的深远意义
PARA-Drive 对评估的贡献超出了它本身。在它之前,UniAD 和 VAD 的评估方法不一致导致社区对"到底谁更好"存在争议。PARA-Drive 把两者拉到同一基准上重新比较:
| 发现 | 影响 |
|---|---|
| VAD 的 L2 优势部分来自评估差异 | 社区不能再简单说"VAD 比 UniAD 在 L2 上好" |
| GT 轨迹也可能有"碰撞"(false positive) | 评估时需要更精细的碰撞检测 |
| map compliance 是关键的补充指标 | 单看 L2 和碰撞可能遗漏"开出路肩"的问题 |
| 目标场景评估能暴露模型真实弱点 | 直行占多数的评估会稀释模型在复杂场景中的差异 |
这对后续工作有很大的约束力——VADv2、DriveTransformer 等后续方法都参考了 PARA-Drive 的评估协议。
开放环 vs 闭环的根本差异
最后需要认真讨论一下:PARA-Drive 只在 nuScenes 开放环上验证。开放环评估本质上是"拟合轨迹"——给定当前场景,模型预测的轨迹和人类驾驶的 GT 轨迹有多接近。
但开放环好不等于闭环好,原因有三:
- 分布偏移:开放环中模型的预测不影响后续帧的输入(所有帧的传感器数据固定)。但闭环中模型的决策会影响下一帧看到什么——一个错误决策会把车带到训练数据分布之外的场景。
- 安全边际:人类驾驶的 GT 轨迹不一定是最安全的(可能离路肩很近、可能跟车很近)。开放环只要求"像人一样开",不要求"安全地开"。
- 自愈能力:开放环中错了就错了;闭环中模型需要能从错误中恢复。
这也是为什么 VADv2 在 CARLA 闭环的 85.1 DS 和 PARA-Drive 在 nuScenes 的 0.17% 碰撞率不能直接比较——验证维度不同。两者是互补的验证方式:开放环衡量"轨迹拟合精度",闭环衡量"安全交互能力"。
一句话总结:PARA-Drive = 系统性的设计空间探索(模块必要性 × 连接方式 × 信息传递)+ 完全并行的架构(4 个模块共享 BEV 特征,互不依赖)+ 标准化开放环评估(消除评估不一致)。它最核心的贡献是:用严谨的消融实验证明了"并行设计优于串行"这个设计原则,为后续端到端模块化架构提供了设计指南。
参考资料
- 论文:CVPR 2024 Open Access
- 项目页:xinshuoweng.github.io/paradrive
- 相关论文:UniAD [CVPR 2023], VAD [ICCV 2023], OccNet [ICCV 2023]