论文信息
- 标题:TransFuser: Imitation with Transformer-Based Sensor Fusion for Autonomous Driving
- 作者机构:图宾根大学(University of Tübingen) × MPI for Intelligent Systems(Kashyap Chitta, Aditya Prakash, Bernhard Jaeger, Zehao Yu, Katrin Renz, Andreas Geiger)
- arXiv:2205.15997(NeurIPS 2022,CVPR 2021 的期刊扩展版)
- 代码:github.com/autonomousvision/transfuser
- 一句话总结:用 Transformer 把相机图像和LiDAR 鸟瞰图的特征在多个分辨率上做密集融合,让两个模态"商量"着理解场景,再通过 GRU 自回归预测轨迹。在 CARLA Town05 比之前最好方法 DS 高 48%,碰撞降低 48%。
要解决什么问题:传感器融合不是"拼图",是"对话"
端到端自动驾驶的一个核心工程问题:车上装了多个传感器(相机、LiDAR、雷达),怎么把它们的特征真正融合起来?
之前的做法主要有两种:
| 融合方式 | 做法 | 问题 |
|---|---|---|
| Late Fusion(后融合) | 每个模态独立处理,最后把结果拼一起 | 错过模态间的细粒度交互信息 |
| Geometric Fusion(几何融合) | 把图像特征投影到 BEV 空间(基于已知的相机-LiDAR 外参)再拼接 | 依赖精确标定,在密集交通下无法捕捉复杂的交互场景 |
这两种方式的共同问题:融合是静态的、一次性的——图像和 LiDAR 的特征没有真正"交流"过。比如 LiDAR 看到了远处一辆车的点云但不知道是啥类型,相机能识别出"那是一辆卡车"但不知道它的准确距离——这两种信息应该在多个层次上反复交互,而不是到了最后一层才拼接。
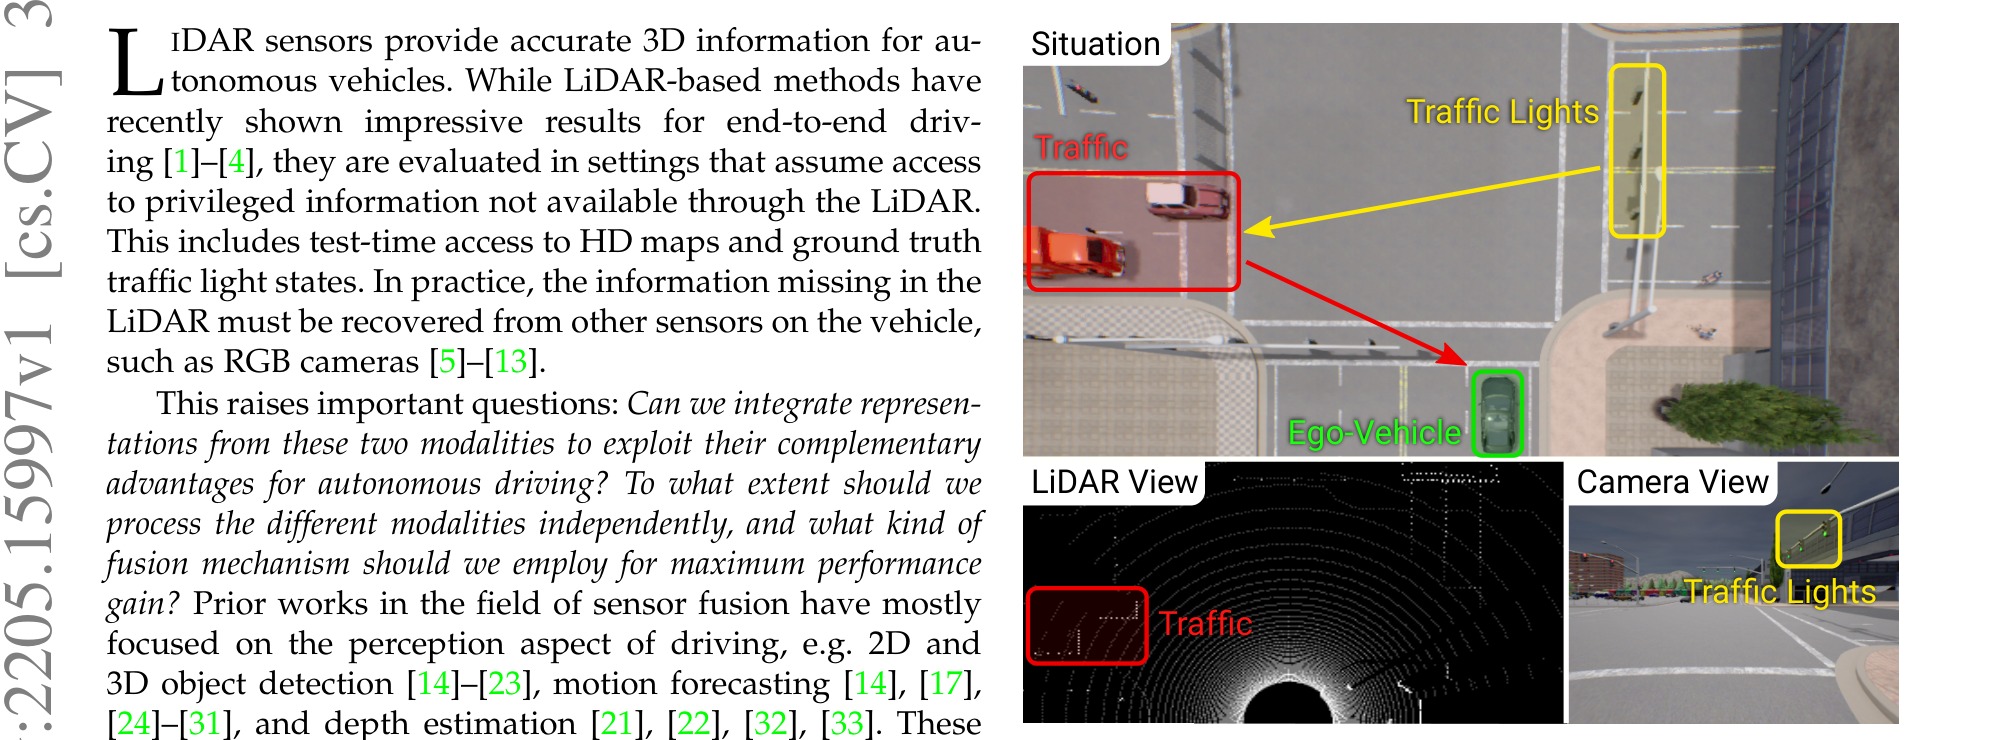
图 1:TransFuser 的核心动机。 相机提供丰富的语义信息(物体类别、交通灯颜色)但缺乏深度,LiDAR 提供精确的 3D 几何信息(距离、形状)但缺乏语义。TransFuser 的核心问题是:如何让这两种互补的传感器在特征层面充分交互?
核心思想:在多个分辨率上用自注意力做密集融合
TransFuser 的核心主张很简单但有效:
在 CNN 特征提取器的每个分辨率层级上,用 Transformer 的自注意力让图像特征和 LiDAR BEV 特征互相"看"对方一眼,把融合嵌入到特征提取的过程中,而不是放在最后。
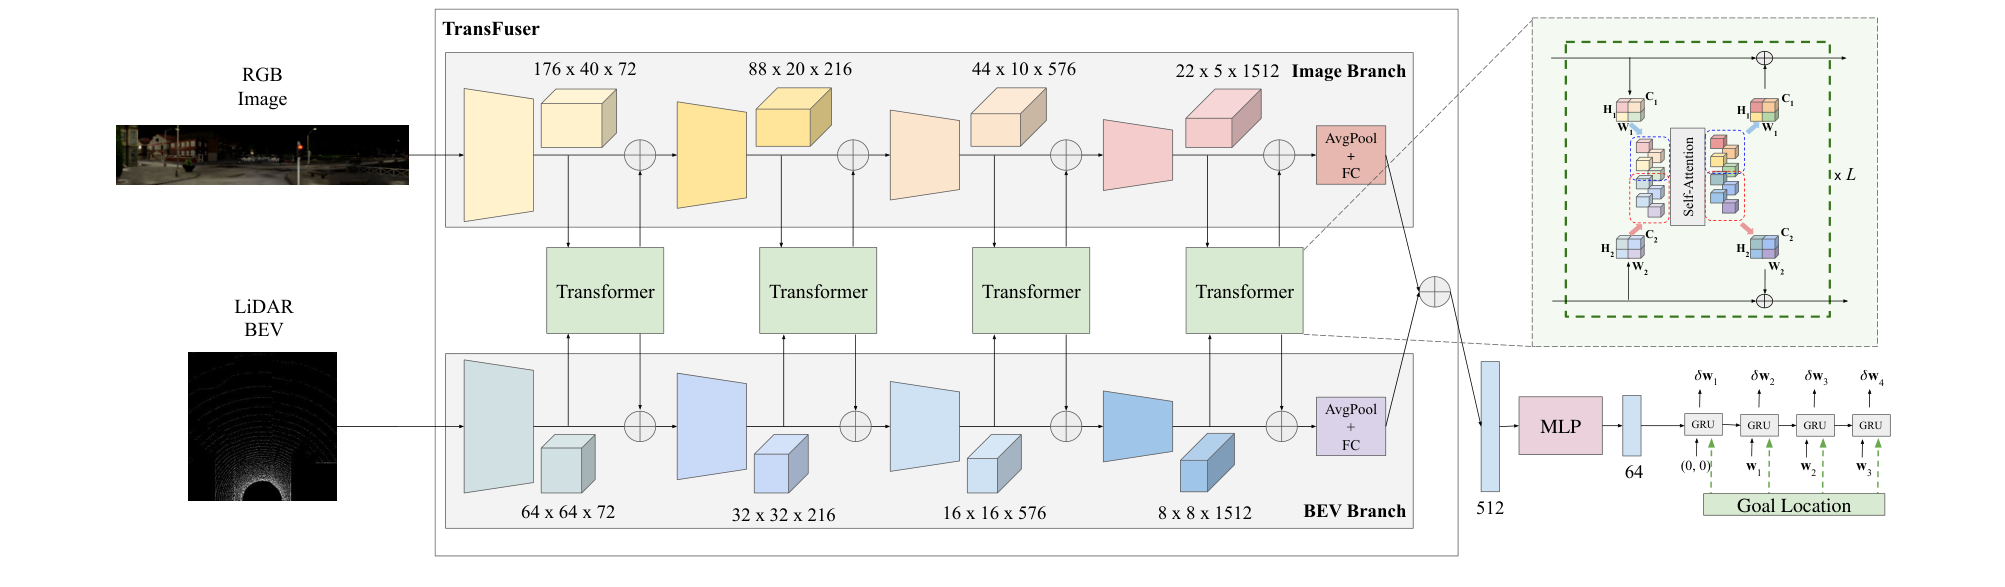
图 2:TransFuser 整体架构。 RGB 图像和 LiDAR BEV 分别经过独立的 CNN 特征提取器。在 4 个分辨率层级上,每个分支的特征被展平为 token 序列,经过 Transformer 做自注意力融合(让图像 token 和 LiDAR token 互相注意力),融合后的特征再 reshape 回原分辨率回到各自分支继续前向传播。最终两个分支的 512 维特征向量相加,经 MLP 降维后作为 GRU 的初始隐状态,自回归预测 4 个差分 waypoint。
整条数据流拆成四大步:
- 输入表示:RGB 图像(400×300) + LiDAR BEV(256×256,2 通道:高度 + 密度)
- 多分辨率 Transformer 融合:在 4 个分辨率层级上分别做自注意力,让图像和 LiDAR 特征密集交互
- 全局特征编码:融合后的特征 → AvgPool → FC → 512 维全局场景向量
- 自回归 waypoint 预测:512 维向量 → MLP(256, 128) → 64 维 → GRU 初始隐状态 → 逐 step 预测 4 个差分 waypoint → PID 控制器
下面逐块详细拆解。
方法详解
一、输入表示(Input Representation)
TransFuser 使用两种互补的传感器模态:
1. RGB 图像(相机)
- 单目前视相机,分辨率 400×300
- 提供丰富的语义信息(物体类别、颜色、纹理、交通灯状态、路标)
- 缺点:没有深度信息,单目测距不准
2. LiDAR BEV(激光雷达鸟瞰图)
- 将 LiDAR 点云投射到 256×256 的 BEV 栅格(每个像素对应 0.125m,覆盖 32m × 32m 区域)
- 每个栅格的2 个通道:
- 高度通道:该栅格内点云的最大高度(归一化到 [0,1])
- 密度通道:该栅格内点云的数量(对数归一化到 [0,1])
- 提供精确的 3D 几何信息(物体位置、距离、形状)
- 缺点:没有语义信息(不知道"这是一个行人")
互补关系:相机知道"那是什么",LiDAR 知道"它在哪"。关键是让两者在特征层面交互。
二、多分辨率 Transformer 融合(核心创新)
这是 TransFuser 最核心的模块。做法如下:
2.1 为什么在多个分辨率上融合?
CNN 的不同层编码了不同层次的信息:
- 浅层(高分辨率):边缘、纹理、局部几何
- 深层(低分辨率):语义类别、全局场景结构
TransFuser 选择在 4 个分辨率层级上都做融合(而不是只在最后一层),让信息在不同抽象层次间充分交换。
2.2 单层融合的具体操作(以其中一个分辨率为例)
图像分支特征图:尺寸 H₁ × W₁ × C₁
BEV 分支特征图:  尺寸 H₂ × W₂ × C₂

Step 1:展平为 token 序列
  图像 token: (H₁×W₁) 个,每个维度 C₁
  BEV token:  (H₂×W₂) 个,每个维度 C₂

Step 2:拼接所有 token
  总 token 数 = H₁×W₁ + H₂×W₂,统一维度 C(用 1×1 卷积对齐)

Step 3:加上可学习位置编码(让网络知道每个 token 的原始空间位置)

Step 4:送入 Transformer
  Q = Fin @ Mq, K = Fin @ Mk, V = Fin @ Mv
  A = softmax(QK^T / √D) @ V     ← 自注意力:每个 token 关注所有其他 token
  Fout = MLP(A) + Fin              ← 残差连接

Step 5:reshape 回原始分辨率
  融合后的特征拆分为图像部分和 BEV 部分,分别 reshape 回 H₁×W₁×C₁ 和 H₂×W₂×C₂

Step 6:元素相加回到原分支
  融合后的特征图 + 原分支特征图(残差连接)
关键理解:自注意力让图像 token 可以看到 LiDAR token 的信息,反之亦然。一个图像中的"红色圆形" token 可以通过注意力机制从 LiDAR 的某个 token 那里了解到"那个圆形在 15 米外"。
2.3 多尺度处理
由于高分辨率特征图 token 数量太大(计算量 O(N²)),Transformer 无法直接处理。TransFuser 的做法:
- 将高分辨率的特征图用 AvgPool 下采样到与低分辨率相同的尺寸
- Transformer 输出后用双线性插值上采样回原始分辨率
- 再与原始分支特征图元素相加
分辨率层级:
  Level 1: Image (176×40→22×5)  + BEV (64×64→8×8)
  Level 2: Image (88×20→22×5)   + BEV (32×32→8×8)
  Level 3: Image (44×10→22×5)   + BEV (16×16→8×8)
  Level 4: Image (22×5)          + BEV (8×8)
  (→ 后的尺寸是 AvgPool 下采样后的 token 数量)
每个 TransFuser 模块有 L=4 层,每层 4 个注意力头。
2.4 全局特征
经过 4 层融合后,两个分支各自输出的特征图经过 AvgPool → FC 压缩为 512 维向量,然后元素相加得到最终的全局场景特征。
关键认知:这 512 维向量不是简单的"图像特征 + BEV 特征",而是经过了多层次自注意力交互后的联合嵌入——它既包含了图像的语义信息,也包含了 LiDAR 的几何信息,更重要的是,它编码了两个模态之间的对应关系(比如"这个像素对应的那个点云")。
三、Waypoint 预测网络
全局特征向量不直接预测方向盘/油门,而是预测轨迹 waypoint,再由 PID 控制器转为控制信号。
3.1 自回归 GRU 解码器
输入:512 维全局特征
→ MLP(512→256→128→64)
→ 64 维向量作为 GRU 初始隐状态 h₀

for t = 1 to 4:
    输入:当前点 w_{t-1}(第一个点为 (0,0))+ 目标位置 G
    输出:差分 waypoint δw_t
    最终 waypoint:w_t = w_{t-1} + δw_t
每个 step 预测差分 waypoint(相对于上一步的位移),而不是绝对坐标。这样更稳定——模型只需预测"下一步往哪走",而不是直接猜"终点在哪"。
目标位置 G(GPS 坐标,已转换到自车坐标系)作为额外输入,确保轨迹朝着导航方向前进。
3.2 PID 控制器
预测的 4 个 waypoint → 两个 PID 控制器:
- 纵向 PID:根据 waypoint 间的距离计算目标速度 → 油门 / 刹车
- 横向 PID:根据 waypoint 间的方向计算目标转角 → 方向盘
此外还有一个蠕行机制(Creeping):如果车停了超过 55 秒(红灯排队等情况),就设定目标速度 4 m/s 蠕动 1.5 秒,防止模型在"停车"状态陷入死循环。蠕行时用 LiDAR 检测前方是否有障碍物,有就取消蠕行(安全启发式)。
四、辅助任务(Auxiliary Tasks)
只靠 4 个 waypoint 的 L1 损失监督是不够的——场景太复杂,梯度信号太稀疏。TransFuser 加了 4 个辅助任务,让中间特征学到更丰富的场景表示:
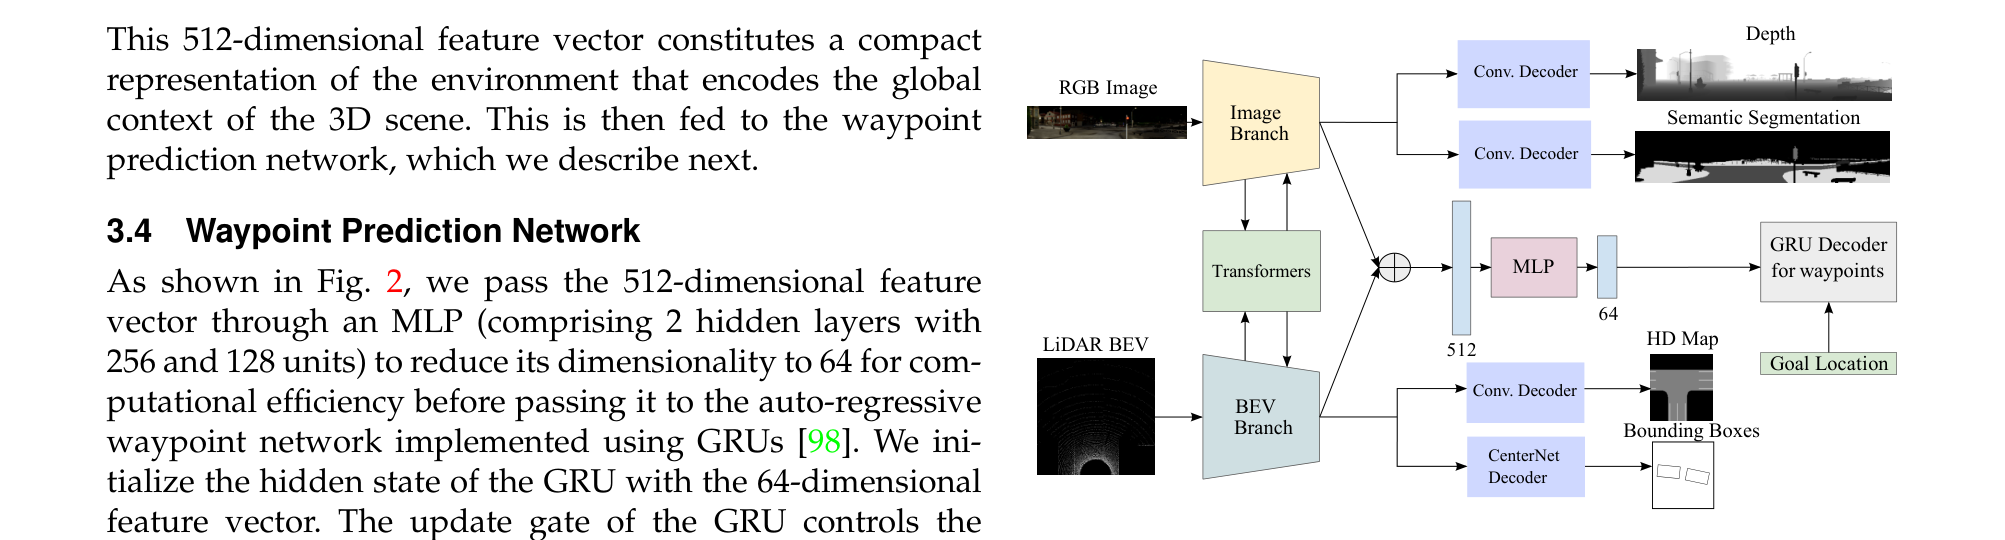
图 3:辅助损失。 除了 waypoint L1 损失,还有 4 个辅助任务。
| 辅助任务 | 分支 | 解码器 | 损失 | 作用 |
|---|---|---|---|---|
| 深度估计 | 图像 | Conv Decoder | L1 | 让图像特征学到距离信息,弥补 LiDAR 缺失时的深度线索 |
| 语义分割 | 图像 | Conv Decoder | 交叉熵(7 类) | 让图像特征识别道路、车辆、行人、红绿灯等语义 |
| HD 地图预测 | BEV | Conv Decoder | 交叉熵(3 类) | 让 BEV 特征编码可通行区域 |
| 车辆检测 | BEV | CenterNet Decoder | Focal + CE + L1 | 让 BEV 特征感知周围车辆位置和朝向 |
为什么辅助任务重要:它们提供了强力的中间监督,确保中间特征图不仅仅服务于 waypoint 预测,还编码了场景的各种结构化信息。这相当于把"暗盒"的特征提取变成了"带语义标签"的特征提取。
五、损失函数详解
TransFuser 的总训练损失由 5 个部分组成,每个的数学形式和设计动机如下:
5.1 Waypoint 预测损失(主损失)
\[ \mathcal{L}_{\text{waypoint}} = \sum_{t=1}^{T} ||w_t - w_t^{gt}||_1 \]- T=4(预测 4 个未来 waypoint,对应 2 秒,间隔 0.5 秒)
- 使用 L1 而非 L2:L1 对大误差的惩罚更温和,在驾驶场景中更鲁棒(突然的大误差可能是标注噪声而非真正的危险)
- 差分形式 \(w_t = w_{t-1} + \delta w_t\):预测位移增量而非绝对坐标,训练更稳定
5.2 深度估计损失
\[ \mathcal{L}_{\text{depth}} = ||\hat{D} - D^{gt}||_1 \]- 从图像分支特征经卷积解码器输出深度图 \(\hat{D}\)
- GT 深度 \(D^{gt}\) 由 LiDAR 点云投影到图像平面得到
- 作用:迫使图像特征编码距离信息,弥补单目缺少深度模态时的线索
5.3 语义分割损失
\[ \mathcal{L}_{\text{semantic}} = \text{CrossEntropy}(\hat{S}, S^{gt}) \]- 7 类:未标注、车辆、道路、红灯、行人、车道标线、人行道
- 从图像分支特征解码
- 作用:让图像特征学会识别关键语义元素,尤其是红灯和行人这类规划决策的关键信号
5.4 HD 地图预测损失
\[ \mathcal{L}_{\text{HDmap}} = \text{CrossEntropy}(\hat{M}, M^{gt}) \]- 3 类:道路、车道标线、其他
- 从 BEV 分支特征经卷积解码器输出 64×64 的 BEV 分割图
- 作用:让 BEV 特征编码可通行区域和道路结构
5.5 车辆检测损失
\[ \mathcal{L}_{\text{detection}} = \mathcal{L}_{\text{focal}}(\hat{P}, P^{gt}) + \mathcal{L}_{\text{CE}}(\hat{O}, O^{gt}) + ||\hat{R} - R^{gt}||_1 \]- CenterNet 风格解码器,从 BEV 特征输出:
- 位置热力图 \(\hat{P}\):Focal 损失(检测车辆中心)
- 粗方向分类 \(\hat{O}\):交叉熵损失(12 类,每类 30°)
- 精方向回归 + 尺寸 + 位置偏移 \(\hat{R}\):L1 损失
- 作用:让 BEV 特征感知周围车辆的精确位置、朝向和尺寸
5.6 总损失与权重
\[ \mathcal{L} = \mathcal{L}_{\text{waypoint}} + \mathcal{L}_{\text{depth}} + \mathcal{L}_{\text{semantic}} + \mathcal{L}_{\text{HDmap}} + \mathcal{L}_{\text{detection}} \]所有权重设为 1(简单均匀加权)。作者在消融实验中验证了每个辅助任务都有正向贡献,但没有做精细的权重搜索——这是一个简化设计,后续工作可以用不确定性加权或 GradNorm 进一步优化。
训练:Expert 数据生成
数据如何获取
TransFuser 的训练数据通过一个规则专家在 CARLA 中采集:
- 228k 帧数据,来自 8 个 CARLA 城镇
- 包含约 2500 条城区路口路线(平均 100m)+ 1000 条高速公路路线(平均 400m)
- 每 0.5 秒存一帧(2 FPS)
专家策略(Expert Policy)
专家使用特权信息(仿真器提供的 ground truth)来生成完美轨迹:
- A* 全局规划器:生成从起点到终点的粗粒度路径
- 横向 PID:沿着 A* 路径行驶,最小化与路径的角度偏差
- 纵向 MPC:分 3 档目标速度
- 正常:4.0 m/s
- 路口内:3.0 m/s
- 预测到碰撞/闯红灯:0.0 m/s(停车)
- 碰撞预测:用预训练的自行车模型(Bicycle Model) 预测未来 4 秒所有车辆的运动轨迹(路口场景)或 1 秒(其他场景),检测是否会碰撞
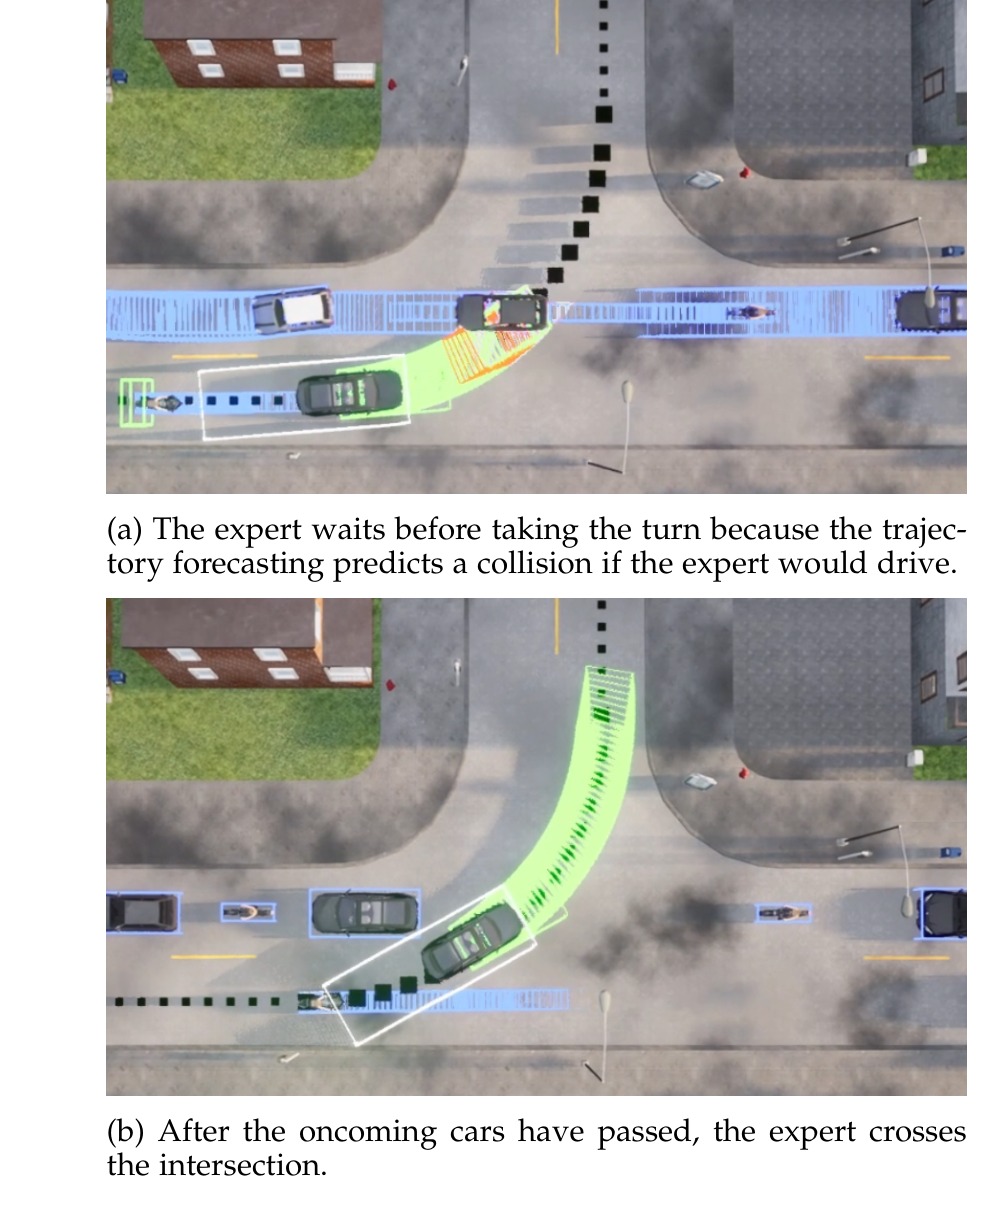
图 4a:专家在路口等待。 自行车模型预测如果此时左转会撞到对向车辆,所以专家选择停车等待。
图 4b:对向车流通过后,专家完成左转。 碰撞预测显示安全后,专家加速通过路口。
推理:从图像到控制信号
TransFuser 的推理流程是完整的端到端链路,不依赖任何规则后处理(除了蠕行安全启发式):
推理流程(每帧)
多视图图像 (400×300) + LiDAR 点云
       ↓
图像分支 CNN + BEV 分支 CNN(并行,4 层 TransFuser 融合)
       ↓
两个 512 维特征向量 → 元素相加 → 全局场景特征
       ↓
MLP(512→256→128→64) → 64 维向量
       ↓
GRU 自回归解码(4 step,每步输入上一步位置 + 目标位置)
       ↓
4 个差分 waypoint → 累加得到 4 个绝对 waypoint
       ↓
PID 控制器(横向 + 纵向)
       ↓
方向盘转角 + 油门 + 刹车
每一步的细节
Step 1:传感器输入
- RGB 图像:单目前视,400×300 分辨率
- LiDAR 点云:投影为 256×256×2 的 BEV 栅格(高度通道 + 密度通道)
Step 2:多分辨率融合
- 图像分支和 BEV 分支各自独立做卷积
- 在 4 个分辨率层级上,特征被展平、拼接、送入 Transformer(L=4, heads=4)
- 融合后再 reshape 回原分辨率,与原始特征相加
Step 3:全局特征
- 两个分支最终的特征图(22×5×C 和 8×8×C)分别 AvgPool + FC 到 512 维
- 两个 512 维向量元素相加得到全局场景向量
Step 4:Waypoint 解码
- 全局向量经 MLP 降为 64 维,作为 GRU 初始隐状态
- GRU 逐 step 解码 4 个 waypoint,每步输入目标位置 G
Step 5:PID 控制
- 横向 PID:根据 waypoint 间的方向算方向盘转角
- 纵向 PID:根据 waypoint 间的距离算目标速度 → 油门/刹车
- PID 参数:横向 Kp=1.25 Ki=0.75 Kd=0.3,纵向 Kp=5.0 Ki=0.5 Kd=1.0
Step 6:安全蠕行
- 如果车静止超过 55 秒,设定目标速度 4 m/s 蠕动 1.5 秒
- 蠕动前用 LiDAR 检测前方有无障碍物
推理配置
| 配置项 | 值 |
|---|---|
| 帧率 | 实时(27.6 ms/帧 ≈ 36 FPS) |
| 硬件 | 单张 RTX 3090 |
| 集成方式 | 单模型或 3 模型集成(集成时 59.6 ms/帧 ≈ 17 FPS) |
| 后处理 | 仅蠕行安全启发式,无规则轨迹修正 |
实验与结果
Longest6 基准
为了能在本地高效评估,作者提出了 Longest6 基准:
- 从 CARLA 官方的 76 条路线中选出每个城镇最长的 6 条路线(共 36 条)
- 平均路线长度 1.5 km(接近官方 Leaderboard 的 1.7 km)
- 最高密度交通 + 6 种天气 × 6 种光照组合
- 包含 NHTSA 预碰撞场景(急刹、变道冲突等)
主要结果
| 方法 | DS ↑ | RC ↑ | IS ↑ | Veh ↓ | Collisions/km 对比 |
|---|---|---|---|---|---|
| Late Fusion (LF) | 22.47 | 83.30 | 0.27 | 4.63 | - |
| Geometric Fusion (GF) | 27.32 | 91.13 | 0.30 | 4.64 | - |
| LAV | 32.74 | 70.36 | 0.51 | 0.83 | - |
| Latent TransFuser (image only) | 37.31 | 95.18 | 0.38 | 3.66 | - |
| TransFuser (image + LiDAR) | 47.30 | 93.38 | 0.50 | 2.45 | 比 GF 降 48% |
| Expert (upper bound) | 76.91 | 88.67 | 0.86 | 0.28 | - |
核心发现:
- TransFuser 的 DS 比最好的几何融合(GF)高 20 分(+73%)
- 每公里碰撞次数从 4.64(GF)降到 2.45(TransFuser),降低 48%
- 即使只用相机的 Latent TransFuser 也比 LAV 等完整方法高
| 方法 | 输入模态 | DS | RC | IS |
|---|---|---|---|---|
| CILRS | Image | 7.0 | 64.6 | 0.10 |
| NEAT | Image | 15.1 | 66.4 | 0.22 |
| LAV | C+L | 32.7 | 70.4 | 0.51 |
| Latent TransFuser | Image | 37.3 | 95.2 | 0.38 |
Latent TransFuser 纯相机的 DS 超过了使用 LiDAR 的 LAV——说明 Transformer 注意力融合带来的提升,在某些情况下甚至比增加一个传感器还大。
消融实验详解
为了搞清楚每个设计的贡献,作者做了一组系统的消融实验:
1. Transformer 深度(L)
| 层数 L | DS | 分析 |
|---|---|---|
| 1 | 37.5 | 一次注意力交互不够,融合不够充分 |
| 2 | 43.4 | 更多的交互带来了显著提升 |
| 4 | 47.3 | 最佳深度,充分交互又不过度 |
| 8 | 40.6 | 层数太多反而过拟合或优化困难 |
2. 注意力头数
| 头数 | DS | 分析 |
|---|---|---|
| 1 | 45.4 | 单头表达能力有限 |
| 4 | 47.3 | 多头能关注不同方面的跨模态关系 |
| 8 | 43.3 | 头太多可能引入噪声或参数量过大 |
3. 安全启发式的影响
| 安全启发式 | DS | Veh↓ | Ped↓ |
|---|---|---|---|
| 无 | 45.2 | 3.61 | 0.06 |
| 仅蠕行时 | 47.3 | 2.45 | 0.03 |
| 全程启用 | 40.9 | 2.28 | 0.03 |
全程启用反而降低 DS——太保守导致很多该过的时候不过(比如路口等待时不敢走)。
CARLA Leaderboard
在官方的 100 条秘密路线上,TransFuser 提交时在所有已发布方法中排名第一。
跨模态注意力统计
为了验证 Transformer 是否真的在做跨模态交互,作者统计了每层中"至少有一个 top-5 关注 token 来自另一个模态"的比例:
| Transformer | Head 1 | Head 2 | Head 3 | Head 4 |
|---|---|---|---|---|
| T1(最高分辨率) | Image→LiDAR: 100%, Li→Im: 0% | 100%, 0% | 100%, 0% | 100%, 1.5% |
| T2 | 99.8%, 0% | 99.9%, 0% | 39.7%, 0% | 99.9%, 0.3% |
| T3 | 44.6%, 98.7% | 7.6%, 99.0% | 27.7%, 98.1% | 99.9%, 99.9% |
| T4(最低分辨率) | 77.8%, 89.9% | 80.1%, 95.9% | 90.1%, 99.9% | 80.1%, 99.5% |
关键发现:
- T1、T2(高分辨率):Image→LiDAR 接近 100%,但 Li→Im 接近 0%。说明图像 token 大量关注 LiDAR token(索要几何信息),但 LiDAR token 几乎不看图像(浅层的 LiDAR 特征已经够用)
- T3、T4(低分辨率):双向都很高。说明在语义层级上,两个模态需要双向沟通——图像需要知道 LiDAR 的精确位置,LiDAR 需要知道图像的语义标签
这个统计有力地证明了 TransFuser 的注意力机制确实在做有意义的跨模态信息交换,而不是学了一个恒等映射或位置编码。
推理速度
| 方法 | 单模型 | 集成 3 个模型 |
|---|---|---|
| Late Fusion | 23.5 ms | 46.7 ms |
| Geometric Fusion | 43.5 ms | 69.1 ms |
| TransFuser | 27.6 ms | 59.6 ms |
TransFuser 在单 RTX 3090 上 >36 FPS,完全可以实时运行。
注意力可视化
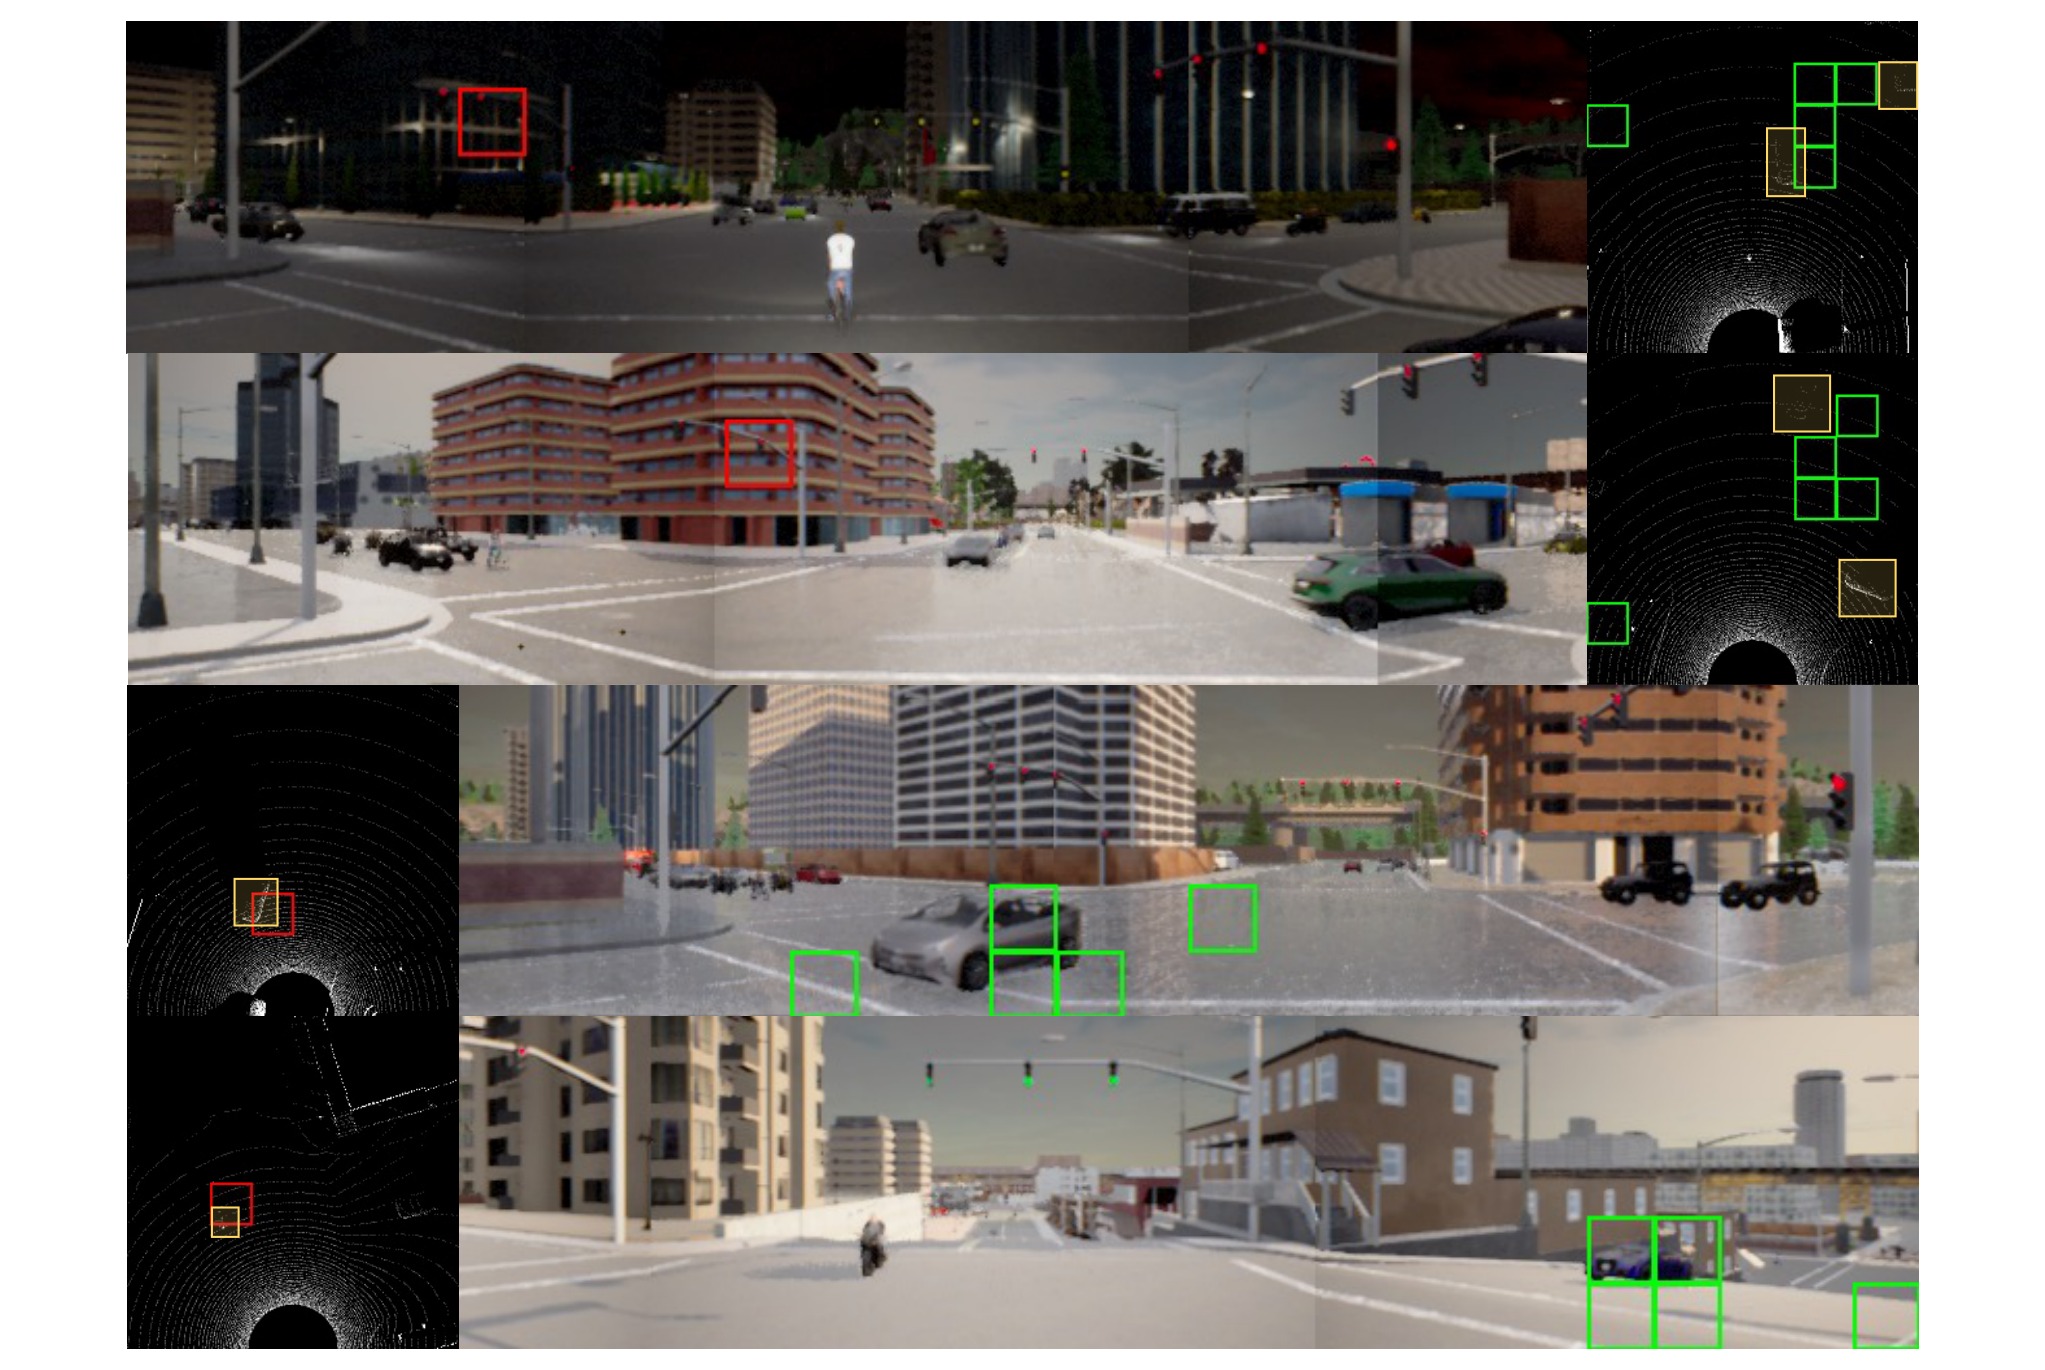
图 5:注意力可视化。 对于红色标记的 query token,绿色标记了 top-5 高注意力权重的 token(来自另一个模态)。上方 4 行是图像 token 关注 LiDAR token 的区域,下方 4 行是 LiDAR token 关注图像 token 的区域。可以看到 TransFuser 的注意力高度集中在车辆、行人、交通灯等关键目标周围——说明模型学会了跨模态关注"什么重要"。
与 Expert 的差距分析
| 指标 | TransFuser | Expert | 差距 |
|---|---|---|---|
| DS | 47.30 | 76.91 | 38.5% |
| RC | 93.38 | 88.67 | Expert 路线更保守 |
| IS | 0.50 | 0.86 | 碰撞/违规是主要瓶颈 |
| Veh/km | 2.45 | 0.28 | 8.7× |
| Stat/km | 0.07 | 0.01 | 7× |
RC 比 Expert 还高(93 vs 89)——说明 TransFuser 在"走完全程"上已经接近甚至超过专家。但碰撞次数是专家的 8.7 倍,这是所有模仿学习方法的通病:模型学到了一般情况怎么开,但在边界情况下缺少专家的安全感知能力。
关键设计分析
1. 为什么在多个分辨率上做融合?
| 融合策略 | 做法 | 表现(DS) |
|---|---|---|
| 仅在最高分辨率融合 | 只在前 2 层做 | 35.2 |
| 仅在最低分辨率融合 | 只在后 2 层做 | 39.8 |
| 全部 4 层融合 | 所有分辨率都做 | 47.3 |
浅层特征包含位置/边缘信息,深层特征包含语义信息——两者都需要跨模态交互。
2. 为什么用自注意力(self-attention)而不是交叉注意力?
自注意力让所有 token 互相看,包括同模态内部和跨模态。这样:
- 图像内部的 token 可以互相交互(全局上下文)
- LiDAR 内部的 token 可以互相交互
- 图像 token 可以关注 LiDAR token(跨模态融合)
- LiDAR token 可以关注图像 token
统一在一个注意力矩阵里完成,不需要设计复杂的跨模态路由。
3. 为什么用 waypoint 而不是直接控制信号?
waypoint 比控制信号更平滑、更可解释。方式:
- 预测 4 个差分 waypoint(L1 损失)
- PID 将 waypoint 转为控制信号
- PID 控制器本身是固定的、物理可解释的(比例 P → 误差大小,积分 I → 历史累积误差,微分 D → 误差变化趋势)
局限与反思
TransFuser 的局限
第一,碰撞仍然偏多(每公里 2.45 次 vs Expert 的 0.28 次)。主要失败场景是密集交通下的变道和无保护左转——模型在需要精确时机判断的场景中表现不佳。
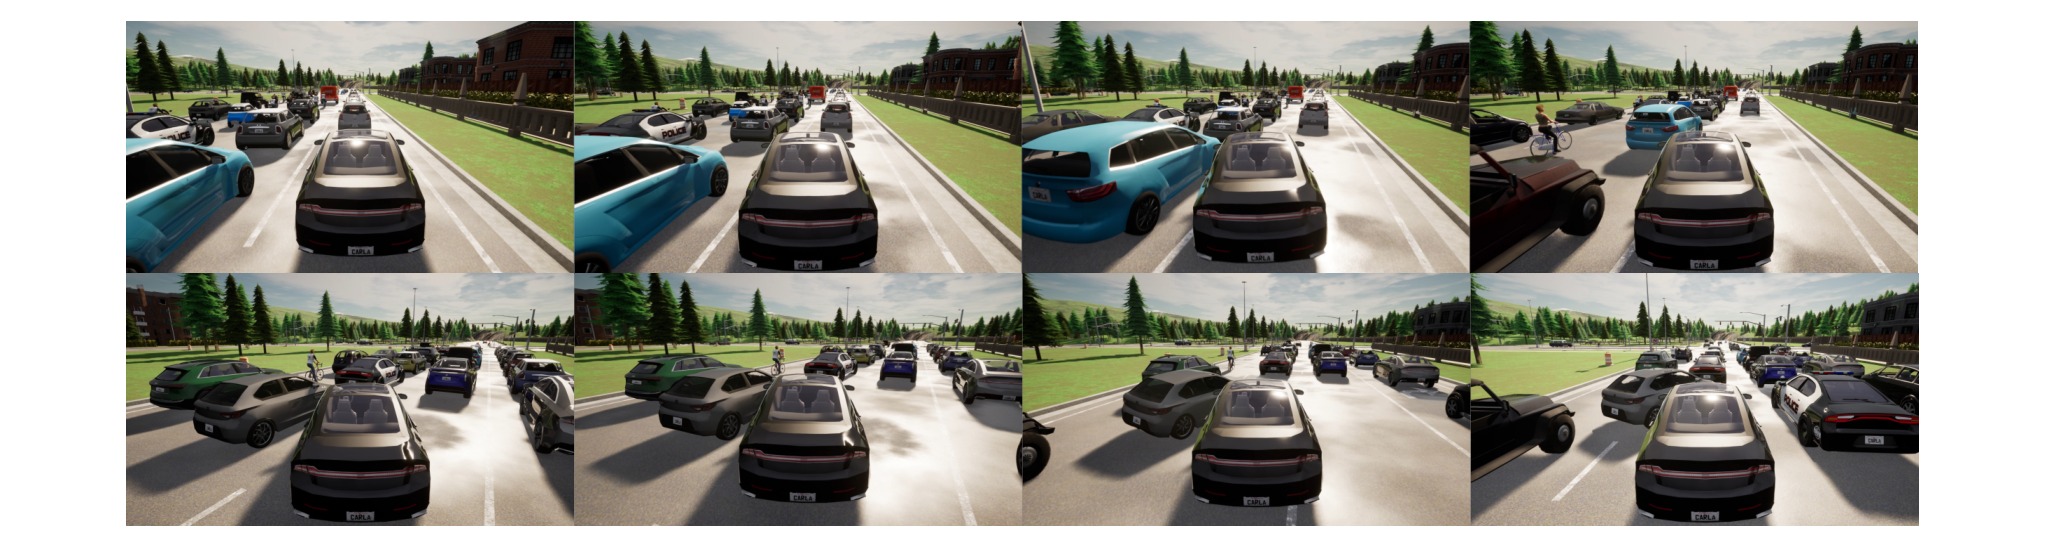
图 6:变道失败。 在密集交通中变道时,TransFuser 容易连续碰撞。这是所有模仿学习方法在高密度交互场景下的共同难题。
第二,依赖 LiDAR 输入。Latent TransFuser 虽然比之前的方法好,但 DS 37.31 仍然远低于 47.30——说明 LiDAR 的精确几何信息对端到端驾驶来说仍然是不可或缺的。
第三,辅助任务的损失权重都是简单设置为 1,没有学习自适应权重。后续工作可以用不确定性加权或 GradNorm 来优化。
和本系列其他论文的关系
TransFuser 在"端到端驾驶规划"这条线上是一个早期的奠基作品。它发表于 2021 年 CVPR,是第一个将 Transformer 成功应用于端到端驾驶传感器融合的工作:
对比 NEAT(2021,注意力 BEV 变换派):NEAT 也是用注意力从图像生成 BEV 表示,但 NEAT 做的是单向投影(图像→BEV),而且需要测试时迭代优化注意力。TransFuser 做的是双向密集融合(图像↔BEV)且是一次前向传播,两者互为补充。
对比 UniAD(2023,规划中心派):UniAD 把"以规划为中心"的方法系统化,TransFuser 更关注"怎么把传感器特征融合好"。两个工作在架构层面共享一个直觉——多层级多模态交互。UniAD 的 TrackFormer/MapFormer 在 BEVFormer 的特征上叠加注意力模块,和 TransFuser 在 CNN 各层插 Transformer 的思路是相通的。但 UniAD 是纯视觉的(400×300 单目),而 TransFuser 验证了相机 + LiDAR 互补的优势。
对比 AIM(2023,TransFuser 扩展):AIM 由同一团队提出,直接把 TransFuser 的架构用在了多帧时序设定下,并且用 discrete action space 替代了 waypoint 预测。它证明了 TransFuser 的设计不只是"单帧融合有用",扩展到时序后同样受益。
对比 VAD / VADv2(2023-2025,向量化派):VAD 系列用向量化 scene token(几百个稀疏 token)替代了 TransFuser 的稠密 BEV 特征图(64×64),效率更高。但 TransFuser 奠定的"让不同模态在多个分辨率上交互"这个原则在 VAD 系列中被继承——BEVFormer 本质上是用 attention 在多视图图像之间做融合。
对比 TCP / ThinkTwice / DriveAdapter(2022-2024,安全派):这些工作在 TransFuser 之上增加了安全约束、两阶段推理、或 adapter 微调。TransFuser 相当于它们的"发动机"——提供了可靠的多模态场景表示,上层再加安全策略。
对比 DriveMLM(2024,LLM 派):TransFuser 和 DriveMLM 代表了两种完全不同的路线。TransFuser 用 CNN + Transformer 做紧凑特征编码,轻量高效(27.6ms);DriveMLM 用 LLM 做推理,可解释但延迟高。两者本质上正交——TransFuser 关注"感知融合怎么做",LLM 方法关注"推理怎么做"。
个人思考
从历史视角看 TransFuser 的定位
2021 年是自动驾驶端到端学习的一个关键转折点。在此之前,CARLA 上的主流方法要么是 CILRS 那种直接回归控制信号的简单方法(DS 不到 10),要么是做 RL(训练极其不稳定)。TransFuser 的出现改变了这个局面——它第一次证明了"一个设计良好的端到端模型"可以跑出有实际意义的结果。
但 TransFuser 也暴露了模仿学习的根本局限:行为克隆只能学到训练数据里的模式,而驾驶中的安全边界大部分在数据分布之外。 这个问题直到 VADv2 的 conflict loss(2025)和 GRPO 系列的 RL 搜索(2026)才有更系统的解决。从这条线看过去,TransFuser 是"第一块踏脚石"——它证明了"这条路能走通",后续工作才能沿着这个方向精进。
三个值得记住的设计哲学
1. “融合不是最后一层的事,是每层的事”
这是 TransFuser 最有价值的设计原则。两个模态的特征在浅层、中层、深层各自有不同的表现形式——浅层需要融合几何信息,深层需要融合语义信息。只在最后一层融合等于"让两个人在完全不交流的情况下分别完成任务,到最后才拼答案"。
2. “自注意力比交叉注意力更适合这个任务”
虽然直觉上"图像看 LiDAR,LiDAR 看图像"应该用交叉注意力,但 TransFuser 选择自注意力——因为同模态内部的交互也有价值。图像内部的远距离像素需要互相理解上下文(比如"远处的红绿灯和近处的停车线"之间的关系),自注意力在一个矩阵里同时完成了模态内和跨模态两种交互。
3. “差分预测 + PID 控制比直接预测控制信号更稳定”
预测差分 waypoint($w_t = w_{t-1} + \delta w_t$)而不是绝对坐标,这个设计在后续几乎被所有基于 waypoint 的方法继承(UniAD、VAD、ThinkTwice)。它其实是"残差学习"思想在轨迹预测上的体现——预测的变化量比绝对量小、更稳定。
与 VADv2 / UniAD 的对比
从架构设计角度来看三个工作的演进非常清晰:
| 维度 | TransFuser (2021) | UniAD (2023) | VADv2 (2025) |
|---|---|---|---|
| 传感器 | 相机 + LiDAR | 纯相机(6 视图) | 纯相机(6 视图) |
| 场景表示 | 稠密 BEV 特征图 | BEV 特征 + query | 向量化 scene token |
| 模态融合 | 多分辨率自注意力 | BEVFormer(BEV 空间注意力) | BEVFormer(继承) |
| 规划方式 | 确定性回归(GRU waypoint) | 确定性回归(GRU waypoint) | 概率分布(sigmoid + 采样) |
| 辅助任务 | 深度/语义/地图/检测 | 全栈(检测/跟踪/地图/运动/规划) | 地图/agent/交通元素 |
| 推理速度 | 27.6 ms | ~50 ms | ~40 ms |
| DS (Town05) | 47.30 | 31.0 | 85.1 |
从 TransFuser 到 UniAD,核心变化是从"传感器融合驱动"变成"规划目标驱动"——UniAD 证明让所有任务都服务于规划目标比单纯做融合更有效。再到 VADv2,核心变化是从"确定性"变成"概率性"——承认驾驶的不确定性,把规划从回归变成分类。
但 TransFuser 的贡献没有因为这些进步而贬值。相反,它确立的"多分辨率跨模态交互"这个设计原则,在 BEVFormer 和后续所有 BEV 方法中都以不同形式被继承了下来。
一句话总结:TransFuser = 双分支 CNN(图像 + LiDAR BEV)+ 4 层多分辨率自注意力融合 + GRU 自回归 waypoint 预测 + 4 个辅助任务(深度/语义/地图/检测)。它最核心的贡献是:证明了"在特征提取过程中做多分辨率跨模态注意力"可以取代"几何投影后融合"——这个设计原则影响了后续几乎所有端到端驾驶方法。
参考资料
- 论文:arXiv:2205.15997
- 代码:github.com/autonomousvision/transfuser
- 相关论文:NEAT arXiv:2104.09224, CILRS arXiv:1910.13690