📄 论文信息
| 项目 | 内容 |
|---|---|
| 标题 | TruckDrive: Long-Range Autonomous Highway Driving Dataset |
| 团队 | Torc Robotics、Princeton University(Filippo Ghilotti, Edoardo Palladin, Samuel Brucker, Adam Sigal, Mario Bijelic, Felix Heide,三人等贡献) |
| 发表 | arXiv 2603.02413,CVPR 2026 |
| 代码/数据 | https://github.com/torc-ai/TruckDrive / 项目主页 |
| 关键词 | 重卡自动驾驶、长距离感知、高速公路、多模态数据集、FMCW 激光雷达、4D 雷达、2D/3D 标注、端到端驾驶 |
一句话概括:TruckDrive 是一个站在半挂重卡上、专门为了「高速上要提前几百米看清路况」而采集的多模态感知数据集——它把 2D 标注推到 1000 米、3D 标注推到 400 米,并且用实验证明:当前最先进的自动驾驶模型在 150 米以外就「瞎了」,3D 感知任务性能暴跌 31% 到 99%。
🖼️ 论文图片
采集车辆概览
TruckDrive 的采集平台基于一辆半挂重卡,搭载了全套长距离传感器套件。下图展示了采集车外观、传感器布局、以及典型的高速公路长距离感知场景:
TruckDrive 采集车与高速公路长距离感知场景
传感器套件细节
论文的传感器套件经过专门的长距离感知设计,核心包括 7 台长距 FMCW 激光雷达、10 台 4D 雷达和 11-15 路相机。下图展示了完整的传感器布局:
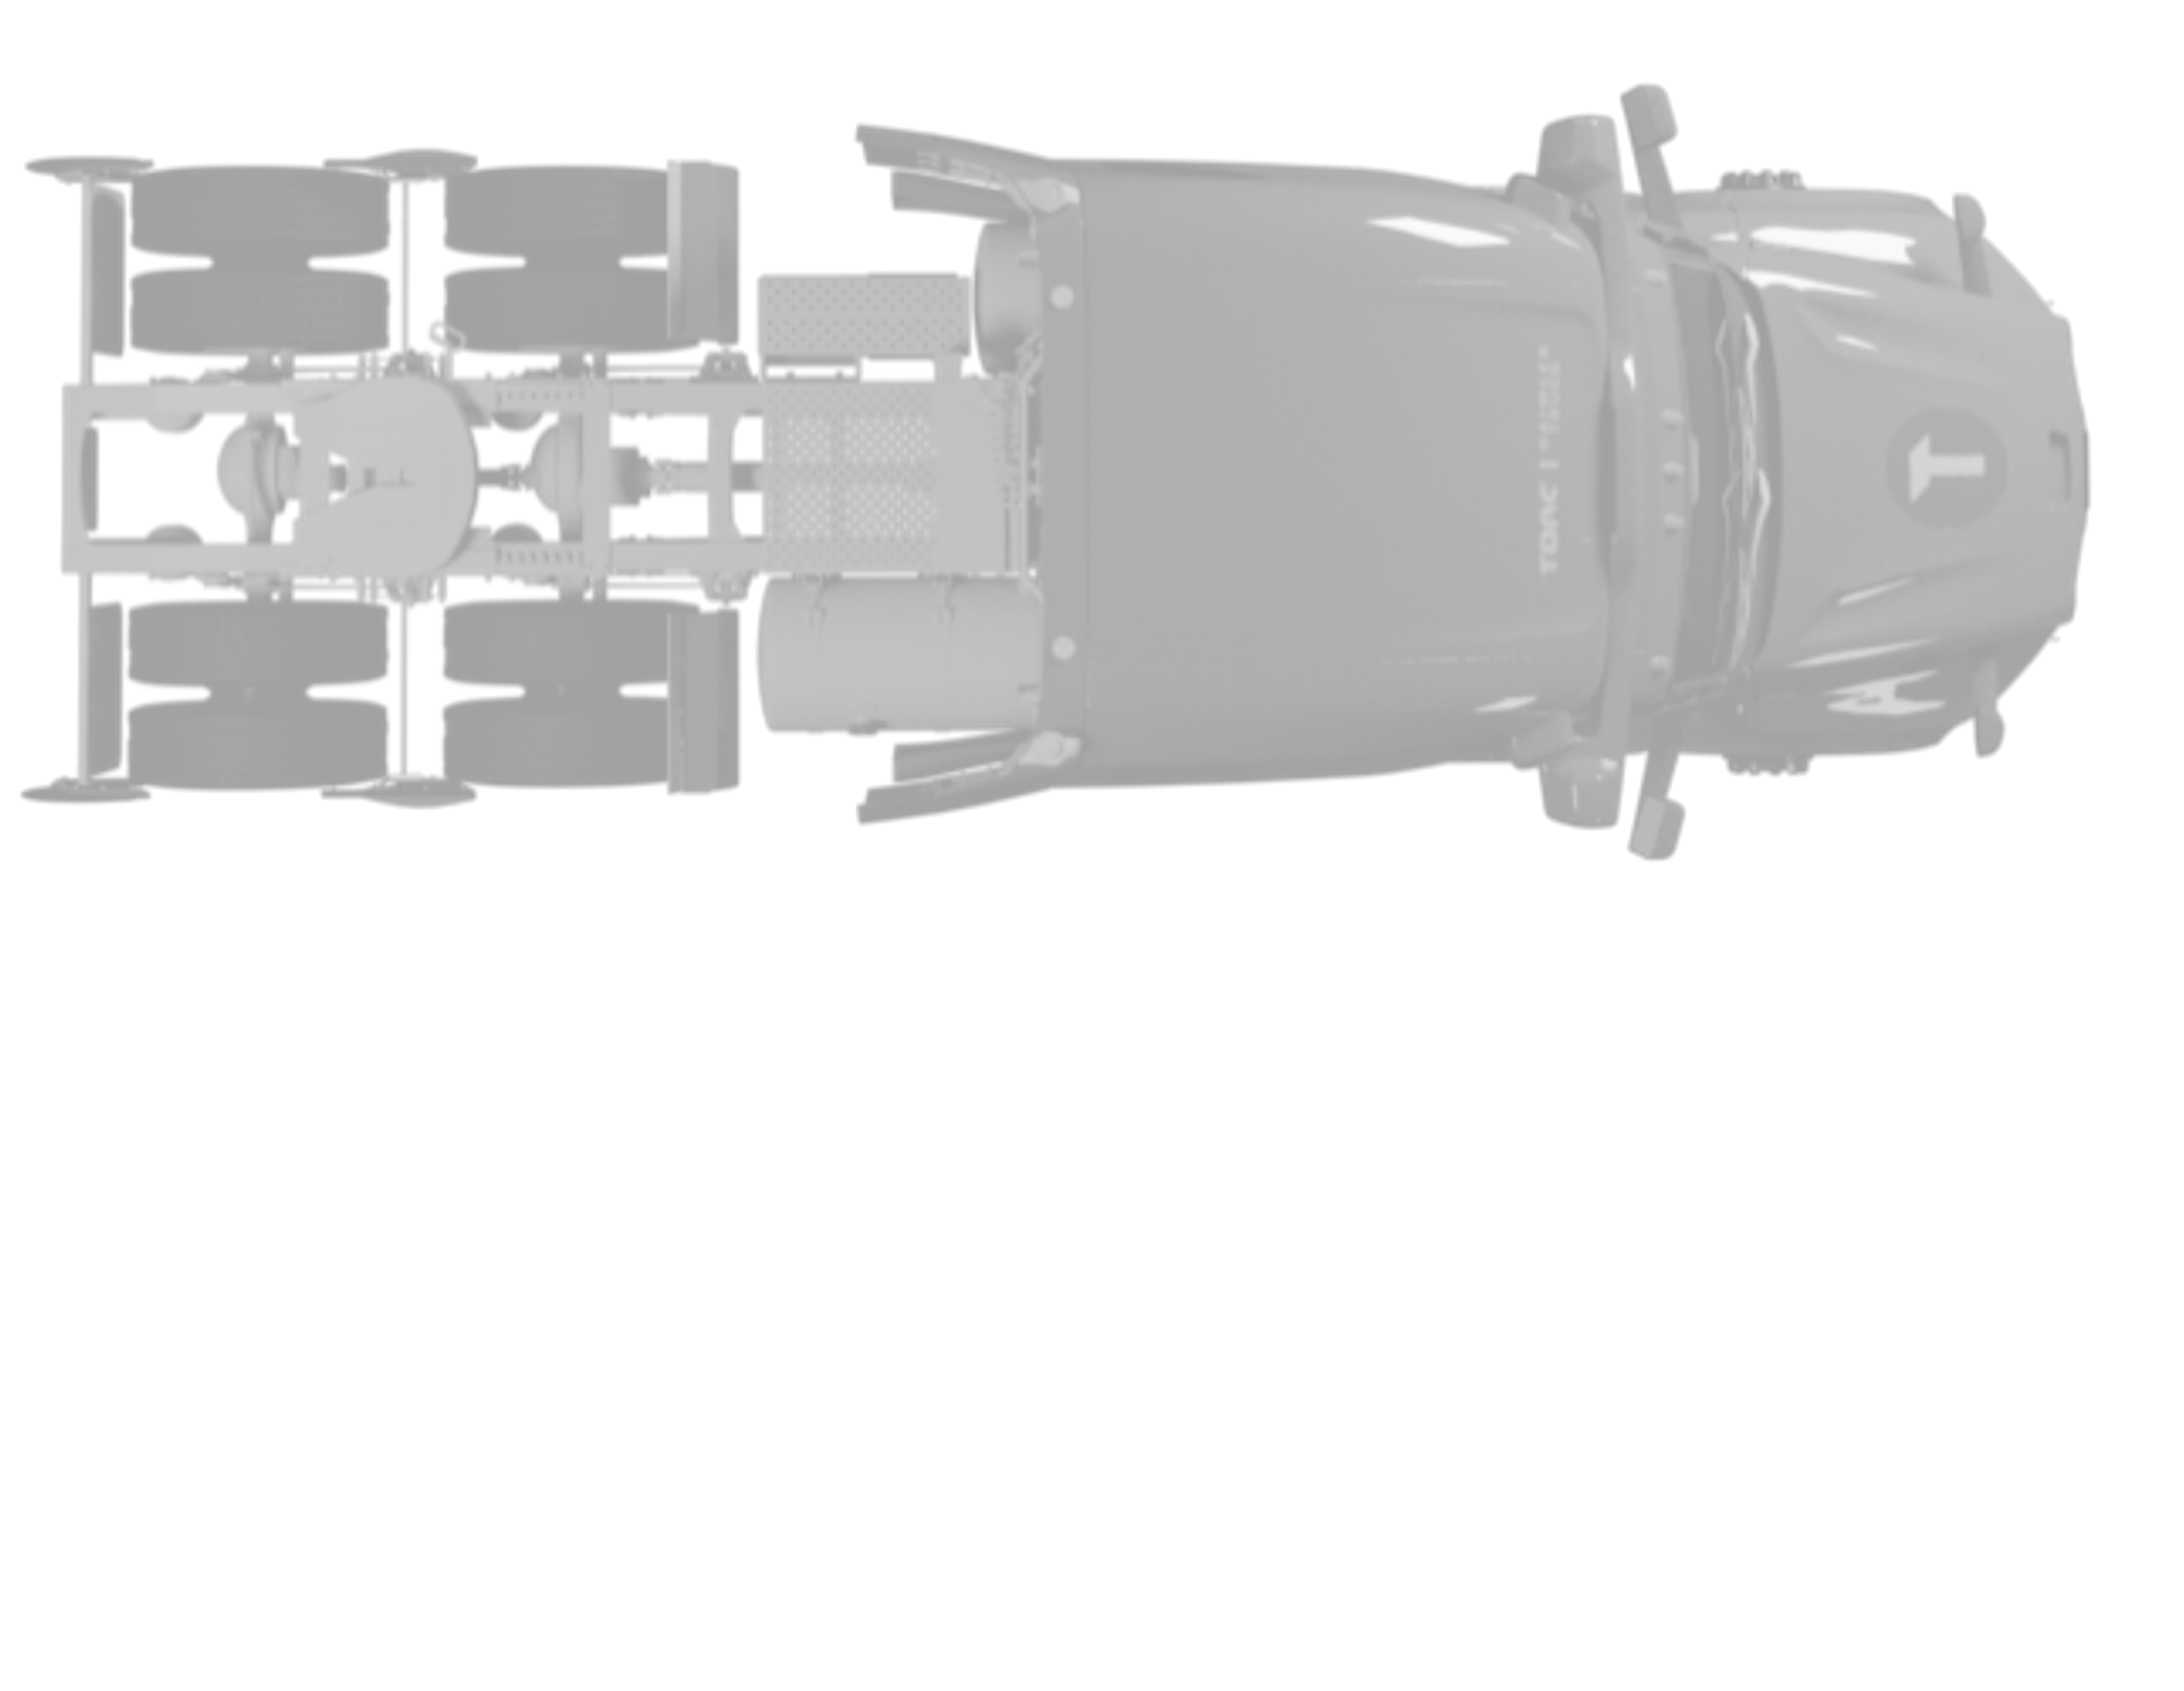
TruckDrive 采集平台 — 半挂重卡的传感器部署概览
各传感器的具体安装位置如下。其中激光雷达覆盖了车头、车顶和两侧,确保前方 400 米范围内无死角覆盖:
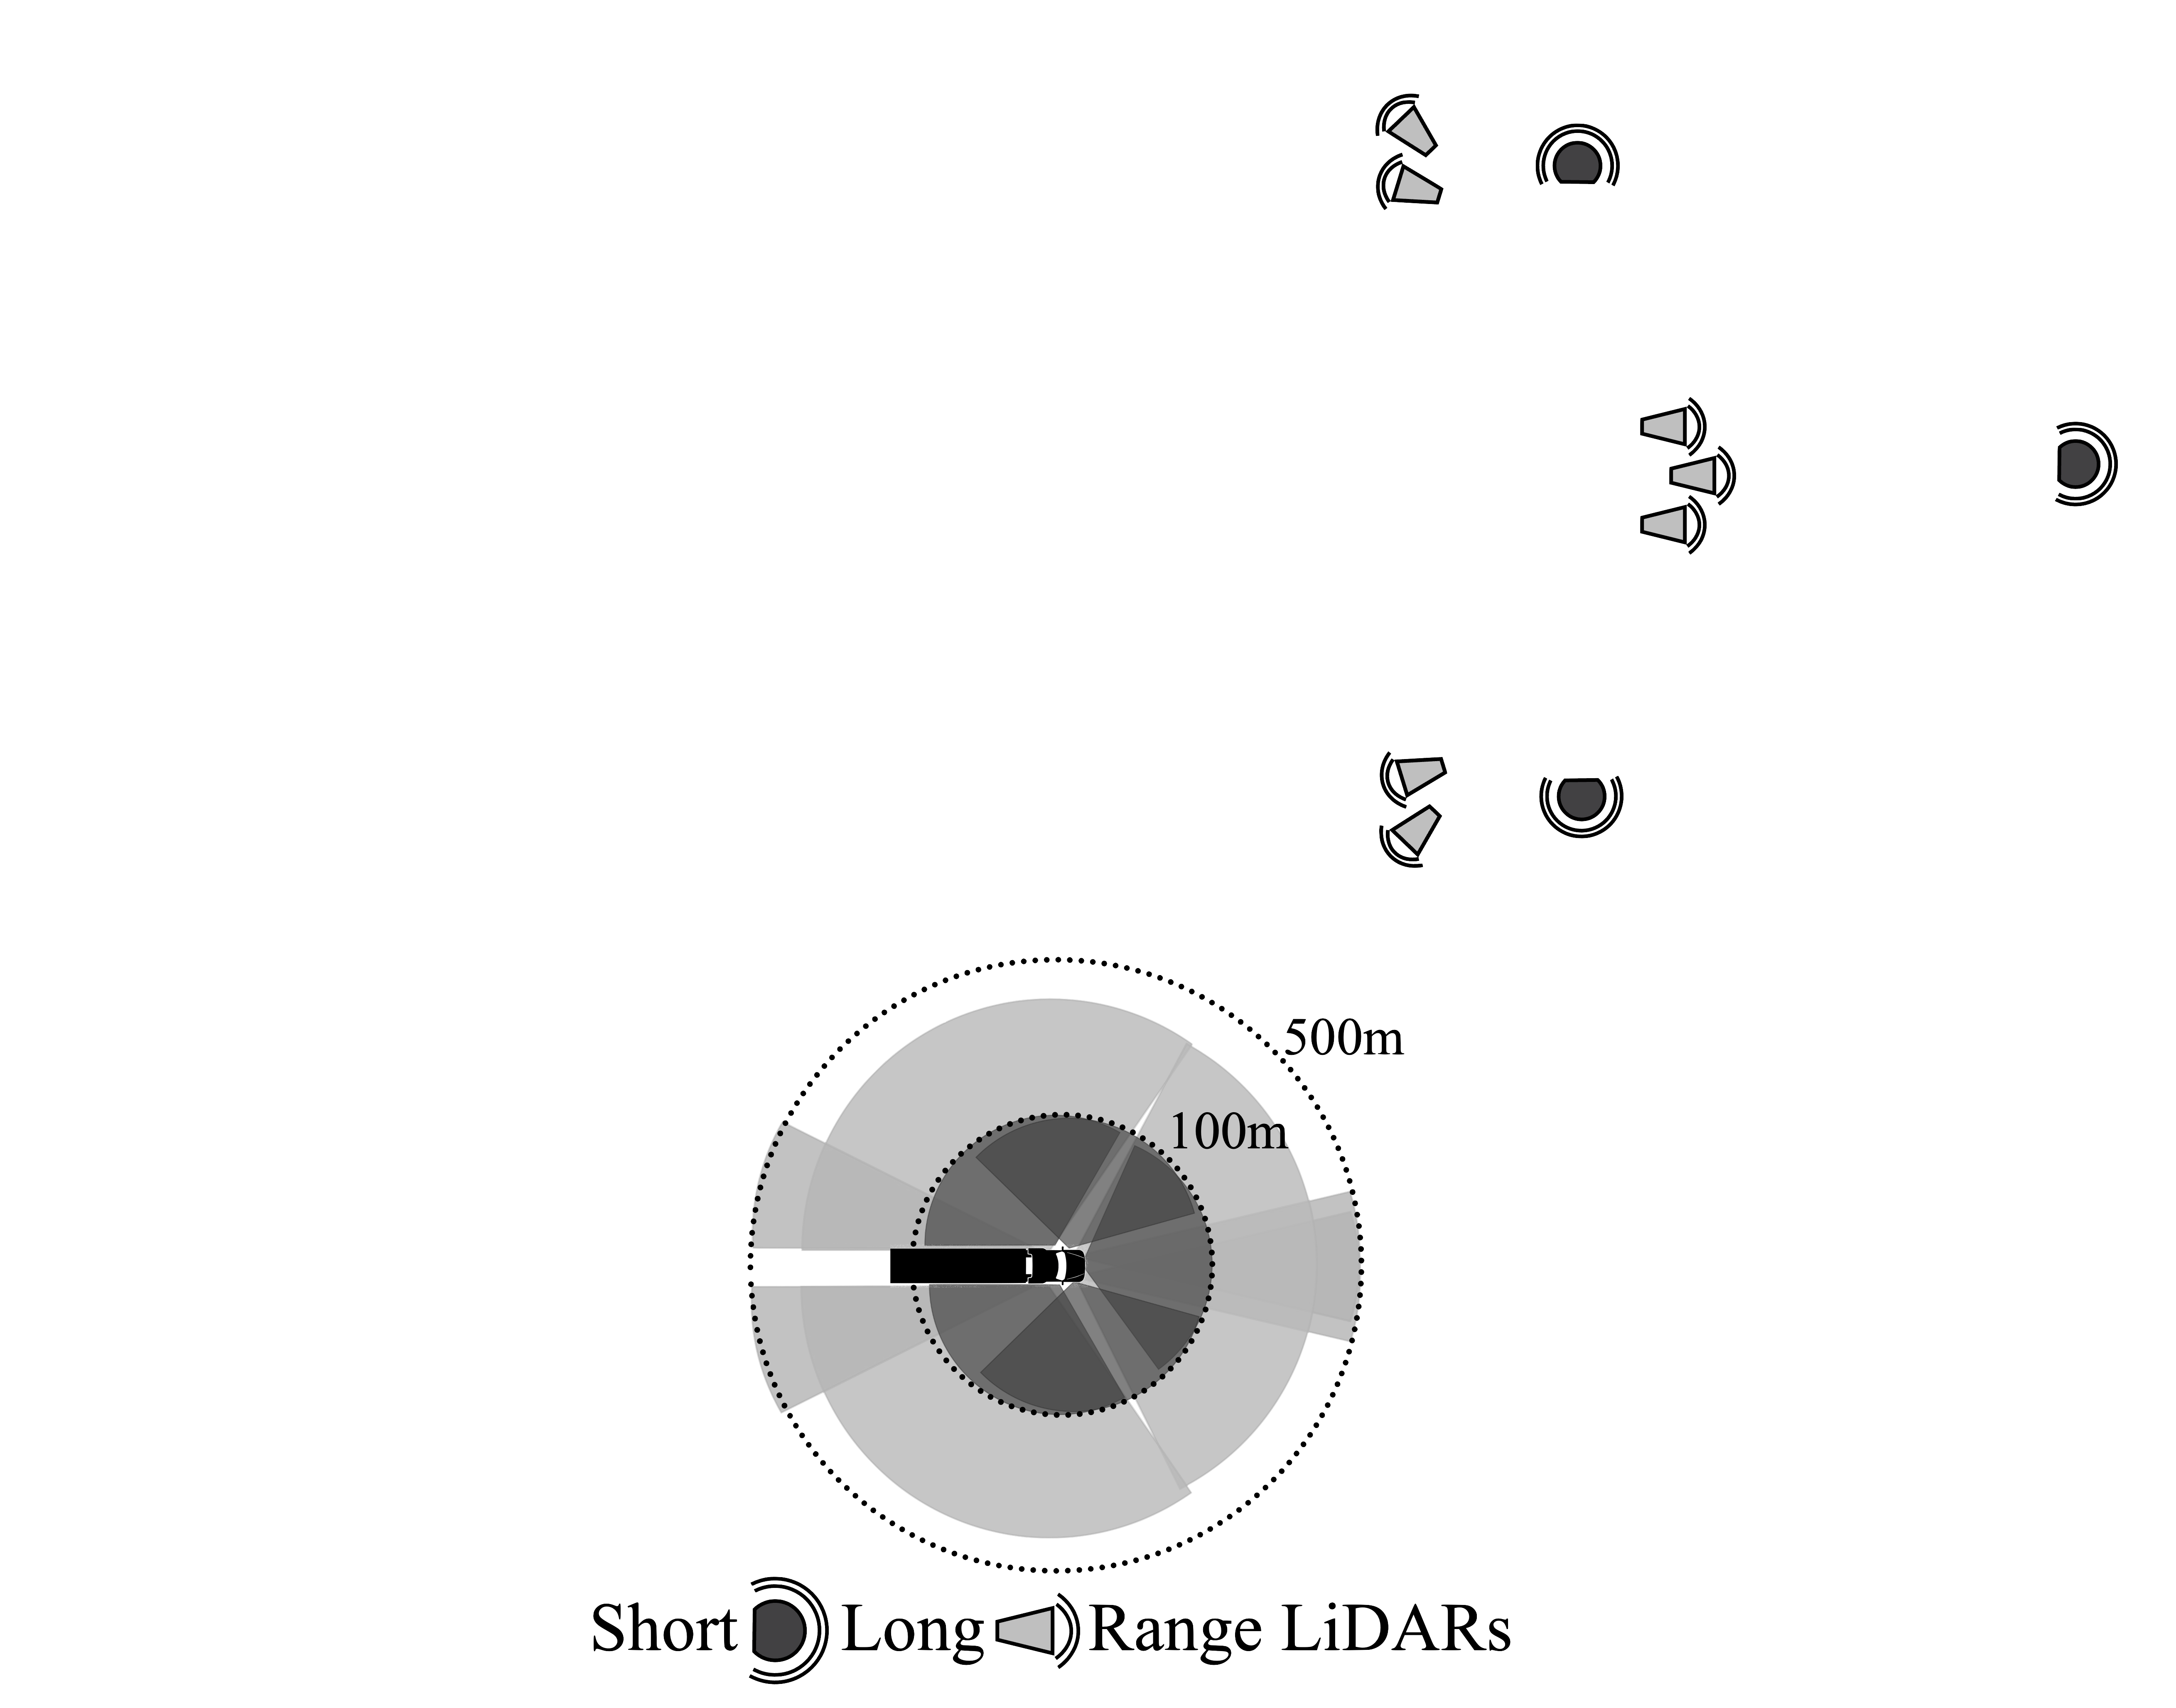
7 台长距 FMCW 激光雷达 + 3 台短距高分辨率激光雷达分布
4D 雷达的安装位置覆盖了车头保险杠区域和两侧,利用其全天候优势保障雨雾天气下的感知能力:
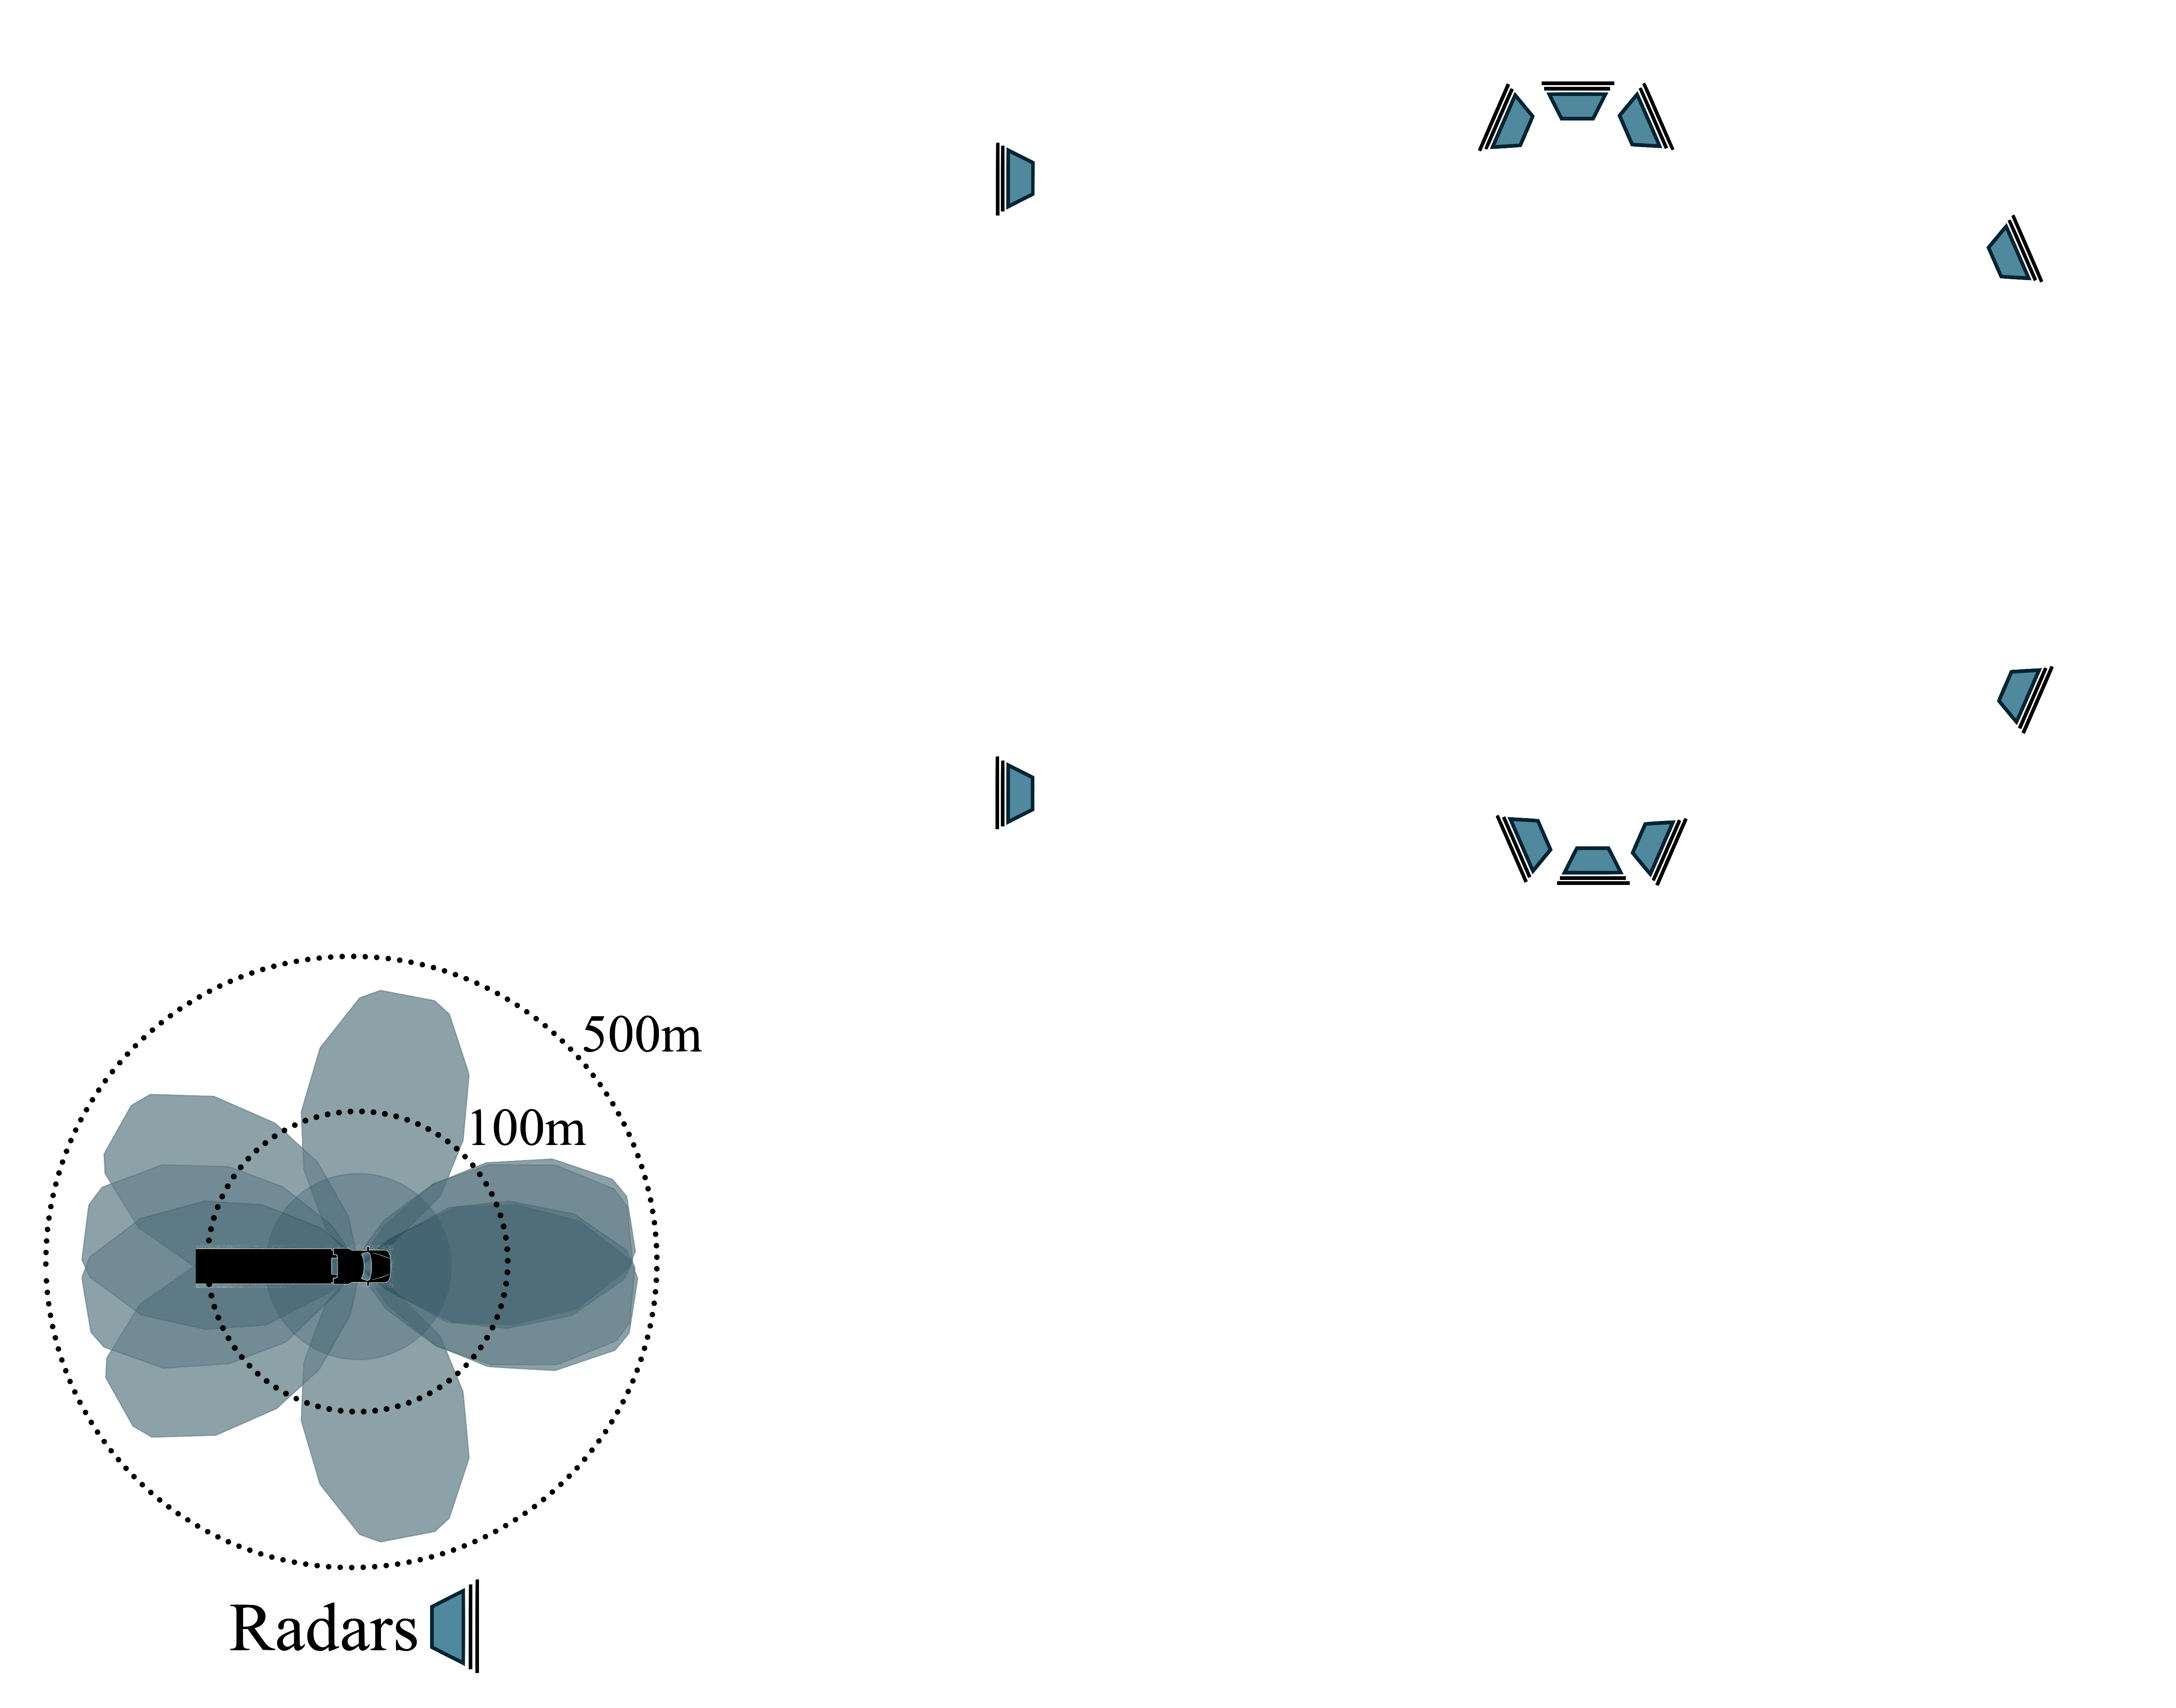
10 台 4D FMCW 毫米波雷达安装位置
多焦距相机系统是 TruckDrive 的另一个亮点——通过混合使用广角和长焦镜头,同时保证了近处的宽视野和远处的目标分辨率:
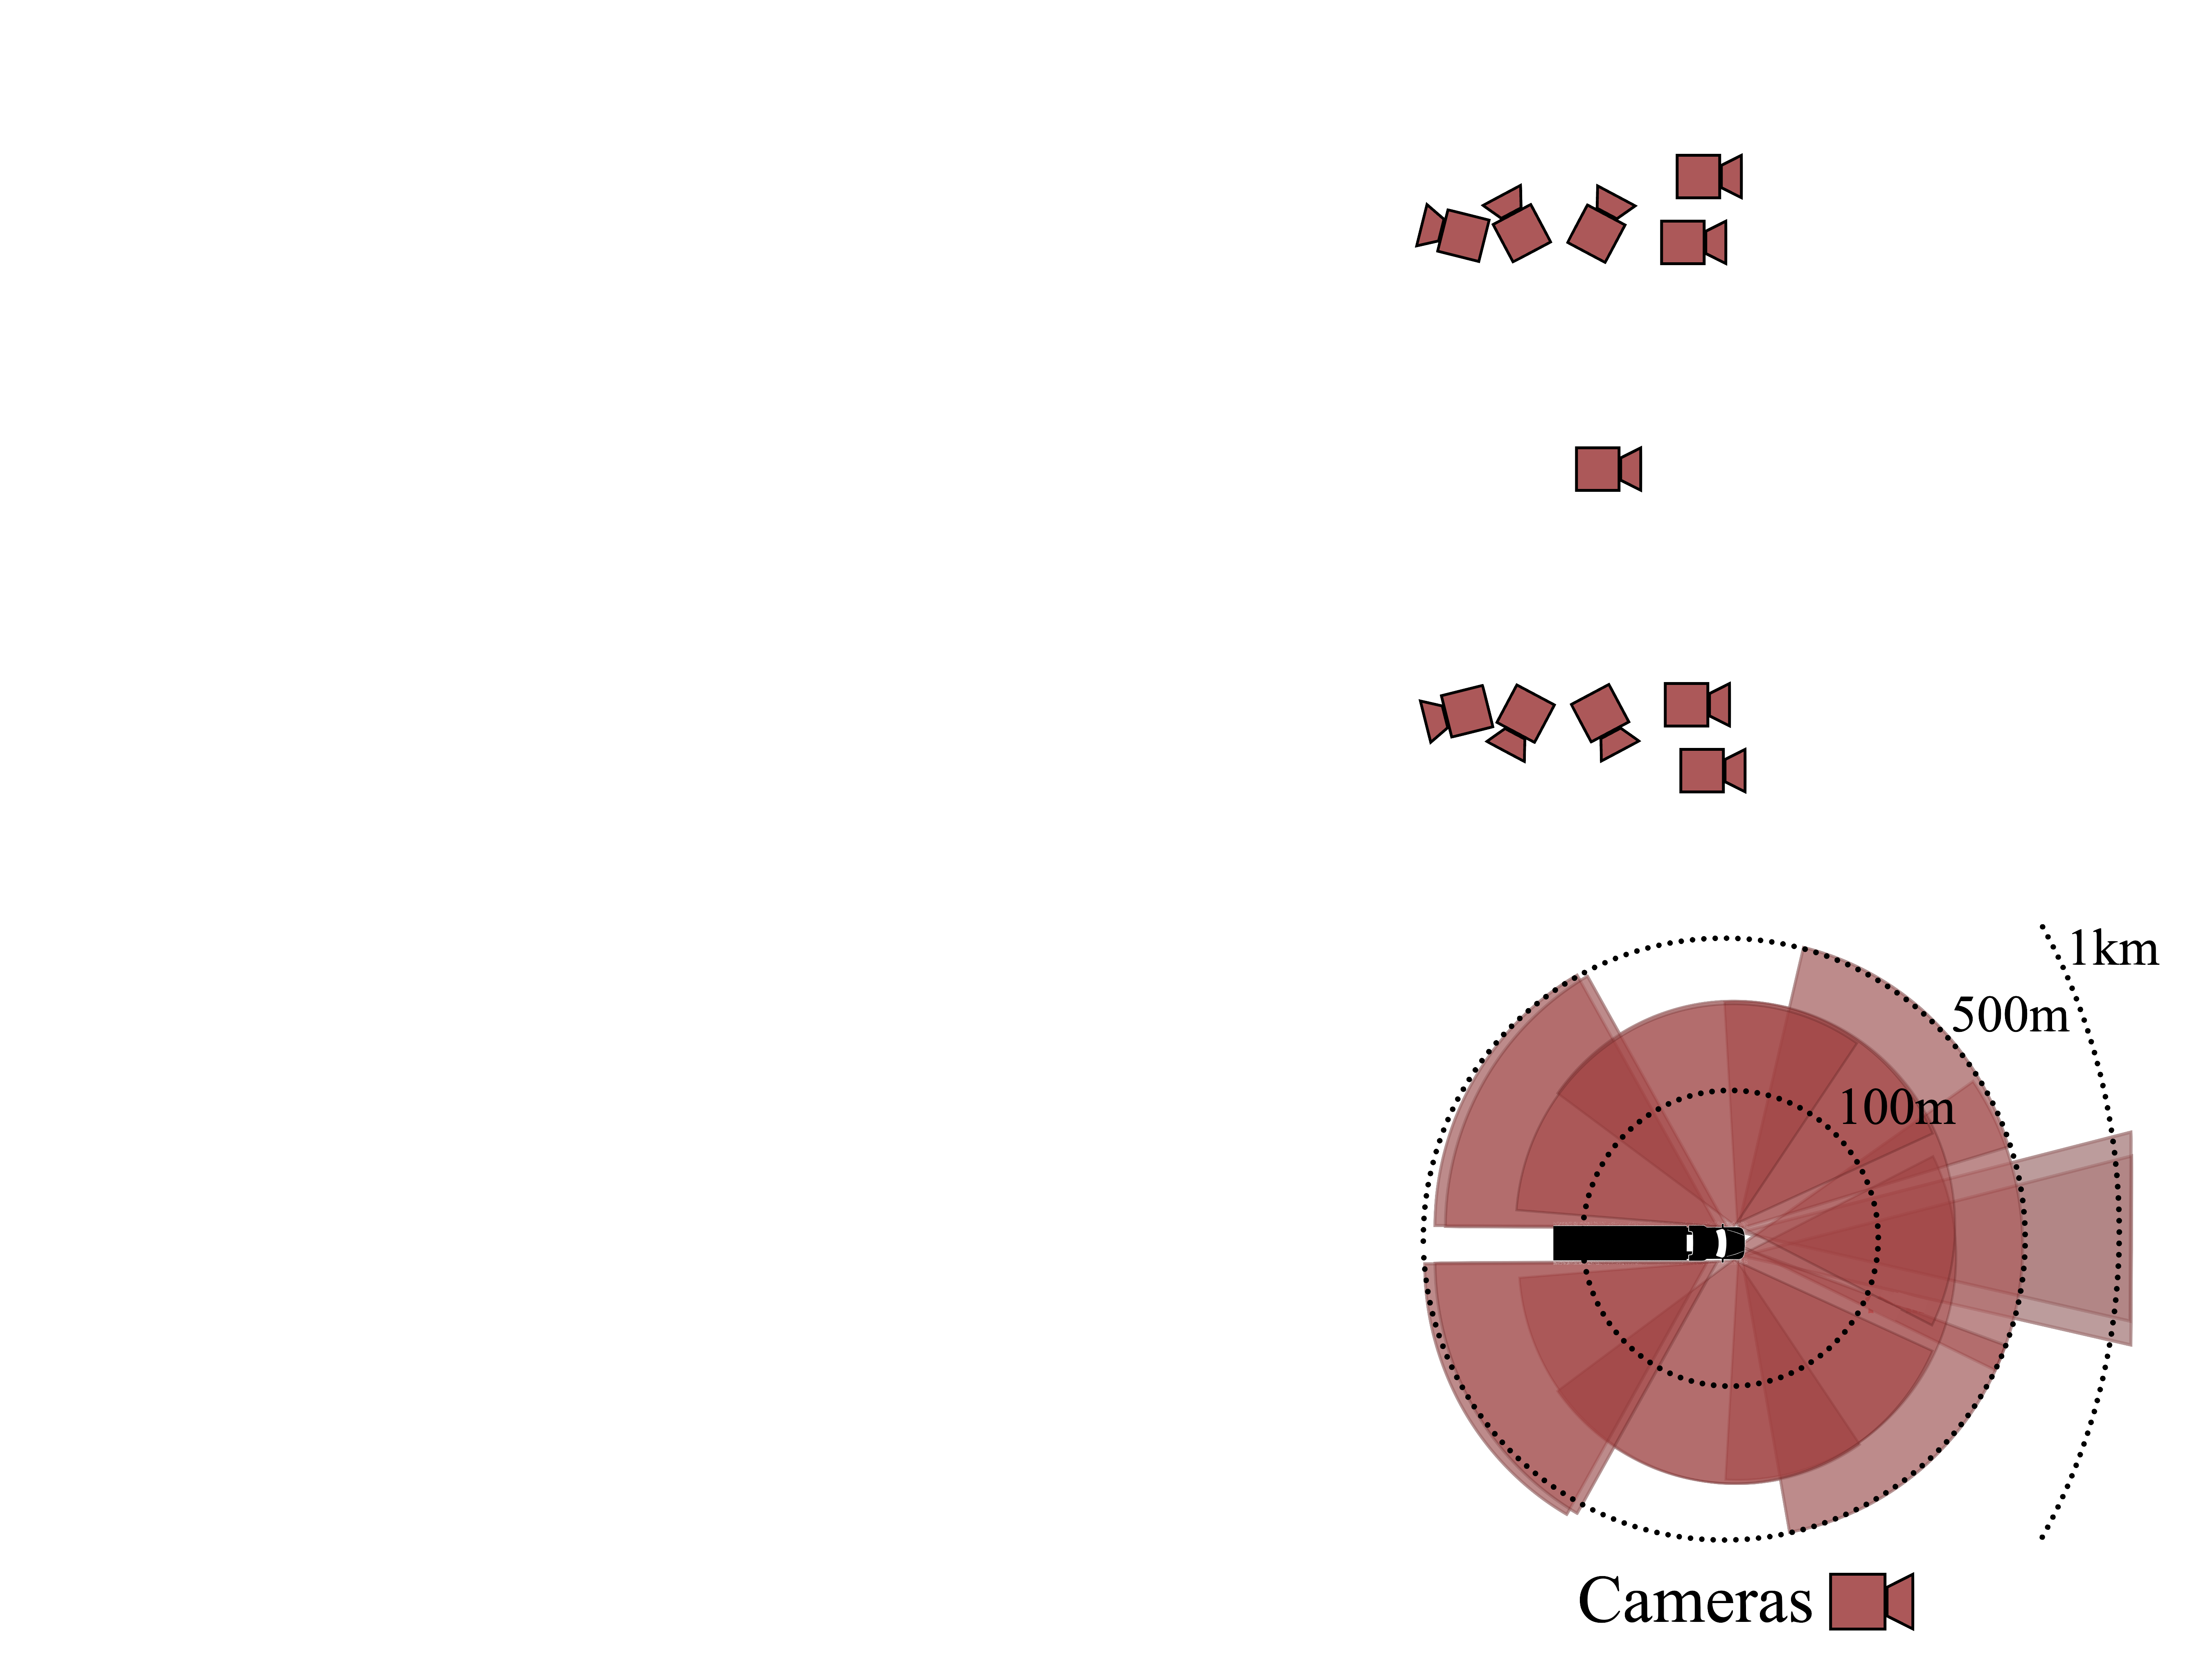
11-15 路 8MP 环绕相机,混合焦距设计
🤔 要解决什么问题?
先解释几个名词(小白友好版)
在正式讲问题之前,先把文章里反复出现的几个词用大白话讲清楚,后面就不会卡壳了。
- 感知(Perception):自动驾驶系统用相机、激光雷达、雷达等传感器「看」世界的过程。相当于人的眼睛和大脑视觉皮层,负责回答「前面有什么、多远、在动还是静止」。
- 3D 目标检测(3D Object Detection):在三维空间里给每个物体画一个带朝向的长方体框(bounding box),并标出它的中心坐标 $(x, y, z)$、长宽高和航向角。通俗说就是「不仅知道前面有辆车,还知道它在你前方 215 米、偏左 1.2 米、朝哪个方向开」。
- 多目标跟踪(Multi-Object Tracking, MOT):把连续多帧里同一个物体认出来,给它们同一个 ID。比如第 1 秒看到的前方卡车,和第 3 秒看到的那辆,要判断是不是同一辆。
- BEV(Bird’s-Eye View,鸟瞰图):把相机、激光雷达看到的信息投影到「从上往下俯视」的坐标系里。想象无人机在车顶正上方俯拍,所有车、路、人都摊平在一张平面地图上,特别适合规划模块使用。
- 长尾场景(Long-Tail Scenario):那些很少出现、但一出事就很严重的罕见情况,比如前方翻车、道路施工、逆行车辆。数据分布像一条长尾巴,大部分样本挤在常见场景,罕见场景样本极少。
- 域适应(Domain Adaptation):模型在 A 场景(比如城市、轿车)训练,要在 B 场景(比如高速、重卡)也能用,这中间的「跨场景迁移」就叫域适应。重卡数据集和轿车数据集之间的差别,就是典型的域偏移。
- 端到端(End-to-End)/ VLA:端到端指系统直接从传感器原始输入映射到驾驶动作,中间不显式拆成「感知→预测→规划→控制」模块;VLA(Vision-Language-Action)则是把视觉、语言(指令/常识)和动作统一到一个大模型里。本文读者主要关心这类模型。
核心矛盾:轿车数据集喂不饱重卡
过去十年,自动驾驶研究基本是被 KITTI、nuScenes、Waymo Open、Argoverse 这类数据集「带歪」的——它们几乎全是城市、低速、短距场景。论文在引言里直接点破:这些数据集隐含地把整个领域往「短距感知 + 低速驾驶」方向偏置了。
为什么这对重卡是致命的?因为一辆满载的半挂卡车:
- 城市里轿车刹停可能只要二三十米,而满载重卡以 80-100 km/h 行驶时,光刹车就要 150-200 米才能停稳;
- 如果感知系统只「看」到 100 米,那等它发现前方有静止障碍物时,物理上已经刹不住了。
论文给出的核心数据:现有主流数据集的 3D 标注极少超过 80 米,有效感知范围普遍被限制在 100 米以内(nuScenes/Waymo 大约就是这样)。而重卡高速安全驾驶需要的是 300 米以上的可靠感知。这就是 TruckDrive 要填的「长距离鸿沟(long-range gap)」。
论文的硬核结论
作者把当前 SOTA 自动驾驶模型放到 TruckDrive 上评测,发现:模型在 150 米以外就系统性失效,3D 感知任务的性能跌幅在 31% 到 99% 之间。注意,这不是缓慢衰减,而是「撞墙式」的断崖下跌——模型不是慢慢变弱,而是根本没见过这么远、这么稀疏的目标,直接「看不见」。这个 gap 当前架构和训练信号都补不上。
🛠️ 数据集是怎么建起来的?
传感器套件(专门为长距离设计)
TruckDrive 最大的卖点之一,是它用的传感器是按长距离感知定制的,而不是把城市车的那一套搬上来。具体配置如下(数据来自论文与官网):
- 7 台长距 FMCW 激光雷达:型号是 AEVA Aeries II,不仅能测距离,还能测每个点的径向速度(也就是物体朝你靠近还是远离、速度多少)。有效测距约 400 米。
- 3 台短距高分辨率激光雷达:负责车周围近处的精细建模(比如贴近的挂车、路肩)。
- 11-15 路 8MP 环绕相机:分辨率 800 万像素,且焦距各不相同(有广角也有长焦),长焦相机专门负责把远处小目标放大看清。
- 10 台 4D FMCW 雷达:所谓 4D 是指除了传统的距离、方位、俯仰,还能测径向速度和提供更高的角分辨率,对雨雾天气特别鲁棒。
名词解释:FMCW 是「调频连续波」激光雷达,相对传统机械旋转激光雷达,它天生能顺便测速度、抗阳光干扰强,很适合高速。4D 雷达就是「能看高度 + 能测速」的新一代毫米波雷达。
为什么需要这么多长距传感器?因为重卡车体本身就高(驾驶室离地 3 米以上),想把几百米外车道上的一辆小车看清楚,单靠一两台短距激光雷达根本扫不到——点云会随距离平方衰减,远处的物体回波极弱。所以论文用了 7 台长距雷达做互补覆盖。
传感器精确安装位置
根据项目主页的技术规格,TruckDrive 采集车的传感器安装位置(相对于车辆后轴中心)如下表所示。这些精确的坐标信息对于跨传感器标定和 BEV 感知建模至关重要:
| 传感器 | 数量 | x (m) | y (m) | z (m) | 说明 |
|---|---|---|---|---|---|
| FMCW 长距激光雷达 | 7 | +0.5 ~ +3.0 | ±0.5 ~ ±2.5 | +2.5 ~ +4.0 | 车顶前部阵列 + 两侧 |
| 短距激光雷达 | 3 | −1.0 ~ +0.5 | −0.8 ~ +0.8 | +0.5 ~ +1.0 | 保险杠区域 |
| 长焦相机 | 6 | +0.3 ~ +1.5 | ±0.3 ~ ±1.5 | +2.8 ~ +4.0 | 远距离视觉 |
| 广角相机 | 5-9 | +0.3 ~ +3.0 | ±0.2 ~ ±3.5 | +2.8 ~ +4.0 | 环绕视觉覆盖 |
| 4D 雷达 | 10 | −0.5 ~ +2.5 | ±0.5 ~ ±3.0 | +0.3 ~ +1.5 | 前后保险杠 + 侧面 |
表中坐标以车辆后轴中心为原点,x 正向为车头方向,y 正向为左侧,z 正向为上方。这种布局保证了前方 400 米、侧面 100 米和全方位后方的稠密覆盖,与传统乘用车数据集(nuScenes 仅 1 台激光雷达、Waymo 仅 5 台)形成鲜明对比。
FMCW 激光雷达原理
TruckDrive 选择 FMCW 激光雷达而非传统 ToF(飞行时间)机械旋转雷达,一个关键原因是 FMCW 能直接测量每个点的径向速度。其原理是通过发射线性调频连续波,与回波混频后得到差频信号。差频的频率分量对应距离,相位变化则对应目标的径向速度:
$$ v_r = \frac{\Delta\phi \cdot \lambda}{4\pi t} $$其中 $\Delta\phi$ 是连续 chirp 之间的相位差,$\lambda$ 是激光波长,$t$ 是 chirp 时间间隔。这意味着每个激光点天然包含距离 + 径向速度信息,在高速场景中特别有价值——你可以直接判断前方目标是在靠近还是远离、速度差多少,而不需要像 ToF 雷达那样做帧间匹配才能算速度。
4D 雷达的技术亮点
传统毫米波雷达只能输出距离、方位角和径向速度(所谓的 3D 雷达),而 4D 雷达在此基础上增加了俯仰角(elevation)测量能力和更高的角分辨率。TruckDrive 使用的 4D FMCW 雷达通过 MIMO(多输入多输出)天线阵列,在方位和俯仰两个维度都实现角度分辨,从而在点云层面形成类似激光雷达的稀疏点云——每个点都带有 $(x, y, z, v_r)$ 四维信息。
这对重卡高速场景意义重大:
- 高速上的坡道、桥梁、悬空标志牌需要俯仰角信息来区分——3D 雷达会把桥梁误判为前方障碍物;
- 雨雾天气下激光雷达衰减严重,4D 雷达的长波长(毫米波)穿透力强,可以作为冗余感知通道;
- 10 台雷达的冗余设计意味着即使部分雷达被泥污遮挡,系统仍能正常工作。
采集路线与规模
- 序列数量:3,828 条序列(sequence),在 2 年跨度内采集。
- 地理覆盖:横跨美国 8 个州(NM、TX、VA、NC、TN、AR、WV、AZ),多样性面积指标 1,261.3 km²,是 Waymo Open Dataset 的 16.5 倍。
- 季节与天气:覆盖全年四季(秋 48%、冬 32%、春 15%、夏 5%)和多种天气(80% 晴/多云/阴,10% 雾,10% 降水)。对重卡高速来说,雾和降水场景尤其关键,因为重卡刹不住、更怕恶劣天气。
- 每条序列时长:15-25 秒,平均自车轨迹长度 500 米。
- 道路类型:主要是高速(3,244 条),其次郊外(351 条)和城市(233 条)。
- 驾驶行为分布:45.8% 巡航/加减速,36.5% 变道/超车,5.4% 近距离加塞(cut-in),12.3% 复杂布局(施工区、路口、无保护转弯)。
- 光照覆盖:3,285 条白天,367 条夜晚,122 条黄昏,54 条黎明。
标注规模与范围
- 同步样本总数:47.5 万(475k)帧多模态同步样本。
- 密集标注帧:16.5 万(165k)帧,有完整人工标注。
- 无标注同步样本:31 万(310k)帧,留给自监督/半监督学习用。
- 2D 标注范围:最远到 1,000 米(图像上画框)。
- 3D 标注范围:最远到 400 米(点云里画立体框)。
- 支持的标注类型:3D 检测、2D 检测、多目标跟踪、深度估计、轨迹预测、规划、端到端驾驶。
关键点:大部分已有数据集在远处几乎没有标注,而 TruckDrive 在远处保持较高的标注密度。论文强调它「在距离维度上分布更均衡」,不像 nuScenes 那样大部分框都挤在 50 米以内。
标注流水线
论文说他们的标注管线是「人工标注 + 自动化多视角补全 + 运动学精修」三件套:
- 人工标注:基础的真值框由标注员画。
- 多视角自动补全:一辆车被多路相机/激光雷达看到,利用几何一致性把某些视角漏标的目标补全。
- 运动学精修(Kinematic Refinement):利用目标的运动模型(速度、加速度)对框做时间上的平滑和纠正,减少抖动和漏帧。
这保证了即便在 400 米外、点云极稀疏的目标,也能有相对可靠的 3D 框。
📏 距离维度分析
TruckDrive 的项目主页展示了一组关键的对比图——不同数据集在距离维度上的实例分布(instance distance distribution)。下图取自论文官方可视化,展示了 TruckDrive 与 nuScenes 在目标距离分布上的差异:
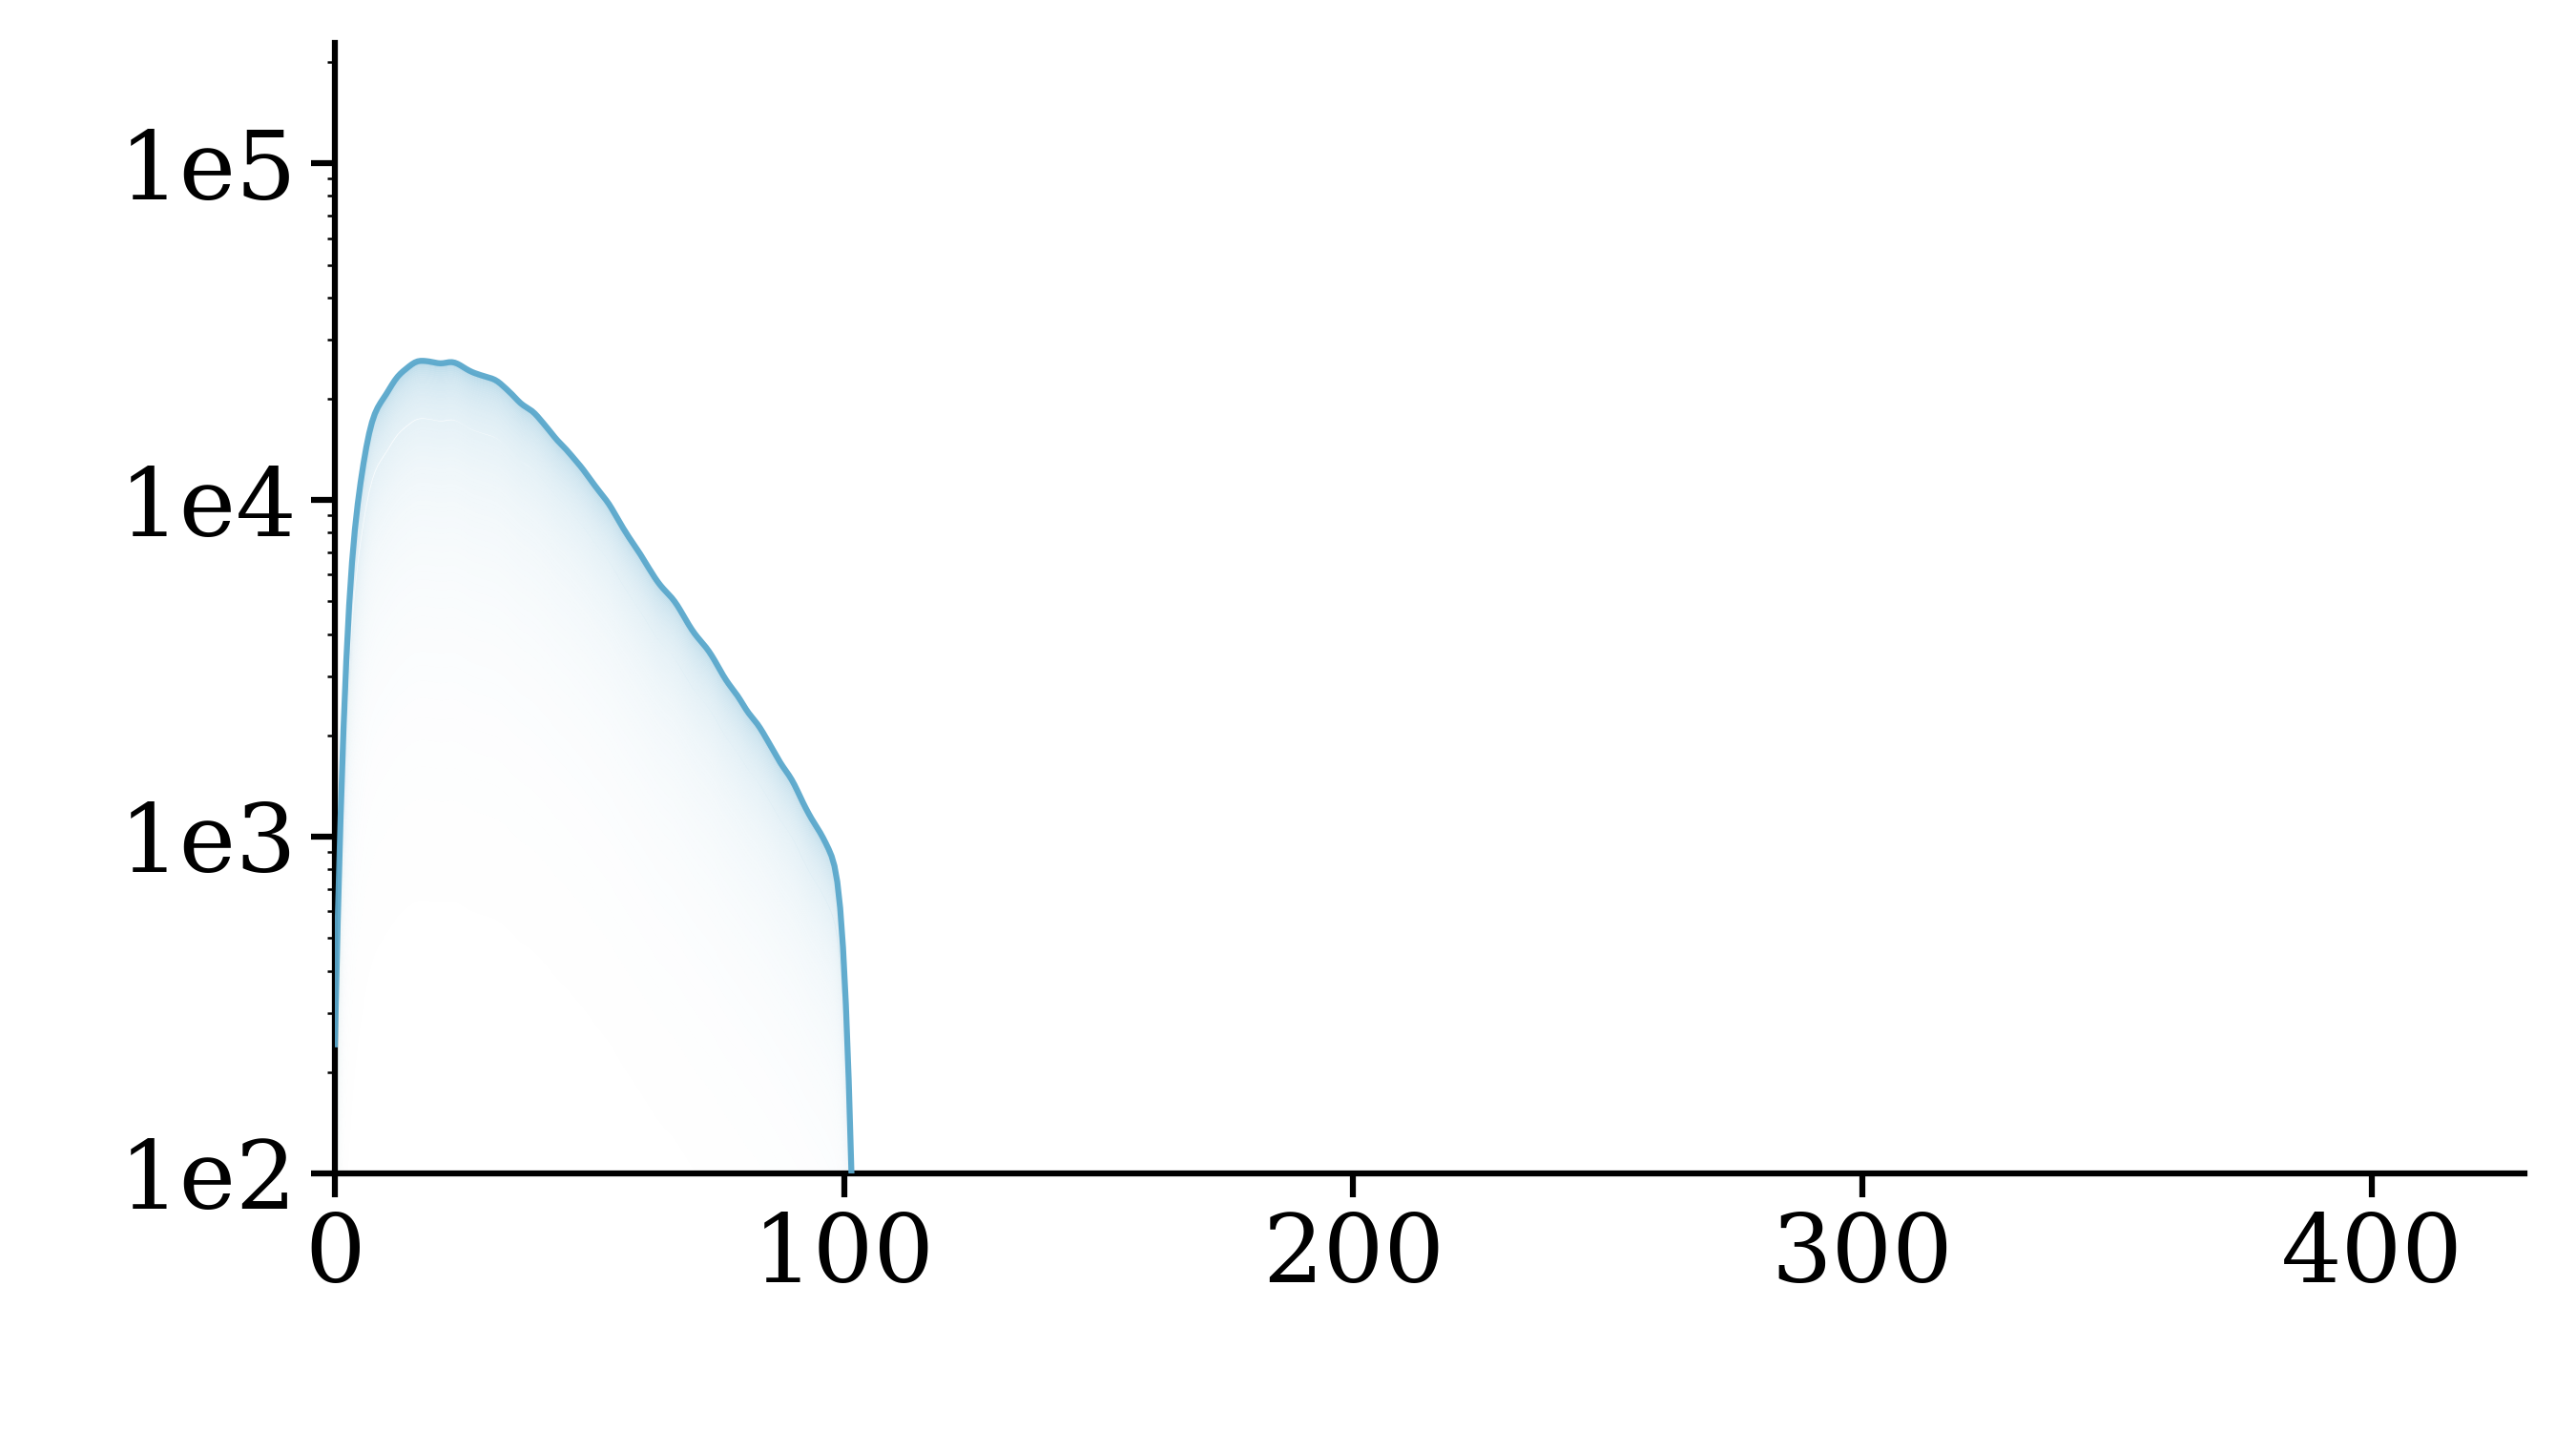
实例距离分布对比(TruckDrive vs nuScenes)— TruckDrive 在远距离保持更均衡的分布
从图中可以清楚看到,nuScenes 的数据分布呈现典型的「近距离偏置」:绝大多数标注框集中在 0-50 米范围内,50 米以外迅速衰减,100 米外几乎无标注。而 TruckDrive 在 0-50 米、50-100 米、100-200 米、200-400 米各区间内都有持续且稳定的实例分布。
这种「距离维度上的分布均衡性」是 TruckDrive 最本质的贡献之一。它意味着:
- 训练时,模型在每个距离段都能看到足够多的正样本,不会像 nuScenes 那样被近距离目标 dominate;
- 评测时,能按距离分桶算 AP(Average Precision),精准定位模型在哪个距离段失效;
- 为距离感知(range-aware)训练提供了数据基础,比如可以按距离对 loss 加权,或者做距离维度的课程学习。
这对 VLA/端到端模型尤为重要——如果训练数据里 90% 的目标都在 50 米内,模型自然会「近视」,而 TruckDrive 强迫模型学会「看远」。
📊 与已有数据集对比
下面这张表把 TruckDrive 和常见的自动驾驶数据集放一起比。注意:部分对比数值(如 nuScenes/Waymo 的标注范围)来自论文 Table 1 的定性描述,具体数字以原论文为准。
| 数据集 | 主导场景 | 3D 标注范围 | 2D 标注范围 | 传感器特点 | 标注帧规模 | 重卡/高速偏向 | 4D雷达 | FMCW激光雷达 |
|---|---|---|---|---|---|---|---|---|
| KITTI | 城市/郊区(德国) | ~80 m | ~80 m | 1 激光雷达 + 2 相机 | 约 1.5 万 | 否 | 否 | 否 |
| nuScenes | 城市(波士顿/新加坡) | 约 100 m(极少超 80 m) | 约 100 m | 6 相机 + 1 激光雷达 + 5 雷达 | 4 万关键帧 | 否 | 否 | 否 |
| Waymo Open | 城市为主 | 约 100 m | 约 100 m | 5 激光雷达 + 相机 | 20 万+ | 否 | 否 | 否 |
| Argoverse 2 | 城市/郊区 | 约 100 m | 约 100 m | 7 相机 + 2 激光雷达 | 10 万+ | 否 | 否 | 否 |
| ONCE | 多样(含高速) | 约 100 m | 约 100 m | 激光雷达 + 相机 | 100 万(含大量无标注) | 弱 | 否 | 否 |
| MAN TruckScenes | 重卡环绕(城市/仓运) | 约 100 m | 约 100 m | 6 相机 + 4 激光雷达 + 6 雷达 | 约 2 万关键帧 | 是(重卡但短距) | 否 | 否 |
| HICODA | 高速交叉口 | 有限 | 有限 | 激光雷达 + 相机 | 较小 | 高速但规模小 | 否 | 否 |
| OpenCDA | 协同驾驶仿真 | 仿真 | 仿真 | 多智能体仿真 | 仿真为主 | 否(仿真) | 否 | 否 |
| aiMotive | 城市/高速(欧洲/美国) | ~120 m | ~120 m | 12 相机 + 4 激光雷达 + 12 雷达 | 约 50 万+ | 弱 | 否 | 否 |
| TruckDrive | 高速/重卡 | 400 m | 1000 m | 7 长距 + 3 短距激光雷达、10 台 4D 雷达、11-15 相机 | 16.5 万密集标注 / 47.5 万同步 | 是(高速重卡长距) | 是(10台) | 是(7台) |
最关键的差异一句话总结:别人都在 100 米内卷,TruckDrive 把标准拉到 400 米(3D)和 1000 米(2D),而且专门站在重卡上采——这是别人没有的「域」。此外,TruckDrive 是唯一同时配备 FMCW 激光雷达和 4D 雷达的公开数据集,这两个传感器在高速场景中天然适合测速,为模型提供了额外的速度模态。
🧪 核心方法与基准实验(论文做了什么评测)
实验设计逻辑
论文不只是「丢个数据集出来」,它还做了诊断性基准实验来佐证「长距离 gap 真实存在」。逻辑是:
- 拿当前 SOTA 的感知/端到端模型(论文里提到的是当时先进的驾驶模型),在 TruckDrive 上按距离分桶评测。
- 看模型在 0-50 m、50-100 m、100-150 m、150-200 m、200-400 m 各区间的 3D 检测/跟踪表现。
主要发现
- 断崖在 150 米:模型在 150 米以内基本还能用,超过 150 米性能断崖式下跌。
- 跌幅 31%-99%:不同任务、不同模型的跌幅区间。越是依赖近距离稠密点云的任务,远处跌得越狠,有些甚至接近「完全失效」(99%)。
- 原因指向训练偏置:作者认为这不是模型架构的小修小补能解决的,而是因为现有模型是在「短距城市数据」上训练出来的,训练信号里根本没有「远处小目标」这个分布。
对 VLA 工程师的启示:如果你的端到端模型只在 nuScenes 级别的数据上训过,那它天然就有「近视」缺陷。TruckDrive 这类数据,是验证模型是否真的具备长距离感知能力的试金石。
🚛 重卡自驾为什么更难(独立小节,重点展开)
这一节单独拎出来讲,因为这是 TruckDrive 存在的根本理由,也是刚入行的同学最容易忽略的点。
1. 车重导致制动距离极长
一辆空载半挂约 15 吨,满载可以到 36-40 吨。动能和速度平方成正比,和质量成正比:
$$E_k = \frac{1}{2} m v^2$$质量 $m$ 是轿车的 10-20 倍,速度 $v$ 在高速上又是 80-100 km/h。结果就是:轿车 100 km/h 刹停约 40-50 米,满载重卡要 150-200 米。这意味着感知系统必须提前几百米就「看见」风险,否则物理上救不回来。
2. 挂车铰接导致轨迹非刚性
轿车是一个刚体,车头和车尾走的是同一条线。半挂卡车是 tractor(车头)+ trailer(挂车)通过鞍座铰接的两段式结构:
- 转弯时挂车内侧会「内切」,走比车头更紧的曲线;
- 高速变道或避让时,挂车会摆动(trailer sway),像被拖着的尾巴甩动;
- 倒车、窄路掉头时,车头和挂车角度可以差很大。
这对感知和规划的影响:你不能把整辆车当成一个长方体去预测轨迹,要考虑挂车的摆动相位和延迟。TruckDrive 采的是真实半挂,天然包含这种非刚性运动。
3. 盲区大
重卡驾驶室高 3 米以上,带来几个致命盲区:
- 前方近盲区:车头正下方、引擎盖前方一大片区域,司机(和传感器若装太低)根本看不见贴近的小型车辆、行人、摩托车。
- 侧后方盲区:挂车两侧和正后方是大块「看不见」区域,变道加塞时极易出事。
- A 柱/后视镜遮挡:重卡 A 柱粗、双大后视镜占视野,相机如果照搬轿车位置,会被这些结构挡住。TruckDrive 的相机布局和焦距专门考虑了重卡车体遮挡问题。
4. 高速场景对感知的独特要求
高速上没有红绿灯、没有行人突然窜出,但相对速度极大。你以 90 km/h 开,前方慢车以 60 km/h 开,相对速度 30 km/h(约 8.3 m/s)。如果感知只看到 100 米,你只有约 12 秒反应时间,且其中还要预留刹车距离。想要从容变道或减速,必须看到 300-500 米外。
制动距离的物理计算
制动距离由车辆初速度和地面摩擦系数决定,基本公式为:
$$ d = \frac{v^2}{2\mu g} $$其中 $v$ 是初速度(m/s),$\mu$ 是轮胎-路面摩擦系数(干燥沥青约 0.7-0.8,湿滑路面约 0.4-0.5),$g$ 是重力加速度(9.8 m/s²)。
对于轿车 $m = 1.5t$,100 km/h(约 27.8 m/s)下的制动距离:
$$ d_{\text{car}} = \frac{27.8^2}{2 \times 0.75 \times 9.8} \approx 52.5 \text{ 米} $$对于满载重卡 $m = 40t$,制动距离长很多,除了摩擦系数因素外,还有刹车系统响应延迟和轮胎热衰减。实际工程中,重卡 100 km/h 制动距离约为 150-200 米。这意味着:
感知系统需要在 200 米外就完成「检测 → 分类 → 跟踪 → 预测」的完整流水线,才能在物理极限距离之外留出足够的安全余量。
安全跟车距离计算
高速公路上的安全跟车距离常用「3 秒规则」估算:与前车保持至少 3 秒的时距。在 100 km/h(27.8 m/s)下,3 秒对应:
$$ d_{\text{safe}} = v \cdot t = 27.8 \times 3 \approx 83 \text{ 米} $$但这只是轿车标准。重卡由于制动距离长、反应延迟大,行业普遍推荐 5-7 秒时距:
$$ d_{\text{truck safe}} = 27.8 \times 6 \approx 167 \text{ 米} $$再加制动距离的安全余量,重卡感知系统需要可靠覆盖 300 米以上。而 TruckDrive 的 3D 标注延伸到 400 米,正是为满足这一物理需求。
感知距离需求对比图
下图直观展示了乘用车与重卡在感知距离需求上的巨大差异:
乘用车 vs 重卡感知距离需求对比 — 红色虚线表示当前模型在 150 米处的失效边界
从图中可以看到:
- 乘用车的有效感知范围约 100 米(蓝色区域),制动距离约 40-50 米(绿色区域),两者基本匹配;
- 重卡的制动距离就达 150-200 米(橙色区域),要求感知系统覆盖 300-500 米(红色区域);
- **150 米断崖(红色虚线)**代表当前 SOTA 模型在 TruckDrive 上验证的失效边界——乘用车的感知需求刚好在这条线以内,而重卡的需求远远超出。
一句话:高速把「感知距离」从「加分项」变成了「保命项」。
🔍 重卡感知的独特难点(工程视角)
除了上面讲的「更难」物理原因,落到感知算法本身,还有几个具体坑:
- 远处目标点云极稀疏:400 米外的一辆轿车,在激光雷达里可能只有十几个点甚至几个点。传统基于稠密点云的检测头(如 PointPillars、CenterPoint)在远处直接「点不够用」。
- 长焦相机的标定与同步:多焦距相机 + 多激光雷达 + 多雷达,时间同步和空间标定难度指数级上升。TruckDrive 专门讲了 cross-modal synchronization(跨模态同步)策略。
- 类别极度不平衡:高速上 95% 是轿车/卡车/护栏,行人、逆行、翻车等长尾极少,但模型必须对这些极少类别保持敏感。
- 天气鲁棒性:高速重卡最怕雾和暴雨,而 4D 雷达在恶劣天气下比激光雷达稳,所以论文特意堆了 10 台 4D 雷达做冗余。
- 域适应:在轿车城市数据上预训练的模型,直接上重卡高速会「水土不服」——视角更高、目标更小更远、车体运动模式不同。
💡 个人思考
为什么重卡自驾和乘用车是「两件事」
很多人以为「自动驾驶算法通用,换个车就能跑」。TruckDrive 这篇论文用数据打了这个想法的脸:
- 乘用车数据集定义的「好感知」是 100 米内框得准;
- 重卡定义的「够用感知」是 400 米外还能发现静止障碍。
这是需求层面的根本不同,不是调参能抹平的。重卡自动驾驶公司(如 Torc、Aurora、Kodiak)之所以自己采数据,就是因为公开数据集根本覆盖不到他们的运营域(operational design domain, ODD)。
对端到端 / VLA 模型的启示
- 别迷信「城市 SOTA」:一个在 nuScenes 上 PDMS 很高、规划很顺的 VLA,放到高速重卡上可能 150 米外就「瞎」。长距离感知能力应该成为 VLA 评测的硬性指标。
- 长焦视觉 + 雷达融合是刚需:纯视觉在远处像素太少,纯激光雷达在远处点太稀,4D 雷达的速度测量是高速场景的「安全带」。VLA 如果要上重卡,输入模态里大概率不能少了雷达。
- 训练数据的「距离分布」要重新设计:现在大部分模型 loss 在近距离目标上占主导,远处目标贡献小。要显式地对远距离目标加权,或者做课程学习(curriculum learning)让模型先学近再学远。
- 世界模型也要「看得远」:端到端模型常配合世界模型做未来预测。如果感知输入在远处就断了,世界模型预测 3 秒后的场景也会失真——而重卡恰恰需要 3-5 秒的长时域规划。
长距离感知的技术挑战:为什么现有 BEV 会失效
当前主流的 VLA 和端到端模型大多基于 BEV(鸟瞰图)感知范式——将多视角图像或点云投影到统一的 BEV 网格上,然后用 transformer 做检测。这类模型在 TruckDrive 数据上会遇到几个根本性问题:
感受野与网格分辨率的矛盾:BEV 网格通常采用固定分辨率(如 0.5 m/pixel)。如果要覆盖 400 米范围,BEV 网格尺寸会变得极大(400 × 400 = 160,000 个网格单元),计算量暴涨;如果保持网格数量不变,分辨率就下降到每格数米,远处的小目标(如 400 米外的一辆轿车,在 BEV 中仅占 2-3 个像素)根本无法被检测头有效识别。
距离依赖的特征衰减:现有注意力机制对所有距离一视同仁,但远处目标的特征天生就弱——点云更稀疏、图像像素更少。标准 transformer 的 attention 权重受距离影响极小,导致模型把宝贵的计算资源浪费在近处高密度目标上,而远处的重要目标被淹没。
训练信号的分布偏置:即使模型架构本身能支持长距离,如果训练数据中 90% 的目标都在 50 米内,loss 会被近距离目标主导,梯度更新也主要优化近距离性能。这也是为什么论文强调「距离分布均衡」是 TruckDrive 最核心的进步之一。
可能的解决方向:距离感知训练
一种可行的思路是引入距离感知(range-aware)训练策略:
- 按距离分桶加权 loss:将 200-400 米区间目标的基础 loss 乘以一个大于 1 的权重系数,迫使模型关注远距离目标。
- 课程学习(curriculum learning):先让模型在 0-100 米数据上预训练收敛,然后逐步引入 100-200 米、200-400 米的数据,类似于人类先学近处再学远处。
- 距离条件化特征(range-conditioned features):在 BEV 检测头中引入距离先验,让模型知道「这个位置的物理意义是 300 米外」,从而调整对特征稀疏度的期望。
TruckDrive 的 16.5 万密集标注帧使得上述策略成为可能——如果数据本身在远处没有标注,再好的训练策略也巧妇难为无米之炊。
一点批判性看法
TruckDrive 目前是「感知为主」的数据集,论文明确说不含物理/动力学参数(没有车辆控制量、轮胎力、挂车摆动动力学真值)。这意味着它适合做感知、预测、规划的开环评测,但不适合直接做控制闭环仿真。想做重卡动力学相关的研究,还得配合 MAN TruckScenes 或专用仿真器(如 CARLA 的重卡扩展、或 TruckSim)。另外,47.5 万样本对现代大模型来说不算「海量」,后续是否会有更大的「TruckDrive v2」值得关注。
不过,从纯感知数据集的维度看,TruckDrive 填补了一个极其重要的空白——它让社区第一次可以在真实的「重卡 + 高速 + 长距离」运营域上评测感知模型。对于所有声称做「通用自动驾驶」的研究组来说,不在 TruckDrive 上跑一下,你都不知道自己的模型多远就「瞎」了。
📚 延伸阅读
下面列出与本文主题相关的方向,方便刚入行的同学按图索骥:
- MAN TruckScenes:同样是重卡多模态数据集(MAN 卡车出品),但偏城市/仓运短距,和 TruckDrive 互补,适合做「重卡域」内的对比。
- nuScenes / Waymo Open / Argoverse 2:理解「城市短距基准」长什么样,才知道 TruckDrive 改了什么。
- ONCE:大规模、含大量无标注帧,适合自监督学习,可配合 TruckDrive 做域适应实验。
- HICODA:高速交叉口数据集,规模小但场景专注,适合研究高速交互。
- OpenCDA:协同自动驾驶仿真框架,含多车通信,可做重卡编队(platooning)仿真。
- Seeing Through Fog / A*3D:恶劣天气、主动学习标注相关,理解重卡最怕的雾天怎么采数据。
- BEVFormer / Sparse4D / UniAD:感知与端到端架构论文,可拿来在 TruckDrive 上复现「长距离 gap」实验。
- FMCW 激光雷达与 4D 雷达入门:理解为什么 TruckDrive 选这两类传感器,推荐搜 AEVA Aeries II 的技术白皮书。
🧾 小结
TruckDrive 不是又一个「城市自动驾驶数据集」,它是第一个把重卡 + 高速 + 长距离作为一个完整运营域、用定制传感器套件认真采集并标到 400 米(3D)/1000 米(2D)的公开基准。它用一组触目惊心的数字(150 米外暴跌 31%-99%)提醒整个社区:我们引以为傲的 SOTA 模型,其实都是「近视眼」。对于做 VLA、端到端驾驶的工程师来说,这篇论文最该记住的一句话是——如果你的模型没在 400 米外见过目标,那它就不算真的会开高速重卡。
本文数据均来自 arXiv:2603.02413(CVPR 2026)公开版本及官方项目主页/GitHub,部分对比表中的已有数据集数值为论文定性描述或公开常识,引用时请以原论文 Table 1 为准。