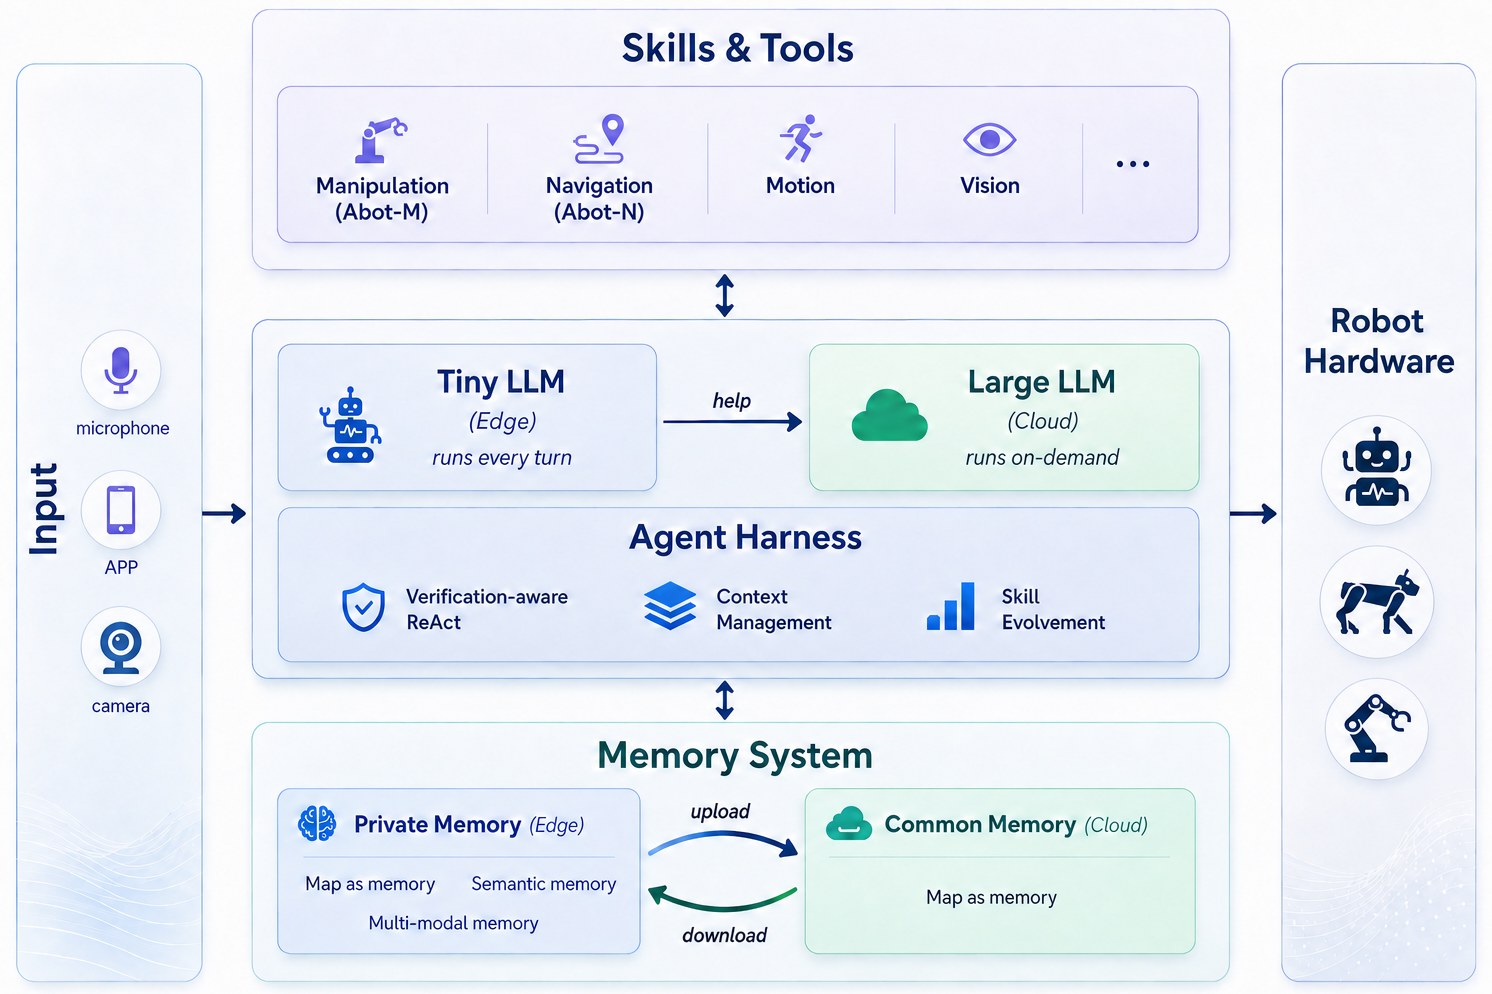
配图说明:本文收录论文全部 8 张插图(Figure 1 ~ Figure 8),放在站内 /images/abotagentos/,逐张讲解,文末附图表总索引。论文 ABot-AgentOS: A General Robotic Agent OS with Lifelong Multi-modal Memory(arXiv 2607.10350v3,2026-07,AMAP CV Lab / Alibaba Group),项目页 amap-cvlab.github.io/ABot-AgentOS。姊妹篇:RoboOS-NeXT 精读(多机共享记忆调度视角)。
🧒 小白 5 分钟:到底什么是「具身机器人大脑系统」?
先分清两层。 直接「相机进、动作出」的 VLA 模型是机器人的小脑——反应快,但只顾眼前一步。大脑系统管的是五件小脑不管的事:①听懂话 ②拆任务 ③调度(多机时) ④记忆 ⑤验证(没放对碗就回去重做)。
「操作系统」的类比在本文最贴切,直接按 OS 的三大件对号入座:
| 计算机 OS | 机器人大脑 OS(ABot-AgentOS) |
|---|---|
| 进程(跑程序) | 技能执行(Skill Runner 跑「导航 5 米」「开抽屉」这类程序化子任务) |
| 内存(记东西) | 多模态记忆图(对话/看到的/位置/时间/轨迹都变成图上的节点与边) |
| 文件系统(存知识) | 持久化记忆库 + 自进化沉淀的 evo-assets(经验条目) |
| 系统调用/驱动 | 工具接口(导航命令、VLM 观测工具、对话……) |
| 内核调度 | 边云路由:端侧小模型管每回合,难题升级给云上大模型 |
| 测试与补丁 | 三阶段验证 + 失败驱动自进化(发现 bug → 打补丁 → 只对以后版本生效) |
一句话:VLA 负责动手,大脑 OS 负责「像操作系统一样」管理思考、记忆与执行。本文把这套 OS 做完整了,还带了一个考场(EmbodiedWorldBench)与一套「打补丁」机制(自进化)。读完你会发现:它和 RoboOS-NeXT 是同一问题的两面——那边解决「多台机器人共享白板」,这边解决「单台机器人的完整 OS」。
📄 论文信息
- 标题:ABot-AgentOS: A General Robotic Agent OS with Lifelong Multi-modal Memory
- 机构:AMAP CV Lab, Alibaba Group(高德地图 CV 实验室)
- 时间:2026-07-10(arXiv 2607.10350v3,v3 2026-07-17)
- 关键词:Agent OS、Agent Harness、Skill Runner、三阶段验证、Universal Multi-modal Graph Memory、失败驱动自进化、EmbodiedWorldBench、边云协同、学生策略蒸馏(SFT+RL)
- 一句话总结:在低层控制器之上加一层通用运行时——场景条件规划、上下文隔离的技能执行、多阶段验证、多模态图记忆、边云协作;失败记忆被诊断成**带门控的补丁(evo-assets)**只准以后用;自报记忆基准 87.5/59.9/88.6/76.5,自进化再抬一截。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| EmbodiedWorldBench(同模型消融) | ReAct+Qwen3.6-Plus TSR 49.97% / GCR 57.95% → 本文同模型 61.96% / 68.79%(+11.99 / +10.84) | 架构(分层执行+记忆+验证)的净增益 |
| 换更强主脑 | DeepSeek-V4-Pro(本文架构)68.18% / 74.62% | 比本文 Qwen 版再 +6.22 / +5.83 |
| 记忆基准(Static) | LoCoMo 87.5、OpenEQA EM-EQA 59.9、Mem-Gallery 88.6、NExT-QA Acc@All 76.5 | 六个记忆/问答基准之四 |
| 自进化增益 | LoCoMo 88.7、OpenEQA 60.4、Mem-Gallery 89.0 | 分数只准「以后的 split」挣到(防泄漏) |
| 考场规模 | 16 场景 × 4 难度 × 200+ 任务 | 室内/室外/混合,导航+NPC 对话+动态事件 |
| 验证阶段 | 3 档:运行中 / 技能级 / 收尾 | 没验证不许结束任务 |
| 记忆写入 | 对话、视觉观测、空间、时间、任务轨迹 → 类型化节点/边 | Universal Multi-modal Graph Memory |
🗺️ 仿真 vs 真机:一眼分清
| 场景 | 类型 | 说明 |
|---|---|---|
| EmbodiedWorldBench / UnrealZoo | 仿真 | 主实验:NavMesh 导航、VLM 观测工具、结构化评估器(不给隐藏状态) |
| 记忆基准(LoCoMo/OpenEQA/Mem-Gallery/NExT-QA/EgoLifeQA) | 离线/问答评测 | 纯记忆与推理能力,不跑机器人 |
| 学生策略训练 | 文本化环境(仿真) | 可控文本环境 + 教师轨迹蒸馏 + 在线 RL |
| 真机 | 未给大表 | 论文重心是可部署运行时与可审计记忆;真机细节不在本文主实验 |
🧭 读前 5 分钟:五个概念
- 双 LLM 边云架构:端侧 Tiny LLM 处理每一回合(便宜、快),按需把难题升级路由给云端大模型——机器人算力与网络现实下的标准解法。
- Agent Harness:主 LLM 干「读记忆+上下文 → 场景条件规划」,把程序性子任务委派给 Skill Runner,再收 Verifier 的纠正反馈——形成「推理-执行-验证」循环。
- 三阶段验证:运行时(轨迹是否跑偏)、技能级(委派的子任务真完成没)、收尾级(主 LLM 想结束时,最终条件全满足没)——不验证不许收工。
- Universal Multi-modal Graph Memory:一切信息进图(类型化节点/边),在线写入-检索-记录轨迹;离线诊断失败。
- 失败驱动自进化:失败 → 诊断 → 产出候选 evo-assets → 门控通过 → 只允许后续评测 split 使用——既持续改进又防「本题答案泄漏」。
🛠️ 方法:Harness、图记忆、自进化、学生策略
Agent Harness(Fig. 2)
- 主 LLM:场景条件规划(吃记忆与上下文),决定委派什么、何时收工;
- Skill Runner:技能级子代理,管「持续性的本地执行」(不是一次性调用),保持过程连续、吸收程序细节;
- Verifier:三阶段验证把缺漏的任务打回重做——对应小白表里的「测试与补丁」。
图记忆(Fig. 3)
在线:观测与交互写入**源可追溯(source-grounded)**的记忆图 → 检索任务相关证据 → 记录检索与回答轨迹(可审计)。离线:失败轨迹被诊断、转成 evo-assets。边云协同记忆管理让端侧只持有必要子图。
自进化与门控(Fig. 4/7/8)
- Fig. 4 给出两个具体失败→进化案例(视觉记忆缺品种线索、时间记忆的相对日期归一化错误);
- Fig. 7 的铁律:split 内失败只在评测后诊断与门控,通过的资产只能被后续 split 用——防当前题泄漏;
- Fig. 8 汇总各基准「Static → +Self-evo」的绝对增益条形。
可部署学生策略(Fig. 6)
三层蒸馏:可控文本环境 → 教师轨迹蒸馏做 SFT 初始化 → 在线 RL(LLM-as-Judge 打奖励 + GiGPO 把奖励转成相对优势)→ 更小的学生模型可下端部署——把「大模型大脑」压成「能上机的小大脑」。
自带考场 EmbodiedWorldBench(Fig. 5)
16 场景 × 4 难度 × 200+ 任务,涵盖导航、目标搜索、NPC 对话、动态事件;指标 TSR(全子目标+终态全满足才算成,最严)与 GCR(满足子目标占比,看部分进度);几何条件按位姿+成功半径程序判定,语义条件看运行证据——结构化评估器 + 轨迹可回放。
📸 逐图讲解(Figure 1 ~ 8)
Figure 1:系统架构——边云双脑
(即文首头图。)左侧多源输入(麦克风、APP、相机)→ 中央双 LLM 核心:Tiny LLM(边缘)处理每回合,按需升级到云端大 LLM;外围是 Agent Harness(感知推理 ReAct 循环、上下文管理、技能演进)。读图要点:成本敏感的路由是第一设计约束——不是所有回合都配得上云端大模型。
Figure 2:Agent Harness——推理-执行-验证环
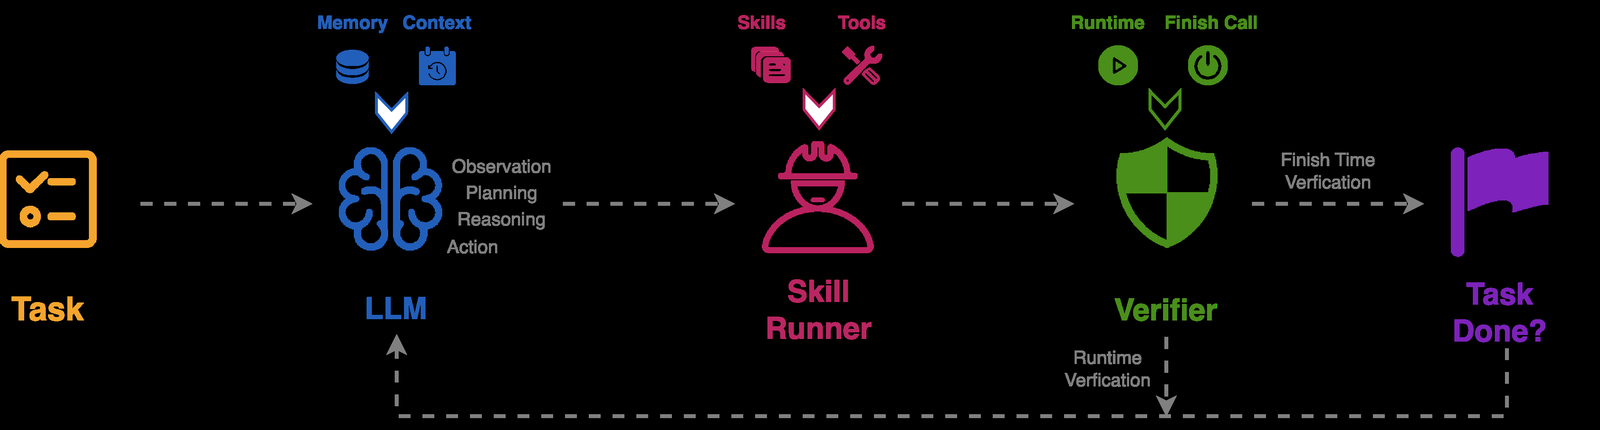
主 LLM(带记忆与上下文的场景条件规划)→ 委派程序性子任务给 Skill Runner → Verifier 返回纠正反馈 → 回到主 LLM。三角色缺一不可:没有 Skill Runner,规划被过程细节淹没;没有 Verifier,「以为做完了」的幻觉会直接进记忆。
Figure 3:多模态记忆架构——在线写读、离线进化
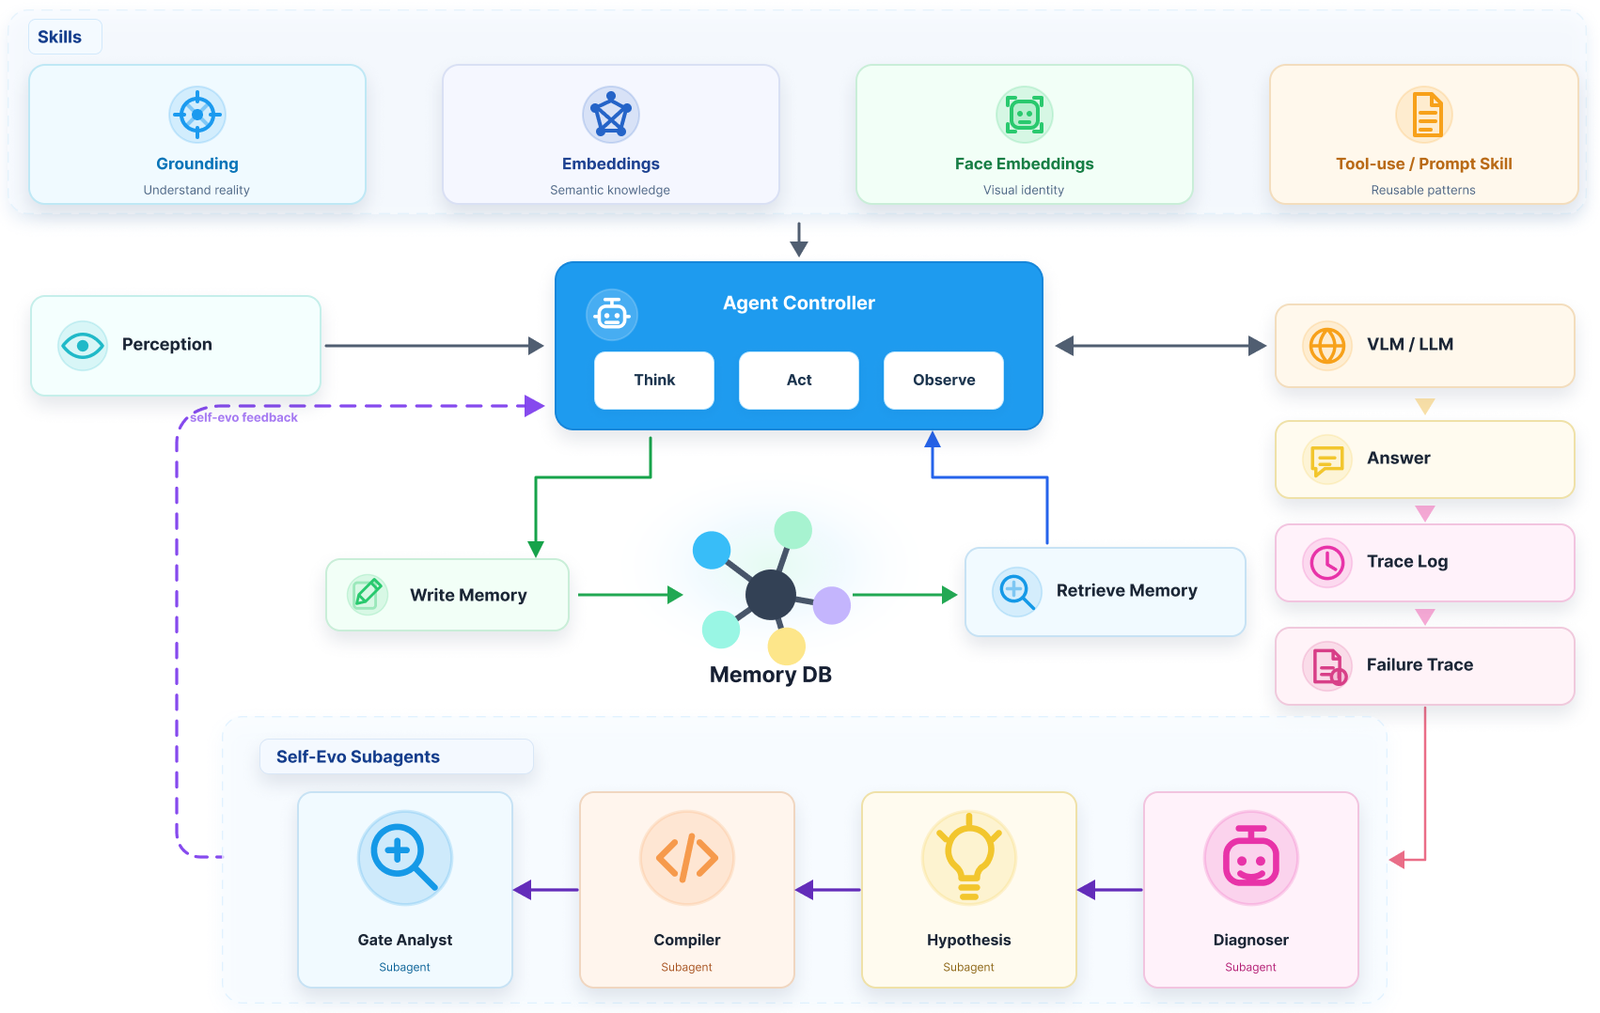
上半在线:观测/交互写入源可追溯记忆图,按任务检索证据,并记录「检索-回答」轨迹(审计线索);下半离线:失败轨迹 → 诊断 → evo-assets。这张图是「OS 内存子系统」的完整数据流:写入 → 检索 → 留痕 → 修补。
Figure 4:失败→进化实例
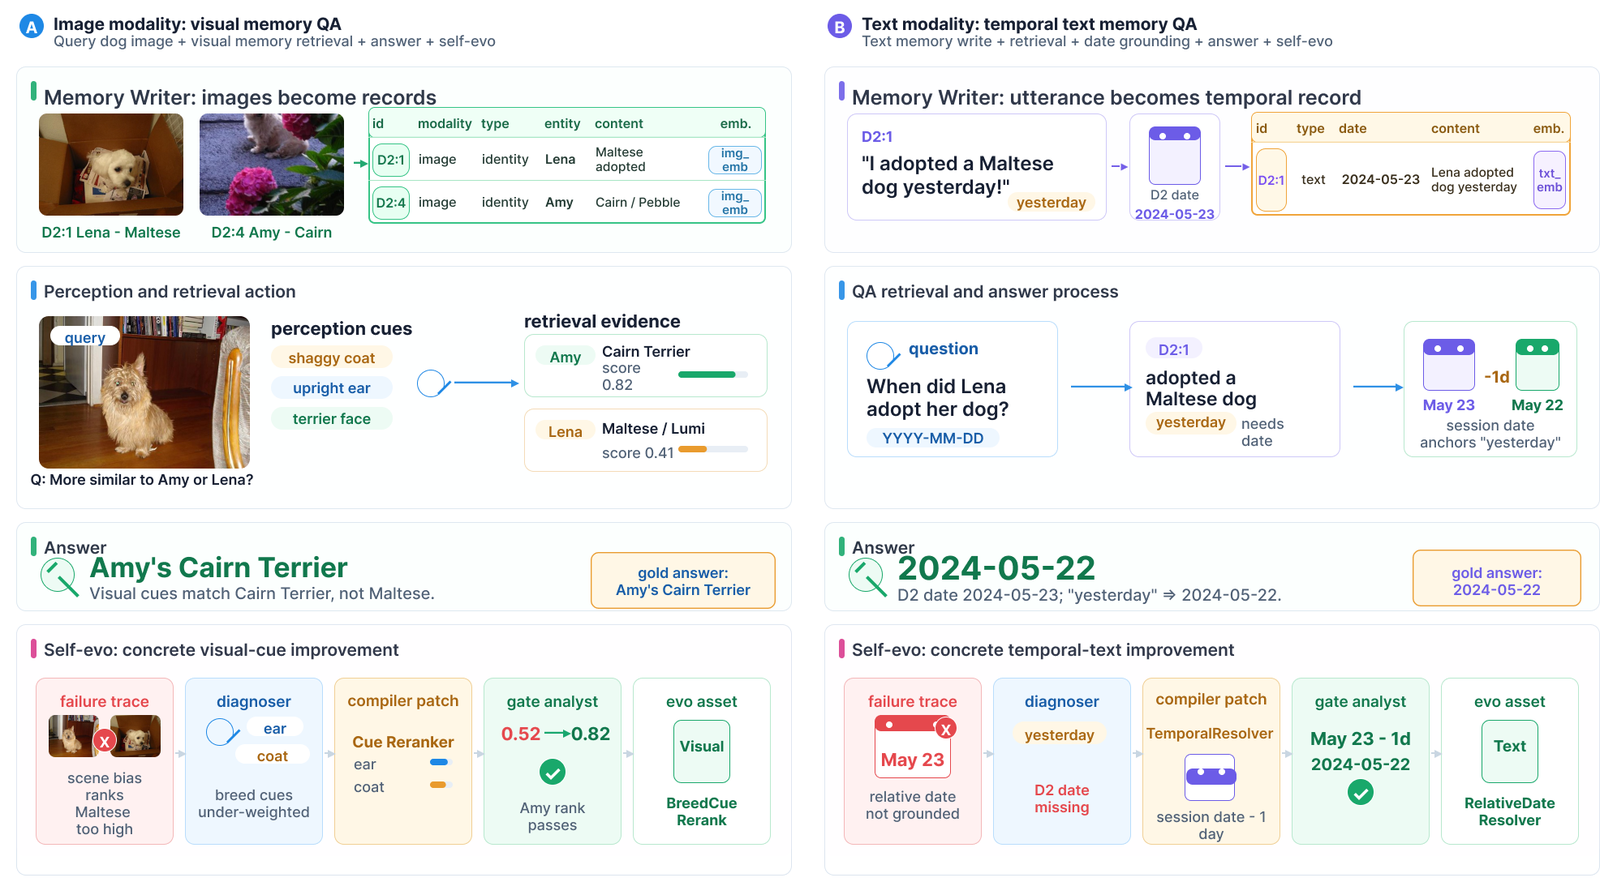
左:视觉记忆问答能调出「图像证据」证明身份,但暴露品种级线索缺失;右:时间文本记忆用会话元数据解析相对日期,但暴露时间归一化错误。解读:自进化不是玄学——每条 evo-assets 都对应一个可复述的失败机理(缺什么线索、错在哪个归一化)。
Figure 5:EmbodiedWorldBench 总览
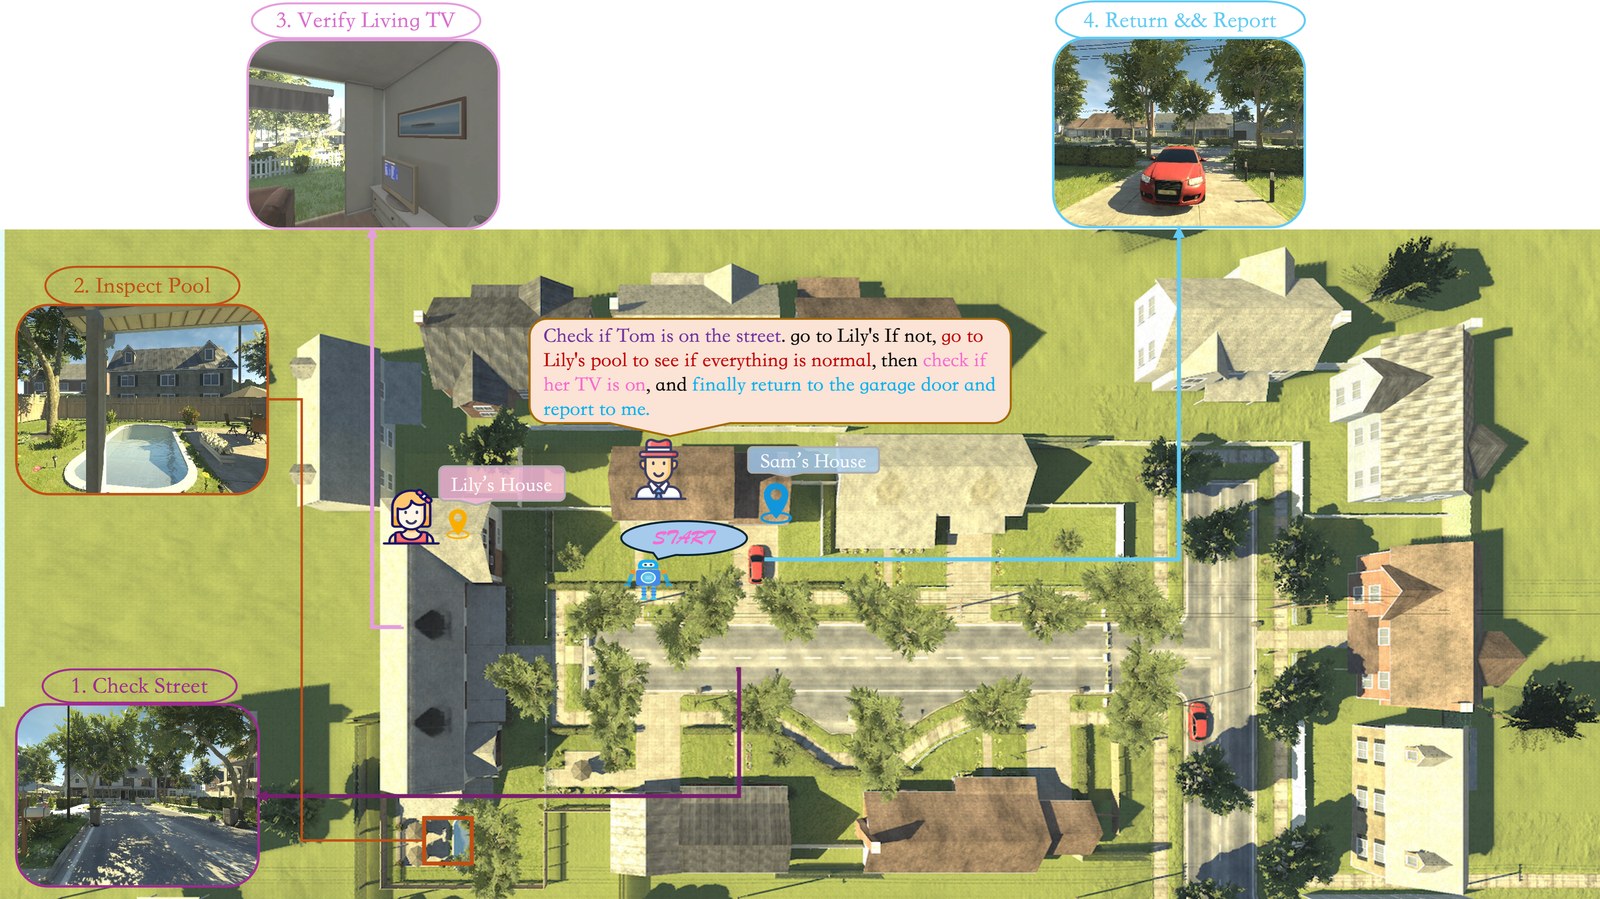
16 个室内外混合场景 × 4 难度的复合任务示意:导航 + NPC 交互 + 环境感知紧耦合(走到-对话-取证-离开),200+ 任务。评测含义:光会导航不够,光会聊天也不够——TSR 要求全部子目标与终态条件同时满足。
Figure 6:学生策略训练管线
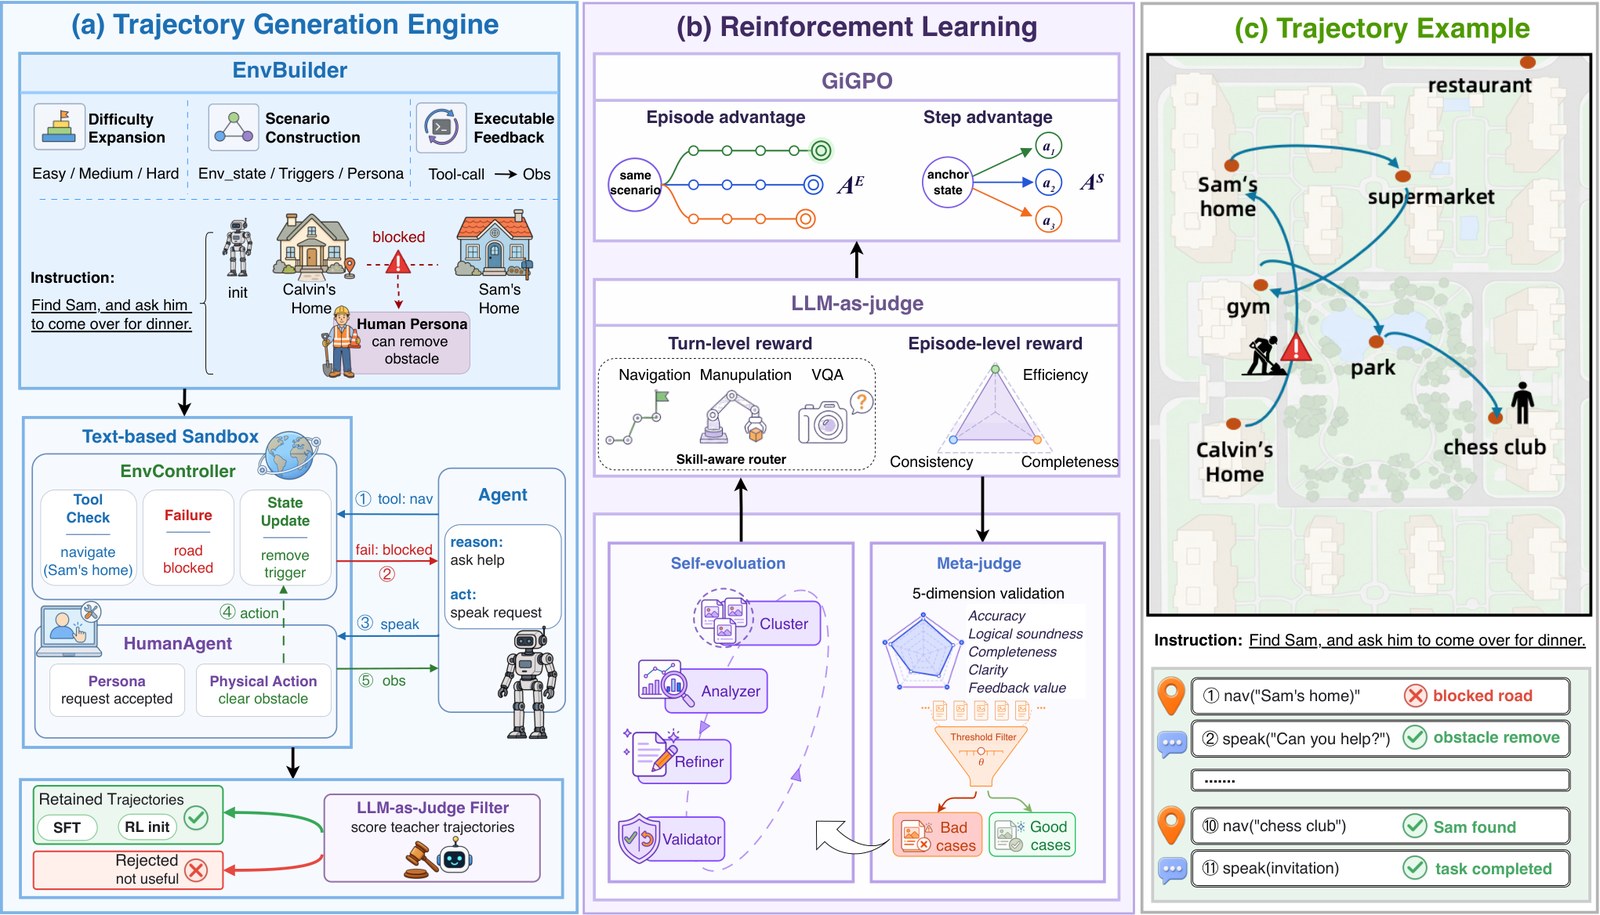
三步:可控文本环境构造 → 教师轨迹蒸馏(SFT 初始化)→ 在线 RL(LLM-as-Judge 奖励 + GiGPO 相对优势),产出可部署的学生策略。定位:大脑 OS 不只服务「调 API 的 agent」,还能蒸馏成上机策略——与 π0.7 的教练→自主 路线异曲同工(那边语言教练,这边文本环境+Judge)。
Figure 7:终身自进化的 split 铁律
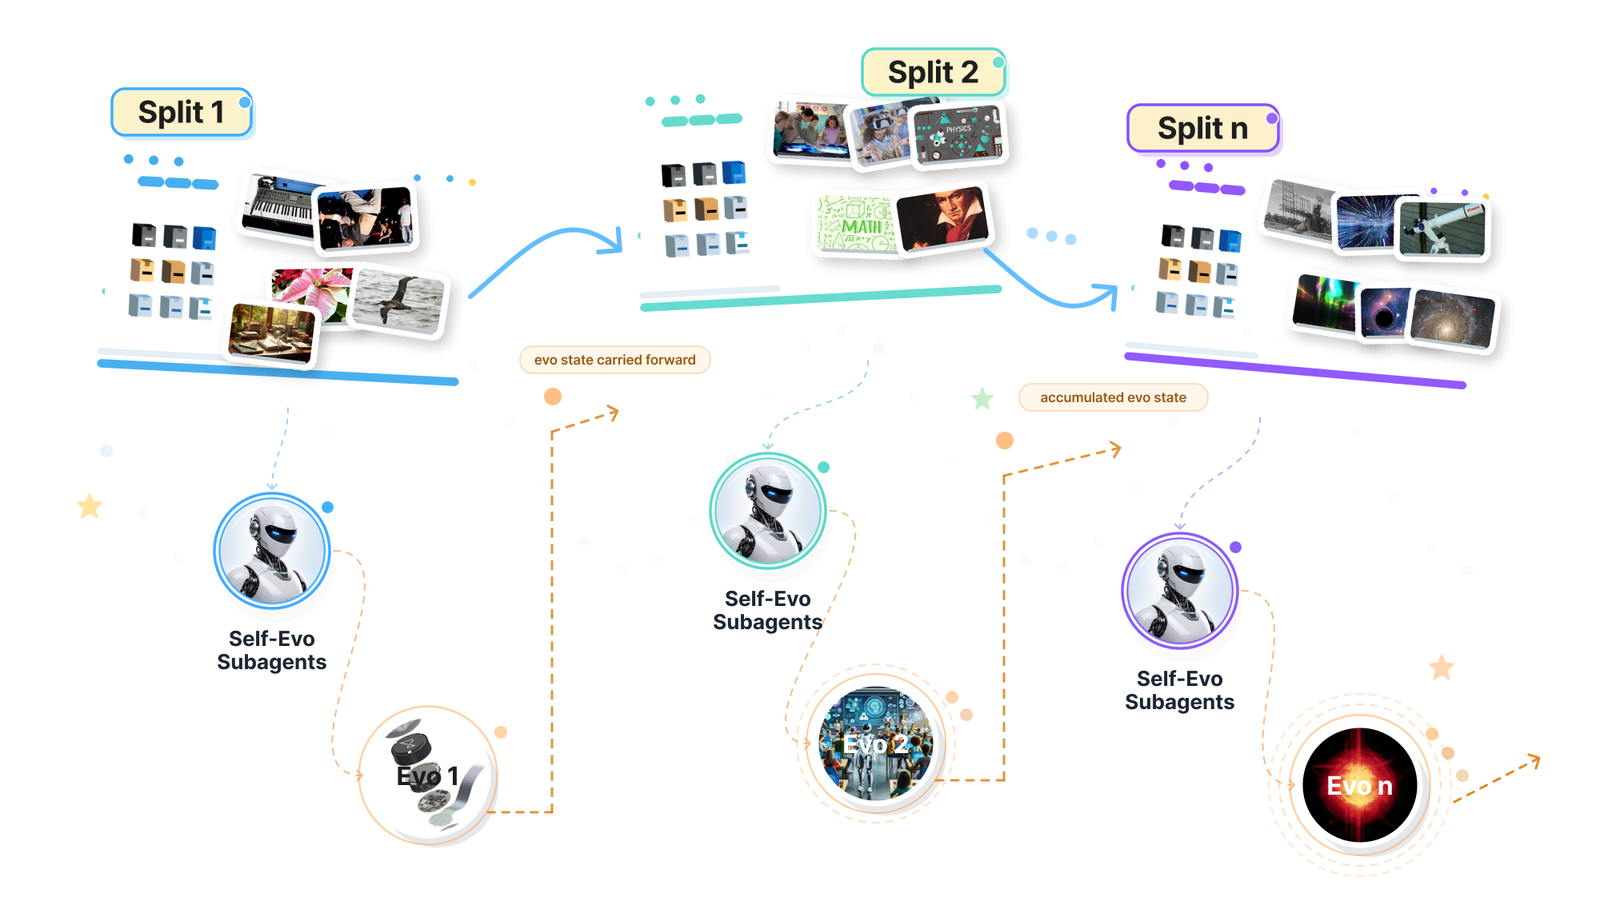
流水线:每个 split 只能用之前 split 晋升的 evo-assets;当前 split 的失败在评测之后才被诊断、门控;通过者仅供后续。这是防泄漏的核心机制——类比软件版本管理:补丁只能打给下一个版本,不许回头改考卷。
Figure 8:各基准自进化增益
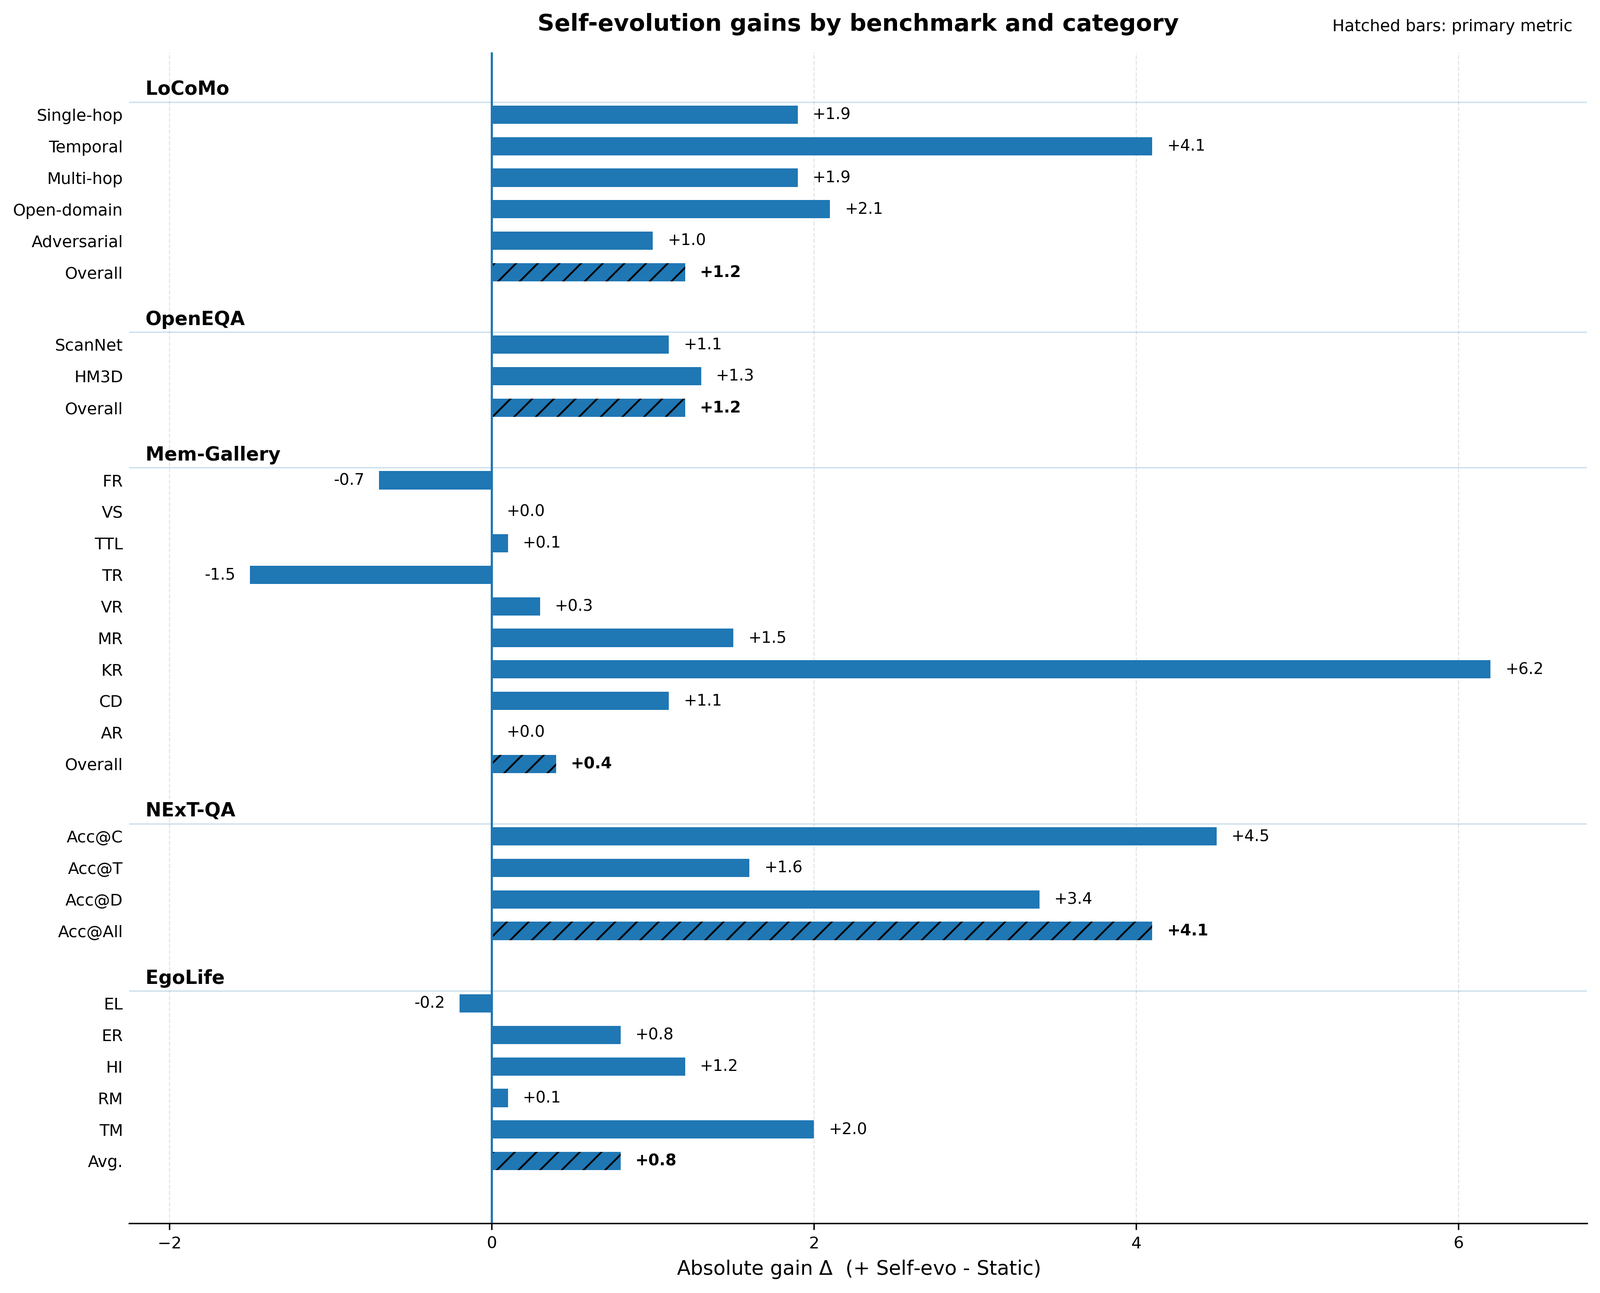
柱状图:Static → +Self-evo 的绝对分数变化(阴影柱=各基准主指标)。对照摘要数字:LoCoMo 87.5→88.7、OpenEQA 59.9→60.4、Mem-Gallery 88.6→89.0——增益不大但方向全正,且严格是在「不碰当前题」前提下挣的。
🧪 实验:三张表讲完
- 架构 vs 模型(Table 1):同 Qwen3.6-Plus,本文架构 TSR +11.99、GCR +10.84——分层执行、任务记忆、技能反馈、收尾验证的净贡献;换 DeepSeek-V4-Pro 再 +6.22/+5.83——架构与模型双升级都有效(Read 小白表里的两行对照)。
- 记忆问答(Table 2–6):LoCoMo 按题型(单跳/时间/多跳/开放域/对抗)、OpenEQA 按数据源(ScanNet/HM3D)、Mem-Gallery 按 9 类、NExT-QA 按因果/时序/描述、EgoLifeQA 按 5 类——分题型暴露强弱项,自进化只在门控后的 split 上加分。
- 门控审计(Table 7–9):OpenEQA 代表 split 的候选资产、门控结果、8-split 全轨迹——论文连「候选被拒」都披露,接受≠终身保留,新资产可能后续又被淘汰——「可审计」不是口号。
💡 评析:三个亮点,三条边界
三个亮点
- OS 骨架名副其实:进程(Skill Runner)、内存(图记忆)、系统调用(工具)、调度(边云路由)、补丁管理(evo-assets 门控)一一对得上——比很多只改名的「XX-OS」完整。
- 防泄漏的自进化协议:split 时序 + 候选门控 + 全轨迹披露,把「越测越强作弊」的质疑提前堵死——与 RoboDojo 的隐藏布局哲学同款。
- 同模型消融干净:ReAct vs 本文同底座比,架构贡献可归因;再展示换强模型的叠加收益。
三条边界
- 分数是自报子集:EmbodiedWorldBench「initial subset」结果,论文自己也说「只谈主趋势、不做细粒度断言」——离正式榜单还有距离。
- 增益绝对值有限:自进化 +0.5~1.2 分级别,长期看需更多 split 才知是否持续。
- 真机证据薄:重心在运行时与记忆协议,上机部署(学生策略)给了管线但缺大篇幅真机成绩。
🗺️ 在「具身大脑系统」谱系里的位置
- 姊妹视角:RoboOS-NeXT 解决多机共享记忆 + 调度;本文解决单机完整 OS + 终身自进化——一篇像「团队协作制度」,一篇像「个人电脑操作系统」。
- 与经验演化线互补:EmbodiedEvo / HexaShell 把经验存成代码与教训;本文存成带类型与来源的记忆图 + 门控补丁——两条「终身学习」路线的存储格式之争。
- 与策略层衔接:学生策略蒸馏线(Fig. 6)对应 π0.7 教练→自主;底层动作可接任意 RoboDojo 上榜策略。
- 谱系标签:Agent OS / 图记忆 / 失败驱动自进化。
📊 图表总索引
| 图 | 内容 | 本站文件 |
|---|---|---|
| Figure 1 | 系统架构:边云双 LLM + Harness | 本文插图 |
| Figure 2 | Agent Harness 推理-执行-验证环 | 本文插图 |
| Figure 3 | 多模态记忆架构(在线/离线) | 本文插图 |
| Figure 4 | 失败→进化两个实例 | 本文插图 |
| Figure 5 | EmbodiedWorldBench 总览 | 本文插图 |
| Figure 6 | 学生策略训练管线 | 本文插图 |
| Figure 7 | 自进化 split 时序铁律 | 本文插图 |
| Figure 8 | 各基准自进化增益 | 本文插图 |
(Table 1 agent 对照、Table 2–6 记忆基准、Table 7–9 门控审计——正文已复现关键数字。)
❓ 自测 Q&A
Q1:Tiny LLM 和大 LLM 怎么分工?
端侧 Tiny 模型处理每一回合(观察、轻推理),任务变难时按需路由升级到云端大模型——省钱、低延迟、离线可用。
Q2:Skill Runner 为什么不是「一次性函数调用」?
技能是持续过程(导航 5 米要连续控制与检查进度);Skill Runner 保持过程连续性、屏蔽程序细节,主 LLM 只看进度与结论。
Q3:TSR 和 GCR 差在哪?
TSR 要求全部子目标与终态满足才算成功(最严);GCR=满足子目标的比例,能反映「走到了但没聊完」这类部分完成。
Q4:evo-assets 为什么只能给以后的 split 用?
若当前 split 失败诊断出的补丁能立刻用回当前测试,等于对着答案改卷;只准向后生效,分数才是真的在涨。
Q5:和 RoboOS-NeXT 怎么选?
单机 OS 全家桶(边云/图记忆/自进化/学生蒸馏)→ 本文;多机共享记忆与编队调度 → RoboOS-NeXT。两者都以「记忆是大脑系统的地基」为共同前提。
📚 资源与延伸
- 论文:arXiv 2607.10350;项目页 amap-cvlab.github.io/ABot-AgentOS
- 姊妹篇:RoboOS-NeXT 精读
- 同主题精读:EmbodiedEvo 精读、HexaShell 精读、π0.7 精读、RoboDojo 精读
- 知识铺垫:什么是世界模型、Chain-of-Thought 推理详解