📄 论文信息
- 标题:Alpamayo-R1: Bridging Reasoning and Action Prediction for Generalizable Autonomous Driving in the Long Tail
- arXiv:2511.00088(2025年10月,2026年1月更新 v2)
- 团队:NVIDIA(42+ 位作者,NVIDIA CES 2026 发布)
- 开源:模型权重 huggingface.co/nvidia/Alpamayo-R1-10B,推理代码 github.com/NVlabs/alpamayo
- 一句话总结:把 结构化因果推理链(Chain of Causation) 与 GRPO 强化学习后训练 引入 VLA 驾驶策略,让模型在长尾场景中不仅能"开得好",还能"解释为什么这么开"。
一、动机:模仿学习的天花板与推理的必要性
当前端到端自动驾驶的主流范式是模仿学习(IL)——用海量人类驾驶数据做行为克隆。IL 让模型学会了"正常开车",但在安全关键的长尾场景中表现脆弱。原因有两个:
1. 监督稀疏:长尾场景(鬼探头、加塞、施工绕行等)在人类驾驶数据中占比极低,模型没有足够样本学习正确的应对方式。即便数据规模再大,长尾的分布天然是稀疏的。
2. 因果理解缺失:IL 拟合的是行为的相关性(“这个画面 → 这个动作”),而非决策的因果性(“因为前方有行人横穿,所以减速让行”)。一旦遇到训练集中未见过的情况,模型不具备因果推理能力,很容易崩溃。
NVIDIA 的解法思路非常明确:不试图用更多数据覆盖更多场景,而是让模型学会"推理"——在决策之前,先基于场景观测构建因果链,再驱动轨迹生成。这就是 AlpaMayo-R1 的核心设计哲学。
二、架构总览:VLA 三组件 + 模块化设计
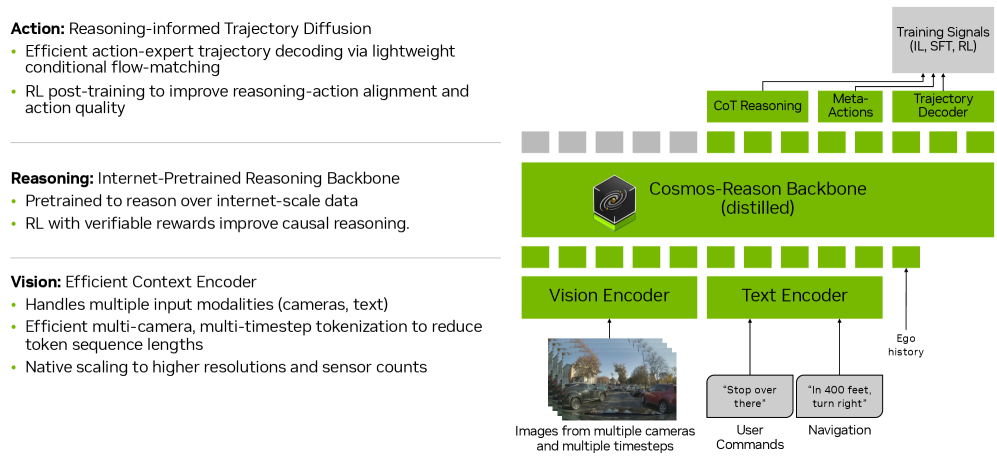
AlpaMayo-R1 是一个模块化的 VLA(Vision-Language-Action)模型。架构的核心哲学是模块化——可以替换任意 VLM 骨干,同时保持领域特定的视觉编码和动作解码组件。
2.1 问题形式化
输入:历史多帧多摄图像 $o_{\text{image}}$ + 自车运动历史 $o_{\text{egomotion}}$
输出:推理链 Reason + 未来 6.4s 轨迹 $\tau$
序列公式:
$$[o_{\text{image}}, o_{\text{egomotion}}, \text{Reason}, \tau]$$每个元素都以前面的所有元素为条件。
轨迹 $\tau$ 包含 64 个 waypoint(10Hz 采样):
$$\tau = \{(x^i, y^i, \theta_{\text{yaw}}^i)\}_{i=1}^{64}$$2.2 视觉编码:高效的多摄多帧处理
自动驾驶车辆通常有 6-10 个摄像头。如果每个摄像头独立编码,token 数量会线性增长,导致推理不可实时。AlpaMayo-R1 支持三种图像 tokenization 策略:
| Tokenization 策略 | 方式 | token/帧 | 适用 |
|---|---|---|---|
| 单帧单摄编码 | ViT patch + 双线性下采样(448×280→160 token/图) | ~1120(7摄) | 默认配置 |
| 多摄联合编码 | Triplane 3D 隐式编码(固定大小 288 token) | 288(固定) | 多摄场景 |
| 多摄视频编码 | Flex 全自注意力压缩多帧多摄 | 可压缩至~50 | 极限压缩场景 |
其中 Triplane 方法 是一个关键创新:将多摄图像投影到三个正交平面(xy, xz, yz),用固定大小的 triplane grid 表示全景场景。无论有多少个摄像头、多高分辨率,triplane token 数量恒定(例如 Sx=Sy=96, Sz=48, px=py=pz=8 → 288 token)。相比单帧单摄编码,压缩比达 3.9× 且指标几乎无损。
2.3 VLM 骨干:Cosmos-Reason
AlpaMayo-R1 采用 Cosmos-Reason 作为 VLM 骨干。Cosmos-Reason 是 NVIDIA 专为 Physical AI 设计的 VLM,在 370 万 VQA 样本上做过后训练,以发展物理常识和具身推理能力。其中包含:
- 24,700 个驾驶场景视频 VQA 样本(场景描述、驾驶难度标注、推理链)
- 使用 DeepSeek-R1 蒸馏的"下一步动作"推理链数据
为了适配自动驾驶部署,NVIDIA 在 Cosmos-Reason 基础上补充了:
- 跨物理 AI 领域(机器人、医疗、智能城市、制造等)的多领域预训练
- 自动驾驶专项 10 万样本(关键目标标注 + 下一步动作推理)
2.4 动作解码:基于 Flow Matching 的轨迹生成
动作解码是 VLA 模型最难的部分之一——既要保证生成精度,又要满足实时推理约束。
为什么不直接用 x,y 坐标回归? 原始位置 waypoint 空间对传感器噪声敏感,容易影响模型收敛;且下游控制器通常会对轨迹做平滑处理。
AlpaMayo-R1 的解法:基于单轮动力学模型(Unicycle Dynamics)的控制量表示。
控制量 $a = \{(a^i, \kappa^i)\}_{i=1}^{64}$(加速度 + 曲率),通过欧拉积分映射到轨迹:
$$\mathbf{x}^{i+1} = f(\mathbf{x}^i, a^i, \kappa^i, \Delta T)$$这个表示同时包含位置、航向角、速度、加速度/曲率,比直接回归 waypoint 更稳定、更物理合理。
Flow Matching 解码器:将离散轨迹 token 映射为连续 waypoint。采用 $\pi_{0.5}$-KI 的策略——VLM 输出离散 token,一个独立的"动作专家"(action-expert)模块用 Flow Matching 解码为连续轨迹。这种"离散 token + 连续解码"的设计既保留了 VLM 训练的高效性,又保证了轨迹生成的精度和动力学可行性。
三、Chain of Causation 数据集:因果链标注
这是 AlpaMayo-R1 最有特色的贡献。现有的驾驶推理数据集存在三个普遍问题:
- 行为描述模糊:“the ego vehicle should be cautious”——到底该怎么操作?缺乏与具体轨迹的绑定。
- 推理浅表化:“晴天、宽路"这类与决策无直接因果关系的因素。
- 因果混淆:标注员看了完整视频(包括未来帧),标注了模型不可观测的"未来因素”。
3.1 结构化 CoC 格式
AlpaMayo-R1 把每个推理样本拆分为三个结构化组件:
| 组件 | 定义 | 是否闭集 |
|---|---|---|
| 驾驶决策 Driving Decision | 当前时刻的纵向+横向操控意图 | 闭集(8纵×8横) |
| 关键因素 Critical Components | 影响决策的场景元素(目标、红绿灯、道路事件等) | 开集(可扩展) |
| CoC 推理链 | 将决策和因果因素组合为自然语言推理链 | 动态生成 |
3.2 闭集驾驶决策
纵向决策(至多选1个):
| 决策 | 含义 |
|---|---|
| Set speed tracking | 无约束下保持/达到目标速度 |
| Lead obstacle following | 与前车保持安全时距 |
| Speed adaptation (road events) | 为道路特征(弯道、减速带等)调整速度 |
| Gap-searching (for LC/merge) | 为变道/合流匹配目标车道车速或创造空档 |
| Acceleration for passing/overtaking | 加速超越慢车 |
| Yield (agent right-of-way) | 让行有路权的目标(行人、交叉车流等) |
| Stop for static constraints | 在控制点(停止线、红灯等)减速至停止 |
横向决策(至多选1个):
| 决策 | 含义 |
|---|---|
| Lane keeping & centering | 保持在车道内,不越线 |
| Merge / Split (facility change) | 设施间过渡(匝道↔主路) |
| Out-of-lane nudge | 短暂越线避障后回到原车道 |
| In-lane nudge | 车道内偏移避障 |
| Lane change (lateral push) | 变道到相邻车道 |
| Pull-over / curb approach | 靠边/停靠 |
| Turn | 转弯/掉头 |
| Lateral maneuver abort | 取消正在进行的横向操作并回到车道中心 |
这套闭集设计确保推理链直接锚定到具体驾驶行为,杜绝了"be cautious"这类模糊描述。
3.3 混合标注管线
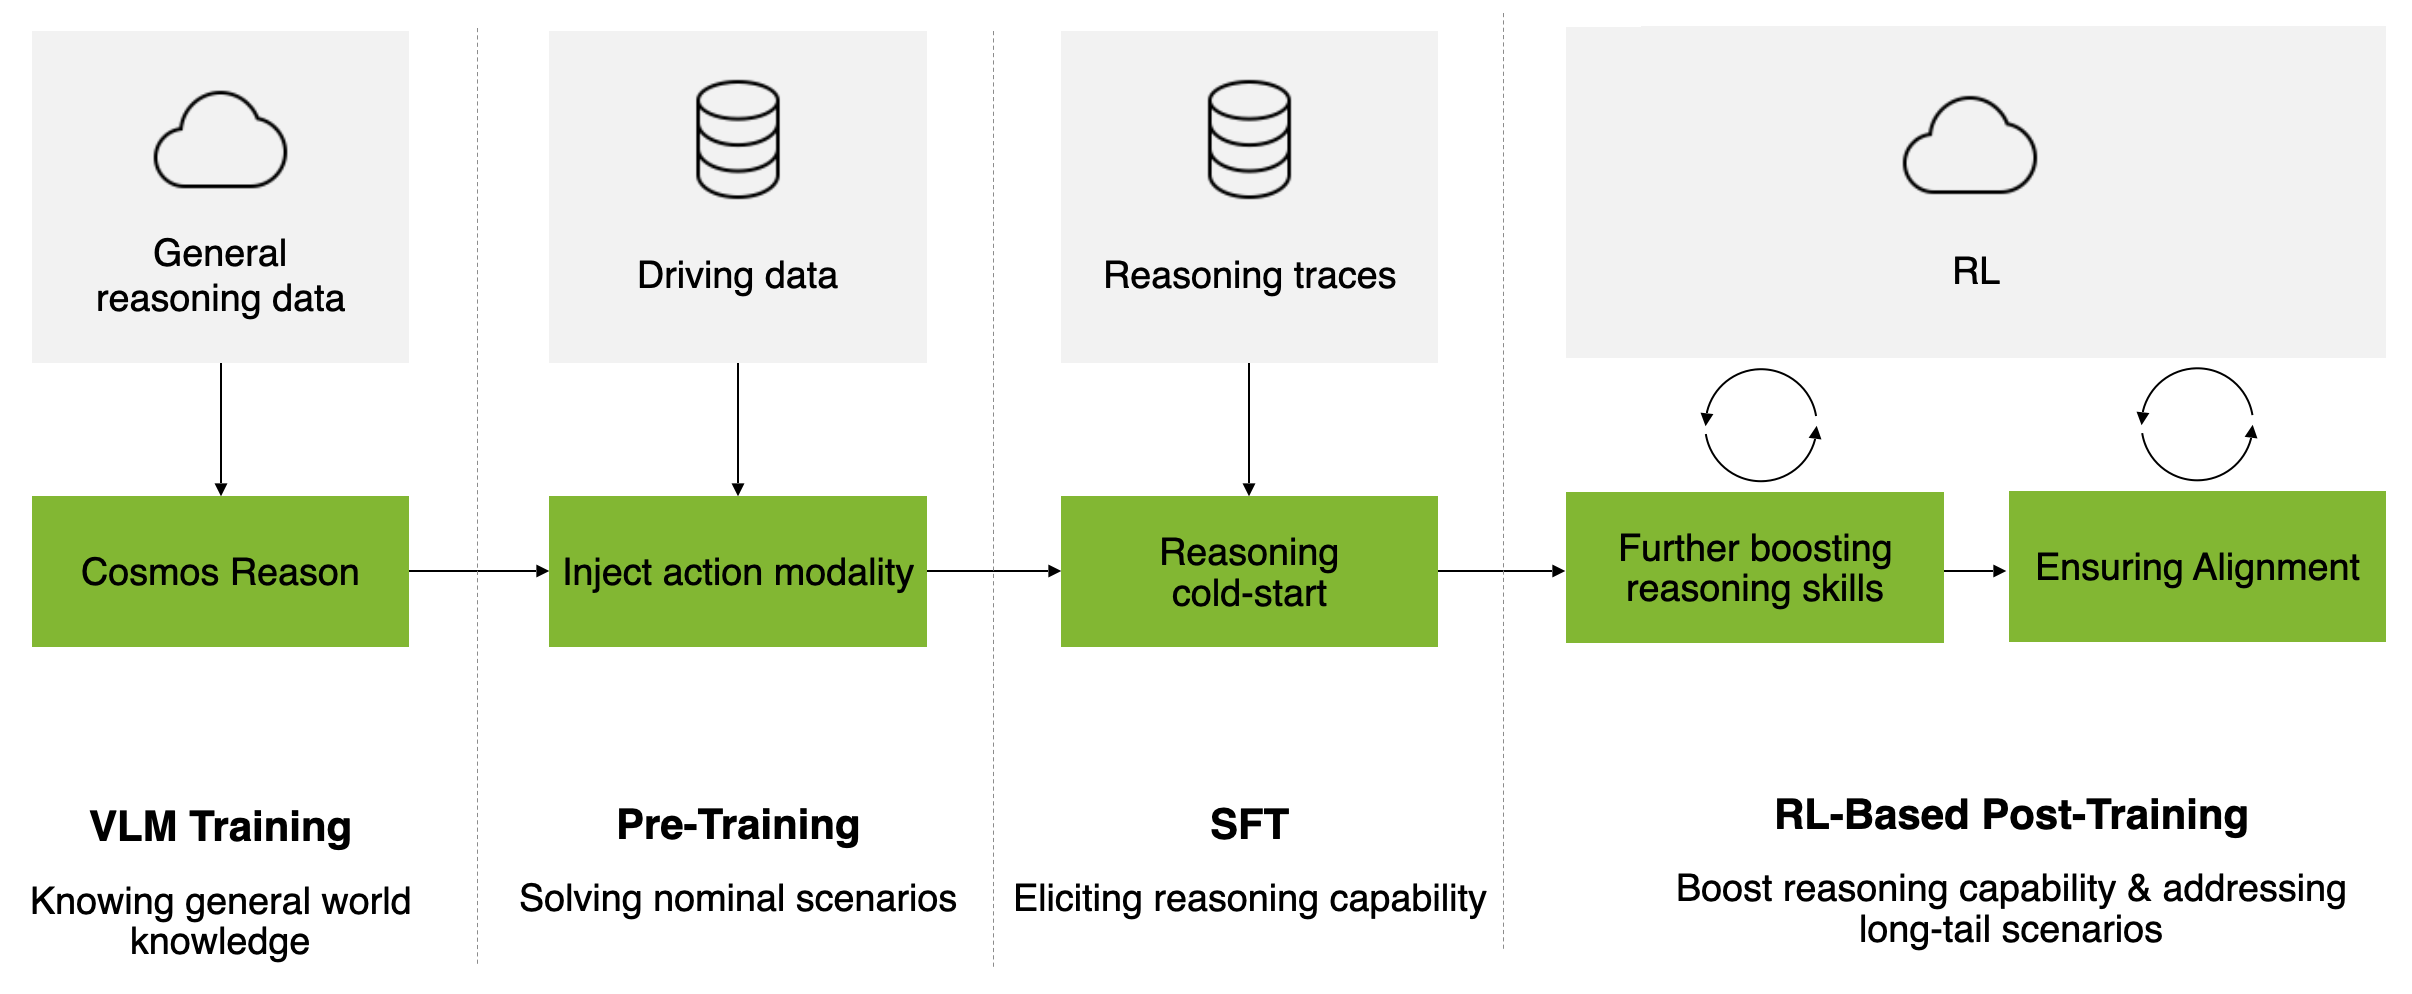
NVIDIA 设计了一个五步标注管线,兼顾质量与规模:
片段选择:从海量驾驶数据中筛选"包含明确驾驶决策"的片段。分为两类:
- 被动场景:自车必须立即响应的事件(前车刹车/红灯/行人横穿等),14 种
- 主动场景:自车需要主动评估和预判的情况(变道准备/预判减速等),5 种
关键帧定位:在片段中精确定位"决策时刻"。
- 被动场景:事件触发后 0.5s 作为关键帧
- 主动场景:标注决策准备区间(起始和结束帧)
标注关键因素:只标注在关键帧之前的观测窗口内可观测的因素,禁止引用未来信息。
确定驾驶决策:从闭集中选择匹配的纵向/横向决策。
组装 CoC 链:将决策与关键因素组合为自然语言推理链。
3.4 自动标注 + 人工校验
为了规模化,NVIDIA 采用混合方案:
- 自动标注:用 Qwen3-VL 等教师 VLM 生成结构化 CoC 样本(注入驾驶先验 + 元动作定义)
- 人工标注:覆盖 ODD(天气/光照/路况)、交通法规、关键目标因果推理等高要求部分
- 人工校验:对自动标注结果做抽样审核,保证质量
这种混合方式平衡了规模(自动标注千万级)和质量(人工保证因果准确性)。
四、三阶段训练策略
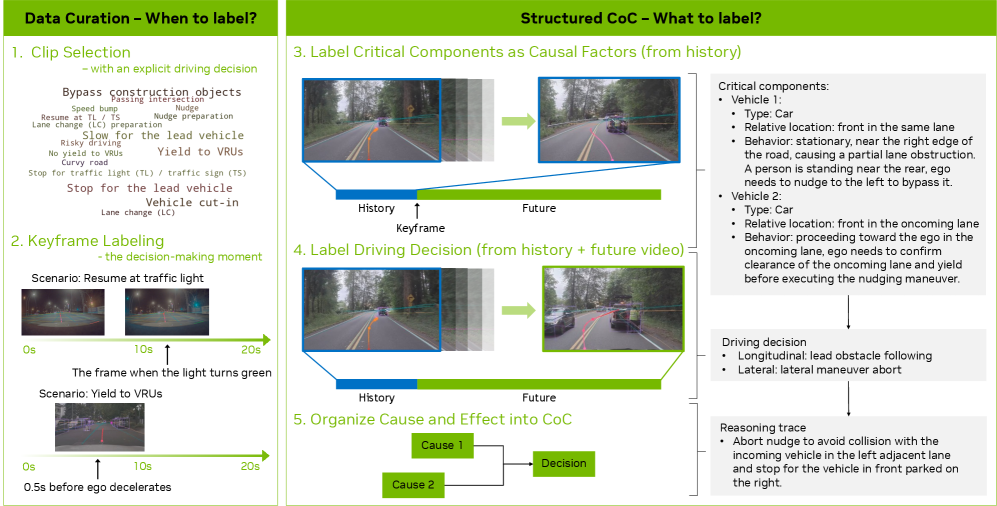
Stage 1:动作模态注入
让 VLM 学会输出驾驶动作。方法:
- 将轨迹 $\tau$ 编码为离散 token(均匀量化控制量 $a$)或连续 embedding(sinusoidal positional encoding + MLP)
- 与文本 token 一起送入自回归 VLM
- 训练目标:标准的 next-token prediction
这个阶段的输出是一个能理解并生成轨迹的 VLA。同时训练 Flow Matching 动作解码器。
Stage 2:推理能力激发
用 CoC 数据集做 SFT,让模型学会输出结构化因果推理链。
数据格式:
- 输入:多摄图像 + 自车历史
- 输出:[CoC 推理链 → 轨迹 token]
经过 Stage 2,模型能够在做出驾驶决策之前,先生成一段自然语言推理链,解释"为什么这么开"。
Stage 3:RL 后训练
最关键的阶段。用 GRPO(Group Relative Policy Optimization)来做强化学习后训练。
为什么用 GRPO 而不是 PPO?
PPO 的 advantage 估计依赖一个价值网络(critic)$V(s)$。但在自动驾驶场景中,critic 很难训:
- 状态空间巨大(高维感知)
- 回报稀疏(碰撞是低概率事件)
- critic 本身就是个和 policy 差不多大的回归网络
GRPO 的核心创新:用"组内相对"替代 critic。
对同一场景 $s$,采样 G 条候选轨迹 $\{a_1,...,a_G\}$,做组内标准化:
$$A_i = \frac{r_i - \text{mean}(\{r_1,...,r_G\})}{\text{std}(\{r_1,...,r_G\}) + \epsilon}$$无需价值网络,省一半显存,训练更稳定。
GRPO 目标函数:
$$ \mathcal{J}{\text{GRPO}}(\theta) = \mathbb{E}\left[\frac{1}{G}\sum{i=1}^G\frac{1}{|\tau_i|}\sum_{t=1}^{|\tau_i|} \min\left(w_t^{(i)}A_i,\ \text{clip}(w_t^{(i)}, 1-\epsilon, 1+\epsilon)A_i\right)
- \beta,\mathbb{D}{\text{KL}}(\pi\theta|\pi_{\text{ref}})\right] $$
其中 $w_t^{(i)}$ 是 importance ratio,$\pi_{\text{ref}}$ 是参考策略(Stage 2 的模型),KL 散度防止策略退化。
Reward 模型设计
RL 奖励函数包含三个独立维度:
| 奖励项 | 评估内容 | 评估方式 |
|---|---|---|
| 推理质量 | 推理链的逻辑合理性、场景相关性 | 大模型评分(VLM as judge) |
| 推理-动作一致性 | 生成的轨迹是否与推理链中的决策一致 | 自动规则检查 |
| 轨迹质量 | 安全/舒适/效率多目标 | 仿真器碰撞检测 + 运动学指标 |
这三个奖励一起优化,确保模型不仅"做对了",还能"解释正确且言行一致"。
RL 训练基础设施
大规模 RL 训练需要高效的基础设施。NVIDIA 设计了专门的 RL 训练框架:
- 在仿真环境中批量 rollout(每帧采样 G 条轨迹)
- 用 VLM 对推理链质量做自动评分
- 支持分布式训练(模型并行 + 数据并行)
- 训练过程中动态过滤低质量数据,提高训练效率
五、实验与结果
5.1 开环规划准确率
在挑战性场景(long-tail cases)中:
| 模型 | 规划准确率 | 提升 |
|---|---|---|
| 纯轨迹基线(无推理) | baseline | — |
| AlpaMayo-R1(w/ CoC + RL) | +12% | ↑ 12% |
推理链的引入让模型在复杂、罕见场景中的表现显著提升。
5.2 闭环仿真安全指标
| 指标 | 纯轨迹基线 | AlpaMayo-R1 | 改善 |
|---|---|---|---|
| 碰撞率(off-road rate) | baseline | -35% | ↓ 35% |
| 近距离冲突率(close encounter) | baseline | -25% | ↓ 25% |
闭环环境的改善尤其关键——这证明了推理链 + RL 的组合不仅提升了"纸上谈兵"的开环指标,也改善了真实的驾驶安全性。
5.3 RL 后训练效果
| 指标 | SFT 后 | + RL 后 | 提升 |
|---|---|---|---|
| 推理质量(大模型评分) | baseline | +45% | ↑ 45% |
| 推理-动作一致性 | baseline | +37% | ↑ 37% |
推理质量 +45% 说明 GRPO 后训练确实让模型学会了"更好的推理"(不仅推理结果正确,过程更合理)。推理-动作一致性 +37% 则是验证了"言行一致"——模型推理链中说要减速,轨迹也真的减速了。
5.4 消融实验
VLM 骨干选择
| 模型 | 规划准确率 |
|---|---|
| Alpamayo-VA(纯轨迹,无推理) | baseline |
| Alpamayo-R1 w/ 8B VLM | +8% |
| Alpamayo-R1 w/ Cosmos-Reason | +12% |
Cosmos-Reason 的 Physical AI 预训练带来了显著的额外收益。
模型缩放律
从 0.5B 到 7B 参数,性能持续提升、无饱和迹象。更大模型 = 更好规划 + 更好推理。
动作模态注入方式
| 方式 | 收敛速度 | 闭环表现 |
|---|---|---|
| 离散 token | 快 | 中等 |
| 连续 embedding | 慢 | 较好 |
| 离散 token + Flow Matching(最终方案) | 快 | 最优 |
离散 token + Flow Matching 策略在训练效率和闭环性能之间取得了最佳平衡。
视觉编码效率
| 方法 | token/帧 | 压缩比 | 规划准确率 |
|---|---|---|---|
| 单帧单摄 | 1120 (7cam) | 1× | baseline |
| Triplane 多摄 | 288 | 3.9× | ≈baseline |
| Flex 视频 | ~50 | ~20× | ≥baseline |
Flex 方法最惊艳:20 倍压缩的同时没有降低规划准确率,说明视频级别的 tokenization 可以高效利用跨帧信息冗余。
5.5 真车路测
- 端到端延迟:99ms(满足 10Hz 实时控制要求)
- 部署场景:城市道路复杂交通环境
- 推理链可以在车载上实时生成,用于安全监控和可解释性
六、与现有方法的对比
| 维度 | AutoVLA | DriveVLM | AlpaMayo-R1 |
|---|---|---|---|
| 推理形式 | 自适应"think vs. act" | 自由格式 CoT | 结构化 CoC |
| 推理锚定 | 松散 | 松散 | 闭集驾驶决策 |
| 因果约束 | 无 | 无 | 显式因果链接 |
| RL 后训练 | 无 | 无 | GRPO(推理+一致性+轨迹) |
| 轨迹解码 | 自回归 waypoint | 自回归 waypoint | Flow Matching + 单轮动力学 |
| 视觉编码 | 单帧 | 单帧 | 多摄 Triplane/Flex |
| 模型缩放 | 有限 | 有限 | 0.5B→7B 持续提升 |
AlpaMayo-R1 的核心差异化优势:
- 结构化推理:闭集决策 + 开集因素,确保推理链的决策锚定性
- 因果完整性:强制关键帧分割,避免因果混淆
- RL 后训练的完整性:同时优化推理质量、一致性和轨迹质量
- 工程完备性:多摄高效编码 + 实时推理(99ms)+ 真车部署
📊 方法特性总结
| 组件 | 作用 | 解决什么问题 |
|---|---|---|
| CoC 结构化推理 | 决策锚定的因果推理链 | IL 的因果理解不足 + 模糊推理 |
| Cosmos-Reason VLM | 具身推理预训练 VLM | 通用 VLM 的驾驶领域适应 |
| Flow Matching 解码器 | 离散→连续轨迹生成 | 轨迹精度 + 多模态 + 实时性 |
| Triplane/Flex 编码 | 高效多摄多帧 tokenization | 推理延迟与 token 数量的矛盾 |
| GRPO 后训练 | 组相对优势优化策略 | PPO critic 训不准 + reward hacking |
📝 个人思考
AlpaMayo-R1 是 2025-2026 年自动驾驶论文中我评价最高的工作之一。不是因为它的指标最惊艳(规划准确率 +12% 虽然不错但并不夸张),而是因为它同时解决了多个层面的核心问题。
1. “推理"不再是贴片
很多 VLA 论文的"推理"其实是后加的——模型先预测轨迹,再"附上"一段解释。这种推理是装饰性的,对驾驶性能没有实质贡献。AlpaMayo-R1 特别强调 reasoning-action consistency(推理-动作一致性),并通过 CoC 的闭集决策设计确保推理链与轨迹生成之间的因果关系。
这个设计哲学很关键:推理不是为了让论文更"可解释”,而是作为一个功能性组件直接改善驾驶性能。RL 后训练中同时优化推理质量和推理-动作一致性,说明他们把推理放到了和轨迹同等重要的位置。
2. CoC 标注管线的普适价值
CoC 标注管线虽然是为 AlpaMayo-R1 设计的,但其方法论可以推广到整个自动驾驶标注领域。现有的驾驶 VQA 数据集(DriveLM、NuInstruct 等)大量存在"因果混淆"问题——标注员看了完整视频后写出的"推理",模型在做决策时根本看不到这些信息。CoC 的"关键帧分割 + 仅标注历史窗口"原则应该是所有驾驶推理数据集的默认标准。
3. 消融实验的说服力
AlpaMayo-R1 的消融实验质量很高。特别是 Flex 视频 tokenizer 的 20 倍压缩不降指标的实验,以及 0.5B→7B 持续缩放的验证,为后续的工程化部署和模型选型提供了可靠依据。这些消融实验的完整性在自动驾驶论文中并不常见。
4. 一点反思
如果说有什么不足:GRPO 的 reward 模型中使用"VLM as judge"来评估推理质量,这引入了额外的复杂性和潜在的偏见——VLM judge 的偏好偏差会通过 reward 信号传递到策略中。论文中对此的讨论相对有限。不过考虑到这已经是当前 RLVR(Reinforcement Learning with Verifiable Rewards)范式的标准做法,这个批评可能适用于整个领域而非 AlpaMayo-R1 本身。
另外,论文开源了模型权重和推理代码(7B 模型目前是最大的开源驾驶 VLA 模型之一),这对社区的价值很大——不仅是一个方法论报告,还是一个可以实际部署和复用的系统。
总的来说,AlpaMayo-R1 是 VLA + 推理 + RL 后训练这条技术路径上最重要的工作之一。它的 CoC 数据集、结构化推理设计和 GRPO 后训练框架,很大概率会成为后续驾驶 VLA 研究的新基线。
本文基于 arXiv:2511.00088 v2(2026 年 1 月更新)撰写。