📄 论文信息
- 标题:AlphaDrive: Unleashing the Power of VLMs in Autonomous Driving via Reinforcement Learning and Reasoning
- 团队:华中科技大学(hustvl,王兴刚团队)× 地平线机器人(Horizon Robotics)
- arXiv:2503.07608(2025 年 3 月)
- 代码:
github.com/hustvl/AlphaDrive - 关键词:GRPO、推理强化学习、高层规划、VLM、奖励设计
- 一句话总结:首个把 GRPO 推理式强化学习引入自动驾驶规划的工作,靠四个"为规划量身定做"的奖励 + SFT 预热两阶段策略,让 Qwen2VL-2B 反超 7B 模型,并涌现出"一景多解"的多模态规划能力。
🤔 要解决什么问题?SFT 撑不起驾驶推理
OpenAI o1 与 DeepSeek R1 证明了 RL + 推理在数学、代码上能逼近甚至超越人类专家。自动驾驶也有类似诱惑:端到端模型规划很强,却缺常识、缺推理,遇到长尾就翻车。比如"前车顶着一排锥桶行驶"——纯端到端模型看不懂"前车与锥桶的关系",会误判前方施工而急刹。
把 VLM 引入驾驶(DriveVLM、Senna 等)是出路,但它们几乎清一色只用 SFT 监督微调。作者敏锐地指出三个"直接搬 RL 不灵"的根因:
| 障碍 | 数学/代码场景 | 驾驶规划场景 |
|---|---|---|
| 奖励设计 | 答案对错分明 | 不同动作重要性不同(刹车 vs. 保持) |
| 解的唯一性 | 通常唯一解 | 多解并存(直路可匀速可加速) |
| 推理数据 | 教材/题解丰富 | 几乎没有,标注极贵 |
核心问题:如何让 R1 式的推理 RL 真正在驾驶规划上落地?AlphaDrive 的答案是——重新设计奖励 + 用大模型蒸馏推理过程做 SFT 预热。
🏗️ 架构总览:GRPO + VLM 训练框架
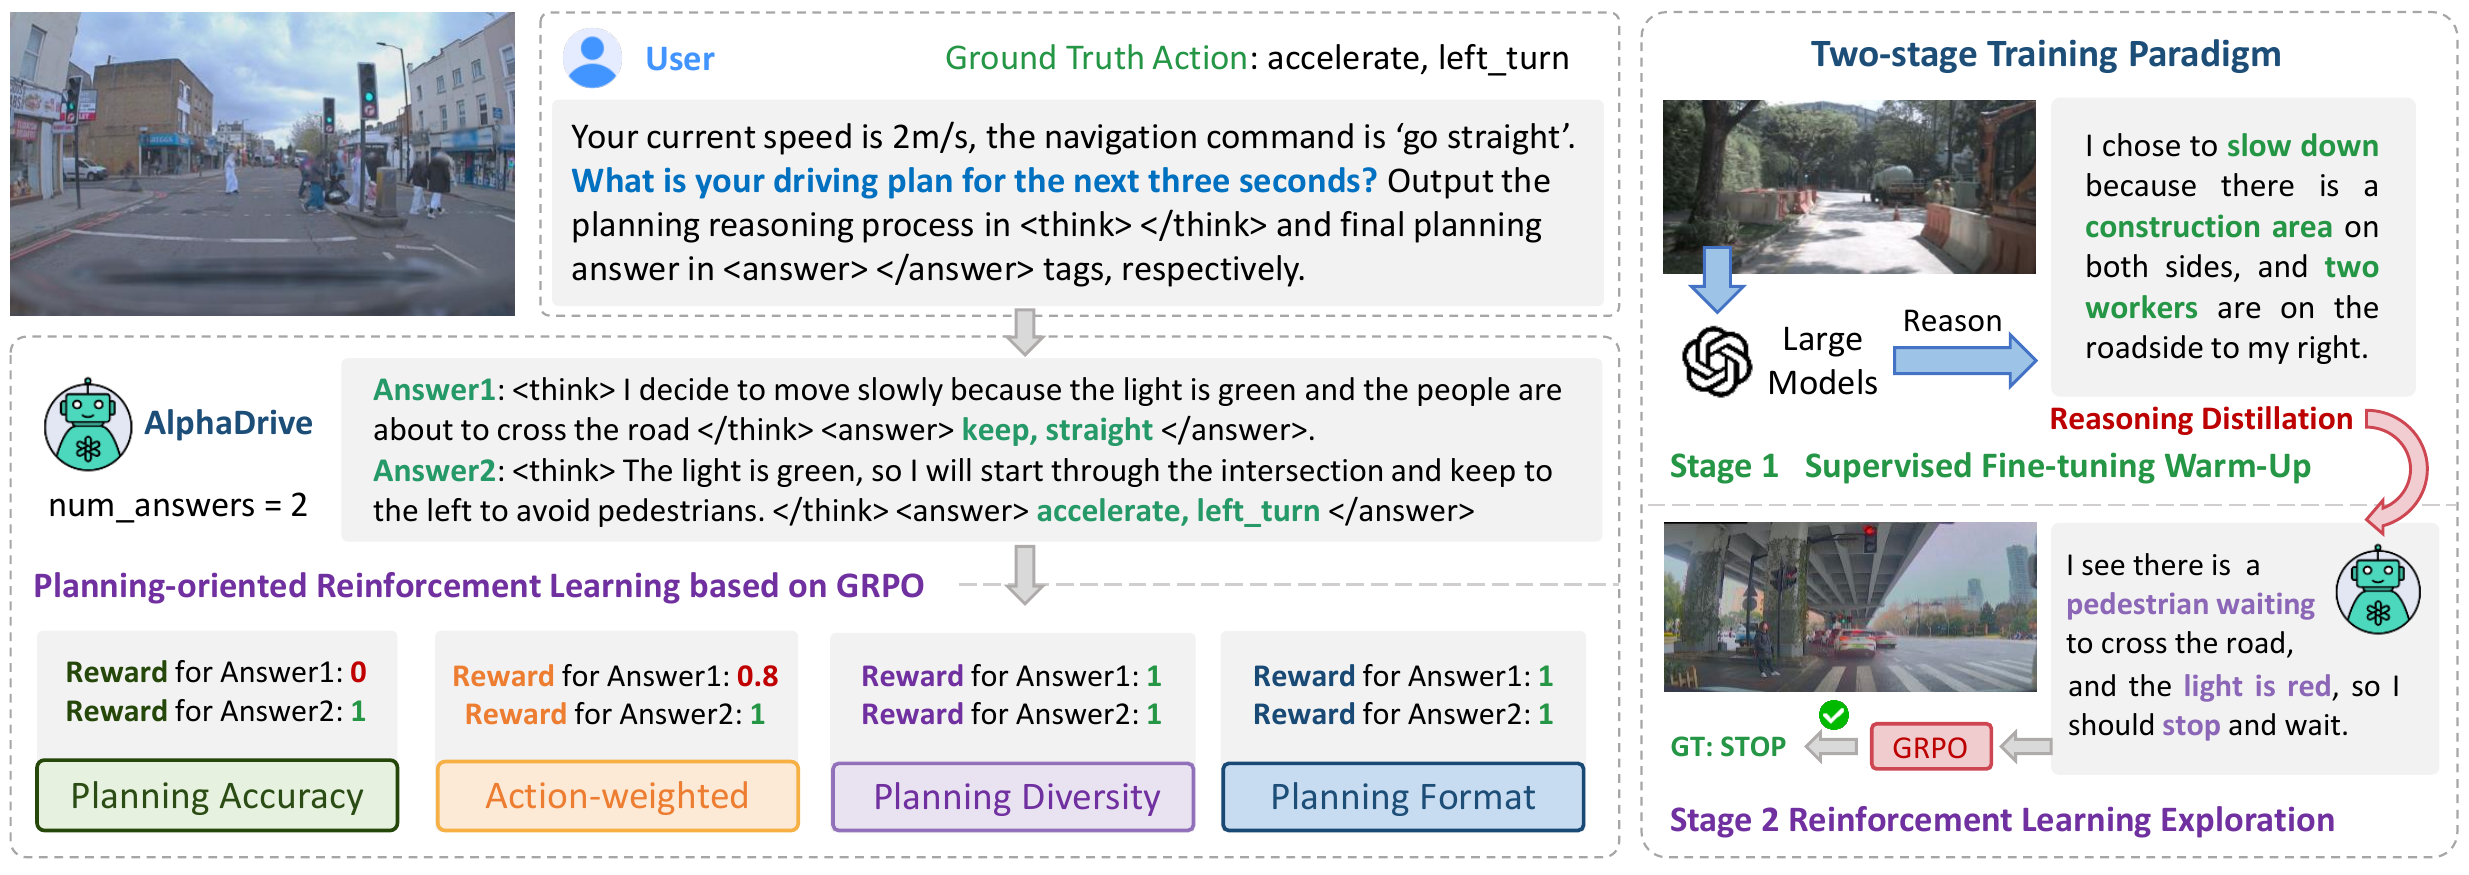
图注:论文的核心框架图。图中上部是推理蒸馏:驾驶片段(真实动作 + 车辆状态 + 导航)喂给云端大模型生成
<think>推理过程;下部是基于 GRPO 的规划强化学习:同一 query 采样两条答案,四条奖励(Accuracy / Action-weighted / Diversity / Format)对两条答案分别打分,再经 GRPO 组内归一化后更新参数。这正是全文的"骨架"——上半张图回答"推理从哪来",下半张图回答"怎么用 RL 优化规划"。
AlphaDrive 的核心训练框架如上图所示。它基于 Qwen2VL-2B 视觉语言模型,输入前视图像 + 自车速度 + 导航文本,输出带 <think> 推理链和 <answer> 规划结果的格式化文本。整个训练分两阶段:
| 阶段 | 方法 | 数据量 | 作用 |
|---|---|---|---|
| SFT 预热 | GPT-4o 蒸馏推理数据做监督微调 | 30k | 注入推理能力,缓解 RL 冷启动幻觉 |
| RL 探索 | GRPO + 四项规划奖励 | 110k | 探索最优规划策略,涌现多模态 |
GRPO 组内相对优化
$$\mathcal{J}_{\text{GRPO}}(\theta)=\mathbb{E}\left[\frac{1}{G}\sum_{i=1}^{G}\min\big(w_i A_i,\,\text{clip}(w_i,1-\epsilon,1+\epsilon)A_i\big)-\beta\,\mathbb{D}_{KL}(\pi_\theta\|\pi_{\text{ref}})\right]$$其中 $w_i=\pi_\theta(o_i\mid q)/\pi_{\theta_{\text{old}}}(o_i\mid q)$,$A_i = (r_i - \text{mean}(r_1..r_G)) / \text{std}(r_1..r_G)$ 为组内相对优势。
完整的 GRPO 训练循环(配图)
图注:从输入到更新的六个环节。关键点在于第③步——同一 query 采样的 G 条输出各自独立过四条规划奖励,第④步用组内均值当基线算出优势(不需要 PPO 那种额外训练的价值网络),第⑤步用 clip + KL 惩罚稳住更新。左侧两张卡片解释"为什么选 GRPO 而非 PPO"和关键超参(G、ε、β)。
💡 核心思想:规划是高层动作分类,不是轨迹回归
把规划语言化
AlphaDrive 不让 VLM 直接吐轨迹点(VLM 在语言空间里不擅长精确数值)。它做的是高层元动作规划:输入前视图像 + 提示词(当前车速 + 高德导航文本"直行 100 米后右转"),输出自然语言决策。
| 维度 | 动作集合 |
|---|---|
| 横向 path | 直行 / 左转 / 右转 |
| 纵向 speed | 保持 / 加速 / 减速 / 停车 |
这把规划变成一个横向+纵向的双分类问题,天然适合语言模型和 RL 奖励设计。
为什么是 GRPO 而不是 PPO/DPO
作者对比三大 RL 算法后选了 GRPO(Group Relative Policy Optimization),两个理由:
- DeepSeek R1 已证明 GRPO 训练更稳、更高效;
- GRPO 的"组内相对优化"天然契合多解规划——对一个 query 采样一组 $\{o_1,\dots,o_G\}$,用组内归一化奖励作为优势 $A_i$,多解之间的相对优劣正好是规划需要的信号。
其中 $w_i=\pi_\theta(o_i\mid q)/\pi_{\theta_{\text{old}}}(o_i\mid q)$。这个"组内相对"的设定,也是后文多模态规划涌现的伏笔。
GRPO 相对 PPO/DPO 的实际优势
值得对比一下三大算法在规划上的表现差异:PPO 需要训练一个独立的 value 网络估计基线,在小模型上 value 不准会导致方差爆炸;DPO 依赖成对偏好数据,而驾驶里"哪个动作更好"很难离线标注成对样本;GRPO 用组内均值当基线,省掉 value 网络,又天然利用了"同一场景多解"的结构。作者实验里 GRPO 训练曲线最稳、收敛最快,这印证了"组内相对"对多解任务的适配性——规划的答案不唯一,所以"谁比谁好"比"谁对谁错"更重要。
🎯 灵魂设计:四个面向规划的 GRPO 奖励
这是全文最有工程价值的部分。直接用"答对给 1 分"的通用奖励在规划上会崩——AlphaDrive 设计了四个互锁的奖励。
图注:上方是四条奖励各自的职责,左边一条直通"质量奖励":
R_quality = Accuracy × Action-Weighted × Diversity(speed / path 各算一次),再与 Format 奖励相加得到总奖励R_total = R_quality + R_format。右侧卡片解释"为什么必须乘法耦合"——乘法保证任何一条为 0 就一票否决,模型学不到打擦边球的捷径。
1. 规划准确率奖励(Planning Accuracy)
用 F1-Score 分别评估横向、纵向决策。为什么不用精确匹配?作者踩过的坑很真实:
- 精确匹配:早期模型格式不稳(大小写、多余输出),训练剧烈震荡;
- 包含匹配(提取所有词看是否含答案):模型学会捷径——把所有动作都输出,召回率高精度低,mode collapse;
- F1-Score:兼顾精度与召回,杜绝"全输出"捷径,训练稳定。
2. 动作加权奖励(Action-Weighted)
不同动作对安全的重要性不同:减速、停车、转向比"保持"关键得多。给各动作赋不同权重,作为准确率奖励的乘子,让模型在关键决策上更使劲。
3. 规划多样性奖励(Planning Diversity)
这是最巧妙的一笔。RL 后期模型输出会坍缩成同一个答案。AlphaDrive 反向激励:当组内输出更多样时给更高奖励,重复则扣分(最多扣 20%):
$$\text{diversity}=1-\min\big(0.2,\ \text{该答案在组内的占比}\big)$$这条奖励直接催生了后文"多模态规划涌现“的奇观。
4. 规划格式奖励(Planning Format)
学 R1,用 <think></think> 包推理、<answer></answer> 包结果。格式不符则格式奖励为 0,逼模型输出结构化。
奖励合成(论文 Algorithm 1 逐行拆解)
论文用一段伪代码(Algorithm 1)给出了完整流程,逐行翻译如下:
| 步骤 | 伪代码含义 | 产出 |
|---|---|---|
| ① | 正则匹配 F 提取每条回答的 action_ans,统计组内频次 | ans_counter |
| ② | 从 action_ans 分别抽取 speed / path 两个分量 | speed_ans、path_ans |
| ③ | 各算一次 F1 准确率 | speed_acc_R、path_acc_R |
| ④ | 查表取动作权重 | speed_weighted_R、path_weighted_R |
| ⑤ | 算组内占比 → 1 − min(0.2, 占比) | plan_div_R |
| ⑥ | 正则校验 <think>/<answer> | format_R(0/1) |
| ⑦ | speed_R = acc×weighted×div,path_R 同理 | 存入 [speed_R, path_R, format_R] |
最终总奖励:
$$R_{\text{quality}} = \text{Acc}_{\text{F1}} \times \text{Weighted} \times \text{Diversity},\qquad R_{\text{total}} = R_{\text{quality}} + R_{\text{format}}$$四者乘法耦合而非简单相加,确保模型必须"既准、又重要、又多样、又规范”。
与其他 RL 算法的对比
| 维度 | PPO | DPO | GRPO(AlphaDrive 选用) |
|---|---|---|---|
| 价值网络 | 需要 critic | 不需要 | 不需要 |
| 数据需求 | 单条 rollout | 成对偏好数据 | 组内采样(G 条) |
| 多解适配 | 差(单值 critic 混淆) | 需全排序 | 天然适配(组内相对) |
| 训练稳定性 | critic 偏差敏感 | 偏好噪声敏感 | 最稳 |
| 规划适用性 | 低(动作不等权) | 低(无多样性机制) | 高(四项定制奖励) |
🧠 推理从哪来:大模型蒸馏 + SFT 预热
图注:推理数据的生产流水线(左→中)与两阶段训练(中→右)。驾驶片段 + 真实动作 + 车辆状态喂给 GPT-4o 生成简洁决策推理,人工过滤后得到 30k 高质量语料 → 阶段 1 用 SFT 蒸馏推理能力(教"怎么想")→ 阶段 2 用 110k 全量数据做 GRPO 探索(教"选哪个最优")。
推理数据不够?借 GPT-4o 造
驾驶没有现成推理语料。作者用 GPT-4o 对一小批驾驶片段(给真实动作 + 车辆状态 + 导航)生成简洁决策推理过程,人工过滤后得到高质量 reasoning 数据。直接把推理塞进 RL 训练效果差,作者总结出三个具体缺陷:
- 感知不全:小模型抓不住关键元素(如红绿灯);
- 因果混乱:推理过程逻辑散、因果关系弱;
- 冗长无效:输出又长又没用。
所以,蒸馏小模型才是正解。
两阶段:SFT Warm-up + RL Exploration
| 阶段 | 数据 | 目标 |
|---|---|---|
| 阶段 1:SFT 预热 | 30k GPT-4o 蒸馏推理数据 | 蒸馏推理能力、缓解 RL 早期幻觉 |
| 阶段 2:RL 探索 | 110k 全量 MetaAD | GRPO 探索最优规划策略 |
为什么必须 SFT 预热?RL 依赖稀疏奖励,小模型(2B)感知推理能力弱,冷启动 RL 会剧烈震荡、幻觉横飞。先用 SFT 把 reasoning 能力蒸馏进来当 warm-up,再让 RL 去探索——SFT 教"怎么想",RL 教"怎么选最优"。
🧪 实验与结果
实验设置
- 数据集:MetaAD,120k 段真实驾驶片段(每段 3 秒),110k 训练 / 10k 验证,场景与动作分布均衡;
- 基座模型:Qwen2VL-2B(输入前视图像 + 规划 prompt,prompt 含当前车速与高德导航文本);
- 训练:16 张 NVIDIA A800;
- 评测:元动作准确率(逐类 F1)+ 推理质量(BLEU-4 / CIDEr / METEOR)。
主结果:2B 反超 7B
在 MetaAD(120k 片段,110k 训 / 10k 验)上,基座 Qwen2VL-2B:
| 模型 | 规划准确率 |
|---|---|
| Qwen2VL-7B(SFT) | 61.44% |
| AlphaDrive(2B) | 77.12%(+25.5%) |
完整表格(含逐类 F1 与推理质量):
| 方法 | 参数量 | Acc(%) | Path-F1(直/左/右) | Speed-F1(保/加/减/停) | BLEU-4 | CIDEr | METEOR |
|---|---|---|---|---|---|---|---|
| Qwen2VL (预训练) | 2B | 13.69 | 34.05/21.46/13.46 | 52.34/11.14/13.73/17.03 | 16.41 | 10.85 | 27.66 |
| Qwen2VL (预训练) | 7B | 19.28 | 45.92/33.09/19.20 | 54.13/12.86/27.01/23.48 | 30.30 | 16.16 | 33.36 |
| Qwen2VL (SFT) | 2B | 55.84 | 82.68/80.31/70.04 | 75.97/34.92/55.55/72.64 | 24.46 | 23.14 | 34.26 |
| Llama3.2-V (SFT) | 11B | 58.21 | 85.58/84.64/79.12 | 74.79/35.56/58.99/76.20 | 32.05 | 21.25 | 37.70 |
| Qwen2VL (SFT) | 7B | 61.44 | 86.45/85.84/87.75 | 84.53/43.81/56.30/73.80 | 41.09 | 30.65 | 47.47 |
| AlphaDrive | 2B | 77.12 | 96.62/89.83/93.25 | 86.80/56.33/71.40/86.63 | 43.54 | 38.97 | 55.23 |
两个观察:① 预训练模型直接评估规划准确率只有 10~20%,说明通用 VLM 完全不会"开车规划",必须经过驾驶数据训练;② AlphaDrive 只用了 2B 参数,却把 7B SFT 模型按在地上摩擦(+25.5%),转向、加减速这些关键决策的提升最显著,推理质量(BLEU-4/CIDEr/METEOR)也全面领先——这正是"推理 + RL"带来的红利。
数据效率:20k 样本反超全量 SFT
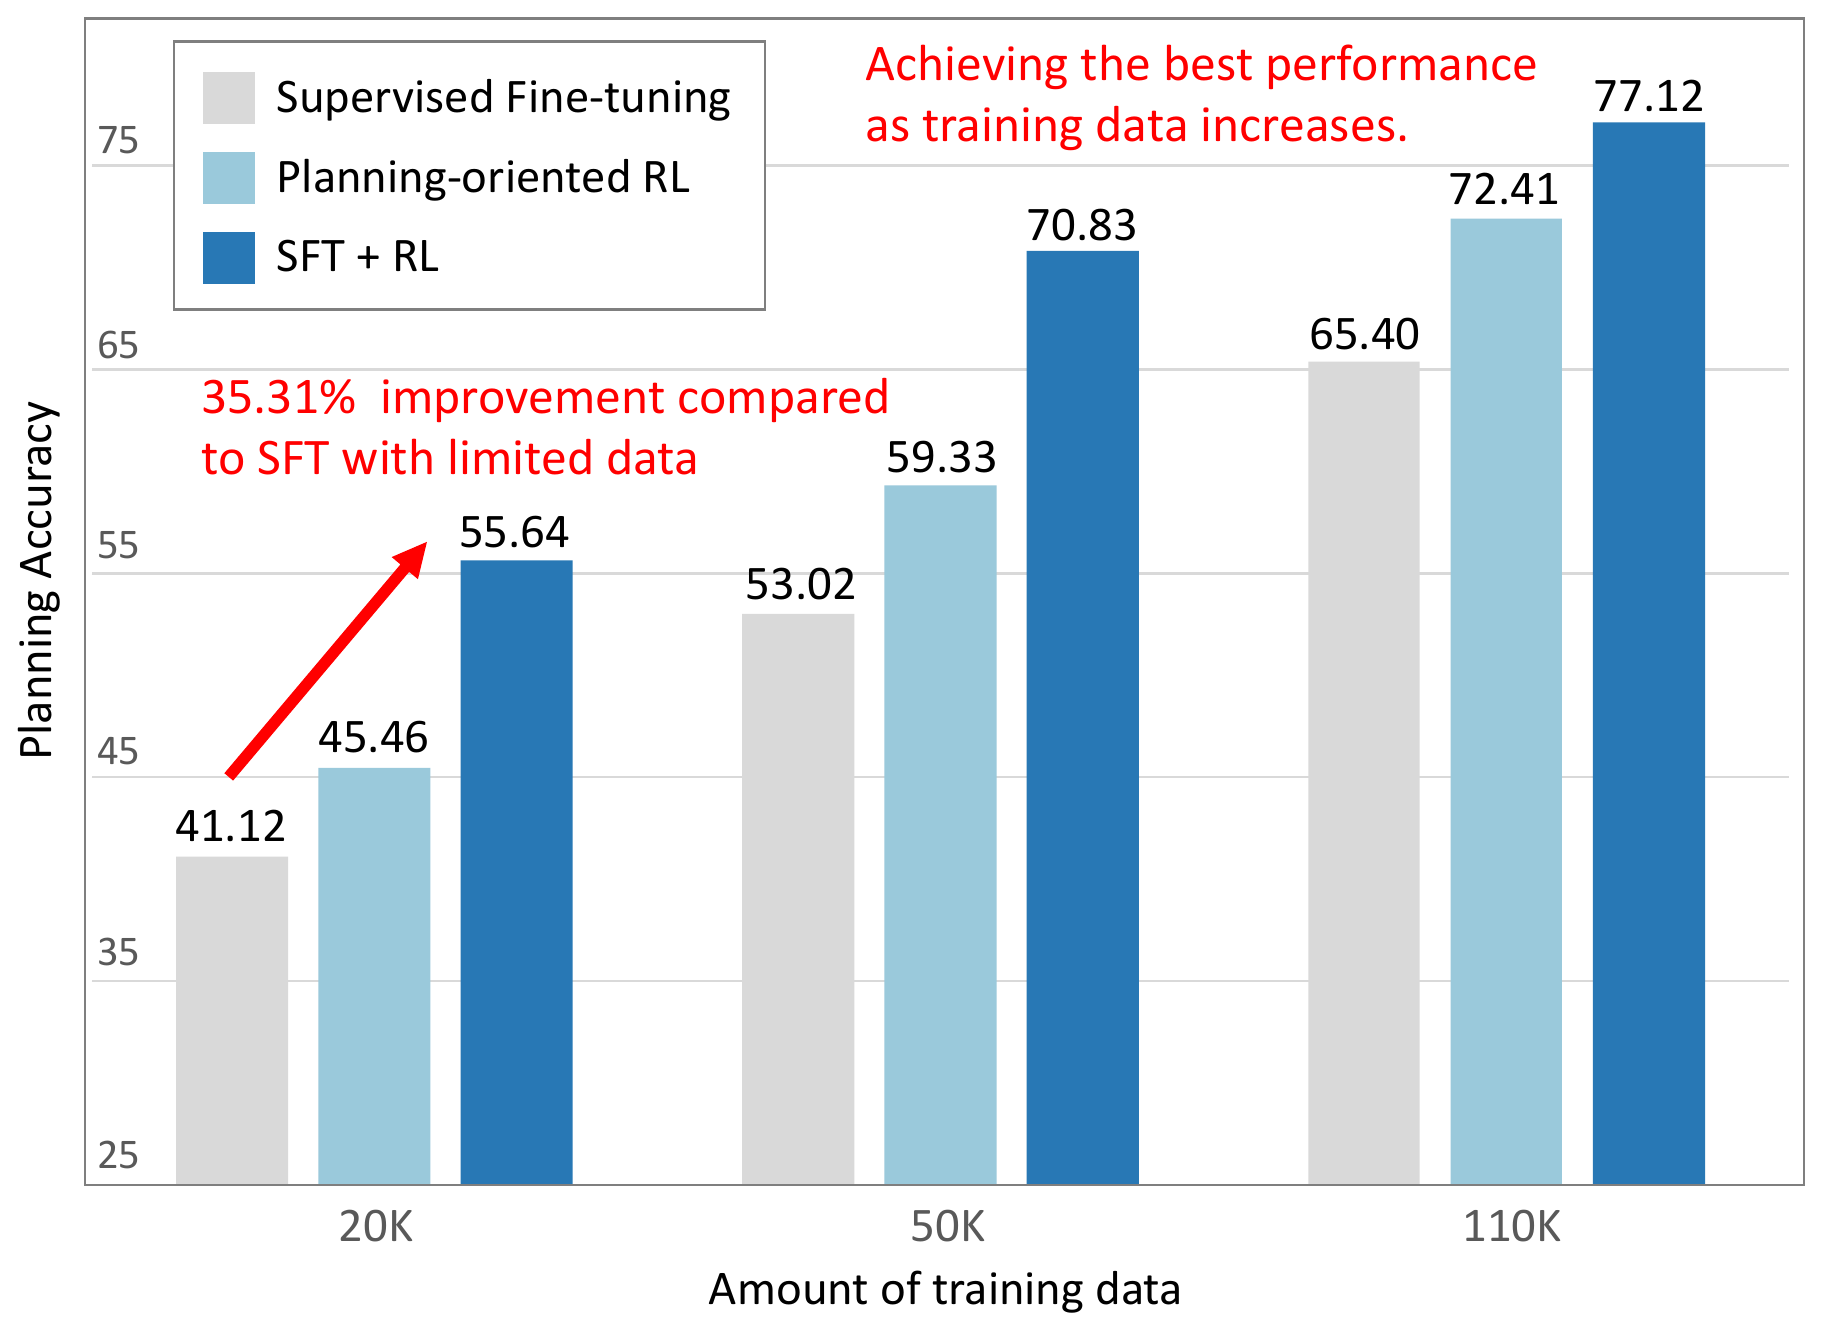
图注:论文头图,横轴是训练数据量(20K / 50K / 110K),三条曲线分别是 SFT-only、RL-only、SFT+RL。可以看到:数据越少,SFT 掉得越快;而 SFT+RL 始终最高,且在 20K 时对 SFT 有 35.31% 的相对提升(55.64 vs 41.12)。
| 训练数据 | SFT | RL | SFT+RL |
|---|---|---|---|
| 20k | 41.12% | 45.46% | 55.64% |
| 50k | 53.02% | 59.33% | 70.83% |
| 110k | 65.40% | 72.41% | 77.12% |
仅用 20k(约 20%)样本,AlphaDrive 就比全量 SFT 高 35.31%(相对提升)。用一半数据(50k)时准确率已达 70.83%,接近全量 SFT 的结果。RL 对数据效率的撬动作用极其明显——这正是 R1 路线最诱人的红利。
消融:四个奖励缺一不可
| ID | Accuracy | Weighted | Diversity | Format | Acc(%) |
|---|---|---|---|---|---|
| 1 | 基础精确匹配 | – | – | – | 42.36 |
| 2 | 基础精确匹配 | – | – | ✓ | 55.71 |
| 3 | F1 | – | – | ✓ | 67.91 |
| 4 | F1 | ✓ | – | ✓ | 72.20 |
| 5 | F1 | – | ✓ | ✓ | 69.38 |
| 6 | F1 | ✓ | ✓ | ✓ | 77.12 |
逐项加入奖励:42.36% → +格式 55.71% → +F1准确率 67.91% → +加权 72.20% → +多样性 77.12%。注意 ID 5:只加多样性不加加权反而比 ID 4 低(69.38 < 72.20),说明多样性奖励是"锦上添花"而非"雪中送炭"——它和加权奖励配合才最优。F1-Score 防捷径、加权提升关键动作、多样性催生多模态,环环相扣。
推理训练策略消融:推理 + 两阶段都关键
| 带推理 | 策略 | Acc(%) |
|---|---|---|
| ✗ | SFT | 56.97 |
| ✗ | RL | 62.16 |
| ✗ | SFT+RL | 70.73 |
| ✓ | SFT | 65.40 |
| ✓ | RL | 72.41 |
| ✓ | SFT+RL | 77.12 |
三个结论:① 任何训练策略下,带推理都比不带推理强(差距在 6~8 个点),推理对复杂场景的决策提升尤其显著;② 单独 RL 在推理质量上反而不如 SFT(小模型感知推理能力有限,RL 学不动推理过程),所以必须 SFT 预热;③ SFT+RL 两阶段叠加达到最佳——SFT 补推理能力,RL 做策略探索,缺一不可。
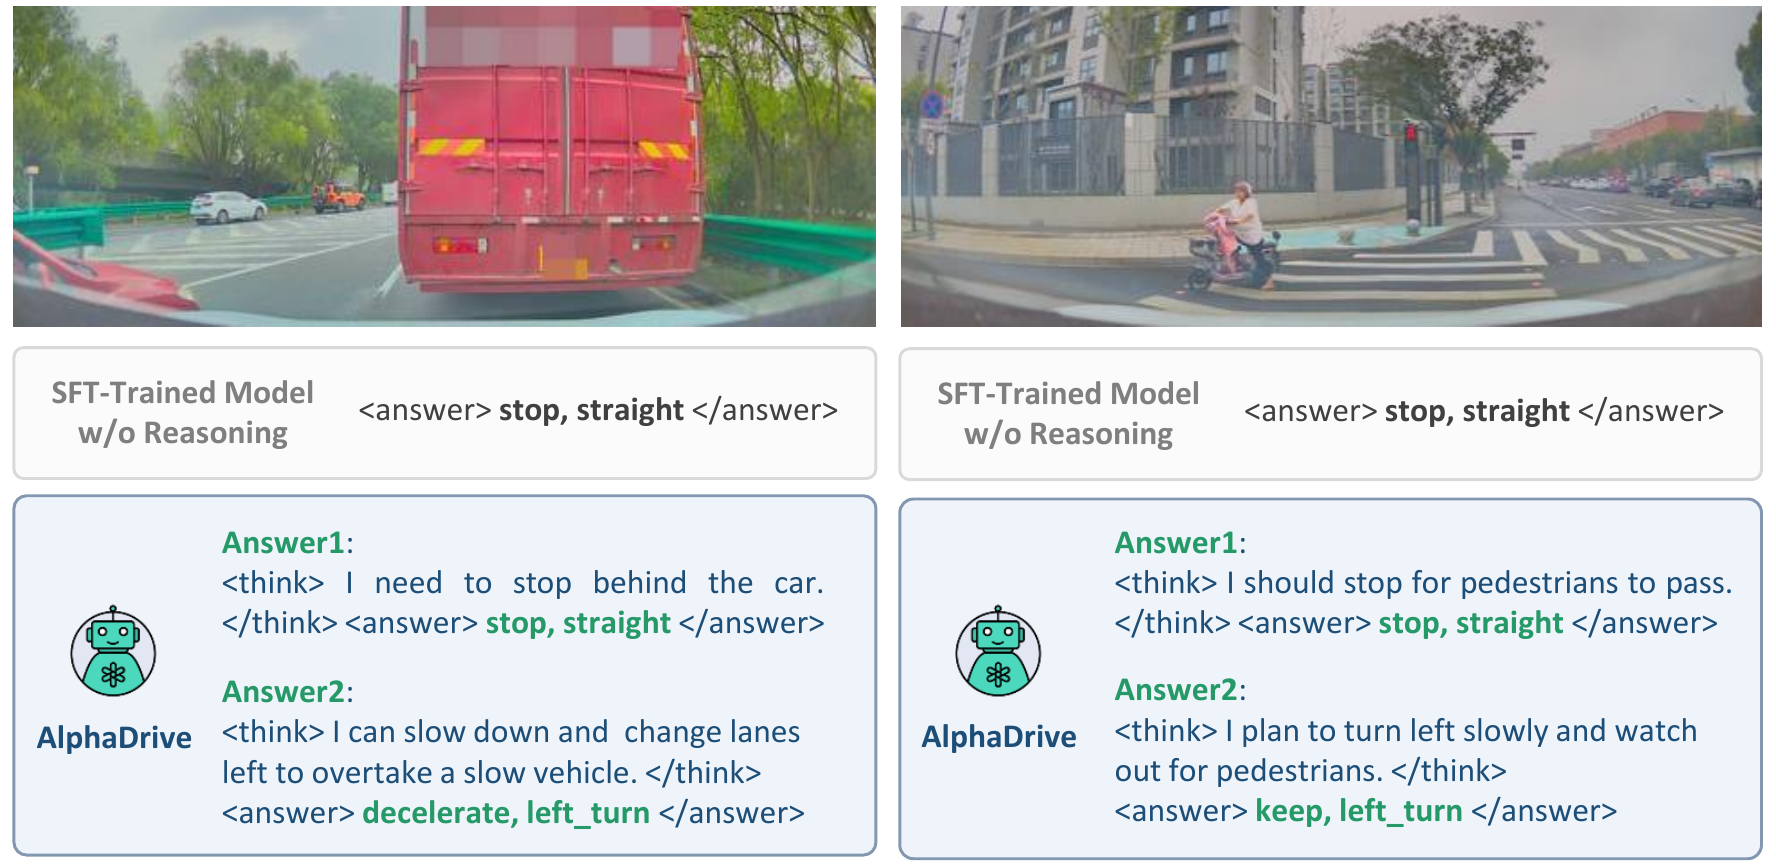
图注:论文的定性可视化。上方是 SFT 模型(无推理),面对复杂场景只输出唯一的
stop, straight;下方是 RL 训练后的 AlphaDrive,同一场景给出两个都合理的解——例如"减速并左变道超越慢车"与"跟车停车避让"并存。这就是"多模态规划涌现"的直接证据。
涌现现象:多模态规划能力
图注:左栏是 SFT 模型的"单解"困局,右栏是 AlphaDrive 的"多解"涌现,下方对比它和扩散模型式多模态的本质区别。
RL 训练后,AlphaDrive 在复杂场景下能自发给出多个合理解,而 SFT 模型只能给一个。作者把这归因于 GRPO 的组内相对优化 + 多样性奖励。这对安全意义巨大——下游动作模型可从多个候选里动态选优,把"单选规划"升级成"多选规划"。
这和扩散式多模态有何不同
有人会问:Diffusion Planner、DiffusionDrive 用扩散模型也能生成多模态轨迹,AlphaDrive 这种"语言模型涌现多模态"有什么新意?区别在于层次:扩散是在底层轨迹空间做多模态(同一意图下不同几何走法),而 AlphaDrive 是在高层元动作空间做多模态(“减速跟车"和"变道绕行"两个截然不同的策略都能给出来)。前者是"怎么走"的多样性,后者是"做什么"的多样性。理想系统需要两者叠加——高层多策略决策(AlphaDrive)+ 底层多轨迹生成(Diffusion Planner),这才是完整的多模态规划栈。
⚠️ 局限与未来方向
- 动作粒度粗:目前只输出元动作,变道、贴边挤让等复杂行为还做不了,受限于标注丰富度;
- 推理数据是伪标签:基于真值动作回放生成,感知可能不准、关键因素可能漏;
- 开环评测:高层动作需配合下游动作模型才能闭环验证真实驾驶表现。
后续方向我看好:把元动作接到 Diffusion Planner / Flow Matching 轨迹头做闭环、用环境反馈奖励(碰撞、舒适)替代部分规则奖励、把多模态候选接入best-of-N 打分实现推理时 scaling。
📝 个人思考
AlphaDrive 最让我兴奋的不是某个奖励公式,而是它第一次把 R1 范式真正"接地气"到了驾驶。过去一年所有人都在喊"把 o1/R1 用到垂直领域”,但真正做出来会发现通用 RL 配方根本不work——数学题答对就是答对,驾驶规划却有"多解、不等权、无推理语料"三重障碍。AlphaDrive 的价值在于它示范了怎么针对领域特性重新设计奖励:F1 防捷径、加权对齐安全、多样性催生多模态,每一条都是踩过坑后的工程结晶。这种"通用方法 + 领域化奖励"的范式,对所有想把 RL 用到非标准任务的人都是教科书。
第二点启发在**“数据效率被 RL 重新定义”。20k 样本反超 110k SFT,这个结果对工业界是地震级的。它意味着高质量驾驶数据的获取瓶颈,可能被 RL 部分绕过**——只要有一个能自动判分的奖励函数,模型就能从相对比较中自我进化,而不必死磕人工标注的规模。这与 DriveVLA-W0 用世界模型"撬起"缩放律是同一种智慧:当直接监督信号稀缺或稀疏时,换一种更密的信号源(RL 相对奖励 / 世界模型稠密预测)比堆数据更划算。两条路线本质相通。
最后,“多模态规划涌现”这点深远。我们一直以为多模态轨迹要靠扩散模型这种生成式架构才能得到,但 AlphaDrive 证明——在 GRPO 的组内相对优化 + 多样性奖励下,连自回归语言模型都能自发产生多解。这暗示"多模态"可能不是某种架构的专利,而是合适的训练目标的产物。结合 Diffusion Planner 的联合生成、Flow-GRPO 的轨迹对齐,我倾向于认为,“推理式高层决策(AlphaDrive)+ 扩散式底层轨迹(Diffusion Planner)“的双层架构,会是从"可解释"到"可执行"的最短路径。GRPO 给了驾驶大模型"会思考"的能力,这才是它真正的历史位置。
🔗 延伸阅读
| 工作 | 关系 |
|---|---|
| DeepSeek R1 / GRPO | 本篇方法母体,组内相对优化 |
| DriveVLM / Senna | VLM 高层规划先驱,本篇的训练对象升级 |
| Diffusion Planner | 本系列第 15 篇,底层轨迹生成,与 AlphaDrive 高层决策互补 |
| DriveVLM-RL | 本系列第 14 篇,神经科学双通路 RL,另一条安全 RL 路线 |
| OpenAI o1 | 推理时 scaling 思想来源 |
📖 这是论文精读系列的第 16 篇。当驾驶大模型学会"想清楚再开”,RL 会成为自动驾驶的"最后一公里"吗?欢迎留言讨论。