📄 论文信息
- 标题:BrainWAM: Action-Space Coordination of Semantic Priors and Predictive Dynamics for Autonomous Driving
- 作者机构:中科院自动化所 NLPR(张冰、尚澍要、卢烁、徐远、王超、范略 ✉、张兆翔 ✉)× 理想汽车(顾家豪、王肇、王轶达、张学阳、詹坤)
- arXiv:2608.12854
- 一句话总结:BrainWAM 指出"VLA 会语义、WAM 会预测",但直接拼在一个 token 空间里会打架——语义 token 太好学,把注意力全吸走,预测信号被淹没。它的解法是:像大脑一样分工——左脑语义通路 + 右脑预测通路,各自产出一组"面向动作的表示",再通过模拟胼胝体的 CAB 双向交换、模拟小脑的 CIF 协调解码。NAVSIM v1 89.5 PDMS / v2 89.6 EPDMS,双榜 SOTA。
🎯 一句话记忆点:BrainWAM = “左脑想语义,右脑想预测,胼胝体传消息,小脑把脉捏成轨迹”——它不混 raw token,只在"动作表示"这一层做协调,就像大脑不在底层神经信号上融合,而在行为层面协同。
🧠 先搞懂:自动驾驶里的 WAM 到底是什么?
写这篇精读之前,必须先把概念钉死——因为 WAM、WM、动作专家(Action Expert)、VLA 这四个词很容易混。BrainWAM 论文自己的 Keywords 就是 world action models, world models, vision-language-action models 三个,可见它们确实需要辨析。
WAM vs WM(世界模型)——差在一个"动作"
| WM(World Model,世界模型) | WAM(World Action Model,世界动作模型) | |
|---|---|---|
| 学什么 | 环境如何演化:当前观测 → 未来观测/场景 | 动作与未来状态如何一起演化:(当前观测, 动作) → 未来场景 |
| 输出 | 未来帧/未来 BEV/未来 occupancy | 未来帧 + 轨迹(两者联合建模) |
| 本质 | 一个生成器/预测器,不直接开车 | 一个策略 + 生成器的联合体 |
| 和规划的关系 | 旁路:给规划器当特征/当模拟器 | 内建:动作预测直接由世界建模监督 |
| 典型例子 | GAIA-1、DriveDreamer、GenAD、VISTA | DriveWAM、SimWAM、Metis、BrainWAM |
| 一句话 | “世界会怎么变” | “我这么开,世界会怎么变,然后我就这么开” |
关键差异:WM 只是"预测未来"的模块,它本身不产生驾驶决策(最多被规划器借用);WAM 则把"预测未来"和"产出轨迹"焊在一起——用世界动态当动作预测的监督信号。这就是名字里那个 Action 的分量。
💡 类比:WM 像"天气预报中心",只报天气;WAM 像"有经验的司机"——他一边看路况预判接下来会怎样(世界建模),一边根据预判打方向盘(动作生成),而且他的预判能力是开车开出来的(联合训练)。
WAM vs 动作专家(Action Expert)——一个"有老师",一个"没老师"
动作专家(Action Expert)是 WAM 里的"轨迹输出器",通常是一个轻量 DiT/MLP,只负责把条件变成轨迹。二者是包含关系,不是并列关系:
| Action Expert(动作专家) | WAM(世界动作模型) | |
|---|---|---|
| 职责 | 把条件 c 映射成轨迹 a | 联合建模"未来世界 + 轨迹" |
| 是否含世界建模 | ❌ 没有,纯轨迹生成 | ✅ 含视频/未来预测分支 |
| 动态先验来源 | 全靠条件里给的表示 | 自己从未来监督里学 |
| 举例 | SimWAM 的 Action DiT、BrainWAM 的 action expert | SimWAM、Metis、DriveWAM、BrainWAM 整体 |
所以更准确地说:WAM = Action Expert + 世界建模分支(VGM/未来预测),两者联合训练。你可以把 Action Expert 看成 WAM 的"执行器官",把世界建模分支看成它的"预判器官"。很多论文(包括 BrainWAM)会单独讨论 action expert 的规模/时延,但整个架构才是 WAM。
WAM vs VLA——补的是"预测"还是"语义"
| VLA(Vision-Language-Action) | WAM(World Action Model) | |
|---|---|---|
| 先验来源 | VLM 的世界知识(语言/语义/规则) | 未来动态(世界怎么演化) |
| 强项 | 规则遵守、路线理解、场景语义、用户意图 | 运动趋势、交互结果、物理可行性 |
| 弱项 | 缺少显式的"未来演化"建模 | 规则感知/意图推理弱 |
| 推理时在算什么 | 语义推理 → 决策 → 动作 | 未来预测 → 动作 |
| 典型代表 | ReCogDrive、DriveVLA-W0、AutoVLA、DynVLA | DriveLaW、DriveWAM、SimWAM、Metis |
一句话:VLA 是"懂道理的车",WAM 是"有预判的车"。一个强在规则语义,一个强在动态预测——BrainWAM 的核心主张就是这俩是互补的,应该协同而不是二选一。
一张表收束四个概念
| 概念 | 有没有"未来预测" | 有没有"轨迹输出" | 有没有"语义/语言先验" | 角色 |
|---|---|---|---|---|
| WM(世界模型) | ✅ 有 | ❌ 无 | 可选 | 只预测世界的模块 |
| Action Expert(动作专家) | ❌ 无 | ✅ 有 | 可选 | 只输出轨迹的模块 |
| WAM(世界动作模型) | ✅ 有 | ✅ 有 | 通常无 | 预测+轨迹联合建模的范式 |
| VLA(视觉语言动作模型) | 通常无 | ✅ 有 | ✅ 有 | 语义推理+轨迹输出的范式 |
🔑 这四者里,WAM 和 VLA 是两种"端到端驾驶范式",WM 和 Action Expert 是两种"零件"。BrainWAM 的野心,是把两个范式(VLA + WAM)在动作层面拧成一个系统——这就是标题里 “Action-Space Coordination” 的含义。
🤔 要解决什么问题?
先认识三个绕不开的词:MoT / Dual-MoT / Tri-MoT
💡 很多读者卡在这里,先把这几个概念说透。 “Mo” 是 Mixture-of-Transformers(混合 Transformer) 的缩写,“T” 是 Transformer。它是"MoE(Mixture-of-Experts)“思想在注意力层的变体:不同类型的 token 共享一部分注意力层,但各自保留专属的 FFN(前馈网络),让不同模态"能对话、又不互相污染”。
- Dual-MoT(双模态 MoT):两类 token(比如"视频 token + 动作 token"或"语义 token + 动作 token")共享自注意力,各自有专属 FFN——BrainWAM 的每个分支内部用它来耦合。
- Tri-MoT(三模态 MoT):三类 token(VLM 语义 token + VGM 视频 token + 动作 token)全部放进同一个共享注意力空间自由互相关注。它是最"暴力"的融合方式——所有 token 都能碰到彼此。
- MoT 与 MoE 的关系:MoE 是"不同输入走不同专家网络",MoT 是"不同模态的 token 在同一个 Transformer 里但注意力/FFN 分工"。二者都强调"特化 + 共享"的平衡。
🎯 一句话:Tri-MoT = “把三类 token 一股脑倒进同一个注意力锅”,而 BrainWAM 反对的就是这种"倒大锅"的融合方式——它把融合从"原始 token 空间"挪到"动作表示空间"。下文会反复拿 BrainWAM 和 Tri-MoT 对比,所以先记住 Tri-MoT 的定义很重要。
驾驶规划需要两种证据:语义约束 + 预测动态
端到端规划本质是在回答"下一步怎么开"。这需要两种性质不同的证据:
- 语义约束(semantic constraints):这条路的规则是什么、导航指令要我往哪拐、前车刹车灯亮了代表什么、要不要让行人。这类证据离散、符号化、靠世界知识。
- 预测动态(predictive dynamics):这个路口接下来会怎么演化、我打这个方向盘后 2 秒会到哪、旁边那辆车会不会挤进来。这类证据连续、时变、靠运动建模。
现有方法通常只占一边:
| 阵营 | 擅长 | 短板 |
|---|---|---|
| VLA(ReCogDrive、DriveVLA-W0、AutoVLA…) | 用 VLM 先验做语义推理 | 没有显式建模"未来场景怎么演化" |
| WAM(DriveLaW、DriveWAM、SimWAM…) | 用世界模型做未来感知 | 规则感知、意图驱动的推理较弱 |
BrainWAM 的立场:语义和预测不是二选一,而是天然互补——VLA 提供"该往哪开、遵守什么"(task-aware semantic priors),WAM 提供"这么开会发生什么"(future-aware dynamics)。问题是怎么把它们有效地合起来。
直接拼?——Tri-MoT 的注意力失衡病
最直白的合并方式是 Tri-modal Joint Attention(Tri-MoT):把 VLM 的 token、VGM(视频生成模型)的 token、动作 token 全部丢进同一个共享注意力空间,让它们自由互相关注。
但论文发现一个反直觉的现象:Tri-MoT 的端到端性能甚至不如单独的 WAM(87.8 vs 88.1 PDMS)。为什么?
诊断证据在论文图 2:把 action token 对 VLM token 和 VGM token 的注意力占比画出来,发现绝大多数 Transformer 层里,action token 对语义(VLM)token 的注意力显著高于对视频(VGM)token 的注意力,浅层尤其严重。
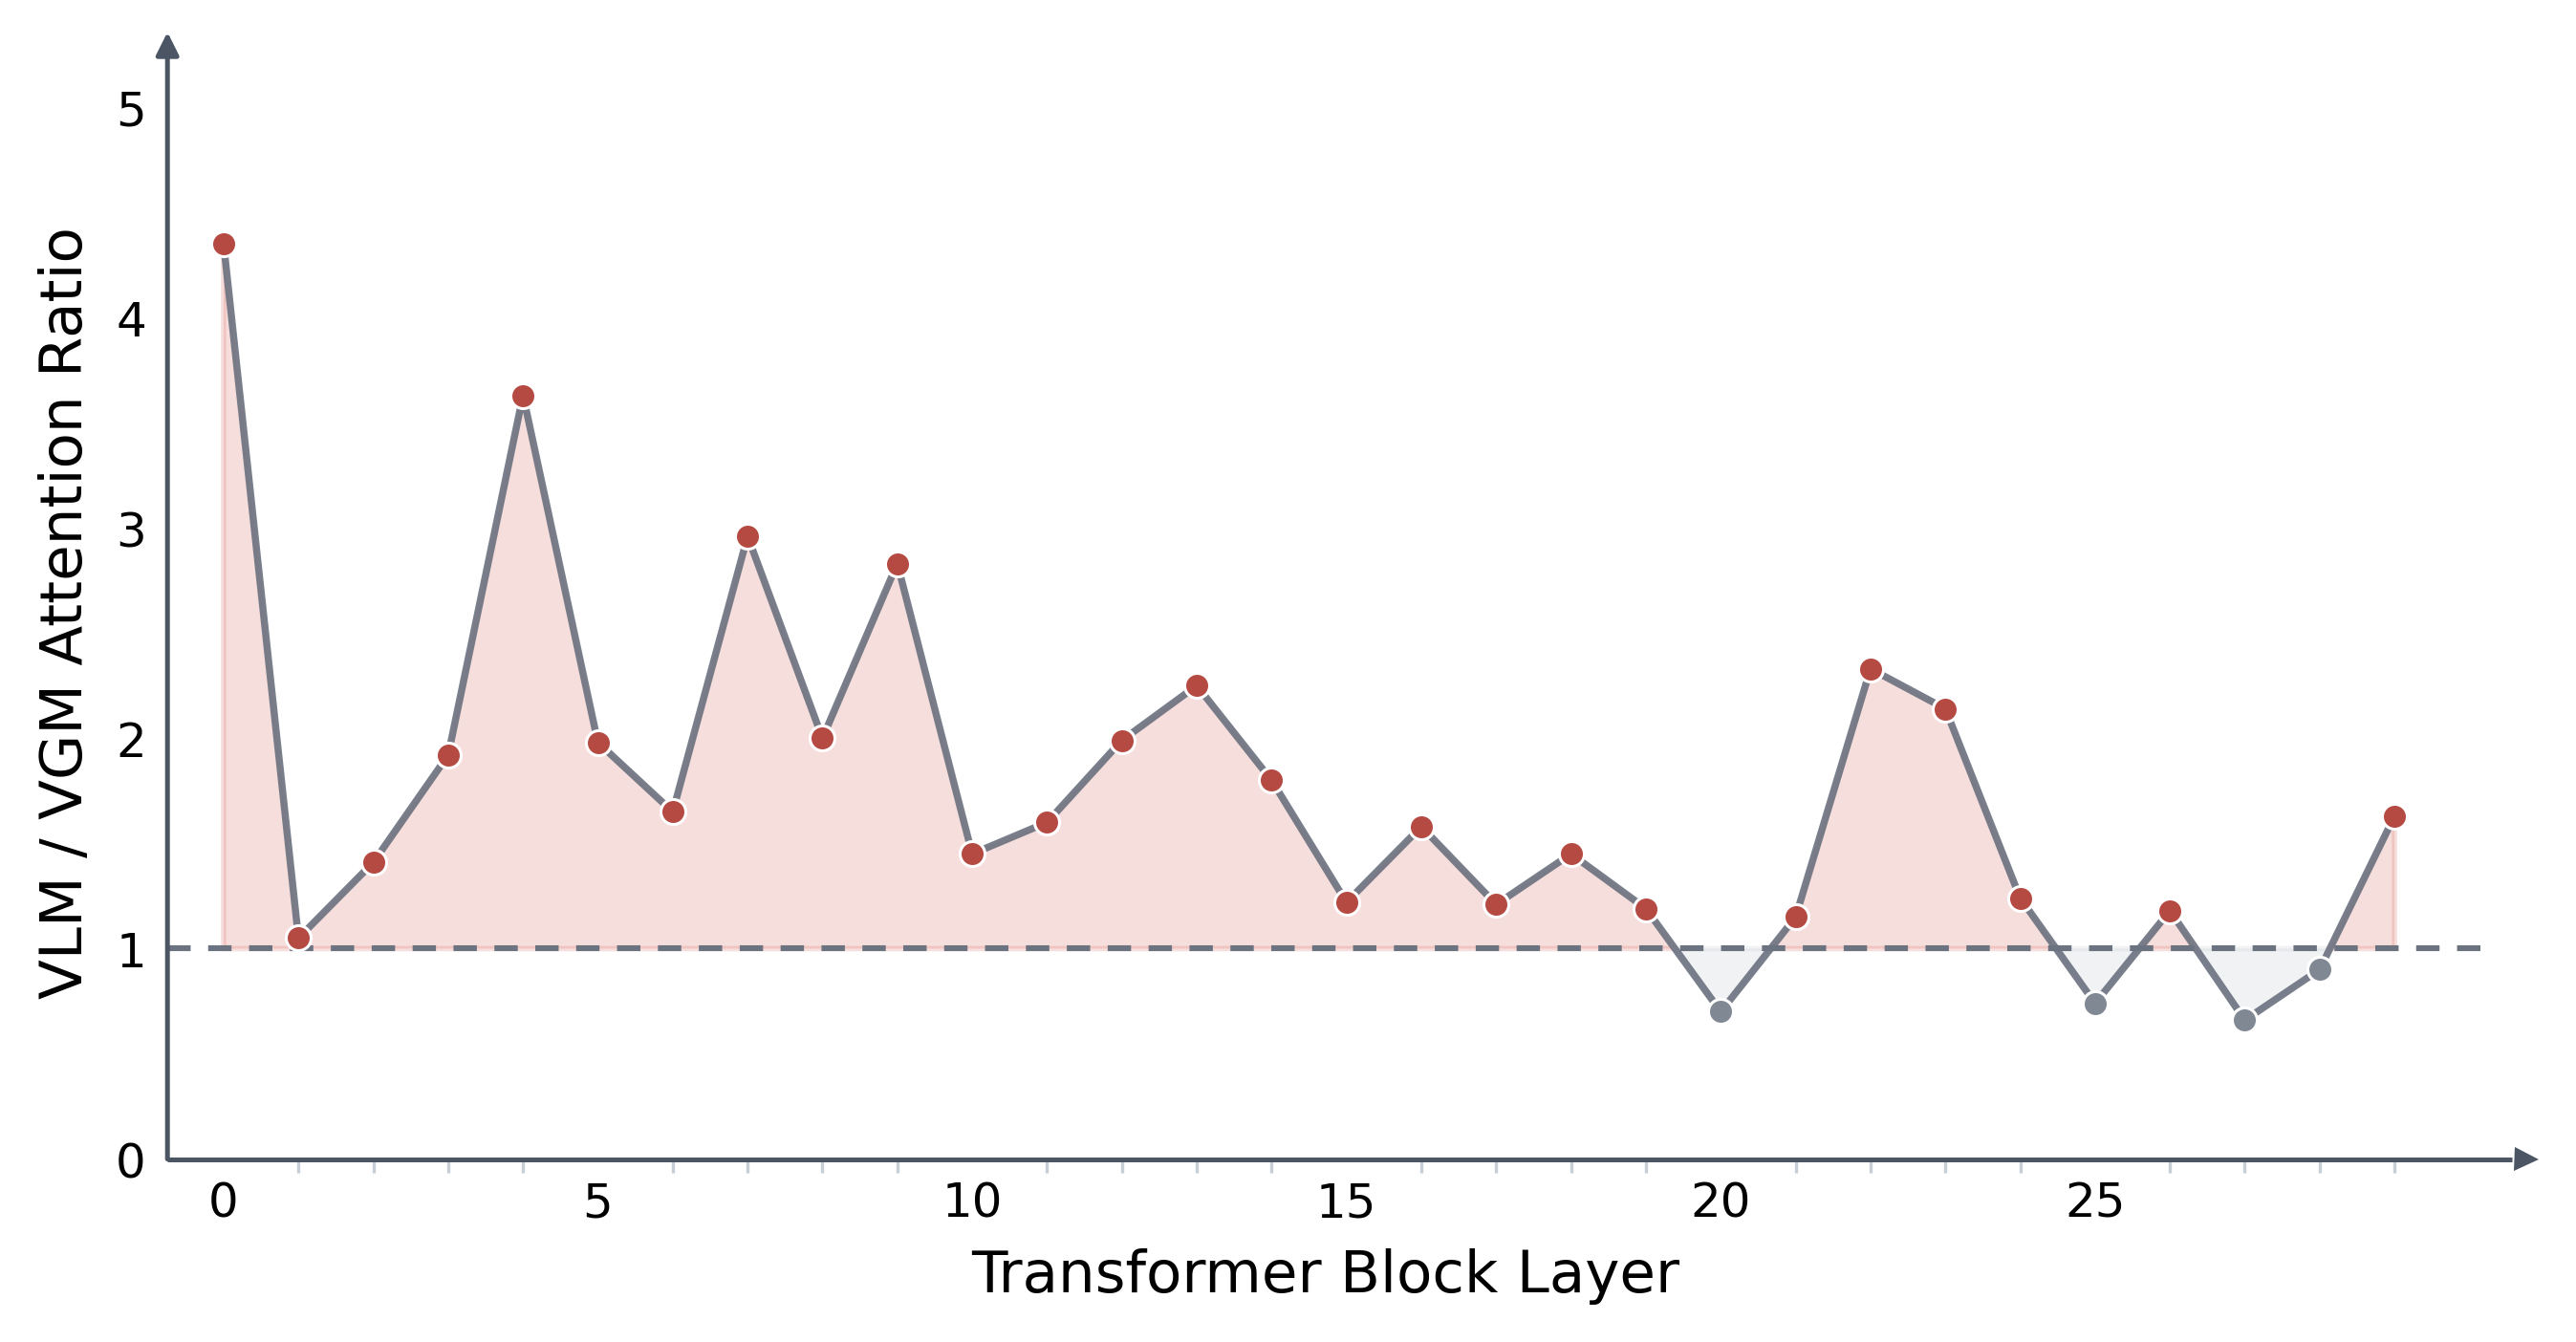
🔍 图 2 怎么读?
- 横轴 = Transformer 层(浅层→深层),纵轴 = action token 对另一类 token 的平均注意力权重比例;
- 图上有两条曲线:一条是 action→VLM(语义) 的注意力,一条是 action→VGM(视频/预测) 的注意力;
- 结论一眼可见:语义曲线几乎全程压在预测曲线上方,尤其在浅层——action token 从 VLM 那边"吸"走了太多注意力,VGM 提供的预测信号被边缘化。
为什么会这样? 论文给出模态竞争的机制解释:联合多模态训练里,“更容易学的模态"会主导优化、压过难学的模态。这里:
- VLM token 是干净、语义紧凑的(图片一进来就是高信号的特征),太好学了;
- VGM token 还正在去噪中(视频分支处于 noisy 状态),信号弱、变化大,难学。
于是 action token 走了"语义捷径”(semantic shortcut),把注意力全放在好啃的 VLM 上,预测视频 token 被忽略。结果是:混合进共享空间的预测信号形同虚设——这就是注意力分配错配(attention-allocation mismatch)。
🎯 一句话:Tri-MoT 的病根是"高维异构 token 直接混居,容易学的模态把注意力抢光了"。 解决思路不是加大融合力度,而是别让它们在同一层里混居。
💡 核心思路:大脑式分工 → 动作空间协调
论文从神经科学借来一个组织原则:复杂行为不是靠把所有信号混成一种表示涌现的,而是靠"功能特化的子系统之间的协调":
- 左脑半球:负责语言、符号、序列处理 → 对应 语义通路(VLA);
- 右脑半球:负责视觉空间、整体理解 → 对应 预测通路(WAM);
- 胼胝体(corpus callosum):左右脑交换信息的桥 → 对应 CAB(Callosal Action Bridge);
- 小脑(cerebellum):协调运动意图、精细打磨动作 → 对应 CIF(Cerebellar Intent Fusion)。
把这个映射搬到自动驾驶:
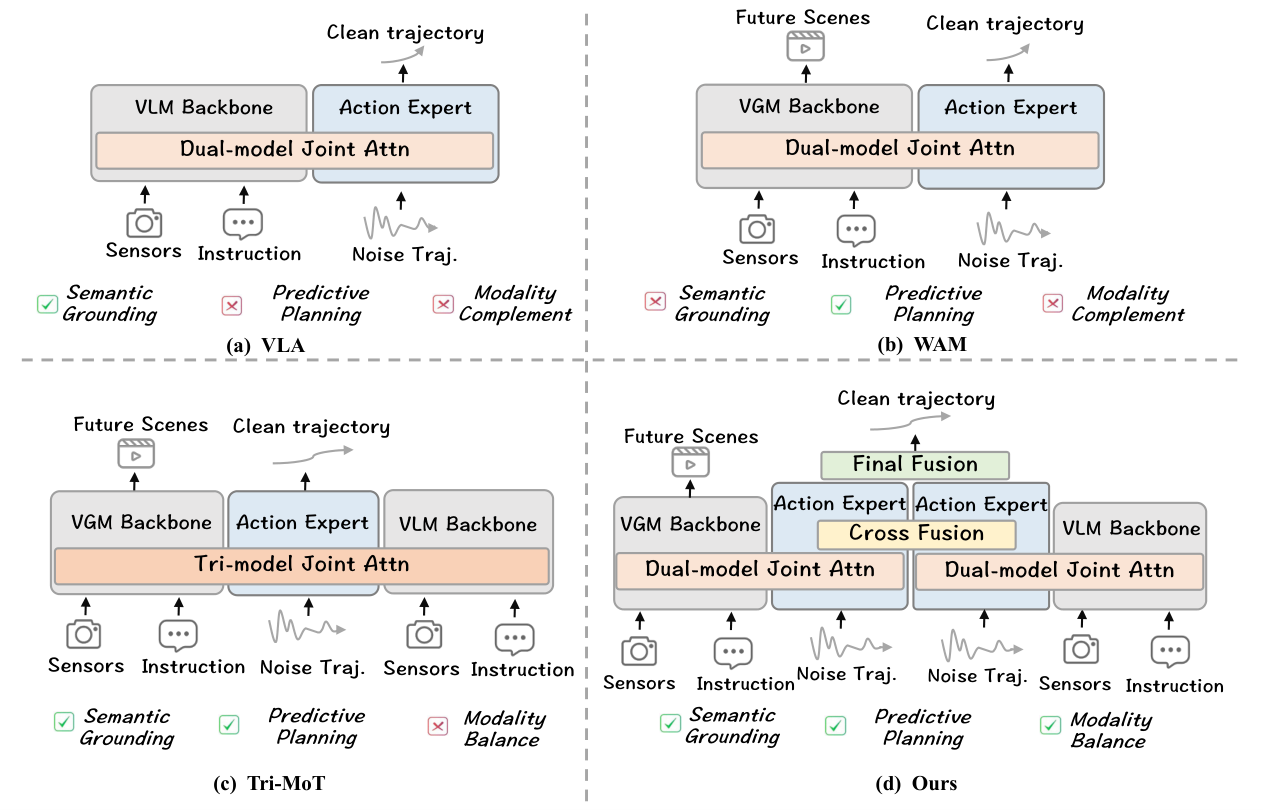
🔍 图 1 怎么读?
这是一张"范式总览图",画了四种端到端架构的数据流骨架,重点对比 (c) 和 (d):
- (a) VLA:观测 + 指令 → VLM 语义推理 → 动作。没画未来预测(缺 WAM 那半边);
- (b) WAM:观测 → 视频生成 → 动作。没画语义/语言接地(缺 VLA 那半边);
- (c) Tri-MoT:VLM token、VGM token、action token 全部汇入同一个 attention 池——图上能看到三类 token 交织成一张"全连接网",这正是它互抢注意力的可视化;
- (d) BrainWAM:左边一条语义通路(VLM→语义动作 token)、右边一条预测通路(VGM→预测动作 token),两条通路各自独立前进,中间只有一根"桥"(CAB)在动作表示层交换消息,最后汇入一个小脑式协调器(CIF)输出轨迹。
读图关键:从 (c) 到 (d),变化的不是"加了什么模块",而是"在哪一层融合"——从"原始 token 空间"挪到"紧凑动作空间"。这是整篇论文最核心的 design choice。
🎯 一句话记忆:大脑不同部位不共享原始神经信号,它们各自形成"意图",再在意图层面协调——BrainWAM 让语义通路和预测通路各自形成"动作意图",再在动作层面协调。
🧩 架构讲解:输入 → 模型 → 输出
📍 架构图在这:BrainWAM 的完整架构图是 图 3(Figure 3,见下方"🧩 整体架构拆解"小节)——它是全文的"总装图"。下面先用一张我自己画的流程图把整体数据流讲清楚,再逐模块拆解。
① 输入是什么?(4 类)
| 输入 | 类型 | 进哪条通路 | 作用 |
|---|---|---|---|
多视角图像(当前观测 o_t) | 视觉 | 两条通路都进 | 给 VLM 看场景,给视频骨干做未来预测的起点 |
导航指令 l | 文本 | VLA 语义通路 | 告诉模型"该往哪开",是语义先验的来源 |
自车历史状态 E | 向量 | VLA 语义通路 | 自车过去的速度/轨迹,提供运动上下文 |
噪声视频 latent x_v + 噪声轨迹 x_a | 生成起点 | 视频→WAM,轨迹→两条通路的动作专家 | 这是 flow 生成模型的"起点",从噪声逐步去噪 |
② 中间经历了什么?(两步)
- 两条通路各自"特化":左通路(WAM 预测)看视频动态,右通路(VLA 语义)看语义规则,各自训练时只学自己那一半,产出性质不同的动作 token(A_pred vs A_sem);
- 动作空间协调:CAB 在两条动作 token 流之间双向交换消息(不碰原始 token)→ CIF 把协调后的两个意图融合 → 解码出轨迹。
③ 输出是什么?(1 类)
一条未来 4 秒的轨迹 a = (x, y, θ) 序列(含位置与朝向),可以直接下发控制。注意:VLA/VGM 的原始 token 永远不直接见面,只有它们的"动作投影"在动作层协调。
🧩 整体架构拆解(论文核心图)
📍 架构图在这:图 3(Figure 3)就是 BrainWAM 的完整架构图,下面这张图承载了整篇论文的设计。把它读懂了,全文就懂了 80%。
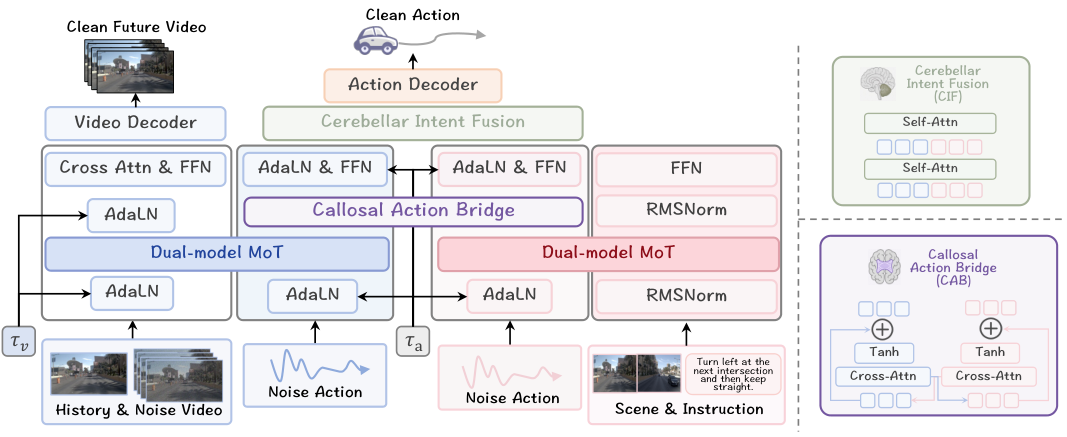
🔍 图 3 怎么读?(全文最重要的图,按顺序读)
这张图是"总装图",按下述顺序读:
- 左半边 = WAM 通路(右脑/预测):当前观测 →
Wan2.2-TI2V-5B视频骨干 → 未来视频 latent 去噪 → 视觉 tokenV;动作专家处理带噪轨迹 → 预测接地动作 tokenA_pred。Dual-MoT 让V和A_pred在分支内互动; - 右半边 = VLA 通路(左脑/语义):多视角图像 + 指令 →
Qwen3-VL-4B→ 语义 tokenU;自车历史 → 状态 tokenE;动作专家 → 语义接地动作 tokenA_sem。Dual-MoT 让U/E/A_sem在分支内互动; - 中间那根"桥" = CAB:
A_pred和A_sem双向 cross-attention + 门控残差注入。注意图上原始 VLM/VGM token 不会跨过桥——桥只连动作 token; - 底部 = CIF + 解码器:把协调后的两条动作流拼接 → 小 Transformer → 平均 → 解码出最终轨迹。
🎯 架构图的核心读法:看"什么 token 能碰到什么 token"。Tri-MoT 里所有 token 都能碰到彼此;BrainWAM 里 VLM 和 VGM 的原始 token 永远不见面,只有它们的"动作投影"通过 CAB 桥打招呼。
📥 输入 / 📤 输出(对齐上面流程图再读一遍)
- 输入:多视角图像(双通路共用)+ 导航指令(VLA 通路)+ 自车历史(VLA 通路)+ 噪声视频 latent(WAM 通路)+ 噪声轨迹(两条通路的动作专家共用);
- 中间:两个"特化"的动作 token(A_pred/A_sem)经 CAB 协调、CIF 融合;
- 输出:一条可执行的未来轨迹
a。
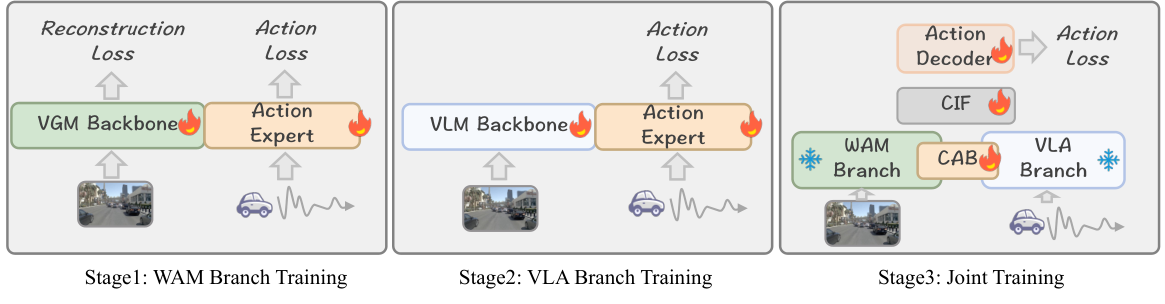
🔍 图 4 怎么读?
一张横向三段图,从左到右是训练时间线:
- Stage 1(WAM 分支):只训练"预测通路"。输入当前观测 → VGM(视频骨干)学未来帧生成,同时一个 rectified-flow action expert 学轨迹;两个目标联合(
L_vid+L_pred^a)。产出:预测接地(prediction-grounded)的动作表示; - Stage 2(VLA 分支):只训练"语义通路"。输入多视角图像 + 导航指令 → VLM(Qwen3-VL-4B)提取语义,同样接一个 rectified-flow action expert。产出:语义接地(semantic-grounded)的动作表示;
- Stage 3(冻结 + 协调):两条分支全部冻结,只训练 CAB + CIF + 最终动作解码器——让两个已经"成才"的通路在动作层面对话。
🔑 为什么 Stage 3 要冻结分支?论文在附录 D 里专门论证:冻结预训练分支能让第 3 阶段优化更稳定——如果继续微调大模型,协调模块的学习会和分支自身的表示漂移耦合,训练不稳定;冻结后,协调模块只需学"如何组合两个固定的、互补的表示",问题干净得多。
⚙️ 模块一:WAM Branch(右脑——预测通路)
3.1 架构
WAM 分支是"未来感知"半边,对应架构图(图 3)的左侧:
- 视频骨干:
Wan2.2-TI2V-5B(Wan 系列的 text-image-to-video 模型),负责对未来视频 latent 做去噪,产出视觉 tokenV(捕捉场景动态); - 轻量动作专家:rectified-flow 动作模型,对轨迹做去噪,产出预测接地动作 token
A_pred; - Dual-MoT 耦合:视频流和动作流通过共享自注意力互动,但各自保留专属的 feed-forward 网络——这是 “Dual-MoT”(双模态)的关键:注意力层共享让两类 token 能对话,FFN 专属保证各自建模能力不被污染。
输入和输出(论文 Eq.1):
$$\hat{u}^v,\ \hat{u}^a_{\text{pred}} = F_{\text{WAM}}\left(x^v_{t_v},\ x^a_{t_a},\ t_v,\ t_a,\ c_{\text{obs}}\right)$$x^v/x^a:带噪声的视频 latent 和动作轨迹;t_v/t_a:各自独立的 rectified-flow 时间步(这个"解耦调度"是后面异步推理的关键);c_obs:当前观测条件特征;- 输出:预测的视频速度场
u^v和动作速度场u^a_pred。
3.2 Rectified-flow 训练
和 SimWAM 一样走 rectified flow:在干净数据 x0 和高斯噪声 ϵ 之间做线性插值
WAM 分支把这个路径同时施加到视频 latent 和动作轨迹(但用独立的 t_v/t_a):
速度目标都是"噪声减干净":u^v = ε^v − x^v_0、u^a = ε^a − x^a_0。两个回归损失(L1)+ 加权合成:
为什么视频和动作用独立的 timestep? 这是埋下伏笔的设计——允许视频流"早退":预测上下文一旦形成就让视频流停,动作流继续去噪出轨迹(后面"异步推理"全靠它)。
⚙️ 模块二:VLA Branch(左脑——语义通路)
3.3 架构
VLA 分支是"语义理解"半边,对应架构图(图 3)的右侧:
- VLM 骨干:
Qwen3-VL-4B,把多视角图像和驾驶指令编码成语义 tokenU; - 状态 token:自车历史(ego history)编码成
E; - 轻量动作专家:rectified-flow 动作模型,处理带噪轨迹
x^a_{t_a},产出语义接地动作 tokenA_sem; - Dual-MoT:语义 token、状态 token、动作 token 通过共享自注意力耦合,引导动作去噪。
(Eq.7)VLA 分支只预测动作速度场:
$$\hat{u}^a_{\text{sem}} = F_{\text{VLA}}\left(U,\ E,\ x^a_{t_a},\ t_a\right)$$3.4 Rectified-flow 训练
和 WAM 的轨迹部分同构,只是监督来自语义:
$$\mathcal{L}_{\text{sem}}^a = \mathbb{E}\,\|\hat{u}^a_{\text{sem}} - u^a\|_2^2,\qquad u^a = \epsilon^a - x^a_0$$💡 两个分支的结构高度对称:都是"大骨干 + 轻量 rectified-flow 动作专家",都用 Dual-MoT 在分支内部耦合。区别只在"老师":WAM 的老师是未来视频(动态),VLA 的老师是语言+图像(语义)。这正是"功能特化"的体现——两套动作表示,来源完全不同。
⚙️ 模块三:CAB + CIF——在大脑层面的协调
3.5 联合训练设置
第 3 阶段,两条分支冻结,只有三样东西可训:CAB、CIF、最终动作解码器。两条动作专家接收同一条带噪轨迹、同一个动作时间步(t_a 一致),这样两边的动作 token 处于相同噪声水平——CAB 交换消息才公平;视频分支保留自己的 t_v 提供预测上下文。
3.6 Callosal Action Bridge(CAB)——模拟胼胝体
胼胝体是连接左右脑的"信息桥"。CAB 就是连接两条动作通路的桥——在动作 token 层面做双向跨流注意力,而不是混 raw token。
在第 l 层,CAB 计算双向消息(Eq.10):
其中 Ψ_cab(X,Y) 是用 X 做 query、Y 做 key/value 的 cross-attention。然后通过带门控的残差注入更新两条流(Eq.11):
- 门控
α = tanh(g),初始化为 0——训练刚开始时两条流保持原样,随训练逐步学习"该传多少信息过去"; - 好处:不打扰已经预训练好的动作表示,先让桥开着,再慢慢调节门,稳。
💡 CAB 和 Tri-MoT 的本质区别:Tri-MoT 是所有 token 无差别地互相看(VLM/VGM/action 全混一个池);CAB 是只有动作 token 在桥的两头互相看,而各自的语义/视频原始 token 仍然留在各自分支内部。融合发生在"动作表示"这一层,而不是"原始模态表示"这一层。
3.7 Cerebellar Intent Fusion(CIF)——模拟小脑
小脑负责把运动意图打磨成精细动作。CIF 就是把 CAB 协调后的两条动作流合并成最终意图再解码出轨迹:
$$Z_{\text{pred}}, Z_{\text{sem}} = \text{CIF}\left(\tilde{A}_{\text{pred}}^L,\ \tilde{A}_{\text{sem}}^L\right),\qquad Z = \mathcal{M}(Z_{\text{pred}}, Z_{\text{sem}})$$- 先把两条流拼接,过一个小型 Transformer 模块;
- 再把输出逐元素平均(
M表示 mean); - 融合表示
Z由动作解码器D_fuse(Z, t_a)解出动作速度场u^a_fuse; - 联合训练阶段只监督这一个融合输出(Eq.13):
L_fuse = E‖u^a_fuse − u^a‖²。
3.8 推理(Inference)
推理时:两条动作专家从同一条噪声轨迹出发,走完全相同的动作时间步 → CAB 协调中间表示 → CIF 融合 → 解码出最终轨迹。(完整架构图见上文"🧩 整体架构拆解"章节的图 3)
🔍 逐图详解:三张"诊断图"读懂 BrainWAM 的动机
图 2(注意力诊断)——为什么 Tri-MoT 会输
已在上文展开:action token 对 VLM token 的注意力在绝大多数层碾压对 VGM token 的注意力,浅层尤甚 → 语义捷径压垮预测信号。
图 6(附录图)——模态失衡的量化证据
论文附录 A 把"语义优势"从"统计规律"上升到"系统性现象":几乎每一层、每一个注意力头上,action 对 VLM 的关注都系统性高于对 VGM 的关注。这把"注意力分配错配"的诊断坐实——它不是你调几个超参就能绕过去的偶发现象,而是 Tri-MoT 这个设计的内在毛病。
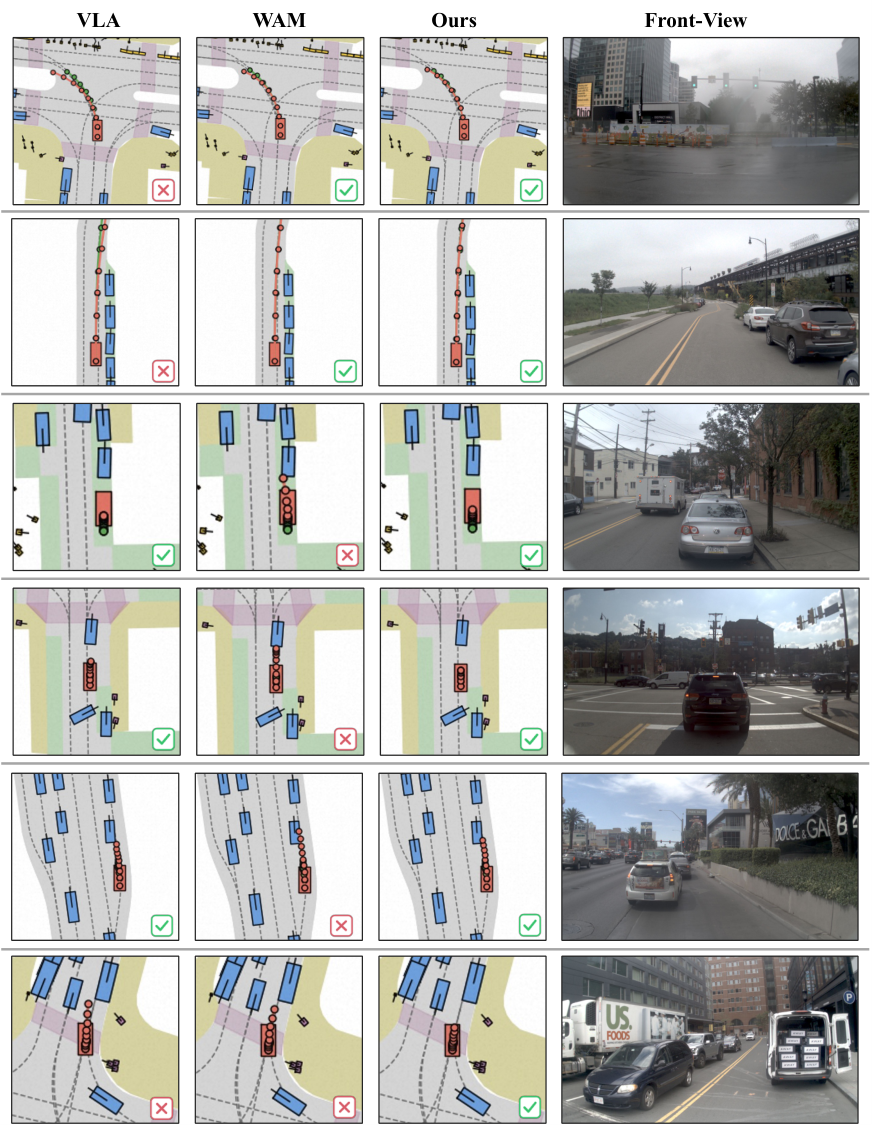
图 5(定性对比)——四条场景见真章

论文挑的四类场景正好对应"语义 vs 预测"的分工:
| 场景 | 考验什么 | 谁强 |
|---|---|---|
| 导航跟线 | 遵循路线指令,别选"局部合理但走错路"的分支 | VLA(指令接地好) |
| 红绿灯/前车刹车理解 | 联合读懂刹车灯 + 红灯,避免追尾 | VLA |
| 交互博弈 | 预判本车/行人/周围车的耦合行为 | WAM |
| 弯道轨迹可行性 | 只凭当前观测会误判未来运动 | WAM |
VLA-only 在语义类场景(前两行)表现好但预测类场景(后两行)拉胯;WAM-only 正好相反。BrainWAM 靠动作层协调,四类都稳——这就是"互补性"最直观的证明。
📊 实验结果:双榜 SOTA
5.1 主结果(NAVSIM v1,PDMS)
| 类别 | 方法 | 相机 | 激光 | NC↑ | DAC↑ | TTC↑ | C↑ | EP↑ | PDMS↑ |
|---|---|---|---|---|---|---|---|---|---|
| Human | — | — | — | 100.0 | 100.0 | 100.0 | 99.9 | 87.5 | 94.8 |
| 传统E2E | UniAD | ✓ | — | 97.8 | 91.9 | 92.9 | 100.0 | 78.8 | 83.4 |
| 传统E2E | DiffusionDrive | ✓ | ✓ | 98.2 | 96.2 | 94.7 | 100.0 | 82.2 | 88.1 |
| VLA | AutoVLA | ✓ | — | 98.4 | 95.6 | 98.0 | 99.9 | 81.9 | 89.1 |
| VLA | DriveVLA-W0 | ✓ | — | 98.4 | 95.3 | 95.2 | 100.0 | 80.9 | 87.2 |
| VLA | ReCogDrive | ✓ | — | 98.1 | 94.7 | 94.2 | 100.0 | 80.9 | 86.5 |
| WM | DrivingGPT | ✓ | — | 98.9 | 90.7 | 94.9 | 95.6 | 79.7 | 82.4 |
| WM | Epona | ✓ | — | 97.9 | 95.1 | 93.8 | 99.9 | 80.4 | 86.2 |
| WAM | DriveLaW | ✓ | — | 99.0 | 97.1 | 96.7 | 100.0 | 81.3 | 89.1 |
| WAM+VLA | BrainWAM | ✓ | — | 98.1 | 97.5 | 94.9 | 100.0 | 83.8 | 89.5 |
结论拆解:
- 89.5 PDMS,v1 上超过所有 VLA 和世界模型系方法,比最强 WAM(DriveLaW 89.1)高 0.4,比最强 VLA(AutoVLA 89.1)高 0.4;
- 增益集中在 DAC(97.5,全场最高)和 EP(83.8,全场最高)——可行驶区域合规和前进进度明显提升,说明"语义+预测"双通路让轨迹既守规则又走得更远;
- 相机-only(无激光雷达),参数规模、公平性对标同梯队。
5.2 主结果(NAVSIM v2,EPDMS)
| 方法 | NC | DAC | DDC | TLC | EP | TTC | LK | HC | EC | EPDMS |
|---|---|---|---|---|---|---|---|---|---|---|
| TransFuser | 96.9 | 89.9 | 97.8 | 99.7 | 87.1 | 95.4 | 92.7 | 98.3 | 87.2 | 76.7 |
| DriveSuprim | 97.5 | 96.5 | 99.4 | 99.6 | 88.4 | 96.6 | 95.5 | 98.3 | 77.0 | 83.1 |
| DriveVLA-W0 | 98.5 | 99.1 | 98.0 | 99.7 | 86.4 | 98.1 | 93.2 | 97.9 | 58.9 | 86.1 |
| DriveDreamer-Policy | 98.4 | 97.1 | 99.5 | 99.9 | 87.9 | 97.7 | 97.6 | 98.3 | 79.4 | 88.7 |
| BrainWAM | 98.1 | 97.5 | 99.6 | 99.9 | 88.2 | 97.4 | 97.6 | 98.4 | 85.8 | 89.6 |
- 89.6 EPDMS,v2 也 SOTA;提升主要来自 EP(88.2)和 EC(85.8)——效率与舒适,而规则合规指标(DDC/TLC)已接近饱和;
- 说明动作空间协调在更全面的 v2 协议(+DDC/TLC/LK/HC/EC)下依然有效。
5.3 消融 1:分支互补性 + 融合位置(表 3)
| 方法 | NC↑ | DAC↑ | TTC↑ | C↑ | EP↑ | PDMS↑ |
|---|---|---|---|---|---|---|
| VLA-only | 97.7 | 94.9 | 93.3 | 100.0 | 80.7 | 86.1 |
| WAM-only | 98.0 | 96.4 | 94.4 | 100.0 | 82.6 | 88.1 |
| Tri-MoT(raw token 融合) | 98.3 | 96.2 | 94.7 | 100.0 | 81.7 | 87.8 |
| BrainWAM(动作层协调) | 98.1 | 97.5 | 94.9 | 100.0 | 83.8 | 89.5 |
三个结论:
- WAM-only(88.1)远超 VLA-only(86.1)——在 NAVSIM 上,预测动态先验比纯语义先验更有价值;
- Tri-MoT(87.8)甚至低于 WAM-only(88.1)——直接把 VLM+VGM+action token 混进共享注意力,语义短路不仅没帮忙反而拖累预测——这印证了图 2 的注意力失衡诊断;
- BrainWAM(89.5)同时超过两个单分支和 Tri-MoT——差距不是靠加参数量(论文明说两者参数量相当),而是靠"在动作层协调"这个机制本身。
5.4 消融 2:CAB 和 CIF 各自的贡献(表 4)
| CAB | CIF | NC | DAC | TTC | C | EP | PDMS |
|---|---|---|---|---|---|---|---|
| ✓ | — | 98.1 | 96.8 | 94.8 | 100.0 | 83.0 | 88.7 |
| — | ✓ | 98.1 | 96.7 | 94.7 | 100.0 | 82.9 | 88.5 |
| ✓ | ✓ | 98.1 | 97.5 | 94.9 | 100.0 | 83.8 | 89.5 |
- CAB 单独用 88.7、CIF 单独用 88.5,合体 89.5(+0.8/+1.0);
- 增益集中在 DAC/EP,NC/TTC 稳定——说明 CAB 负责"中途交换动作消息",CIF 负责"收尾融合最终表示",两者互补不重复;
- 附录 B/C 还确认:两个 CAB 块够用、两个 CIF Transformer 层够用、Transformer 融合优于 MLP/拼接——工程上很克制。
5.5 消融 3:异步视频去噪的时延-精度权衡(表 5)
| 视频去噪步数 | 时延↓ | PDMS↑ | EPDMS↑ |
|---|---|---|---|
| 0 | 382 ms | 79.3 | 75.8 |
| 1 | 475 ms | 89.3 | 89.4 |
| 2 | 565 ms | 89.5 | 89.6 |
| 3 | 644 ms | 89.4 | 89.6 |
- 视频去噪 = 0 步时断崖式跌到 79.3:预测上下文没了,规划质量崩盘——证明"视频动态对规划是不可或缺的"(不是可有可无的装饰);
- 1 步视频去噪就回到 89.3:视频流"早退"只损失 0.2 PDMS;
- 从 1 步到 3 步,性能在 89.3–89.5 之间,时延从 475ms 涨到 644ms——1 步视频已经拿到绝大部分预测红利,这就是异步调度(解耦的
t_v/t_a)的工程价值。
🎯 异步视频去噪的设计精髓:视频和动作各自拥有独立的 rectified-flow 时间步,所以视频流可以在"预测上下文刚形成"时就停,把特征缓存给动作流用,动作流继续去噪出轨迹——用最小的视频开销拿到最多的预测增益。
⚖️ 与博客系列的精读横向对比
把 BrainWAM 放进博客已有的知识链里看位置。它的独特点是:别人的 WAM 是"单通路"(视频专家 + 动作专家),BrainWAM 是双通路 WAM(VLA 语义 + WAM 预测,动作层协调)。
与 SimWAM / Metis 的对比(同期"WAM 应该怎么设计"的三种答案)
| 维度 | SimWAM | Metis | BrainWAM |
|---|---|---|---|
| 核心机制 | 训练期视频监督 + 隔离注意力掩码(动作不看未来帧) | MoT 双专家 + 非对称掩码(动作只看当前帧,未来视频可看动作) | 双通路(VLA+WAM)+ 动作空间协调(CAB/CIF) |
| 视频分支的去留 | 训练完删除 | 训练完跳过 | 保留但异步早退(解耦 t_v/t_a) |
| 融合位置 | 共享注意力(训练期) | 共享注意力(训练期) | 动作 token 层(CAB 桥) |
| RL 环节 | ✅ Flow-GRPO | ❌ 无 | ❌ 无(纯两阶段蒸馏+协调) |
| 语义/语言先验 | ❌ 无 | ❌ 无 | ✅ VLM 语义通路(Qwen3-VL-4B) |
| NAVSIM 成绩 | 91.5 PDMS (v1) | navtest/navhard SOTA | 89.5 PDMS (v1) / 89.6 EPDMS (v2) |
关键差异:SimWAM/Metis 都是"视频+动作"的双专家(WAM 家族内部的设计之争),BrainWAM 是"VLA+WAM"双范式——它把"语义推理"也当成一条平级的通路接进来。从概念上,BrainWAM 比 SimWAM/Metis 多覆盖了 VLA 那半边。
与 DriveVLA-W0 / ReCogDrive 的对比(VLA 家族)
| 维度 | DriveVLA-W0 | ReCogDrive | BrainWAM |
|---|---|---|---|
| 语义来源 | Emu3-8B / Qwen2.5-VL-7B | Qwen2.5-VL + 扩散规划器 | Qwen3-VL-4B(作为一条通路) |
| 世界模型 | 显式未来图像预测(稠密监督) | 无 | WAM 预测通路(Wan2.2-TI2V-5B) |
| 融合哲学 | 同一 VLA 骨干联合预测 | VLM 认知表征 → 扩散规划器 | 语义/预测分离,动作层协调 |
| 定位 | VLA 系(用世界模型放大数据) | VLA 系(DiffGRPO) | VLA+WAM 双范式融合 |
与 DriveWAM(论文里 WAM 的直接参照)对比
| 维度 | DriveWAM | BrainWAM |
|---|---|---|
| 通路数 | 单条(视频+动作) | 双条(语义+预测) |
| 语义接地 | 弱 | VLM 显式语义通路 |
| 融合层 | 视频 latent 作为动作条件 | 动作 token 层双向桥(CAB) |
| 视频推理 | 全量生成未来帧 | 异步早退,1 步视频即可 |
一张图看清 BrainWAM 在知识链上的位置
传统 E2E(UniAD/VAD,模仿学习)往下分出三条范式线:
- VLA 范式:ReCogDrive、DriveVLA-W0(语义/语言先验驱动);
- WM 范式:GAIA-1、DriveDreamer、GenAD(纯未来预测,不直接出动作);
- WAM 范式:DriveWAM、SimWAM、Metis(视频预测 + 动作联合建模)。
BrainWAM 站在第 1 条和第 3 条线的交叉点上:把 VLA 的语义通路(第 1 支)和 WAM 的预测通路(第 3 支)同时接入,在动作层协调(“语义通路 × 预测通路”)。WM 范式则作为 WAM 的"底座"存在于它的预测分支里。
BrainWAM 是这个知识链上的"合流点":它把 VLA 的语义先验(ReCogDrive/DriveVLA-W0 那支)和 WAM 的预测动态(SimWAM/Metis/DriveWAM 那支)同时接入,并且证明"直接拼会翻车,动作层协调才行"。
⚠️ 优势与局限
✅ 优势
- 诊断清晰:先给出 Tri-MoT 失败的可量化机制(图 2 注意力失衡),再对症下药——不是盲试架构;
- 脑科学映射有工程抓手:CAB/CIF 不是装饰,消融证明两者各司其职、合体增益明确(+0.8/+1.0);
- 冻结分支保稳定:Stage 3 冻结两大骨干,协调模块学习目标干净,训练稳定(附录 D);
- 异步推理省时延:解耦
t_v/t_a,1 步视频去噪拿到 99.8% 的预测红利,时延从 644ms 降到 475ms; - 双榜 SOTA:v1 89.5 PDMS、v2 89.6 EPDMS,超过所有 VLA-only 和 WAM-only。
❌ 局限
- 绝对分数不是最强:NAVSIM v1 的 89.5 低于 SimWAM 的 91.5(SimWAM 有 Flow-GRPO RL 加持),说明纯两阶段蒸馏+协调的天花板低于"蒸馏+RL";
- 没有 RL 环节:轨迹质量依赖两个分支的预训练先验,没有像 SimWAM 那样用奖励直接优化驾驶质量;
- 非反应式评估:NAVSIM 的 PDM/EPDMS 基于非反应式仿真,真实闭环表现(Bench2Drive 等)未验证;
- 参数量/时延仍是双大模型:VLM(4B) + VGM(5B) 两套骨干,475ms 的推理时延在"端到端上车"语境下仍偏重,需要工程瘦身;
- CAB/CIF 的"动作空间"选择:为什么动作表示是融合的正确层级、而不是更高阶意图,论文给出了实证(表 3)但机制解释仍偏直觉。
📝 个人思考
这是"多模态融合应该发生在哪一层"的一次教科书级回答。BrainWAM 的贡献分两层:第一层是诊断——它用注意力可视化证明 Tri-MoT 失败不是"融合不够",而是"融合错了层"(raw token 空间里易学模态碾压难学模态);第二层是处方——把融合挪到动作表示层,用门控桥(CAB)和协调器(CIF)实现"特化 + 协调"。
三个让我眼前一亮的点:
“语义捷径"这个概念很有普适性。任何多模态联合训练都会遇到"好学的模态抢注意力"的问题(语言模型里早就观察到文本压过视觉)。BrainWAM 把这个问题搬到"语义 vs 预测视频"上,并给出一个可操作的规避方案——在更抽象的、任务相关的表示层(动作)融合。这个原则可以迁移到任何"强先验 × 弱信号"的多模态组合。
“功能特化"比"统一大杂烩"更接近大脑,也更接近工程现实。SimWAM/Metis 用掩码强制解耦,BrainWAM 用双通路物理分离 + 动作层桥接——殊途同归,都指向同一个结论:不要把所有信号倒进一个锅里。这跟 MoE(Mixture-of-Experts)的哲学同源。
冻结 + 只训协调模块是高效的"联邦式"微调。第 3 阶段把两个预训练大模型当"固定的特征工厂”,只训练轻量协调器——这和 LoRA、adapter 的思路一致,但结构上更符合"特化系统协同"的隐喻。如果未来 VLM/VGM 各自升级,协调器不用重训。
下一步最值得关注:①给 BrainWAM 加一个 RL 环节(像 SimWAM 的 Flow-GRPO),大概率能再上一个台阶——毕竟它的双通路表示更丰富,RL 的探索空间更大;②把异步视频早退的调度用到极致(比如 0.5 步视频),看时延能不能压到纯 planner 水平;③Bench2Drive 反应式闭环验证——这是所有 NAVSIM SOTA 的最终考卷。
关联阅读:这篇和 SimWAM 精读(单通路 WAM + Flow-GRPO)、Metis 精读(MoT 双专家 + 非对称掩码)、ReCogDrive 精读(DiffGRPO 强化认知)、DriveVLA-W0 精读(世界模型放大数据)串起来读,正好构成"VLA 语义 → WAM 预测 → 双通路协调"的完整图谱:ReCogDrive/DriveVLA-W0 代表 VLA 那支,SimWAM/Metis 代表 WAM 那支,BrainWAM 是第一篇把两支在动作空间拧成一个系统的 WAM。
📖 论文精读系列。BrainWAM(arXiv:2608.12854,中科院自动化所 × 理想汽车)是"VLA + WAM 双通路在动作层协调"的代表作,与 SimWAM(单通路 WAM + Flow-GRPO,arXiv:2608.07468)对照阅读,能看清 2026 年 WAM 设计的两大方向:单通路做精 vs 双通路融合。