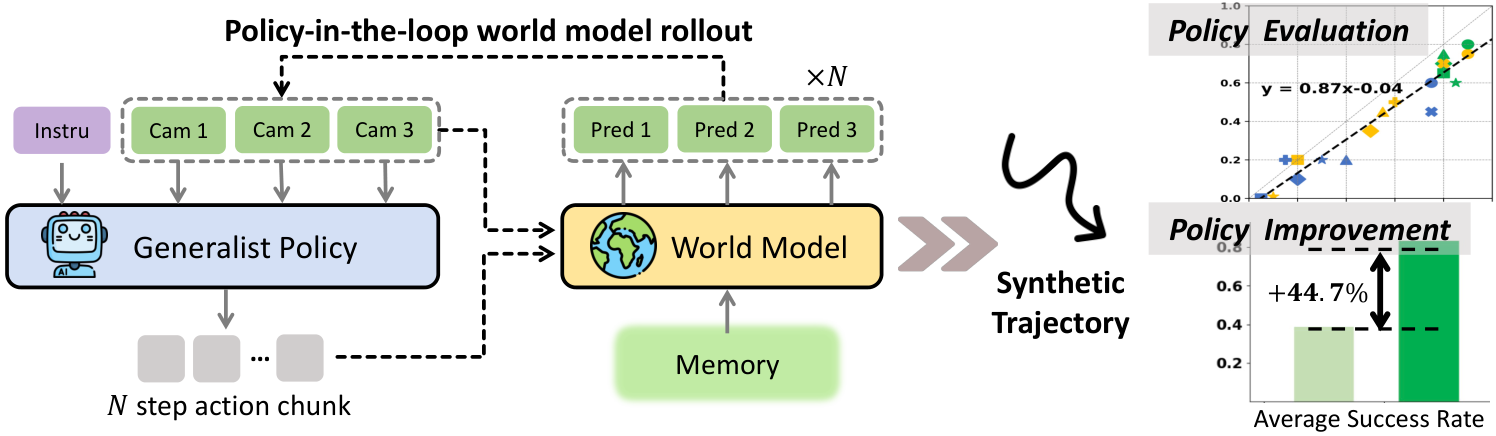
配图说明:本文收录 9 张论文插图(/images/ctrlworld/fig1–9)+ 官方 GitHub 演示媒体 9 件(横幅 JPG、2 个长程对比 GIF、2 组三视角合成轨迹 MP4),论文图逐张讲解,GitHub 媒体在第 4 章内嵌播放。论文 Ctrl-World: A Controllable Generative World Model for Robot Manipulation(arXiv 2510.10125,ICLR 2026),斯坦福 + 清华(Yanjiang Guo、Lucy Xiaoyang Shi 共同一作,Jianyu Chen,Chelsea Finn);官网 ctrl-world.github.io;官方实现 github.com/Robert-gyj/Ctrl-World(575★,MIT,同时包含后续 VLAW 论文的世界模型后训管线)。
📄 论文信息
- 标题:Ctrl-World: A Controllable Generative World Model for Robot Manipulation
- 机构:Stanford University、Tsinghua University
- 时间:2025-10 挂 arXiv(2510.10125),ICLR 2026 正式发表
- 关键词:可控世界模型、policy-in-the-loop、多视角(含腕部)、帧级动作条件、位姿条件记忆、指令跟随评测与改进、DROID、SVD 初始化
- 一句话总结:给 VLA 配一个「能一起玩」的世界模型——多视角联合预测 + 厘米级动作控制 + 20 秒长程记忆,让策略在想象里被测(排名≈真机)与被改(合成成功轨迹 SFT,成功率 +44.7%)。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| 想象排名 ≈ 真机排名 | 指令跟随 y=0.87x−0.04;成功率 y=0.81x−0.11 | π0/π0-fast/π0.5 × 7 任务,真机 vs 世界模型散点(Fig. 7) |
| 策略改进 | 平均 +44.7%(0.39→0.83) | 合成成功轨迹 → SFT(Fig. 9) |
| 分任务涨幅 | Spatial 0.29→0.88;Shape 0.44→0.93;Towel-Dir 0.57→0.80;Novel-Obj 0.25→0.73 | 四类指令理解短板 |
| 训练数据 | DROID 95k 轨迹 / 564 场景 | 全开源可复现 |
| 长程生成 | 新场景/新相机位姿下 >20 秒 连贯多视角 | 位姿条件记忆检索 |
| 动作控制精度 | 厘米级(帧级条件注入 1 秒动作块) | 同初始帧 + 不同动作序列 → 不同轨迹 |
| 底座 | Stable Video Diffusion(SVD) 初始化 | 适配为可控、时间一致的世界模型 |
| 官方仓库 | Robert-gyj/Ctrl-World,575★,MIT | 4 条推理跑法 + 训练/后训(VLAW) |
✨ 创新点:论文自己认领的四条 + 为什么难
先看它要打的靶:此前的动作条件世界模型有三宗罪——①单视角导致部分可观测与接触幻觉(碗没碰就「进爪」),也不匹配现代 VLA 的多相机输入;②缺高频动作条件,动作与画面的因果对不上;③长程不一致,误差累积漂移(相关工作 §2 归纳)。
论文的四条创新(按论文声明整理):
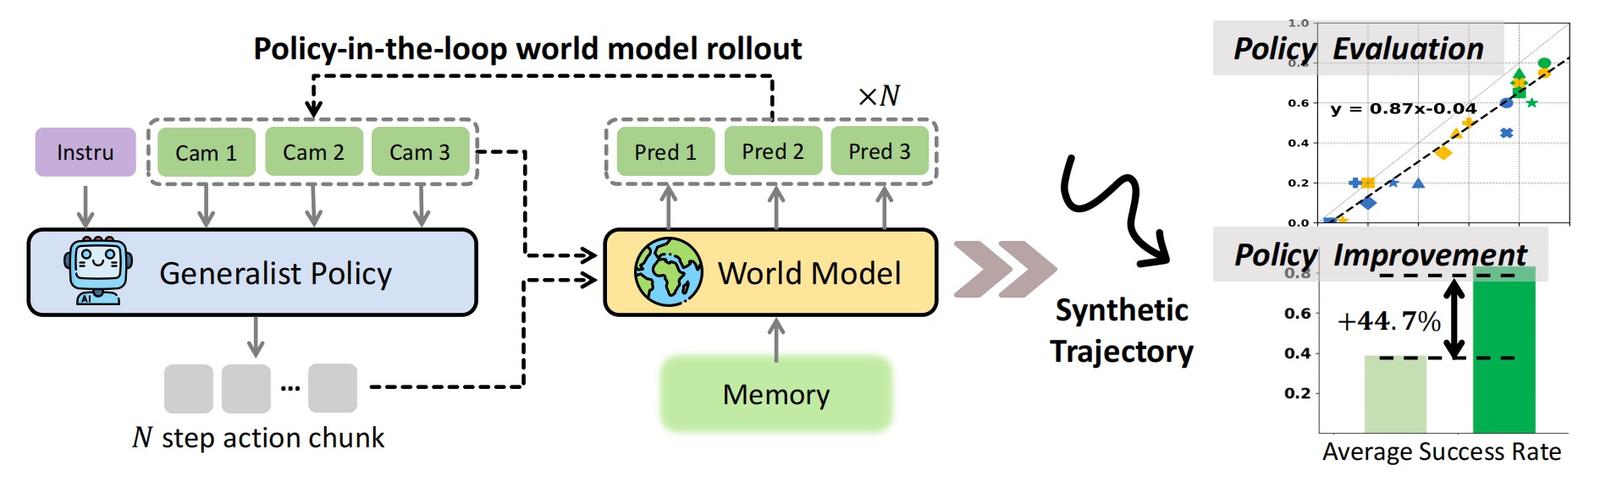
- 首提「可控多视角世界模型 × policy-in-the-loop」工作流:核心贡献(原文 core contribution)是让 SOTA VLA 官方权重(π0/π0-FAST/π0.5)在世界模型里闭环跑——策略出动作、模型出未来、交替自回归,全程想象空间。附录 B 原话:first world model that enables policy-in-the-loop interactions between state-of-the-art VLA models;
- 三机制把「被动视频生成器」改造成「策略兼容的交互模拟器」(原文 transformation 语):
- 联合多视角预测——含腕部,显著减少接触密集交互的幻觉,同时满足 VLA 输入格式;
- 帧级动作条件——视觉动态与控制信号逐帧对齐,rollout 反映每个动作的因果效果(厘米级);
- 位姿条件记忆检索——稀疏历史帧 + 位姿入帧,让模型「 attend to similar past states」,稳住 20 秒+ 长程;
- 想象力工作流闭环(评测 + 改进双用途):评测——想象中的指令跟随排名与真机对齐(回归线 0.87/0.81);改进——想象里合成成功轨迹 → SFT → 下游任务成功率 38.7%→83.4%(+44.7pp),全程不采一条真机演示;
- 零样本迁移的实用边界:只用开源 DROID 训练 → 新场景、新相机位姿上 20 秒+ 连贯 rollout——作者自建平台与验证集双零样本(策略与模型同时迁移)。
一句话创新点:不是让世界模型更像视频,而是让它「听动作的话、记得住过去、接得住策略」——三个机制各治一宗罪,换来一个能测能改 VLA 的仿真替身。
🗺️ 仿真 vs 真机:一眼分清
| 场景 | 类型 | 说明 |
|---|---|---|
| 世界模型内 rollout(回放/键盘/π0.5 进环) | 生成式「想象」评测 | 不是物理仿真器——视频扩散模型自回归造未来 |
| 真机 rollout(π0.5 七任务 × 20 次) | 真机(对照组) | 用来验证「想象排名=真机排名」(Fig. 6/7) |
| 合成成功轨迹 → SFT | 真机策略改进 | 改进幅度在真机上验收(Fig. 9,+44.7%) |
| 训练/后训(DROID 预训练 + VLAW 下游后训) | 离线数据 | 8×A100/H100 级别;后训见仓库(3)节 |
一句话定位:世界模型是「生成式评测器」——它既不是 MuJoCo 那种物理仿真,也不是纯视频玩具;有效性的证据就是 Fig. 7 的两条回归线。
🧭 读前 5 分钟:四个概念
- Policy-in-the-loop(策略进环):世界模型不止预测「给定动作的未来」,还要能接住真策略的输出再生成下一步——闭环里策略与模型互相为对手/学生;本文是首个让 SOTA VLA(π0/π0-FAST/π0.5 官方 DROID 权重)在世界模型里闭环交互的工作(附录 B 原话)。
- 多视角联合预测(含腕部):现代 VLA 吃第三人称 + 腕部相机;腕部视野在一条轨迹里剧烈变化,单视角世界模型要么幻觉(物体无接触就「粘」进夹爪)要么不兼容策略输入。
- 帧级动作条件(frame-level action conditioning):把动作转成笛卡尔位姿后逐帧注入生成过程——同初始帧、换动作序列就换轨迹,精度到厘米级。
- 位姿条件记忆检索(pose-conditioned memory retrieval):长程自回归会漂;按位姿检索历史帧进上下文,并把位姿嵌入帧做交叉注意——预测第 4 秒时会「回看」第 0 秒的相似位姿帧(Fig. 4 左侧注意力可视化就是证据)。
📐 问题形式化:两条方程的自回归闭环
现代通才策略 π 把 n 路观测 + 语言 映射成 H 步动作块:
$$o_t = [I^1_t, \dots, I^n_t, q_t], \qquad a_{t+1:t+H} \sim \pi(\cdot \mid o_t, l) \tag{1}$$世界模型 W 的任务是预测执行这串动作后的多视角未来,把结果喂回策略形成闭环:
$$o_{t+1:t+H} \sim W(\cdot \mid o_t, A_t), \qquad A_{t+H} \sim \pi(\cdot \mid o_{t+H}, l) \tag{2}$$如此策略 ↔ 世界模型交替自回归,长程 rollout 全程发生在想象空间——既不需要物理仿真器,也不需要真机。要让 (2) 成立,W 必须同时做到三件事:多视角一致、动作可控、长程不漂——这正是下面三个改造要解决的。
🛠️ 方法详解:SVD 底座上的三个改造(原文 §4.1 + 附录 A)
4.1 底座与训练目标
- 底座:预训练 1.5B Stable Video Diffusion(SVD)——时空 Transformer(spatial-temporal transformers)视频扩散骨干,继承其全部视频先验;
- 唯一新参数:一个 3 层 MLP,把 7 维笛卡尔空间动作投影到 1024 维潜变量——除它之外初始化时参数全不动;
- 编码:图像过 8×8 空间下采样 VAE;3 路相机各 192×320 → 潜特征 24×40;
- 扩散训练(x0 预测式,Eq. 3):目标帧 $x_0=o_{t+1:t+H}$ 加噪 $x_{t'}=\sqrt{\alpha_{t'}}x_0+\sqrt{1-\alpha_{t'}}\epsilon$,模型输入 = [历史帧 tokens ‖ 加噪未来 tokens],条件 c = [历史位姿 + 未来动作位姿 + 历史帧],损失:
- 训练配方(附录 A):95k DROID 轨迹全量;每步随机采轨迹→随机采当前帧→向过去采记忆帧→预测其后未来帧;2×8 H100、batch 64、lr 1e-5、100k 步、约 2–3 天。
4.2 改造一:多视角联合预测
N 路输入图像(每帧 H×W 个潜 token)沿 token 维拼接,一次联合去噪所有视角的未来 $o_{t:t+H}$。联合预测不只是「顺便多出两个视角」——论文观察它本身提升一致性并大幅减少幻觉:腕部「看」到的接触事件可以由第三人称视角的几何信息背书(反之亦然)。数量关系:每帧 token 数 P = N × H_latent × W_latent。
4.3 改造二:位姿条件的记忆检索
- 稀疏历史:向过去按步长 m 采 k 帧(实装 k=7,历史帧间隔 1–2 秒)——上下文被硬性限长;
- 位姿入帧:把机械臂位姿 $[q_{t-km},\dots,q_t]$ 通过帧级交叉注意力(frame-wise cross-attention)注入空间 Transformer 的对应帧——每个视觉 token 组「知道」自己帧的本体位姿;
- 检索语义:模型用「位姿相似度」从历史里抓相关帧,把未来预测锚回曾经见过的相似状态(re-anchoring)——预测 t=4s 帧时注意力强指回 t=0s 的同位姿帧(Fig. 4 左图的注意力热图),这就是「检索」的可视化证据。
4.4 改造三:帧级动作条件
- 预训练 SVD 只认文本+图像,控制精度为零——Ctrl-World 追加动作条件:
- 动作块先转成笛卡尔位姿序列 $[a'_{t+1:t+H}]$,与历史位姿 $[q_{t-km},\dots,q_t]$ 拼成一条位姿序列;
- 同一套帧级交叉注意力分工:历史帧的视觉 token 注意自己帧的 q,未来帧的视觉 token 注意自己帧的 a’——「每帧一个位姿 token($B\times1, C_a$)」,把高频动作钉到对应帧上(消融里去掉它,腕部 PSNR 从 19.18 掉到 15.69——三改造里对控制精度贡献最大)。
- 15 步进、5 步算:DROID 动作块 15 步(1 秒),为省显存先转笛卡尔再时间下采样到 5 步喂给模型——控制窗口不变、序列变稀。
4.5 Token 账本(架构一图流)
总输入形状:$B \times (7\ \text{历史帧} + 5\ \text{未来位姿帧}) \times (3\ \text{视角} \times 24 \times 40)$——12 个「帧位置」每个装 2880 个视觉 token,再叠 CLIP 语义 token(文本)、历史/未来位姿嵌入($B\times1\times C_a$);进入 SVD 的 Spatial Transformer(B×P,T,C)→ Temporal Transformer(B×T,P,C) 交替栈(Fig. 2 右侧结构图即此账本)。历史帧的噪声是独立采样的(对鲁棒性的又一个小设计)。
4.6 策略桥:从关节速度到世界模型的位姿接口(附录 B)
官方 openpi 策略吃关节角+双视角、吐关节速度;世界模型要笛卡尔位姿——桥接三步:
- Adapter(2 层 MLP,在 DROID 上训练):$q^{joint}_{t+1:t+H} = \text{Adapter}(q^{joint}_t, a^{jv}_{t+1:t+H})$——把「当前关节+速度指令」积成未来关节构型;
- 正运动学:$q^{cartesian} = \text{FK}(q^{joint})$(Franka Panda FK);
- 喂模型:$o_{t+1:t+H} = \text{WM}(o_t,\ q^{cartesian}_{t+1:t+H},\ q^{cartesian}_{history})$。
这条链让 π0/π0-FAST/π0.5 的官方权重零改动进环——「policy-in-the-loop」的工程关键就在这个 2 层 MLP 上。
🗂️ 数据集:DROID 怎么用(平台 / 规模 / 拆分 / 为什么带失败)
| 维度 | 内容 |
|---|---|
| 平台 | DROID(Khazatsky et al. 2024):Franka Panda + Robotiq 夹爪;1 腕部相机 + 2 个随机摆位第三人称相机(作者评测用同款布局自建平台) |
| 规模 | 95,599 条轨迹 / 564 个场景——含 约 76k 成功 + 约 19k 失败轨迹 |
| 失败数据是资产 | 论文明说:多样动作与失败数据对训练可控世界模型至关重要——模型要能模拟各种未来(包括失败走向),策略进环才不会一遇「没见过的烂摊子」就崩 |
| 训练采样 | 每步随机采一条轨迹 → 随机采当前帧 → 向过去采记忆帧 → 目标 = 其后未来帧(附录 A) |
| 验证划分 | 留出 2% 轨迹作验证集;质量评测从中随机 256 段 × 10 秒 |
| 改进阶段用数 | 不用演示!每任务自采 400 条想象 rollout → 人工偏好挑 25–50 条成功者 → SFT 2k 步(数据是「自己想出来的」) |
| 预训练配置 | 2×8 H100、batch 64、lr 1e-5、100k 步、2–3 天;三相机 192×320、历史 7 帧(间隔 1–2s)、动作窗 1s=15 步(进模型前降到 5 步) |
一句话:DROID 提供「密集动作 + 失败样本 + 多相机」的原料,Ctrl-World 只花 2–3 天把它炖成可交互的替身;改进阶段连真机都不再碰——数据完全来自想象。
📸 逐图讲解(论文 9 张)
Figure 1:总览——策略进环的多视角世界模型(头图)
(即文首头图。)左侧通用 VLA 策略与右侧世界模型构成闭环:初始帧 + 动作块进模型 → 联合多视角未来(含腕部)吐回策略;标注两大用途——(1) 想象中评测指令跟随 (2) 对未见指令做定向改进。读图抓手:「多视角 + 帧级控制 + 位姿记忆」三件套是闭环能转起来的前提,缺任何一个都会在多步交互里散架。
Figure 2:从 SVD 到可控世界模型
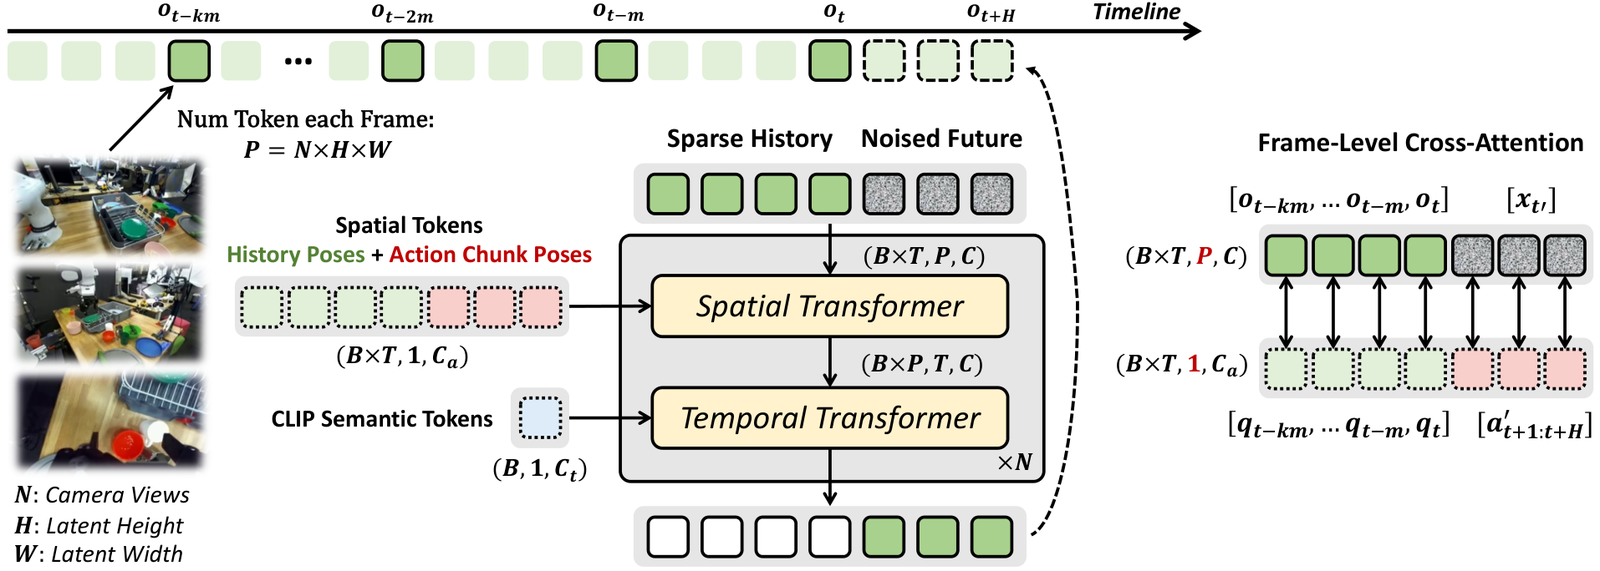
SVD 预训练权重 → 适配为可控、时间一致的世界模型:动作、多视角、记忆等条件通路被接入原视频扩散骨干。工程含义:站在 8GB 级 SVD 肩膀上——生成质量靠底座,可控性靠适配,这是小团队能训起世界模型的现实路径(与 Sonic/SONIC 系「站在大规模预训练上」的哲学一致)。
Figure 3:长程 rollout 定性对比(验证集)
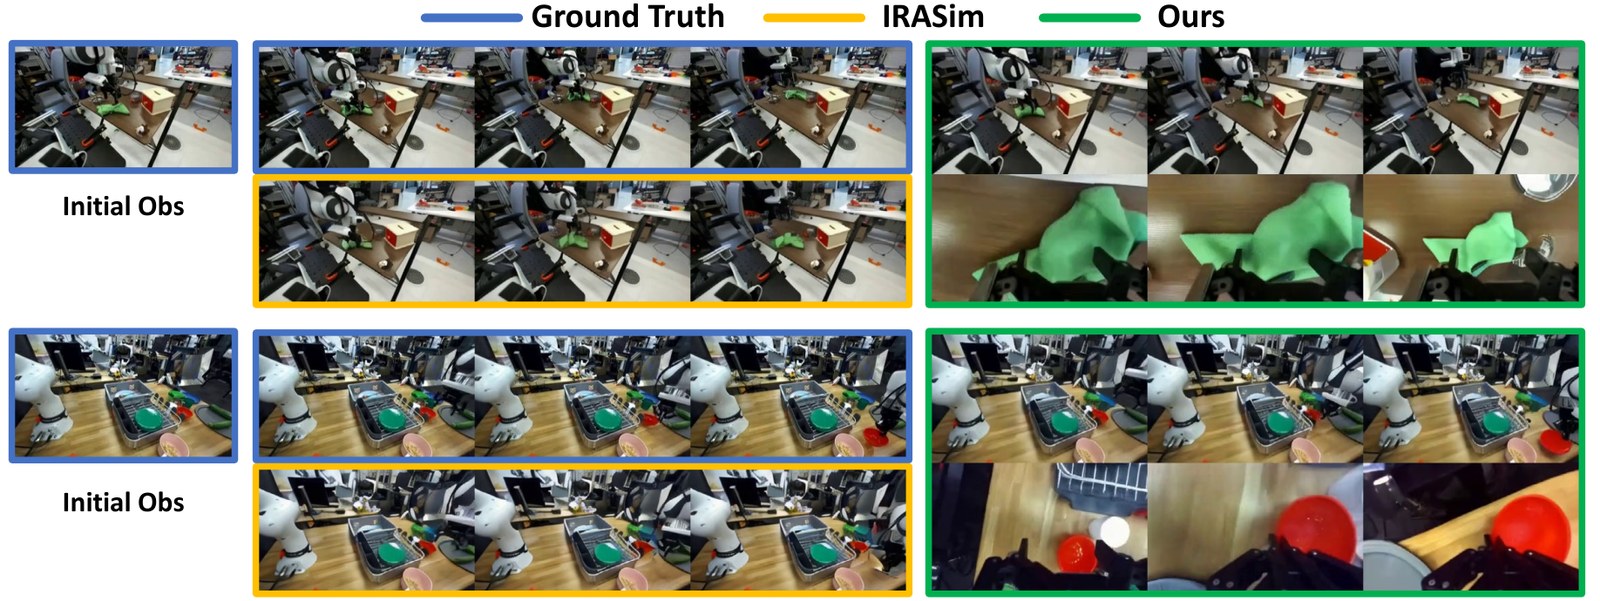
Ctrl-World 与单视角前作在验证集长程回放上的多视角帧对比:前作单视角预测易出幻觉/漂移,本文多视角联合在 20 秒级轨迹上保持场景与物体恒常。配 Table 1(交互式长程生成的量化指标)阅读——定性图给「肉眼连续性」,表格给分数。
Figure 4:可控性与消融——厘米级换动作换轨迹
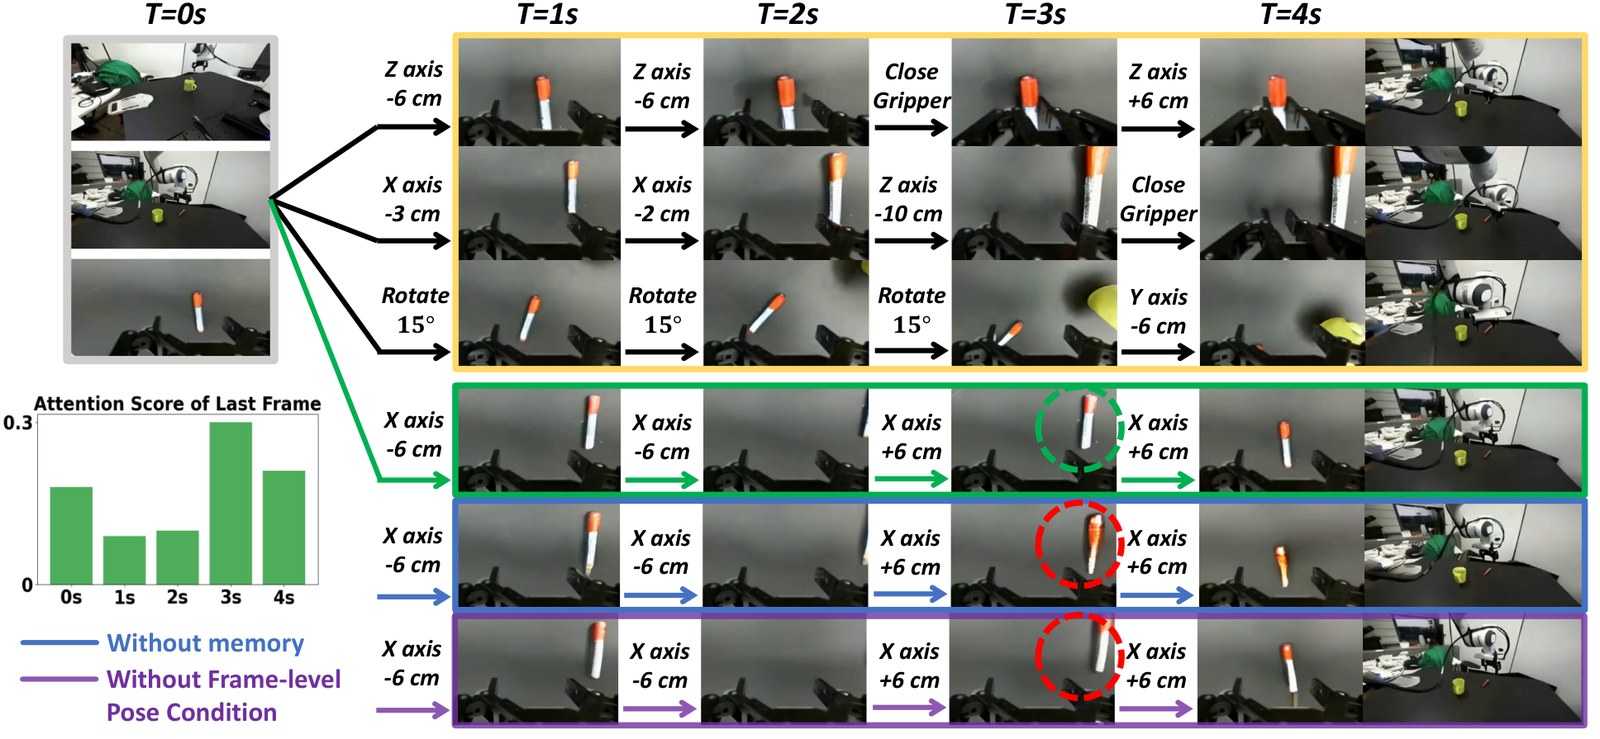
同一初始帧 + 不同动作序列 → 不同轨迹的多组对照,叠加消融可视化(去帧级条件/去多视角的退化)。这是「Controllable」的字面证据:控制粒度到厘米级,而不是「大方向差不多」。
Figure 5:腕部一致性
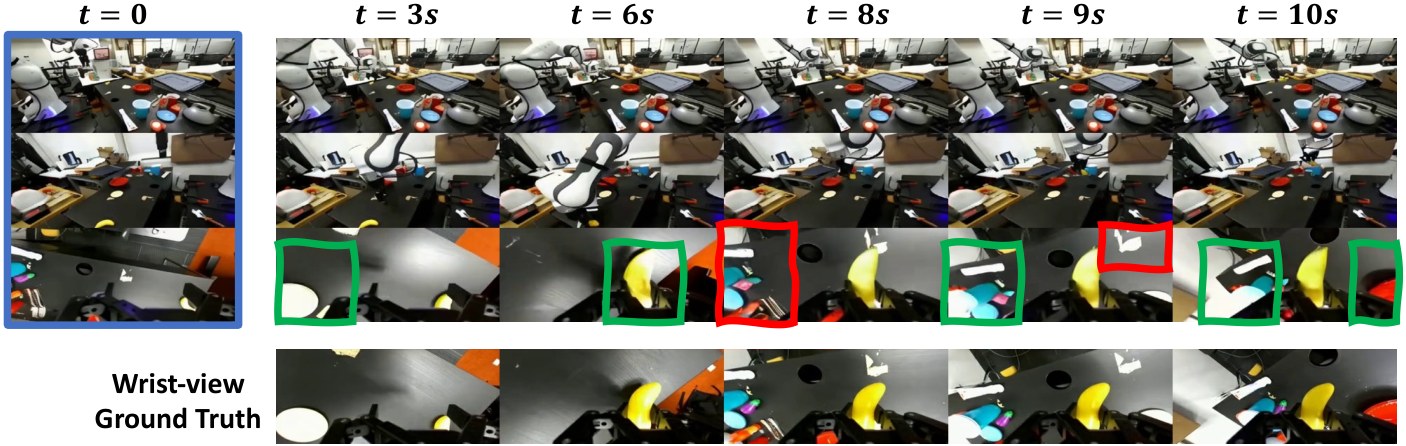
单条轨迹内腕部相机视野剧变下的多视角一致性对照:腕部预测不是附属品——它既是现代 VLA 的输入刚需,也是「近距接触是否发生」的裁判;多视角联合显著降低腕部引发的不一致(配伍 Table 2 消融)。
Figure 6:π0.5 真机 vs 世界模型(20 次交互)
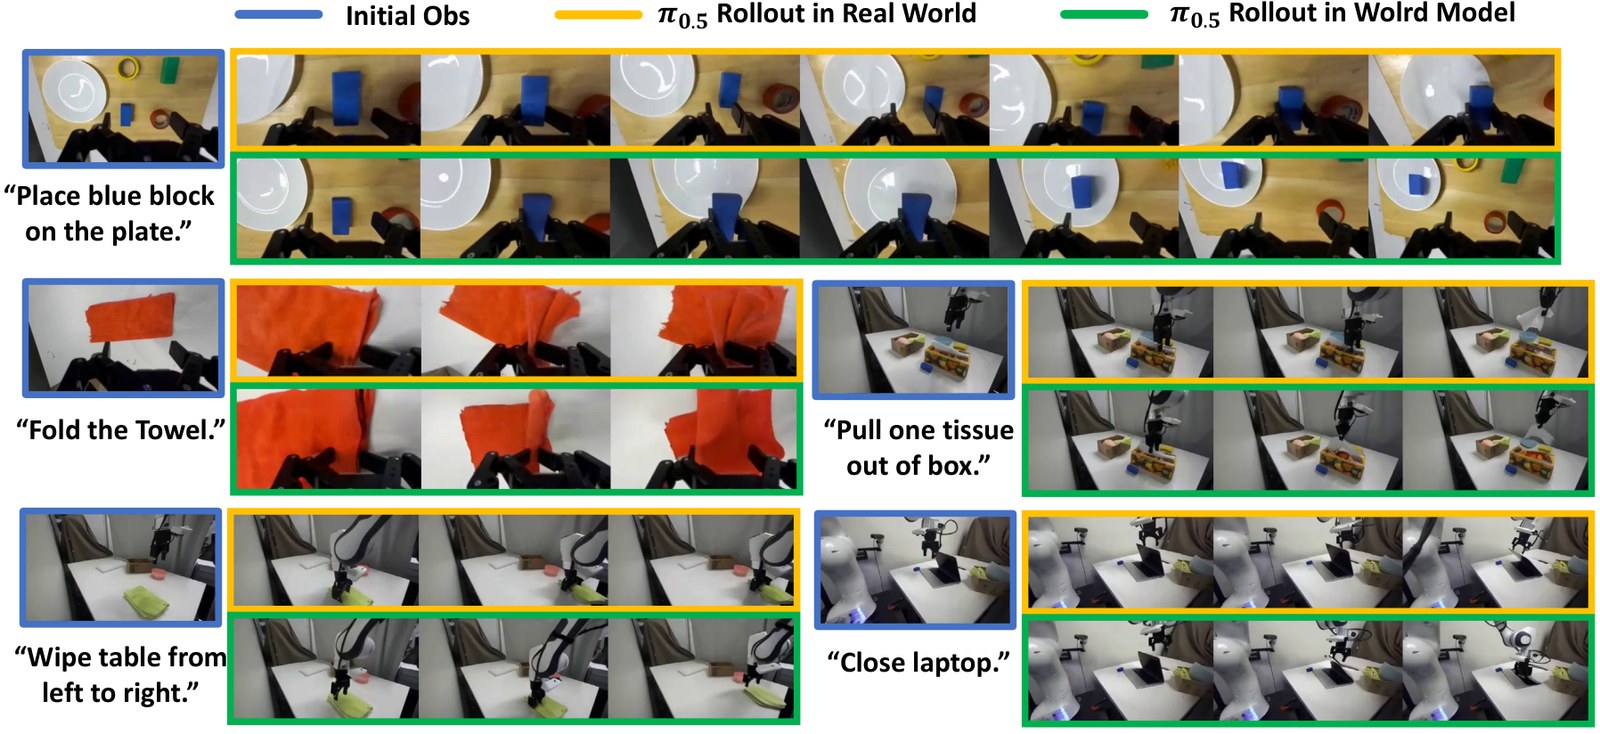
每条轨迹含 π0.5 与环境的 20 次交互,上真机、下世界模型逐段对照——真机成功/失败的行为模式(何时抓偏、指令走到哪一步)在想象里被复刻。这是 Fig. 7 定量相关的定性注脚:不是像素级复刻,是「策略行为级」复刻。
Figure 7:真机-世界模型定量相关
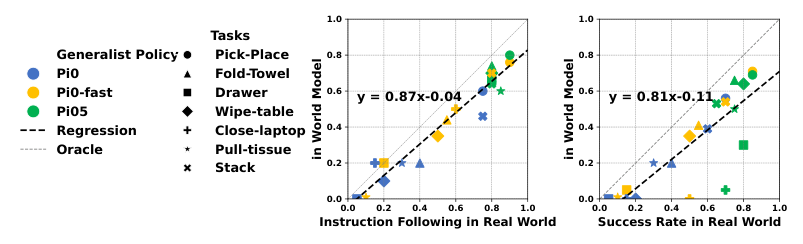
两张散点:指令跟随 y=0.87x−0.04、成功率 y=0.81x−0.11(虚线=oracle);图例 = π0/π0-fast/π0.5 × 7 任务(Pick-Place、Fold-Towel、Drawer、Wipe-table、Close-laptop、Pull-tissue、Stack)。结论一句话:不用真机 rollout 也能给策略正确排名——世界模型评测有效性的核心证据。
Figure 8:后训任务与合成轨迹
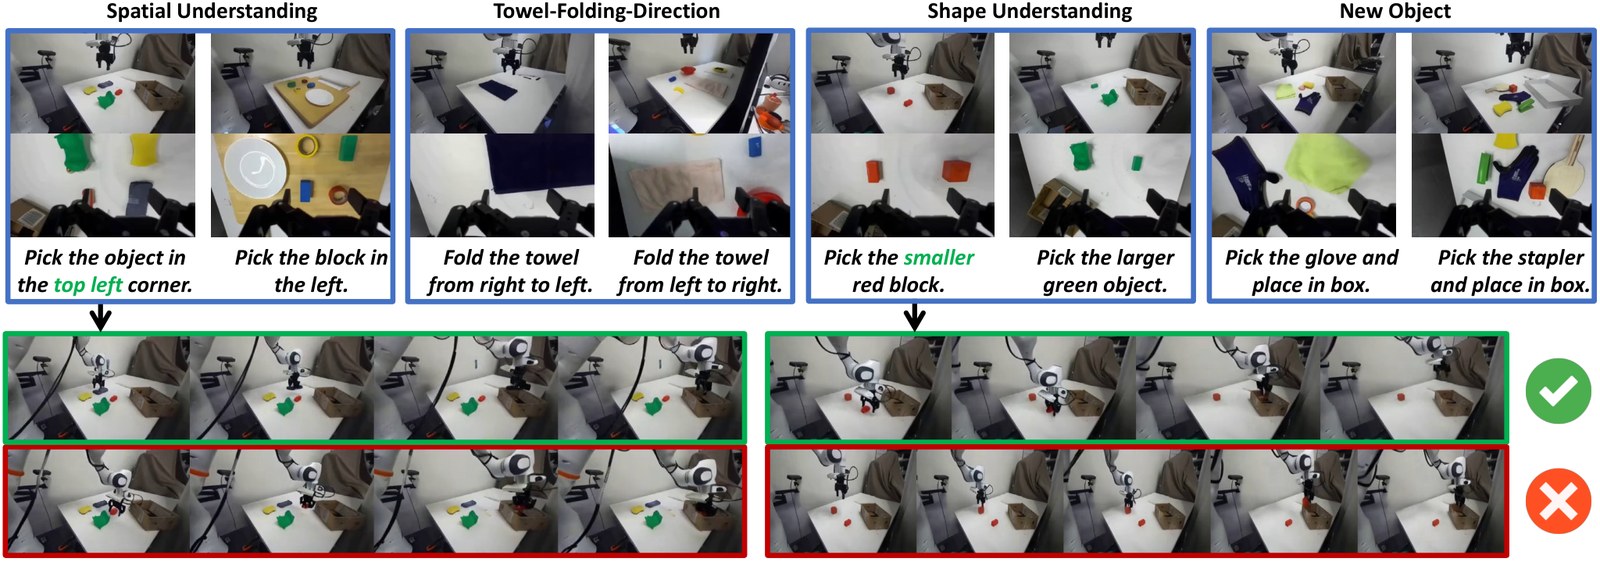
上排:后训任务(新物体/新指令等短板场景);下排:世界模型内生成的合成轨迹。这是「改」的原材料——在想象里把失败任务的成功解法造出来。仓库 README 的两个 GIF(真机 vs 世界模型 20 秒并排)就是这条线的动态版,见第 4 章。
Figure 9:策略改进 +44.7%
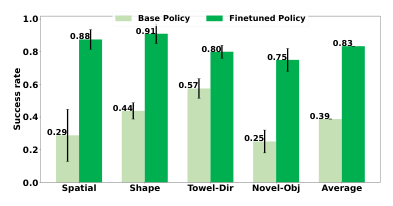
Base vs Finetuned 五组柱:Spatial 0.29→0.88、Shape 0.44→0.93、Towel-Dir 0.57→0.80、Novel-Obj 0.25→0.73、Average 0.39→0.83(+44.7%)。四个维度恰好对应「空间理解、形状理解、方向指令、新物体」四类指令跟随短板——合成数据专打语言接地的软肋(配 Table 4–7 分任务细表)。
🧪 实验详读:质量、可控性、评测、改进四条证据链
先给目录再进细节——论文一共 6 组实验,回答 §5 开头的三问(生成质量?排名可信?能否改进):
| # | 实验 | 协议一句话 | 指标 | 结论一句话 |
|---|---|---|---|---|
| E1 | 世界模型质量(Table 1) | 验证集 256 段×10s,每轮 15 步动作、自回归 10 轮 vs 真值;对照 WPE/IRASim/自家单视角版 | PSNR/SSIM/LPIPS/FID/FVD | 全文版全指标第一(PSNR 23.56、FVD 97.4) |
| E2 | 组件消融(Table 2) | 去记忆 / 去帧级条件 / 去联合预测,分第三人称与腕部两组视角 | 同上五指标 | 腕部最敏感;帧级条件单点影响最大 |
| E3 | 可控性(Fig. 4) | 同初始帧换厘米级动作序列(±2–6cm、±15° 旋转)多组对照 + 注意力可视化 | 轨迹分叉度 / 注意力分布 | 厘米级可控;注意力指回同位姿历史帧 |
| E4 | 长程一致性(Fig. 5) | 腕部视角 10 秒 rollout,绿/红框标「跨视角推断 vs 记忆检索」来源 | 定性 | 两通路共同维持腕部连贯 |
| E5 | 想象中评测(Fig. 6/7 + 附录表) | 自建新 DROID 场景(新相机位姿)× 3 策略(π0/π0-FAST/π0.5 官方权重)× 7 任务 × 每条 20 次交互;真机与想象同初始观测;人工偏好标注成败 | 指令跟随率、成功率 + 相关回归 | IF 相关 0.87、SR 相关 0.81;系统性低估执行 SR(三条差距见 5.3) |
| E6 | 想象中改进(Fig. 8/9) | LLM 改写指令 + 随机重置位姿扩多样;每任务 400 条想象 rollout 人工挑 25–50 成功 → π0.5 SFT 2k 步 | 4 组任务成功率 | 38.7% → 83.4%(+44.7pp),仅对新指令/新物体成立 |
逐任务样例(附录表节选,真机 vs 想象):Pick-Place 上 π0.5 指令跟随 0.90/0.80、成功率 0.85/0.70;π0 为 0.75/0.60、0.70/0.55——排序一致、数值被低估正是回归线 0.87/0.81 的微观形态;Fold-Towel 上 π0.5 0.80/0.75(IF)与 Drawer 全员低分(π0 仅 0.05/0.00)说明难任务上想象里同样难,不是放水。
5.1 世界模型质量(Table 1/2,10 秒长程)
协议:留出 2% 轨迹作验证集,随机 256 段 × 10 秒;每轮给 15 步(1 秒)动作块、自回归 10 轮生成 10 秒,与真值比 PSNR/SSIM/LPIPS/FID/FVD。
| 方法 | PSNR↑ | SSIM↑ | LPIPS↓ | FVD↓ |
|---|---|---|---|---|
| WPE-Single-View | 20.33 | 0.772 | 0.131 | 156.4 |
| IRASim-Single-View | 21.36 | 0.774 | 0.117 | 138.1 |
| Ctrl-World 单视角版 | 21.27 | 0.793 | 0.110 | 127.5 |
| Ctrl-World(全文) | 23.56 | 0.828 | 0.091 | 97.4 |
单视角版已胜出,多视角联合再抬一截——「联合预测本身有益」的定量版。
消融(Table 2):第三人称:去记忆 23.56→23.06,去帧级条件→21.20;腕部:全文 19.18 / 去记忆 18.84 / 去联合预测 15.94 / 去帧级条件 15.69——腕部是三改造的主战场,帧级动作条件是最大单点功臣。
5.2 可控性与一致性(Fig. 4/5 的定量脚注)
- 厘米级:只差 2–6cm 的不同动作序列生成不同轨迹(归因:DROID 密集动作覆盖 + 多视角 + 帧级条件);去记忆→画面变糊(蓝),去位姿条件→控制精度掉(紫);
- 注意力证据:预测 t=4s 帧时强注意 t=0s 同位姿帧——记忆检索不是玄学,是可画出来的注意力边;
- 腕部一致性(Fig. 5):绿框 = 由其他视角推断补全,红框 = 从记忆检索复用——两条通路共同维持腕部视野剧变下的连贯。
5.3 想象中评测(Fig. 6/7 协议细节)
- 零样本新场景:作者自建 DROID 平台、新相机位姿——预训练只用开源 DROID,策略与世界模型双双零样本迁移;
- 三家策略:官方
openpi的 π0-DROID / π0-FAST-DROID / π0.5-DROID;7 任务(Pick-Place、Fold-Towel、Drawer、Wipe-Table、Close-Laptop、Pull-tissue、Stack),每条 20 次交互; - 判定:真机与想象同一初始观测起跑;成功率/指令跟随由人工偏好标注(VLM 当奖励模型留作 future work——诚实声明);
- 结果:指令跟随 y=0.87x−0.04、成功率 y=0.81x−0.11;系统性低估执行成功率——三条已知差距:①复杂物理(碰撞/滑移/旋转,Fig. 6 合盖不精确)②真机「失败后反复重试」行为想象里没复现 ③数据分布外的失败模式缺失——作者预期补策略自身的 rollout 数据能收窄差距。
5.4 想象中改进(Algorithm 1 逐行读)
- 多样性是搜索的前提:策略在同初始条件下高度确定(总抓同一个物体)→ 两种结构化扰动:(i) LLM 改写指令(“place glove in box” → “pick up the cloth and put it inside the box”)、(ii) 随机重置初始位姿(线性插值规划器挪过去);
- 循环:对每任务 i,跑 N 轮 rollout(策略带扰动采样 ε_a)→ 拼历史上下文 h → W 预测 → 轨迹入 τ → 人工偏好判成败 → 成功者进合成集 D_s;
- 微调:$L_\theta = \mathbb{E}_{o_t,a \sim D_s}\|\pi_\theta(o_t, l) - a_{t:t+H}\|^2$——每任务 400 条 rollout,只留 25–50 条人工判定成功,再训 2k 步;
- 成绩(Fig. 9):π0.5 在陌生指令/物体上 38.7% → 83.4%(+44.7pp)——分维:Spatial 0.29→0.88、Shape 0.44→0.91、Towel-Dir 0.57→0.80、Novel-Obj 0.25→0.75、平均 0.39→0.83。改进只对「新指令」成立——作者自陈模型还不够准去提升已见指令的低层成功率(见结论边界)。
🧰 官方 GitHub 详解:4 条跑法 + 训练/后训
仓库:Robert-gyj/Ctrl-World(575★,MIT,ICLR 2026 官方 PyTorch 实现;同时收录 VLAW(arXiv 2602.12063)的世界模型后训管线)。
资产清单(README「CheckPoint and Dataset」表)
| 资产 | 来源 | 大小 |
|---|---|---|
| CLIP text/image encoder | HF openai/clip-vit-base-patch32 | ~600M |
| SVD 视频扩散底座 | HF stabilityai/stable-video-diffusion-img2vid | ~8G |
| Ctrl-World ckpt(DROID 训练) | HF yjguo/Ctrl-World | ~8G |
| DROID 数据集 | HF cadene/droid_1.0.1(95k 轨迹/564 场景) | ~370G |
环境:conda Python 3.11 + requirements.txt;玩 π0.5 进环需另按 openpi 装 JAX 依赖(GIT_LFS_SKIP_SMUDGE=1 uv sync)。
跑法 ① DROID 轨迹回放(合成长视频)
从记录轨迹里采一帧作初始,反复喂 1 秒动作块自回归出完整 rollout:
CUDA_VISIBLE_DEVICES=0 python scripts/rollout_replay_traj.py \
  --dataset_root_path dataset_example --dataset_meta_info_path dataset_meta_info \
  --dataset_names droid_subset --svd_model_path ${svd} --clip_model_path ${clip} \
  --ckpt_path ${ctrlworld_ckpt}
- 配置集中在
config.py的__post_init__; - 速度提示(README 原文):A100 约 10 秒/交互步、H100 约 5 秒——一步=1 秒动作块;
- 本章贴的两组三视角 mp4(
dataset_example/droid_new_setup与..._full/drawer的 val 样本)就是这条管线的产出物形态(第三人称 + 腕部并排)。
跑法 ② 键盘交互(人在环造轨迹)
键盘命令逐条转动作块、自回归顺序执行,可一次输入多键:
... python scripts/rollout_key_board.py ... --task_type keyboard --keyboard lllrrr
合法键:l/r/f/b(左右前后)、u/d(升降)、o/c(开合夹爪)——官网 Interactive Demo 的网页版同款逻辑(见官网,另附 keyboard_first_frame*.png 初始帧素材)。
跑法 ③ π0.5 策略进环(policy-in-the-loop 的字面实现)
从新开 DROID 场景快照出发,让官方 π0.5-DROID 与世界模型闭环互动(两者都零样本迁移);任务类型:pickplace / towel_fold / wipe_table / tissue / close_laptop / stack:
CUDA_VISIBLE_DEVICES=0 XLA_PYTHON_CLIENT_MEM_FRACTION=0.4 \
python scripts/rollout_interact_pi.py ... --task_type pickplace
工程细节:π0.5 是 JAX 实现,XLA_PYTHON_CLIENT_MEM_FRACTION=0.4 防止 JAX 预占满显存——这是把两家生态(PyTorch 世界模型 + JAX 策略)焊在一起的关键垫片。作者声明:只在开源 DROID 上训模型、新场景全零样本;可评指令跟随,但物理交互可能不准。
跑法 ③-New 论文评测协议(20 次/类)
论文口径:每类任务 20 次(5 或 10 个初始条件 × 重复 2 或 4 次),初始条件在 dataset_example/droid_new_setup_full;对应脚本:
... python scripts/rollout_interact_pi_eval.py ... --task_type fold_tower
跑法 ④ 训练:预训练(DROID)与后训(VLAW)
- 潜空间预抽(视频扩散在图像编码器潜空间训练,先抽潜提速):
accelerate launch dataset_example/extract_latent.py ...; - 元信息:
create_meta_info.py生成 json、算状态/动作归一化; - 训练:
accelerate launch scripts/train_wm.py ...(仓库自带小子集droid_subset可先冒烟);论文规模 = 1–2 节点 × 8×A100/H100; - 后训(VLAW,2026-02 新增):接触密集/可变形任务预训练不够准时,按下游任务后训——后训模型支持长程策略进环,README 给出「同一初始条件下真机 20 秒 vs 世界模型 20 秒」的上下行对比 GIF(本章下方内嵌);更多视频见 VLAW 项目页(arXiv 2602.12063)。
仓库结构速记:scripts/(rollout_replay / rollout_key_board / rollout_interact_pi(_eval) / train_wm)+ dataset_example/(数据样例与潜空间工具)+ synthetic_traj/gallery/(README 演示媒体)+ config.py(全局配置)。致谢链:SVD(生成底座)+ openpi(π0.5 策略)。
🎬 演示媒体(GitHub 原样收录)
效果横幅(README 首图)
同一世界模型生成的多场景轨迹拼画廊——README 开篇即挂它,对应论文多视角合成能力。
效果 1:真机 vs 世界模型 · 长程 20 秒并排(后训模型,上下行)
上=真机、下=世界模型,同一初始条件各 rollout 20 秒(VLAW 后训效果,README 官方素材):
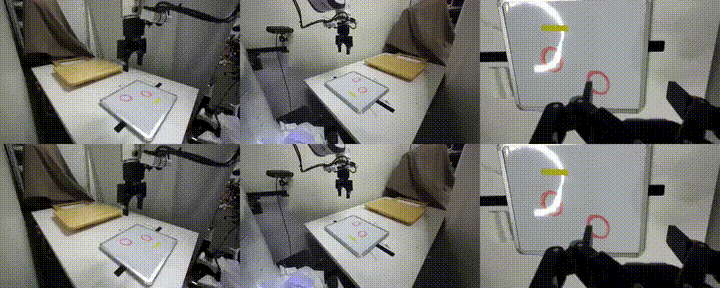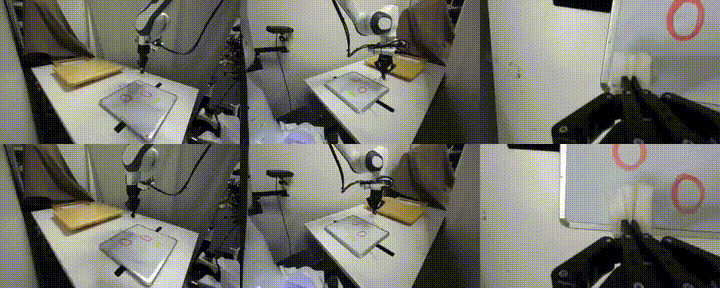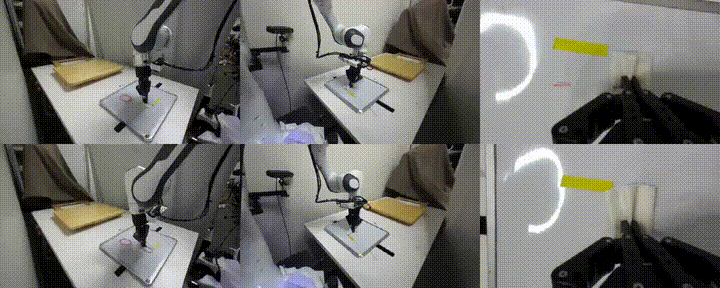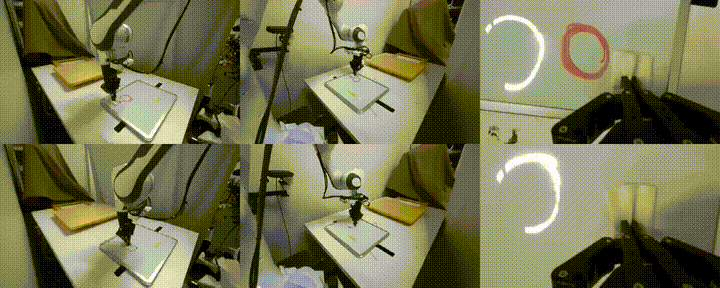
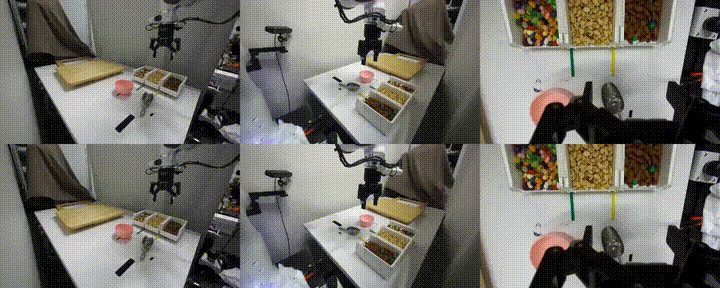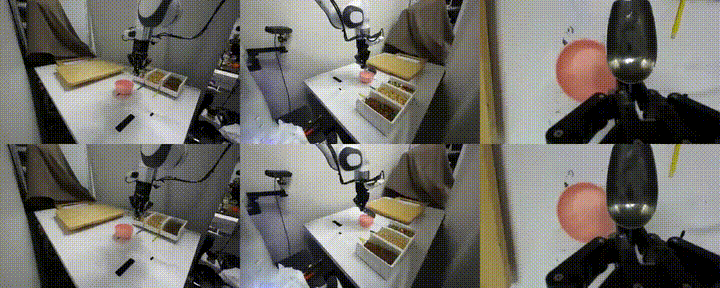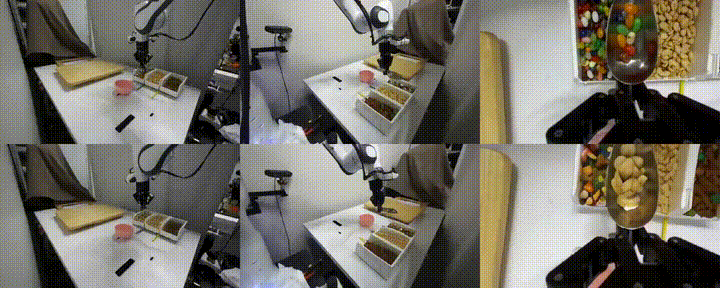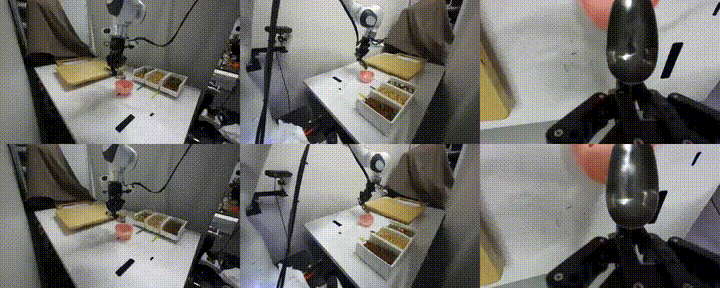
读法:盯住物体被移动的关键帧上下对齐程度——行为级一致(不是像素级克隆),这正是 Fig. 6 定量实验的动态版。
效果 2:DROID 新场景三视角合成轨迹(回放管线产出)
dataset_example/droid_new_setup val 样本(第三人称主视角 / 腕部视角 / 第三视角,各约 2–4 秒):
效果 3:抽屉场景三视角(droid_new_setup_full/drawer)
(仓库 dataset_example/ 内还有 13+ 组同类三视角样本,均为跑法①的产物;官网另有键盘交互与对比视频合集——见 ctrl-world.github.io 的 Interactive demos 与 comparison 区。)
💡 评析:三个亮点,三条边界
三个亮点
- 把「评测」做成了回归线:Fig. 7 的 0.87/0.81 相关是世界模型从「演示玩具」变「评测基础设施」的通行证——排名一致比像素一致更便宜也更有用。
- 改进闭环短且可复现:合成成功轨迹 → SFT → +44.7%,全程不碰专家标注;四类短板(空间/形状/方向/新物体)全部受益——打的是 VLA 的「语言接地软肋」而非重新练操作。
- 开源彻底:官方实现 + ckpt(HF)+ 数据管线 + π0.5 进环脚本 + VLAW 后训——四条跑法把论文实验全部落成命令行。
三条边界
- 物理可信度:README 自陈「物理交互可能不准」——粘吸、穿透类幻觉在多视角下缓解但未根除;测「会不会做」可靠,测「力学是否对」仍需真机;
- 算力门槛不低:全量训练 8×A100/H100 起步,推理一步 5–10 秒——适合评几个关键策略,不适合海量在线评测;
- 世界-策略共同漂移风险:用同一个模型既出题又改卷(合成数据 SFT 后再回模型里验),过拟合到模型偏好的解法需要靠真机终验把关(论文 Fig. 9 有真机验收,应用时别省这步)。
❓ 自测 Q&A
Q1:Ctrl-World 和 MuJoCo/Isaac 这类仿真器差在哪?
仿真器解物理方程(准但难长程好看、要资产),Ctrl-World 是视频扩散生成(好看、能零样本新场景、但物理可能不准)——它是评测/改进的快速回路,不是物理金标准;两者互补(真机终验仍是金标准)。
Q2:为什么腕部视角这么关键?
现代 VLA 输入就含腕部;且腕部视野剧变是长程一致性的最大压力源——腕部预测稳了,「夹爪里到底有没有东西」才有裁判(单视角幻觉的病根)。
Q3:+44.7% 是在想象里测的吗?
不是——改进幅度在真机上验收(Fig. 9/Table 4–7);想象负责「造数据」,真机负责「盖章」。
Q4:想最快上手仓库?
下载 HF yjguo/Ctrl-World ckpt + 仓库自带 droid_subset → 跑法①回放看 mp4 → 跑法②键盘玩交互 → 有 π0.5 环境再上跑法③。
Q6:动作块明明 15 步,为什么模型只喂 5 步?
15 步转笛卡尔位姿后再时间下采样到 5 步(附录 A)——控制窗口仍是完整 1 秒,但序列变稀省显存;细节靠帧级交叉注意把稀疏位姿钉回对应帧,而不是靠密集动作采样。
Q7:记忆检索的「按位姿找」具体怎么实现?
历史帧与未来帧各带一个位姿 token,在空间 Transformer 里做帧级交叉注意力——预测第 4 秒时对第 0 秒同位姿帧的注意力显著拉高(Fig. 4 左侧热图);效果是把预测「锚回」曾见过的相似状态,去记忆后 PSNR/清晰度同步下降(Table 2)。
Q8:适配器只有 2 层 MLP,为什么说是工程关键?
因为官方 π 系策略输出关节速度、世界模型输入笛卡尔位姿——语义不同、坐标系不同;2 层 MLP + Franka FK 把两者焊死,三家官方权重才零改动进环(附录 B 公式链)。没有这条桥,policy-in-the-loop 只能停留在论文示意图。
Q5:和 VLAW 什么关系?
同一作者线:Ctrl-World 是「可控世界模型」本体,VLAW(2602.12063)是「策略与世界模型互相迭代改进」的扩展——官方仓库(3)节的后训就是 VLAW 管线,README 的双行 GIF 即其效果。
📊 图表总索引(9 张论文图 + 9 件 GitHub 媒体)
| 图/媒体 | 内容 | 本站文件 |
|---|---|---|
| Figure 1(头图) | 策略进环总览 | 本文插图 |
| Figure 2 | SVD → 可控世界模型 | 本文插图 |
| Figure 3 | 长程多视角定性对比 | 本文插图 |
| Figure 4 | 厘米级可控性 + 消融 | 本文插图 |
| Figure 5 | 腕部一致性 | 本文插图 |
| Figure 6 | π0.5 真机 vs 想象 20 次交互 | 本文插图 |
| Figure 7 | 真机-世界模型相关回归(0.87/0.81) | 本文插图 |
| Figure 8 | 后训任务 + 合成轨迹 | 本文插图 |
| Figure 9 | 策略改进 +44.7% 柱图 | 本文插图 |
| GitHub 横幅 | README 生成轨迹画廊 | 本文插图 |
| GIF ×2 | 真机 vs 世界模型 20 秒并排 | 本文插图 |
| MP4 ×6 | 两组三视角合成轨迹(视频内嵌) | 第 4 章 <video> 播放器 |
(Table 1–7 与 Algorithm 1 的关键数字已以文字表格复现。)
📚 资源与延伸
- 论文:arXiv 2510.10125(ICLR 2026);官网 ctrl-world.github.io(Interactive demos / comparison 视频)
- 官方代码:github.com/Robert-gyj/Ctrl-World(575★,MIT)· ckpt HF yjguo/Ctrl-World · 数据 HF DROID
- 姊妹工作:VLAW(策略-世界模型互改进)arXiv 2602.12063,后训代码见官方仓库
- 同站相关:具身智能强化学习调研精读(世界模型/评测全景)、OpenWAM-α 精读(另一路 WAM)、π0.7 精读(π 系策略,本文的被测对象家族)、DROID 数据集精读
- 知识铺垫:什么是世界模型、Flow Matching 入门详解