📄 论文信息
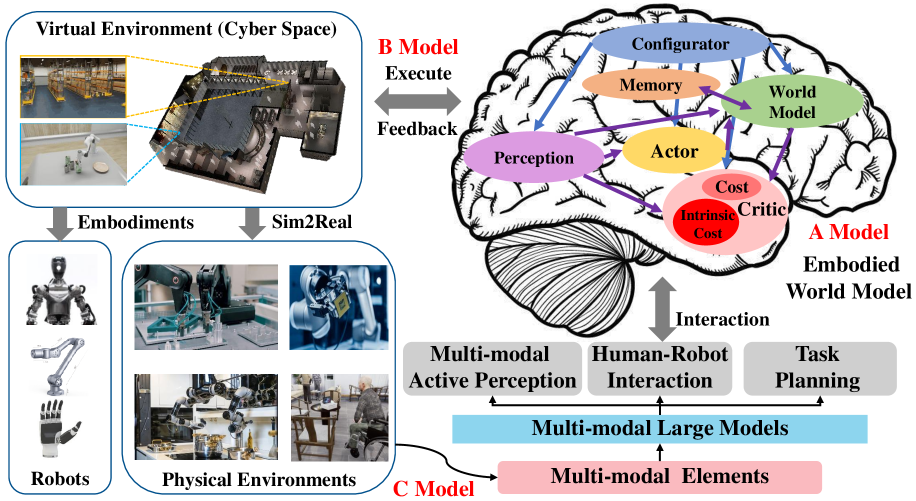
- 标题:Aligning Cyber Space with Physical World: A Comprehensive Survey on Embodied AI(虚实对齐:具身智能全面综述)
- 团队:中山大学、北京大学
- 发表:arXiv:2407.06886, 2024(多次更新至2025)
- 关键词:具身智能、仿真到真实迁移、多模态大模型、世界模型、虚拟-物理对齐
- 一句话总结:从虚实对齐的视角全面综述具身智能,系统分析了感知、交互、智能体和Sim2Real迁移四大研究方向。
- 论文链接:arXiv:2407.06886
🤔 为什么需要这篇综述?
具身智能(Embodied AI)对于实现通用人工智能(AGI)至关重要,它是连接网络空间与物理世界的基础。近年来,多模态大模型(MLMs)和世界模型(WMs)的出现引起了广泛关注,因为它们具有卓越的感知、交互和推理能力,为具身智能体提供了有前景的架构。
然而,具身智能研究面临着一个核心挑战:如何弥合仿真环境与真实世界之间的差距?仿真环境提供了可控、高保真的训练和评估平台,但真实世界的复杂性和不确定性使得直接迁移变得困难。这种"虚实对齐"问题贯穿于具身智能的各个方面,从感知到交互,从智能体设计到Sim2Real迁移。
本综述的独特之处在于,它从"虚实对齐"的视角出发,系统性地分析了具身智能的研究进展。作者不仅关注仿真器和真实机器人,还深入探讨了多模态大模型在虚拟和现实环境中的应用,为理解具身智能的技术全景提供了全新框架。
📚 综述覆盖范围
第一部分:具身机器人与仿真器
综述首先介绍了具身智能的硬件基础——具身机器人和仿真器:
具身机器人:涵盖了多种形态的机器人,包括:
- 人形机器人:如Tesla Optimus、Figure 01等,具有类人形态,适用于与人类环境交互
- 四足机器人:如Spot、AnyMal等,具有良好的地形适应能力
- 机械臂:如Franka Emika、UR系列等,专注于操作任务
- 无人机:适用于空中任务和探索
仿真器:为具身智能研究提供了可控的实验平台:
- 物理仿真:MuJoCo、PyBullet、Isaac Gym等,提供精确的物理模拟
- 环境仿真:Habitat、AI2-THOR等,构建逼真的虚拟环境
- 多智能体仿真:PettingZoo、Melting Pot等,支持多智能体交互
第二部分:具身感知
具身感知是智能体获取环境信息的关键途径。综述将其分为多个子方向:
视觉感知:
- 目标检测与分割:从传统的CNN方法到基于Transformer的检测器
- 场景理解:深度估计、语义分割、3D重建
- 视觉定位:视觉语言导航(VLN)、视觉目标定位(Visual Grounding)
触觉感知:
- 材质识别:通过触觉信号识别物体材质
- 力控制:在操作任务中实现精确的力控制
- 触觉-视觉融合:结合触觉和视觉信息提升感知能力
多模态感知:
- 视觉-语言对齐:CLIP、BLIP-2等模型实现视觉和语言的对齐
- 跨模态融合:将不同模态的信息进行有效融合
- 主动感知:智能体主动选择感知策略以获取关键信息
第三部分:具身交互
具身交互是智能体与环境进行有效互动的能力:
操作交互:
- 抓取:从简单的平行抓取到复杂的多指灵巧操作
- 工具使用:智能体学习使用工具完成复杂任务
- 操作策略学习:从演示中学习操作策略
导航交互:
- 点到点导航:在已知或未知环境中导航
- 视觉语言导航:根据自然语言指令在环境中导航
- 探索与建图:同时定位与建图(SLAM)
人机交互:
- 语言条件化:根据语言指令执行任务
- 社交导航:在有人环境中安全导航
- 协作任务:与人类协作完成复杂任务
第四部分:具身智能体
具身智能体是能够自主感知、决策和行动的系统:
基于大语言模型的智能体:
- 任务规划:利用LLM进行高层任务分解
- 推理能力:思维链(CoT)、思维树(ToT)等推理方法
- 常识利用:利用LLM中的常识知识指导行动
基于视觉-语言模型的智能体:
- 视觉理解:理解视觉输入并做出决策
- 多模态推理:结合视觉和语言进行推理
- 动作生成:直接从感知生成动作
世界模型:
- 内部表示:构建环境的内部表示
- 预测规划:基于预测进行规划
- 想象与推理:在想象空间中进行推理
第五部分:Sim2Real迁移
Sim2Real迁移是将仿真中学到的知识迁移到真实世界的关键技术:
域随机化:
- 视觉域随机化:随机化视觉外观以提高泛化能力
- 动力学域随机化:随机化物理参数以提高鲁棒性
- 课程学习:逐步增加域随机化的程度
域适应:
- 对抗训练:使用对抗训练缩小域差距
- 自监督学习:利用无标签数据进行适应
- 元学习:快速适应新环境
策略迁移:
- 模仿学习:从真实数据中学习策略
- 强化学习:在仿真中训练并在真实世界中微调
- 混合训练:结合仿真和真实数据进行训练
🗺️ 技术路线图
本综述提出了一个清晰的具身智能分类体系:
具身智能
├── 具身机器人与仿真器
│   ├── 机器人形态
│   │   ├── 人形机器人
│   │   ├── 四足机器人
│   │   ├── 机械臂
│   │   └── 无人机
│   └── 仿真平台
│       ├── 物理仿真
│       ├── 环境仿真
│       └── 多智能体仿真
├── 具身感知
│   ├── 视觉感知
│   │   ├── 目标检测
│   │   ├── 场景理解
│   │   └── 视觉定位
│   ├── 触觉感知
│   │   ├── 材质识别
│   │   └── 力控制
│   └── 多模态感知
│       ├── 视觉-语言对齐
│       ├── 跨模态融合
│       └── 主动感知
├── 具身交互
│   ├── 操作交互
│   │   ├── 抓取
│   │   ├── 工具使用
│   │   └── 操作策略
│   ├── 导航交互
│   │   ├── 点到点导航
│   │   ├── 视觉语言导航
│   │   └── 探索与建图
│   └── 人机交互
│       ├── 语言条件化
│       ├── 社交导航
│       └── 协作任务
├── 具身智能体
│   ├── LLM智能体
│   │   ├── 任务规划
│   │   ├── 推理能力
│   │   └── 常识利用
│   ├── VLM智能体
│   │   ├── 视觉理解
│   │   ├── 多模态推理
│   │   └── 动作生成
│   └── 世界模型
│       ├── 内部表示
│       ├── 预测规划
│       └── 想象与推理
└── Sim2Real迁移
    ├── 域随机化
    │   ├── 视觉域随机化
    │   ├── 动力学域随机化
    │   └── 课程学习
    ├── 域适应
    │   ├── 对抗训练
    │   ├── 自监督学习
    │   └── 元学习
    └── 策略迁移
        ├── 模仿学习
        ├── 强化学习
        └── 混合训练
这一体系的核心洞察是:具身智能是连接网络空间与物理世界的桥梁。仿真环境提供了可控的实验平台,但最终目标是在真实世界中部署智能体。因此,Sim2Real迁移是贯穿整个领域的关键技术。
🔍 个人思考
综述的亮点
1. 独特的虚实对齐视角:与现有综述不同,本工作从"虚实对齐"的视角出发,将仿真环境与真实世界的对齐作为核心问题。这种视角更贴近实际应用需求,因为Sim2Real迁移是具身智能落地的关键瓶颈。
2. 全面的多模态大模型分析:综述深入探讨了多模态大模型(MLMs)在具身智能中的应用,包括LLM智能体、VLM智能体和世界模型。这反映了该领域的最新发展趋势。
3. 丰富的资源汇总:综述详细总结了各种仿真器、数据集和基准测试,为研究者提供了宝贵的资源目录。
不足之处
1. Sim2Real迁移的深度不足:虽然综述将Sim2Real迁移作为重要主题,但对该技术的深入分析相对有限。例如,不同迁移方法的优劣对比、实际部署中的挑战讨论不够充分。
2. 实际应用案例的缺失:综述主要进行技术梳理,缺乏对实际应用案例的深入分析。例如,在自动驾驶、医疗机器人等领域的应用讨论不够具体。
3. 定量分析的缺乏:综述主要进行定性分析,缺乏对各方法性能、效率等指标的定量比较,这在一定程度上限制了其实用价值。
对领域的启发
本综述揭示了具身智能发展的几个关键趋势:
多模态大模型的核心地位:LLM、VLM和世界模型正在成为具身智能的核心组件,它们提供了强大的感知、推理和规划能力。
仿真到真实的迁移挑战:Sim2Real迁移仍然是主要瓶颈,需要新的技术方案来缩小域差距。
虚实融合的必要性:未来的具身智能系统需要同时在仿真和真实环境中训练和部署,这需要新的框架和工具。
从单一到多元:具身智能正在从单一任务、单一环境向多任务、多环境扩展,这需要更强的泛化能力。
📖 延伸阅读
Sim-to-Real Robot Learning from Pixels: A Progressive Survey(Zhao et al., 2020)- 系统综述了从像素到机器人的Sim-to-Real学习方法
Sim2Real in Robotics: A Survey of Current Progress and Future Directions(Gao et al., 2023)- 全面分析了Sim2Real迁移的技术进展和未来方向
World Models for Autonomous Driving: A Survey(Hu et al., 2024)- 专门针对自动驾驶场景的世界模型综述