📄 论文信息
- 标题:DiffusionDrive: Real-Time End-to-End Multimodal Trajectory Planning for Autonomous Driving(实时端到端多模态轨迹规划)
- 团队:华中科技大学 × 理想汽车(Li Auto)
- 关键词:扩散模型、条件去噪、多模态轨迹、端到端规划、轨迹初始化
- 一句话总结:把轨迹规划重新定义成一个条件去噪过程,从噪声出发逐步"雕刻"出多条合理轨迹,用轨迹初始化先验和少步采样让扩散真正跑在车端,是生成式端到端驾驶的代表作。
🤔 要解决什么问题?为什么轨迹规划需要多模态?
绝大多数端到端规划器都采用确定性回归:网络直接输出一条未来轨迹(一串 waypoints)。这条路线简洁高效,却有一个被长期忽视的软肋——轨迹分布本质上是多模态的。
考虑这样一个场景:前方有静止障碍物,左车道空、右车道也空。 此时合理选择至少有两种——向左变道、向右变道,甚至减速跟停也是合法选项。如果用 L2 回归去拟合人类轨迹,网络会把所有训练样本"平均"起来,结果往往是输出一条压着障碍物正中间走的轨迹。这就是经典的 mode averaging(模态平均) 问题——平均化的轨迹比任何一个合理选择都更危险。
确定性规划的三类典型困境:
| 困境 | 表现 | 后果 |
|---|---|---|
| mode averaging | 多条合理轨迹被回归平均 | 输出落在"无人区",甚至压障碍物 |
| 单点估计 | 只给一条轨迹,无备选 | 遇到执行偏差没有回旋余地 |
| 难以表达意图 | 不敢变道还是准备变道? | 行为预测、交互建模无从展开 |
工业界传统方案(如 EM Planner)其实早就意识到这点——它们显式生成多条候选,再用代价函数挑最优。但端到端回归头丢了这种能力。多候选打分路线(先输出 $K$ 条锚定轨迹再打分)虽然恢复了多选,可候选集是固定锚点,覆盖范围有限,难以生成场景相关的多样化轨迹。
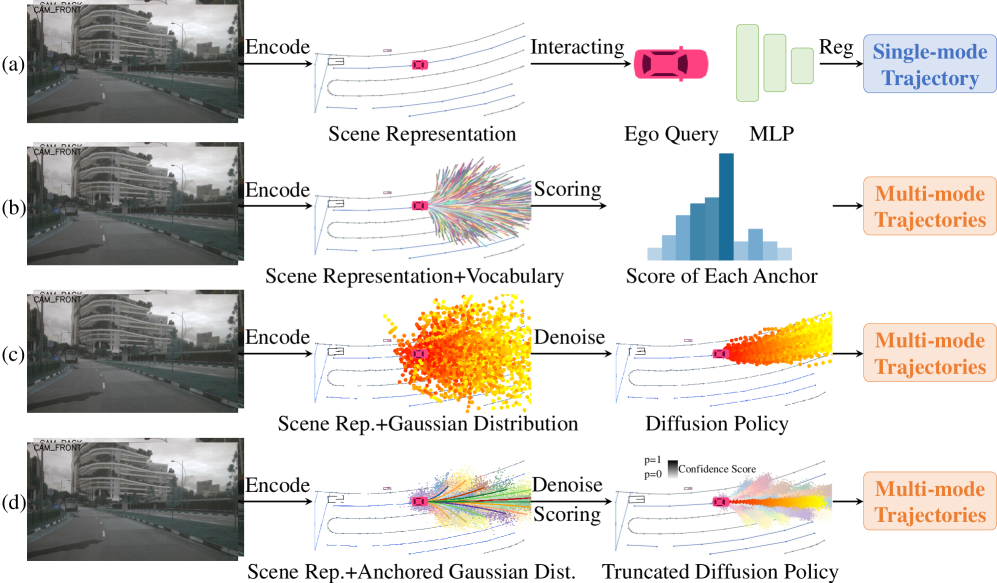
DiffusionDrive 的核心判断:与其用回归硬挤出一个"平均答案",不如直接建模轨迹的整个分布,让模型学会"在这种情况下,有哪些合理走法"。这正是生成式模型(扩散、Flow Matching)的强项。
💡 核心思想:把轨迹规划变成"条件去噪"
扩散模型做轨迹生成的直觉
扩散模型在图像生成里大放异彩,它的本质是两个过程:
- 前向过程:把一条干净轨迹 $x_0$ 逐步加高斯噪声,直到变成纯噪声 $x_T \sim \mathcal{N}(0, I)$
- 反向过程:训练一个网络 $\epsilon_\theta$,学会从噪声一步步去噪,还原出合理轨迹
把这个范式搬到轨迹规划上,直觉非常优雅:从一团随机噪声出发,像雕刻一样一点点把噪声去掉,最后"显形"出一条平滑合理的驾驶轨迹。 关键在于,由于去噪是一个随机过程,采样多次会得到不同的合理轨迹——多模态因此天然成立。
前向加噪可以写成闭式:
$$q(x_t \mid x_0) = \mathcal{N}\left(x_t;\ \sqrt{\bar{\alpha}_t}\, x_0,\ (1-\bar{\alpha}_t) I\right)$$反向去噪则训练网络预测每一步加入的噪声:
$$\mathcal{L}_{\text{diff}} = \mathbb{E}_{x_0,\, t,\, \epsilon}\left[\big\|\, \epsilon - \epsilon_\theta(x_t, t, \mathbf{c})\,\big\|^2\right]$$条件扩散:以场景上下文为"指挥棒"
裸扩散只能生成"看起来像轨迹"的东西,但规划要的是在当前场景下合理的轨迹。因此 DiffusionDrive 采用条件扩散:在去噪网络里注入场景条件 $\mathbf{c}$。
条件 $\mathbf{c}$ 通常包含:
- 自车状态:位姿、速度、加速度、历史轨迹
- 周围智能体:从他车检测/跟踪得到的动态目标特征
- 在线地图:车道线、可行驶区域、道路边界等矢量要素
- 导航意图:全局路由给的"该往哪走"的提示
注入方式一般是通过 cross-attention(交叉注意力) 或 MLP 拼接,让去噪网络在"雕刻"轨迹的每一步都能"看到"当前场景——这就把一个无条件的"画轨迹"任务,变成了一个听从场景指挥的条件生成任务。
🏗️ 模型架构:稀疏感知 + 条件扩散规划头
DiffusionDrive 的整体数据流可以概括为"稀疏感知理解场景,扩散头生成轨迹":
多相机图像 ➜ 稀疏感知编码器(检测智能体 + 在线建图)➜ 场景条件特征 $\mathbf{c}$ ➜ 条件扩散规划头(含噪声轨迹 $x_t$ + 时间步 $t$)➜ 多模态轨迹分布
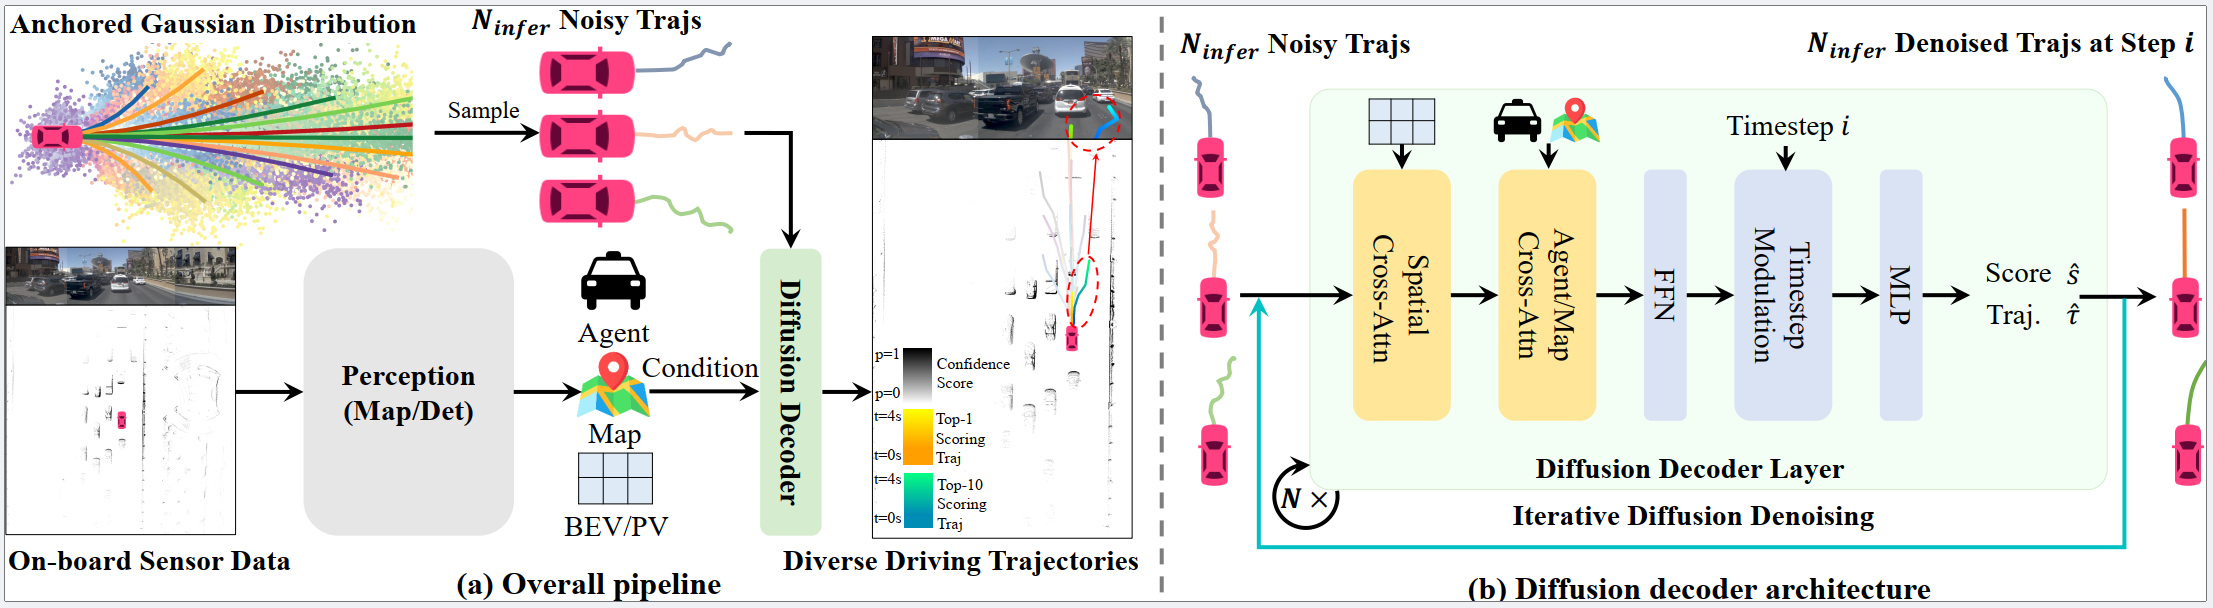
稀疏感知骨干
它沿用了一条全稀疏的感知路线:不构造密集 BEV 栅格,而是用一组 query 直接检出周围智能体和矢量地图元素。这种设计算力开销小、特征紧凑,非常适合作为扩散头的条件源——把动辄上百万像素的密集特征压缩成几百维的结构化表示。
关键创新:截断扩散策略(Truncated Diffusion Policy)+ 轨迹初始化
这是 DiffusionDrive 最精彩的一笔,也是它能实时运行的命门。核心思想可拆成两步:先把起点聚到合理位置(轨迹初始化),再把扩散调度截断(截断扩散)。
问题:标准扩散从纯高斯噪声 $\mathcal{N}(0, I)$ 起步。但真实驾驶轨迹是平滑、有界、强结构化的(几十米范围内、曲率受限、速度连续),和高斯噪声的分布差距极大。弥合这个差距需要很多步去噪(几十到上百步),对车端 10Hz+ 的实时性是灾难。
DiffusionDrive 的解法:不要从纯噪声起步,而是从一个结构化的轨迹先验起步。具体做法是:
- 在训练集上把人类轨迹聚类成一组锚定原型轨迹(anchor trajectories / 基底轨迹)
- 推理时先从锚定集合里采样一个"粗略合理的起点"
- 再用少量去噪步在这个起点上做残差式精修
这本质上是把扩散从"噪声 ➜ 数据"压缩成了"粗轨迹 ➜ 平滑轨迹",起点已经落在噪声轨迹附近,自然只需极少步数就能收敛。形象地说:标准扩散是从一团乱流捏车,而 DiffusionDrive 是从一个"半成品的车型"开始精修——后者当然快得多。
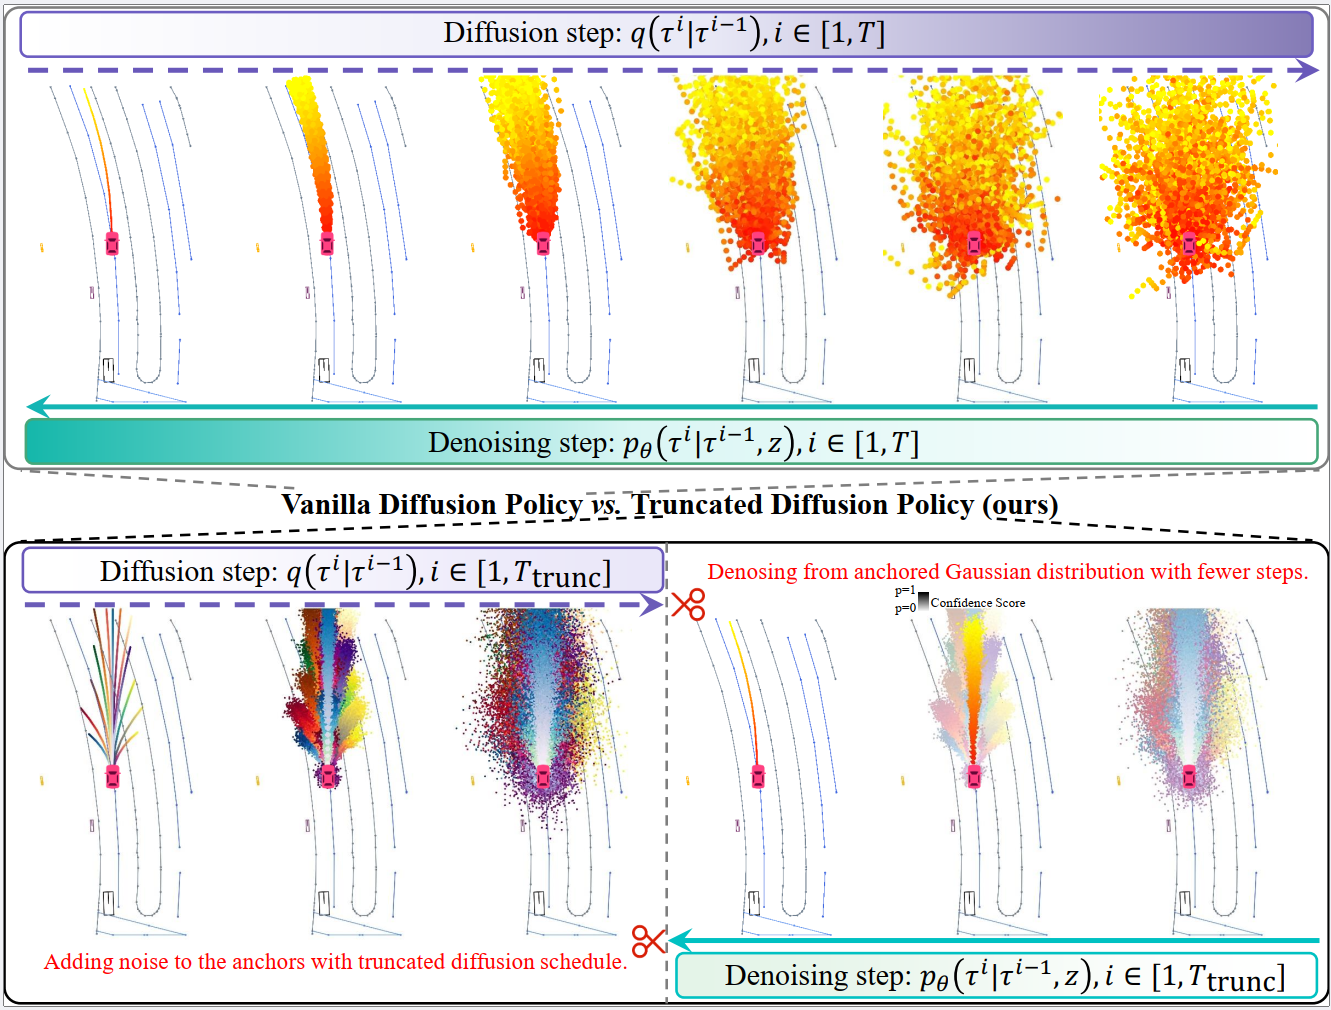
论文训练时就采用截断调度:用 K-Means 在训练集上聚类出 $N_{\text{anchor}}$ 条锚定轨迹 $\mathbf{a}_k$,向它们加噪生成 $\tau_k^i=\sqrt{\bar{\alpha}^i}\,\mathbf{a}_k+\sqrt{1-\bar{\alpha}^i}\,\epsilon$,只遍历 $i\in[1,T_{\text{trunc}}]$($T_{\text{trunc}}\ll T$)。扩散解码器对这些噪声轨迹预测"去噪轨迹 + 分类分数",训练目标同时包含轨迹重建(L1)与正负样本的二分类:
$$\mathcal{L}=\sum_{k=1}^{N_{\text{anchor}}}\big[\,y_k\,\mathcal{L}_{\text{rec}}(\hat{\tau}_k,\tau_{\text{gt}})+\lambda\,\text{BCE}(\hat{s}_k,y_k)\,\big]$$其中离真值轨迹最近的锚点对应的噪声轨迹为正样本($y_k=1$),其余为负样本。
推理时则从锚定高斯分布采样 $N_{\text{infer}}$ 条噪声轨迹起步,用 DDIM 规则逐时间步去噪;并且 $N_{\text{infer}}$ 与训练时的 $N_{\text{anchor}}$ 解耦,可以按算力与实时性需求动态调整——这是它能在"少步数 + 多候选"之间自由伸缩的关键工程特性。
| 设计 | 起点分布 | 所需步数 | 多样性来源 |
|---|---|---|---|
| 标准扩散 | 纯高斯噪声 | 几十~上百步 | 噪声随机性 |
| DiffusionDrive | 锚定轨迹先验 | 2~少数步 | 锚点选择 + 噪声 |
多步多迭代采样
为了让输出既多样又安全,DiffusionDrive 采用多步、多迭代的采样策略:并行采样多条候选轨迹,再结合下游的代价评估(碰撞、舒适、合规)挑选最优的一条下发控制。这其实和传统规划"生成候选 ➜ 打分 ➜ 选优"的范式在精神上是一致的,只是候选生成方式从规则采样换成了学习到的扩散分布。
推理流程:从锚定高斯分布采样 $N_{\text{infer}}$ 条带噪轨迹 → 扩散解码器逐步去噪并同时输出每条轨迹的二分类分数 → DDIM 更新到下一时间步 → 最终按分数挑出 top-1 作为下发轨迹、**top-K 作为一个"行为候选池"**供后续安全校验。
🆚 Flow Matching vs DDPM:轨迹生成用哪个?
扩散(DDPM)并非连续分布生成的唯一选择,Flow Matching 近两年正快速崛起(详见本博客《Flow Matching 入门详解》)。两者都能建模多模态轨迹分布,但哲学不同。
| 维度 | DDPM(扩散) | Flow Matching(流匹配) |
|---|---|---|
| 前向路径 | 弯曲(非线性噪声调度) | 直线(线性插值 $x_t=(1-t)x_0+t x_1$) |
| 底层方程 | SDE(含随机项) | ODE(确定性) |
| 采样步数 | 较多(需技巧加速) | 几步即可 |
| 训练目标 | 预测噪声 $\epsilon$ | 预测速度场 $v$(目标 $x_1-x_0$) |
| 训练稳定性 | 对噪声调度敏感 | 通常更平滑 |
| 理论关系 | Flow Matching 的一个特例 | 更一般的框架 |
Flow Matching 的训练目标是让网络学会一个"恒定速度"$u = x_1 - x_0$:
$$\mathcal{L}_{\text{FM}} = \mathbb{E}\left[\big\|\, v_\theta(x_t, t, \mathbf{c}) - (x_1 - x_0)\,\big\|^2\right]$$由于路径接近直线,推理时用少量欧拉步积分就能从噪声"流"到数据,天生适合实时。
DiffusionDrive 为什么选 DDPM 而不是 Flow Matching? 一个合理推测是:扩散生态更成熟、可调技巧多(如一致性蒸馏、DDIM),且论文的轨迹初始化先把"起点拉到数据附近",恰恰抵消了扩散"路径弯、步数多"的主要劣势——一旦起点不再远,扩散和 Flow Matching 的速度差距就被抹平了。这也是我认为后续工作完全可能用 Flow Matching 替换 DDPM 头的原因:轨迹初始化这一招对两者都成立。
🧪 训练策略与 loss 设计
数据来源
DiffusionDrive 的训练数据主要来自大规模人类驾驶数据集:
- nuPlan / OpenScene:当前最主流的闭环/开环规划 benchmark,提供海量带轨迹标注的真实驾驶片段
- 训练时以人类驾驶轨迹作为 $x_0$(扩散的"干净样本"),场景上下文作为条件 $\mathbf{c}$
loss 组合
训练目标是多 loss 联合,既有生成式损失,也有安全约束:
| loss | 作用 | 说明 |
|---|---|---|
| 扩散去噪 loss $\mathcal{L}_{\text{diff}}$ | 主目标 | 让网络学会在场景条件下逐步去噪 |
| 碰撞 loss | 安全兜底 | 惩罚与占用/障碍物重叠的轨迹 |
| 边界 loss | 合规 | 约束轨迹不越出可行驶区域 |
| 舒适 loss | 平顺 | 限制过大的加速度/急动度(jerk) |
一个重要的工程经验是:不能只靠扩散 loss。纯生成目标只关心"分布像不像人类轨迹",但驾驶是安全攸关任务,必须把碰撞、合规等硬约束作为辅助 loss 显式注入,才能避免模型偶尔采样出"分布内但不安全"的轨迹。这和 UniAD 把碰撞 loss 写进规划头是同一个道理——越是生成式、概率性的系统,越需要确定性安全网兜着。
⚡ 推理加速:让扩散真正跑上车
扩散模型上车最大的拦路虎是延迟。DiffusionDrive 用了几个组合拳把它压到实时:
- 轨迹初始化(见上文):把起点从纯噪声拉到数据附近,采样步数从几十步骤降到 2 步量级,这是最关键的提速。
- 缓存矩阵(Cached Matrix):去噪过程中,场景条件 $\mathbf{c}$ 是不变的,只有噪声轨迹 $x_t$ 和时间步 $t$ 在变。因此可以把"场景与轨迹交互"的部分预先算好并缓存,避免每个去噪步都重算注意力,大幅省算力。
- 少步采样:配合 DDIM 等加速采样器,进一步压缩去噪步数。
一致性模型:潜在的进一步加速
除了上述工程技巧,学术界还有一类一致性模型(Consistency Model)思路:把多步去噪蒸馏成一步映射,即"噪声 ➜ 轨迹"一跃而成。这类方法在图像生成里已验证可行,迁移到轨迹规划上,有望把扩散头压到接近单次回归的延迟。DiffusionDrive 的轨迹初始化其实已经隐含了一步生成的影子——当起点足够好时,一两步去噪等价于一个"残差精修",和一致性蒸馏的精神相通。这指明了后续工作的一个清晰方向。
⚔️ 与传统优化规划(EM Planner)的对比
传统工业界规划(如百度 Apollo 的 EM Planner)走的是优化路线:在 Frenet 坐标下生成大量候选,用代价函数(碰撞、舒适、合规、效率)打分,再用动态规划 + 二次规划求解最优。DiffusionDrive 走的是学习式生成路线。两者本质不同:
| 维度 | EM Planner(优化) | DiffusionDrive(生成) |
|---|---|---|
| 候选来源 | 规则采样(固定模板) | 学习到的轨迹分布 |
| 多样性 | 受模板覆盖限制 | 天然多模态、场景自适应 |
| 代价函数 | 人工设计、显式可调 | 隐式编码在训练数据里 |
| 可解释/可调 | 强(每项代价可审计) | 弱(黑盒分布) |
| 数据依赖 | 低(靠规则) | 高(靠人类驾驶数据) |
| 长尾泛化 | 受规则覆盖度限制 | 受数据覆盖度限制 |
| 实时性 | 强(QP 求解快) | 需加速技巧才能达标 |
一个值得玩味的观察:DiffusionDrive 的"采样多条 ➜ 打分选优“其实和 EM Planner 的”生成候选 ➜ 代价函数选优“在流程上惊人地相似——差别只在于候选是用规则生成还是用学习到的分布生成。这暗示两条路线并非对立,而是可以融合:用扩散头生成更聪明的候选,再用可解释的代价函数做最终裁决,既拿到生成式的多样性,又保留优化的可审计性。
📊 在 NAVSIM / nuPlan 上的性能
DiffusionDrive 主要在 NAVSIM 上评测。NAVSIM 采用 PDMS(Predictive Driver Model Score) 作为核心指标,它由多个子分(如碰撞率、可驾驶区域合规、舒适度、方向正确性等)加权而成,比单纯的 L2 误差更贴近"开得好不好”。
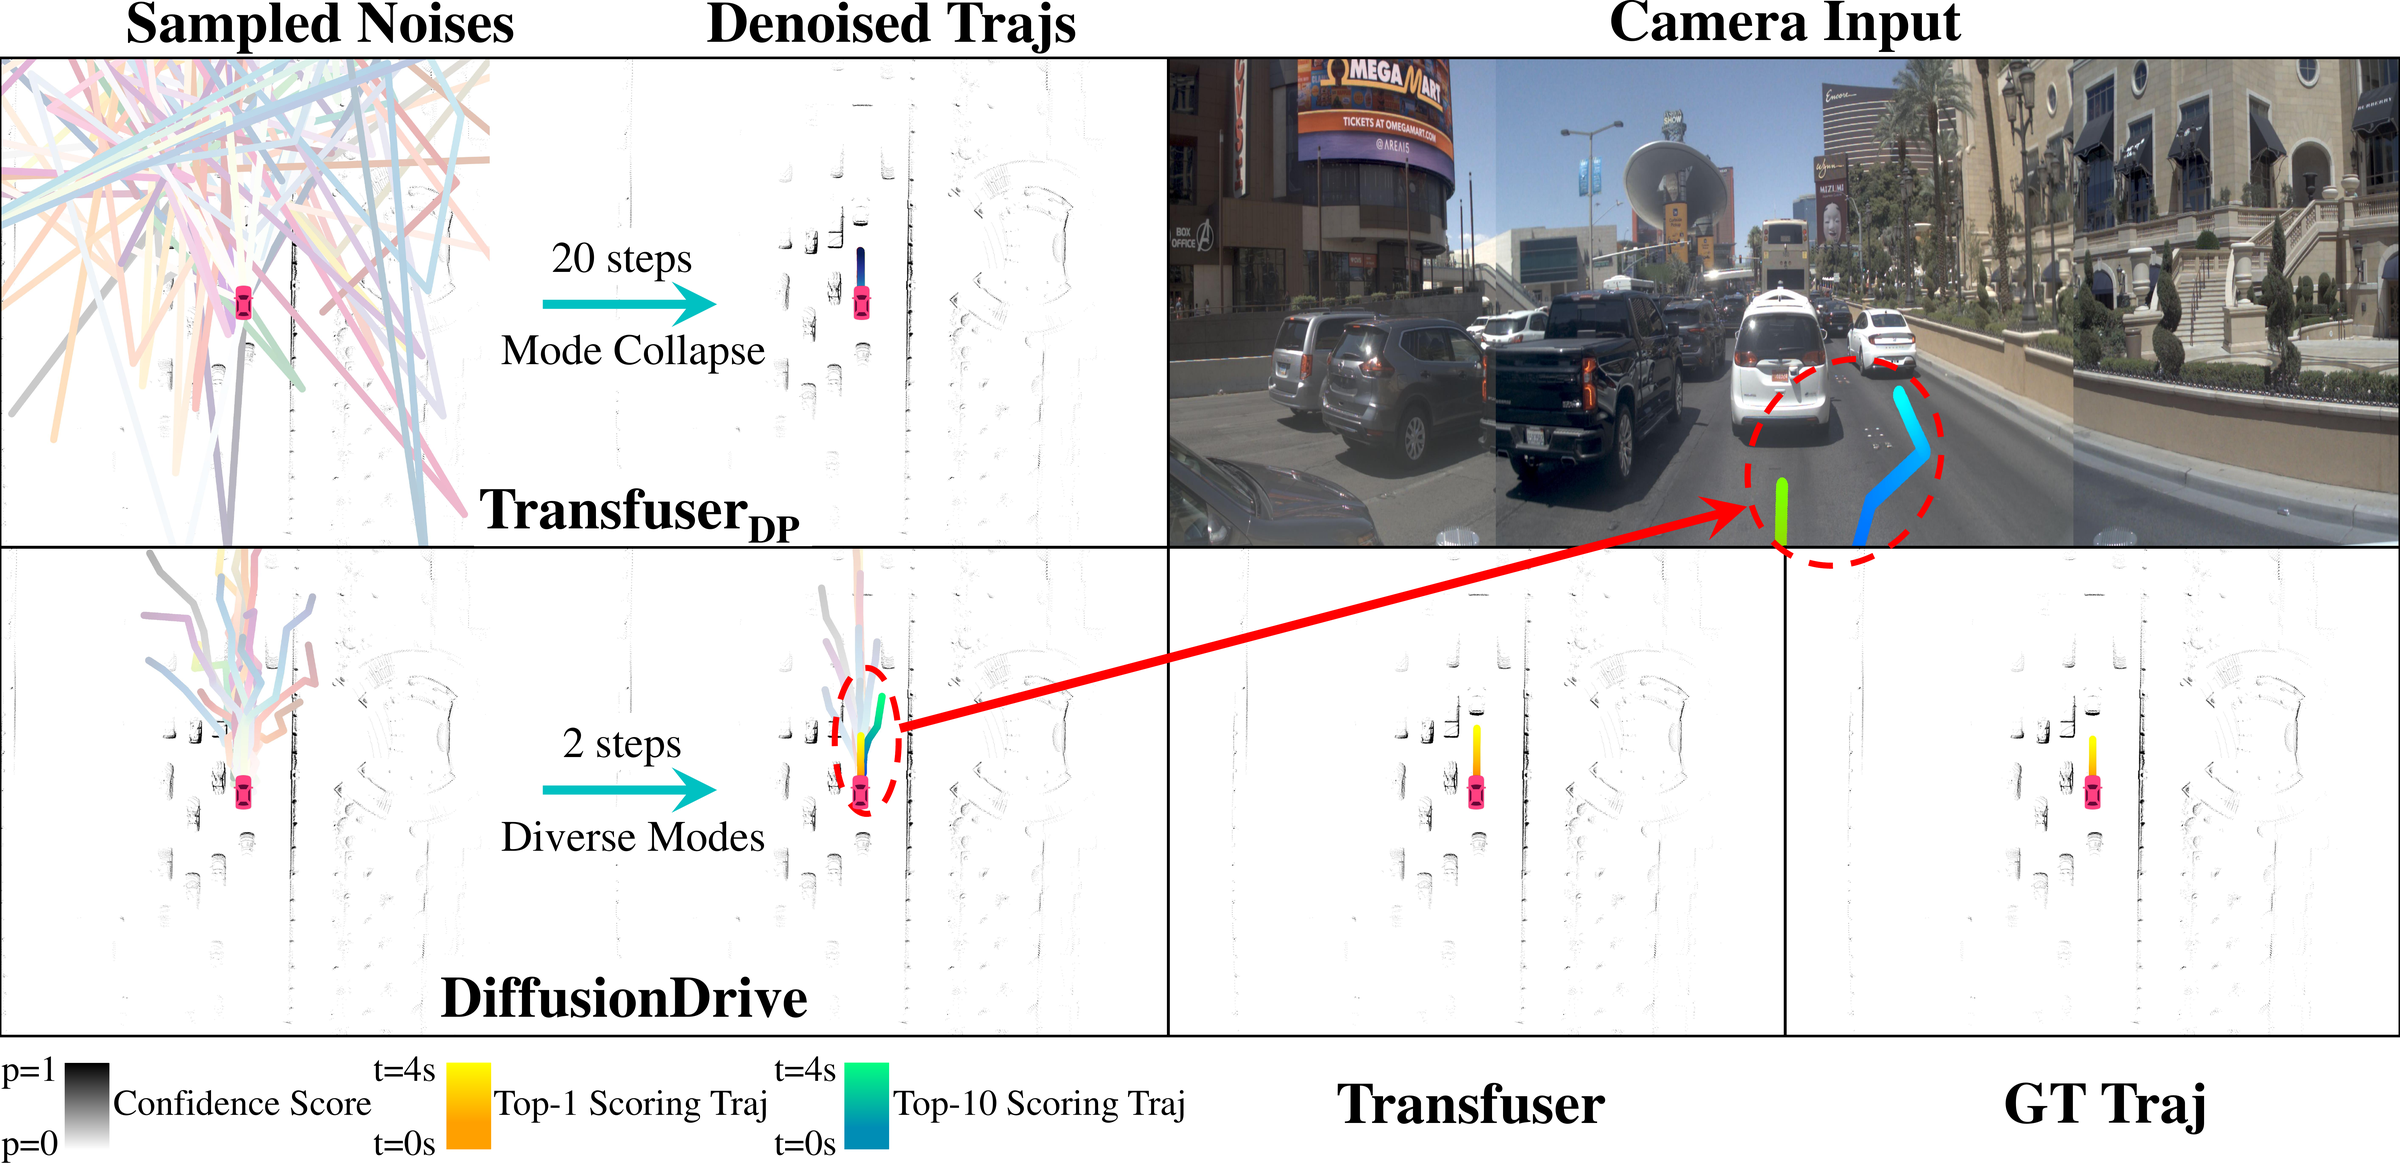
主要结论(定性,具体数值请参照原论文表格):
- PDMS 领先:发布时在端到端规划器中处于第一梯队(NAVSIM navtest 88.1 PDMS),显著优于确定性回归基线,尤其在需要"做选择"的变道/绕行场景上优势明显
- 多模态优势:在多候选场景下,扩散头能给出更分散、更贴合场景的候选轨迹,mode averaging 问题得到缓解
- 质量与多样性可兼得:论文还引入 mode diversity 分数 $\mathcal{D}$ 评估候选轨迹的多样化程度——top-1 紧贴真值的同时,top-10 能给出栅格级的变道选择,而不是挤成一团
- 实时可达:借助截断扩散和缓存矩阵,去噪步数从 20 步降到 2 步,延迟被压到可上车量级(45 FPS @ 4090),打破了"扩散太慢不能上车"的刻板印象
- 消融验证:去掉轨迹初始化后采样步数必须大幅增加才能维持质量;论文还证明去掉空间交叉注意力会让 PDMS 大幅跳水,反向验证各组件有效性
在 nuPlan 闭环/开环评测上,该方法同样展现出竞争力;nuScenes 开环指标下则比 VAD 快 1.8×、L2 误差低 20.8%、碰撞率低 63.6%。
🎨 定性可视化对比:多模态轨迹到底长什么样?
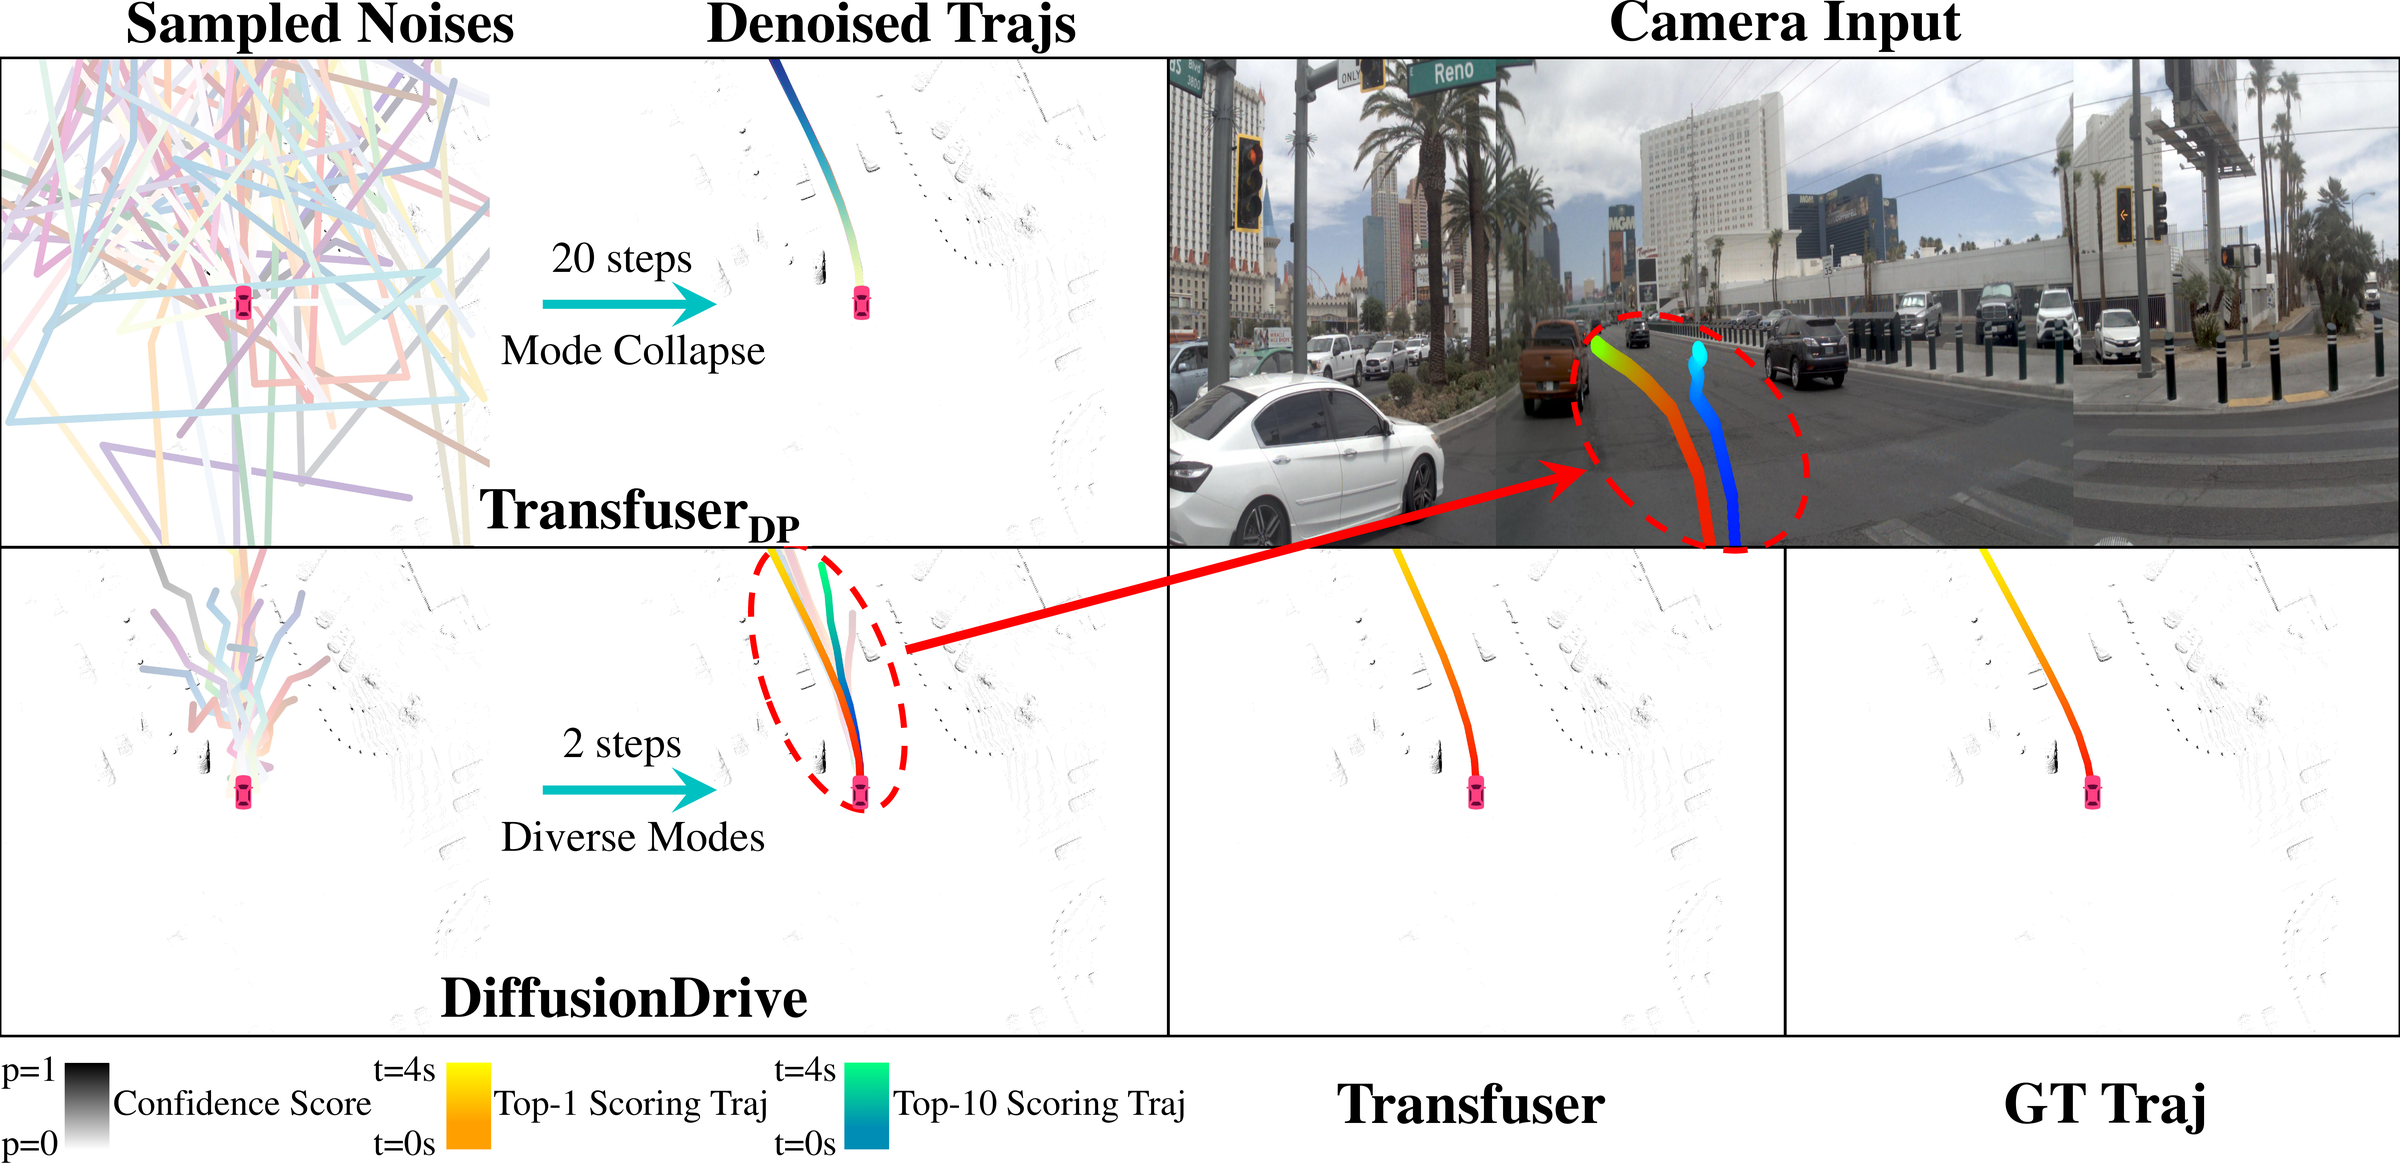
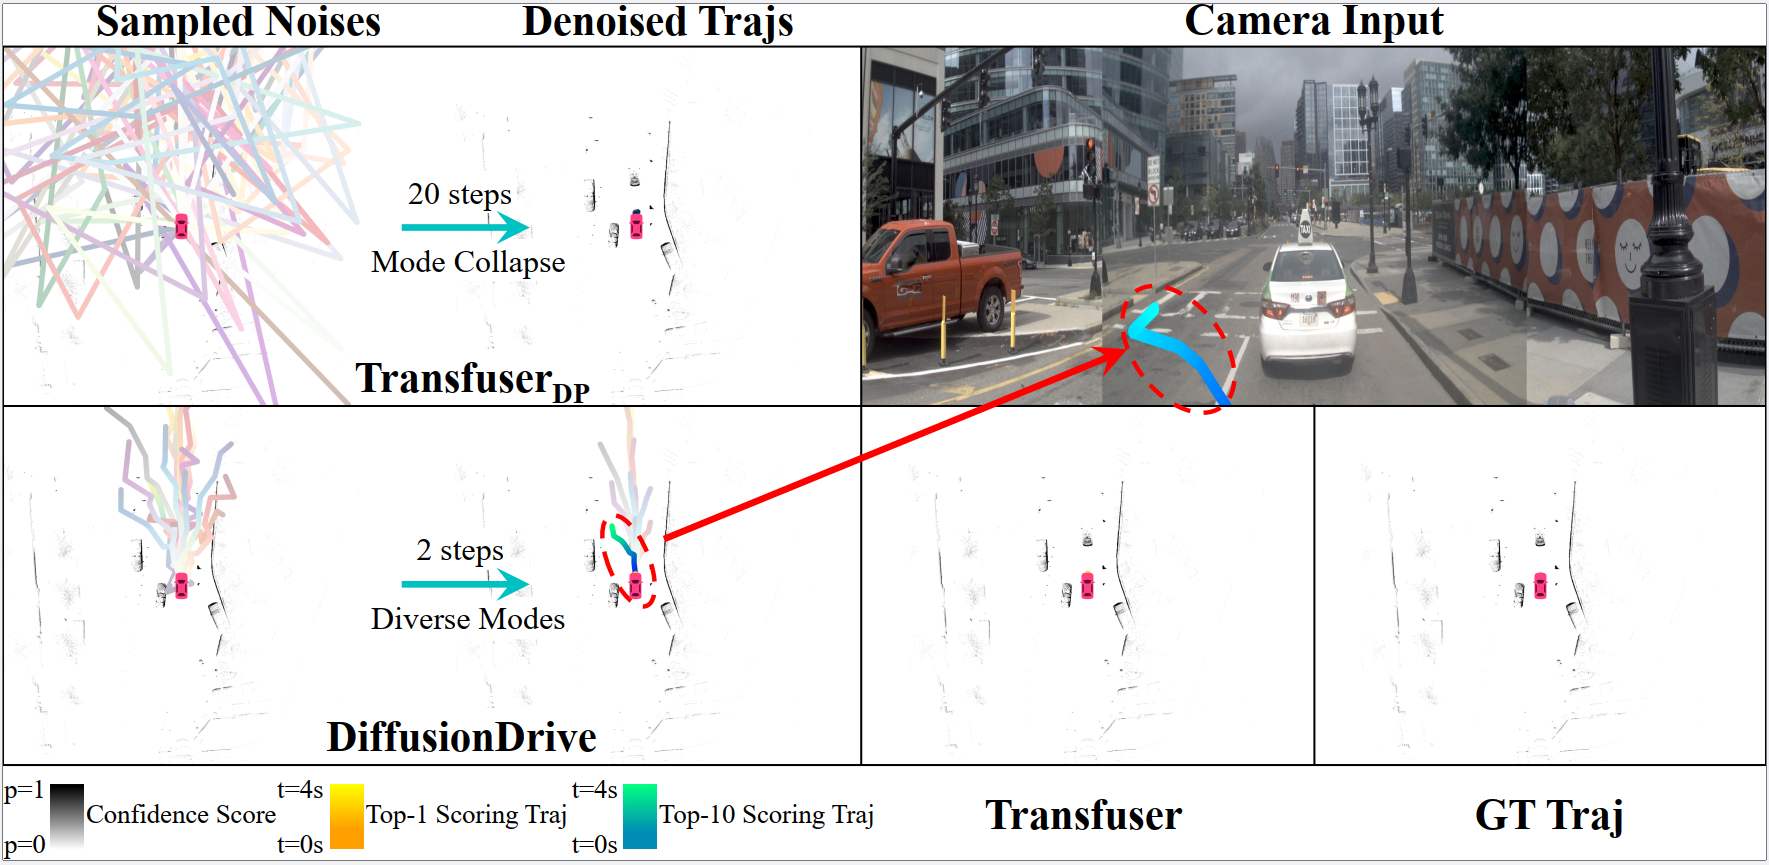
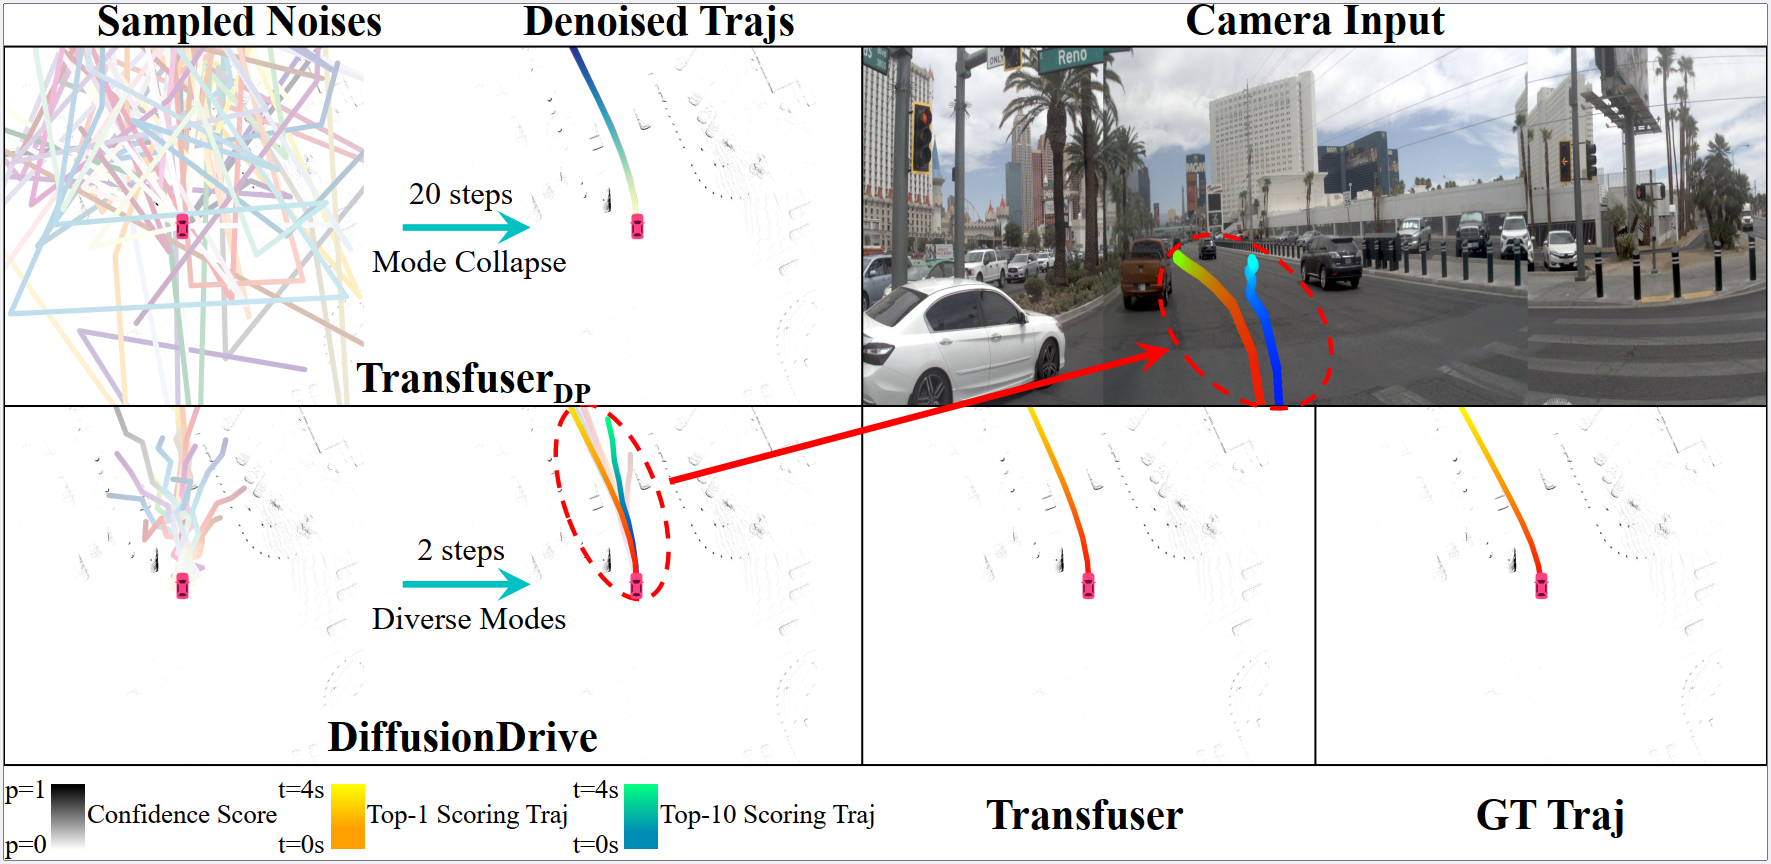
光看指标很难感受"多模态",下面直接看作者官方发布的 NAVSIM navtest 定性对比。四张大图覆盖三类典型场景,都对比了 Transfuser(单模态回归 → 一条轨迹)、Transfuser-DP(标准 DDIM 扩散策略 → 多条轨迹)与 DiffusionDrive(截断扩散)。
直行场景:跟车 + 变道
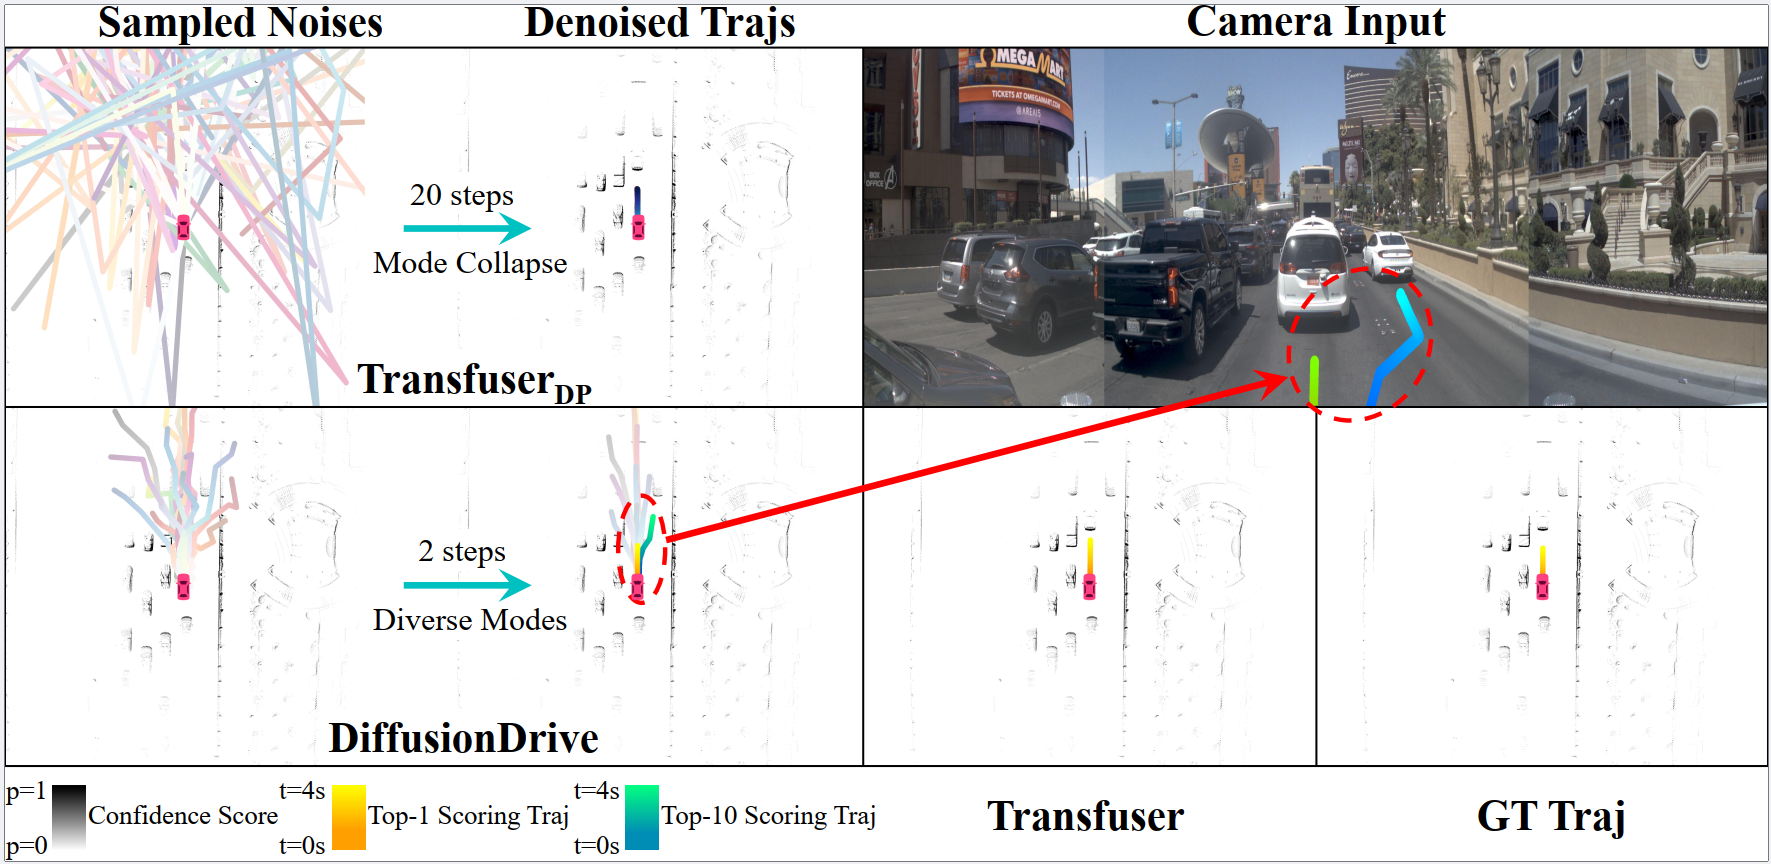
解读:这张图最能体现**模式坍缩(mode collapse)**的对比。Transfuser 的单条轨迹中线插在两车道之间(mode averaging 的典型症状:直接压在分隔线上),Transfuser-DP 的噪声采样则挤成一团、看不出分化;只有 DiffusionDrive 在 top-10 中给出了理由充分的变道候选。注意看红框标注的 top-1:它仍然贴着真值走,变道只出现在"行为伞"里,保证了安全兜底。
直行场景:变道 + 红绿灯 + 停车线
解读:这个场景暴露了原始扩散(Transfuser-DP)的"腿乱飞"问题——从标准高斯噪声出发、去噪步数少,候选轨迹会在场景里发散、不够收敛。位置化:确定性回归(Transfuser)和原始扩散(Transfuser-DP)在红绿灯面前要么不减速要么乱窜;兼具两者优点的 DiffusionDrive 则在懂规则(见红灯停下)+ 有选择(灯后变道)之间取得了平衡。这也正是截断扩散 + 锚定起点带来的收益:起点在人类轨迹附近,模型只需要在"驾驶行为空间"里做小范围修正,而不是从完全随机处去学"红灯要停"这种常识。
左转:与周边智能体交互
解读:左转是自动驾驶里交互最强、博弈最重的场景。单模态回归在这个场景必然冒进:它只能学到"左转轨迹的平均形状",不知道什么时候该停。Transfuser-DP 的随机性则没有训练的适配,候选要么撞车要么明显不自然。DiffusionDrive 的全部能力在多模态上:top-1 决策"减速让行"是最安全的解法,top-10 则把"加速抢道/停车等待"等人类司机在不同博弈下会走的各种策略都摊开,交给下游得分器选择——这正是**“分布即行为库”**的生动例子。
右转:跟车 + 绕行
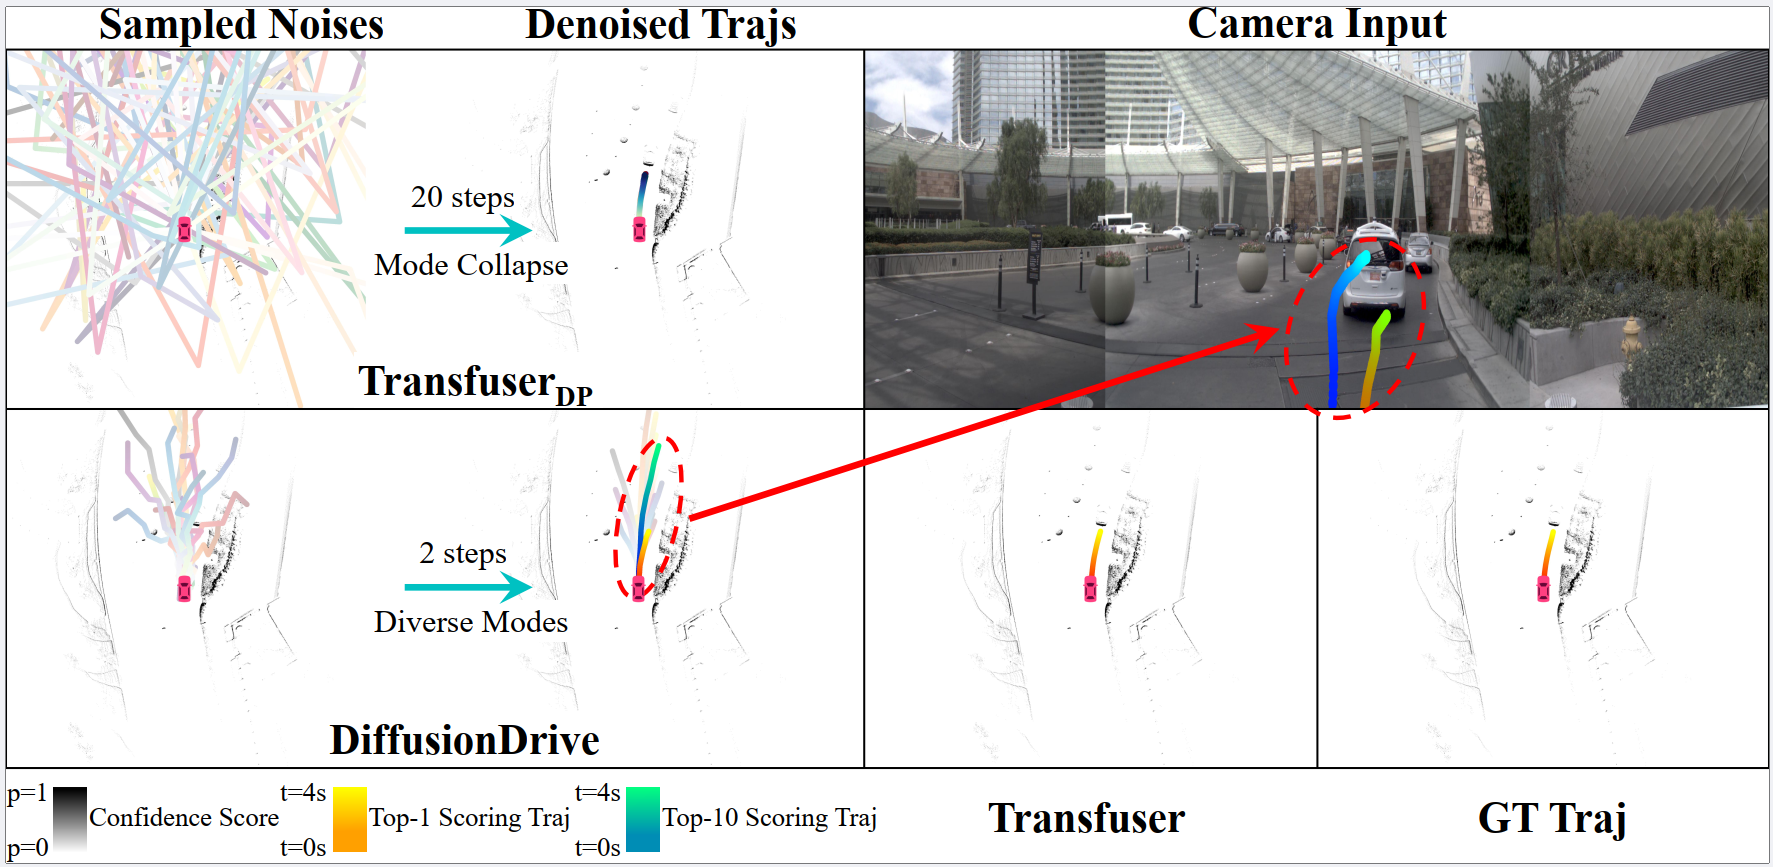
解读:这张图展示了扩散轨迹的**“交规与效率的权衡"在多模态里的体现**。单模态和 vanilla 扩散都只给出一条"禁直绕行"的可能;唯一能给出"先绕变量、再合规右转"的多模态方案的,是 DiffusionDrive 的包裹——它把"安全等待(top-1)“与"高效绕行(top-10 变道)“两条路同时摆上桌。这正是端到端生成式规划相比回归式规划的结构性优势:不是"输出一条最优”,而是"输出一个分布,让下游选择器既有照做又有切换的自由”。
看图解读(三图通用):红色 top-1 轨迹永远贴着真值和车道线走(安全底线),灰色 top-10 文档构成"行为伞"覆盖变道/绕行/让行等所有合法决策——“一条保安全、一簇保多样” 就是截断扩散多模态规划的画质。
⚠️ 局限性与未来方向
DiffusionDrive 并非银弹,它也暴露了生成式规划的几条固有软肋:
- 延迟仍高于单次回归:哪怕加速到 2 步,扩散头仍比直接回归多几次前向,对极高频控制是负担
- 硬约束难保证:扩散是软概率约束,无法像优化那样 100% 保证不碰撞、不越界,需依赖辅助 loss 和下游安全校验
- 错误模态风险:多模态采样偶尔会产生"分布内但不合理"的轨迹,需要可靠的打分/筛选机制兜底
- 数据依赖重:生成质量受人类驾驶数据覆盖度限制,长尾场景泛化能力存疑
- 可解释性不足:黑盒分布难以审计,在事故定责、安全认证上仍是障碍
未来方向我看好几条:用 Flow Matching 替换 DDPM 头进一步提速;用一致性蒸馏做到一步生成;与**强化学习(如 Flow-GRPO)**结合,把"模仿出来的分布"对齐到安全舒适的奖励信号;以及最务实的——扩散候选 + 优化裁决的混合范式。
📝 个人思考
读完 DiffusionDrive,最打动我的是它对”轨迹规划到底该建模什么“这个问题的重新发问。长久以来,端到端社区默认"输出一条轨迹"是天经地义的,于是所有人都在 L2 误差上卷。但 DiffusionDrive 把一个被忽视的事实摆上台面:驾驶本质是一个多解问题,同一个场景下合理走法不止一条,强行让网络吐一个"平均答案"反而是错的。把规划建模成分布而非点估计,这个视角的转变,比任何具体的去噪技巧都更深刻——它让我们意识到,确定性只是多模态分布退化后的一种近似,而真实驾驶从来不是单选。
第二点启发在工程现实主义。扩散模型上车最大的骂名就是"慢”,而 DiffusionDrive 用轨迹初始化这一招巧妙化解:既然噪声到数据的距离太远,那就别从噪声起步,从一个"粗略合理"的锚点起步做残差精修。这个思路本质上是"用先验换算力"——你对外部世界的先验越强(聚类出的锚点、场景结构),生成所需的开销就越小。我认为这是个可迁移的通用哲学:在实时性攸关的落地场景里,纯生成式未必最优,生成式 + 强先验才是甜点。这也解释了为什么它和 EM Planner 的"生成候选+打分"流程殊途同归——先验和优化的结合,无论用什么实现,都是工程上的稳赢选择。
最后一点是对生成式规划与强化学习结合的期待。DiffusionDrive 走的是模仿学习路线,它的分布上限就是人类司机的水平。但要真正超越人类、做到"比人更安全更舒适",必须引入奖励信号做偏好对齐——而这正是 Flow-GRPO 这类工作的用武之地:用扩散/Flow 头做多模态轨迹采样,用 GRPO 做组内相对优势优化,把"学人类"升级为"学最优策略"。我倾向于认为,生成式规划头 + 强化学习对齐会是端到端驾驶的下一个范式跃迁,而 DiffusionDrive 把生成式这扇门推开,功不可没。
📖 这是论文精读系列的第 8 篇。扩散模型正让端到端规划从"单选"走向"多选",你怎么看生成式规划的未来?欢迎留言。