📄 论文信息
- 标题:DLWM: Dual Latent World Models enable Holistic Gaussian-centric Pre-training in Autonomous Driving
- 团队:香港科技大学, 华为
- arXiv:2604.00969
- 收录:CVPR 2026
- 关键词:世界模型, 3D 高斯泼溅, 自监督预训练, 占据预测, 运动规划
- 一句话总结:DLWM 提出双潜在世界模型的自监督预训练框架,通过高斯流引导和自车规划引导两条路径,在占据感知、4D 预测和运动规划三个任务上同时取得显著提升。
🤔 要解决什么问题?
基于视觉的自动驾驶中,3D 场景表示的选择至关重要:
| 表示方法 | 优点 | 缺点 |
|---|---|---|
| 稠密 BEV | 空间连续,信息完整 | 计算量大,冗余高 |
| 稀疏 Query | 高效,聚焦关键区域 | 缺乏几何细节 |
| 3D 语义高斯 | 稀疏且全面,兼具几何和语义 | 缺乏统一预训练方法 |
核心问题:如何为高斯中心的场景表示设计一个统一的自监督预训练框架,同时服务于占据感知、4D 预测和规划?
💡 核心思想
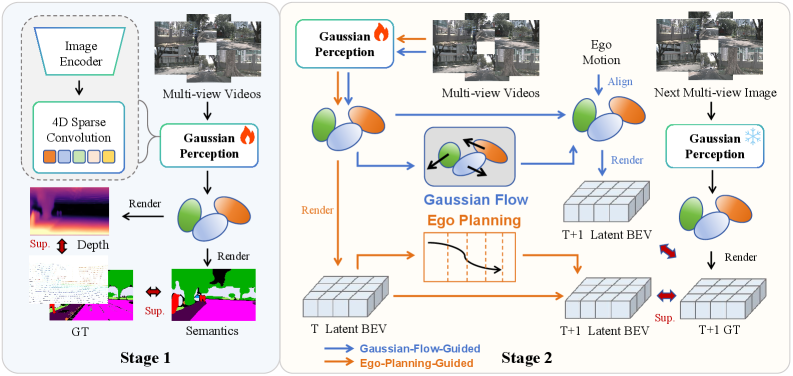
DLWM 采用两阶段预训练方案:
- 第一阶段:几何与语义学习 — 从多视图图像重建语义和深度图,学习 3D 高斯的上下文特征
- 第二阶段:双潜在世界模型 — 训练两个独立的潜在世界模型:
- 高斯流引导的世界模型 → 占据感知与预测
- 自车规划引导的世界模型 → 运动规划
⚙️ 方法细节
第一阶段:多视图重建预训练
给定多视图图像输入,DLWM 预测 3D 语义高斯,并通过可微渲染重建多视图语义图和深度图:
$$ \mathcal{L}_{stage1} = \mathcal{L}_{semantic}(\hat{S}, S) + \lambda \cdot \mathcal{L}_{depth}(\hat{D}, D) $$其中 $\hat{S}$ 和 $\hat{D}$ 是重建的语义和深度图,$S$ 和 $D$ 是伪标签。这一阶段让高斯 query 学会几何和语义特征。
第二阶段:双潜在世界模型
世界模型一:高斯流引导(Gaussian-flow-guided)
输入:当前帧的 3D 高斯特征 任务:预测未来帧的高斯特征流 输出:用于 3D 占据感知和 4D 占据预测
核心思想:高斯的运动天然以流的形式存在(每个高斯在三维空间中移动),因此用潜在世界模型预测高斯流的演进。
世界模型二:自车规划引导(Ego-planning-guided)
输入:当前帧的高斯特征 + 候选自车轨迹 任务:预测轨迹对应的未来场景演进 输出:评估不同轨迹的合理性,用于运动规划
核心思想:如果一条轨迹会驶入前方障碍物占据的区域,世界模型应能提前预测到冲突。
与现有方法的对比
| 方法 | 表示 | 预训练目标 | 下游任务范围 |
|---|---|---|---|
| VisionPAD | BEV | 重建 + 时间对比学习 | 感知 + 规划 |
| BEV-VAE | BEV | VAE 重建 | 规划 |
| DLWM | 3D 高斯 | 双潜在世界模型 | 感知+预测+规划 |
🧪 实验与结果
3D 占据感知(SurroundOcc)
| 方法 | mIoU | 说明 |
|---|---|---|
| Baseline (scratch) | 38.26 | 无预训练 |
| Baseline + DLWM | 39.73 (+1.47) | 清晰提升 |
4D 占据预测(nuScenes)
| 方法 | mIoU (1s) | mIoU (2s) | mIoU (avg) |
|---|---|---|---|
| Baseline (scratch) | 35.12 | 33.85 | 34.49 |
| Baseline + DLWM | 37.14 | 35.83 | 36.49 (+2.00) |
运动规划(nuScenes)
| 方法 | L2 (1s) ↓ | L2 (3s) ↓ | 碰撞率 ↓ |
|---|---|---|---|
| Baseline | 0.67 | 1.33 | 0.85 |
| + DLWM (stage1 only) | 0.58 | 1.18 | 0.62 |
| + DLWM (dual WM) | 0.54 | 1.12 | 0.51 |
L2 误差降低约 16%,碰撞率降低约 40%。
消融实验
| 组件 | 占据 mIoU | L2 (3s) |
|---|---|---|
| 完整 DLWM | 39.73 | 1.12 |
| w/o 高斯流 WM | 38.52 | 1.12 |
| w/o 规划引导 WM | 39.73 | 1.25 |
| w/o 阶段1 预训练 | 38.15 | 1.21 |
⚠️ 局限与未来方向
- 两阶段训练增加了整体训练复杂度
- 高斯场景表示对动态物体的建模仍有挑战
- 仅在 nuScenes 和 SurroundOcc 验证,需扩展到更多数据集
- 高斯的数量对性能的影响需要进一步 scaling 分析
📝 个人思考
DLWM 选择高斯作为场景表示是一个值得关注的方向。相比 BEV 的稠密网格和 sparse query 的隐式表示,3D 高斯同时具备了可解释性(语义+几何)和稀疏性(计算高效)。双世界模型的设计也很有工程智慧——不同下游任务需要的世界模型侧重点不同,分开训练比强行统一更合理。
让我联想到之前读的 DriveDreamer 和 OccWorld——世界模型正从"用一个模型预测一切"走向"任务特定的世界模型"。DLWM 的双分支设计是这个趋势的一个很好的体现。
不过两个世界模型分开训练也意味着更多的工程工作量。如果能设计一个共享大部分参数、只在预测头解耦的统一框架,可能会更优雅。
📖 这是论文精读系列的第 XX 篇。3D 高斯正在从 NeRF 炫技走向自动驾驶的实用表示。欢迎留言讨论。