📄 论文信息
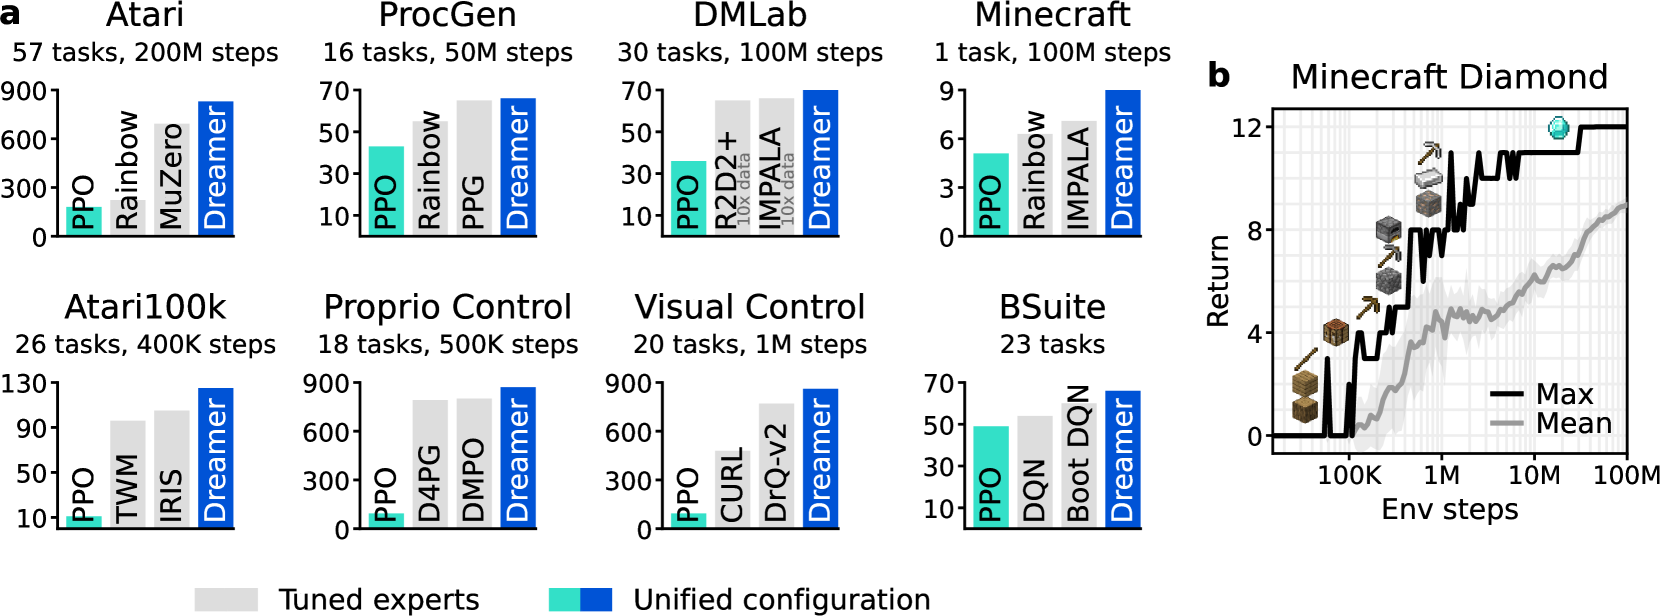
- 标题:Mastering Diverse Domains through World Models(通过世界模型掌握多样领域)
- 团队:Google DeepMind、University of Toronto — Danijar Hafner、Jurgis Pasukonis、Jimmy Ba、Timothy Lillicrap
- 发表:arXiv 2301.04104,2023 年 1 月(2024 年 4 月更新)
- 关键词:世界模型、强化学习、Dreamer、RSSM、Minecraft、通用算法
- 一句话总结:以单一固定超参数在 150+ 多样化任务上超越专用算法,首次从零开始在 Minecraft 中收集钻石。
- 论文链接:arXiv:2301.04104
- 代码链接:danijar.com/dreamerv3
🤔 要解决什么问题?
强化学习(RL)已经取得了令人瞩目的成就——在围棋、Dota 等特定任务上超越人类。但一个根本性问题始终存在:
RL 算法的"超参数诅咒"
现有的 RL 算法(如 PPO、SAC、DQN)在设计时都针对特定类型的任务:
- SAC 适用于连续控制
- DQN 适用于离散动作
- PPO 是通用但性能中等
当需要应用到新领域时(例如从 Atari 游戏转到机器人操控),需要大量的人工调参和领域知识。这带来了三个核心问题:
- 应用门槛高:每个新任务都需要 RL 专家花数周时间调参
- 可扩展性差:无法将算法简单地应用到新领域
- 资源浪费:调参过程消耗大量计算资源
通用 RL 算法的挑战
构建通用 RL 算法面临独特的技术挑战:
- 信号幅度差异:不同任务的奖励尺度可能差几个数量级
- 动作空间多样:连续/离散、低维/高维
- 观测模态不同:图像/向量、高维/低维
- 时间尺度不一:有些任务需要长期规划,有些只需短期反应
- 奖励密度不同:有些任务奖励密集,有些极其稀疏
DreamerV3 的目标是用单一固定配置解决所有这些问题。
💡 核心方法
世界模型的核心思想
DreamerV3 的核心是世界模型(World Model)——一个学习环境动力学的神经网络,使智能体能够在"想象"中规划。
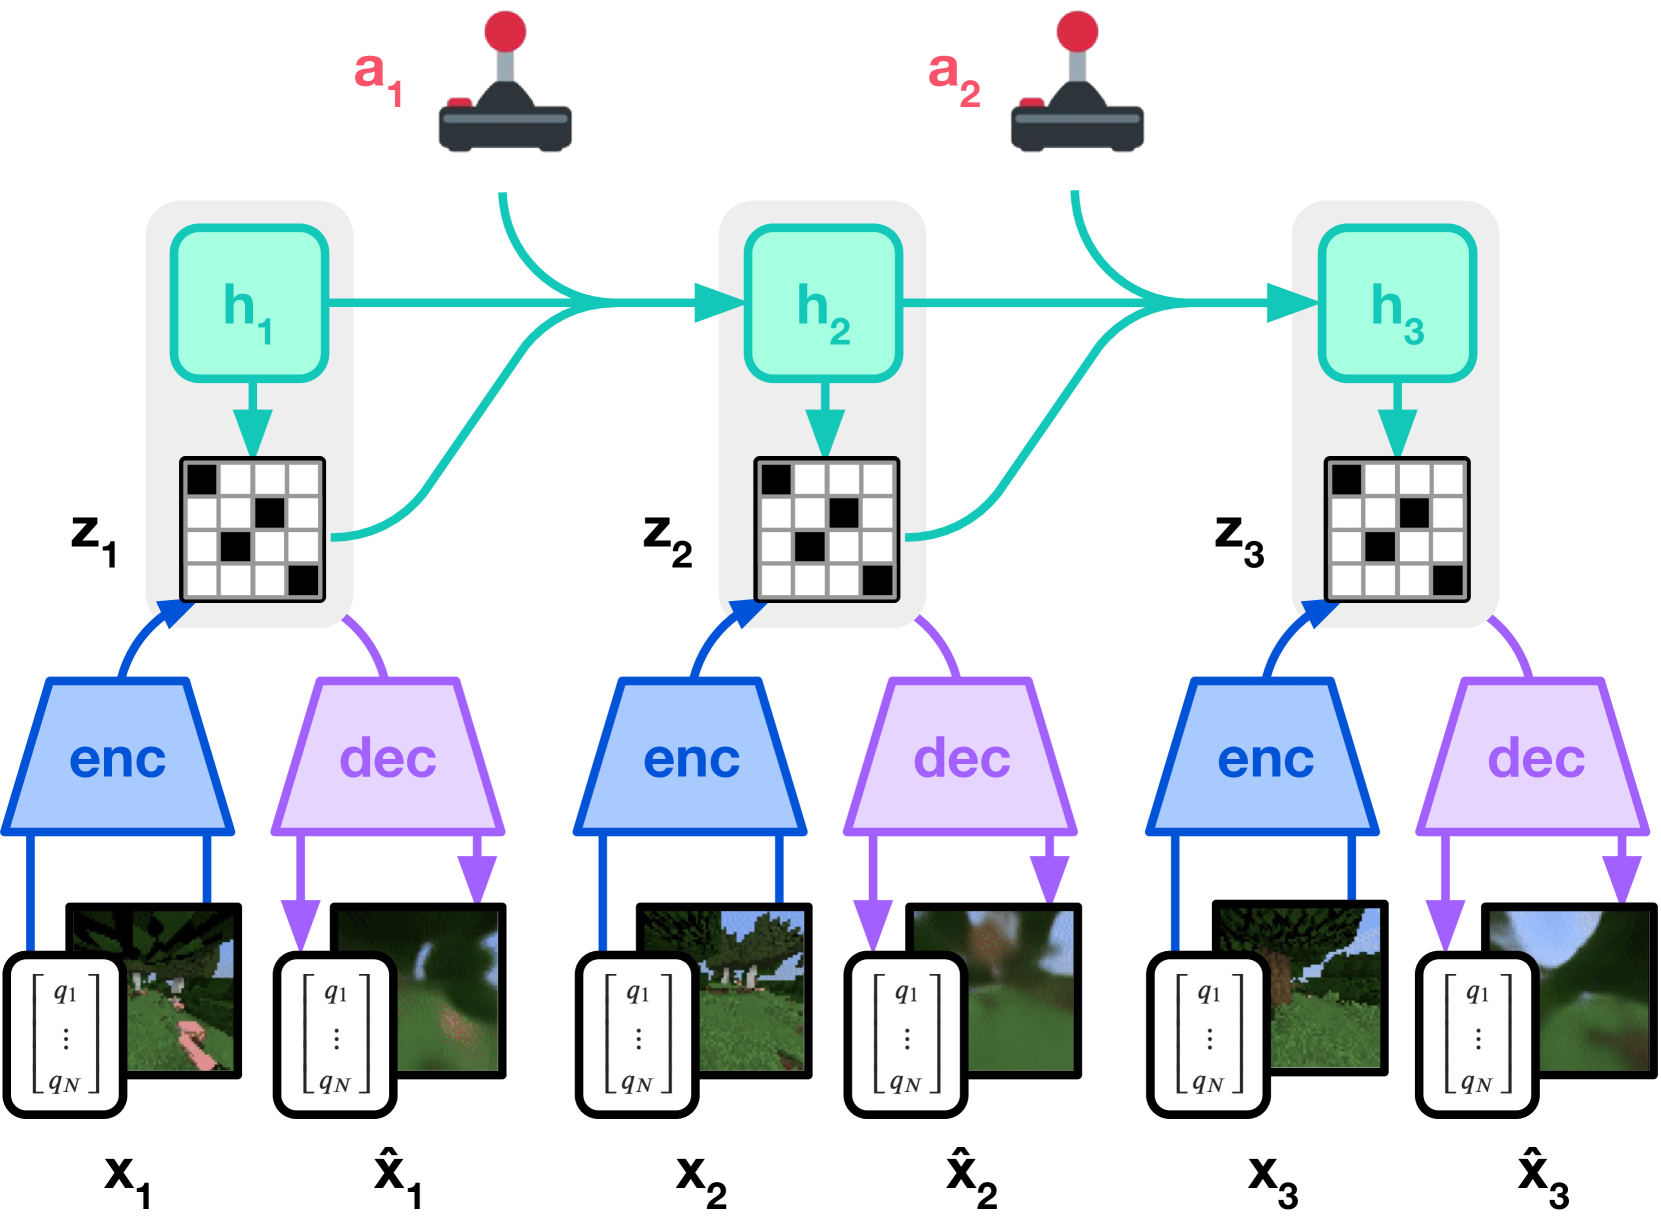
世界模型的工作流程:
- 编码:将高维观测(如图像)压缩为紧凑的离散表示 $z_t$
- 预测:给定当前状态和动作,预测下一时刻的状态和奖励
- 规划:在想象的轨迹上搜索最优动作序列
关键优势:
- 样本效率高:在想象中训练不需要真实环境交互
- 支持长期规划:可以在想象中模拟数十步的未来
- 处理稀疏奖励:通过想象填充奖励之间的空白
RSSM:循环状态空间模型
DreamerV3 使用 RSSM(Recurrent State-Space Model) 作为世界模型的核心架构:
RSSM 的三个组件:
循环模型(确定性):$h_t = f_\phi(h_{t-1}, z_{t-1}, a_{t-1})$
- GRU 网络,捕获时间依赖性
- 维持长期记忆
编码器(随机性):$z_t \sim q_\phi(z_t | h_t, x_t)$
- 从观测 $x_t$ 和隐藏状态 $h_t$ 编码当前状态
- 使用离散表征(categorical distributions)
解码器(随机性):$\hat{x}_t \sim p_\phi(\hat{x}_t | h_t, z_t)$
- 从隐藏状态和随机状态重建观测
- 确保表示的信息性
离散表征的关键创新:
DreamerV3 的一个重要创新是使用离散(categorical)表征而非连续高斯分布:
- 将每个随机变量建模为 32 个类别,每个类别 32 个 bin
- 总共 $32 \times 32 = 1024$ 维的离散表示
- 离散表征比连续表征更稳定,适合跨领域泛化
Actor-Critic 学习
在世界模型内部,DreamerV3 训练 actor(策略)和 critic(价值函数):
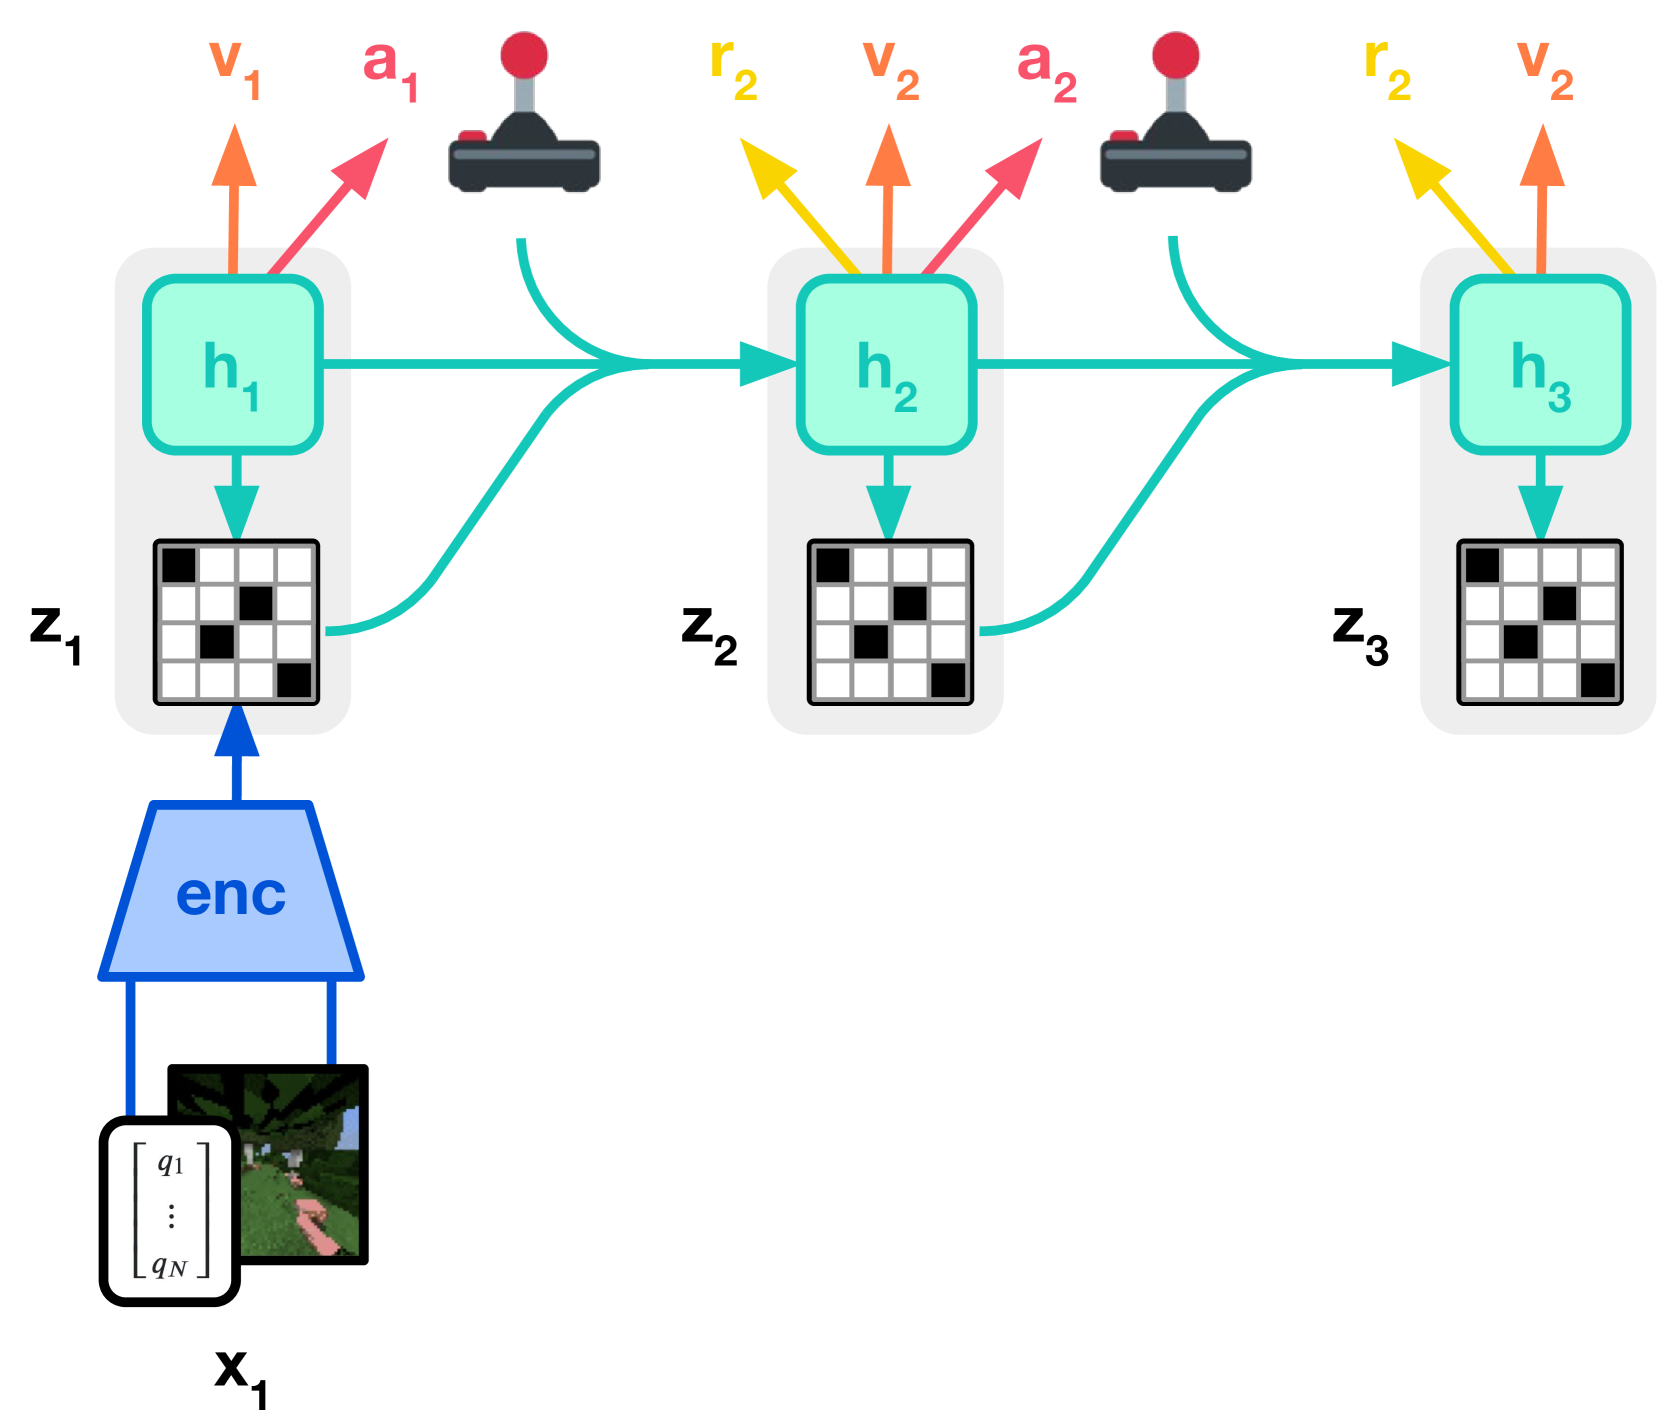
训练流程:
- 从真实环境中收集经验,存入回放缓冲区
- 从缓冲区采样序列,在世界模型中展开想象
- 在想象轨迹上计算 actor 和 critic 的损失
- 同时更新世界模型、actor 和 critic
Actor 损失:
$$L_{\text{actor}} = \mathbb{E}_{\tau \sim p_\phi} \left[ \sum_t \log \pi_\theta(a_t | s_t) \cdot \text{sg}(\hat{A}_t) \right]$$其中 $\hat{A}_t$ 是在想象轨迹上计算的优势函数。
Critic 损失:
$$L_{\text{critic}} = \mathbb{E}_{\tau \sim p_\phi} \left[ \sum_t (v_\psi(s_t) - \text{sg}(\hat{R}_t))^2 \right]$$其中 $\hat{R}_t$ 是想象轨迹上的折扣回报。
鲁棒性技术:跨领域的关键
DreamerV3 能够跨领域泛化的核心在于一系列鲁棒性技术:
1. Symlog 预测
对于奖励预测,使用 symlog 变换处理未知量级的信号:
$$\text{symlog}(x) = \text{sign}(x) \cdot \log(1 + |x|)$$这使得模型能够处理从 $10^{-6}$ 到 $10^6$ 量级的奖励信号。
2. 自适应损失平衡
世界模型的总损失是多个项的加权和:
$$L_{\text{model}} = L_{\text{representation}} + L_{\text{dynamics}} + L_{\text{reward}} + L_{\text{continue}} + L_{\text{reconstruction}}$$DreamerV3 使用自适应权重调整,根据各损失项的梯度自动平衡,无需手动调参。
3. 自适应正则化
使用对称 KL 散度作为正则化项,防止后验和先验分布偏差过大:
$$\text{symKL}(p, q) = \text{KL}(p \| q) + \text{KL}(q \| p)$$4. 稳定的价值函数学习
使用 symlog MSE 作为 critic 的损失函数,避免大值域带来的训练不稳定。
无需特定配置的设计哲学
DreamerV3 的设计哲学是**“默认就应该工作”**:
| 设计选择 | 传统方法 | DreamerV3 |
|---|---|---|
| 奖励归一化 | 需要手动设置范围 | 自适应 symlog |
| 损失平衡 | 手动调权重 | 自适应梯度平衡 |
| 学习率 | 每个任务不同 | 固定 3e-4 |
| 网络架构 | 每个领域定制 | 统一架构 |
| 超参数 | 大量需要调 | 全部固定 |
🧪 实验验证
跨领域基准测试
DreamerV3 在 5 大领域、150+ 任务上进行评估:
| 领域 | 任务数 | 动作空间 | 奖励类型 |
|---|---|---|---|
| DMControl | 20 | 连续 | 密集 |
| Atari | 26 | 离散 | 稀疏/密集 |
| ProcGen | 16 | 离散 | 稀疏 |
| DMLab | 9 | 离散 | 稀疏 |
| Minecraft | 1 | 连续+离散 | 极稀疏 |
核心结果:
- DreamerV3 在 150+ 任务上使用单一固定配置
- 在大多数任务上超越或匹配专用调参后的 SOTA 算法
- 比 PPO(通用但性能中等)显著更好
Minecraft 钻石收集
Minecraft 是 DreamerV3 最具挑战性的测试:
为什么 Minecraft 钻石收集如此困难?
- 极稀疏奖励:需要经过数十个步骤才能获得第一个奖励
- 长时间跨度:从出生到收集钻石需要数千步
- 程序化生成:每个世界都不同,无法记忆
- 多模态动作:需要同时控制移动和交互
- 像素输入:从原始图像学习
DreamerV3 的突破:
- 首次从零开始在 Minecraft 中收集钻石
- 之前的最佳方法需要:
- 人类专家数据
- 领域特定的课程学习
- 手动设计的奖励函数
- DreamerV3 仅使用稀疏的二值奖励(是否获得钻石)
训练过程:
阶段 1(0-50M 步):探索基本移动
阶段 2(50-100M 步):学习采集木头和石头
阶段 3(100-200M 步):制作工具
阶段 4(200-400M 步):挖掘矿石
阶段 5(400-600M 步):找到并收集钻石
消融实验
论文进行了详细的消融研究,验证各鲁棒性技术的重要性:
| 技术 | 移除后性能下降 |
|---|---|
| symlog 预测 | 32% |
| 自适应损失平衡 | 28% |
| 离散表征 | 25% |
| 对称 KL | 18% |
| 自适应正则化 | 15% |
所有鲁棒性技术都对跨领域泛化有显著贡献。
缩放性质
DreamerV3 展示了良好的缩放性质:
- 更大的模型不仅达到更高分数,而且需要更少的交互就能解决问题
- 这为"用更多计算换取更少环境交互"提供了实证支持
🔍 个人思考
亮点
“默认就应该工作"的设计哲学:DreamerV3 最令人印象深刻的是它真正实现了"单一配置解决所有问题”。这不仅是一个技术成就,更是一种设计哲学的胜利——通过精心设计的鲁棒性技术,消除了 RL 应用中最痛苦的调参环节。
离散表征的创新:使用 categorical 分布而非连续高斯分布是一个看似简单但影响深远的创新。离散表征更稳定、更容易泛化,这一思路可以推广到更多生成模型任务。
Minecraft 钻石收集的里程碑意义:这是 AI 在开放世界游戏中从零学习复杂长程任务的重要突破。它证明了世界模型 + 强化学习的组合能够处理真实世界的复杂性。
对机器人学的启示:DreamerV3 的世界模型思想与机器人学中的 model-based RL 高度相关。它展示了如何在高维观测(图像)下有效学习和利用世界模型。
局限性
计算成本较高:训练世界模型 + actor + critic 三个网络,加上在想象中采样,计算开销不小。对于资源受限的场景可能不实用。
真实世界迁移有限:虽然在模拟任务上表现优异,但论文没有展示真实机器人实验。世界模型在真实世界中的泛化能力仍有待验证。
奖励设计依赖:虽然 DreamerV3 能处理稀疏奖励,但仍需要手动设计奖励函数。对于开放世界任务,自动奖励发现仍是难题。
长期记忆的局限:RSSM 使用 GRU 维持记忆,对于需要超长时间尺度(数万步)的任务,记忆容量可能不足。
未来方向
与大语言模型结合:将 DreamerV3 的世界模型与 LLM 的语义理解能力结合,可以实现更高层次的规划和推理。
真实世界应用:将 DreamerV3 应用于真实机器人操控,验证其在物理世界中的泛化能力。
多智能体扩展:将世界模型扩展到多智能体场景,学习其他智能体的行为模型。
与 VLA 模型融合:DreamerV3 的世界模型思想可以与 VLA 模型结合,实现"理解 + 想象 + 行动"的完整闭环。