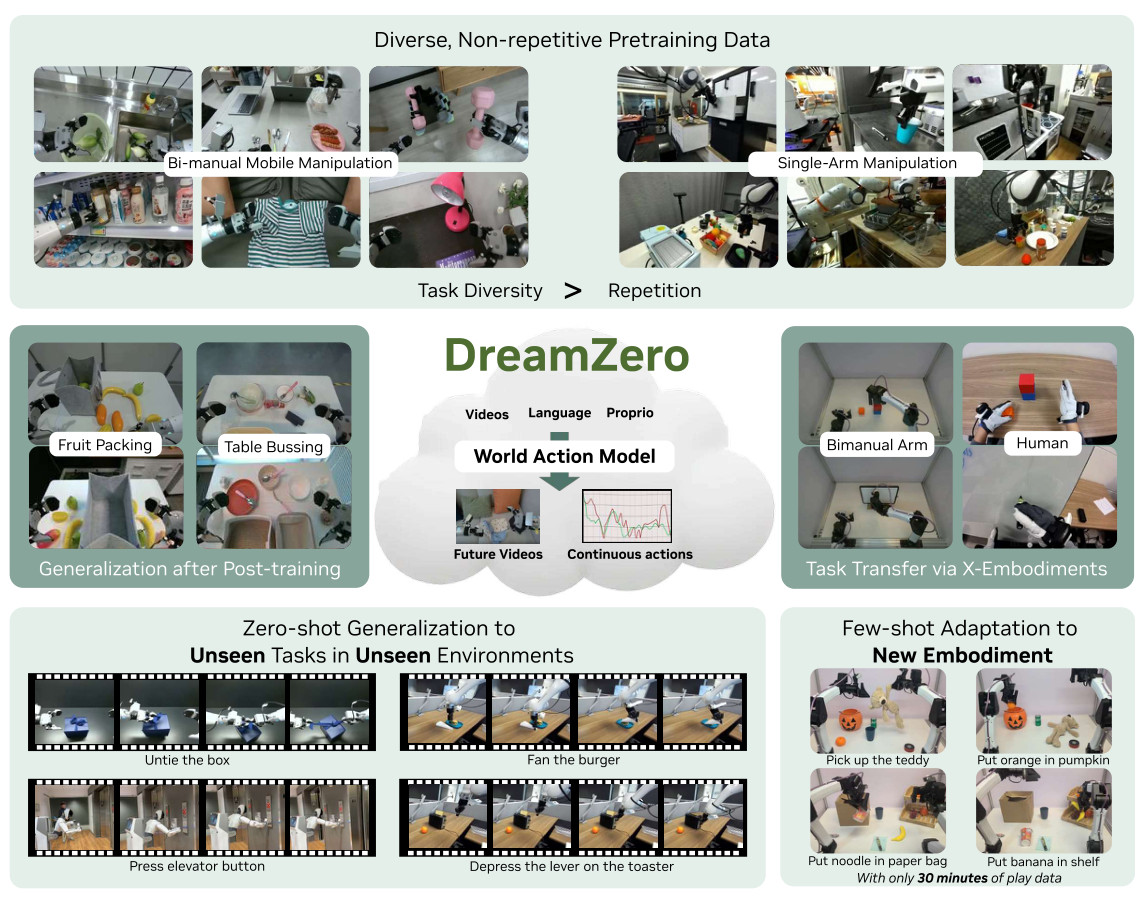
配图说明:本文收录论文全部 16 张插图(Figure 1 ~ Figure 16),放在站内 /images/dreamzero/,逐张讲解,文末附图表总索引表。论文来自 NVIDIA,2026 年 2 月 19 日挂 arXiv(2602.15922),项目页 dreamzero0.github.io,权重与推理代码已开源。
📄 论文信息
- 标题:World Action Models are Zero-shot Policies
- 机构:NVIDIA(Seonghyeon Ye、Yunhao Ge、Kaiyuan Zheng、Shenyuan Gao、Sihyun Yu、George Kurian 等为共同一作/核心贡献,Yuke Zhu、Linxi “Jim” Fan、Joel Jang 为项目负责人)
- 时间:2026-02-19(arXiv 2602.15922)
- 关键词:世界行动模型(WAM)、视频扩散骨干、自回归 DiT、teacher forcing、异步闭环、DreamZero-Flash、跨本体迁移、少样本本体适配
- 一句话总结:把「预测未来视频」当成机器人策略的主任务,而不是附属任务——14B 的 Wan2.1 视频模型同时吐出未来画面和动作,靠视频预训练带来的物理先验,从 500 小时「乱七八糟」的真机数据里学出比 VLA 强两倍的零样本泛化;再用一套系统+模型级优化把 5.7 秒/块的延迟压到 150 毫秒,让 WAM 第一次跑进 7Hz 的实时闭环。
🎯 一句话版本:它到底证明了什么
论文的核心主张可以拆成四句:
| 主张 | 证据 | 数字 |
|---|---|---|
| WAM 能从异构、不重复的数据里学 | 500 小时遥操作、22 个真实场景、7,193 条轨迹,每条平均 4.4 分钟、42 个子任务 | seen 任务 62.2% vs 最强预训练 VLA 27.4%(>2×) |
| WAM 能零样本做没见过的任务 | 10 个训练中完全不存在的任务(熨衣服、系鞋带、摘帽子……) | 39.5% vs 预训练 VLA 16.3%,from-scratch VLA <1% |
| 视频-only 数据也能跨本体迁移 | 20 分钟 YAM 视频 / 12 分钟人类第一视角视频 | 未见任务 38.3% → 55.4% / 54.3%(相对 +42% 以上) |
| 30 分钟新本体数据就能换机器人 | AgiBot G1 预训练 → YAM 55 条轨迹 | 保留语言跟随与零样本泛化 |
| 14B 视频扩散可以实时 | 异步执行 + CFG 并行 + DiT 缓存 + 编译/量化 + Flash 蒸馏 | 5.7 s → 150 ms(38×),7Hz 闭环 |
一句话:VLA 学的是「看到什么、该出什么动作」;DreamZero 学的是「世界接下来会怎么变,以及我的动作如何嵌进这段变化里」。前者在语义层面很强,后者在物理运动层面更强。
🧭 读前 5 分钟:五个必须懂的概念
- WAM(World Action Model,世界行动模型):同一个生成模型里联合去噪未来视频 latent 和动作序列。与「先生成视频、再用逆动力学模型(IDM)反推动作」的两段式不同,DreamZero 是端到端一个模型。论文把它写成概率分解 π(o,a|c) = π(o|c)·π(a|o),但训练时共享一套参数、一个损失。
- Flow Matching 与「时间步 t」:把干净数据 x₁ 和噪声 x₀ 线性插值成 x_t = t·x₁ + (1−t)·x₀,网络学预测速度 v = x₁ − x₀。t 越接近 1 越干净。DreamZero 里同一 chunk 内视频和动作共享同一个 t,不同 chunk 独立采样 t——这是它能做 teacher forcing 的关键。
- Teacher forcing + KV cache:训练时当前 chunk 只能看已经干净的历史 chunk(C₀, C₁, C₂…),预测当前 chunk 的速度;推理时把历史帧的 KV 缓存下来,逐 chunk 往前推。好处是误差不累积——因为真实观测会不断替换掉预测帧。
- 自回归(AR)vs 双向(BD):双向模型必须吃固定长度序列,长任务里只能对视频做「抽帧」来对齐语言描述,抽帧会破坏原生帧率,进而破坏「视频帧 ↔ 动作」的时序对齐;自回归模型按 chunk 生成,KV cache 支持任意长上下文,原生帧率不变。附录 B 用一张图讲清了这个取舍(本文 Figure 13)。
- 异步闭环与实时预算:机器人以 30Hz 执行、每块 48 步(1.6 秒)。推理不必在机器人动之前完成,只要在当前动作块用完之前完成即可。于是目标延迟从「<33ms」放宽到「~200ms」,这才给了 14B 模型上场的机会。
🏗️ 方法:一张架构图 + 三处关键设计
1. 联合去噪:一个骨干,两路输入,两路输出
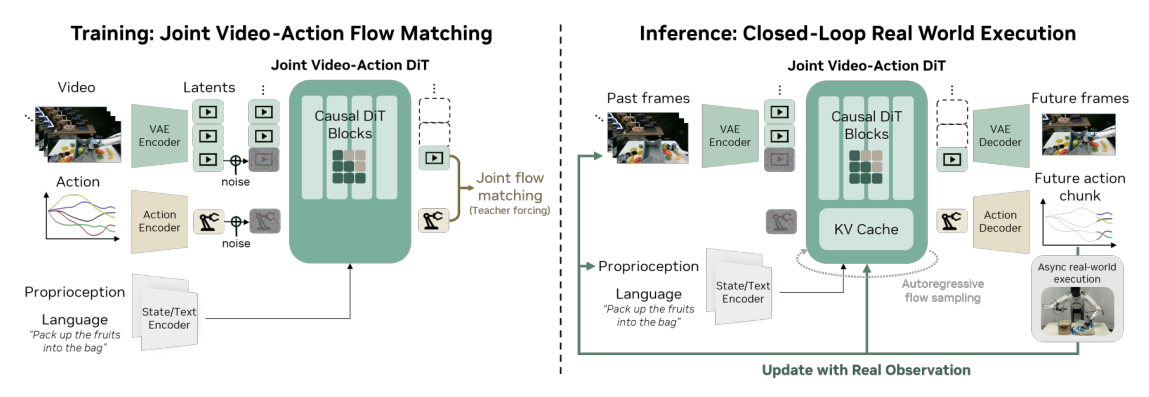
这张图是全篇的骨架,左半是训练、右半是推理:
- 三路输入:视觉上下文(当前帧 + 历史帧)过 VAE 变成 video latent;语言指令过冻结的文本编码器;机器人本体状态(proprio)过一个小 state encoder。多相机数据不改编排,直接把多视角拼成一张图再编码。
- 骨干:Wan2.1-I2V-14B-480P 的 DiT,用 flow matching 训练。相比原视频模型只新增 state encoder、action encoder、action decoder 三小块参数;文本编码器、图像编码器、VAE 全部冻结,DiT 全量更新。
- 训练(左):对第 k 个 chunk,取带噪的视频 latent z^k_t 和带噪动作 a^k_t,条件在已经干净的历史 chunk C_k 上,让网络预测联合速度 [z₁, a₁] − [z₀, a₀]。
- 推理(右):当前 chunk 用 KV cache 联合去噪出视频和动作;动作下发执行;执行完把真实观测帧写回 KV cache 替换预测帧。这一步是 WAM 独有的便宜——纯视频生成模型没有「真实未来」可以回填,误差只能一路滚下去。
论文反复强调一个经验观察:生成视频的质量直接决定动作质量。Figure 16 的失败案例里,机器人并不是「动作算错了」,而是「视频先预测错了,然后忠实地执行了错误计划」。
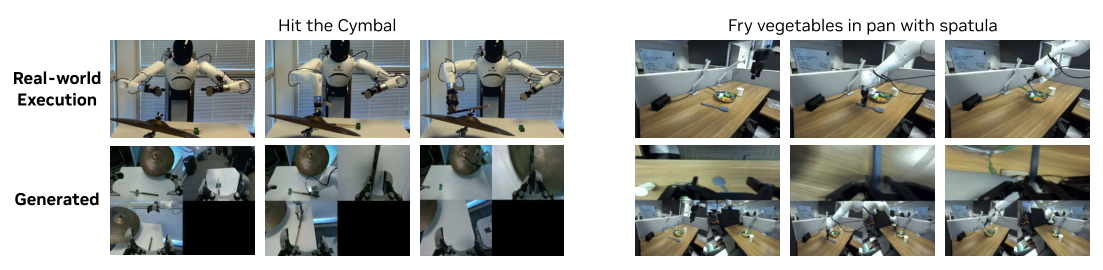
这张图是「视频-动作对齐」最直观的证据:上排是模型生成的未来帧,下排是真实机器人执行同一段动作的录像(示例来自完全没见过的任务——敲镲、用锅铲炒菜)。可以看到夹爪的接近方向、接触时刻、物体被推动的轨迹,与生成帧基本同步。作者用这类样本支撑一个判断:动作不是独立预测出来的,而是从「已经想好的视觉未来」里反推出来的;因此视频预测一旦跑偏,动作会「认真地做错事」(见 Figure 16)。这也是后面所有消融都围绕视频骨干和视频质量展开的原因。
2. 注意力掩码:谁能看谁,写死在一张图里
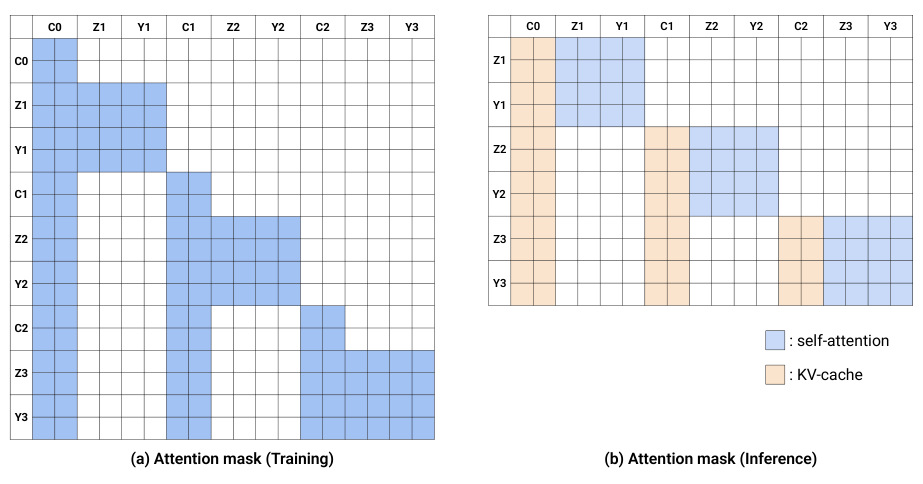
(a) 训练时的 QKV 掩码:横轴是 Key/Value,纵轴是 Query。给定条件帧 C₀、C₁、C₂,模型要预测下一批帧 Z₁、Z₂、Z₃ 和动作 Y₁、Y₂、Y₃。可以看到:
- C 行是下三角:第 i 个条件帧只能看它自己和更早的条件帧;
- Z/Y 行能看全部历史 C,且同一 chunk 内视频帧与动作互相可见(保证视频-动作对齐),但不能看未来 chunk;
- 因此一次前向就能对整条轨迹做「轨迹级更新」,不用逐 chunk 串行反传。
(b) 推理时把条件帧的 KV 缓存算好、拼上当前 chunk 的查询,动作 Y₃ 能同时注意到 C₀、C₁、C₂——这就是「有状态策略」的来源,模型天然拥有约 6 秒的视觉记忆。
3. 为什么坚持自回归:不是口味问题,是对齐问题
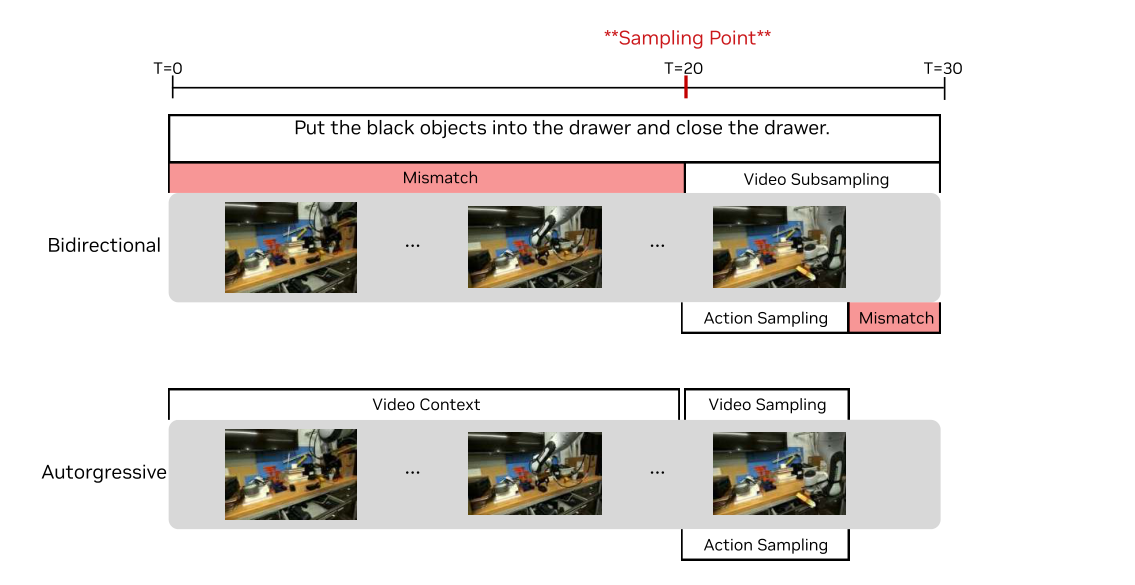
这张图值得所有做长程操作的人看三遍。任务指令是「把黑色物体放进抽屉并关上抽屉」,采样点落在任务中段 T=20:
- 双向模型:语言标注对应整段任务,但固定长度窗口只能覆盖任务的一小段。要么不抽帧——语言说的事还没发生,图文不匹配;要么抽帧对齐——原生帧率被破坏,「第几帧对应第几个动作」的时序关系被搅乱,闭环训练时从任意时刻起手的样本全都变形。
- 自回归模型:直接以视频上下文为条件,既不抽帧也不改帧率,语言、视频、动作三者的对齐在所有采样点上都成立。
配套的消融(Table 4)显示:AR 与 BD 在 PnP-Easy 上任务进度都是 50%,但 AR 的动作明显更平滑,且推理因 KV cache 快 3–4 倍。所以作者的选择不是「AR 更准」,而是「AR 更平滑、更快、更好训」。
4. DreamZero-Flash:把「少步推理」的训练/测试错配补上
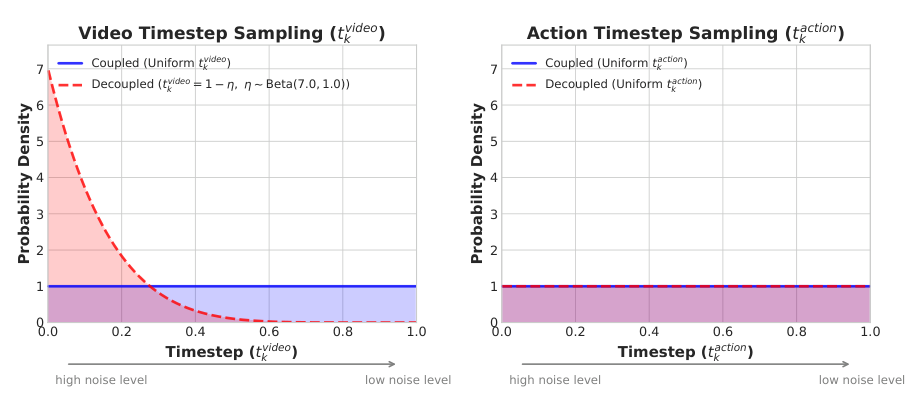
实时化的最后一关是去噪步数。但直接把 16 步砍到 4 步甚至 1 步会掉点,原因是训练与推理的噪声状态不一致:
- 标准 DreamZero 对视频和动作采同一个 t ~ U(0,1)(图中蓝线,两条都均匀);
- 推理时若只走 1–2 步,动作要「一步到位变干净」,而视频还停在很高噪声的状态——训练时模型从没见过「动作干净、视频很脏」的组合。
DreamZero-Flash 的做法是给视频单独偏置噪声表:t_video = 1 − η,η ~ Beta(7, 1),均值 0.125,即视频绝大多数时候处于高噪声(图中红线集中在左侧高噪声区);动作仍保持均匀采样。这样训练分布就覆盖了「从含噪视觉上下文预测干净动作」的情形,正好匹配少步推理。
结果(Table 3,table bussing 任务):4 步 DreamZero 83%,硬砍到 1 步掉到 52%;Flash 单步 74%,只比 4 步低 9 个点,速度从 350ms 到 150ms(2.33×)。论文还有一个小细节:动作块生成后做 2× 上采样 + Savitzky-Golay 滤波 + 下采样,用来压高频抖动。
5. 实时化的完整账本
Table 1 把加速拆得很清楚(每行包含上面所有优化):
| 优化 | H100 | GB200 |
|---|---|---|
| Baseline | 1× | 1.1× |
| + CFG 并行(条件/无条件分两张卡) | 1.9× | 1.8× |
| + DiT 缓存(速度余弦相似度高就复用,16 步→4 步) | 5.5× | 5.4× |
| + torch.compile + CUDA Graphs | 8.9× | 10.9× |
| + cuDNN attention + 调度器上 GPU | 9.6× | 14.8× |
| + NVFP4 量化(QKV/Softmax 保 FP8,非线性保 FP16) | — | 16.6× |
| + DreamZero-Flash | — | 38× |
最终 5.7 秒 → 约 150 毫秒,2 张 GB200 上以 7Hz 出动作块。作者也坦白:除 DiT 缓存和量化外,其余优化在数学上等价,测不出性能损失。
📊 数据与实验设置:先看数据长什么样
6. 500 小时、22 个真实场景:故意不重复
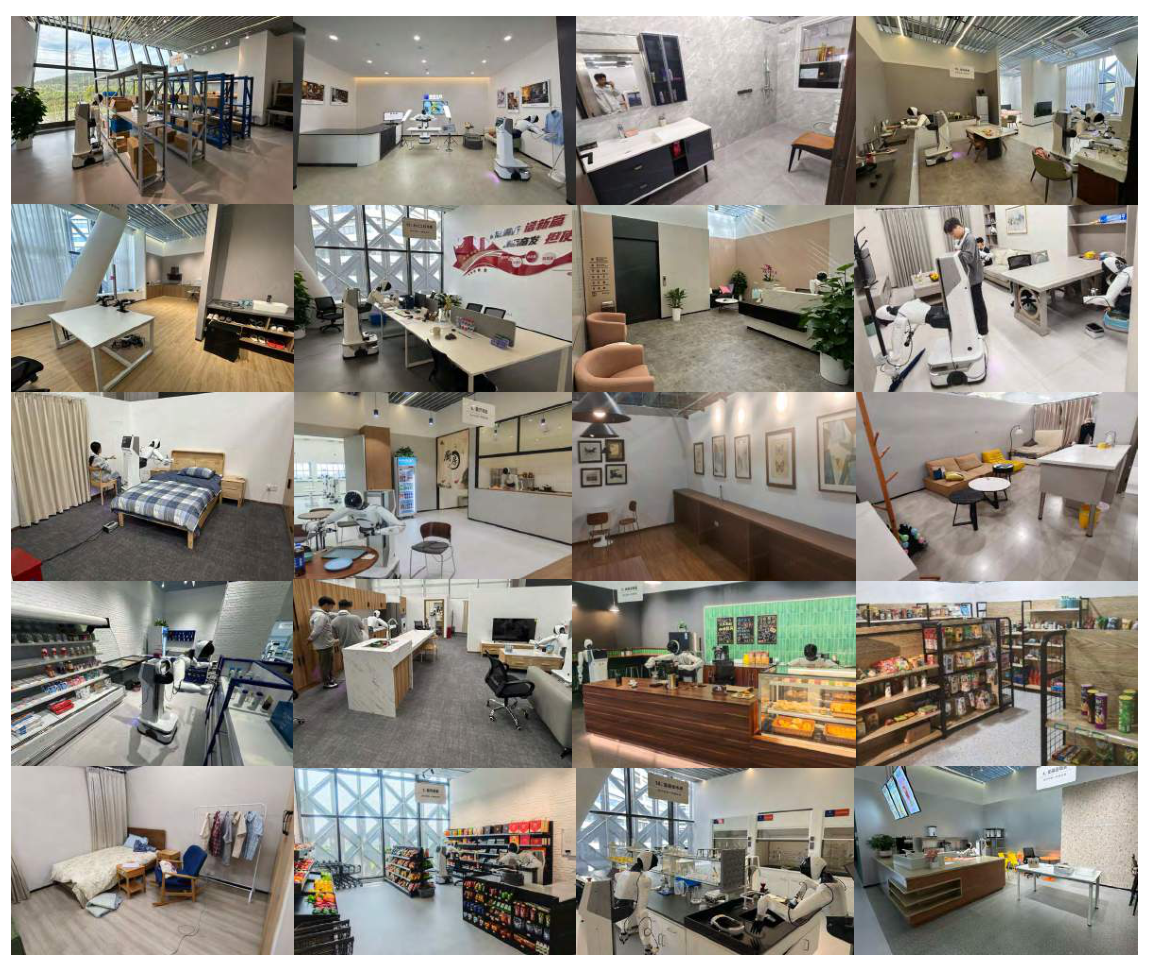
22 个环境覆盖办公室、实验室、餐厅、超市、咖啡店、仓库、住宅、酒店、零售店。采集哲学与主流 VLA 相反:要广度,不要重复。理由是——只学「观察→动作」的模型必须从噪声很大的状态-动作对里隐式推断动力学,所以需要大量重复来压低方差;而 WAM 已经会预测未来,剩下要学的是逆动力学(从「未来画面」反推「此刻动作」),逆动力学需要的是多样化的状态-动作对应,重复数据反而没用。
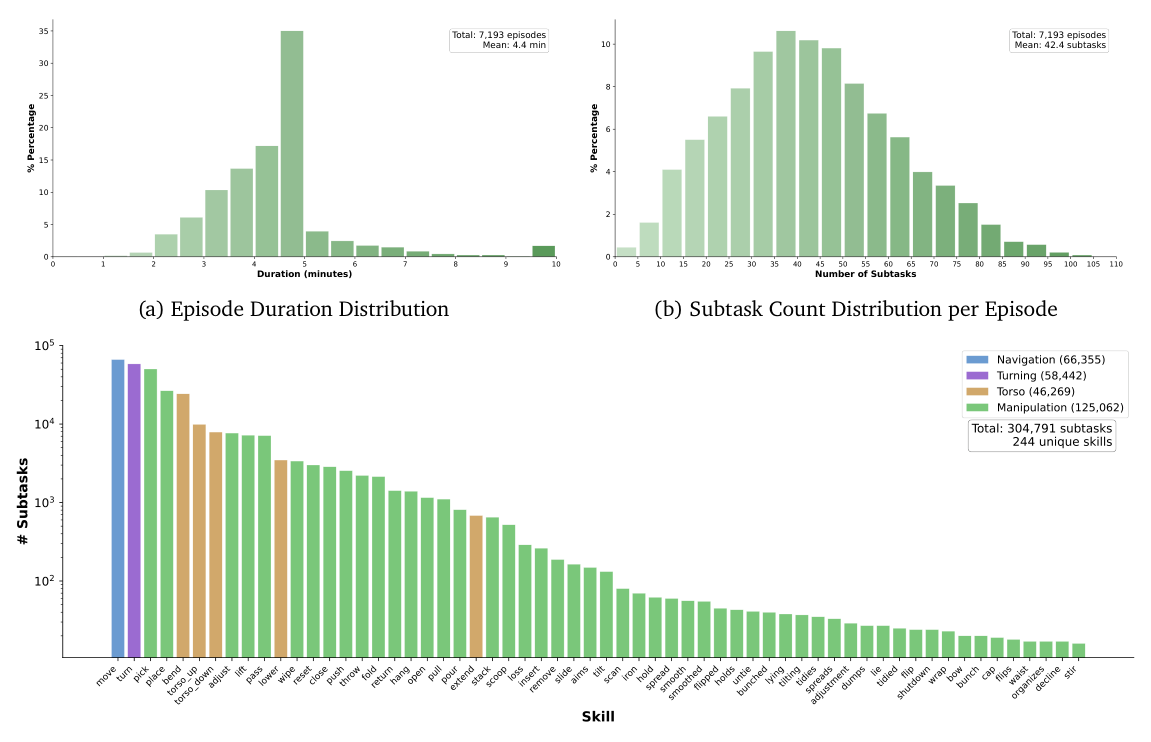
三个子图分别是:episode 时长分布(均值 4.4 分钟,远长于常见操作数据集)、每条轨迹的子任务数(均值 42.4 个)、技能覆盖(导航用于跨工位移动,躯干调整用于够高处的架子/柜子)。总计 7,193 条、约 500 小时。Franka 单臂则用公开的 DROID 数据集,保证可复现。
7. 评测设置:默认就是「没见过环境 + 没见过物体」
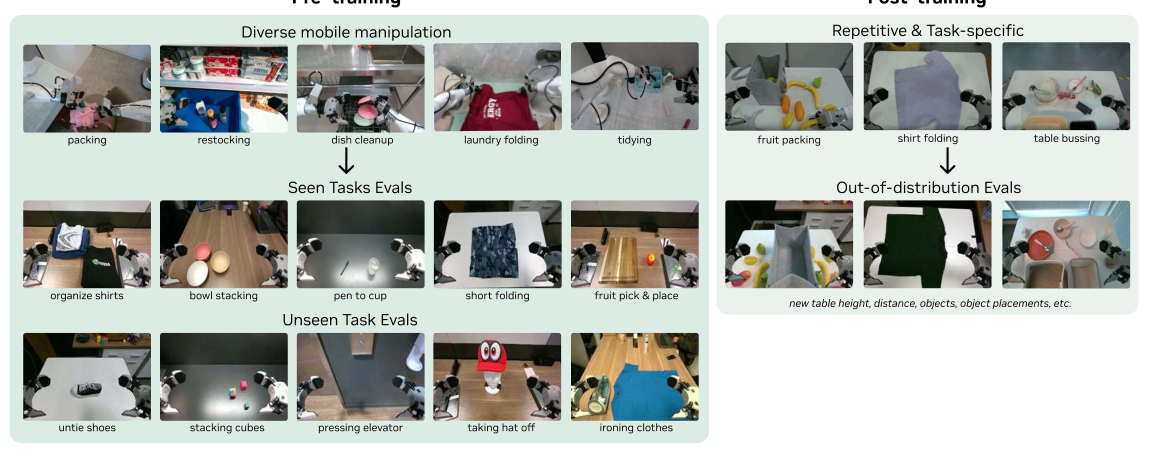
图里把评测分成三层:seen tasks(训练分布内的任务,但换环境/换物体)、unseen tasks(训练中完全没有的运动技能,如熨衣服、系鞋带)、以及 after post-training 的下游任务。因为采集地和评测地不在同一个地理区域,论文声称「每个基准天然都是分布外泛化,而不是插值」。
具体协议:AgiBot 上 seen 10 个任务、unseen 10 个任务,每任务 8 次 rollout、4 台机器人、不同环境与物体(每 checkpoint 共 80 次);DROID 上 20 seen + 20 unseen,每任务 2 次(共 80 次)。基线是 GR00T N1.6 与 π0.5,各跑「from scratch」和「from pretrained」两版,训练数据、batch size、梯度步数与 DreamZero 对齐。
🧪 结果:四张图回答四个问题
8. Seen 任务:从异构数据里真的学得动
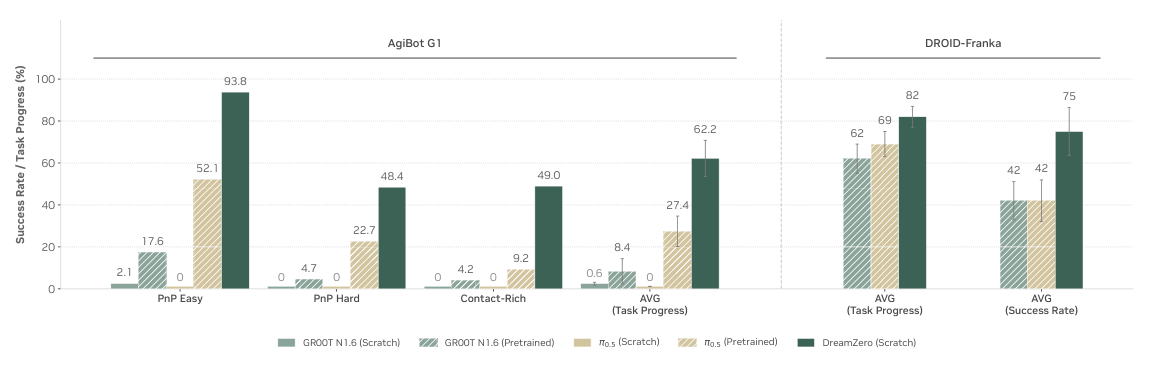
横轴按 PnP-Easy、PnP-Hard、Contact-Rich 和平均值分组,纵轴是任务进度/成功率。两个最刺眼的事实:
- from-scratch VLA 几乎全零:即使是最简单的抓放,也会「伸向正确物体但抓不准」。说明 VLA 从零学「观察→动作」在异构数据上非常吃力;
- 预训练 VLA 也只有 27.4%,而 DreamZero 是 62.2%,超过两倍。注意预训练基线还额外吃过数千小时跨本体机器人数据,DreamZero 只吃了这 500 小时。
DROID-Franka 上趋势一致。作者把差距归因于联合视频-动作建模:视频生成提供了一个极强的先验,模型不需要从零建立「像素→电机指令」的映射。
9. Unseen 任务:零样本做没见过的运动
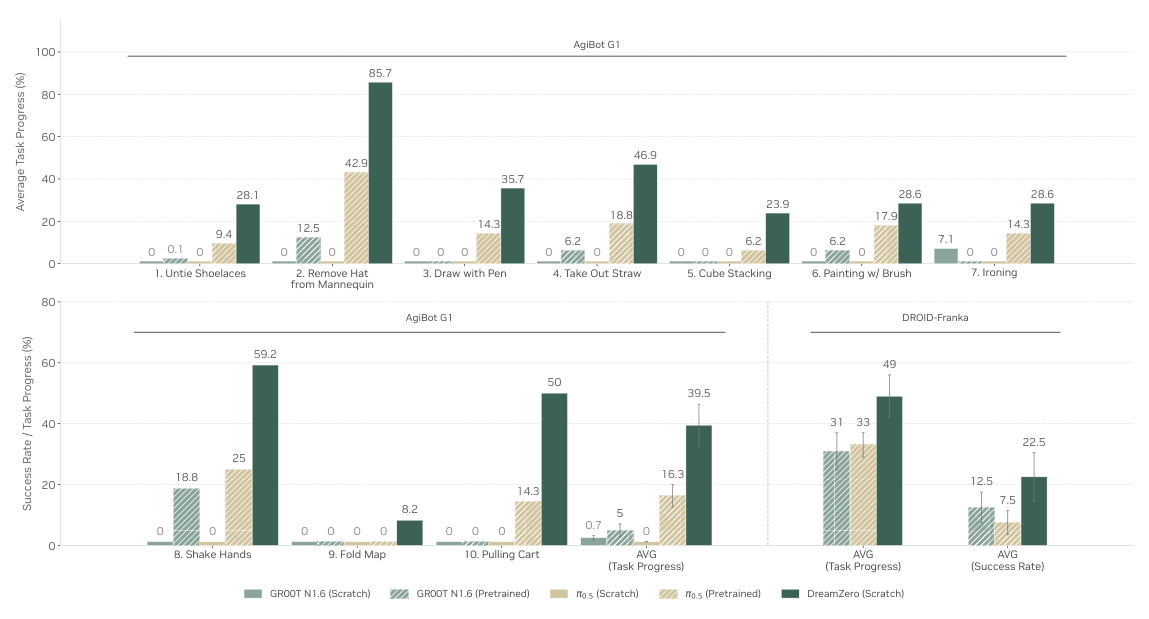
10 个训练中完全不存在的任务:系鞋带、摘人体模型上的帽子、用笔画画、取吸管、叠方块、刷漆、熨衣服、握手、折地图、拉小车。结果:
- AgiBot 上 from-scratch VLA <1%,DreamZero 39.5%,预训练 VLA 16.3%;
- 单项里「摘帽子」85.7%、「握手」59.2% 相当高;
- DROID-Franka 上 DreamZero 49% 任务进度 / 22.5% 成功率,GR00T 31% / 12.5%,π0.5 33% / 7.5%。
定性观察很关键:预训练 VLA 面对新指令时经常「不管指令是什么都去抓东西」,这是对训练里占主导的抓放行为的过拟合;DreamZero 则先做视觉规划再执行,生成的视频与真实执行高度一致。
10. 后训练:泛化不会在微调后消失
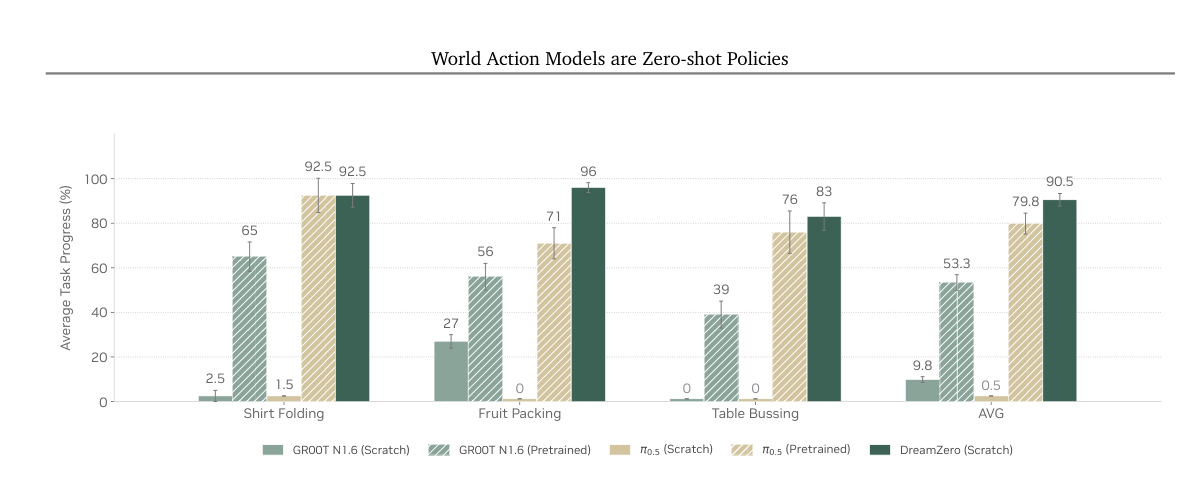
三个下游任务:折衬衫(33 小时)、装水果(12 小时)、收桌子(40 小时),每任务后训练 50K 步,评的是平均任务进度。DreamZero 平均 90.5%,π0.5 预训练版 79.8%,GR00T 预训练版 53.3%,from-scratch 基线基本个位数。折衬衫和收桌子是「打平或略胜」,装水果则大幅领先(96% vs 71%)。
论文特别指出:后训练评测仍在未见环境里做,所以这说明「环境泛化能力在后训练之后被保留了下来」,而不是被任务数据冲掉。
11. 跨本体迁移:只给视频,不给动作
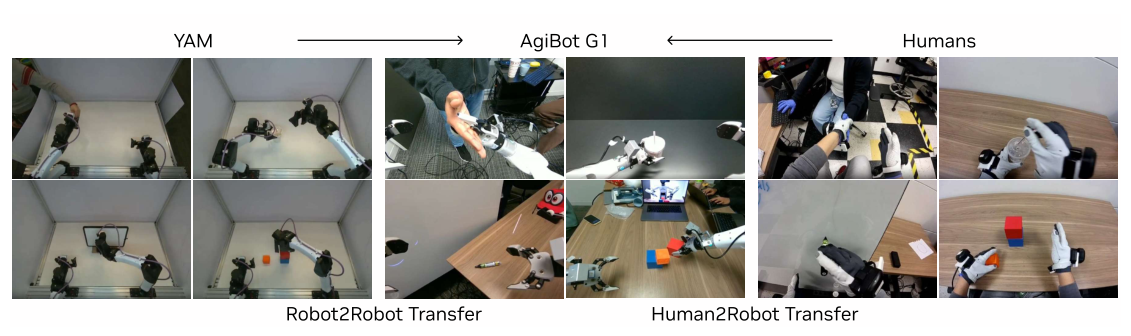
两条路径:机器人→机器人(YAM 双臂 → AgiBot G1)与人类→机器人(第一视角人类演示 → AgiBot G1)。每条路径只采 72 条多视角轨迹(9 个未见任务 × 8 条,YAM 20 分钟、人类 12 分钟),以 1:1 混入预训练数据、只训 10K 步。跨本体数据只用视频预测目标,没有动作标签。
| 方法 | 任务进度 |
|---|---|
| DreamZero(基线) | 38.3% ± 7.6% |
| + Human2Robot 迁移 | 54.3% ± 10.4% |
| + Robot2Robot 迁移 | 55.4% ± 9.5% |
机器人→机器人增益更大,因为 YAM 和 AgiBot 都是双臂平行夹爪,本体差距小;人类→机器人差距大(形态、视角都在变),但仍有 +16 个点。这条结果的意义在于打开了一条不需要动作标注的扩展路径:人类视频比机器人数据大几个数量级。
12. 少样本换本体:30 分钟 play data
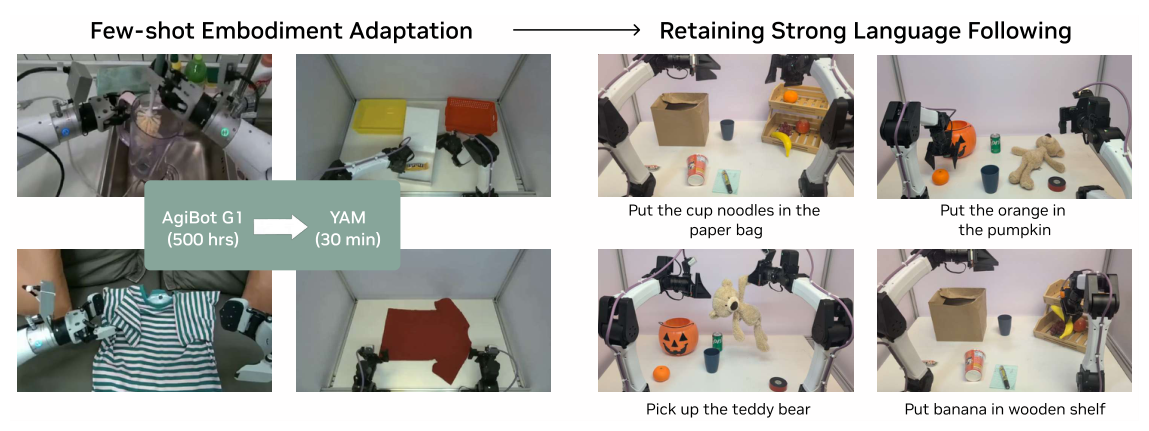
把 AgiBot 预训练 checkpoint 后训练到全新的 YAM 上,只用 55 条轨迹、11 个任务、约 30 分钟「玩耍数据」。结果不仅保住了语言跟随,还能对训练中没见过的物体(南瓜、泰迪熊、杯面、纸袋、笔)做零样本组合,比如「把杯面放进纸袋」「把香蕉放到木架上」。
作者给出两个解释:一是两个本体视觉上接近(都是双臂平行夹爪);二是更本质的——从预测视频里学隐式 IDM,可能比直接学策略更样本高效:模型只需要学「视觉未来 → 动作」的映射,物理动力学已经由视频预训练提供。
13. 自由形式任务:100+ 个口头指令
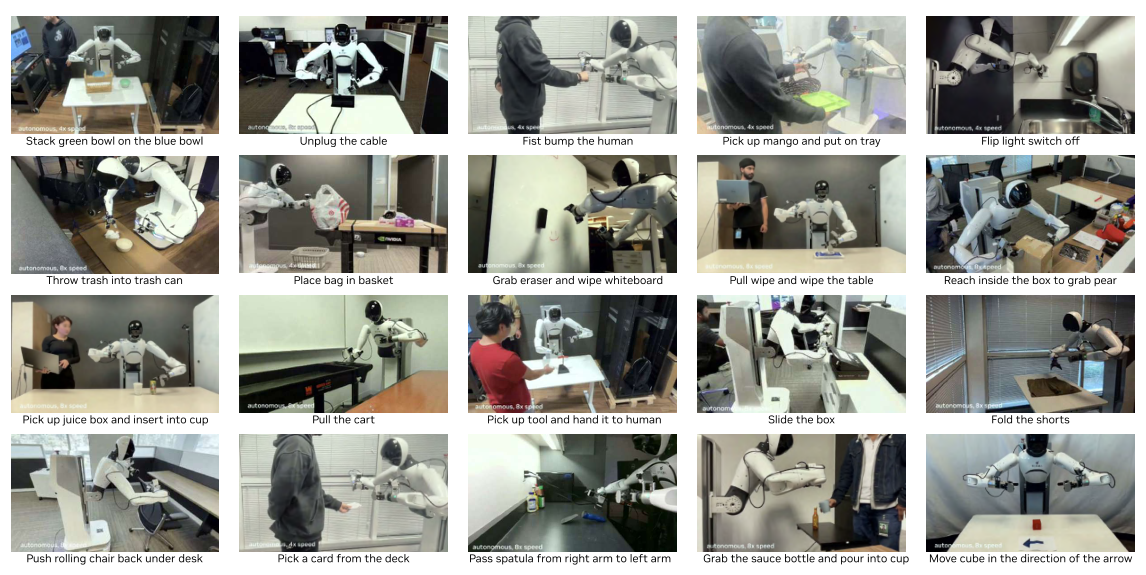
除了结构化基准,作者还用自然语言口头下指令,测了 100 多个任务:敲镲、倒垃圾、把果汁盒插进杯子、推椅子回桌下、抽牌、右手把锅铲递给左手、倒酱汁、按箭头方向移方块、拉车、把工具递给人类、擦白板、拉纸巾擦桌子、伸进箱子拿梨、拔插头、和人类碰拳……覆盖工具使用、人机交互、精细操作。这组图主要用于展示「语言条件 + 世界模型」的组合广度,不是定量结论。
14. 失败案例:错在视频,不在动作
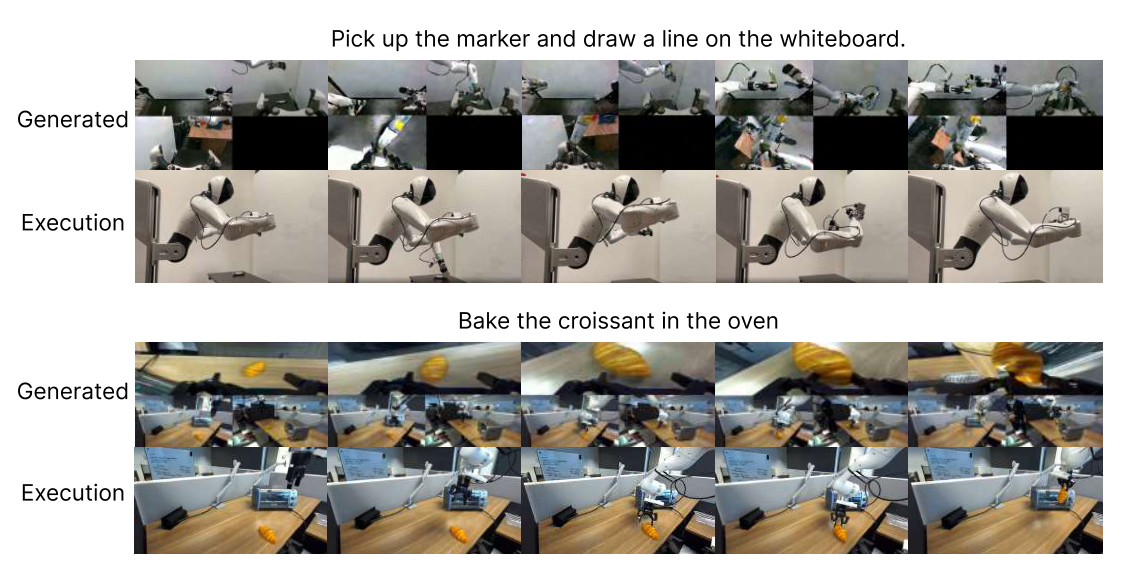
两个例子:AgiBot 在白板上画画时,视频没能生成正确的「手臂+笔」轨迹;Franka 开烤箱时,视频先预测了一个错误的开门顺序,机器人照做了。动作解码器忠实地执行了错误的视觉计划。这既是局限,也是好消息——它意味着改进视频骨干会直接改进策略,而不需要重新设计动作头。
🔬 消融:什么在真正起作用
Table 4 在 PnP-Easy 上做三组消融(都训 50K 步、batch 32):
| 问题 | 设置 | 任务进度 |
|---|---|---|
| 数据多样性 | 500h 重复数据(70 任务、大量重复) | 33% ± 4.2% |
| 500h 多样数据 | 50% ± 6.3% | |
| 模型规模 | 5B + 多样数据 | 21% ± 4.2% |
| 14B + 多样数据 | 50% ± 6.3% | |
| VLA 规模 | VLA 5B / 14B + 多样数据 | 0% / 0% |
| 架构 | 双向 14B | 50% ± 14.4% |
| 自回归 14B | 50% ± 6.3% |
三个结论:
- 多样性 > 重复性,同样 500 小时差 17 个点。作者的解释是视频预测能力基本继承自预训练,真正要学的是 IDM,而鲁棒的 IDM 需要跨上下文的状态-动作对应。
- WAM 有明显的规模收益(5B→14B 翻倍以上),5B 模型容易产生视觉幻觉并把幻觉传成错误动作。而 VLA 即使放大到 14B,在异构数据上仍是 0%——只扩容量解决不了数据分布问题。
- AR 与 BD 精度相当,但 AR 更平滑、快 3–4 倍,所以工程上选 AR。
💡 评析:三个最妙的设计,三条边界
三个最妙的设计
- 把「视频质量」变成策略的第一性指标。Figure 16 的失败分析、5B vs 14B 的规模效应、跨本体只用视频目标——全都指向同一件事:策略能力上限由世界模型决定。这让「换更强的视频骨干」成为一个明确的、可预期的提升杠杆,而不是玄学调参。
- 闭环回填 KV cache。这是 WAM 相对纯视频生成的结构性优势:每一块执行完都有真实观测,误差不会像自回归视频生成那样滚雪球。它同时解释了为什么 AR 在这里可行——换成开放环生成早就崩了。
- Flash 只改训练分布,不改架构。DreamZero-Flash 没有新增网络、没有改推理图,只是把视频噪声表偏向高噪声,就补上了少步推理的训练/测试错配。这种「改数据分布而不是改模型」的思路,迁移成本极低。
三条边界
- 7Hz 仍然不算快。论文自己承认 VLA 在消费级 GPU 上能跑 20Hz+,DreamZero 需要 2 张 GB200;且 150ms 是单块延迟,端到端还要叠加通信、滤波、控制器。真要做到「System 1」,需要更小的视频骨干。
- 记忆只有约 6 秒。作者明确说没有专门评测/后训练「必须依赖记忆才能完成」的任务,长程执行仍要外挂 System 2 规划器或扩展上下文。
- 精度任务未验证。亚厘米级装配(插钥匙、精细组装)是行为克隆的老大难,本文的多样性优先策略可能反而欠采样了这类密集演示;作者只能引用他人的毫米级结果作为乐观信号。
🗺️ 在 WAM 谱系里的位置
| DreamZero | VPP2 | Flash-WAM | π0.5 | |
|---|---|---|---|---|
| 类型 | WAM(AR 联合去噪) | WAM(视频预训练 + 动作专家) | WAM 蒸馏框架 | VLA |
| 骨干 | Wan2.1-I2V-14B | Wan2.1-I2V-14B + 0.9B 动作 DiT | LingBot-VA / Motus | 3.3B VLM |
| 动作监督 | 联合视频-动作 | 视频 + MoT 动作专家 | 沿用教师 | 直接动作 |
| 实时性 | 7Hz(2×GB200) | 0.22 s/块 | 347 ms/块(L40S) | 20Hz+ |
| 独门贡献 | WAM 命名、异步闭环、Flash 噪声解耦、跨本体视频迁移 | 事件级视频预训练 + 详细 caption | 模态感知的一致性蒸馏 | 两级推理 |
站内延伸:《WAM 世界行动模型全景分析》、《FLUX 3 Action 精读》、《VPP2 精读》、《Flash-WAM 精读》。
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 总览:WAM 的四种能力 | 开篇 |
| Fig 2 | 联合视频-动作预测示例 | 方法/定性 |
| Fig 3 | 自由形式任务 100+ | 结果 13 |
| Fig 4 | 模型架构(训练/推理) | 方法 1 |
| Fig 5 | 解耦噪声表(Flash) | 方法 4 |
| Fig 6 | 数据分布统计 | 数据 6 |
| Fig 7 | AgiBot 评测设置 | 评测 7 |
| Fig 8 | Seen 任务结果 | 结果 8 |
| Fig 9 | Unseen 任务结果 | 结果 9 |
| Fig 10 | 后训练结果 | 结果 10 |
| Fig 11 | 跨本体迁移 | 结果 11 |
| Fig 12 | 少样本本体适配 | 结果 12 |
| Fig 13 | 双向 vs 自回归 | 方法 3 |
| Fig 14 | 注意力掩码 | 方法 2 |
| Fig 15 | 22 个采集环境 | 数据 6 |
| Fig 16 | 失败案例 | 结果 14 |
表格:Table 1 加速账本(方法 5)、Table 2 跨本体迁移(结果 11)、Table 3 Flash 评测(方法 4)、Table 4 消融(消融节)。
❓ 自测 Q&A
Q1:DreamZero 与「先视频生成、再逆动力学」的两段式 WAM 有什么本质区别? A:两段式是两个独立模型,视频预测的误差无法通过动作损失回传;DreamZero 是一个模型、一个联合 flow-matching 损失,视频与动作在同一 DiT 里去噪,梯度共享。论文认为这让两个模态的对齐更深,也让视频预训练的先验更完整地迁移到动作上。
Q2:为什么训练时视频和动作共享同一个 t,而 Flash 又要把它们解耦? A:共享 t 让训练初期收敛更快,且同一 chunk 内两模态噪声水平一致、便于联合去噪。但少步推理时动作必须一步变干净、视频仍很脏,共享 t 的训练分布覆盖不到这种组合。Flash 把视频 t 偏向高噪声(Beta(7,1),均值 0.125)、动作保持均匀,从而对齐少步推理的真实情形。
Q3:既然闭环可以用真实帧替换预测帧,为什么还要担心误差累积? A:替换只发生在块与块之间。块内的动作仍依赖块内的视频预测;如果视频预测错了,动作会忠实地执行错误计划(Figure 16)。回填解决的是跨块漂移,不解决块内规划错误,所以视频骨干质量仍是上限。
Q4:跨本体迁移为什么可以不用动作标签? A:训练目标里视频预测项只需要视频,不需要动作。加入 YAM/人类视频时只开视频预测损失,相当于给世界模型补充「别的本体怎么做这件事」的视觉经验;隐式 IDM 仍然由有动作的 AgiBot 数据提供。
Q5:消融里 VLA 放大到 14B 仍是 0%,说明了什么? A:说明异构数据上的失败不是容量问题,而是目标函数问题。VLA 必须从噪声很大的状态-动作对里隐式推断动力学;WAM 把这部分交给视频预测,剩下的只是逆动力学映射,所以能利用多样性。这也是论文主张「数据哲学要变」的根据。
Q6:7Hz 是怎么算出来的,瓶颈还在哪? A:每块 48 步动作、30Hz 控制 → 1.6 秒/块;2 张 GB200 上推理约 150ms,理论可到 7Hz 左右。瓶颈仍是 14B 参数 + 视频 token 的迭代去噪,作者认为下一步要靠更小的视频骨干或更强蒸馏。
📚 资源与延伸
- 论文:arXiv 2602.15922
- 项目页:dreamzero0.github.io(评测 rollout、训练数据样例、YAM play data 全量可视化)
- 代码:github.com/dreamzero0/dreamzero(DROID 推理与 PolaRiS 仿真评测)
- 站内延伸:《WAM 世界行动模型全景分析》、《什么是世界模型》、《Flow Matching 入门详解》、《DROID 机器人操作数据集精读》