📄 论文信息
- 标题:DriveVLA-M0: Failure-Aware Memory Augmentation for Autonomous Driving
- 团队:中科院自动化所(CASIA / NLPR)× 长安科技(Chongqing Chang’an Technology)
- 发表:arXiv:2608.10413(2026 年 8 月);ACM MM 2026(第 34 届 ACM 国际多媒体会议,里约热内卢)
- 代码:
github.com/ZebinX/DriveVLA-M0 - 一句话总结:给 VLA 自动驾驶装上一个"失败记忆库"——离线把模型表现差的长尾场景连同路网/交互结构存进 latent memory,在线按结构相似度检索,再用解耦 LoRA 做测试时训练逐场景纠正,让模型"吃一堑长一智"。
🤔 要解决什么问题?
VLA 会"屡教不改":同样的坑掉两次
现有 VLA 自动驾驶模型有个被忽视的通病:模型在相似场景下反复犯同样的错误。它没有能力把"当前处境"和"过去失败"关联起来——今天在这个路口没刹住,明天换个时间出现在同一个路口,它还是没刹住。
论文从人类认知借来洞察:人之所以越开越稳,是因为大脑会把当下处境和历史错误关联起来,预测当前情境出错的概率,从而提前调整行为(Brown & Braver 2005, Botvinick 2001)。而现在的 VLA 模型没有"记忆"这个器官——训练完参数就固定了,上线后遇到分布偏移(新的城市、新的交通习惯)只能硬扛。
🎯 核心问题:如何让 VLA 模型"记得过去的失败",并在遇到相似场景时用这些失败经验纠正自己?
为什么"拿语言特征当检索键"不够?
直觉做法是把 VLA 的中间语言特征(F_lang)当检索键,从记忆里找相似场景——这是 MemoryVLA 等具身智能记忆系统的常见做法。但论文指出驾驶规划场景下这样检索是失灵的,因为自动驾驶决策高度依赖两类内在结构信息:
| 信息类型 | 内容 | 为什么关键 |
|---|---|---|
| 动态信息(dynamic) | 周围 agent 的运动、交互 | 决定碰撞风险(NC/TTC) |
| 场景结构(structure) | 道路拓扑、车道线、边界 | 决定可行驶区域(DAC/EP) |
语言特征捕捉的是高层语义(“前面有辆车”),却忽略结构属性(“这车在哪个车道、路怎么拐”)。用语言特征检索,可能召回"语义上相关但结构上完全不同"的场景——这种检索对驾驶决策毫无帮助。
💡 核心思路:记忆增强 + 测试时训练(TTT)
一句话:离线把"失败"写进记忆,在线按"结构"检索,再按场景临时微调。
DriveVLA-M0 的关键洞察有两个:
- 结构检索(Structural Retrieval):检索键必须基于场景级结构相似度(动态 + 物理结构),而不是视觉-语言相似度;
- 失败感知(Failure Awareness):记忆里只存模型表现差的场景——聚焦长尾、安全关键情境,而不是均匀采样。
整个框架分成两个阶段:
- 离线(Memory Generation):用 oracle 仿真打分器识别失败场景,把它们的中间表示(场景嵌入、轨迹簇、专家信号)写进 latent memory;
- 在线(Inference with TTT):用 Retrieve Model 检索结构相似的失败案例,通过解耦 LoRA对动作解码器做测试时训练,逐场景定向纠正,最小化开销。
🎯 记忆和 TTT 的协同是关键:记忆提供"过去的失败经验",TTT 让模型"临场消化"这些经验。二者结合,让模型在原本容易失败的场景上稳住,同时应对分布偏移——且不需要大规模重训。
🧩 整体架构拆解(论文核心图)
图 1:DriveVLA-M0 与经典 VLA 的范式对比
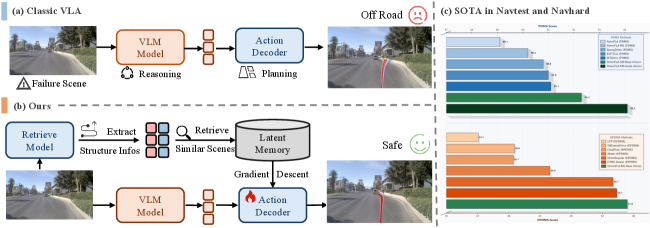
🔍 图 1 怎么读?
这张图是**“范式对比图”**,画了三种状态的对比:
- (a) 经典 VLA:图像 + 指令 → VLM 场景推理 → Action Decoder 出轨迹。模型没有记忆器官——红色轨迹是模型基于训练分布的"惯性选择",无论之前在这个场景栽过几次跟头,它都不会吸取教训;
- (b) DriveVLA-M0:VLM 推理的同时,Retrieve Model 去 latent memory 里捞结构相似的失败案例,把这些案例经 LoRA 测试时训练注入 Action Decoder——注意图和 (a) 的差别就在多了中间那条"记忆 → 检索 → 注入"的通路;
- (c) 成绩单:左蓝右橙两个条形图分别是 Navtest 和 Navhard,DriveVLA-M0 都拔得头筹。
读图关键:(a) 到 (b) 之间不是换了模型,而是给模型加了一个"外挂记忆 + 检索 + 临时微调"的三件套。
图 2:DriveVLA-M0 完整总装图(全文最重要的图)
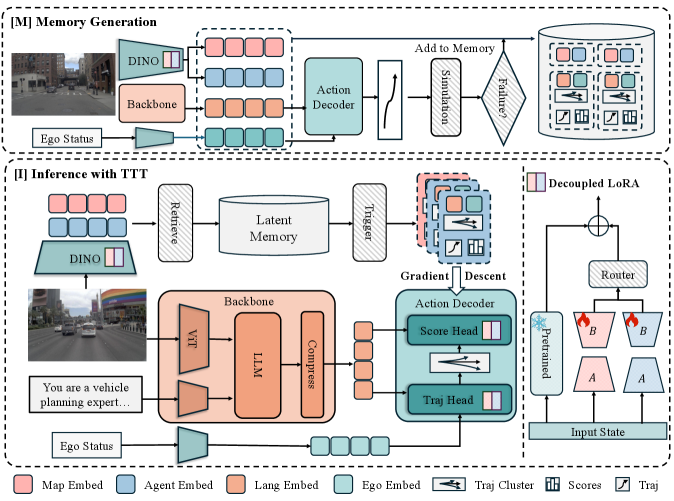
🔍 图 2 怎么读?(按上下两半 + 中缝读)
这张图是全文的"总装图",分三部分读:
- 上半([M] 离线 Memory Generation):Base Model 在历史数据上跑推理 → oracle 打分器 PDM 评估 → 低于阈值 β 的判为失败 → 连同 Retrieve Model 提取的路网/agent 结构表示、Base Model 缓存的规划表示一起写入 latent memory。右侧的记忆池里能看到每条记忆的三元组
(k, x, y); - 下半([I] 在线 Inference with TTT):当前场景经 Retrieve Model 提取查询键 → 从记忆池检索结构相似案例 → Decoupled LoRA 对规划头做测试时训练(只动解码器、不动 VLM 骨干)→ 出修正后的轨迹;
- 中缝的联动:上半"写入"的记忆,就是下半"检索"用的记忆——同一份记忆库在离线与在线之间复用,这是"记忆增强"闭环的关键。
架构图核心读法:看"谁产生记忆、谁消费记忆"。Base Model 和 Retrieve Model 产生记忆(离线),同一个 Retrieve Model + 解耦 LoRA 消费记忆(在线)——记忆是连接两阶段的"缓存层"。
🧩 架构讲解:输入 → 模型 → 输出
📍 架构图在这:论文的完整架构是 图 2(Figure 2)——它同时画了"离线写记忆"和"在线 TTT"两条流程,是全文总装图。下面先用一张我自己画的流程图把整体数据流讲清楚。
① 输入是什么?(2 类)
| 输入 | 类型 | 作用 |
|---|---|---|
前视图像 I | 视觉 | 同时进 Base Model(做场景理解与规划)和 Retrieve Model(提结构检索键) |
系统指令 T / 自车状态 | 文本 / 向量 | 进 Base Model,作为语言指令与运动状态条件 |
② 中间经历了什么?(离线 + 在线两条线)
- 离线:Base Model 出轨迹 → PDM oracle 打分 →
Q(τ̂) < β判失败 → 把(k, x, y)写进 latent memory(k=结构键、x=解码器输入、y=监督标签); - 在线:Retrieve Model 提结构键 → Trigger 按相似度门控 → 检索 top-k 失败案例 → Decoupled LoRA TTT 微调 Action Decoder → 路径感知分数融合选轨迹。
③ 输出是什么?(1 类)
一条可执行的未来轨迹 τ̂。模型不直接回归,而是先生成 M 条候选轨迹簇 𝕋̂ ∈ ℝ^{M×8×3},再用 Score Head 打分选出最优——失败记忆纠正的正是"打分器的偏好",让模型从"不敢选"变"敢选对"。
🧠 模块一:Base Model(VLM 骨干 + 两阶段解码器)
3.1 VLM Backbone:InternVL3 + Q-Former 压缩
Base Model 的视觉语言部分沿用 RecogDrive 的配方:
- 骨干用 InternVL3,在大规模自动驾驶问答数据(RecogDrive 聚合的 12 个公开数据集,含 Talk2Car、SUTD、NuScenes-QA、OmniDrive 等,共 310 万 QA 对;过滤后约 77.5 万对用于 NAVSIM 训练)上做领域预训练;
- 前视图像 + 系统提示 → 双编码器 → 统一特征空间 → LLM 模块,取 LLM 最后一层特征
h^{-1}作为中间场景表示。
但 h^{-1} 维度高达 2800 × 1536,直接存记忆/算注意力开销过大。因此引入 Q-Former 式压缩模块:
其中可学习 query Q_cmp ∈ ℝ^{16×256},把 h^{-1} 压成 16 个 token、256 维的紧凑特征 F_lang——约 1050 倍压缩。注意:压缩模块只在训练 Action Decoder 时联合训练,不参与 VLM 预训练。
3.2 Action Decoder:Trajectory Head + Score Head(iPad 式)
解码器走 score-based planning 两阶段路线(iPad 范式):
① Trajectory Head(出候选轨迹):先经轻量 MLP 把自车状态压成 F_ego ∈ ℝ^{1×D},再与 F_lang 联合解码出 M 条轨迹的轨迹簇:
其中 Q_ego 是可学习 embedding,引导 M 个多样的轨迹模式。轨迹监督用 min-over-N 的 L1 损失:
min 形式鼓励轨迹多样化,保证至少一条接近人类示范。
② Score Head(打分选优):把轨迹簇重新编码为 F'_proposals,融合 F_lang 后为每条候选预测 K 个安全子分数(碰撞率、可行驶区域合规等):
打分用 BCE,软标签来自 PDM oracle 给每条候选打的真实质量分 s_i ∈ [0,1]。得分最高的轨迹作为最终输出 τ̂。
🎯 Base Model 的定位:它是"记忆系统的土壤"——失败场景的记忆正是围绕它的中间表示
F_lang/F_ego/𝕋̂构建的,TTT 也作用在它的解码器上。
🧠 模块二:Retrieve Model(结构检索的关键,重点讲解)
📍 这是本文最重要的架构图(图 5),读懂它就懂了一半的"结构检索"思想。
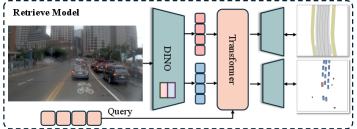
🔍 图 5 怎么读?
这张图是 Retrieve Model 的"结构图",按从左到右读:
- 特征提取器:
DINOv2(轻量预训练视觉模型)做 backbone,用 LoRA 微调——不是全量微调,只插低秩适配器; - Decoupled LoRA 关键设计:把微调拆成 Map(静态)和 Agent(动态)两条 LoRA 分支,同一个输入
I并行过两条分支,同时产出两个解耦特征: $$F_{\text{map}}, F_{\text{agent}} = \mathrm{DINO}_{\text{LoRA}}(I)$$- Map 分支捕捉静态道路结构(边界、车道线、拓扑);
- Agent 分支捕捉动态 agent 上下文(前向车辆等);
- 聚合与解码:每条分支经 Transformer 解码器 + 可学习 query 压成紧凑表示,再用独立的解码头输出 occupancy grid
M̂_map/M̂_agent; - 监督:沿用 TransFuser 的 occupancy-grid 范式,用二元交叉熵监督两张栅格图: $$\mathcal{L}_{\text{Retrieve}} = \mathrm{BCE}(\hat{\mathcal{M}}_{\text{map}}, \mathcal{M}_{\text{map}}) + \alpha \cdot \mathrm{BCE}(\hat{\mathcal{M}}_{\text{agent}}, \mathcal{M}_{\text{agent}})$$
为什么"解耦"这么重要?
论文用注意力可视化(图 3)证明解耦是有效的:
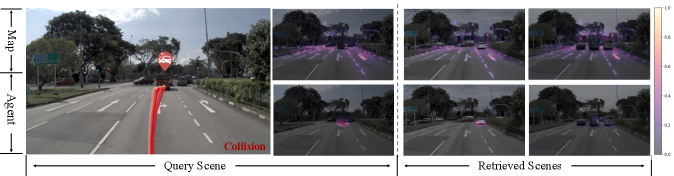
Map 分支的注意力集中在路网结构上(边界、车道线),Agent 分支的注意力集中在动态目标上(前向车辆)。这让检索能"按需命中":
- 想纠正道路结构类错误(压线、偏航)→ 用 map 特征检索;
- 想纠正交互类错误(碰撞风险)→ 用 agent 特征检索。
而且后面 TTT 阶段会复用同一套解耦 LoRA——map 检索喂静态分支、agent 检索喂动态分支,检索和纠正"键值同构"。
🗄️ 模块三:Memory Generation(离线写记忆)
记忆里存什么?
每个记忆案例编码三类信息(结构 𝕄 = {(kᵢ, xᵢ, yᵢ)}):
| 符号 | 内容 | 作用 |
|---|---|---|
| k(检索键) | 静态 map 特征 F_map + 动态 agent 特征 F_agent | 让在线检索"按结构命中" |
| x(适配输入) | 语言嵌入 F_lang + 自车嵌入 F_ego + 轨迹簇 𝕋̂ | 作为 TTT 时解码器的输入 |
| y(监督标签) | 专家轨迹 τ + oracle 打分的轨迹簇分数 𝕊 | 作为 TTT 时解码器的监督 |
怎么判定"失败"?
给定场景,两条支线并行:
- Base Model 跑推理:出预测轨迹
τ̂,缓存中间表示F_lang / F_ego / 𝕋̂; - Retrieve Model 提键:DINO_LoRA 提取
F_map / F_agent; - Oracle 打分:把
τ̂放进仿真,用 PDM 打分器按 K 个安全/舒适子标准打分,聚合为Q(τ̂) ∈ [0,1]; - 阈值判定:
Q(τ̂) < β→ 记为失败场景,写入记忆: $$\mathbb{M} \leftarrow \mathbb{M} \cup \big\{ (F_{\text{lang}}, F_{\text{ego}}, \hat{\mathbb{T}}),\ (F_{\text{map}}, F_{\text{agent}}),\ (\tau, \mathbb{S}) \big\}$$
去重与扩展
- 去重:写入前用 cosine 相似度检查记忆里是否已有足够相似的场景,防止冗余、把记忆池控制在可管理大小;
- 扩展:记忆可以无训练地扩容——用 SimScale 合成数据生成新失败场景直接塞进记忆(论文扩到 10K 条),在线检索到更多相关经验就能持续涨点。这是"记忆规模即收益“的免费扩展路径。
⚡ 模块四:Inference with TTT(在线纠正,重点讲解)
📍 这张图(图 4)展示了 TTT 注入为什么有效——它是"记忆系统"最后一步的机制验证。
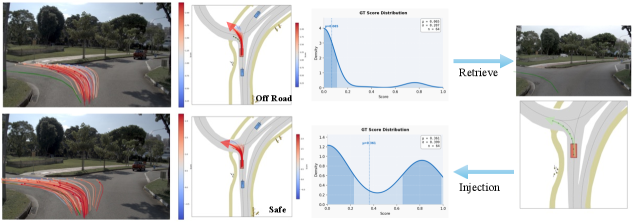
检索(Retrieve from Memory)
在线阶段,当前前视图像 I 过 Retrieve Model 提取 F_map、F_agent 作为查询键,分别按 map 级和 agent 级检索 top-k 最相似案例。取回的 x = (F_lang, F_ego, 𝕋̂) 和 y = (τ, 𝕊) 用于微调。
Trigger 门控:只在"可能翻车"时出手
TTT 微调不是无条件触发的——引入一个基于 cosine 相似度的二值开关:
$$g = \begin{cases} 1, & \text{if } \dfrac{F^\top F^{*}}{\|F\|_2 \|F^{*}\|_2} > \lambda \\ 0, & \text{otherwise} \end{cases}$$F* 是从记忆里检索到的特征。只有当当前场景和某个失败案例结构足够相似(λ=0.9 最优)时才激活 TTT,否则直接返回 base 轨迹 τ̂₀。消融显示:λ 太松(0.7)会引入噪声检索、NC/TTC 反而下降;λ 太严(0.99)几乎不触发,性能掉到 89.4 甚至低于基线——“选择性适应"比"无差别微调"更有效。
Decoupled LoRA TTT:低成本、场景定制
一旦触发,用 LoRA 只微调 Action Decoder 的规划头(不动 VLM 骨干):
- 采用与 Retrieve Model 同款解耦设计:map 检索的案例喂 Map(静态)LoRA 分支,agent 检索的案例喂 Agent(动态)LoRA 分支;
- LoRA 权重每个测试场景重新初始化——保证严格"场景专属"适应,不把上个场景的经验带过来;
- 微调用 AdamW,lr=2e-4,3 步即可(附录 D 显示 1 步也有 92.0+ PDMS,且对超参极鲁棒,PDMS 波动 ≤0.3)。
路径感知分数融合
微调后两条分支各自独立打分:
- 道路理解类子分(如可行驶区域合规 DAC)→ 用静态 LoRA 的预测;
- 动态能力类子分(如碰撞避免 NC、TTC)→ 用动态 LoRA 的预测。
这种”路径感知的分数融合“贯穿整个轨迹簇选择,最终选出最优轨迹 τ̂。
🎯 直观理解:失败案例里"该往哪开”(轨迹监督 τ)和"哪种轨迹算好"(分数监督 𝕊)被临时灌进解码器的 LoRA 里,等于让模型在相似场景"临时复习"怎么避坑。
📊 实验结果
NAVSIM v1(Navtest):VLA 阵营登顶
| 方法 | 类型 | 传感器 | PDMS ↑ |
|---|---|---|---|
| TransFuser | 经典 E2E | 3cam+LiDAR | 83.4 |
| GoalFlow | 经典 E2E | 3cam+LiDAR | 90.3 |
| Centaur | 经典 E2E(TTT) | 3cam | 92.6 |
| DriveSuprim | 经典 E2E | 3cam | 93.5 |
| AutoVLA | VLA | 环绕相机 | 89.1 |
| ReCogDrive | VLA | 前视 | 90.8 |
| ELF-VLA | VLA | 前视 | 91.0 |
| DriveVLA-W0(同系) | VLA | 前视 | 90.2 |
| DriveVLA-M0-Base | VLA+记忆 | 前视 | 92.3 |
| DriveVLA-M0-Scale(10K 记忆) | VLA+记忆 | 前视 | 94.1 |
- DriveVLA-M0-Base(92.3) 仅凭前视相机就超过所有先前 VLA,并逼近最强 E2E(含同样用 TTT 的 Centaur 92.6);
- DriveVLA-M0-Scale(94.1) 用 SimScale 合成数据把记忆扩到 10K 条,不重训模型就涨到 94.1——追平最接近人类的水平。
NAVSIM v2(Navhard):安全关键指标碾压
NAVSIMv2 是更新的伪闭环基准,多数 VLA 方法还没上榜,主要对比 E2E 强基线:
| 方法 | NC↑ | DAC↑ | DDC↑ | TTC↑ | EP↑ | EPDMS↑ |
|---|---|---|---|---|---|---|
| DiffusionDrive | 96.8 | 80.3 | 88.2 | 86.1 | 84.5 | 28.9 |
| Mimir | 95.6 | 80.6 | 92.2 | 89.3 | 86.4 | 34.6 |
| GTRS-Dense | 98.9 | 91.5 | 98.2 | 90.1 | 94.7 | 45.3 |
| DriveVLA-M0-Base | 98.9 | 91.1 | 96.2 | 89.2 | 93.1 | 47.0 |
DriveVLA-M0 在 EPDMS(47.0) 上全面领先,且各项子指标更均衡——不偏科(不像 GTRS 那样某个子项极高、某个子项崩掉)。
消融一:检索策略(结构键 vs 语言键)
| 检索键 | NC↑ | DAC↑ | EP↑ | TTC↑ | PDMS↑ |
|---|---|---|---|---|---|
| Base Model(无记忆)† | 98.4 | 97.1 | 87.7 | 95.2 | 91.0 |
| Lang(语言特征) | 98.0 | 97.3 | 88.1 | 93.9 | 90.7 ↓ |
| Map(仅静态) | 98.4 | 97.7 | 89.1 | 94.5 | 91.7 |
| Map + Agent(双结构键) | 98.9 | 97.7 | 89.6 | 95.0 | 92.3 |
- 语言特征检索反而拖后腿(90.7 < 91.0)——证实了"语言特征对驾驶结构检索无效"的假设;
- map 键提升 DAC/EP(路拓扑相关),加 agent 键后 NC/EP/TTC 各 +0.5(交互相关)——解耦结构键各管一摊。
消融二:知识注入策略(离线 vs TTT)
| 注入方式 | PDMS↑ |
|---|---|
| Base Model(无记忆)† | 91.0 |
| 离线后训练(失败样本训 10 epoch) | 91.2 |
| TTT 全量微调(解码器) | 92.4 |
| TTT 解耦 LoRA | 92.3 |
- 离线后训练只涨 0.2——固定数据混合无法做场景特定适应(分布失配);
- TTT 全量微调最高(92.4),但解耦 LoRA(92.3)几乎打平,同时把后向开销从 55.42ms 砍到 26.44ms——低秩适应在测试时能逼近全量微调。
消融三:Trigger 阈值
| λ | NC↑ | DAC↑ | EP↑ | TTC↑ | PDMS↑ |
|---|---|---|---|---|---|
| 0.70(太松) | 98.0 | 96.9 | 88.1 | 93.8 | 90.4 |
| 0.90(最优) | 98.4 | 97.7 | 89.1 | 94.5 | 91.7 |
| 0.95 | 98.1 | 97.6 | 88.8 | 94.3 | 91.4 |
| 0.99(太严) | 98.1 | 96.9 | 85.2 | 94.3 | 89.4 |
λ=0.9 是甜点:既覆盖足够多场景,又不让噪声检索污染。0.99 时 EP 崩到 85.2(几乎不触发),0.7 时 NC/TTC 被噪声干扰。
效率:TTT 开销极小
| 组件 | 耗时 (ms) |
|---|---|
| 检索(查询 4000 条记忆) | 15.19 |
| 前向(单次推理) | 30.79 |
| 后向 LoRA(TTT) | 26.44 |
| 后向全量(对比) | 55.42 |
H20 GPU + 4000 条记忆下,TTT 只增加 26.44ms 后向开销——满足车端实时部署要求。
附录可视化


⚖️ 与 DriveVLA-W0 的深度对比(同系接力)
这是用户最关心的部分。DriveVLA-W0 和 DriveVLA-M0 出自同一批人(CASIA)、都叫 DriveVLA、都用前视单目、都刷 NAVSIM,但走的是两条几乎相反的技术路线——一个从"数据“入手,一个从”记忆“入手:
| 维度 | DriveVLA-W0(世界模型) | DriveVLA-M0(失败记忆) |
|---|---|---|
| 一句话定位 | 世界模型放大数据缩放律 | 失败记忆 + 测试时训练 |
| 核心手段 | 预测未来图像,用稠密自监督喂饱骨干 | 检索失败场景,用 TTT 逐场景纠正 |
| 解决的问题 | “监督赤字”——稀疏动作监督喂不饱大模型 | “屡教不改”——相似场景反复出错、无法关联过去 |
| 监督来源 | 稠密(每个像素的未来帧预测) | 定向(只针对失败场景的专家轨迹 + oracle 分数) |
| 训练方式 | 两阶段:世界预训练(6VA)→ 动作专精(2VA) | 两阶段:离线 Memory Generation → 在线 TTT |
| 模型结构 | VLM 骨干 + 世界模型(AR/Diffusion)+ MoE 动作专家 | VLM 骨干 + Q-Former 压缩 + 双头解码器 + Retrieve Model + 记忆池 |
| 动作生成 | Query-based / AR / Flow Matching 三种专家 | Trajectory Head 出多候选 + Score Head 打分选优 |
| 部署开销 | 推理时世界模型旁路;MoE 把延迟降到 74.3ms | 推理时多一次检索(15ms)+ 触发时 26.44ms 后向 |
| 核心收益 | 数据越多越强(70M 帧仍持续提升),跨域泛化 | 记忆越大越强(10K 记忆免费涨点),场景自适应 |
| NAVSIMv1 PDMS | 90.2(AR 专家 + best-of-N 93.0) | 92.3 / 94.1(10K 记忆) |
| NAVSIMv2 EPDMS | 86.1 | 47.0 |
关键区别:监督密度 vs 记忆密度
两者本质差异可以用一句话概括:
W0 把"驾驶"重新定义成"建模世界动力学”——用像素级稠密监督逼模型学世界规律,把知识存进权重;M0 把"驾驶"重新定义成"关联失败经验"——用结构检索 + TTT 在关键时刻调用历史经验,把知识存进显式记忆。
- W0 是"练内功":不改变模型推理流程,只是训练时多一个世界模型任务,让骨干更懂世界。收益是可迁移的(换个数据集照样有用),代价是需要大规模预训练数据;
- M0 是"吃一堑长一智":不改变主干训练,另建一个记忆系统 + 检索模型,在推理时按需纠正。收益是即插即用(不用动 base 模型就能涨点),代价是多一套离线记忆构建 + 在线检索开销。
为什么 M0 能反超 W0?
- W0 的上限受数据曲线限制——它放大缩放律,但前提是有海量数据;M0 直接瞄准 W0 没解决的长尾失败场景,用记忆"精准补课";
- M0 可以无训练扩容——记忆池从 4K 扩到 10K 不用动模型;W0 想要更强必须重新训练;
- 导航/指令等语义信息在 M0 里由 Base Model(RecogDrive 配方)承接,而 W0 用世界模型间接建模——M0 的语义通路更直接。
🎯 一句话对比:W0 用"世界模型"换稠密监督,M0 用"失败记忆"换场景自适应。前者赌"数据喂得越多越好",后者赌"关键时刻用对经验"。
📝 个人思考
这篇论文最打动我的,是它把自动驾驶的"经验闭环"第一次做成了显式模块。人类老司机的核心优势从来不是反应快,而是“我经历过这种场面”——同样的路口、同样的加塞模式,别人紧张我淡定。DriveVLA-M0 用 latent memory 把"经历"存下来,用结构检索在"场面相似"时把经历调出来,再用 TTT 临时消化——这套"记忆 → 检索 → 临场应用“的闭环,比单纯堆参数更贴近驾驶的本质。
另一个值得学习的点是**“解耦"贯穿始终**:检索键解耦(map/agent)、TTT 分支解耦(静态/动态)、分数融合解耦(DAC 走静态、NC 走动态)。这种”把不同性质的信息交给不同通路“的设计,和 BrainWAM 的"动作空间协调”、WAM 系列的"token 隔离"异曲同工——自动驾驶问题本质上就是"结构 + 动态"两类信息的耦合问题。
几个可以深入探讨的点:
- 记忆的时效性:论文的记忆是静态构建的。真实驾驶中失败是随时间积累的——如果记忆能在线增量写入(今天遇到的坑,明天就能用),会不会更强?
- 记忆与权重蒸馏:W0 把世界知识蒸馏进权重,M0 把失败知识存在显式记忆。两者能否融合?——用 W0 的世界模型训练出一个更强的 base,再用 M0 的记忆系统兜底长尾,可能是下一代 DriveVLA 的方向;
- TTT 的安全边界:LoRA 每场景重置避免了"串经验”,但也意味着每次触发都要花后向时间。在算力受限的车端,26.44ms 能否压缩到个位数,是量产关键。
🔗 延伸阅读
| 工作 | 与 DriveVLA-M0 的关系 |
|---|---|
| DriveVLA-W0 | 同系前作,世界模型路线,本文主要对比对象(详见上文深度对比) |
| ReCogDrive | Base Model 的 VLM 配方来源(InternVL3 + 驾驶 QA 预训练) |
| iPad | Action Decoder 的两阶段范式来源(Trajectory + Score 双头) |
| MemoryVLA / EchoVLA | 具身智能记忆系统,本文对比"语言特征检索"的不足 |
| Mimir / Centaur | NAVSIM 上同样用 TTT 的代表工作,本文的结构检索 + LoRA 与其差异化 |
| SimWAM / BrainWAM | 同为 WAM 系列(世界模型 + 动作),本文展示"记忆增强"与"世界建模"是互补杠杆 |
📖 这是论文精读系列关于 DriveVLA 家族的第二篇(W0 → M0)。下一站或许就是"W0 的稠密监督 + M0 的失败记忆"的合体版本?欢迎留言讨论。