📄 论文信息
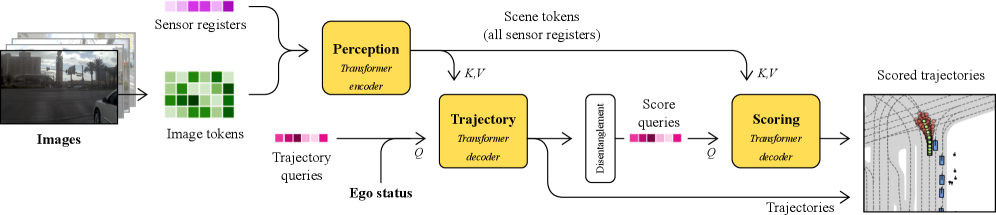 **图1: DrivoR架构概览**。由三个Transformer模块组成:感知编码器(将视觉信息压缩到相机感知寄存器中)、轨迹解码器(生成候选轨迹)、评分解码器(评估轨迹)。最终轨迹通过最高预测分数选出。
- 标题:Driving on Registers(基于寄存器驾驶)
- 团队:Valeo.ai, Paris(Ellington Kirby, Alexandre Boulch, Yihong Xu等14位作者)
- 发表:CVPR 2026(arXiv:2601.05083)
- 关键词:端到端自动驾驶、ViT、寄存器token、Token压缩、轨迹评分
- 一句话总结:一个极致简洁的纯Transformer端到端自动驾驶架构,通过ViT寄存器token将数千视觉token压缩为数十场景token,仅~40M参数达到SOTA。
- 论文链接:arXiv:2601.05083
- 项目主页:valeoai.github.io/driving-on-registers
- 代码仓库:github.com/valeoai/DrivoR
🤔 要解决什么问题?
端到端自动驾驶方法的感知backbone通常主导了参数和FLOP计数。现有方法主要面临以下问题:
1. 视觉Token爆炸
ViT等大规模预训练模型虽然性能优越,但每帧输出数千个token。以ViT-Large为例,单张图像产生1024个patch token(14×14 patch划分,224×224分辨率),6个相机就是6144个token。要在这些token上做数百条轨迹的交叉注意力计算,计算瓶颈极其严重:
- 计算复杂度:交叉注意力的复杂度为 O(Q × KV),其中Q为轨迹查询数(如256条),KV为视觉token数(如6144)。单次交叉注意力的计算量高达 256 × 6144 ≈ 157万次注意力操作,在多层解码器中还会进一步放大。
- 内存瓶颈:6144个视觉token在多头注意力中的KV缓存占用大量显存,尤其是使用ViT-L(每token 1024维)时,单帧KV缓存即达 6144 × 1024 × 2 ≈ 12.6M浮点数。
- 多帧扩展困难:如果考虑时序信息需要缓存多帧token,上述问题还会成倍放大。
这一瓶颈导致大多数端到端方法要么不得不使用较浅的CNN backbone(如ResNet-50/101),要么使用ViT时不得不大幅降低分辨率或只使用最后一层特征。
2. 简单的池化操作信息丢失严重
一些方法试图通过空间池化(spatial pooling)来降维,如全局平均池化(GAP)或空间注意力池化。然而这些方法存在根本性缺陷:
- 无差别的信息聚合:全局池化将所有空间位置视为等重要的,无法区分交通灯、行人等关键区域与天空、路面等背景区域。
- 相机视角区分困难:简单池化后不同相机的特征混合在一起,模型难以区分"左前相机中的红色物体"和"右后相机中的红色物体"。
- 分辨率敏感:池化操作的输出维度固定,当输入图像分辨率变化时,池化区域对应的实际物理范围也随之变化,引入额外的不确定性。
- 空间关系丢失:池化本质上是袋模型(bag-of-features),丢弃了视觉token之间的空间排列信息,这对于理解道路布局至关重要。
3. 端到端方法仍然复杂
虽然UniAD、VAD等方法号称端到端,但仍然依赖检测、跟踪、建图等中间模块:
- UniAD:包含检测、跟踪、建图、运动预测、规划五个模块,每个模块都需要独立的训练数据和损失函数
- VAD:同样需要vectorized map和agent的显式检测与跟踪
- ST-P3:在鸟瞰图(BEV)空间中进行感知、预测和规划,BEV变换本身就是一个复杂的模块
这些中间模块增加了标注成本(需要3D框、车道线、轨迹标注)、部署难度(多模块级联的累积误差)和计算开销。
与Token压缩相关的工作
DrivoR并非第一个试图压缩视觉token的工作,但其思路独树一帜:
- Perceiver系列(Jaegle et al., 2021):通过交叉注意力将大量输入token压缩为少量latent token,但需要额外的注意力计算,且latent token不携带相机几何信息。
- TiTok(Yu et al., 2024):证明图像可被压缩为32个token进行重建,展示极低token密度的可行性,但主要用于图像生成而非场景理解。
- Token Merging(Bolya et al., 2023):在ViT中逐步合并相似token,减少序列长度,但合并策略在驾驶场景中可能导致关键区域的错误合并。
DrivoR的核心问题非常简单直接:到底需要多少个token才能表示一个驾驶场景?
作者的回答是:24个就够了(6个相机 x 4个寄存器token)。这比ViT直接输出的6144个token压缩了256倍。
打个比方:传统方法在描述场景时,相当于把6张高清照片的每个像素都送给决策系统;DrivoR则用24个"关键词"来概括整个场景——“前方有车、右侧有车道、交通灯是绿的……"。这24个token由ViT中的**寄存器token (register tokens)**自动学习生成,不需要人工标注,也不需要BEV变换等复杂中间表示。
核心洞察:驾驶决策不需要"看清每个像素”,只需要"理解场景的稀疏语义结构"。寄存器token就是提取这种结构化语义的钥匙。
🏗️ 核心架构
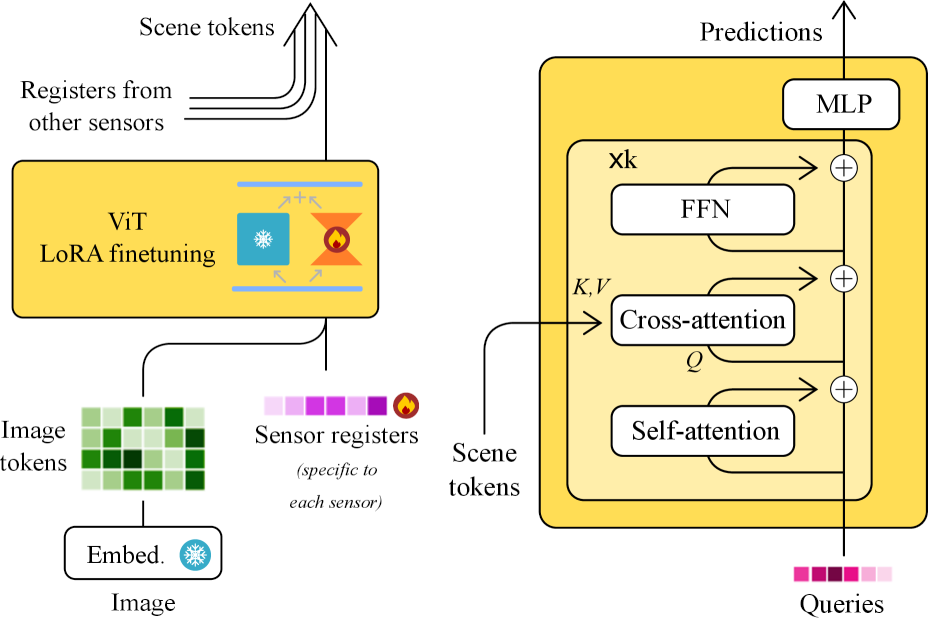 **图2: 编码器和解码器架构**。(a)编码器:在ViT中引入相机感知寄存器,将每相机的视觉信息压缩到R个寄存器token中。(b)解码器:标准Transformer解码器,以场景token为KV进行交叉注意力,生成轨迹或分数。
DrivoR的设计哲学是"极简"——没有BEV表示、没有大规模轨迹词典、没有复杂的中间模块。整个架构由三个Transformer模块组成。
总体架构概览
整个网络按流水线顺序执行:
Step 1: 多相机图像 → ViT + Registers → 场景token (N x R个)
Step 2: 场景token + 自车状态 → 轨迹解码器 → K条候选轨迹
Step 3: 候选轨迹 + 场景token → 评分解码器 → 多维子分数
Step 4: 子分数 x 行为权重 λ → 加权总分 → 选取得分最高轨迹
1. 感知编码器(Perception Encoder)
核心创新在于相机感知寄存器token(camera-aware register tokens),这是对ViT寄存器机制(Darcet et al., ICLR 2024)在自动驾驶领域的创新应用。
寄存器token机制详解
在标准ViT中,输入序列由三部分组成:
- CLS token:一个可学习的特殊token,用于全局分类任务
- Patch token:将图像切分为P×P的patch,线性投影为token序列,长度为 H×W / P²
- 位置编码:为每个patch添加空间位置信息
可以这样理解寄存器token:一辆车的前方场景包含多种视觉元素(车道线、前车、行人、路标),传统方法让驾驶模型自己从6144个patch token中"大海捞针";DrivoR则提前开辟了R个专用信息通道,每个通道负责从图像中提取一类关键信息。
具体实现上,DrivoR在ViT的输入序列末尾追加了R个可学习的寄存器token:
Input = [CLS, Register_1, Register_2, ..., Register_R, Patch_1, Patch_2, ..., Patch_n]
这些寄存器token经过ViT的L层Transformer层的前向传播后,在每层中都与patch token通过**多头自注意力(MHSA)**进行信息交互。以第l层为例:
X_l = MHSA(LN(X_{l-1})) + X_{l-1}
X_l = FFN(LN(X_l)) + X_l
其中 LN 为LayerNorm,FFN 为前馈网络。在这个过程中,寄存器token通过自注意力从patch token中提取和汇聚与驾驶场景相关的视觉信息,同时patch token也获得来自寄存器的全局上下文。
关键区别在于:
- CLS token:目标是聚合全局信息进行分类,与所有patch等权重交互,输出一个笼统的"全局特征"
- Register token:每个register是一个独立的信息通道,可以关注不同的视觉模式(如Register 1关注前方车辆、Register 2关注车道线、Register 3关注红绿灯)。这种分工是模型自动学习的,无需人工指定。
相机感知的设计
与简单地在所有相机上共享寄存器不同,DrivoR的寄存器是**相机感知(camera-aware)**的:
- 每个相机有独立的R个寄存器token(不同的可学习参数)
- 不同相机的寄存器在ViT处理过程中互不干扰
- 处理后所有N×R个寄存器拼接为场景token
这种设计使得:
- 模型自然区分不同视角的信息来源
- 寄存器能够编码与相机位姿相关的几何先验
- 拼接后的场景token天然携带了多视图的空间关系
微调策略
DrivoR采用**LoRA(Low-Rank Adaptation)**进行ViT backbone的微调:
- 冻结预训练ViT的权重,在每层注意力中插入低秩矩阵 ∆W = BA
- 训练时仅更新LoRA参数和寄存器token,ViT原始权重保持不变
- 秩 r 通常取8-16,每个注意力层仅增加 ~2×d_model×r 个参数
相比全量微调,LoRA的优势在于:
- 避免过拟合:驾驶数据集通常比预训练数据集小得多(如nuPlan约1200小时 vs ImageNet-21K的1400万图像),全量微调容易过拟合
- 保留预训练知识:冻结的ViT backbone保留了在通用视觉数据上学到的特征,LoRA仅做任务适配
- 参数量极低:ViT-S的总参数量约22M,LoRA模块仅增加约0.5M参数
关键数值洞察
| 配置 | Patch Token数 | 寄存器token数 | 压缩比 |
|---|---|---|---|
| 无寄存器(全token) | 6144 | 0 | 1× |
| R=1 | 6144 | 6 | 1024× |
| R=4 | 6144 | 24 | 256× |
| R=8 | 6144 | 48 | 128× |
| R=16 | 6144 | 96 | 64× |
即使是R=4的配置,也能将视觉token压缩至原来的1/256,极大地降低了后续decoder的计算负担。
2. 轨迹解码器(Trajectory Decoder)
轨迹解码器采用标准Transformer解码器架构,以场景token为条件生成K条候选轨迹。
架构细节
输入:
- K个可学习的轨迹查询(trajectory queries),维度为 d_model
- 编码后的自车状态(ego state),包括速度、加速度、转向角等,通过MLP编码到 d_model 维度
- 场景token作为交叉注意力的Key和Value
交叉注意力层:
Q = trajectory_queries + ego_state_embedding    (K x d_model)
K = scene_tokens                                 (N x R x d_model)
V = scene_tokens                                 (N x R x d_model)

Attention(Q,K,V) = softmax(QK^T / sqrt(d_k)) x V
其中 d_k = d_model / n_heads 为每个注意力头的维度。
输出:通过多层解码和MLP头,每条轨迹查询输出一个轨迹向量
τ_i = MLP(Decoder(trajectory_query_i, scene_tokens))轨迹通常表示为未来T个时间步的航点序列:τ_i = {(x_t, y_t, θ_t) | t=1,…,T}
Winner-Takes-All(WTA)训练策略
WTA是轨迹多模态生成的关键训练策略:
直觉:让K条候选轨迹竞争——谁离真实轨迹最近,谁就获得训练信号;其他轨迹得不到梯度,被迫去寻找其他可行的驾驶模式(如不同车道、不同速度曲线)。
训练流程如下:
- 解码器生成K条候选轨迹 {τ₁, τ₂, …, τ_K}
- 计算每条轨迹与GT轨迹的匹配代价(L2距离或碰撞感知代价)
- 选出与GT匹配代价最小的轨迹作为"胜者" τ_win
- 仅对胜者轨迹计算回归损失:
L_reg = ||τ_win - τ_GT||²
L_WTA = L_reg + L_aux
其中 L_aux 可包括额外的正则项,如轨迹平滑性约束。
WTA的巧妙之处在于:每条轨迹查询会竞争性地专注于不同的驾驶模式。由于只有最接近GT的查询得到梯度更新,其他查询被迫寻找不同的模式——就像组里的同事,只有业绩最好的人拿到奖金,其他人只能另辟蹊径。这与Mixture of Experts(MoE)的"soft"路由不同,WTA是一种hard routing策略。
3. 评分解码器(Scoring Decoder)
评分解码器与轨迹解码器共享相同的架构,但关键区别在于梯度分离(gradient stopping)。
直觉:如果不分离梯度,生成网络和评分网络会互相"作弊"——生成网络专挑简单的轨迹出,评分网络就给简单轨迹打高分,两者一起摆烂。梯度分离强迫它们各司其职。
评分解码器的输入是轨迹解码器输出的轨迹token(经过梯度截断):
trajectory_token = StopGradient(Decoder_output)
这意味着:
- 评分网络的梯度不会反传回轨迹生成网络
- 轨迹生成网络只接收回归损失(WTA)的梯度
- 评分网络独立学习如何评估给定轨迹
为什么必须分离?去掉梯度分离后,生成和评分会陷入不良平衡:
问题情形:
评分网络发现"给简单轨迹打高分"最容易降低自身损失
→ 生成网络发现"高分 = 简单轨迹",于是只产生简单轨迹
→ 评分网络更确认简单轨迹是对的
→ 正反馈循环 → 两者收敛到次优解
梯度分离打破了这一循环,使两个网络各司其职:生成网络专注于覆盖所有可能的驾驶模式,评分网络专注于准确评估每条轨迹的质量。
可解释子评分
每条轨迹 τ_i 通过评分解码器后,输出多个维度的子分数:
[s_safety, s_comfort, s_efficiency, s_progress, s_legality] = ScoringDecoder(traj_token_i, scene_tokens)
每个子分数通过独立的MLP头输出,取值范围归一化到 [0, 1]:
- s_safety(安全性):评估轨迹是否与其他agent或道路边界发生碰撞,是否保持安全距离
- s_comfort(舒适性):评估轨迹的加加速度(jerk)、横向加速度是否平顺
- s_efficiency(效率):评估轨迹是否能高效到达目标,是否过度减速或绕路
- s_progress(进度):评估轨迹是否合理地向目标点前进
- s_legality(合法性):评估轨迹是否遵守交通规则(如红绿灯、限速、车道线)
训练损失
评分器的训练使用数据集提供的oracle评分作为监督信号:
L_score = Σ_i CrossEntropy(s_i, oracle_score_i)
其中 oracle_score 通常由仿真器的碰撞检测、路线偏移等规则计算得出。如果oracle评分为标量,则分解训练通过如下方式进行:
L_score_disentangled = Σ_d Σ_i CrossEntropy(s_i^d, oracle_score_i^d)
其中 d 表示不同维度,oracle_score_i^d 通过预设规则计算该维度的地面真值。
4. 可调节驾驶行为
DrivoR最实用的特性——推理时无需重新训练即可调节驾驶风格。
行为调节公式
Score(tau) = lam_safety * s_safety + lam_comfort * s_comfort
           + lam_efficiency * s_efficiency + lam_progress * s_progress
           + lam_legality * s_legality
其中 λ 为各子分数的权重,满足 Σ λ = 1。
典型配置
| 驾驶风格 | λ_safety | λ_comfort | λ_efficiency | λ_progress | λ_legality |
|---|---|---|---|---|---|
| 保守安全型 | 0.5 | 0.2 | 0.1 | 0.1 | 0.1 |
| 均衡型 | 0.3 | 0.2 | 0.2 | 0.15 | 0.15 |
| 激进高效型 | 0.15 | 0.1 | 0.4 | 0.2 | 0.15 |
| 舒适巡航型 | 0.2 | 0.5 | 0.1 | 0.1 | 0.1 |
- λ_safety ↑ → 保守安全型驾驶(与前车保持更大距离,更早刹车)
- λ_efficiency ↑ → 激进高效型驾驶(更快完成变道,更少无谓减速)
- λ_comfort ↑ → 平稳舒适型驾驶(减少急加速和急转弯)
- 无需重新训练,一次训练适配多种风格
这种设计在实际部署中极具价值:一个模型可以同时服务于不同偏好的用户,或者在不同场景下切换不同风格(如雨天自动提高安全权重)。
🔬 实验分析
基准测试表现
| 基准 | 指标 | DrivoR (ViT-S) | 最佳基线 | 人类表现 |
|---|---|---|---|---|
| NAVSIM-v1 | PDMS ↑ | 93.7 | DriveSuprim 93.5 | 94.8 |
| NAVSIM-v2 | EPDMS ↑ | 48.3 | ZTRS (ViT-L) 48.1 | - |
| HUGSIM | RC / HD-Score | 49.8 / 35.7 | UniAD 45.9 / 32.7 | - |
NAVSIM-v1上DrivoR以93.7 PDMS超越所有此前方法,仅落后人类表现1.1分。值得注意的是:
- DrivoR使用的是ViT-Small backbone(~22M),而DriveSuprim(93.5)使用ViT-Large(~300M)
- 参数量的15倍差距下,DrivoR仍以微弱优势领先
NAVSIM-v2的EPDMS指标更加严格(考虑路程进度),DrivoR以48.3超越ZTRS的48.1,而ZTRS同样使用ViT-Large backbone。
HUGSIM(闭环仿真)中,DrivoR在Route Completion(49.8 vs 45.9)和HD-Score(35.7 vs 32.7)上显著超越UniAD。
效率对比
| 模型 | 参数量 | 前向时间 (A100) | 显存峰值 |
|---|---|---|---|
| DrivoR (ViT-S) | ~40M | 110ms | 0.5GB |
| GTRS-Dense (ViT-L) | ~300M | 400ms | 1.6GB |
| DriveSuprim (ViT-L) | ~300M | 350ms | 1.4GB |
DrivoR仅用ViT-Small(~22M backbone + ~15M decoder)即可达到超越大部分ViT-L方法的性能,速度提升3-4倍,显存降低约1/3。
详细效率分析:
- 计算密集度:DrivoR每帧仅需24个场景token做KV,轨迹解码器和评分解码器的交叉注意力复杂度为 O(K × 24 × d_model),远低于O(K × 6144 × d_model)
- 实际推理流程:感知编码器110ms → 轨迹解码器约40ms → 评分解码器约30ms,总计约180ms(6FPS),满足实时性需求
- 可并行性:三个模块可进行pipeline并行,进一步降低延迟
消融实验关键发现
感知消融
| 实验 | PDMS | 说明 |
|---|---|---|
| 全token基线 (6144 tokens) | 93.1 | 直接使用所有patch token |
| R=1 (6 tokens) | 92.3 | 仅6个场景token |
| R=4 (24 tokens) | 93.7 | 最佳性价比 |
| R=8 (48 tokens) | 93.6 | 接近R=4 |
| R=32 (192 tokens) | 93.7 | 性能饱和 |
| 无LoRA(全量微调) | 91.8 | 过拟合严重 |
| 无寄存器(仅CLS token) | 89.2 | CLS token信息量不足 |
关键发现:
- 寄存器数量:每相机4-8个寄存器即可达到接近全token的性能,32个寄存器时性能饱和。24个token(R=4)时性能已达93.7,超出全token基线,说明寄存器机制相比简单使用所有patch token有结构化优势。
- LoRA微调:使用LoRA微调ViT比全量微调性能更好(93.7 vs 91.8),验证了避免过拟合驾驶数据集的假设。
- 寄存器 vs CLS:仅用CLS token(每个相机输出1个全局token)性能仅89.2,远低于R=4的93.7,说明单一全局表示无法捕获驾驶场景的细粒度信息。
轨迹解码器消融
| 实验 | PDMS | 说明 |
|---|---|---|
| K=8 | 91.5 | 候选轨迹过少 |
| K=32 | 93.7 | 最优配置 |
| K=64 | 93.6 | 相近 |
| K=256 | 93.5 | 边际递减 |
| 无WTA(全轨迹回归) | 90.3 | 所有轨迹趋向平均模式 |
| 无自车状态编码 | 91.8 | 缺乏运动学先验 |
评分解码器消融
| 实验 | PDMS | 说明 |
|---|---|---|
| 分离梯度 | 93.7 | 标准配置 |
| 不分离梯度 | 91.2 | 生成-评分不良平衡 |
| 单一分数(不分解) | 92.4 | 可解释性降低,性能下降 |
| 无评分(随机选轨迹) | 81.5 | 评分对于高性能至关重要 |
训练消融
| 实验 | PDMS | 说明 |
|---|---|---|
| 感知+轨迹+评分联合训练 | 93.7 | 完整配置 |
| 两阶段训练(先感知+轨迹,再评分) | 92.8 | 评分无法反馈改善生成 |
| 仅轨迹训练 | 89.6 | 缺乏评分优化 |
缩放实验
DrivoR在论文中还进行了模型规模的缩放实验:
| ViT Backbone | 参数量 | PDMS | 前向时间 |
|---|---|---|---|
| ViT-Tiny | ~5M | 90.2 | 65ms |
| ViT-Small | ~22M | 93.7 | 110ms |
| ViT-Base | ~86M | 93.9 | 210ms |
| ViT-Large | ~300M | 94.0 | 780ms |
有意思的观察:从ViT-S到ViT-L,PDMS仅提升0.3(93.7→94.0),而参数量增长了14倍,推理时间增长了7倍。这表明在寄存器token压缩范式下,更大的backbone带来的收益显著递减——因为寄存器token本身的信息容量有限,更大的backbone产生的更丰富特征无法通过固定数量的寄存器token充分传递。这反而是DrivoR的优势所在:用最小的模型达到接近最优的性能。
💡 个人思考
创新点
重新定义ViT在自动驾驶中的使用方式。之前的方法要么使用CNN backbone(如ResNet),要么直接使用ViT的全部token进行昂贵计算。DrivoR首次利用ViT的寄存器token进行结构化压缩,充分利用了Transformer的灵活性。这一创新实际上是对"什么样的视觉表示最适合驾驶"这一基本问题的回答——答案是"紧凑、结构化、相机感知的表示"。
极致极简架构。没有BEV、没有检测头、没有轨迹词典、没有复杂的多任务训练——三个Transformer模块搞定一切。这种"少即是多"的设计思路值得学习。更广义地说,DrivoR代表了一种研究范式:不增加模块,而是优化每个必要模块的效率。
可解释子分数 + 行为调节。将评分分解为安全、舒适、效率等可解释子分数,并支持推理时行为调节,实用价值很高。这解决了自动驾驶中一个长期存在的问题:如何在单模型中满足不同用户的驾驶偏好。对比传统的"训练多个模型对应不同风格"的方案,DrivoR的方法在效率和灵活性上有数量级的优势。
从Token压缩看ViT的效率革命
DrivoR的成功本质上体现了Transformer架构的灵活表示能力:patch token和register token可以看作是"全连接"的——通过自注意力机制,信息可以在任何token间流动。这意味着少量精心设计的register token可以通过自注意力汇聚整个视觉场景的有效信息。
这一思路与近年来多个研究方向不谋而合:
- TiTok(2024):证明单张图像可被压缩为32个token,且能通过这些token重建出高质量图像
- DINOv2 register(2023):在自监督学习中发现register token能有效编码图像块的统计特征
- Perceiver AR(2022):用交叉注意力实现输入和latent空间的维度解耦
这些工作的共同启示是:对于特定下游任务,我们不需要保留视觉输入的全部信息,而只需要保留与任务相关的结构化信息。DrivoR将"驾驶场景"作为目标,设计出了极低维度的场景表示。
与iPad的对比
| 对比维度 | iPad | DrivoR |
|---|---|---|
| 核心思想 | 迭代精炼稀疏提案 | 寄存器token压缩 |
| 感知表示 | BEV提案特征 | Transformer场景token |
| 轨迹生成 | 预测-锚定-精炼循环 | 查询解码器 |
| 评分方式 | 单一分数 | 多维度子分数 |
| 行为调节 | 不支持 | 支持 |
| 参数量 | ~50M | ~40M |
两个方法代表了端到端自动驾驶轻量化的两种不同路线:iPad走"规划中心"路线,DrivoR走"token压缩"路线。
从技术路线上看,两者的核心差异在于:
- iPad:保持感知的稀疏性(仅关注proposal区域),但在BEV空间中维护了一定程度的结构化表示
- DrivoR:从感知端就进行极致压缩,后续模块完全在token空间中操作,不引入任何几何先验
哪种路线更好?从结果看两者性能相近(iPad在NAVSIM-v1上公开的PDMS为~92.5,DrivoR为93.7),但DrivoR的架构更加简洁统一,对Transformer的利用更彻底。另一方面,iPad的proposal机制可能在某些极端场景(如新奇的障碍物)提供更好的召回率。
与其他SOTA方法的比较
| 方法 | 参数量 | Backbone | 中间表示 | PDMS | 推理时间 |
|---|---|---|---|---|---|
| DrivoR | ~40M | ViT-S | Register tokens (24) | 93.7 | 110ms |
| DriveSuprim | ~300M | ViT-L | Learned query | 93.5 | 350ms |
| GTRS-Dense | ~300M | ViT-L | Dense BEV | 93.0 | 400ms |
| ZTRS | ~300M+ | ViT-L | Token-based | 48.1 (EPDMS) | - |
| UniAD | ~220M | ResNet-101 | BEV + proposals | 45.9 (RC) | 420ms |
| VAD | ~180M | ResNet-50 | Vectorized map | 43.1 (RC) | 250ms |
DrivoR在参数量和速度上具有压倒性优势,同时在精度上达到最高水平,体现了"高效即智能"的设计哲学。
局限性与未来方向
依赖数据集提供的oracle评分。评分训练需要oracle分数作为监督信号,限制了在缺乏评分数据集上的应用。未来的改进方向包括:
- 使用强化学习(RL)替代oracle评分,让模型在仿真中自我探索
- 利用大语言模型(LLM)的常识知识进行轨迹质量评估
- 构建自监督的评分标准(如基于预测一致性)
闭环测试尚未完全覆盖。HUGSIM虽然是闭环仿真,但场景数量和多样性仍有限。在更复杂的真实场景泛化方面还需要更多验证,尤其是在长尾场景(Corner Cases)中的表现。
寄存器token的可解释性。虽然整体架构简单,但寄存器token具体编码了哪些视觉信息还缺乏深入分析。未来可以通过注意力图可视化、token属性分析等方式揭示寄存器token的编码模式:
假设:R=4的寄存器可能分别编码
- Register 1:动态物体(车辆、行人)
- Register 2:道路结构(车道线、路沿)
- Register 3:交通信号(红绿灯、标志)
- Register 4:全局上下文(道路类型、环境光照)
如果这种假设成立,将进一步提升模型的可解释性和可调试性。
时序信息的整合。当前DrivoR仅在单帧上操作,没有显式建模时序依赖。未来可以在寄存器token中引入时序注意力或循环机制,使模型理解车辆和行人的运动趋势,从而做出更安全的决策。
多任务扩展潜力。寄存器token携带了丰富的场景信息,理论上可以支撑检测、跟踪、建图等下游任务。未来DrivoR可以扩展为统一的感知-预测-规划框架,而无需增加大量额外参数。
总结性评价
DrivoR是端到端自动驾驶领域一篇在"正确的时间、正确的地点"出现的论文:
- 正确的时间:当领域正在追求更大、更复杂的模型(大backbone、多模态、大模型)时,DrivoR用反直觉的方式证明"更少可以更多"
- 正确的地点:ViT寄存器token是2024年提出的技术,DrivoR敏锐地将其应用于驾驶场景,展现了技术迁移的巨大价值
- 正确的问题:Token瓶颈是端到端自动驾驶长期被忽视的关键问题,DrivoR给出了优雅的解决方案
在AI领域"越大越好"的潮流下,DrivoR提供了一个重要的修正视角——模型效率和信息密度同样重要,尤其是在计算资源受限的车载部署场景中。这种"实用性导向"的研究思路值得更多关注。
📖 延伸阅读
- iPad: Iterative Proposal-centric End-to-End Autonomous Driving(Guo et al., CVPR 2025)- 以规划提案为中心的端到端自动驾驶
- Vision Transformers Need Registers(Darcet et al., ICLR 2024)- 寄存器token的原始提出论文
- An Image is Worth 32 Tokens for Reconstruction and Generation(Yu et al., 2024)- TiTok,将图像压缩为极少量token
- Hydra-MDP: End-to-End Multimodal Planning with Multi-Target Hydra-Distillation(Li et al., 2024)- 轨迹评分规划的奠基工作
- GTRS: Generalized Trajectory Scoring for End-to-End Multimodal Planning(2025)- 通用轨迹评分方法
- Perceiver: General Perception with Iterative Attention(Jaegle et al., ICML 2021)- 通用感知架构,通过交叉注意力实现输入压缩
- LoRA: Low-Rank Adaptation of Large Language Models(Hu et al., ICLR 2022)- 高效微调方法,DrivoR用于ViT backbone的微调
- Token Merging: Your ViT But Faster(Bolya et al., ICLR 2023)- Token合并策略,与寄存器压缩的对比基线