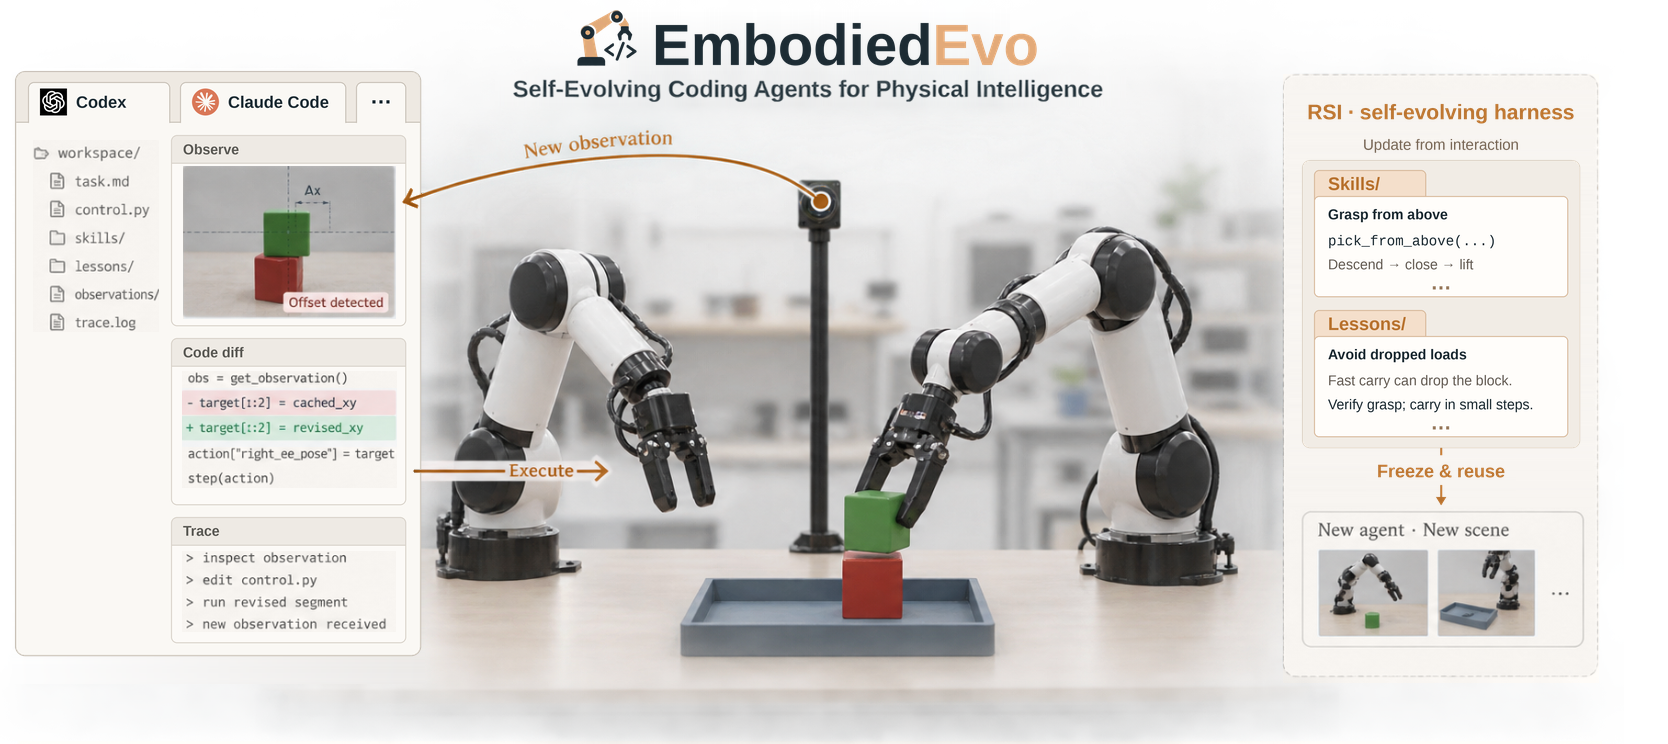
配图说明:本文收录论文全部 15 张插图(Figure 1 ~ Figure 15),放在站内 /images/embodiedevo/,逐张讲解,文末附图表总索引表。论文来自 Navers Lab / Einsia.AI(project lead Wenyi Li,通讯 Kaisen Yang、Qinhuai Na),arXiv 2610.18867(v2,2026-10-13),homepage lab.einsia.ai/embodiedevo。核心主张:物理智能也可以用「SWE 式迭代」长出来——不改模型权重、不收演示,把「学习」写进可检查、可编辑、可冻结的代码 harness。
📄 论文信息
- 标题:EmbodiedEvo: Self-improving Coding Agents for Physical Intelligence
- 机构:Navers Lab、Einsia.AI、清华大学
- 时间:2026-10(arXiv 2610.18867,2026-10-13)
- 关键词:Code as World、Agent as Policy、Skills、Lessons、Playground→Test 冻结协议、自进化 harness、RoboDojo、经验迁移
- 一句话总结:「会写代码的机器人 agent」在一个人造场景上反复试错,把成功动作沉淀成可复用的 Skill、把失败原因沉淀成 Lesson,然后整包冻结交给新场景上的新 agent 直接用——权重全程不动。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| RoboDojo-Sim 平均 | 44.48 分 / 37.82% SR | 超越当时全部官方已验证结果(GPT-6-Astra 仅 22.48% SR) |
| Memory 类 | 71.90 分 / 69.67% SR | 下一名学习型模型 VPP2 仅 55.56% SR |
| Open 类 | 55.52 分 / 53.00% SR | GPT-6-Astra 31.00% |
| 无 wiki 配对实验 | 8.50% → 30.17% SR | 同 executor、同场景,只加 harness |
| 有 wiki 增益 | +21.75 分 / +21.72 pp | 经验不是「抄 wiki 菜谱」就能替代的 |
| 跨模型迁移 | Sol +8.86 / Luna +5.50 pp | 强模型的经验帮到弱模型 |
| vs 原始交互历史 | 同等性能,Test 成本 -53% | Skills/Lessons 是有损压缩,不是全文本 |
| Playground 规模 | 每任务仅 1 个场景 | 冻结后在全新 Test 布局上评估 |
🗺️ 仿真 vs 真机:一眼分清
| 基准 / 场景 | 类型 | 说明 |
|---|---|---|
| RoboDojo-Sim(42 任务 × 50 Test 场景) | 仿真 | 主结果与排行榜对照均在此 |
| Playground(每任务 1 场景) | 仿真 | 仅用于经验演化,与 Test 布局完全隔离 |
| 双臂 / 真机部署 | 未做 | 论文明确只在仿真验证;经验格式设计为「真机也有的 RGB + 状态」 |
🧭 读前 5 分钟:四个概念
- Code as World:环境交互被拆成两层代码——L1 是观察/动作原语(
get_image、step等),L2 是组合成的可执行 Python 过程。代码既是「策略表示」也是「工作空间」。 - Agent as Policy:Agent 不再按固定「规划→执行→校验」流水线走,而是自己决定何时看、跑哪段代码、怎么验证失败。这是把 SWE 式自主循环搬进物理世界。
- Skill / Lesson:Skill 存可执行控制过程 + 适用条件;Lesson 存失败模式、物理约束、恢复经验。两者一起构成 harness。
- Playground → Test 冻结协议:在每任务一个固定场景上反复演化;评估前把 harness 冻结,交给全新 workspace / 全新模拟器会话的 Test agent——防止「边测边学」。
🛠️ 方法:Playground 里长经验,Test 里用经验
Code as World 与原生接口
论文在 RoboDojo 上暴露统一的仿真接口:观察包含 RGB + 机器人状态(关节角、末端位姿等);动作走原生 step。reset 仅在 Playground 阶段可用——Test 阶段只能在 episode 内自己恢复。代码被要求写在 submission/solution.py,经 adapter 提交执行(见 Figure 3)。
演化回路
在 Playground 上,agent:
- 读任务描述 / wiki 菜谱(可选);
- 写 / 改 L2 过程并执行;
- 根据物理反馈(抓空、掉落、超步数……)改代码;
- 把可复用的片段写进 Skill 库,把该记住的教训写进 Lesson(带「何时有效、为何失败、如何恢复」)。
演化的产物(Skills + Lessons + 元数据)构成 harness,之后只读提供给 Test agent。
Test 阶段
每个 Test episode:
- 新 workspace、新 Python 状态、新模拟器会话;
- harness 只读(防篡改);
- Test agent 仍可观察、执行、恢复,只是不能再改 harness。
这套设计把「获得经验」和「使用经验」拆成两种能力,后面实验会证明:弱 executor 可以用上自己根本采不出来的经验。
📸 逐图讲解(Figure 1 ~ 15)
Figure 1:总览——Playground 演化 → 冻结 → Test 复用
(即文首头图。)左半:coding agent 在 Playground 场景里编辑控制程序,用物理反馈反复修订 Skills / Lessons。右半:harness 被 Freeze 后交给全新的 Test agent,在未见过的布局上直接继承。这张图是全文骨架:学习只发生一次(每任务),复用可以发生无数次。
Figure 2:三种具身控制范式对比
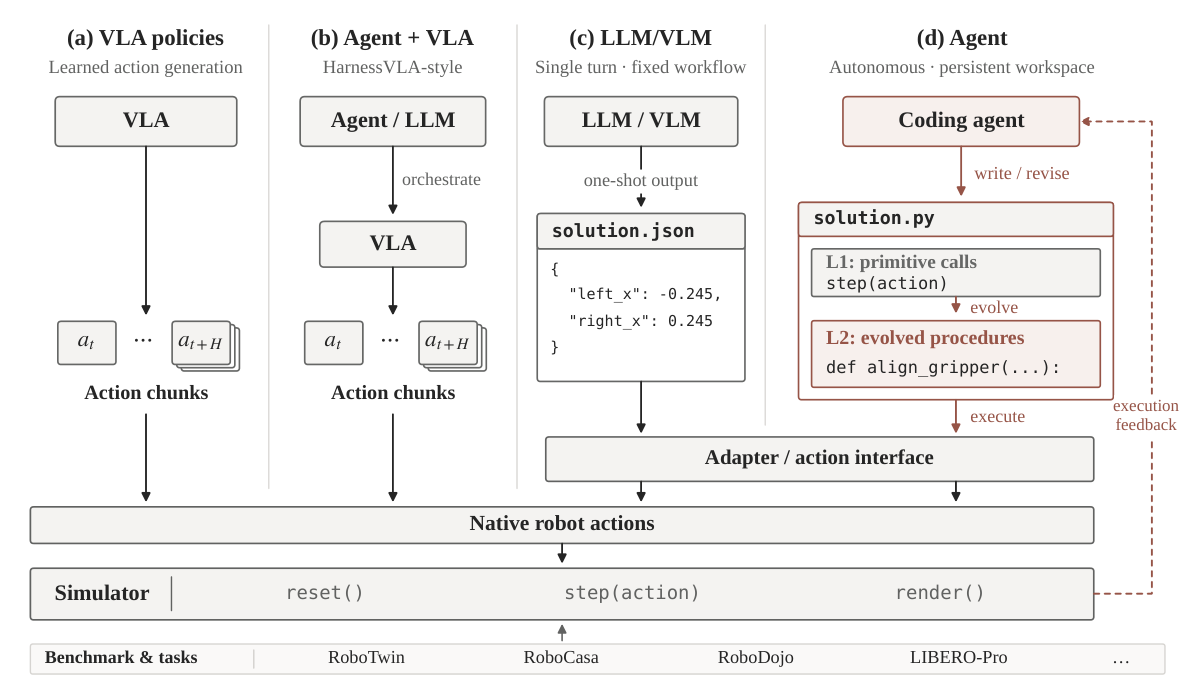
- (a) VLA 策略:观测+指令 → 直接吐 action chunk,行为不可检查;
- (b) Agent 编排 VLA:agent 负责规划,VLA 仍负责生成动作;
- (c) EmbodiedEvo:单一回合的 LLM/VLM 产出结构化控制程序,在统一接口上执行并迭代。代码是显式、可编辑、可复用的——这是「Code as World」的视觉表达。
Figure 3:代码到任务——统一仿真接口
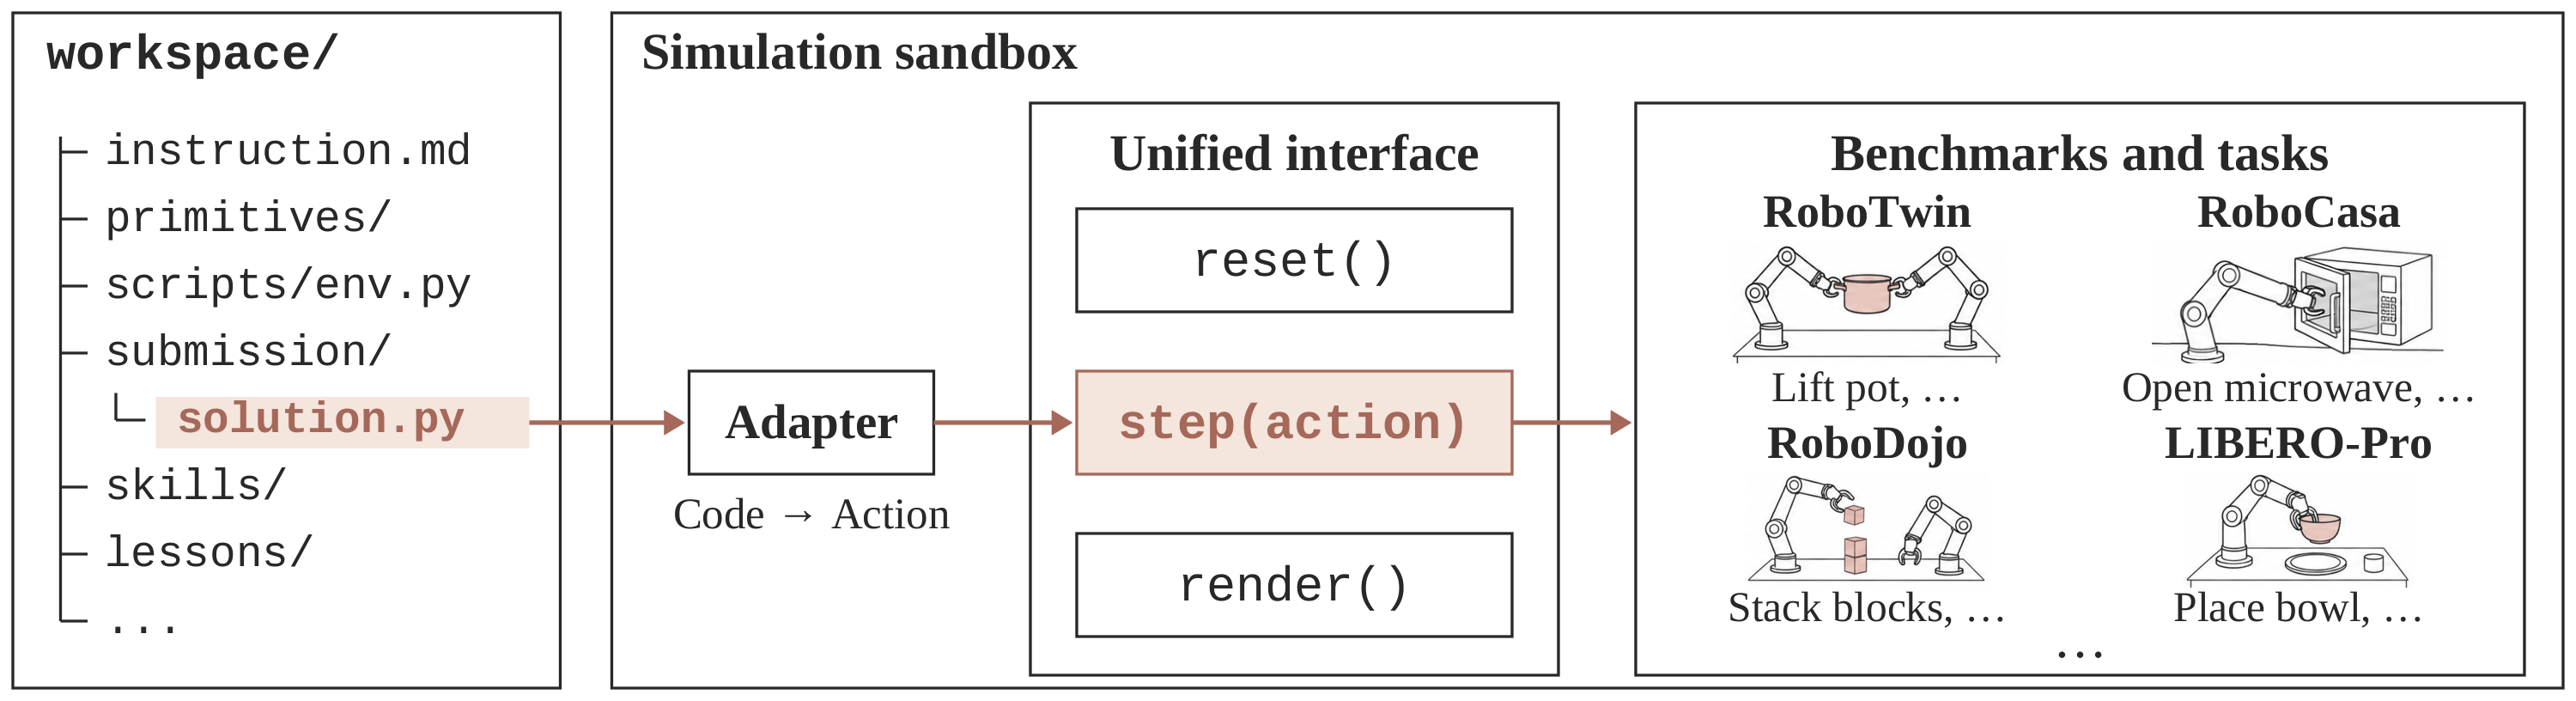
Agent 在工作区写 submission/solution.py,通过 adapter 提交;adapter 调用原生 step/观测接口并把结果回传。整个链路刻意做成 SWE 工作区风格:协议文件只读、执行记录可审计,方便复现与冻结。
Figure 4:Astra 的两种典型失败轨迹
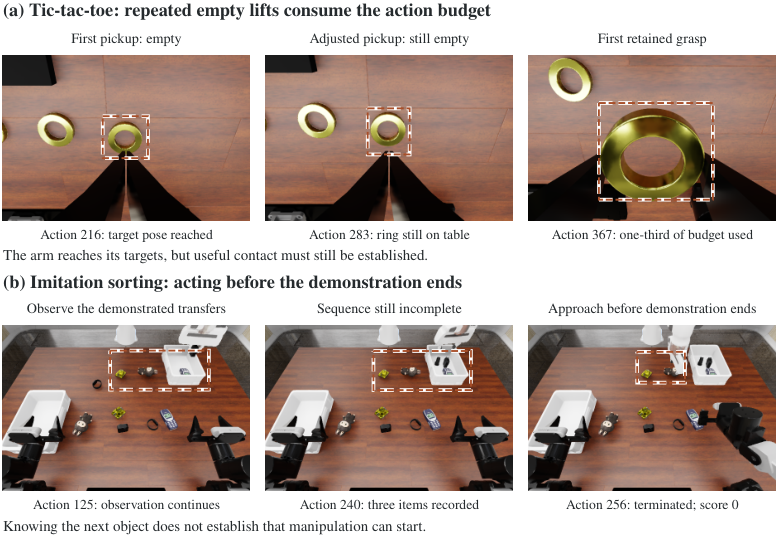
- (a) 先两次空抓才第一次真正抓稳,之后 episode 因步数预算耗尽而未完成;
- (b) 操作未完成时观测切到 manipulation 视角,导致状态丢失。
这些正是 Lesson 要沉淀的素材:「到达的位姿 ≠ 抓稳的负载」、「切换观测前先确认后置条件」。
Figure 5:EmbodiedEvo 方法框架
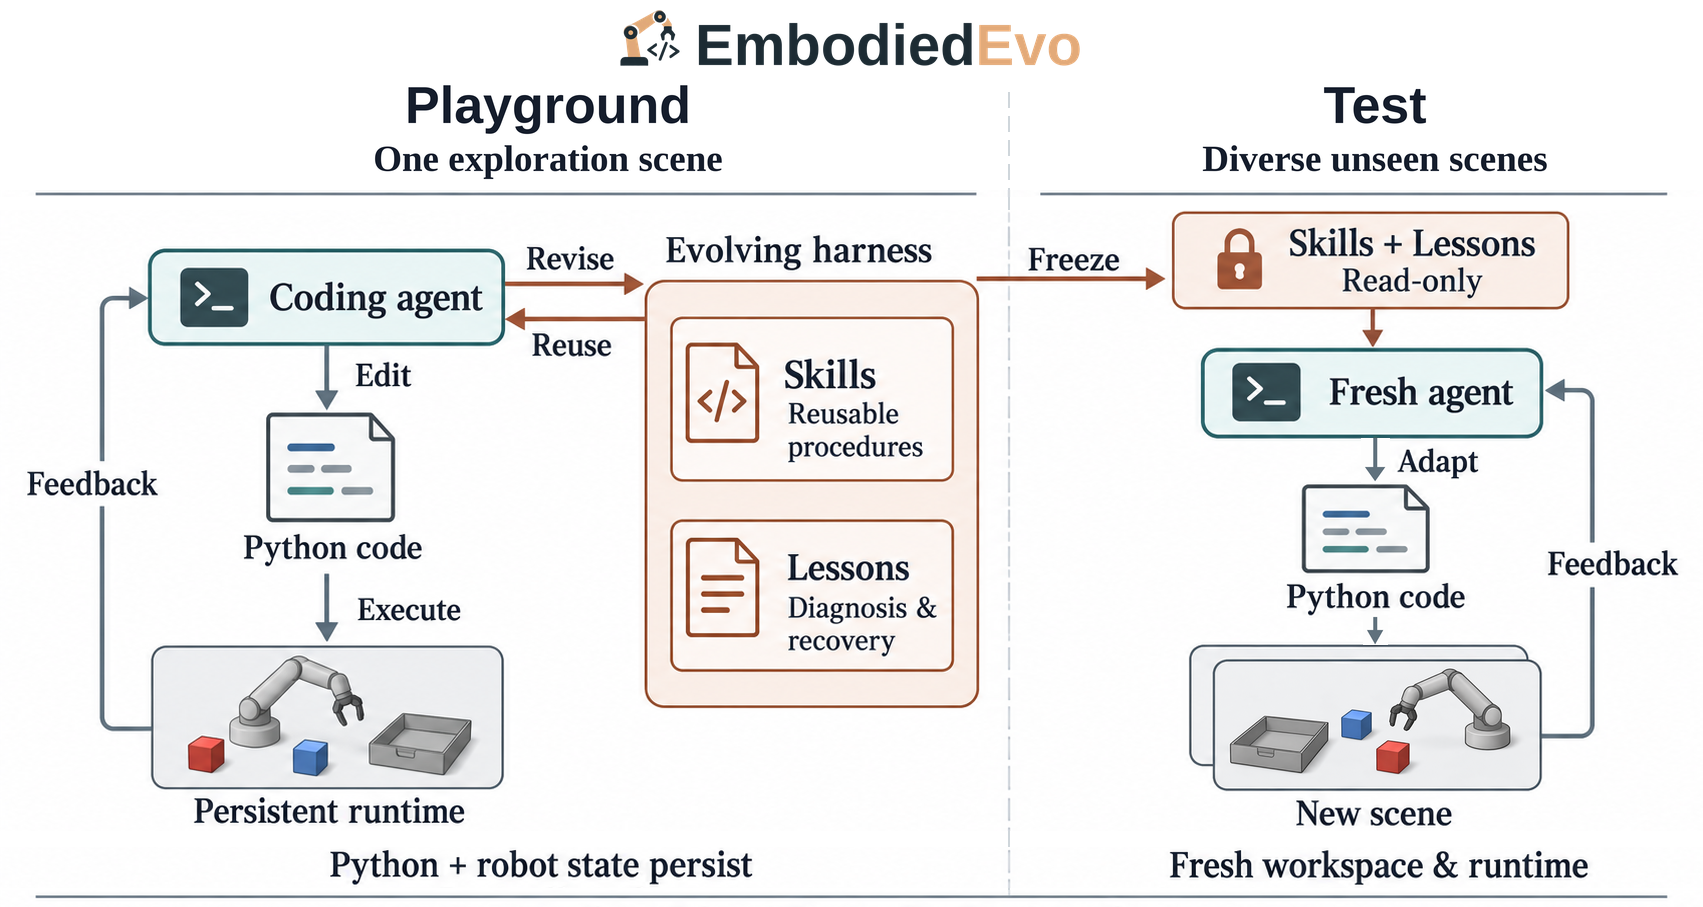
左侧:Playground 上「改代码 → 执行 → 用反馈改 Skills/Lessons」闭环;右侧:Freeze 箭头把 artifacts 搬到新场景上的 Test agent。注意模型权重与机器人接口全程固定——进化的只是 harness。
Figure 6:有无 wiki 的增益对照
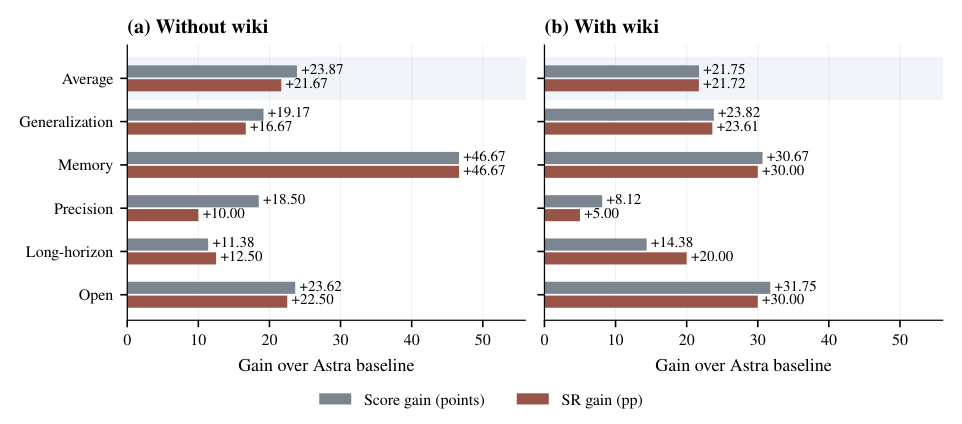
配对实验固定 executor(Astra/xhigh)与场景:
- (a) 仅任务描述:增益 +23.87 分 / +21.67 pp;
- (b) 任务描述 + wiki:增益仍有 +21.75 分 / +21.72 pp。
说明经验的价值不是把 wiki 里已有的菜谱再抄一遍——wiki 给「做什么」,Lesson 给「别踩哪个坑、失败后怎么救」。
Figure 7:能力演化——决定性操作 / 阶段被改掉
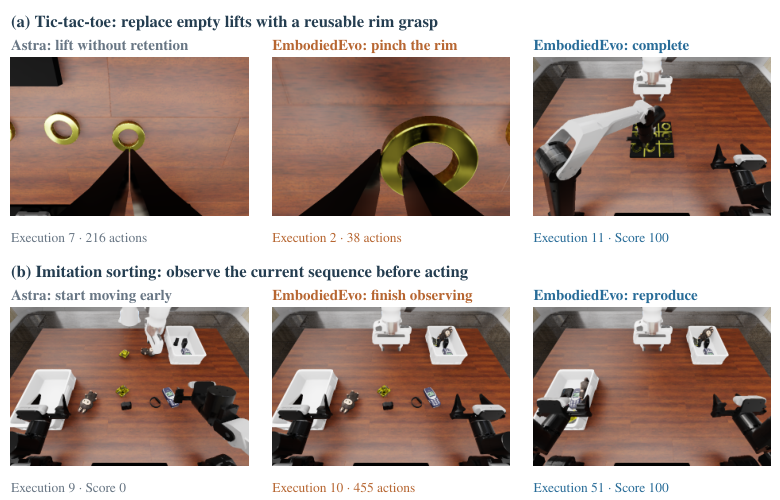
每行对比同任务同场景下的 Astra vs EmbodiedEvo:
- (a) 井字棋 layout 27:Astra 只会空抓,继承 harness 后用沿边缘抓取完成;
- (b) 其他任务里也能看到「关键抓取姿态 / 关键阶段切换」被 Lesson 直接改写。
这是「Memory / Open 类暴涨」的微观机制:记忆依赖任务最需要「上次在哪一步、为什么失败」。
Figure 8:残留边界——接触迁移仍失败
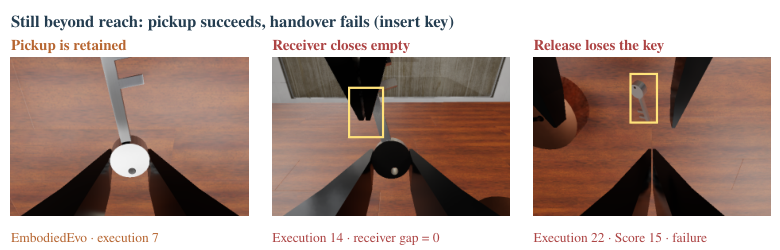
插钥匙 layout 44:donor 手臂保住了钥匙,receiver 合爪却没夹住杆(图中高亮),最终释放丢钥匙。细粒度接触仍是硬边界——这与 HexaShell 的结论一致:卡的是接触物理,不是推理。
Figure 9:经验迁移到更弱的 executor
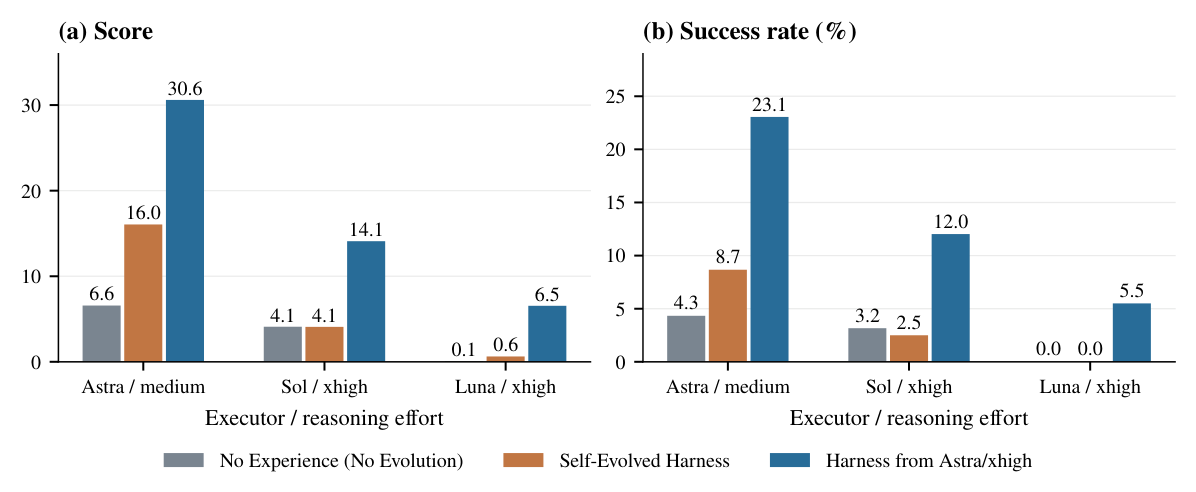
三条件对照:No Experience / Self-Evolved / Harness from Astra。在相同场景上:
- Astra/medium 从 Astra/xhigh 的 harness 获益(验证「推理档位」不同也能用);
- Sol 用 Astra harness 达 12.03% SR(自己演化只有 ~2.5%);
- Luna 从 0 → 5.50%。
「能产出有用控制知识」和「能用上它」是两种能力。
Figure 10:分任务的经验增益条形图
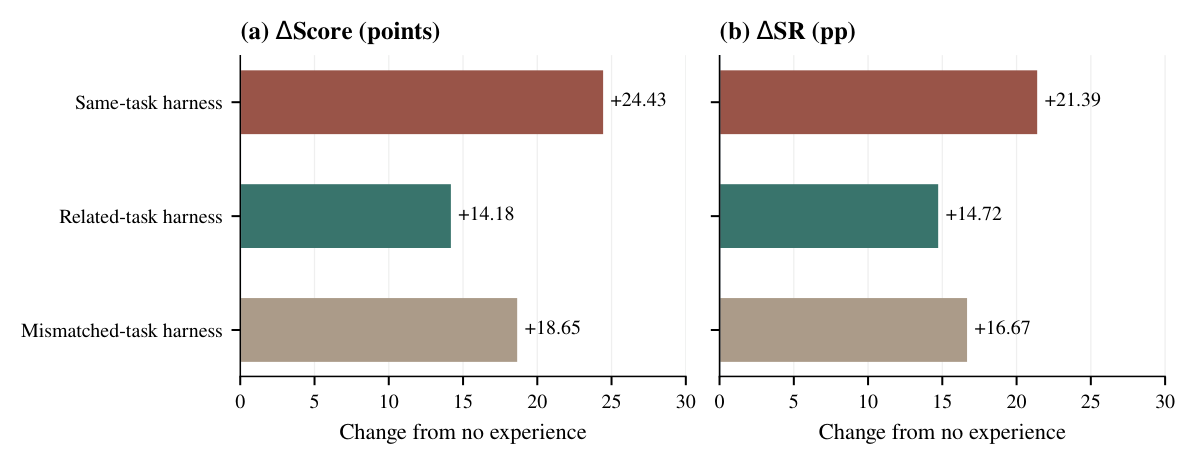
每根柱 = 相对 No Experience 的 ΔScore / ΔSR。增益高度不均:Memory、部分 Open / Long-Horizon 任务提升大;纯接触精密任务几乎不动。与 Figure 8 互相印证。
Figure 11:同等性能下的 token / 成本
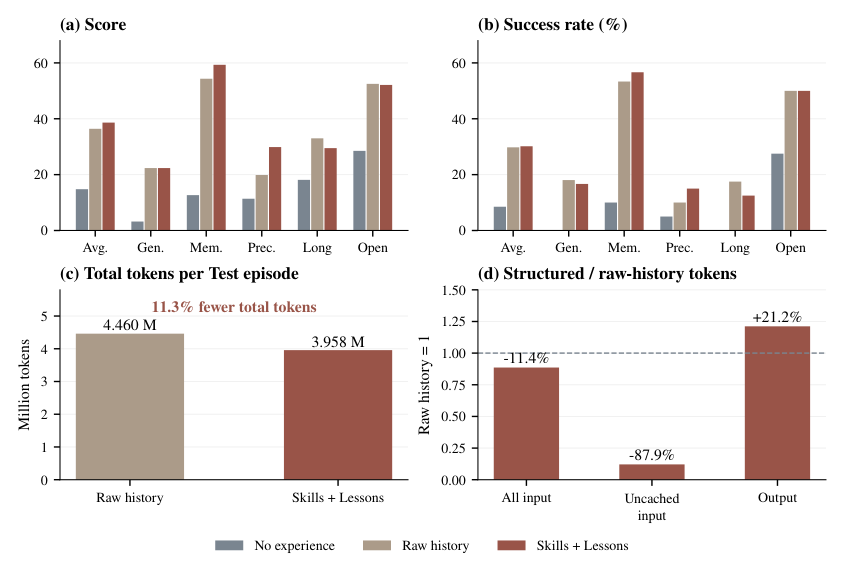
- (a)(b) Raw History 与 Skills/Lessons 的 Score / SR 接近;
- (c) 但 Skills/Lessons 把 Test 阶段总用量从约 4.46M token 量级压下来,执行成本约 -53%。
经验库不是「把历史全塞上下文」,而是结构化有损压缩——保留决策相关部分。
Figure 12:一条被留下并加了执行检查的 Lesson
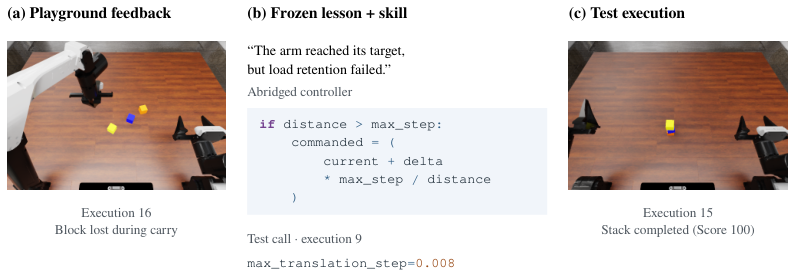
- 左:Playground execution 16 记录到「负载掉落」;
- 中:冻结后的 Lesson 明确区分「到达目标位姿」与「负载仍被抓稳」;
- 右:控制器据此限制多余运动并加检查。
这是 Skills/Lessons 机制的最小完整闭环:失败 → 教训 → 可执行检查。
Figure 13:成功、迁移与回归
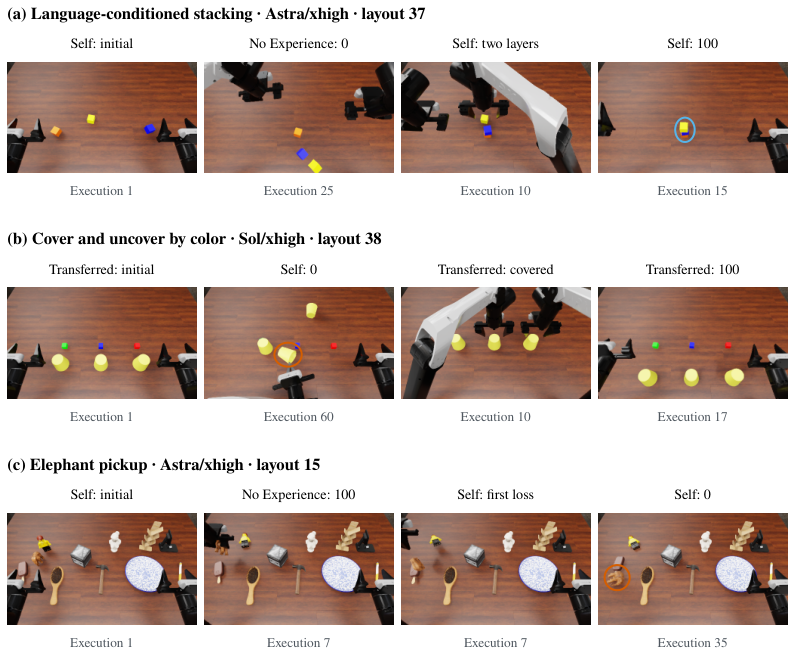
- (a) 语言堆叠 layout 37:自演化 harness 完成堆叠(678 步 vs 自 harness 需 680 步仍未过);
- (b) 盖/揭任务:Astra 的 harness 能让 Sol 成功——跨模型迁移实例;
- (c) 也存在回归:某些配置下强 executor 用外来 harness 反而变差。经验不是越多越好,**适用条件(Lesson 的 when)**很关键。
Figure 14:真实复用中的 Skill + 两条 Lesson
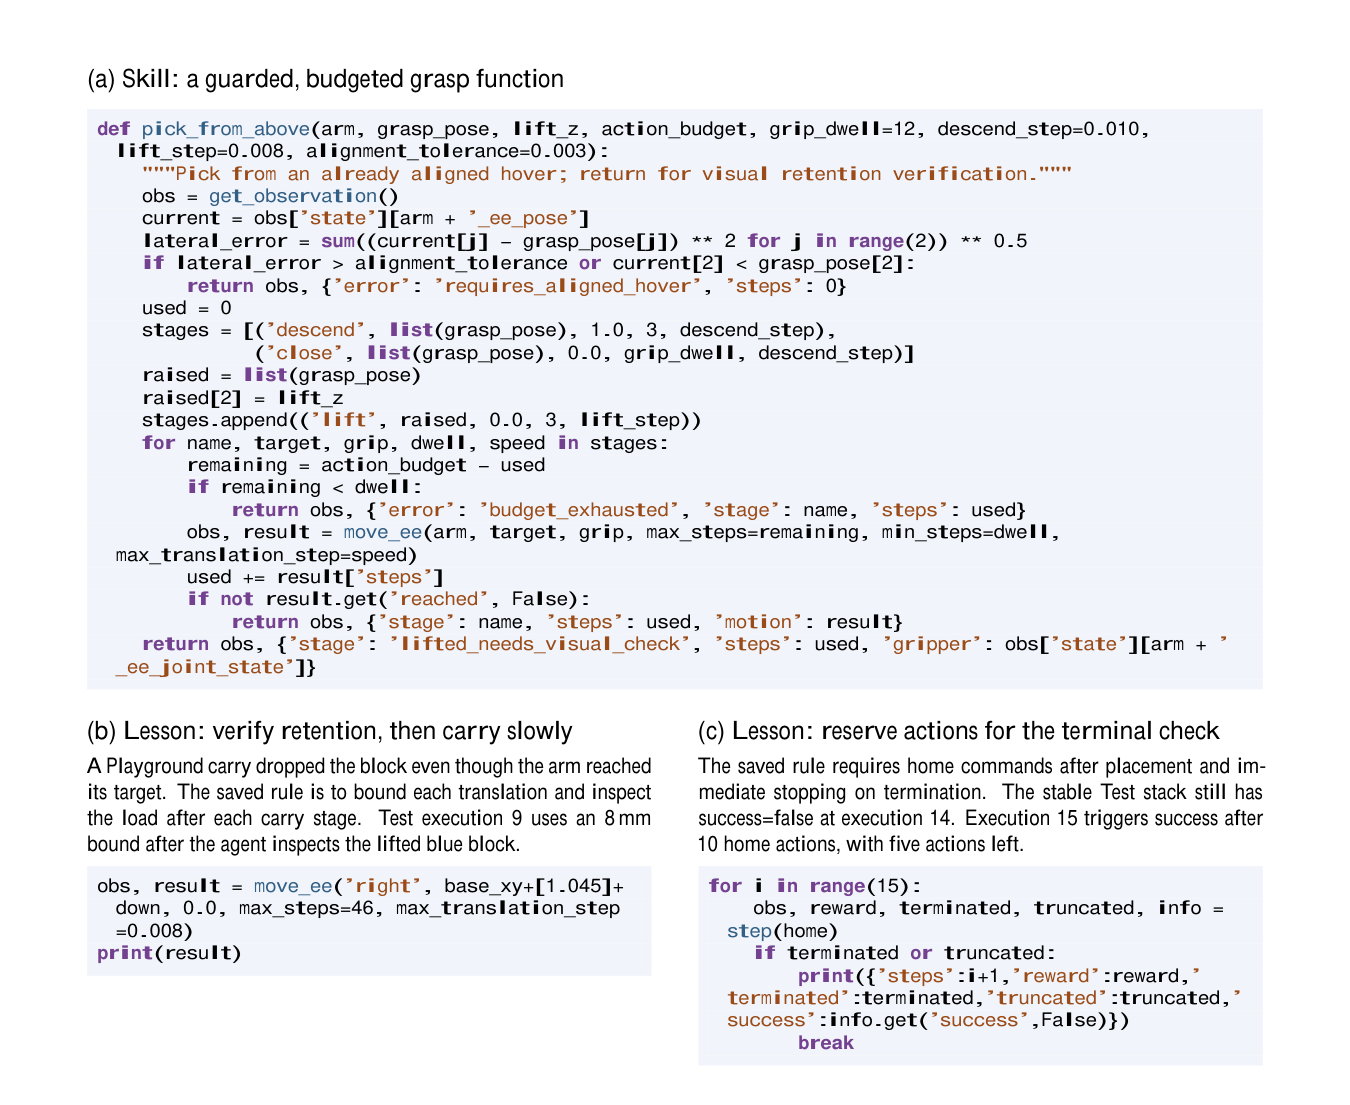
(a) 完整冻结的 pick_from_above:把「按测量位姿下移 → 合爪 → 抬升」的 controller 组合起来,并在抬升前检查对齐与抓稳。(b)(c) 两条 Lesson 的实际条目。这是论文最「程序员友好」的一张图:经验就是带注释、带前置检查的 Python,不是隐向量。
Figure 15:完整堆叠 episode 的端点观测
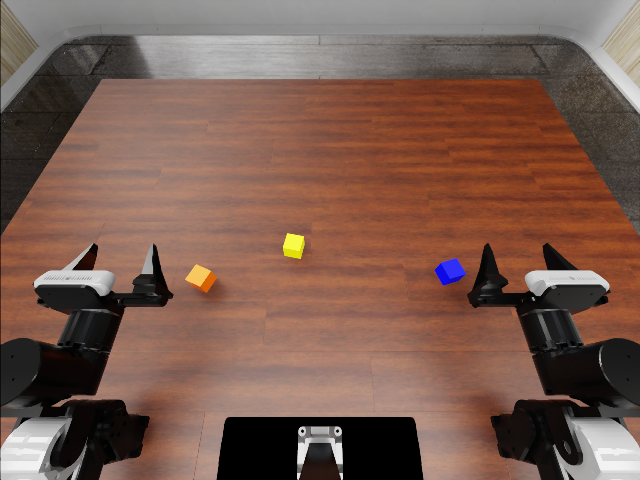
初始头视相机由 agent 自己打开;终帧由环境记录。execution 15 之后 agent 收到 success 反馈并结束。用来说明:物理反馈(包括成功本身)也是 Lesson 的来源,不只是失败日志。
🧪 实验:排行榜与配对消融
官方榜对照(2026-10-09 快照节选)
| 模型 | 类型 | 平均 SR | Memory SR | Open SR |
|---|---|---|---|---|
| GPT-6-Astra | Agent | 22.48% | 38.67% | 31.00% |
| Awomo-0.5 | WAM | 29.64% | 41.22% | 22.92% |
| VPP2 | VLA | ~32% | 55.56% | — |
| EmbodiedEvo | Agent+Harness | 37.82% | 69.67% | 53.00% |
细节:Generalization / Precision 仍偏弱(Precision SR 低于 VPP2 的 35.17%),Long-Horizon SR 23.50% 低于 Simate-beta 的 43.42%——「记忆与开放性」暴涨,「长程与精密」仍是短板。
配对消融(同 executor 同场景)
| 条件 | SR |
|---|---|
| Astra/xhigh,仅任务描述(无 harness) | 8.50% |
| Astra/xhigh,+ 演化 harness | 30.17% |
| Astra 官方发布数字(含 wiki) | 22.48% |
| EmbodiedEvo(Astra/xhigh + wiki + harness) | 37.82% |
经验迁移矩阵(固定 12 个目标任务)
| Executor | 无经验 | 自演化 | Astra/xhigh 经验 |
|---|---|---|---|
| Astra/medium | — | — | +18.72 pp(相对无经验) |
| Sol/xhigh | ~2.5% | ~2.5% | 12.03%(+8.86) |
| Luna/xhigh | 0% | ~0% | 5.50%(+5.50) |
另有 Table 7:Playground 上最终没成功的任务也能产出有用经验——「完成任务」不是「学到东西」的必要条件。
💡 评析:三个亮点,三条边界
三个亮点
- 冻结协议干净:Playground 与 Test 场景隔离 + harness 只读,直接回应「是不是边测边学刷榜」的质疑。
- 把「会用经验」和「会采经验」拆开测:跨模型、跨推理档位的迁移实验设计得比多数「自进化」论文扎实。
- 经验是代码+文本,不是黑箱向量:可审计、可 diff、可单元测试——和 HexaShell 的「工具演化」形成有趣互文(一个偏「修工具」,一个偏「修程序+记教训」)。
三条边界
- 纯仿真:尚未在真机验证冻结 harness 的迁移;物理接触噪声、标定误差未覆盖。
- 精密 / 液体 / 强长程仍难:与榜单一致——接触力学不是「多写几行 Lesson」就能补的。
- executor 模型能力仍是天花板:harness 再好,Astra 抓不准几何时 Lesson 只能少犯错,不能凭空产生毫米级对准。
🗺️ 在「具身 agent 谱系」里的位置
- 对比 HexaShell(46.9%):同属 coding-agent 路线;HexaShell 偏「薄 harness + 工具库 + 第二 agent 读日志修 bug」,EmbodiedEvo 偏「Skills/Lessons 结构化经验 + 冻结复用」。两者都证明:不训练也能大幅超过裸 VLA agent。
- 对比 VPP2 / Flash-WAM:后者是学习型策略/世界行动模型;EmbodiedEvo 是 agent+代码,Memory 任务上以 69.67% 大幅超过 VPP2 的 55.56%。
- 对比 Awomo-0.5:WAM 路线的代表(29.64%);EmbodiedEvo 在榜单上把「agent 编码」路线推到了更前面。
- 谱系标签:自进化 agent / 经验库 / 冻结评测协议。
📊 图表总索引
| 图 | 内容 | 本站文件 |
|---|---|---|
| Figure 1 | 总览:Playground→Freeze→Test | 本文插图 |
| Figure 2 | VLA / Agent+VLA / 代码策略三范式 | 本文插图 |
| Figure 3 | 统一仿真接口与提交链路 | 本文插图 |
| Figure 4 | Astra 两类失败轨迹 | 本文插图 |
| Figure 5 | 方法框架(演化 + 冻结) | 本文插图 |
| Figure 6 | 有 / 无 wiki 的增益 | 本文插图 |
| Figure 7 | 决定性操作/阶段被改写 | 本文插图 |
| Figure 8 | 接触迁移失败(边界) | 本文插图 |
| Figure 9 | 经验迁移到弱 executor | 本文插图 |
| Figure 10 | 分任务增益条形图 | 本文插图 |
| Figure 11 | Token / 成本对比 | 本文插图 |
| Figure 12 | Lesson + 执行检查案例 | 本文插图 |
| Figure 13 | 成功 / 迁移 / 回归 | 本文插图 |
| Figure 14 | Skill 代码与 Lesson 条目 | 本文插图 |
| Figure 15 | 堆叠 episode 端点观测 | 本文插图 |
(论文另有 Table 3 榜单、Table 4–6 配对/迁移、Table 7–9 成本与分任务,正文以文字表格复现,未嵌入图片。)
❓ 自测 Q&A
Q1:为什么说「每任务只有 1 个 Playground 场景」很关键?
因为 Test 布局与之完全不同;任何提升都必须来自可迁移的过程知识,而不是场景记忆。冻结后也不能再交互采样。
Q2:wiki 和 Lesson 有什么区别?
wiki 是任务级「菜谱」(做什么);Lesson 是交互级「失败模式 + 恢复 + 适用条件」(别踩什么坑)。Figure 6 显示:即使两边都有 wiki,harness 仍再涨 ~22 pp。
Q3:为什么 Skills/Lessons 能省 53% 成本?
它们把长历史压成「条件化过程 + 关键教训」,Test 时不必把全部原始轨迹塞进上下文。
Q4:弱 executor 为什么能用强 executor 的经验?
Skill 描述的是任务相关过程(抓哪、怎么验),与 executor 的具体规划风格耦合较弱;只要接口(观测/动作原语)一致就能执行。
Q5:这条路线和 HexaShell 谁更强?
榜单快照上 HexaShell v2 的 46.9% 高于本文 37.82%——但两者协议细节(工具库 vs Skills/Lessons、是否双 agent、预算)不同,不宜简单横比;共同结论是 coding-agent 路线已稳定超过裸 VLA agent。
📚 资源与延伸
- 论文:arXiv 2610.18867
- 主页:lab.einsia.ai/embodiedevo
- 同评测体系:HexaShell 精读、VPP2 精读、Flash-WAM 精读
- 知识铺垫:什么是世界模型、WAM 世界行动模型全景分析