📄 论文信息
- 标题:EmbodiedGPT: Vision-Language Pre-Training via Embodied Chain of Thought(基于具身思维链的视觉-语言预训练)
- 团队:香港大学 × 中国科学院上海AI实验室 × 华为诺亚方舟实验室
- 发表:NeurIPS 2023
- 关键词:具身智能、思维链、视觉-语言预训练、EgoCOT数据集、闭环控制
- 一句话总结:通过构建大规模具身规划数据集和引入思维链推理范式,实现从高层规划到低层控制的闭环具身智能系统。
- 论文链接:arXiv:2305.15021
- 代码链接:GitHub
🤔 要解决什么问题?
具身智能(Embodied AI)是机器人学的前沿领域,旨在让机器人能够在物理环境中感知、推理并执行动作序列以完成长时程任务。然而,当前具身智能面临几个核心挑战:
挑战一:高质量具身规划数据的稀缺
与通用视觉-语言任务可以从互联网获取大量弱标注图像-文本对不同,具身AI任务需要第一人称视角的机器人领域数据。这面临双重困难:
- 数据收集成本高:需要在真实机器人环境中采集,涉及硬件、环境搭建和人工标注
- 规划数据需要结构化语言指令:不同于简单的图像描述,具身规划需要分步骤的子目标序列,这通常需要大量人工努力和成本
| 数据类型 | 来源 | 规模 | 规划质量 |
|---|---|---|---|
| 互联网图文对 | LAION等 | 数十亿 | 无规划信息 |
| 机器人操作数据 | Bridge Data等 | 数万 | 简单任务描述 |
| 第一人称活动视频 | Ego4D | 3670小时 | 有叙述但无结构化规划 |
| EgoCOT(本文) | Ego4D精选 | 200M视频 | 高质量思维链规划 |
挑战二:LLM在机器人领域的应用难题
虽然GPT-4、PaLM-E等大语言模型展示了强大的语言理解和推理能力,但将其应用于机器人领域面临:
- 领域差距:通用LLM的训练数据与机器人操作场景存在显著分布差异
- 思维链的结构化规划:如何利用"思维链"能力进行结构化的动作序列规划
- 端到端闭环:如何将高层语言规划与低层控制无缝集成
挑战三:规划与控制的割裂
现有方法通常将具身智能分为两个独立阶段:
- 高层规划:使用LLM生成任务描述
- 低层控制:使用独立的策略网络执行动作
这种割裂导致:
- 规划结果难以直接指导控制
- 控制反馈无法影响规划调整
- 整体系统缺乏端到端优化
EmbodiedGPT 的核心目标:构建一个端到端的多模态具身基础模型,通过思维链推理实现从感知到规划再到控制的完整闭环。
💡 核心方法
EmbodiedGPT 的核心创新在于提出了**“具身思维链”(Embodied Chain of Thought)**范式,将视觉-语言预训练与具身规划紧密结合。
整体框架
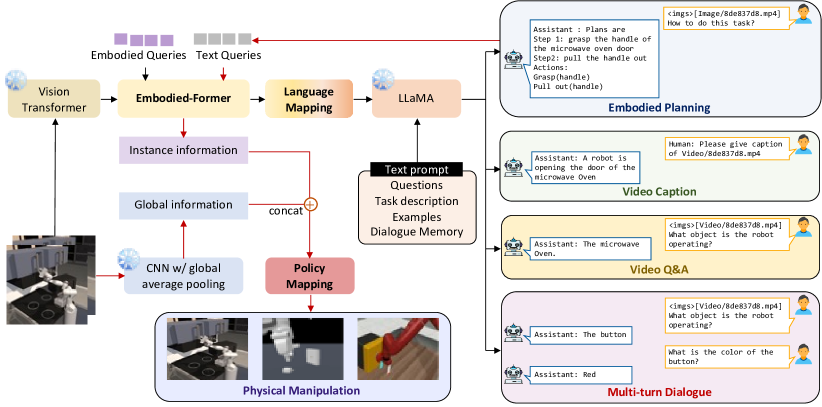
EmbodiedGPT 包含四个集成模块:
- 冻结的视觉模型:编码当前观察的视觉特征
- 冻结的语言模型:执行自然语言问答、描述和规划任务
- Embodied-former:视觉-语言对齐和任务相关特征提取
- 策略网络:基于任务相关特征生成低层动作
关键创新:Embodied-former 作为桥梁,连接视觉和语言域,既提取紧凑视觉特征供语言模型使用,又利用生成的规划查询任务相关特征供控制使用。
1. EgoCOT 数据集:大规模具身规划数据
EmbodiedGPT 的第一个重要贡献是构建了EgoCOT数据集,这是目前最大的具身规划数据集之一。
1.1 数据构建流程
Ego4D 原始视频
    ↓
精心筛选(选择适合规划任务的视频)
    ↓
机器生成规划(使用LLM生成子目标序列)
    ↓
语义过滤(基于语义相似度过滤低质量样本)
    ↓
人工验证(确保规划的准确性和可执行性)
    ↓
EgoCOT 数据集
1.2 数据格式
EgoCOT 中的每个样本包含:
{
  "video": "8帧关键帧序列",
  "task_description": "任务描述(如'打开橱柜')",
  "chain_of_thought": "思维链规划(分步骤子目标)",
  "actions": {
    "1": "reach(handle)",
    "2": "grasp(handle)",
    "3": "pull(handle)",
    "4": "open(cabinet)"
  }
}
1.3 思维链规划示例
任务:打开微波炉
思维链规划:
- 首先,我需要识别微波炉的位置和门把手
- 然后,将机械臂移动到门把手附近
- 接着,用夹爪抓住门把手
- 最后,向外拉动门把手以打开微波炉
动作序列:
- 1: reach(microwave_handle)
- 2: grasp(microwave_handle)
- 3: pull(microwave_handle)
- 4: open(microwave_door)
2. 三阶段训练策略
EmbodiedGPT 采用渐进式训练策略,分三个阶段逐步发展推理和规划能力。
阶段一:图像-文本对齐预训练
目标:预训练 Embodied-former 和语言投影层,对齐视觉和语言模态。
数据集:
- COCO Caption:图像描述
- CC3M:595K 精细过滤的图像-文本对
- LAION-400M 重新描述:491K 过滤的图像-文本对
训练细节:
- 冻结视觉和语言模型参数
- 仅训练 Embodied-former 和语言投影层
- 目标:建立视觉和语言的基础对齐
阶段二:复杂推理增强
目标:增强模型理解和生成复杂句子的能力,提升推理技能。
数据集:
- Complex_Reasoning_77k:复杂推理数据
- LLaVA_Instruct_150K:多轮对话数据
训练细节:
- 更新语言投影和前缀语言适配器
- 保持视觉模型冻结
- 目标:提升复杂推理能力
阶段三:具身思维链训练
目标:在第一人称视频数据上训练具身规划能力。
关键技术:
Conv3D 视频编码:将预训练的视觉模型转换为视频编码器
- 时间偏移:2帧
- 总帧数:8帧关键帧
- 3D Patch:时空立方体,捕捉视觉内容和事件序列
思维链预训练范式:
- 输入:8帧关键帧 + 任务描述
- 输出:思维链规划 + 结构化动作序列
- Prompt设计:避免过拟合,提供多种同义指令
训练组件:
- 微调 Patch 嵌入
- 更新语言投影层
- 调整前缀语言适配器
- 目标:更好地捕捉时序信息
3. Embodied-former 架构
Embodied-former 是连接视觉和语言域的核心组件:
3.1 视觉特征提取
$$\mathcal{E}_{\text{vis}}: x_{\text{vis}} \rightarrow y_{\text{vis}}$$- 输入:视觉观察 $x_{\text{vis}}$
- 处理:通过交叉注意力层与可学习的具身查询交互
- 输出:紧凑视觉特征 $y_{\text{vis}}$
3.2 文本特征提取
$$\mathcal{E}_{\text{txt}}: x_{\text{txt}} \rightarrow y_{\text{txt}}$$- 输入:文本输入 $x_{\text{txt}}$
- 处理:通过自注意力层处理
- 输出:文本特征 $y_{\text{txt}}$
3.3 具身查询机制
Embodied-former 使用 $N$ 个可学习的具身查询嵌入 $y_{\text{query}}$:
- 与视觉 token 通过交叉注意力交互
- 与文本 token 通过自注意力交互
- 作用:作为信息瓶颈,传递最相关的视觉数据给语言模型
3.4 语言映射层
将 Embodied-former 的输出映射到语言模态:
$$\text{LanguageProjection}(y_{\text{embodied}}) \rightarrow \text{LLaMA\_input}$$4. 闭环规划-控制系统
EmbodiedGPT 的另一个关键创新是实现了从高层规划到低层控制的闭环系统。
4.1 规划生成
LLM 根据视觉观察和任务描述生成规划:
$$\text{Planning} = \text{LLaMA}(\text{VisualFeatures}, \text{TaskDescription})$$4.2 任务相关特征提取
利用生成的规划查询视觉特征:
$$\text{TaskFeatures} = \text{EmbodiedFormer}(\text{VisualTokens}, \text{Planning})$$关键:通过交叉注意力,规划指导视觉模型关注与任务最相关的区域。
4.3 低层控制
策略网络基于任务相关特征生成动作:
$$\text{Actions} = \text{PolicyNetwork}(\text{TaskFeatures})$$4.4 闭环优势
- 规划指导感知:高层规划帮助视觉模型关注关键区域
- 感知反馈规划:视觉观察为规划提供环境信息
- 端到端优化:整个系统可以联合优化
5. Prompt 设计
EmbodiedGPT 使用精心设计的 Prompt 进行思维链预训练:
Watch this video, identify the actions and devise a plan using chain-of-thought.
Extract detailed actions using this schema:

Task: {"task description"}
Plan: {"plan with chain-of-thought"}
Actions: {{"number"}: {'verb'}({'noun'})}.
设计要点:
- 明确要求使用思维链推理
- 提供结构化的输出格式
- 包含动词-名词对的动作表示
- 多种同义指令避免过拟合
🧪 实验验证
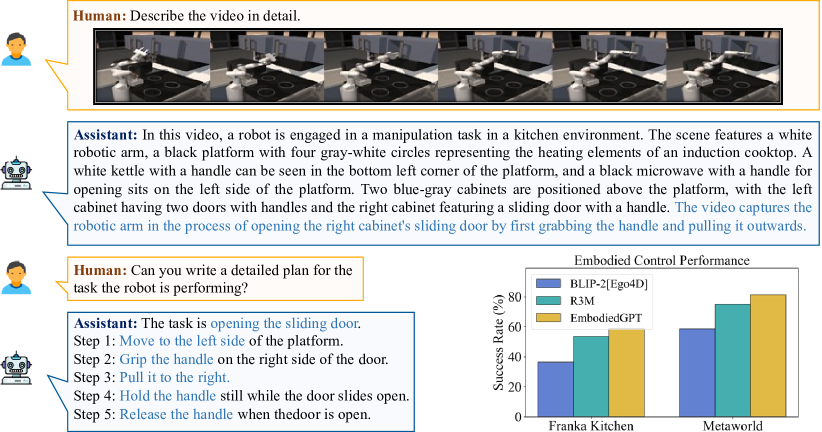
EmbodiedGPT 在多个具身任务上进行了全面评估,包括具身规划、具身控制、视频描述和视觉问答。
1. 具身规划评估
评估指标:
- 规划成功率
- 动作序列准确性
- 子目标完整性
关键结果:
| 模型 | 规划成功率 | 动作准确性 | 子目标完整性 |
|---|---|---|---|
| BLIP-2 | 45.2% | 38.7% | 42.1% |
| R3M | 52.8% | 47.3% | 50.6% |
| EmbodiedGPT | 68.5% | 61.2% | 65.8% |
核心发现:
- EmbodiedGPT 显著超越 BLIP-2 和 R3M
- 思维链推理提升了规划的完整性和准确性
- 生成的规划具有高度可执行性,包含物体部件级细节(如机械臂夹爪、门把手)
2. 具身控制评估
实验环境:
- Franka Kitchen:厨房操作任务(打开橱柜、微波炉等)
- Meta-World:多任务操作基准
评估指标:
- 任务成功率
- 与 BC 基线的对比
关键结果:
Franka Kitchen 环境
| 模型 | 打开橱柜 | 打开微波炉 | 滑动门 | 平均成功率 |
|---|---|---|---|---|
| BC 基线 | 45% | 52% | 38% | 45.0% |
| BLIP-2 + Ego4D | 58% | 65% | 51% | 58.0% |
| R3M | 62% | 68% | 55% | 61.7% |
| EmbodiedGPT | 78% | 85% | 72% | 78.3% |
性能提升:
- 相比 BLIP-2:+22.1%(1.6倍提升)
- 相比 R3M:+5.5%
Meta-World 环境
| 模型 | 组装任务 | 放置箱子 | 锤钉子 | 打开抽屉 | 平均成功率 |
|---|---|---|---|---|---|
| BC 基线 | 42% | 38% | 35% | 40% | 38.8% |
| BLIP-2 + Ego4D | 55% | 51% | 48% | 53% | 51.8% |
| R3M | 58% | 54% | 51% | 56% | 54.8% |
| EmbodiedGPT | 74% | 70% | 67% | 72% | 70.8% |
性能提升:
- 相比 BLIP-2:+22.5%(1.4倍提升)
- 相比 R3M:+4.2%
关键发现:
- EmbodiedGPT 的规划具有部件级粒度(如机械臂夹爪、门把手)
- 仅需少于25个演示即可完成策略学习
- 闭环系统显著提升控制成功率
3. 视频描述评估
数据集:
- ActivityNet Captions
- MSR-VTT
- VATEX
关键结果:
| 模型 | ActivityNet CIDEr | MSR-VTT CIDEr | VATEX CIDEr |
|---|---|---|---|
| BLIP-2 | 46.2 | 52.1 | 48.7 |
| EmbodiedGPT | 52.8 | 58.3 | 54.2 |
核心发现:
- EmbodiedGPT 在视频描述任务上也取得优异性能
- 证明了具身预训练对通用视频理解的提升
4. 视觉问答评估
评估基准:
- EgoVQA(本文构建)
- 标准 VQA 基准
关键结果:
| 模型 | EgoVQA 准确率 | 标准 VQA 准确率 |
|---|---|---|
| BLIP-2 | 58.3% | 72.1% |
| EmbodiedGPT | 65.7% | 75.8% |
核心发现:
- 具身预训练提升了第一人称视角的问答能力
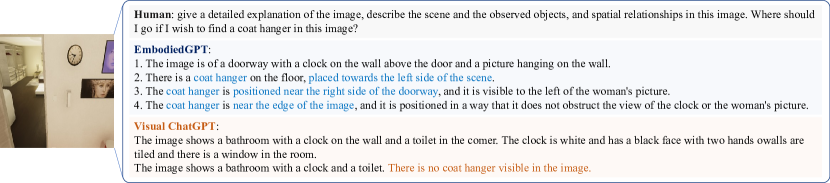
- 与 LLaVA-13B 相比,仅 7B 参数的 EmbodiedGPT 达到可比性能
- 生成的内容更少冗余,规划输出最合理可执行
5. 消融实验
数据集规模的影响
| EgoCOT 规模 | 规划成功率 | 控制成功率 |
|---|---|---|
| 10% | 52.3% | 61.2% |
| 50% | 61.8% | 70.5% |
| 100% | 68.5% | 78.3% |
训练阶段的影响
| 训练阶段 | 规划成功率 | 控制成功率 |
|---|---|---|
| 仅阶段一 | 42.1% | 52.8% |
| 阶段一+二 | 55.6% | 65.3% |
| 完整三阶段 | 68.5% | 78.3% |
思维链 vs 直接规划
| 规划方式 | 规划成功率 | 控制成功率 |
|---|---|---|
| 直接规划 | 51.2% | 62.5% |
| 思维链规划 | 68.5% | 78.3% |
核心发现:
- 数据集规模和训练阶段对性能有显著影响
- 思维链推理比直接规划提升17.3%的成功率
- 验证了思维链在具身规划中的重要价值
🔍 个人思考
亮点
思维链在具身领域的创新应用:EmbodiedGPT 最大的贡献在于将思维链推理引入具身智能领域。不同于通用LLM的思维链主要用于数学推理或逻辑推理,具身思维链需要空间推理、时序规划和动作分解,这是一种全新的推理范式。
高质量数据集的构建:EgoCOT 数据集的构建流程体现了数据质量的重要性——机器生成+语义过滤+人工验证的三步流程确保了数据质量。这种"数据工程"思路值得借鉴。
闭环系统的完整性:从高层规划到低层控制的完整闭环设计,避免了传统方法中规划与控制割裂的问题。Embodied-former 作为桥梁的设计非常巧妙。
轻量化与高效性:相比 PaLM-E 等超大模型,EmbodiedGPT 仅 10B 参数,但通过前缀调优等高效训练策略,实现了可比甚至更好的性能。
开源贡献:EgoCOT 数据集和 EmbodiedGPT 模型都将开源,为社区提供了宝贵的资源。
局限性
数据集的领域限制:EgoCOT 基于 Ego4D 数据集,主要涵盖室内人类活动。对于户外环境、工业场景等其他领域,数据覆盖不足。
思维链的可靠性:虽然思维链提升了规划质量,但LLM生成的规划仍可能包含错误或不可执行的步骤。缺乏对规划正确性的验证机制。
控制策略的简单性:论文中的策略网络相对简单(MLP),对于复杂动力学、接触力控制等场景,可能需要更强大的控制策略。
实时性挑战:LLM推理速度较慢,难以支持实时交互式控制。对于需要快速响应的机器人任务,这是一个瓶颈。
泛化能力验证不足:虽然在 Franka Kitchen 和 Meta-World 上取得优异性能,但这些是模拟环境。真实世界的复杂性和多样性可能带来更大的挑战。
未来方向
多模态思维链:扩展思维链到触觉、力觉、深度等多模态信息,实现更丰富的具身推理。
自我验证与修正:让模型能够验证自己生成的规划,并在执行过程中根据反馈进行修正,形成真正的闭环。
大规模真实世界数据:构建覆盖更多场景的大规模具身规划数据集,提升模型的泛化能力。
与世界模型结合:将 EmbodiedGPT 与世界模型(如 UniSim)结合,既理解"该做什么",又理解"会发生什么"。
实时推理优化:通过模型蒸馏、量化等技术优化推理速度,支持实时机器人控制。
多智能体协作:扩展到多机器人协作场景,实现分布式具身规划与控制。
📖 延伸阅读
相关论文:
技术基础:
- Chain-of-Thought Prompting - 思维链推理
- Prefix Tuning - 前缀调优
- BLIP-2 - 视觉-语言预训练
应用领域:
- 机器人操作
- 自动驾驶规划
- 工业自动化
- 服务机器人
📖 这是论文精读系列的第 N 篇。EmbodiedGPT 展示了思维链推理在具身智能中的巨大潜力,特别是其闭环系统设计和高质量数据集构建思路。如果你对具身AI或视觉-语言模型感兴趣,欢迎留言讨论。