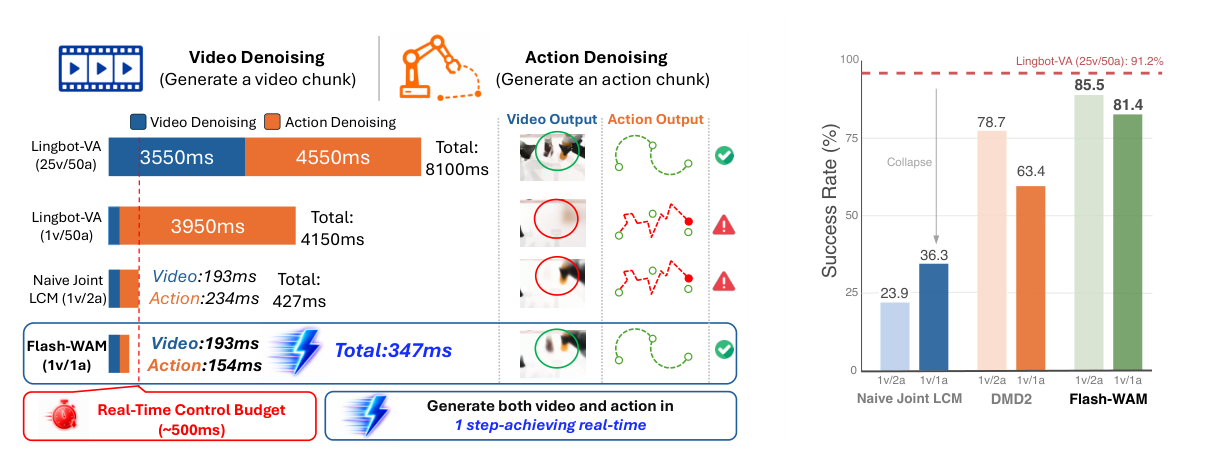
图 1 逐图讲解:全文第一张图就是「问题 + 成绩」双面板,左右各一张坐标图。(a) 每块推理延迟(横轴方法、纵轴毫秒,单位 ms):教师 LingBot-VA(25 视频步 / 50 动作步)总延迟 8100 ms(视频去噪约 3550 + 动作去噪约 4550);只把视频砍到 1 步、动作仍 50 步仍有约 3950 ms——说明光减视频步没用,动作步才是大头;朴素联合 LCM 的 1v/2a 是 4150 ms;Flash-WAM 的 1v/2a 降到 427 ms(视频约 193 + 动作约 234),1v/1a 再降到 347 ms(视频约 193 + 动作约 154)。图中约 500 ms 处有红色虚线 = 实时预算(2 Hz,与 RoboTwin 2.0 单块 640 ms 执行时间兼容),只有 Flash-WAM 的两个配置落进预算内。(b) RoboTwin 2.0 平均成功率(Clean + Randomized 两划分平均):教师 91.2%;朴素联合 LCM 在 1v/2a 只剩 23.9%、1v/1a 是 36.3%(图中标注 Collapse);DMD2 是 78.7% / 63.4%;Flash-WAM 是 85.5% / 81.4%——紧贴教师曲线。视频-only LCM 不在本图,但表 1 里是 78.8% / 73.7%。左右两图合起来读出全文论点:「快」和「不崩」必须同时做到,而现成蒸馏只做到了前者。
配图说明:本文收录论文全部 4 张插图(Figure 1 ~ Figure 4),放在站内 /images/flash-wam/,逐张讲解,文末附图表总索引表。论文来自 Northeastern University、University of Georgia 与 EmbodyX,arXiv 2606.05254(v2,2026-10-03),项目页 flashwam.github.io。这是一篇「诊断 + 修一个损失函数」的短论文,篇幅不大,但结论对所有做 WAM 推理加速的人都有用。
📄 论文信息
- 标题:Flash-WAM: Modality-Aware Distillation for World Action Models
- 机构:Northeastern University、University of Georgia、EmbodyX
- 时间:2026-10(arXiv 2606.05254 v2)
- 关键词:世界行动模型(WAM)、步蒸馏、一致性蒸馏(LCM / consistency distillation)、模态感知、SNR shift、实时推理
- 一句话总结:不是所有模态都该用同一个一致性函数。视频高维冗余、噪声集中在高 σ,标准 LCM 够用;动作低维、精度敏感、噪声铺满低 σ,而标准 LCM 的梯度在 σ→0 时按 σ² 消失——于是动作流几乎学不到东西,任务成功率从 91% 崩到 24%。把动作流换成 b(σ) = −σ 的线性版本,问题解决。
🎯 一句话版本:核心数字
| 配置 | 每块延迟(L40S) | RoboTwin 2.0 平均成功率 | 相对教师 |
|---|---|---|---|
| LingBot-VA 教师(25 视频步 / 50 动作步) | 8.1 s | 91.25% | 1.0× |
| + 朴素联合 LCM(1v/2a) | 4.15 s | 23.97%(崩) | 19.0× |
| + 视频-only LCM(1v/2a) | 4.15 s | 78.79% | 19.0× |
| + DMD2(1v/2a) | 4.15 s | 78.74% | 19.0× |
| + Flash-WAM(1v/2a) | 0.43 s | 85.54% | 19.0× |
| + Flash-WAM(1v/1a) | 0.347 s | 81.41% | 23.3× |
(v/a 表示视频/动作的去噪步数;教师是 25v/50a。LIBERO 上教师则是 20v/50a。)
「1v/1a」意味着视频和动作各只跑一次前向,延迟 347 毫秒,已经落进作者设定的 500 毫秒实时预算内。这是本文最硬的工程结果。
🗺️ 先分清:哪些是仿真,哪些是真机
| 评测 | 环境 | 细节 |
|---|---|---|
| RoboTwin 2.0(表 1、表 4、图 4) | 仿真 | 50 个双臂任务;Clean 与 Randomized 两划分(后者扰动物体位姿、光照、场景布局);每任务多回合闭环 |
| LIBERO 四套件(表 2) | 仿真 | Spatial / Object / Goal / Long-horizon,各 500 条演示;教师先按 LingBot-VA 协议在每套件上微调再蒸馏 |
| Motus 跨架构(表 5) | 仿真 | RoboTwin 的 10 任务子集,每任务 50 次试验 |
| Unitree G1 三任务(表 3、图 3) | 真机 | Dex1-1 夹爪人形机器人;T1 开锅盖放土豆、T2 从干扰物中抓红瓶、T3 放粉块到十字标记;每任务 50 条遥操作演示、每方法 20 次 rollout |
| 图 4 定性 | 仿真(开环) | RoboTwin Clean 的「pick diverse bottles」任务,开环自轮回灌(不回填真实观测) |
一句话:主结果来自 2 个仿真基准 + 1 个真机平台;蒸馏本身不接触真机数据(G1 只做最终评测),训练全部在仿真演示上完成。
🧭 读前 5 分钟:四个概念
- WAM 的延迟结构:一个动作块 = 视频去噪 N_v 步 + 动作去噪 N_a 步,每步都是一次完整 Transformer 前向。LingBot-VA 默认 25+50=75 次前向,8.1 秒;实时控制要求每块 <0.5 秒(2 Hz),差距 16 倍。
- 步蒸馏(step distillation):训练一个学生网络,把「多步 ODE 积分」压缩成「一步映射」。主流两派:轨迹跟随(consistency distillation,学生学「任意噪声点 → 干净终点」)与分布匹配(DMD2,额外训练辅助 score 网络对齐分布)。Flash-WAM 走轨迹跟随,因为它不需要辅助网络、能直接嵌进 flow matching。
- 一致性函数的形式:f(x_σ, σ) = a(σ)·x_σ + b(σ)·v_θ(x_σ, σ),边界条件 a(0)=1、b(0)=0。网络参数只通过 v_θ 进入损失,所以损失对参数的梯度被 |b(σ)| 缩放——|b| 小的地方,网络学不到东西。这是整篇论文的支点。
- SNR shift:flow matching 常用 σ = s·σ̃ / (1+(s−1)σ̃) 把采样质量推向高噪声;s 越大越偏高噪声。WAM 里视频的 shift s_v 大于动作的 s_a:视频高维冗余,高噪声下仍信息丰富;动作低维精确,需要更平缓的时间表。结果就是视频噪声堆在高 σ,动作噪声铺满全区间、在低 σ 还有大量质量。
🗂️ 数据与训练流程:教师从哪来、学生怎么训
Flash-WAM 不从头造数据,它复用现成 WAM 的数据管线,只增加一步「教师微调 + 学生蒸馏」:
- 教师来源:下载 LingBot-VA 的开源 base checkpoint(多任务预训练权重)。LIBERO 上按原作者协议,先在每个套件的 500 条演示上单独微调 4,000 步(AdamW,lr 1e-5,weight decay 0.1,10 步线性 warmup,梯度裁剪 2.0,每卡 batch 1 × 梯度累积 30 = 有效 batch 120,4× H100 约 24 小时),得到各套件专精教师;RoboTwin 侧则直接用已在该基准上训练好的教师权重(论文表 1 标 * 表示自复现)。
- 学生蒸馏:从微调后的教师出发,用 Flash-WAM 损失再训 2,000 步(同一 4× H100 配置,约 24 小时/套件)。关键超参:图像 128×128,动作维度 30,每个视频帧对应 4 个动作步,帧块长度 K=4;视频 SNR shift s_v=5.0、动作 s_a=1.0(正是图 2 中两条噪声曲线分离的来源);动作损失权重 λ_a=1.0,EMA 衰减 0.995,数据尺度 σ_d=0.5,Huber 损失(c=0.001),教师 Euler 步视频用 CFG 且 w ~ U[2,10]、动作用无引导;优化器 AdamW(0.9, 0.999),lr 5e-6,梯度裁剪 2.0,100 步 warmup,有效 batch 48。
- 公平基线:所有 LCM 系基线(朴素联合 / 视频-only / 视频-only+回归正则)共享同一数据、同一 base checkpoint、同一迭代数,只换蒸馏目标——所以表 1/4 的差距可以纯粹归因到损失函数。
- 真机侧:G1 的 50 条/任务遥操作演示用于训练(沿用 LingBot-VA 在真机数据上的协议),Flash-WAM 只改变蒸馏损失;推理时教师本来已减步到 3v/10a(每块 13 次评估),学生 1v/2a 是 3 次、1v/1a 是 2 次。
- 硬件约定:训练用 NVIDIA H100,评测与延迟剖析统一用单张 L40S——图 1 与所有延迟数字都是 L40S 口径,换卡需重测。
🔍 问题:为什么现成蒸馏一用就崩
1. 崩溃现场
回到开篇 Figure 1 的两个面板:视频-only LCM 掉得有限(78.8%),朴素联合 LCM 直接崩(23.9%)——问题出在动作流的蒸馏上。更刺眼的是 Table 4 按任务时长的拆分(后面消融会细读):1v/2a 下 H2 只剩 4.00%、H3 归零。动作误差不是均匀掉点,而是沿子任务链雪崩式累积。
2. 根因:梯度在低噪声段消失
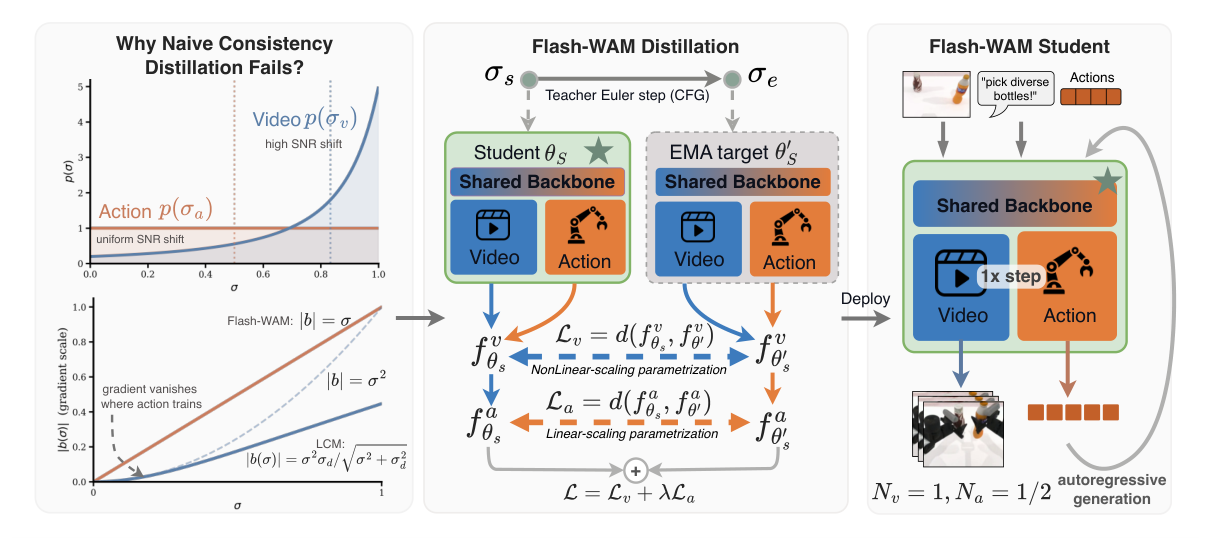
图 2 逐图讲解:方法总览分左、中、右三栏。左栏是问题诊断:横轴是噪声 σ(0 → 1),纵轴是学习信号幅度——蓝色实线是标准 LCM 的 |b_LCM(σ)|,灰色虚线是线性 |b(σ)|=σ。在 σ=0.1 处蓝线比灰线小约 10 倍;σ 越小差距越夸张。下方小字点题:「Standard consistency function passes almost no learning signal at low noise levels, where actions are refined.」中栏是 Flash-WAM 训练管线:上半画着 Video stream 用标准函数(蓝)、下半 Action stream 用线性函数(绿),两条流各自算一致性损失再相加(L = L_v + λ_a·L_a),中间是「Modality-Aware Consistency Functions」标题;左右各挂一个 EMA target 网络图标——架构不动,只换损失。右栏是部署态:蒸馏后的学生在推理时每模态只跑 1 次去噪,从噪声潜变量直接映到干净输出,旁边标注「Single Denoising Step」。整张图把「诊断 → 修法 → 部署」压在一帧里。
论文给出形式化结论(Proposition 1):对任何满足边界条件的一致性函数,
|b(σ)| = |b′(0)|·σ + O(σ²),σ → 0。
- 若 b′(0) ≠ 0,则 |b(σ)| = Θ(σ),线性,梯度不会额外消失;
- 若 b′(0) = 0,则 |b(σ)| = O(σ²),二次消失。
标准 LCM 取 b_LCM(σ) = −σ²σ_d / √(σ²+σ_d²),显然 b_LCM(0)=0 且 b′_LCM(0)=0,对任意 σ_d 都落在二次消失那一类。所以在 LCM 家族里换参数是没用的,必须跳出家族。
一点直觉:一致性损失是「学生输出 vs EMA 目标输出」的距离,而学生输出对参数的导数 = b(σ)·∂v/∂θ。b 在低 σ 趋于 0,相当于把学习率乘了一个趋零的系数。视频不在乎,因为它主要在高 σ 学习;动作在乎,因为它的关键区间就在低 σ。
🛠️ 方法:两条流,两个函数
动作流:换成线性梯度
直接取 a(σ)=1、b(σ)=−σ:
f^a(x_σ, σ) = x_σ − σ·v^a_θ(x_σ, σ)
- 边界条件自动满足:f^a(x_0, 0) = x_0;
- |b(σ)| = σ 严格线性,没有高阶项削弱梯度;
- a 为常数,避免 skip 项随 σ 变化;
- 没有新增超参数。
这其实就是 flow matching 里「一步干净估计」x̂₀ = x_σ − σ·v 的形式——把它直接当成一致性函数用。
视频流:保留标准函数
f^v(x_σ, σ) = c_skip(σ)·x_σ + c_out(σ)·x̂₀
其中 c_skip = σ_d²/(σ²+σ_d²),c_out = σ·σ_d/√(σ²+σ_d²)。为什么视频不换?
- 视频噪声集中在高 σ,LCM 在那里梯度充足;
- 速度误差 δv 传到输出会被 b(σ) 缩放:标准函数最大增益约 σ_d/√(1+σ_d²) ≈ 0.45(σ_d=0.5),而线性函数最大到 1。视频 latent 高维冗余,容忍误差,用 0.45 的阻尼反而更稳。
一句话:动作怕学不到,视频怕学太猛。
联合目标与工程属性
L = L_v + λ_a·L_a,其中每条流的损失都是「学生一致性函数」与「EMA 目标一致性函数」的距离。教师 Euler 步在视频上用 CFG(w ~ U[w_min, w_max]),动作上用无引导预测。关键工程属性:只改损失,不改架构、不改每步计算量,所以同一套代码能直接套到共享骨干(LingBot-VA,视频+动作 token 拼成一条 flex attention 序列、一次前向出两条流的目标)和分离网络(Motus,两个独立网络)上。
🧪 实验一:仿真基准
3. RoboTwin 2.0:50 个双臂任务(仿真)
| 方法 | N_v | N_a | Clean | Rand. | 平均 | 加速 |
|---|---|---|---|---|---|---|
| π0 | – | – | 65.92 | 58.40 | 62.2 | – |
| π0.5 | – | – | 82.74 | 76.76 | 79.8 | – |
| X-VLA | – | – | 72.9 | 72.8 | 72.8 | – |
| Motus | – | – | 88.66 | 87.02 | 87.8 | – |
| LingBot-VA(教师) | 25 | 50 | 91.64 | 90.86 | 91.25 | 1.0× |
| + DMD2 | 1 | 2 | 85.08 | 72.36 | 78.74 | 19.0× |
| + 视频-only LCM | 1 | 2 | 80.66 | 76.92 | 78.79 | 19.0× |
| + 朴素联合 LCM | 1 | 2 | 25.88 | 22.07 | 23.97 | 19.0× |
| + Flash-WAM | 1 | 2 | 88.42 | 82.66 | 85.54 | 19.0× |
| + DMD2 | 1 | 1 | 66.53 | 60.32 | 63.43 | 23.3× |
| + 视频-only LCM | 1 | 1 | 77.90 | 69.46 | 73.68 | 23.3× |
| + 朴素联合 LCM | 1 | 1 | 39.68 | 32.96 | 36.32 | 23.3× |
| + Flash-WAM | 1 | 1 | 82.56 | 80.26 | 81.41 | 23.3× |
读法:
- 1v/2a:Flash-WAM 85.54%,比教师低 5.7 个点,但比 DMD2/视频-only 高约 7 个点,比朴素联合高 61 个点;
- 1v/1a:Flash-WAM 81.41%,仍比教师低约 10 个点,但已经是唯一「单步可用」的方法;
- Clean vs Randomized 的差距也值得看:Flash-WAM 在 1v/1a 下 Randomized 只掉 2.3 个点(82.56→80.26),比 DMD2 的 6.2 个点稳——随机化划分扰动物体位姿与光照,对蒸馏学生更难,但 Flash-WAM 的动作精修更扎实。
4. LIBERO:四个套件(仿真)
| 方法 | N_v | N_a | Spatial | Object | Goal | Long | 平均 | 加速 |
|---|---|---|---|---|---|---|---|---|
| π0 | – | – | 96.8 | 98.8 | 95.8 | 85.2 | 94.1 | – |
| X-VLA | – | – | 98.2 | 98.6 | 97.8 | 97.6 | 98.1 | – |
| LingBot-VA(教师) | 20 | 50 | 98.5 | 99.8 | 98.0 | 98.3 | 98.6 | 1.0× |
| + 视频-only LCM | 1 | 2 | 95.1 | 92.0 | 96.0 | 97.8 | 95.2 | 13.7× |
| + Flash-WAM | 1 | 2 | 97.0 | 92.8 | 96.4 | 98.0 | 96.1 | 13.7× |
| + 视频-only LCM | 1 | 1 | 95.0 | 91.5 | 95.0 | 95.4 | 94.2 | 16.8× |
| + Flash-WAM | 1 | 1 | 96.0 | 92.6 | 96.0 | 95.8 | 95.1 | 16.8× |
LIBERO 上教师是 20v/50a(不是 25v),1v/2a 只掉 2.5 个点;1v/1a 掉 3.5 个点。每块延迟从 6,767 ms 降到 404 ms。注意 Object 套件是共同弱项(92.8/92.6),说明单步蒸馏对「物体外观/位置变化」最敏感——物体套件里目标外观多样,低噪声段的动作精修容错更低。
🧪 实验二:真机与跨架构
5. Unitree G1 真机:三个任务
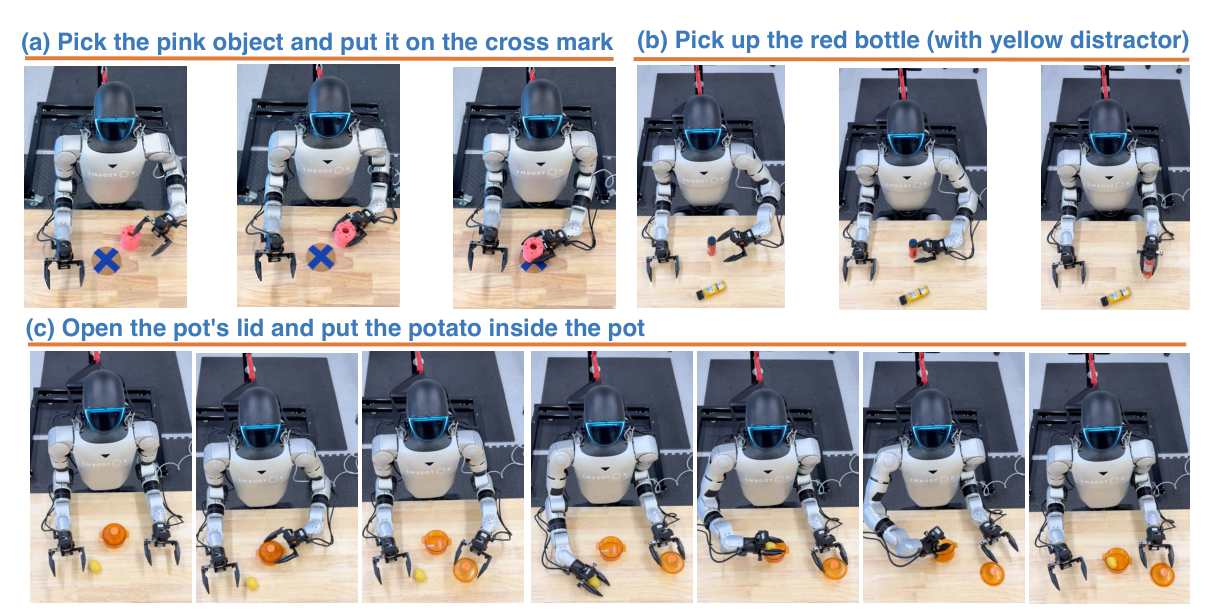
图 3 逐图讲解:真机评测现场的三张任务照,从左到右对应 Table 3 的 T1/T2/T3。(T1) 锅盖打开、土豆被放入锅中——测试「开盖 + 精准投放」的长程接触序列;(T2) 在桌面干扰物(黄色瓶等)中抓起红色瓶子——测试视觉选通与抓取精度;(T3) 把粉色物体放到桌面的十字标记上——测试落点精度。三张照片都是 Unitree G1 人形机器人(双臂 + Dex1-1 夹爪)在真实桌面场景下的工作状态。论文强调每任务只用 50 条遥操作演示训练、每方法只做 20 次 rollout——样本量不大,但足以区分「视频-only 蒸馏」和「模态感知蒸馏」在动作精度上的差距(60.0% vs 43.3%)。
三个任务对应三种能力:T1 开盖+投放是接触密集长程;T2 抓红瓶是干扰下视觉选通;T3 放十字是落点精度。
| 方法 | N_v/N_a | T1 | T2 | T3 | 平均 |
|---|---|---|---|---|---|
| LingBot-VA 教师 | 3/10 | 10/20 | 14/20 | 16/20 | 66.7% |
| 直接减步(无蒸馏) | 1/2 | 6/20 | 6/20 | 12/20 | 40.0% |
| + 视频-only LCM | 1/2 | 6/20 | 10/20 | 10/20 | 43.3% |
| + Flash-WAM | 1/2 | 10/20 | 12/20 | 14/20 | 60.0% |
| 直接减步(无蒸馏) | 1/1 | 2/20 | 6/20 | 6/20 | 23.3% |
| + 视频-only LCM | 1/1 | 4/20 | 8/20 | 8/20 | 33.3% |
| + Flash-WAM | 1/1 | 8/20 | 10/20 | 12/20 | 50.0% |
三个信息:
- 只蒸视频不够:1v/2a 下视频-only 43.3%,Flash-WAM 60.0%,差 16.7 个点;1v/1a 下 33.3% vs 50.0%。真机上动作流必须一起蒸——仿真里「视频-only 也凑合」的错觉到真机就破了。
- 单动作步也能打:Flash-WAM 用 1 个动作步(50.0%)仍然超过两个基线的 2 步版本(43.3%、40.0%)。
- 教师是 3v/10a,不是 25v/50a:真机部署时教师本来就已经减步(每块 13 次评估),Flash-WAM 的 1v/2a 是 3 次、1v/1a 是 2 次,分别少 4.3 倍与 6.5 倍计算。
6. 跨架构:Motus(仿真)
Motus 用分离的视频网络与动作网络,且两条流共享步预算。在 RoboTwin 10 任务子集(每任务 50 次):
| 方法 | 步数 | 成功率 |
|---|---|---|
| Motus 教师 | 10 | 82.8% |
| 朴素联合 LCM | 2 | 57.4% |
| Flash-WAM | 2 | 81.8% |
| 朴素联合 LCM | 1 | 23.0% |
| Flash-WAM | 1 | 77.0% |
单步 77.0% vs 教师 82.8%——只掉 5.8 个点。朴素联合 LCM 单步只剩 23.0%。架构、噪声表都不同,但「崩」与「救回来」的规律完全一致,这与第 4.1 节的分析相符:问题出在一致性函数的梯度结构,而不是某个模型的实现细节。
🔬 消融与定性:优势从哪来
7. 四种 LCM 策略、两个预算、三个任务时长
Table 4 把消融做得很细(RoboTwin 仿真,按任务时长分 Horizon 1/2/3):
| 方法 | N_v/N_a | H1 Clean | H2 Clean | H3 Clean | 平均 Clean |
|---|---|---|---|---|---|
| 教师 | 25/50 | 94.18 | 90.35 | 93.22 | 92.93 |
| 视频-only LCM | 1/2 | 87.10 | 73.13 | 62.50 | 80.66 |
| 视频-only LCM + 回归正则 | 1/2 | 91.53 | 83.00 | 68.00 | 86.92 |
| 朴素联合 LCM | 1/2 | 41.00 | 4.00 | 0.00 | 25.88 |
| Flash-WAM | 1/2 | 92.30 | 84.88 | 73.50 | 88.42 |
| 视频-only LCM | 1/1 | 85.57 | 72.06 | 43.75 | 77.90 |
| 视频-only LCM + 回归正则 | 1/1 | 66.87 | 39.19 | 10.25 | 53.48 |
| 朴素联合 LCM | 1/1 | 54.63 | 21.56 | 0.00 | 39.68 |
| Flash-WAM | 1/1 | 87.30 | 78.44 | 63.50 | 82.56 |
三个结论:
- 朴素联合 LCM 的崩溃随时长加剧:1v/2a 下 H2 只剩 4.00%、H3 归零;1v/1a 下 H3 也归零。动作误差会沿子任务链累积——这是「低噪声梯度消失」最直观的下游后果。
- 加 MSE 正则不能替代蒸馏:在 1v/2a 时它接近视频-only(86.92 vs 80.66),但 1v/1a 时反而比视频-only 低 24 个点(53.48 vs 77.90)——预算一紧,辅助损失就兜不住;一致性约束才是「沿 ODE 轨迹一步到位」的正解。
- Flash-WAM 的优势随时长扩大:1v/1a 下对视频-only 的领先在 H1/H2/H3 分别是 1.7、6.4、19.8 个点。长任务最考验动作精度,也最受益于「低噪声段有梯度」。
8. 定性:视频预测也能看出差别
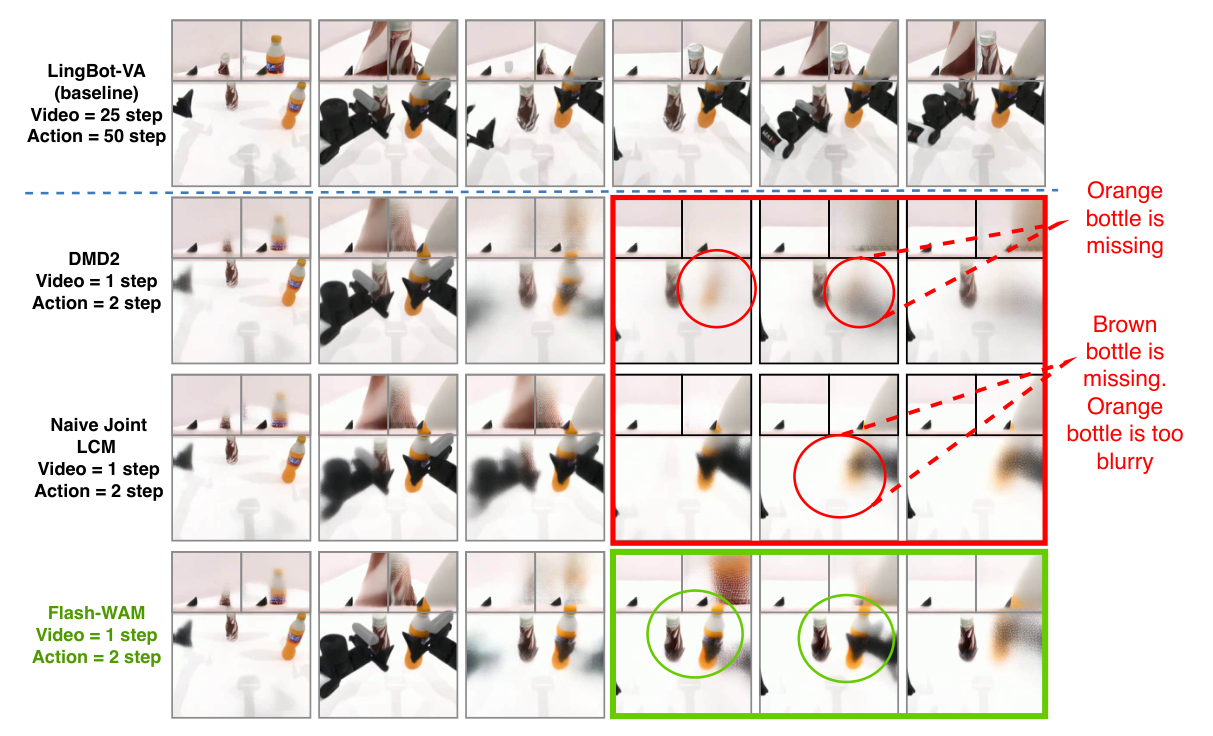
图 4 逐图讲解:四行视频条带的开环对比,任务是 RoboTwin Clean 划分的「pick diverse bottles」(抓取不同颜色的瓶子)。每行是一次自回归 rollout 的时间抽帧——从初始帧开始,模型连续生成后续所有视频块,中间不回填真实观测(开环,最苛刻的评测)。行从上到下:第 1 行 = LingBot-VA 教师(25v/50a)——棕色瓶、橙色瓶、夹爪几何全程身份稳定;第 2 行 = 朴素联合 LCM——中段棕色瓶子直接消失(物体湮灭是共享骨干被动作流学坏的典型症状);第 3 行 = DMD2——橙色瓶边缘变糊、细节丢失;第 4 行 = Flash-WAM——场景结构与各色瓶身身份基本保持可辨认,夹爪轨迹连续。作者特意提醒:这张图只说明视频预测质量,动作精度要看成功率表。它想表达的是——动作流学不好,会反过来污染共享骨干的视频预测;反过来,动作流被正确蒸馏后,视频质量也能保住。
💡 评析:一个漂亮的诊断,三条边界
三个最妙的地方
- 把「蒸馏失败」归因到一个可证明的数学性质。不是「调参没调好」,而是 Proposition 1:任意一致性函数在 σ→0 时 |b(σ)| = |b′(0)|σ + O(σ²),LCM 家族 b′(0)=0,结构性地落在二次消失那一类。诊断到位,修法自然只有一句「换一个 b′(0)≠0 的函数」。
- 只改损失,不动架构。这让方法对「共享骨干」和「分离网络」都成立,也让 Flash-WAM 可以直接叠在现有 WAM 代码上,而不需要重训教师或改推理图。表 5 的 Motus 迁移就是这条属性的实证。
- 视频/动作的取舍是有物理直觉的。动作要线性梯度(怕学不到),视频要阻尼(怕误差放大),并用 δv 增益 0.45 vs 1 给出量化依据,不是拍脑袋。
三条边界
- 1v/1a 仍有明显代价:仿真掉约 10 个点、真机从 66.7% 掉到 50.0%。「实时」是用成功率换来的;对高精度任务,1v/2a(0.43 秒)可能才是甜点。
- 真机证据规模小:3 个任务 × 20 次 rollout,且任务都是短程抓放/开盖。长程、双臂协同、动态场景未验证。
- 依赖教师质量:Flash-WAM 蒸馏的是 LingBot-VA / Motus,教师本身的视频预测误差会被学生继承;论文没有回答「教师弱时怎么办」,也没有和「从头训练一个小步数 WAM」对比。
🗺️ 在 WAM 加速谱系里的位置
| 路线 | 代表 | 做法 | 代价 |
|---|---|---|---|
| 系统/实现优化 | DreamZero | CFG 并行、DiT 缓存、编译、量化 | 不改模型,但天花板有限 |
| 改训练分布 | DreamZero-Flash | 视频噪声表偏向高噪声,单步 | 需重训最后阶段 |
| 蒸馏 | Flash-WAM | 模态感知一致性函数,1v/1a | 掉点、依赖教师 |
| 绕开视频生成 | Fast-WAM / GigaWorld-Policy | 视频 DiT 当编码器/推理信号 | 放弃显式未来预测 |
| 更小视频模型 | Efficient-WAM | 1B 参数、稀疏 token | 容量换速度 |
站内延伸:《DreamZero 精读》(系统级优化的代表)、《VPP2 精读》(单步蒸馏视觉规划器)、《OpenWAM 精读》(表 3 同榜基线 LingBot-VA)、《WAM 世界行动模型全景分析》
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 延迟拆解 + RoboTwin 成功率双面板 | 开篇 |
| Fig 2 | 方法总览:梯度消失 vs 模态感知函数 vs 部署单步 | 问题 2 |
| Fig 3 | Unitree G1 三个真机任务现场照 | 实验 5 |
| Fig 4 | RoboTwin 开环视频预测四行对比 | 消融 8 |
表格:Table 1 RoboTwin 2.0(实验 3)、Table 2 LIBERO(实验 4)、Table 3 真机 G1(实验 5)、Table 4 消融(消融 7)、Table 5 Motus(实验 6);附录 Table 6 教师微调超参、Table 7 蒸馏超参、Table 8 单步全策略对比、Table 9 逐任务成功率。
❓ 自测 Q&A
Q1:为什么朴素联合 LCM 会把成功率从 91% 打到 24%? A:一致性损失对参数的梯度被 |b(σ)| 缩放。标准 LCM 的 b(σ) 在 σ→0 时按 σ² 消失,而动作噪声在低 σ 有大量质量、动作的最终精修也发生在低 σ。于是动作流在大部分训练分布上几乎收不到梯度,蒸馏失败;视频流因为噪声集中在高 σ,不受影响。共享骨干下,动作流学不好还会污染视频预测(图 4 的棕瓶消失就是症状)。
Q2:为什么不能只调 LCM 的 σ_d? A:Proposition 1 表明,LCM 家族对任意 σ_d 都有 b(0)=b′(0)=0,|b(σ)|=O(σ²)。这是结构性性质,不是参数选择问题,所以必须换到家族外(例如 b(σ)=−σ)。
Q3:动作流用线性函数,为什么视频流不跟着换? A:视频 latent 高维、结构冗余,对速度误差容忍度高;线性函数会把 δv 以最高 1 的增益传到输出,标准函数只有约 0.45。视频在高 σ 本来就有足够梯度,不需要冒险放大误差。动作则相反:精度关键、低 σ 梯度稀缺,必须用线性增益。
Q4:1v/2a 和 1v/1a 该怎么选? A:看任务。1v/2a 在 RoboTwin 85.5%、真机 60.0%,延迟 0.43 秒;1v/1a 81.4%/50.0%,延迟 0.347 秒。若 500 ms 预算够用,1v/2a 明显更稳;只有在极端延迟约束下才用 1v/1a。
Q5:为什么「视频-only LCM + 动作 MSE 正则」在 1v/2a 还行、1v/1a 就崩? A:1v/2a 时动作还有 2 步去噪,MSE 正则能提供一部分监督;压到 1 步时,动作必须一次映射到干净值,这正是一致性蒸馏要解决的问题,辅助回归损失无法替代「沿 ODE 轨迹的一致性约束」,所以掉了 24 个点。
Q6:蒸馏用了多少数据、多长时间? A:数据完全是教师已有的——LIBERO 每套件 500 条演示先微调教师 4,000 步(约 24 h / 4×H100),再蒸馏学生 2,000 步(约 24 h);RoboTwin 用原基准训练好的教师直接蒸。Flash-WAM 本身不引入任何新数据,只换损失函数。
Q7:这篇论文和 DreamZero-Flash 是同一类方法吗? A:不是。DreamZero-Flash 改的是训练时的噪声采样分布(视频偏高高噪声),让模型适应少步推理;Flash-WAM 改的是蒸馏损失里的一致性函数,让动作流在低噪声段有梯度。两者可以叠加:先 Flash 式训练,再做模态感知蒸馏。
📚 资源与延伸
- 论文:arXiv 2606.05254
- 项目页:flashwam.github.io
- 关键前作:LingBot-VA(arXiv 2601.21998)、Motus(arXiv 2512.13030)、LCM(arXiv 2310.04378)、Consistency Models(arXiv 2303.01469)、DMD2(arXiv 2311.18828)
- 站内延伸:《DreamZero 精读》、《VPP2 精读》、《OpenWAM 精读》、《FLUX 3 Action 精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》