配图说明:本文收录了报告全部 20 张插图(Fig 1 ~ Fig 20)放进站内 /images/fluxaction/,逐张讲解,文末附图表总索引表。原报告的 Fig 1、2、4、5、6、8、9、10、12 是网页交互图,本文按官方公开的数据用 matplotlib 重绘为静态图;Fig 3、7、11 是官方页面里的 SVG 矢量图,直接提取渲染;Fig 13 ~ 20 是视频,本文使用其官方海报帧(原视频可在官方报告页观看)。
📄 报告信息
- 标题:FLUX 3 Action: A 7B World Action Model for Robot Control
- 团队:Black Forest Labs(BFL,FLUX 系列图像/视频生成模型的团队),2026 年 9 月发布
- 形式:官方在线技术报告——报告正文就发布在 bfl.ai/models/flux-3-action 页面上(没有 arXiv 论文),与权重同步开放。BFL 明确写道:“In robotics, the fine-tuning recipe is just as important as the weights. We are publishing this report along with the weights to make this process transparent."(在机器人领域,微调配方和权重一样重要,我们把报告和权重一起放出,让整个过程透明。)
- 开源内容(GitHub
black-forest-labs/flux-action+ HuggingFaceblack-forest-labs/):- 基座:
flux-3-action-base - 策略(DROID 微调):
flux-3-action-droid - 策略(SO-101 微调):
flux-3-action-so101 - 每个都有 4 步 base(可开 guidance)/ 4 步 guidance 蒸馏 / 1 步 step 蒸馏 三种推理配方,BF16 + FP8 两种精度
- 基座:
- 关键词:世界行动模型(WAM)、联合视频-动作预测、Flow Matching、时间步分布、CFG 分模态引导、EMA / Power EMA、guidance 蒸馏、step 蒸馏、混合策略(reasoner + fast policy)
- 一句话总结:把大规模视频预训练的多模态 FLUX 3 骨干砍到 7B(不到 Cosmos 3 Nano 16B 的一半),用「联合预测视频和动作」保住 WAM 的数据效率与泛化,再用「蒸馏去掉 guidance 反向传播、把 4 步压到 1 步」把速度拉进 VLA 的量级——最终单步 checkpoint 38.3% ± 0.38、guidance 蒸馏版 42.2% ± 0.36 登顶 RoboLab-120,同时在工作站/数据中心 GPU 上比 π0.5 快 1.34~2.28 倍。
📌 读前 5 分钟:四个前置概念
不熟悉这个方向的读者,先记住这四个词(详见《具身智能入门指南》和《什么是世界模型》):
- WAM vs VLA:VLA(Vision-Language-Action)看图像、听指令,直接输出机器人动作——快,但只学「动作」;WAM(World Action Model,世界行动模型)把未来视频帧和未来动作放在同一个生成模型里一起预测——视频预训练带来的世界理解可以迁移到动作上,用很少的动作数据就能学会新任务,代价是序列更长、算得更慢。本文主角 F3A 是 WAM,对比组 π0.5 是 VLA,Cosmos 3 Nano 是另一个 WAM。
- Flow Matching 的时间步 t:训练时把干净数据 x₀ 和噪声 ε 按 z_t = (1−t)x₀ + tε 混合,让模型学会从噪声还原数据。t 在哪采样(时间步分布)很关键——采在「噪声刚变成信号」的过渡区,模型学得最划算。F3A 报告用一整章(Fig 5~7)研究「视频和动作两种模态的过渡区不一样,该怎么采」。
- CFG(classifier-free guidance,引导):推理时把「有条件预测」和「无条件预测」按权重外推,让输出更贴合条件。WAM 的推理默认要开 CFG,但每个采样步都得多跑一次无引导前向,等于速度砍半——F3A 的蒸馏工作(Fig 12 之后)核心目标之一就是把这个 guidance pass 蒸掉。
- RoboLab-120 与 RTF:RoboLab-120 是高保真仿真基准,120 个任务,报成功率(SR%);RTF(real-time factor)= 推理耗时 ÷ 动作块时长,即「算 1 秒机器人动作要花多少秒」,越小越快。看 Fig 1 的 Pareto 图必须先懂这两个坐标轴的含义。
🎯 一句话版本
FLUX 3 Action(F3A)= 7B 的视频-动作联合预测模型 + 一套把 WAM 开成 VLA 速度的蒸馏配方,在 RoboLab-120 上:
| 配置 | 成功率 | 说明 |
|---|---|---|
| F3A 单步(step-distilled) | 38.3% ± 0.38 | 1 次前向出结果,已超所有开源策略 |
| F3A guidance 蒸馏 | 42.2% ± 0.36(B200 FP8 实测 42.24%) | RoboLab 新 SOTA |
| Cosmos 3 Nano(16B,WAM) | 36.8% | 上一代开源最强 WAM,参数是 F3A 的 2.3 倍 |
| π0.5(3.3B,VLA) | 28.0% | 开源最强 VLA,但比 WAM 少学了四分之一成功任务 |
速度侧:F3A 单步版比 π0.5(BF16)快 1.34~2.28 倍(工作站/数据中心 GPU),F3A base/guidance 蒸馏 FP8 比 Cosmos 3 Nano FP8 快 1.52~3.95 倍;效率侧:接上推理模型 GPT 6 Astra 的混合策略,用「低档推理 + F3A 动作策略」把每次成功成本从纯推理的 $13.47 压到 **$8.77**(-29%),时间从 16 分压到 8 分(-40%),还保住 90% 成功率。
🏗️ 架构总览:Fig 3——一个模型同时吐视频和动作
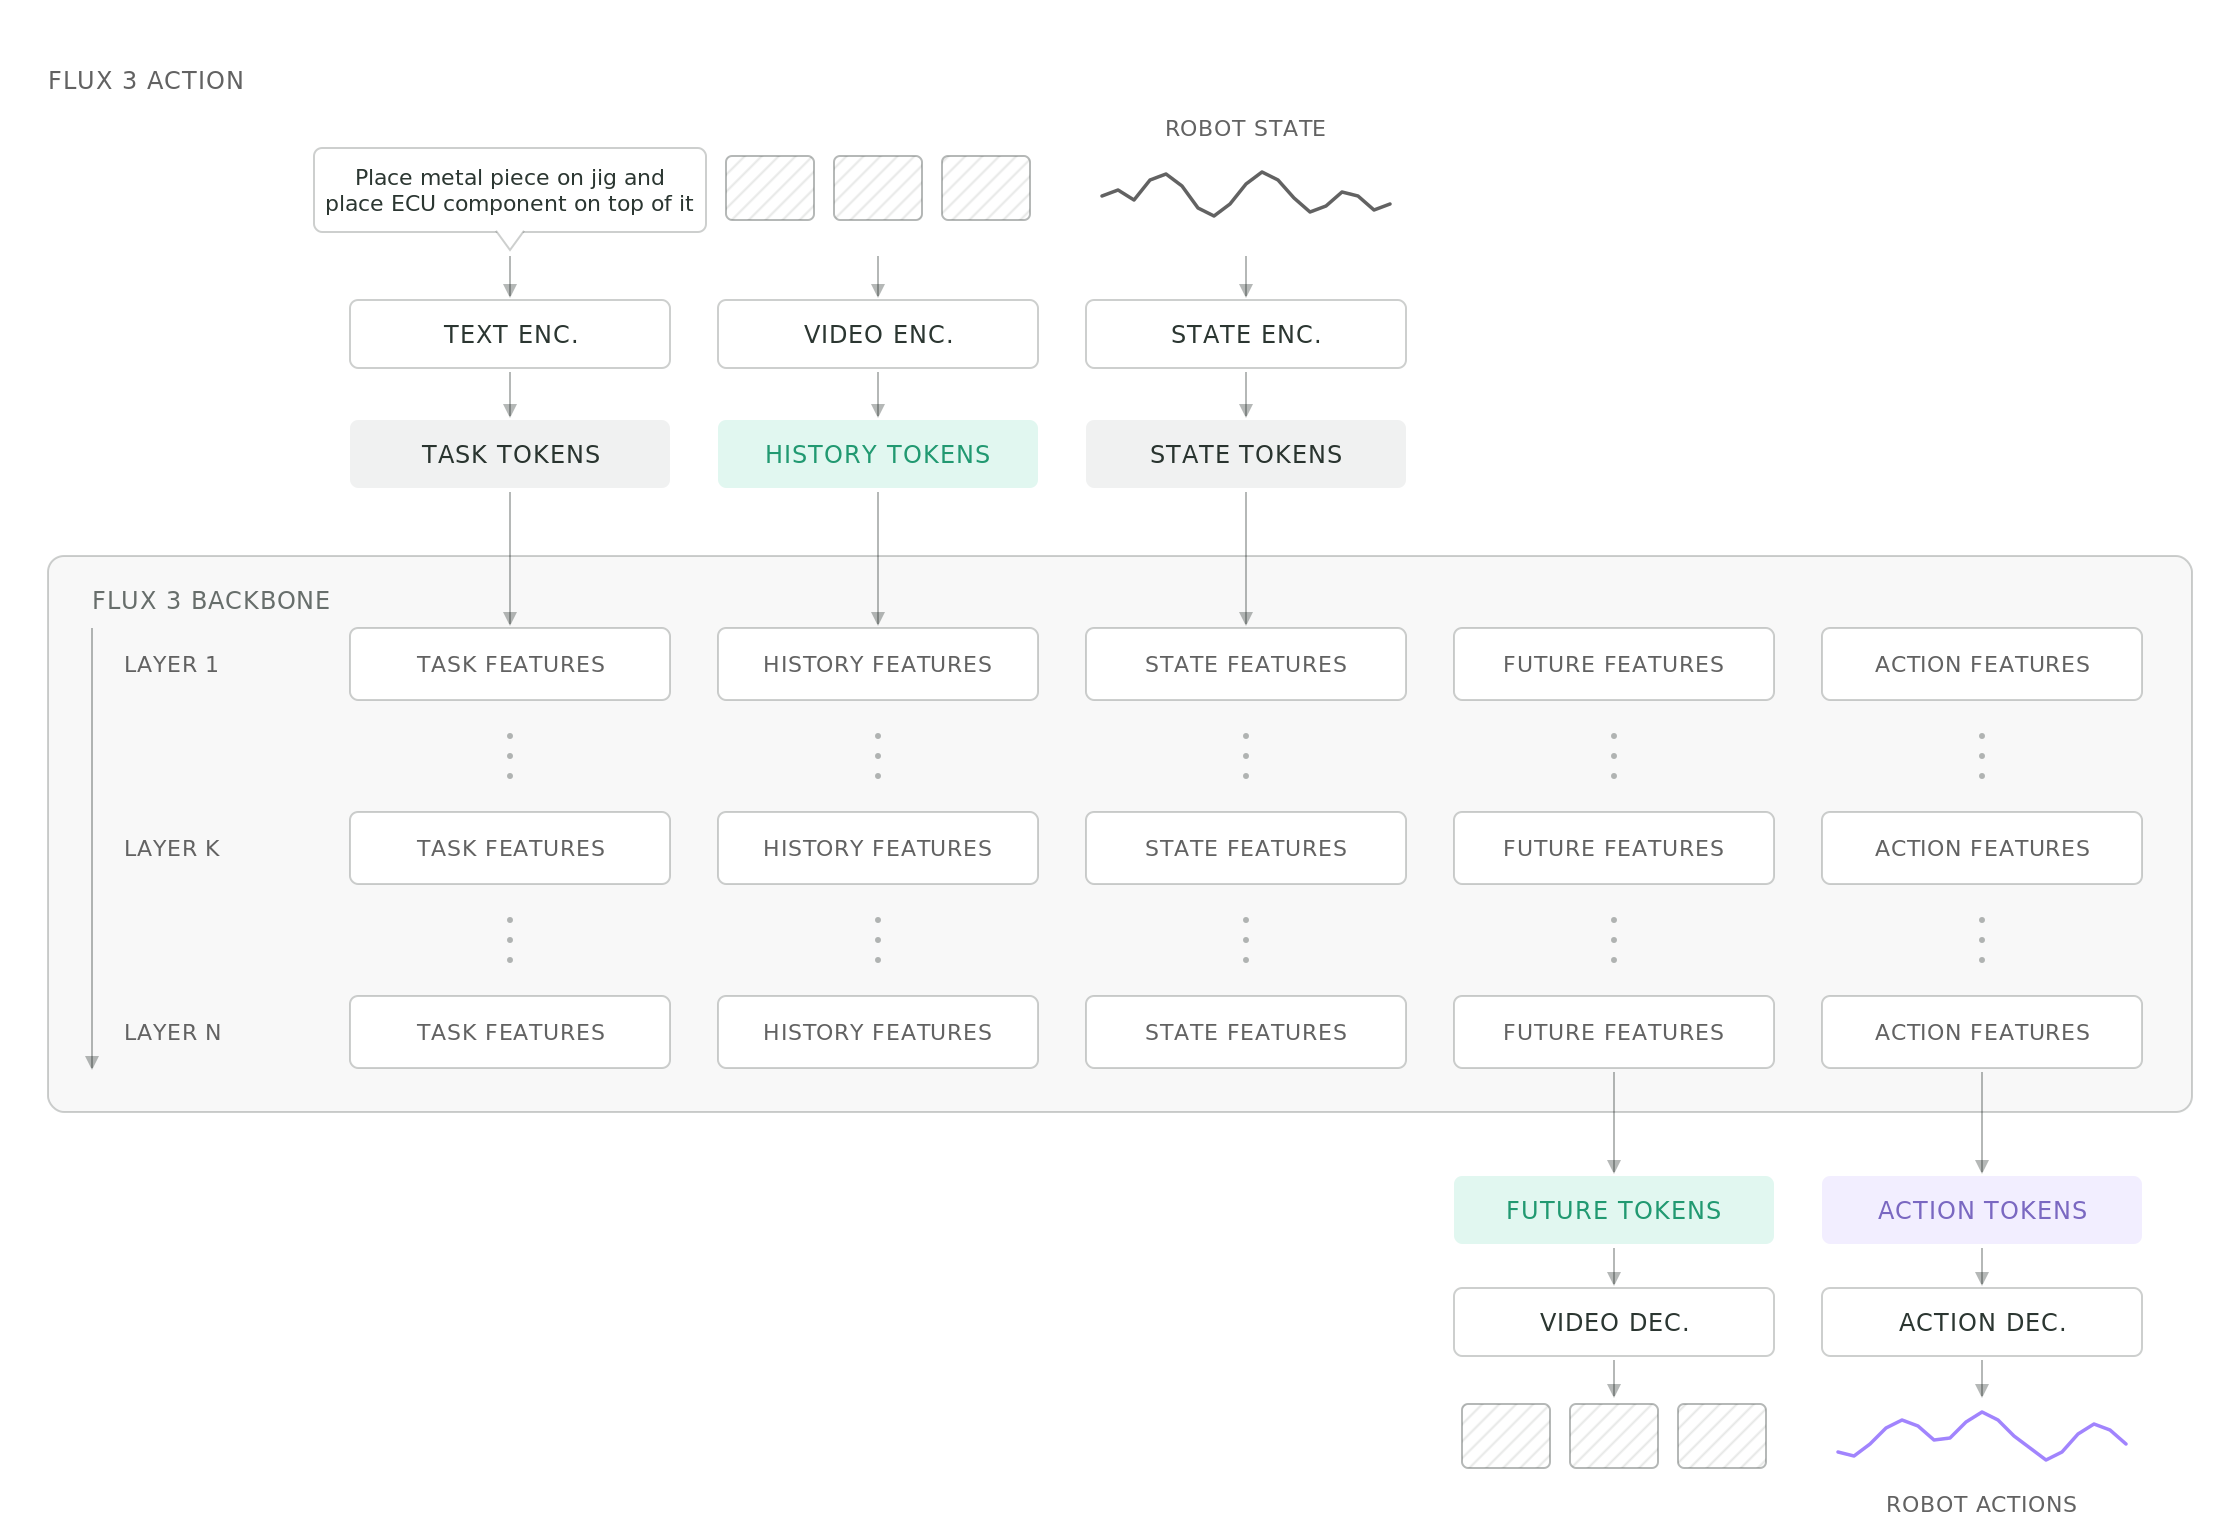
Fig 3:FLUX 3 Action 联合预测未来视频与机器人动作(提取自官方页面 SVG)。
从左到右、从上到下把这张图读一遍:
- 三路输入 → 三类 token:任务指令文本(例如 “Place metal piece on jig and place ECU component on top of it”)走 TEXT ENC. 变成 TASK TOKENS;历史相机帧走 VIDEO ENC. 变成 HISTORY TOKENS;机器人关节状态(ROBOT STATE 波形)走 STATE ENC. 变成 STATE TOKENS。
- FLUX 3 BACKBONE(主干):图中间的大框,画了 LAYER 1 → LAYER K → LAYER N 三层示意。每一层都在同时维护五组特征:TASK / HISTORY / STATE / FUTURE / ACTION FEATURES——注意 FUTURE(未来视频)和 ACTION(动作)从第一层到最后一层始终在同一个网络里并行流动,互相做注意力。这就是 WAM 的「联合」二字在结构上的体现:不是先生成视频再用逆动力学模型(IDM)解出动作,也不是动作旁边挂个小解码头,而是五股流一起过同一个骨干。
- 最后一层 → 两路解码:FUTURE 特征读出 FUTURE TOKENS → VIDEO DEC. 解码成预测的未来画面(图右下三个斜纹小方块);ACTION 特征读出 ACTION TOKENS → ACTION DEC. 解码成 ROBOT ACTIONS(紫色波形)。
和几个近亲的区别(谱系一节会细讲):
- VLA(如 π0.5):只有动作输出,没有视频解码;
- VAM(视频-动作模型,如 FLUX 3 的 mimic 设计):视频模型 + 独立的动作解码器,动作头是外挂的;
- WAM(F3A):视频和动作在每个注意力层里耦合预测,输出头有两个,但中间表示不分家。
控制循环:Look → Think → Move
架构是静态的,跑起来是动态的。报告给了一个交互式演示(这里放它的官方示意图):
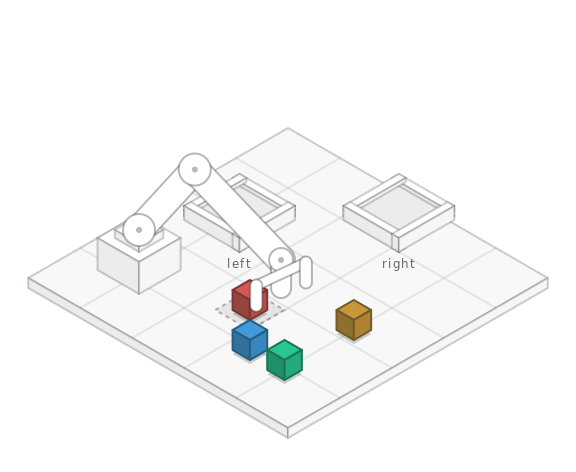
控制循环示意(提取自官方页面 SVG;官方演示为脚本化动画,非实时模型输出)。
任务: "把四个方块分类放进左右两个料槽"  (红+黄 → left, 蓝+绿 → right)
                ┌──────────────────────────────────────┐
                │  01 LOOK   看相机 + 关节位置           │
                │  02 THINK  F3A 一次前向:               │
                │            预测 32 步动作 + 对应未来画面 │
                │  03 MOVE   执行这 32 步动作             │
                └──────────────┬───────────────────────┘
                               │  执行完不再用旧记忆
                               └──→ 回到 01, 用"新鲜观察"重新规划
   (可选: 每 8 步就 Look 一次 vs 每 32 步才 Look 一次)
要点:
- 每次 “THINK” 产出一个动作块:F3A 一次预测 32 步动作,控制频率 15 Hz,所以一个动作块覆盖 2.13 秒的机器人运动(π0.5 是 15 步 / 1 秒,见后文 Table 3);
- 32 步执行完,重新看一眼再规划——观察刷新频率(每 8 步 vs 每 32 步)是可调旋钮,直接影响系统对意外(比如方块掉落)的反应速度;
- 预测出的未来视频帧不只是「副产品」——它是模型的想象/规划轨迹,训练时作为与动作绑定的监督信号,推理时则可视化出来供人检查。
输入侧的多相机观察长这样(F3A 在 SO-101 上的相机排布):
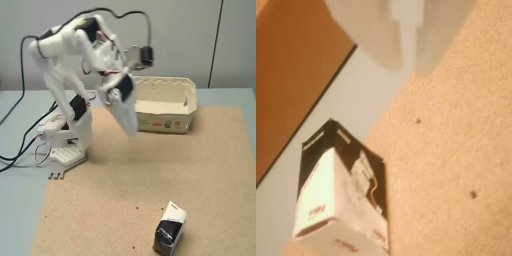
SO-101 机械臂的输入相机画面拼图(来自官方 GitHub 仓库)。
📈 Fig 1:Pareto 前沿——一张图看懂「WAM 税」
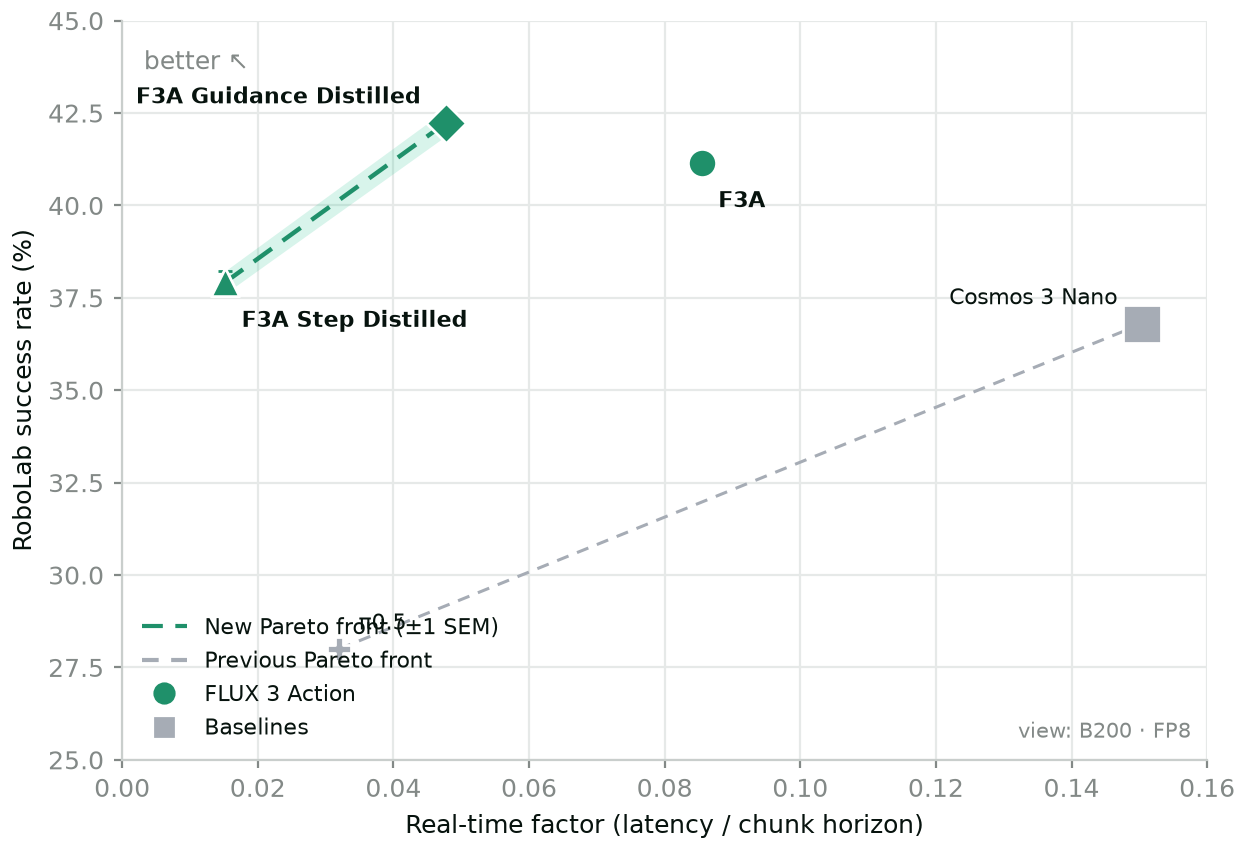
Fig 1:RoboLab 成功率 vs 推理速度的权衡(按官方交互图数据重绘;原图可切换 GPU 与精度、悬停看误差棒)。
读图方法(对任何 Pareto 图都适用):
- 横轴 RTF:处理耗时 ÷ 动作块时长,越靠左越快;纵轴 RoboLab 成功率,越靠上越准。理想点在左上角。
- 虚线 = 新 Pareto 前沿(±1 SEM 的浅绿带),灰色细线 = 旧前沿(Cosmos 3 + π0.5 形成的组合)。F3A 把前沿整体往左上推了一截。
- 圆点面积 ∝ 参数量:能看到 F3A(7B)的点明显小于 Cosmos 3 Nano(16B)。
- 报告文字给出的 B200/FP8 关键读数:guidance 蒸馏版 42.24% @ RTF 0.048;Cosmos 3 Nano 36.8% @ 0.150;π0.5 28% @ 0.032(BF16);单步蒸馏版 37.92% @ 0.015(全场最快)。
为什么这是一张「前所未有」的图? 因为过去 WAM 和 VLA 各占一头,报告开篇把这笔账算得很清楚:
- 精度端:WAM 领跑——Cosmos 3 Nano 36.8%,而最强开源 VLA π0.5 只有 28.0%(选 VLA ≈ 放弃四分之一的成功任务);
- 速度端:WAM 挨打——B200 上 Cosmos 3 Nano FP8 每产生 1 秒机器人动作的耗时是 π0.5 BF16 的 约 4.7 倍;根源有三:① 视频+动作的长序列;② guidance 让每个采样步都翻倍;③ 骨干更大(Cosmos 3 参数是 π0.5 的 4.85 倍)。
F3A 的两招把这个局破解了(不改架构):① 更小的骨干——通过自研 Self-Flow 多模态预训练(视频占训练 token 的 95%+),7B 就打得过 16B;② 蒸馏——去掉 guidance pass、把采样步压到 1 步,但视频和动作不分家。
Table 1:RoboLab-120 总榜(报告发布时)
| 模型 | 开源权重 | 类型 | SR% | 参数量 |
|---|---|---|---|---|
| FLUX 3 Action | ✅ | WAM | 42.92% | 7B |
| OASIS | ❌ | VLM + WAM | 39.0% | – |
| Cosmos3-Nano-Policy | ✅ | WAM | 36.8% | 16B |
| Phoenix | ❌ | TAMP + FM | 34.4% | – |
| BiMind v0.1 | ❌ | VLA | 33.3% | – |
| π0.5 | ✅ | VLA | 28.0% | 3.3B |
| DreamZero | ✅ | WAM | 25.7% | 14B |
| Cosmos3-Edge-Policy | ✅ | WAM | 22.9% | 4B |
| π0-FAST | ✅ | VLA | 15.5% | 3B |
| GR00T N1.6 | ✅ | VLA | 7.2% | 3B |
| π0 | ✅ | VLA | 5.0% | 3.3B |
| paligemma-binning | ✅ | VLA | 3.4% | 3B |
注意两点:① 榜上开源模型里 WAM 与 VLA 的分界清清楚楚——WAM 全线压过 VLA;② F3A 用 7B 拿 42.92%,比 16B 的 Cosmos 3 Nano 还高 6 个百分点。这张表加上前面的 RTF 数据,就是「精度+速度双杀」的完整证据链。
📜 谱系:从视频预测到行动预测
报告用一整节回顾了这条线,值得记住的里程碑:
| 年代 | 工作 | 做法 | 术语 |
|---|---|---|---|
| 1990~2016 | Schmidhuber、Finn《Deep Visual Foresight》等 | 动作条件的视频预测 + 模型预测控制 | 视觉预测控制 |
| 2023 | UniPi(Du et al.) | 文生视频模型生成任务视频 → **逆动力学模型(IDM)**从帧里解出动作 | 两段式 |
| 2023~2026 | GR-1、GR-2、WorldVLA、Cosmos Policy、LingBot-VA | 单个生成模型联合预测未来帧+动作 | – |
| 2026 | DreamZero | 正式命名 World Action Model(WAM) | WAM |
| 2026 | GigaWorld-Policy、Cosmos 3 策略变体 | 沿用 WAM 路线 | WAM |
| 2025~ | mimic-video | 保留 IDM,但条件在视频模型的潜特征上,推理时不合成整段视频 | VAM |
| 2026 早 | BFL 自己的 FLUX-mimic 设计研究 | FLUX 3 作 VAM(独立动作解码器) | VAM |
| 2026.9 | FLUX 3 Action(本文) | FLUX 3 作 WAM,联合预测 | WAM |
一句话记忆:「先看视频再翻译成动作」是 UniPi;「视频动作一起吐」就是 WAM;「视频头外挂动作小头」是 VAM 的折中。F3A 选了最难走但数据效率最高的那条——联合预测,然后用蒸馏解决它的速度问题。
🏋️ 训练配方逐段拆解(报告的 Findings 主体)
这是报告最「值钱」的部分——从预训练检查点到真机,每一步为什么这么选、数字是多少,全部摊开。
Fig 4:预训练 → 动作中期训练,「没有视频预训练就没有一切」
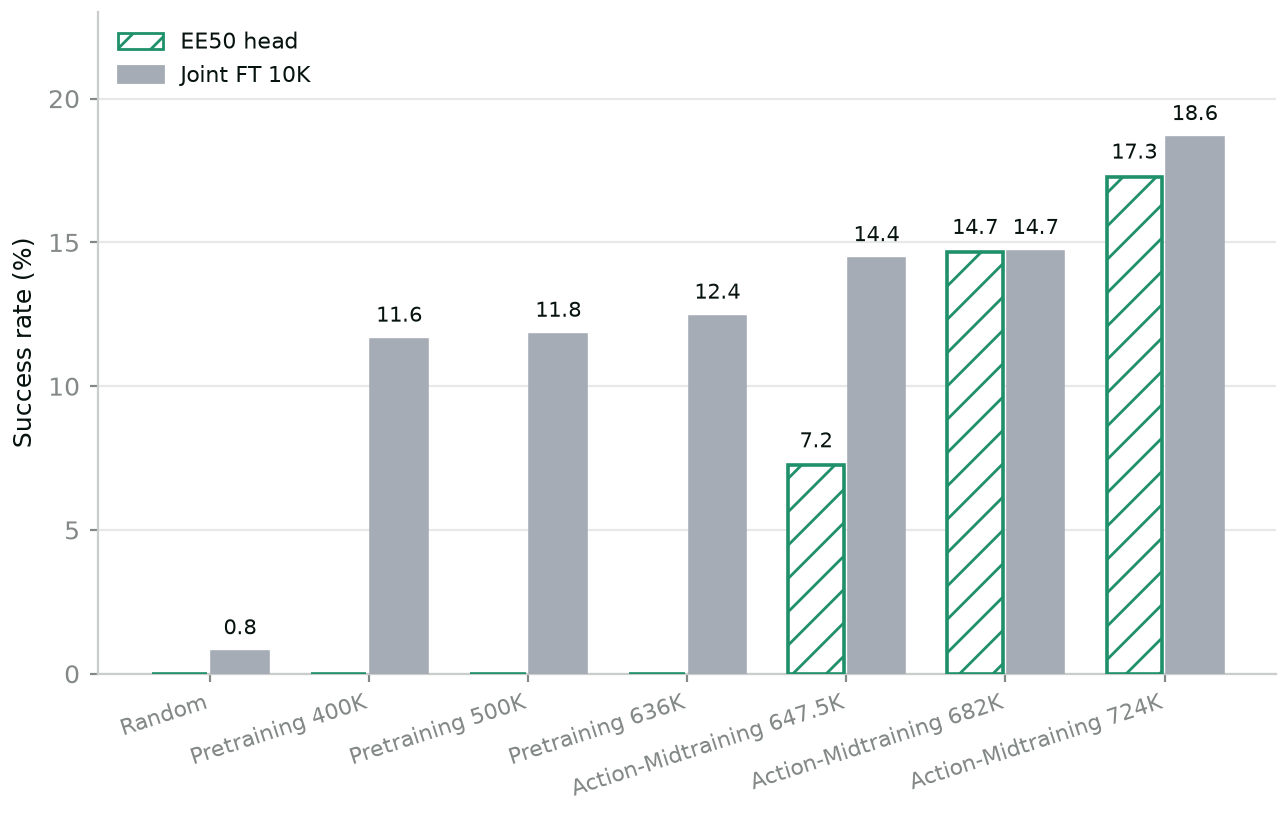
Fig 4:随机初始化 / 预训练 / 动作中期训练各检查点接上动作头后的 RoboLab 成绩(按官方交互图数据重绘;两组柱:EE50 head = 中期训练原生动作头直接评,Joint FT 10K = 接 1 万步 DROID 联合微调后评)。
评测协议(报告说照抄了 Cosmos 3 的做法):给检查点接上随机初始化的动作头 → 在 DROID 上微调 → 评 RoboLab。三组数字连成一条清晰的上升线:
- 随机初始化(没做任何预训练):10K 步微调后只有 0.75%——接近于零。这说明纯 DROID 动作训练严重受数据量限制;
- 接预训练检查点:直接跳到 11.6%,随预训练推进缓慢爬到 12.4%——大规模视频预训练的世界知识换算成了动作能力;
- 接 724K 步动作中期训练(midtraining)检查点:18.63%(Joint FT 10K),原生 EE50 头直接评也有 17.29%。曲线到 724K 还没有饱和迹象(EE50 从 0% → 7.2% → 14.7% → 17.3%,Joint FT 比上一个预训练检查点还多涨 2.3 个点)。
动作中期训练的数据配方(Table 2)——在原预训练数据(图像/视频/音频)里混入带动作标注的视频:
| 数据类别 | 样本占比 | token 占比 |
|---|---|---|
| 联合视频/音频(预训练原生) | 36.95% | 39.00% |
| 游戏录像(Gaming) | 19.55% | 21.85% |
| 第一人称手部视频(Egocentric hands) | 13.54% | 13.78% |
| 手持夹爪(Handheld gripper) | 14.03% | 13.99% |
| 遥操作(Teleop,14 种本体) | 15.93% | 11.37% |
三套动作空间(这是理解后面所有微调实验的地基):
- 游戏动作 102 维:鼠标 x 轴移动离散成 23 档、y 轴 17 档(各含 0 移动档)+ 左右键 2 维 + 键盘 60 键;所有二值通道训练时反量化(dequantize)。
- EE50(50 维):多数第一人称/手持/遥操作数据用它。前 25 维给主末端、后 25 维给副末端;每 25 维里 = 3 维平移 + 6 维旋转(Zhou et al. 2019 的连续旋转表示,取旋转矩阵前两行)+ 16 维手部关节/夹爪(0=闭合、1=张开),不用的维度补零。末端位姿相对于锚点帧(最后一帧条件帧)表示,夹爪和手部保持绝对值;每维按本体做 z-score 归一化。
- 机器人 14 维 / 6+1 维:部分机器人数据集是 7+7 双臂 14 维;但 F3A 对 DROID 这类直接用 6 个关节状态 + 1 个夹爪状态建模(因为没有该本体的前向动力学模型)。所有动作数据频率 5~30 Hz。
为什么中训数据里塞了 19.55% 的游戏?报告在 Outlook 里给了答案:游戏是「动作预测」的天然试验田——并行跑、超实时、零风险,而且鼠标键盘这种低维动作空间天然适配。
Fig 5 → Fig 6 → Fig 7:时间步分布的网格搜索(最硬核的一章)
问题:Flow Matching 训练要把噪声水平 t ∈ (0,1) 采样出来,采哪里?而且 F3A 要同时建模视频和动作两个模态——它们「从噪声变回信号」的过渡区不在同一个位置,一个分布没法同时照顾俩。
Fig 5:先测量两个模态的噪声-信号过渡区
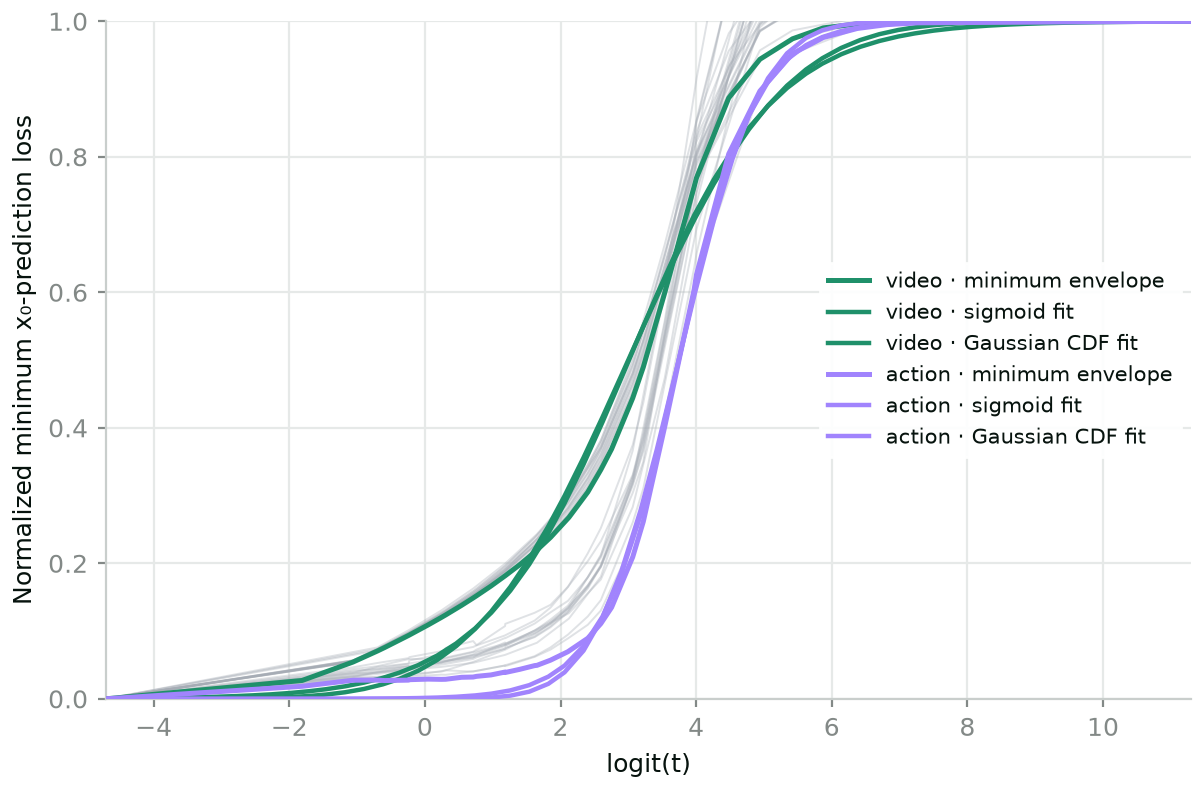
Fig 5:归一化最小 x₀ 损失包络 + sigmoid / Gaussian CDF 拟合(按官方数据重绘;淡线是所有贡献曲线,实线是逐点取最小的包络)。
方法:对多个用不同时间步分布训练的检查点,分别计算视频和动作的 x₀ 重构损失,逐点取最小值(minimum envelope)作为「该噪声水平下最优能达到的损失」的近似,归一化后画出来。结果:
- 两条包络都是 S 形,过渡点在 σ(t) = 3.3,即 t ≈ 0.964——大部分 t 区域其实是「纯信号」或「纯噪声」,信息量最大的是这一小段过渡带;
- 动作包络整体低于视频包络、过渡更晚——同样的 t,动作比视频「更抗噪」;
- sigmoid 拟合和 Gaussian CDF 拟合都贴得很好(报告说两者都用)。
Fig 6:把包络求导,得到「该在哪里多采样」的分布
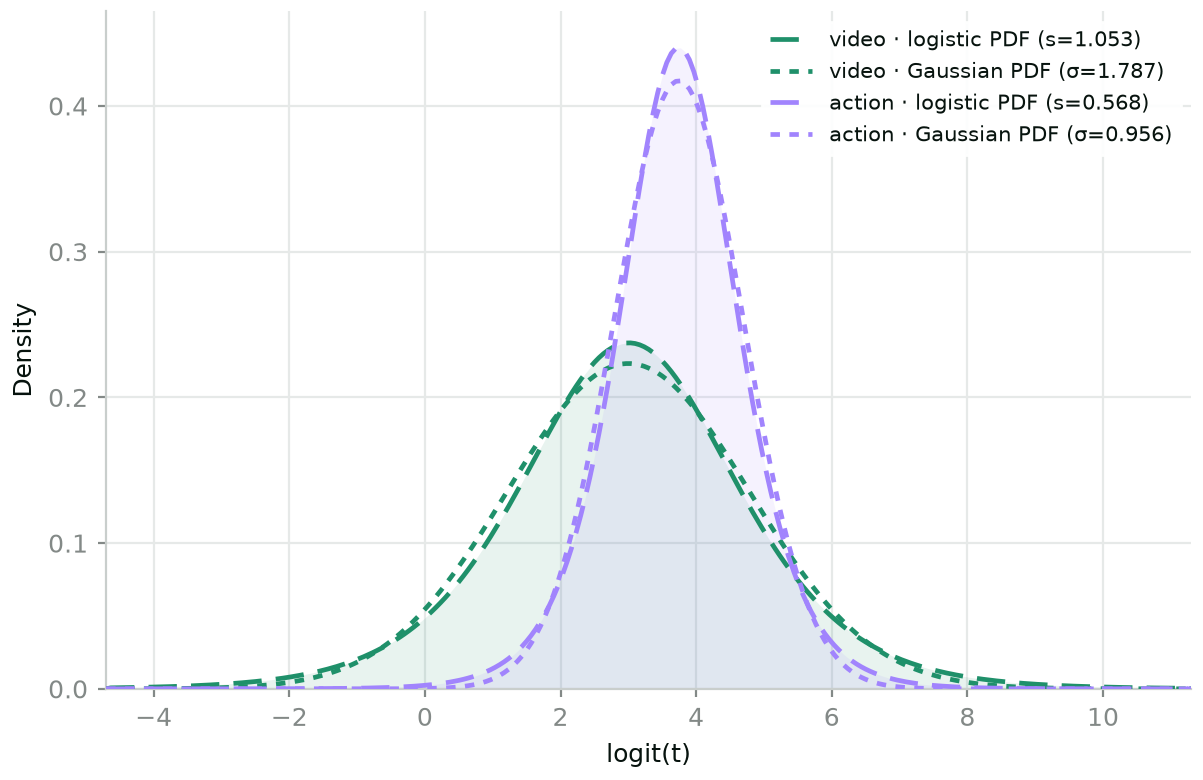
Fig 6:对应拟合分布的提议密度(PDF)(按官方数据重绘)。
思路很直接:如果模型容量花在信号过渡最陡的地方最划算,那时间步的 PDF 就应该正比于 S 形包络的导数。S 形用 sigmoid 拟合 → 求导得 logit 空间的 logistic 分布(video 尺度 s=1.053,action s=0.568);用 Gaussian CDF 拟合 → logit 空间的 正态分布(video σ=1.787,action σ=0.956)。图上可见动作密度的峰比视频更靠右(更晚),且 logit-normal 比 logit-logistic 更窄。
Fig 7:带 shift 和 action scale 的网格搜索
选定分布形状后还有两组旋钮:
- Shift α:三种候选分布统一用「零中心基分布 + 变换 t ↦ αt / (1+(α−1)t)」,把模式平移到 logit(t) = log α。取 α ∈ {24, 33, 42}——这仨数不是拍脑袋,就是 Fig 6 里视频/动作两峰位置(加上中间值)。Waver 分布(Cosmos 3 用的 mode-sampler)按其原文用 α=5,扫 2.5 / 10 一低一高。
- 动作缩放 s ∈ {1, 2}:把动作乘 s(视频不动),等于把两个模态的过渡区相对平移。报告给了一个很漂亮的因子分解直觉:s ≫ 1 时,联合流近似分解成 p(视频 | s·动作)·p(s·动作)——「先学会动作,再学会在动作之上建模视频」;s ≪ 1 则反过来。为排除损失权重干扰,动作损失同步乘 1/s²。
- logit-logistic 的尺度再扫 0.5 / 0.75 两档。
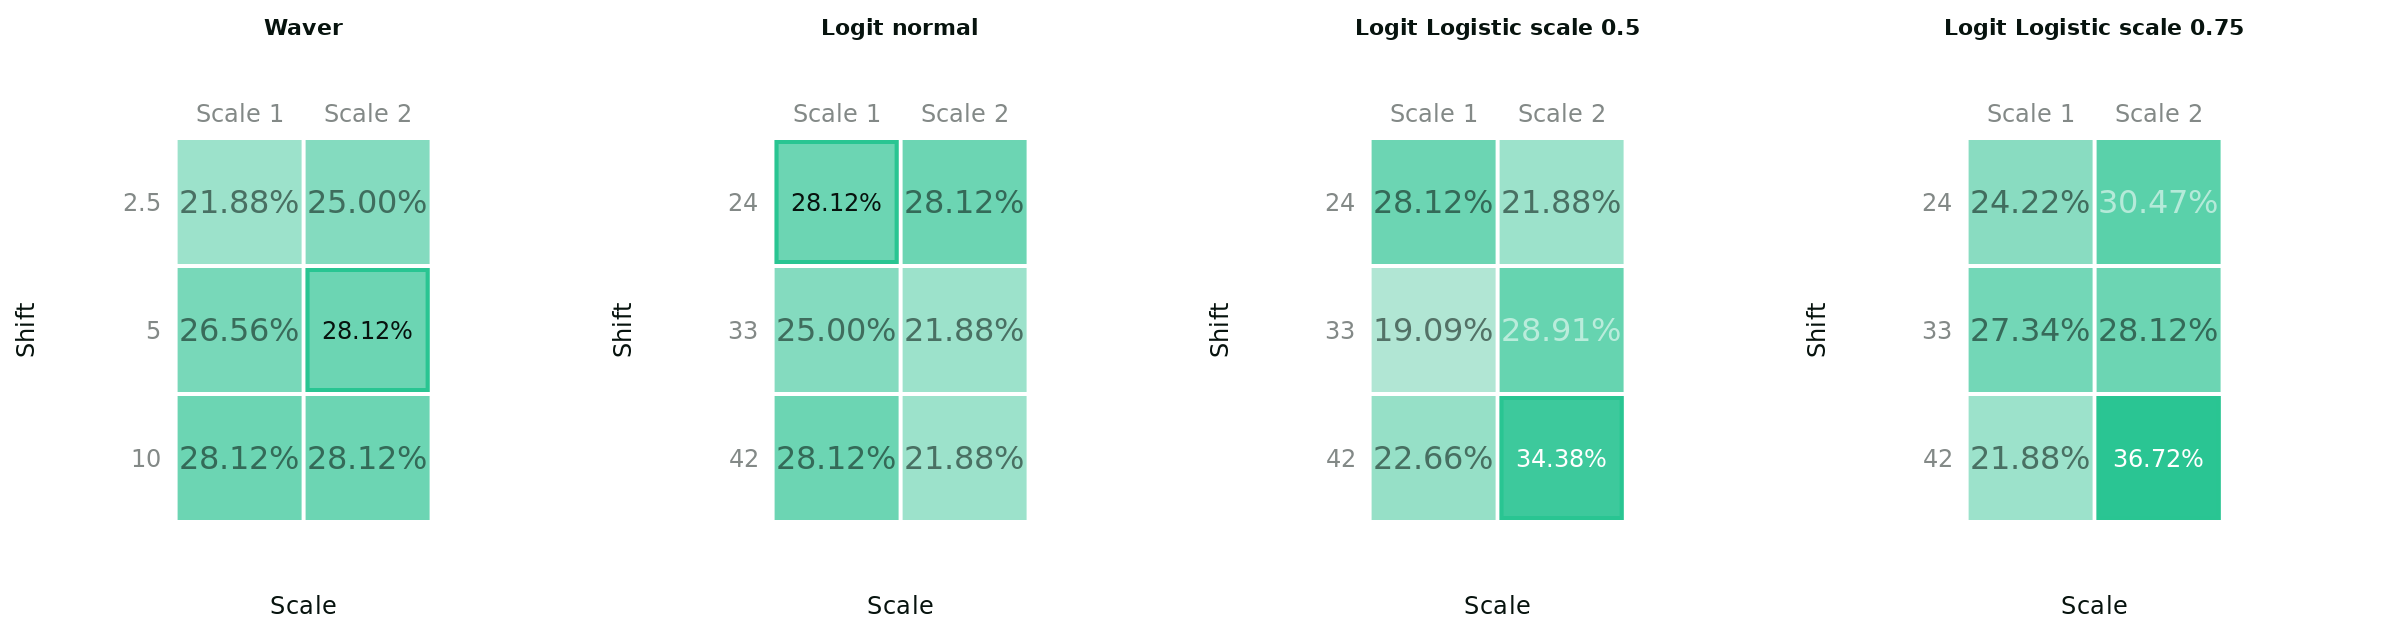
Fig 7:四种时间布 × shift × action scale 的 RoboLab 成功率热力图(提取自官方 SVG;每格为多次种子中位数,行=shift,列=action scale,越高越绿)。
结果读法——报告原话是「overall, we fail to identify a clear trend(整体没找到单调规律)」,但有一条稳定的结论:
- 四个面板的最绿格子高度集中在 shift 42 + Scale 2 一列:Waver 28.12%、logit-normal 21.88%、logit-logistic 0.5 档 34.38%、logit-logistic 0.75 档 36.72%(全场最高);
- 最终选定:logit-logistic、scale 0.75、shift α=42、action scale s=2(即 waver 的左上 21.88 明显垫底,纯靠运气也轮不到它)。
这一小节的方法论价值比结论更大:「先测出每个模态的噪声过渡区 → 按过渡区形状设计时间步分布 → 网格搜索确认」——这是可以原样搬去任何视频-动作联合训练项目的流程(比如我们在 MOT 世界模型上的 Flow Matching 动作专家)。
Fig 8:DROID 微调配方——「先冻住,再慢慢放」
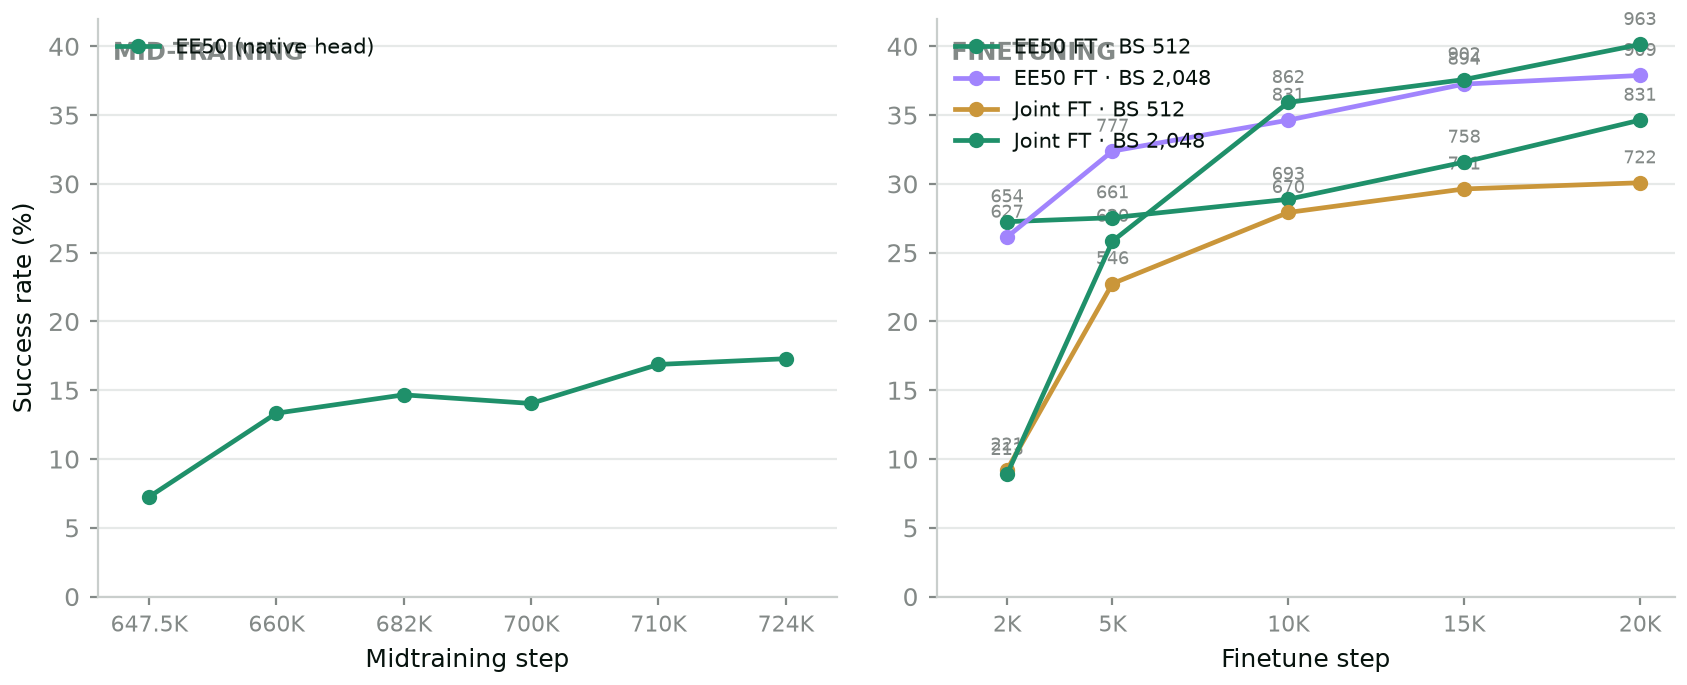
Fig 8:左=中期训练原生 EE50 头在各检查点的成绩(Mid-training);右=DROID 微调四条跑法对比(按官方数据重绘)。
问题设定:微调时接的是随机初始化的动作头,前几千步的梯度信号非常脏,可能把中期训练的好权重冲垮。报告的解法是错峰学习率:
- Joint FT(绝对关节空间,新头):前 1K 步冻结中期训练权重(只让新头自己热身)→ 其学习率再用 2K 步从 0 线性升到 2e-4;动作头自己的学习率 1K 步内从 0 升到 1e-3;
- EE50 FT(相对末端空间,头已由中期训练初始化):无需冻结,全体参数 1K 步从 0 升到 2e-4 的普通 warmup;
- 两种跑法各试 batch 512 和 2048,训 20K 步。
结果(右图四条线 + 文字结论):
- Joint FT + BS 2048 是最终赢家:10K 步后反超,20K 步收官 40.13%,压过同 batch 的 EE50 FT(37.88%);
- 小 batch(512)下反过来:EE50 FT 始终在 Joint FT 之上——EE50 头「出厂即热」的优势在小批量下更明显;
- batch 放大 4 倍很划算:以等 FLOPs 对比,BS2048 在 5K 步的成绩只比 BS512 跑满 20K 步低 2.25 pp(EE50)/ 4.25 pp(Joint);
- 报告的保留意见:EE50 FT 适合数据少、步数少的场景,而且时间步分布那套超参本来就是按 Joint FT 调的,有失公平。原生 EE50 头在 724K 中期训练检查点上的成绩是 17.29%(左图右轴的参照线)。
Fig 9:训练损失一直降,成功率却平了
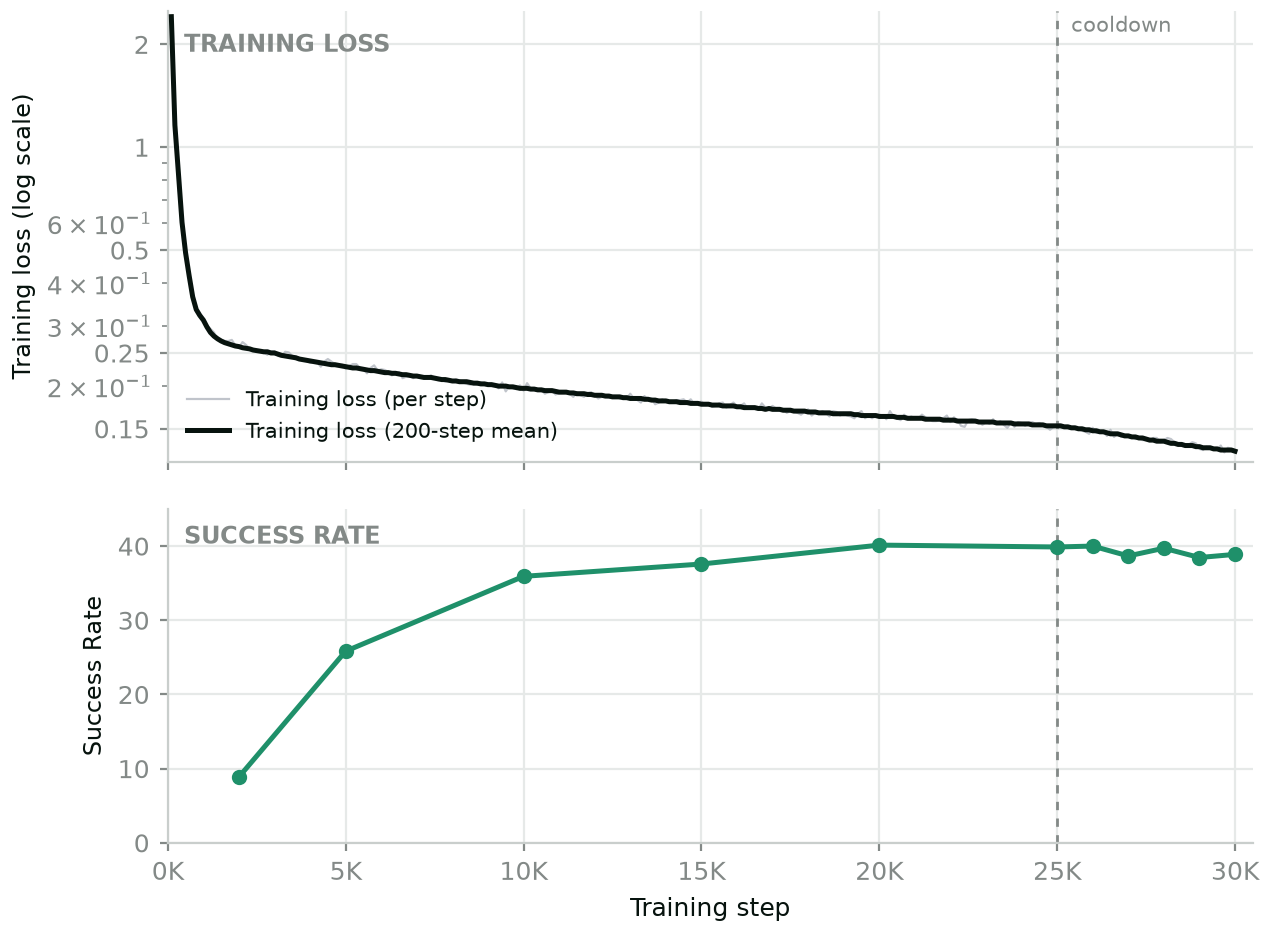
Fig 9:Joint FT 的训练损失(200 步滑动平均)与 RoboLab 成功率,含最后 5K 步退火(按官方数据重绘;上=TRAINING LOSS,下=SUCCESS RATE,竖线=cooldown 开始)。
选点协议:Joint FT 总共训 30K 步,最后 5K 步线性退火(cooldown),退火期间每 1K 步评估一次,从里面挑最好的。图上两块面板讲了一个所有做策略学习的人都该看一眼的故事:
- 损失一路下行,cooldown 期间降得更快(学习率变小,拟合更细);
- 成功率在 20K 步后就平台化,稳在 ~40%,峰值 40.13% @ 20K;退火段挑出的最好检查点也只有 40%(26K 步)。
训练损失 ≠ 任务成功。损失里还在兑现的提升,到了闭环评测里一滴都漏不出来——checkpoint 选择必须以评测指标为准,这条在仿真基准上成立,在真机上更是如此。
Fig 10:Loss spike——出现就回滚,别赌它自己恢复
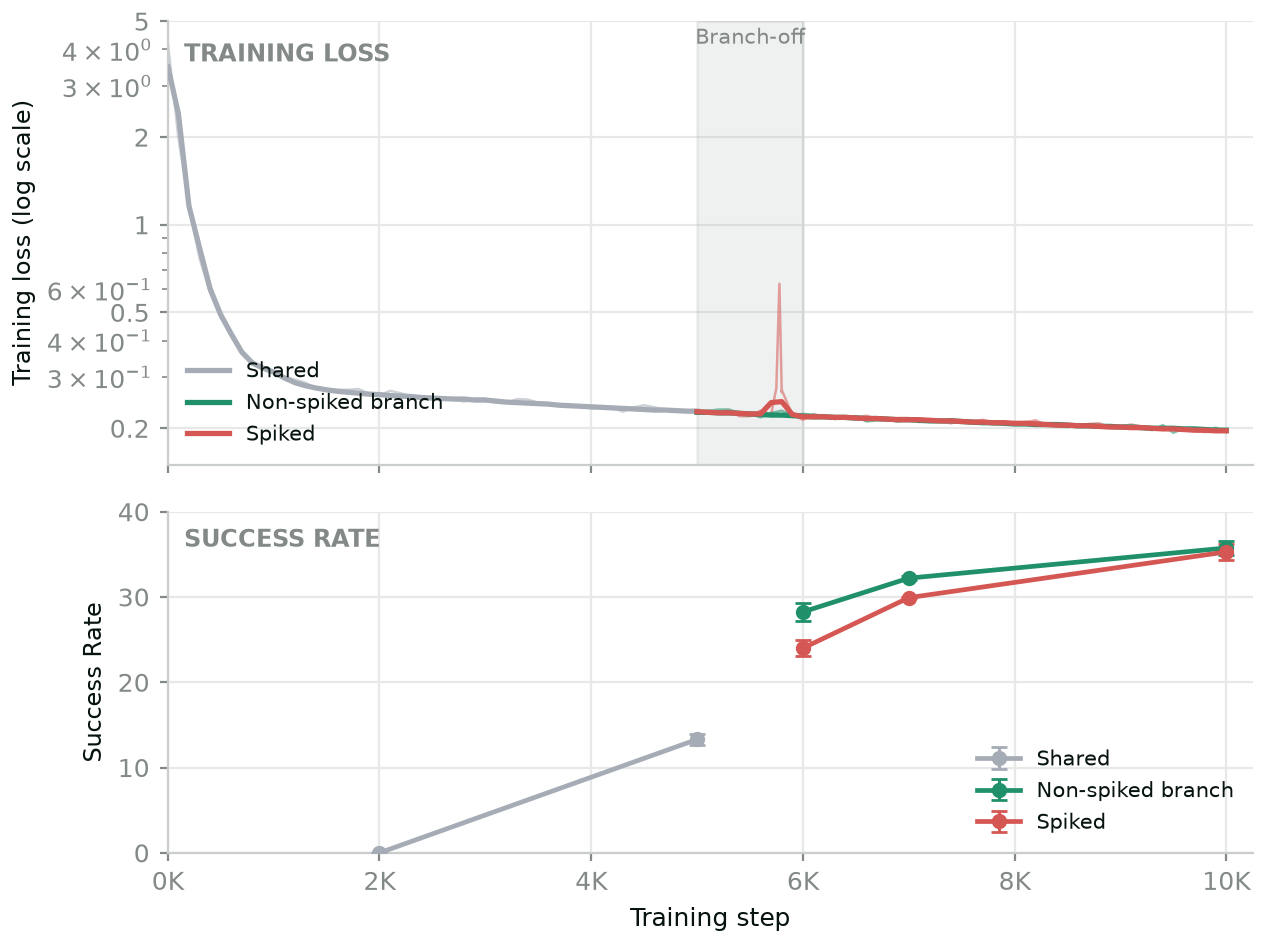
Fig 10:共享主干 + 分叉训练,一支在 ~5.8K 步附近遭遇 loss spike(按官方数据重绘;阴影=5K~6K 分叉区间,误差棒=两种子结果,上=损失,下=成功率)。
观察:学习率在 2e-4 及以上时会偶发尖峰。对比实验把两支跑法放在同一主干上、5~6K 之间分叉,让其中一支炸出尖峰:
- 尖峰支在 6K 步的成功率掉到 24.0%,干净支同点位 28.25%;
- 到 10K 步两支都回到 ~35%,看起来「自愈了」——但报告强调他们见过拖很久都恢复不过来的案例,整个训练窗口内都会垫底。
结论是工程纪律而非学术发现:观察到 spike 一律回滚到之前的干净检查点,保证消融对比的公平性,也避免最终成绩被一次偶发事故绑架。这段是整份报告里「透明公开训练配方」最实在的体现之一。
Fig 11:视频和动作,分开做 CFG
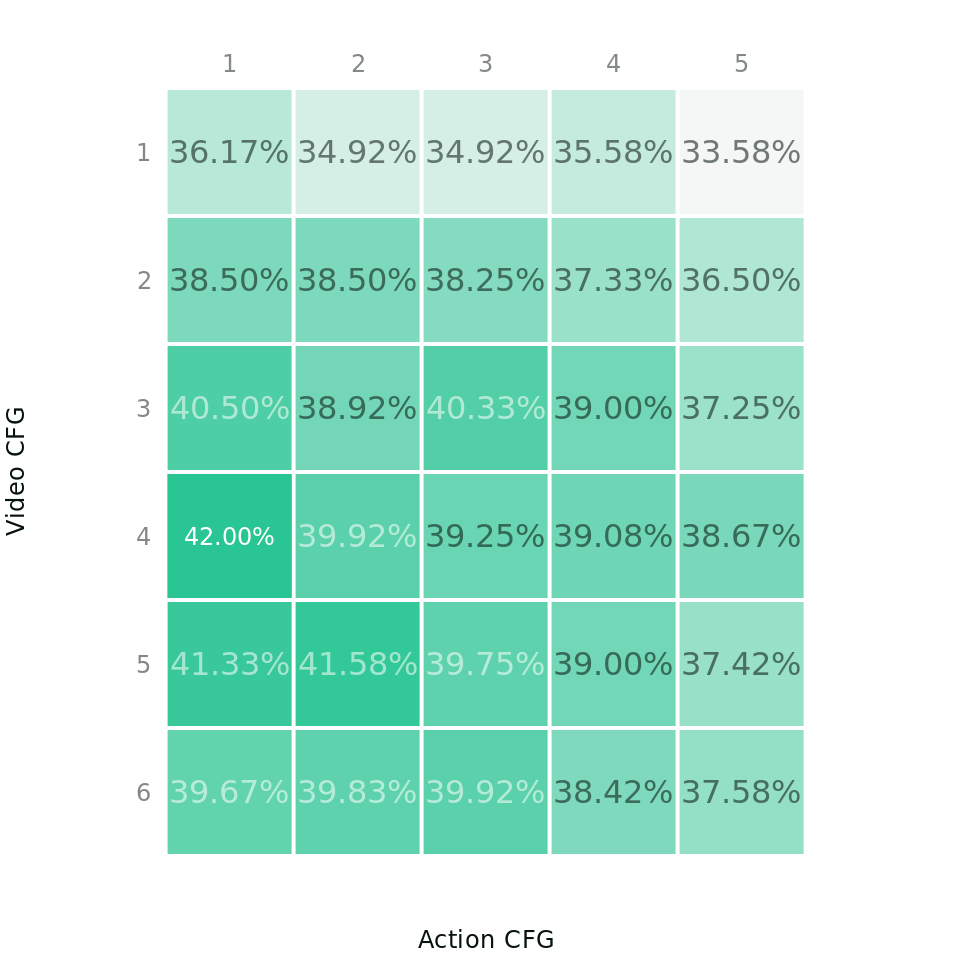
Fig 11:{Video CFG × Action CFG} 网格上的 RoboLab 成功率(提取自官方 SVG;行=Video CFG 16,列=Action CFG 15,全 120 任务)。
既然一次前向同时产出视频和动作,两个模态就可以各自做 classifier-free guidance(推理时各减一次无条件预测)。网格读数:
- 趋势线:要高 Video CFG、低 Action CFG——给「画面听指令」加大力度,动作端保持原始分布;
- 最优格:Video CFG = 4.0、Action CFG = 1.0 → 42.00%(图中深绿格,第 4 行第 1 列);这一组成为生产环境的推理默认配置;
- 次优的第 5 行(Video 5)也在 41% 上下;Video 拉到 6 反而回落(6@A1 = 39.67%),Action CFG > 2 之后全线变浅(最差 33.58%)。
直觉版解释:动作对引导更敏感(它直接进机器人),过强的外推会把动作分布推得「过冲」;视频作为高维信号更耐推。这和图像扩散里「CFG 不是越大越好」的老经验一致。
Fig 12:EMA 的 18 连考——为什么必须有 EMA
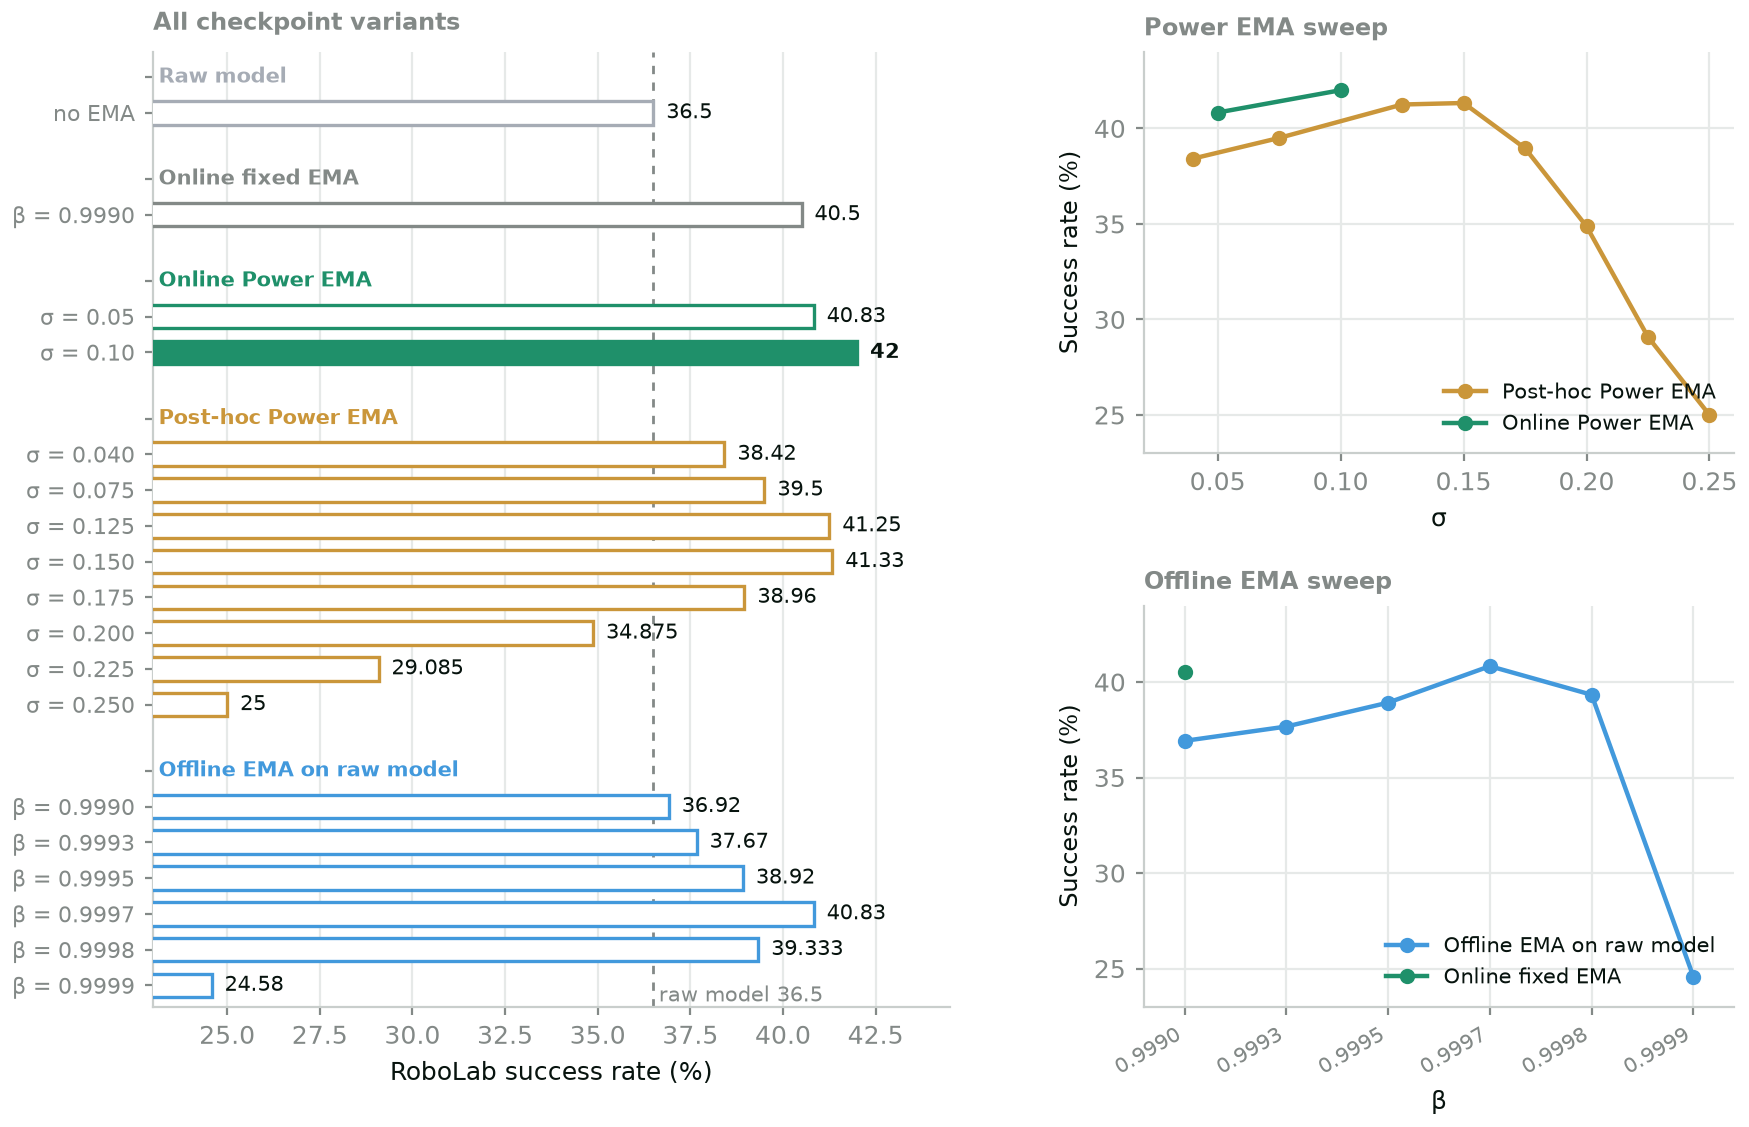
Fig 12:EMA 18 个变体在 RoboLab 上的成绩(按官方数据重绘;左=按组排名的横条,右=Power EMA σ_rel 扫描与 offline β 扫描两条曲线)。
报告开门见山:EMA 对成绩和消融对比的可靠性都至关重要,所以全程同时维护传统 EMA 和 Power EMA 两条线。三个公式(报告原文):
- 传统 EMA:θ̂_β(t) = β·θ̂_β(t−1) + (1−β)·θ(t),取 β = 0.9990;
- Offline EMA:检查点每 K = 1000 步存一次,对没存的 β 值只能「事后补」——用 α = β^K 做逐检查点递推,并除以 (1−α^N) 消掉有限窗口的启动偏差;
- Power EMA(Karras et al. 2024):权重轮廓随训练进度幂次演化,用相对宽度 σ_rel 参数化;训练中并行跟踪两条:σ_rel = 0.05(γ=16.97)和 σ_rel = 0.10(γ=6.94);事后还能拿这两条基(2N 个存档的仿射组合,系数可负、归一化和为 1)重构出任意 σ_rel 的近似 EMA。
左图 18 根横条的结论(分组颜色见图例):
- 不用 EMA 的 raw model:36.50%——最短的条,EMA 的价值一目了然;
- 在线 Power EMA σ_rel=0.10:42.00%,18 变体第一,也是报告推荐的 DROID 配方默认设置;传统在线 EMA 和 Power EMA 都健康地超过 raw,且 Power EMA 略胜传统 EMA;
- 右图两条扫描线都是钟形:post-hoc Power EMA 在 σ_rel=0.15 峰值 41.33%(0.25 时崩到 ~25%),offline EMA 在 β=0.9997 峰值 40.83%——但两者都低于对应的在线版本:每步在线平均永远强于事后近似。
这图对做消融的人是个提醒:没有 EMA 的对照组是在裸奔;而且 EMA 超参本身也有最优区间,不是「越平滑越好」。
⚡ 推理效率:把 WAM 开成 VLA 的速度(Fig 1 背后的工程)
这一节没有独立配图——它的全部结果都画进了 Fig 1 的 Pareto 前沿里。核心思路报告说得很明白:不动架构、不拆视频和动作(以往方案靠分开解码器/注意力掩码来提速,代价是改变了 WAM 的能力),纯靠蒸馏向 VLA 的效率逼近。
两级蒸馏:
- Guidance 蒸馏(GD):CFG 每步要跑「引导 + 无引导」两次前向,延迟近似 ×2(并行摊到两张卡则硬件成本 ×2)。做法:从 F3A DROID 检查点初始化师生,teacher 冻结、在 DROID 样本上输出带引导的预测作为 student 的训练目标;训完 student 裸跑(不开 guidance)。结果:提速 1.8~2 倍,成功率不降反升 +0.6 ~ +1.08 pp——把引导「烧」进了权重。
- Step 蒸馏(SD):在 GD 检查点上继续,让 student 学在 teacher 引导下的单步预测。采样步 4 → 1,提速 3.15~4 倍,代价 −3.51 ~ −4.32 pp;但即便如此仍比 Cosmos 3 高 +1.12 ~ +1.88 pp、同时快 9.19~13.22 倍;比 π0.5 高 +9.92 ~ +10.68 pp。
落地优化(+0/-0.8 pp 换来的速度):rowwise 动态 FP8——对 GD 版 +0.05 pp、SD 版 −0.76 pp,本地 GPU 提速 1.4 倍以上;prompt token 在 mode blocks 里不变 → 缓存一次;同一 canvas 下观察变化但形状不变 → **torch.compile(reduced-overhead)**可稳定编译;把「步不变」的共享计算提升到 block 外的联合准备阶段。
三张表的硬数字:
Table 3:输出与控制设置
| 策略 | 每次预测动作数 | 控制频率 | 整块时长 |
|---|---|---|---|
| π0.5 | 15 | 15 Hz | 1.00 s |
| F3 + Cosmos 3(同款 WAM 设定) | 32 | 15 Hz | 2.13 s |
Table 4:每个动作块的端到端延迟中位数(ms;B200;提示词已缓存、相机编码每次重算)
| 工作负载 | BF16 | FP8 |
|---|---|---|
| F3 · 4 步 · 开 guidance | 246.42 | 182.00 |
| F3 · 4 步 · 关 guidance | 136.25 | 101.71 |
| F3 · 1 步 · 关 guidance | 41.06 | 32.29 |
| Cosmos 3 Nano · 4 步 · 开 guidance | 387.71 | 320.40 |
| π0.5 · 10 步 · 关 guidance | 31.99 | (只测了 BF16) |
注意报告强调的一点:F3A 的速度优势是 RTF 意义上的,不是单次延迟——WAM 一次吐 2.13 秒的动作(π0.5 只吐 1.0 秒),所以哪怕单次延迟 41 ms vs 32 ms 略慢,摊到「每秒机器人动作」上仍然反超;单步 SD 的 41 ms 也意味着控制循环完全可以实时跑。
Table 5:三个 checkpoint × 两种精度的多种子成绩
| 设置 | 种子数 | 成功率 (mean ± SEM) |
|---|---|---|
| Base BF16 | 6 | 41.60 ± 0.46 |
| Base FP8 | 8 | 41.16 ± 0.30 |
| Guidance Distilled BF16 | 6 | 42.19 ± 0.39 |
| Guidance Distilled FP8 | 6 | 42.24 ± 0.36 |
| Step Distilled BF16 | 6 | 38.68 ± 0.29 |
| Step Distilled FP8 | 6 | 37.92 ± 0.31 |
两个坦诚的细节值得表扬:① FP8 几乎不掉点(GD 反而 +0.05 pp 量级),量化基本白赚;② 报告主动承认在 RTX 5090 消费级卡上,F3A SD 相比 π0.5 反而慢 1.15~2.42 倍(FP8/BF16)——速度优势是「工作站/数据中心」级别的结论,不是无条件的。
🦾 真机评测:第三方盲测 + SO-101 迁移(Fig 13 ~ Fig 20)
Table 6:Positronic Robotics 第三方盲测(Franka 机械臂、10 个 DROID 任务 × 每任务 3 次、单次 240 秒窗口、操作者不知哪个模型在跑、全程录像):
| 模型 | 总成绩 |
|---|---|
| F3A | 93.3%(28/30) |
| Cosmos 3 Nano | 90.0%(27/30) |
| DreamZero | 66.7%(20/30) |
| π0.5 | 43.3%(13/30) |
逐任务看:F3A 在 “Put cube in bowl / Move cup left / Close the drawer” 等 8 项拿到 3/3,仅 Sponge in bowl、Marker in bowl 各丢 1 次;π0.5 有 4 项 0/3——仿真上的精度优势在真机上完全兑现。
Fig 13 ~ 16:四个成功 rollout 的海报帧(原视频见官方报告页;1280×240 长条 = 时间轴拼帧):
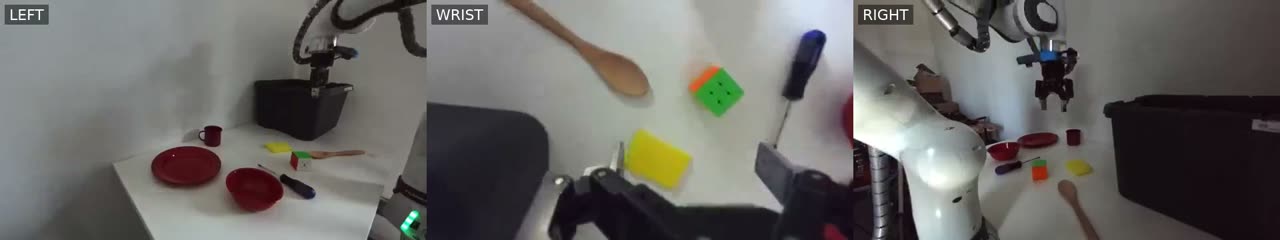 Fig 13:任务「Put the cube in the bowl」的成功 rollout。
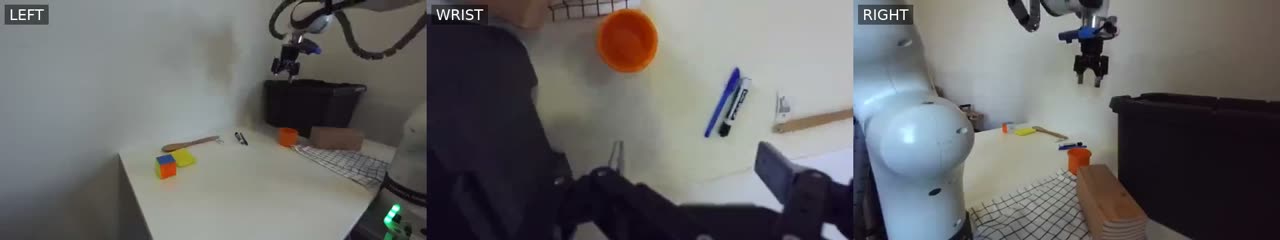 Fig 14:任务「Move the cup to the left」的成功 rollout。
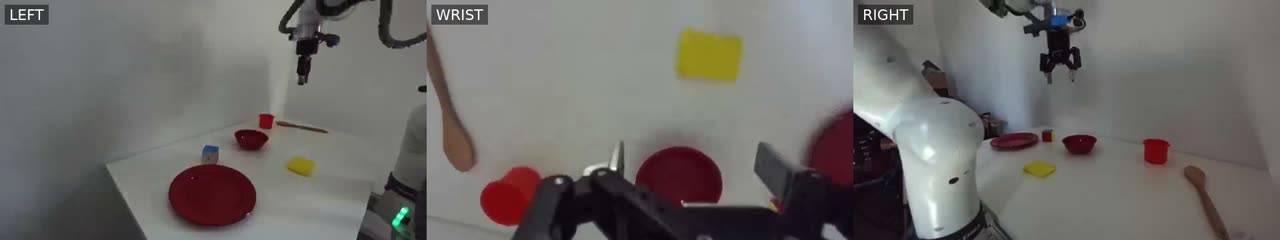 Fig 15:任务「Put the sponge in the bowl」的成功 rollout。
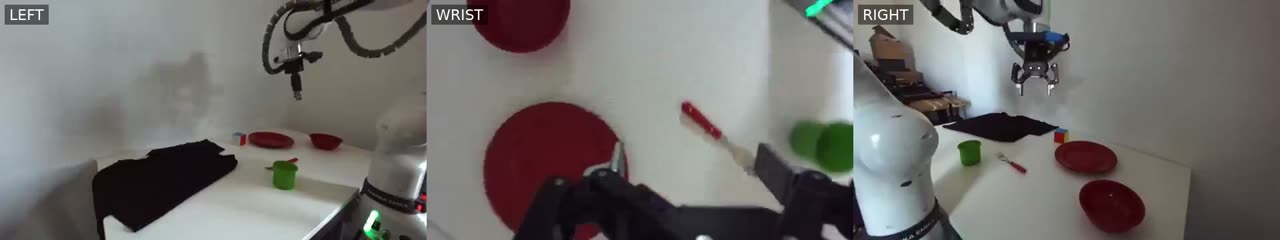 Fig 16:任务「Put the fork on the plate」的成功 rollout。
SO-101:同一配方换个本体——用遥操作采了一小批数据,按 DROID 配方微调(NVIDIA/LeRobot 还协助测试了参数高效微调):
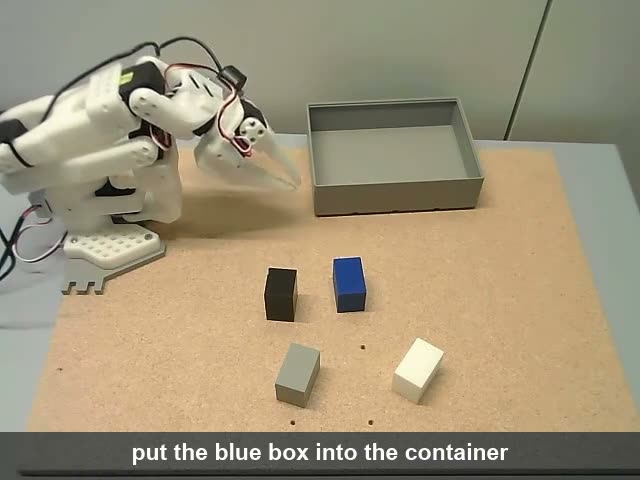 Fig 17:SO-101 分布内任务的 rollout。
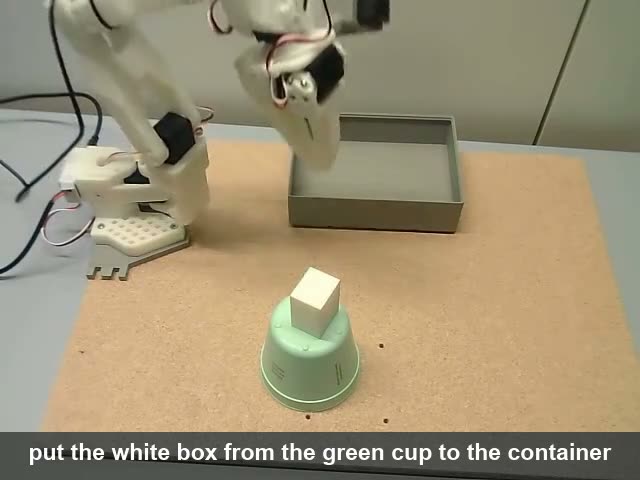
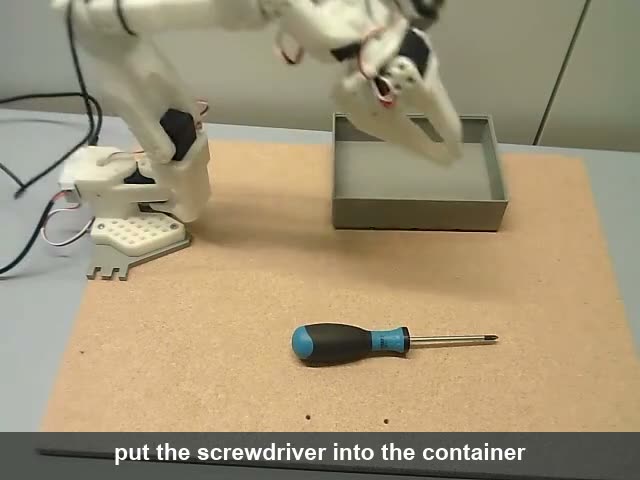
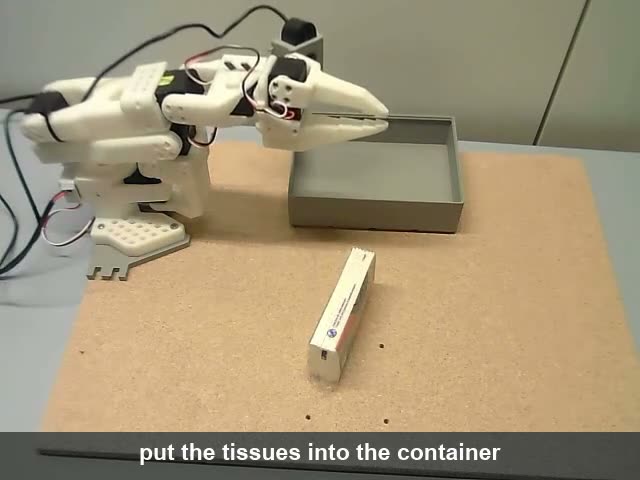 Fig 18:换了没见过的物体(object 泛化),三个例子。
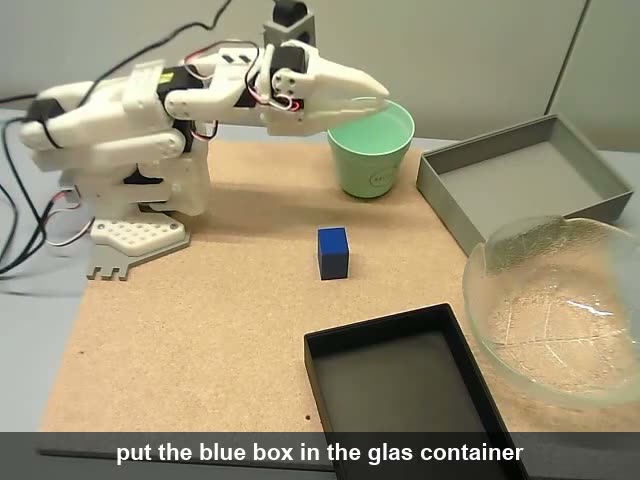
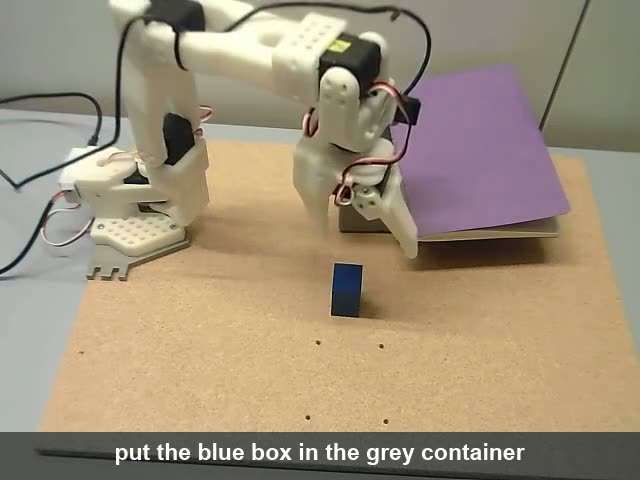
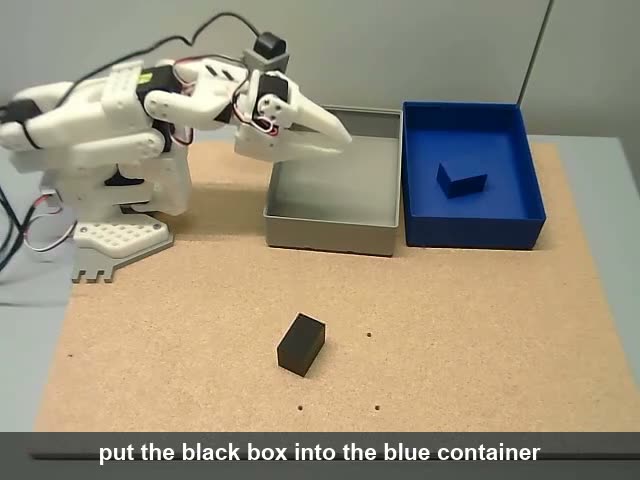 Fig 19:换了没见过的容器(container 泛化),三个例子。
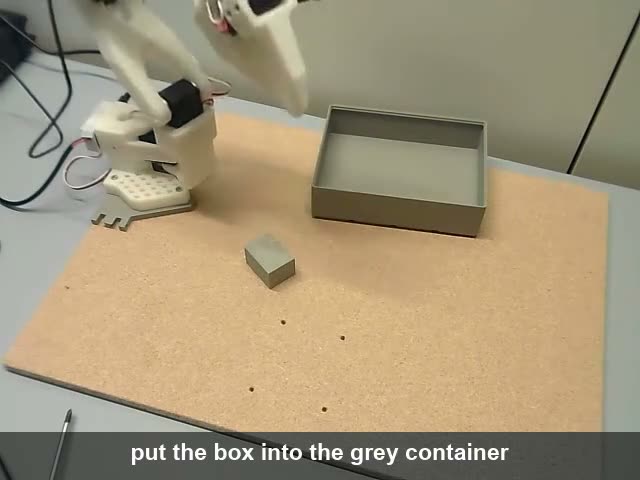
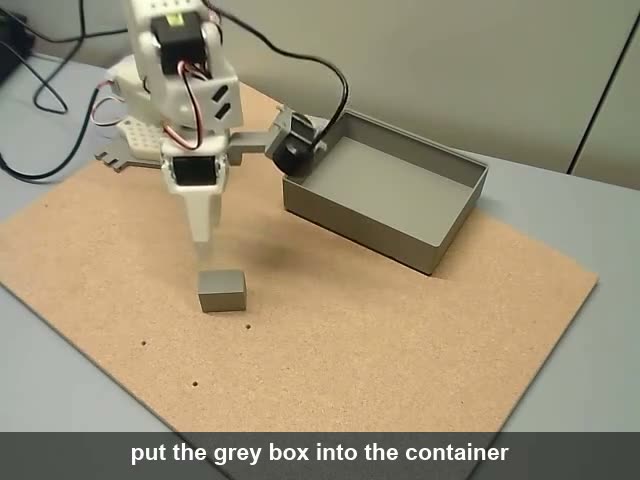
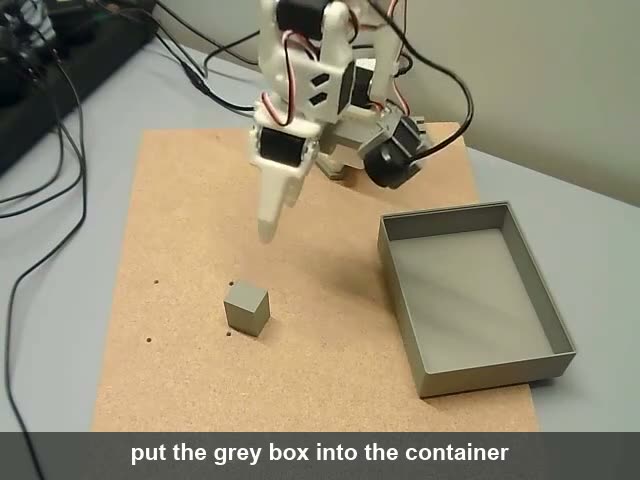 Fig 20:换了没见过的相机视角(camera 泛化),三个例子。
三组 OOD 图合起来讲的是同一件事:视频预训练来的世界理解 + 只需小批遥操作数据的微调配方,让泛化不必靠堆任务数据——这正是 WAM 路线对 VLA 的核心卖点(对比 Table 6 里 π0.5 的 43.3%)。
🎮 游戏:动作预测的下一个试验田
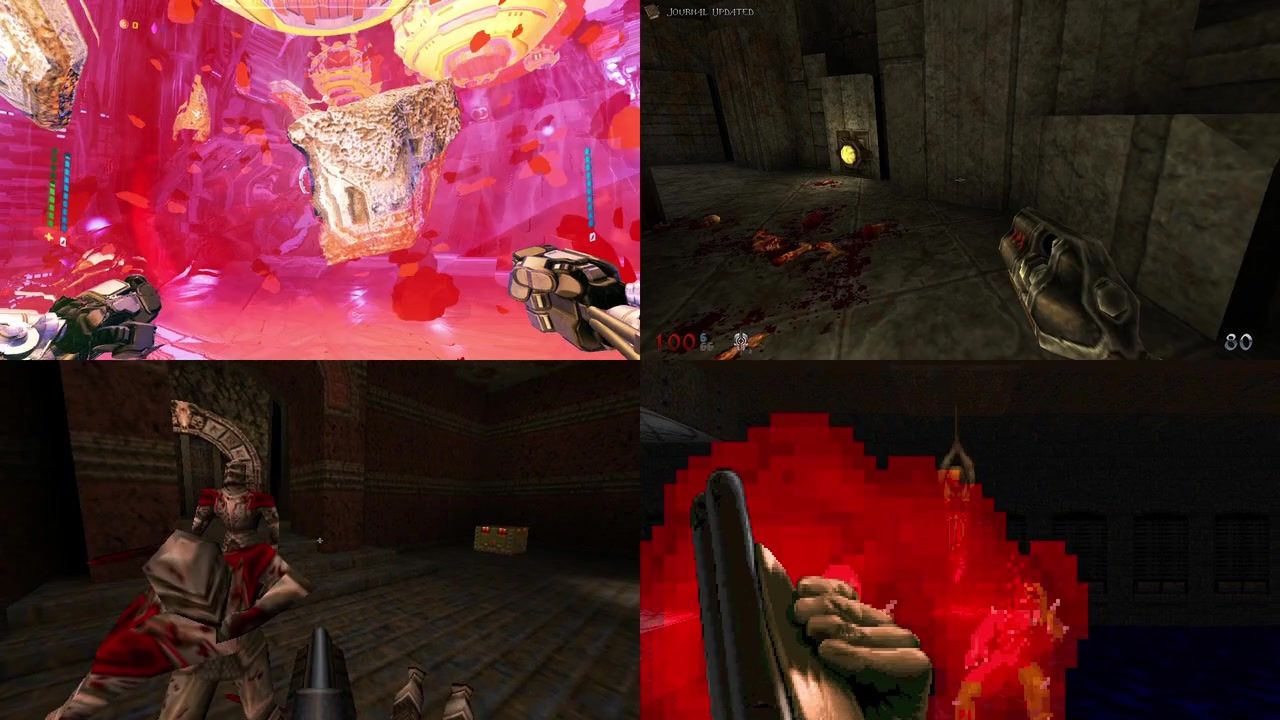 官方游戏演示截帧。注意官方说明:模型还不能实时玩游戏——游戏跑在 Firecracker 虚拟机里,画面是后期加速的。
中训数据里那 19.55% 的游戏录像(102 维鼠标键盘动作)在这里兑现了:报告把游戏称作动作预测的理想试验田——工业自动化之外,「陌生地形导航、从背景里挑出目标、预判其他智能体、部分信息下规划」这些能力在真实世界里没法安全、规模化地评测,而游戏是人类花了上千万工时专门设计来挑战这些能力的,还能并行、超实时、零风险地跑。Outlook 里那句结语很值得记住:
“An agent that plays games is just one short step from operating other software."——会玩游戏的智能体,离操作其他软件只差一步。
(这也呼应了动作预测的更广定义:鼠标键盘、界面操作、延迟敏感的 computer-use agent,都是「动作预测」的射程。)
🤖 混合策略:让推理大模型只在必要时出手(Fig 2)
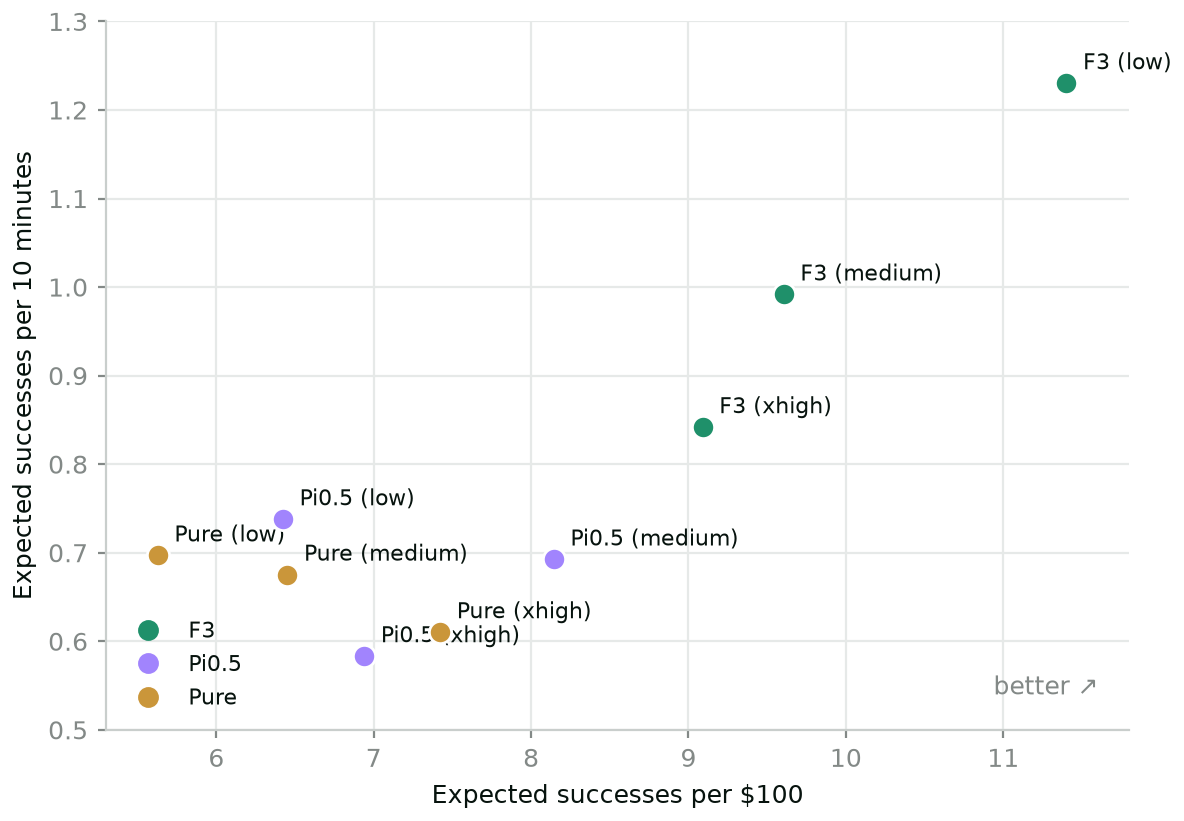
Fig 2:三种配置 × 三档推理强度下的「期望成功数 / $100」与「期望成功数 / 10 分钟」(按官方交互图数据重绘;越靠右上越好,图上标了 better 方向)。
动机:纯动作策略(F3A)快但有天花板——像 “Pumpkins in clutter”、“按红蓝绿黄顺序堆方块” 这类长程任务没有任何纯动作策略能单独解决;纯推理智能体(GPT 6 Astra)在最大推理力度下能解 100% 的任务,但每次成功平均要 16 分钟、$13.47(每次推理调用约 16 秒起)。两者各缺一半。
实验设置(复现 Su et al. 2026):Astra 当管理整局历史的 agent;动作策略(F3A 或 π0.5)基于当前观察出一段预测动作,经正运动学转成末端位姿交给 Astra;Astra 每轮四选一——执行策略预测的动作子集 / 修改其中 1~5 步 / 自己另出动作 / 结束;选定动作经逆运动学在 RoboLab 里执行,循环往复。推理档位三档:low / medium / xhigh。纯推理变体则不给任何策略动作,Astra 全程自己出。
读图:**F3A + Astra(low 档)独占右上角——每 $100 期望成功 11.4 次、每 10 分钟 1.23 次,两根轴都是全场第一**;π0.5+Astra 和纯 Astra 的九个点全被压在 5.6~8.1($/100)和 0.58~0.74(/10min)的区间里。动作策略越强,系统需要的推理就越少——这是本节的中心论点。
纯推理 vs 纯动作的账单(H200 按 $3/GPU·时 计):
| 每秒机器人动作的计算 | 每次成功成本 | 每次成功时间 | |
|---|---|---|---|
| GPT 6 Astra(xhigh) | 35.77 秒 | $13.47 | ~16 分钟 |
| F3A(单步 FP8) | 21.08 毫秒 | $0.09 | < 2 分钟(绝大部分时间在等机器人动) |
F3A 单跑一个 rollout 时几乎全程空闲,理论上还能再并发 47 个 rollout 不加钱;换成纯 Astra 则是 8.57 倍时间成本、155 倍金钱成本(并行场景下差距拉到 ~400 倍 / 7843 倍)。
Table 7:混合配置主表(节选)
| 配置 | 成功率 | 每次成功成本 | 每次成功时间 | token/成功 |
|---|---|---|---|---|
| F3A + Astra(low) | 90% (45/50) | $8.77 | 8m08s | 6.60M |
| F3A + Astra(medium) | 84% (42/50) | $10.41 | 10m05s | 7.69M |
| F3A + Astra(xhigh) | 94% (47/50) | $11.00 | 11m53s | 7.83M |
| π0.5 + Astra(medium) | 86% (43/50) | $12.28 | 14m26s | 8.86M |
| 纯 Astra(xhigh) | 100% (50/50) | $13.47 | 16m23s | 10.00M |
| 纯 Astra(low) | 84% (42/50) | $17.77 | 14m21s | 14.13M |
对比结论:π0.5 只带来温和的效率改善(medium 档把成本从 $13.47 压到 $12.28);F3A 把成本压到 $8.77(-29%)、时间压到 8m08s(-40%),还保住 90% 成功率——比最优替代配置又便宜 29% 又快 40%。纯 Astra(xhigh)100% 的准确率仍是天花板,可靠性 vs 成本的权衡点被一个更强的动作策略整体挪动了。
最生动的案例:按序堆方块
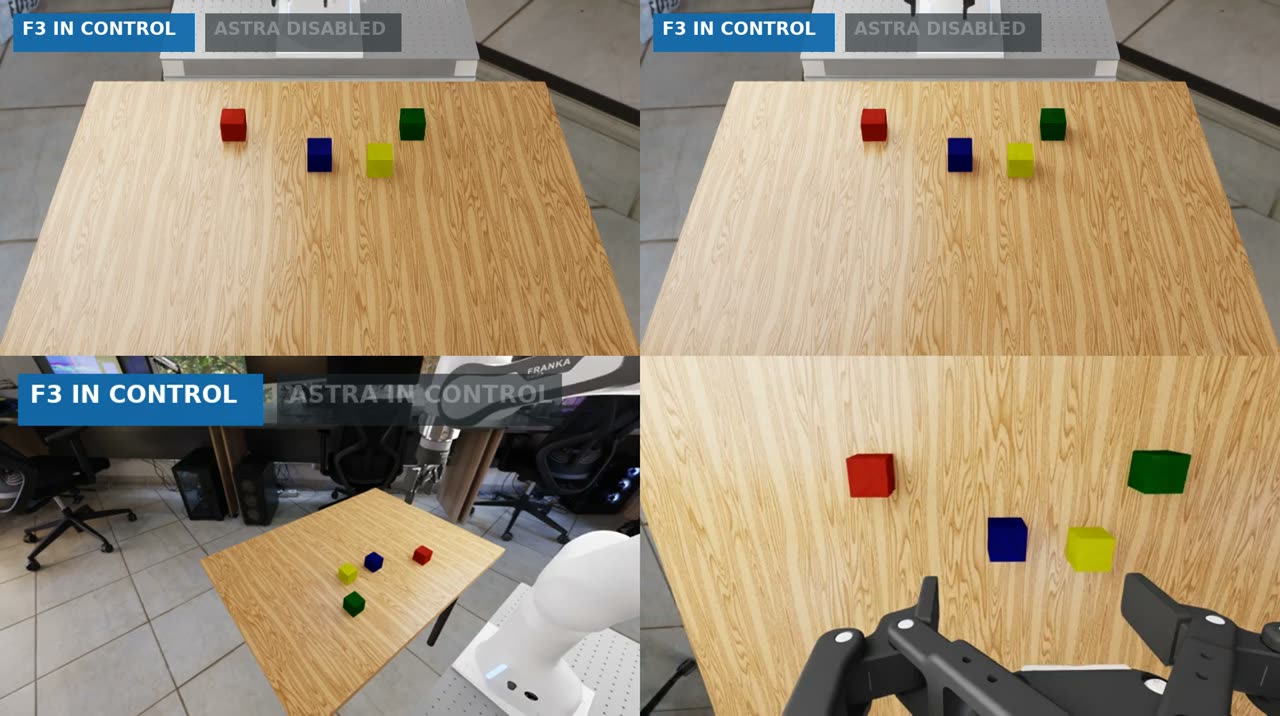 任务「按从下到上顺序堆:红、蓝、绿、黄」。上两条 = 纯 F3A rollout,底条 = F3A+Astra(low)混合 rollout(叠加层显示此刻谁在控制)。
视频(海报帧)说明了一切:F3A 其实有堆方块的视觉运动技能,但会无视「顺序」要求——它正要把黄块放到红蓝之上时,Astra 短暂接管,把末端挪近绿块,只修正了这一下就交还控制权,F3A 随后自己完成了正确顺序。这正是报告想要的分工:策略管「手」,推理管「脑」,脑只在策略即将犯原则性错误时出来点一下。
🗂️ 图表总索引(20 张图 + 8 张表全收录)
| 编号 | 内容 | 本文小节 |
|---|---|---|
| Fig 1 | RoboLab 成功率 vs 速度的 Pareto 前沿(交互图,重绘) | Fig 1:Pareto 前沿 |
| Fig 2 | 混合策略每 $100 / 每 10 分钟期望成功数(重绘) | 混合策略 |
| Fig 3 | F3A 架构:三编码器 → 五特征流骨干 → 双解码头(SVG) | 架构总览 |
| Fig 4 | 预训练/中训检查点接动作头的 RoboLab 成绩(重绘) | Fig 4 |
| Fig 5 | 视频与动作最小 x₀ 损失包络(重绘) | Fig 5 |
| Fig 6 | logit-logistic / logit-normal 提议密度(重绘) | Fig 6 |
| Fig 7 | 时间步分布 × shift × action scale 网格热力图(SVG×4 合成) | Fig 7 |
| Fig 8 | 中训成绩 + DROID 微调四条跑法(重绘) | Fig 8 |
| Fig 9 | 训练损失 vs 成功率,含退火段(重绘) | Fig 9 |
| Fig 10 | loss spike 分支对比(重绘) | Fig 10 |
| Fig 11 | Video CFG × Action CFG 网格(SVG) | Fig 11 |
| Fig 12 | EMA 18 变体排名 + σ/β 扫描(重绘) | Fig 12 |
| Fig 13 | 真机:Put the cube in the bowl(视频海报帧) | 真机评测 |
| Fig 14 | 真机:Move the cup to the left | 真机评测 |
| Fig 15 | 真机:Put the sponge in the bowl | 真机评测 |
| Fig 16 | 真机:Put the fork on the plate | 真机评测 |
| Fig 17 | SO-101 分布内任务 | 真机评测 |
| Fig 18 | SO-101 分布外物体(3 例) | 真机评测 |
| Fig 19 | SO-101 分布外容器(3 例) | 真机评测 |
| Fig 20 | SO-101 分布外相机(3 例) | 真机评测 |
表格:Table 1 RoboLab 总榜(Pareto 节)、Table 2 中训数据混合(Fig 4 节)、Table 3 动作块设置 / Table 4 延迟 / Table 5 多种子成绩(推理效率节)、Table 6 真机盲测(真机节)、Table 7 混合策略效率 + Table 8 按任务拆解(混合策略节)。另有控制循环示意、SO-101 相机排布、游戏截帧、方块堆叠对比 4 张站点演示图。
💡 架构评析:三个最妙的设计,三条边界
三个最妙的设计
- 「正交蒸馏」而不是「改架构」。WAM 慢的三个根源(长序列、guidance 双前向、大骨干),报告只动了两个可蒸馏的:guidance 蒸馏掉(还倒赚 0.6~1.08 pp)、步数蒸掉(4→1);骨干靠 Self-Flow 预训练做小(7B < 16B 的一半);唯独不动「视频-动作联合预测」这个根本。对比之下,此前所有提速方案(分开解码器、注意力掩码、并行化 guidance)都在架构上开了口子。先证明能力不可妥协,再向工程要速度——这个顺序是对的。
- 把「配方」当成一等公民交付。时间步分布的「测过渡区→设计分布→网格确认」流程(Fig 5~7)、loss spike 必回滚的纪律(Fig 10)、EMA 18 变体的系统对比(Fig 12)、甚至「中训数据每类占多少 token」(Table 2)——全是平时被论文省略、但复现时能救命的细节。开源权重 + 开源配方的组合对社区价值极大。
- 重新定价「推理 × 动作」。Fig 2 + Table 7 证明了一条可迁移的系统规律:混合系统的成本几乎线性地取决于动作策略的强度——策略越强,推理模型越可以只当「偶尔出手的监理」。$13.47 → $8.77、16 分 → 8 分、还保住 90%,这个杠杆对任何「大模型规划 + 小模型执行」的架构都成立。
三条边界
- SOTA 是「蒸馏后」的 SOTA:单步版 −3.5~−4.3 pp、guidance 蒸馏才到 42.2%;而 step 蒸馏在消费级 RTX 5090 上比 π0.5 还慢 1.15~2.42 倍。「快」的结论限定在工作站/数据中心 + FP8 语境,报告对此倒是坦白。
- 真机证据仍然薄:第三方盲测只有 10 任务 × 3 次 = 30 次尝试;SO-101 是单臂桌面场景;OOD 泛化只有海报帧没有定量成功率。仿真 42% 与真机 93% 之间隔着「任务难度不可比」这层雾——WAM 数据效率的真机定量验证仍缺一个大规模基准。
- 混合策略的天花板没变:Astra(xhigh)纯推理仍是唯一 100% 的配置;F3A+Astra(low)90% 意味着仍有 10% 硬任务要花大钱推理来兜底。且整个 hybrid 结论建立在 RoboLab 仿真 + 特定 agent 协议上,游戏演示也尚非实时——「脑手分工」的最终形态还在探索期。
🗺️ 在 WAM / VLA 谱系里的位置
| F3A | Cosmos 3 Nano | π0.5 | DreamZero | |
|---|---|---|---|---|
| 类型 | WAM | WAM | VLA | WAM |
| 参数量 | 7B | 16B | 3.3B | 14B |
| RoboLab SR | 42.92%(GD 版 42.2% mean) | 36.8% | 28.0% | 25.7% |
| 视频预测 | ✅ 联合 | ✅ 联合 | ❌ | ✅ 联合 |
| 单步推理 | ✅(蒸馏) | ❌(4 步+guidance) | ✅(10 步) | – |
| 独门贡献 | 蒸馏配方 + 时间步/EMA 方法论 | 全模态世界基础模型 | 两级推理 + 混合动作表示 | 提出 WAM 命名 |
给自己的启发(结合 MOT 世界模型 + Flow Matching 动作专家的日常):这份报告里三块东西可以直接搬运——① 分模态 CFG 网格的形态(视频引导加大力度、动作端保守),我们的视频世界模型 + 动作头一样适用;② **「先测噪声过渡区、再定时间步分布、动作缩放 s 控制模态间条件分解」**这一套,比默认均匀采 t 严谨得多;③ EMA 用 Power EMA σ_rel=0.10、spike 即回滚,属于训练工程的免费午餐。至于 WAM vs VLA 之争,F3A 给出的答案是:在参数和蒸馏到位的前提下,两者不再是二选一。
🎤 汇报口述稿
各位好,今天分享 Black Forest Labs 九月发布的 FLUX 3 Action 官方技术报告——一个 7B 的世界行动模型,在 RoboLab-120 上把精度和速度同时做到了开源第一。
背景一句话:动作策略长期被分成两个阵营——WAM 联合预测视频和动作,数据效率和泛化好,但慢;VLA 只预测动作,快,但少学四分之一的成功任务。F3A 的目标是把两边的红利同时拿到手。
结构上,F3A 就是图 3:文本、历史视频、机器人状态三路编码,过同一个 FLUX 3 骨干,每层都同时维护任务、历史、状态、未来视频、动作五股特征,最后一层分别解码成未来画面和机器人动作。跑起来是一个 Look-Think-Move 的控制循环:一次前向吐 32 步动作、15 赫兹、覆盖 2.13 秒,执行完重新观察再规划。
成绩单:单步蒸馏版 38.3% ± 0.38,guidance 蒸馏版 42.2% ± 0.36,都超过 16B 的 Cosmos 3 Nano 的 36.8%;速度上比 π0.5 快 1.34 到 2.28 倍,FP8 下比 Cosmos 3 Nano 快 1.52 到 3.95 倍。实现靠两招:Self-Flow 多模态预训练把骨干做小,两级蒸馏把 guidance 和采样步数蒸掉,架构本身完全不动。
配方方面报告给了四个可以直接抄的流程:第一,预训练和中训——没有视频预训练的对照组只有 0.75%,视频预训练直接拉到 11.6%,中训混合里游戏占了近 20%;第二,时间步分布——先分别测出视频和动作的噪声过渡区,动作过渡更晚更抗噪,据此设计 logit-logistic 分布、加 shift 42 和动作缩放 2,网格搜索后 36.72% 最优;第三,DROID 微调——新动作头先冻住中训权重 1000 步再线性放开,联合微调大批量最终到 40.13%,而且损失还在降时成功率已经平台化,选点必须看评测;第四,推理侧——分模态 CFG 找到视频 4、动作 1 的最优格 42.00%,EMA 十八个变体对比后选在线 Power EMA σ=0.10。
效率侧的账:guidance 蒸馏提速 1.8 到 2 倍还倒涨一个点,step 蒸馏四步变一步再提速 3 到 4 倍,代价三到四个点,但仍然比 Cosmos 高、快一个数量级;FP8 加 torch.compile 加提示词缓存几乎不掉点。真机第三方盲测 28/30、93.3% 排第一,SO-101 小批遥操作数据换个本体,物体、容器、相机三种分布外都能泛化。
最后是系统层的发现:把 F3A 接到 GPT 6 Astra 后面,低档推理就够——每次成功成本从 13.47 美元降到 8.77 美元,时间从 16 分钟降到 8 分钟,成功率还有 90%,比最优替代方案又便宜 29% 又快 40%。核心规律是:动作策略越强,系统需要的推理就越少。会玩游戏的智能体,离操作软件只差一步——这是他们的展望。
我的评价:这份报告最值得学的不是那个 42.2%,而是它把时间步分布、EMA、loss spike 处理这些「平时没人写进论文」的配方全部摊开了。谢谢大家,下面是几个自测问题。
❓ 自测 Q&A
Q1:WAM 和 VLA 的本质区别是什么?F3A 凭什么两头都占?
A:VLA 只建模 p(动作|观察),WAM 联合建模 p(未来视频, 动作 | 观察)——视频预训练的世界知识随联合训练迁移到动作上,所以同样的动作数据能学到更强的泛化。F3A 两头都占的办法:联合预测的架构和数据效率一点不动,然后用蒸馏把速度补回来——guidance 蒸馏去掉双前向(1.82 倍提速,还 +0.61.08 pp),step 蒸馏 4 步到 1 步(3.15~4 倍),再加上把骨干从 16B 砍到 7B。
Q2:为什么「视频和动作的噪声过渡区不同」会导致时间步分布要重新设计? A:Flow Matching 的前向过程把数据和噪声混合,不同模态在同一 t 下的信噪比不同——Fig 5 测出动作的损失包络更低、过渡更晚(t≈0.964 附近才完成过渡),说明动作比视频抗噪。若用同一个 t 分布采样,两个模态学到的东西不匹配。解决办法是把分布 PDF 取成包络导数的形状(过渡最陡处多采样),并引入动作缩放 s:s=2 让动作更抗噪,联合流近似分解成 p(视频|动作)·p(动作)——即「先把动作建好、再在动作之上建模视频」。
Q3:Fig 9 和 Fig 10 讲了哪两个「损失曲线骗人」的教训? A:① 损失一路降、成功率 20K 步就平台化(40.13%),退火段损失继续降但成功率不再涨——checkpoint 必须按评测指标选,不能按损失选;② 学习率 ≥2e-4 会偶发 loss spike,尖峰分支成功率一度 24.0% vs 干净分支 28.25%,有的跑法恢复极慢——见到 spike 一律回滚,不赌自愈。
Q4:分模态 CFG 的最优配置是什么?为什么动作端的 CFG 要小? A:Video CFG = 4.0、Action CFG = 1.0,42.00%(Fig 11 全网格最优)。动作直接进机器人,对引导外推更敏感、容易过冲;视频是高维信号更耐推。所以趋势是「视频加大力度、动作保持温和」。
Q5:guidance 蒸馏和 step 蒸馏各解决了什么、代价是什么?
A:guidance 蒸馏解决「CFG 每步双前向」——teacher 冻结输出带引导预测当目标,student 裸跑,提速 1.82 倍,**代价为负(+0.61.08 pp,反而更好);step 蒸馏解决「4 步采样太慢」——在 GD 检查点上用 teacher 引导学单步预测,提速 3.154 倍,**代价 −3.51−4.32 pp,但仍然比 Cosmos 3 高 1 个点以上、快 9~13 倍。
Q6:Fig 2 的混合策略说明了什么系统规律? A:混合系统的效率由动作策略的强度决定。Astra 是固定的「脑」,策略是「手」:π0.5 的手不够快/不够准,混合后只省 9%;F3A 的手快 155 倍,脑就可以降到 low 档,成本 $13.47→$8.77、时间 16m→8m、成功率仍 90%。对任何「大模型规划 + 小模型执行」架构,升级执行器都是比升级规划器更划算的第一杠杆。
📚 资源与延伸
- 官方技术报告(本文的原始材料):bfl.ai/models/flux-3-action(报告正文 + 交互图 + 演示视频)
- 代码与权重:GitHub
black-forest-labs/flux-action;HuggingFaceblack-forest-labs/flux-3-action-base/flux-3-action-droid/flux-3-action-so101 - 报告引用的关键工作:Self-Flow 预训练(arXiv 2603.06507)、Cosmos 3(arXiv 2606.02800)、π0.5(arXiv 2504.16054)、DreamZero / WAM 命名(arXiv 2602.15922)、RoboLab(arXiv 2604.09860)、Power EMA(Karras et al. 2024, arXiv 2312.02696)
- 站内延伸阅读:
- 概念补课:《什么是世界模型》、《什么是 VLA 模型》、《具身智能入门指南》
- 近邻精读:《π0.5 开放世界泛化精读》(本文的头号对比对象)、《Cosmos 3 世界基础模型精读》(WAM 阵营的上一代)、《DROID 机器人操作数据集精读》(微调数据的来历)
- 技术底座:《Flow Matching 入门详解》、《VLA 大模型训练技巧》、《前沿 VLA 模型全景速览》