📄 论文信息
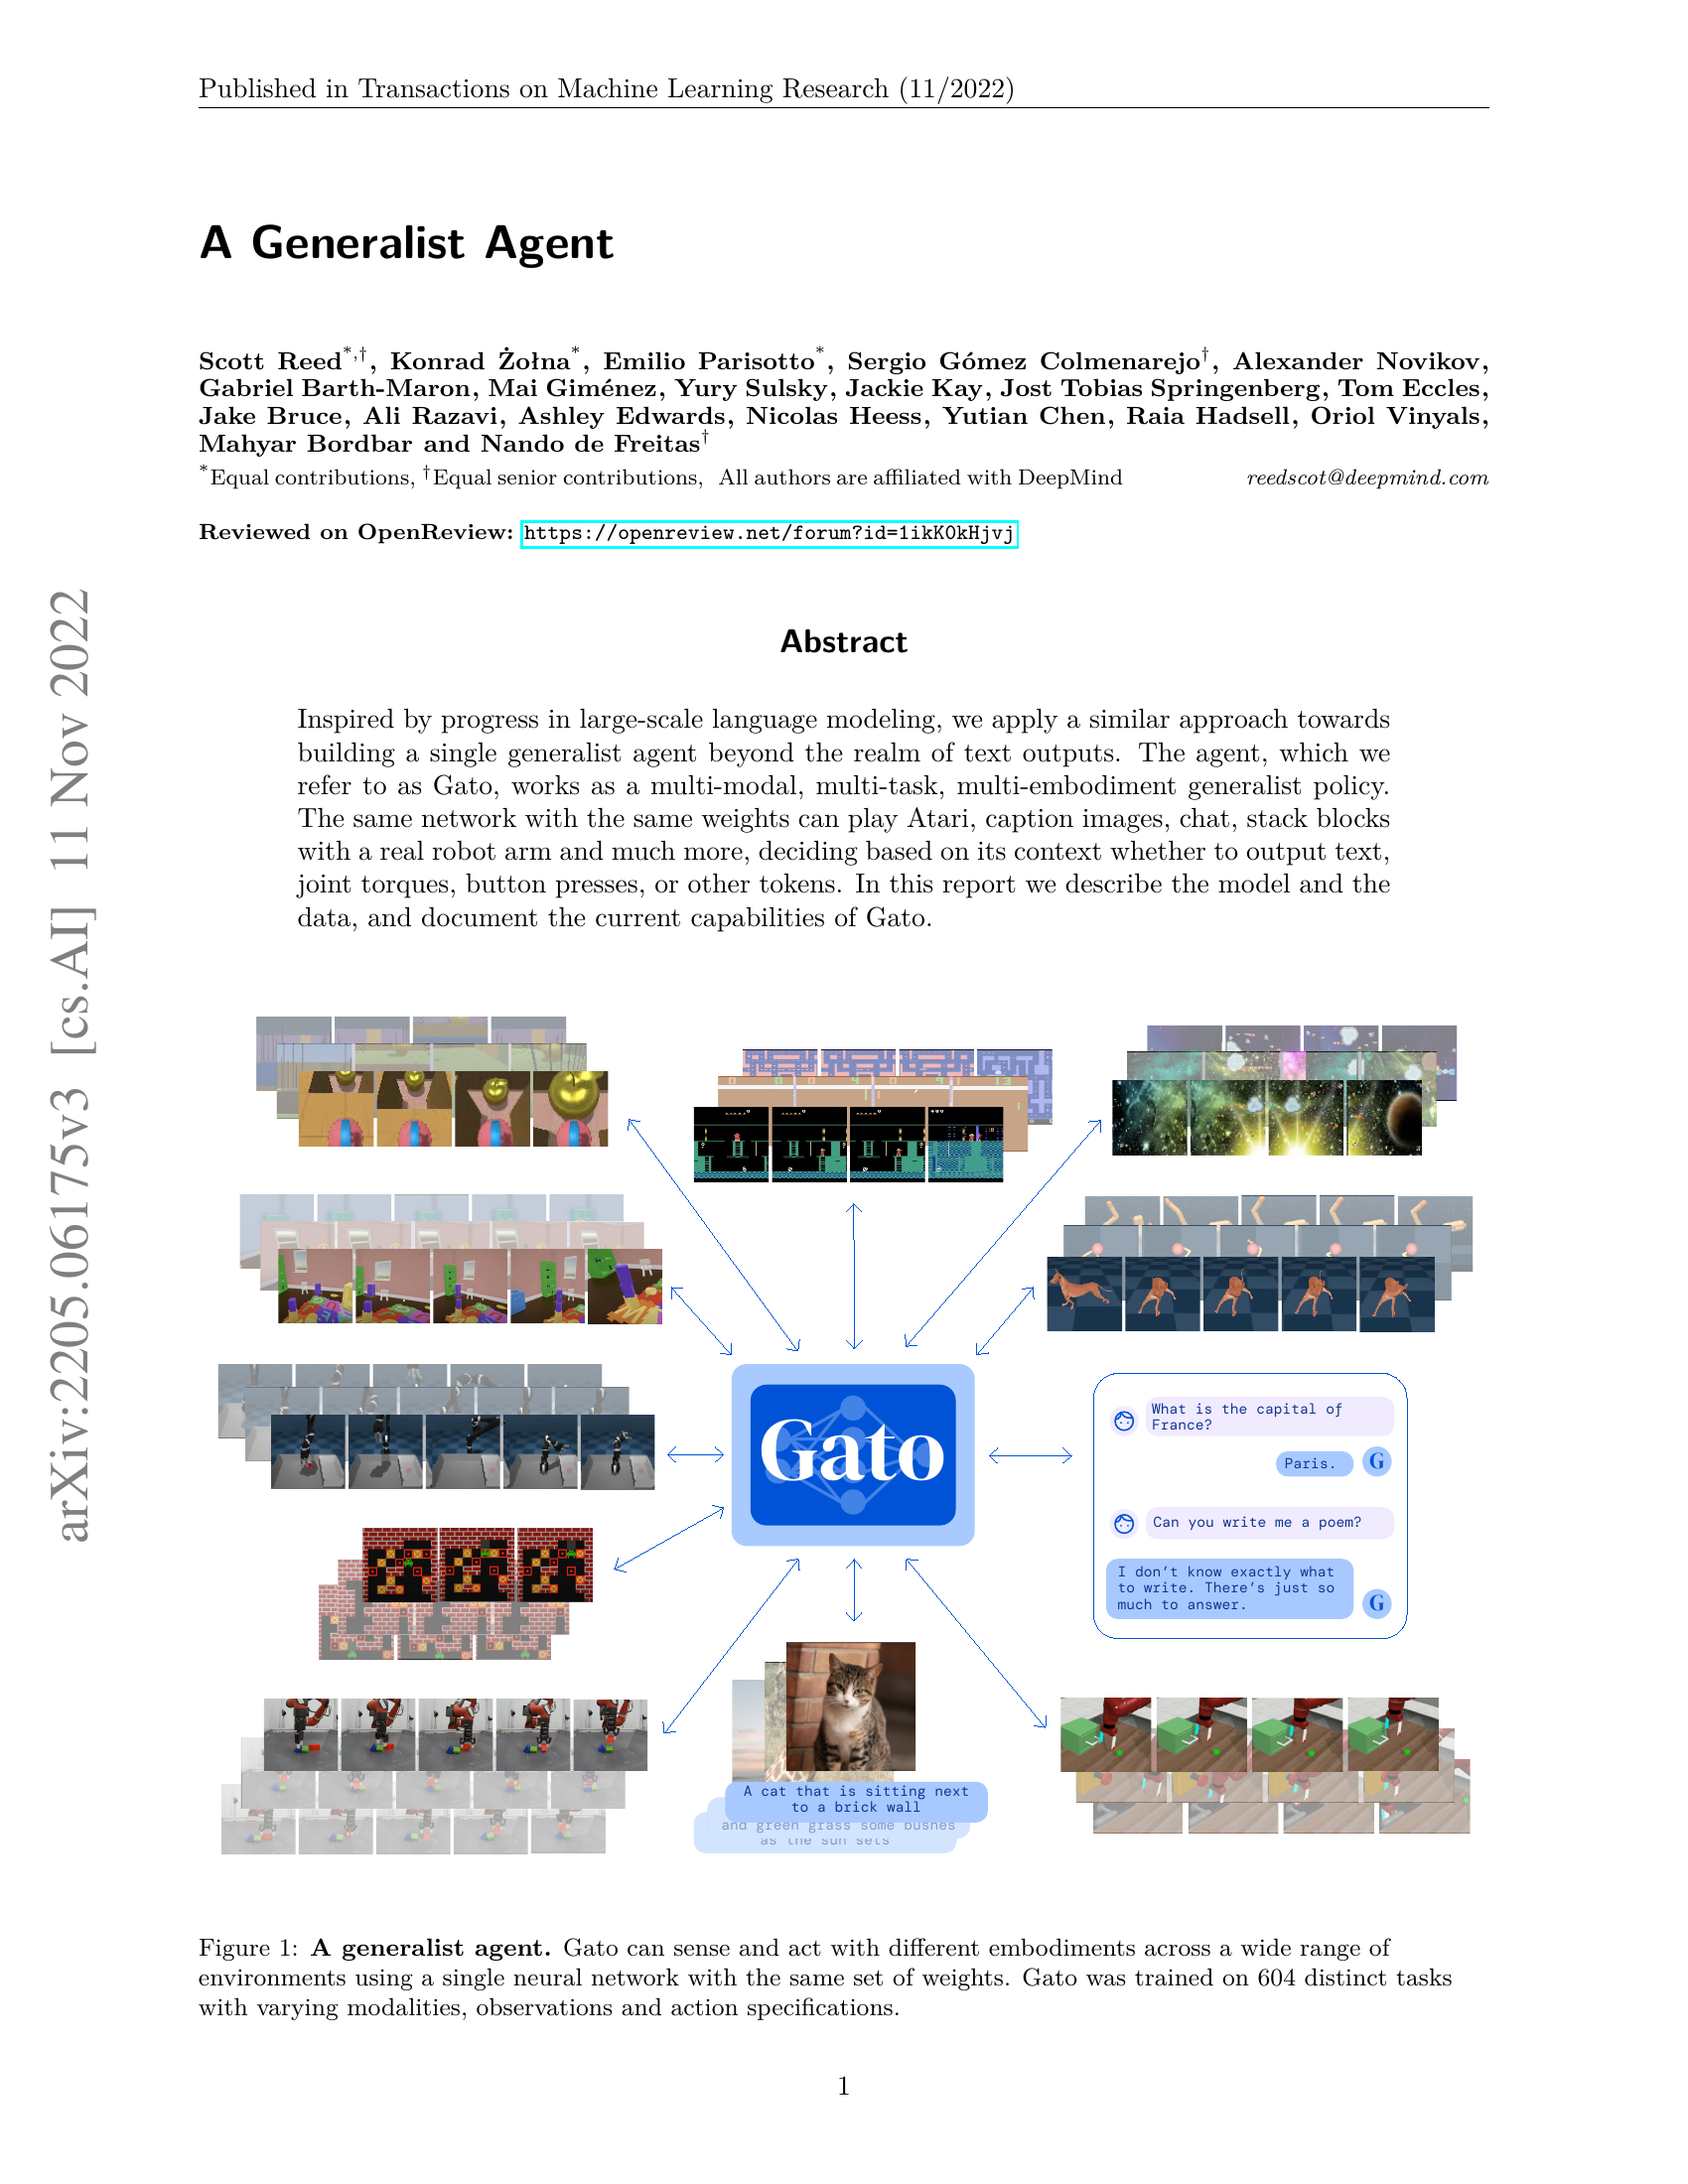
| 项目 | 内容 |
|---|---|
| 标题 | A Generalist Agent(一个通用智能体) |
| 作者 | Scott Reed, Konrad Żołna, Emilio Parisotto, Sergio Gómez Colmenarejo, Alexander Novikov, Gabriel Barth-Maron 等 20 位作者 |
| 单位 | DeepMind |
| 发表 | TMLR 2022(Transactions on Machine Learning Research),arXiv:2205.06175 |
| 关键词 | 通用智能体、多任务学习、Transformer、多模态、强化学习 |
| 一句话总结 | 用一个 1.2B 参数的 Transformer 网络在 604 种任务上联合训练,同时掌握游戏、机器人、对话等多种技能,证明了通用智能体的可行性 |
| 论文链接 | arXiv:2205.06175 |
| 代码链接 | 未开源 |
🤔 要解决什么问题?
核心问题:智能体的"专才"困境
在 Gato 之前,人工智能领域存在一个深刻的割裂:语言模型越来越通用,而控制策略始终是"专才"。
GPT-3 可以写诗、翻译、编程、推理,一个模型处理所有文本任务;但在机器人控制和游戏领域,每个任务都需要单独训练一个模型——打 Atari 需要一个 DQN,机械臂抓取需要一个 SAC,对话需要一个语言模型,图像描述需要一个视觉语言模型。这些模型之间几乎没有知识共享。
这种"专才"模式存在根本性缺陷:
- 数据效率低下:每个任务从零开始学习,无法利用其他任务的经验
- 泛化能力有限:在 A 任务上学到的技能无法迁移到 B 任务
- 部署成本高昂:N 个任务需要 N 个模型,存储和推理资源成倍增长
- 无法涌现通用能力:没有"举一反三"的可能
更深层的思考:具身智能的模态壁垒
传统控制策略的输入通常是低维的状态向量(关节角度、速度等)或像素图像,输出是动作向量。而语言和视觉理解任务处理的是完全不同的数据模态——文本序列、图像 patches。这两类任务之间存在巨大的模态壁垒。
Gato 要回答的核心问题是:能否用一个统一的网络架构,将所有模态的数据(文本、图像、动作、状态)统一表示,并在一个模型中同时处理所有任务?
这不仅是工程上的挑战,更是对"通用智能"本质的一次探索——如果一个模型真的能同时掌握 604 种截然不同的任务,那它在某种意义上就具备了"通用性"。
💡 核心方法
1. 统一的 Token 化框架
Gato 的第一个关键洞察是:如果把所有模态的数据都变成离散 Token,那么一个语言模型就能处理一切。
这是对 GPT 系列"万物皆可 Token"思想的极致延伸。GPT 用 BPE 将文本变成 Token,Gato 则将所有模态——文本、图像、动作、状态——全部转化为统一的 Token 序列。
具体的 Token 化方案如下:
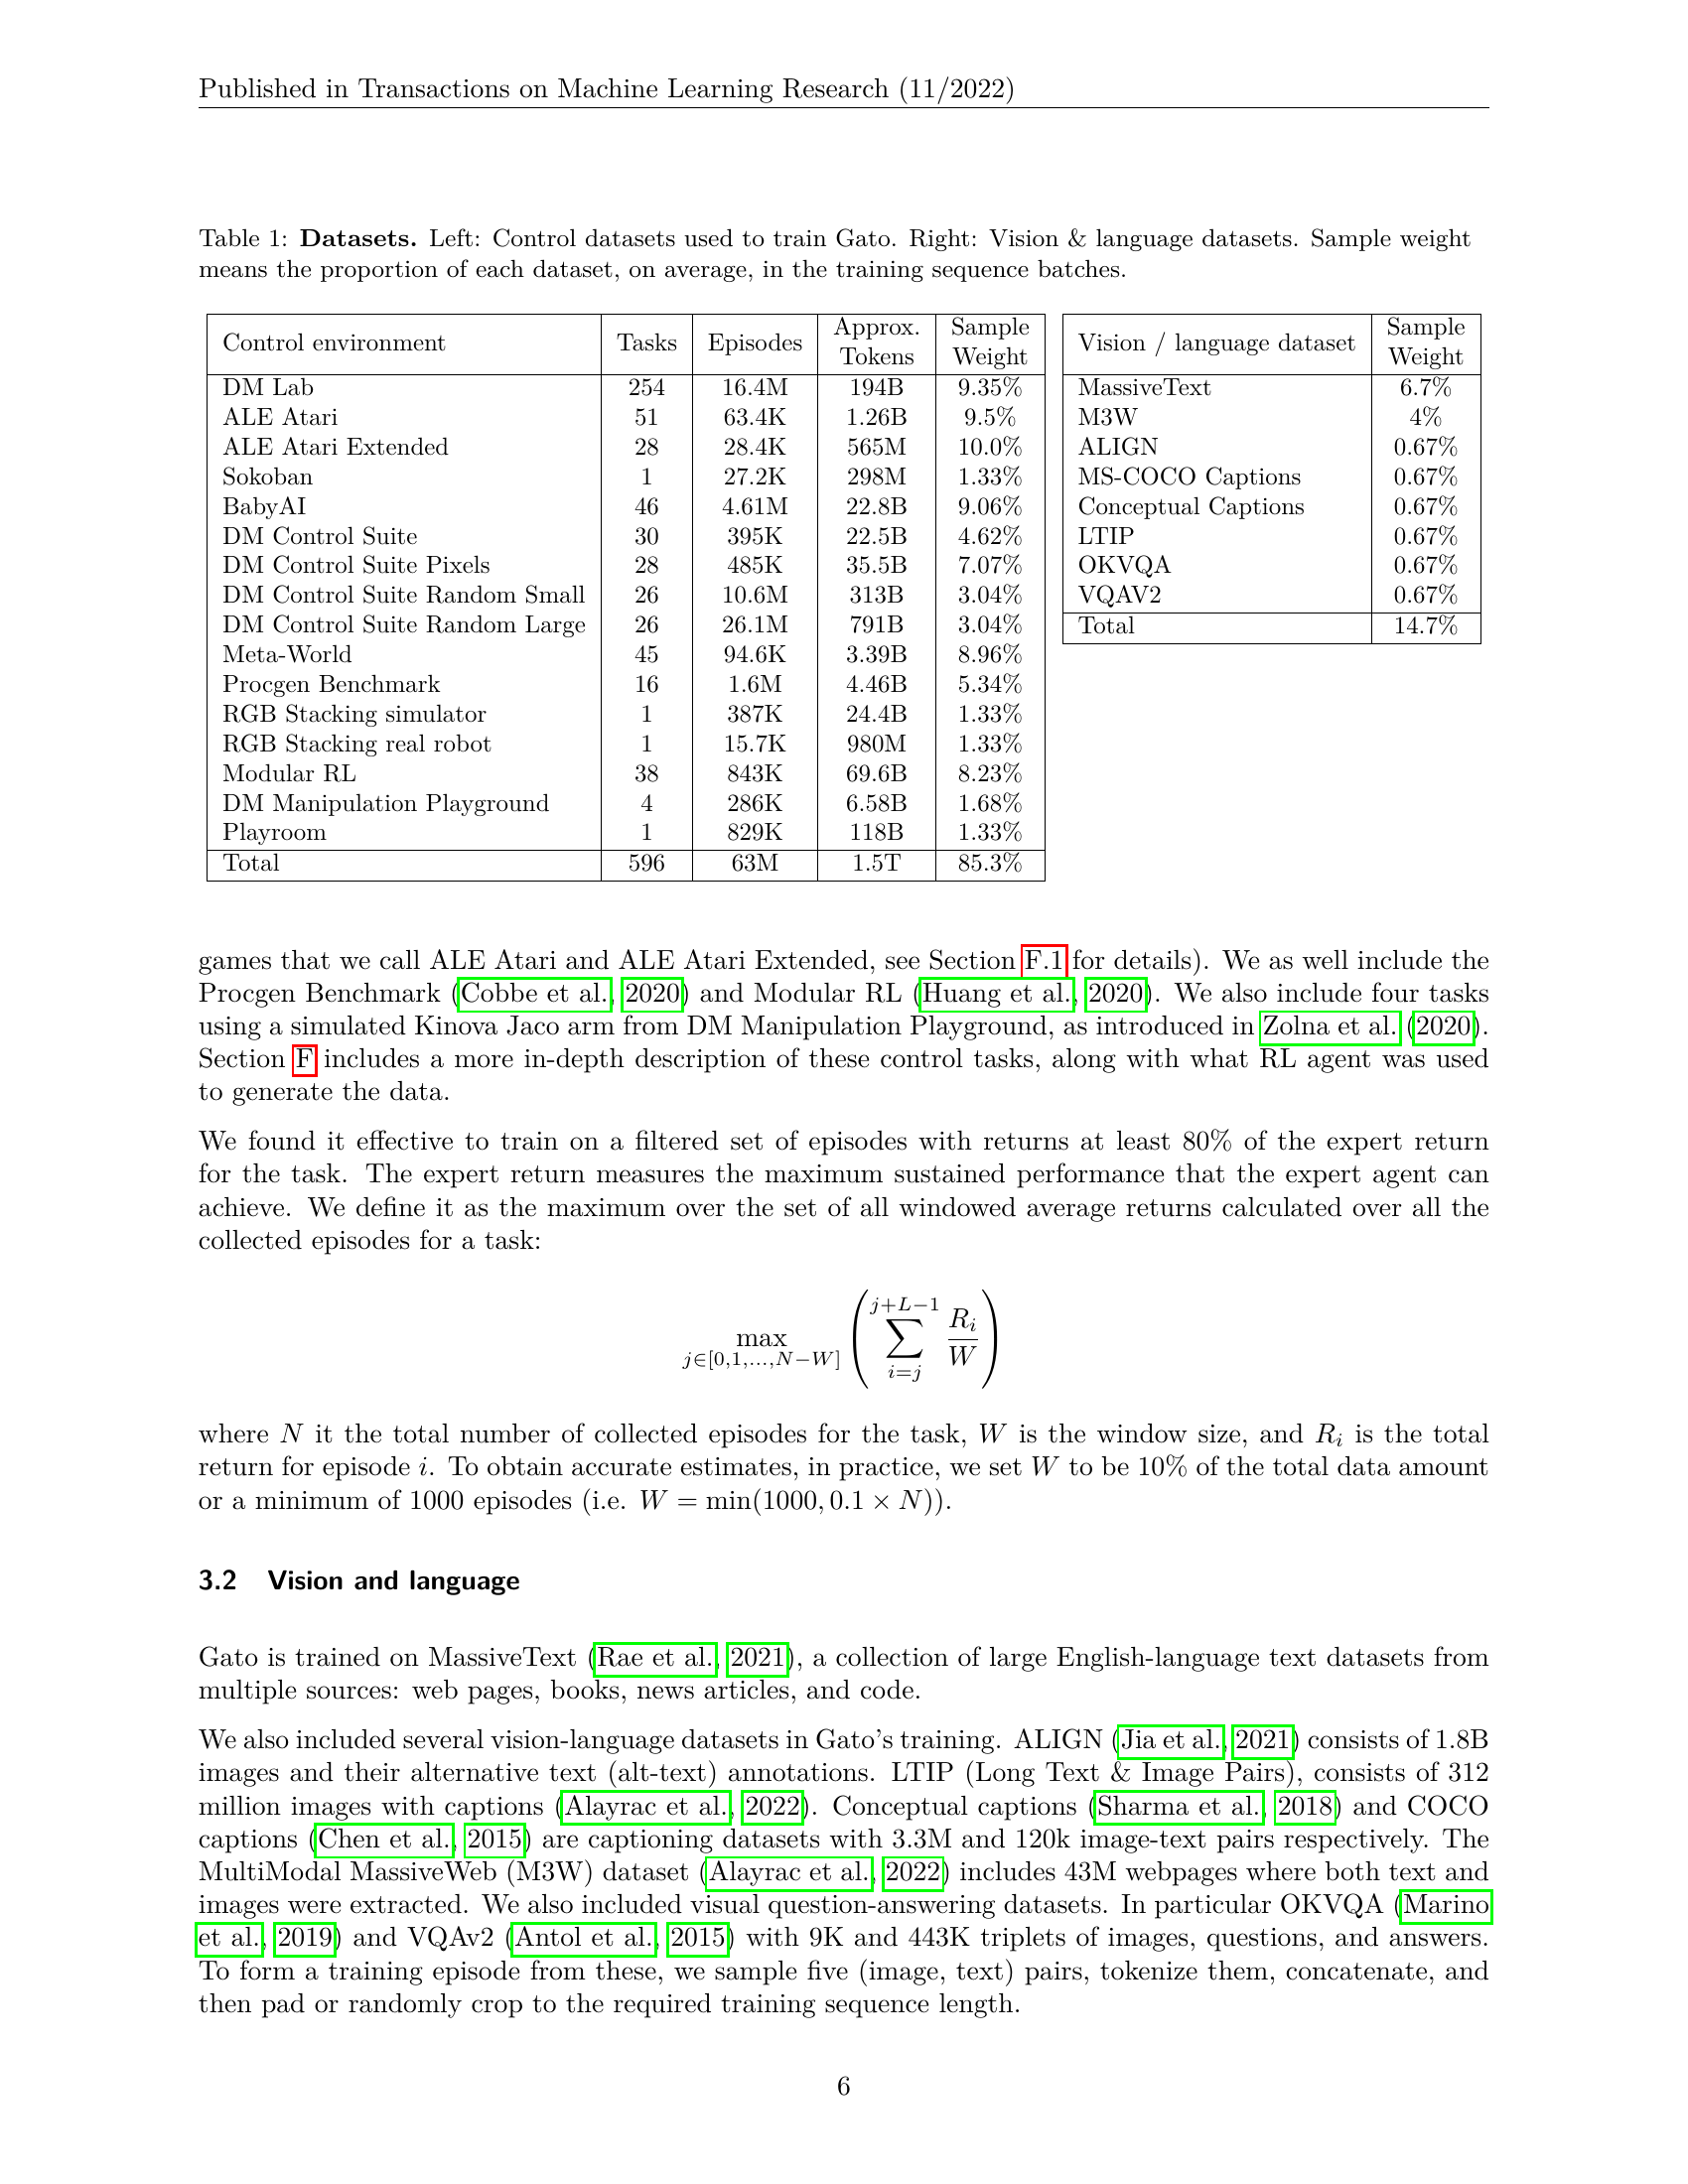
文本 Token:使用 SentencePiece 实现的 BPE(Byte Pair Encoding),词表大小为 32,000。这是标准的 NLP Token 化方案,直接复用。
图像 Token:将图像分割为 $16 \times 16$ 的 patch,每个 patch 通过一个 ResNet 编码器转换为一个 Token。这与 ViT(Vision Transformer)的思想一致——将图像视为一个 patch 序列。对于 Atari 游戏画面($210 \times 160$ 像素),会生成 $13 \times 10 = 130$ 个图像 Token。
离散动作 Token:如 Atari 游戏中的按钮按下(上、下、左、右、开火等),直接映射为整数 Token,范围在 $[0, 1024]$ 内。
连续动作 Token:这是最精妙的部分。机器人控制中的连续动作值(如关节力矩、末端执行器位移)首先通过 mu-law 编码映射到 $[-1, 1]$ 区间,然后离散化为 1024 个 bin。每个连续值变成一个整数 Token。mu-law 编码的公式为:
$$x' = \frac{\text{sign}(x) \cdot \ln(1 + \mu |x|)}{\ln(1 + \mu)}$$其中 $\mu = 255$。这种编码方式对小值更敏感(分辨率更高),对大值较粗糙,符合控制任务中对精度的需求。这与 WaveNet 中使用的音频量化方案一脉相承。
本体感知 Token:机器人的关节角度、速度等本体感知信息也被离散化为 Token。
2. 统一的序列格式
Token 化之后,所有数据被组织成统一的序列格式。这是 Gato 能够用一个模型处理所有任务的关键:
[observation_tokens] [sep] [action_tokens] [observation_tokens] [sep] [action_tokens] ...
具体来说:
- 每个时间步的观测(图像 + 本体感知)先被 Token 化,按光栅扫描顺序排列
- 观测 Token 之后紧跟一个特殊的
[sep]分隔符 Token - 分隔符之后是该时间步的动作 Token
- 整个 episode 按时间顺序排列
对于文本任务(如对话、图像描述),序列格式更简单——直接是文本 Token 的序列,不需要观测-动作的交替结构。
这种统一格式意味着:无论是打游戏、控制机器人还是聊天,数据在模型眼中都是同一种序列。模型不需要知道自己在执行什么任务——它只需要预测下一个 Token。
3. 网络架构
Gato 采用纯解码器(decoder-only)Transformer架构,这与 GPT 系列一致:
| 参数 | 值 |
|---|---|
| 参数量 | 1.2B |
| 层数 | 24 |
| 嵌入维度 | 2048 |
| 注意力后前馈隐藏维度 | 8196 |
| 注意力头数 | 32 |
| 上下文窗口 | 1024 tokens |
为什么选择 decoder-only 而不是 encoder-decoder?作者的解释是"为了简单和可扩展性"。但更深层的原因是:decoder-only 架构天然适合自回归生成,而 Gato 的所有输出(文本、动作)都是自回归生成的。
嵌入函数包含两个组件:
- Token 嵌入查找表:文本、离散值、连续值 Token 通过查找表映射到嵌入空间
- ResNet 视觉编码器:图像 patch Token 通过一个 ResNet 编码器转换为嵌入向量,并添加图像内位置编码
序列模型就是一个标准的 Transformer 解码器,输出下一个 Token 的概率分布。
4. Prompt 条件化
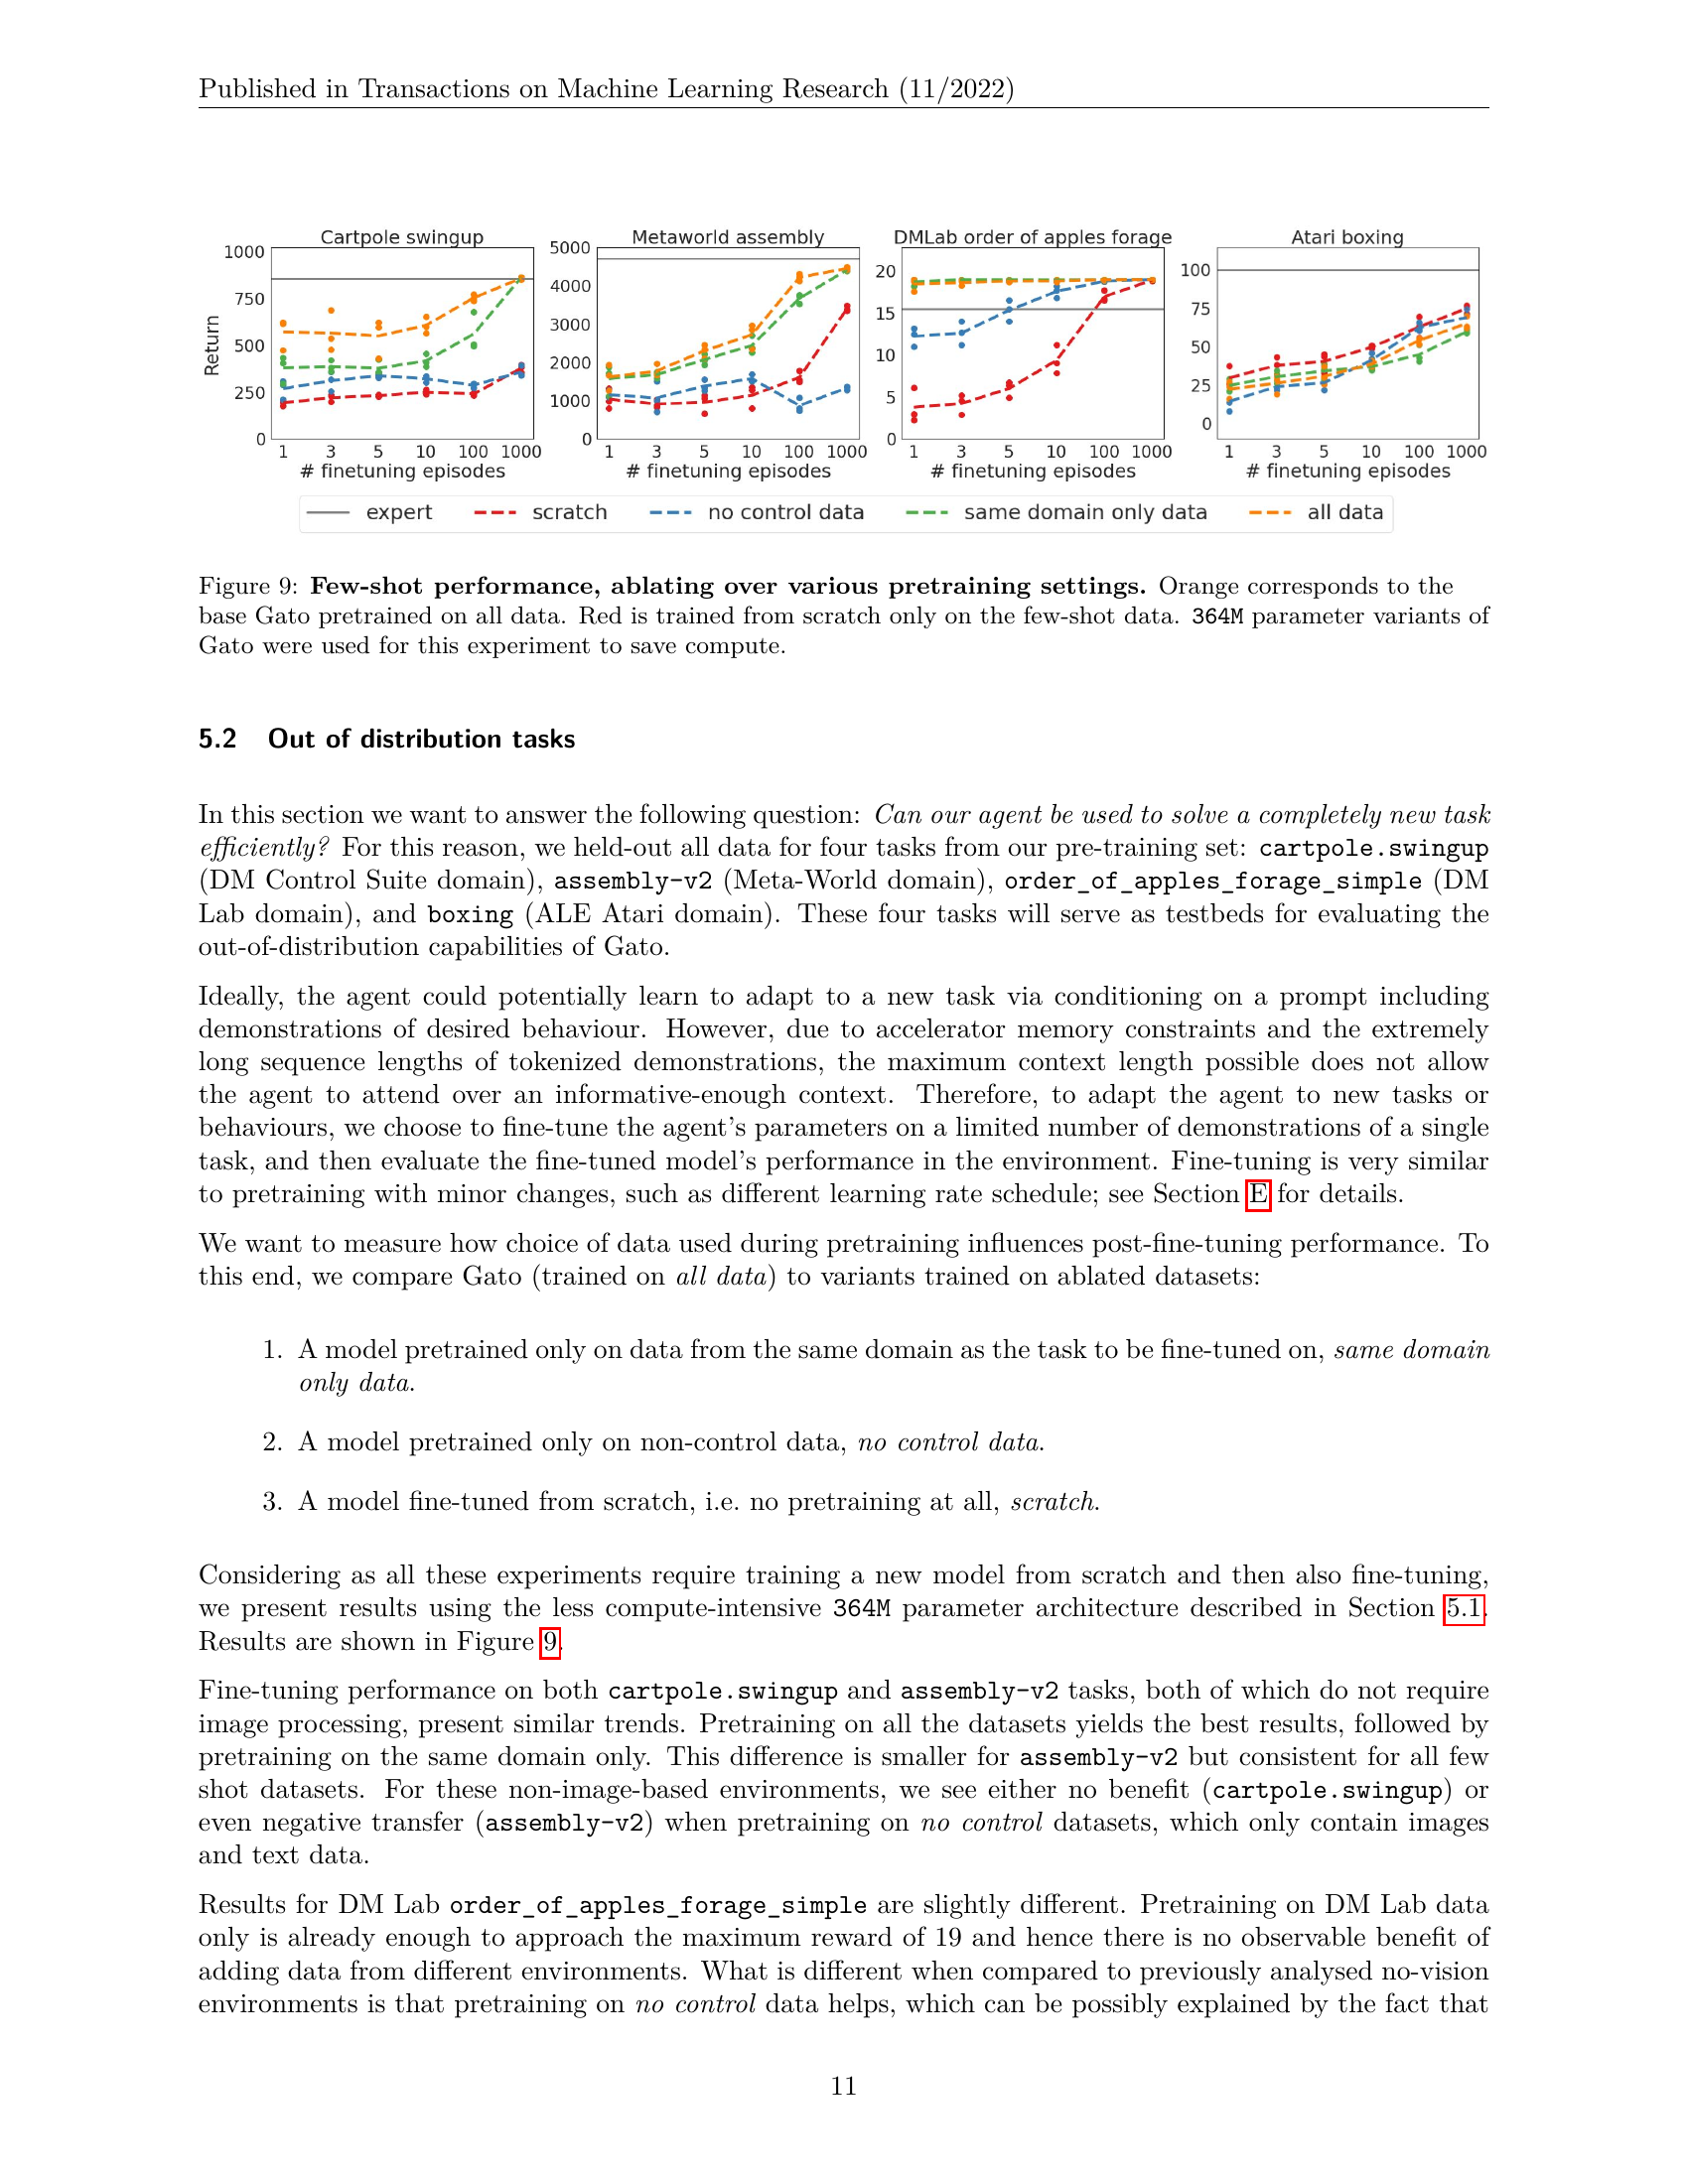
Gato 的另一个关键设计是 prompt 条件化(prompt conditioning)。在同一个域(如 Atari)中,不同游戏可能有完全相同的观测格式和动作空间,但任务目标不同。模型需要某种方式来区分它们。
Gato 借鉴了 GPT-3 和 T5 的思路,使用 prompt 来提供上下文。具体做法是:
- 在训练时,每个 batch 中 25% 的序列前面会附加一个 prompt 序列
- Prompt 来自同一任务、同一来源 agent 的一个 episode
- 一半 prompt 取自 episode 的末尾(作为目标条件化),另一半从 episode 中均匀采样
- 在评估时,默认使用一个成功的示范作为 prompt
这意味着 Gato 的 prompt 不是自然语言指令,而是一段成功的行为示范。这种设计类似于 few-shot learning 中用示例来引导模型行为。
5. 训练策略
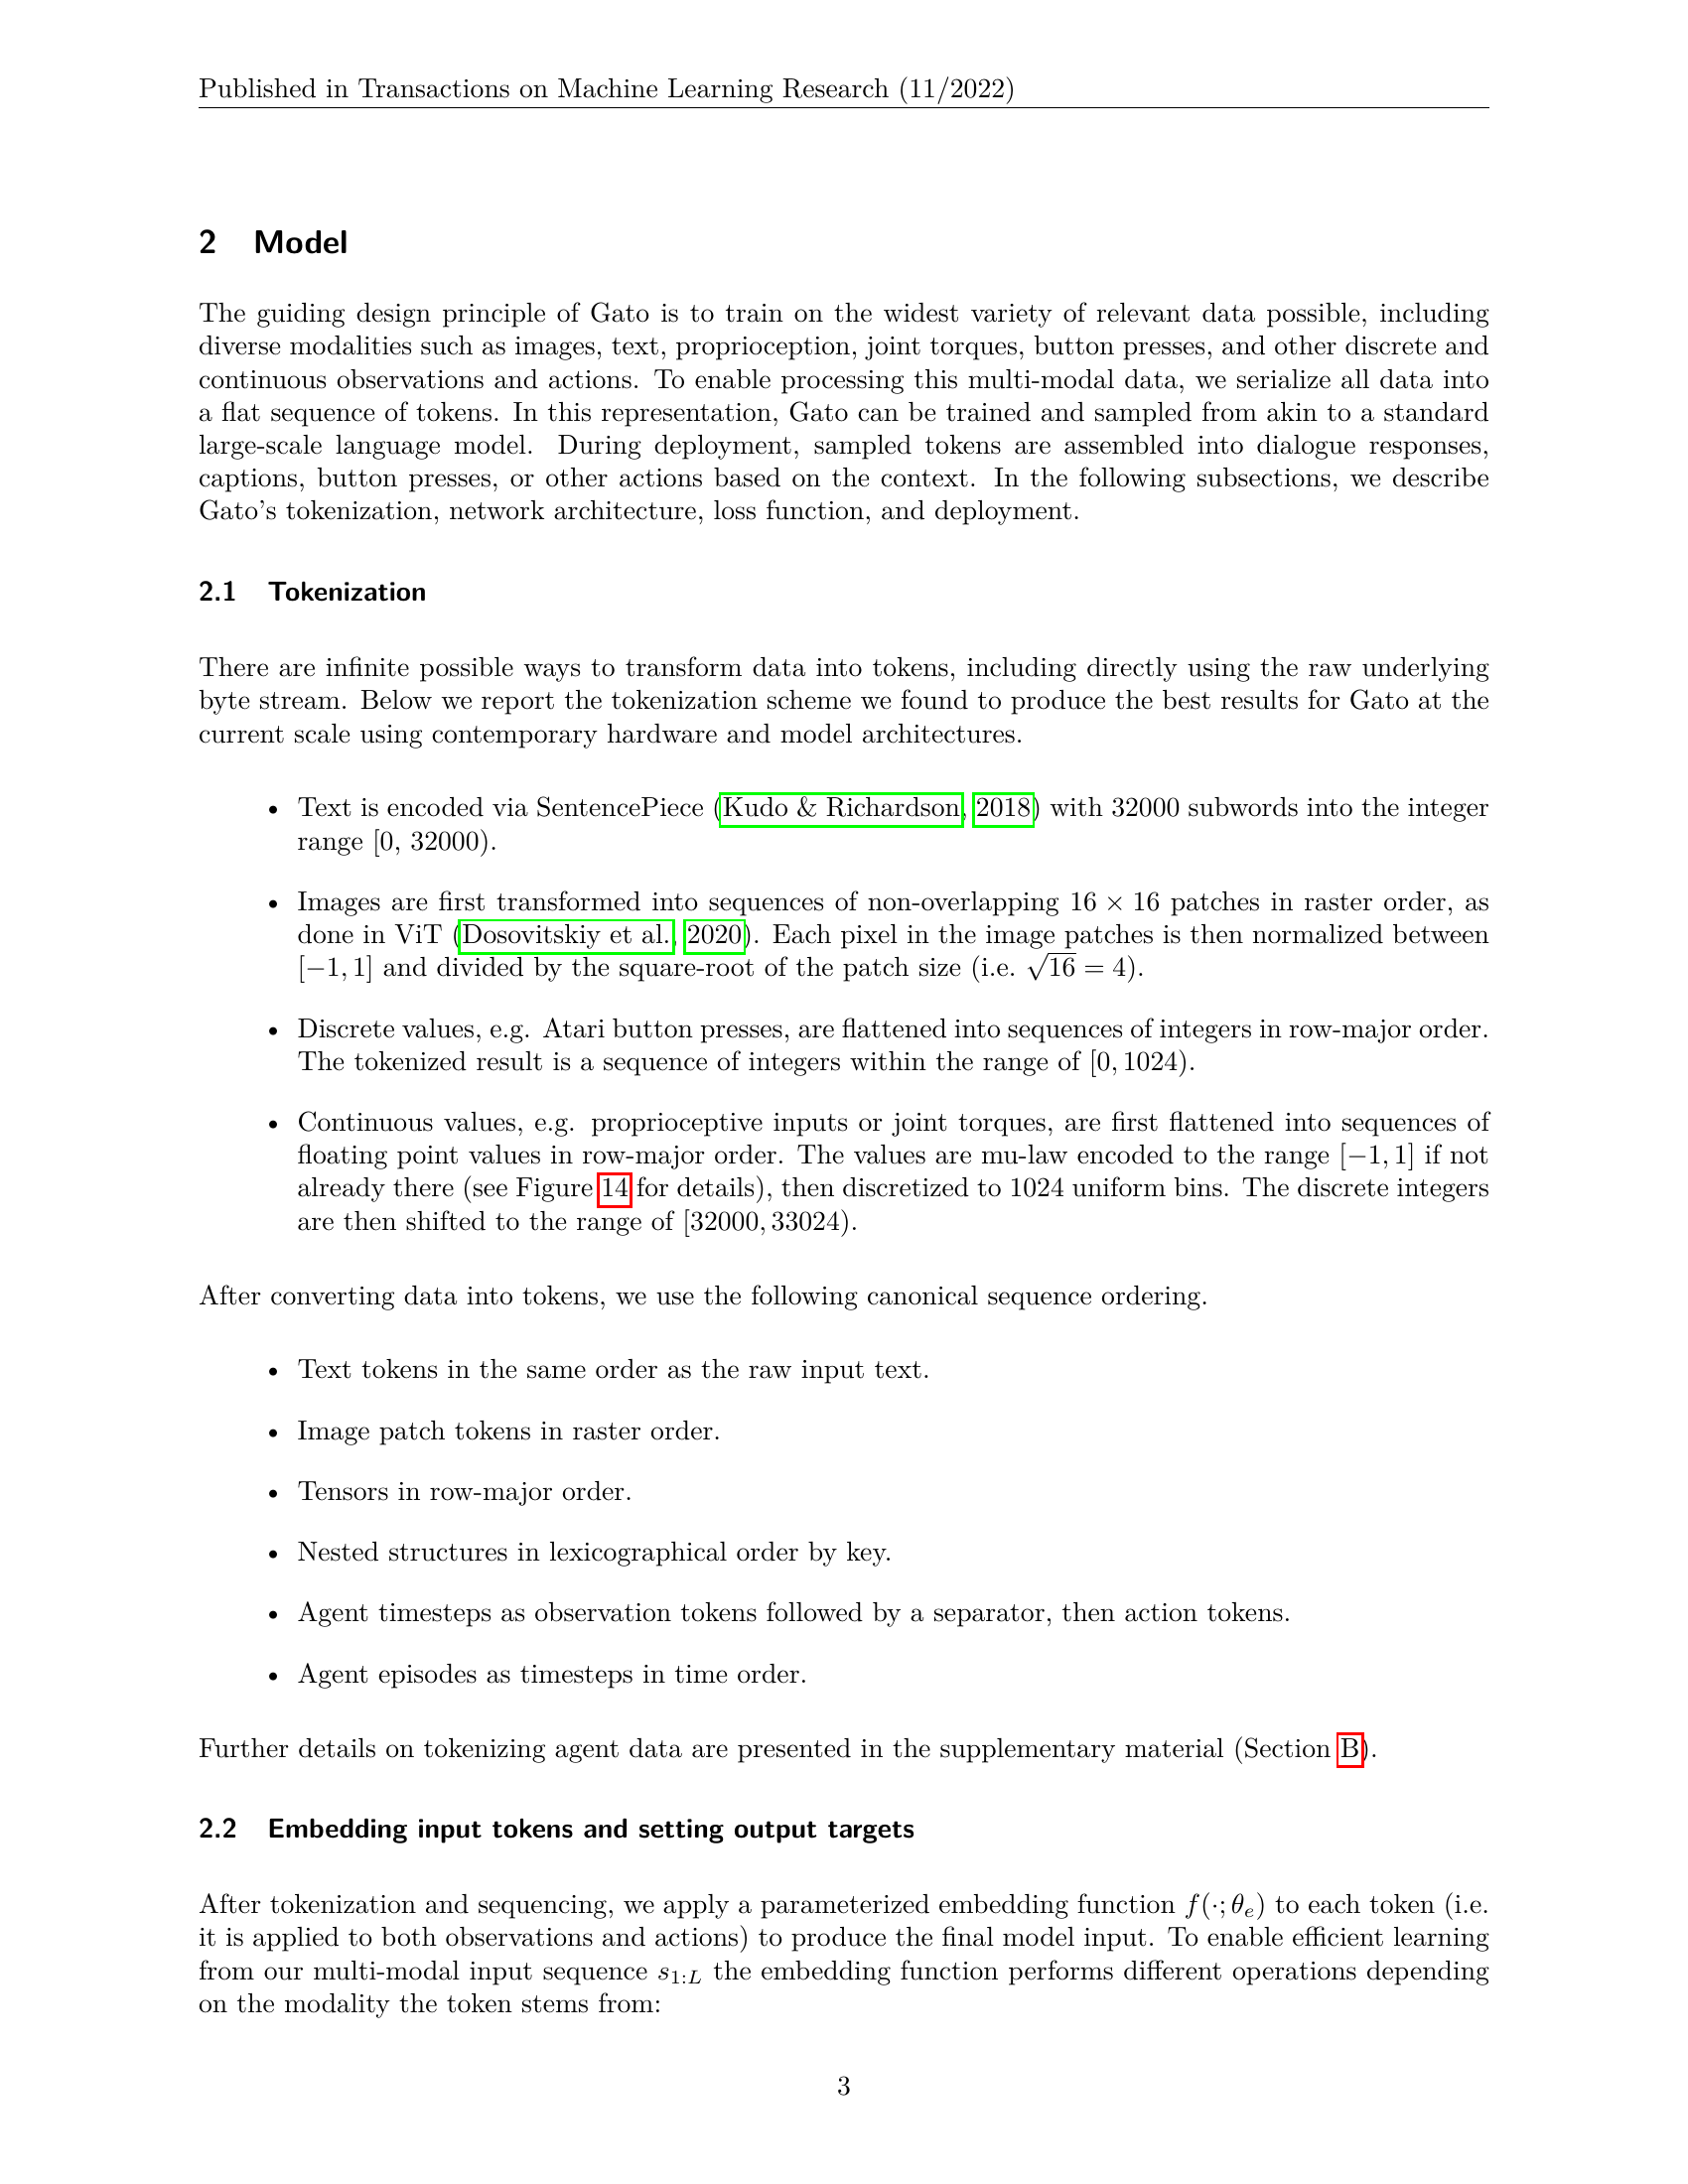
数据混合:Gato 在 604 种任务的数据上联合训练,涵盖以下域:
| 域 | 任务数 | 数据类型 |
|---|---|---|
| Atari 2600 | 54 | 游戏画面 + 按钮动作 |
| DM Control Suite Pixels | 20 | 机器人仿真 + 连续动作 |
| DM Homogeneous Rooms | 2 | 3D 导航 + 连续动作 |
| Meta-World | 145 | 机械臂操作 + 连续动作 |
| 视觉-语言任务 | - | 图像描述、VQA、对话等 |
| 文本任务 | - | 翻译、摘要、对话等 |
数据上采样:为了平衡不同数据集的贡献,作者对较大的和质量较高的数据集进行了手动上采样。具体来说,来自 MT-Open(Meta-World)和 DM Control 的数据被上采样 5 倍,来自 MassiveWeb 的文本数据被上采样 3 倍。
训练配置:
| 参数 | 值 |
|---|---|
| 硬件 | 16×16 TPU v3 |
| 训练步数 | 1,000,000 |
| Batch size | 512 |
| 序列长度 | 1024 tokens |
| 训练时间 | ~4 天 |
| 优化器 | Adam |
| 学习率 | 0.0001(warmup 10k 步) |
| dropout | 0.1 |
关键技巧——随机子序列采样:由于 agent episode 和文档通常远超 1024 tokens 的上下文窗口,训练时从每个 episode 中随机采样长度为 1024 的子序列。每个 batch 中的子序列大致均匀地混合来自不同域的数据。这种做法既保证了每个 batch 的多样性,又避免了截断造成的系统性偏差。
损失函数:标准的下一个 Token 预测交叉熵损失,但只对动作 Token 和文本 Token 计算损失——图像 Token、分隔符 Token 等观测 Token 不参与损失计算。这是通过 masking 实现的,与 BERT 的 masked language modeling 类似,但这里 mask 的是不需要预测的位置。
6. 推理/部署流程
Gato 作为控制策略部署时的流程如下:
- Prompt 初始化:将一段成功的示范 episode Token 化,作为初始序列
- 接收观测:环境产生第一个观测,Token 化后追加到序列中
- 自回归生成动作:模型逐 Token 自回归地生成动作向量,直到所有动作维度都生成完毕
- 执行动作:将生成的动作 Token 解码为连续/离散动作值,发送给环境
- 循环:环境产生新观测,回到步骤 2
关键细节:模型在上下文窗口内看到所有历史观测和动作(最多 1024 tokens)。作者发现使用 Transformer-XL 记忆(扩展上下文)在部署时有益,尽管训练时没有使用。
🧪 实验验证
主要结果概览
Gato 在 604 种任务上进行了评估。下图展示了各域中达到专家表现不同百分比的任务数量:
各域表现总结:
| 域 | 达到 50% 专家分数的任务数 | 达到 100% 专家分数的任务数 |
|---|---|---|
| Atari 2600 | 45/54 | 28/54 |
| DM Control Suite Pixels | 16/20 | 4/20 |
| Meta-World | 121/145 | 30/145 |
| MassiveWeb(文本) | - | 良好 |
| 图像描述 | - | 良好 |
| 对话 | - | 良好 |
与专用模型的对比
这是评估通用智能体价值的关键实验。Gato 将自己与各任务上最佳的专用模型进行了比较:
Atari 游戏:在 54 款 Atari 游戏中,Gato 在 45 款上达到了超过 50% 的专家分数。值得注意的是,Gato 的参数量(1.2B)远小于专用 DQN 或 R2D2 模型,却能在大多数游戏上取得有竞争力的表现。在某些游戏(如 Breakout、Pong)上,Gato 甚至超过了专用模型。
DM Control Suite:在 20 个连续控制任务中,Gato 在 16 个上超过 50% 专家分数。但与专门训练的 SAC 或 DreamerV3 相比,Gato 在大部分任务上仍有差距。这在意料之中——通用模型在单个任务上通常不如专用模型。
Meta-World 机械臂操作:在 145 个操作任务中,Gato 在 121 个上达到 50% 专家分数。这是一个令人印象深刻的结果,因为这些任务涉及不同的物体、不同的操作目标,且大多数任务的训练数据非常有限。
文本和视觉-语言任务:Gato 在图像描述(MS COCO)、对话( MASSIVE)和翻译等任务上都取得了合理的表现,虽然不及专门的大语言模型(如 GPT-3),但作为一个 1.2B 参数的多任务模型,表现已经相当不错。
Prompt 条件化的消融实验
作者进行了详细的消融实验,验证 prompt 条件化的效果:
- 无 prompt:模型仅依靠观测来推断任务,性能明显下降
- 随机 episode prompt:使用随机 episode 的片段作为 prompt,性能有所提升但不稳定
- 成功 episode prompt:使用成功 episode 的片段作为 prompt,性能最佳
- 末尾 vs 均匀采样:从 episode 末尾采样作为 prompt 通常优于均匀采样,因为末尾包含了"目标状态"的信息
Attention 可视化
作者对 Gato 的注意力权重进行了可视化分析。在 Atari Breakout 游戏中,注意力集中在球和挡板上;在 RGB Stacking 任务中,注意力跟踪着机械臂和目标物体。这表明 Gato 学会了根据任务自动关注相关区域,而不是均匀地处理所有视觉信息。
嵌入可视化
作者使用 t-SNE 对不同任务的嵌入向量进行了可视化。结果表明:
- 同一任务的嵌入紧密聚集
- 来自同一域(如 DM Control Suite)的不同任务嵌入彼此靠近
- 即使是留出任务(cartpole.swingup,训练时未见过),其嵌入也被正确地聚类到 DM Control Suite 域中
这说明 Gato 的嵌入空间具有良好的结构——它自动学习了任务之间的相似性和层次关系。
Scaling 分析
虽然 Gato 本身只训练了一个 1.2B 的模型,但作者指出 Gato 遵循 Transformer 的 scaling law——更大的模型、更多的数据通常会带来更好的性能。这为未来构建更大的通用智能体提供了理论基础。
🔍 个人思考
亮点
1. 统一表示的优雅性
Gato 最大的贡献在于证明了一个极其简洁的假设:所有模态的数据都可以被离散化为 Token,从而被同一个 Transformer 处理。这种统一性是深刻的——它意味着"智能"的不同方面(感知、推理、行动)可能共享相同的底层计算机制。mu-law 编码将连续动作离散化为 1024 个 bin 的方案尤其巧妙,既保证了精度,又使得动作可以像文本一样被自回归生成。
2. 工程上的大胆
在 604 种任务上联合训练一个 1.2B 的模型,这需要解决大量工程挑战:数据格式的统一、不同数据集的采样平衡、训练稳定性的维护。Gato 在 16×16 TPU v3 上仅用 4 天完成训练,展示了 DeepMind 强大的工程能力。
3. Prompt 条件化的实用性
使用成功 episode 作为 prompt 来区分同一域内的不同任务,这是一个非常实用的设计。它不需要任务 ID 的 one-hot 编码,也不需要自然语言指令,而是直接用"做给你看"的方式告诉模型要做什么。这种 few-shot 式的条件化与当前 LLM 的 prompt engineering 一脉相承。
4. 注意力和嵌入的可解释性
论文提供了注意力权重和嵌入空间的可视化,这在多任务学习论文中并不常见。注意力集中在任务相关物体上的发现,以及嵌入空间的有意义聚类,增强了我们对 Gato 内部机制的理解。
局限性
1. 性能天花板
Gato 在大多数控制任务上仍不如专用模型。1.2B 参数的模型要在 604 种任务之间分配容量,每个任务分到的"专业知识"必然有限。这引发了一个根本性问题:通用性和专业性之间是否存在不可调和的矛盾?
2. 模态 Token 化的粗糙性
mu-law 编码将连续动作离散化为 1024 个 bin,这在精度上可能存在瓶颈。对于需要精细力控制的机器人任务,1024 个 bin 可能不够。相比之下,连续输出的策略网络(如 SAC 的高斯策略)可以输出任意精度的动作值。
3. 上下文窗口的限制
1024 tokens 的上下文窗口对于长序列任务(如长时域机器人操作)来说非常有限。虽然部署时可以使用 Transformer-XL 记忆来扩展,但训练时的限制仍然约束了模型处理长序列的能力。
4. 缺乏在线学习能力
Gato 是一个纯监督学习模型,不具备在线试错和自我改进的能力。它只能模仿训练数据中的行为,无法通过与环境交互来探索新策略。这与真正的强化学习智能体有本质区别。
5. 代码未开源
Gato 的代码没有开源,这严重影响了学术界对其方法的验证和复现。考虑到 DeepMind 的特殊地位,这或许可以理解,但也使得 Gato 的影响力受到了一定限制。
未来方向
1. 更大的模型 + 更多的任务
Gato 已经证明了 1.2B 参数的 Transformer 可以在 604 种任务上工作。自然的下一步是:如果把模型扩大到 10B、100B,任务数扩大到 10000+,会发生什么?scaling law 暗示性能会持续提升。
2. 与 VLA 的融合
Gato(2022)和 RT-2(2023)代表了两条互补的技术路线:Gato 从"控制"出发,加入语言和视觉;RT-2 从"语言视觉"出发,加入动作。未来的通用智能体很可能融合两者的优势——既有 Gato 的多任务统一性,又有 RT-2 的大规模预训练知识。
3. 在线学习与自我改进
当前的 Gato 是一个"冻结"的模型,无法在部署后继续学习。将在线强化学习或自我对弈机制引入通用智能体框架,是一个激动人心的方向。
4. 具身智能的统一范式
Gato 展示的"多模态统一 Token 化"思想,正在成为具身智能领域的主流范式。从 RT-2 到 Octo,从 PaLM-E 到 π₀,越来越多的工作采用"将所有输入输出统一为 Token"的策略。Gato 是这条路线的先驱之一。
📖 延伸阅读
- Decision Transformer(Chen et al., 2021):将强化学习转化为序列建模的开创性工作,Gato 的直接前身
- RT-1 / RT-2(Brohan et al., 2022/2023):Google DeepMind 的机器人 Transformer 系列,VLA 范式的代表
- PaLM-E(Driess et al., 2023):将视觉多模态嵌入语言模型的具身 AI 工作
- Octo(Team et al., 2024):开源的通用机器人策略,延续了 Gato 的多任务统一思想
- GPT-4 / Gemini:展示了更大规模的多模态 Transformer 的涌现能力
- Flamingo(Alayrac et al., 2022):DeepMind 的视觉语言模型,与 Gato 共享部分设计理念
编者按:Gato 发表于 2022 年 5 月,距今已四年有余。回头看,它的历史地位或许不在于性能上超越了哪些专用模型,而在于它率先证明了一个关键假设:用一个统一的 Transformer 网络处理多模态、多任务的输入输出是可行的。这一思想深刻影响了后续的 VLA、多模态具身智能等工作,成为通向通用智能体的重要里程碑。如果说 GPT-3 证明了"语言可以统一一切文本任务",那么 Gato 则在探索"Token 可以统一一切模态和任务"的可能性——虽然它只是迈出了一小步,但方向是正确的。