📄 论文信息
- 标题:GigaWorld-0: World Models as Data Engine to Empower Embodied AI
- 团队:GigaAI(GigaWorld Team,字母序署名,含 Zheng Zhu 等)
- 发表:arXiv 2511.19861,v1 2025-11-25,v2 2025-11-30(本文按 v2 拆解)
- 资源:项目页
giga-world-0.github.io,代码open-gigaai/giga-world-0,训练框架open-gigaai/giga-train,下游策略 GigaBrain-0(arXiv 2510.19430) - 关键词:世界模型、视频生成、Flow Matching、MoE、3D Gaussian Splatting、可微物理、VLA 数据合成
- 一句话总结:世界模型不拿来当「仿真器」也不拿来当「策略」,而是当「数据工厂」——Video 线产「看起来真」的观测,3D 线产「动起来真」的场景与动作,合流出的 (视频, 动作) 对只用合成数据就能把 VLA 训到真机可用。
🎯 它到底在做什么:先把「数据引擎」这个定位说清楚
先把三条路线摆在一起,GigaWorld-0 的站位一眼可见:
| 路线 | 世界模型扮演的角色 | 代表工作 | 短板 |
|---|---|---|---|
| 世界模型当仿真器 | 闭环交互环境,进去做 RL / 评测 | UniSim、GAIA 系 | 单步误差累积,长程失真 |
| 世界模型当策略 | 直接看视频学动作 | VideoAgent 类、Dynalang | 动作空间受限、精度不够 |
| 世界模型当数据引擎(本文) | 离线批量产 (观测, 动作) 训练对 | GigaWorld-0、Cosmos 系 | 不参与推理闭环,只管喂饱 VLA |
数据引擎路线的诱惑在于:它绕开了「模型要在环」的误差累积问题——不要求世界模型单步 100% 准,只要求「批量生成的这批数据,让策略学到真实分布」。最终裁判不是 FID/CLIP 分数,而是真机成功率。
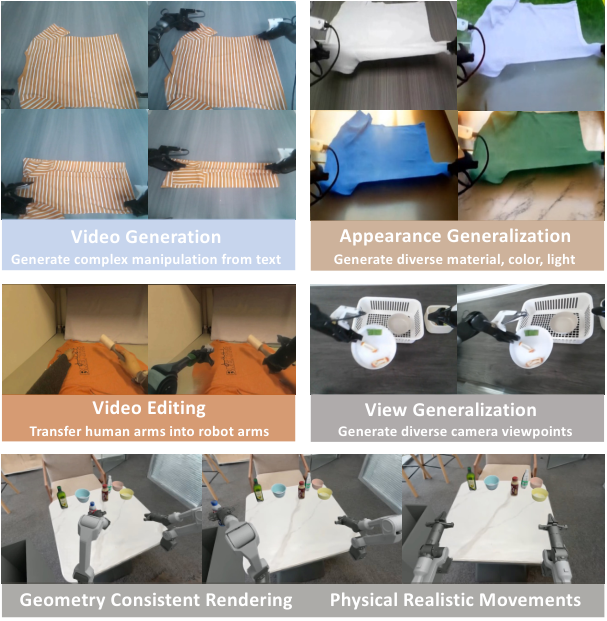
逐格讲 Fig.1(论文第 1 图,六格能力面板):
- Video Generation:给文本(“把条纹衣服叠成方块”),从同一初始状态生成后续操作视频——生成的多样性由指令控制,不靠换随机种子硬抽。
- Appearance Generalization:同一块布,换材质(条纹/毛绒/皮革)、换颜色(白/蓝/绿)——这就是在扩 VLA 最容易缺的外观分布。
- Video Editing:把第一视角里人手臂的画面编辑成机械臂——人手示教数据的跨本体翻译入口(MimicTransfer)。
- View Generalization:同一操作从天花板视角/侧视角分别生成——视角迁移(ViewTransfer),免二次采集。
- Geometry Consistent Rendering:多机位渲染下物体、桌面、机械臂的空间关系稳定——3D 线的几何承诺。
- Physical Realistic Movements:倒饮料时杯口与瓶口的接触关系符合物理——3D 线的物理承诺。
一张图概括本文主张:「纹理丰富 × 几何一致 × 物理可信 × 指令对齐」四件事同时满足的合成数据,才配进 VLA 的训练集。
🗺️ 模型族谱:8 个成员,一张表认全(论文 Table 1)
GigaWorld-0 不是单模型,是一套「1 + 3 + 4」的家族(1 个视频基座 + 3 个视频后训练 + 4 个 3D 模块):
| 模型名 | 功能 | 归属 |
|---|---|---|
| GigaWorld-0-Video-Dreamer | 图文到视频(IT2V)基座模型,MoE 架构 | Video 线 |
| GigaWorld-0-Video-AppearanceTransfer | 文本改外观:材质、光照、纹理 | Video 线后训练 |
| GigaWorld-0-Video-ViewTransfer | 从指定相机外位姿渲染视频(同步变换动作) | Video 线后训练 |
| GigaWorld-0-Video-MimicTransfer | 第一人称人手示教 -> 机械臂可执行轨迹/视频 | Video 线后训练 |
| GigaWorld-0-3D-FG | 生成前景可操作物体的 3D 资产 | 3D 线 |
| GigaWorld-0-3D-BG | 用 3DGS 重建背景环境 | 3D 线 |
| GigaWorld-0-3D-Phys | 建模物体物理 + 可微系统辨识 | 3D 线 |
| GigaWorld-0-3D-Act | 合成可执行、物理一致的臂运动 | 3D 线 |
命名规则值得记:前缀 = 所在线(Video / 3D),后缀 = 干的事。三个 Video 后训练模型全部共享 Dreamer 基座——这是典型的「基座 + 轻量适配头」范式,和 LLM 的 LoRA/Adapter、VLA 的动作头是同一手筋。
🏗️ 总架构:先看自绘全景图
三个读图要点:
- 双线并行、职责互补:Video 线负责「像素层真实」(外观、视角、跨本体),3D 线负责「结构层真实」(几何、物理、可执行动作)。单用 Video 线,动作是 IDM 从视频里「读」出来的(间接);单用 3D 线,外观多样性受限于 3D 资产制作成本——两条线在结尾汇流,甚至用 AppearanceTransfer 给 3D 渲染结果改外观(3D 的几何 × Video 的外观)。
- GigaTrain 是横向底座:视频基座的训练成本靠 FP8 + 稀疏注意力压下来,它是「能不能训得起」的工程前提,不参与推理。
- 闭环终点是 GigaBrain-0:整条流水线的唯一 KPI 是——VLA 只吃合成数据,真机能不能干活。
🎬 Video 线之一:Dreamer 基座——2B 激活参数打赢 14B 的配方
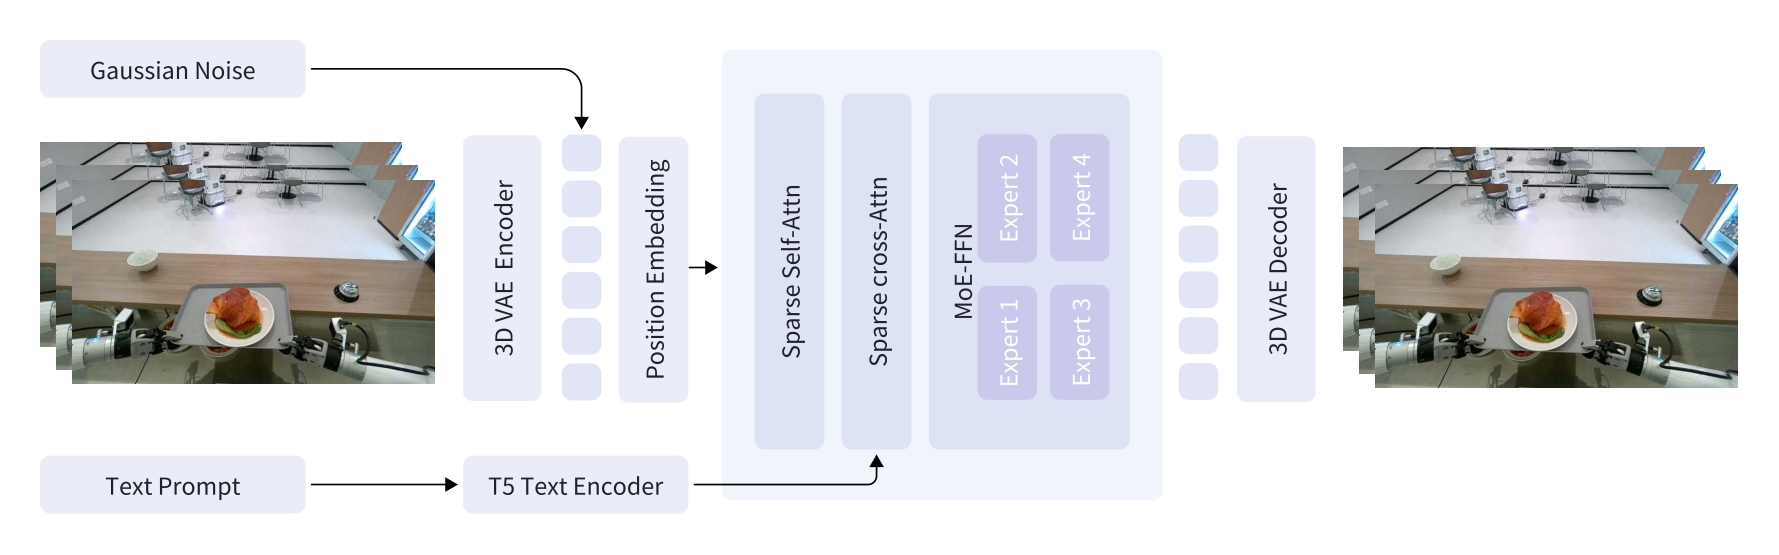
逐块讲 Fig.2:左边输入视频过 3D-VAE Encoder 变成 latent(图中紫色小块),与 Gaussian Noise 汇合——这正是 Flow Matching 的训练/推理起点;Position Embedding(3D-RoPE) 给 token 上时空坐标;中间三段是 DiT 主干:Sparse Self-Attn(自身时空调制)-> Sparse cross-Attn(接收下方 T5 Text Encoder 的文本条件)-> MoE-FFN(图里画了 Expert 1~4,每 token 只激活 2 个);最后 3D-VAE Decoder 把 latent 解回像素视频。右侧是 61 帧 480×768 的生成结果。
生成范式:Flow Matching(论文式 1)
论文用 Flow Matching 而非 DDPM/DDIM 形式:
d z_t / dt = v_theta(z_t, t, c)
z_t:t 时刻的 latent;c:条件 = {文本 embedding, 首帧图像};v_theta:模型输出的速度场。- 训练时按概率路径在「干净 latent」和「噪声」之间取直线插值采出
z_t,让网络回归真实速度;推理时从纯高斯噪声出发,沿 ODE 积分到 t=0 得到干净 latent。 - 和扩散的差别只在概率路径与参数化目标(预测速度 vs 预测噪声);对读者而言记住「连续流、少步数友好」即可——步数蒸馏(几十步 -> 1 步)在 Flow Matching 上天然顺,这也是后文 50× 加速的基础之一。
输入表示:3D-VAE + patchify + 3D-RoPE(三个压缩动作要分清)
| 动作 | 参数 | 效果 |
|---|---|---|
| 3D-VAE 压缩 | 时 4 × 高 8 × 宽 8,16 通道 latent | 61 帧 × 480 × 768 的视频 -> 时序约 15 层、空间 60×96 的 latent 网格 |
| patchify | 1 × 2 × 2(时×高×宽) | latent 再切块成 DiT 的 token,token 数再除 4 |
| 位置编码 | 3D-RoPE | 时、高、宽三个轴独立旋转位置编码,保证换分辨率/帧长可外推 |
这三层压缩是「480×768×61 帧能进 8 卡 H20」的直接原因。分辨率选择也不是拍脑袋:主流 VLA(π0、RDT 系)观测就是 480p,数据引擎对齐下游传感器规格,比刷 720p 的生成指标更有用。
主干:稀疏注意力 DiT + MoE-FFN(论文式 2-8 全拆)
稀疏注意力:自注意力用 NATTEN(邻域注意力,CVPR 2023),token 只看时空邻域窗口而非全图——视频 token 数是图像的几十倍,全图注意力在 61 帧上不可行。论文实测 NATTEN 比 SageAttention 更快,但必须微调适配,直接换会掉点(这是给想复现的人的坑)。
MoE-FFN 是本文最值得抄的细节(式 2-4):
h'_t = u_t + sum_{i=1..Nr} g_{i,t} * FFN_i(u_t)      # 式2: 只有被路由到的专家贡献

g'_{i,t} = s_{i,t}  if s_{i,t} in Topk({s_j,t}, Kr)   # 式3: Top-K 门控
           0       otherwise

s_{i,t} = softmax(u_t^T e_i)                          # 式4: token 与专家向量点积打分
配置与 DeepSeek-V2 的三点差异(论文明确强调):
- Nr = 4 路由专家,每 token 激活 Kr = 2——激活比 50%,参数翻倍算力只加一半。
- 不设共享专家(DeepSeek-V2 有一个 always-on 的 shared expert):视频的语义区域(桌面背景 / 机械臂 / 被操作物)分工更「块状」,让专家按区域专精,共享专家反而稀释专精度。
- 负载均衡用 DeepSeek-V3 的互补损失(式 5-8):
L_Load = α Σ f_i P_i,α = 0.01。其中f_i是专家 i 在该序列上进 Top-K 的频次占比,P_i是归一化门控权重的均值占比——一个管「选没选上」、一个管「选上了权重多大」,两项相乘惩罚「既常被选、权重又高」的垄断专家。作用域是单条视频序列内的均衡(不是全局 batch),因为一条 61 帧视频里如果某专家垄断全部 token,时序建模会退化。
这套设计的实际效果:激活参数只有 2B,在 PBench 上干掉 14B 的 Cosmos-Predict2 和 Wan2.2(后面实验节看数)。
条件注入:T5 文本 + 首帧图像
文本走 T5 编码器出 embedding,经稀疏交叉注意力注入(不是拼进 token 序列);首帧图像作为图像条件(IT2V 的 “I”)——「同一初始帧 + 不同指令 -> 不同未来」的可控性就来自这里,Fig.12 会展示。
🎬 Video 线之二:控制分支——为什么偏偏不用 ControlNet
三个后训练模型共用同一套控制机制,论文 Fig.4 给了图:
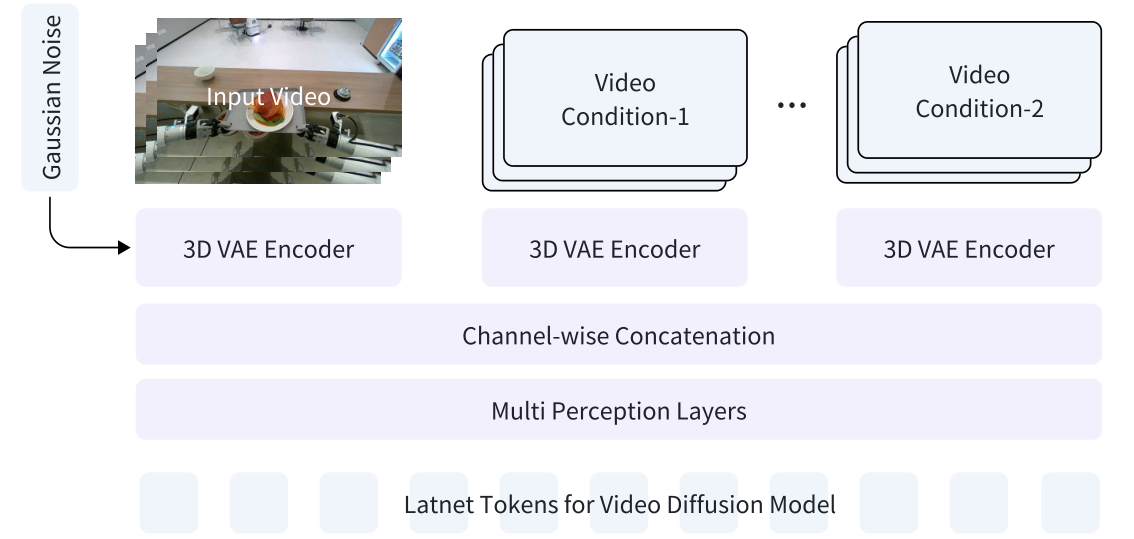
逐块讲 Fig.4:最上排是三路输入——左侧 Gaussian Noise + Input Video(主扩散路径),右侧 Video Condition-1 … Video Condition-2(控制条件,可多路);三路都过同一个 3D-VAE Encoder 变 latent;然后 Channel-wise Concatenation 在通道维拼起来;过 Multi Perception Layers(本质是通道压缩 MLP,把拼宽的通道压回 DiT 期望的输入宽度);最下面一排浅色块 = 送进 DiT 的 latent tokens。
为什么不用 ControlNet?(论文原话逻辑,很适合面试讲):
- ControlNet 的标准做法是复制一份骨干网络做控制编码器。但 Dreamer 基座的 FFN 是 MoE——复制一层 FFN = 复制 4 个专家,参数量成倍膨胀,训练/显存成本直接爆炸。
- 替代方案:控制条件过 3D-VAE 得到 latent,与噪声 latent 沿 channel 拼接,再用一小段 MLP(Multi Perception Layers)压回原通道数——参数量 O(通道数²) 的小 MLP,而不是 O(模型参数) 的骨干副本。
- 代价:控制信号与噪声在通道维混合,信息要靠 MLP 自己学会解缠——对「深度/法线/掩码」这类低维几何先验完全够用。
三个后训练模型的条件组合(下文逐个展开):AppearanceTransfer 用 depth + normal,ViewTransfer 用 重投影背景 + 仿真渲染臂,MimicTransfer 用 掩码背景 + 仿真臂——全是「几何/结构」类条件,正好是通道拼接擅长、外观生成模型不自带的信息。
AppearanceTransfer:文本改外观,专治「数据长得都一样」
真实采的 VLA 数据纹理、光照、配色高度单一——策略一换桌面材质就懵;传统仿真管线可以随便换材质,但渲染感太重(sim2real 差距),真机成功率上不去。AppearanceTransfer 的定位就是夹在中间:
- 条件:深度(VideoDepthAnything)+ 法线(LOTUS)提供几何骨架,几何与运动被条件锁死;文本 prompt 独立控前景/背景的材质、颜色、光照。
- 两条业务线(论文反复强调):real2real(真实视频 -> 同场景不同外观的变体)和 sim2real(仿真轨迹 -> 照片级渲染),后者直接对症 sim2real gap。
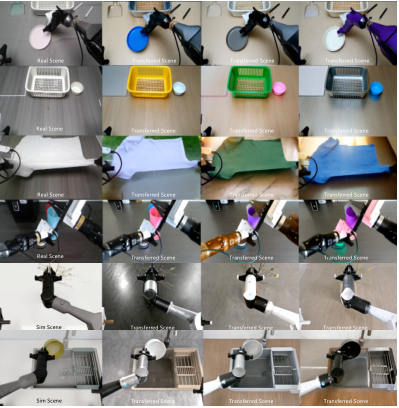
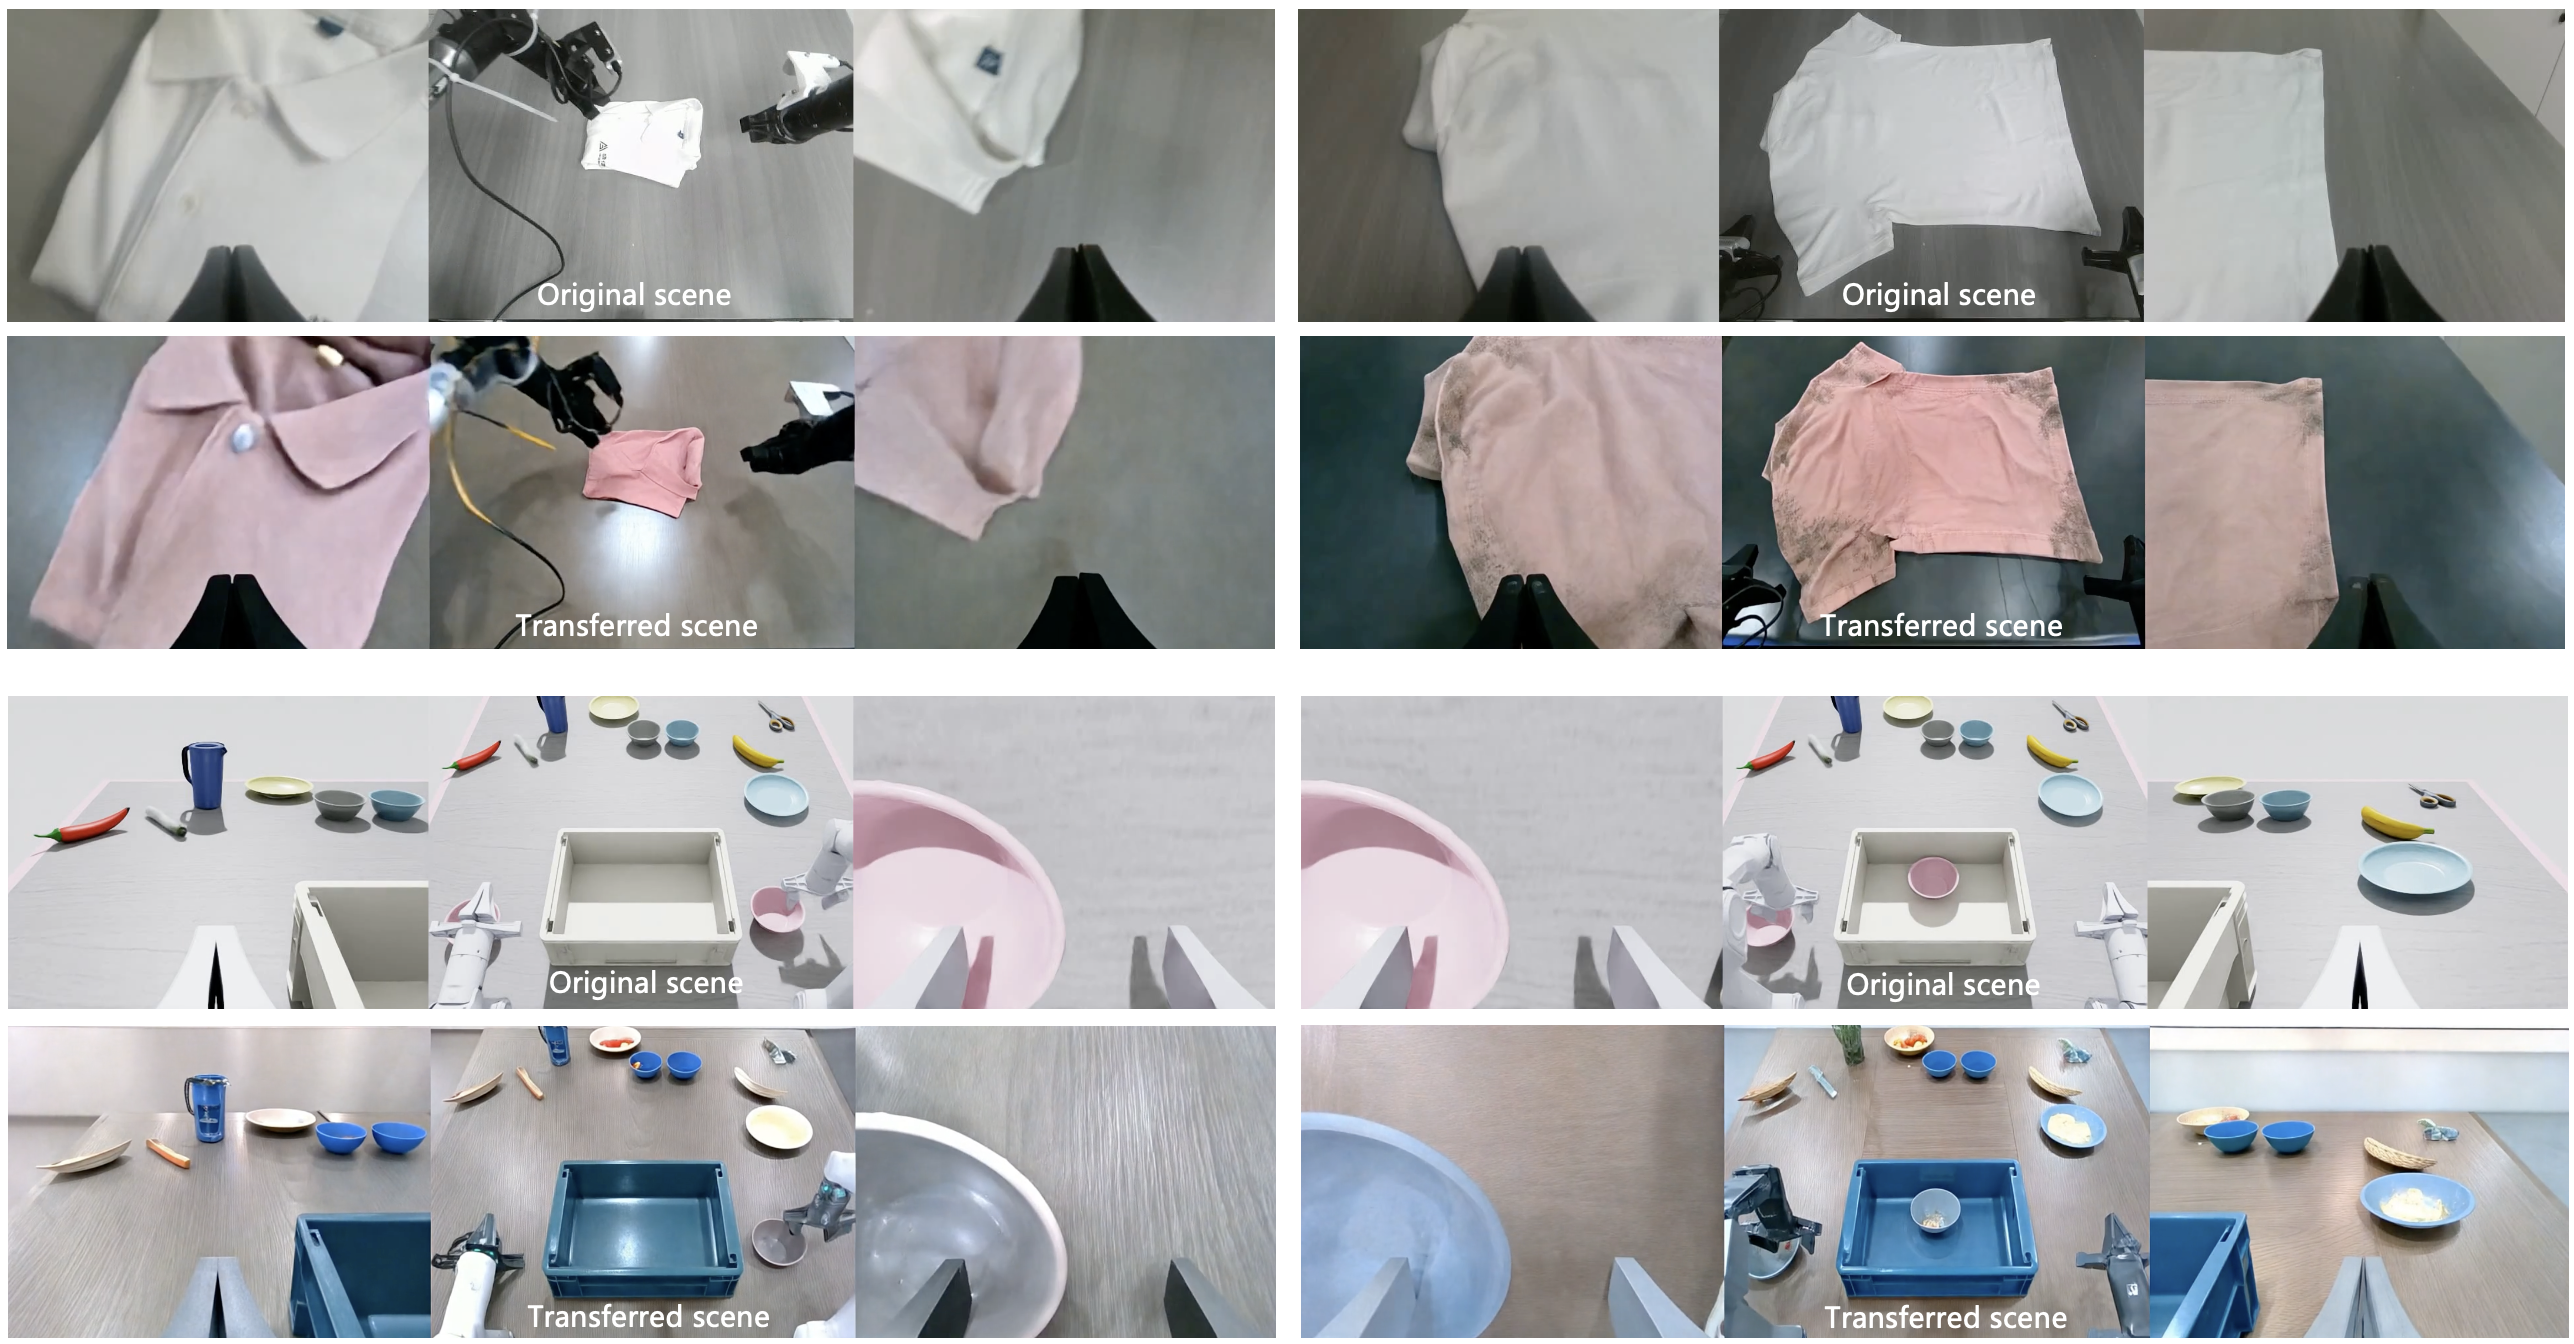
Fig.14 讲解:左列是原始视频,右列是文本改写后的结果——同一块布换颜色、同一张桌子换材质,机械臂的位姿序列与布料的形变过程完全不变(因为变的只是像素外观条件,动力学信息在原视频里)。数据引擎视角:一条真实轨迹 × N 条外观指令 = N 条外观增广样本,边际成本接近零。
ViewTransfer:单条视频变多机位,还顺手变换了动作
视角泛化的朴素解法是多机位重采——贵且要重新标注。ViewTransfer 做到「一条第一视角视频 -> 任意新视角 + 新视角下的动作」,核心是任务语义不变的坐标变换(论文式 10-11):
已知:机械臂在世界系 W_A 的视频 V_A,末端相对基座位姿 T_t^{ee->base}
目标:基座搬到 W_B(T^{base->W_B} != I),但末端的世界系绝对位姿不变(任务语义不变)

约束:T_t^{ee->W} = T^{base->W_A} * T_t^{ee->base} = T^{base->W_B} * K_t

解出:K_t = (T^{base->W_B})^{-1} * T^{base->W_A} * T_t^{ee->base}    # 式11
用人话讲:夹爪在世界上干的活不变,变的只是「相对新基座怎么描述这个动作」——K_t 就是新视角数据配套的动作标签。没有这一步,换视角得到的视频配旧动作标签,VLA 会被动作-观测错位直接毒死。
训练对怎么造(论文 Fig.5,自监督):真实成对多视角视频 (V_A, V_B) 不存在,论文用双重重投影:
- 条件 1(背景几何):MoGe 估 V_A 的尺度深度 -> warp 到目标视角 W_B -> 再重投影回 W_A(一来一回,把新视角几何信息「折叠」进原视角坐标系),warp 时把机械臂掩掉(SAM 分割),只留背景——否则运动的臂会把重投影变成一团糊。重投影结果当输入,原视频 V_A 当 GT。
- 条件 2(臂运动):式 11 解出的
K_t在**物理仿真器(MuJoCo)**里渲染成臂专属视频——给模型明确的「新位姿下臂长什么样」。 - 模型学「给定新视角背景几何 + 新位姿臂 -> 还原出连贯真实视频」。
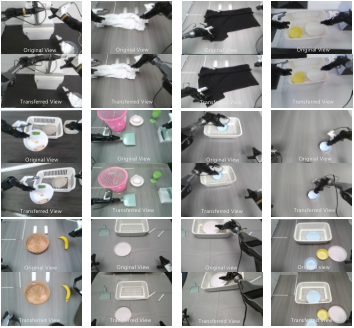
Fig.15 讲解:同一桌面操作场景,条件给到不同机位,生成的视频里桌面透视、遮挡关系、臂的可视角度同步变化,且每个新视角都配有对应的 K 动作序列。对 VLA 的价值:第一视角数据一条变多条,部署时相机高度/角度变了也不至于失效。
MimicTransfer:人手示教视频 -> 机械臂视频(跨本体)
遥操作采数据贵,人手第一视角示教视频几乎免费(手机/眼镜拍就行),但存在致命 gap:画面里是人手,策略要学的是机械臂——外观与自由度都对不上。
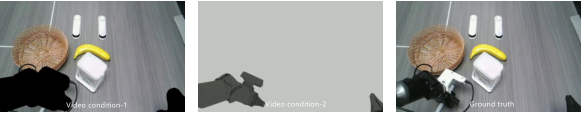
Fig.6 讲解 + 训练技巧(论文最聪明的一段数据工程):难点是不存在「人手做同一动作、机械臂做同一动作」的配对视频——没法直接监督「人手帧 -> 机械臂帧」的翻译。论文绕开的办法:
- 只用机械臂视频构造训练对:条件 1 = 把臂掩掉的背景(场景上下文);条件 2 = 用原臂轨迹驱动仿真器渲染的「像人手一样动」的臂视频;监督 = 原始臂视频。
- 也就是说,模型学的是「结构条件 -> 还原真实臂视频」这个映射,把「人手 vs 臂」的外观差分摊到推理期的条件构造里。
- 推理期(正式当数据引擎时):人手示教视频 -> 标注人手末端位姿 -> 逆运动学 IK 解出机械臂关节角 -> 仿真器渲染条件 2;人手掩掉当条件 1 -> 模型吐出机械臂做同样动作的真实感视频。
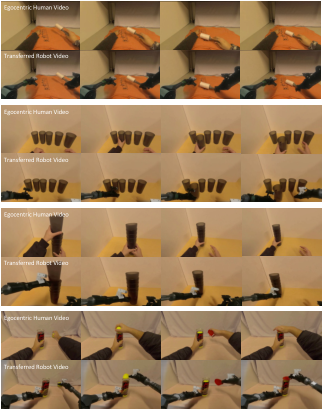
Fig.16 讲解:上排人手叠衣服/整理衣物的第一视角画面,下排是机械臂在同场景做同样动作的生成结果——手的位置与夹爪位置空间对齐、动作相位一致。这等于把互联网级的人手操作视频批量转译成机器人监督信号,是三条后训练线里数据杠杆最大的一条。
🎬 Video 线之三:多视角、加速与质检(工程三件套)
多视角:沿宽度拼全景(Fig.7 / Fig.13)
做法:把多相机图像沿宽度维度拼成一张全景图喂给模型——不改架构,完全复用扩散模型的 in-context 学习能力,小规模微调多视角数据后,模型自己学会「同一场景的多个视角拼在一张图里,生成时要互相一致」。
为什么这样做(对比视角):另一条路是给每个视角单独建分支/交叉视角注意力模块——架构复杂、参数翻倍、还得处理视角间的对应关系。拼图方案的赌注是:Transformer 的 in-context 能力足以把「图内的不同区域」理解成「不同相机」。Fig.13 的结果支持这个赌注:跨视角几何与动作一致。
论文还给了个很实的观察:夹爪状态估计的 IDM 关键依赖多视角输入——单视角下夹爪开合经常被遮挡,多视角生成能力因此不是锦上添花,而是 IDM 数据可用性的前提。
加速:步数蒸馏 + FP8 = 50×
- 去噪步蒸馏:把几十步采样压到 1 步(蒸馏类方法,论文引 Yin et al. 2024)。
- FP8 推理:配合训练侧的 FP8,端到端比标准扩散模型快 50 倍以上。
- 数据引擎场景下这个数字的含义:生成一条 61 帧视频从「分钟级」到「秒级」,百万条级合成才在算力上成立。
质检:合成数据的「出厂检」(数据引擎最容易被忽略的环节)
生成模型会幻觉——一只穿模的手、漂浮的杯子,进训练集就是毒数据。GigaWorld-0-Video 给每条视频算四维综合分:
| 质检维度 | 检什么 | 用在哪 |
|---|---|---|
| 几何一致(geometric consistency) | 物体是否穿模、透视是否崩 | 硬门槛 |
| 多视角一致(multi-view coherence) | 同时刻跨相机画面是否同一世界 | 多视角数据专用 |
| 文本对齐(text-to-video alignment) | 生成的是否真是指令说的操作 | 指令条件数据必备 |
| 物理合理(physical plausibility) | 接触、重力、形变是否违反常识 | 抓取/软体任务必备 |
综合分决定数据去向:预训练(放宽)/ 微调(收紧)/ 直接丢弃。这套「数据分级」思路和 LLM 预训练的数据配比是同一套方法论——数据引擎的产出率不是 100%,敢丢数据的引擎才可信。
📌 Video 线小结(一张图串起来)
Dreamer 基座(IT2V, Flow Matching + 稀疏注意力 MoE DiT, 2B 激活)
    |
    |  冻结基座 + 轻量控制分支(通道拼接 + 压缩 MLP,拒绝 ControlNet)
    |
    +-- AppearanceTransfer   条件: depth + normal + 文本   -> 外观增广(real2real / sim2real)
    +-- ViewTransfer         条件: 双重重投影背景 + 仿真臂  -> 视角增广(式10-11 变换动作)
    +-- MimicTransfer        条件: 掩码背景 + 仿真臂        -> 跨本体(人手示教 -> 臂视频)
    |
    工程: 多视角全景拼接 | 1 步蒸馏 + FP8 = 50x | 四维质检分级
    |
    产出: 纹理丰富、时序连贯、可控的具身交互视频(配 IDM 动作标签)
🔁 关键闭环:GigaWorld-0-IDM——视频怎么变成动作标签
前面所有视频生成能力,只有配上动作才叫 (观测, 动作) 监督对。论文的答案是一个掩码训练的逆动力学模型(IDM):给生成视频,回推出机械臂关节角。
形式化(论文式 9):给定生成视频序列 V = {v_1, ..., v_T},IDM 估计关节角轨迹
theta_1:T = f_IDM(V)

其中 theta_t = [theta_t^(1), ..., theta_t^(D)]^T 属于 R^D
D = 机械臂关节旋转角维度
与先前 IDM 的差异:掩码训练。先用 SAM 把机械臂从画面里分割出来,只把臂区域喂给 IDM——背景里的桌布、杯子、光影变化全是回归噪声,屏蔽后 IDM 只需专注「臂的像素运动 -> 关节角」这一条映射。论文强调这显著提升了真实世界视觉歧义下的鲁棒性。
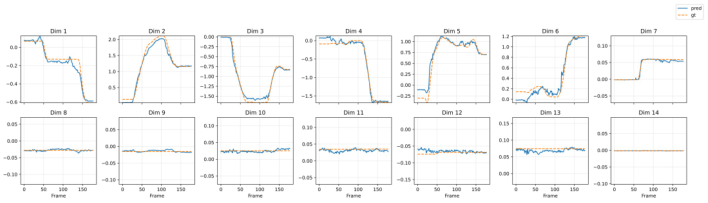
Fig.3 讲解:多行小图 = 12 个关节 + 2 个夹爪自由度,每行是时间轴上「预测轨迹 vs 真值轨迹」的叠加曲线——所有关节的预测线与真值线几乎重合,说明仅凭视觉就能恢复物理上合理的操作策略。评测用的是未见任务的采集数据,验证的不是死记硬背而是泛化的「读动作」能力。
为什么这条闭环成立,三个关键点:
- 多样性来自指令:同一初始帧换文本 = 换任务,Dreamer 采样一次 = 一条新轨迹,数据分布由自然语言任意扩展——这是「生成式数据引擎」相对「真实采集」的本质优势。
- 动作天然对齐:动作是从视频里「读」出来的,(V, theta) 在时间轴上天然对齐,不存在「策略输出与录像不同步」的标定问题。
- IDM 是质量闸门:IDM 精度 = 数据精度上限。论文用未见任务验证对齐,但没有给出「用生成数据训练 VLA 的成功率消融」——这块量化被移到了 GigaBrain-0 论文里(读本文时要留意的边界)。
最终产出 (V, theta_1:T):多样、时序对齐、无需真实机器人交互的监督信号——VLA 训练数据的「合成配方」到此完整。
🧊 3D 线:几何一致 + 物理真实的四个模块
Video 线管「看起来真」,但碰撞、接触、重力、可执行性这些光看像素看不出来。GigaWorld-0-3D 以 3D Gaussian Splatting(3DGS)为核心场景表示,用四模块流水线造「既好看又能进仿真器」的场景。
3D-FG 前景资产:两道质检卡住生成模型(论文 Fig.8)
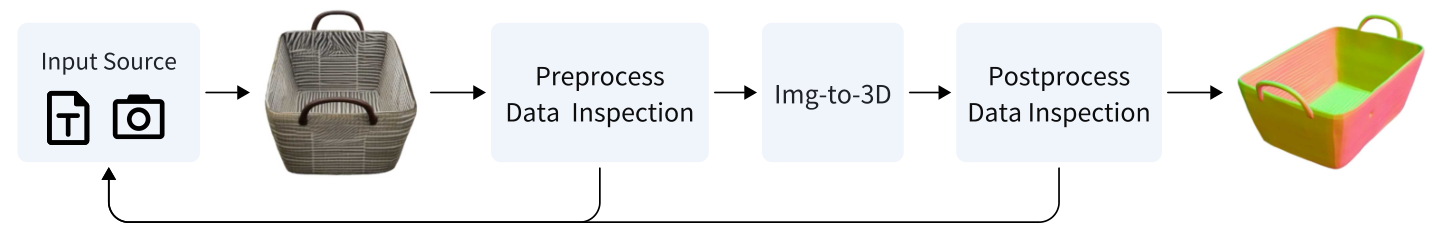
Fig.8 逐格讲:Input Source(文生图 T / 照片相机图标)-> 样例物体(编织篮)-> Preprocess Data Inspection -> Img-to-3D -> Postprocess Data Inspection -> 输出的带物理材质的 3D 资产;下方红色虚线表示任一质检不过关就回炉——这是整条 3D 线的方法论核心:生成模型的输出必须被管线管住。
具体三道闸:
- Preprocess 质检(生成前):
Aesthetic-Checker:美学评分与纹理丰富度正相关——先把「画面本身难看」的输入筛掉;ImageSegChecker(GPT-4o 驱动):前景分割是 3D 生成的命门,分割烂则 3D 必烂;集成 3 个分割后端(SAM 系、rembg 系、RMBG-1.4),GPT-4o 判定哪个失败 -> 触发重试(让用户重拍,或换一个文生图模型重新生成输入)。
- Img-to-3D 生成:选 Trellis(开源,同时支持 mesh 和 3DGS 双表示,方便社区跟进)。论文也直说 Trellis 的毛病:纹理高光过曝、烘焙到 mesh 上发白、生成物没有真实尺度、没有物理属性——能看不能仿。
- Postprocess 资产质检:
MeshGeoChecker把资产从四个正交视角渲染,评估几何完整性与合理性;过关 -> 导出 URDF 归档;不过关 -> 换参数、换随机种子重采,回对应环节重新生成。
为什么 URDF 是关键交付物:URDF 是机器人仿真器(MuJoCo/Isaac)的资产交换格式——通过质检 = 这个物体可以进物理仿真,这是「3D 资产」变成「仿真可用资产」的临门一脚。
3D-BG 背景重建:稀疏视角的现实与补救(论文 Fig.9)
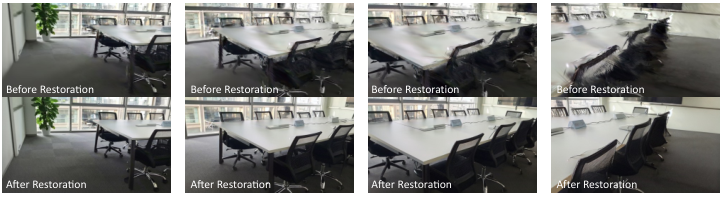
Fig.9 讲解:左侧「修复前」的新视角合成有明显空洞、拉伸与光度伪影(稀疏视角下 3DGS 没见过的角度硬猜);右侧「修复后」纹理连续、边缘干净——这些修复视角随后作为增广输入喂第二阶段的稠密重建。
技术要点:
- 3DGRUT(不是原版 3DGS):给每个高斯挂 7 个代表点(1 中心 + 6 边界点),从而精确建模卷帘快门、非针孔相机——具身场景常用的真实相机(手机、机器人头显)正是这类,原版 EWA splatting 的针孔近似会糊。
- 视角修复(view restoration):训练一个视角精修模型幻觉补出中间视角,消掉稀疏 NVS 的几何/光度伪影 -> 补出的稠密视角做第二阶段稠密 3DGS 重建。
- Poisson 表面重建:把稠密高斯云转成水密 mesh——mesh 给碰撞检测与动力学用,高斯给渲染用(同一场景两套表示,物理和渲染各取所长)。
3D-Phys 物理赋能:三类物体三条赋物理路线(论文 Fig.10)
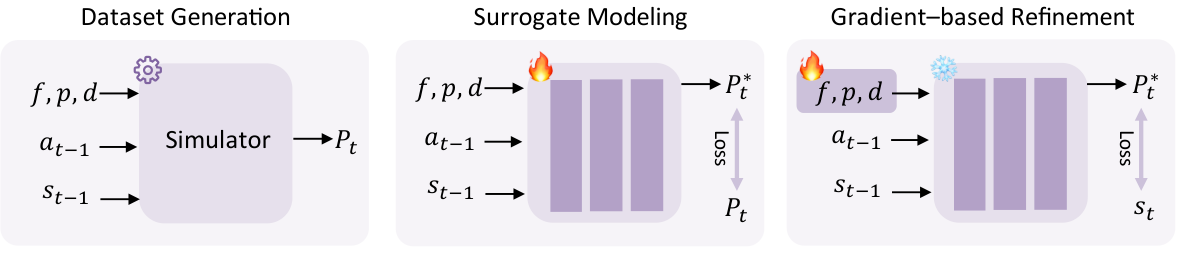
Fig.10 三阶段逐格讲(机械臂的关节摩擦/刚度/阻尼怎么标定——f 摩擦、p 刚度、d 阻尼):
- Dataset Generation:真实轨迹
(a_{t-1}, s_{t-1})(动作 + 状态)与随机采样的物理参数 (f, p, d) 配对,送进仿真器跑 rollout,产出参数化的仿真结果P_t(图中齿轮图标 = 仿真器,只此一次大规模调用)。 - Surrogate Modeling:训一个代理模型 M(图中火苗 = 可训练),输入
(f,p,d), a_{t-1}, s_{t-1},输出预测状态P*_t,用与仿真器输出P_t的 MSE 拟合——得到一个可微分的动力学替身。 - Gradient-based Refinement:冻结代理模型(雪花 = 固定),损失变成「预测状态 vs 真实状态
s_t」的差异,对参数 (f, p, d) 直接梯度下降,收敛出(f*, p*, d*)——这组参数让仿真器复现真实臂的行为。
方法论意义:传统系统辨识(手调、模拟退火)慢且费人;这里把「不可微的仿真器」用代理模型变成可微对象,参数估计从搜索问题变成梯度问题(PINN 式思路)。关节摩擦、PD 增益这类实测不到的量,是仿真可信度的地基——地基不准,Act 线规划出的「可执行轨迹」落地就翻车。
另外两类物体:
- 刚体物体:Qwen3-VL 当物理专家——看正交渲染视图推断物理属性。妙在分两步:先用前视图 + 文本约束估计真实尺度(解决「照片里不知道杯子多大」的尺度歧义),再基于尺度预测质量、摩擦系数,挂到语义类别上供下游复用。
- 可形变物体:弹簧-质点系统绑到高斯粒子(PhysTwin 思路)。差异:PhysTwin 是逐场景优化(每个场景重跑优化),本文在探索单目视频前馈直出弹簧-质点参数——从「一景一优化」走向「一次推理通用化」(论文标注为探索中)。
3D-Act 动作生成:简单/复杂场景两档(论文 Fig.11)
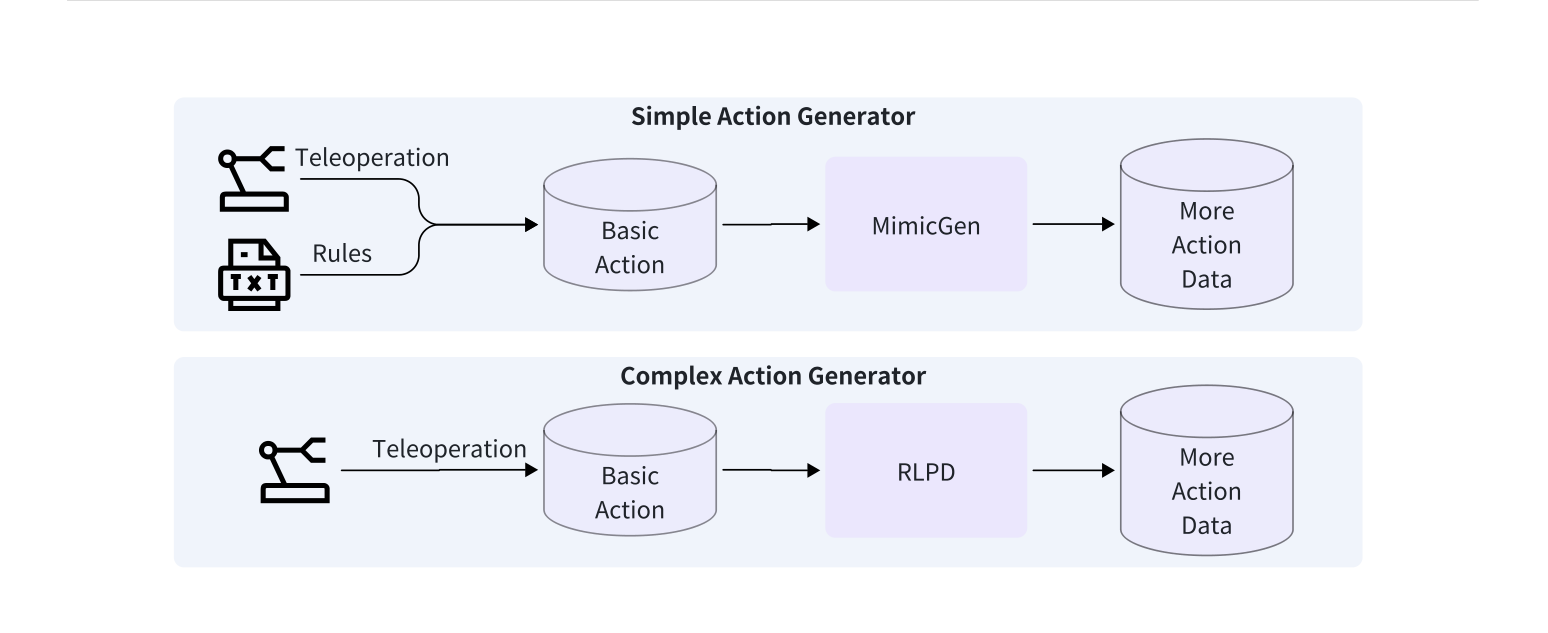
Fig.11 逐格讲:
- 上排 Simple Action Generator:
Teleoperation(遥操作)或Rules(规则脚本)先攒一小撮Basic Action种子 -> MimicGen 把种子轨迹系统性地移植到新物体位姿与场景布局 ->More Action Data。适用于抓取、摆放等几何可参数化复用的任务——一份人类示范,几十个场景变体,零额外人力。 - 下排 Complex Action Generator:多步推理、接触密集的任务没法靠几何变换复制 -> 遥操作演示当冷启动数据,RLPD(ICML 2023 的高效在线 RL)快速在线训练 -> 收敛策略批量 rollout 刷出
More Action Data。先模仿后强化,把高层任务结构落到低层电机控制。
两档设计背后的判断:不是所有任务都值得上 RL,也不是所有任务都能靠位姿变换复制——按任务复杂度路由到正确档位,是这条线能上量的经济学。
汇流:3D 数据引擎的完整输出(论文 Fig.17)
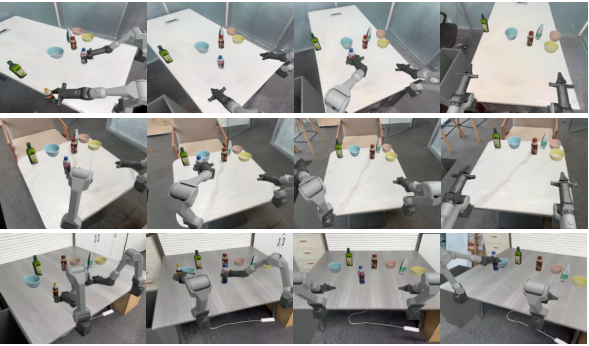
Fig.17 讲解:多机位、多场景的操作可视化——前景物体(FG)与背景(BG)无缝拼合(关键:前景物体是不同相机看都成立的 3DGS/mesh,不是 2D 贴片),跨视角几何一致;机械臂运动与物体交互满足碰撞/接触约束(Phys + Act 的功劳)。
论文点明的分工:前景 BG/FG 用 3DGS 出照片级渲染、用 mesh 出碰撞与动力学;Phys 赋质量/摩擦/弹性 + 系统辨识标定臂动力学;Act 出无碰撞可执行轨迹;最后接 AppearanceTransfer 对渲染结果做文本改外观——3D 的几何物理 × Video 的外观多样,两线在此正式合流,零新增 3D 资产成本做域扩增。
🚂 训练工程:GigaTrain 如何把视频基座训得起
数据:公开盘点 + 自采千小时
| 来源 | 内容 |
|---|---|
| 公开数据 | AgiBotWorld、RoboMind(操作与移动基础覆盖) |
| 自采数据 | Agilex Cobot Magic + AgiBot G1 两个平台,数千小时 |
| 场景规模 | 3,100 m²,5 大类环境(工业/商业/办公/住宅/实验室) |
| 细分场景 | 14 个真实场景:超市、酒店大堂、咖啡店、奶茶店、便利店、餐厅、仓储料区、工业产线、茶水间、民宅、公寓室内、会议室、工位、实验室 |
| 任务谱系 | 基础抓放 -> 长程顺序活动 -> 动态布局移动操作 -> 可形变物体交互 |
注意 14 个场景全是生活化非结构化场景——这决定了基座的分布是「家居服务业」而非「工厂节拍」,与下游 GigaBrain-0 干的叠衣服、倒果汁、收餐桌完全一致。数据引擎的场景清单就是产品的场景清单。
训练配置选择同样务实:主流 VLA 输入是 480p,于是基座训 480×768、61 帧——不是不能训更高,是下游用不上,省下的算力换数据吞吐。
GigaTrain 能力清单(开源:open-gigaai/giga-train)
- 并行框架:DeepSpeed ZeRO(Stage 0-3)、FSDP2
- 混合精度:FP16 / BF16 / FP8
- 显存手段:梯度累积、梯度检查点(activation checkpointing)、EMA
- 可配优化器 / 学习率调度等训练模块
设计目标一句话:大规模预训练和 8 卡小算力微调用同一套代码——论文特意报告 8×H20、batch 32 的配置,就是给想在有限算力上做 post-training 的社区用户抄作业。
消融:Table 2 拆成图(自绘)
原始表(节选 FSDP-2 与对照,8×H20 / batch 32;Act. Ckpt. = 对 FFN 开激活检查点):
| 并行框架 | Act.Ckpt | FP8 | 稀疏注意力 | w/ MoE | 时延 (s/step) | 显存 (MB) |
|---|---|---|---|---|---|---|
| DeepSpeed-Zero0 | OOM | OOM | ||||
| DeepSpeed-Zero2 | 32.84 | 95241 | ||||
| FSDP-2 | 33.19 | 89355 | ||||
| FSDP-2 | ✓ | 29.53 | 71857 | |||
| FSDP-2 | ✓ | ✓ | 25.38 | 73131 | ||
| DeepSpeed-Zero0 | ✓ | ✓ | ✓ | ✓ | OOM | OOM |
| DeepSpeed-Zero2 | ✓ | ✓ | ✓ | ✓ | 33.27 | 84699 |
| FSDP-2 | ✓ | ✓ | ✓ | ✓ | 33.38 | 73997 |
四条结论(面试可直接说):
- 显存排序:FSDP-2 > ZeRO-2 > ZeRO-0——ZeRO-0 直接 OOM(它本来就不分片优化器状态),FSDP-2 最省但通信开销略高、单步略慢(33.19 vs 32.84)。
- FP8 是全线净赚:三种框架上同时降时延与显存(FSDP-2:33.19->29.53 s,89->72 GB),是最划算的一项。
- 稀疏注意力(NATTEN)在 FP8 之上再省 ~14% 时延(29.53->25.38 s)——但论文提醒:不微调适配会掉模型质量,稀疏不是免费午餐。
- 上 4 路 MoE 后必须开 FFN 激活检查点:时延回到 33 秒量级(参数量 + 重算的代价),显存靠 FSDP-2 仍压在 74 GB;同一配置下 ZeRO-0 直接 OOM——MoE 时代选对并行框架是能不能训的问题。
📊 实验:基准、可视化、下游
PBench(Robot Set):2B 激活打赢 14B(论文 Table 3)
评测维度:i2v-bg(图生视频背景一致)、i2v-s(结构)、aes(美学)、img(图像质量)、bg-con(背景一致)、mot(运动)、sub-con(主体一致)、o-con(物体一致)+ Domain + Overall。
| 模型 | 参数 | i2v-bg | i2v-s | aes | img | bg-con | mot | sub-con | o-con | Domain | Overall |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Cosmos-Predict2 | 14B | 97.4 | 97.3 | 47.0 | 94.0 | 66.3 | 98.9 | 12.0 | 93.1 | 84.0 | 79.88 |
| Wan2.2 | 14B | 95.9 | 95.9 | 48.6 | 91.0 | 67.1 | 97.6 | 11.9 | 88.1 | 83.2 | 78.85 |
| Wan2.2 | 5B | 95.4 | 95.0 | 46.7 | 92.7 | 63.9 | 97.9 | 12.0 | 90.2 | 80.1 | 77.15 |
| Cosmos-Predict2.5 | 2B | 93.8 | 91.3 | 49.3 | 92.1 | 74.2 | 99.2 | 12.2 | 90.2 | 84.7 | 79.95 |
| GigaWorld-0-Video-Dreamer | 2B(Act.) | 97.6 | 97.6 | 48.1 | 93.6 | 66.8 | 99.2 | 12.6 | 91.9 | 88.2 | 82.07 |
读表要点:
- Overall 82.07 全场第一,且是激活参数最小的模型(2B vs 14B)——MoE + 面向具身数据的预训练红利。
- Domain 88.2 领先第二名 3.5 分——「领域分」正是它与通用视频模型拉开差距的地方:具身交互分布上见得多。
- 诚实处也要看:
aes(美学 48.1)输给 Cosmos-Predict2.5 的 49.3,bg-con(66.8)远低于 2.5 代的 74.2——短板在画面美感与背景静态一致性。数据引擎要的是「动作对、结构对」,美学分 1 分之差影响不大,但这说明它不是「通用文生视频最强」,是具身场景特化。 - 全场
sub-con都在 12 分上下——该子项区分度极低,看总分别被单项误导。
DreamGen Bench:同框微调对比(论文 Table 4)
公平性设计值得学:公开的 DreamGen 代码里 prompt 与论文不一致,本文以论文 prompt 为准复现基线;所有模型用相同超参(batch 64、200 步)在 GR1 数据上微调(GR1-Env 29 条 / GR1-Object 50 条 / GR1-Behavior 47 条);PA 分按 VideoPhy 协议算 PA II,最终 PA = (PA I + PA II)/2。
| 方法 | 参数 | Env: Qwen-IF / GPT-IF / PA | Object: Qwen-IF / GPT-IF / PA | Behavior: Qwen-IF / GPT-IF / PA |
|---|---|---|---|---|
| Cosmos-Predict2 | 14B | 0.966 / 0.552 / 0.586 | 0.840 / 0.760 / 0.471 | 0.894 / 0.638 / 0.458 |
| Wan2.2 | 14B | 0.900 / 0.760 / 0.549 | 0.700 / 0.780 / 0.531 | 0.870 / 0.570 / 0.477 |
| Wan2.2 | 5B | 0.790 / 0.340 / 0.531 | 0.720 / 0.780 / 0.522 | 0.830 / 0.280 / 0.468 |
| Cosmos-Predict2.5 | 2B | 0.930 / 0.480 / 0.534 | 0.920 / 0.240 / 0.503 | 0.830 / 0.320 / 0.471 |
| GigaWorld-0-Video-Dreamer | 2B(Act.) | 0.966 / 0.586 / 0.529 | 0.920 / 0.540 / 0.481 | 0.894 / 0.638 / 0.446 |
解读:论文强调的结论是**「在三个场景的指令跟随(Qwen-IF/GPT-IF)上全面优于同为 2B 的 Cosmos-Predict2.5」**(预训练语料里没有大量 GR1 数据仍赢)。也要看到 PA(物理合理)并非全面领先——物理常识分与专用物理评测互有胜负,数据引擎的最终裁判仍是下游 VLA,而非视频分。
可视化逐图(Fig.12)
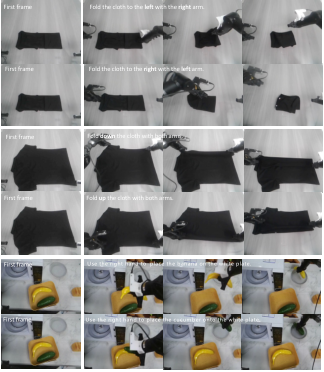
Fig.12 讲解:同一初始画面(叠衣服/倒果汁等场景)分叉出不同指令的后续——从刚体抓取到软体折叠都保持时序连贯与指令忠实。「同帧多指令」是数据引擎的产能单元:初始状态复用,任务多样性纯靠文本扩。(Fig.13 多视角版本已在 Video 线讲过。)
下游真机:GigaBrain-0 六连图(论文 Fig.18-23)
最硬的验证不在视频分数,而在只用合成数据训练的策略上真机。六个部署场景:
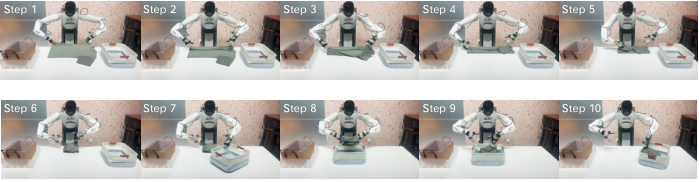 Fig.18 叠衣服(G1 人形):双臂协同 + 可形变布料——数据引擎里软体交互(Fig.12 叠衣服生成)的实机兑现,检验 3D-Phys 弹簧-质点与 IDM 软体动作标签的成色。
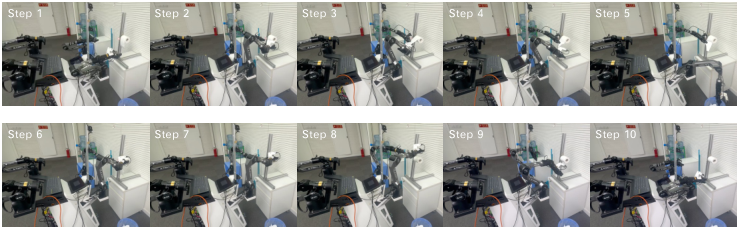 Fig.19 纸巾制备(PiPER 双臂):抓取-展开-放置多步顺序操作,长程一致性考验。
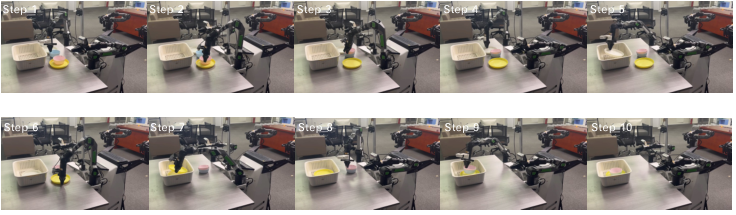 Fig.20 收拾餐桌(PiPER 双臂):多物体、多位置的桌面清理——正是 Fig.17 里多物体桌面场景的任务化版本,物体位姿多样性能否泛化看这张。
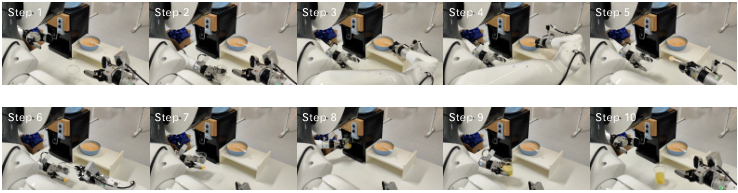 Fig.21 果汁制备(G1 人形):移动操作 + 容器交互,接触密集(倒液体不能穿模不能泼洒)——Phys/Act 联合把关的场景。
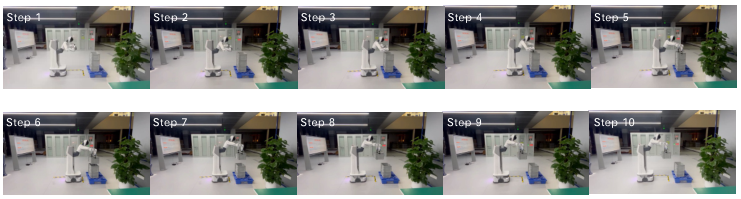 Fig.22 搬箱子(G1 人形):大体积刚体重载搬运,质量/摩擦参数猜错就会滑脱。
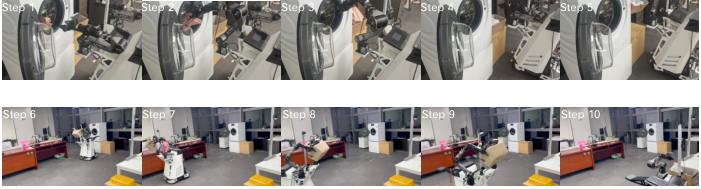 Fig.23 搬脏衣篮(PiPER 双臂):双手抱持大体量柔性容器——移动 + 双臂 + 软体三项叠加,是六图里任务难度最高的一张。
汇总读法:六张图覆盖双臂桌面操作、移动操作、刚体、软体、多步长程五类难度轴,且换本体(G1 人形 / PiPER 双臂)都成立——对应 GigaWorld-0 反复强调的三项卖点:多样性、跨本体、长程。但注意:论文给的是成功执行的定性图,成功率、鲁棒性与消融数字在 GigaBrain-0 论文里(本文明确外链)——引用时别说成「本文报告了 XX% 成功率」。
💡 深度评析:三个最妙的设计,三个要留心的边界
三个最妙的设计
1. 控制分支的「通道拼接 + MLP」是对 ControlNet 的成本手术。 多数复现者第一反应都是「基座上挂 ControlNet」——论文直接算清了这笔账:MoE 基座挂 ControlNet = 复制 4 个专家的 FFN,参数与显存成倍涨。换通道拼接后,控制编码器只是「3D-VAE(本来就有)+ 一段小 MLP」。这个决策的本质是:控制信号是低维几何先验,不值得用生成模型的容量去编码。同款思路可以迁移到任何「大 MoE 基座 + 轻量条件注入」的场景。
2. 「动作从生成视频里读出来」消灭了对齐误差。 合成数据的老大难是 (观测, 动作) 对齐:仿真渲染好对齐但有 sim2real gap,真实数据天然对齐但贵。IDM 方案取了个巧——动作标签是视频的函数,时间对齐在构造上就是零误差;掩码训练再把背景噪声从这个函数里剥掉。整条链的误差预算全部集中到 IDM 一项上,单点可测、可替换、可升级(换更强的 IDM 全线受益),这是很好的系统分解。
3. 3D 线把「质检回环」写进了管线而不是论文口号。 Aesthetic-Checker、ImageSegChecker(GPT-4o 判 + 三分割后端重试)、MeshGeoChecker(四视角渲染查几何)——每一道闸都有明确的失败动作(重试/换种子/换模型)。数据引擎的可信度不来自生成模型多强,而来自不合格数据出不了厂。这一层在学术论文里常被省略,却是工程落地与 demo 的分水岭。
三个要留心的边界
1. 闭环的量化证据在别的论文里。 本文的下游验证是六张成功案例定性图,成功率/消融在 GigaBrain-0;PBench/DreamGen 是视频层指标,不直接等于数据引擎的「训练价值」。「合成数据训练的 VLA 比真实数据好多少 / 差多少」这个最核心的问题,本文没有给出对照数字(比如纯真实数据 vs 真实+合成的 ablation)。
2. IDM 是单点风险。 视频生成再多样,动作标签错一点就是毒样本;论文 Fig.3 展示了未见任务上的对齐,但没有报告「IDM 误差如何传导到 VLA 成功率」。按「数据引擎 = 数据 × 标签质量」的分解,这恰是最该量化的一项。
3. 3D 与 Video 两线的合流深度有限。 论文展示的合流是「3D 渲染结果接 AppearanceTransfer 改外观」——方向正确,但 3D 场景的光照/材质与视频生成的条件体系(depth/normal)仍是两套表示;更彻底的统一(比如 3D 高斯作为视频生成的条件)在论文里只字未提,属于两线并联而非深度融合。
和你读过的 Cosmos-3 放在一起看
| 维度 | Cosmos-3(NVIDIA) | GigaWorld-0(GigaAI) |
|---|---|---|
| 定位 | 全模态世界基础模型(五模态统一底座) | VLA 数据引擎(面向下游训练的产线) |
| 架构核心 | MoT 双塔(Reasoner / Generator) | MoE 视频基座 + 轻量控制分支 + 3D 流水线 |
| 物理从哪来 | 模型内生(物理 AI 预训练) | 管线外挂(可微系统辨识 + 物理专家 + 执行规划) |
| 验证方式 | 物理 AI 基准 | 真机 VLA 部署(GigaBrain-0) |
| 共同点 | 都用混合精度/大底座路线;都主张「世界模型喂下游」而非只刷视频分 |
一句话区分:Cosmos-3 造的是「更全的底座」,GigaWorld-0 造的是「更硬的产线」。前者赌模态统一的规模效应,后者赌「几何+物理+质检」的管线工程——对做工程落地的人,后者的质检回环、坐标变换、系统辨识这些可迁移的手艺更多。
🎤 汇报口述稿(30 秒 + 2 分钟)
30 秒版:
「GigaAI 的 GigaWorld-0,arXiv 2511.19861。它把世界模型定位成 VLA 的数据引擎:Video 线一个 2B 激活参数的 MoE 视频基座 Dreamer,挂外观/视角/人手转机械臂三个轻量控制分支;3D 线用 FG/BG/Phys/Act 四模块产几何一致、物理可信的可仿真场景;生成视频再用掩码 IDM 读出 12 关节动作标签,拼成 (视频, 动作) 对。GigaBrain-0 只吃这批合成数据,真机叠衣服、倒果汁、收餐桌全跑通,训练全程零真实交互。PBench 总分 82.07,用 2B 激活打赢 14B 的 Cosmos-Predict2。」
2 分钟版(在 30 秒上加四层):
- 架构:Flow Matching + 3D-VAE(4×8×8) + 稀疏 NATTEN 注意力 + MoE-FFN(4 专家 Top-2、无共享专家、DeepSeek-V3 式负载损失 α=0.01);三个后训练模型共用控制分支——因为 MoE 基座挂 ControlNet 要复制 4 个专家,所以改成通道拼接 + 压缩 MLP。
- 几何/物理:ViewTransfer 用式 10-11 的位姿变换保证「任务语义不变、动作标签同步变换」,训练对靠双重重投影自监督;3D-Phys 用「仿真 rollout -> 可微代理模型 -> 梯度反推 (f,p,d)」三阶段做系统辨识;Act 简单场景 MimicGen、复杂场景 RLPD。
- 工程:GigaTrain 的 FP8 + NATTEN 把单步从 33 秒压到 25 秒(8×H20),MoE 需 FFN 激活检查点否则 OOM;数据出厂有四维质检分级。
- 边界:本文成功率是定性展示,量化在 GigaBrain-0;IDM 是单点风险;两线合流还停留在「3D 渲染 + 视频改外观」的并联层。
❓ 自测 Q&A
Q1:为什么说它是「数据引擎」而不是「世界模型仿真器」? A:仿真器要进环——策略在里面闭环交互,单步误差会累积,长程必然失真;数据引擎离线批量产数据,只要求「数据分布让策略学到真实行为」,不进推理环。因此它的核心 KPI 不是 rollout 保真度,而是下游 VLA 真机成功率,视频指标只是过程指标。
Q2:MoE 基座为什么不用 ControlNet?换成什么了? A:ControlNet 要复制骨干做控制编码器;基座 FFN 是 4 专家 MoE,复制一层就多 4 个专家,参数爆炸。改成:控制条件过 3D-VAE -> 与噪声 latent 通道维拼接 -> Multi Perception 压缩 MLP -> 进 DiT。参数只增一小段 MLP,控制信号(深度/法线/掩码)这类低维几何先验足够编码。
Q3:MoE 的负载均衡损失长什么样?和 DeepSeek 什么关系?
A:L_Load = α Σ f_i P_i(α=0.01),f_i 是专家进 Top-K 的频次占比、P_i 是归一化门控权重均值占比——「选中率」与「权重」双惩罚,防止垄断专家。形式取自 DeepSeek-V3 的互补损失;与 DeepSeek-V2 的差异是不设共享专家(视频语义按区域分工更块状,专精度优先)。
Q4:ViewTransfer 怎么保证「换视角不换任务」?动作标签怎么办?
A:约束是末端世界系绝对位姿不变(式 10),由此解出新基座下的末端位姿 K_t = (T^{base->W_B})^{-1} T^{base->W_A} T_t^{ee->base}(式 11)。视频条件用双重重投影自监督(MoGe 深度 warp 再投回、掩掉机械臂),臂的条件用 K 在 MuJoCo 里渲染。新视频配新动作标签,避免观测-动作错位。
Q5:IDM 为什么要做掩码训练? A:背景(桌布、杯子、光影)对「像素运动 -> 关节角」的回归是纯噪声;SAM 分割后只喂臂区域,模型只学臂的运动学。论文 Fig.3 显示未见任务上 12 关节 + 2 夹爪全部贴合真值。代价是整条数据链的质量上限被 IDM 锁死——这是系统分解换来的单点风险。
Q6:3D-Phys 的三阶段系统辨识在解决什么问题? A:关节摩擦、刚度、阻尼、PD 增益这些参数实测不到,手调/模拟退火太慢。三阶段:随机参数跑仿真 rollout -> 训可微代理模型拟合仿真器 -> 冻结代理,用「预测 vs 真实轨迹」的梯度直接优化 (f,p,d)。本质是把不可微的仿真器换成可微替身,搜索问题变梯度问题。
Q7:Table 2 里最划算的加速手段是哪个?MoE 有什么代价? A:最划算是 FP8(三框架一致地同时降时延与显存,约 -11% 时延 / -18% 显存);其上叠 NATTEN 稀疏再 -14%。MoE 的代价:耗时回到 33 秒量级、且必须给 FFN 开激活检查点,ZeRO-0 直接 OOM,要 FSDP-2/ZeRO-2 才扛得住。
Q8:PBench 82.07 怎么解读?有短板吗? A:2B 激活 > 14B Cosmos-Predict2/Wan2.2,Domain 88.2 大幅领先,说明具身分布特化成功。短板:美学分 48.1 输给 Cosmos-Predict2.5(49.3)、bg-con 66.8 明显低于 74.2;全场景 sub-con 都在 12 分(该子项无区分度)。它是具身特化选手,不是通用文生视频冠军。
Q9:这套东西和自动驾驶的世界模型(Cosmos Drive、DriveDreamer 系)什么关系? A:范式同源(生成式世界模型产数据/做预测),差异在动作与物理的接口:驾驶是「轨迹->视角流」的准结构化动作,用 NAVSIM 类指标闭环;具身是「关节角 + 接触 + 可形变」,物理细节多一个量级——所以 GigaWorld-0 要专门搞系统辨识、弹簧-质点、URDF。「数据引擎 + 质检回环」的框架可以整体平移到驾驶数据合成,这正是两边可以互相借鉴的地方。
Q10:如果只抄一个设计到自己项目里,抄哪个? A:「质检回环 + 数据分级」。无论用不用 GigaWorld-0,只要在做合成数据生产,就该有:输入质检(美学/分割)、资产质检(多视角几何)、成品质检(几何/多视角/文本/物理四维)-> 综合分决定进预训练、进微调还是丢弃。生成能力会迭代,这套路检逻辑是长期资产。
🧭 结论与论文展望
论文 Conclusion 给了三级路线图,值得记住:
- 从数据引擎到交互式策略环境:世界模型当 Model-Based RL 的安全探索场——本文刻意没进环,下一步进环。
- 从被动生成到主动共创:学出物理动力学、语义可供性、任务结构的通用先验,主动提出动作序列、拆解子目标——从「产数据」到「当教练」。
- 真实-合成自提升闭环:机器人真机 rollout 反哺世界模型 -> 世界模型产出更高质量数据 -> 系统终身自改进。
按本文已铺好的部件看,这三步都缺一个统一的评价与回流通道——IDM、质检、系统辨识都是单向产线;谁先把「真机失败案例 -> 定向重生成」的回路做出来,谁就完成了从 data engine 到 self-improving system 的一跃。
📚 资源与延伸
- 论文:
arxiv.org/abs/2511.19861(v2,2025-11-30) - 项目页:
giga-world-0.github.io(含视频 demo) - 代码:
github.com/open-gigaai/giga-world-0;训练框架:github.com/open-gigaai/giga-train - 下游策略:GigaBrain-0(arXiv 2510.19430,成功率/消融看这篇)
- 被本文当作对照的基线:Cosmos-Predict2 / 2.5(世界基础模型平台)、Wan2.2(通用视频生成)
- 同门续作:GigaWorld-1(arXiv 2607.02642,转向「世界模型当策略评测器」,WMBench 基准)——正好补上本文缺口(长程 rollout 可靠性与量化评测),两篇对读能看清这条产品线的演进方向。
本文全部 23 张论文插图已按论文编号摘录讲解,另有 6 张自绘 SVG(总架构 / Dreamer 深拆 / 控制分支 / IDM 闭环 / 3D 流水线 / 训练消融)配合拆解。图源:arXiv HTML v2 与官方 PDF。