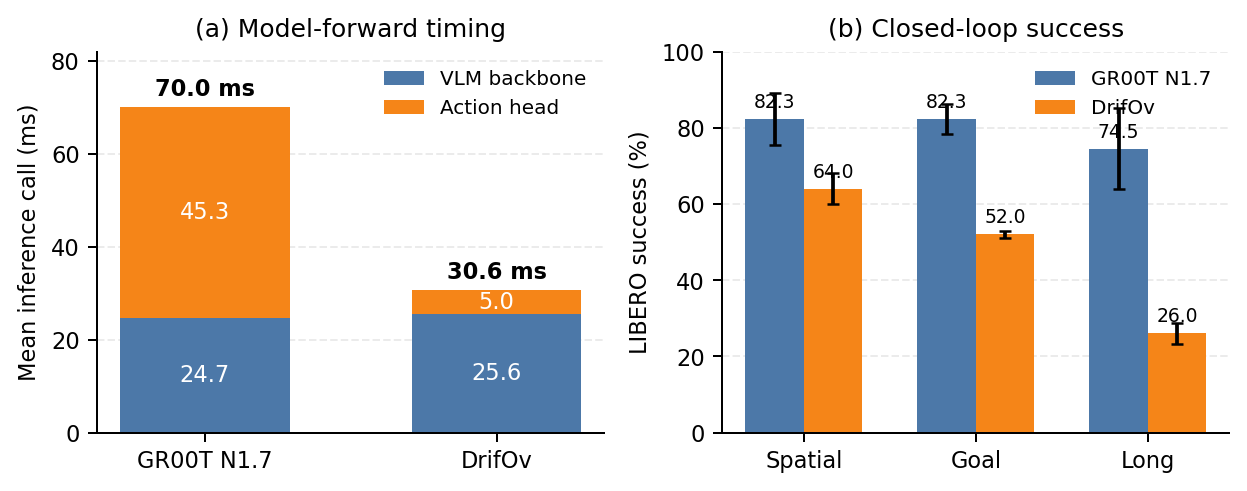
配图说明:本文收录论文全部 6 张插图(Fig. 1 ~ Fig. 6),放在站内 /images/grootn17/,逐张讲解,文末附图表总索引表。论文 Technical Report: One-Step Drifting Action Heads for GR00T N1.7(arXiv 2609.18108v1,2026-09-16,CC BY 4.0),作者 Xihe Shao(浙江大学-伊利诺伊联合学院,LimX Dynamics 深圳实习)。须先说清出处:这不是英伟达官方发布,而是第三方对英伟达 GR00T N1.7(NVIDIA Isaac GR00T 家族当前版本)动作头的替换研究——它系统回答了「VLA 的扩散/流匹配头能不能不迭代」这个全领域都在问的问题,且结论是一份罕见的诚实负结果。
📄 论文信息
- 标题:Technical Report: One-Step Drifting Action Heads for GR00T N1.7
- 作者 / 机构:Xihe Shao,ZJU-UIUC Institute(浙大国际联合学院)+ LimX Dynamics(逐际动力)实习
- 时间:2026-09-16(arXiv 2609.18108v1);许可 CC BY 4.0
- 被研究对象:NVIDIA GR00T N1.7(开源 VLA,Apache 2.0,3B 参数,HF
nvidia/GR00T-N1.7-3B) - 关键词:一步生成(one-step generation)、漂移策略(Implicit Drifting Policy / IDP)、动作块(action chunking)、实时分块(RTC)、DrifOv 重叠条件、LIBERO、速度-成功率权衡
- 一句话总结:用「一次网络前向吐完整动作块」替换「迭代 45ms 的流匹配头」,动作头快 9 倍、整条模型前向快 2.2–2.4 倍;但三个种子一致显示成功率大跌——报告把退化拆成四个待检验假设,结论是「按速度-成功率前沿评价,而不是宣称无损」。
🎯 一句话版本:核心数字
| 指标 | GR00T N1.7(迭代头) | 一步漂移头 | 变化 |
|---|---|---|---|
| 动作头单次前向 | 45.2–45.8 ms | 4.94–5.07 ms | ≈9.0–9.3× 快 |
| backbone + 头总时间 | 69.3–72.0 ms | 29.3–31.5 ms | 2.2–2.4× 快 |
| VLM backbone 单独 | ≈24–26 ms | ≈24–26 ms | 几乎不变(仍是大头) |
| LIBERO-Spatial SR | 82.3 ± 6.8%(77/90/80) | 64.0 ± 4.0%(60/64/68) | -18.3 pp |
| LIBERO-Goal SR | 82.3 ± 4.0%(80/87/80) | 52.0 ± 1.0%(52/51/53) | -30.3 pp |
| LIBERO-Long SR | 74.5 ± 10.6%(67/82) | 26.0 ± 2.6%(28/27/23) | -48.5 pp |
| 训练显存观测峰值 | 45.748 GiB | 17.752 GiB | 见 Fig. 3(轶事性观测) |
| 训练配置 | 2×A800、20k 步、bs 32×2、bf16、H=40 | 同 | 种子 1/42/1000 |
🗺️ 仿真 vs 真机:一眼分清
| 场景 | 类型 | 说明 |
|---|---|---|
| LIBERO(lerobot/libero + LeRobot 栈) | 仿真 | 唯一受控对比;每子任务 10 episodes、每 suite 100 rollouts |
| LimX Tron2 真机部署 | 真机(工程记录) | RTX 4090 + 14900KF 工作站;玩具摆放 / 工业配件装盘 / 叠衣服数据采集——明确声明不是受控成功率对比 |
| 时延测量 | — | 只测 backbone 与动作头(CUDA 同步夹逼),不含前后处理/网络/控制——不是端到端时延 |
被排除的对照:π0.5 归档评测全 0%(更像评测/动作映射故障而非策略结果)、legacy drif_ov_libero0809(4×A800、bs256、15k 步单跑,配方不一致)——都只进附录不进主对比。
🧭 读前 5 分钟:五个概念
- 迭代动作头的问题:扩散/流匹配头每个动作块要做多次网络前向——即便 VLM 很快,动作头本身也可能是时延主要来源之一(本报告里它单独就占 ~45ms)。
- IDP(Implicit Drifting Policy):不在回归显式漂移场,而是围着专家动作构造几何加权势能
E(a)=½(a−a*)ᵀ(I+M)(a−a*);部署时零动作种子一次映射出完整动作块。本报告继承该目标,不宣称新生成目标。 - 几何矩阵 M:对观测特征做近邻权重(softmax),估计动作各坐标的条件方差 vs 参考方差,
ReLU得「几何超出」——M 越大的坐标,惩罚越重(数据里方向越确定越不能错)。M 是 detached 的,只加权训练势能。 - DrifOv(overlap-conditioned):异步换块场景——新块生成时旧块还有一段「已承诺前缀」在执行。DrifOv 把前缀 + 有效性掩码 + 重叠长度 + 执行偏移喂给头,解码后前缀坐标原样拷回(物理上不可被改写),只生成未知后缀。
- 模式平均风险:确定性单步生成面对「同一观测多个合法走法」时,容易输出多模式的条件均值附近——那里可能没有任何真实轨迹存在;多步扩散可以在轨迹中换模式,一步必须立刻站队。
🛠️ 方法:一步头 + DrifOv
架构(保留什么、换掉什么)
- 保留:GR00T N1.7 的预处理栈与 Cosmos-Reason2/Qwen3-VL 视觉-语言 backbone(官方 N1.7 即此架构:4B 级 VLM + 流匹配 DiT 头、16 层扩散层);从 第 16 层读隐藏特征投影到动作头维度。
- 换掉:迭代流匹配生成器 → 确定性条件 Transformer,单次评估输出完整动作块。
- 头规格:12 block,模型维度 1024,16 注意力头,FFN 4096,dropout 0.1;每 block = 动作/状态 token 自注意力 + 对视觉-语言记忆的交叉注意力(图像 token 与文本 token 交替)+ FFN。
- 维度:动作块 H=40,状态/动作最大维 132,状态历史长度 1;部署时零动作种子 + 时间 0 → 一次前向 = 完整块,推理步数固定为 1。
IDP 训练目标(继承)
- 势能与修正:
Eᵢ(a)=½(a−aᵢ*)ᵀ(I+Mᵢ)(a−aᵢ*),−∇E=(I+Mᵢ)(a*−a)。 - 两个评估点:
- 提案点:零种子 t=0 →
yᵢ=fθ(oᵢ,0,0); - 近端点:
ãᵢ=aᵢ*+(1−t*)ε,t*=0.9,zᵢ=fθ(oᵢ,ãᵢ,t*)。
- 提案点:零种子 t=0 →
- 损失
L = E(yᵢ) + 81.0·E(zᵢ)(λprox=81.0)。 - 几何加权:观测特征内积 → 行标准化 softmax 近邻权重 wᵢⱼ → 动作维条件方差
v_cond=Σⱼwᵢⱼ(a*ⱼ−a*ᵢ)²vs 批内参考方差 →m=ReLU(s_cond/s_ref+ε−1)。两个自认的坑:①参考方差来自当前 minibatch(依赖批量与组成);②实现里把查询样本自己算了邻居(IDP 原式 j≠i)——报告都列为限制而非验证过的设计。
DrifOv:重叠条件后缀生成
- 掩码
m_{h,j}=I[h<L]·ν_{h,j}:L 行已承诺前缀、ν 是有效动作掩码。 - 输出位置 h 的查询 = 编码后的掩码前缀 + 前缀掩码嵌入 + 重叠长度嵌入 + 执行偏移嵌入 + 位置嵌入;所有 H 个查询一次联合解码,交叉注意视觉-语言与状态条件 token。
- 硬约束:
b = m·p + (1−m)·Âθ—— 已承诺坐标逐值原样拷贝,学习头改写不了;前缀仍通过自注意力影响后缀。 - 损失只落在后缀坐标(ω=ν(1−m));可选边界项:首后缀动作位置误差权重 1.0、有限差分速度误差 0.1、加速度 0——鼓励前缀-后缀衔接,不构成新生成模型,只是辅助正则。
- 训练采样:重叠长度 0..H−1 均匀,零重叠概率 0.2;前缀从专家块拷贝后以 0.5 概率加高斯噪声(std 0.02,截断 ±0.05);执行偏移在 0..L 间采样。
- 关键细节:同步 LIBERO 评测不供前缀(空前缀路径)——所以主实验测的是无条件一步头,没有测到异步重叠收益;且训练前缀来自专家、部署前缀来自策略自身(分布不一致)。
📸 逐图讲解(Fig. 1 ~ 6)
Fig. 1:速度-成功率权衡总图
(即文首头图。)- (a) 时延柱:Spatial/Goal/Long 三 suite 的模型前向平均时间对照——GR00T 迭代头 ~70ms vs 一步头 ~30ms,误差棒极小(跨种子稳定)。
- (b) 成功率:三 suite 中匹配完整的部分——每个模型一组柱 + 跨种子标准差误差棒。一眼可见时延大幅左移、成功率同步右跌,且 Long 跌得最狠。 这张图就是全文标题:speed–success trade-off,不是 win-win。报告开宗明义:低种子方差意味着退化不是「一次倒霉初始化」。
Fig. 2:旧 checkpoint 的 LIBERO-Long 历史剖面
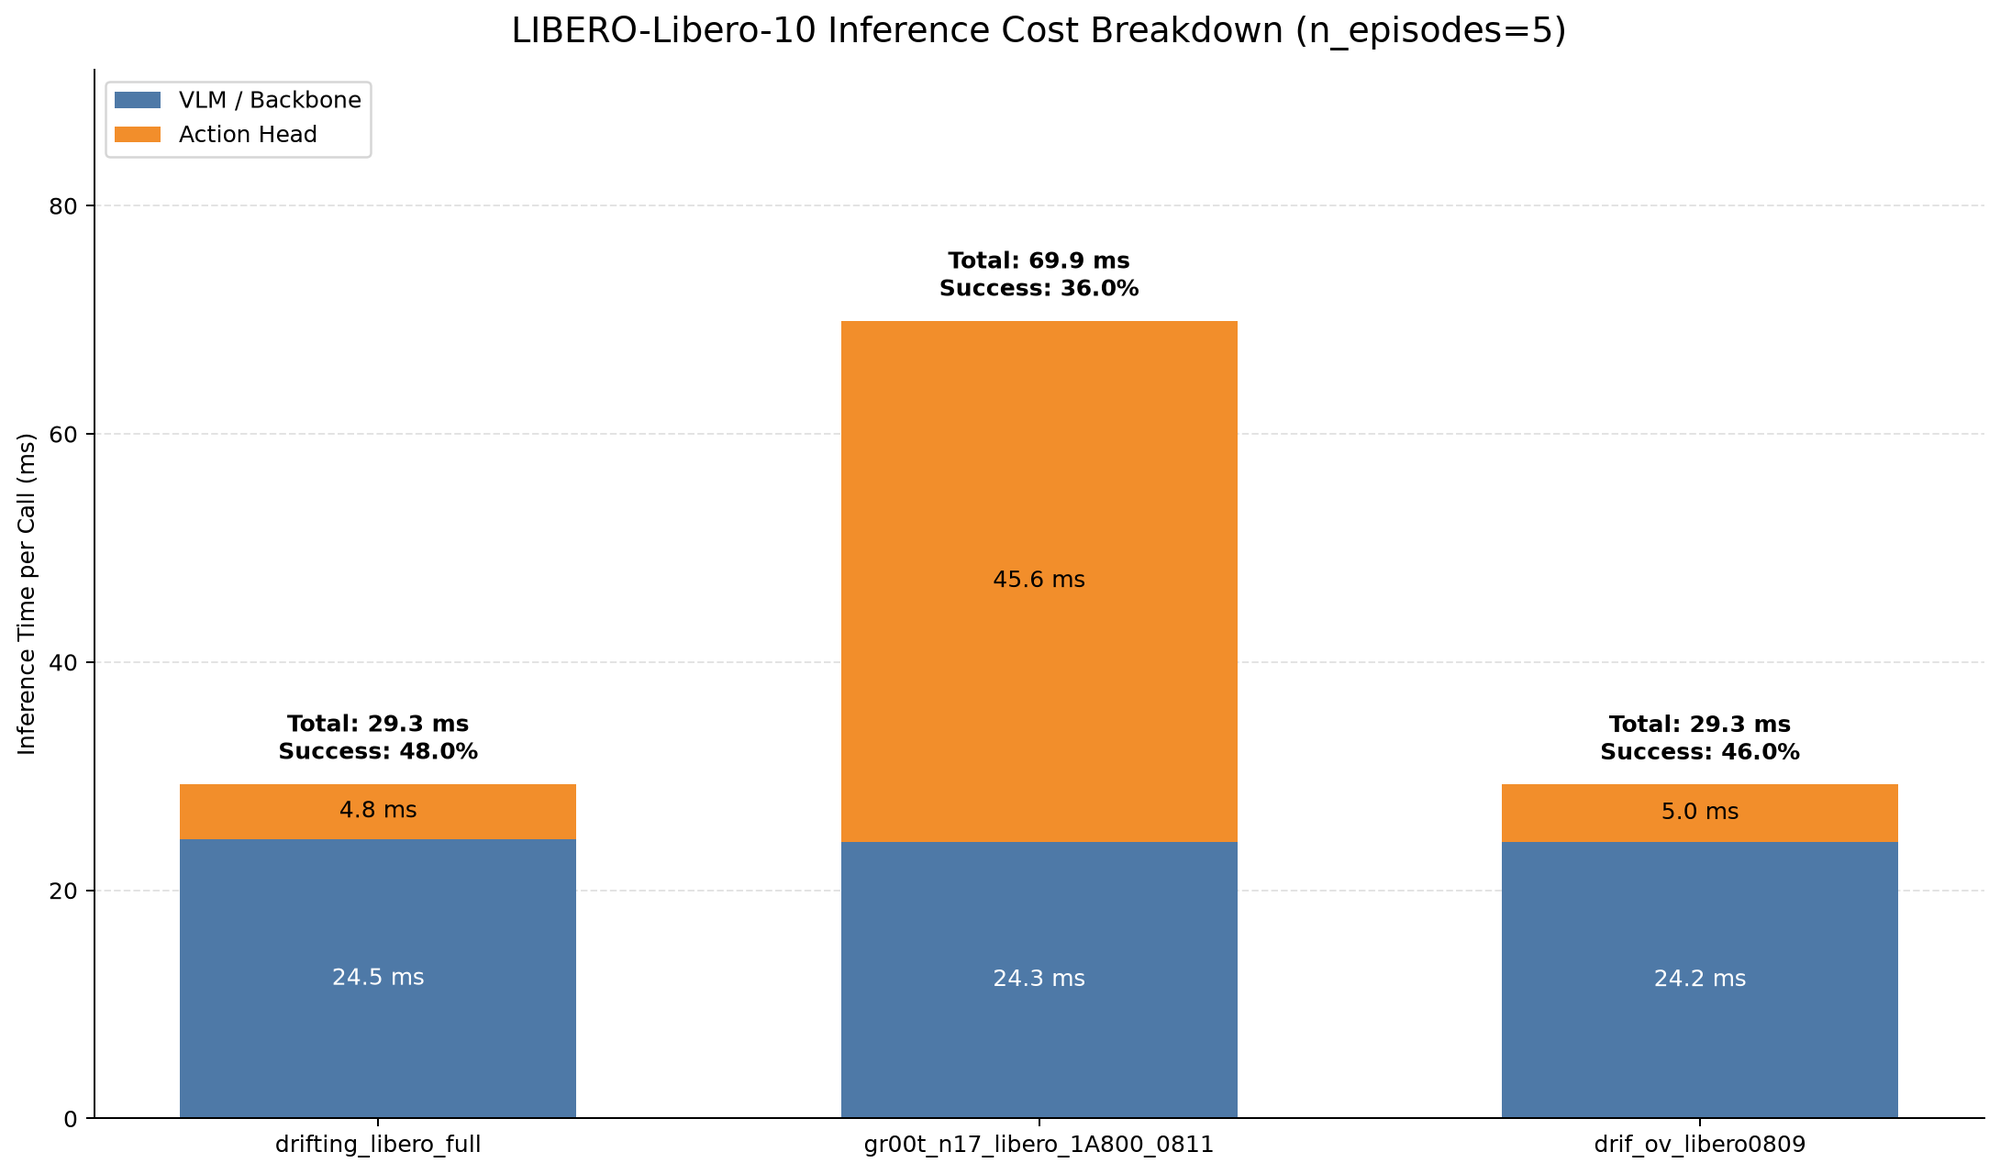
早期单跑(不同 checkpoint、不同训练制度)的开发历史记录——报告明确:仅作工程档案,不进主对比、不用于估计方法成功率(legacy 跑是 4×A800 / bs256 / 15k 步,与主配方 2×A800 / bs64 / 20k 步不一致)。读图时只需看趋势形态(逐子任务成功率起伏),不要抄它的绝对数值。这份「把不该比的图也放出来但贴上警示标签」的做法,是整篇报告诚实风格的缩影。
Fig. 3:训练显存遥测——一步头跑得更「瘦」
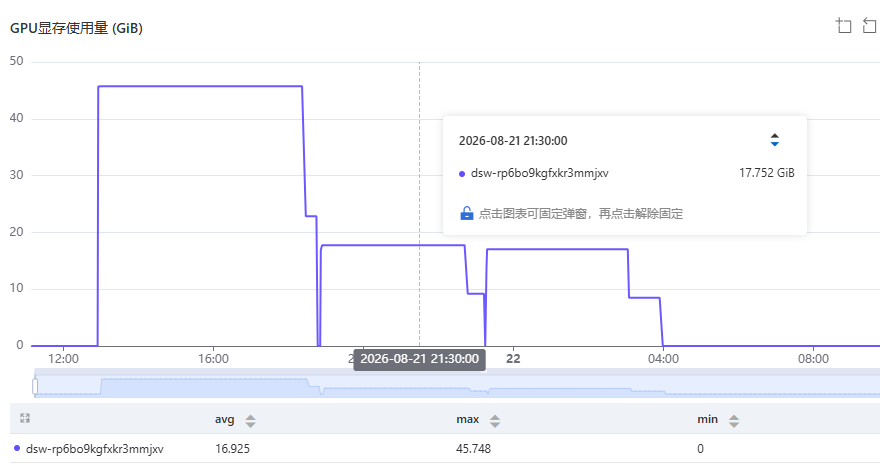
三联图:(a) drifting 训练、(b) GR00T 训练、(c) 合并对照。选定峰值 45.748 GiB(GR00T) vs 17.752 GiB(drifting)。但报告自己泼了冷水:这是轶事性观测——同服务器上还有别的任务与空闲期混在遥测里,不能把差值全归给动作头。合理解读方向:对资源受限训练值得继续查证的潜在收益,需要干净的对照实验才能定论。
Fig. 4:真机任务一——玩具与文具入格
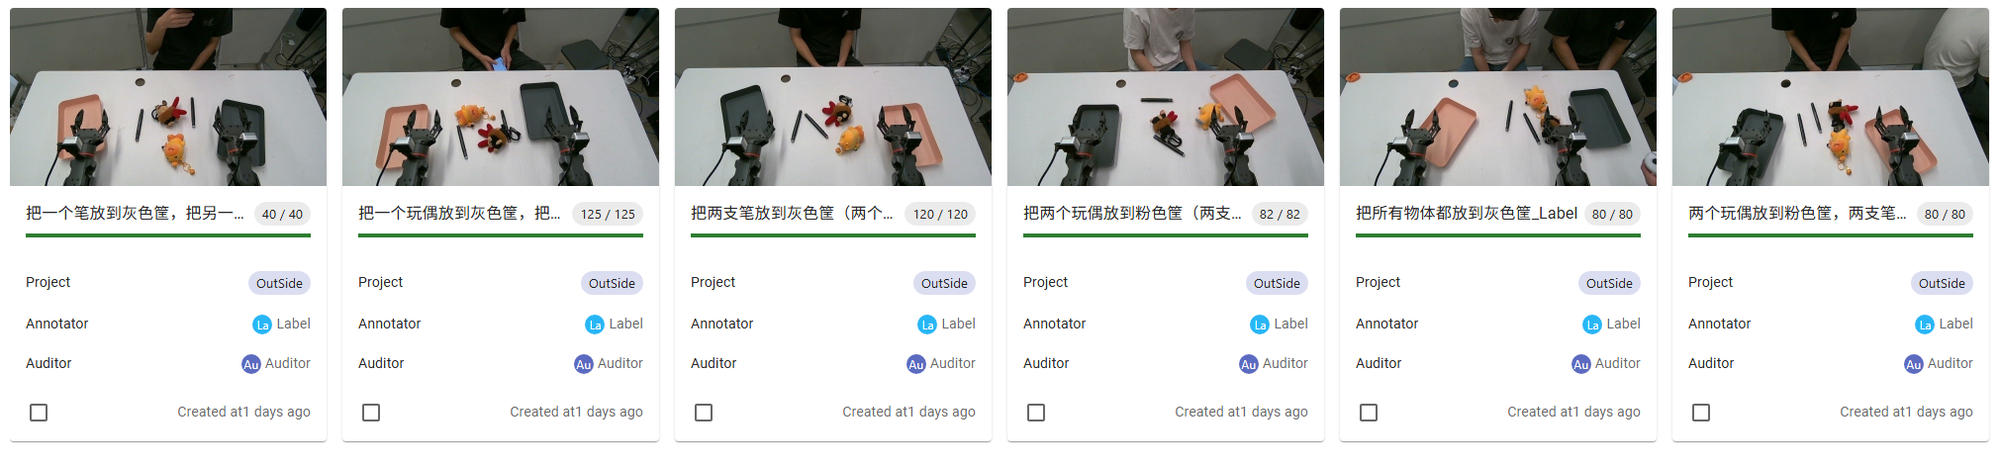
LimX Tron2 双臂平台上「把玩具/文具放进指定格子」的标注界面与任务变体关键帧。这是数据采集与系统集成的记录:成功/失败标签用于数据筛选,但没有固定策略评测协议——报告明确这些真机内容不是受控成功率对比。价值在于证明:一步头策略栈(RTX 4090 + 14900KF)能真实闭环跑起来。
Fig. 5:真机任务二——工业配件装盘标注进度
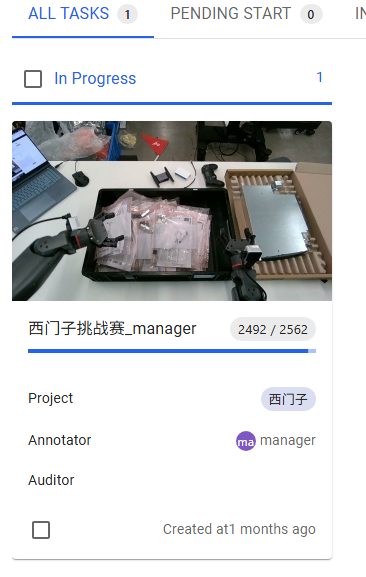
工业配件放入目标托盘任务的标注界面,共采集 2,562 条 rollout 轨迹——比 LIBERO 种子实验的数据集大得多,但同样没做匹配的策略对比(没有「一步头 vs 迭代头」在该任务上的对照)。图中进度条/批次视图展示的是标注吞吐而非策略性能。
Fig. 6:真机任务三——叠衣服数据集(成功 / 失败 / 人类接管)
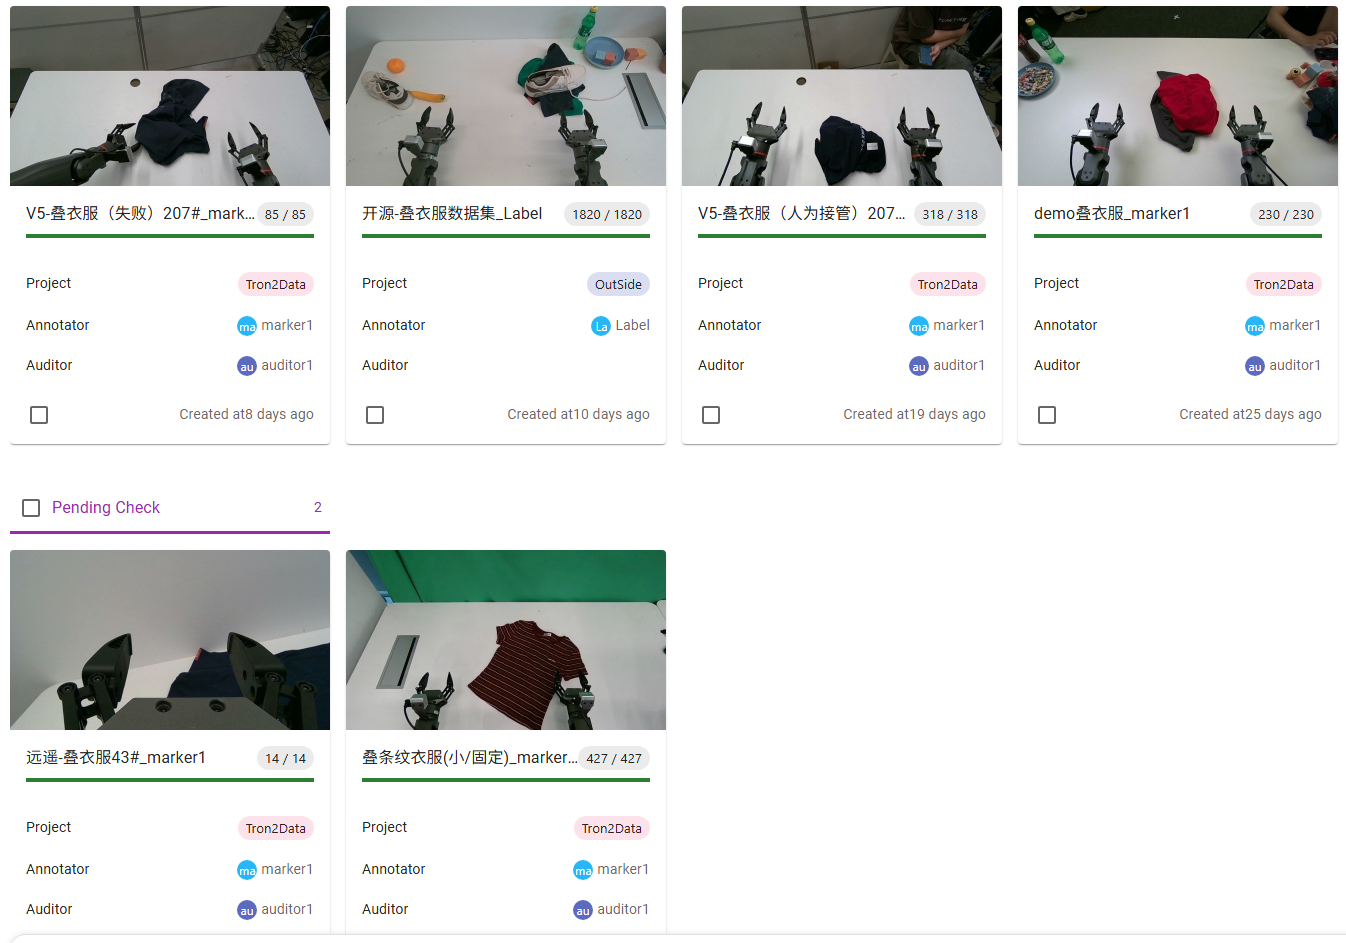
可变形物体(布料)部署采集的总览:成功演示、失败尝试、人类接管片段三类混编。目的有二:①研究布料操作数据形态;②为「人机接管」式数据闭环留档。同样声明:无受控策略成功对比。三张真机图(Fig. 4–6)共同构成报告的「工程观察」章节——能用、在采数,但不吹性能。
🧪 实验:两张表讲完全部受控结论
Table II:时延(模型前向,均值±方差)
| Suite | 模型 | backbone (ms) | 动作头 (ms) | 总计 (ms) | 头加速 |
|---|---|---|---|---|---|
| Spatial | GR00T N1.7 | 24.99±0.28 | 45.36±0.17 | 70.35±0.19 | 1.0× |
| Spatial | DrifOv | 24.42±0.11 | 4.96±0.08 | 29.38±0.05 | 9.1× |
| Goal | GR00T / DrifOv | ≈25 / ≈26 | 45.43 / 5.07 | 70.46 / 31.54 | 9.0× |
| Long | GR00T / DrifOv | 24.14 / 25.92 | 45.18 / 5.04 | 69.33 / 30.95 | 9.0× |
| Object | GR00T / DrifOv | 26.21 / 24.30 | 45.80 / 4.94 | 72.01 / 29.25 | 9.3× |
要点:头快 ~9×,但 backbone 纹丝不动(~25ms)——所以总加速只有 2.2–2.4×,而且这不等于端到端机器人时延(前后处理、网络、控制器、调度都还没算)。动作头-only 的优化救不了整条流水线的实时性。
Table III:LIBERO 成功率(种子 1/42/1000)
| Suite | GR00T N1.7 | 一步漂移 | 差距 |
|---|---|---|---|
| Spatial | 82.3 ± 6.8%(77, 90, 80) | 64.0 ± 4.0%(60, 64, 68) | -18.3 pp |
| Goal | 82.3 ± 4.0%(80, 87, 80) | 52.0 ± 1.0%(52, 51, 53) | -30.3 pp |
| Long | 74.5 ± 10.6%(67, 82;2 种子) | 26.0 ± 2.6%(28, 27, 23) | -48.5 pp |
| Object | 88.0%(仅 1 种子) | N/A | 无漂移种子数据 |
两个读法:①三种子方差极小(Goal 甚至 ±1.0)→ 退化是系统性的,不是运气;②退化随任务时长放大(Long 最惨)→ 与「开环块执行 + 模式平均误差累积」的假设自洽。
四个候选解释(报告强调:是假设,不是结论)
- 确定性一步的模式平均:势能仍是回归向目标;多模式观测下输出落在条件均值附近——那里可能没有真实轨迹。多步生成能在轨迹中切模式,一步必须立即站队。检验方法(报告提议):按观测附近专家模式数切片看一步预测误差;试潜变量/离散模式变量。
- minibatch 几何估计:局部 bs 仅 32,邻居权重与方差随批量组成漂移;实现还包含自邻居(原式排除)——两者都需要消融;可改检索式/数据集级几何估计。
- H=40 开环执行:头快不自动缩短开环窗口——误差照样攒。直接实验:把执行步数改成 1/2/5/10/20/40 再测;若短执行窗成功率回升,时延优势就换成了更高反馈频率。
- 异步重叠路径没被测到:同步 LIBERO 供空前缀;训练前缀来自专家、部署前缀来自模型——分布不匹配。要验 DrifOv 得在异步 rollout 里用模型自己生成的、到达状态物理一致的前缀。
另有一条混淆要记牢:动作头架构、初始化、目标都变了,且没有用预训练 GR00T 头做初始化(from-scratch 对比),也没有 MSE 头/几何项消融/一致性蒸馏对照——掉分不能归因到单一因素。
💡 评析:三个亮点,三条边界
三个亮点
- 罕见的诚实负结果:9× 头加速是真赢,成功率下跌也如实报,结论句直接写「当前 LIBERO 结果不支持无损替代的主张」——还主动列威胁效度(seed-1000 参考 checkpoint 协议差异、π0.5 全零被剔、Object 缺失不插补)。
- 把「快」和「有用」分开评审:时延表、成功率表分列;结论提出速度-成功率前沿与「时延降低是否换来更高闭环反馈频率」作为一阶评价标准——比单报加速倍数的行业惯用写法严格得多。
- DrifOv 的工程约束设计漂亮:前缀逐坐标硬拷贝(学习头无权改写已承诺命令)+ 请求超时拒绝(估计延迟超过可用前缀就不执行过期后缀)——把「异步控制的安全性」写进了前向传播里。
三条边界
- 受控证据只有 LIBERO 仿真;真机三节全是采集记录,无成功率对照——真实接触/时序下会怎样,未知。
- 异步重叠路径(DrifOv 的卖点之一)根本没被主实验测到——同步评测供空前缀,等于只验证了「无条件一步头」这一半。
- 时延口径窄:只含 backbone+头;端到端机器人管线(感知、编码、传输、控制器)未覆盖,9× 与 2.2–2.4× 都不能直接当「机器人快 9 倍」读。
🗺️ 在「VLA 加速谱系」里的位置
- 被研究对象 GR00T N1.7:英伟达 GR00T 家族(N1→N1.5→N1.6→N1.7)当前版本,3B、Cosmos-Reason2-2B/Qwen3-VL backbone、流匹配 DiT 头(16 层,N1.6 为 32 层)、Apache 2.0、预训练含 2 万小时 EgoScale 人类视频;官方家族论文 arXiv 2503.14734;RoboDojo 榜上 GR00T-N1.7 快照成绩 2.85 分 / 1.31% SR(见 RoboDojo 精读)。
- 加速路线对比:VLA-Cache(token 复用)、Fast-in-Slow(快慢双系统)、DEER(提前退出)、量化/编译——本报告走的是动作头替换路线,与前者互补;且它实测证明:头再快,backbone 仍是主导。
- 一步生成谱系:IDP(目标来源)、RTC/训练期动作条件(DrifOv 灵感来源 [Black et al.])——DrifOv 是「学习式前缀条件一步生成」而非推理期迭代引导。
- 谱系标签:推理加速 / 一步生成 / 诚实负结果。
📊 图表总索引
| 图 | 内容 | 本站文件 |
|---|---|---|
| Fig. 1 | 速度-成功率权衡(时延 + 成功率双联) | 本文插图 |
| Fig. 2 | Legacy LIBERO-Long 剖面(仅工程档案) | 本文插图 |
| Fig. 3 | 训练 GPU 显存遥测三联 | 本文插图 |
| Fig. 4 | 真机玩具摆放任务变体 | 本文插图 |
| Fig. 5 | 工业配件装盘标注进度(2,562 轨迹) | 本文插图 |
| Fig. 6 | 叠衣服数据集(成功/失败/接管) | 本文插图 |
(Table I 配置、Table II 时延、Table III 成功率为三张主表,正文已完整复现;附录 A 检查点清单、附录 B 排除项亦已摘要。)
❓ 自测 Q&A
Q1:这是英伟达的论文吗?
不是。作者是浙大-伊利诺伊联合学院学生、逐际动力实习;论文研究对象是英伟达 GR00T N1.7。英伟达官方 GR00T 家族论文是 arXiv 2503.14734(N1 起),N1.7 的模型卡在 GitHub/HF 官方发布。
Q2:为什么加速 9×,总加速只有 ~2.4×?
因为 VLM backbone(~25ms)没变,它成了新的瓶颈——动作头从 45ms 压到 5ms 后,占比已经很小。
Q3:掉分的四个假设里,报告自己最怀疑哪个?
报告明确「不确立任何单一因素」;但从它设计的后续实验看(减执行步数、异步 rollout、去 minibatch 依赖),开环执行 + 模式平均是最被优先检验的两个。
Q4:三种子 ±1% 的低方差说明什么?
说明退化系统性存在——不是初始化运气;同时也说明一步头在这个配方下「稳定地差」,换种子救不了。
Q5:DrifOv 为什么在 LIBERO 里没被真正测到?
同步评测不供动作前缀(空前缀路径),所以测的只是无条件一步头;重叠条件生成需要异步部署 + 模型自生成前缀才能评价。
📚 资源与延伸
- 论文:arXiv 2609.18108(CC BY 4.0)
- 被改造模型:GitHub NVIDIA/Isaac-GR00T、HF
nvidia/GR00T-N1.7-3B、官方家族论文 2503.14734 - 目标来源:Implicit Drifting Policy(arXiv 2606.01098);RTC / Training-time action conditioning(arXiv 2512.05964)
- 同评测体系:LIBERO 精读、RoboDojo 精读
- 同门路线:Flash-WAM 精读(蒸馏加速)、π0.7 精读(5B 通才)