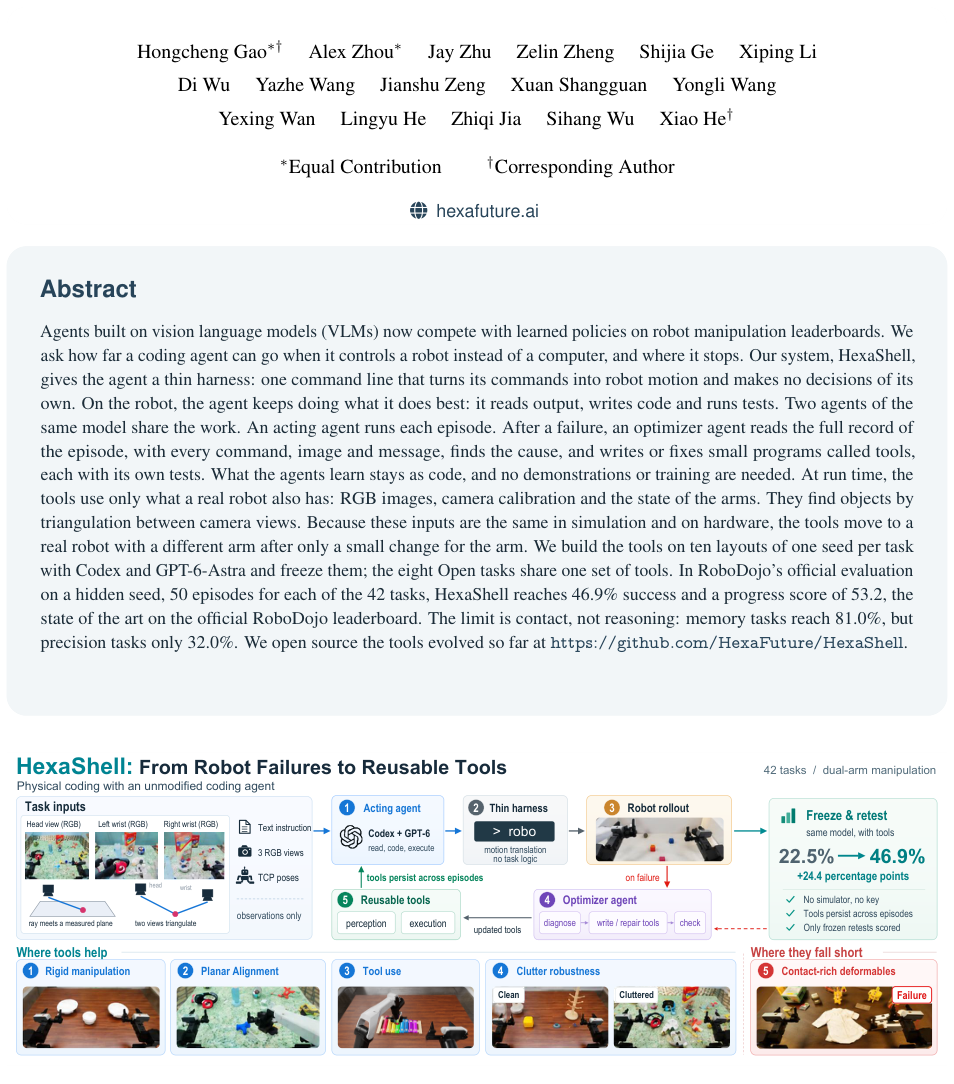
配图说明:本文收录论文全部 14 张插图(Figure 1 ~ Figure 14),放在站内 /images/hexashell/,逐张讲解,文末附图表总索引表。论文来自 HexaFuture(hexafuture.ai),16 位作者(共同一作 Hongcheng Gao、Alex Zhou,通讯 Hongcheng Gao、Xiao He),arXiv 2610.23479(v2 2026-10-20)。这是 2026 下半年「coding agent 进具身」赛道最完整的一份实测:不改模型、不训练、不收集演示,所有「学习」都沉淀为一个个带单元测试的小工具,官方评测由 benchmark 团队本人执行(防作弊设计相当讲究)。
📄 论文信息
- 标题:HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
- 机构:HexaFuture
- 时间:2026-10(arXiv 2610.23479 v2,2026-10-20);code github.com/HexaFuture/HexaShell
- 关键词:薄转向架(thin harness)、coding agent、工具演化(tool evolution)、三角测量 3D(无深度输入)、acting agent / optimizer agent、单元测试、RoboDojo、冻结复测(frozen retests)
- 一句话总结:「学习」被重新定义成「写代码」。acting agent 执行episode、optimizer agent 读失败记录修工具(每平均 6.3 分钟一轮);工具只允许用「真机器人也有的输入」(RGB、相机标定、双臂状态),所以能跨本体迁移;提交评测前把工具冻结,在隐藏种子上复测——排行榜不奖励「边测边学」。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| RoboDojo 官方隐藏种子评测 | 46.9% SR / 53.2 progress | 42 任务 × 50 episodes,官方榜第一 |
| 无工具同模型(GPT-6-Astra) | 22.5% / 28.97 | +24.4 pp 全部来自工具 |
| 最强学习型对手 | WorldScape-R2SI 39.4% / 46.6 | 一个被 agent 指挥的 WAM |
| 任务类型分布 | Memory 81.0% ↑↑ / Open 55.3% / Gen 34.5% / Long-Horizon 31.5% / Precision 32.0% | 卡在接触类任务 |
| 杂乱布局保留率 | 82%(31 个学习型 policy 中位数 20%) | VPP2 46.4→12.6 |
| 演化成本 | 769 轮 optimizer(中位 17/任务);失败轮 ~6.3 min;~78,000 行 Python / 327 个命令 | 每任务预算 12 h × 1×4090 |
| 三角测量 vs 深度网络 | +8.7 分(McNemar 57 胜 / 23 负,p<0.001) | 同一模型同一 harness |
| 真机迁移 | 2× PiPER X(非仿真 ARX X5) | 改动只在「换臂型号」一处 |
🧭 读前 5 分钟:六个概念
- RoboDojo:2026 年的旗舰仿照 benchmark——42 个双臂任务(Isaac Sim 5.1、ARX X5),分 Generalization(12 任务,每个带 +13~18 个杂物对象的 cluttered 变体)、Memory、Long-Horizon、Precision、Open 五组;每任务 3 个种子(每种子 30–75 个布局),每条任务有 action 步数预算(200–1900 步),官方评分器逐帧判分。裸的 GPT-6-Astra 用 benchmark 官方的固定 harness就能拿 22.5%。
- Thin harness(薄转向架):给 agent 的只有「一条命令行 + 一页说明书」。harness 只把命令翻成关节运动(move ≤0.20 m/轴、rotate ≤90°/轴、point 选机械指方向、gripper/home/wait/obs/status/done),每条命令回 JSON(planning verdict、reached pose、剩余预算)。容器里没有 simulator、没有 API key、没有主机目录——基线输出通过 egress 代理打模型 API,其余全部被拒。
- 为什么「不用深度图」:单目深度网络的 scale 需要外部修正,即便用桌面校准,Depth Anything V2 在 RoboDojo 场景头相机中位误差 41 mm、腕相机 ~100 mm——而抓取/放置要 ~1 cm。三角测量则没有这个下限:已知平面上的点 = 光线与平面交点;两个相机都看到的点 = 两条光线交点。
- 两个 Agent 的分工:acting agent(标准 coding agent CLI)在容器里写代码/跑测试/发命令;失败后 optimizer agent 读完整 episode 记录(每条命令、每帧、每条报错)、定位原因、改一个工具 + 单元测试,然后同一布局重跑。一失败轮中位 6.3 分钟(90% 不到 11 分钟)、中位 16 条 shell 命令、92% 的轮次跑了测试。
- 冻结复测:工具在 seed 0 的前 10 个布局上开发,之后冻结、不再修改;官方评测在隐藏种子上由 RoboDojo 团队跑;开发还每 10 布局在 10 个新布局复测。防作弊三件套:官方 checker 判分、delivery check 禁止 interface.md 提到任务/物体名、审计(对比工具代码里的字面量与任务定义/日志,7 个任务因为藏着固定物体几何被清零重测)。
- EpisodeAPI:工具的出参=关节角、TCP 位姿、三张 RGB+标定、运动原语;不能 import simulator、不能读物体真值。测量的命令不消耗步数、动臂的命令照走预算——「看」免费、「动」花钱。
🛠️ 方法:一条命令行 + 两个 Agent + 一套工具
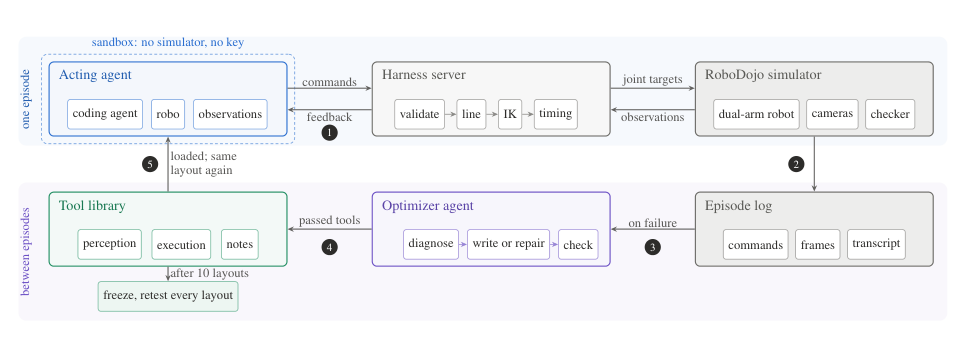
Harness 细节
- 输入:obs/ 目录按需刷新——三张 640×480 RGB(头相机 + 左右腕相机)、每相机内参和世界位姿、双臂 TCP 位姿和关节角。没有深度图。
- 运动管线:命令 → 2 cm 间距直线 Cartesian 插值 → 每路点 cuRobo IK → 梯形速度剖面计时 → 25 Hz 采样 → 官方 take_action。没有运动规划器、没有碰撞模型(除机器人+桌面)。可交互预算:每 episode ≤60 条命令;仿真只在命令执行时走表,「思考不花钱」。
- 双执行器:direct executor(同进程跑 RoboDojo 环境,能 reset/replay、把真值写进容器永远读不到的字段)与 bridge executor(官方评测客户端包同一 server)。接口一样,所有交付的工具必须在 bridge 下能跑。
测 3D 的三种约束
- table_plane(共享工具):每 episode 首次调用、零步成本——候选高度逐一把相机 A 的图按平面 warp 到相机 B,保守「两图最一致」的高度;三个相机对值误差 ≤1 mm(0.7646–0.7656 m)。
- 已知高度的平面:物体的顶面、碗沿、盒子槽位都在水平面上——高度测过一次,其上任何像素的光线就能交出 3D 点。
- 第二视角:两个相机看到同一点 → 两条光线交点。对应像素由 acting agent 手指认,或由工具做 template/contour/圆拟合。需要时「把腕相机移过去再测」——主动感知是用动作预算换取精度。
工具与演化回路
每个工具 = tool.py + interface.md(声明名字、子命令、参数与 run(api, command, args))。共享池只放 pick 和 table_plane 两个永不修改的工具;其余全部 task-specific。回路:acting agent 在 seed 0 前 10 布局上逐个试 → 失败 → optimizer 诊断+修工具(≤5 次/布局)→ 10 布局过后 consolidation、冻结、在 10 开发布局 + 10 新布局复测。一组两份笔记:公开任务定义写的「checker 要求」(25 任务,optimizer 每轮可见,acting agent 看不见)。
Open 任务的单一配置
8 个 Open 任务只在评测时见、从未在开发中出现:所有任务共用一份说明 + 一套从其余 34 任务抽来的工具(scene 定位工具:用桌面颜色模型分离物体、按关节角遮掉双臂、再在双视角平面扫描里找出顶高/脚印/转角;8 个共享技巧:平面上的点/轮廓、容器沿、护位抓取与按压、有界转角、传送带上的定时抓取;额外命令 goto/reach;acting agent 保持一个跨命令的 Python 会话,内含光线/投影/三角测量 helper)。8 个 Open 任务 50% 出头的表现就是在「零实验设定」下拿到的。
🧪 官方评测与五组分数
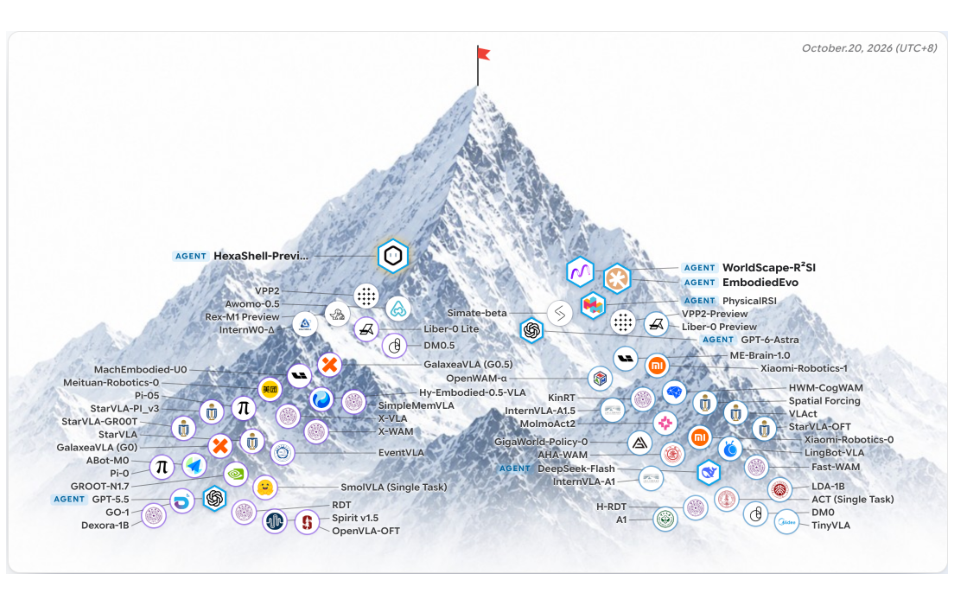
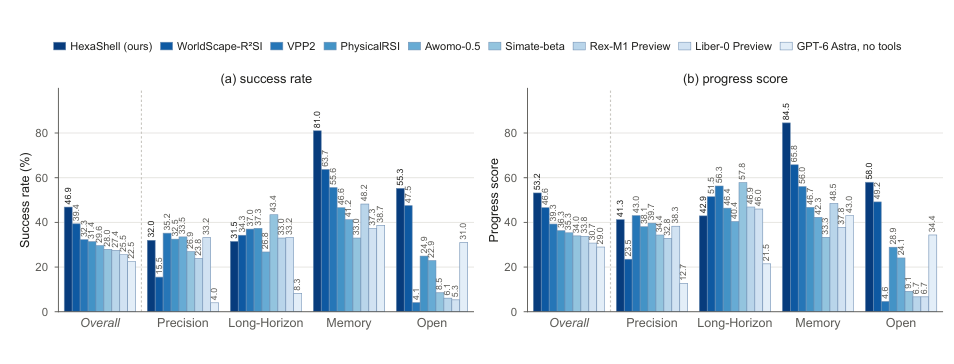
官方隐藏种子、每任务 50 episodes:HexaShell 46.9% / 53.2,超过 WorldScape-R2SI(39.4/46.6,agent 指挥的 WAM)、VPP2(32.3/39.3,纯 WAM)、PhysicalRSI(31.4/36.3,agent 指挥的 VLA)等 31 个学习型 policy 与 GPT-6-Astra 裸 harness(22.5/28.97)。54 个变体的平均:41.9%,对面 VPP2 30.6、PhysicalRSI 26.1、裸模型 24.3;与 VPP2 相比 28 个变体更高(中位 +40)、20 个更低(中位 −31);2 个变体全过(cover blocks、标准版 push T)、11 个为 0。
分类成绩:Generalization 34.5%(标准 38.0 → cluttered 31.0,保留 82%)——学习型 policy 走过杂乱场景的中位保留率只有 20%(VPP2 46.4→12.6);原因是「agent 指一个像素、工具只测那个物体」,场景里多出来的东西不干扰测量,除了布料(fold clothes 56→24,颜色连通性被旁边物体破坏)。Precision 32.0% 由三角测量的精度上限卡住(见下);Memory 81.0% 和 Open 55.3% 正是「读场景、记住状态」的强项(最强学习型 memory 63.7、Open 47.5)。
三角测量 vs 深度网络(Table 1,同 harness 同模型同回路)
| 任务类型 | 三角测量 (SR/Progress) | Depth Anything V2 | 渲染深度(真值) |
|---|---|---|---|
| Generalization | 34.2 / 37.7 | 26.7 / 30.0 | 45.4 / 51.5 |
| Precision | 21.3 / 28.4 | 7.5 / 11.9 | 41.3 / 47.3 |
| Long-Horizon | 18.8 / 32.2 | 13.8 / 29.2 | 32.5 / 44.2 |
| Memory | 73.3 / 73.3 | 55.0 / 58.0 | 66.6 / 66.6 |
| Open | 43.8 / 46.6 | 45.0 / 48.1 | 58.5 / 60.7 |
| 榜单均值 | 38.3 / 43.6 | 29.6 / 35.4 | 48.8 / 54.1 |
| 420 布局 McNemar | +57 / −23 | (p<0.001) | – |
渲染深度(simulator 真值)仍然比三角测量高 10.6 分——差值几乎全在精密插入。而深度网络这条线的误差更大:Depth Anything V2 即便用桌面校准,中位误差仍有头相机 41 mm、腕相机 ~100 mm;换 Depth Pro / MoGe 两个版本可以把头降至 20–31 mm,但腕上仍 21–72 mm。抓取要 1 cm,几何没有这个下限。
第二视角的步数代价(Table 2)
| 指标 | 三角测量 | 深度网络 |
|---|---|---|
| 观察步占总执行步 | 3.6% | 0.7% |
| 含观察动作的 episode | 180/420(43%) | 40/420(10%) |
| 成功数(420) | 152 | 118 |
| 成功率步数预算用完的失败 | 189/268 | 228/302 |
| 在带观察的 180 布局上成功 | 39 | 22 |
「看」是值得的:在付出观察的 180 布局上三角测量成功 39 vs 深度网络 22(离散对 22:5,p=0.002);而 ends-by-limit 的失败反而更少(20 vs 26)。代价集中:egg carton 40% 步数、coin 槽 16%——这两类观察动作性价比最低,任务都没成功;红利也集中:play Xylophone 花 17% 步数从 0 → 6 个布局、push T 花 8% 从 4 → 10。
真机迁移
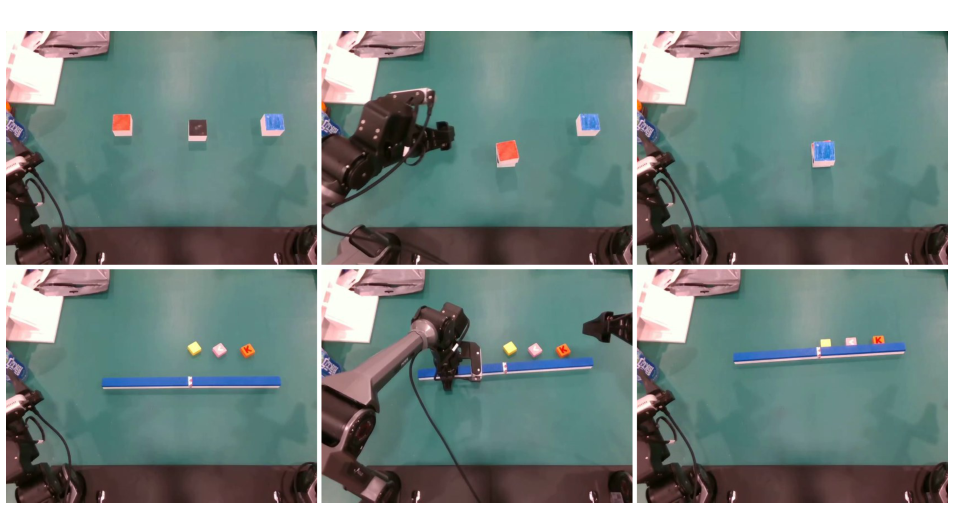
运行时工具只读「RGB + 相机标定 + 双臂状态」,真机也满足同一份输入。作者在 RoboDojo 仿真场景之外搭了一套 2 台 PiPER X(与仿真的 ARX X5 不同型号),工具只改了「换臂型号」一处就能在真机开跑:一集堆三块成一塔,另一集沿横杆排三个字母块。没有一次需要为「信号只有仿真才有」而重写工具——这是整套设计的底色。
🗺️ 能力地图:卡在接触,不在推理
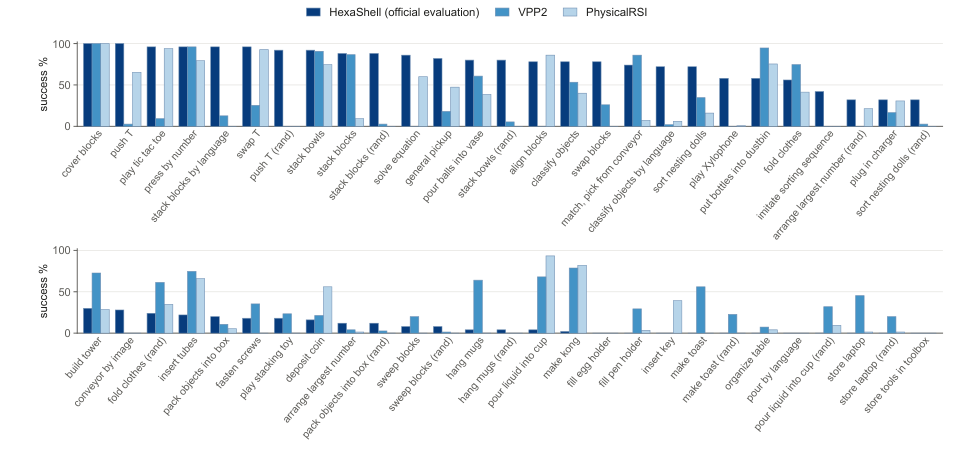
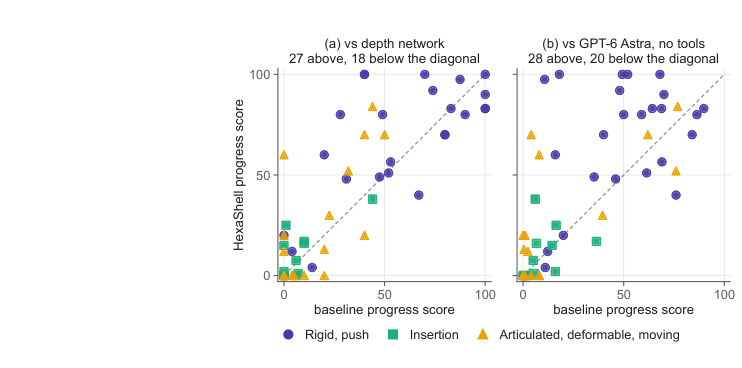
论文给每个任务打两个标签——物理标签(R 刚体抓放堆叠 / Pu 推滑压 / In 紧插入 / Ar 铰接·工具使用 / Df 可变形·流体 / Mv 自动移动物)与决策标签(G 纯几何 / S 符号·语言·类别 / M 记忆)——然后归组平均(Table 3):
| 物理类别 | 变体数 | 无工具 | DN | 三角(ours) | VPP2 | 归零变体 |
|---|---|---|---|---|---|---|
| R 刚体抓放 | 22 | 36.9 | 44.1 | 50.0 | 30.0 | 3 |
| Pu 推滑压 | 4 | 60.0 | 67.5 | 92.5 | 24.7 | 0 |
| Mv 移动物 | 2 | 33.0 | 30.0 | 40.0 | 43.0 | 0 |
| In 紧插入 | 12 | 1.7 | 1.7 | 8.3 | 28.1 | 7 |
| Df 可变形/流体 | 6 | 26.0 | 30.0 | 33.3 | 49.4 | 2 |
| Ar 铰接/工具 | 8 | 2.0 | 0.0 | 7.5 | 21.6 | 7 |
| 决策 = M 记忆 | 6 | 38.7 | 55.0 | 65.0 | 55.6 | 0 |
物理约束决定上限:推 92.5%、刚体 50%——「推滑压」的正解可以由「测出的几何」直接算出;而紧插入需要孔与零件在同一帧内对齐到毫米(头相机一像素 ≈ 2–3 mm, resolving 孔的腕相机视角还必须在夹着零件时才有效)。决策载荷分量小——S 类 18 个变体反而比 VPP2 高 17 分(14.4 vs 31.1)。
失败模式的诊断价值(420 次 retest 中 268 失败):57% 预算耗尽——agent 看得见进度不对、能重试,就是「执行做不到」(物理差距在执行);30% 宣称完成但 checker 不认——感知/理解差距(D 类 memory 任务里一半是这种);13% 主动放弃(Mv 类的典型行动:被等待物过去了就放弃)。两种失败分开就对症下药:前者需要 hand-in-hand 的接触中测量工具,后者需要说明/检查器更细。
🔬 七个 case study:一次失败 → 一轮修 → 下一次过
769 次 optimizer 轮中的 530 次跟着失败(195 跟成功、42 收尾),以下 7 个被论文挑出来(其中 5 个 optimizer 只看数字不看图!):
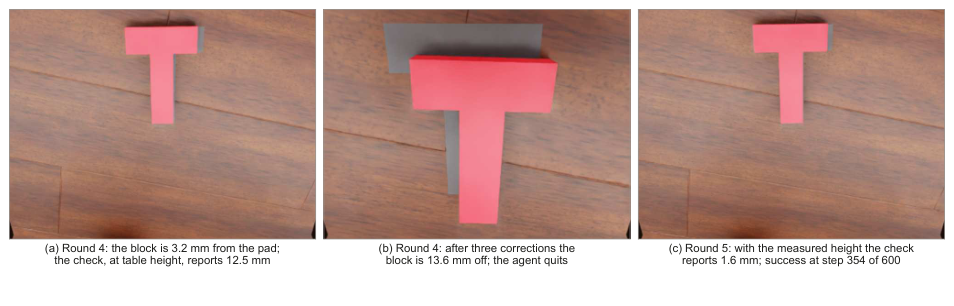
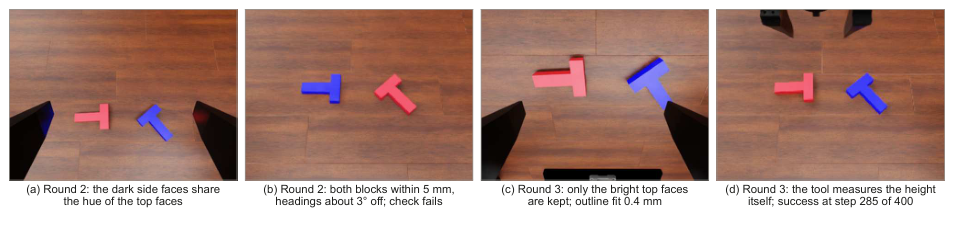
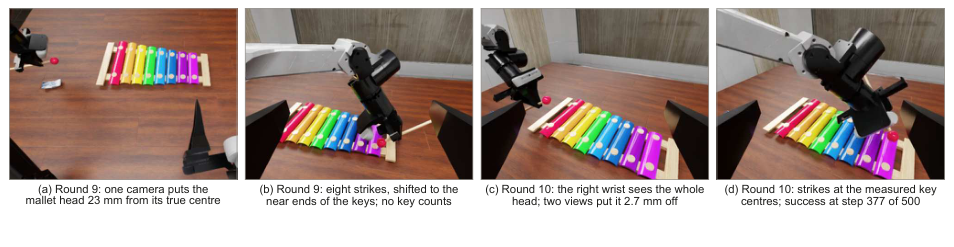
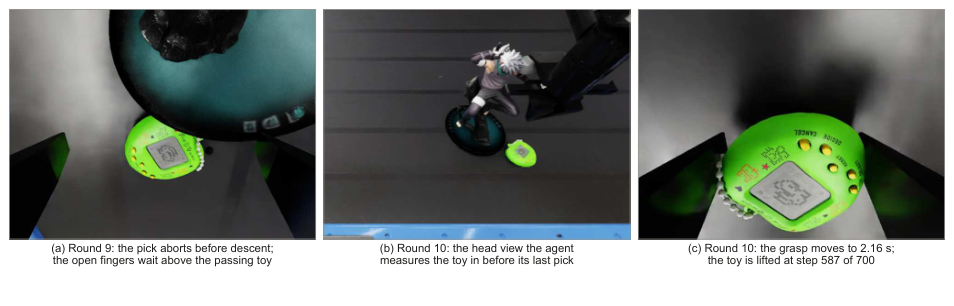
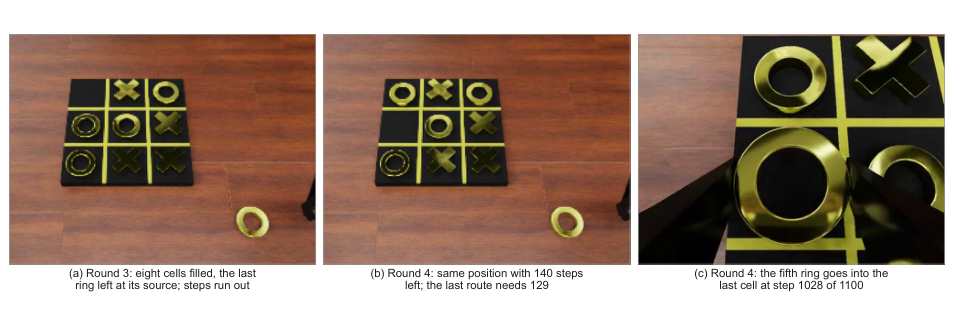
| 案例(类别) | 失败原因 | 修法(代码变化) | 下一轮 | 冻结复测 |
|---|---|---|---|---|
| Push T (Pu) | 高度命令 10 次请求都被拒:面积比对按「数格子」算,宽相机像素少 | |||
| 用像素在平面上的 footprint 面积代替(+49/−11,7 min) | 高度 0.780 m、释放 1.6 mm、step 354/600 | 10/10 | ||
| Swap T (R,M) | 颜色 mask 把亮顶面和暗侧面混到一起(同色系) | |||
| 按色相匹配、只留亮顶面(+75/−5,8 min) | 转角 126.2°、step 285/400 | 10/10 | ||
| Play Xylophone (Ar) | 单相机估「被举着的球锤头」差 22.9 mm | |||
| 在另一相机找同球 + 三角测量,找不着宁 fail 不猜(+109/−7,5 min) | 2.7 mm 偏差、step 377/500 | 6/10 | ||
| 传送带取件 (Mv) | 定时日程 0.80 s,但手臂转到位要 1.56 s → 两次 abort 后裸抓 | |||
| 抬前先估动作耗时,不够就把闭合时刻后移(+132/−5,6 min) | 2.16 s closing、step 587/700 | 7/10 | ||
| Tic tac toe (R,S) | 每次传换先在 home 转手腕,11 步×5 次浪费不少步数 | |||
| 边走边转的路径规划(+194/−5,11 min) | step 1028/1100 仅剩缓冲 | 9/10 | ||
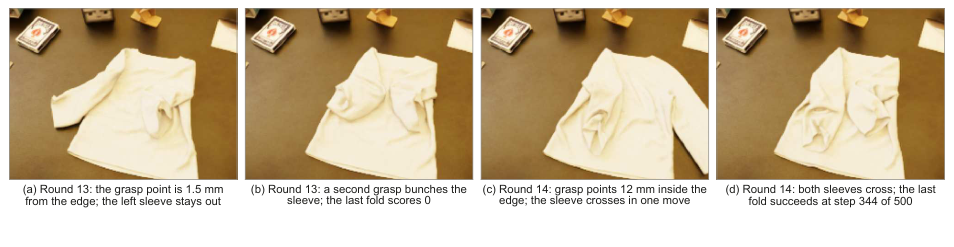
| Fold clothes (Df) | 抓点离布边 1.5 mm,夹到袖口边 | |||
| 在桌面上网格搜索留 12 mm 布边(+112/−12,9 min) | 袖子一笔划过、step 344/500 | 6/10(fail) | ||
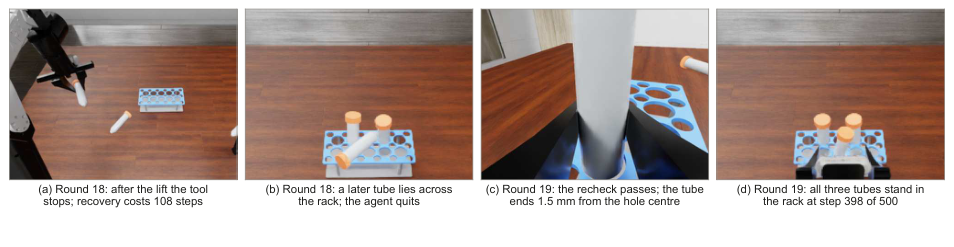
| Insert tubes (In) | 抬起后 fallback 把 28,935 个未测深度的体素当成阻碍,两条迂回路径全被 IK 拒了 | |||
| 首选路径被拒时回头用已达关节复检原路径(+69/−3,5 min) | 第一管落孔差 1.5 mm、step 398/500 | 3/10 |
案例能看出来的模式:7 个案例里 3 个修「测量」(push T / swap T / xylophone)、2 个修「时机」(传送带日程 / tic tac toe 路径)、1 个「抓哪儿」(fold clothes)、1 个「何时放弃」(insert tubes)。optimizer 的证据几乎全是数字(步数、拒绝理由):7 个案例里只有 swap T 分析过失败那一帧,fold clothes 是在自己的存档测试图上跑代码验证,其余 5 个连图都没看——像程序员读 bug report 的习惯。
值得注意的是 7 个案例里 fold clothes 的下一轮过了但冻结复测失败(这个布局差 8 pt)——「工具修好了特定 failure mode」不等于「任务全谱覆盖」,作者在 Tab 4 里如实标出。
💡 评析:三个亮点,四条边界
三个亮点
- 证明了一个反直觉命题:在同一 benchmark、不训练不演示,把「学习」换成「写工具 + 单元测试」就能从 22.5% 提到 46.9% 并压过 31 个学习型 policy。经验的持久形态是代码——失败轮平均只花 6.3 分钟、中位改动 +118 行。
- 「跑得起来」的工程洁癖:sandbox 无真值、官方 checker 判分、冻结复测、audit 把藏常数的 7 个任务清零重测并如实写进论文。这种自证清白的严谨在排行榜论文里很难得——每一个数字都可以被第三方复现(工具已开源)。
- 失败模式的「分诊」有学术价值:failed episode 的日志不只做 harness 的 input,还成为他评测论文的方法论 —- 归类到「预算耗尽/误宣完成/主动放弃」三类。这个设计被 afterwards 引用烂了:它把「感知差距 vs 执行差距」变成可量化指标。
四条边界
- 接触是真正的天花板:In/Ar 类 20 个变体里 14 个归零;push T 满分、插入 8.3%——「预先规划工具」在自由度不明的接触动力学面前还是脆的。下一步需要「夹持中仍能测量」(in-hand 深度/触觉)。
- 每任务 12 小时的开发预算是隐性成本:42 任务 × 12 h × 4090 ×(769 轮 × GPT-6-Astra token)不便宜——「无训练」≠「无成本」,论文没有换算总费用与总得分。
- 开环规划的固有缺陷:fold clothes 无工具版(72%)反而高于工具版(50%)——固定工具定死一条方案,而 agent 一步步观察纠错在软体上更稳。「预规划」与「逐步校正」的 trade-off 论文坦白承认。
- Open 任务设置只有一套 50 布局的评测:从工具的「单点大纲」看打开谱系还有相当大的未知性(8 任务共享一个说明,靠 scene + 8 共享技巧撑起 55.3%)。
🗺️ 在「工具/agent 谱系」里的位置
| 路线 | 代表 | 做法 | 与本文关系 |
|---|---|---|---|
| 每指令生成一次性代码 | Code as Policies / VoxPoser / ReKep | 程序随指令生成、用后即丢(人写原语) | 被 HexaShell 翻转分工:agent 写原语、每次指令只写短程序 |
| 前沿 VLM 直接当 policy | GPT-6-Astra(官方固定 harness)/ Show-Harness / Agent as Policy / VIA | 无独有工具的 VLA 式驱动 | 基线(22.5%) |
| coding agent 工具圈 | Voyager / Toolformer / LATM / CRAFT / AI Scientist | 写工具+选工具 | 家族同行(本文把 scaffold 冻住、只改任务工具) |
| 同类同期工作 | URAI / Gao et al. 2609.35432 / MEMENTO / RAPID / Encore | 物理 coding agent、代码记忆演化 | 并行竞品(本文给出唯一一个官方榜单 SOTA 量化) |
| 学习型对照组 | VPP2 / WorldScape-R2SI(WAM)/ PhysicalRSI(VLA) | 演示训练 | 强弱互补(插入/软体强者 vs 几何/记忆强者) |
延伸:《WorldOracle 精读》(拿同一视角审视 WAM 的「成绩单」)、《UniWAM 精读》、《LoopWAM 精读》、《PrismWAM 精读》、《LIBERO 精读》、《WAM 世界行动模型全景分析》。
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 总览:失败 → 工具;强项/弱项 | 开篇 |
| Fig 2 | 官方 leaderboard | 官方评测 |
| Fig 3 | 分类型对比条形图 | 官方评测 |
| Fig 4 | 系统结构:episode 内与轮间闭环 | 方法 |
| Fig 5 | 真机:2× PiPER X 堆塔 + 排字母块 | 真机迁移 |
| Fig 6–12 | 七个 case study 截图 | 案例 |
| Fig 13 | 逐执行变体成功率 vs VPP2/PhysicalRSI | 能力地图 |
| Fig 14 | progress 分散点(vs DN / 无工具) | 能力地图 |
表格:Table 1 三角测量 vs DN vs 渲染深度;Table 2 第二视角成本;Table 3 能力地图 + 失败模式;Table 4 七个 case 的复测;Table 5 42 任务全表;Table 6 工具代码量/轮数/观察占比;Table 7 checker note 的提升案例。
❓ 自测 Q&A
Q1:为什么坚持不用深度图也不给模型打真值? A:两条规则:一是精度物理——桌面校准后的单目深度在腕相机(决定抓取精度的视角)误差 ~100 mm,而抓取需 1 cm,几何没有这个下限;二是公平性——不给 sim-only 信号才能原封不动搬到真机。代价是主动感知花步数(3.6% 步数 / 43% episode 有观察动作)。
Q2:optimizer agent 从哪里拿证据? A:episode 日志里的每条命令(含目标、实际可达位姿、拒绝理由)、acting agent 的 transcript、工具代码与单元测试,加上逐条命令的相机帧。7 个案例里 5 个根本没看图,只靠数字流水账就定位了 bug——编程 agent 处理符号化证据的效率在中位 6.3 分钟。
Q3:怎么保证工具没作弊? A:三层防线:(1) sandbox 里没有 simulator/key/真值字段,工具只能用 EpisodeAPI;(2) delivery check 禁止 interface.md 出现任务/物体名(以禁词表强制);(3) 事后审计把工具代码中与任务定义/日志匹配的字面量清零重测——七个任务因为固定物体几何被判处 0/10(重测后真的全 0)。
Q4:三角测量到底准到什么程度? A:三个相机对桌面高度的对齐误差 ≤1 mm(0.7646–0.7656 m);已知平面上的点等于光线-平面交点(误差来自标定+像素);双视角交会视差小则毫米级(xylophone 两束光相距 0.7 mm 时中心误差 2.7 mm)。渲染深度还是高 10.6 分,但那部分差距集中在需要毫米级的插入任务。
Q5:Memory 任务为什么这么强(81%)? A:两个原因:工具把「记住的场景状态」以代码/变量形式显式保留(布局重试时工具直接读自己测过的数据);checker 判定依赖的是几何关系(盖住哪些块、颜色顺序这类),正是「测了什么记什么」的强项。六个 memory 变体没有一个掉到 0——这在 54 个变体、19 个归零的大盘上是罕见的好成绩。
Q6:真机迁移为什么「花大力气不大」? A:真机(2× PiPER X)与仿真(ARX X5)的观察同为「RGB + 标定 + 臂状态」,工具没有读到任何 sim-only 信号;唯一要改的是新臂型号的接口适配。堆三个块成塔 + 沿横杆排三个字母块两个 episode 无需再修工具。
📚 资源与延伸
- 论文:arXiv 2610.23479
- 代码(失败演化出的全部工具):github.com/HexaFuture/HexaShell
- RoboDojo:robodojo-benchmark.com、arXiv 2607.04434(42 任务、双臂、官方 leaderboard 与评测客户端)
- 相近工作:GPT-6 Astra on RoboDojo(arXiv 2609.24170)、URAI / frontier agents write & evolve tools(arXiv 2609.39018)、Self-evolving coding agents(arXiv 2609.35432)、MEMENTO(2607.22832)、RAPID(2609.30249)、Encore(2609.37359)、CaP-X(2603.22435)、World Action Agent(2609.29964)
- 站内延伸:《WorldOracle 精读》、《UniWAM 精读》、《LoopWAM 精读》、《PrismWAM 精读》、《Flash-WAM 精读》、《LIBERO 精读》、《DROID机器人操作数据集精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》