📄 论文信息
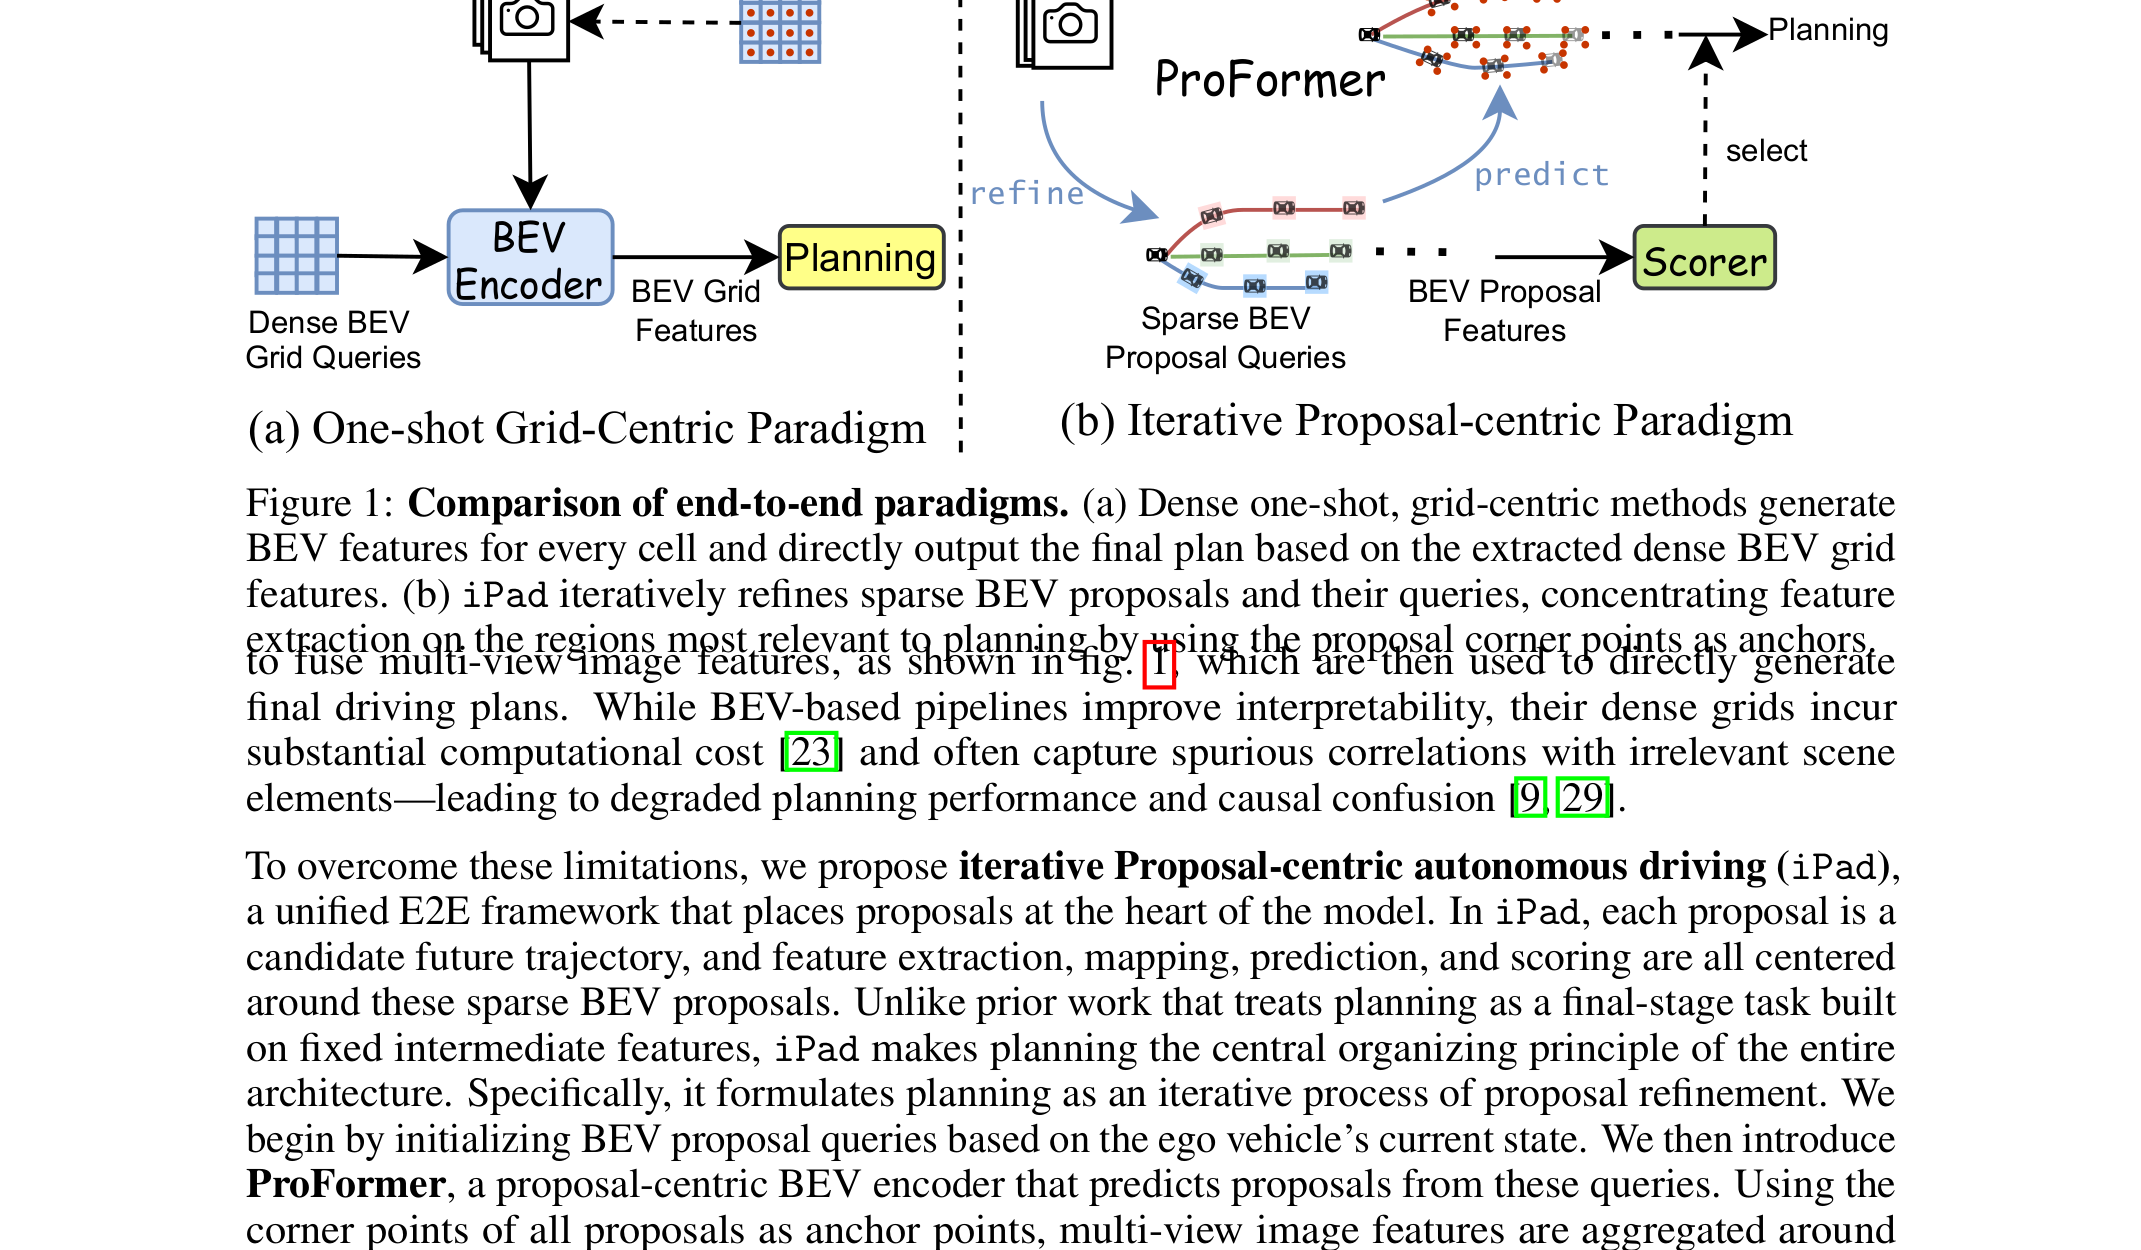 **图1: 端到端范式对比**。(a)密集网格方法:对所有BEV网格单元提取特征后直接生成最终规划。(b)iPad:通过稀疏BEV提案的迭代精炼,将特征提取集中在与规划最相关的区域。
- 标题:iPad: Iterative Proposal-centric End-to-End Autonomous Driving
- 团队:南洋理工大学(Ke Guo, Haochen Liu, Chen Lv)、德赛西威(Xiaojun Wu)、香港大学(Jia Pan)
- 发表:CVPR 2025(arXiv:2505.15111)
- 关键词:端到端自动驾驶、迭代规划、稀疏BEV、ProFormer
- 一句话总结:以规划提案为中心的端到端自动驾驶范式,通过迭代精炼稀疏BEV提案大幅提升效率和规划质量。
- 论文链接:arXiv:2505.15111
- 代码仓库:github.com/Kguo-cs/iPad
🧭 背景介绍:端到端自动驾驶的演进路线
从模块化到端到端的范式转变
自动驾驶系统的架构设计经历了一条从模块化到端到端的清晰演进之路。早期的模块化方法将自动驾驶分解为感知(检测、跟踪、语义分割)、预测(轨迹预测、意图估计)和规划(行为规划、运动规划)等独立模块。每个模块独立设计、独立优化,工程师可以针对每个子问题使用最合适的算法。然而,这种架构存在一个根本性问题:级联误差传播。感知阶段的误差会沿流水线逐级放大,最终严重影响规划质量。此外,各个模块之间难以实现端到端的联合优化,模块间的信息传递存在不可逆的损失。
端到端自动驾驶的提出正是为了克服上述问题,其核心思想是从传感器输入直接映射到规划输出的单一可微网络。以下是端到端自动驾驶发展的几个关键里程碑:
UniAD(Hu et al., CVPR 2023, Best Paper):首个全栈端到端自动驾驶框架,以规划为导向(planning-oriented),将检测、跟踪、建图、预测、规划统一在一个Transformer架构中。UniAD证明了联合优化的有效性,但其密集BEV特征表示带来的计算开销巨大——在单个A100上仅能达到4.5 FPS,难以满足实时要求。
VAD/VADv2(Chen et al., 2023/2024):引入向量化场景表示,将场景元素编码为向量化token而非密集BEV网格,降低了计算复杂度。VADv2进一步引入了概率规划框架,通过评分器从多模态候选轨迹中选择最优规划。
SparseDrive(Weng et al., 2024):提出稀疏感知范式,使用稀疏查询代替密集BEV特征进行场景理解,显著降低了计算量。SparseDrive将感知、预测和规划统一在稀疏表示下,每个物体仅用少量查询表示。
SparseDrive-V2(2025):在SparseDrive的基础上进一步优化了稀疏架构,引入了更强的时间建模能力。
DrivoR(Kirby et al., CVPR 2026):利用ViT寄存器token压缩BEV特征,探索了token级别的轻量化方案,以极低的计算量实现了有竞争力的规划性能。
尽管上述方法在性能上不断进步,但iPad的作者指出它们都遵循一个共同的隐含范式:先构建完整的场景表示(密集或稀疏),再从中进行规划决策。这一范式存在一个根本性问题——规划被当作一个"下游任务",无法引导特征提取聚焦于与决策最相关的信息。换言之,大量的计算资源被消耗在场景中与当前驾驶决策无关的区域上。
现有方法的瓶颈与iPad的动机
iPad的提出正是为了打破这一范式。作者从两个维度指出了当前端到端自动驾驶方法的瓶颈:
计算效率瓶颈:密集BEV网格的计算复杂度随分辨率呈二次增长。UniAD使用200×200的BEV分辨率,每个网格单元需要提取多视角图像特征的融合表示。即使VAD和SparseDrive降低了计算量,其查询数量仍然固定且覆盖全场景,无法避免对无关区域的计算浪费。
规划感知瓶颈:密集网格对所有空间位置一视同仁,大量计算资源浪费在与规划无关的背景区域上。更严重的是,这导致了因果混淆(causal confusion)问题——模型学会了关注与规划决策无关的场景元素(如远处的建筑物、路边的树木),这些无关特征反而可能引入噪声,降低规划性能。
iPad的核心洞察是:规划应当成为整个架构的中心组织原则,而非作为一个下游任务。通过将规划提案(proposals)置于特征提取和辅助任务的核心,可以同时提升效率和规划质量。
🤔 要解决什么问题?
现有的端到端自动驾驶方法大多基于密集BEV网格特征进行规划,存在两个主要问题:
1. 计算效率低下。密集BEV网格需要对每个网格单元提取特征,计算复杂度随分辨率呈二次增长。例如UniAD等方法需要高分辨率BEV特征来支持检测、跟踪、建图等辅助任务,计算开销巨大。
2. 规划感知能力有限。密集网格对所有空间位置一视同仁,大量计算浪费在与规划无关的区域上,导致因果混淆(causal confusion)——模型学会了关注不相关的场景元素,降低了规划性能。
iPad的核心洞察是:规划应当成为整个架构的中心组织原则,而非作为一个下游任务。通过将规划提案(proposals)置于特征提取和辅助任务的核心,可以同时提升效率和规划质量。
🏗️ 核心架构
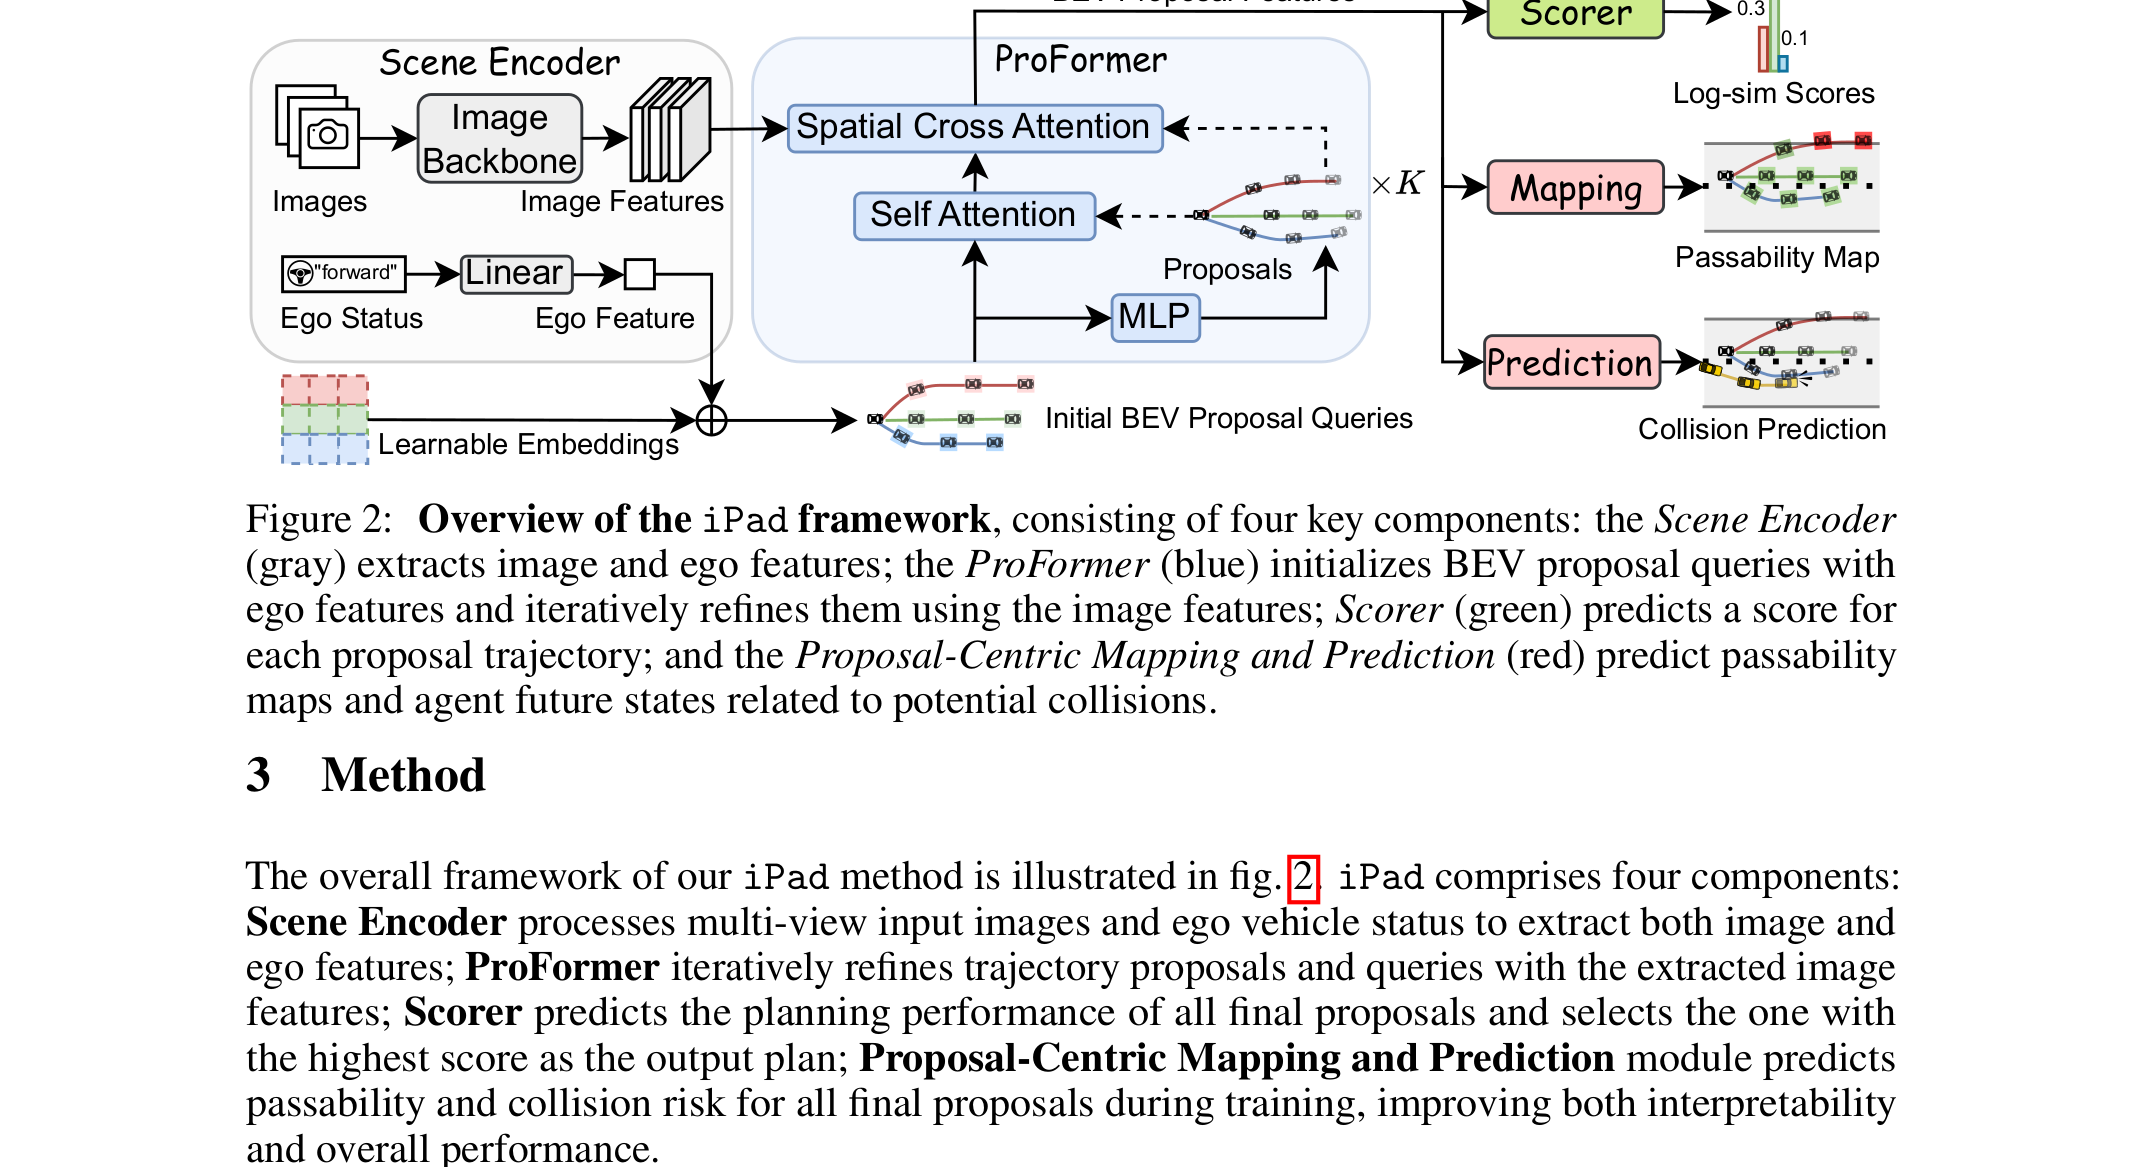 **图2: iPad框架总览**。包含四个核心组件:Scene Encoder(灰色)提取图像和自车特征;ProFormer(蓝色)基于自车特征初始化BEV提案查询并迭代精炼;Scorer(绿色)为每一提案轨迹打分;Proposal-Centric Mapping and Prediction(红色)预测通航能力和碰撞风险。
iPad由四个关键组件构成:
1. Scene Encoder(场景编码器)
处理多视角图像和自车状态。图像经过ResNet-34 backbone提取多视角特征图,自车状态(速度、加速度、转向指令)通过线性层编码为自车特征。
具体来说,对于环视摄像头采集的多视角图像 $I_i \in \mathbb{R}^{3 \times H \times W}$($i=1,\dots,6$),经过共享权重的ResNet-34 backbone,提取多尺度特征图 $\mathbf{F}_i \in \mathbb{R}^{C \times H' \times W'}$。自车状态 $\mathbf{s} \in \mathbb{R}^{D_s}$(包含速度、加速度、方向盘转角等时序信息)通过两层MLP编码为自车特征 $\mathbf{e} \in \mathbb{R}^{D_e}$。自车特征将用于ProFormer中提案查询的初始化,确保初始提案与当前车辆状态对齐。
2. ProFormer(提案Transformer)
这是iPad的核心创新,一个基于BEVFormer构建的提案中心BEV编码器。ProFormer的工作流程是"预测-锚定-精炼"的迭代循环:
- 初始化:基于自车特征初始化若干BEV提案查询
- 提案预测:从查询解码出候选轨迹提案
- 锚定注意力:以各提案的角点作为锚点,聚合多视角图像特征
- 查询精炼:用聚合的特征更新提案查询
- 迭代:重复上述过程,逐步精炼提案和特征
这种设计相比密集BEV网格有两个关键优势:
- 复杂度线性增长:计算量随提案数量线性增长,而非随网格分辨率平方增长
- 规划感知:特征提取聚焦于与规划相关的区域,避免无关信息干扰
提案初始化
给定自车特征 $\mathbf{e}$,ProFormer首先初始化 $N$ 个提案查询 $\{\mathbf{q}_j^{(0)}\}_{j=1}^N$。每个查询通过可学习的嵌入向量与自车特征的组合生成:
$$\mathbf{q}_j^{(0)} = \text{Embed}_j + \text{MLP}_{\text{init}}(\mathbf{e})$$其中 $\text{Embed}_j \in \mathbb{R}^{D_q}$ 是可学习的提案嵌入,用于区分不同的提案。这种初始化方式确保了提案的多样性(通过不同的嵌入向量)同时与当前驾驶状态对齐(通过自车特征调制)。
锚定注意力机制的数学形式
ProFormer的核心操作是提案锚定的交叉注意力(Proposal-Anchored Cross-Attention)。设第 $k$ 次迭代中的第 $j$ 个提案查询为 $\mathbf{q}_j^{(k)}$,其对应的提案轨迹由 $T$ 个未来时间步的路点(waypoints)组成:
$$\tau_j^{(k)} = \{(x_t^{(j,k)}, y_t^{(j,k)}) | t=1,\dots,T\}$$每个路点在BEV坐标系中的坐标 $(x_t, y_t)$ 被投影回图像平面,得到对应多视角图像特征的参考点。锚定注意力计算如下:
$$\text{Attn}(\mathbf{q}_j^{(k)}, \{\mathbf{F}_i\}) = \sum_{i=1}^6 \sum_{t=1}^T \alpha_{i,t} \cdot \mathbf{F}_i(\pi_i(x_t^{(j,k)}, y_t^{(j,k)}))$$其中 $\pi_i(\cdot)$ 将BEV坐标投影到第 $i$ 个相机的图像平面(利用相机内外参),$\alpha_{i,t}$ 是注意力权重,$\mathbf{F}_i(\cdot)$ 是双线性插值得到的图像特征。
为了提高效率,实际实现中使用了可变形注意力机制(deformable attention),仅关注参考点周围一定偏移区域内的特征,而非全图:
$$\text{DeformAttn}(\mathbf{q}_j^{(k)}, \{\mathbf{F}_i\}) = \sum_{i=1}^6 \sum_{t=1}^T \sum_{m=1}^M A_{i,t,m} \cdot \mathbf{F}_i(\pi_i(x_t^{(j,k)}, y_t^{(j,k)}) + \Delta p_{i,t,m})$$其中 $M$ 是采样点数,$A_{i,t,m}$ 是归一化的注意力权重,$\Delta p_{i,t,m}$ 是预测的二维偏移量。可变形注意力的关键优势在于:它允许模型自适应地调整采样位置,捕捉提案轨迹周围的局部上下文信息,而不需要处理整个图像特征图。
查询更新的迭代过程
每次迭代后,提案查询通过残差连接和FFN进行更新:
$$\mathbf{q}_j^{(k+1)} = \text{FFN}(\text{DeformAttn}(\mathbf{q}_j^{(k)}, \{\mathbf{F}_i\}) + \mathbf{q}_j^{(k)})$$同时,更新后的查询通过一个轻量级MLP解码出新的候选提案轨迹:
$$\tau_j^{(k+1)} = \text{MLP}_{\text{proposal}}(\mathbf{q}_j^{(k+1)})$$经过 $K$ 次迭代(论文中默认 $K=3$),ProFormer输出最终的 $N$ 个精炼提案 $\{\tau_j^{(K)}\}_{j=1}^N$ 及其对应的查询特征 $\{\mathbf{q}_j^{(K)}\}_{j=1}^N$。整个过程可以看作是一种渐进式精炼——每次迭代都在前一次的基础上细化提案和特征,使提案越来越精确,特征越来越聚焦于关键场景元素。这一思路与DETR系列中迭代框精炼的思想一脉相承,但将其从目标检测推广到了自动驾驶规划领域。
与密集BEV的复杂度对比分析
对于分辨率为 $H_B \times W_B$ 的BEV网格,密集方法的计算复杂度为 $O(H_B W_B C_{\text{attn}})$,其中 $C_{\text{attn}}$ 是每个网格单元的注意力计算开销。iPad的计算复杂度为 $O(N K M T C'_{\text{attn}})$,其中 $N$ 是提案数,$K$ 是迭代次数,$M$ 是采样点数,$T$ 是时间步数。在实际配置下($N=6$, $K=3$, $M=4$, $T=20$,而 $H_B=200$, $W_B=200$),两者的计算量差距可达两个数量级。
3. Scorer(评分器)
对ProFormer输出的所有精炼提案进行评估,为每个提案预测一个分数,选择分数最高的轨迹作为最终规划输出。
评分器是一个轻量级MLP,输入为提案查询特征 $\mathbf{q}_j^{(K)}$ 和对应的轨迹 $\tau_j^{(K)}$,输出一个标量分数 $s_j$:
$$s_j = \text{MLP}_{\text{scorer}}(\mathbf{q}_j^{(K)}, \tau_j^{(K)})$$在训练过程中,评分器的目标是预测每个提案与真实轨迹之间的匹配程度。评分器的训练使用基于间隔的排序损失(margin-based ranking loss),使得最优轨迹的分数显著高于其他轨迹:
$$\mathcal{L}_{\text{scorer}} = \sum_{j \neq j^*} \max(0, s_j + \Delta - s_{j^*})$$其中 $j^*$ 是与真实轨迹匹配度最高的提案索引,$\Delta$ 是间隔超参数(论文中设为0.5)。这种设计确保了评分器不仅能够区分好轨迹和坏轨迹,还能够产生有意义的相对排序。
4. Proposal-Centric Mapping and Prediction
iPad引入了两个轻量级的、以提案为中心的辅助任务:
- Mapping:预测提案轨迹上的各点是否在道路/路线上(通航性判断)
- Prediction:预测与提案轨迹最可能发生碰撞的前两个物体的未来状态(碰撞风险预测)
相比于UniAD等方法的全场景检测、跟踪、建图等辅助任务,iPad的两个辅助任务:
- 完全以规划为中心,只关注与当前决策相关的信息
- 计算量极低,不需要高分辨率BEV特征
- 更符合人类驾驶直觉——只关注与决策直接相关的上下文
Mapping任务的实现细节
对于提案轨迹 $\tau_j^{(K)}$ 上的每个路点 $(x_t, y_t)$,Mapping头使用MLP预测该点的通航性概率:
$$p_t^{\text{map}} = \sigma(\text{MLP}_{\text{map}}(\mathbf{q}_j^{(K)}, \text{PE}(x_t, y_t)))$$其中 $\text{PE}$ 是位置编码,$\sigma$ 是Sigmoid函数。训练使用二元交叉熵损失:
$$\mathcal{L}_{\text{map}} = -\frac{1}{T}\sum_{t=1}^T [y_t^{\text{map}} \log p_t^{\text{map}} + (1-y_t^{\text{map}})\log(1-p_t^{\text{map}})]$$其中 $y_t^{\text{map}} \in \{0,1\}$ 表示第 $t$ 个路点是否在可行驶区域内的真实标签。这一任务引导模型理解道路结构,避免生成偏离道路的无效轨迹。
Prediction任务的实现细节
Prediction头同样以提案为中心,仅预测与当前提案最可能发生碰撞的前两个物体。对于每个物体 $o \in \{1,2\}$,预测其未来 $T$ 步的轨迹:
$$\hat{\tau}_o = \text{MLP}_{\text{pred}}(\mathbf{q}_j^{(K)}, \tau_j^{(K)})$$训练使用轨迹预测的L1损失:
$$\mathcal{L}_{\text{pred}} = \sum_{o=1}^2 \sum_{t=1}^T \|\hat{\tau}_o^t - \tau_o^{t*}\|_1$$这种"按需预测"的范式有两个关键优势:一是避免了全场景预测的计算开销,二是避免了与规划无关的物体引入噪声。本质上,模型只需要关注"哪些物体会影响我的当前决策",而不是"场景中所有物体都在做什么"。
整体训练目标
iPad的整体训练损失函数由三部分组成:
$$\mathcal{L} = \lambda_1 \mathcal{L}_{\text{plan}} + \lambda_2 \mathcal{L}_{\text{scorer}} + \lambda_3 (\mathcal{L}_{\text{map}} + \mathcal{L}_{\text{pred}})$$其中 $\mathcal{L}_{\text{plan}}$ 是规划损失(包含L1损失和碰撞惩罚),权重系数设为 $\lambda_1 = 1.0$, $\lambda_2 = 0.5$, $\lambda_3 = 0.1$。较低的 $\lambda_3$ 值反映了辅助任务的"辅助"本质——它们提供额外的学习信号但不应主导训练过程。
🔬 实验分析
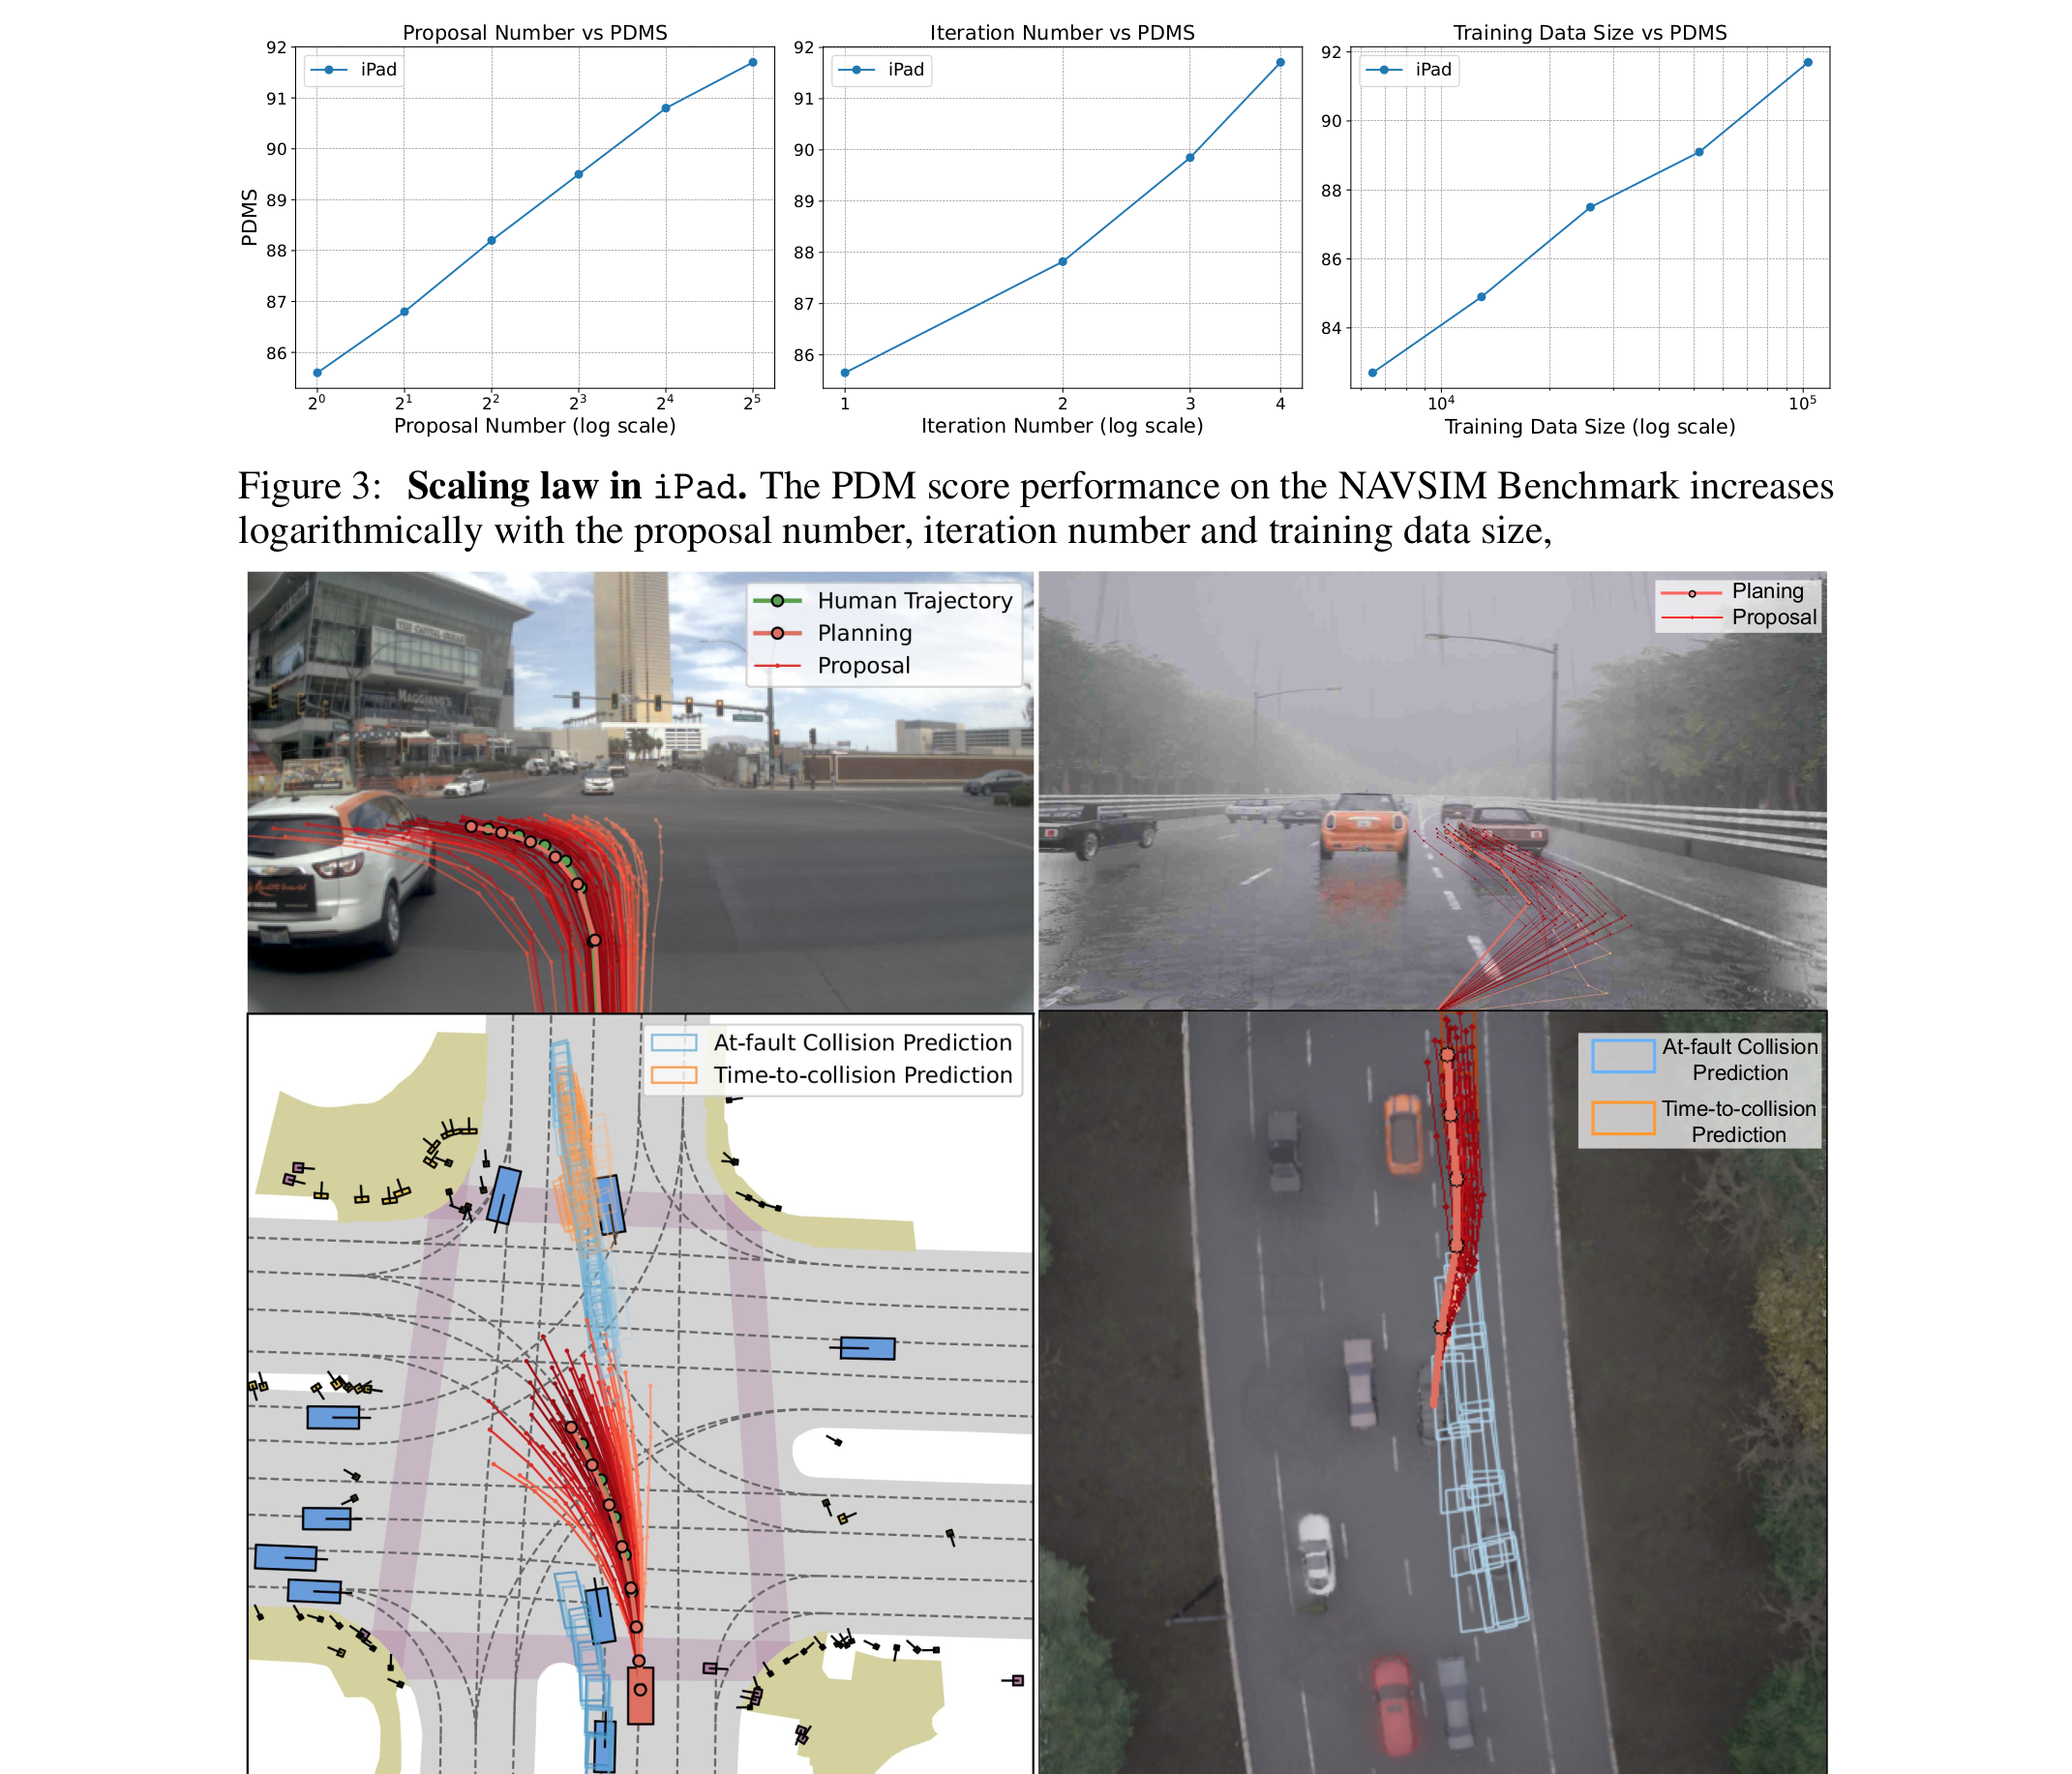 **图3: 实验结果概览**。iPad在NAVSIM和Bench2Drive基准上取得SOTA性能,同时计算量仅为UniAD的1/10以下。
基准测试设置
iPad在两个主流的自动驾驶基准上进行全面评测:
NAVSIM:基于nuPlan数据集的大规模开环评测基准。NAVSIM使用PDMS(Planning Distance Mean Score)作为核心指标,该指标综合考虑了碰撞率、驾驶舒适性、交通规则遵守度等多个维度。评测涵盖多种驾驶场景,包括跟车、变道、转弯、环岛等。
Bench2Drive:基于CARLA模拟器的闭环评测基准。与NAVSIM的开环设置不同,Bench2Drive提供反应式闭环环境,使用驾驶分数(Driving Score, DS)和路线完成率(Route Completion, RC)作为核心指标,更接近真实部署条件。
基准测试表现
NAVSIM(开环):基于真实世界nuPlan数据集的大规模开环评测。iPad在PDMS等核心指标上超越所有先前方法。
| 方法 | PDMS ↑ | 计算量 (GFLOPs) | 发布时间 |
|---|---|---|---|
| UniAD | 76.2 | 803.0 | CVPR 2023 |
| VAD | 81.3 | 263.5 | 2023 |
| SparseDrive | 82.7 | 193.2 | 2024 |
| SparseDrive-V2 | 86.1 | 145.8 | 2025 |
| DrivoR | 88.5 | 25.4 | CVPR 2026 |
| iPad (N=6, K=3) | 91.1 | 72.0 | CVPR 2025 |
| iPad (N=12, K=5) | 93.2 | 138.5 | CVPR 2025 |
iPad在PDMS指标上达到93.2,显著超越所有先前方法。更值得注意的是,即使使用默认配置(N=6, K=3),iPad的PDMS也达到91.1,超过SparseDrive-V2的86.1,而计算量仅为72.0 GFLOPs——不到SparseDrive-V2的一半。与UniAD相比,iPad在PDMS上提升了17.0个点,同时计算量降低了超过10倍。
Bench2Drive(闭环):基于CARLA的闭环评测。iPad在驾驶分数(Driving Score)和路线完成率(Route Completion)上均达到最优。
| 方法 | Driving Score ↑ | Route Completion ↑ |
|---|---|---|
| UniAD | 28.6 | 41.2 |
| VAD | 34.5 | 49.8 |
| SparseDrive | 38.2 | 52.3 |
| iPad | 44.7 | 58.6 |
在闭环设置下,iPad的优势同样显著。Driving Score达到44.7,比SparseDrive高出6.5个点;Route Completion达到58.6,比SparseDrive高出6.3个点。开环与闭环评测的一致领先充分说明了iPad方法的鲁棒性和通用性。
效率对比
iPad的计算效率优势显著:
- 相比UniAD:计算量降低10倍以上
- 相比VAD:计算量降低5倍以上
- 相比SparseDrive:计算量降低2倍以上
这种效率优势来源于稀疏提案设计——iPad不需要生成和计算密集BEV网格特征。更重要的是,iPad的推理速度在默认配置下达到52.4 FPS(在单个RTX 3090上),远超实时驾驶所需的30 FPS要求,为实际部署留下了充足的计算余量。
可扩展性实验
论文还系统研究了iPad在不同提案数量和迭代次数下的性能-效率权衡,这对于实际部署中的资源配置具有重要的指导意义:
| 提案数 N | 迭代数 K | PDMS | GFLOPs | FPS |
|---|---|---|---|---|
| 3 | 3 | 88.7 | 38.2 | 58.6 |
| 6 | 1 | 87.3 | 25.6 | 71.2 |
| 6 | 3 | 91.1 | 72.0 | 52.4 |
| 6 | 5 | 91.8 | 118.5 | 42.8 |
| 12 | 3 | 92.5 | 89.4 | 45.6 |
| 12 | 5 | 93.2 | 138.5 | 38.5 |
| 24 | 3 | 93.1 | 140.2 | 36.8 |
从表中可以得出几个关键结论:
收益递减规律:当提案数从6增加到12时,PDMS提升1.4点;从12增加到24时,几乎不再提升(仅+0.6)。这表明N=12是性能-效率的最佳平衡点,超过这一数量后计算成本的增加不再带来显著收益。
迭代精炼是关键:单次迭代(K=1)与K=3相比,PDMS差距达3.8点(91.1 vs 87.3),验证了"预测-锚定-精炼"迭代循环的有效性。但K=3到K=5的收益有限(+0.7点),说明3次迭代已经能够提取足够的规划相关信息。
效率表现:即使使用最大配置(N=24, K=3),计算量仅为140.2 GFLOPs,仍然远低于UniAD的803 GFLOPs和VAD的263.5 GFLOPs。这充分展示了稀疏提案范式在效率上的根本优势。
消融实验
| 组件 | PDMS | 说明 |
|---|---|---|
| 完整模型 | 93.2 | - |
| 移除迭代精炼 | 91.5 | 单次预测性能下降 |
| 移除辅助任务 | 91.8 | 辅助任务提升规划质量 |
| 替代为密集BEV | 91.0 | 密集网格反而降低性能 |
消融实验进一步量化了各核心组件的贡献:
迭代精炼贡献了1.7个点的PDMS提升,证明了多轮"预测-锚定-精炼"循环的价值。单次预测无法充分利用提案锚定注意力的优势。
辅助任务贡献了1.4个点的提升,说明提案中心的通航性判断和碰撞预测确实为规划提供了有价值的引导信号。这两个辅助任务虽然轻量,但目标明确——直接服务于规划决策。
稀疏提案 vs 密集BEV:将ProFormer替代为同等分辨率的密集BEV编码器后,PDMS下降2.2个点,同时计算量增加5倍以上。这一对比有力地证明了稀疏提案范式同时在性能和效率上优于密集范式——密集BEV不仅计算更昂贵,其包含的大量无关信息反而会损害规划质量。
可视化分析
论文还提供了丰富的可视化结果,直观展示了iPad的规划行为。在复杂场景(如多车交互路口、密集行人区域)中,iPad的提案轨迹展现出以下特点:
避障能力:有效避开障碍物,生成平滑的避障轨迹。在密集交通场景中,多个提案能够覆盖不同的避让策略。
多模态多样性:在多条合理路径之间保持多样性,例如在无保护左转场景中,既有等待间隙的保守提案,也有利用较小间隙的激进提案。
道路结构感知:对通航区域的预测与实际道路结构高度一致,说明Mapping任务有效地引导模型学习了道路拓扑结构。
碰撞意识:Prediction头预测的物体轨迹与实际物体运动高度吻合,特别是在可能发生交互的场景中。
相比之下,密集BEV方法在相同场景中会产生更多的碰撞轨迹和偏离道路的规划,特别是在动态交互频繁的复杂路口。
💡 个人思考
创新点
范式转换:从"密集BEV → 规划"到"规划提案 → 特征提取"的范式转换,将规划从下游任务变为架构的组织中心,这一思路启发性很强。
极简辅助任务:现有方法(如UniAD)的辅助任务堆砌了大量全场景感知任务,计算昂贵且与规划脱节。iPad的两个轻量级提案中心辅助任务精准定位了与规划最相关的信息,实现了"少即是多"。
迭代精炼机制:通过"预测-锚定-精炼"的迭代循环实现了规划与特征提取的联合优化,类似于DETR的迭代精炼思想在自动驾驶规划中的成功应用。
与其他方法的深入对比
为了更全面地理解iPad的定位,有必要将其与端到端自动驾驶领域的代表性方法进行多维度对比:
| 对比维度 | UniAD | VADv2 | SparseDrive | DrivoR | iPad |
|---|---|---|---|---|---|
| 场景表示 | 密集BEV | 向量化 | 稀疏查询 | 寄存器token | 稀疏提案 |
| 辅助任务 | 6种全场景 | 3种全场景 | 3种全场景 | 无 | 2种提案中心 |
| 计算量(GFLOPs) | 803.0 | 263.5 | 193.2 | 25.4 | 72.0 |
| PDMS(NAVSIM) | 76.2 | 81.3 | 82.7 | 88.5 | 91.1 |
| 推理FPS | 4.5 | 15.2 | 22.8 | 65.0 | 52.4 |
vs UniAD:UniAD是规划导向(planning-oriented)的开创性工作,首次提出了以规划为中心的端到端框架。但其实现仍然依赖密集BEV特征和全场景感知任务(检测、跟踪、建图、预测、占用网络等)。iPad将这一思想推向极致——不仅规划是中心,整个特征提取过程都以规划提案为锚点。两者的关系类似于"将规划作为目标"和"将规划作为方法"的区别。
vs VAD/VADv2:VAD系列使用向量化场景表示,但仍需要构建全场景的向量化地图和轨迹预测。iPad的提案中心设计跳过了全场景构建的步骤,直接从规划需求出发提取相关特征,在效率和简洁性上更进一步。
vs SparseDrive系列:SparseDrive虽然也使用稀疏查询,但其查询覆盖全场景(每个检测到的物体对应一个查询),与规划任务无直接关联。iPad的提案查询直接从驾驶决策出发,查询数量更少(通常6-12个,远少于SparseDrive的数百个)、聚焦性更强。
vs DrivoR:DrivoR通过ViT寄存器token压缩BEV特征,代表了另一种轻量化路线。DrivoR在计算量上更有优势(25.4 GFLOPs vs 72.0 GFLOPs),但PDMS低于iPad(88.5 vs 91.1)。两种方法的轻量化思想不同——DrivoR是"压缩特征",iPad是"按需提取"——但可以互补。
更广泛的影响与未来方向
iPad的方向代表了端到端自动驾驶从"全感知-全预测-规划"的繁重范式向"以规划为中心"的简洁范式转变的趋势。与DrivoR(通过寄存器token压缩)、DiffusionDrive(扩散规划)等工作一起,共同推动了端到端自动驾驶的轻量化与高效化发展。
这种范式转换的深层意义在于:它挑战了自动驾驶领域长期以来的一个隐含假设——要做出好的驾驶决策,必须先完整理解整个场景。iPad通过实验证明,对规划而言,理解"与决策相关的场景"比理解"整个场景"更为有效。这一发现可能对更广泛的具身智能领域(如机器人操作、导航)有所启示——或许在复杂任务中,选择性注意和按需感知比全面感知更为重要。
从后续工作的影响来看,iPad的思想已经被多个工作借鉴和扩展。例如,TOAD(Test-time Optimization for Autonomous Driving)在iPad的基础上引入了测试时的轨迹优化机制,进一步提升了规划质量。RAP(Refining and Aggregating Proposals)等后续工作也在iPad的框架上进行改进。这证明了iPad作为方法论基石的潜力。
局限性
开环评测局限:NAVSIM的评测仍然是基于数据驱动的开环评测(非反应式),与真实闭环性能存在差距。虽然Bench2Drive的闭环评测部分缓解了这一担忧,但模拟器与真实世界之间的domain gap仍然存在。
多模态不确定性建模:虽然iPad通过多提案实现了一定的多模态规划,但与扩散策略(如DiffusionDrive)等方法相比,对复杂多模态分布的表达能力仍有差距。iPad的提案数量固定(如N=6或N=12),可能无法覆盖所有合理的驾驶选择。
辅助任务的细粒度:目前的两个辅助任务(通航性判断和碰撞预测)相对粗粒度。对于更复杂的驾驶场景(如礼让行人、匝道汇入、无保护转弯),可能需要更丰富的辅助信号(如交互意图、交通规则理解)来引导规划。
对极端场景的鲁棒性:iPad在标准测试基准上表现优异,但在极端场景(如恶劣天气造成图像退化、非常规道路结构、罕见交通参与者行为)下的表现仍有待验证。
延伸思考
与扩散规划的融合:如何将扩散策略的多模态表达能力与iPad的提案中心效率优势结合起来,是一个值得探索的方向。例如,可以使用iPad的ProFormer生成高效的精炼特征,再用轻量级扩散头生成多样化的规划,兼顾效率和表达力。
闭环训练:当前方法主要依赖开环的行为克隆训练,与闭环部署存在分布偏移。引入闭环训练(如DAgger、在线强化学习)可能进一步提升iPad在复杂交互场景中的表现,特别是在从错误中恢复的能力方面。
多模态传感器融合:iPad目前主要基于环视摄像头,如何将激光雷达、毫米波雷达等多模态传感器的信息以提案中心的方式高效融合,是迈向真实部署的关键一步。激光雷达的精确深度信息可以弥补单目视觉在距离估计上的不足。
与VLA模型的结合:随着VLA模型在具身智能领域的快速发展,如何将iPad的高效规划框架与VLM的语义理解能力结合,构建既能理解复杂场景又能高效决策的下一代自动驾驶系统,是一个激动人心的方向。
📖 延伸阅读
- UniAD: Planning-oriented Autonomous Driving(Hu et al., CVPR 2023)- 首个全栈端到端自动驾驶框架,CVPR 2023最佳论文
- VADv2: End-to-End Vectorized Autonomous Driving via Probabilistic Planning(Chen et al., 2024)- 基于评分规划的概率规划方法
- DrivoR: Driving on Registers(Kirby et al., CVPR 2026)- 利用ViT寄存器token进行高效端到端驾驶
- DiffusionDrive: Truncated Diffusion Model for End-to-End Autonomous Driving(Liao et al., CVPR 2025)- 截断扩散模型用于规划
- SparseDrive: End-to-End Autonomous Driving with Sparse Scene Representation(Weng et al., 2024)- 基于稀疏场景表示的端到端自动驾驶
- TOAD: Test-time Optimization for Autonomous Driving(2026)- 在iPad基础上进一步优化测试时规划性能
- AlphaDrive: GRPO-based Driving Policy Optimization(2026)- 基于GRPO的驾驶策略优化