1. JEPA 架构:世界模型的底层范式革命
1.1 起源:LeCun 的 2022 年蓝图
2022 年,Yann LeCun 发表位置论文《A Path Towards Autonomous Machine Intelligence》,提出了一个完整的 AI 架构蓝图。JEPA(Joint Embedding Predictive Architecture)是其中的核心——一个用于构建世界模型的自监督学习框架。
核心理念:智能的本质不是模式匹配,而是拥有一个世界模型——能够在抽象空间中预测行为后果的内部模型。
1.2 JEPA 的核心机制
JEPA 的架构围绕三个组件构建:
| 组件 | 作用 | 架构 | 参数更新 |
|---|---|---|---|
| Context Encoder | 编码观测信息 → 隐空间表征 | ViT | 梯度下降 |
| Target Encoder | 编码待预测目标 → 真实表征 | ViT(与 context 同结构) | 动量更新(EMA) |
| Predictor | 从 context 预测 target 表征 | 轻量 Transformer | 梯度下降 |
训练目标仅在隐空间计算:$\mathcal{L} = \|\text{pred} - \text{sg}(\text{target})\|^2$。从不预测像素。
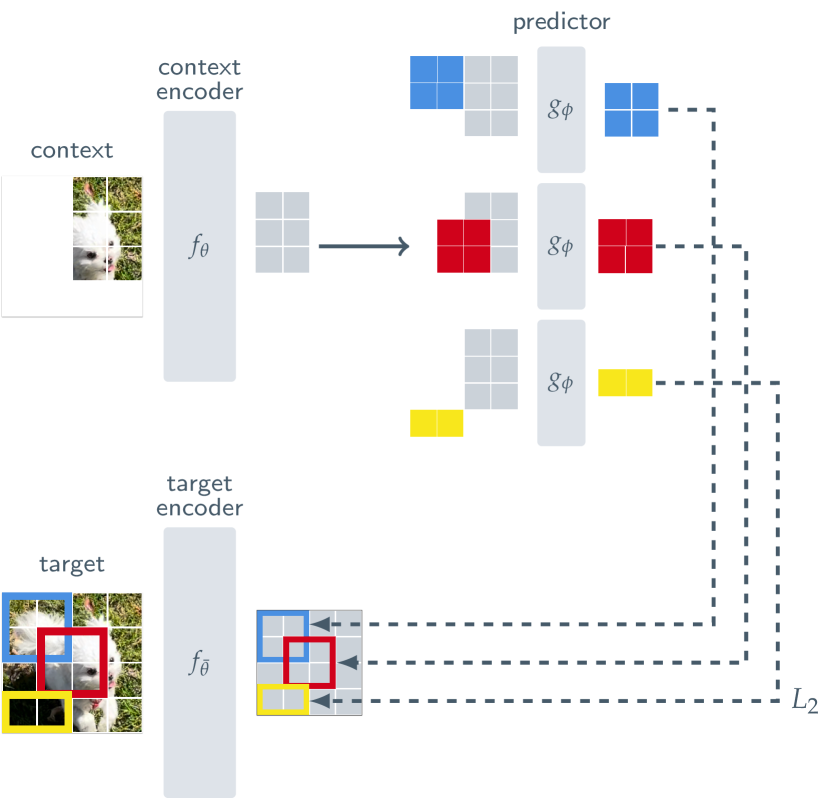
I-JEPA 的训练流程:
- 从图像中采样 context block(保留区域)
- 采样多个 target block(遮挡区域,需大尺度 >15% 图像面积)
- context encoder (ViT) → context representation
- predictor(轻量 Transformer)→ 预测 target representations
- target encoder(动量更新)→ 真实 target representations
- L2 损失:||pred - target||²(仅在隐空间)
两个关键设计选择:
- Target blocking 必须足够大 → 迫使模型学习语义级表征,而非像素级纹理
- Context block 必须信息丰富(空间分布广)→ 避免模型走捷径(只预测附近区域)
为什么非要在隐空间预测?而不像 VAE/MAE 那样直接在像素空间做?
理解这个问题是理解 JEPA 的关键。
VAE 和 MAE 的做法是:遮住图像的一部分 → 让模型预测被遮住的像素。问题是模型有很多"作弊"方式——它可以用周围的像素颜色做插值、模糊填充,或者在像素平均颜色附近随便猜一个值。这些方式都能降低像素级的 MSE,但模型完全不需要理解被遮住的是什么物体。
JEPA 把预测从像素空间搬到了隐空间。模型不再被问"这些位置的像素值是多少",而是被问"被遮住的东西在抽象空间里是什么样"。由于隐空间是编码器学出来的(编码器本身也在参与训练),这个空间天然压缩了语义信息、丢弃了像素级细节。模型无法通过猜颜色来混过去,它必须真正理解 scene composition、物体关系、物理常识。
这就是为什么 I-JEPA 不需要任何数据增强(对比 SimCLR 依赖的随机裁剪/颜色抖动)——它的"数据增强"是架构自带的:在隐空间做预测天然丢弃了像素级干扰。
结果:I-JEPA 在 ImageNet 上用 ViT-Huge/14 在 16 个 A100 GPU、72 小时内完成训练,下游分类、目标计数、深度估计等任务达到 SOTA,且完全不需要数据增强(对比 SimCLR/BYOL 依赖的随机裁剪、颜色抖动等)。
1.3 JEPA 家族全景
从 2023 年 I-JEPA 到 2026 年,JEPA 已发展出覆盖图像、视频、语言、驾驶等模态的完整家族:
JEPA 家族演进时间线:
- 2022 — LeCun 位置论文提出 JEPA 概念
- 2023 — I-JEPA(图像掩码预测,CVPR 2023) + MC-JEPA(图像运动+内容)
- 2024 — V-JEPA(视频时空预测,Meta)
- 2025 — V-JEPA 2(1.2B 参数,Block-Causal Attention,100万+小时视频)
- V-JEPA 2-AC(动作条件世界模型,零样本机器人规划)
- VL-JEPA(Vision-Language JEPA,选择性解码 2.85×加速)
- LeJEPA(可证明的自监督理论框架)
- 2026 — DRIVE-JEPA(XPENG × VT × Purdue,V-JEPA 预训练+轨迹蒸馏,NAVSIM SOTA)
- 构想中 — H-JEPA(层次化世界模型,高层次抽象决策+低层次精细控制)
各变体详解:
| 变体 | 年份 | 机构 | 模态 | 核心贡献 |
|---|---|---|---|---|
| I-JEPA | 2023 CVPR | Meta | 图像 | 首个 JEPA 实现,多块掩码预测,无需数据增强 |
| MC-JEPA | 2023 | Meta | 图像 | 联合学习光流(运动)+ 内容特征,双流结构 |
| V-JEPA | 2024 | Meta | 视频 | 扩展至视频,时空掩码,学习物体交互物理常识 |
| V-JEPA 2 | 2025 | Meta | 视频 | 1.2B 参数,Block-Causal Attention,100万+小时视频预训练 |
| V-JEPA 2-AC | 2025 | Meta | 视频+动作 | 动作条件世界模型,零样本机器人规划突破 |
| VL-JEPA | 2025 | Meta | 视觉+语言 | 替代自回归解码,选择性解码加速 2.85× |
| LeJEPA | 2025 | Meta/NYU | 理论 | 可证明的 JEPA 理论框架,去掉所有启发式 |
| DRIVE-JEPA | 2026.01 | XPENG+VT+Purdue | 驾驶 | V-JEPA 预训练 + 多模态轨迹蒸馏,NAVSIM v1/v2 SOTA |
| H-JEPA | 构想中 | — | 多层次 | 层次化世界模型:高级抽象决策 + 低级精细控制 |
1.4 DRIVE-JEPA(2026):JEPA 在驾驶中的首次应用
2026 年 1 月,XPENG Motors 联合 Virginia Tech 和 Purdue 发表了 DRIVE-JEPA(arXiv:2601.22032),这是 JEPA 架构在端到端自动驾驶中的首次直接应用。
核心思路:
- V-JEPA 视频预训练:用 V-JEPA 在大规模驾驶视频上做自监督预训练,学习场景理解和运动表征
- 多模态轨迹蒸馏:将 V-JEPA 接入多模态轨迹解码器,用专家轨迹蒸馏生成多样化的候选
- 端到端微调:在 NAVSIM v1/v2 和 Bench2Drive 上微调
与 VLA 的关键区别:DRIVE-JEPA 用 V-JEPA 替换了传统 VLA 中的 CLIP 视觉编码器。CLIP 学的是互联网图文对齐,V-JEPA 学的是物理世界动态——后者对驾驶中的场景演变更本质。本质仍然是模仿学习路线(V-JEPA 做特征提取 → 解码器生成轨迹),而非推演式决策。
1.5 JEPA 作为世界模型:为什么与 VLA 有本质不同
JEPA 不是"另一种 VLA",它在哲学上就与 VLA 不同:
| 维度 | VLA(模仿学习范式) | JEPA 世界模型范式 |
|---|---|---|
| 学什么 | $P(\text{action} \mid \text{observation})$ | $P(\text{world state} \mid \text{prev state}, \text{action})$ |
| 决策方式 | 单次 forward 生成动作 | 推演多种可能 → 评分 → 选最优 |
| 推理能力 | 统计相关性(学数据分布) | 因果推理(场景一致性) |
| OOD 处理 | 弱——未见过的场景没有训练数据支撑 | 强——不合理的行为会被高能量检测到 |
| 知识表征 | 隐式编码在 LLM 权重中 | 显式编码为场景隐空间 + 行为组合词汇表 |
| 可解释性 | 黑盒(无法回答为什么) | 白盒——可以问"为什么选这条?因为其他的重建误差更大" |
| 数据需求 | 互联网图文 + 驾驶标注 | 仅驾驶数据,自监督 |
| Scaling 方式 | 增大模型和数据 | 增大词汇量(组合爆炸)和场景多样性 |
用一句话总结:
- VLA:看了大量人开车的视频 → 学会了"遇到这种情况就这么开" → 但遇到没见过的情况就蒙了
- JEPA 世界模型:学会了"这个世界是怎么运作的" → 遇到新情况时在脑子里推演各种走法 → 选那个"走得通"的 → 即使没见过也能推理
1.6 JEPA 家族中与驾驶相关的路线
从 JEPA 家族中梳理出两条与驾驶决策相关的技术路线:
路线 A:DRIVE-JEPA(XPENG)—— JEPA 作为特征提取器
- 用 V-JEPA 做视觉编码器,替换 CLIP
- 保留模仿学习范式(端到端单次生成)
- 改进在特征层面,不在决策范式层面
路线 B:JEPA-DRIVE(我们的项目)—— JEPA 作为自监督评分信号
- 用 JEPA 能量函数思想设计 cycle energy 评分
- 彻底转向推演式决策(生成+评分+选择)
- 改进在决策范式层面,不在特征层面
两者互补:路线 A 解决特征质量,路线 B 解决决策范式。理论上可以结合。
2. JEPA-DRIVE:JEPA 在驾驶决策中的落地
JEPA-DRIVE 是我们将 JEPA 的"隐空间世界模型 + 推演式决策"思想具体化为驾驶决策系统的项目。与标准 JEPA 不同,JEPA-DRIVE 不处理原始像素,而是接收结构化场景特征(物体/车道/地图等感知模块输出)。
2.1 问题形式化
给定场景特征 $S$ 和候选轨迹集合 $\mathcal{C}$:
$$ T^* = \arg\max_{T \in \mathcal{C}} f(T, S) $$其中 $f$ 是评分函数。JEPA-DRIVE 的独特之处在于 $f$ 基于自监督重建误差(cycle energy),而非外部标签。
NAVSIM 约束:每个场景固定提供 8 个 SD 候选,评估 selected_pdm(选中的轨迹的 PDM 分数)、oracle_pdm(最高 PDM 分数)、gap(两者之差)。模型可以生成任意多候选用于训练,但最终评估只看 8 个 SD 候选中的选择质量。数据规模:85,109 训练场景 + 12,000 测试场景。
2.2 架构全景
2.3 World Encoder:结构化场景编码
JEPA-DRIVE 接收的是感知模块输出的结构化场景特征——6 种模态的向量,每种模态用独立 MLP 编码到统一的 96 维隐空间:
class ModalEncoder(nn.Module):
    def __init__(self, in_dim=24, out_dim=96):
        super().__init__()
        self.proj = nn.Linear(in_dim, out_dim)
        self.norm = nn.LayerNorm(out_dim)

    def forward(self, x):
        return self.norm(self.proj(x))
各模态编码后拼接为 [65 tokens × 96 dim]:
| 模态 | 输入维度 | token 数 | 含义 |
|---|---|---|---|
| Object | 32 × 24 | 32 | 周围物体位置/类别/速度 |
| Lane | 16 × 24 | 16 | 车道线几何/类型 |
| Map | 4 × 24 | 4 | 地图元素(人行道/路肩等) |
| Route | 4 × 24 | 4 | 导航路径点 |
| Velocity | 1 × 24 | 1 | 自车速度 |
| Dynamics | 8 × 24 | 8 | 动态物体运动状态 |
为什么用 MLP 而非 Transformer 编码器? 场景要素已经高度结构化(物体位置、车道线方向等),MLP 更轻量,且保持模态分离——下游 CrossAttn 可以区分 token 的模态来源。
2.4 Vocabulary 系统(核心创新)
这是 JEPA-DRIVE 区别于所有其他方法的核心设计。
关键思想:驾驶行为可以被分解为两个独立维度的组合——横向(path)和纵向(vel)。
self.path_queries = nn.Parameter(torch.randn(512, 96))  # 512 种横向行为
self.vel_queries  = nn.Parameter(torch.randn(128, 96))  # 128 种纵向行为
为什么是 512 × 128 = 65,536?
- 512 种路径:4 种基础走法(直行/左转/右转/变道)× 8 种幅度 × 16 种细粒度偏移
- 128 种速度:4 种基础趋势(加速/巡航/减速/停止)× 4 种幅度 × 8 种微调
候选生成流程:
- Path/Vel Queries → CrossAttn(场景) → 场景感知的 path/vel features
- Cartesian Product: 512 × 128 = 65,536 组合
- Predictor MLP + Trajectory Decoder → 65,536 条轨迹
关键优势:组合爆炸。512 种路径 × 128 种速度 = 65,536 种行为模式,但只需要学习 512 + 128 = 640 个 query 向量。这是 JEPA-DRIVE 能够做到 3.88M 参数的秘密——用组合代替记忆。
训练时:从 65,536 中均匀采样 64 个候选,reshape 为 [B, 64, 24]。 推理时:coarse-to-fine 策略——先用 path/vel scorer 粗筛 top-64×top-32=2048,再用 FineScorer 精评。
2.5 FineScorer V2(评分器)
Phase B 唯一训练的部分,经历了 20+ 版本的迭代:
class FineScorerV2(nn.Module):
    # 输入: action_lat [B,N,96] + attended [B,N,96] + traj_lat [B,N,96]
    # ① TrajFusion: concat → MLP(288→1024→96)
    # ② CrossAttn(融合特征, world_tokens) → 场景感知特征
    # ③ SceneQuery: 跨候选全局上下文
    # ④ ScoreHead: MLP(192→1024→1024→1) → 分数 [B,N]
    # ⑤ ComponentHead: MLP(96→512→6) → 6 维辅助评分
设计演进(关键修复):
| 版本 | 评分器设计 | 问题 |
|---|---|---|
| V10 | hidden=512, 全局 mean pool 场景 | 全局池化丢失空间信息,hidden=512 是假的大(实际 192) |
| V11-V14 | hidden=512,各种改进 | 逐步调优但基础受限 |
| V15 | hidden=512(真实),更深 MLP | 容量提升,0.84→0.85 |
| V16-V17 | 移除全局池化,改 CrossAttn | 关键突破,0.85→0.8839 |
| V18-V20 | 微调 | 接近 64 值瓶颈上限 |
| V21 | Cycle Energy 自监督 | 训练中,目标突破瓶颈 |
V10 用全局 mean pool 提取场景特征,所有候选共享同一个场景向量——丢失了"某条轨迹是否适合场景的某一部分"这样的精细信息。V16 改 CrossAttn 让每个候选独立查询场景,这是 0.84 → 0.8839 的关键突破。
2.6 Cycle Energy:自监督评分信号
Cycle energy 来源于 JEPA 的**能量基础模型(EBM)**思想:给定场景 $S$ 和轨迹 $T$,能量 $E(T, S)$ 越低,表示 $T$ 与 $S$ 越兼容。
计算流程(轨迹 12 帧切成两半,用前 6 帧 + 场景预测后 6 帧):
action_lat = MLP(prefix)→ 轨迹前半段编码 [96]traj_lat = MLP(full_traj)→ 轨迹全段编码 [96]attended = CrossAttn(action_lat, world_tokens)→ 场景-轨迹交互 [96]pred_suffix = Decoder(concat[action_lat, attended, traj_lat])→ 预测后半段 [6,2]cycle_energy = MSE(pred_suffix, real_suffix)→ 标量
直觉:如果一条轨迹在场景中是合理的,场景隐空间包含"这条路接下来会怎样"的信息,解码器准确预测后半段。反之,如果轨迹不合理(如直行撞向路栏),场景中无支持信息,解码器只能胡猜——重建误差大。
相比 PDM 标签的优势:
| 维度 | PDM(64 值瓶颈) | Cycle Energy(自监督) |
|---|---|---|
| 值域 | 64 个离散值 {0.00, 0.17, …, 12.00} | 连续值,任意精度 |
| 来源 | 外部 PDM 打分器 | 自监督,从数据中产生 |
| 数据覆盖 | 仅 9k / 85k 场景 | 全部 85k 场景 |
| 语义 | 单一分数,无法解释 | 可分解(位置/速度/方向误差) |
2.7 两阶段训练方法
Phase A:生成器训练
Epochs: 100 | Batch: 2 | LR: 1e-4 | GPU: 1×L20 (48GB)
数据: 7119 navtrain 场景(有候选标注用于多样性损失)
冻结: 无(全模型训练)
损失函数:
$$\mathcal{L}_{\text{Phase A}} = \mathcal{L}_{\text{im-s}} + \mathcal{L}_{\text{im-w}} + \lambda_{\text{cyc}}\mathcal{L}_{\text{cyc}} + \lambda_{\text{div}}\mathcal{L}_{\text{div}} + \lambda_{\text{dst}}\mathcal{L}_{\text{dst}}$$| 分量 | 权重 | 作用 |
|---|---|---|
| 图像重建(强/弱) | 1.0 | 候选轨迹在场景中的特征重建 |
| Cycle 一致性 | 1.0 | 编解码循环中的自一致性 |
| 多样性 | 0.01 | 鼓励 64 个候选多样化 |
| 距离损失 | 0.10 | 候选接近数据集轨迹 |
收敛:E1 loss=1.30, cyc=0.22, div=0.77 → E100 loss=0.06, cyc=0.003, div=0.92(~17 小时)
Phase B:评分器训练
Epochs: 50 | Batch: 8×8GPUs=64 | LR: 1e-4 | GPU: 8×A800-80GB
数据: 85109 navtrain 全量场景(cycle energy 实时计算)
冻结: 生成器全部冻结,仅训练 FineScorerV2(3.17M/3.88M 参数)
V17 损失(PDM 标签):$\mathcal{L}_{\text{listnet}}(scores, proxy) + 0.2 \cdot \bar{E}_{\text{cyc}} + 0.1 \cdot \mathcal{L}_{\text{BCE}}$
V21 损失(Cycle Energy):$\mathcal{L}_{\text{listnet}}(scores, -ce) + 0.05 \cdot \mathcal{L}_{\text{GRPO}} - 0.01 \cdot \mathcal{H}(\pi)$
V21 中 GRPO 只有 0.05 权重,只是"保底"防止 cycle energy 初始阶段出错。随着训练进行,listnet 主导学习。
2.8 实验演进
| 版本 | 时间 | 关键变化 | 分数 |
|---|---|---|---|
| V1-V9 | 7/9-7/11 | 原型探索,基础 JEPA 验证 | — |
| V10 | 7/11 | 评分器定型,全局池化缺陷 | ~0.80 |
| V11-V14 | 7/12-7/13 | Baseline 优化 | 0.82-0.84 |
| V15 | 7/14 | 评分器容量修复(hidden 192→512) | ~0.84 |
| V16 | 7/15-7/16 | 移除全局池化,改 CrossAttn | ~0.85 |
| V17 | 7/17-7/19 | 架构定型:FineScorerV2 + CrossAttn + 1024 hidden | 0.8839 |
| V18-V20 | 7/19-7/23 | 尝试各种改进 → 确认 64 值瓶颈 | 0.875-0.882 |
| V21 | 7/23-至今 | Cycle Energy 自监督替代 PDM(训练中) | ? |
V17 里程碑:验证了 JEPA 架构可行、推演式决策有效、FineScorerV2 设计正确。但暴露了数据泄露(训练在 navtest)和 64 值瓶颈两个问题。
64 值瓶颈:V18-V20 无论怎么改架构——加大评分器、换损失函数、升级整个模型——分数全在 0.875-0.882 徘徊。因为:
scores = model(batch)   # [B, 64] 评分器输出,连续值
proxy  = get_nn_proxy() # [B, 64] 只有 8 种不同的值(被广播到 64 个候选)
# 评分器只能学这 8 个档次之间的排序
PDM 的打分精度就是评分器的理论上限。Cycle energy 没有这个限制——每个候选有自己独立的连续值标签。
V21 当前状态:
| 步骤 | 状态 | 详情 |
|---|---|---|
| Phase A | ✅ 完成 | 100 epochs, loss=0.06 |
| Phase B | 🔄 训练中 | 8×A800 DDP, ~55min/epoch |
| 预计完成 | 7/26 | 50 epochs |
2.9 与 DRIVE-JEPA 的对比
| 维度 | DRIVE-JEPA(XPENG) | JEPA-DRIVE(我们的项目) |
|---|---|---|
| 流派 | 端到端模仿学习 | 规划+评分(推演式决策) |
| JEPA 角色 | 视觉编码器(特征提取) | 世界模型 + 自监督评分信号 |
| 参数量 | ~300M+(视觉编码器) | 3.88M |
| 训练方式 | V-JEPA 预训练 → 微调 | Phase A 生成器 + Phase B 评分器 |
| 评分信号 | PDM 标签(模仿学习) | Cycle Energy 自监督 |
| 输出 | 单条轨迹(端到端生成) | 65,536 候选 → 评分 → 选最优 |
| NAVSIM 分数 | SOTA(闭源) | V17: 0.8839, V21 训练中 |
2.10 优劣势总结
核心优势:
- 极轻量:3.88M 参数 vs VLA 的 7B+,差 1800 倍;vs DRIVE-JEPA 的 300M+,差 77 倍
- 完全自监督:不需要互联网数据、不需要人工标注、不需要 PDM
- OOD 鲁棒:推演式决策天生处理未见场景
- 可解释:每个决策可以追溯到重建误差的来源
核心劣势:
- 计算量大:推理需多次 decoder forward,延迟 ~220ms(可优化至 50-100ms)
- 依赖场景编码质量:编码器漏了关键信息,cycle energy 就不准
- 候选覆盖有限:65,536 虽大,仍有覆盖不到的行为
- 工程复杂:两阶段训练、DDP、候选采样
2.11 JEPA-DRIVE 中的 JEPA 架构映射
很多读者读完 JEPA-DRIVE 后会有和你一样的困惑:“这个系统哪里体现出 JEPA 了?”
答案是:JEPA-DRIVE 不是 JEPA 的严格实现(严格实现应该预测隐空间+动量目标编码器),而是把 JEPA 的预测范式重新解读后应用到驾驶决策中。
把标准 JEPA 和 JEPA-DRIVE 一一对应:
| 标准 JEPA(I-JEPA) | JEPA-DRIVE 中的对应 | 说明 |
|---|---|---|
| Context = 图像可见区域 | 场景特征(物体/车道/地图等,共 65 tokens) | 都是"已知的上下文信息" |
| Target = 图像被遮区域 | 轨迹后半段(6 帧坐标) | 都是"要预测的东西" |
| Context Encoder(ViT,梯度下降) | World Encoder(MLP + LSTM) | 把上下文编码到隐空间 |
| Predictor(轻量 Transformer,梯度下降) | Trajectory Decoder | 从隐空间预测 target |
| Target Encoder(ViT,动量更新 EMA) | 直接取真实轨迹坐标作为 target | JEPA-DRIVE 做了简化,skip 了动量编码器 |
| 损失函数:$\|\text{pred} - \text{sg}(\text{target})\|^2$ | Cycle Energy:$\text{MSE}(\text{pred\_suffix}, \text{real\_suffix})$ | 都是重建误差,能量越低越好 |
三个关键差异(为什么说 JEPA-DRIVE 是"JEPA 思想"而非"JEPA 实现"):
预测空间不同:标准 JEPA 的 Predictor 输出的是隐空间表征,JEPA-DRIVE 的 Decoder 输出的是轨迹坐标——回到了物理空间。这是最大的偏离。
没有动量 Target Encoder:标准 JEPA 用动量更新的 Target Encoder 生成 target 表征(防止模式坍塌),JEPA-DRIVE 直接用真实轨迹做 target——因为在驾驶决策场景中,轨迹坐标有明确的物理含义,不需要担心坍塌。
JEPA 的角色不同:标准 JEPA 用预测任务训练编码器从而学出好表征;JEPA-DRIVE 用预测任务评估候选轨迹的质量——JEPA 在这里是评分信号,不是表征学习工具。
JEPA-DRIVE 真正继承 JEPA 的地方在 Cycle Energy 背后的逻辑:
# 如果候选轨迹 T 在场景 S 中是合理的
# → 场景隐空间包含"这条路接下来会怎样"的信息
# → Decoder 能准确预测 T 的后半段
# → Cycle Energy 低 → 推荐这条轨迹

# 如果候选轨迹 T 不合理(如直行撞向路栏)
# → 场景隐空间中无支持信息
# → Decoder 只能猜
# → Cycle Energy 高 → 拒绝这条轨迹

# 这本质上是 JEPA 的前向预测范式:
# "用已知的(场景+轨迹前半段)推演未知的(轨迹后半段),
#  用推演误差衡量合理性"
用一句话总结 JEPA-DRIVE 和 JEPA 的关系:JEPA-DRIVE 没有复刻 JEPA 的架构,但复刻了 JEPA 的核心思想——在抽象空间中用预测误差作为推理和决策的依据。
3. 个人思考
3.1 JEPA 家族给我们的启示
从 I-JEPA 到 V-JEPA 2 到 VL-JEPA 到 DRIVE-JEPA,JEPA 的演进路径清晰地指向一个方向:从表征学习走向世界模型,从感知走向决策。
V-JEPA 2-AC 的零样本机器人规划已经证明了 JEPA 世界模型在动作空间中的推演能力。DRIVE-JEPA 证明了 V-JEPA 作为驾驶场景特征提取器的有效性。我们的 JEPA-DRIVE 则证明了 JEPA 能量函数思想在驾驶决策评分中的可行性。三条路线各有所长,最终可能交汇。
3.2 与 VLA 的本质差异
3.88M vs 7B 只是表象。更深层的差异在哲学层面:
VLA 把驾驶看成"映射问题"——输入场景,输出动作。JEPA-DRIVE 把驾驶看成"选择问题"——生成候选,推演后果,选择最优。
映射问题一旦遇到分布外输入就会坍塌。选择问题天然包含异常检测——如果所有候选的推演结果都不好(能量都高),模型可以选择"减速/停车"作为安全兜底。这是 JEPA 世界模型路线的核心优势。
3.3 64 值瓶颈的教训
V18-V20 花了大量时间改架构但没用——因为瓶颈不在模型容量,在标签质量。改架构之前先确认瓶颈在哪。
3.4 与 LinkVLA 的对比
两者都用离散词汇表,动机不同:LinkVLA 用共享词表对齐语言-动作 embedding;JEPA-DRIVE 用组合生成覆盖最大行为空间。两者都验证了离散化是 VLA 系统的重要设计维度。
3.5 与 SparseDrive V2 的巧合与差异
2026 年 3 月 31 日,清华和地平线联合发布 SparseDrive V2(arxiv: 2603.29163),与我们的 JEPA-DRIVE 几乎同时(V21 实验是 7/24 开始的)。两者的核心思路惊人地相似:
共同范式:规划 = 生成候选 + 评分选优
- SparseDrive V2 = 轨迹词汇表 × 两阶段评分器
- JEPA-DRIVE = 路径×速度词汇表 × Cycle Energy 评分器
关键对照:
| 维度 | SparseDrive V2 | JEPA-DRIVE (V17) |
|---|---|---|
| 词汇表大小 | 路径 512 × 速度 512 = 262,144 | 路径 256 × 速度 256 = 65,536 |
| 评分机制 | 两阶段 coarse-to-fine scorer(显式) | Cycle Energy(隐式自监督) |
| 场景编码 | Transformer decoder(依赖检测) | LSTM 编码器(结构化特征) |
| 视觉主干 | ResNet-34 | 无(复用 METR 的视觉信息) |
| 推理延迟 | 未见实验 | ~220ms |
| NAVSIM PDMS | 92.0 | 88.39 |
| NAVSIM EPDMS | 90.1 | 未测试 |
| Bench2Drive DS | 89.15 | 未测试 |
| 训练方式 | 端到端(检测+规划联合) | 两阶段(生成器+评分器分离) |
SparseDrive V2 用多帧注意力(Multi-Frame Attention)聚合时序信息,生成初始检测和轨迹候选,再用 coarse scorer 筛选 top-K,最后 fine scorer 精细评分。JEPA-DRIVE 用离散组合生成候选,用 cycle energy(重建误差的隐式正则化)自动评估可行性。
核心差异点:
- 评分信号来源:SparseDrive V2 的评分器是显式训练的(从 NAVSIM 监督);JEPA-DRIVE 的 cycle energy 是自监督的(不依赖任何标注或 PDM)
- 词汇表组合方式:SparseDrive V2 的路径/速度词汇表是分开学到的;JEPA-DRIVE 的路径/速度是因子化乘积
- 检测 vs 直接规划:SparseDrive V2 仍然依赖显式检测输出;JEPA-DRIVE 完全跳过检测(结构化特征直接输入)
SparseDrive V2 的结果验证了 Scoring 范式是目前端到端驾驶的最优路线——这与 JEPA-DRIVE 的核心理念完全一致。差距主要在工程细节(词汇表大小、端到端训练、视觉特征质量),而非方法论层面。
3.6 下一步方向
如果 V21 验证了 cycle energy 能打破 64 值瓶颈:
- 词汇表扩展:1024×256 = 262k 候选(追上 SparseDrive V2 规模)
- 端到端联合训练:cycle energy 反向传播到生成器
- 联合 V-JEPA 2:用 V-JEPA 2 做视觉编码器替换结构化特征输入
- 多步 cycle energy:不只是预测后 6 帧,而是多步 rollout
📖 本文是对 JEPA-DRIVE 项目的技术总结与个人思考。V21 训练结果预计 7/26 完成,届时更新。