📄 论文信息
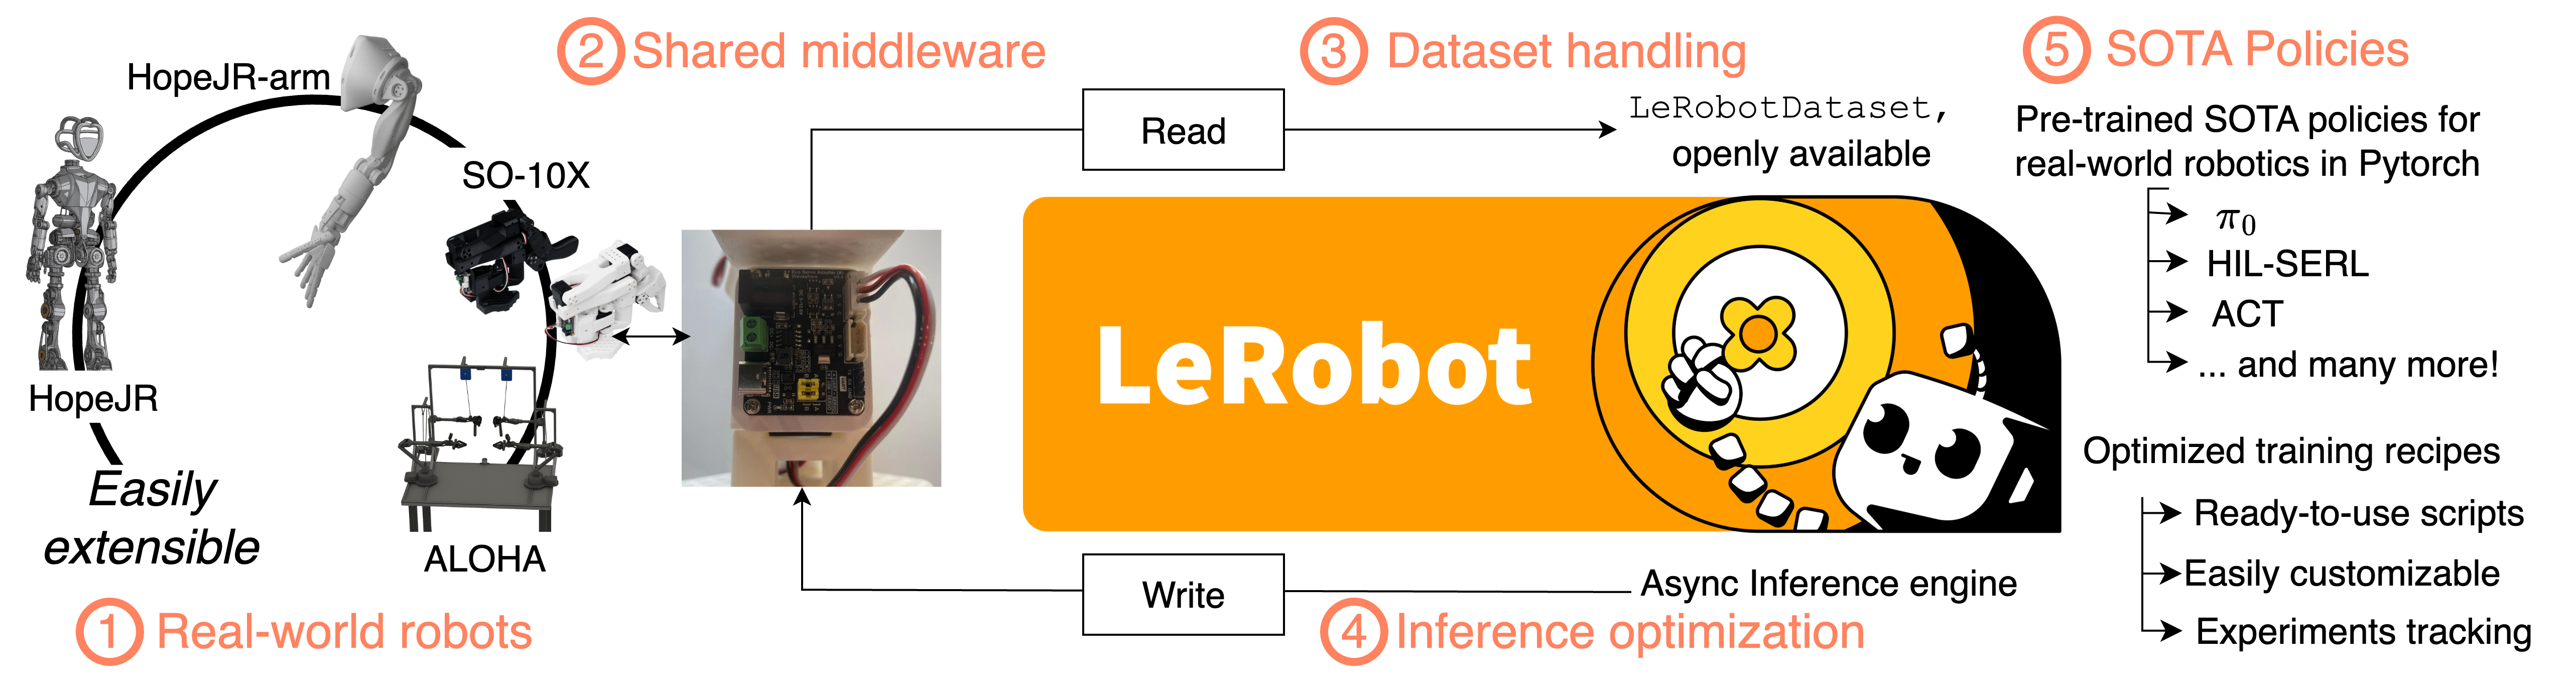
- 标题:LeRobot: An Open-Source Library for End-to-End Robot Learning(LeRobot:一个用于端到端机器人学习的开源库)
- 团队:Hugging Face(Remi Cadene, Simon Aliberts, Francesco Capuano 等17人)& University of Oxford
- 发表:arXiv 2026.02(ICLR 2026)
- 关键词:开源机器人学习、端到端学习、模仿学习、数据集、低成本硬件、异步推理
- 一句话总结:LeRobot提供了一个垂直集成的开源机器人学习栈,从低成本硬件支持到大规模数据集流式传输,旨在降低机器人学习门槛并加速领域发展。
- 论文链接:arXiv:2602.22818
- 代码链接:GitHub - huggingface/lerobot
🤔 要解决什么问题?
机器人学习生态的碎片化困境
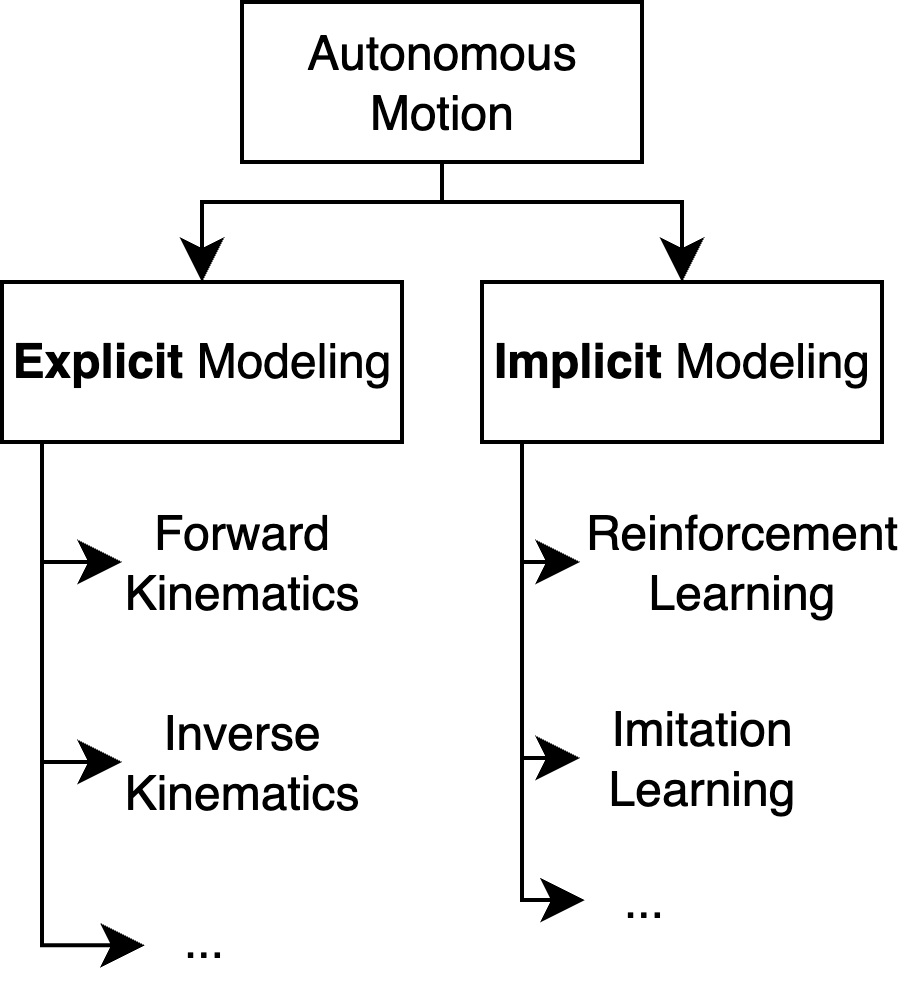
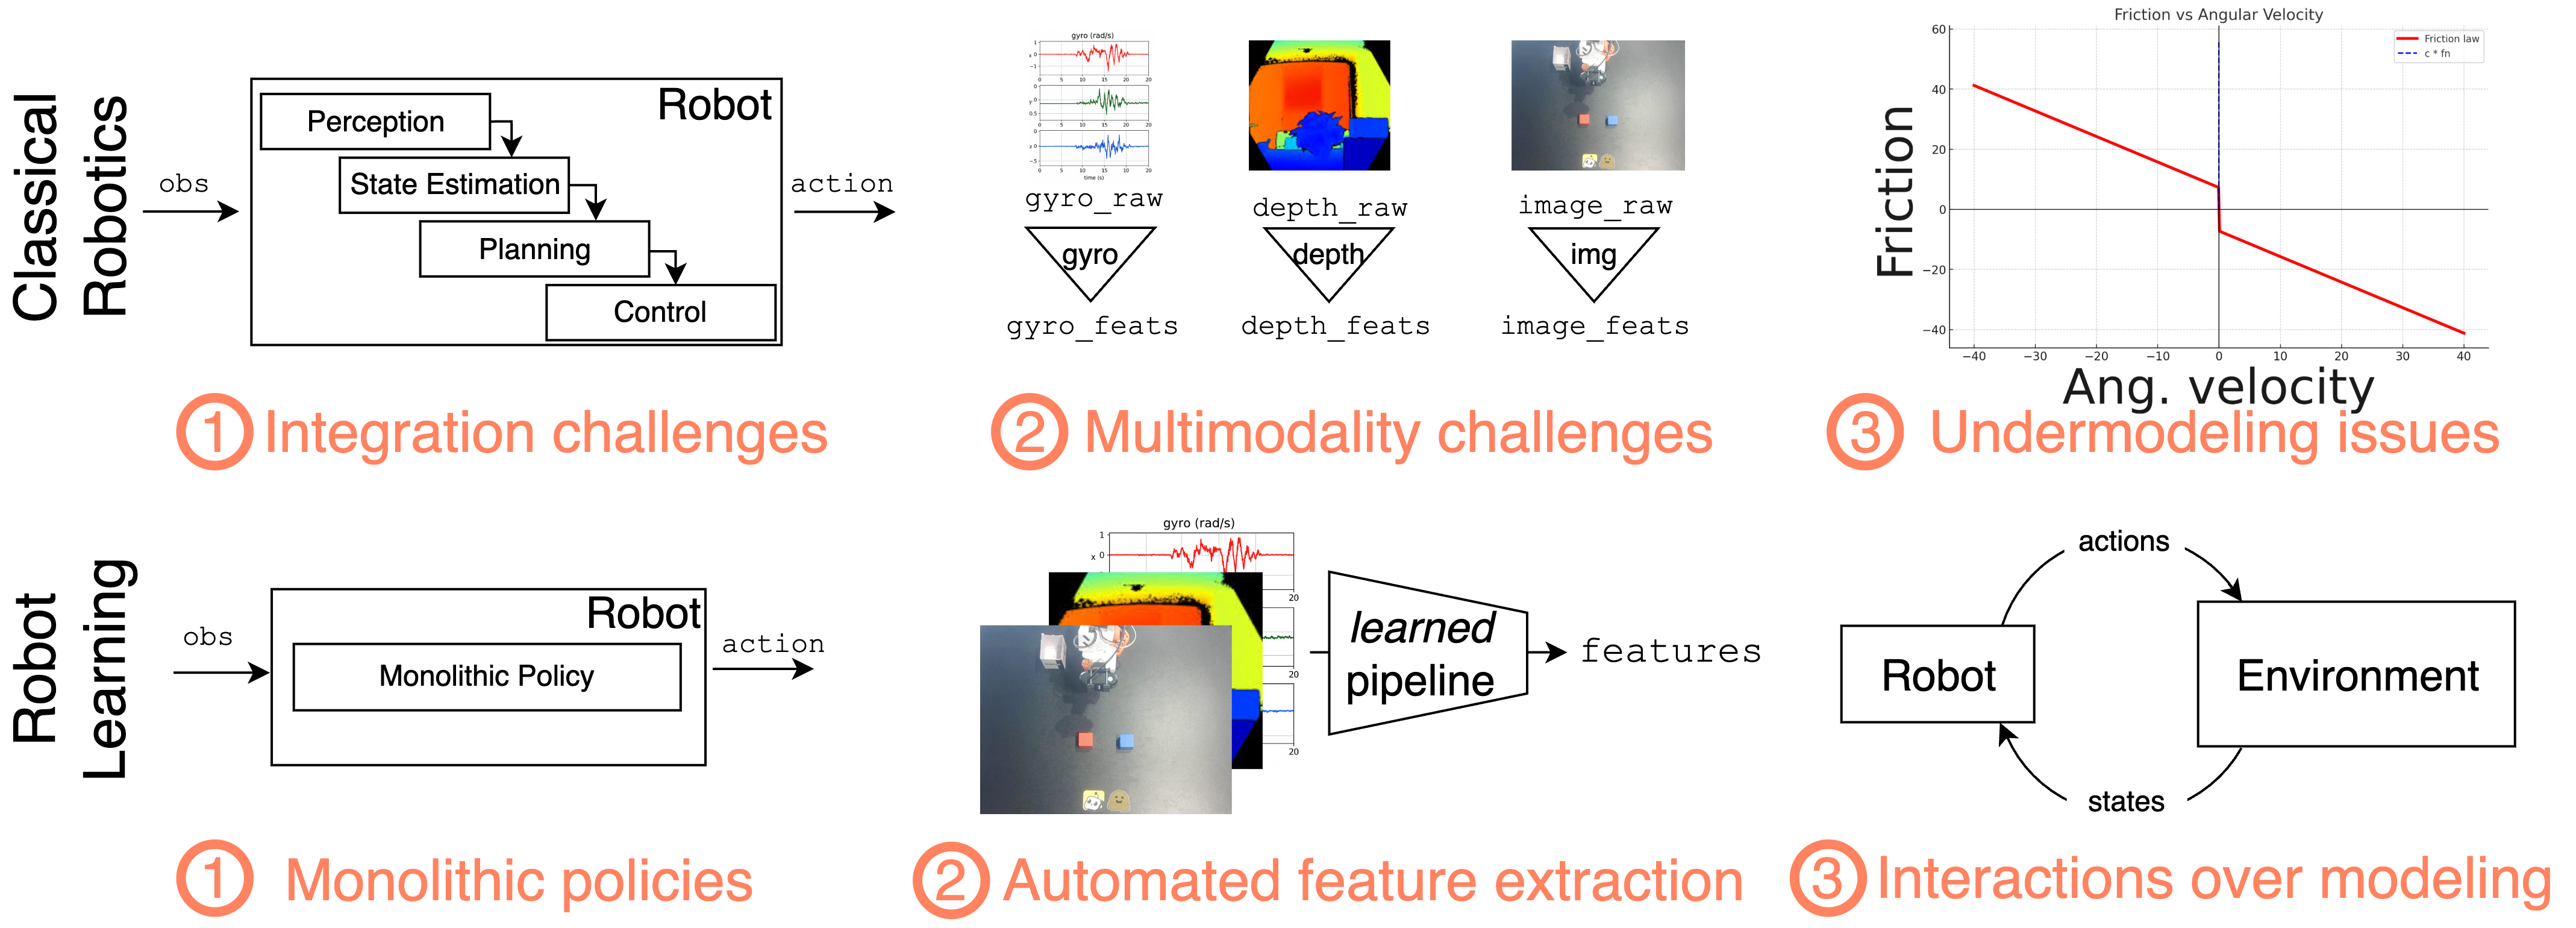
机器人学习领域正在经历一场从显式模型(explicit models)到隐式模型(implicit models)的范式转变:
| 维度 | 显式模型(经典机器人学) | 隐式模型(机器人学习) |
|---|---|---|
| 方法论 | 模块化管道:感知→规划→控制 | 端到端数据驱动策略 |
| 特征工程 | 手工设计刚体运动学、接触模型 | 从交互数据中学习表示 |
| 扩展性 | 难以适配多样化部署场景 | 性能随数据量和算力提升 |
| 适用环境 | 受控环境(工厂产线) | 非结构化动态环境(家庭) |
尽管隐式模型(如Transformer策略、扩散策略)展现出强大的扩展性,但机器人学习生态面临三大碎片化问题:
1. 中间件接口碎片化
当前机器人学习的中间件(middleware)高度平台化:
- 不同机器人(Franka、xArm、SO-100)使用不同的SDK和通信协议
- 研究团队需要为每个新平台开发定制适配器
- 跨平台的数据共享和算法复用极其困难
2. 数据集格式不统一
大规模机器人数据集通常以不同格式发布:
- TensorFlow Datasets、ROS bags、自定义JSON布局
- 缺乏统一的、支持多模态的 schema
- 不同数据集难以聚合成更大的混合训练集
3. 算法实现不可复现
- 各研究组独立实现算法,代码质量参差不齐
- 算法、数据处理和评估流程的微小差异可导致结果显著不同(Henderson et al., 2018)
- 硬件差异进一步加剧了复现困难
核心问题:能否构建一个统一的、开源的、端到端的机器人学习框架,覆盖从硬件控制到数据管理再到算法实现的完整栈,降低进入门槛并加速整个领域的发展?
💡 核心方法:垂直集成的开源机器人学习栈
LeRobot的核心设计理念是垂直集成——覆盖从底层硬件控制到上层算法实现的完整栈,同时保持每个组件的可扩展性和可替换性。
1. 统一机器人集成(Accessible Real-world Robots)
LeRobot提供了一致的、基于Python的中间件API,用于控制多种机器人平台:
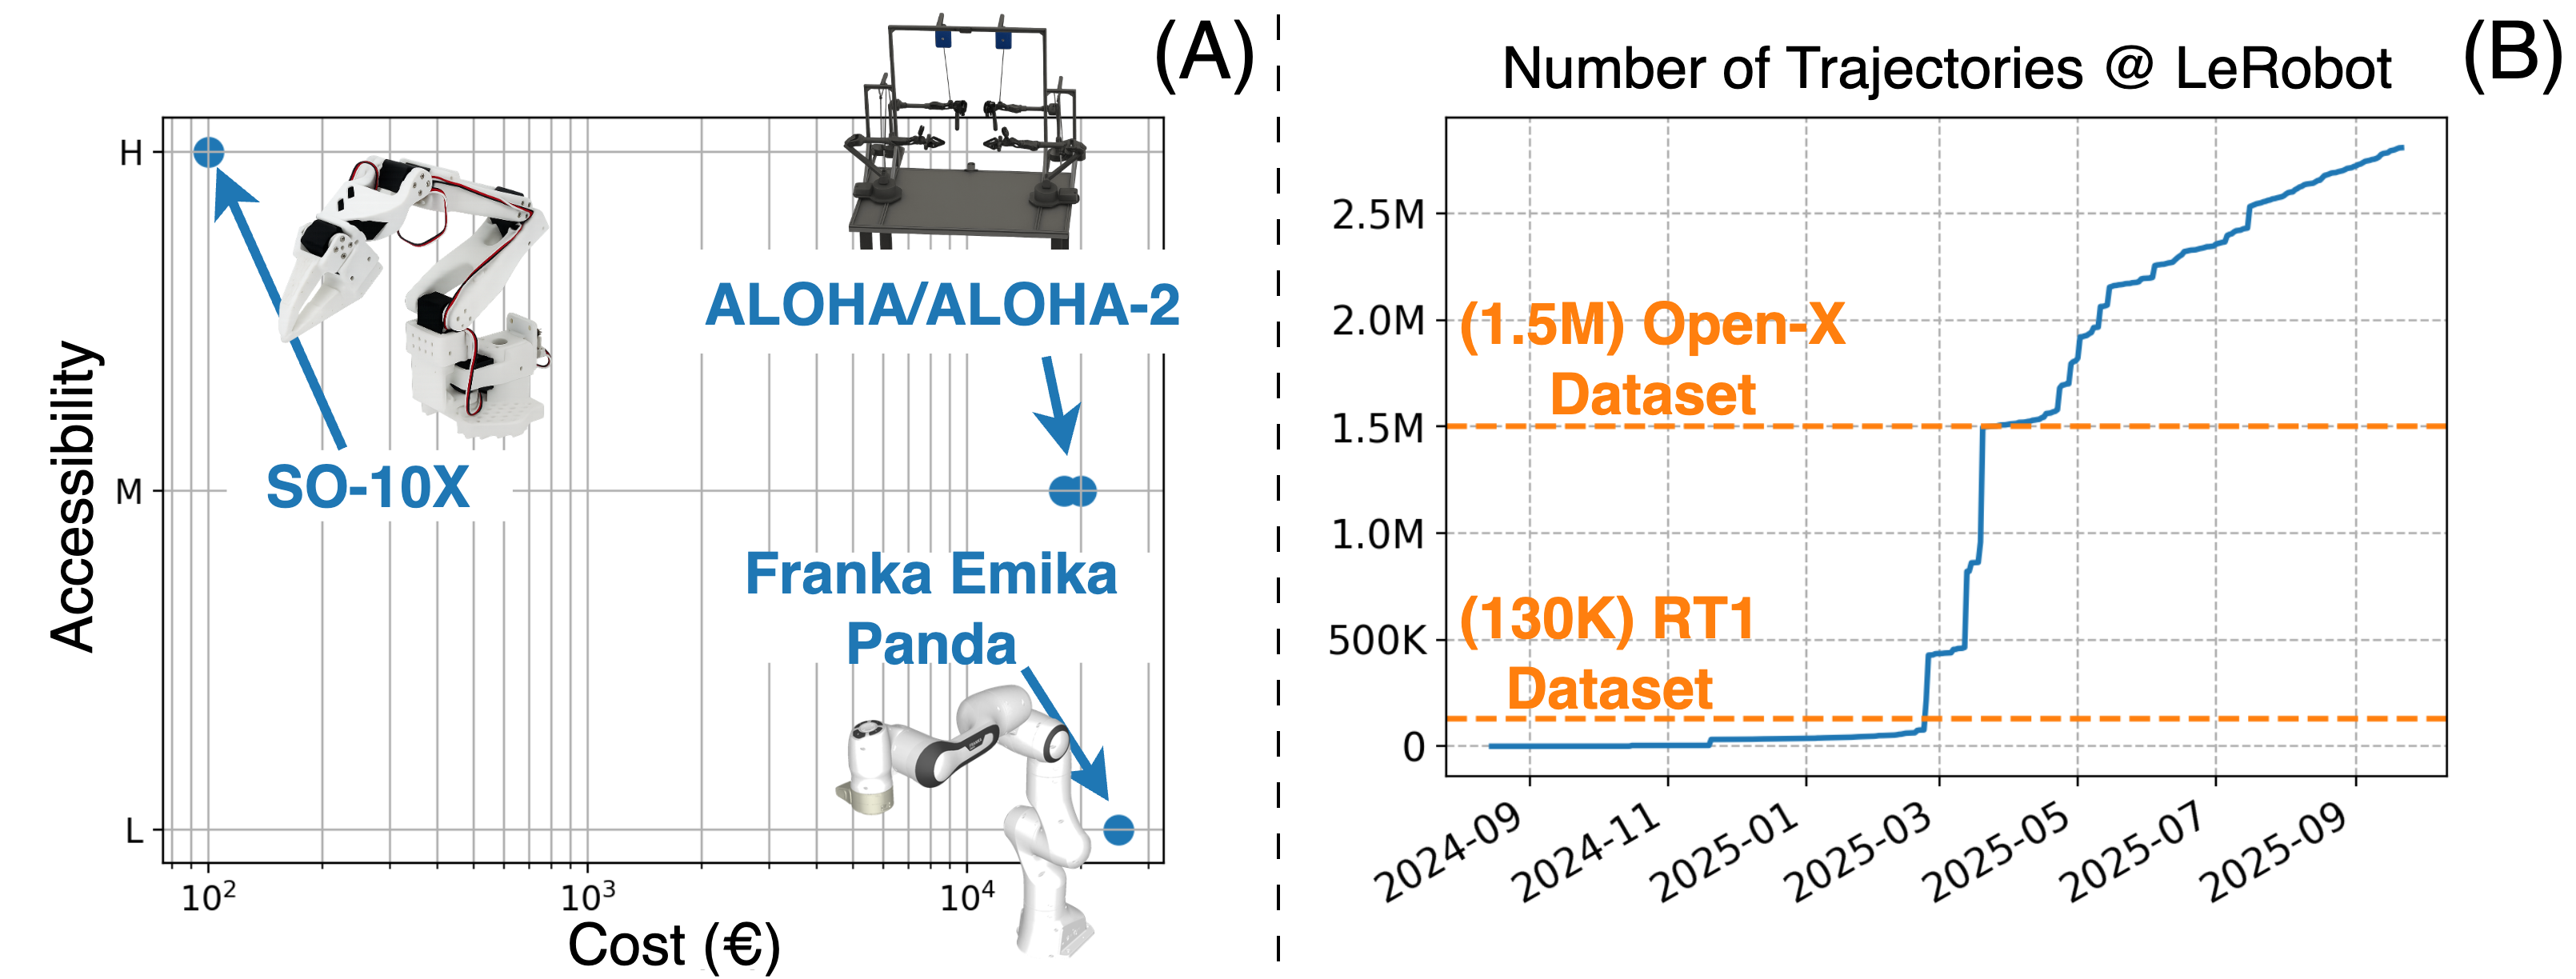
支持的硬件平台及成本:
| 机器人类型 | 成本(€) | 特点 |
|---|---|---|
| SO-100/SO-101 | ~225(单臂)/ 550(双臂) | 3D可打印、开源设计、消费级零件 |
| Koch-v1.1 | ~670(双臂) | 开源机械臂 |
| ALOHA-2 | ~21,000 | 双臂遥操作系统 |
| Hope-JR | ~500 | 人形手臂和灵巧手 |
| LeKiwi | ~230 | 移动操作平台 |
| Stretch-3 | - | 移动操作平台 |
| Reachy-2 | - | 人形机器人 |
关键优势:SO-10X等低成本平台的成本仅为工业级机器人(如Franka Emika Panda)的1/100,使得大规模数据收集成为可能。这些平台支持:
- 遥操作:leader-follower架构,读取leader机器人配置并写入follower机器人
- 策略推理:直接用学习到的策略控制follower机器人
- 去中心化数据收集:社区成员各自在本地收集数据,再通过HuggingFace Hub共享
2. 标准化数据集(LeRobotDataset)
LeRobotDataset是专为机器人学习设计的统一多模态数据格式:
设计原则:
- 可扩展性:支持处理包含数百万专家轨迹的大型仓库
- 多模态支持:无缝集成图像、传感器读数、遥操作状态信号
- PyTorch生态集成:与PyTorch DataLoader等工具无缝对接
- 流式传输:支持远程托管的大型数据集,无需下载完整语料即可处理
社区规模(截至2025年9月):
- 16,000+ 个公开数据集
- 2,200+ 个独立贡献者
- 支持SO-10X、Franka Panda、xArm等多种机器人平台
数据集统计:
| 机器人 | 下载量 | 数据集数 | 情景数 |
|---|---|---|---|
| Panda | 1,878,395 | 588 | 926,776 |
| xArm | 1,107,329 | 74 | 450,329 |
| WidowX | 832,177 | 100 | 214,117 |
| KUKA | 662,550 | 3 | 419,784 |
| SO-101 | 319,586 | 3,965 | 58,299 |
| SO-100 | 278,697 | 5,161 | 78,510 |
流式传输示例:
from lerobot.datasets.lerobot_dataset import LeRobotDataset
from lerobot.datasets.streaming_dataset import StreamingLeRobotDataset

repo_id = "lerobot/svla_so101_pickplace"

# 下载完整数据集并加载到内存(支持随机访问)
dataset = LeRobotDataset(repo_id)

# 流式传输帧,无需下载(顺序访问,.next())
dataset = StreamingLeRobotDataset(repo_id)
3. 高效可复用的算法(Models)
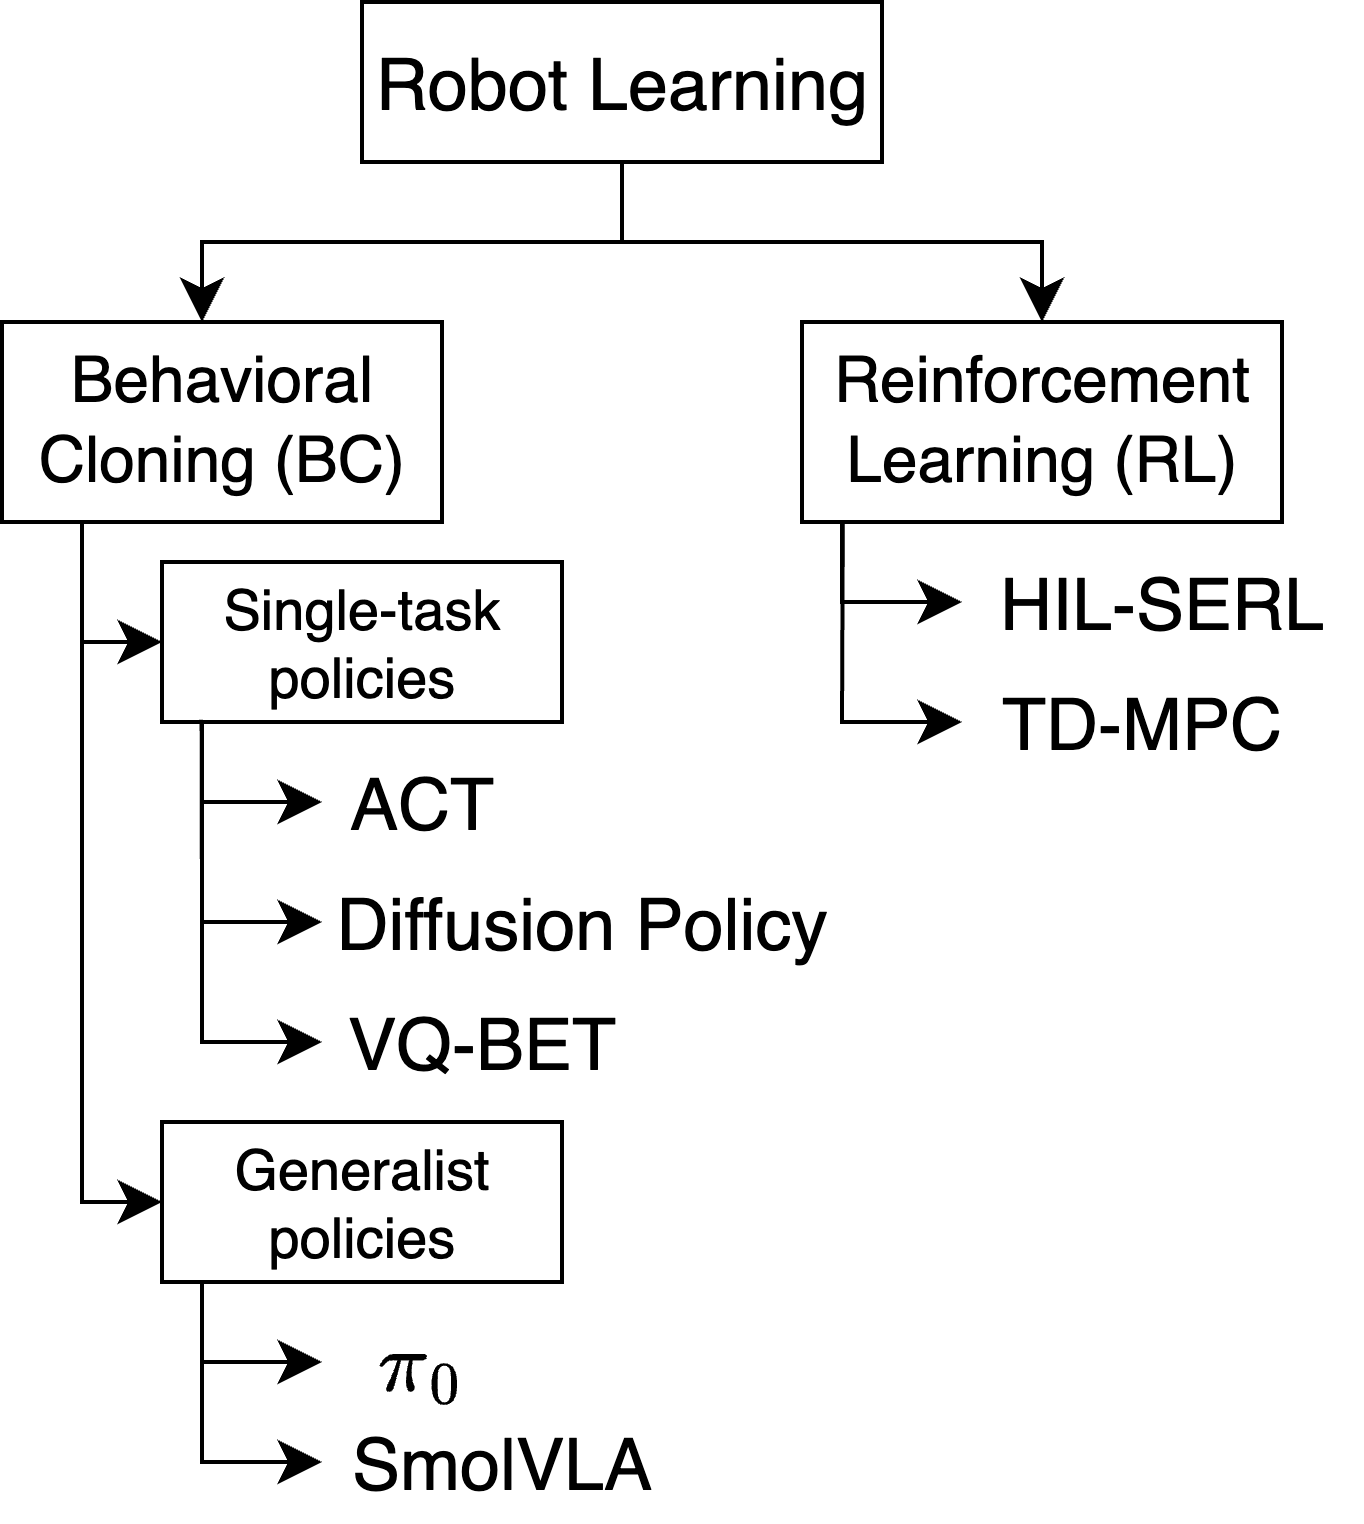
LeRobot提供了多种SOTA机器人学习算法的干净、基于PyTorch的实现:
强化学习方法:
- HIL-SERL:人在环强化学习,结合学习到的奖励分类器和人工干预,可在1-2小时真实世界训练中达到近完美成功率
- TD-MPC:基于时序差分的模型预测控制
模仿学习方法:
- ACT(Action Chunking with Transformers):使用VAE的双手操作方法,52M参数,RTX 4090上推理延迟仅5ms
- Diffusion Policy:使用扩散模型学习多模态动作分布,263M参数
- VQ-BET:基于向量量化的动作生成
视觉-语言-动作模型:
- π₀(Pi-Zero):基于Flow Matching的通用机器人控制模型,3.5B参数
- SmolVLA:轻量级VLA模型,450M参数,支持语言条件控制
模型性能对比:
| 模型 | 参数量 | RTX 4090推理延迟 | A100峰值显存 |
|---|---|---|---|
| ACT | 52M | 5.01ms | 211MB |
| Diffusion Policy | 263M | 613.89ms | 1.12GB |
| π₀ | 3.5B | 568.98ms | 13.32GB |
| SmolVLA | 450M | 99.24ms | 1.75GB |
关键洞察:ACT因其小巧的模型尺寸和极快的推理速度(100-200Hz),成为最受欢迎的策略——用户仅需50条真实世界轨迹即可训练出表现良好的策略。
4. 优化的异步推理栈(Inference)
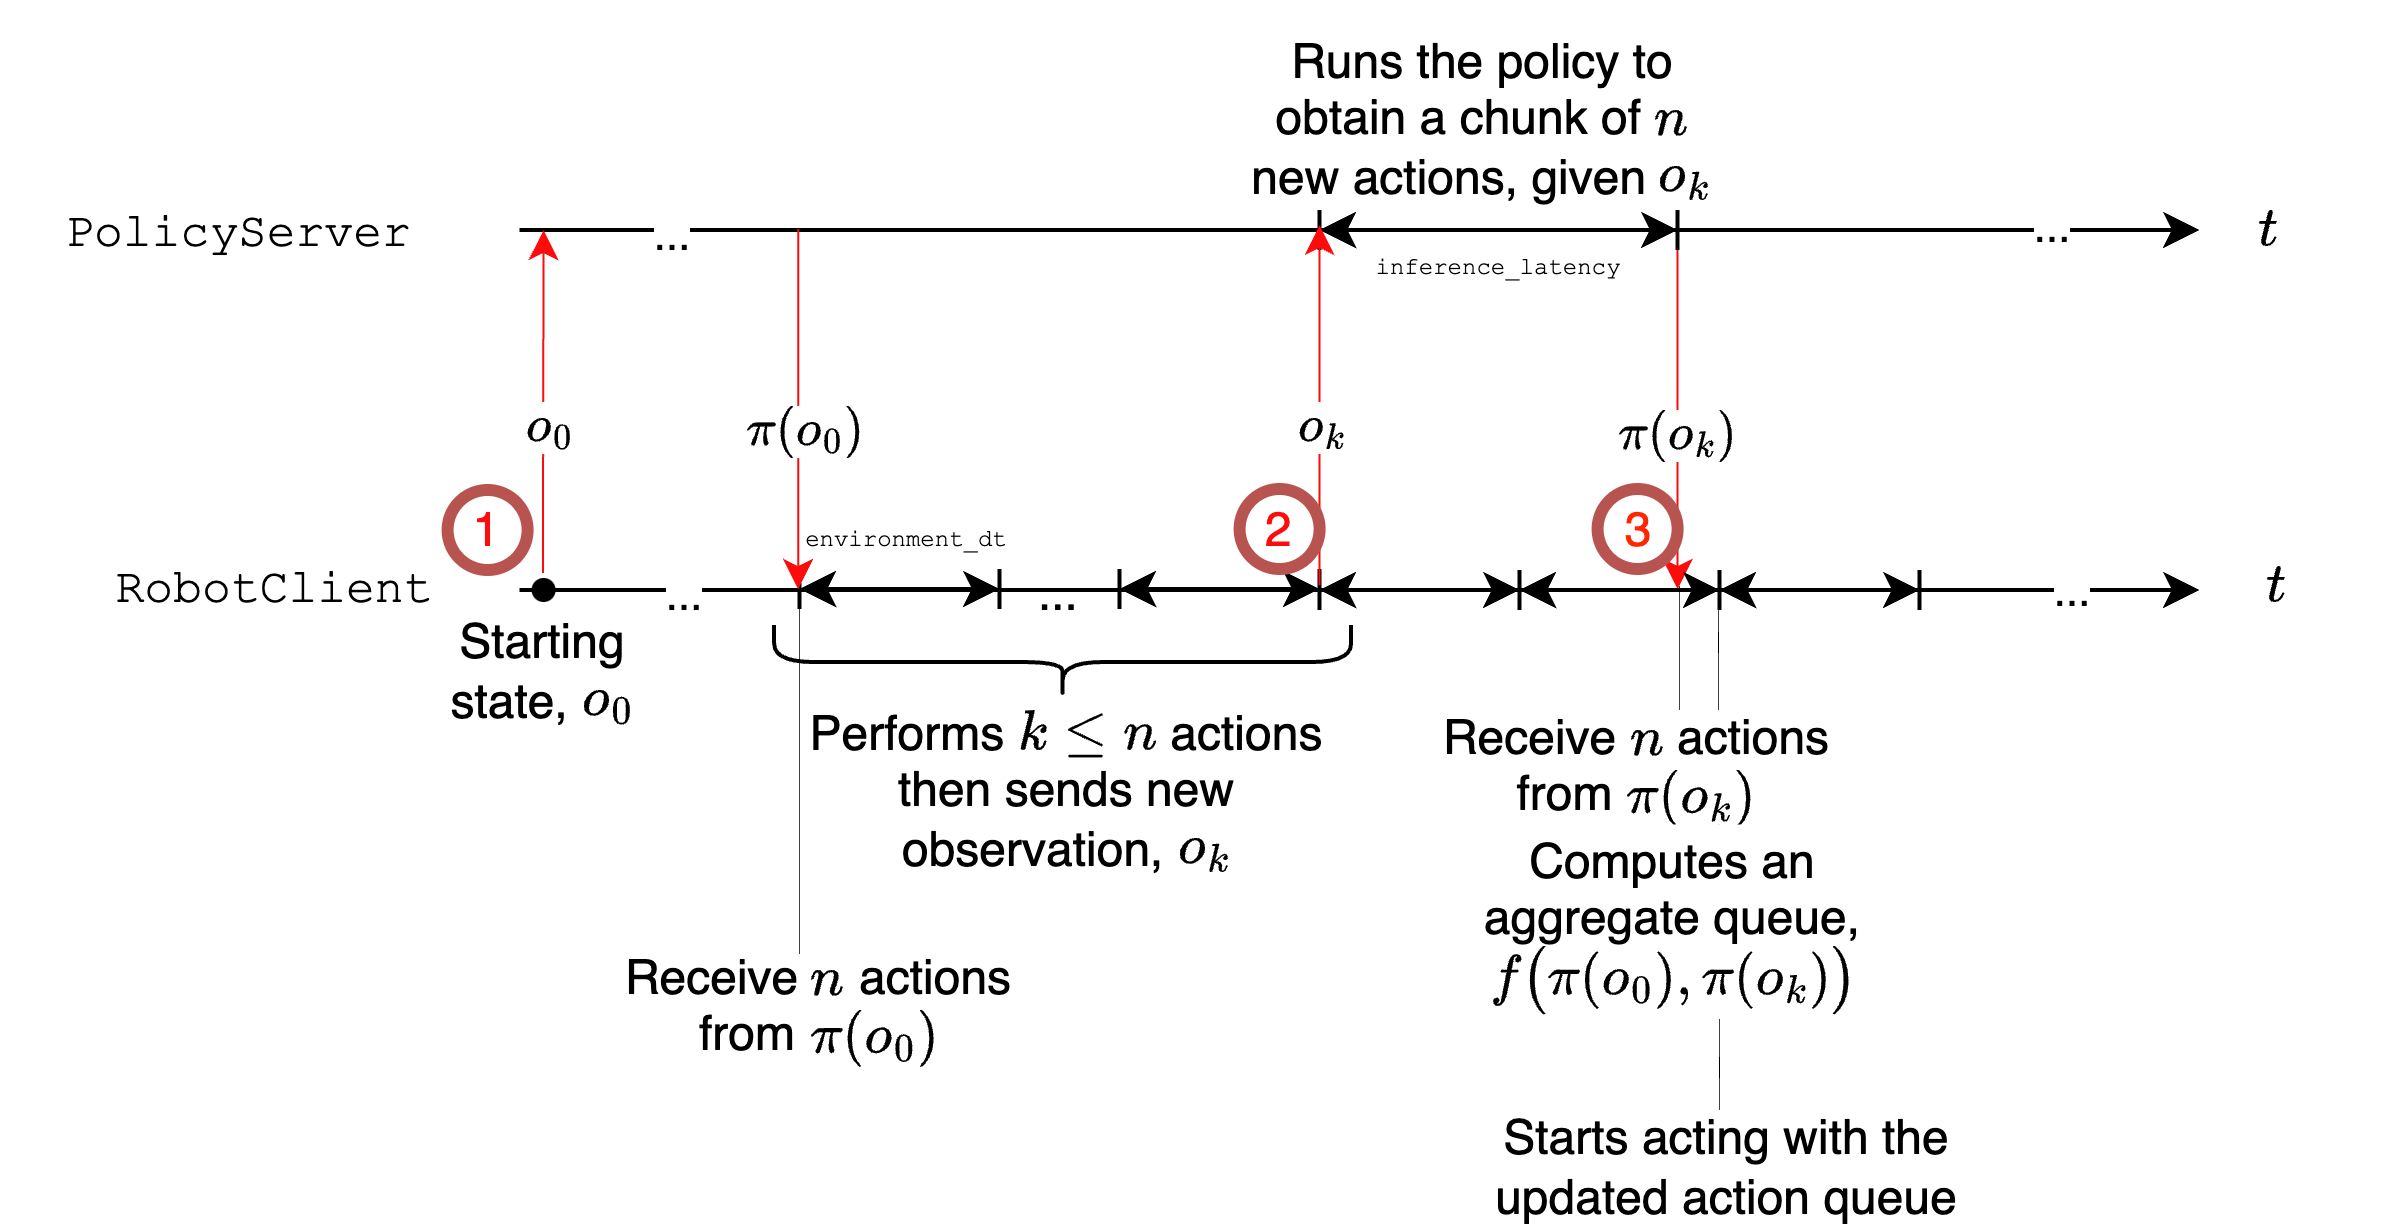
LeRobot的推理栈实现了物理分离和逻辑分离的双重解耦:
物理分离:
- 策略可以在独立的远程机器上运行
- 获得比机器人机载计算更多的计算资源
- 低级控制循环保持高频率执行
逻辑分离(异步生产者-消费者模式):
- 生产者:推理进程预测动作序列(action chunk), lookahead horizon $H$
- 消费者:环境控制以固定频率消费动作
- 聚合函数 $f$:重叠的动作块通过广义聚合函数合并,确保动作队列非空,防止机器人空闲
这种设计使得:
- 策略可以利用更强大的GPU进行推理
- 低级控制循环保持高频率执行
- 系统能够在运行时动态适应环境变化
- 支持动作块(action chunk)预测,而非单步动作
🧪 实验验证
仿真评估
LeRobot在两个主流仿真基准上验证了算法实现的有效性:
LIBERO基准:
- 包含130个长horizon操作任务,4个任务套件
- 评估模型在复杂任务规划和执行中的能力
- LeRobot的实现达到了与文献中最佳结果相当的性能
Meta-World基准:
- 包含50种不同的机器人操作任务
- 评估模型在多样化任务中的泛化能力
- 支持多任务学习(MT10/MT50)和元学习(ML1/ML10/ML45)评估
真实世界验证
低成本硬件的有效性:
- SO-100/SO-101等3D可打印机械臂能够收集高质量的演示数据
- ALOHA-2双臂系统展示了双手协调操作的能力
- 证明了低成本硬件可以支持先进的机器人学习研究
社区驱动的数据飞轮:
- 16K+数据集来自2.2K+贡献者
- SO-10X平台贡献了50%+的数据集
- 去中心化数据收集模式已超越集中式收集
算法性能对比
| 算法 | LIBERO-Spatial | LIBERO-Object | LIBERO-Goal | Meta-World |
|---|---|---|---|---|
| BC | 基线 | 基线 | 基线 | 基线 |
| ACT | 显著提升 | 显著提升 | 显著提升 | 中等提升 |
| Diffusion Policy | 显著提升 | 显著提升 | 显著提升 | 显著提升 |
| TD-MPC | 中等提升 | 中等提升 | 中等提升 | 显著提升 |
🔍 个人思考
亮点
垂直集成的完整性:LeRobot覆盖了机器人学习的完整栈——从硬件控制到数据管理,再到算法实现和推理部署。这种垂直集成大大降低了研究者的入门门槛,使得专注于算法创新而非工程实现成为可能。
低成本硬件的民主化:通过支持SO-100等3D可打印的低成本机械臂(~225€),LeRobot使得机器人学习研究不再局限于拥有昂贵设备的大型实验室。这种"硬件民主化"对于推动整个领域的发展具有重要意义。
社区驱动的数据飞轮:LeRobotDataset格式与HuggingFace Hub的无缝集成,使得数据共享变得前所未有的简单。社区贡献的16K+数据集和数百个预训练模型形成了一个良性循环——更多数据→更好的模型→更多人参与→更多数据。
异步推理的工程创新:物理分离+逻辑分离的双重解耦设计,使得策略推理和控制执行可以并行运行,这对部署大模型(如π₀的3.5B参数)到资源受限的机器人上具有重要实践价值。
局限性
机器人覆盖不完整:虽然支持8种机器人平台,但远未覆盖所有主流硬件。从2025年初的3种到现在的8种,保持这一扩展速度至关重要。
算法实现深度有限:虽然提供了多种算法的实现,但某些实现可能不如原始论文或专门的代码库那样优化。对于需要极致性能的研究,可能仍需参考专门的实现。
缺乏低级优化:当前库未包含量化、图编译等推理优化技术,这限制了大模型在边缘设备上的部署效率。
未来方向
- 更多算法集成:持续集成最新的机器人学习算法,特别是VLA模型和世界模型
- 硬件生态扩展:支持更多类型的机器人硬件,包括灵巧手和移动平台
- 推理优化:引入量化、蒸馏、图编译等技术,提升大模型的部署效率
- 跨平台迁移学习:利用大规模预训练模型实现跨机器人平台的知识迁移
📖 延伸阅读
RT-1: Robotics Transformer for Real-World Control at Scale(arXiv:2212.06817)- Google的机器人Transformer,展示了大规模数据和Transformer架构在机器人控制中的潜力,是LeRobot中实现的重要基线算法之一
Open X-Embodiment: Robotic Learning Datasets and RT-X Models(arXiv:2310.08864)- 跨机器人平台的大规模数据集和模型,展示了数据共享在推动机器人学习中的重要性,与LeRobot的数据共享理念高度一致
Diffusion Policy: Visuomotor Policy Learning via Action Diffusion(arXiv:2303.04137)- 使用扩散模型的机器人策略学习方法,是LeRobot中实现的最先进算法之一,在多模态动作分布建模方面表现出色