📄 论文信息
- 标题:LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning
- 团队:UT Austin(Bo Liu, Yifeng Zhu, Yihao Feng, Qiang Liu, Yuke Zhu, Peter Stone)+ 清华大学(Chongkai Gao),NeurIPS 2023 Datasets & Benchmarks Track
- 论文:arXiv:2306.03310
- 代码:https://github.com/Lifelong-Robot-Learning/LIBERO(2k+ Stars)
- 网站:https://libero-project.github.io
- 一句话总结:专为终身机器人学习设计的基准——包含 130 个可程序化生成的机器人操作任务,系统研究知识迁移中的策略架构、算法设计和预训练策略,揭示了一系列反直觉的实验发现。
🤔 要解决什么问题?
终身学习的核心矛盾
终身学习的目标是构建一个终身通用的智能体——它不需要一次性学会所有任务,而是在其生命周期中持续学习和适应。但现有的终身学习研究主要集中在图像和文本领域(如 CIFAR-100 的类增量学习、Mini-ImageNet 的任务增量学习),这些场景只涉及陈述性知识(declarative knowledge)的迁移——即关于实体和概念的知识。
然而决策制定中的终身学习(LLDM) 还涉及程序性知识(procedural knowledge)的迁移——即关于如何执行动作和行为的知识。考虑一个场景:
机器人最初学会了从冰箱里拿果汁。在学习了新任务后,它忘记了怎么拿果汁。这可能是忘记了果汁/冰箱的位置(陈述性知识遗忘),也可能是忘记了怎么开冰箱门或抓取果汁(程序性知识遗忘)。
关键问题:我们缺乏一个系统性的基准来定量分析这种复杂的知识迁移过程——模型到底忘了什么?为什么忘?什么样的架构和算法能更好地保留和迁移知识?
现有基准的不足
| 维度 | 图像/文本领域基准(如 CIFAR-100) | 机器人领域基准(如 MetaWorld) |
|---|---|---|
| 知识类型 | 仅陈述性知识(类别/概念) | 通常混合两种知识,难以解耦 |
| 任务多样性 | 类别标签不同,视觉特征相似 | 场景、物体、目标混在一起变化 |
| 可扩展性 | 固定数据集,无法新增任务 | 通常固定场景,不支持程序化生成 |
| 策略学习 | 分类器,无动作空间 | 有操作策略,但缺乏标准化的 LLDM 评测 |
LIBERO 的核心洞察:要真正理解 LLDM,需要一个可程序化生成、能解耦不同知识类型、支持多种策略架构和终身学习算法的标准化测试平台。
🏗️ 核心设计:四大任务套件
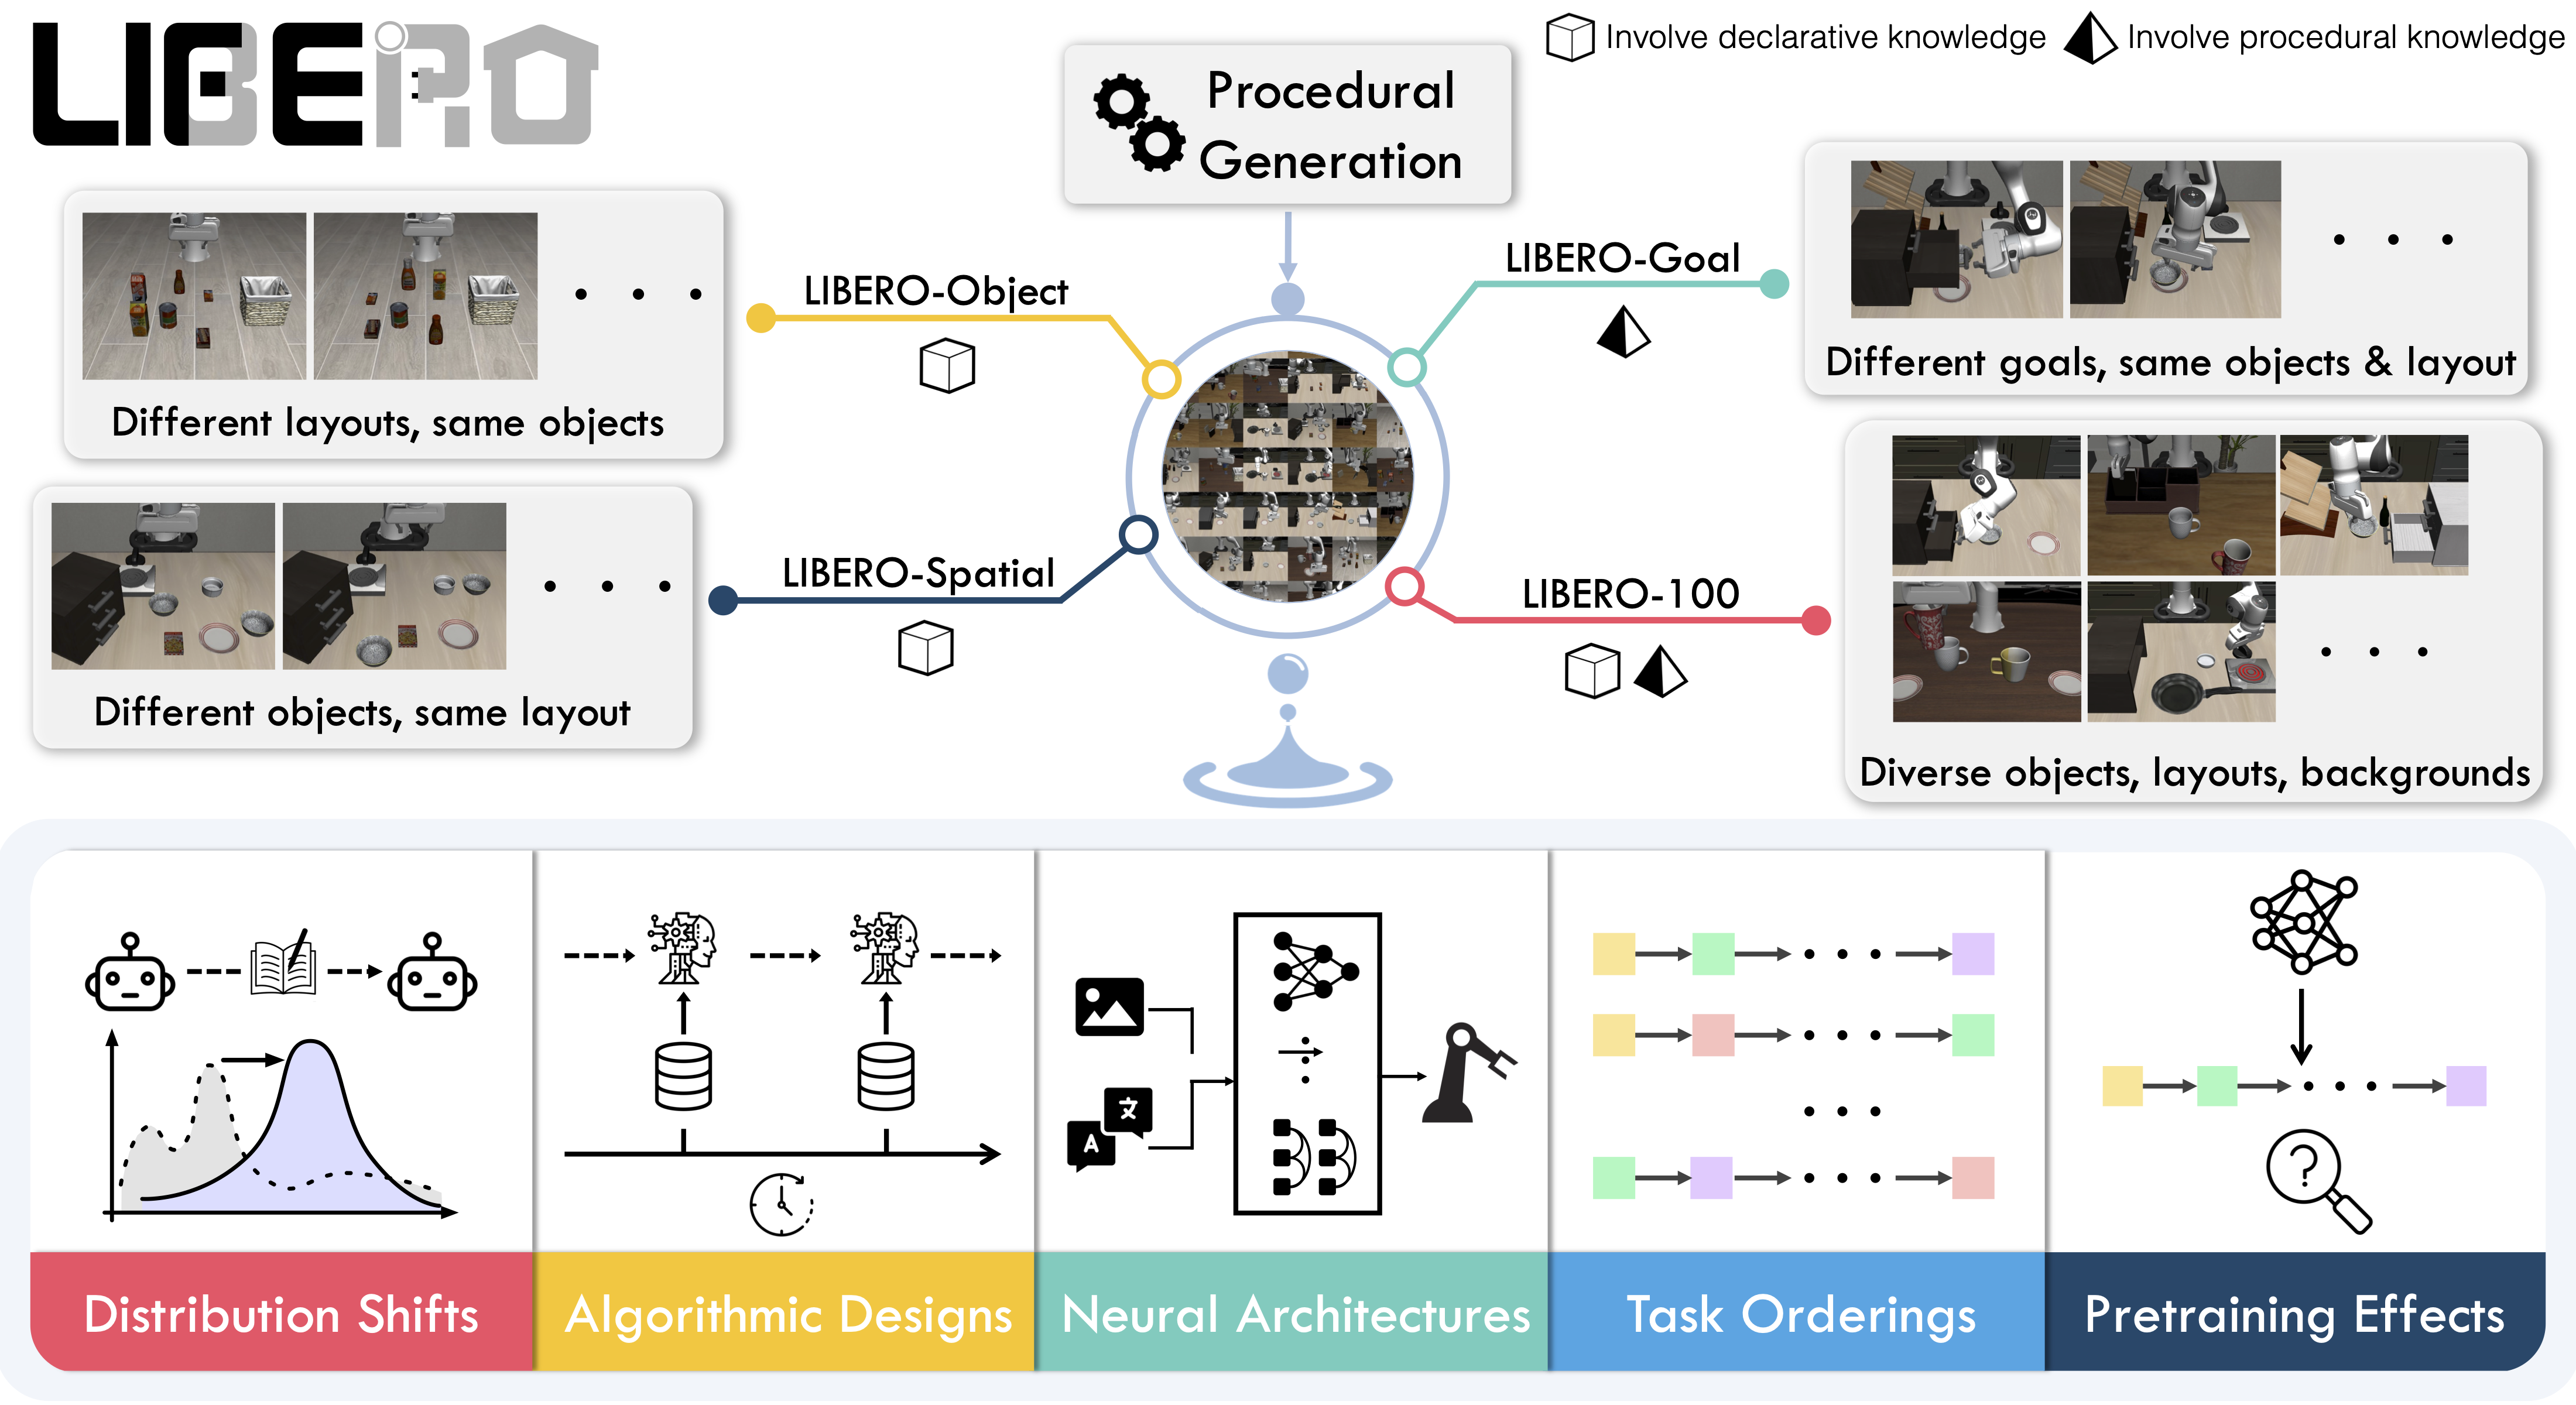
上图(Top):LIBERO 的四个程序化生成任务套件。下图(Bottom):LIBERO 聚焦的五大 LLDM 研究课题。
LIBERO 的核心设计哲学是:用一个统一的程序化生成管线,创造可解耦不同知识类型的任务套件。
四个任务套件
LIBERO 包含 130 个语言条件机器人操作任务,分为四个套件:
| 任务套件 | 任务数 | 知识迁移类型 | 设计意图 |
|---|---|---|---|
| LIBERO-Spatial | 10 | 空间关系(陈述性) | 同一组物体,不同的空间布局要求 |
| LIBERO-Object | 10 | 物体概念(陈述性) | 同一操作模式,不同的操作物体 |
| LIBERO-Goal | 10 | 任务目标(程序性) | 同一组物体和布局,不同的操作目标 |
| LIBERO-100 | 100 | 混合知识 | 真实场景下的复杂知识迁移 |
LIBERO-Spatial:空间关系迁移
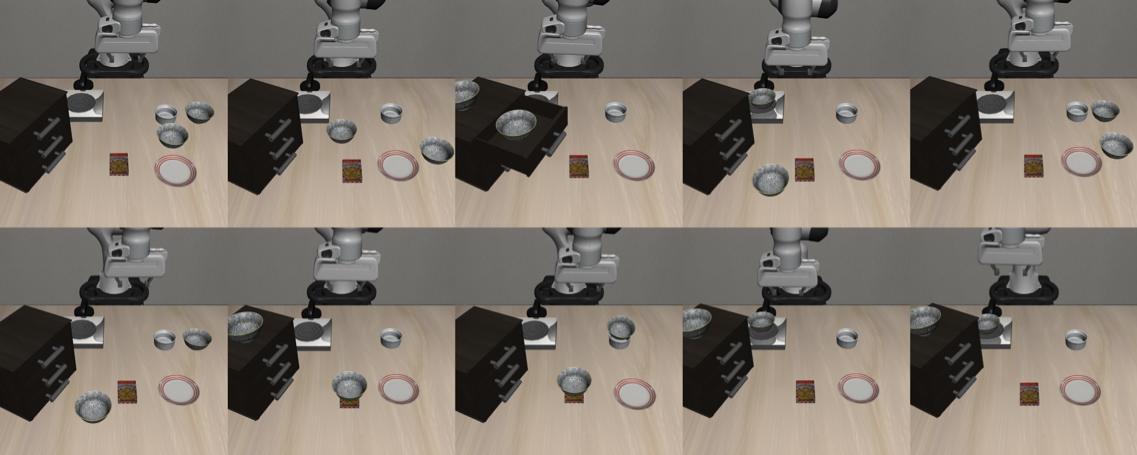
所有任务都要求机器人将一个碗放在盘子上,但碗的空间位置不同:有的在左边、有的在右边、有的在其他物体之间。机器人需要持续学习和记忆新的空间关系。
关键设计:碗的外观完全相同,唯一区别是空间位置。这样所有任务之间的差异纯粹是空间关系(陈述性知识) 的变化,排除了物体外观和操作方式的影响。
LIBERO-Object:物体概念迁移
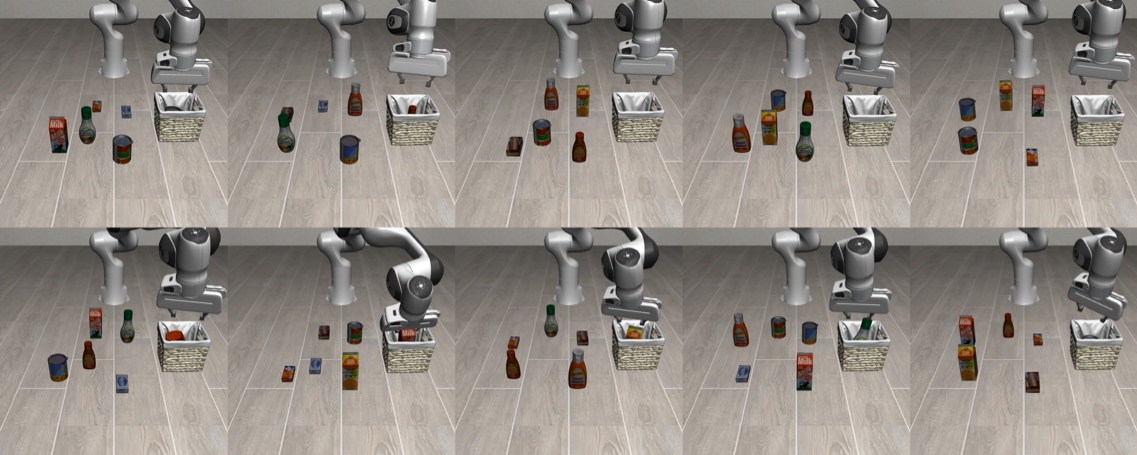
每个任务要求机器人 pick-place 一个独特的物体。例如:拿起牛奶盒放在篮子里、拿起番茄酱放在托盘上等。机器人需要持续学习新的物体类型。
关键设计:所有任务的操作模式(pick-place)完全相同,唯一变化是操作对象。这纯粹测试物体概念(陈述性知识) 的迁移,排除了空间和目标差异的影响。
LIBERO-Goal:任务目标迁移
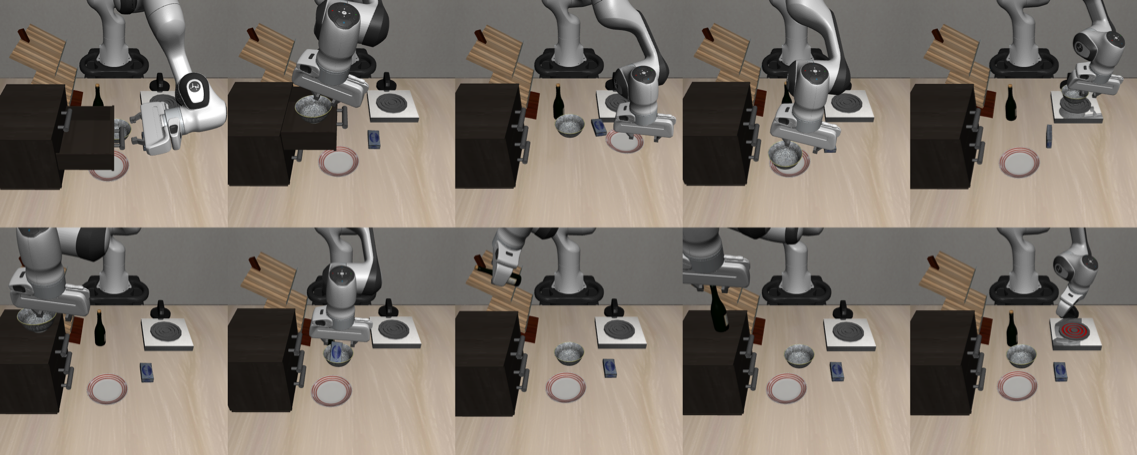
所有任务共享完全相同的物体和空间布局,但任务目标不同。例如:把碗推到桌子中间 vs 把碗翻过来。机器人需要学习新的运动和行为模式(程序性知识)。
关键设计:场景完全不变,只有"怎么做"在变化。这纯粹测试程序性知识的迁移——这是 LLDM 区别于传统终身学习的独特维度。
LIBERO-100:混合知识迁移
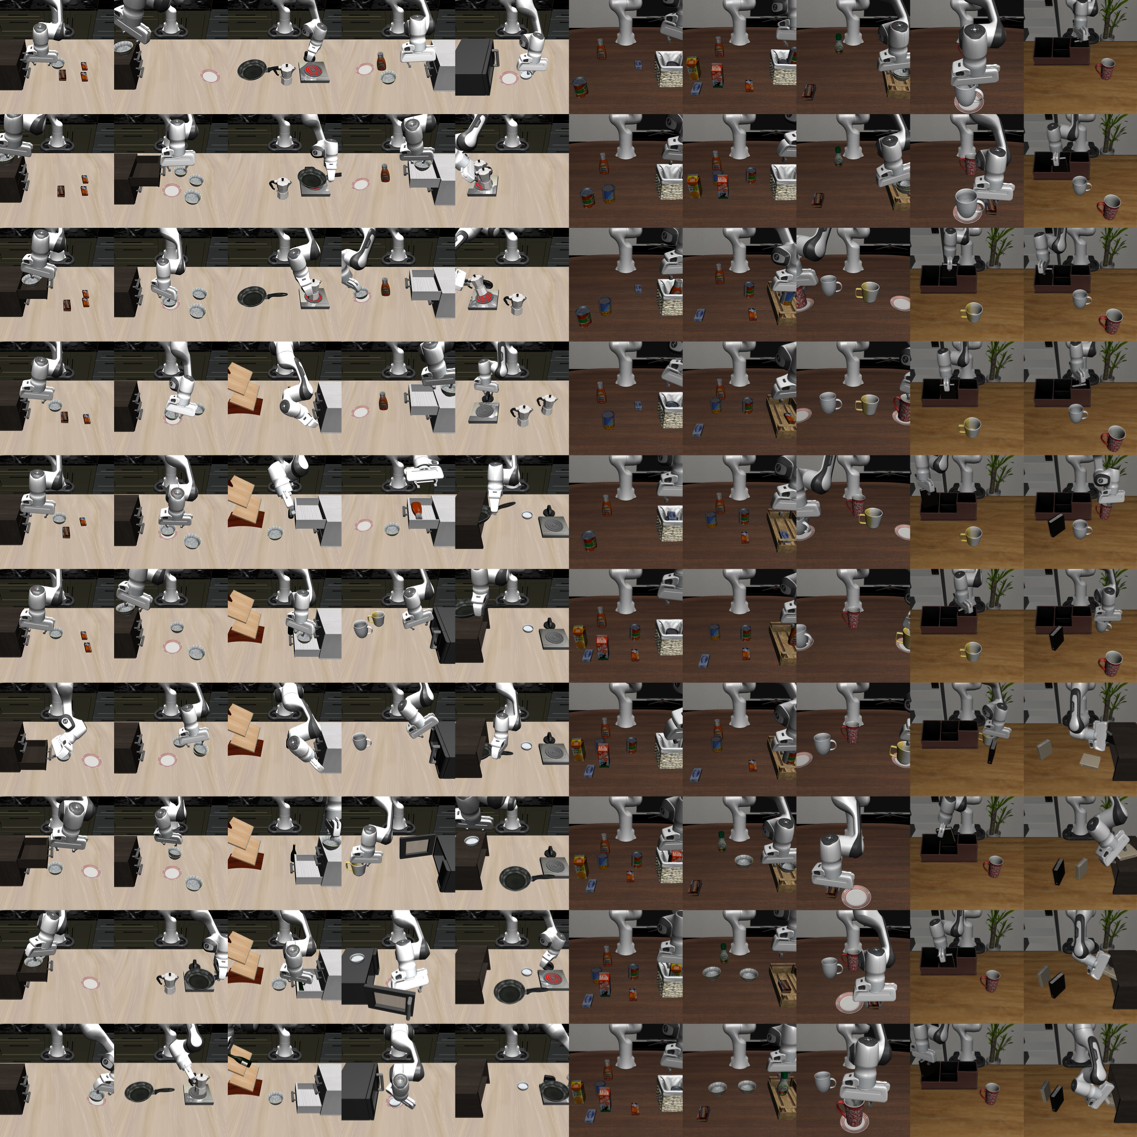
包含 100 个多样化任务,涉及丰富的物体交互和多样的操作技能。论文将 100 个任务拆分为:
- LIBERO-90:90 个短视任务,作为预训练数据源
- LIBERO-Long:10 个长视任务,用于下游终身学习算法评估
🔧 程序化生成管线
LIBERO 最有特色的工程贡献之一是其可扩展的程序化任务生成管线,理论上可以生成无限多的操作任务。
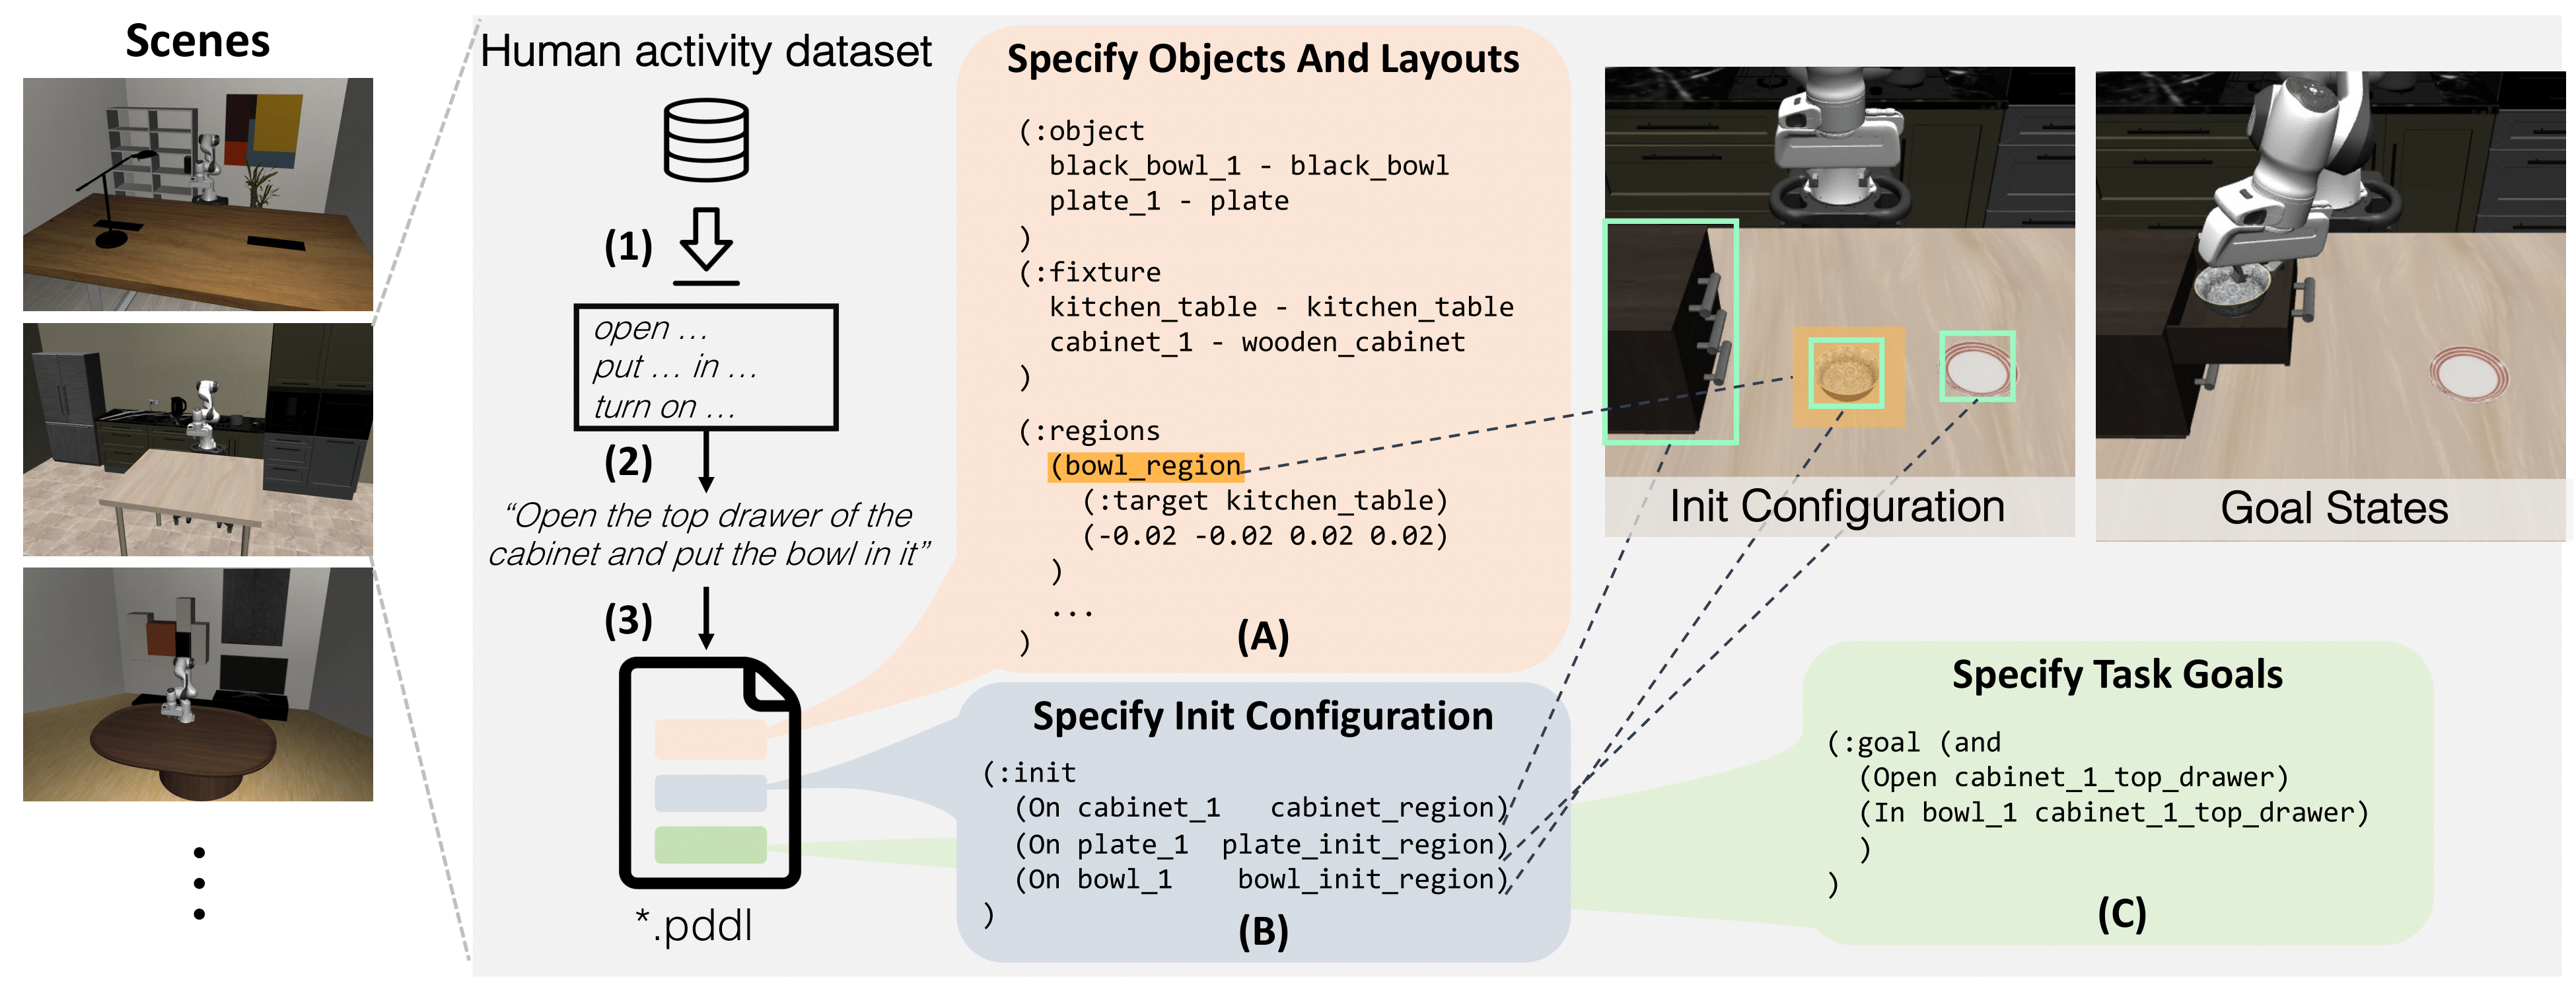
管线分为四个步骤:
- 行为模板提取:从大规模人类活动数据集 Ego4D 中提取操作行为的文本描述模板
- 任务指令生成:基于行为模板自动生成自然语言任务指令
- PDDL 描述生成:根据任务描述选择合适的场景,生成 PDDL(Planning Domain Definition Language)描述文件,包含:
- (A) 物体和布局:场景中出现的物体及其初始位置
- (B) 初始物体配置:物体的初始状态(位置、朝向等)
- (C) 任务目标:成功条件(如"碗在盘子上")
- 仿真场景构建:基于 PDDL 描述在仿真器中自动搭建场景
关键设计:所有任务共享一组视觉概念(陈述性知识)和交互模式(程序性知识),但通过排列组合生成不同的任务——这使得知识迁移的分析成为可能。
🧠 策略架构设计
LIBERO 研究了多种策略架构在 LLDM 中的表现,涵盖了视觉编码器和时序建模器的不同组合。
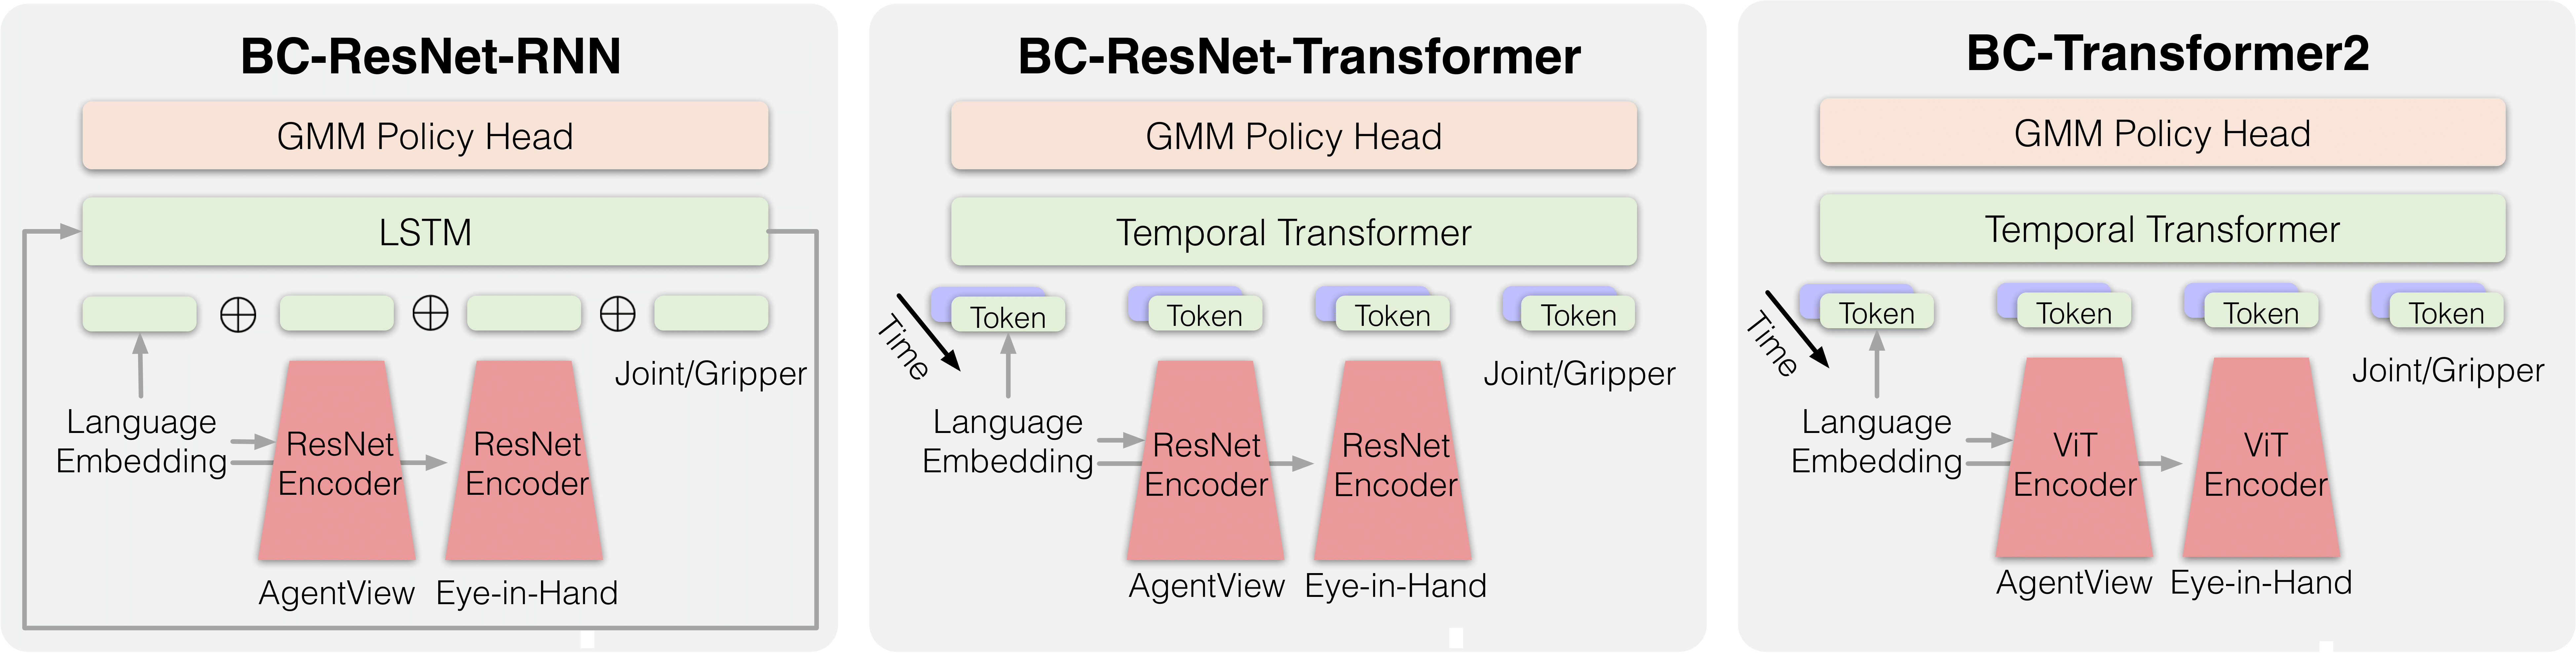
视觉编码器(Visual Encoder)
LIBERO 对比了三种视觉编码器:
| 编码器 | 类型 | 特点 |
|---|---|---|
| ResNet | 卷积网络 | 擅长局部特征,对空间结构敏感 |
| ViT | Transformer | 全局自注意力,擅长语义丰富的场景 |
| CLIP-ViT | 预训练 ViT | 在大规模图文数据上预训练,语义理解强 |
时序建模器(Temporal Modeling)
两种时序架构:
- RNN(LSTM):递归处理时序,参数少但长程依赖能力有限
- Transformer:自注意力处理时序,能更好地建模长程时序依赖
四种组合
LIBERO 实验了四种架构组合:
| 架构 | 视觉编码器 | 时序建模器 | 特点 |
|---|---|---|---|
| ResNet+RNN | ResNet | LSTM | 经典组合,参数量小 |
| ResNet+Transformer | ResNet | Transformer | 卷积特征 + 时序注意力 |
| ViT+Transformer | ViT | Transformer | 纯 Transformer 方案 |
| CLIP-ViT+Transformer | CLIP-ViT | Transformer | 预训练语义 + 时序注意力 |
 上图展示 ViT+Transformer 架构的具体实现:CLIP-ViT 编码图像,transformer 处理时序,最终由 MLP 预测动作。
终身学习算法
LIBERO 实现了三种代表性终身学习算法作为基线:
| 算法 | 类型 | 核心机制 |
|---|---|---|
| Experience Replay (ER) | 回放 | 从旧任务中采样少量数据混入新任务训练 |
| Elastic Weight Consolidation (EWC) | 正则化 | 对重要参数施加二次约束,防止大幅更新 |
| PackNet | 掩码 | 为新任务分配独立的参数子集,冻结旧参数 |
 上图为 ER(经验回放)的实现架构:新任务数据和旧任务缓存数据混合训练。
🔬 实验分析
实验设定
LIBERO 使用顺序微调(Sequential Finetuning) 作为标准评测流程:模型依次学习每个任务套件中的 10 个任务,每次学习新任务后评估所有已学任务的表现。
评测指标:
- 成功率(Success Rate):每个任务完成情况的 0/1 指标
- 正向迁移(Forward Transfer):学习新任务的速度和质量
- 反向迁移(Backward Transfer / Forgetting):学习新任务后对旧任务的影响
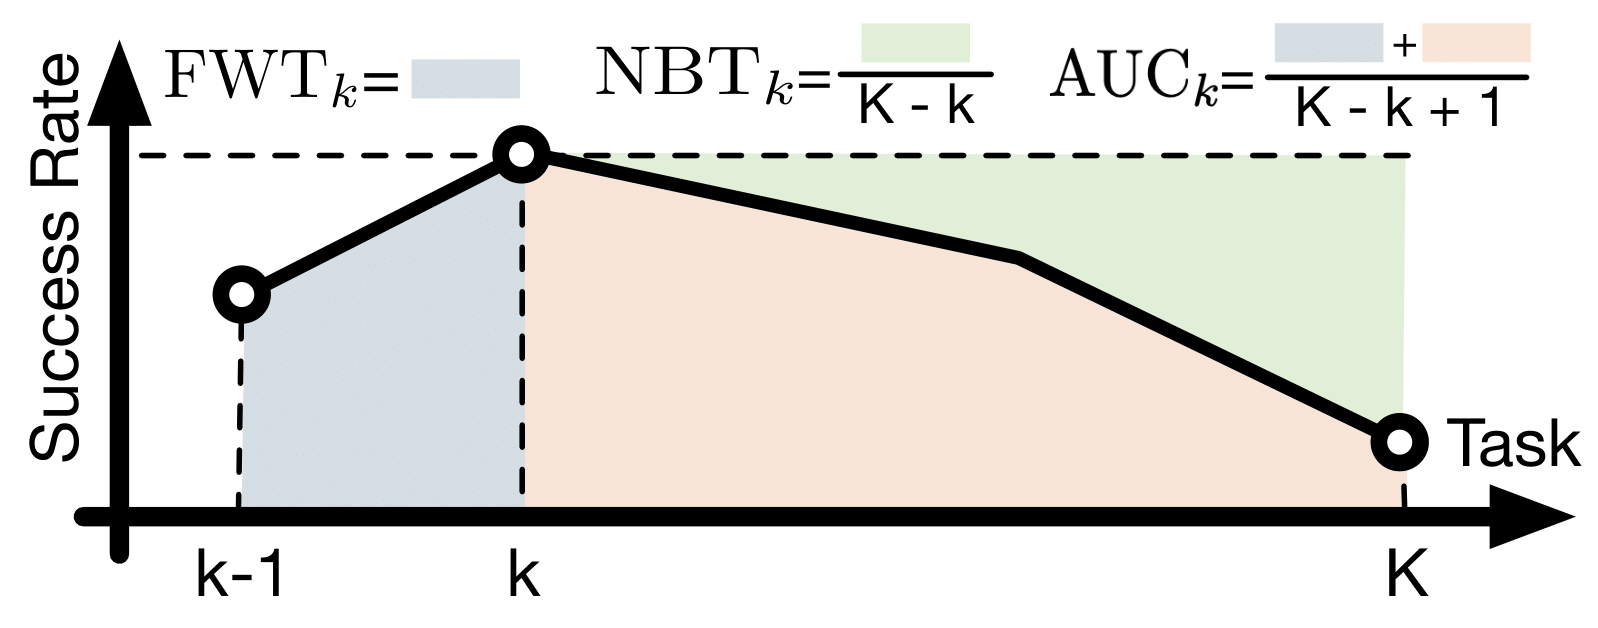 上图为 LIBERO 的评测流程:每个任务训练后评估所有已学任务,追踪正向和反向迁移。
核心发现 1:架构设计比终身学习算法更重要
| 架构 | LIBERO-Spatial | LIBERO-Object | LIBERO-Goal | LIBERO-Long |
|---|---|---|---|---|
| ResNet+RNN | 中等 | 低 | 高 | 低 |
| ResNet+Transformer | 中等 | 低 | 高 | 低 |
| ViT+Transformer | 高 | 高 | 中等 | 高 |
| CLIP-ViT+Transformer | 高 | 高 | 中等 | 高 |
三个关键发现:
- Transformer 优于 RNN:Transformer 在时序建模上全面优于 LSTM,尤其是在需要长程依赖的任务上差距明显
- ViT 在视觉丰富的任务上更强:LIBERO-Spatial 和 LIBERO-Object 包含丰富的视觉信息(多个物体、不同空间布局),ViT 的全局自注意力在此类任务上优于 ResNet
- ResNet 在程序性知识任务上有优势:在 LIBERO-Goal(纯程序性知识迁移)上,ResNet+RNN 反而表现最好——因为任务场景固定、视觉变化小,ResNet 更轻量且不容易过拟合到视觉细节
核心发现 2:顺序微调比终身学习算法正向迁移更好
| 算法 | 平均遗忘率↓ | 正向迁移↑ |
|---|---|---|
| Sequential Finetuning(顺序微调) | 最高遗忘 | 最佳正向迁移 |
| EWC | 低遗忘 | 中低正向迁移 |
| ER | 低遗忘 | 中正向迁移 |
| PackNet | 几乎无遗忘 | 最差正向迁移 |
反直觉结论:最先进的终身学习算法(EWC、PackNet)虽然在防止遗忘上非常有效,但在正向迁移(学习新任务的能力)上却不如简单的顺序微调。
解释:EWC 和 PackNet 通过约束参数更新来保护旧知识,但这种约束也限制了模型适应新任务的能力。PackNet 为新任务分配独立的参数子集,新旧任务之间几乎不共享知识,所以正向迁移最差。
核心发现 3:任务描述 vs 任务 ID——语义丰富的描述并没有帮助
| 条件 | 平均成功率 |
|---|---|
| Task ID(任务编号) | 最高 |
| Task Description(任务描述) | 无显著提升 |
| 预训练语言嵌入 | 无额外提升 |
反直觉:使用语义丰富的任务描述(如"把碗放在盘子上")作为条件,比使用简单的任务 ID(如"任务 3")并没有带来显著的性能提升。即使使用预训练语言模型(如 BERT)嵌入任务描述,表现也不如任务 ID。
可能原因:仿真环境中的视觉特征已经包含了足够的信息,语言描述提供的额外信息有限。同时也说明当前策略架构对语言条件的利用还不够充分。
核心发现 4:大规模预训练可能损害 LLDM 性能
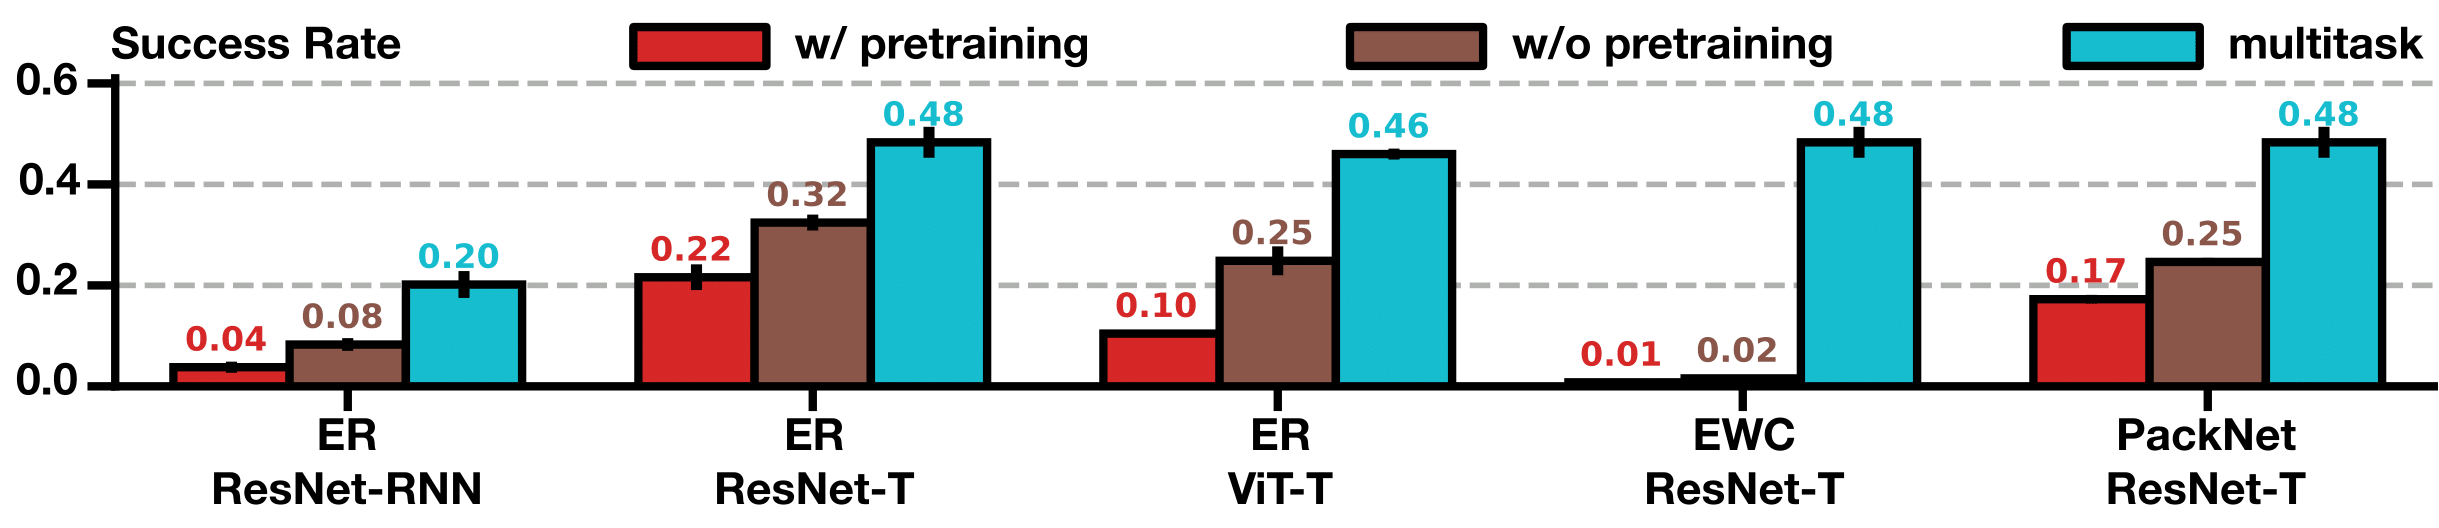 上图展示了在 LIBERO-90 上预训练后,在 LIBERO-Long 上评测的结果。橙色为预训练后微调,蓝色为直接从头训练。
| 设定 | LIBERO-Long 平均成功率 |
|---|---|
| 无预训练(从头训练) | 更好 |
| LIBERO-90 预训练 + 顺序微调 | 更差 |
反直觉:在 LIBERO-90 上做大规模有监督预训练,然后在 LIBERO-Long 上做顺序微调,效果反而不如直接从零开始训练。
解释:预训练让模型过度适应了预训练任务的分布,在后续终身学习过程中难以摆脱这种"初始偏见"。这个发现对"预训练 + 微调"范式在机器人终身学习中的有效性提出了质疑。
核心发现 5:任务顺序对学习效果有显著影响
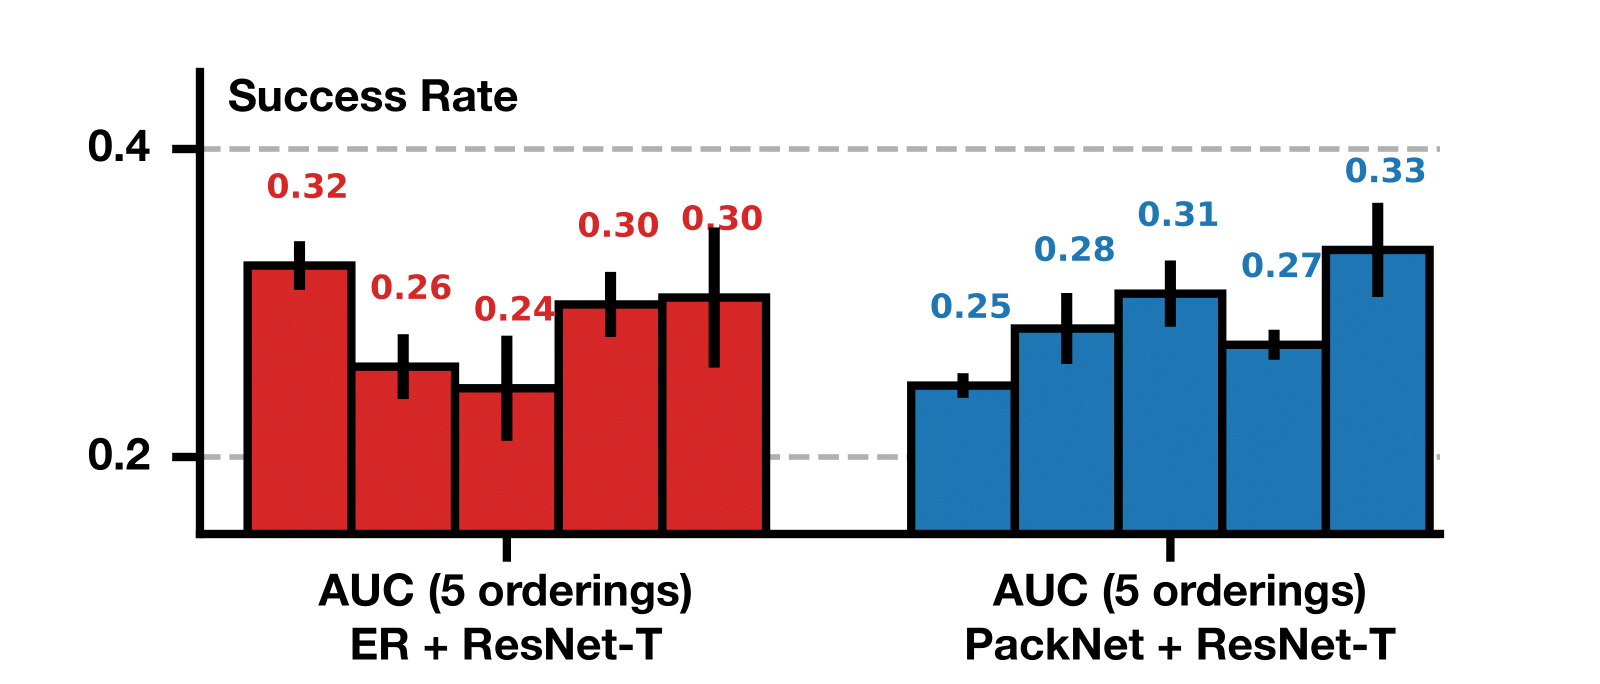 上图展示了不同任务顺序下的学习曲线变化。纵坐标为成功率,不同颜色代表不同的任务学习顺序。
同一组任务以不同顺序学习,最终性能有显著的差异。有些顺序能让模型更好地积累知识,有些则导致严重的灾难性遗忘。
实际意义:在设计终身学习课程时,任务顺序和课程学习策略是不可忽视的设计维度。
⚖️ 与其他基准的对比
| 维度 | LIBERO | MetaWorld | RLBench | CALVIN | FurnitureBench |
|---|---|---|---|---|---|
| 任务数 | 130 | 50 | 100+ | 34 | 4 |
| 终身学习支持 | ✅ 原生设计 | ❌ | ❌ | ❌ | ❌ |
| 程序化生成 | ✅ | ❌ | ❌ | ❌ | ❌ |
| 语言条件 | ✅ | ✅ | ✅ | ❌ | ❌ |
| 知识解耦 | ✅(4 个套件) | ❌ | ❌ | ❌ | ❌ |
| 人类演示数据 | ✅ 全部 130 任务 | ❌ | ✅ 部分 | ✅ | ❌ |
| 基线算法 | 3 种 LL 算法 + 4 种架构 | N/A | N/A | N/A | N/A |
🔗 后续影响
LIBERO 自 2023 年发布以来,已成为具身智能领域中终身学习和多任务学习的事实标准基准。截至 2026 年,已有大量后续工作基于 LIBERO 进行评测:
- VLA 模型的终身学习能力评估:多个 VLA 模型(如 RT-2、π0、Octo)的终身学习/多任务版本在 LIBERO 上评测
- 策略架构创新:Diffusion Policy、Flow Matching 等生成式策略在 LIBERO 上验证终身学习能力
- 预训练策略研究:CoT 推理、世界模型预训练等新范式在 LIBERO 上测试对 LLDM 的影响
- 持续学习方法:从 EWC/ER 到损失均衡、梯度投影等新方法都在 LIBERO 上对比
LIBERO 论文的代码库已积累 2k+ Stars,其程序化生成管线和标准化的评测流程成为后续机器人终身学习研究的基石。
💭 个人思考
LIBERO 的三大贡献
- 标准化了 LLDM 的研究范式——在此之前,每个人用不同的环境、不同的任务、不同的评测流程,结果无法对比。LIBERO 提供了一个"共同的靶场"。
- 解耦了知识类型——通过精心设计的四个任务套件,首次系统性地分离了陈述性知识和程序性知识在终身学习中的表现差异。
- 反直觉发现推动了后续研究——“顺序微调 > 终身学习算法”、“预训练有害”、“任务描述不比任务 ID 强”——这些发现直接挑战了学界的共识,推动了更深入的算法设计研究。
局限性
- 仿真与现实的鸿沟:LIBERO 基于仿真环境,真实的物理机器人的终身学习(磨损、校准漂移、物理接触变化)不在评测范围内
- 任务同质性:130 个任务虽然多样,但都基于桌面操作场景,缺乏移动操作、人机交互等更广泛的具身任务
- 评测维度有限:仅评估成功率,缺乏对样本效率、计算开销、推理延迟等工程维度的系统分析
对具身智能终身的展望
LIBERO 揭示的核心矛盾——保护旧知识 vs 学习新知识——在具身智能领域尤其尖锐。物理世界的机器人不像图像分类器可以轻松重放旧数据,因为:
- 物理交互成本高,无法无限量回放旧任务
- 真实的部署环境会变化(光照、物体位置、磨损)
- 机器人需要同时具备"稳定性"(保证已有能力)和"可塑性"(适应新任务)
在我看来,未来的方向不是"更好的正则化"或"更大的回放缓存",而是让模型的知识表示本身具有持续扩展性——例如通过模块化架构(为每个能力域分配独立参数模块)、通过世界模型(用仿真生成回放数据)、或者通过自然语言作为知识凝结的中介(用语言描述替代物理演示)。
📚 延伸阅读
- 奠基工作:Ellen M. Jong, Ellen’s Lifelong Learning — 终身学习提出者和早期基准
- 经典方法:Kirkpatrick et al., Overcoming catastrophic forgetting in neural networks(EWC, PNAS 2017)
- 同期工作:Wolczyk et al., Zero-shot transfer in continual RL(CoRL 2022)—— 也研究 LLDM 但侧重零样本迁移
- 后续发展:Kumar et al., Lifelong Robot Learning with Human-in-the-Loop(RSS 2024)—— 在 LIBERO 上扩展人类反馈