📄 论文信息
- 标题:Unifying Language-Action Understanding and Generation for Autonomous Driving
- 作者:王新阳(浙大), 刘倩, 丁文杰, 杨昭(项目主导), 李伟, 刘畅, 李柏霖, 战锟, 郎咸朋, 陈为(浙大)
- 团队:浙江大学 CAD&CG 国家重点实验室 & 理想汽车
- arXiv:2603.01441(Submitted: 2026-03-02)
- 收录:CVPR 2026(Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pp. 25193-25203)
- 官方链接:CVPR Open Access
- 关键词:VLA, 离散词表, 语言-动作对齐, 粗到细生成, Bench2Drive
- 一句话总结:LinkVLA 通过共享离散词表(结构链接)+ 轨迹→指令反向理解(语义链接)建立语言-动作双向对齐,再用 C2F 两步解码代替自回归,在 Bench2Drive 上 DS=91.01,延迟仅 48ms(比 AR 降低 86%)。
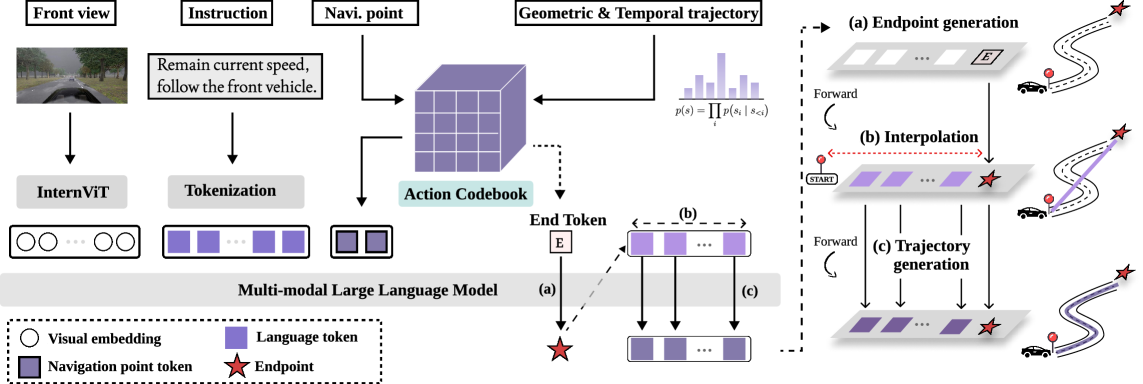
🏗️ 架构详解
LinkVLA 的整体架构遵循"视觉编码器 → LLM → 离散动作解码"的标准 VLA 范式,但有三处关键设计使其区别于其他 VLA:
数据处理流
前视相机图像
    ↓
InternViT-300M(视觉编码器) → 视觉 token(patch embeddings,~256 个)
    ↓
Qwen2-0.5B-Instruct(LLM backbone)
    ↓  ←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←←→→→→→→→→→
    ↓                                                       ↓
【训练阶段】                                           【推理阶段】
  ↓                                                       ↓
两种拼接方式随机采样:                                    C2F 两步解码:
┌─────────────────────┐                                 ┌───────────────┐
│ [V, L, A] → 预测 A   │ (动作生成)                    │ Step1: 预测终点│
│ [V, A, L] → 预测 L   │ (动作理解)                    │ (1 步解码)     │
└─────────────────────┘                                 ↓
  ↓                                                     │ 插值 → 20 粗航点│
共享词表 K = K_text ∪ K_action                         └───────┬───────┘
  │ 文本 token (≈50K)                                          ↓
  │ 动作 token (5,656)                               Step2: 并行精化→10 航点
  └────────────→ logits 投影到 K 上的概率分布              (20 步并行)
三个核心设计要点
① 共享词表(图中红色箭头):动作 token 的 embedding 直接插入到 Qwen2 的原始 embedding 矩阵中,与文本 token 在同一空间做 attention。这意味着"change lane to the left"这句话的语义表征会自然地与"向左变道"对应的动作 token 表征靠拢——因为 attention 机制会在它们之间建立直接的注意力通路。
② 双向训练(图中双箭头):不同于 VLA 只做 L→A 的单向映射,LinkVLA 在 batch 中随机选取一半样本做 A→L 的反向任务。这个设计的精妙之处在于:(V, A) → L 迫使模型关注轨迹中蕴含的场景交互信息(比如"减速"可能是因为前方有车),这些信息在纯 L→A 训练中容易被视觉特征淹没。
③ C2F 解码(图中右下角):推理时模型先输出 <path_goal> token 确定轨迹终点(宏观方向),然后根据终点几何插值出 20 个粗航点,最后用一个轻量细化网络同时优化这 20 个点得到 10 个精确航点。所有细粒度预测是并行的——这是加速的核心来源。
与其他 VLA 架构的关键区别
| 方面 | 传统 VLA(SimLingo/AutoVLA 等) | LinkVLA |
|---|---|---|
| 动作表示 | 连续坐标 + MLP 回归头 或 独立离散 head | 与文本共享同一 embedding 层的离散 token |
| 语言-动作交互 | 单向 L→A(隐式对齐) | 双向 L↔A(显式对齐) |
| 轨迹解码 | 自回归逐点 或 单步 MLP | 先终点后细化的两步 C2F |
| 词表 | 文本词表 + 独立动作映射 | 统一词表 $K_{\text{text}} \cup K_{\text{action}}$ |
🤔 要解决什么问题?
核心痛点
| 问题 | 具体表现 | 根因分析 |
|---|---|---|
| 语言-动作不对齐 | 模型说"向左变道"却输出直行轨迹;说"加速"却减速 | 语言和动作在架构层面分离:文本 tokenizer 处理语言,连续回归头处理轨迹,两者之间没有结构性对齐机制 |
| 自回归生成低效 | 预测一条 20 步轨迹需要逐 token 解码 80+ 步 | 每一步都依赖前一步输出,无法并行,推理延迟高达 361ms,远超实时要求(<100ms) |
现有方法为什么不奏效
- 数据增强法(SimLingo 2025, CAST 2026):通过扩展数据集来间接缓解对齐问题——但这是在绕开根本的建模挑战,不是从架构上保证对齐
- RL 后处理(AutoVLA 2026):在 SFT 之后通过 GRPO 强化学习校正行为——但将对齐当作"事后修正",SFT 阶段的不对齐会持续到 RL 阶段
- 隐空间分布匹配(ORION 2026):在某一中间层对齐语言和动作的隐分布——但缺乏直接可验证的监督信号
LinkVLA 的解决方案是:从架构层面建立结构级和语义级的双向链接,在 SFT 阶段就解决对齐问题。
💡 核心思想
LinkVLA 的三项创新环环相扣,分别从结构、语义、效率三个层面解决问题:
- 结构链接(Structural Link)——共享词表:语言 token 与动作 token 共用同一离散词表,从 embedding 层面消除模态鸿沟,是架构上保证对齐的根基
- 语义链接(Semantic Link)——双向理解:引入"从轨迹反推指令"的反向训练目标,迫使模型建立语言↔动作的双向映射,在训练中强化对齐
- 效率优化(C2F)——粗到细解码:两步代替多步自回归,先预测终点确定宏观方向,再插值并行细化,将延迟从 361ms 压缩到 48ms
三者关系:结构链接提供对齐基础,语义链接强化映射精度,C2F 保证实用效率。
⚙️ 方法细节
3.1 统一 Token 化框架
为什么需要动作 Token 化? 语言模型天然处理离散 token(词表中的 id),而驾驶轨迹是连续坐标序列。要让两者共享同一模型和词表,必须将连续的轨迹离散化。
方案:将 BEV 空间 $x \in [0,50]\text{m}$、$y \in [-30,30]\text{m}$ 划分为离散网格,每个网格对应一个 action token,共 $56 \times 101 = 5{,}656$ 个离散动作 token。这些 token 的 embedding 被加入到 LLM 原有文本词表(约 50K token)中,构成统一的词表 $K = K_{\text{text}} + K_{\text{action}}$。
但直接的均匀量化有两个已知问题:
- 分辨率浪费:近处(车前 0-10m)的精度需求远高于远处(40-50m),均匀网格无法自适应
- 空间拓扑丢失:One-hot 标签将相邻网格视为完全不同的类别,没有嵌入"相邻网格在物理空间中也相邻"这一先验
LinkVLA 通过两项关键技术解决:
① 对数坐标变换(Log Coordinate Transformation)
对每个坐标 $z \in \{x, y\}$ 做非线性变换,使得近处分辨率高、远处分辨率低:
$$z' = \operatorname{sign}(z) \cdot \log(1 + k \cdot |z|)$$其中 $k=5$ 控制线性区域大小。这相当于在物理空间中做非均匀量化——车前 0-5m 的每个网格对应很小的物理空间(高精度),而 30-50m 的每个网格对应很大的物理空间(低精度),与驾驶规划的实际需求一致。变换后的空间 $(x', y')$ 再进行均匀量化。
② 空间软标签(Spatial Soft-labeling)
模型预测的是 action token 上的概率分布 $p(a)$,但标准的 one-hot 交叉熵损失会惩罚任何分配到相邻 token 的概率。空间软标签构建了一个以 GT token $a_{gt}$ 为中心的高斯分布作为 target:
$$q(a) = \frac{1}{Z} \exp\left(-\frac{\|\text{pos}(a) - \text{pos}(a_{gt})\|_2^2}{2\sigma^2}\right)$$其中 $\text{pos}(a)$ 是 token $a$ 的网格坐标,$\sigma=1.2$ 控制分布范围,$R=10$ 个格子内的高斯值被考虑。
损失函数改为 soft cross-entropy:
$$\mathcal{L}_{\text{generation}} = -\sum_{a \in \mathcal{C}_{\text{action}}} q(a) \log p(a)$$这一设计的好处:即使模型预测到 GT token 的相邻网格,也只受到轻微惩罚,让模型学习到动作空间的平滑性。
3.2 统一语言-动作理解与生成(双向训练)
核心洞察:在视觉-语言建模中,图像→文本(caption)和文本→图像(generation)是互逆任务,同时训练两者能产生更鲁棒的联合嵌入空间(类比于 CLIP 的双向对比学习)。LinkVLA 将这一思想扩展到语言-动作映射。
正向——动作生成(Action Generation):给定视觉场景 $V$ 和语言指令 $L$,预测动作序列 $A$:
$$p(A|V,L)$$反向——动作理解(Action Understanding):给定视觉场景 $V$ 和执行过的动作序列 $A$,推断指令 $L$:
$$p(L|V,A)$$训练目标为两者加权和:
$$\mathcal{L}_{\text{total}} = \mathcal{L}_{\text{generation}} + \lambda \mathcal{L}_{\text{understanding}}$$$$\mathcal{L}_{\text{understanding}} = -\sum_j \log p(l_j | V, A, l_{1:j-1})$$其中 $l_{1:j-1}$ 表示前 $j-1$ 个已生成的文本 token(标准自回归分解)。$\lambda$ 是一个平衡超参数。
训练时,每个 batch 中随机将 $(V, L, A)$ 拼接为两种格式:
- $[V, A, L]$:监督 $L$ 的输出,执行动作理解任务
- $[V, L, A]$:监督 $A$ 的输出,执行动作生成任务
两种格式共享同一个模型参数,通过 attention mask 控制不同的预测目标。
3.3 粗到细生成(C2F)
传统 VLA 在推理时用自回归逐个预测轨迹点,每步依赖上一步的输出,无法并行。LinkVLA 提出了两步生成方案。
训练阶段:引入两个特殊 token —— <path_goal> 和 <waypoint_goal>。模型学会:
- 在看到
<path_goal>时预测整个轨迹的终点位置 - 在看到
<waypoint_goal>时输出细化后的精确航点
推理阶段分三步:
- Step 1 — 路径终点预测:模型输出
<path_goal>对应的终点 token(1 步解码),得到轨迹的宏观方向 - Step 1.5 — 插值:根据预测终点,通过简单的几何插值生成 20 个粗航点(path tokens),作为细化阶段的起点
- Step 2 — 并行精化:20 个粗航点同时通过细化网络,得到 10 个最终精化航点(waypoint tokens),所有细化计算可并行
| 解码方式 | 解码步数 | 总延迟 | DS | 加速比 |
|---|---|---|---|---|
| 标准自回归 (AR) | 80+ token | 361ms | 90.66 | 1× |
| C2F(两步) | 2 步 | 48ms | 91.01 | 7.5× |
有趣的是 C2F 不仅加速,还提升了 DS(从 90.66 到 91.01)。这是因为"先定方向再细化"的归纳偏置天然有利于生成合理轨迹——AR 模型可能在逐步解码中累积方向偏差。
模型与训练配置
模型结构:
- Vision Backbone:InternViT-300M-448px(InternVL2-1B 系列中的视觉编码器)
- LLM:Qwen2-0.5B-Instruct(0.5B 参数的轻量语言模型)
- 总参数量:约 1B
训练细节:
- 微调方式:LoRA(rank=32,$\alpha=64$),只训练 adapter,不更新全量参数
- 训练轮数:30 epochs
- 计算资源:32 × H20 GPU,batch size = 48
- 优化器:AdamW,lr = 1e-4,weight decay = 0.1,cosine 学习率调度
- 数据:用 PDM-lite 专家在 CARLA v2 Bench2Drive 场景中采集
推理细节:
- 采用 CoT 方式:先生成文本解释(commentary),再基于 commentary + 视觉特征预测 action sequence
- 每帧输出 20 个 path tokens + 10 个 waypoint tokens
- C2F 的延迟 48ms 已排除了 CoT 的时间(因为 CoT 是可选配置)
🧪 实验与结果
基准说明:Bench2Drive
Bench2Drive(Jia et al., 2025)是 CARLA v2 上最全面的闭环评测基准之一,包含 44 种交互场景 × 5 条路线 = 220 条官方测试路线,覆盖多种天气条件(晴天、阴天、雨天、黄昏等)。评估指标包括:
- Driving Score (DS):综合分数,反映整体驾驶质量
- Success Rate (SR):任务完成率
- Efficiency:路线完成效率
- Comfortness:驾驶舒适度
- Multi-Ability:在 7 种子能力上的平均表现
4.1 Bench2Drive 主动循环评估(Table 1)
闭环指标对比:
| 方法 | 类型 | DS ↑ | SR (%) ↑ | 效率 ↑ | 舒适度 |
|---|---|---|---|---|---|
| UniAD-Base (Hu et al., 2023) | IL(端到端) | 45.81 | 16.36 | 129.21 | 43.58 |
| VAD (Jiang et al., 2023) | IL(向量化) | 42.35 | 15.00 | 157.94 | 46.01 |
| DriveTransformer (Jia et al., 2025) | IL(Transformer) | 63.46 | 35.01 | 100.64 | 20.78 |
| Orion (Kumar et al., 2025) | VAE 规划 | 77.74 | 54.62 | 151.48 | 17.38 |
| AutoVLA (Yue et al., 2026) | VLA + GRPO | 78.84 | 57.73 | 146.93 | 39.33 |
| SimLingo (Yuan et al., 2025) | VLA(MLP head) | 85.07 | 67.27 | 259.23 | 33.67 |
| LinkVLA (Ours) | VLA(共享词表) | 91.01 | 74.55 | 255.84 | 34.62 |
LinkVLA 在 DS 上超越 SOTA SimLingo 达 5.94 分(+6.98% 相对提升),SR 提升 7.28 分(+10.82%)。相比同为 VLA 但使用 MLP head 的 SimLingo,LinkVLA 的共享词表方案证明了对齐带来的不仅仅是"说做一致"的改善,也直接提升了驾驶质量。
多能力分解:
| 子能力 | SimLingo | LinkVLA | 提升 |
|---|---|---|---|
| Merging(汇入车流) | 53.75 | 60.00 | +6.25 |
| Overtake(超车) | 68.89 | 80.00 | +11.11 |
| Brake(制动) | 81.67 | 93.33 | +11.66 |
| Give-Way(让行) | 50.00 | 50.00 | 0 |
| Traffic-Sign(交通标志) | 82.11 | 83.68 | +1.57 |
| Multi-Ability 平均 | 67.28 | 73.40 | +6.12 |
提升最显著的是 Brake(制动,+11.66)和 Overtake(超车,+11.11)——这两项都是对指令跟随要求极高的能力:急刹车对应"减速"指令、超车对应"变道+加速"的组合指令。LinkVLA 在指令跟随上的优势自然地转化为了场景驾驶能力的提升。
4.2 指令跟随评估(Table 3)
使用 SimLingo 的 Action Dreaming 数据集,在 CARLA Town 13 上评估 6 类语言指令的跟随成功率:
| 配置 | 统一词表 | C2F | 对齐训练 | Faster | Slower | Target Spd | Lane Change | Object | Stop | 均值 |
|---|---|---|---|---|---|---|---|---|---|---|
| ① 基线 (SimLingo) | ✗ | ✗ | ✗ | 81.42 | 61.83 | 66.27 | 75.53 | 74.69 | 60.93 | 70.11 |
| ② +Token | ✓ | ✗ | ✗ | 88.44 | 65.24 | 63.37 | 88.49 | 84.34 | 99.88 | 81.63 |
| ③ +C2F | ✓ | ✓ | ✗ | 93.16 | 55.86 | 69.24 | 95.45 | 85.38 | 92.14 | 81.87 |
| ④ 完整 | ✓ | ✓ | ✓ | 96.48 | 65.57 | 74.73 | 97.42 | 91.41 | 97.34 | 87.16 |
逐项分析:
- 统一词表(②→①)带来 +11.52 的巨幅提升,说明结构性对齐的基础性作用
- C2F(③→②)变化不大(+0.24),说明解码方式本身不影响模型的对齐能力
- 对齐训练/动作理解目标(④→③)贡献 +5.29,尤其在 Faster(+3.32)和 Stop(+5.20)上——这两个是最需要理解"加速/减速"语义的指令
4.3 语言能力评估(Table 4)
DriveLM-hard VQA 和 Commentary 生成评测(SPICE / BLEU / ROUGE-L):
| 配置 | VQA SPICE | VQA BLEU | VQA ROUGE-L | Com. SPICE | Com. BLEU | Com. ROUGE-L |
|---|---|---|---|---|---|---|
| ① 基线 | 66.7 | 68.9 | 71.5 | 49.2 | 60.3 | 64.3 |
| ② +Token | 69.7 | 70.5 | 73.1 | 53.3 | 63.7 | 68.0 |
| ③ +C2F | 71.3 | 69.9 | 73.4 | 53.6 | 61.6 | 67.3 |
| ④ 完整 | 73.0 | 74.7 | 77.0 | 57.4 | 65.7 | 70.8 |
引入动作理解反向目标(④→③)在语言指标上的提升表明:让模型学会从轨迹反推文本,反过来增强了模型的文本生成能力——这是因为轨迹编码中包含了丰富的场景信息(在哪里、做了什么),这些信息通过反向任务被更好地融合到了语言表示中。
4.4 消融实验(Table 5)
| 统一词表 | C2F | 对齐训练 | DS | SR (%) | 对应消融贡献 |
|---|---|---|---|---|---|
| ✗ | ✗ | ✗ | 85.07 | 67.27 | SimLingo 基线 |
| ✓ | ✗ | ✗ | 89.57 | 73.18 | +Token: DS +4.50 |
| ✓ | ✓ | ✗ | 89.85 | 72.27 | +C2F: DS +0.28(但延迟↓86%) |
| ✓ | ✓ | ✓ | 91.01 | 74.55 | +Align: DS +1.16 |
关键发现:
- 统一词表贡献最大(DS +4.50)——这是 LinkVLA 最核心的技术贡献
- C2F 对性能几乎没有影响(DS +0.28),但大幅降低延迟——是纯工程优化
- 对齐训练(DS +1.16)主要是提升指令跟随,在基本驾驶能力上影响有限
4.5 推理延迟分析(Table 2)
| 方法 | 解码方式 | 延迟 | DS | 延迟-性能权衡 |
|---|---|---|---|---|
| Orion | VAE(单步) | 65ms | 77.74 | 低延迟但性能差 |
| SimLingo | MLP(单步) | 34ms | 85.07 | 最低延迟,中等性能 |
| LinkVLA (AR) | 自回归(80+步) | 361ms | 90.66 | 高性能但延迟超标 |
| LinkVLA (C2F) | 两步 | 48ms | 91.01 | 最佳均衡点 |
C2F 在延迟上击败了自回归(361ms→48ms),接近 SimLingo 的 34ms,但性能更优。这说明 C2F 是一个"两全其美"的方案——既有接近 MLP head 的效率,又保留了统一词表的对齐优势。
🔬 深入分析:LinkVLA 为什么有效?
共享词表的类比意义
从表征学习的角度看,共享词表相当于在 50K 文本 token 和 5.6K 动作 token 之间建立了隐含的语义连接桥梁。当 LLM 在处理"change lane to the left"这句话时,其内部的 attention 机制会自动将这句话的语义表征与"向左变道"对应的动作 token 表征拉近,因为它们在 embedding 空间中共享同一个投影矩阵。
动作理解任务的微妙之处
这个反向任务的训练样本不需要额外标注——只要有一条轨迹和对应的指令,就可以构造成 $(V, A) \rightarrow L$ 的样本。在自动驾驶数据集中,指令通常是弱标注的(有些来自场景描述,有些来自自动生成),但 LinkVLA 的动作理解目标对这些弱标注不敏感,因为它的反向任务本身就是"从执行结果反推意图",而不是"与精确文本匹配"。
与领域其他工作的关系
| 工作 | 对齐方式 | 延迟 | 性能 | 核心思路 |
|---|---|---|---|---|
| SimLingo | 数据增强 | 34ms | 85.07 | 增加对齐数据数量 |
| ORION | 隐空间匹配 | 65ms | 77.74 | 在 VAE 隐空间对齐 |
| AutoVLA | RL 后训练 | ~400ms | 78.84 | SFT 不对齐然后 RL 纠正 |
| LinkVLA | 架构对齐 | 48ms | 91.01 | 从架构保证对齐 |
| NoRD | 放弃推理 | ~120ms | ~85.6 | 不需要对齐,直接映射 |
⚠️ 局限与未来方向
- 仿真局限:仅在 Bench2Drive(CARLA v2)上验证,无 NAVSIM 或真实世界路测结果。Bench2Drive 虽然场景丰富(44 场景),但仍是仿真环境
- 超参数敏感性:对数坐标变换的 $k$ 值(=5)需要根据车速范围调整;动作理解损失的 $\lambda$ 需要调参
- C2F 的单点故障:第一步终点预测如果出错,插值和细化阶段无法纠正——这是一个"先射箭再画靶"的潜在风险
- 未探索 RL 阶段:与 AutoVLA 对比,LinkVLA 未使用 GRPO 做 RL 后训练。在 LinkVLA 的对齐基础上叠加 RL 可能进一步提升性能
- 模型规模:仅使用 1B 模型,更大规模(7B+)的扩展性未探索
📝 个人思考
LinkVLA 最让我欣赏的是设计的优雅性:它不像其他 VLA 那样在模型之后接额外的 MLP head 或 diffusion 模块,而是直接修改了 token 化层——把驾驶轨迹变成和文本一样的离散 token。这种"侵入式"的设计虽然工程上更复杂(需要重写 tokenizer、处理位置编码等),但从信息论的角度看是最彻底的模态统一方案。
与同类离散 token 范式的对比:LinkVLA vs AutoVLA
AutoVLA(Yue et al., CVPR 2026)和 LinkVLA 的共同点是都将动作轨迹离散化为 token,但在具体实现上有本质区别:
| 对比维度 | AutoVLA | LinkVLA |
|---|---|---|
| 词表设计 | 动作 token 独立于文本词表,通过额外 head 映射 | 动作 token 直接插入 LLM embedding 矩阵,与文本共享 |
| 对齐方式 | 隐式对齐(SFT 阶段 L→A 单向学习),不对齐后果被推到 RL 阶段修正 | 显式对齐(共享词表保证结构对齐 + 反向理解任务强化语义对齐) |
| 训练流程 | SFT → GRPO(先学基础,再用 RL 纠偏) | 端到端双向训练(无 RL 阶段) |
| 解码效率 | 自回归逐 token 解码(~400ms 延迟) | C2F 两步解码(48ms 延迟) |
| 指令跟随 | RL 后训练提升,但 SFT 阶段天然不对齐 | 共享词表 + 反向训练在 SFT 阶段就内建了对齐能力 |
为什么 AutoVLA 不直接使用共享词表? 这很可能是工程权衡:AutoVLA 基于 InternVL2-8B(比 LinkVLA 的 1B 大 8 倍),修改 8B 模型的 embedding 层需要额外显存和训练成本。LinkVLA 选择 0.5B LLM 作为 backbone,修改 embedding 的成本相对可控。这揭示了一个有趣的设计空间:模型规模 → 对齐策略。小模型适合从架构上硬对齐(LinkVLA 路线),大模型可能更适合在 SFT 后通过 RL 软对齐(AutoVLA 路线),因为修改大模型架构的边际成本太高。
LinkVLA + RL 会怎样? 这是最让人好奇的问题。LinkVLA 的双向训练已经建立了很好的对齐基础(DS=91.01),如果再叠加 AutoVLA 式的 GRPO 后训练,效果可能进一步提升。但需要注意的是:LinkVLA 的共享词表是一个离散动作空间,而 GRPO 在离散空间上的 KL 散度计算天然稳定——这恰好是 AutoVLA 的连续动作空间所不具备的优势。换句话说,如果在 LinkVLA 基础上做 GRPO,既享受了架构对齐的好处,又免去了连续空间 RL 不稳定的困扰。
离散 token 化方向的启示
LinkVLA 和 AutoVLA 共同指向一个趋势:VLA 正从"语言模型 + 连续动作头"向"统一离散词表"演进。这个趋势让我想起 2023-2024 年图像生成领域从 diffusion→VQGAN→VQVAE-2 的范式迁移——一旦某个模态被成功离散化,它就能与语言模型无缝整合。
对于 Flow-GRPO 项目,LinkVLA 的共享词表设计提供了一个直接可用的思路:如果将策略网络输出的连续动作先通过对数坐标变换离散化,再用 GRPO 在离散 token 空间优化,可以在保持端到端可微的同时,利用离散空间的统计稳定性来加速 RL 收敛。
📖 这是论文精读系列的第 XX 篇。语言和动作的统一词表是 VLA 对齐的一条优雅路径,但"对齐之后如何利用 RL 进一步提升"仍然是一个开放问题。欢迎留言讨论。