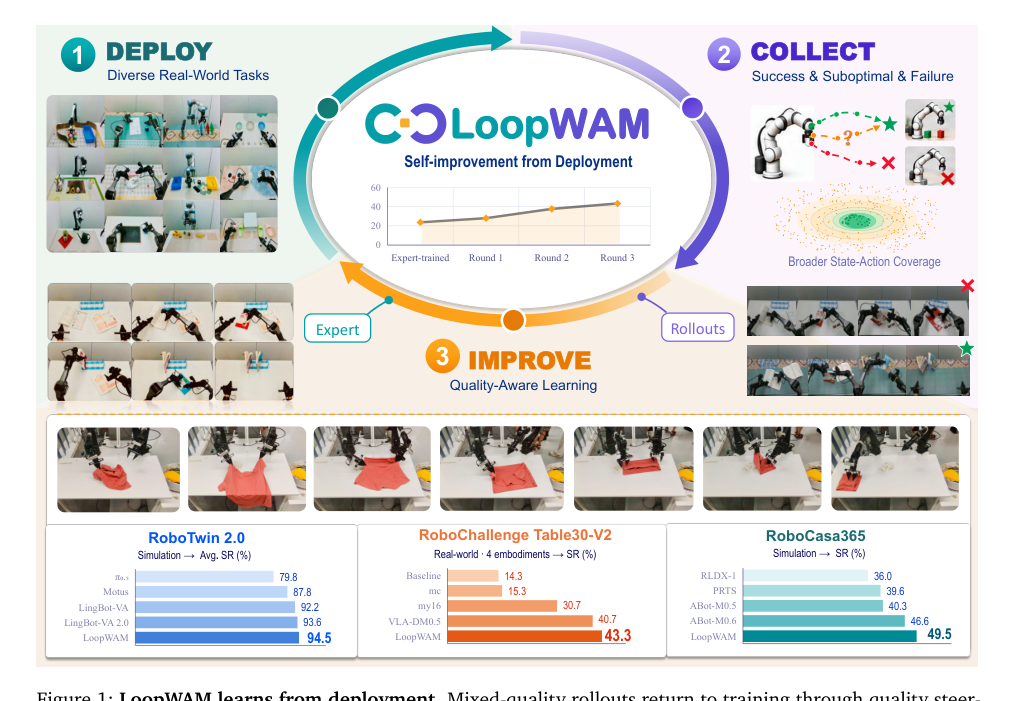
配图说明:本文收录论文全部 14 张插图(Figure 1 ~ Figure 14),放在站内 /images/loopwam/,逐张讲解,文末附图表总索引表。论文来自清华大学、Dexmal(桌面灵巧操作公司)、Loopeva,arXiv 2610.18873(v2 2026-10-15)。这篇是 2026 年下半年「部署-训练闭环」方向最有冲击力的一篇:它把 RL 飞轮的原料(成功/次优/失败混合 rollout)直接熔进 WAM 的训练目标里,而不是用奖励或筛选丢一半信息。
📄 论文信息
- 标题:LoopWAM: Closed-Loop Generalist Policy Improvement from Deployment Rollouts
- 机构:清华大学、Dexmal、Loopeva(一作 Wenxuan Guo,通讯 Xiuwei Xu / Meng Zhang / Jiwen Lu)
- 时间:2026-10(arXiv 2610.18873 v2,2026-10-15)
- 关键词:闭环自进化(closed-loop self-improvement)、混合质量 rollout(mixed-quality rollouts)、source-dependent 噪声采样、quality steering、quality-weighted 监督、MoT 双流、RoboChallenge Table30-V2
- 一句话总结:失败的轨迹不是垃圾,是免费的物理课。专家数据 → 动作专家(模仿主体);次优 rollout → 弱化模仿但保留视频监督;失败 rollout → 只有视频监督(学习「这样操作会发生什么」)。同一个模型、同一个去噪阶段、三种角色按质量分流,然后部署 → 收集 → 再训练 → 再部署,循环往复状态持续上升。
🎯 一句话版本:核心数字
| Benchmark | LoopWAM | 最强对手 | 备注 |
|---|---|---|---|
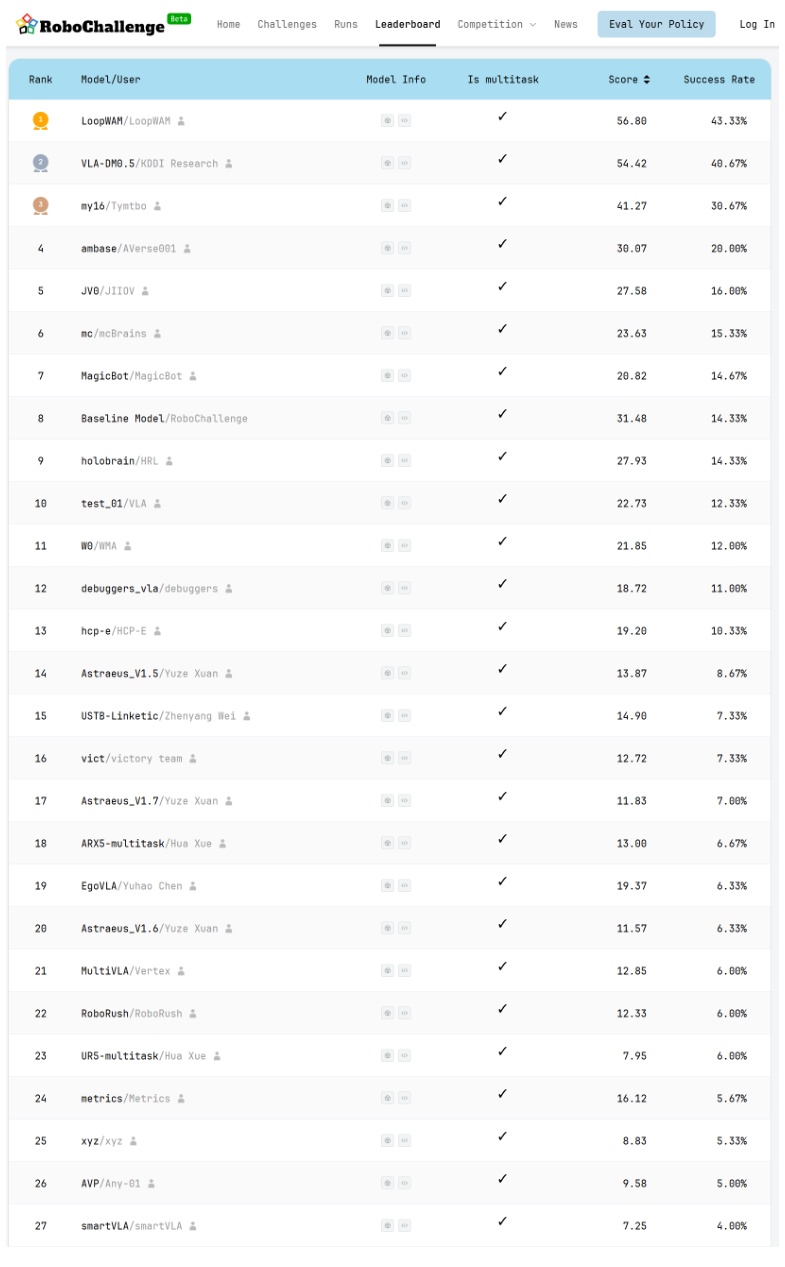
| RoboChallenge Table30-V2(真机,四本体) | 43.33% SR / 56.80 分 | VLA-DM0.5 40.67% / 54.42 分 | 榜一且双指标第一;三轮闭环:23.67→28.00→37.67→43.33 |
| RoboTwin 2.0(50 任务) | 94.5% | LingBot-VA 2.0 93.6%(带具身预训练) | LoopWAM 无具身预训练;比 AHA-WAM 92.8% +1.7 pp |
| RoboCasa365(50 任务) | 49.5% | ABot-M0.6 46.6%(带具身预训练) | Atomic 79.7 / Composite-Seen 50.3 / Composite-Unseen 14.9 |
| 衬衫折叠(单任务后训练 + 闭环) | 55.56% | 首轮只有 13.20% | 两轮闭环 +42.4 pp;分数 14.44→67.78 |
🧭 读前 5 分钟:五个概念
- 瓶颈卡在 demo scaling 上:专家演示越多泛化越广,但部署暴露的「新状态、新交互、新失败模式」没有回流——DAgger 要专家在线标注,真机 RL(π0.6 的 advantage-conditioned、RL Token)常出现分布收窄、且不适合多任务通才。LoopWAM 要的是「通才直接吃部署全谱数据」。
- VLA steering vs WAM world modeling 的分工——过去是二选一:π0.6/π0.7 用 quality/advantage 条件控制行为分布,但没有「动作→后果」的显式动力学目标;τ0-WM 把失败数据给 ACWM、用 ACWM 当选择器,FACT 用一个模型但顺序生成动作→后果。LoopWAM 的挑战问题:能不能一个 WAM 直接学混合质量数据、让「学到的后果」直接参与动作生成?
- Source-dependent noise sampling(偏工程但在论文里最巧):专家段给 σv
Beta(7,1)(视频大噪声、动作走 base 分布)学「从烂输入恢复专家未来」;rollout 段给 σvbase、σa~Beta(1,7)(动作低噪声、保留原始操作,视频流预测其后果)= 在同一模型内做 action-conditioned world modeling。 - Quality steering:质量分数 q 直接作为指令后缀(Instruction ℓ + Quality q)。训练时不同 q 的条件吸引模型学习不同质量层级的行为分布;部署时把 q 固定在最高分 q*,把采样行为「约束」为专家质量模式。q 有两个标注力度:细粒度(episode 级 1–12 分)和粗粒度(每个 policy 一个共享分,rollout 分 {1,2,3,4}、专家 q*=5)。
- Quality-weighted action supervision:视频损失全保留(失败也给世界监督),动作损失乘 λ(q)——专家 λ=1、失败 λ=0、其余线性。失败的「执行部分」被拉黑、但「后果部分」全部保育。
🛠️ 方法:一个模型里的三个角色
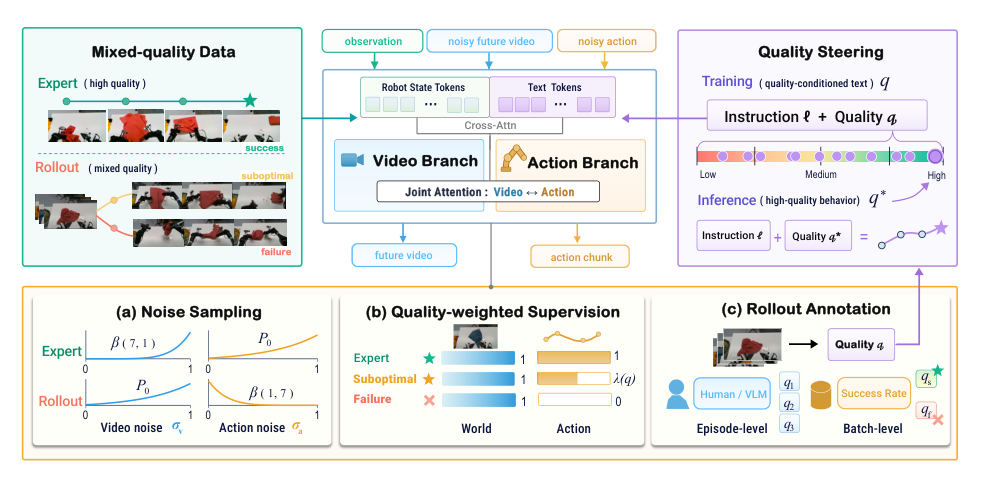
Figure 2 一图三块,是全文的骨架:
(a) 噪声采样:视频噪声 σv 与动作噪声 σa 独立采样。专家:σvBeta(7,1)、σaP0;rollout:σvP0、σaBeta(1,7)。P0 是 base 分布 φ5(u)=5u/(1+4u)(κ=5)。Beta 的形状像「把模态钉在」噪声端(Beta(7,1) 集中于 1)或干净端(Beta(1,7) 集中于 0)。
(b) 质量加权监督:损失 = world 监督(全保留)+ λ(q) 加权的 action 监督(式 6,λ 的总和对样本归一)。专家 → λ=1;失败 q=1 → λ=0;中间按分数插值。
(c) Rollout 标注:quality q 来自「human / VLM episode 打分」或「checkpoint 级粗标注(0.7% 抽查动作 smoothness,共用一个分数)」;部署时用 q*。
架构
MoT 双流:视频骨干 + 文本编码器 + VAE 全部从 Wan2.2-TI2V-5B 初始化;动作流是 hidden=1024 的 DiT。每层 joint attention 双向互看,块状 mask 矩阵 M(O,V,A) = [1,0,0; 1,1,1; 1,1,1]:观测 token 只看自己(初始帧),未来视频和动作互相全看。两条流都能 cross-attend「带质量后缀的指令」;机器人状态 token 只条件动作流。
一个训练段 = 64 步动作 chunk + 9 帧 RGB(间隔 8 控制步),多相机拼成一张图;动作与状态按专家数据统计归一。
闭环
部署(对 q*=expert 分的 marginal 采样)→ 每任务 ~100 条 rollout、按质量打分 → 与专家数据 + 前几轮 rollout 一起再训练 → 换模型再部署。rollout 也可以来自其他 policy(RoboTwin/RoboCasa 用的就是 X-VLA、π0.5、RLDX-1 的数据)——打破「只要自家数据」的假设:模型至少能吸收任何部署策略产出的经验,无需经验来源和自己同源。
🧪 实验:三个 benchmark + 一个软物体任务
1. 真机闭环:RoboChallenge Table30-V2
真机标准化 benchmark,30 个桌面任务、四种本体(ALOHA、DOS-W1、ARX5、UR5),官方 multi-task 协议。每个本体一个专家训练的多任务模型,然后三轮闭环。
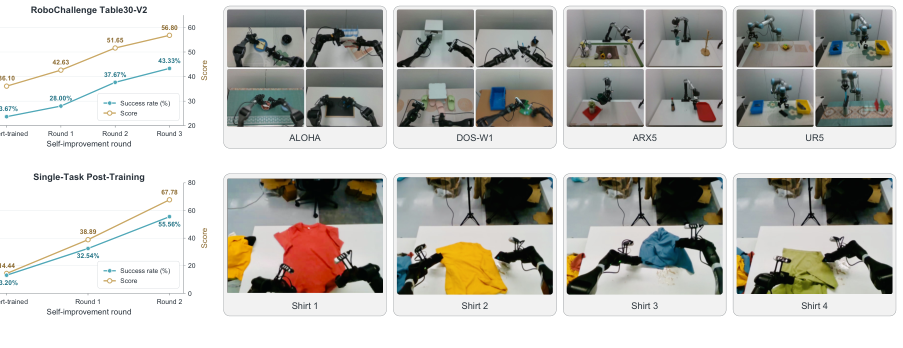
| 轮次 | 总分 | 总 SR |
|---|---|---|
| Expert-trained | 36.10 | 23.67% |
| Round 1 | 42.63 | 28.00% |
| Round 2 | 51.65 | 37.67% |
| Round 3 | 56.80 | 43.33% |
Leaderboard 对比给的 Table 1 关键行:LoopWAM 56.80/43.33 榜一,VLA-DM0.5 54.42/40.67 第二;my16 41.27/30.67;mc 23.63/15.33;Baseline Model 31.48/14.33。分本体看:UR5 从 26.67% 提到 76.67%(+50 pp),ALOHA 从 8.00% 提到 26.00%——闭环在「专家本来就弱」的本体上吃红利最多(rollout 里藏着专家 demo 没有的物理交互分布)。
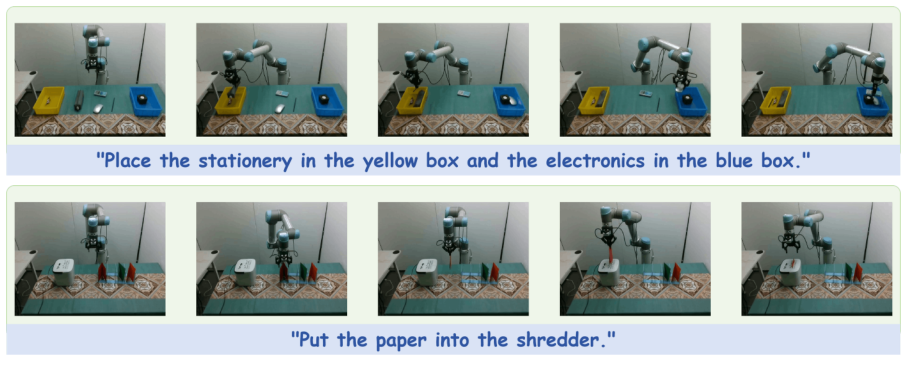
按任务给子任务指令表(Table 5,用 Qwen2.5-VL-7B 做子任务切换):按压按钮 4 段、浇花 2 段、碎纸 2 段、盖章 3 段——「长程任务自然切子任务提示」是 secret sauce 之一。
2. RoboTwin 2.0(50 任务、双臂、clean/randomized 两场景)
Rollout 增强数据:2,500 clean 专家演示 + 25,000 重随机化演示,再各加 expert-trained LoopWAM / X-VLA / π0.5 的 rollout(每 policy 每任务 20 clean + 130 random,共 22,500 条、总时长 ≈ 专家数据);训练/评估用不同 seed。质量粗标注:expert-trained LoopWAM rollout ~90% 成功率且平滑 → q=4;X-VLA / π0.5 成功率 <50% → q=3;失败一律 q=1;专家 q*=5。
| 方法 | 具身预训练 | Clean | Rand. | 平均 |
|---|---|---|---|---|
| π0 | ✓ | 65.9 | 58.4 | 62.2 |
| X-VLA | ✓ | 72.9 | 72.8 | 72.9 |
| π0.5 | ✓ | 82.7 | 76.8 | 79.8 |
| ABot-M0 | ✓ | 81.2 | 80.4 | 80.8 |
| Motus(from Wan2.2) | ✗ | 77.6 | 77.0 | 77.3 |
| Motus | ✓ | 88.7 | 87.0 | 87.8 |
| LingBot-VA | ✓ | 92.9 | 91.5 | 92.2 |
| Fast-WAM | ✗ | 91.9 | 91.8 | 91.8 |
| AHA-WAM | ✗ | 93.4 | 92.2 | 92.8 |
| LingBot-VA 2.0 | ✓ | 93.8 | 93.4 | 93.6 |
| LoopWAM | ✗ | 94.6 | 94.4 | 94.5 |
跟 UniWAM 的 RoboTwin 2.0(75.14 C2C / 68.32 C2R)比,这份表上限高得多——差异要从数据配方找:LoopWAM 用了 27,500 条演示(2,500 clean + 25,000 randomized)+ 22,500 条混合质量 rollout——「仿真随机化 + 混合质量」双重覆盖把评估分布摸得很准。**「无具身预训练仍拿下总榜第一」**是其最响亮的标签。
3. RoboCasa365(50 任务、厨房场景、Human300 训练 split)
复合任务(Composite)分两类:Composite-Unseen 16 个任务不训练、零样本评估。LoopWAM 79.7 / 50.3 / 14.9 / 总体 49.5,比带预训练的 ABot-M0.6 高 2.9 pp;rollout 方式来自两个自家 expert-trained policy(64 步 chunk 的 q=3、32 步的 q=4)+ RLDX-1 rollout(q=2)。Composite-Unseen 14.9%(第五名的 ABot-M0.5 只有 3.3)说明混合 rollout 真的教了「组合泛化」。
| 方法 | 具身预训练 | Atomic Seen | Composite Seen | Composite Unseen | Overall |
|---|---|---|---|---|---|
| π0 | ✓ | 34.6 | 6.1 | 1.1 | 14.8 |
| π0.5 | ✓ | 39.6 | 7.1 | 1.2 | 16.9 |
| GR00T N1.5 / N1.6 | ✓ | 50.7 / 51.1 | 14.8 / 9.4 | 2.7 / 1.7 | 23.9 / 21.9 |
| RLDX-1 | ✓ | 67.6 | 27.9 | 8.5 | 36.0 |
| PRTS | ✓ | 66.3 | 30.3 | 18.8 | 39.6 |
| ABot-M0.5 / M0.6 | ✓ | 75.6 / 79.4 | 37.7 / 48.3 | 3.3 / 7.9 | 40.3 / 46.6 |
| LoopWAM | ✗ | 79.7 | 50.3 | 14.9 | 49.5 |
4. 衬衫折叠:软物体 + 状态混乱
DOS-W1 多任务模型先用新采集的衣折叠专家数据做单任务后训练,随后两轮闭环:13.20% → 32.54% → 55.56%(分数 14.44 → 67.78)。衬衫被「随手扔进工作空间」、角可能被压住、需要逐步撩出来直到四角全部露出再叠——混合质量 rollout 的价值在软物体上格外明显(每次尝试都是一份「布料物理课程」)。
🔬 消融 Table 4(RoboTwin 2.0)
| Quality Steering | 质量加权 action 监督 | Clean | Rand. | 平均 |
|---|---|---|---|---|
| None | ✗ | 73.5 | 71.1 | 72.3 |
| Extra-coarse | ✗ | 92.2 | 93.3 | 92.8 |
| Extra-coarse | ✓ | 93.9 | 93.3 | 93.6 |
| Coarse(本文) | ✗ | 93.2 | 92.2 | 92.7 |
| Coarse(本文) | ✓ | 94.6 | 94.4 | 94.5 |
三个发现的翻译版:(1) steering 是关键(72.3 → 加 steering 后 +20 pp 量级);(2) 「失败/成功」粗标签(extra-coarse)就有效——fine-grained 标注不是必需的;(3) rollout 的质量加权 action 监督在两套标注方案下都加分(+0.8 / +1.8 pp)。失败数据的价值主要在视频监督上——失败的动作目标本来就 λ=0,加权主要作用在「次优」数据上。
💡 案例图集
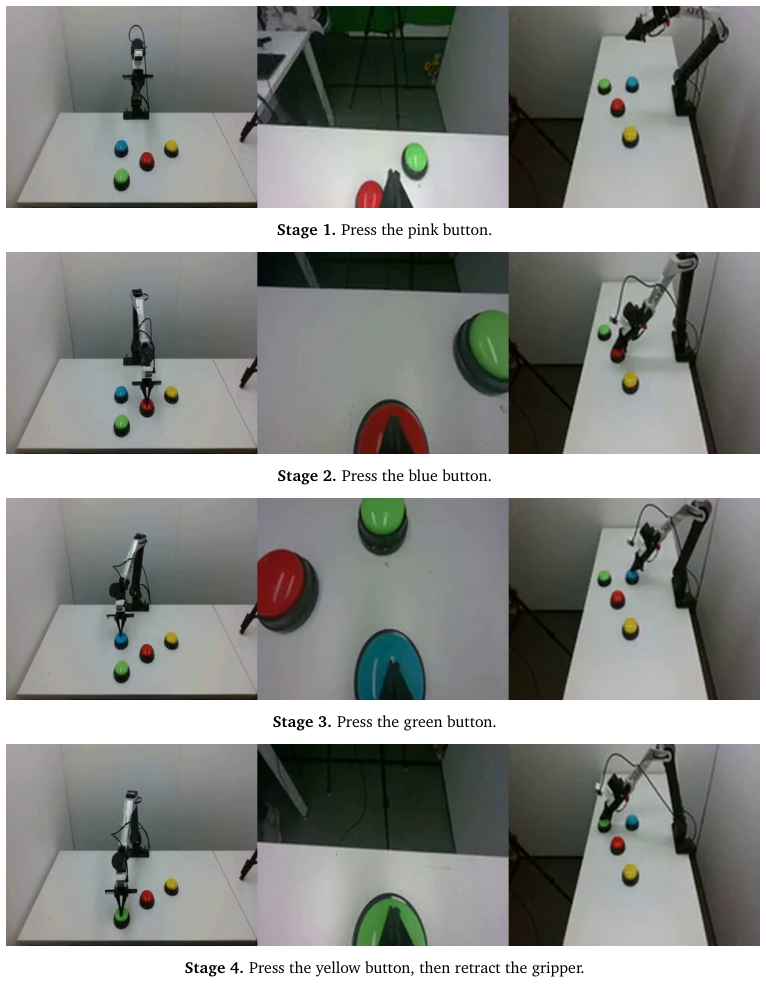
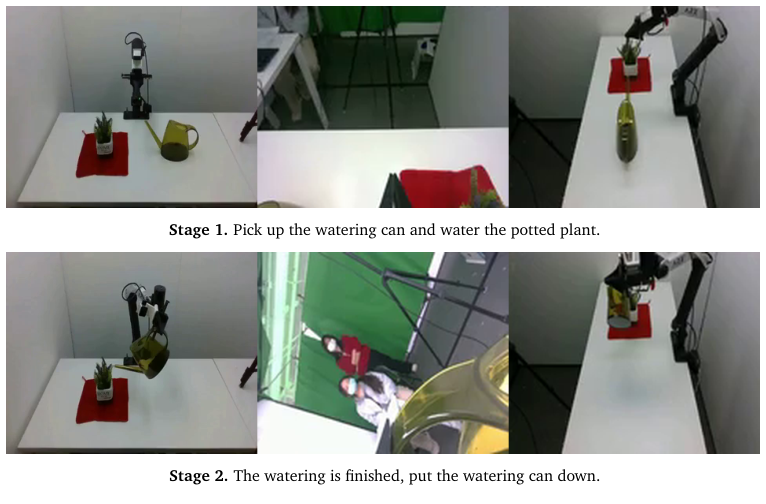
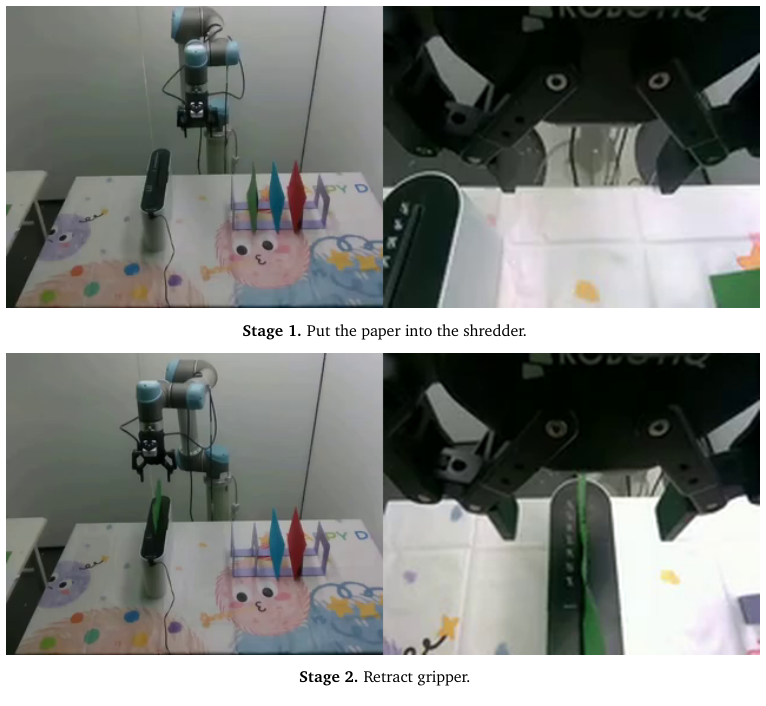
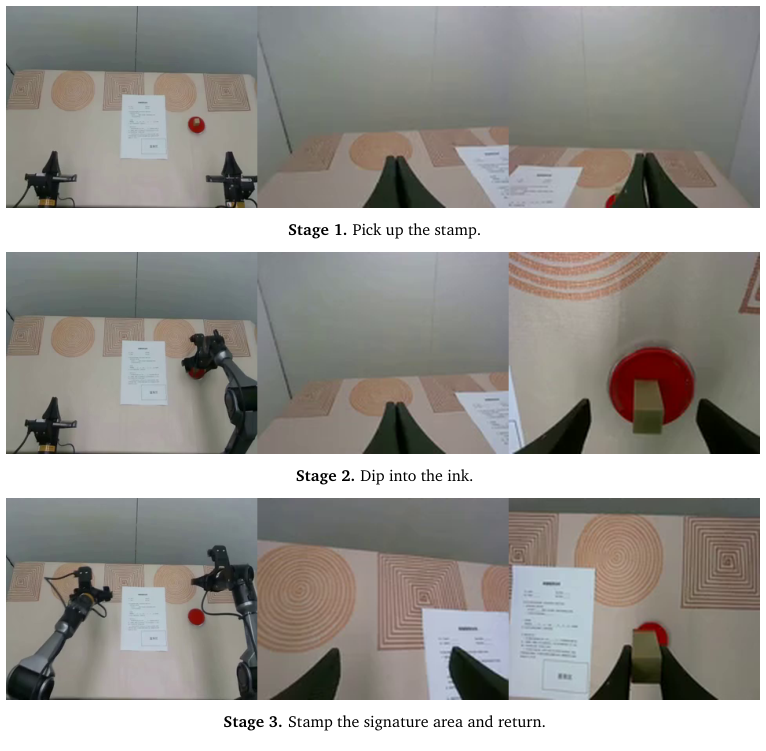
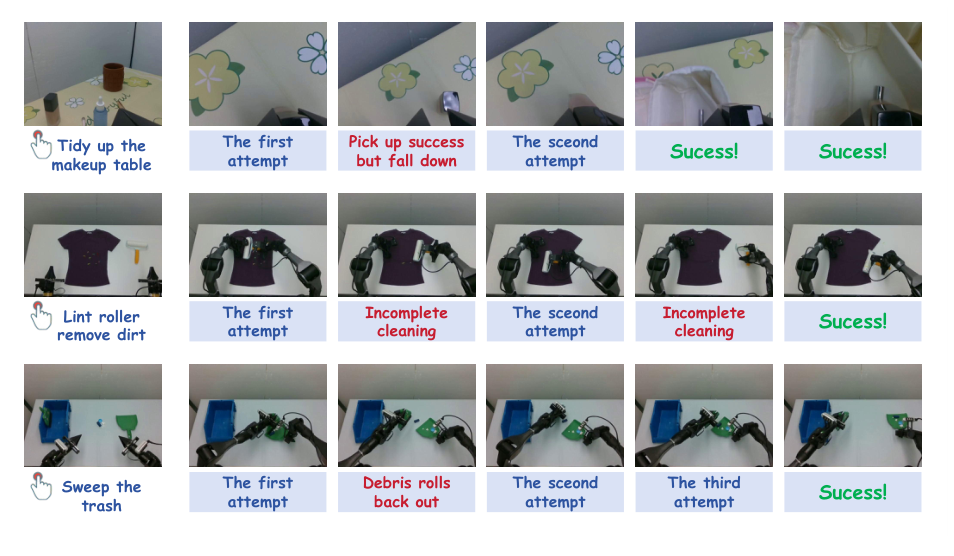
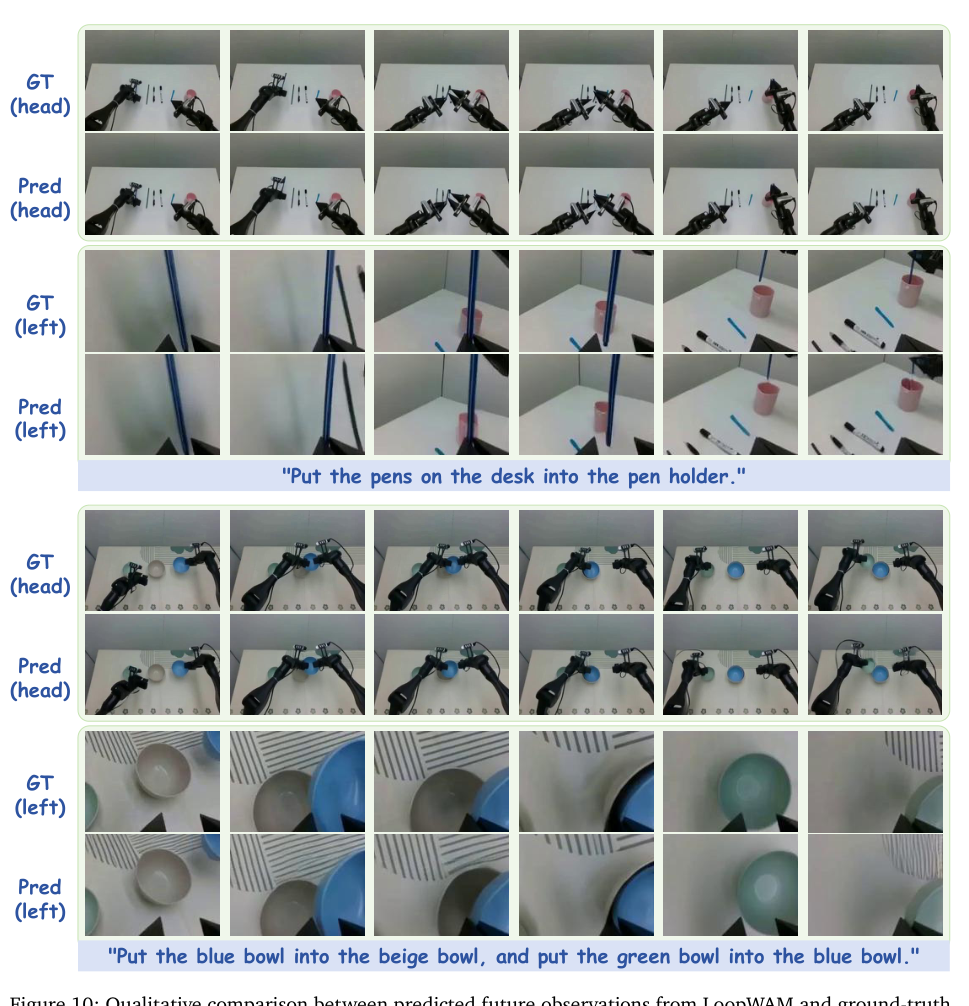
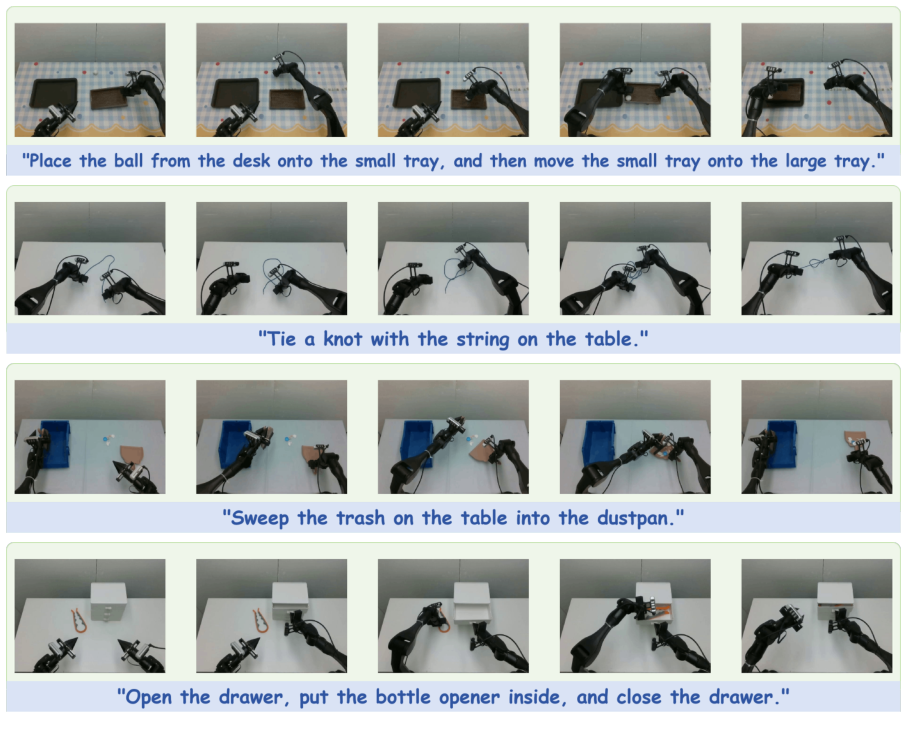
Figure 9 里有意思的三个失败恢复案例:化妆台收整(第一次拿起但东西掉了,第二次成功)、lint roller(第一次没擦干净,再试成功)、sweep trash(碎片滚回,第三次才成功)——失败不只是重试数据,也提供了「物理后果」的视觉监督,让失败之后生成修正行为。这组案例是「闭环为什么有用」的直观答案。
💡 评析:一个洞察,两个亮点,四条边界
一个洞察
「混合质量部署数据」的正确用法不是二值分类(成功/失败筛选),而是把成功/次优/失败变成一条连续的质量谱,让每个维度被不同频率的监督方法悬停:视频全保,动作按 λ(q) 渐减。失败数据学「后果」(世界模型),成功数据学「行为」(policy),次优数据学「什么操作会偏差」——三种学习机制在 joint attention 里混合联动(动作 token 直读视频 token 的后果表示,无需额外的 ACWM 选择器/后果阶段)。
两个亮点
- 真机闭环数据是「冠军证据」:所有仿真 benchmark 都能靠「数据配方」造数;RoboChallenge 是平台全流程强评审的真机 trial,LoopWAM 从 expert-trained 23.67% 起步以三轮 +19.7 pp 收官,这种「部署-训练-部署」的完整报告在 2026 年的 WAM 系论文里非常罕见(大多只做一次数据增补)。
- 粗标注就够用:每个 checkpoint 一个共享分数就带来大部分增益(Table 4 里 coarse+加权 94.5 vs extra-coarse+加权 93.6 vs 无 steering 72.3),这给「数据飞轮的运营成本接近零」的论点背书——不需要 per-episode 打分的成本,只要每轮模型改版打一个分。
四条边界
- RoboTwin / RoboCasa 的第一非常「数据配方驱动」:27.5k 演示 + 22.5k rollout 是别人没有的高度定制化数据,对照(UniWAM 报告的 75.14 / LoopWAM 自己引用的 FACT 87.5)说明这种差距的来源至少一半在「benchmark 训练剂量」而非机制。
- 闭环收益集中在自部署数据:四个本体都从 expert-trained 起步做三轮迭代,没有评测「跨 policy 冷启动」——用其他 policy 的数据第一次着力时收益曲线如何,论文未给出专门证据(虽然 RoboTwin/RoboCasa 的方案提供了间接说明)。
- λ(q) 只是一个手工插值:λ 与 q 的映射没有系统评测(失败数据会不会「污染」世界模型表示未验证);权重单调不减的假设与「偶发成功」「局部正确」的场景解耦存疑。q 是行为质量的评分数值,与物理世界真正的「成败因果」之间可能有 gap。
- 每任务 100 条 rollout 是平台帮你背的算力:三次部署-再训练全流程(initial expert model → round 3 +19.7 pp)的每轮部署时间与评分成本论文没有披露,之外平台的 RoboChallenge 设定还提供了官方评分基础设施——离开这类平台,same 工程×算力要自建。
🗺️ 在 WAM 谱系里的位置
| 路线 | 代表 | 思路 | 与本文关系 |
|---|---|---|---|
| VLA 飞轮 | π0.6 / π0.7 | advantage / quality steering + 专家蒸馏 | 思想来源(无动力学的 steering) |
| 数据回收 WAM | τ0-WM / FACT | ACWM 当选择器 / 共享模型顺序生成 | 中间形态(后果只是间接参与动作) |
| 视频动力学骨干 | DreamZero / LingBot-VA 2.0 / Fast-WAM / GigaWorld-Policy | 视频生成 + 动作解耦 | 架构基础(LoopWAM 用 Wan2.2) |
| 闭环直连(本文) | LoopWAM | 混合质量直接进 joint denoising | 谱系上的「部署反馈」端点 |
| 行为先验 WAM | UniWAM / Being-H0.7 | 人+机共训 / 未来 obs 监督 | 互补(数据谱系的另一个维度) |
延伸:《UniWAM 精读》(同月 WAM)、《PrismWAM 精读》(MoT 架构)、《Flash-WAM 精读》、《WorldOracle 精读》(给 WAM 的「成绩单」)、《DROID机器人操作数据集精读》、《WAM 世界行动模型全景分析》。
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 总览:闭环 + 三个 benchmark 排名 | 开篇 |
| Fig 2 | 架构与三大质量机制 | 方法 |
| Fig 3 | Table30-V2 三轮 + 衬衫折叠两轮曲线 | 真机 |
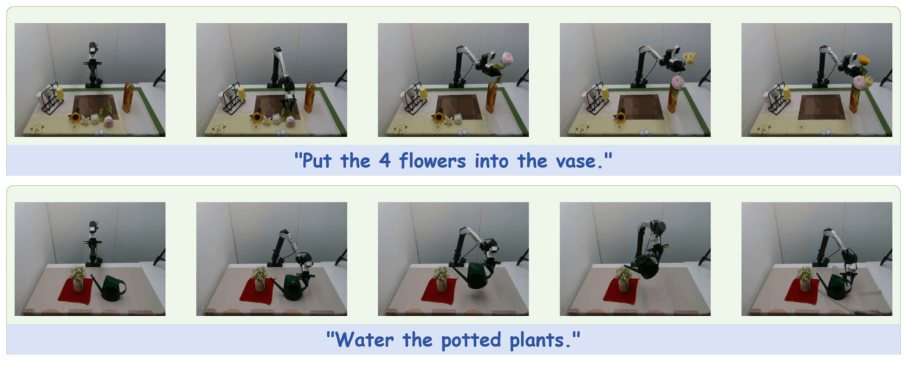
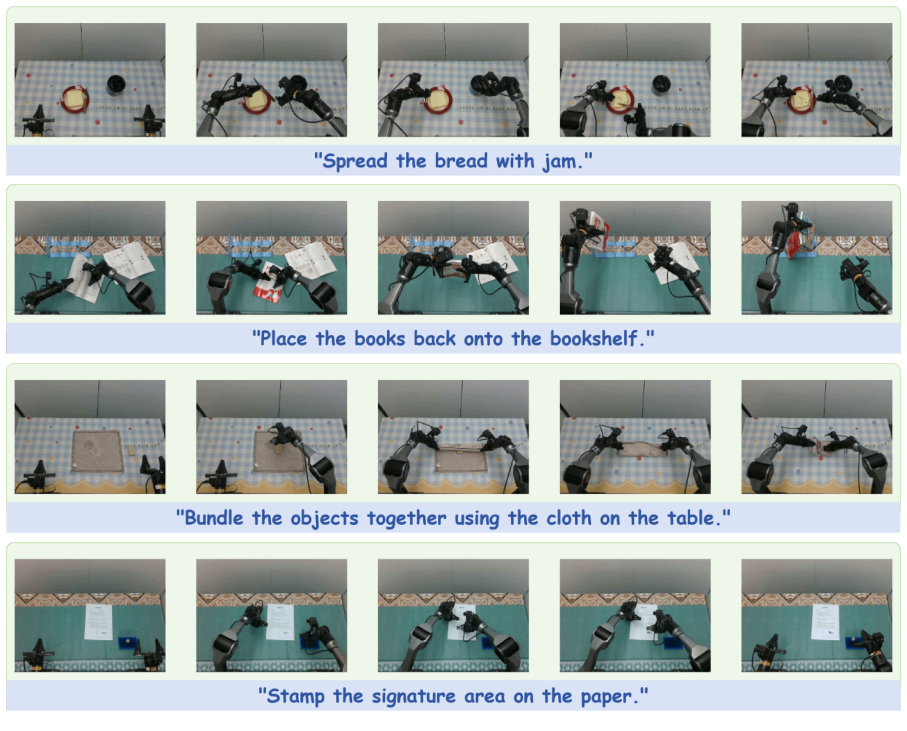
| Fig 4–7 | 四个任务的子任务分段示例(按钮/浇花/碎纸/盖章) | 案例 |
| Fig 8 | RoboChallenge 官方 leaderboard 快照 | 真机 |
| Fig 9 | 失败恢复三案例(迭代执行) | 案例 |
| Fig 10 | 未来观测预测 GT vs Pred | 案例 |
| Fig 11–14 | ARX / ALOHA / UR5 / W1 四本体任务示例 | 案例附录 |
表格:Table 1 Table30-V2 leaderboard 分本体成绩;Table 2 RoboTwin 2.0;Table 3 RoboCasa365;Table 4 ablation(含 extra-coarse 对比);Table 5 Table30-V2 子任务指令。
❓ 自测 Q&A
Q1:为什么不能只筛出成功 rollout 来训练? A:筛选丢失的两样东西:失败轨迹里「做了什么、发生了什么」的物理后果视频(世界模型监督)和次优轨迹里「比专家差在哪」的质量梯度。筛掉它们等于把飞轮转回「只有专家数据」,闭环收益的上限也被压在专家谱系内。
Q2:source-dependent noise sampling 为什么是「免费的 ACWM」? A:rollout 段的动作噪声 Beta(1,7) 集中在 0(近乎干净),视频流照常插噪声预测未来——这和 ACWM「给定动作预测未来」的构造完全同构,只是把「动作输入」换成「近乎干净的动作 + 小噪声」。专家段反过来(视频高噪声、动作走 base 分布),让模型同时学会「从烂输入恢复专家轨迹」和「从专家动作推后果」。
Q3:质量分数 q 是数字还是文本? A:数字,但通过文本后缀注入:「Instruction ℓ + Quality: q」。episode 级用 1–12(专家 q*=12)、粗级用 1–5(专家 q*=5),推理时只用 q* 这个「最高模式」。因为所有段继承 trajectory 级分数,一个 checkpoint 的所有成功 rollout 共享一个分数。
Q4:失败轨迹的动作 λ=0,那模型对「失败操作」学什么? A:视频监督完整保留——所以它学的是「这个动作序列会导致什么画面」(比如物体被撞倒、没抓住、偏离目标)。这些后果表示通过 joint attention 参与动作 token 的形成——推理时如果场景有类似前兆,动作 token 会受到「后果感知」的影响(这是论文「learned consequences inform action generation」的机制)。
Q5:其他 policy 的 rollout 真的有用吗? A:RoboTwin 表里所有 rollout 来自 expert-trained LoopWAM、X-VLA、π0.5(后两者成功率 <50%),Table 4 消融证明「粗标注 + 加权」的方案对这些低成功率数据也能给正贡献。本质上是 q 值分层次吸收:「不同 policy 分不同共享分数」而不是「无视来源统一使用」。
Q6:衬衫折叠为什么是单任务闭环好的测试场? A:可形变物体 + 乱的初始状态(角被压住/隐藏)在视频里产生丰富的「布料动力学」;每次部署的失败和次优动作都是新的物理演绎数据。两轮 +42.4 pp(13.2→55.6),说明闭环在多任务范式之外还有「单任务专精」的路线。
📚 资源与延伸
- 论文:arXiv 2610.18873
- RoboChallenge Table30-V2 leaderboard:robochallenge.cn
- 关键基础设施参考:RoboChallenge Table30-V2 tech report(Dexmal,robochallenge.ai/robochallenge_techreport_V2.pdf)
- 关键前作:π0.6(arXiv 2511.14759)、π0.7(arXiv 2604.15483)、τ0-WM(arXiv 2606.01027)、FACT(arXiv 2608.10232)、DreamZero(arXiv 2602.15922)、LingBot-VA(arXiv 2601.21998)、LingBot-VA 2.0(arXiv 2607.08639)、Fast-WAM(arXiv 2603.16666)、GigaWorld-Policy(arXiv 2603.17240)、AHA-WAM(arXiv 2606.09811)、Being-H0.7(arXiv 2605.00078)、Motus(arXiv 2512.13030)、Wan2.2、RoboTwin 2.0、RoboCasa365、RLDX-1、DAgger(Ross et al. 2011)
- 站内延伸:《UniWAM 精读》、《PrismWAM 精读》、《Flash-WAM 精读》、《HexaShell 精读》、《WorldOracle 精读》、《π0.5开放世界泛化精读》、《LIBERO 精读》、《DROID机器人操作数据集精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》