📄 论文信息
- 标题:Metis: A Generalizable and Efficient World-Action Model for Autonomous Driving and Urban Navigation
- 作者机构:复旦大学 × 上海创新研究院 × 香港大学 × 同济大学 × 理想汽车(Li Auto) × 华中科技大学 × 帝国理工 × 萨里大学(Jingyu Li, Zhe Liu, Dongnan Hu, Junjie Wu, Wenxiao Wu, Li Zhang 等,通讯作者 张犁)
- arXiv:2606.15869
- 代码:github.com/LogosRoboticsGroup/Metis
- 一句话总结:把视频生成和动作预测拆成两个独立的 Transformer 专家(Mixture-of-Transformers),用一张非对称注意力掩码让动作只看向当前观测、未来视频却能看向动作——训练时联合优化学到世界动态,推理时彻底跳过视频生成只跑动作分支。在 NAVSIM-v2(navhard 32.2 / navtest 89.5 EPDMS) 和 CityWalker 上都做到 SOTA,纯动作推理比带视频推理快 8 倍,并零样本部署到四足机器人。
🎯 一句话记忆点:Metis = “动作只看现在,视频看着动作”——非对称掩码让世界模型在训练期’喂’动作专家,推理期彻底退场,只留下一个又快又准的 planner。
🔗 姊妹篇:这篇与 SimWAM 精读 同期探索了"视频生成与动作预测解耦"的 WAM 设计。Metis 用非对称掩码(视频可看动作),SimWAM 用隔离掩码(两者互不可见);Metis 无 RL,SimWAM 有 GRPO。 强烈建议两篇对照读。
🤔 要解决什么问题?
背景:World-Action Model(WAM)的两条路线与两个硬伤
世界动作模型(WAM)把"预测未来观测"和"生成动作"统一进一个框架,用未来动态建模来增强动作规划。现有 WAM 大致分两条路线:
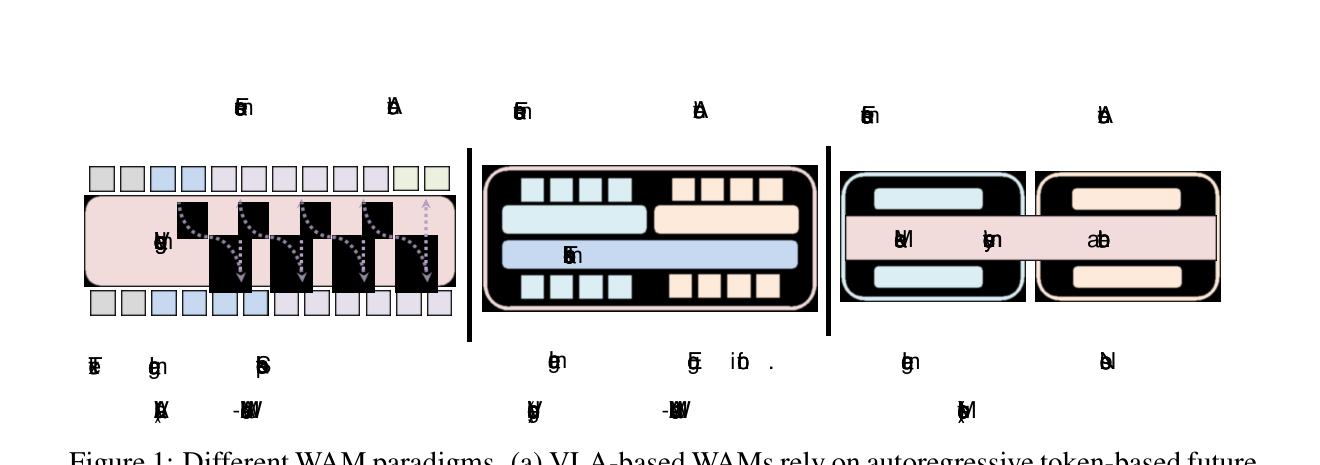
| 范式 | 代表思路 | 致命问题 |
|---|---|---|
| VLA-based WAM(图1a) | 在 VLM 上追加 token 做自回归未来观测生成 | 推理时必须先生成未来观测,计算延迟不可避免 |
| Video-gen-based WAM(图1b) | 视频生成模型里共享表示,联合预测未来视频+动作 | 紧密耦合:高维视觉表示干扰低维动作空间 → 代表性错配、泛化下降 |
| Metis(图1c) | 非对称掩码解耦视频生成与动作推理 | — |
核心痛点一:高延迟——未来观测生成进了实时链路
VLA-based WAM 的典型流程是"先想象未来、再规划动作":推理时先自回归生成未来帧,再把未来帧作为条件预测轨迹。每一步决策都要走一次昂贵的自回归生成,计算延迟不可接受。视频生成系方法也类似——要么走完整多步去噪,要么递归逆动力学,都逃不掉未来帧的高维采样。
核心痛点二:表征错配——视频噪声污染动作空间
视频生成系 WAM 把动作和视频在同一个模型、同一套表示里联合建模。问题在于:未来视频预测输出的高维视觉表示(纹理、光照、语义)和低维动作空间(几个 waypoint)分布差异巨大。联合建模时,生成过程的高维噪声会被注入动作空间,干扰动作预测的精度与稳定性——这就是论文反复强调的 “distributional mismatch”。
核心矛盾:既要让世界模型给动作"喂"动态先验,又不能让世界模型的生成噪声污染动作空间——Metis 用一张非对称注意力掩码在表征层面解决这个问题。
💡 核心思路:MoT 双专家 + 非对称注意力掩码
Metis 的解法分三步:
- Mixture-of-Transformers(MoT)架构:把视频生成和动作预测拆成两个独立的 Transformer 专家,各自保留自身的分布特性;
- 非对称注意力掩码:动作 token 只能看向当前观测;未来视频 token 可以同时看向当前观测 + 所有未来动作 token——信息流是单向的;
- 联合训练、解耦推理:训练时联合优化两个专家,推理时完全跳过视频生成,只跑动作分支。
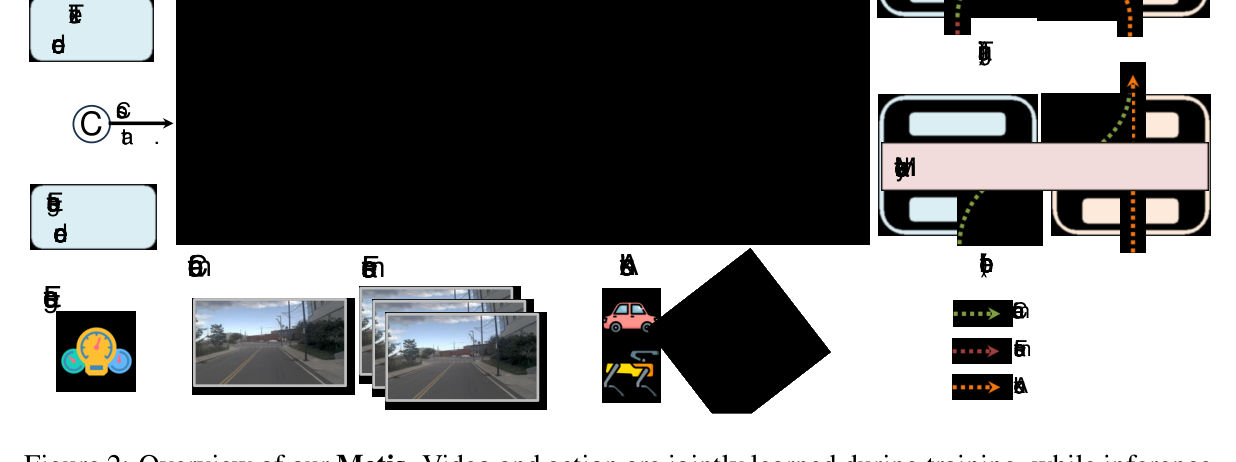
先看宏观数据流(训练期):
推理期数据流(极简):
⚙️ 模块一:Mixture-of-Transformers(MoT)架构
1.1 问题形式化
Metis 用解耦推理范式。设 z(o_t, l) 为视频 backbone 在当前观测和上下文下产生的 latent 表示,动作预测建模为:
未来观测只在训练期用,推理期 z(o_t, l) 只通过 backbone 的一次前向得到,从而实现实时规划。对比想象-行动范式:
| 范式 | 推理期计算 | 训练-推理一致性 |
|---|---|---|
| 联合去噪生成 (a,v) | 高维视频采样 + 递归去噪 | 一致 |
| 逆动力学:先生成未来帧再反推动作 | 先生成 v 再解出 a | 一致 |
| Metis 解耦推理 | 只跑当前帧 backbone 一次 | 一致(训练时动作就不看未来帧) |
1.2 两个专家各司其职
| 专家 | 实现 | 职责 | 备注 |
|---|---|---|---|
| Video Generation Expert(VGE) | Wan2.2-5B 初始化(含 video VAE + T5 文本编码器) | 继承大规模视频模型的物理先验,捕捉时空动态 | 只在训练期活跃 |
| Action Expert(AE) | Diffusion Transformer,镜像 VGE 的层深、hidden=1024 | 低维轨迹预测 | 唯一部署的分支 |
关键设计:专家间通过共享 latent 空间交互,但各自保留分布结构。 token 组织方式:
- 三类 token:当前观测 latent、未来观测 noisy token、动作 noisy token;
- 所有 token 先通过 cross-attention 看向语言 embedding;
- 通过专家专属投影进入共享 latent 空间,交互受结构化注意力机制约束;
- 每个专家用自己的 FFN 和输出头做任务特定预测。
这种"token 级交互"实现了受控的信息交换,不直接混合异构任务空间的表示——这正是避免表征错配的关键。
🔑 模块二:非对称注意力掩码(核心创新)
2.1 掩码规则
这是 Metis 区别于所有前作的最核心设计。它不像之前的方法在时间轴/分辨率上做手脚(减预测步数、降未来帧分辨率、或干脆不生成未来帧——这些要么牺牲性能要么牺牲信息),而是在表征层面用一张掩码显式管理两个专家之间的信息流:
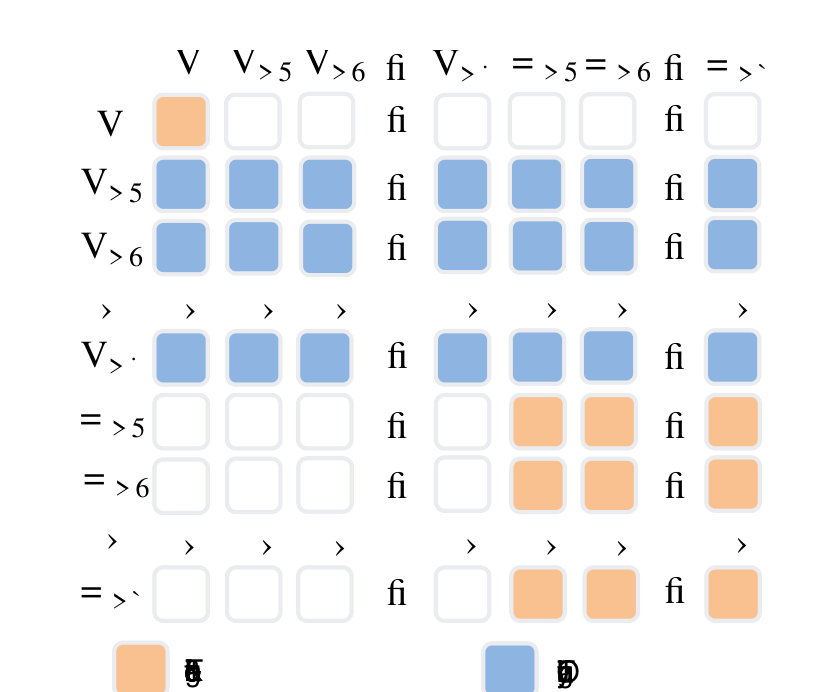
单向可见性约束:
- 动作 token → 只能看向当前观测 token(规划 grounded 在当前上下文);
- 未来视频 token → 可以看向当前观测 + 所有未来动作 token。
信息流是单向的:未来视频可以"看动作"来生成与世界演化一致的画面;但动作永远看不到未来视频。
2.2 为什么这样设计?两个方向的收益
① 训练期(视频→动作的知识注入):由于 VGE 能看到动作 token,它生成未来视频时会以具体轨迹意图为条件——预测"如果我这么开,世界会怎么演化"。而两个专家在联合优化中共享表示空间,VGE 的预测能力就隐式参与了动作精炼过程。这正是"世界模型给动作喂动态先验"的机制:AE 学到的是"被未来动态约束过的轨迹"。
② 推理期(动作→不依赖未来):动作 token 从一开始就只看当前帧,所以推理时视频生成分支可以完全旁路,训练-推理严格一致——没有 train/inference mismatch,也没有未来帧生成噪声注入动作空间。
🧠 直觉类比:把视频专家想成一位"看过无数盘棋的教练"。训练时,教练(视频)能看见你(动作)打算怎么走,于是告诉你"你这一步会导致什么局面"——你在这样的反馈下学会走棋。但比赛时(推理),教练不能上场,你只看当前棋盘直接落子。因为你训练时就从没依赖过教练上场,所以比赛时一点都不慌。
2.3 与"联合注意力"“隔离注意力"的对比(Table 4 / Table 8)
论文做了两组注意力变体对照:
| 变体 | 信息流 | navtest PDMS | navhard EPDMS | 说明 |
|---|---|---|---|---|
| Joint(联合) | 未来视频和动作 token 完全耦合 | 87.1 | 28.0 | VLA/video-WAM 常规做法;推理时生成噪声注入动作空间,DAC/EP 落后 |
| Isolated(隔离) | 两专家完全解耦,互不可见 | 88.0 | 29.4 | 动作完全用不上当前观测的视觉上下文,总分偏低 |
| Metis Asymmetric | 动作看当前,视频看动作 | 88.8 | 31.6 | 全指标最佳 |
两个关键结论:
- vs Joint:非对称掩码大幅领先(navhard +3.6 EPDMS)。附录指出 Joint 的问题——推理时动作空间被生成过程噪声严重注入,干扰动作预测的完整性;
- vs Isolated:非对称掩码仍胜出。因为 Isolated 把任务完全切开,动作分支利用不上当前观测提供的视觉上下文,也失去了训练期"通过生成专家隐式优化动作"的杠杆。虽然 DAC/EP 与 Metis 相当,但总分偏低——世界理解的精妙和推理时无生成噪声,两者都要。
🔑 Metis 与 SimWAM 的第一个关键区别:SimWAM 用的是 Isolated(动作和未来视频互不可见,视频纯当训练信号),Metis 用的是 Asymmetric(未来视频能看动作)。Metis 的消融显示 Asymmetric 优于 Isolated(navhard 31.6 vs 29.4)——因为让视频"看到动作"能学到"动作→世界演化"的因果,这是 SimWAM 隔离设计牺牲掉的。
⚙️ 模块三:Flow Matching 联合训练目标
Metis 用 flow matching 框架统一优化动作预测和未来视频生成,和 SimWAM 同源(都是 rectified flow)。
对动作 token,监督当前上下文条件下的速度场预测:
$$\mathcal{L}_{\text{act}} = \mathbb{E}\left[ \left\| u_\theta(a^{(s)}_{t:t+H}, s \mid o_t, l) - \dot{a}^{(s)}_{t:t+H} \right\|_2^2 \right]$$其中 $s \in [0,1]$ 是 flow 时间,$a^{(s)}_{t:t+H} = (1-s)\epsilon + s\,a_{t:t+H}$,速度场 $\dot{a}_{t:t+H} = a_{t:t+H} - \epsilon$。
对未来视频 token,监督以当前上下文和动作 token 为条件的速度场:
$$\mathcal{L}_{\text{video}} = \mathbb{E}\left[ \left\| u_\phi(z^{(s)}_{t+1:t+H}, s \mid o_t, \hat{a}_{t:t+H}, l) - \dot{z}^{(s)}_{t+1:t+H} \right\|_2^2 \right]$$其中 $\hat{a}_{t:t+H}$ 是预测的未来动作序列——注意这里正是非对称掩码的公式体现:视频的条件包含动作,动作的条件不包含视频。
总目标:
$$\mathcal{L} = \mathcal{L}_{\text{action}} + \lambda\, \mathcal{L}_{\text{video}}, \quad \lambda = 1$$📊 实验结果
3.1 NAVSIM-v2 navhard(安全关键场景闭环节点)
Metis 在 Stage 1(244 个真实安全场景)和 Stage 2(4164 个 3DGS 合成场景)都做到最佳:
| 方法 | 类型 | EPDMS↑ |
|---|---|---|
| PDM-Closed(规划器,真值输入) | 规则基准 | 51.3 |
| LTF | 传统 E2E | 24.4 |
| DiffusionDrive | 传统 E2E | 27.5 |
| ReCogDrive(带 RL) | VLA | 25.7 |
| SGDrive | VLA | 25.5 |
| Metis | WAM | 32.2 |
关键结论:
- 无地图监督下 DAC/DDC 大涨:比之前方法在 Stage 2 的 DAC 至少高 7.9 分、DDC 至少高 2.5 分——说明世界建模提供了"环境约束性驾驶行为"的更强归纳偏置;
- VLA 系方法依赖场景理解和高层推理,在动作生成时对这类约束的强制力不足。
3.2 NAVSIM-v2 navtest(多样化泛化场景)
| 方法 | 传感器 | EPDMS↑ |
|---|---|---|
| Human Agent | — | 90.3 |
| ReCogDrive*(RL) | 1×C | 83.6 |
| SGDrive | 1×C | 86.2 |
| Vega | 1×C | 86.9 |
| DriveFine*(RL) | 1×C | 87.1 |
| Epona | 1×C | 85.1 |
| DriveVLA-W0† | 1×C | 86.1 |
| Metis | 1×C | 89.5 |
| Metis‡(best-of-6) | 1×C | 90.3 |
关键结论:
- 不用多阶段训练、不用 RL、不用辅助数据集,就在公平对比下拿到 SOTA,比之前 VLA 系方法至少高 2.4 分;
- 对比在固定时间戳预测未来状态的方法(Vega、SGDrive),Metis 在 EP(进度)、LK(车道保持)、EC(扩展舒适) 上显著领先——训练期内化了物理 grounded 的动态,动作专家输出更守规则、更舒适。
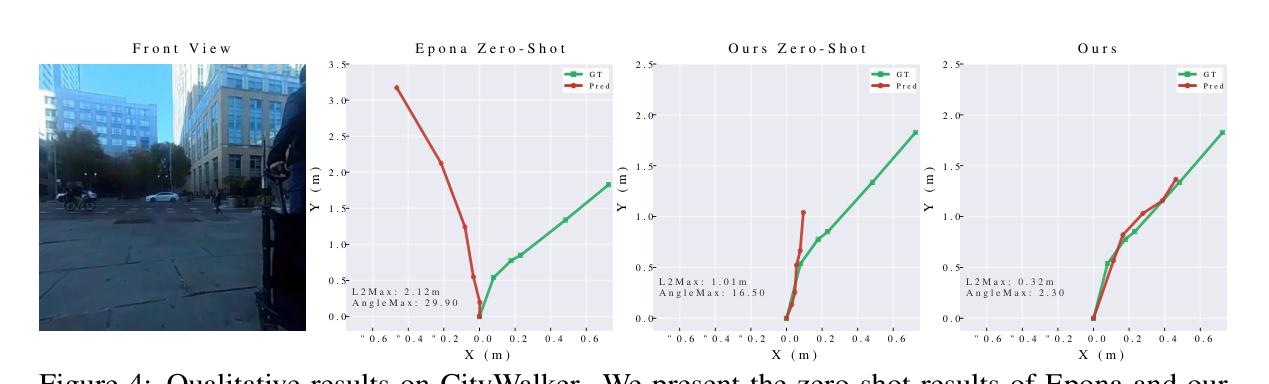
3.3 CityWalker(城市导航跨域验证)
| 方法 | 微调 | 平均 L2(m)↓ | 平均 MAOE(°)↓ |
|---|---|---|---|
| ABot-N0*(大规模预训练) | 预训练 | — | 7.6 |
| GNM | 微调 | 0.74 | 12.1 |
| ViNT | 微调 | 0.70 | 12.6 |
| NoMaD | 微调 | 0.74 | 12.1 |
| Metis | 零样本 | 0.64 | 9.8 |
| Metis(微调后) | 微调 | — | — |
- 在 L2 和 MAOE 上都领先所有微调方法——零样本还打赢了微调基线;
- 与大规模预训练导航模型 ABot-N0 比,Metis 在 Turn、Detour、Crowd 等复杂场景 MAOE 更低:“把 latent 世界动态与动作规划结合"比"在语言空间里做逻辑推理"更能给出细粒度运动引导。
3.4 推理时延(Table 7):纯动作推理快 8 倍
| 方法 | PDMS | EPDMS | 推理时延(s) |
|---|---|---|---|
| Epona | 86.2 | 85.1 | 0.32 |
| PWM | 87.3 | — | 0.57 |
| PWM(带视频) | 88.1 | — | 0.83 |
| Metis(带视频) | 89.0 | 89.5 | 1.38 |
| Metis(纯动作) | 88.9 | 89.2 | 0.17 |
结论:对比"生成未来视频"的变体,纯动作推理拿到最高 8× 加速(1.38s → 0.17s),性能几乎不损(EPDMS 89.5→89.2)——这就是"训练期世界建模、推理期不生成"的红利。
3.5 消融实验
去噪步数(Table 5):1→10 步,navtest EPDMS 87.2→89.5,navhard 30.4→32.2。步数越多越好,挑战场景提升更明显(帮助复杂动态下的轨迹精修)。但注意:纯动作推理用 2 步就能到 89.2(配 0.17s 时延),生产部署时按需选步数。
VGE/AE 搭配(Table 6):
| VGE | AE | navtest PDMS | navhard EPDMS |
|---|---|---|---|
| Wan2.1-1.3B | ~0.24B | 88.5 | 28.8 |
| Wan2.2-14B | ~0.21B | 88.2 | 31.2 |
| Wan2.2-14B | ~1.04B | 89.1 | 32.2 |
- 更强 VGE 在 navhard 上更稳(低容量生成先验在复杂场景露怯);
- 固定 VGE 时扩大 AE 规模进一步提升全指标泛化——策略头与生成骨干一起 scale。
动作专家规模(Table 10):0.21B→1.04B,EPDMS 31.2→32.2,navhard S2 提升更明显。
联合训练消融(Table 11):w/o co-train PDMS 87.4 vs w/ co-train 89.1——联合训练带来清晰增益,验证非对称掩码确实让动作专家在训练期学到了世界动态。
分辨率(Table 4):640×768 相比 320×384,navtest EPDMS 88.8→89.5、navhard 31.6→32.2——高分辨率提供更丰富的空间/几何线索。
🎮 Real-World 部署:四足机器人零样本导航
论文在 Unitree Go2 四足机器人上做了真实世界部署,用 [73] 提供的 PD 控制器输出速度指令,零样本(不做任务特定训练)测试室内白天和室外夜晚场景:
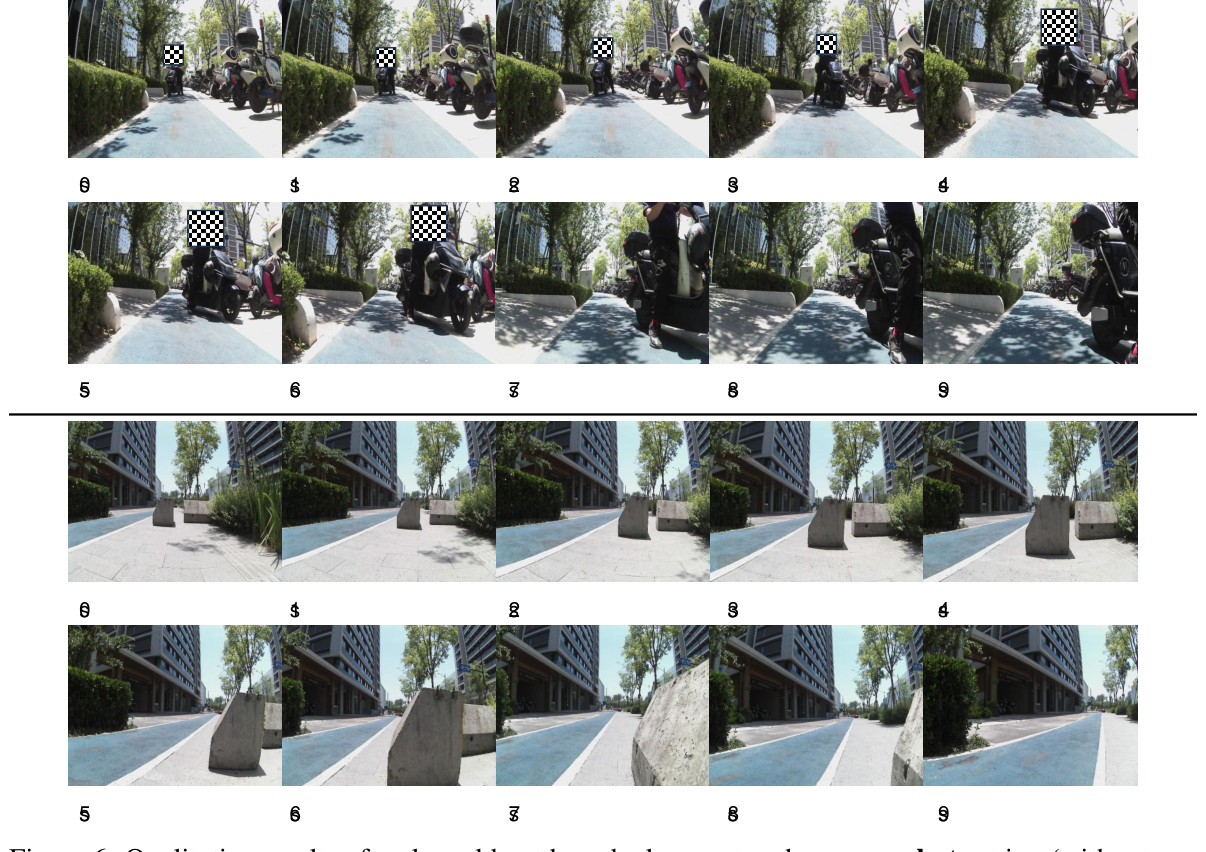
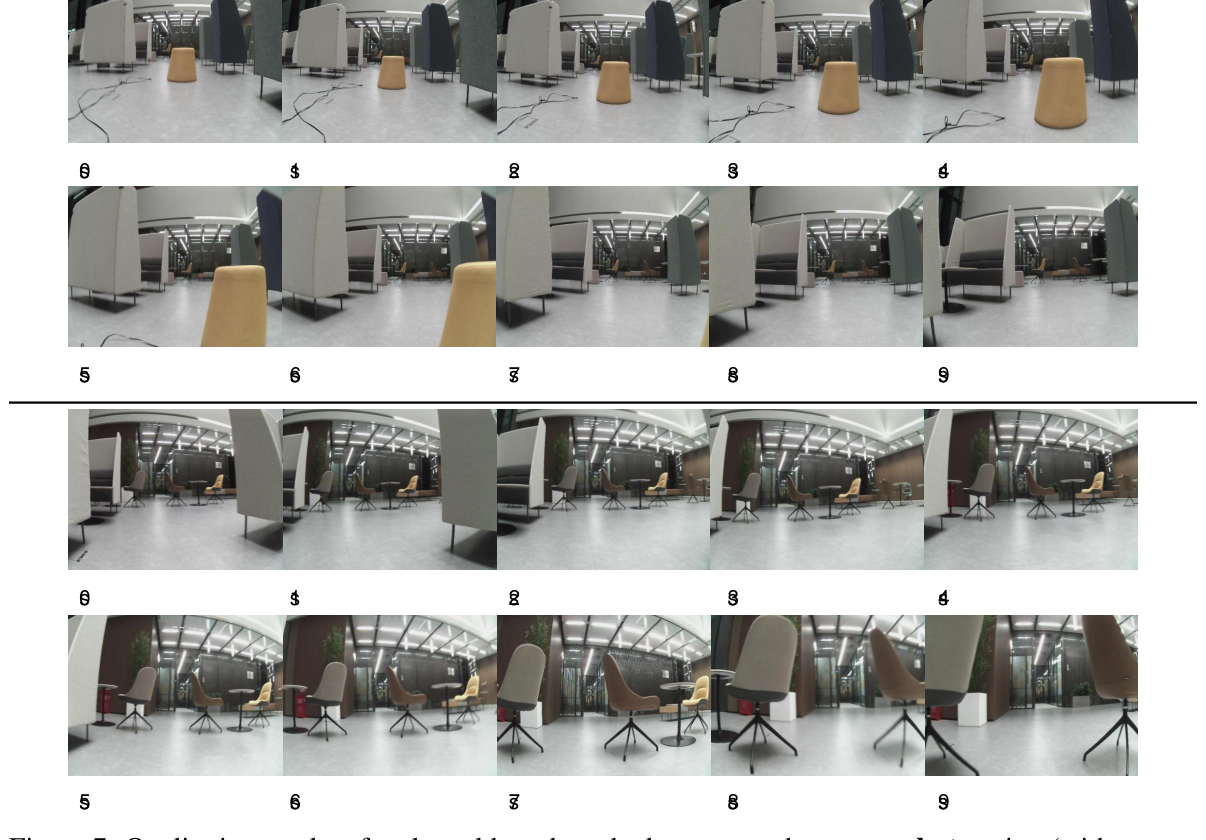
- 在障碍物规避的闭环测试中,四足机器人规划出合理的绕行路径,室内白天、室外夜晚都可用;
- 这是"训练期世界建模 + 推理期纯动作"范式跨具身、跨任务的泛化证明——从车到四足,从 NAVSIM 到真实街道。
🖼️ 生成专家可视化
Metis 的 Video Generation Expert 用 flow matching 生成未来帧。附录 Fig.8 展示:
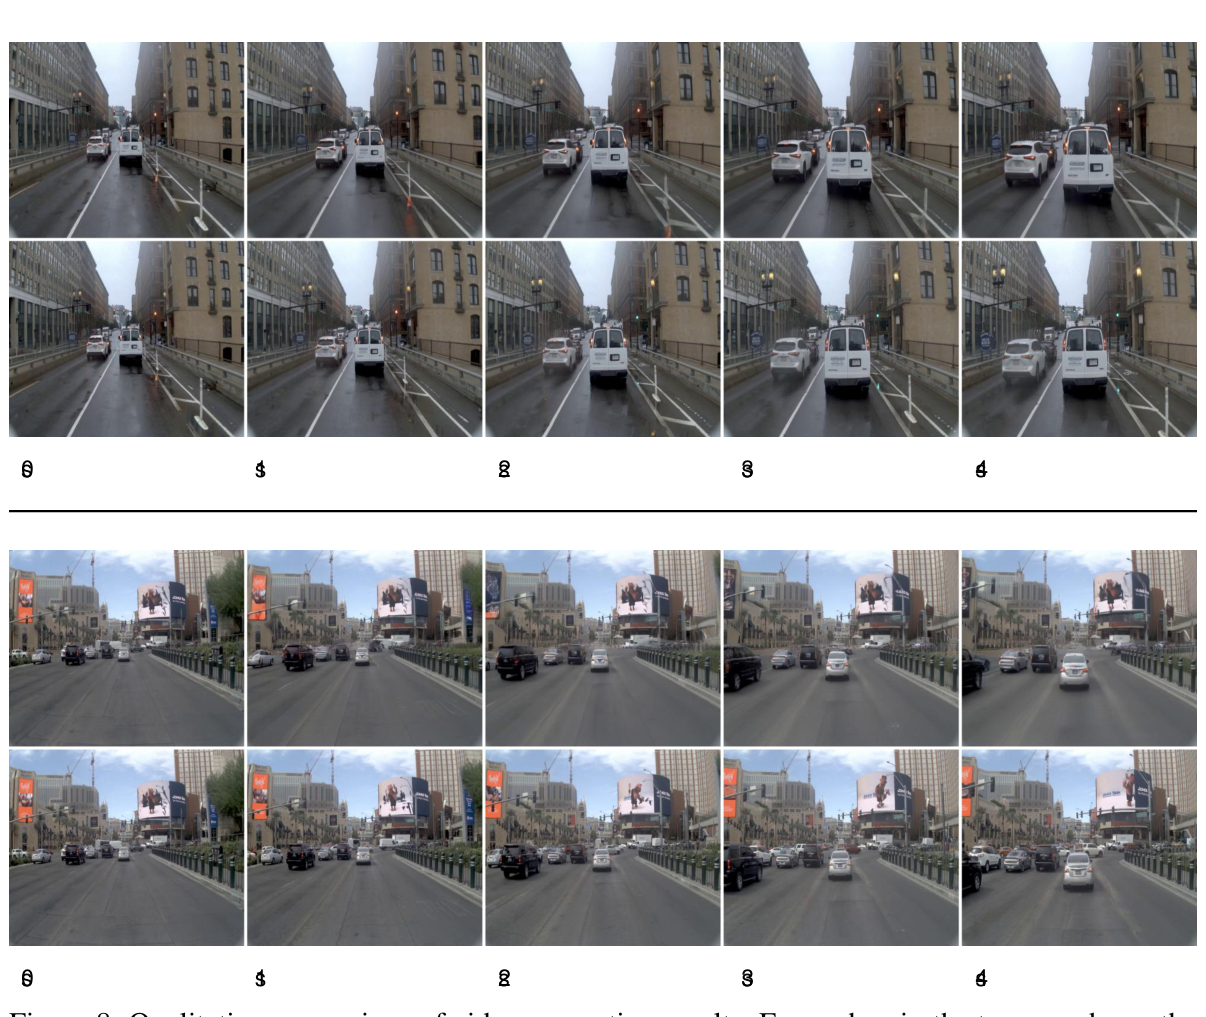
- 相对静态场景生成质量很高;
- 复杂动态交叉口场景下,远处背景车辆的细节可能丢失——但作者指出这不影响短期驾驶动作预测,因为动作分支根本不依赖生成的未来帧。
⚖️ Metis vs SimWAM:同期 WAM 解耦设计的两种取向
这两篇是同一时期(2026年6-8月)探索"解耦视频生成与动作预测"的姊妹工作,思路高度同源,但有几处关键差异值得点透:
| 维度 | Metis(arXiv:2606.15869) | SimWAM(arXiv:2608.07468) |
|---|---|---|
| 团队 | 复旦/港大/同济/理想/华科/帝国理工/萨里 | 华科(白翔团队)× 东风研发 |
| 视频-动作掩码 | Asymmetric:动作看当前,未来视频看动作 | Isolated:未来视频与动作互不可见 |
| 掩码哲学 | 让视频"看到动作"学到"动作→世界演化"因果 | 视频纯当训练信号,隔离最彻底 |
| RL 强化 | ❌ 无 RL(纯模仿 + 世界建模) | ✅ Flow ODE→SDE + GRPO 优化组合驾驶奖励 |
| 基准 | NAVSIM-v2(EPDMS 32.2/89.5)+ CityWalker | NAVSIM-v1(PDMS 91.5)+ nuScenes 零样本 |
| 部署验证 | Unitree Go2 四足机器人 real-world | 论文补充材料提及 real-robot |
| 跨任务 | AD + 城市导航(UN)双任务 | 主攻 AD |
| backbone | VGE 用 Wan2.2-5B;AE 镜像层深 1B,总 6B | VGE 用 Wan2.2-5B;AE hidden=1024(1.02B) |
为什么 Metis 不做 RL? 论文在实验里反复强调”notably without relying on multi-stage training, reinforcement learning, or auxiliary datasets"——它把"世界建模内化动态"当作不依赖 RL 的 SOTA 证明。而 SimWAM 则在同样的解耦地基上叠加了 GRPO(直接继承 Flow-GRPO 的 ODE→SDE 转换),把分数进一步推高。两条路线互为补充:Metis 证明"纯解耦世界建模"本身够强,SimWAM 证明"解耦 + RL"还能更强。
💡 对读者的启示:如果你的目标是"理解 WAM 解耦的本质”,Metis 更纯粹(一张掩码说清所有);如果你关注"如何在 NAVSIM 上拿最高分",SimWAM 的 RL 环节更关键。两者共享的底层洞察是同一句:世界模型的价值在训练期,不在推理期。
🔧 实现细节汇总
| 设置 | 值 |
|---|---|
| VGE | Wan2.2-5B + video VAE + T5 编码器 |
| AE | Diffusion Transformer,镜像 VGE 层深,hidden=1024,约 1B |
| 总参数量 | 6B |
| 输入 | 仅前视相机,640×768(NAVSIM-v2)/ 384×384(CityWalker) |
| 轨迹 | NAVSIM-v2:8 waypoint × 4s @0.5s 间隔(x,y,θ);CityWalker:5 waypoint(x,y) |
| 视频-动作对齐 | 1:1 时间比 |
| 训练 | 双 flow matching 联合;NAVSIM 60 epochs、CityWalker 30 epochs;batch 64 |
| 优化器 | AdamW(lr=1e-4, wd=0.01),cosine 衰减,混合精度,梯度裁剪 1.0 |
| 推理 | 10 步去噪(纯动作部署可用 2 步),CFG=1.0 |
| 硬件 | 8×NVIDIA H200(140GB) |
⚠️ 优势与局限
✅ 优势
- 训练-推理解耦彻底:非对称掩码保证动作从训练到推理都不依赖未来帧,无 mismatch、无生成噪声污染动作空间;
- 8× 推理加速:纯动作推理 0.17s vs 带视频 1.38s,性能几乎无损——实时部署友好;
- 双任务泛化:NAVSIM-v2(AD)+ CityWalker(UN)都 SOTA,还零样本迁移到四足机器人;
- 无 RL 依赖:证明"世界建模内化动态"本身就能到 SOTA,不靠多阶段训练/辅助数据/强化;
- 代码开源:LogosRoboticsGroup/Metis,可复现。
❌ 局限
- 无 RL:相比 SimWAM 的 GRPO 环节,Metis 停留在模仿+世界建模,驾驶质量优化天花板受专家数据限制;
- 重度依赖预训练 VGE:推理虽不跑视频,但训练期 5B 视频模型的训练计算开销仍然巨大(附录 G 明说);
- VAE 降采样比是效率-质量权衡点:降采样比显著影响训练效率和表示质量(附录 G);
- 单目局限:长时程规划中仅靠单目会偶发轻微偏差(附录 E 的 Figure 10),多视角世界建模留作未来工作;
- 极端 corner case 待验证:世界建模本质依赖数据,极端场景可靠性仍需完整验证。
📝 个人思考
这是"解耦 WAM"这篇论文里最干净的一个设计。Metis 把全部创新收敛到"一张非对称注意力掩码"上:动作只看当前、未来视频看动作——这一个小小的不对称,同时带来了知识注入(训练)、效率(推理)、泛化(无污染)三样东西。比起 SimWAM 的"隔离掩码 + RL 双引擎",Metis 的哲学更朴素:把信息流管好,世界模型自然把该教的都教了。
非对称掩码 vs 隔离掩码的取舍,值得单独琢磨:SimWAM 的隔离设计让"视频纯当训练信号",换来的是 RL 阶段可以完全抛开视频分支、独立优化动作专家;Metis 的非对称设计让"视频看动作"学到动作→演化的因果,换来的是 navhard 上更强的表现(Asymmetric 31.6 vs Isolated 29.4)。前者为 RL 铺路,后者为纯世界建模提分——这取决于你想要"更高的最终分"还是"更独立的可优化动作模块"。
我对两个方向的判断:
- “视频-动作单向可见"这个掩码范式会成为 WAM 的标准件——它几乎零成本(一张 mask),却能同时换来训练知识注入和推理旁路,Metis 和 Fast-WAM(arXiv:2603.16666)都在往这个方向收敛;
- 下一步的合流大概率是"非对称掩码 + Flow-GRPO”——Metis 证明了掩码本身够强,SimWAM 证明了 GRPO 能再涨一截。把 Metis 的非对称掩码(视频看动作,学到动作-演化因果)和 SimWAM 的 RL 优化组合在一起,理论上能同时拿到两者的红利。
关联阅读:这篇和 SimWAM 精读、DriveVLA-W0 精读(世界模型放大数据)、ReCogDrive 精读(DiffGRPO)、Flow-GRPO 详解(RL 底座)串起来,正好构成"世界模型范式演进"的完整图谱:DriveVLA-W0(世界模型当数据)→ Metis(世界模型当训练老师,非对称掩码)→ SimWAM(世界模型当老师 + GRPO 强化)→ 未来的合流方向。
📖 论文精读系列。Metis 与 SimWAM 是"解耦 WAM"这一范式的同期双子星,建议对照阅读:Metis 看"非对称掩码如何管住信息流",SimWAM 看"解耦之后如何用 Flow-GRPO 把驾驶质量再顶上去"。