📄 论文信息
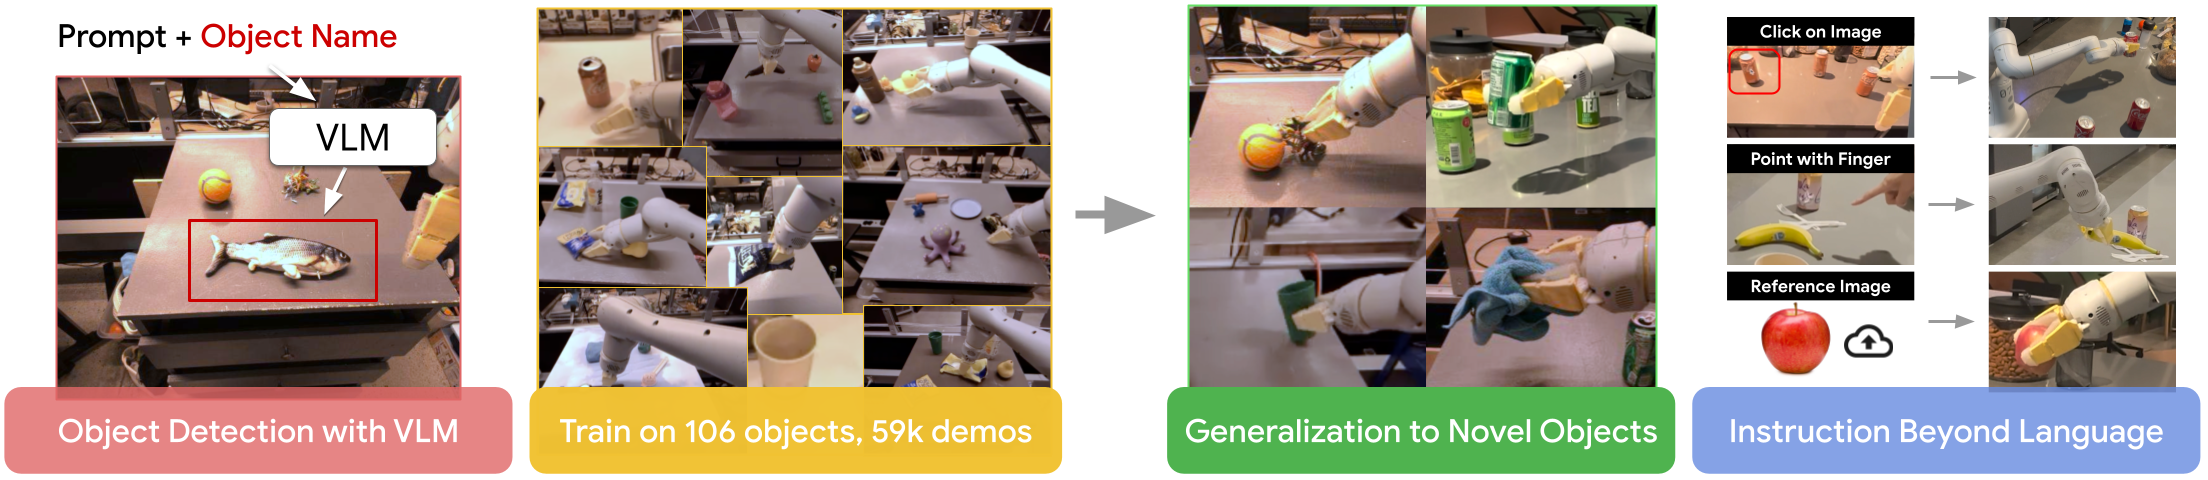
- 标题:Open-World Object Manipulation using Pre-Trained Vision-Language Models(基于预训练视觉-语言模型的开放世界物体操作)
- 团队:Google Robotics(Google Research)
- 发表:CoRL 2023(Conference on Robot Learning)
- 关键词:开放世界操作、视觉-语言模型、零样本泛化、机器人学习、行为克隆
- 一句话总结:MOO通过将预训练VLM的物体定位能力与端到端训练的操控策略相结合,使机器人能够操作训练数据中从未见过的新物体类别。
- 论文链接:arXiv:2303.00905
- 项目主页:robot-moo.github.io
🤔 要解决什么问题?
机器人的能力可以从两个维度来衡量:技能(Skills)和物体(Objects)。
- 技能:具体的行为,如"拿起X"、“将X移到Y附近”、“打开X的盖子”
- 物体:技能操作的对象,如"苹果"、“易拉罐”、“咖啡罐”
现有的机器人学习方法通常在有限的物体集合上训练,因此只能操作训练时见过的物体。当我们要求机器人操作一个从未见过的物体时(比如"拿起那个粉色的毛绒鲸鱼"),系统往往会失败。
核心挑战:如何让机器人在只见过有限物体的情况下,能够泛化到无限的新物体类别?
传统方法的局限性:
- RT-1等端到端方法依赖语言嵌入来区分物体,面对新物体时语言嵌入是陌生的,难以泛化
- 管道式方法(如先检测再操作)虽然可以利用预训练模型,但各模块独立优化,容易产生脆弱性
- 需要为每个新物体收集大量演示数据,不具有可扩展性
💡 核心方法
1. 系统架构
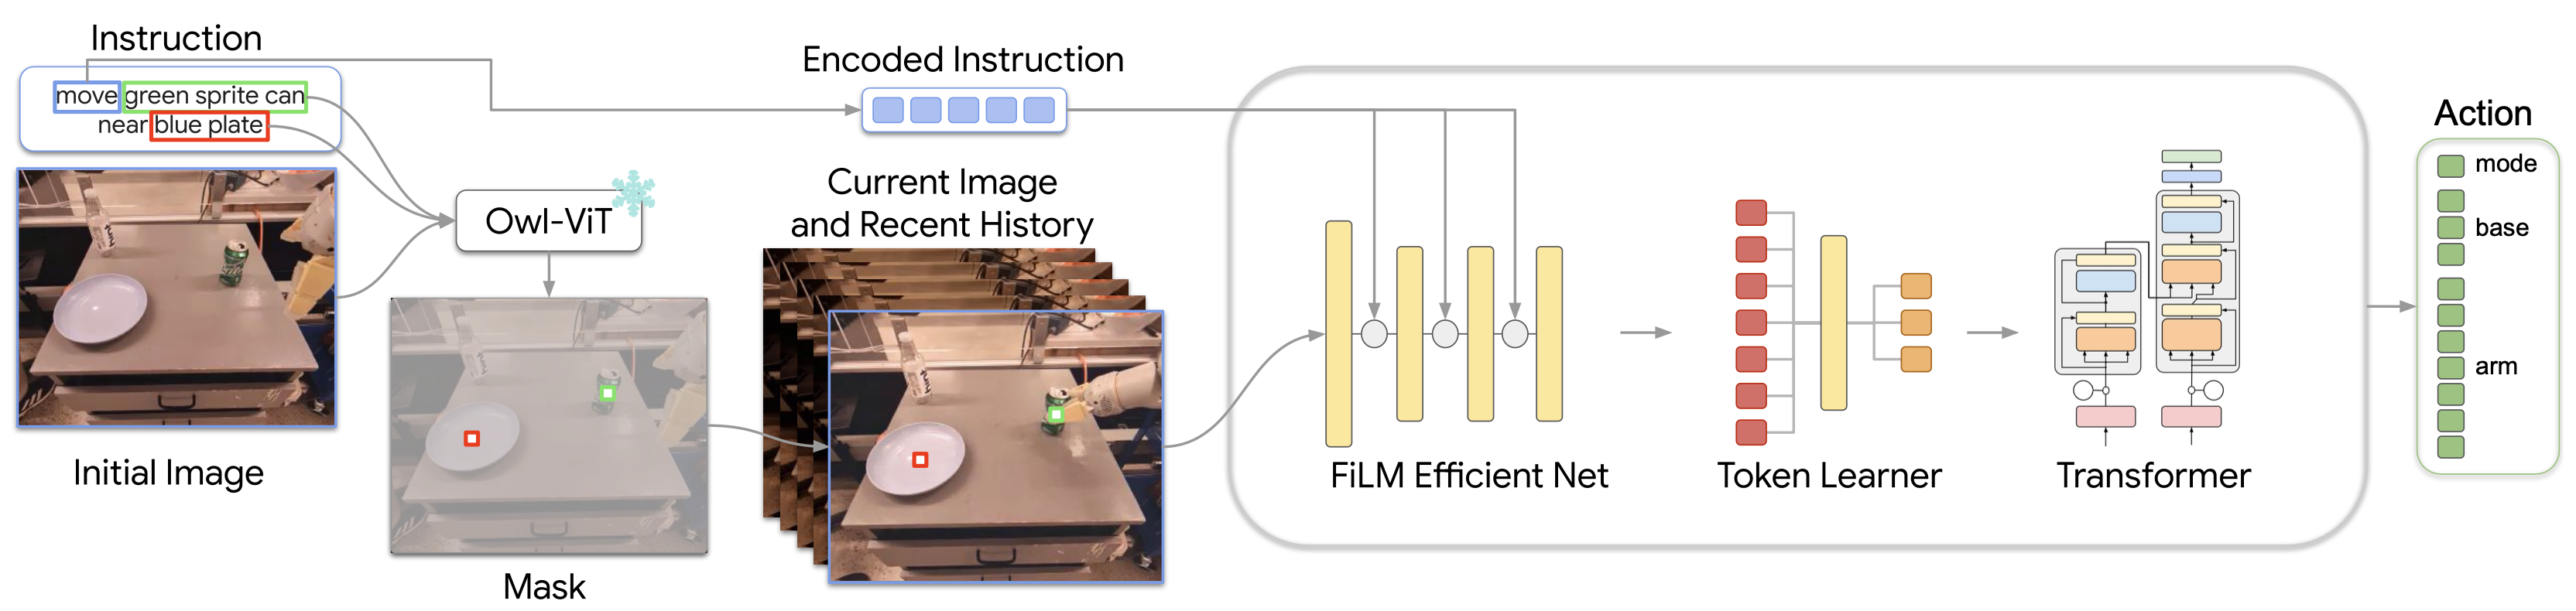
MOO的设计理念是将预训练VLM的感知能力与端到端训练的操控策略相结合:
阶段一:物体定位
- 使用冻结的预训练开放词汇检测器OWL-ViT
- 输入:当前RGB图像 + 语言指令中描述物体的文本
- 输出:目标物体的2D边界框和分割掩码
阶段二:策略执行
- 基于RT-1架构的改进版Transformer策略
- 输入:当前RGB图像 + 物体掩码表示 + 去除物体描述的指令
- 输出:机器人动作序列
2. 关键设计选择
物体掩码表示(Object Mask Representation):
- 将VLM检测到的物体位置转换为单通道分割掩码
- 掩码中心点标记物体位置,周围区域表示物体范围
- 这种表示对所有物体(无论已见还是未见)都是相同的,简化了泛化
语言指令处理:
- 从原始指令中移除物体描述部分
- 只保留技能描述(如"拿起"、“移到"等)
- 避免了新物体语言嵌入带来的泛化问题
训练策略:
- 端到端行为克隆(Behavioral Cloning)
- VLM在整个训练过程中保持冻结
- 策略在真实的VLM检测结果上训练(训练时使用真实的VLM检测器)
3. 数据收集
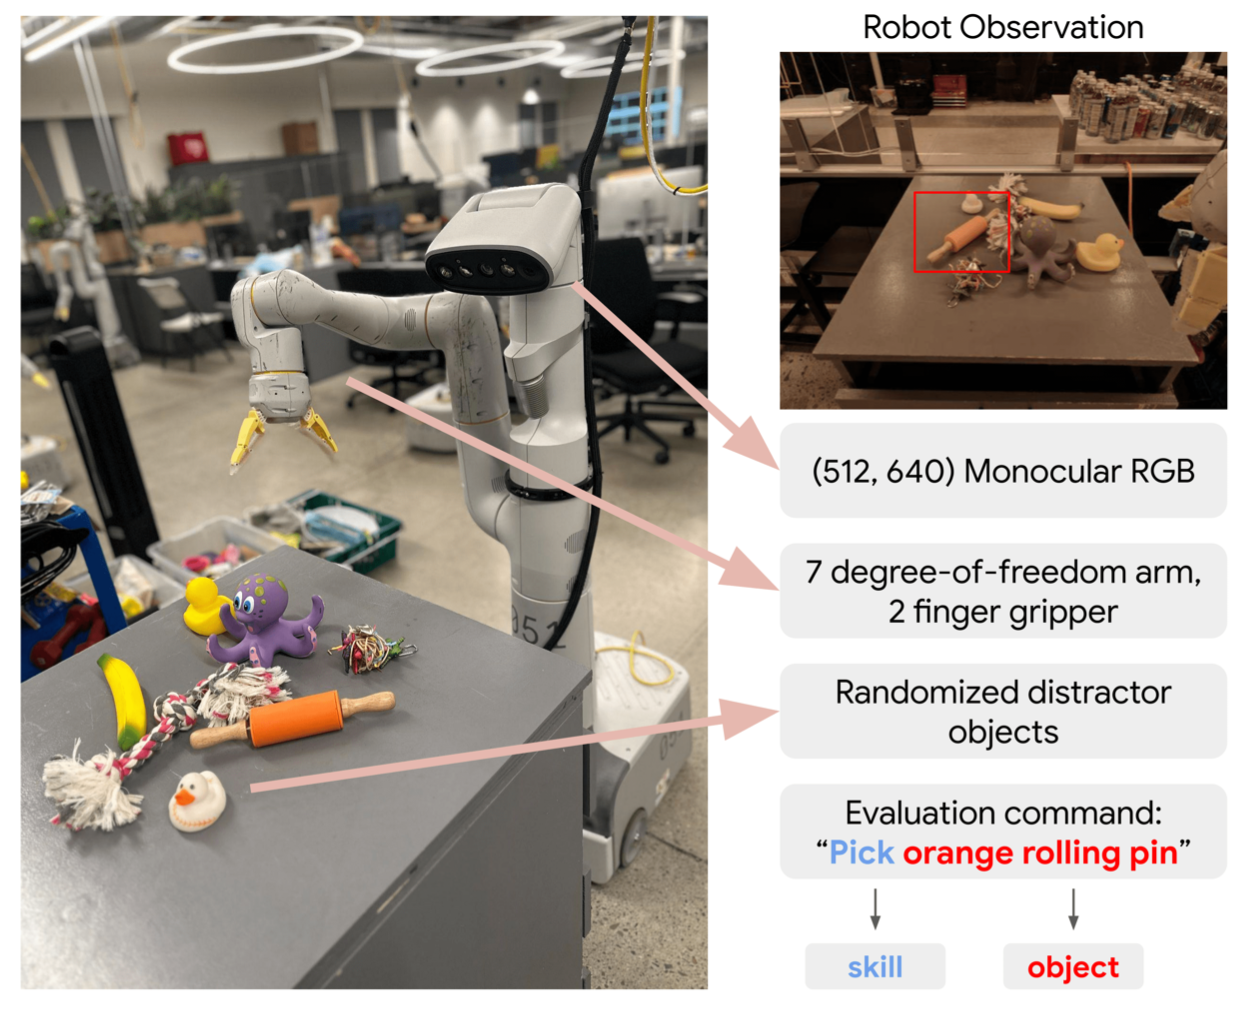
为了学习可泛化的操控技能,作者大幅扩展了训练数据:
- 原始RT-1数据集:仅包含16种物体类型
- MOO扩展数据集:增加了90种不同物体类别的抓取演示
- 总计:106种不同物体类型的演示数据
- 关键洞察:由于大多数技能都需要抓取作为组件步骤,通过增加抓取演示可以学习到泛化到新物体所需的主要信息
4. 多模态输入扩展
MOO的一个重要优势是其物体掩码表示可以支持多种输入模态:
- 文本查询:标准的OWL-ViT文本条件检测
- 指向手势:使用PaLI等VLM解释人类指向,然后用OWL-ViT生成掩码
- 图像查询:OWL-ViT可以直接使用图像特征而非文本特征生成掩码
- 人工GUI输入:人类可以直接在GUI上点击生成掩码
🧪 实验验证
实验设置
评估对象:
- 49个已见物体(训练数据中出现过)
- 47个未见物体(训练数据中完全未出现)
评估指标:任务成功率(成功完成指定技能的比例)
基线方法:
- RT-1:原始的Robotics Transformer
- VIMA:基于多模态提示的通用机器人操作
主要实验结果
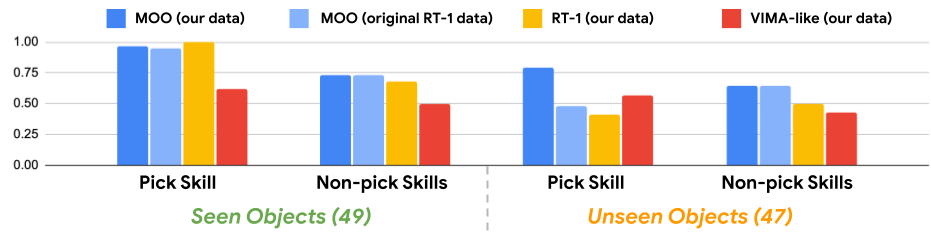
关键发现:
- 未见物体泛化:MOO在未见物体上达到约**79%**的成功率,显著优于RT-1和VIMA
- 已见物体性能:MOO在已见物体上也优于基线方法
- 模型容量的影响:更大的模型容量带来更好的性能
- 数据多样性的影响:更多样化的训练数据显著提升泛化能力
鲁棒性评估
MOO在各种挑战性场景中表现出色:
- 新房间环境:在从未见过的房间中操作
- 新桌面纹理:包括带有干扰性视觉图案的桌布
- 额外的开放世界干扰物:在存在多个干扰物体的环境中操作
开放世界导航与操作
作者还将MOO与开放词汇物体导航算法CoW(Clip on Wheels)结合:
- CoW-MOO系统:先导航到目标物体,然后使用MOO操作
- 实现了真正的开放世界任务执行:机器人能够先找到从未交互过的物体,然后成功操作它
🔍 个人思考
亮点
优雅的模块化设计:MOO巧妙地将预训练VLM的感知能力与端到端训练的操控策略结合。VLM提供物体定位,策略负责执行,两者通过物体掩码表示进行桥接。这种设计既利用了VLM的强大语义理解能力,又保持了策略的端到端可训练性。
强大的零样本泛化能力:在从未见过的物体类别上达到79%的成功率是一个非常令人印象深刻的结果。这证明了将预训练视觉-语言模型引入机器人学习的价值。
多模态输入的灵活性:物体掩码表示使得系统可以支持文本、指向、图像等多种输入方式,大大扩展了应用场景。
局限性
依赖物体检测质量:MOO的性能很大程度上取决于OWL-ViT的检测质量。如果VLM无法正确检测目标物体,整个系统会失败。
仅限于预定义技能:MOO扩展了物体泛化能力,但技能集仍然是预定义的(如"拿起”、“移动"等)。对于真正开放世界的任务,还需要技能层面的泛化。
训练数据需求:虽然MOO减少了对新物体演示数据的需求,但初始训练仍需要大量多样化的物体演示数据(106种物体类型)。
未来方向
- 与更大的VLM结合:探索使用GPT-4V、Gemini等更强大的VLM来提升物体理解和定位能力
- 技能层面的泛化:将开放世界泛化从物体扩展到技能,使机器人能够执行训练时从未见过的新技能
- 在线适应:使MOO能够在与环境交互的过程中持续学习和改进
- 多机器人协作:将开放世界操作扩展到多机器人协作场景
📖 延伸阅读
- RT-1: Robotics Transformer for Real-World Control at Scale(arXiv:2212.06817)- MOO的策略架构基于RT-1改进,该论文展示了Transformer在大规模机器人控制中的潜力
- OWL-ViT: Open-World Localization with Vision Transformers(arXiv:2205.06230)- MOO使用的开放词汇检测器,支持文本和图像条件的物体检测
- VIMA: General Robot Manipulation with Multimodal Prompts(arXiv:2210.03094)- MOO的基线比较方法之一,采用多模态提示的统一接口设计