📄 论文信息
- 标题:Scaling-Aware Data Selection for End-to-End Autonomous Driving Systems
- 团队:NVIDIA, New York University, University of Ottawa
- arXiv:2604.08366
- 收录:CVPR 2026
- 关键词:数据选择, 缩放定律, 端到端自动驾驶, 数据混合, EPDMS
- 一句话总结:MOSAIC 提出基于聚类+缩放定律的数据选择框架,通过拟合每个数据域对评估指标的贡献曲线,迭代地从边际增益最大的域添加数据,在 NAVSIM 上以 42% 更少数据达到全量性能。
🤔 要解决什么问题?
端到端自动驾驶模型的数据需求面临核心矛盾:
| 问题 | 表现 | 后果 |
|---|---|---|
| 数据异构性 | 不同场景(高速/城市/夜间/雨天)对模型性能影响不同 | 简单加数据效果无法预测 |
| 指标竞争 | 部分场景提升 A 指标时可能降低 B 指标 | 全局优化困难 |
| 选择盲目性 | 随机采样/难例挖掘均无法保证最优 | 数据效率低下 |
核心问题:在一个包含多种场景的混合数据集中,如何选择最具价值的数据点来最大化综合评估指标?
💡 核心思想
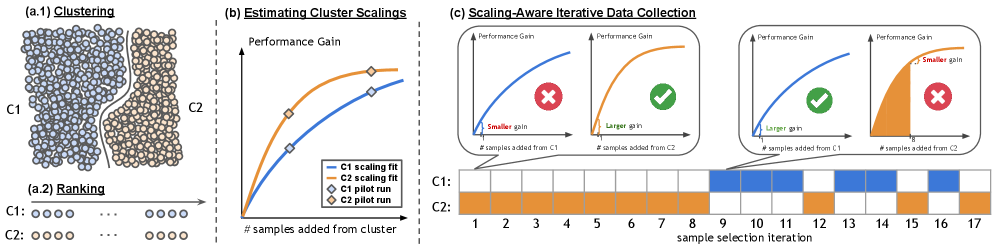
MOSAIC 的关键洞察:不同数据域的缩放行为不同,通过在域级别建模数据的边际贡献,可以做出最优选择。
三阶段流程:
- 聚类分域:将数据集划分为语义一致的域
- 拟合缩放定律:对每个域拟合数据量→指标提升的缩放曲线
- 迭代选择:每次从边际增益最大的域挑选一个样本
⚙️ 方法细节
算法流程
Algorithm: Mixture Optimization via Scaling-Aware Iterative Collection (MOSAIC)

1. 将候选数据集 D_pool 聚类为 M 个域
2. 对每个域拟合缩放定律 ΔÛ_i(n)
3. 初始化:D_sel = ∅, b_i = 0 (已选计数)
4. while |D_sel| < B (预算):
     for i = 1 to M:
       δ_i = ΔÛ_i(b_i + 1) - ΔÛ_i(b_i)
     j = argmax δ_i
     从域 j 的排序序列中取下一个样本加入 D_sel
     b_j += 1
关键组件
1. 聚类与排序:
- 使用语义描述(caption)/ 地理位置 / 场景属性对数据聚类
- 每个域内根据重要性分数排序
2. 神经缩放定律:
- 对每个域训练多个数据量级别的模型子集
- 拟合数据量 $n$ 与累积指标提升 $\Delta U_i(n)$ 的关系
3. 迭代选择:
- 每次选择使 $\delta_i$(边际增益)最大的域
- 从该域中按重要性排序依次取样本
适用模型
MOSAIC 在 Hydra-MDP(NAVSIM challenge 获胜模型)上验证,但框架通用,可应用于任意端到端规划器。
🧪 实验与结果
NAVSIM 性能
| 方法 | EPDMS | 使用数据比例 |
|---|---|---|
| 全量训练 | 87.12 | 100% |
| 随机采样 | 82.45 | 50% |
| 难例挖掘 | 84.18 | 50% |
| Influence-based | 83.76 | 50% |
| 聚类均匀采样 | 84.92 | 50% |
| MOSAIC | 86.88 | 50% |
| MOSAIC (最佳) | 86.73 | ~42% (达到全量 99.6%) |
MOSAIC 仅用 42% 的数据即可达到全量训练的 99.6% 性能,节省超过一半的数据采集成本。
不同聚类方法的鲁棒性
| 聚类方法 | EPDMS (50%) | 说明 |
|---|---|---|
| 语义 Caption | 86.88 | 基于场景描述聚类 |
| 地理位置 | 86.02 | 基于采集地点聚类 |
| 场景属性 | 86.45 | 基于光照/天气等聚类 |
| 不使用聚类(flat) | 82.15 | 仅缩放定律,不分域 |
MOSAIC 对不同聚类方法均优于基线,且聚类+缩放定律的组合显著优于仅用聚类。
数据效率提升
| 场景 | 数据节省 |
|---|---|
| 达到全量 EPDMS 的 99% | -42% |
| 达到特定 EPDMS 阈值 | -80%(vs 随机采样) |
⚠️ 局限与未来方向
- 每个域需要训练多个子模型来拟合缩放定律,计算开销不可忽视
- 聚类方式的选择对最终结果有影响,最优聚类策略仍需探索
- 仅在仿真基准(NAVSIM)上验证,真实场景的适用性待确认
- 当前仅考虑固定数据预算下的选择,未考虑主动学习场景
📝 个人思考
MOSAIC 是数据效率派的典型代表——在自动驾驶数据集规模越来越大的今天(Waymo 超 2000 万帧,nuScenes 超 140 万帧),不是数据越多越好,而是哪种数据更有用才重要。 这篇工作的工程实用性非常强——数据采集是自动驾驶中最昂贵的环节之一,减少 42% 的数据需求意味着千万级的成本节省。
与缩放定律的关系:经典的缩放定律研究关注"加更多数据会怎样",而 MOSAIC 逆向思考"加哪种数据收益最大"。两者本质互补——缩放定律告诉你曲线趋势,MOSAIC 告诉你选哪个点。
这个框架对正在进行 Flow-GRPO 训练的我们有直接参考价值——不同驾驶场景的训练数据配比直接影响 RL 策略的最终性能,MOSAIC 的域级边际收益分析可以被引入到 reward 设计中。
📖 这是论文精读系列的第 XX 篇。数据的选择比数据的数量更重要——在自动驾驶领域尤其如此。欢迎留言讨论。