📄 论文信息
- 标题:NoRD: A Data-Efficient Vision-Language-Action Model that Drives without Reasoning
- 团队:Applied Intuition, Texas A&M University, UC Berkeley
- arXiv:2602.21172
- 代码:github.com/Applied-Open-Source/nord
- 收录:CVPR 2026
- 关键词:VLA, 数据效率, 免推理驾驶, Dr.GRPO, RL 后训练
- 一句话总结:NoRD 去掉了 VLA 中的推理环节,只用少量轨迹数据做 SFT + Dr.GRPO 强化学习,在 Waymo 和 NAVSIM 上取得可比性能,token 数减少 3 倍。
🤔 要解决什么问题?
当前 VLA 模型在自动驾驶中面临两个高昂的依赖:
| 依赖 | 问题 | 代价 |
|---|---|---|
| 大规模数据集 | 需要数十万乃至百万级带标注驾驶样本 | 采集和标注成本极高 |
| 推理标注 | 需要 GPT-4o 等教师模型生成 CoT 推理链 | 训练计算量大,推理延迟高 |
NoRD 的关键问题:自动驾驶真的需要"边想边开"吗?能否做到直接感知到动作的映射?
💡 核心思想
NoRD 的核心洞察有三层:
- 推理并非必要:模型可以在不生成中间推理文本的情况下直接预测轨迹,利用 VLM 内部的空间-时间先验即可
- 小数据 + 无推理的 SFT 策略足够作为起点:仅用 80K 样本(SOTA 方法的 <60%)即可训练基础策略
- 标准 GRPO 在弱策略上因难度偏差失效:Dr.GRPO 可修复这个问题
⚙️ 方法细节
训练流程对比
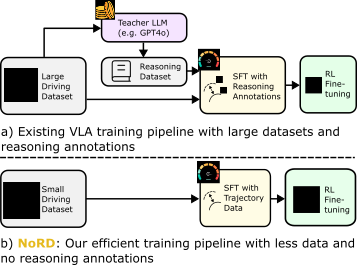
传统 VLA 流程: 大规模驾驶数据 → 教师 LLM 生成推理标注 → SFT 训练(含推理链)→ GRPO 强化学习
NoRD 流程: 小规模驾驶数据(80K 样本)→ SFT 训练(仅轨迹)→ Dr.GRPO 强化学习
难度偏差(Difficulty Bias)
这是本文最核心的分析发现:
标准 GRPO 的优势计算为:
$$ A_i = \frac{r_i - \mu}{\sigma} $$对于弱策略产生的 rollout,简单场景(直线行驶)的 rollout 方差低,reward 稳定;复杂场景(急转弯、避障)的 rollout 方差高,reward 波动大。GRPO 用标准差 $\sigma$ 做归一化时,高方差场景的 reward 被严重惩罚,导致模型倾向于只学习简单场景,忽略困难场景。
| 场景类型 | Rollout 方差 | GRPO 优势 | 学习效果 |
|---|---|---|---|
| 简单(直线) | 低 | 正常 | 正常学习 |
| 复杂(转弯) | 高 | 被压制 | 几乎不学习 |
Dr.GRPO 的改进
Dr.GRPO 移除了标准差分母,缓解难度偏差:
$$ A_i = r_i - \mu $$这样高方差场景中偶尔成功的 rollout 也能获得正向优势信号,让弱策略能有效从困难场景中学习。
模型架构
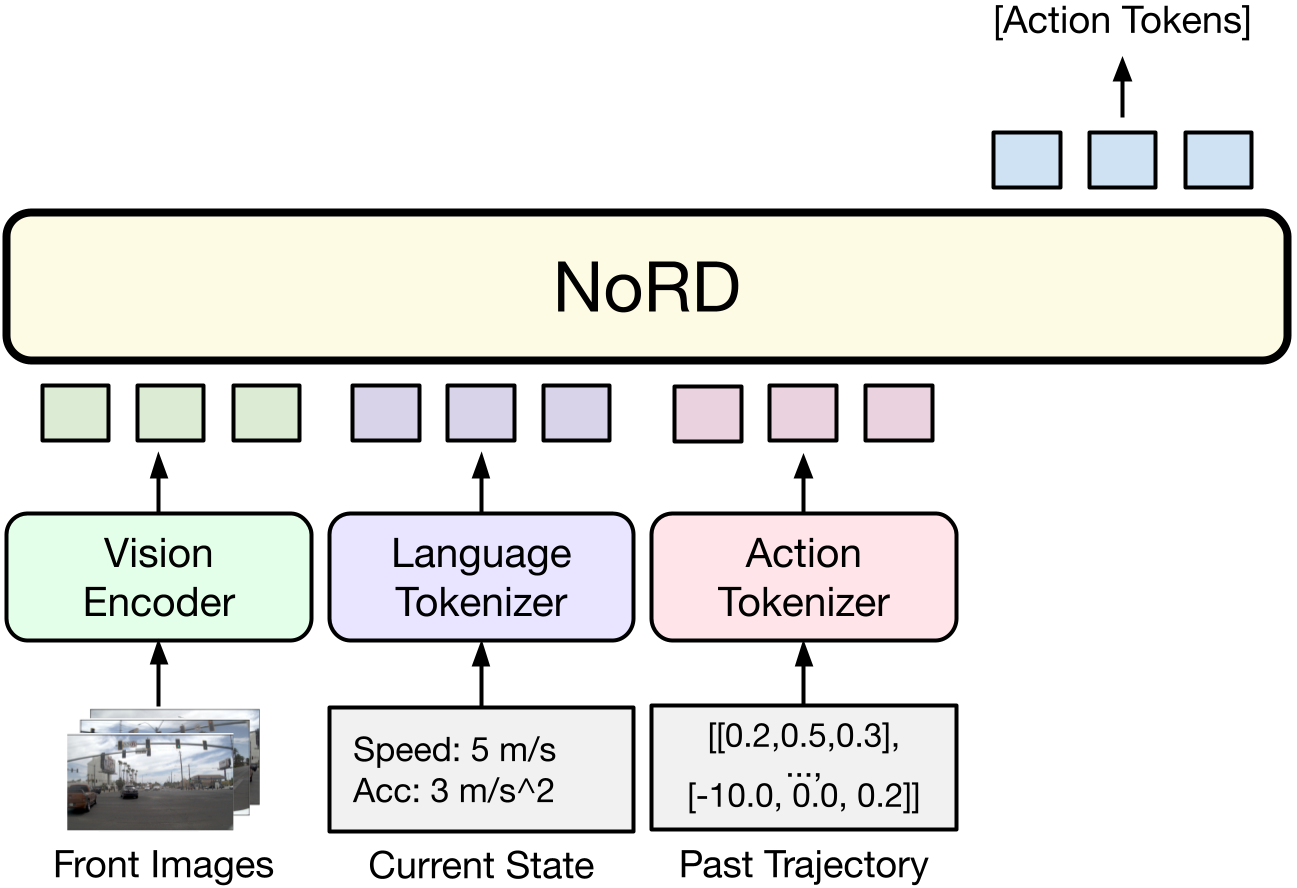
- 基座:Qwen-2.5VL-3B-Instruct
- 输入:多视角 RGB 图像(前、前左、前右)+ 历史轨迹 token + 速度/加速度
- 输出:使用 k-disc tokenized 词表直接预测未来 10Hz 轨迹
🧪 实验与结果
NAVSIM 结果
| 方法 | PDM Score | 训练数据量 | 推理标注 |
|---|---|---|---|
| UniPlan | 82.14 | ~790K | ✅ |
| HMVLM | 83.95 | ~350K | ✅ |
| AutoVLA | 84.12 | ~460K | ✅ |
| NoRD (SFT only) | 76.88 | 80K | ❌ |
| NoRD (SFT + GRPO) | 77.55 | 80K | ❌ |
| NoRD (SFT + Dr.GRPO) | 85.60 | 80K | ❌ |
Dr.GRPO 带来了 11.68% 的显著提升,而标准 GRPO 仅有 0.67%。
WaymoE2E 结果
| 方法 | RFS | 数据量 | 推理标注 |
|---|---|---|---|
| Poutine | 7.91 | ~680K | ✅ |
| AutoVLA | 7.87 | ~460K | ✅ |
| NoRD (SFT only) | 7.26 | 80K | ❌ |
| NoRD (SFT + Dr.GRPO) | 7.59 | 80K | ❌ |
Token 效率
| 方法 | Token 数 | 推理延迟 |
|---|---|---|
| AutoVLA (含推理) | ~900 tokens | ~400ms |
| EMMA (含推理) | ~750 tokens | ~380ms |
| NoRD | ~250 tokens | ~120ms |
消融实验 — GRPO vs Dr.GRPO
| 策略 | PDM Gain | 说明 |
|---|---|---|
| SFT baseline | 76.88 | 基础 |
| + GRPO | 77.55 (+0.67%) | 几乎无提升 |
| + Dr.GRPO | 85.60 (+11.68%) | 显著提升 |
🎯 NoRD vs LinkVLA:两种哲学
| 维度 | NoRD | LinkVLA |
|---|---|---|
| 语言-动作关系 | 去掉推理,直接映射 | 强化对齐,双向绑定 |
| 对推理的态度 | 不需要 | 需要(但只是生成动作,非 CoT) |
| 后训练 | Dr.GRPO | 纯 SFT |
| 关键瓶颈 | 难度偏差 | 模态不对齐 |
⚠️ 局限与未来方向
- 仅使用 Qwen2.5VL-3B,更大模型的表现有待验证
- 在真实场景中的闭环比仿真更具挑战性
- 无推理策略在极端长尾场景下的表现需进一步研究
- Dr.GRPO 的超参数敏感性未充分分析
📝 个人思考
NoRD 最精彩的部分是对 GRPO 失效原因的诊断。难度偏差这个概念在 LLM 领域已被关注,但 NoRD 首次在自动驾驶 VLA 中揭示了它的影响。这个发现不仅对 NoRD 本身有价值,对所有用 RL 做 VLA 后训练的工作都有警示意义。
与 LinkVLA 对比来看,NoRD 走了相反的路——去掉冗余的中间环节。两篇同时被 CVPR 2026 接收,说明当前领域对 VLA 应该"多思考"还是"少思考"还存在根本分歧。我个人倾向于中间路线:保留轻量推理但不过度,同时用 RL 做端到端优化。
有趣的是,NoRD 来自工业界(Applied Intuition),LinkVLA 来自车企(理想汽车)。工业界对效率的极致追求在这里体现得很明显——每毫秒的延迟节省和每 MB 的计算量都有实际意义。
📖 这是论文精读系列的第 XX 篇。驾驶到底需不需要推理?这个问题的答案可能因场景而异。欢迎留言讨论。