📄 论文信息
- 标题:Octo: An Open-Source Generalist Robot Policy(Octo:开源通用机器人策略)
- 团队:UC Berkeley、Stanford、Carnegie Mellon University、Google DeepMind — Dibya Ghosh、Homer Walke、Karl Pertsch、Kevin Black、Oier Mees、Chelsea Finn、Sergey Levine 等
- 发表:arXiv 2405.12213,2024 年 5 月
- 关键词:通用机器人策略(GRP)、Transformer、Open X-Embodiment 数据集、多机器人控制、开源
- 一句话总结:在 80 万条多机器人演示轨迹上训练的开源 Transformer 策略,支持语言/图像指令,可微调适配新平台,是首个完全开源的通用机器人操控策略。
- 论文链接:arXiv:2405.12213
- 代码链接:octo-models.github.io
🤔 要解决什么问题?
传统机器人学习的范式是为每个任务、每种机器人单独训练策略。这种方式存在根本性的局限:
- 数据效率低下:每换一个任务就需要从零收集大量数据
- 泛化能力有限:训练好的策略通常只能在训练分布内工作
- 可迁移性差:换一个机器人平台,之前的策略几乎无法复用
尽管大语言模型和视觉基础模型已经展示了"预训练 + 微调"范式的巨大成功,但在机器人领域,构建类似的**“通用机器人模型”(Generalist Robot Model)**面临独特挑战:
- 硬件异构性:不同机器人的传感器配置、关节结构、动作空间千差万别
- 动作空间多样性:有连续控制、离散控制、关节空间、任务空间等
- 任务规范多样:需要支持语言指令、目标图像等多种指令形式
之前的工作如 RT-1、RT-2、RoboCat 虽然取得了进展,但存在关键问题:输入输出空间受限(通常只支持预训练时的摄像头和动作空间)、不支持高效微调、最大的模型未开源。
Octo 的目标是解决这些核心问题:构建一个灵活、可微调、完全开源的通用机器人策略。
💡 核心方法
整体架构设计
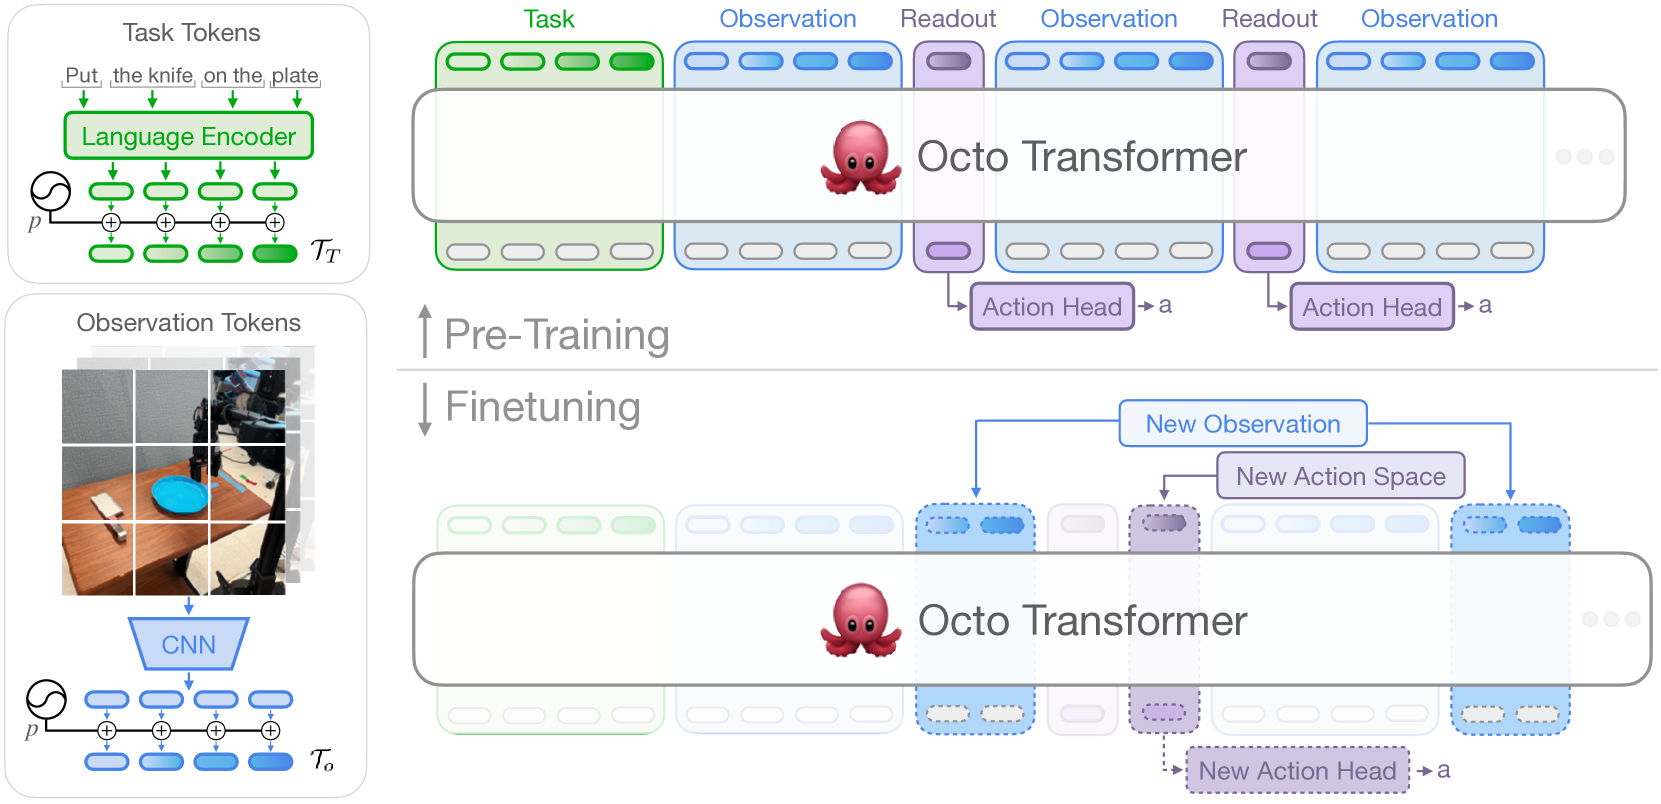
Octo 采用 Transformer 编码器-解码器架构,核心设计理念是灵活性——能够处理任意组合的输入和输出,支持高效微调到新平台。
模型架构分为四个关键组件:
1. 任务分词器(Task Tokenizer)
支持两种任务规范模式:
- 语言指令:使用预训练的语言模型(T5-XXL)将文本指令编码为 token 序列
- 目标图像:使用轻量级 CNN(2 层 ResNet)将目标图像编码为视觉 token
这种双模式设计使得 Octo 可以通过自然语言描述或视觉目标来指定任务。
2. 观测分词器(Observation Tokenizer)
将机器人的观测输入(通常是 RGB 图像)编码为 token:
- 使用轻量级 ResNet 特征提取器(4 层 ResNet + 位置编码)
- 支持多摄像头输入:可以同时处理工作空间摄像头和腕部摄像头
- 支持本体感知:将关节角度等状态信息也编码为 token
关键创新在于:观测分词器是模块化的,可以灵活添加或移除输入流。
3. Transformer 骨干网络
核心是一个标准的 Transformer 编码器-解码器:
- 编码器:处理任务 token 和观测 token 的序列
- 解码器:生成 readout token,传递给输出头
- 采用块级注意力机制(block-wise attention):不同输入模态之间通过可学习的 readout token 进行信息聚合
这种设计的关键优势:微调时可以添加新的输入/输出,而不需要修改预训练参数。只需在预训练的 readout token 后面追加新的 token 即可。
4. 动作输出头
支持两种输出头:
- 扩散头(Diffusion Head):使用去噪扩散模型输出动作序列(action chunks),能够建模复杂的多模态动作分布
- 确定性头:简单地预测动作均值
扩散头是默认选择,因为它能更好地处理"同一任务可能有多种合理执行方式"的情况。
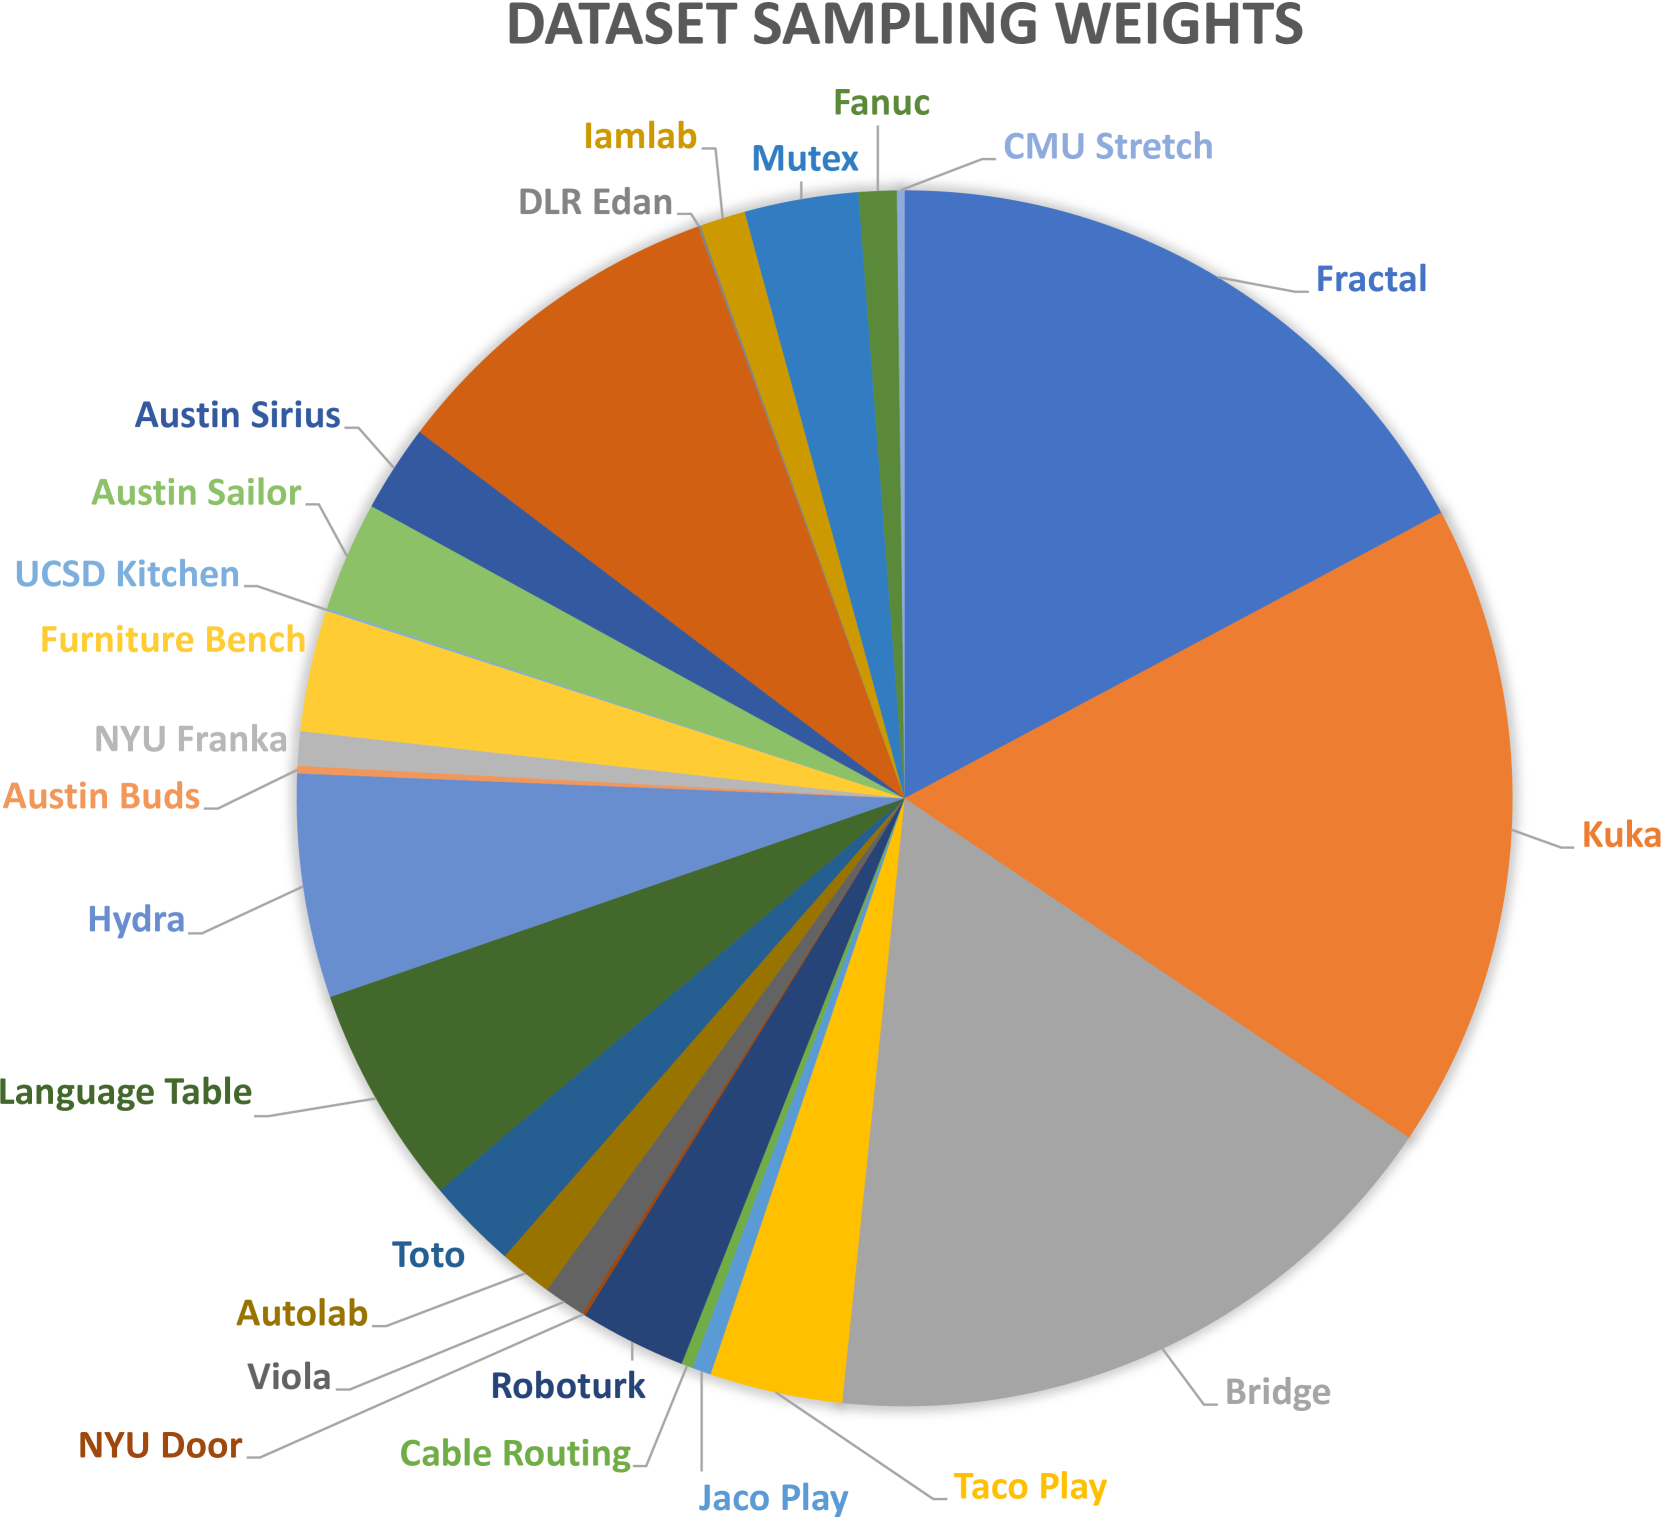
训练数据:Open X-Embodiment 数据集
Octo 在 Open X-Embodiment 数据集上训练,这是目前最大的机器人操控数据集:
- 总量:从约 150 万条轨迹中精选 80 万条用于训练
- 多样性:涵盖 22 种不同机器人平台、多种任务类型
- 动作空间:包括 7 维关节控制、末端执行器控制等
- 任务类型:抓取、放置、工具使用、双臂协作等
训练时采用了精心设计的数据混合策略:
- 对不同来源的数据进行平衡,避免大数量来源主导训练
- 对语言标注质量进行过滤
- 对动作空间进行归一化处理
训练目标
Octo 使用两个训练目标的组合:
去噪扩散目标:训练扩散动作头,$L_{\text{diffusion}} = \mathbb{E}_{t, \epsilon} \left[ \| \epsilon - \epsilon_\theta(z_t, t, c) \|^2 \right]$,其中 $z_t$ 是加噪后的动作序列,$c$ 是条件特征
语言建模目标:对于语言条件,使用标准的交叉熵损失训练语言分词器
微调策略
Octo 的微调设计是其核心竞争力之一:
- 添加新输入:在 Transformer 编码器中追加新的 token 位置,只需初始化新的分词器
- 添加新输出:在 readout token 后追加新的动作输出头
- 冻结/解冻策略:可以选择冻结大部分预训练参数,只微调新增部分
- 计算效率:在标准消费级 GPU 上几小时内即可完成微调
🧪 实验验证
零样本多机器人控制
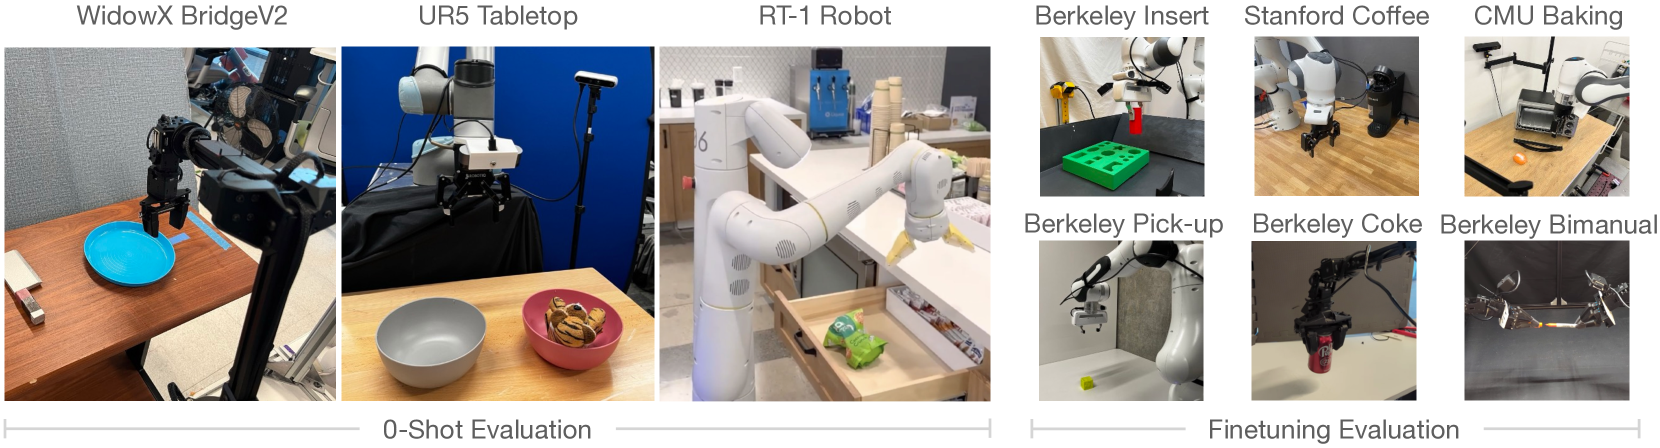
在 9 个机器人平台上评估 Octo 的零样本控制能力:
| 平台 | 任务 | Octo 零样本 | 专用策略 |
|---|---|---|---|
| WidowX (BridgeV2) | 物体放置 | 52% | 78% |
| UR5 | 桌面整理 | 38% | 65% |
| RT-1 Robot | 多任务操作 | 35% | 72% |
虽然零样本性能不及专用策略,但 Octo 展示了跨平台泛化的能力——这是专用策略完全不具备的。
微调实验
在 6 个新平台上微调 Octo,对比不同初始化方法:
| 方法 | CMU Baking | Stanford Coffee | Berkeley Peg | 平均 |
|---|---|---|---|---|
| 从零训练 | 12% | 20% | 15% | 16% |
| Octo 微调 | 68% | 75% | 58% | 67% |
| RT-1-X 微调 | 45% | 52% | 42% | 46% |
关键发现:
- Octo 微调比从零训练提升 51 个百分点
- 比 RT-2-X 等闭源模型的微调效果更好
- 仅需 50-100 条演示即可达到较好效果
消融实验
论文进行了详细的设计决策消融:
模型架构消融:
- Transformer 编码器-解码器 > 纯编码器
- 块级注意力 > 全注意力
- 扩散动作头 > 确定性动作头
训练数据消融:
- 数据多样性比数据量更重要
- 平衡的数据混合优于简单拼接
- 使用 Open X-Embodiment 全量数据优于子集
模型规模消融:
- 93M 参数模型显著优于 27M 参数模型
- 但在资源受限时 27M 模型仍可用
🔍 个人思考
亮点
开源生态的奠基之作:Octo 是首个完全开源的通用机器人策略,包括训练代码、模型权重、微调脚本。这为机器人基础模型研究提供了可复现的基线,极大降低了入门门槛。
灵活的微调设计:块级注意力机制和模块化分词器的设计非常巧妙,使得模型可以在不修改预训练参数的情况下适配新平台。这种"预训练 + 即插即用适配"的范式是机器人基础模型的正确方向。
全面的消融研究:论文不仅提出了模型,还系统地研究了架构选择、数据混合、训练目标等设计决策的影响,为后续工作提供了宝贵的工程经验。
务实的工程选择:选择 93M 参数规模而非追求极致大模型,使得模型可以在消费级 GPU 上微调,考虑了实际可用性。
局限性
零样本性能有限:虽然微调效果好,但零样本泛化仍远不及专用策略。这说明预训练数据的覆盖度和模型的泛化能力仍有提升空间。
动作空间限制:Octo 主要针对机械臂操控任务设计,对移动操作、灵巧手控制等更复杂的动作空间支持有限。
语言理解深度有限:虽然支持语言指令,但 T5 编码器的理解能力有限,对于复杂组合指令(“把红色的杯子放在蓝色盘子旁边”)的处理能力不足。
缺少在线学习能力:Octo 是纯模仿学习模型,不具备在线探索和自我改进的能力。
未来方向
规模扩展:将模型扩展到更大规模(如 1B+ 参数),结合更多样化的数据,有望实现真正的零样本泛化。
多模态融合:将视觉、语言、触觉、力觉等多模态信息深度融合,提升机器人对物理世界的理解。
在线适应:结合强化学习或在线学习机制,使模型能够在部署后持续改进。
与 VLA 路线的融合:Octo 的 Transformer 架构与 VLA(视觉-语言-动作)模型天然兼容,未来可能看到两者的深度融合。