📄 论文信息
- 标题:OpenVLA: An Open-Source Vision-Language-Action Model(OpenVLA:开源视觉-语言-动作模型)
- 团队:Stanford University、UC Berkeley、Toyota Research Institute、Google DeepMind — Moo Jin Kim、Karl Pertsch、Siddharth Karamcheti、Chelsea Finn、Sergey Levine、Percy Liang 等
- 发表:arXiv 2406.09246,2024 年 6 月
- 关键词:VLA、开源、Llama 2、DINOv2、SigLIP、LoRA 微调、机器人操控
- 一句话总结:首个完全开源的 7B 参数 VLA 模型,以 7 倍更少参数超越闭源 RT-2-X,支持高效微调和量化部署。
- 论文链接:arXiv:2406.09246
- 代码链接:openvla.github.io
🤔 要解决什么问题?
视觉-语言-动作模型(VLA)被认为是机器人通向通用智能的关键路径。这类模型将预训练的视觉-语言模型(VLM)直接微调为机器人控制策略,能够利用互联网规模的视觉-语言先验来提升泛化能力。
然而,VLA 模型的广泛应用面临两大障碍:
1. 现有 VLA 模型几乎全部闭源
RT-2(55B 参数)虽然展示了惊人的泛化能力,但它是闭源的——不公开模型权重、训练代码或数据混合。这意味着:
- 研究社区无法复现或改进
- 其他实验室无法在其基础上构建
- VLA 研究变成了"军备竞赛"而非开放合作
2. 缺乏高效微调的最佳实践
即使有开源的通用策略(如 Octo),如何高效地将其适配到新机器人、新任务仍是未解问题。现有工作:
- 没有系统研究 LoRA 等参数高效微调方法在 VLA 上的效果
- 没有探索模型量化对 VLA 推理的影响
- 缺乏面向消费级硬件的部署方案
核心问题
如何构建一个开源、高效、可微调的 VLA 模型,使其性能达到或超越闭源模型,同时让机器人研究社区能够自由使用和改进?
OpenVLA 的回答是:基于开源 VLM 骨干 + 机器人数据微调 + 参数高效适配。
💡 核心方法
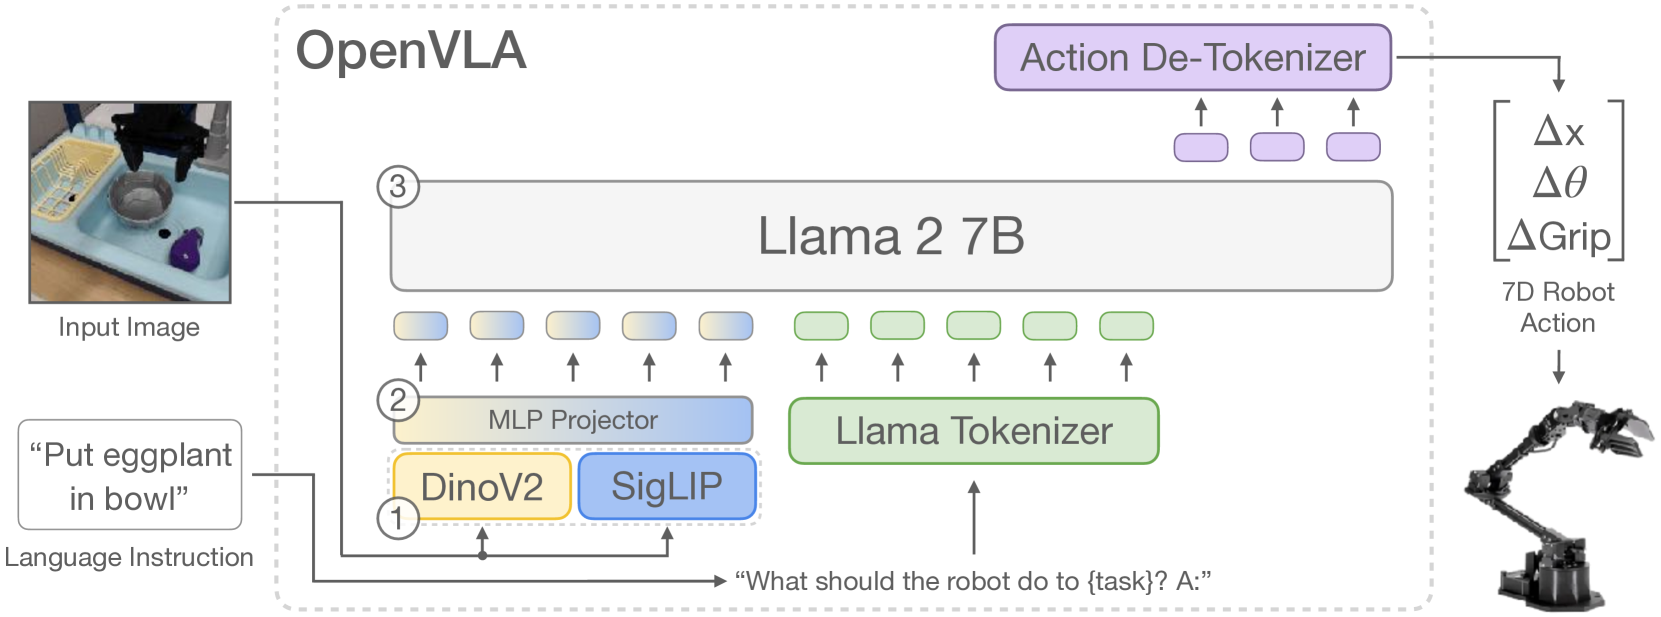
模型架构:端到端 VLA
OpenVLA 的核心创新是直接微调预训练 VLM 生成机器人动作,而非像 Octo 那样将视觉编码器和语言模型分开处理。
视觉编码器:DINOv2 + SigLIP 双流融合
OpenVLA 使用两个互补的预训练视觉编码器:
| 编码器 | 特点 | 提供的能力 |
|---|---|---|
| DINOv2 | 自监督训练,关注空间结构 | 低层次几何信息、物体边界、空间关系 |
| SigLIP | 监督训练,关注语义理解 | 高层次语义信息、物体识别、场景理解 |
两个编码器的特征通过 patch-as-token 方式融合:
- 图像被分成 $16 \times 16$ 的 patch
- 每个 patch 同时提取 DINOv2 和 SigLIP 特征
- 拼接后投影到语言模型的输入空间
这种双流设计使得 OpenVLA 能够同时理解"在哪里"(空间)和"是什么"(语义)。
语言骨干:Llama 2
使用 Llama 2 7B 作为语言模型骨干,这是一个在互联网规模文本上预训练的强大语言模型。选择 Llama 2 的原因:
- 开源且广泛使用
- 强大的指令遵循和推理能力
- 成熟的微调生态(LoRA、量化等)
动作输出:离散化 token 预测
与 Octo 使用扩散头不同,OpenVLA 将连续动作离散化为 token:
- 将每个动作维度的范围均匀分成 256 个 bin
- 每个动作维度映射为一个离散 token
- 语言模型自回归地预测这些动作 token
这种方法的优势:
- 可以直接复用语言模型的自回归生成框架
- 不需要额外的动作解码器
- 训练简单,损失函数就是标准的交叉熵
劣势:
- 精度受 bin 数量限制
- 自回归生成速度较慢
训练数据:Open X-Embodiment 精选
OpenVLA 在 97 万条真实机器人演示轨迹上训练,这些数据来自 Open X-Embodiment 数据集的精选子集:
- 来源:21 种不同机器人平台
- 任务类型:物体操控、桌面整理、工具使用等
- 数据筛选:过滤低质量轨迹,平衡不同来源的数据比例
关键的数据处理策略:
- 动作归一化:对每个动作维度进行标准化
- 图像增强:随机裁剪、颜色抖动等
- 语言标注清洗:使用语言模型验证指令质量
参数高效微调:LoRA
OpenVLA 首次系统研究了 LoRA(Low-Rank Adaptation) 在 VLA 模型上的效果:
- 在 Transformer 层的注意力矩阵中添加低秩适配层
- 微调时只更新 LoRA 参数,冻结原始模型权重
- 可以将微调参数量从 7B 降低到约 数十 MB
实验表明,LoRA 微调的 OpenVLA 在大多数任务上能达到全参数微调的效果,但计算成本大幅降低。
量化推理:INT4/INT8
为了在消费级硬件上部署,OpenVLA 探索了模型量化:
- INT8 量化:几乎不影响性能,内存减少约 50%
- INT4 量化:轻微性能下降,但内存减少约 75%
- 支持在单张消费级 GPU 上实时推理
🧪 实验验证
直接评估:超越闭源模型
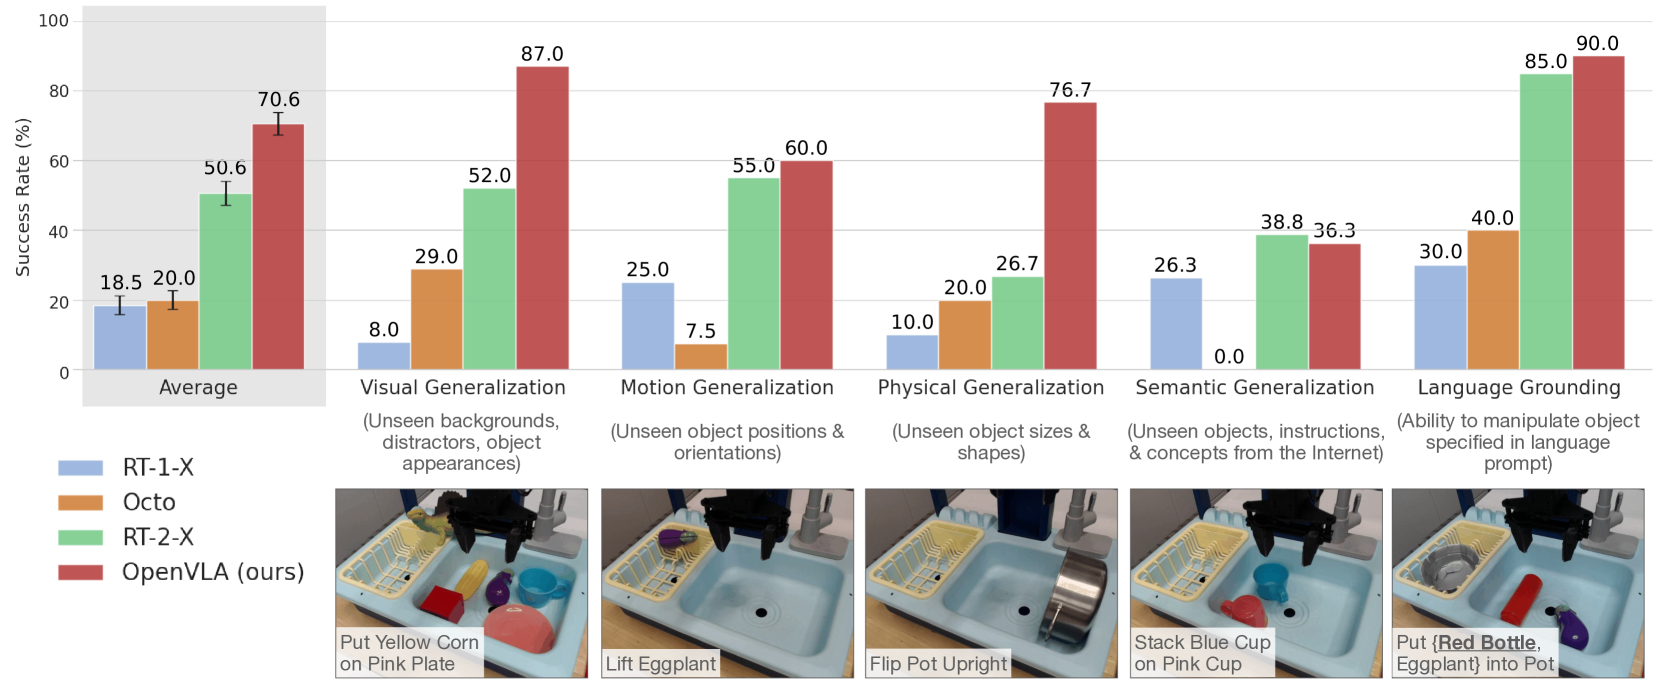
在 WidowX 和 Google Robot 两个平台上评估 29 个任务:
| 模型 | 参数量 | 平均成功率 |
|---|---|---|
| RT-2 (PaLI-X) | 55B | 62.3% |
| OpenVLA | 7B | 78.8% |
| Octo | 93M | 52.1% |
| 从零训练 Diffusion Policy | - | 45.6% |
关键发现:
- OpenVLA 以 7 倍更少的参数 超越 RT-2-X 16.5% 的绝对成功率
- 这得益于更好的数据多样性和双视觉编码器设计
- 开源模型首次在 VLA 领域达到 SOTA
微调实验:高效适配新平台
在 Franka 机器人上评估微调效果,涉及 7 个操控任务:
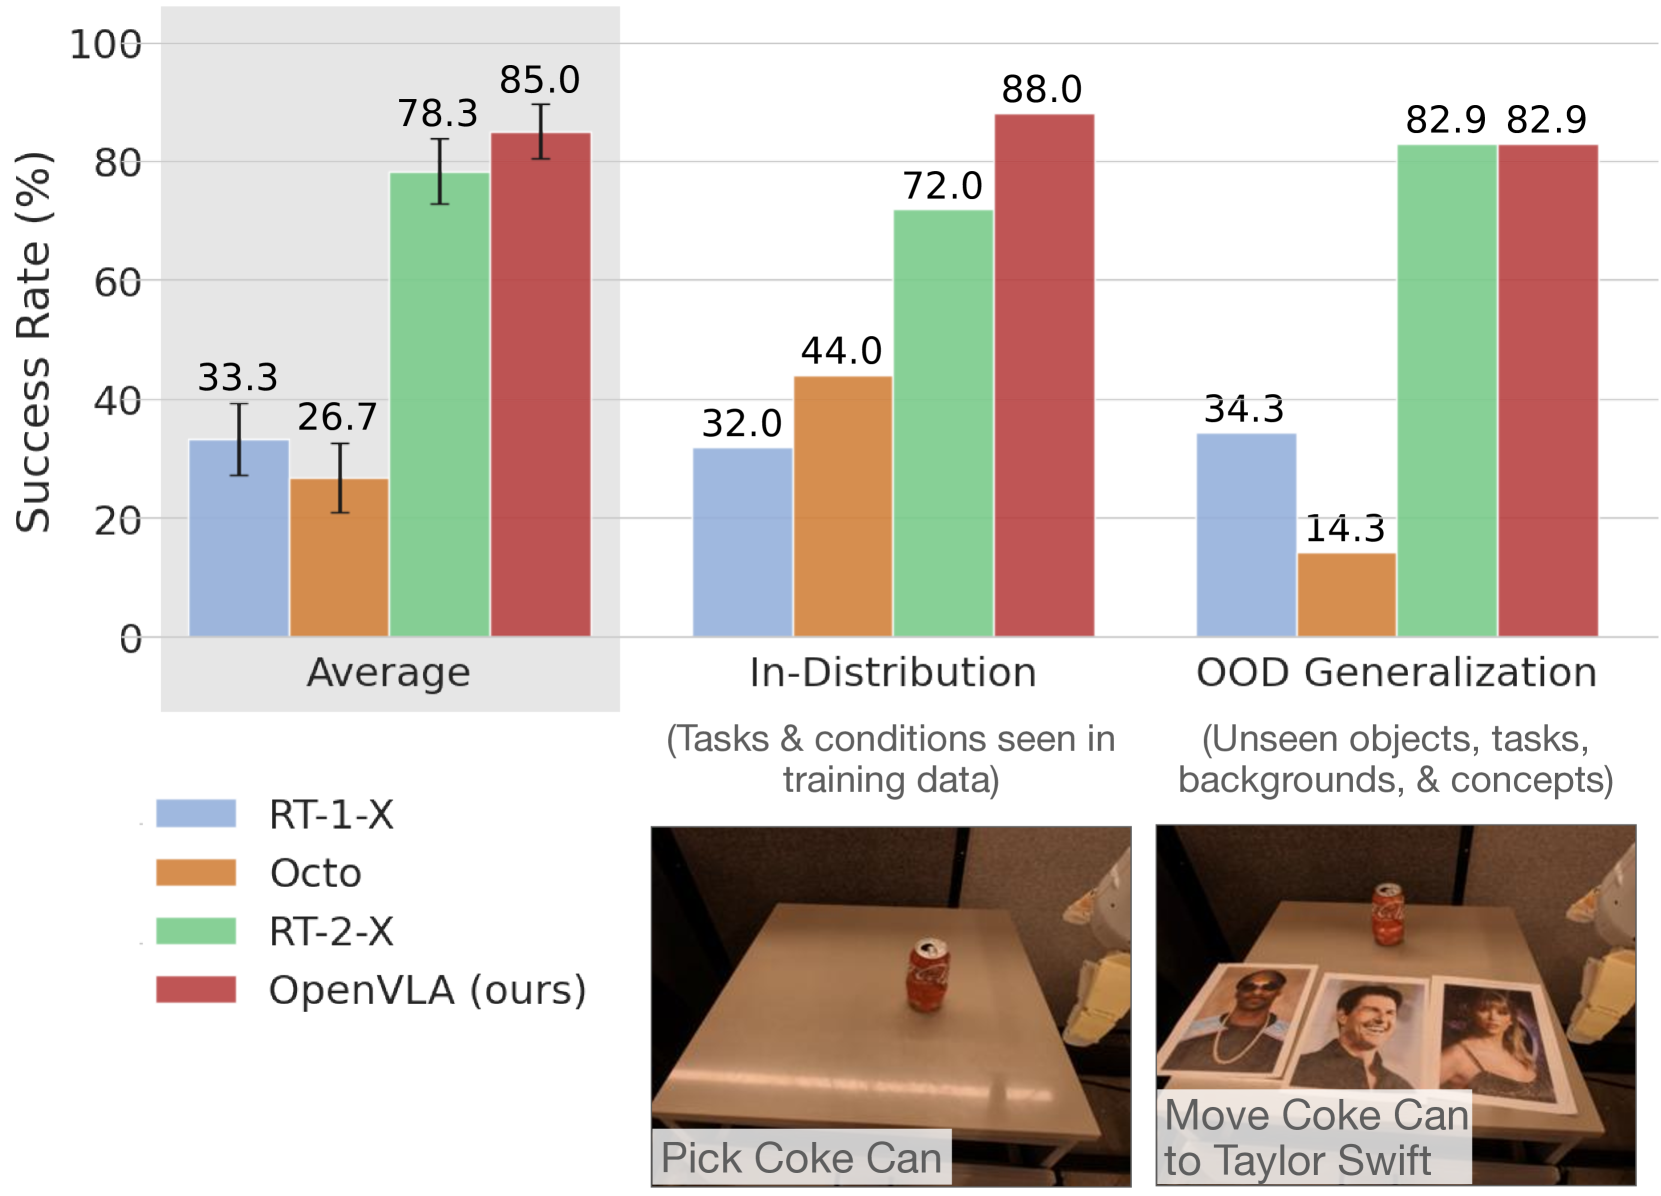
| 方法 | 单任务 | 多任务 | 语言泛化 |
|---|---|---|---|
| 从零训练 Diffusion Policy | 62.3% | 41.2% | 28.5% |
| Octo 微调 | 68.7% | 52.8% | 45.2% |
| OpenVLA 全参数微调 | 85.4% | 71.6% | 68.3% |
| OpenVLA LoRA 微调 | 83.2% | 69.5% | 65.7% |
关键发现:
- OpenVLA 微调显著优于从零训练(+23.1%)和 Octo 微调(+16.7%)
- LoRA 微调仅用 1% 的参数即可达到全参数微调 97% 的效果
- 在多任务和语言泛化场景下优势更明显
LoRA 微调消融
系统研究 LoRA 的秩(rank)对性能的影响:
| LoRA Rank | 可训练参数 | 成功率 | 相对全参数 |
|---|---|---|---|
| 4 | 2.3M | 76.8% | 89.9% |
| 16 | 8.9M | 80.2% | 93.9% |
| 64 | 34.8M | 82.5% | 96.6% |
| 全参数 | 7B | 85.4% | 100% |
发现:rank=64 是性能-效率的最佳平衡点,用不到 0.5% 的参数达到 97% 的性能。
量化推理评估
| 量化方式 | 内存占用 | 推理延迟 | 成功率 |
|---|---|---|---|
| FP16 | 14GB | 85ms | 83.2% |
| INT8 | 7GB | 62ms | 82.8% |
| INT4 | 4GB | 48ms | 81.5% |
INT8 量化几乎不影响性能,但内存和延迟都显著降低。
🔍 个人思考
亮点
开源生态的里程碑:OpenVLA 是第一个在性能上超越闭源 SOTA 的开源 VLA 模型。这不仅是一个技术突破,更是对机器人研究生态的重要贡献——它让全球研究者都能在统一的基线上竞争和合作。
双视觉编码器的巧妙设计:DINOv2(空间)+ SigLIP(语义)的组合非常优雅,解决了单一视觉编码器难以同时捕获空间和语义信息的问题。这种设计思路可以推广到更多多模态任务。
工程实用性极强:LoRA 微调 + INT8 量化使得 OpenVLA 可以在单张消费级 GPU 上运行,这对于资源有限的实验室和初创公司极具吸引力。
系统性消融研究:论文不仅报告了 SOTA 结果,还系统研究了数据混合、视觉编码器选择、微调策略等关键决策,为后续工作提供了宝贵的工程指南。
局限性
离散化动作的精度瓶颈:将连续动作离散化为 256 个 bin 虽然简化了训练,但引入了不可逆的精度损失。对于需要精细力控或高速运动的任务,这可能成为瓶颈。
自回归生成速度慢:动作 token 需要逐个生成,对于高频控制(>20Hz)可能不够快。相比之下,扩散头可以并行生成整个动作序列。
数据规模仍有限:97 万条轨迹虽然已经很大,但与互联网规模的视觉-语言数据(数十亿)相比仍相差甚远。这限制了模型的泛化上限。
缺少触觉和力觉:纯视觉输入难以处理需要力反馈的任务(如插入、拧紧)。多模态感知的融合是未来的必要方向。
未来方向
从离散到连续:将动作头从离散 token 预测改为连续输出(如 Flow Matching 或扩散模型),可以同时提升精度和速度。π0 等后续工作已经验证了这条路线。
规模扩展:将模型从 7B 扩展到 13B、70B,结合更大规模的数据,有望实现真正的零样本泛化。
多模态感知融合:加入触觉、力觉、听觉等模态,使机器人能够更全面地感知物理世界。
在线学习与自我改进:结合强化学习或在线学习机制,使模型能够在部署后从自身经验中学习和改进。