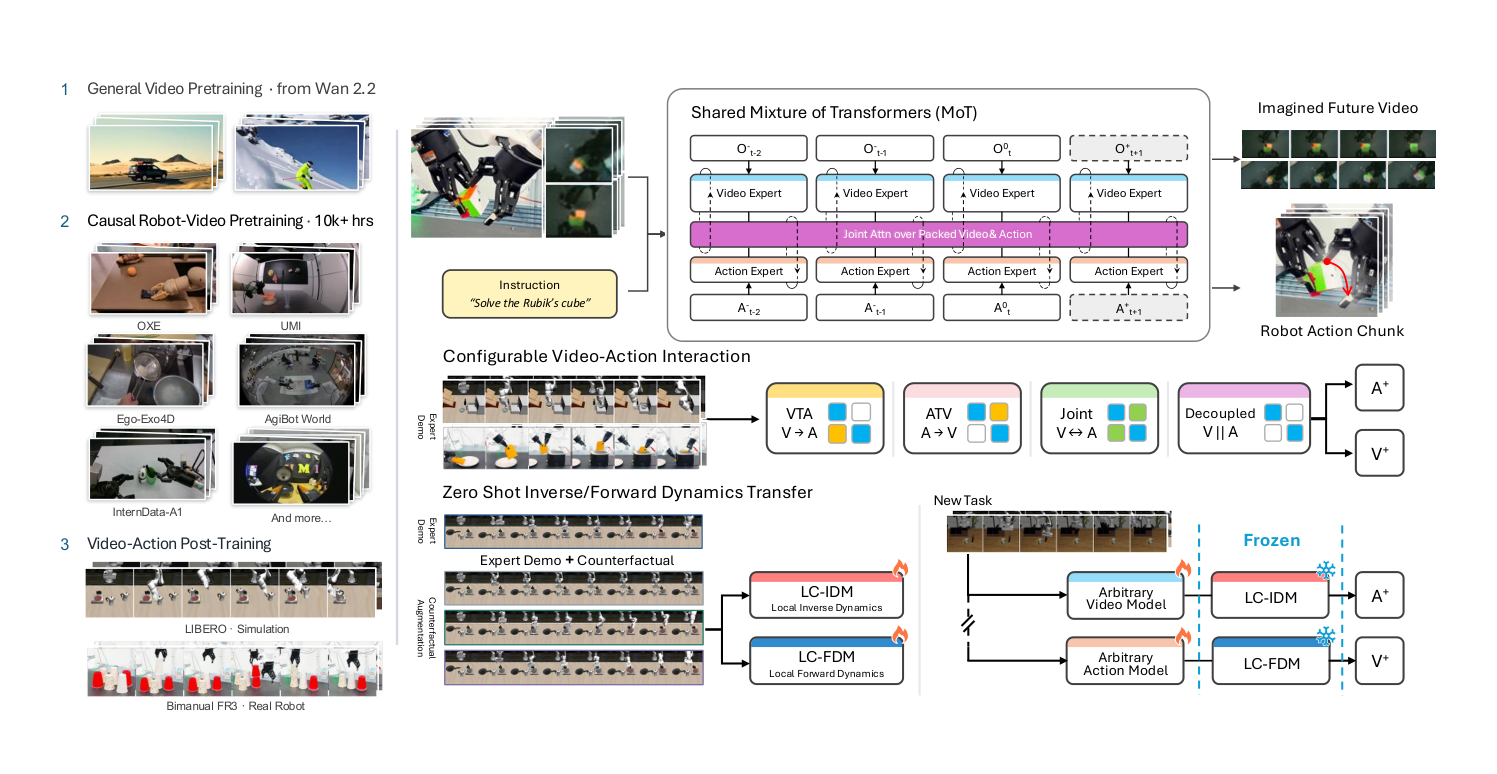
图 1 逐图讲解:这是全文的四块拼图总览,按「左 / 右上 / 右中 / 右下」读。左侧是数据与预训练流水线:起点是通用视频模型 Wan2.2(带彩色播放器图标),中间绿色框写着「Causal Pretraining on Robot & Human-Interaction Video」——不用任何动作标签,只在机器人操作与人-物交互视频上做块因果续预训练;下方蓝色框是「Video–Action Training on Sim. & Real Robot Demos」——再用仿真与真机演示做视频-动作联合训练,两条演示流以摄像机小图标汇入。右上是共享 Mixture-of-Transformers:左支 Video Expert(5B)、右支 Action Expert(2B),中间粗线是「Joint Attention over Packed Video & Action Tokens」,任务文本 L 从左侧交叉注意力注入两支——时间上对齐的视频块与动作块在注意力层互通,但各自保留独立的 LayerNorm/投影/FFN。右中是四种可配置交互模式的示意:Joint(两流并发)、Video-then-Action(VTA,先视频后动作)、Action-then-Video(ATV,先动作后视频)、Decoupled(两流互不可见)——同一架构、同一掩码族,只改「谁先去噪、未来 token 能看谁」。右下是本文第二主角「局部上下文动力学」:左侧 LC-IDM(逆动力学)从「当前观察 + 本体感觉 + 给定未来视觉轨迹」译出动作,右侧 LC-FDM(前向动力学)从「当前观察 + 本体感觉 + 给定动作」画出未来视觉;中间虚线框标着「Counterfactual Transitions」——从同一起始状态分叉执行替代动作得到的反事实数据。底部一句总结全文用法:「A frozen IDM translates predictions from compatible task-adapted video models into actions, while an FDM predicts the visual consequences of candidate actions.」——冻结的 IDM 负责翻译,FDM 负责预演。
配图说明:本文收录论文全部 5 张插图(Figure 1 ~ Figure 5),放在站内 /images/openwam/,逐张讲解,文末附图表总索引表(另有 14 张表全部覆盖)。论文来自斯坦福大学(Heng Yu、David D. Yuan、Juze Zhang 共同一作;Li Fei-Fei、Jiajun Wu、Ehsan Adeli 等),arXiv 2610.07922v1(2026-10-06),项目页与代码早在 2026 年 6 月放出。一句话定位:这不是提出第 5 种 WAM,而是把「世界模型和动作怎么耦合」这件事本身变成一个受控实验平台——底座固定、接口固定、评测协议固定,只动两个变量:生成顺序和未来跨模态可见性。
📄 论文信息
- 标题:OPENWAM: An Open Framework for Composable World-Action Models
- 机构:Stanford University(Heng Yu*、David D. Yuan*、Juze Zhang* 共同一作;Changan Chen、Yao Feng、Michelle Baldonado、Steve Cousins、Li Fei-Fei、Jiajun Wu、Ehsan Adeli)
- 时间:项目页与代码 2026-06-04;论文 2026-10-06(arXiv 2610.07922,cs.RO)
- 关键词:WAM、块因果视频预训练、Mixture-of-Transformers(MoT)、VTA/ATV/Joint/Decoupled、局部上下文 IDM/FDM、反事实转移动作、LIBERO-Long-CF、组件复用
- 一句话总结:把「视频先、动作先、还是同时出」做成四个开关,在同一个因果机器人视频底座上公平对比;再证明「看过反事实施」的局部动力学组件可以在视频预测器换任务后依然被冻着复用。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| 机器人视频预训练 | 约 1.46 万小时 / 334 万条 | 8 个数据源混合;32×B200 训 14 天;不用任何动作标签 |
| 底座初始化消融 | LIBERO-Long:68.4% → 97.8%(+29.4) | 原始 Wan2.2-5B vs 机器人视频因果化;Joint 模式 62.2% → 96.6%(+34.4) |
| 四模式 LIBERO 均值 | VTA 98.6 / Decoupled 98.0 / Joint 97.6 / ATV 96.8 | 三随机种子;四套件 Object/Goal/Spatial/Long |
| 同表基线 | LingBot-VA 98.5、Motus 97.7、Fast-WAM 97.6、π0.5 96.9 | OpenVLA 均值仅 76.5 |
| 双臂真机三任务 | VTA 92.1% / Joint 91.9% | 吐司、魔方、分杯;每任务 50(36)次闭环评测 |
| 冻结 IDM 跨任务迁移 | 局部+混合监督 84.0% | 对比全上下文 47.0%、纯演示局部 21.5%、未适配 VTA 10.5% |
| 反事实数据规模 | 32,000 段 / 29.7× 控制记录 | LIBERO-Long-CF:160 状态 × 16 分支结构,56.9 小时 |
| FDM 结果识别 | K=16:21.1% → 71.3%;RGB MSE −34.5% | 反事实监督 vs 纯演示监督 |
🧭 读前 5 分钟:六个概念
- WAM(World-Action Model):把「预测未来观察」和「生成机器人动作」耦合进同一个系统的模型家族。本文站在 DreamZero、DVA、LingBot-VA 这条「视频底座 + 动作头」路线旁边,但目的不是再刷一个点,而是给这条路线造一台可拆卸的实验台。
- 链式法则的两条拆法:联合分布 p(未来视频, 未来动作 | 上下文) 有两种分解——先出视频再出动作(CVP→IDM,即 VTA 路线),或先出动作再出视频(VLA→FDM,即 ATV 路线)。四种交互模式全是这两种分解及其变体的实现。
- 块因果(chunk-causal):原版 Wan2.2 视频模型不是时序因果的(双向注意力看全序列)。本文把它改成:未来块可以看当前帧、之前的历史和已生成的块,但看不到更晚的块;块内 token 仍联合去噪。时间因果和跨模态交互被刻意拆成两个独立设计维度。
- Mixture-of-Transformers(MoT):视频专家(5B)和动作专家(2B)各管各的归一化、投影和 FFN,只在注意力层对「打包」后的视频+动作 token 做联合注意力;任务文本走单独的交叉注意力。动作专家由对应视频层做宽度适配初始化。
- 局部上下文动力学(local-context dynamics):IDM(逆动力学)只看「当前观察 + 本体感觉 + 未来视觉轨迹」预测动作;FDM(前向动力学)只看「当前观察 + 本体感觉 + 给定动作」预测未来视觉。都不准看语言、过去动作和历史帧——这是让组件可被单独冻结、跨任务搬运的条件边界。
- 反事实转移动作(counterfactual transitions):演示只覆盖「专家选的那一条」动作续行。从同一起始仿真状态分叉、执行替代动作序列(停住、缩放、反向、轴向脉冲、随机化、改夹爪时机……),就得到了「同一状态、不同动作、不同后果」的配对监督——不需要成功,也不需要成功标签。
🗺️ 先分清:哪些是仿真,哪些是真机
| 实验/组件 | 环境 | 说明 |
|---|---|---|
| 四模式 LIBERO 四套件(表 3) | 仿真 | Object / Goal / Spatial / Long-horizon,各 10 任务 × 50 回合 × 3 种子;四模式共享 50 个环境种子 |
| 底座初始化消融 / MoT 消融(表 12/13) | 仿真 | LIBERO-Long 单套件 |
| 组件迁移四目标(表 5、图 4 右) | 仿真 | LIBERO-90 中挑的 4 个目标任务,均不在源任务集内 |
| FDM 结果识别(表 7) | 仿真 | LIBERO-Long 的 10 任务 × 160 上下文 × 16 分支 |
| 反事实数据 LIBERO-Long-CF(表 9-11) | 仿真 | 仿真器特权状态分叉采集;32,000 段、29.7× 控制记录 |
| 与 UVA 对照、单 checkpoint 多目标(表 14) | 仿真 | 同一 LIBERO 协议 |
| 双臂三任务:Toast / Rubik / Sort Cups(表 4、图 4 左、图 5) | 真机 | 双 Franka FR3 + Flexiv Grav 夹爪,GELLO 遥操作采集;每任务 200/200/180 条 30 秒演示;评测 50/50/36 回合 |
一句话:仿真侧覆盖模式对比、底座消融、组件复用与反事实数据全部主结论;真机侧只验证「四模式在真实双臂上也都站得住」(VTA 92.1% / Joint 91.9%)——反事实组件复用本身尚未上真机。
🗺️ 论文要回答的两个问题
开篇引言把动机拆得很干净。第一,交互设计空间无法公平比较:DreamZero 联合生成、DVA/LingBot-VA 视频先行,但各家的底座、数据、目标、推理流程同时在变——你永远说不清「视频先生成到底有没有用」。第二,成功演示的覆盖太窄:每个访问过的状态基本只有一条被专家选中的动作续行,这适合模仿学习,却不足以学「别的动作会造成什么后果」——而后者恰恰是动力学组件能被复用的前提。
OPENWAM 的三项贡献对应三条:①受控的 WAM 框架(共同因果底座 + 可配置交互 + 统一训练评测协议);②局部上下文动力学接口(独立训练的 IDM/FDM,通过显式轨迹接口组合);③受控实证分析(预训练、交互设计、转移动作覆盖、条件上下文各自的影响被逐项拆开测量)。
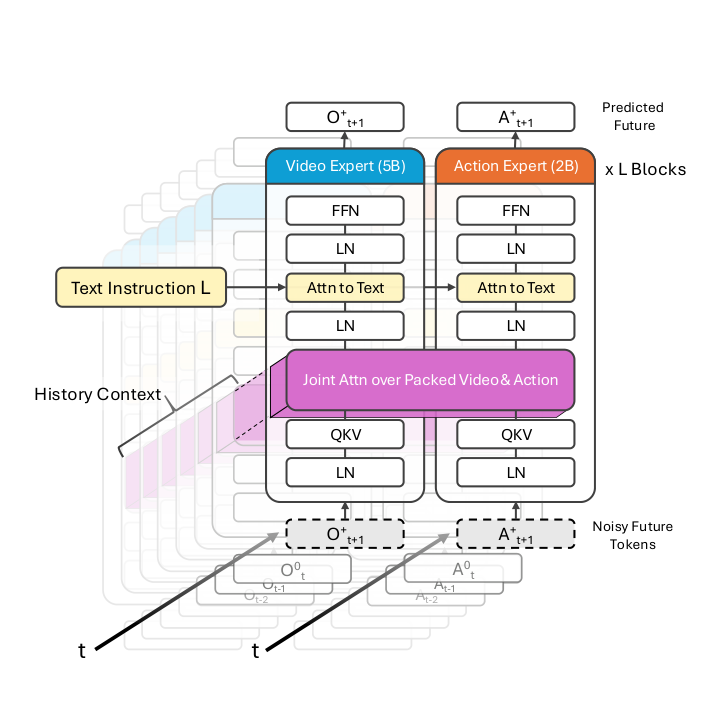
图 2 逐图讲解:这是四种模式共用的唯一架构。左右两支分别是 5B 视频专家和 2B 动作专家,各自持有独立的 LayerNorm、QKV 投影和 FFN(动作专家的 Q/K/V 从 2048 维映到 3072 维以对齐视频流)。底部进入的是带噪未来 token,上方左右两侧挂的是历史上下文(O⁻、O⁰、A⁻);任务文本 L 通过单独的交叉注意力层同时注入两支。中间横贯两支的粗线就是「打包视频与动作 token 的联合注意力」——四种交互模式全部只是在改这个注意力能看到什么、以及两支谁先谁后去噪,骨干本身一动不动。
⚙️ 方法一:因果机器人视频底座
底座从 Wan2.2-5B 出发,在异构机器人操作与人-物交互视频上继续预训练,全程不供给动作标签、本体感觉和任务目标。语料组成(附录表 8):Open X-Embodiment(49 个操作数据集,约 1911 小时)、AgiBot World Beta(约 2976 小时)、InternData-A1(合成机器人视频,约 7434 小时)、RoboCOIN(双臂,约 1307 小时)、RoboMIND、FastUMI-100K、UMI 家族(UMI/DexUMI/UMI-on-Legs/MV-UMI 合并)、Ego-Exo4D v2(人类交互)——合计约 334 万条轨迹/镜头、约 1.464 万标称小时,消耗 32 张 NVIDIA B200 训练 14 天。
因为原版视频模型不是时序因果的,预训练引入块因果预测:未来块可注意当前观察、先前观察和已生成的块,块内 token 联合去噪。作者反复强调这是两个独立维度——块因果决定「哪些时间可见」,交互模式决定「哪些模态流互通」——所以因果化后的检查点既能单独当视频预测器,也能不改接口地接上动作分支。
两阶段训练:先做上述因果机器人视频预训练,再在目标任务上做视频-动作联合训练。四个下游变体共享这个初始化——这是「受控比较」的第一道保险。
⚙️ 方法二:四种交互模式 = 两张变量表
三种生成路线来自链式法则:Joint(视频与动作并发去噪,未来 token 之间双向可见)、VTA(先生成不看未来动作的视频,再以完整视觉轨迹为条件生成动作)、ATV(顺序颠倒)、Decoupled(两支并发但未来不跨模态互通;历史和任务文本仍共享)。训练时 VTA/ATV 的第二阶段用教师强制(条件落在真实轨迹上);推理时换成第一阶段的生成轨迹——程序不变,条件来源从「记录」换成「生成」。
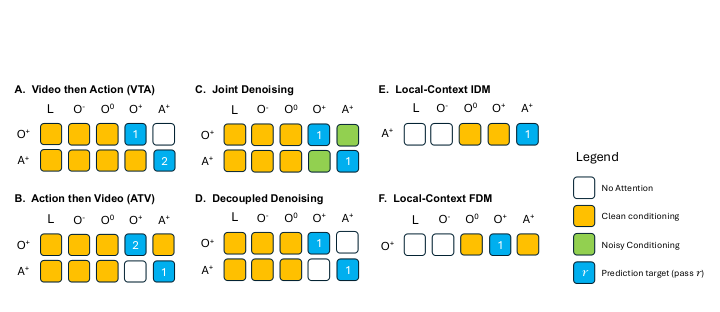
图 3 逐图讲解:行 = 被预测/被去噪的流,列 = 它可以注意的流,颜色 = 干净条件/带噪条件/无注意力,数字 = 生成遍数。A(VTA)两遍:第 1 遍 O⁺ 去噪看不到 A⁺,第 2 遍 A⁺ 干净地看 O⁺;B(ATV)镜像;C(Joint)单遍,O⁺ 与 A⁺ 的带噪 token 互相可见;D(Decoupled)单遍但未来跨模态全盲;E/F 是本文的第二主角——LC-IDM 只有一行(产出动作):干净的 O⁺、O⁰、q 进,A⁺ 出;LC-FDM 镜像:干净的 A⁺ 进,O⁺ 出。E/F 不含 L、O⁻、A⁻——这就是「局部上下文」四个字在掩码层面的全部含义。
共享的流匹配目标:干净目标潜变量 Z* 与噪声 ε 插值得 Z_τ,网络回归速度 u = Z* − ε。实现上 σ = 1−τ,1000 级噪声网格,视频流移位 s_V=5.0、动作流 s_A=1.0,另有中间噪声水平加权、纯噪声端点权重归零;两模态损失等权相加。其余实现细节:30 层双流;视频隐层 3072 / FFN 14336,动作隐层 2048 / FFN 8192,均 24 头×128;双视角(agent+腕)各 128×128 编码成 8×8×48 潜变量、横向拼成 8×16×48 画布;1×2×2 patch → 每潜变量帧 32 个视频 token;视频 VAE 每 4 个环境步压成 1 帧,一个生成块 = 4 个未来潜变量帧 = 16 步动作块(7 维:3 位置 + 3 轴角 + 1 夹爪;本体 8 维以加法注入而非拼接 token)。AdamW、lr 1e-5、有效批 10、梯度裁剪 2.0、bf16、1 万步。
⚙️ 方法三:局部上下文动力学 + 反事实数据
任务条件生成器可以用语言和非局部历史来指定行为;可复用的动力学组件不需要这些。于是定义两个接口:p(A⁺ | O⁺, O⁰, q) 和 p(O⁺ | A⁺, O⁰, q)——条件边界由掩码强制,训练目标不变。推理时两条组合:视频预测器出轨迹 → 冻结 IDM 译成动作;或任意动作生成器(VLA 甚至外部策略)出动作 → FDM 预演视觉后果。作者明确提醒:这是学习出来的组合,两个独立训练的组件并不保证恰好分解同一个联合分布——它们共享的只是轨迹接口,而「替换什么时候成立」正是实验要测的。
监督来源写成 D_dyn = (1−η)·D_demo + η·D_cf。反事实数据 LIBERO-Long-CF(附录表 9-11):从 LIBERO-Long 的 500 条演示分叉,32,000 段、每段 128 步控制 + 129 帧双视角同步观测,共 409.6 万控制记录(29.7×)、56.9 小时;同一起始状态的分支强制划入同一 train/val/test 分区。分叉配方分布:夹爪干预 31.3%、随机时长干预 25%、轴向偏置/脉冲 12.5%、随机化控制 12.5%、停/缩放 9.4%、反向/重定向 6.3%、偏航 3.1%。物理覆盖:90.4% 段含夹爪接触、50.0% 检出抓取、72.3% 改变了物体构型;75% 段直接从演示前缀状态出发,25% 先执行一次扰动再出发(平均偏离演示路径 3.34 cm,61.6% 携带演示外的物体构型)。主实验取 η=0.6(60% 反事实 + 40% 演示)。
🧪 实验一:四模式原生策略表现
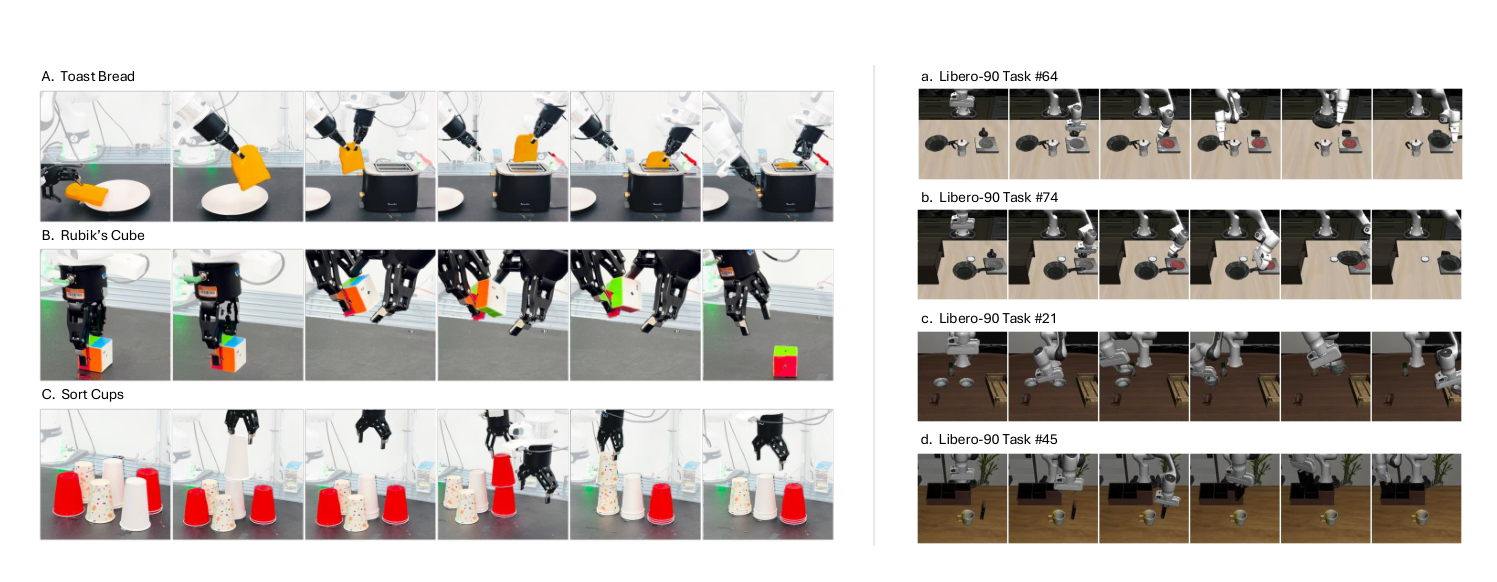
图 4 逐图讲解:左半是真机三任务各一条成功 rollout 的抽帧——A. Toast Bread(把面包放进烤面包机并启动)、B. Rubik’s Cube(复原 2×2 魔方最后一层)、C. Sort Cups(按颜色分杯)。三者分别对应形变+精密插入、接触密集的推与转、可变顺序的多物体排序。右半是组件迁移用的四个 LIBERO-90 目标:#64 叠碗入托盘(新技能组合)、#74 书入收纳盒左格(熟悉操作的重定向)、#21 开灶放平底锅(物体与抓取方式变化)、#45 与 #21 同目标但换场景布局。评测协议:3 个独立种子 × 每套件 10 任务 × 50 回合 = 每种子 500 回合;四个程序共享同一组 50 个环境种子——初值条件严格对齐。
表 3(四套件闭环成功率):VTA 99.4 / 98.4 / 98.6 / 97.8 → 均值 98.6;Decoupled 98.0;Joint 97.6;ATV 96.8。同表里 OpenVLA 均值 76.5、π0 94.1、π0.5 96.9、GR00T-N1 93.9、Motus 97.7、Fast-WAM 97.6、LingBot-VA 98.5——四个程序全部站上 96+,这正是「共同底座支持多种生成顺序」主张的证据。但也要读出细节:四种模式的差距只有 ~1.8 分且方差 0.2-0.6,在这套已经接近饱和的基准上,生成顺序本身的影响很小——底座预训练才是大头。
初始化消融(附录表 12)把大头钉实了:随机初始化 VTA/Joint 只有 20.0/27.2;原始 Wan2.2 是 68.4/62.2;机器人视频因果化后 97.8/96.6——对 Wan2.2 的增益 +29.4(VTA)和 +34.4(Joint)。注意作者的措辞:这是「机器人视频预训练 + 因果适配」的合效应,没有再拆单因。MoT 消融(表 13):非 MoT 共享 DiT 已能拿 92.8/93.6,MoT 再加 +5.0/+3.0——专用动作专家有用,但没有预训练那种量级。
真机侧(表 4):VTA 三任务 92.0 / 90.0 / 94.4 → 均值 92.1%;Joint 90.0 / 94.0 / 91.7 → 91.9%。采集规格(附录 A.5、图 5):双 Franka FR3 + Flexiv Grav 夹爪,双臂 GELLO 遥操作示范;两腕装 RealSense D405(1280×720)+ 中央 Orbbec Femto Mega(1920×1080),30 fps;每步动作 20 维(每臂 3 位置 + 6 姿态 + 1 夹爪宽度)。示范量:Toast/Cube 各 200 条、Sort Cups 180 条,每条 30 秒;评测 50 / 50 / 36 回合。
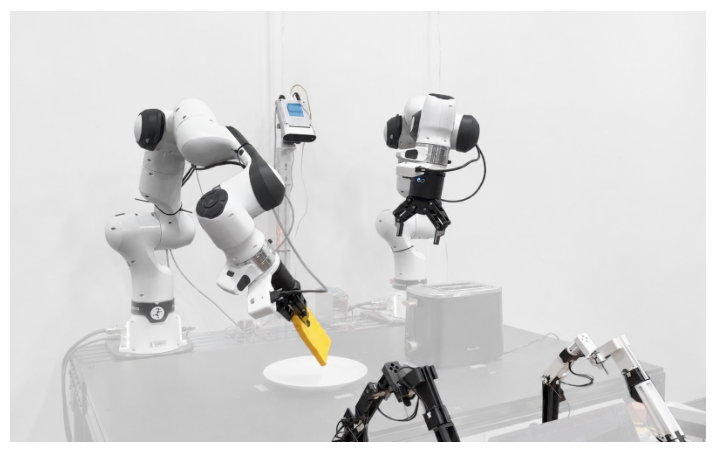
图 5 逐图讲解:这是附录里的实物照——两台 Franka Research 3 配 Flexiv Grav 夹爪,中间是用于采集示范的双臂 GELLO 遥操作手柄;相机三路:两台腕装 RealSense D405 + 一台中央 Orbbec Femto Mega。与仿真侧统一的约定是「4 个动作步 = 1 个潜变量视频帧」;真机上目标位姿按块相对表达(相对块起始观察位姿),夹爪宽度保持绝对值。
🧪 实验二:组件复用——冻结的动作组件还值钱吗
核心协议:视频侧换成针对新任务微调过的 VTA 预测器,动作侧的 IDM 保持冻结(只在 LIBERO-Long 源任务上训过)。四个 LIBERO-90 目标都不在源任务集内。表 5 的几行读下来:
| 视频/策略 | 冻结动作组件 | 64 | 74 | 21 | 45 | 均值 |
|---|---|---|---|---|---|---|
| 任务微调 VTA(参考上界) | — | 94% | 86% | 92% | 100% | 93.0% |
| 任务微调视频 | 全上下文 IDM,纯演示 | 88% | 90% | 0% | 0% | 44.5% |
| 任务微调视频 | 全上下文 IDM,混合 | 54% | 92% | 4% | 38% | 47.0% |
| 任务微调视频 | 局部 IDM,纯演示 | 36% | 50% | 0% | 0% | 21.5% |
| 任务微调视频 | 局部 IDM,CF-only | 80% | 92% | 90% | 76% | 84.5% |
| 任务微调视频 | 局部 IDM,混合 | 74% | 86% | 88% | 88% | 84.0% |
| 原始 VTA(未适配参考) | — | 42% | 0% | 0% | 0% | 10.5% |
两个变量强交互:混合监督把局部 IDM 从 21.5% 拉到 84.0%,同样的监督喂给全上下文 IDM 却只从 44.5% 走到 47.0%;在匹配的混合监督下,局部条件比全上下文高出 37.0 个百分点,同时源任务成功率还保留 94.4%。CF-only(84.5%)与混合(84.0%)几乎打平。逐任务看更锋利:纯演示的全上下文 IDM 在 #64/#74 上体面(88/90%),在 #21/#45 上直接 0%——而局部+反事实的两行在四个目标上都稳。表 6 的源任务侧对照:全上下文纯演示(即原生 VTA)97.8%、局部纯演示只有 25.8%——「砍掉语言和历史」本身是有代价的,反事实施是用来支付这个代价的。
直觉解释:换到新任务后,视频预测器生成的未来在外观、物体、布局上都是「源 IDM 没见过的语境」;全上下文 IDM 过度依赖语言指令和历史动作的表面统计,指令一换就失灵;局部 IDM 只需要「从当前画面和本体感觉出发,判断这段视觉轨迹对应什么动作」——这个局部映射本来就更任务无关,再配上有正有反的反事实覆盖,就扛住了视觉侧的迁移。
🧪 实验三:前向动力学——你画的未来,是这个动作造成的吗
FDM 评测:10 个 LIBERO 任务、160 个上下文,每上下文 16 条动作分支 = 2,560 条反事实未来;除 RGB 预测误差外,新增结果识别率——同一状态的 K 个已实现未来里,预测在 RGB MSE 上最接近哪一个算认对(K=2 两两、K=16 全体)。
| 监督 | RGB MSE(×10⁻³)↓ | K=2 识别 ↑ | K=16 识别 ↑ |
|---|---|---|---|
| 纯演示 | 14.35 | 68.3% | 21.1% |
| CF-only | 9.40(−34.5%) | 93.6% | 71.3% |
| 混合 | 9.62(−33.0%) | 91.8% | 67.7% |
纯演示训练的 FDM 会滑向「平均未来」——把不同动作分支的后果抹平(K=16 仅 21.1%,比瞎猜 6.25% 好不了太多)。反事实监督同时改善预测精度和动作可辨识性:预测开始「认得」是哪条动作画出来的未来。
附录 E(表 14)把范围扩到与最接近的开源系统 UVA 的对照。单目标专精:LC-IDM 混合监督在真实演示上 IDM 位置误差 0.44 cm / 旋转 1.21°,反事实施上 CF-only 位置 1.17 cm;LC-FDM 混合监督真实演示 MSE 0.00186、SSIM 0.9776——两项都明显好于 UVA(位置 2.03 cm、旋转 1.60°/反事实 12.99°,MSE 0.00279)。统一模型:单个 OPENWAM checkpoint 按 60% 策略 + 20% IDM + 20% FDM 混训(IDM/FDM 各半演示/反事实),策略成功率 92.8% vs UVA 88.0%,真实演示侧 FDM/IDM 误差也全面占优;但在反事实分布上 0.01416 的 MSE 逊于专精模型的 0.00940——多目标与专精之间的取舍如期出现,且只有 60% 更新在优化策略,92.8% 低于策略专精模型也符合预期。
💡 评析:三个亮点,四条边界
三个亮点
- 把设计空间变成了可重复的受控实验。「Joint 还是 VTA 好」在各家系统里从来都是混杂问题;这里四模式共享底座、词化、目标族、数据、优化与评测协议(连环境种子都对齐),差异只剩生成顺序与未来跨模态可见性。得到的结论本身很有信息量:在这代底座上四模式差距很小(96.8-98.6),真正的性能开关是机器人视频因果预训练(+29.4/+34.4)——这类「哪个变量其实不重要」的结论,只有受控平台才发得出来。
- 「条件边界」和「监督来源」被拆成两个正交变量。表 5/6 最漂亮的一行对比:同样的混合反事实监督,全上下文 47.0%、局部 84.0%——不是「反事实数据好」一句话能概括的,是局部接口 + 反事实覆盖的组合让冻结组件可迁移;而局部纯演示只有 25.8%(源任务)说明接口本身有代价。这种 2×2 式的拆解在同类论文里少见。
- 结果识别率这个指标值得推广。「RGB MSE 降 34.5%」是精度叙事,「16 选 1 从 21.1% 到 71.3%」才是因果性叙事——它直接测「预测的未来是否携带了条件动作的身份信息」,是「世界模型到底在模拟动作后果还是在编一段像样的视频」的最低门槛测试。
四条边界
- 组件复用只在仿真里成立。3.2 万段反事实数据来自仿真器特权状态分叉;作者自己在讨论中承认,真机上的等价复用需要更数据高效的动力学监督采集。反事实数据的「29.7×」目前是仿真红利。
- 不是完整视频-动作模型的零样本迁移。迁移实验里视频预测器是为新任务微调过的——测的是「动作组件能否在视觉适配后被复用」,而不是整个 VTA 链的零样本换域。表 5 里「原始 VTA 未适配」那一行(10.5%)反而提示完整链直接搬运基本不可行。
- 单一多目标 checkpoint 还打不过专精变体。表 14 的统一模型在反事实动力学上明显落后专精模型;讨论一节点到「尚未证明单个多目标模型能在所有模式上匹配最强专精变体」。组件化目前还是靠拆开来训。
- 近饱和基准上的模式对比缺乏区分度。四模式在 LIBERO 上挤在 1.8 分区间内,3 个种子的标准差 0.2-0.6——差异真实但很小;生成顺序的价值可能要在更难的长程/接触密集任务上才能显形,而这恰是当前评测的盲区(FDM 也只做局部短程预测)。
🗺️ 在 WAM 谱系里的位置
| 路线 | 代表 | 解决了什么 | 与本文关系 |
|---|---|---|---|
| 联合去噪生成 | DreamZero、Cosmos 3、Prediction-with-Action | 视频与动作一次成型 | 本文的 Joint 模式即此路线的受控实现 |
| 视频先行(因果) | DVA、LingBot-VA、UniPi | 先想象再落地,IDM 可独立换数据 | 本文 VTA + 局部 IDM 是其系统化与接口化 |
| 专用视频/动作双通路 | 各类 cross-modal WAM | 模态分工 + 显式交换 | 本文用 MoT 把这条路也纳入同一平台 |
| 统一多目标 | UWM、UVA | 策略/IDM/FDM/视频在一个系统里 | 表 14 正面对比;本文专精 + 显式接口路线占优 |
| 交互设计轴单独研究 | Fast-WAM 等(稀疏化/重排/异步) | 压缩预测计算量 | 同属「拆开设计空间」阵营,轴不同 |
| 失败/反事实学习 | Fail2Progress、Rocoda、AHA | 从失败与扰动中扩监督 | 本文的 LIBERO-Long-CF 是其在动力学复用问题上的实例 |
站内延伸:《UniWAM 精读》(同属「统一视频-动作」路线但走单模型多任务)、《LoopWAM 精读》(闭环强化视角)、《PrismWAM 精读》、《WorldOracle 精读》、《X2Real 精读》(另一套「组件在新环境还成不成立」的检验思路)、《Flash-WAM 精读》(表 3 同榜基线)、《LIBERO 精读》(本文主战场)、《π0.5 开放世界泛化精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》。
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 总览:三阶段管线 + 共享 MoT + 四模式 + 局部动力学迁移 | 开篇 |
| Fig 2 | 共享 MoT 架构(双流专家 + 打包联合注意力) | 方法二 |
| Fig 3 | 六程序注意力掩码(A-D 交互模式,E-F 局部动力学) | 方法二 |
| Fig 4 | 评测任务:三真机任务 + 四 LIBERO-90 迁移目标 | 实验一 |
| Fig 5 | 真机双臂平台实物照 | 实验一 |
表格:Table 1 四个 LIBERO-90 迁移目标定义;Table 2 真机三任务目标与主挑战;Table 3 四套件 × 四模式 + 8 基线;Table 4 真机三任务成功率;Table 5 冻结 IDM 迁移主表;Table 6 源任务组合成功率;Table 7 FDM 反事实预测;Table 8 预训练语料 8 源;Table 9 LIBERO-Long-CF 规模;Table 10 干预配方分布;Table 11 物理交互统计;Table 12 底座初始化消融;Table 13 MoT vs 非 MoT;Table 14 与 UVA 的专精/统一对照(附录 E)。
❓ 自测 Q&A
Q1:为什么说本文是「受控实验」而不是又一个刷点模型? A:因为变量被锁死了。四个模式共享:同一个机器人视频因果预训练检查点、同一套 token 化(4 潜变量帧 = 16 动作步)、同一个流匹配目标族、同一份下游数据与优化超参、同一评测协议(3 种子 × 共享 50 环境种子 × 500 回合)。唯一操纵的是生成顺序和未来跨模态注意力——表 3 的模式间差距(1.8 分)和表 12 的底座差距(29.4+ 分)因此可以直接归因。
Q2:块因果预训练和普通视频微调差在哪? A:原版 Wan2.2 的注意力是双向的——训练时能看见「未来」,推理时只能滑窗生成,存在训练-推理错位。块因果把可见性改成:未来块只能看当前、历史和已生成块。这既给了顺序预测需要的时间方向,又保留了块内联合去噪(这是扩散/流匹配视频模型的效率来源)。消融表明「预训练+因果适配」合起来贡献 +29.4(VTA)/+34.4(Joint);论文未再拆分两个因子各自的份额。
Q3:局部上下文 IDM 为什么能赢全上下文,尽管信息更少? A:因为它的条件更「任务不变」。全上下文 IDM 依赖语言指令和历史动作——换到新任务,这些表面统计全变了,模型按旧指令模式去解释新画面就崩(表 5 中 #21/#45 直接 0%)。局部 IDM 只回答一个更物理的问题:「从这个画面和这个本体状态出发,要走出这段视觉轨迹,该发什么动作」。这个映射跨任务稳定,代价是源任务掉分(表 6:25.8% vs 97.8%),而反事实施把代价补回来(混合监督 94.4%)。
Q4:反事实施到底解决了什么「演示学不到」的东西? A:演示对每个状态只给出一条被专家选中的动作续行——从中无法辨识「其他动作会造成什么」,前向模型会学成「不管给什么动作都预测相似未来」的滑头货(表 7 K=16 仅 21.1%)。从同一起始状态分叉执行替代动作,模型被迫把未来与条件动作对齐:RGB MSE 降 34.5%、16 选 1 识别升到 71.3%。注意配方里 90.4% 的段有实际接触、72.3% 改变了物体构型——不是纯噪声扰动,而是「有意义的失败与探索」。
Q5:组件复用协议里,到底冻结了什么、动了什么? A:动作侧 IDM 全程冻结(只见过 LIBERO-Long 的源任务数据);视频侧是为每个 LIBERO-90 目标任务专门微调过的 VTA 预测器;推理时视频预测器生成未来潜变量,经 VAE 潜变量接口(不传隐藏状态、不传 KV cache)交给冻结 IDM 译码成动作。所以这测的不是零样本,而是「视觉适配新任务后,旧动作组件还能不能用」——结论是:局部+反事实监督的组件能(84%),其余配置不能(≤47%)。
Q6:这份工作和 UniPi 的「视频规划 + 独立 IDM」是什么关系? A:UniPi 提出了「把视频规划与逆动力学解耦、IDM 可以用另一份(甚至次优的)数据集训练」的思路;OPENWAM 把这个思路平台化、接口化并给出了受控测量:掩码层面精确定义局部条件边界(图 3E/F)、造了 29.7× 的系统性反事实监督、用冻结迁移实验量化了「什么时候该用局部 IDM、需要什么数据」。另外注意同名彩蛋:北大同期工作也叫 OpenWAM(arXiv 2609.07398),本文在相关工作里明确区分——那篇做模块化预训练框架,本文固定底座对比交互设计并研究组件复用,互补不冲突。
📚 资源与延伸
- 论文:arXiv 2610.07922
- 代码:github.com/OpenWAM/OpenWAM
- 项目页:openwam.stanford.edu
- 底座:Wan2.2-5B(视频基础模型)、Mixture-of-Transformers、LIBERO / LIBERO-90(评测与反事实数据来源)、Franka FR3 + Flexiv Grav + GELLO(真机)
- 同期同名:PKU OpenWAM(arXiv 2609.07398,模块化预训练设计研究)
- 站内延伸:《UniWAM 精读》、《LoopWAM 精读》、《PrismWAM 精读》、《WorldOracle 精读》、《X2Real 精读》、《HexaShell 精读》、《Flash-WAM 精读》、《π0.5 开放世界泛化精读》、《Cosmos3-世界基础模型精读》、《LIBERO 精读》、《DROID 机器人操作数据集精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》