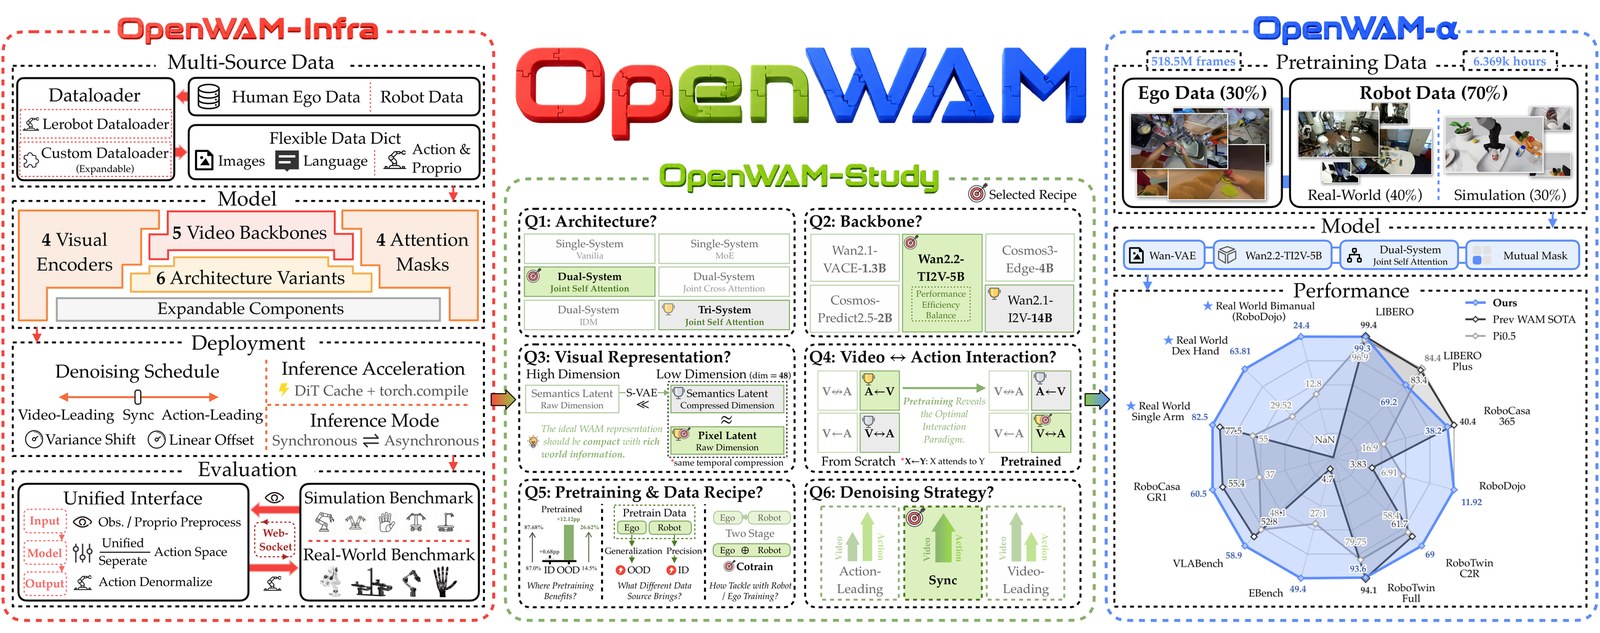
配图说明:本文收录 14 张插图:官网原图 2 张(/figs/overview.png、/figs/architecture.png,即论文 Figure 1 与 Figure 12 的高分辨率版)+ 论文 PDF 裁剪 12 张,均在站内 /images/openwam-alpha/,逐张讲解,文末附图表总索引。论文 OpenWAM: An Open, Modular Exploration Towards Systematic World-Action Model Pretraining(arXiv 2609.07398),官网 openwam-official.github.io(含完整成绩页)、代码 github.com/OpenWAM-Official/OpenWAM、模型与数据 huggingface.co/OpenWAM(46 个开放 checkpoint)、已接入 XPolicyLab。
⚠️ 先分清两篇 OpenWAM:站内已有 OPENWAM 精读 是斯坦福的 An Open Framework for Composable World-Action Models(arXiv 2610.07922,Li Fei-Fei 组),主题是「生成顺序与跨模态可见性的受控比较」;本篇是南大/清华/北大等的 An Open, Modular Exploration Towards Systematic World-Action Model Pretraining(2609.07398),主题是整条预训练流水线的模块化与六问受控实验。名字撞车,团队与论文均不同。
📄 论文信息
- 标题:OpenWAM: An Open, Modular Exploration Towards Systematic World-Action Model Pretraining
- 机构:新加坡国立大学(NUS)、清华大学、北京大学、香港大学、浙江大学、港中深、上交
- 作者:Yuran Wang、Siqiao Huang(共同一作/项目负责人)等;通讯 Lin Shao(NUS)、Hang Zhao(清华);Shanghang Zhang、Hao Dong(北大)等
- 时间:arXiv 2609.07398(2026-09);官网/代码/模型全开
- 关键词:WAM、受控实验(controlled study)、模块化 Infra、注意力掩码、联合去噪、统一动作空间、人本+机器人共训、OpenWAM-α
- 一句话总结:别人交一个模型,它交一套「实验程序」——把 WAM 拆成可换零件(Infra),用六个受控问题筛出设计原则(Study),再把原则拼成开放模型 OpenWAM-α 在八基准九榜+三类真机上验收。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| 可组合模块 | 4 视觉编码器 × 5 视频骨干 × 6 架构 × 4 掩码 | 单一训练器/策略服务器/评测协议 |
| 受控问题 | 六问(Q1–Q6)→ 三条结论 | 前一问的答案锁定后一问的条件 |
| 预训练数据 | 518.5M 帧 ≈ 6,369h(约 6,400h) | 70% 机器人 / 30% 人本第一视角,单阶段共训 |
| 统一动作空间 | 80 维:2×34 臂块(EE 位姿3+6D 旋转6+夹爪1+灵巧手24)+12 预留(移动底盘等) | 索引表 Scatter/Gather,未映射槽位零梯度 |
| 八基准九榜(OpenWAM-α) | LIBERO 99.3 · RT2.0-Full 93.60 · RT2.0-C2R 69.0 · LIBERO-Plus 69.2 · EBench 49.4 · RoboCasa-GR1 60.5 · VLABench 58.9 · RoboCasa365 38.2 · RoboDojo 11.92 | 成绩页与论文 Figure 11 对齐 |
| 真机 | 单臂 82.5% · 双臂(RoboDojo 18 任务)37.6 分/24.4% · 灵巧手 90.0% | 双臂对照 π0.5 的 22.9/12.8 |
| 开放程度 | 46 个 checkpoint + 评测协议 + 数据配方 | 全栈开源 |
🗺️ 仿真 vs 真机:一眼分清
| 场景 | 类型 | 说明 |
|---|---|---|
| 八基准九榜(LIBERO/LIBERO-Plus/VLABench/RoboTwin2.0 双轨/RoboDojo/RoboCasa365/EBench/RoboCasa-GR1) | 仿真 | 主结果;每基准经策略服务器适配器接入 |
| 六问受控实验 | 仿真(RoboTwin2.0) | Study 阶段统一用 RoboTwin2.0-Full 与 Clean2Random 两协议 |
| 单臂 Franka Research 3 六任务 | 真机 | 挂杯、抽屉、层层积木等(Fig. 12/13) |
| 双臂 RoboDojo 三平台 18 任务 | 真机 | ARX X5 / Piper / Piper X 各 4 任务展示,37.6/24.4 |
| 灵巧手(Wuji/Tianji 双臂+灵巧手) | 真机 | 收羽毛球、拧瓶盖、收衣服、叠塔 + 布局/背景/物体/光照 OOD(Fig. 14) |
🧭 范式详解:OpenWAM 到底在「范」什么?
用户最关心的部分——OpenWAM 的范式 = 「受控实验程序」四个字,拆成三层就能看懂:
第 0 层问题:现有 WAM 是「单体(monolithic)」的——视频底座、视觉表示、架构、信息流、推理流程、训练数据耦死在一起,论文作者们吵「A 设计还是 B 设计好」根本吵不出结果,因为变量不唯一。
第 1 层 OpenWAM-Infra(实验台):把设计空间切成可独立替换的零件并统一接口——
- 模型侧可换:视觉编码器 4 种(像素重建系 Wan2.2-VAE/FLUX.2-VAE + 语义表示系 DINOv3/V-JEPA2.1)、视频骨干 5 种(Wan2.1-VACE-1.3B → Cosmos-Predict2.5-2B → Cosmos3-Edge-4B → Wan2.2-TI2V-5B → Wan2.1-I2V-14B)、架构 6 变体(单系统 vanilla/MoE、双系统 IDM/联合自注意力/联合交叉注意力、三系统)、注意力掩码 4 种(Isolated / Video 感知 Action / Action 感知 Video / Mutual 互见);
- 运行侧统一:一个训练器(DeepSpeed/ZeRO、梯度检查点、CPU offload、预训练/微调/续训工作流)+ 一个 WebSocket 策略服务器(观测进、动作出,归一化全在服务端)+ 一套仿真与真机共用的评测协议(适配器复刻各基准训练读者的预处理);
- 动作侧统一:默认各基准原生动作空间直通;跨本体单模型训练则用 80 维统一动作空间(固定槽位语义,未映射槽位不收梯度)。
第 2 层 OpenWAM-Study(六问三结论):在实验台上按顺序问六个问题,上一问的答案成为下一问的默认配置:
- Q1 架构(单系统/双系统/三系统怎么分?)→ Q2 骨干(多大视频模型才够本?)→ Q3 视觉表示(重建编码器还是语义编码器?)→ Q4 视频↔动作交互(谁可见谁?四种掩码)→ Q5 预训练与数据配方(从零 vs 预训练、人本 vs 机器人)→ Q6 去噪策略(谁先谁后、同步还是偏移)。
- 收敛出三条结论(Finding1–3):①继承——足够强的生成骨干 + 紧凑信息密的潜空间最能继承上游世界知识(表示型编码器不必弱于重建型);②协同——世界-动作协同需要专用动作容量 + 显式世界→动作信息流 + 推理期同步联合去噪;③扩展——具身预训练主要涨 OOD 泛化,机器人轨迹保动作接地、人本视频拓迁移面,单阶段共训两者兼得,规模化后互见掩码持续占优。
第 3 层 OpenWAM-α(配方落地):把三条结论拼成具体模型——双系统(视频 DiT + 专用 ActionDiT)互见联合自注意力,518.5M 帧单阶段共训,然后在八基准九榜 + 三类真机上验收,并把 Infra、协议、权重、数据配方全部放出——别人可以在同一实验台上问第七个问题。
一句话记忆:Infra 是实验台,Study 是实验记录,α 是实验产出的旗舰机。
🛠️ 方法分层细讲
3.1 OpenWAM-Infra:实验台(Fig. 2/3/4)
- 模型三类模块(Fig. 2):视觉编码器(像素系压缩到 S-VAE 潜空间 / 语义系低维紧凑潜变量)、骨干(VLM 骨干 / 可扩展骨干 / 动作骨干 + 5 种视频骨干可选)、可见性注意力掩码(四格:互见、动作看视频、视频看动作、隔离);底部列出 6 种架构变体(单系统 vanilla、单系统 MoE、双系统 IDM、双系统联合自注意力、双系统联合交叉注意力、三系统联合自注意力),训练工具(DeepSpeed/ZeRO-1/2、梯度检查点、CPU offload、预训练/微调/续训工作流)内嵌中央面板。
- 推理与去噪(Fig. 3):(a) 同步 vs 异步推理模式;(b) 去噪时刻表三族——同步(Sync)、视频先行(Video-Leading)、动作先行(Action-Leading)(另有方差偏移/线性偏移变体),部署还有 DiT cache + torch.compile 加速。
- 评测协议(Fig. 4):benchmark 作为瘦客户端经 WebSocket 连策略服务器——视角裁剪/缩放/合成按 checkpoint 的标准布局、缺相机补黑帧、本体感觉归一化进模型动作表示,输出动作块再反归一化回真实物理单位(归一化值永不上机器人);episode 间一次 reset 清空执行器状态。真机与仿真走完全同一接口——新增一个基准=写一个适配器,模型与双运行时不动。
3.2 OpenWAM-Study:六问与三条结论(Fig. 5–9)
- Q2 骨干(Fig. 5):Wan2.1-VACE-1.3B 90.14 → Cosmos-Predict2.5-2B 91.64 → Wan2.2-TI2V-5B 92.39 → Wan2.1-I2V-14B 93.79——参数越大平均成功率越高(气泡图三轴之一);α 默认取 5B 档(能力/成本折中)。
- Q3 表示(Fig. 6):重建型(VAE 系)vs 表示型(DINOv3/V-JEPA 系)先验对比——表示型带维度压缩也能打平甚至更好,推翻「必须重建」的默认假设。
- Q4 交互(Fig. 7):四掩码矩阵一目了然——互见(Mutual):动作行可看视频、视频行可看动作,只屏蔽「被噪化的未来帧行互看」;消融显示动作能否访问世界特征是成败分水岭(Isolated 最差)。
- Q5 数据/OOD(Fig. 8):具身预训练主要提升分布外(OOD)成功率——ID 内涨幅有限、OOD 涨幅显著;机器人数据保动作接地,人本视频拓迁移。
- Q5 信息流反转(Fig. 9):预训练改变最优信息流方向的中心标记图——预训练前后的偏好翻转,说明「该不该互见」不是先验而是随规模/数据状态变的。
- Q6 去噪策略(正文,图外):同步联合去噪在多数配置下最优——对应结论②。
3.3 OpenWAM-α:配方旗舰(Fig. 10)
- 双系统:视频流 Wan2.2-TI2V-5B(宽 3072,帧/高/宽 3D RoPE)负责在未来视频窗内去噪;动作流 ActionDiT(宽 1024,1D RoPE,每动作步一 token);
- 耦合:30 个成对层全部作桥层,双方残差投影进共享 24 头 × 128 维注意力空间,互见掩码(干净首帧行既不看被噪未来帧也不看动作);
- 冻结件:Wan2.2-VAE(因果编码:首帧独立 + 每 4 帧一组,首潜帧是干净「现在」锚点)、umT5 文本编码器(4096 维上下文,双流各自交叉注意);
- 数据与动作:518.5M 帧(6,369h,70% 机器人 [真机40%/仿真30%] + 30% 人本第一视角),80 维统一动作空间(两块镜像 34 维臂块 + 24 维灵巧手 + 12 预留槽);
- 三阶段结论落地表(官网「accumulated recipe」):Inherit → Wan2.2-TI2V-5B + compact latent;Interact → 双系统联合自注意力 + 同步去噪;Consolidate → 单阶段人本+机器人共训 + 互见掩码。
📸 逐图讲解(14 张:官网 2 + 论文 12)
Figure 1:三层栈总览(官网原图,头图)
(即文首头图。)左 OpenWAM-Infra:可扩展组件区列出 6 架构 / 5 骨干 / 4 编码器 / 4 掩码,向下贯通部署件(DiT cache + torch.compile、同步/异步推理、视频先行/动作先行/同步等去噪时刻表、灵活数据字典与统一动作空间);中 OpenWAM-Study:六问(Q1 Architecture → Q6 Denoising)按序排布;右 OpenWAM-α:多源数据(机器人 70% / 人本 30%)→ 双系统模型 → 仿真+真机评测。读图顺序即范式顺序:先搭台,再实验,后出货。
Figure 2:OpenWAM-Infra 模型模块图(论文 Fig. 2)
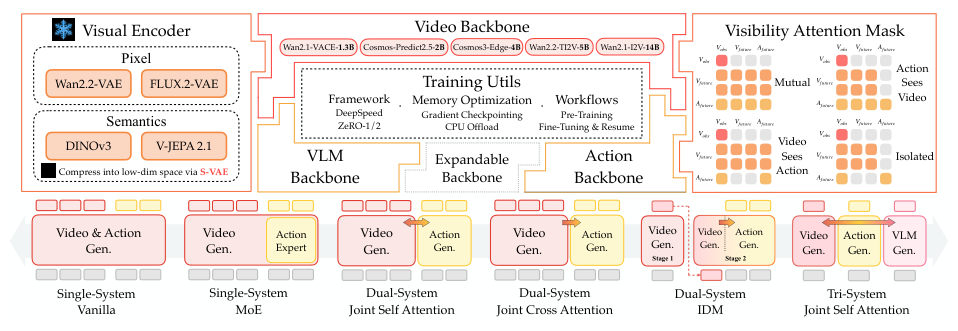
上方三块:视觉编码器(Pixel 框:Wan2.2-VAE、FLUX.2-VAE——压缩到 S-VAE 潜空间;Semantics 框:DINOv3、V-JEPA2.1——低维压缩表示);视频骨干(Wan2.1-VACE-1.3B、Cosmos-Predict2.5-2B、Cosmos3-Edge-4B、Wan2.2-TI2V-5B、Wan2.1-I2V-14B 一排)与内嵌训练工具(Framework: DeepSpeed/ZeRO-1/2;Training Optimization: 梯度检查点、CPU offload;Workflows: 预训练/微调/续训);可见性注意力掩码四格(Mutual / Action Sees Video / Video Sees Action / Isolated)。下方 6 个架构变体框(单系统 vanilla/MoE → 双系统 IDM/联合自注意力/联合交叉注意力 → 三系统联合自注意力)用粉/黄/灰 token 条示意各流组成。这张图就是「实验台」的零件清单。
Figure 3:推理模式与去噪时刻表(论文 Fig. 3)
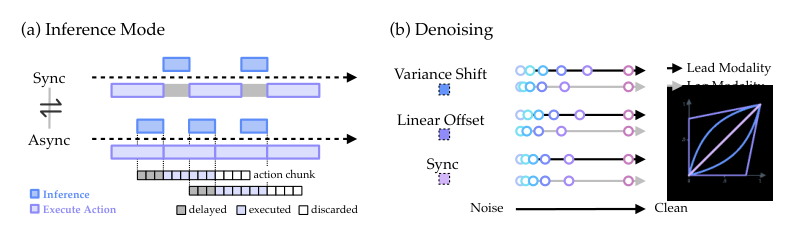
(a) 同步 vs 异步推理模式示意;(b) 三条去噪曲线——同步(两流同速)、视频先行(视频先干净)、动作先行(动作先干净)。工程含义:时刻表决定「动作什么时候可信」——异步部署时动作先行能更早吐可用动作块;正文消融再给出与信息流的相互作用(Q6)。
Figure 4:评测协议——瘦客户端 + 策略服务器(论文 Fig. 5)
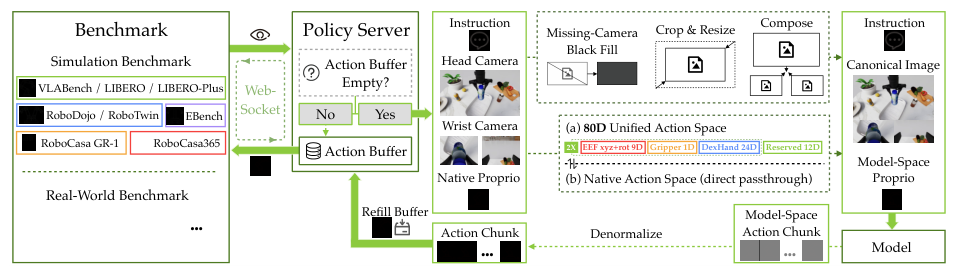
左侧各 benchmark 适配器作为瘦客户端,经 WebSocket 连中央策略服务器;服务器内完成观测合成(多视角按 checkpoint 布局裁剪缩放、缺相机补黑帧)、本体感觉归一化、模型推理、动作块反归一化回物理单位再回传。右侧分支给出两种动作表示:各基准原生空间直通(如 RoboTwin 14 维关节/20 维双臂 EE、LIBERO 10 维 EE)或 80 维统一空间。「真机和仿真用同一套接口」的工程底座——也是本文所有榜单可比的前提。
Figure 5:Q2 骨干缩放——越大越强(论文 Fig. 6)
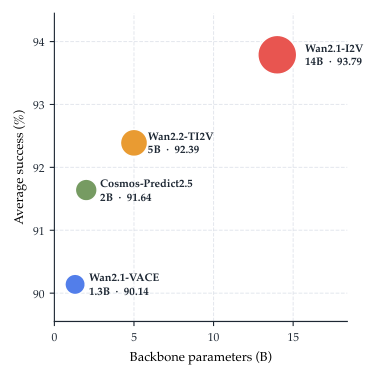
气泡图:横轴参数量、纵轴平均成功率——Wan2.1-VACE-1.3B 90.14 → Cosmos-Predict2.5-2B 91.64 → Wan2.2-TI2V-5B 92.39 → Wan2.1-I2V-14B 93.79。结论直观:视频骨干的能力直接决定继承的上限(Finding 1 的半壁江山);α 选 5B 是吞吐/效果折中(14B 更好但更贵)。
Figure 6:Q3 视觉表示先验——重建 vs 语义(论文 Fig. 7)
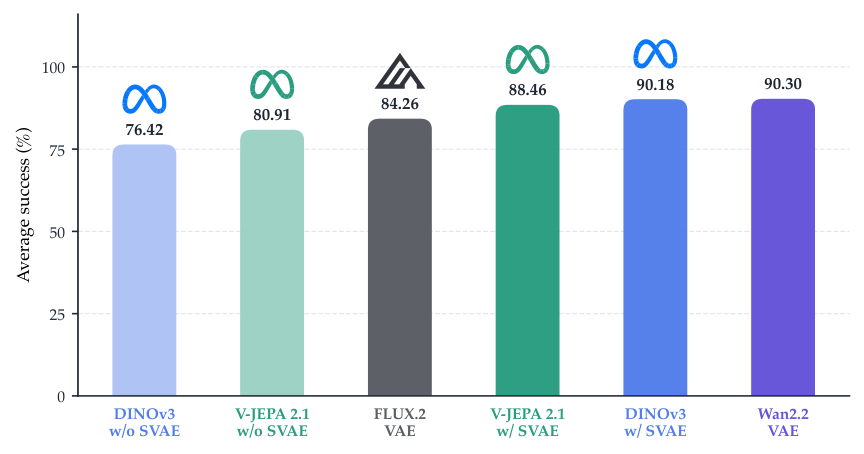
左重建型(像素系:Wan2.2-VAE、FLUX.2-VAE——重建画面)与右表示型(语义系:DINOv3、V-JEPA2.1——压缩语义潜变量)的先验对比示意与成绩对照。关键发现:带维度压缩的表示型编码器不输重建型——「要懂世界不必先会画画」,这对压缩训练成本是大利好(Finding 1 另一半)。
Figure 7:Q4 四种注意力掩码(论文 Fig. 8)
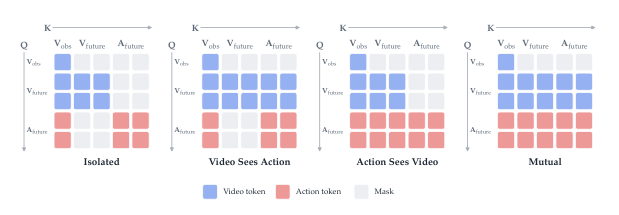
四张 Q×K 矩阵并排:Isolated(视频/动作互不看见)→ Video Sees Action → Action Sees Video → Mutual(互见)。色块:蓝=视频 token、红=动作 token、灰=屏蔽。读图抓手:行 =「谁能看见」——Mutual 只保留必要的屏蔽(被噪未来帧之间、干净首帧行)。消融结论:动作侧能否访问世界特征是性能分水岭;规模化后互见持续最优(Finding 2/3 都指向它)。
Figure 8:Q5 具身预训练主要涨 OOD(论文 Fig. 10)
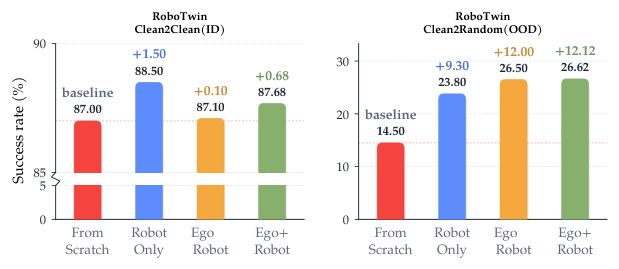
成功率为指标的分组柱图:预训练前后在 ID(域内)与 OOD(域外) 上的对比——ID 涨幅温和,OOD 涨幅显著(配文点名 RoboTwin2.0-Clean2Random 两个 split 同向复现)。这支撑 Finding 3:具身预训练的红利主要是「出分布还活着」,不是把背过的题再考高几分。
Figure 9:预训练改变最优信息流(论文 Fig. 11)
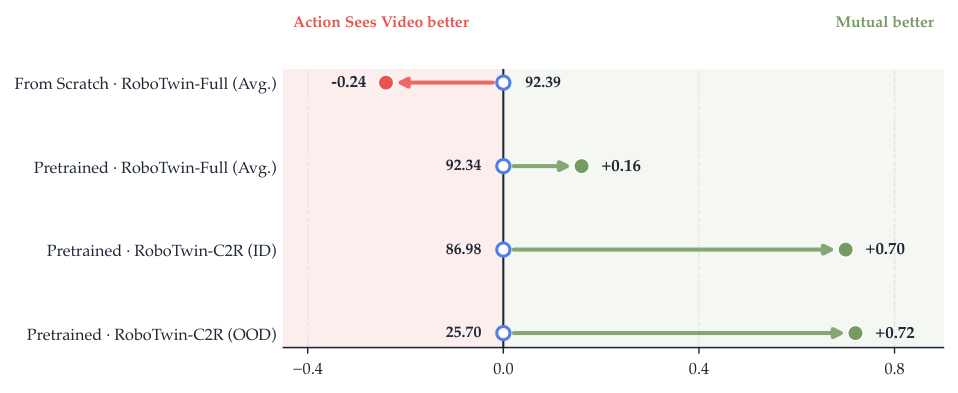
中心标记给出各信息流方向在预训练前后的绝对成功率——偏好发生反转:预训练前某种方向占优,预训练后(数据与知识状态变了)互见占优。方法论意义很大:「该不该让动作看见视频」不是可以拍脑袋定死的超参,而是随训练状态迁移的决策——受控实验才能抓住这种反转(单体论文里它会被淹没)。
Figure 10:OpenWAM-α 架构总览(官网原图 = 论文 Fig. 12)
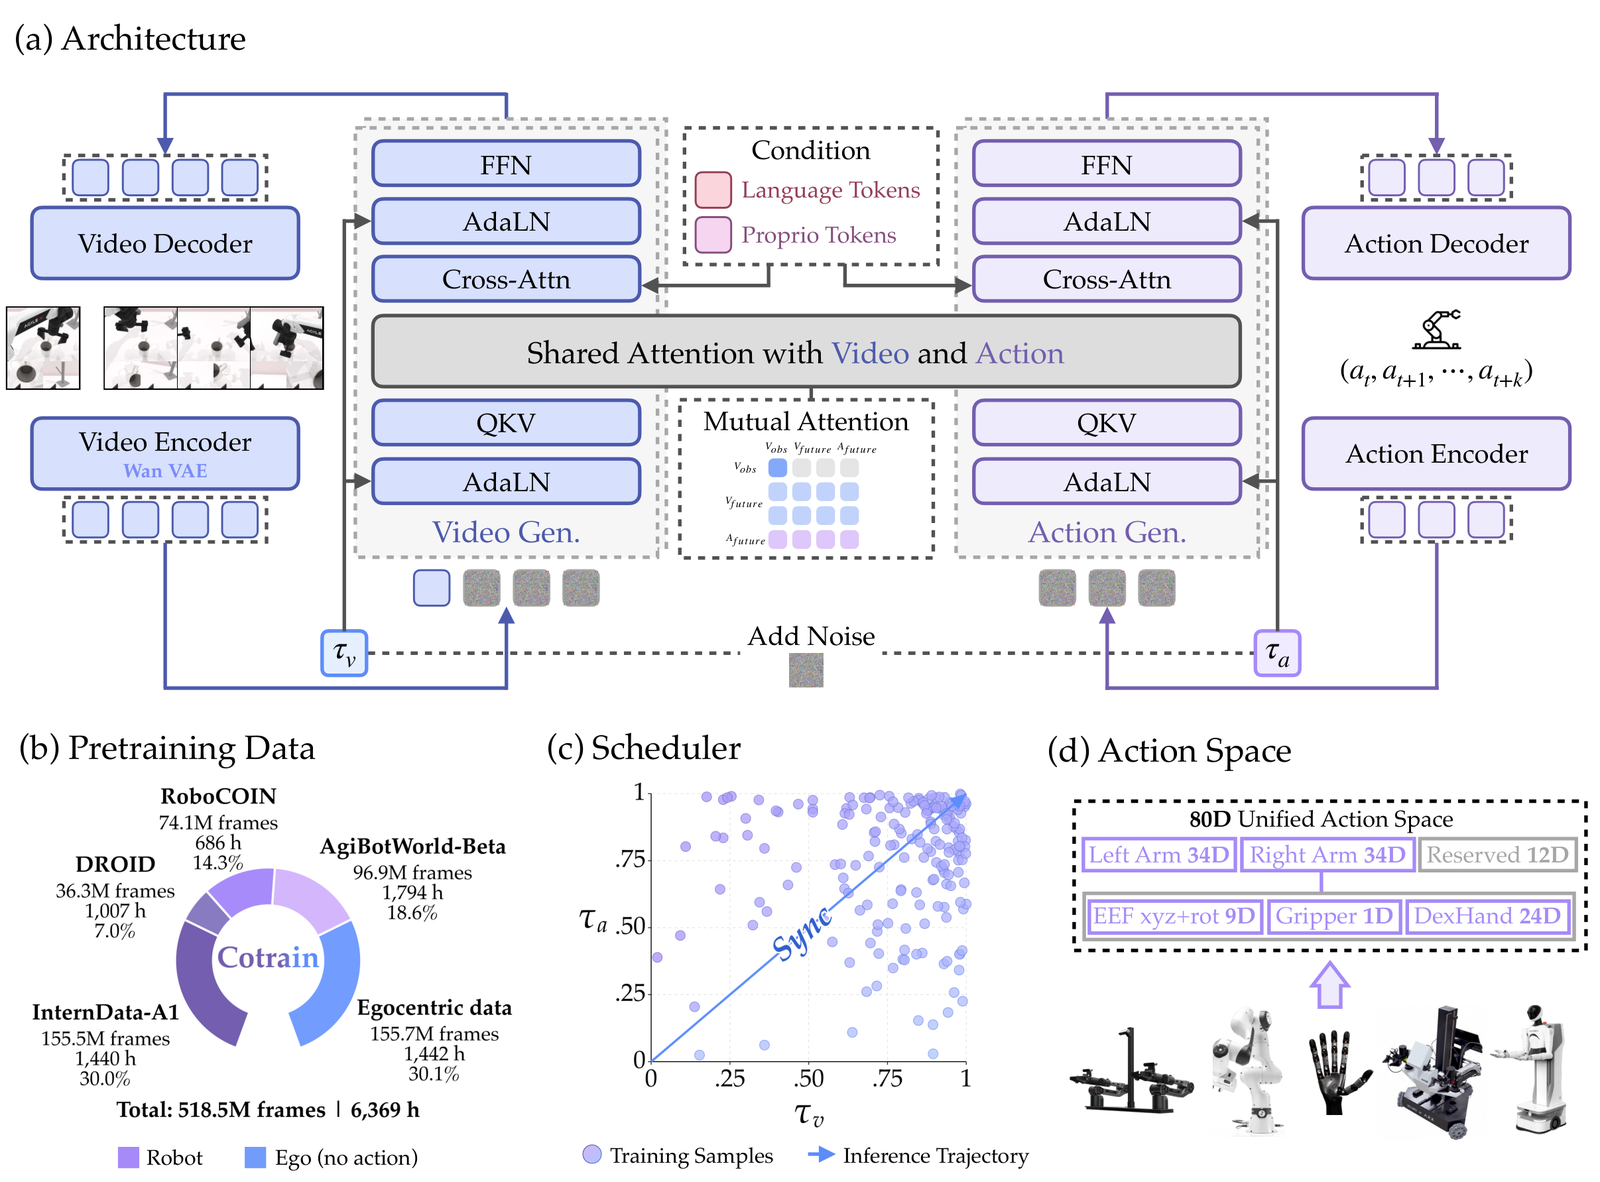
四个面板:(a) 视频 DiT 与专用 ActionDiT 在互见掩码下联合去噪未来帧与动作块;(b) 单阶段预训练混合(机器人/人本配比);(c) 训练覆盖整个联合噪声平面、推理沿同步对角线走;(d) 80 维统一动作空间的固定槽位语义(两镜像臂块 + 灵巧手 + 预留槽,各本体共用坐标)。官网把它当模型页主图——α 的一页说明书。
Figure 11:八基准九榜成绩对比(论文 Fig. 13,九连板)
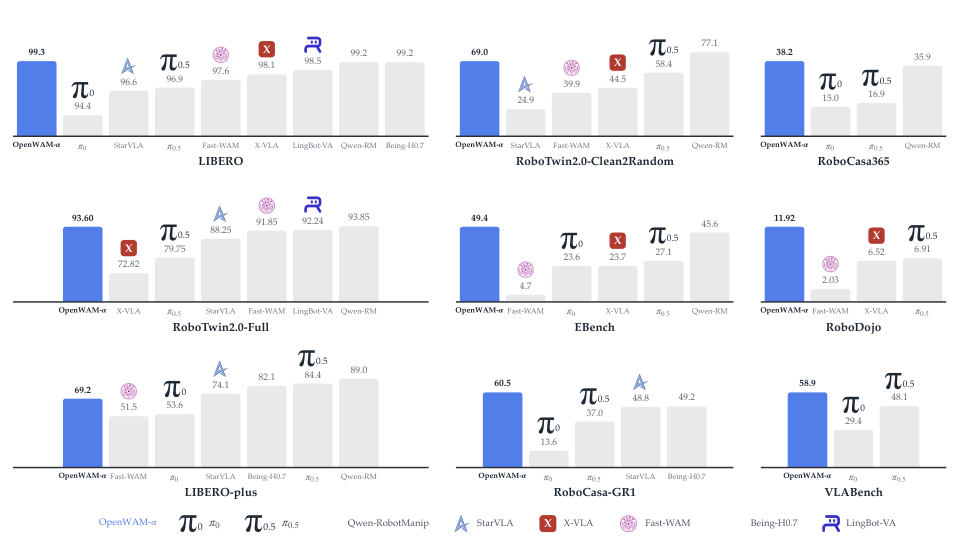
3×3 连板,每板一个基准、柱顶标真实分数:LIBERO 99.3(对照 π0 94.4 / π0.5 96.9 / Fast-WAM 97.6 / X-VLA 98.1 / Qwen-RM 99.2 / Being-H0.7 99.2……完整分套表见成绩页,LIBERO 上 ABot-M0.5 99.4 为全表最高、α 以 99.3 次之);RoboTwin2.0-Clean2Random 69.0(Fast-WAM 仅 4.7——OOD 轨道淘汰赛);RoboCasa365 38.2(π0.5 6.91——移动单臂差距悬殊);RoboTwin2.0-Full 93.60(Qwen-RM 93.85 略高);EBench 49.4(Being-H0.7 49.2 紧随);RoboDojo 11.92(π0.5 6.91 之上的分数制口径,与 RoboDojo 精读的 score/SR 双指标一致);LIBERO-plus 69.2(Qwen-RobotManip 89.0 更高——鲁棒性榜是 α 的失分点,图如实呈现);RoboCasa-GR1 60.5;VLABench 58.9。读图纪律:这是论文自报 + 全基线同框的对照图,个别榜并非全场第一,抄数先看柱。
Figure 12:真机单臂实验平台(论文 Fig. 18)
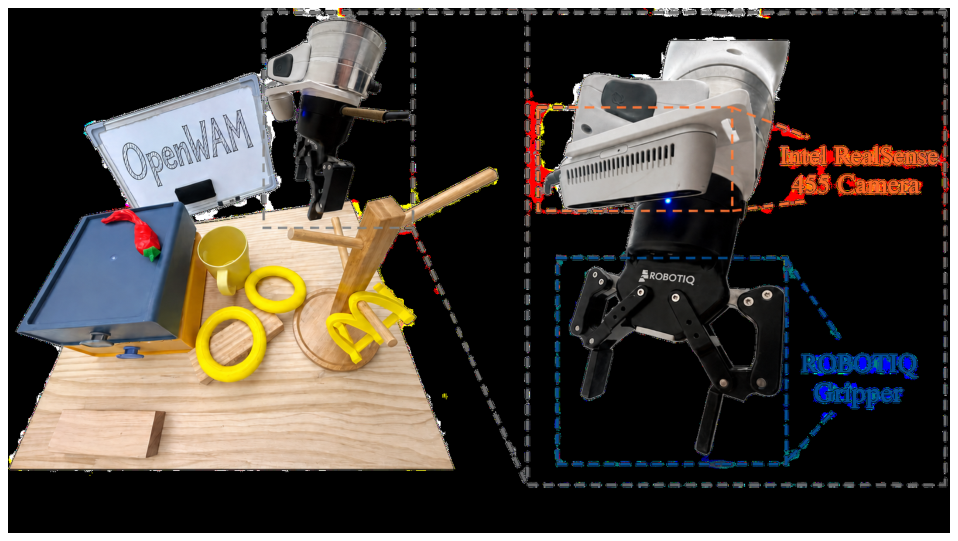
Franka Research 3 实验台实拍:工作台、相机位姿与场景布置。对应真机第一档单臂六任务 82.5%(挂放 M 形件、辣椒入抽屉、挂杯、层层积木、积木入抽屉、叠套圈——见 Fig. 13 时序)。
Figure 13:单臂任务执行时序(论文 Fig. 19)
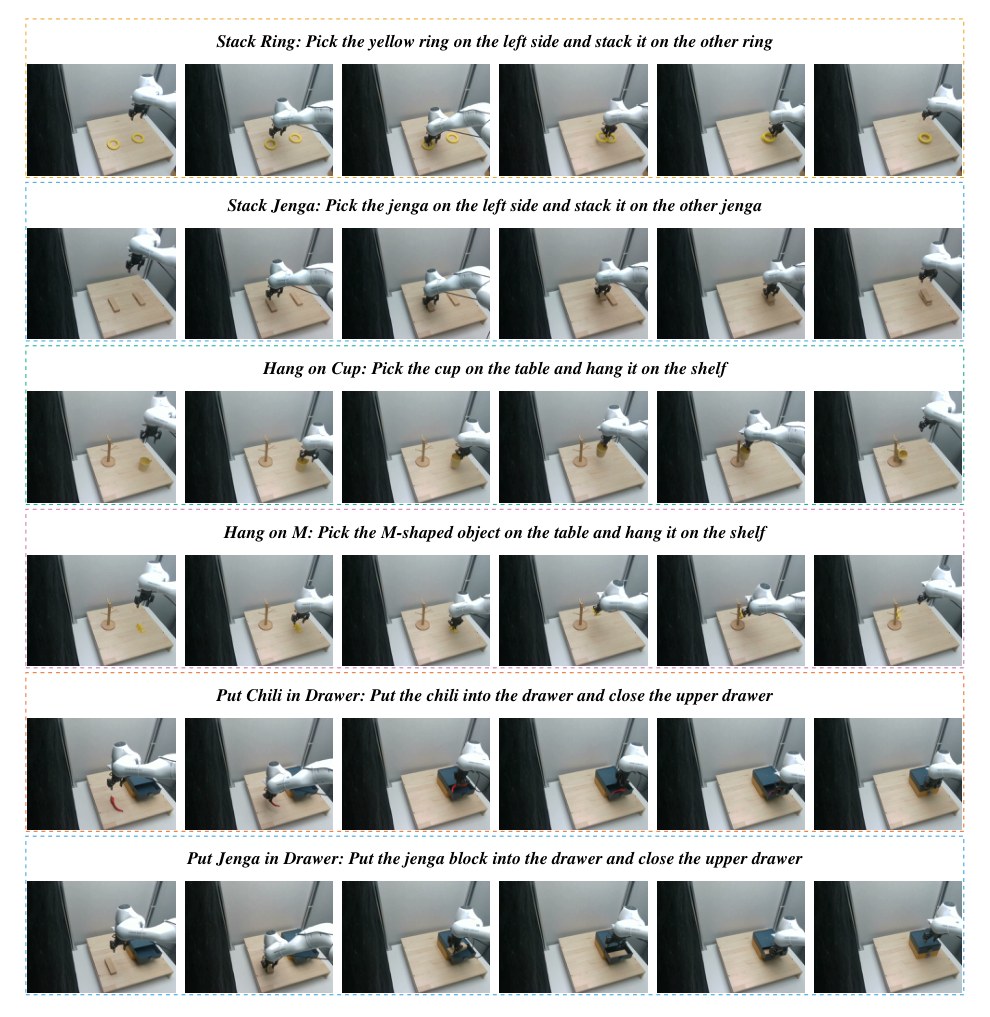
四个任务的逐帧执行带(时间从左到右),展示同一 α 策略在抓取-移动-入位各阶段的连续动作。评测口径:固定机位相机、逐任务成功判定——开箱策略(SFT 自八基准配方)直接上真机的证据链一环。
Figure 14:灵巧手任务与 OOD 条件(论文 Fig. 21)
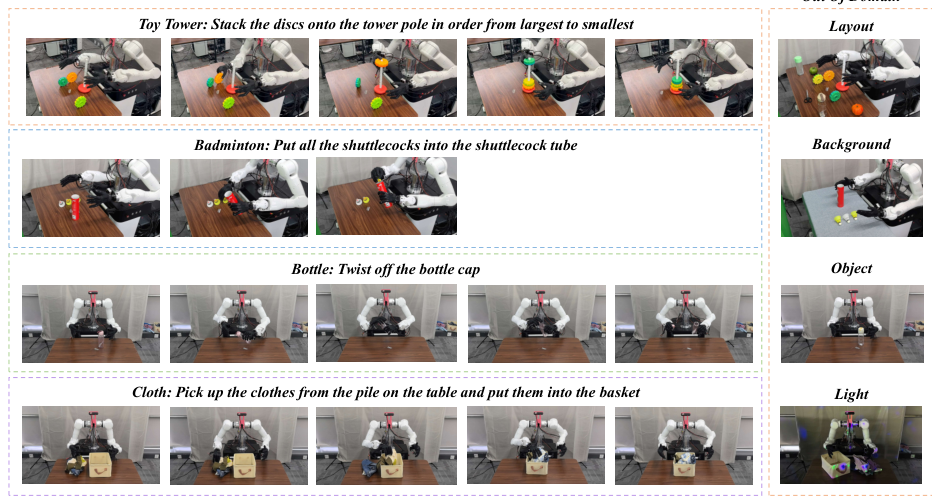
左四行时序:Toy Tower(按大小叠塔)、Badminton(羽毛球入筒)、Bottle(拧瓶盖)、Cloth(衣物入篮)——双臂+灵巧手(21 手部自由度 + 6 维末端位姿;该本体从未出现在预训练混合里);右列四格 OOD 条件:Layout / Background / Object / Light(加上域内对照,共 17 段真机演示)。灵巧手真机总分 90.0——跨本体 OOD 泛化的最硬证据(Finding 3 的真人版)。
🧪 评测协议补充
- 八基准 = 九榜:RoboTwin2.0 拆 Full(clean+randomized 混合训练,测两条件,ID 能力)与 Clean2Random(只训 clean、测两条件,OOD 能力)两条轨道;
- 五本体类别:单臂(LIBERO / LIBERO-Plus / VLABench)、双臂(RoboTwin2.0 / RoboDojo)、移动单臂(RoboCasa365)、移动双臂(EBench)、灵巧手(RoboCasa-GR1);
- Study 阶段专用协议:六问全部在 RoboTwin2.0 双轨上做(2,500 clean + 25,000 randomized 演示的 Full 集,Bi et al. 2026 配方;C2R 只用 clean,Yuan et al. 2026a 配方),成功率为唯一指标;
- 各基准详细科普(任务是什么、怎么测)见姊妹篇 具身仿真 Benchmark 全精读(已按本文评测栈补入 LIBERO、LIBERO-Plus、EBench、RoboCasa-GR1、RoboDojo 五章与 RoboTwin 双轨注记)。
💡 评析:三个亮点,三条边界
三个亮点
- 把「不可比」变成「可比」:六问在同一实验台、同一协议、逐问锁定条件下进行——结论(互见、同步去噪、单阶段共训)是净效应而不是实现细节的回声;这是对 WAM 社区方法论级别的贡献。
- 开放彻底:46 个 checkpoint + 评测协议 + 数据配方 + 接入 XPolicyLab——「可复现」在 WAM 领域罕见地做到了全套。
- 成绩与失分都公开:LIBERO-Plus 被 Qwen-RobotManip 反超、RT2.0-Full 差 Qwen-RM 0.25——九榜全基线同框(Fig. 11),没有挑软柿子。
三条边界
- α 的涨幅高度依赖配方链:换掉 Wan2.2-TI2V-5B 或丢掉人本 30%,结论是否迁移需要重跑六问——论文给的是「一条最优路径」而非全空间保证。
- 六问实验以 RoboTwin2.0 为场:结论在别的基准上默认继承,跨基准的「信息流翻转」复现实验未做全套。
- 分数口径易混:RoboDojo 是 score 制(11.92 ≠ 成功率),真机 37.6/24.4 又是另一套——对表时必须带指标名。
🗺️ 在「WAM 谱系」里的位置
- 与斯坦福 OPENWAM(2610.07922):撞名双子——斯坦福篇管「可组合的交互模式」(Joint/VTA/ATV…),本篇管「预训练流水线的模块化与六问」;两篇都主张受控变量,可对照读。
- 与 WAM 全景分析:本文是全景图里「工程基础设施」分支的代表作。
- 与 RoboDojo / Benchmark 全精读:α 的九榜就是在这套考场上验的;RoboDojo 11.92 是分数制。
- 与 π0.7 / GR00T-N1.7 / Flash-WAM:同榜对手;α 的差异点是视频生成底座 + 世界-动作联合去噪 + 人本共训。
- 谱系标签:WAM / 受控实验方法论 / 全栈开源。
📊 图表总索引(14 张)
| 图 | 内容 | 本站文件 |
|---|---|---|
| Figure 1(官网) | 三层栈总览 | 本文插图 |
| Figure 2 | Infra 模型模块(编码器/骨干/掩码/六架构) | 本文插图 |
| Figure 3 | 推理模式与去噪时刻表 | 本文插图 |
| Figure 4 | 评测协议(WebSocket 策略服务器) | 本文插图 |
| Figure 5 | Q2 骨干缩放气泡图 | 本文插图 |
| Figure 6 | Q3 重建 vs 表示先验 | 本文插图 |
| Figure 7 | Q4 四种注意力掩码 | 本文插图 |
| Figure 8 | Q5 OOD 泛化柱图 | 本文插图 |
| Figure 9 | Q5 信息流翻转 | 本文插图 |
| Figure 10(官网) | α 架构四面板 | 本文插图 |
| Figure 11 | 八基准九榜成绩连板 | 本文插图 |
| Figure 12 | 真机单臂实验台 | 本文插图 |
| Figure 13 | 单臂四任务时序 | 本文插图 |
| Figure 14 | 灵巧手四任务 + OOD 四条件 | 本文插图 |
(正文另有4 掩码消融、六问配置表、九榜汇总表、accumulated recipe 表,已以文字表格复现;成绩明细见官网 /results/。)
❓ 自测 Q&A
Q1:OpenWAM 范式一句话?
「受控实验程序」:Infra 固定实验台(换零件不换接口)→ Study 按六问顺序筛原则(上一问锁条件)→ α 把原则拼成模型并在九榜验收,最后全栈开源让别人接着问。
Q2:六问为什么必须按顺序?
因为问题互相耦合——骨干多大(Q2)影响表示选择(Q3)的公平性,交互方式(Q4)又依赖前两者;论文规定上一问的答案成为下一问的默认配置,避免组合爆炸与不公平比较。
Q3:80 维统一动作空间怎么工作?
固定槽位语义(两块镜像 34 维臂:EE 位姿 3 + 6D 旋转 6 + 夹爪 1 + 灵巧手 24,再加 12 预留槽给移动底盘等);每个数据集声明原生维度→槽位的索引表 π,散射归一化、 gather 反归一化;未映射槽位零梯度——不同本体的公共结构落在同一坐标上。
Q4:为什么互见(Mutual)最后赢了?
Finding 2/3:动作需要显式访问世界特征(Isolated/单向可见都会丢信息),且预训练后这种需求更强(Fig. 9 的偏好翻转);互见只屏蔽必要的「被噪未来帧互看」,信息保留最完整。
Q5:α 是不是九榜全部第一?
不是——LIBERO-Plus 69.2(Qwen-RobotManip 89.0 更高)、RT2.0-Full 93.60(Qwen-RM 93.85 略高)、LIBERO 99.3 全表次高(ABot-M0.5 99.4)。论文/官网都按全基线同框呈现,引用时务必带榜带指标。
Q6:和站内斯坦福 OPENWAM 怎么选读?
受控变量哲学相同、切面不同:斯坦福篇=「交互模式组合学」(Wan 底座上 Joint/VTA/ATV…),本篇=「预训练流水线模块化 + 六问 + 旗舰 α」。建议先读本篇建立栈级框架,再读斯坦福篇钻单一变量。
📚 资源与延伸
- 论文:arXiv 2609.07398;官网 openwam-official.github.io(含 /results/ 全量成绩)
- 代码/模型:GitHub OpenWAM-Official/OpenWAM · HuggingFace OpenWAM(46 ckpts)· XPolicyLab 接入
- 姊妹篇:具身仿真 Benchmark 全精读(本文九榜逐个科普)· OPENWAM 斯坦福篇精读
- 同榜模型精读:π0.7、GR00T-N1.7、Flash-WAM、RoboDojo
- 知识铺垫:WAM 世界行动模型全景分析、Flow Matching 入门详解