📄 论文信息
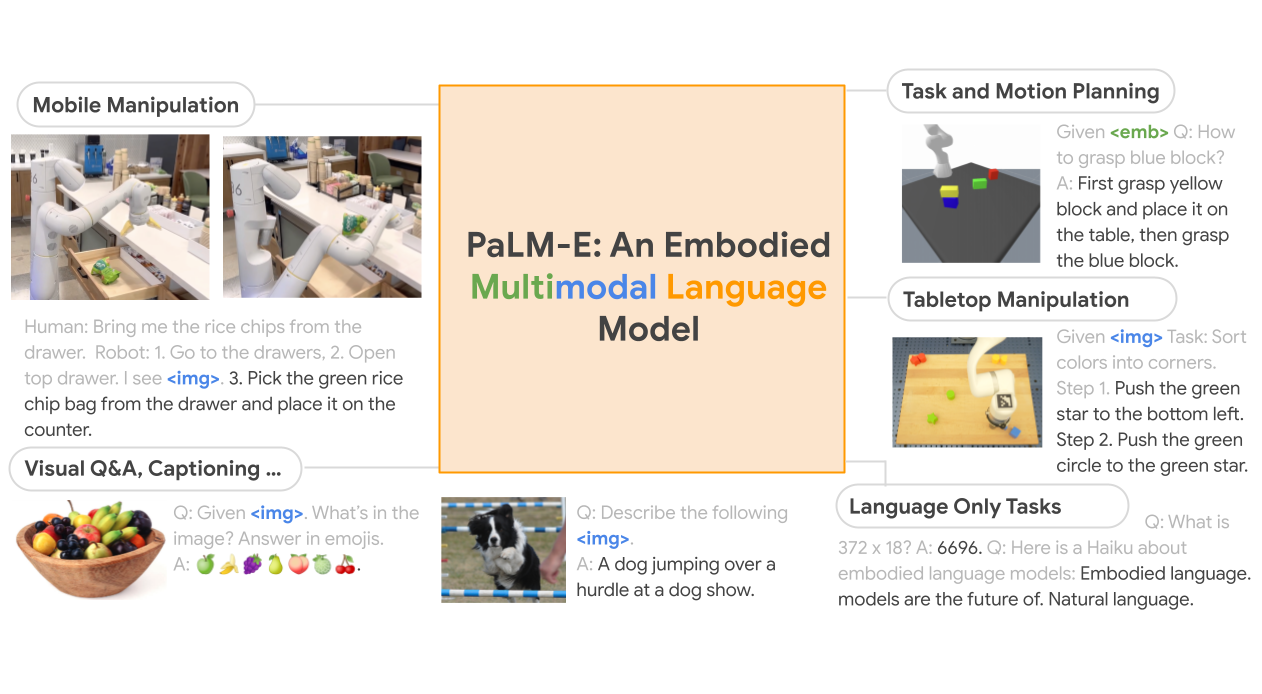
- 标题:PaLM-E: An Embodied Multimodal Language Model(PaLM-E:具身多模态语言模型)
- 团队:Google Robotics at Google + 柏林工业大学(Danny Driess, Fei Xia, Corey Lynch, Sergey Levine, Karol Hausman, Pete Florence 等22位作者)
- 发表:ICML 2023(arXiv 2023.03)
- 关键词:多模态大语言模型、具身智能、视觉语言模型、机器人规划、跨模态迁移
- 一句话总结:PaLM-E将大语言模型直接与连续传感器输入结合,构建了一个能同时处理机器人规划、视觉问答、图像描述等多种任务的通用具身多模态模型,最大规模达562B参数。
- 论文链接:arXiv:2303.03378
- 代码链接:palm-e(非官方实现)
🤔 要解决什么问题?
语言模型的"具身接地"挑战
大型语言模型(LLM)在文本理解和生成方面展现了惊人的能力,但在将其应用于机器人等物理世界任务时,面临一个核心挑战:接地(Grounding)问题。
这个问题的本质在于:LLM的知识是通过文本获得的,它"知道"如何清洁溢出的饮料,但这种知识是抽象的、脱离物理现实的。当一个机器人需要在真实环境中执行这个任务时,它面临多重挑战:
- 理解当前环境状态:哪些物体在哪里?它们的物理属性是什么?颜色、形状、材质如何?
- 感知连续传感器数据:机器人配备的是图像、深度图、关节角度、力传感器等连续信号,而非文本描述
- 将抽象知识与具体感知关联:LLM说"拿起海绵",但机器人需要"看到"海绵在哪里、判断能否抓取、规划运动轨迹
- 处理物理世界的不确定性:物体可能滑动、传感器可能有噪声、环境可能动态变化
传统方法(如SayCan)通过将LLM的输出与低级技能库结合来解决这个问题。在SayCan框架中,LLM负责理解指令并选择合适的技能,而affordance函数负责评估技能的可行性。但这种方式存在明显局限:
- 需要预先定义技能库:技能库的覆盖范围决定了系统能力的上限
- LLM只能输出文本:它无法直接感知环境,需要额外的"翻译层"将文本映射到动作
- 信息传递有损失:从文本到动作的多次转换会引入信息损失
- 缺乏端到端优化:各模块独立训练,无法联合优化
此前的视觉语言模型(VLM)如CLIP、Flamingo等虽然能处理图像和文本,但它们主要针对互联网上的静态图像设计,缺乏对机器人操作场景的理解。这些模型"看到"的是高质量的互联网图片,而非机器人视角的实时传感器数据。
PaLM-E的核心问题
能否让大语言模型直接"看到"和"感受"物理世界,从而构建一个真正意义上的具身智能体?
具体来说:
- 能否将连续传感器数据(图像、状态估计等)直接输入LLM?
- 训练这样一个模型是否会导致灾难性遗忘(catastrophic forgetting)?
- 多任务、多模态、多机器人的联合训练是否能带来正向迁移?
💡 核心方法
核心思想:将连续感知注入语言嵌入空间
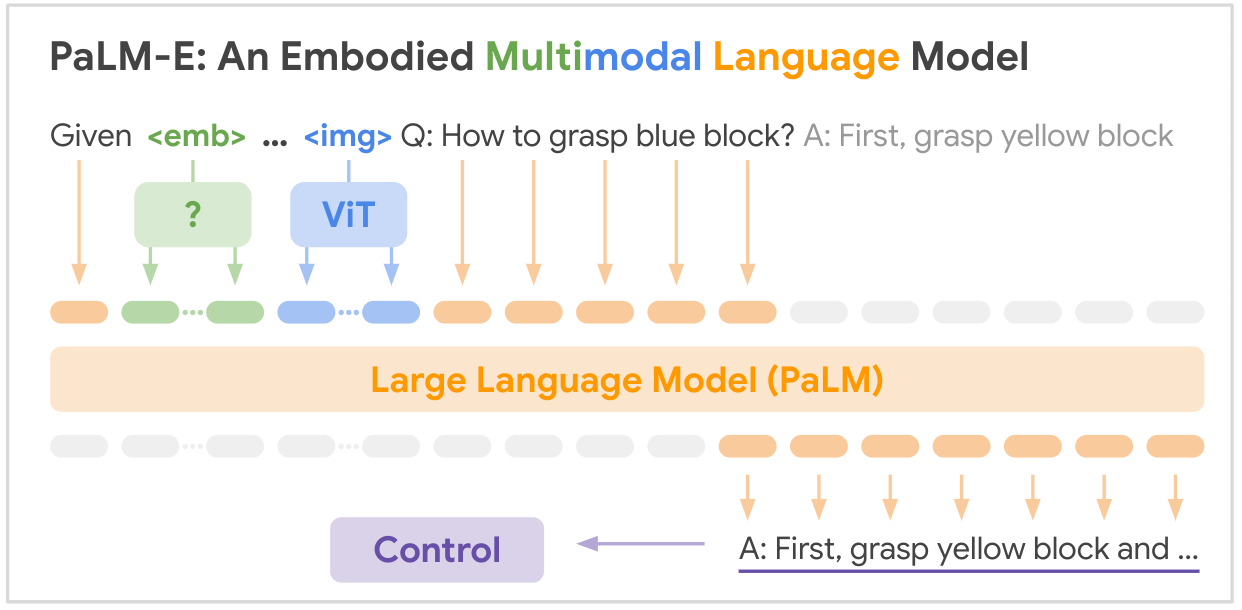
PaLM-E的核心架构思想非常优雅:将连续的具身观测(图像、状态估计等)编码为与语言token相同维度的向量,然后将这些"具身token"与文本token交错排列,形成"多模态句子"(multimodal sentences)作为LLM的输入。
模型架构
1. 整体架构
PaLM-E是一个decoder-only的自回归语言模型,基于预训练的PaLM构建。其输入是文本和连续观测的交错序列:
$$\text{Input} = [\text{text}_1, \text{text}_2, ..., \text{obs}_1, \text{obs}_2, ..., \text{text}_3, ...]$$其中 $\text{obs}_i$ 可以是图像、机器人状态、或神经场景表示等任意模态的连续输入。模型的输出是文本序列,可以是对问题的回答、图像描述、或机器人动作序列。
2. 多模态编码器
PaLM-E支持三种主要的连续输入表示方式:
(a)视觉输入(ViT编码器)
使用预训练的Vision Transformer(ViT)将图像编码为一系列视觉token:
$$\text{visual\_tokens} = \text{ViT}(I) \in \mathbb{R}^{N_v \times d}$$其中 $N_v$ 是视觉token数量,$d$ 是嵌入维度(与PaLM的token嵌入维度匹配)。
(b)状态估计输入
对于机器人关节状态等低维连续信号,使用多层感知机(MLP)将其编码为token:
$$\text{state\_token} = \text{MLP}(s) \in \mathbb{R}^{1 \times d}$$其中 $s \in \mathbb{R}^{d_s}$ 是机器人状态向量。
(c)神经场景表示(OSRT)
PaLM-E引入了一种创新的输入表示——神经场景表示。使用Object-Centric Neural Radiance Field(OSRT)将场景中的物体表示为3D神经场:
$$\text{scene\_token} = \text{OSRT}(\mathcal{O}) \in \mathbb{R}^{N_o \times d}$$其中 $\mathcal{O}$ 是场景中的物体集合。这种表示的优势在于:
- 提供3D空间信息,不受相机视角影响
- 支持物体级别的操作和推理
- 在小数据场景下特别有效
3. 多模态句子构造
将编码后的连续token与文本token交错排列,形成多模态句子:
$$\text{MM-Sentence} = [\text{< img>}, t_1, t_2, ..., \text{< img>}, t_3, t_4, ..., \text{text}]$$其中 <img> 是特殊的多模态token标记,用于分隔不同的模态输入。论文还提出了**实体标注(entity-labeling)**技术,为每个模态输入添加语义标签(如"red star"、“green block”),增强模型对物体的理解。
4. 训练策略
PaLM-E采用端到端微调策略,损失函数为标准的自回归语言建模损失:
$$\mathcal{L} = -\sum_{i=1}^{T} \log p_\theta(x_i | x_{1:i-1})$$其中序列 $x$ 包含文本和连续观测的混合。训练使用多种数据集的混合:
- 机器人任务数据(TAMP、Language-Table、SayCan)
- 通用视觉语言数据(WebLI、VQA、COCO等)
关键设计决策
冻结 vs. 微调 LLM
论文系统研究了冻结(freeze)vs. 微调(finetune)语言模型的影响:
| 策略 | 优势 | 劣势 |
|---|---|---|
| 冻结LLM | 完全保留语言能力 | 视觉-语言对齐受限 |
| 微调LLM | 更好的多模态融合 | 可能发生灾难性遗忘 |
| 仅微调ViT | 平衡点 | 需要更多数据 |
实验发现:随着模型规模增大,微调导致的灾难性遗忘显著减少。对于PaLM-E-562B,仅3.9%的语言能力下降(而PaLM-E-12B下降了87.3%)。
数据混合与正向迁移
PaLM-E的核心发现之一是正向迁移(positive transfer):在多种任务和数据集上联合训练,每个任务的性能反而比单独训练更高。
例如,在TAMP(Task and Motion Planning)环境中:
- 仅用TAMP数据训练:60%成功率
- 用完整数据混合训练:95%成功率
这种正向迁移来自:
- 视觉语言数据提供了丰富的视觉和语义理解
- 多机器人数据提供了更泛化的操作技能
- 语言数据帮助模型更好地理解指令
🧪 实验验证
实验设计
PaLM-E在三大类任务上进行了评估:
- 具身推理任务:机器人规划、操作
- 视觉语言任务:VQA、图像描述
- 语言任务:自然语言理解与生成
核心实验结果
1. 机器人规划任务(TAMP)
在TAMP环境中,给定自然语言指令和场景图像,模型需要输出多步操作计划:
| 模型 | 成功率 |
|---|---|
| PaLM-E-12B(冻结) | 42.9% |
| PaLM-E-12B(微调,单机器人) | 48.6% |
| PaLM-E-12B(微调,完整混合) | 94.9% |
正向迁移的效果极其显著:完整数据混合训练将成功率从48.6%提升到94.9%。
2. Language-Table任务
在桌面操作环境中,模型需要根据语言指令规划积木操作:
- PaLM-E在32-shot数据下就能达到85%+的成功率
- 冻结LLM的策略也能取得不错的结果(74.3%)
- 完整数据混合训练显著提升性能
3. SayCan affordance任务
在真实厨房环境中,PaLM-E需要为SayCan框架提供affordance评分:
- PaLM-E显著优于专用affordance模型
- 视觉语言预训练提供了更好的环境理解
4. 视觉语言基准
PaLM-E在通用VQA任务上同样表现出色:
| 任务 | PaLM-E-562B | 最优参考 |
|---|---|---|
| OK-VQA | 66.1%(32-shot) | 64.7% |
| VQAv2 | 51.1%(冻结LLM) | 51.0% |
| VizWiz | 55.4%(冻结LLM) | 55.7% |
PaLM-E-562B在OK-VQA上达到了当时的SOTA,证明了具身训练不会损害通用视觉语言能力。
5. 语言能力保留
论文系统评估了PaLM-E在21个语言基准上的表现,发现:
- PaLM-E-8B:87.3%的语言能力下降(灾难性遗忘严重)
- PaLM-E-12B:61.6%下降
- PaLM-E-62B:31.8%下降
- PaLM-E-562B:仅3.9%下降
这表明模型规模越大,微调导致的灾难性遗忘越少,为"冻结LLM vs. 微调LLM"的争论提供了重要参考。
6. 涌现能力
PaLM-E-562B展示了多种涌现能力:
- 零样本多模态链式思维(CoT)推理:无需示例即可进行复杂推理
- 视觉条件化笑话生成:根据图像生成幽默内容
- 跨模态问答:理解图像并回答相关问题
🔍 个人思考
亮点
架构设计的优雅性:PaLM-E将连续感知直接注入语言token空间,这种方法既简单又强大。不需要复杂的"翻译层",模型自然地学会了将视觉信息与语言理解关联。
正向迁移的发现:这是本文最重要的贡献之一。联合训练多种任务(机器人+VQA+描述)不仅没有互相干扰,反而产生了显著的性能提升。这为"数据越多越好"的假设提供了实证支持。
模型规模与遗忘的关系:论文系统研究了模型规模与灾难性遗忘的关系,发现562B模型几乎不受影响。这一发现对后续的多模态大模型训练具有重要指导意义。
神经场景表示的引入:OSRT作为输入表示是一个创新点,它提供了3D空间信息,在小数据场景下特别有效。这为机器人感知提供了新的范式。
多模态涌现能力:PaLM-E-562B展示了零样本CoT推理等涌现能力,表明具身训练不仅不会损害通用能力,反而可能增强某些能力。
局限性
计算成本极高:PaLM-E-562B需要巨大的计算资源进行训练和推理,这限制了其在实际机器人系统中的部署。即使是12B版本也需要相当的计算能力。
闭环控制的缺失:PaLM-E主要作为一个规划器(planner),输出的是自然语言动作序列而非直接的低级控制命令。它需要与RT-1等低级策略集成才能完成完整的闭环控制。
推理延迟:大模型的推理延迟较高,对于需要快速反应的机器人任务来说是个挑战。论文中3Hz的控制频率对于精细操作可能不够。
数据需求:虽然论文展示了正向迁移,但PaLM-E的训练仍然需要大量多样化的数据。对于资源有限的团队来说,复现这一工作极具挑战性。
对预训练模型的依赖:PaLM-E完全基于预训练的PaLM,如果基础语言模型本身存在偏见或错误知识,这些也会被传递到具身任务中。
未来方向
与RT-2的结合:PaLM-E的后续工作RT-2(Brohan et al., 2023)将VLM直接用于机器人控制,实现了端到端的视觉语言动作(VLA)模型。
更高效的架构:探索如何在保持性能的同时减小模型规模,使其能够在机器人硬件上实时运行。
实时闭环控制:将PaLM-E扩展为能够输出低级控制命令的闭环策略,而非仅作为高层规划器。
多形态机器人:扩展到更多类型的机器人(如灵巧手、人形机器人),探索真正的跨形态迁移。
在线学习:让PaLM-E能够在部署后从新经验中学习,持续改进其具身理解能力。
📖 延伸阅读
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control(Brohan et al., 2023)- PaLM-E思想的直接延续,将VLM用于机器人控制
- PaLM: Scaling Language Modeling with Pathways(Chowdhery et al., 2022)- PaLM-E的基础语言模型
- ViT: An Image is Worth 16x16 Words(Dosovitskiy et al., 2020)- PaLM-E使用的视觉编码器
- Socratic Models: Composing Zero-Shot Multimodal Reasoning with Language(Zeng et al., 2022)- 相关的多模态推理方法
- Inner Monologue: Embodied Reasoning through Planning with Language Models(Huang et al., 2022)- 基于PaLM-E的闭环规划扩展
- Do As I Can, Not As I Say: Grounding Language in Robotic Affordances(Ahn et al., 2022)- SayCan工作,PaLM-E的前身思想
- OSRT: Object-Centric Neural Scene Representations(Sajjadi et al., 2022)- PaLM-E使用的神经场景表示