📄 论文信息
- 标题:Percept-WAM: Perception-Enhanced World-Awareness-Action Model for Robust End-to-End Autonomous Driving
- 作者机构:引望智能(Yinwang Intelligent Technology,华为车 BU 前身相关)/ 复旦大学(韩建华、田梦、朱江桐、何凡、张慧新、郭思同、朱德昌、唐昊、徐培、郭玉泽、牛敏哲、朱浩杰、董启超、严雪超、董思远、侯璐、黄庆九、贾晓松、徐航 ✉)——韩建华、田梦、朱江桐并列一作,徐航通讯
- 会议:CVPR 2026(pp. 10642-10655)
- arXiv:2511.19221(2025-11-24)
- 一句话总结:Percept-WAM 是第一个把 2D/3D 场景理解"隐式"集成进单个 VLM 的 WAM。它不搞 QA 式空间推理(“前车距离多少?"),而是把感知任务统一成两类世界 token——透视视角的 World-PV 和鸟瞰视角的 World-BEV,每个 token 编码空间坐标 + 校准后的置信度;再用四组点级轨迹 query 把感知表示对齐成轨迹。NAVSIM v1 拿到 90.2 PDMS(超 DiffusionDrive 2.1)、COCO 2D 检测 51.7 mAP、nuScenes BEV 3D 检测 58.9 mAP,流式推理时延 707ms。
🎯 一句话记忆点:Percept-WAM = “把感知器官长进大脑里”——别的 WAM 把感知当"外部输入”,它把感知当"内部神经元"(World-PV/World-BEV token),让规划和感知共享同一个 VLM 骨架,感知越强、规划越稳。
🤔 要解决什么问题?
VLM 的空间感知是硬伤
自动驾驶本质上是"精确空间感知 + 环境推理 + 控制决策"。但常识是:通用 VLM 的空间能力并不好。论文引了多份评估(Thinking-Motion、SpatialRGPT 等)指出 VLM 的三大通病:
- 3D 定位漂移:测距、朝向估计误差大;
- 时序不一致:对同一目标,逐帧判断前后矛盾;
- 置信度不可靠:LLM 系统性地过度自信——即使检测很模糊,softmax 概率也接近饱和。
这些问题在长尾场景(夜间、雨雾、小目标、稀有目标)和复杂交互里会放大成雪崩式的决策失误——感知的一个小几何误差(检测偏了、yaw 漂了、BEV 错了)会一路传导到轨迹。
现有两派都占不全
| 路线 | 代表 | 优点 | 致命伤 |
|---|---|---|---|
| QA 式空间推理 | EMMA、FutureSightDrive、InProMPT | 用 LLM 推理空间 | “前车距离多少?“这种 QA 监督只给间接定位信号,得不到持久、可定位的世界状态,拥挤场景里重复检测+置信度失真 |
| Encoder-扩散-Diffusion 解码 | DiffusionDrive、DiffE2E | 生成式控制,轨迹直接 | 跳过显式空间任务学习 → E2E 性能上不去,且复杂场景需要 LLM 的推理能力 |
💡 论文的观点:感知任务(检测/分割)不是规划的可选项,而是规划的"底盘”。与其让规划器在"看不见"的情况下硬猜,不如把感知能力真正长进模型里——这就是 UniAD 式"planning-oriented"的思路,但落在单个 VLM 里。
关键主张:感知和规划要"共享骨架”
Percept-WAM 的立场是:2D 感知、3D 感知、轨迹规划应该在一个 VLM 里联合优化——感知结果成为"持久、可定位的世界状态",直接喂给推理和规划,而不是作为外部模块先算一遍再传入。这就是 “World-Awareness-Action” 的含义:世界(world)状态内嵌 → 感知(awareness)→ 动作(action),一条链路。
💡 核心思路:三族世界 Token
Percept-WAM 的全部设计围绕 三族 token 展开,对应"感知 → 规划"的完整链路:
- 输入图像先进入 VLM 骨干(InternVL2-8B);
- 再由 World-PV tokens 做透视 2D 感知;
- 由 World-BEV tokens 做鸟瞰 3D 感知;
- 最后由 World-Action tokens(四组 query)解码出轨迹。
- World-PV tokens(透视视角):图像特征按网格化组织,每个 grid 位置负责检测/分割其局部区域的目标;
- World-BEV tokens(鸟瞰视角):一组可学习的 BEV 网格查询,用 cross-attention 从 World-PV 特征"提"出 3D BEV 表示,纯数据驱动地把 2D 证据升维成 3D 空间;
- World-Action tokens(动作):四组点级轨迹查询(Q_pv/Q_bev/Q_ego/Q_full),对齐各自模态特征后由 MLP 解码出轨迹。
为什么叫 World(世界)? 因为这些 token 不是"一次性推理的中间变量",而是持久的、可定位的世界状态——它们编码了空间坐标和置信度,可以在多次推理中被复用(还支持流式 KV cache 复用),构成了模型对"世界"的内部表示。
🧩 架构讲解:输入 → 模型 → 输出
📍 架构图在这:Percept-WAM 的完整架构图是 图 2(Figure 2,见下方"架构总览"小节)。下面先用一张我自己画的流程图把整体数据流讲清楚——它的核心特征是"一个 VLM 里同时长着感知和规划",感知和规划不是串联的模块,而是并联的 token。
① 输入是什么?(2 类)
| 输入 | 类型 | 编码器 | 变成什么 |
|---|---|---|---|
| 多视角图像 | 视觉 | VLM 视觉编码器(InternVL2-8B,动态分块) | 图像特征 → World-PV tokens 的"母体" |
| 可选 LiDAR 点云 | 点云 | 预训练 LiDAR 编码器 | 初始化 World-BEV tokens(消融里 +8.2 mAP) |
② 中间经历了什么?(三族 World token 并行)
- World-PV tokens:图像特征网格化 → 透视视角 2D 感知(检测/分割/单目 3D);
- World-BEV tokens:可学习 BEV 网格查询 cross-attention World-PV → 鸟瞰 3D 感知(3D 检测/BEV 地图);
- World-Action tokens:四组点级 query(Q_pv/Q_bev/Q_ego/Q_full)受控注意力掩码对齐各模态 → MLP 并行解码轨迹。
③ 输出是什么?(2 类,可选)
感知结果(2D/3D 检测框、分割 mask)+ 最终轨迹(推理时只用 Q_full 的解码结果)。同一个骨架既能出感知、又能出轨迹——也可以只输出轨迹。
⚙️ 架构总览(论文核心图)
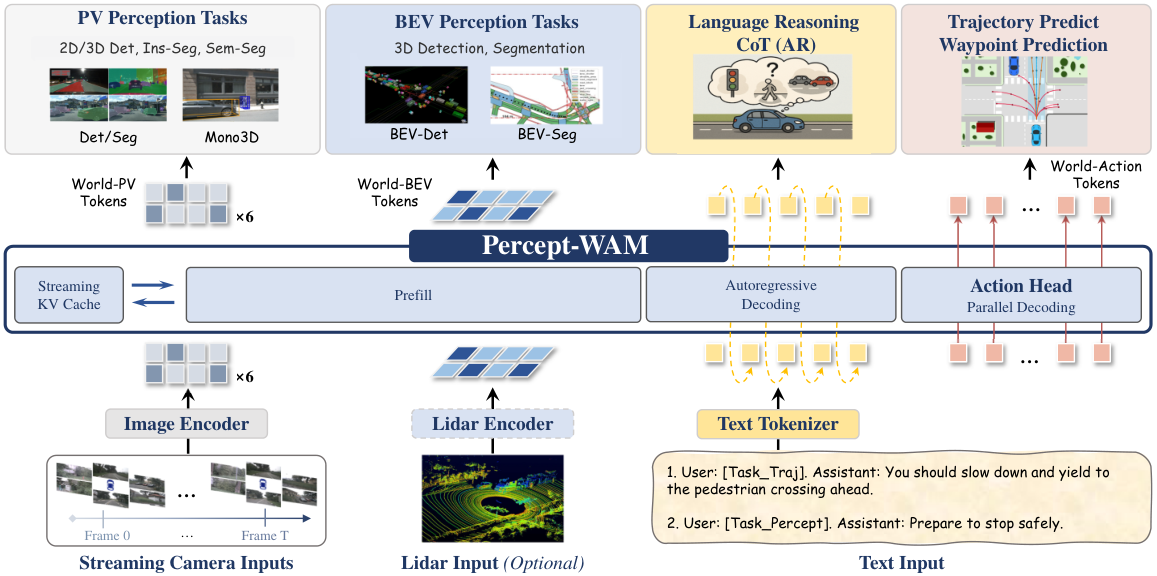
🔍 图 2 怎么读?
这是全文的"总装图",按下述顺序读:
- 输入:多视角相机图像 → VLM 骨干(InternVL2-8B),视觉编码器提取多尺度图像特征。保持预训练 VLM 参数是为了保住通用智能(逻辑推理、常识);
- World-PV tokens(图像平面):把图像特征 patch 化成一个 H×W 网格,每个网格位置作为一个"局部查询",负责检测/分割它坐标附近的目标 → 产出 2D 检测框、分割 mask;
- World-BEV tokens(鸟瞰平面):一组可学习的 BEV 网格查询(论文用 40×40 grid),通过 cross-attention 查询 World-PV 特征,把 2D 证据"升维"成 3D BEV 表示 → 产出 3D 检测框、BEV 语义地图;
- Action Head(右侧):四组点级轨迹查询 Q_pv / Q_bev / Q_ego / Q_full,在受控注意力掩码下各自对齐对应模态,再由 MLP 并行解码出轨迹;
- Memory Bank(底部):流式推理的 KV cache 复用模块,支持无限长时序输入。
读图关键:感知(PV/BEV)和规划(Action)共享同一个 VLM 骨架——图中没有独立的感知模块,感知就是 VLM 内部的 token。这正是和"感知-规划分离"流水线(比如 UniAD 用单独检测头)的本质区别。
⚙️ 模块一:World-PV(透视视角 2D/3D 感知)
3.1 设计
World-PV 分支负责在图像平面上做稠密目标感知。设计要点:
- 利用预训练 VLM 的图像理解:图像先过 VLM 骨干,得到图像特征(World-PV tokens);
- 网格化 patchify:把特征组织成 H×W 网格,每个 grid 位置作为"局部化查询"负责单一目标感知(受 UFO 启发,用插值得到与局部图像坐标对齐的细粒度特征);
- 高分辨率输入:采用 InternVL 式动态分块(dynamic tiling),把高分辨率图像切成不重叠的 tile 共享 ViT 权重编码,再通过全局位置对齐融合——在避免二次方显存增长的同时保留远距离细节(这对检测远处小目标至关重要)。
3.2 任务定义
2D / 单目 3D 检测采用语言式自回归解码,输出序列化为类文本 token(<cls> 标签、<box> 标签、<conf> 标签分别携带类别、box 坐标、置信度):
- 2D 检测:
(cls, x, y, w, h, conf)——中心点 + 宽高; - 单目 3D 检测:
(cls, x, y, z, w, h, ℓ, θ, vx, vy, conf)——3D 中心、尺寸、朝向、水平/垂直速度 + 置信度。
- 连续坐标(中心、尺寸、朝向、速度)归一化后离散成整数 bin,用 cross-entropy 监督(Pix2Seq 范式);
- 分类是文本 token → 天然支持开放词汇检测(open-vocabulary),长尾场景鲁棒;
- 所有 grid 并行解码,吞吐高。
实例/语义分割:借鉴 UFO,把分割建模成特征检索——预测 K=16 个 <MASK> token,通过 World-PV tokens 与 mask token 的点积相似度检索 mask,一次前向产出所有类别的 mask,不加新参数。
3.3 IoU 校准置信度(重要创新)
论文指出 MLLM 检测的经典病根:训练-推理不一致 + LLM 系统性过度自信。UFO 用类 logits 的 softmax 做 box 置信度,但 softmax 即使对模糊检测也饱和 → 拥挤场景大量假阳性。
解法:给每个 box 额外加一个 IoU-based 置信度 token <conf>,它依赖 box 的属性(类别/坐标/尺寸)预测该框和 GT 的 IoU——这样置信度就和"定位准不准"挂钩,而不是和"像不像"挂钩。
围绕它有三个配套设计:
- 置信度调优数据集:不是从 GT 做随机扰动(IoU 分布接近均匀),而是用中间训练阶段模型在训练图上推理,把匹配上 GT 的预测框配上它们的真实 IoU——模型预测的 IoU 分布更贴近真实分布,假阳性更少;
- 训练时的 loss mask:GT 样本(IoU 固定为 1)只学类别和框、不学 IoU(避免塌缩);置信度调优样本预测 IoU,只对置信度算 loss;
- 推理时最终分数 = 类别 softmax × 预测 IoU——更统一、可解释、定位敏感。
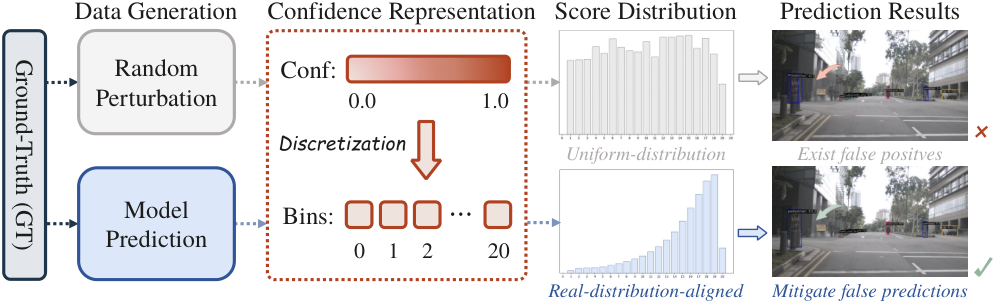
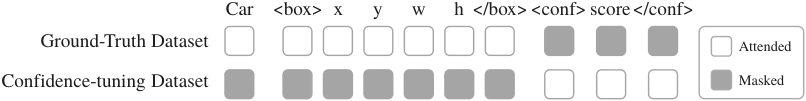
🔍 图 3 怎么读?
- (a) 上半部分是数据生成:一张图对比两种构建置信度数据集的方式——左半边从 GT 框加随机扰动(生成 IoU 分布接近均匀,不真实),右半边让模型先推理一遍再取匹配框配 IoU(分布贴近真实,效果好);
- (b) 下半部分是训练监督:展示 loss-mask 怎么在 batch 里区别对待两种样本——GT 样本锁死 IoU=1 只学框和类,调优样本只学 IoU。这样 IoU 预测既真实又不会拖累检测主任务。
🎯 一句话:Percept-WAM 的置信度不是"像不像这个类",而是"这个框准不准"——它直接把检测质量和分数挂钩,长尾拥挤场景的假阳性大幅减少。
⚙️ 模块二:World-BEV(鸟瞰视角 3D 感知)
3D 空间理解是自动驾驶的基石。Percept-WAM 显式地把 3D 检测和语义地图分割集成进 BEV 表示空间:
- World-BEV tokens 是一组可学习查询 token,把 BEV 空间实例化为以自车为中心的 H×W 网格(检测用 40×40,分割用 10×10);
- 每个 token(即一个 grid cell)输出高维 embedding,编码空间和语义信息(物体、地图元素);
- 这些 World-BEV tokens 通过 cross-attention 查询 World-PV tokens,纯数据驱动地把 2D 证据"升维"成 3D BEV 表示——不需要显式的几何变换(如 IPM 或 depth 预测)。
两大优势:
- 和 World-PV 一样,World-BEV tokens 可以在 prefill 阶段一次前向算完 → 轨迹预测的高效性;
- World-BEV tokens 天然支持 LiDAR 初始化——消融里用预训练 LiDAR 编码器特征初始化 BEV token,mAP 提升 8.2%,说明可以灵活融合多模态。
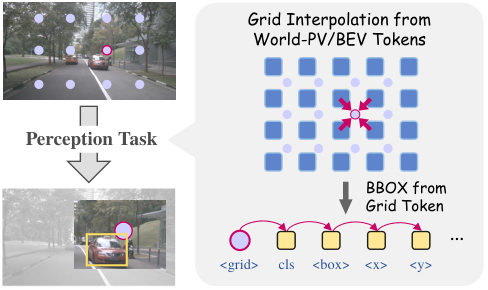
🔍 图 4 怎么读?
- 一张"机制特写图":说明 grid tokens 从哪里来、负责干什么;
- 关键点:grid tokens 是从 World-PV 或 World-BEV tokens 插值得到的(不是独立学习的新参数),每个 grid token 预测与其图像/BEV 坐标对齐的 box;
- 这样就保证了"感知的每一格都和空间位置绑定"——可定位性是这些 token 被称为"世界状态"而不是"临时特征"的根本原因。
⚙️ 模块三:World-Action(从感知到动作)
这是把"感知"变成"驾驶决策"的关键一步——感知-动作对齐。
3.3 四组点级轨迹查询
可靠的未来轨迹需要三种视角的信息:
- World-BEV tokens:准确的动态/静态上下文(物体在哪、路在哪);
- World-PV tokens:丰富的语义细节(这是红灯还是刹车灯);
- ego 状态:车辆运动学信息(速度、航向)。
为了让动作和这些特征完全对齐、避免过度依赖单一模态,论文设计了四组点级查询(每组 N 个轨迹点,随机初始化):
| Query | 注意力掩码 | 对齐的目标 | 作用 |
|---|---|---|---|
| Q_pv | 只看 PV token | 透视图像特征 | 语义/外观细节对齐 |
| Q_bev | 只看 BEV token | 鸟瞰特征 | 3D 空间上下文对齐 |
| Q_ego | 只看 ego 特征 | 自车状态 | 运动学约束对齐 |
| Q_full | 看所有特征 | 全局 | 解码最终轨迹 |
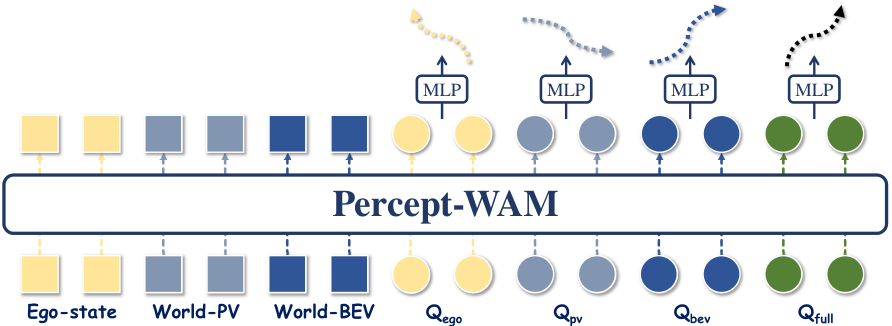
🔍 图 5 怎么读?
- 四个 query 集合 Q_pv / Q_bev / Q_ego / Q_full 各一行,每行是 N 个轨迹点;
- 注意力掩码:前三个 query 通过 mask 只能看自己对应的模态(PV 只看图像特征、BEV 只看鸟瞰特征、ego 只看自车状态),只有 Q_full 可以看全部特征;
- 解码:每个 query 集的特征经 MLP 解码成轨迹。训练时四组并行生成轨迹、用 Smooth-L1 监督;推理时只用 Q_full 的输出作为最终轨迹。
🎯 这个设计的妙处:前三个 query 是"专业分工",Q_full 是"综合裁决"。分组注意力掩码逼着模型分别学会"从图像看语义、从 BEV 看空间、从 ego 看运动",Q_full 再把它们综合——避免了轨迹只从单一模态推断的偏见。
3.4 流式推理(Streaming Inference)
自动驾驶要求实时性。Percept-WAM 引入流式 KV cache:轨迹预测 token 只关注最近两帧(T 和 T-1),历史帧的 KV cache 被复用,避免每帧全量 prefill。
但训练(定长视频片段)和推理(无限时序)的不一致会带来分布漂移,论文用三招应对:
- 更长片段训练:训练时用更长的视频片段,让模型学会依赖更长历史;
- Attention Sink + 双重重算(dual-recomputation):保留 attention sink 锚点稳定计算,同时对旋转位置编码(RoPE)做局部精炼 + 全局缓存重算,纠正跨帧 KV cache 的连续性;
- 周期性缓存 ViT token 并重算完整 KV cache:抑制长序列推理的错误累积。
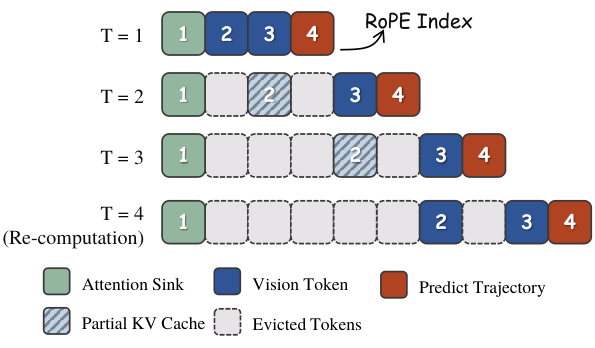
🔍 图 11 怎么读?
- (a) Streaming Attention Map:展示轨迹 token 的注意力窗口——每个预测时刻只看 T 和 T-1 两帧,历史被"压缩"进 KV cache;
- (b) Streaming Strategy:展示 KV cache 的结构——绿色块是 attention sink(锚点,固定保留),蓝色斜纹块是复用的历史帧 KV cache,白色数字是需要双重重算的 RoPE 位置编码。因为 attention sink 和历史帧之间的位置编码不连续,所以要重算来校正。
🎯 流式推理的收益(表 7):AR 解码时延 -16%、Query 解码 -40%,精度损失 <0.01——707ms 就能出一次轨迹。
📊 实验结果
5.1 主结果:NAVSIM v1 + nuScenes
| 方法 | nuScenes L2-1s↓ | L2-2s↓ | L2-3s↓ | Avg↓ | NC↑ | DAC↑ | TTC↑ | Comf↑ | EP↑ | PDMS↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| UniAD | 0.20 | 0.42 | 0.75 | 0.46 | 97.8 | 91.9 | 92.9 | 100 | 78.8 | 83.4 |
| VAD-Base/V2 | 0.17 | 0.34 | 0.60 | 0.37 | 97.2 | 89.1 | 91.6 | 100 | 76.0 | 80.9 |
| DiffusionDrive | 0.27 | 0.54 | 0.90 | 0.57 | 98.2 | 96.2 | 94.7 | 100 | 82.2 | 88.1 |
| DRAMA | — | — | — | — | 98.0 | 93.1 | 94.8 | 100 | 80.1 | 85.5 |
| Hydra-MDP | — | — | — | — | 98.3 | 96.0 | 94.6 | 100 | 78.7 | 86.5 |
| Percept-WAM | 0.17 | 0.35 | 0.63 | 0.38 | 98.7 | 97.8 | 93.2 | 92.8 | 84.4 | 88.6 |
| Percept-WAM* | 0.16 | 0.33 | 0.60 | 0.36 | 98.8 | 98.6 | 94.4 | 99.5 | 84.8 | 90.2 |
- Percept-WAM* 90.2 PDMS,超 DiffusionDrive 2.1;二阶段训练(感知增强基座再 E2E 对齐)带来 +1.6 提升;
- DAC 98.6、NC 98.8 全场最高——感知强了,可行驶区域合规直接受益;
- nuScenes 轨迹 L2 误差 0.36m(Avg),和 VAD 打平,显著好于 DiffusionDrive(0.57)——注意感知增强对轨迹精度的传导。
5.2 感知主结果(PV 2D/3D + BEV)
PV 感知(表 1):
| 任务 | Percept-WAM | 专有模型对比 |
|---|---|---|
| 2D 检测 nuImages | 49.9 mAP | Mask R-CNN 47.8 |
| 2D 检测 COCO | 51.7 mAP | LMM-Det 47.5 |
| 2D 实例分割 nuImages | 41.7 mAP | Mask R-CNN 38.6 |
| 单目 3D 检测 nuScenes | 33.0 mAP | FCOS3D 32.1 |
| 2D 语义分割 COCOstuff | 50.3 mIoU | — |
BEV 感知(表 4,nuScenes val):
| 方法 | 3D 检测 mAP | NDS | Dri IoU | Ped IoU | Lane IoU | Veh IoU |
|---|---|---|---|---|---|---|
| PointPillars | 0.523 | 0.613 | — | — | — | — |
| SECOND | 0.526 | 0.630 | — | — | — | — |
| BEVFusion | 0.685 | 0.714 | 85.5 | 60.5 | 67.7 | — |
| Percept-WAM | 0.589 | 0.645 | 87.0 | 70.9 | 62.7 | 60.2 |
💡 关键洞察:BEV 感知的意义不是"刷 SOTA"(论文明确说没想超过每个子任务的最优),而是增强 3D 空间理解来反哺规划——感知是手段,规划才是目的。
5.3 消融 1:IoU 置信度(表 5)
| 置信度方案 | AP | AP50 | AP75 |
|---|---|---|---|
| 基线(仅类分数) | 48.1 | 70.9 | 51.4 |
| + IoU(random-perturb) | 46.9 | 70.0 | 50.7 |
| + IoU(uniform model-pred) | 46.2 | 69.1 | 49.3 |
| + IoU(real model-pred) | 49.6 | 70.4 | 53.7 |
- 用真实模型预测分布构建置信度数据集 → +1.5 AP、+2.3 AP75;
- 随机扰动 / 均匀采样反而有害(-1~2 AP)——因为 IoU 分布不真实,学出来的置信度反而带偏检测。
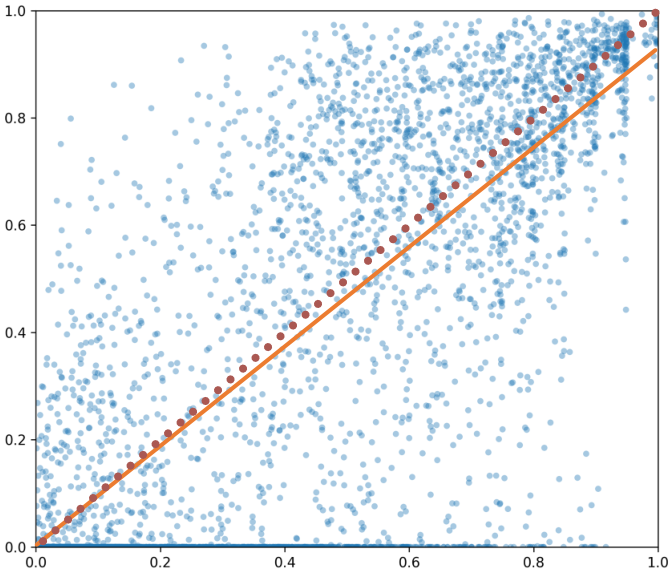
🔍 图 6(c) 怎么读?
- 横轴 = 预测置信度,纵轴 = 框与 GT 的 IoU;完美预测应该落在 y=x 对角线上;
- (a) 里大量点落在右下(低 IoU 但高置信度)→ 后处理滤不掉假阳性;
- (c) 用模型预测分布训练的 IoU 置信度让点整体贴近对角线 → 分数排序可靠,检测精度提升。
5.4 消融 2:BEV 3D 检测(表 6)
| 配置 | mAP | NDS |
|---|---|---|
| 基线(相机) | 25.0 | 25.7 |
| + LiDAR 编码器初始化 | 33.2 (+8.2%) | 32.2 |
| + 数据增强 | 41.3 (+8.1%) | 39.2 |
| + 网格分辨率(20→40) | 50.4 (+9.1%) | 46.6 |
| + MLP 并行(16× 加速) | 50.4 | 43.7 |
每个设计点都能带来 8-9 mAP 的提升;MLP 并行替换 AR 解码在保持 50.4 mAP 的同时加速 16 倍。
5.5 消融 3:轨迹解码方式(表 7)
| 解码机制 | L2 (avg)↓ | 时延 (ms)↓ |
|---|---|---|
| AR(轨迹当文本) | 0.3970 | 2700 |
| AR + 流式推理 | 0.4058 | 2209 |
| AR (cluster) | 0.3919 | 1470 |
| Query-base | 0.3822 | 1174 |
| Query-base + 流式推理 | 0.3839 | 707 |
- Query-base 解码精度和速度都最优(L2 0.3822,时延 1174ms);
- 流式推理再压 40%(→707ms),精度损失 <0.01——这就是"能上车"和"上不了车"的区别。
🔍 可视化:三个"效果图"
PV 感知效果(图 7)
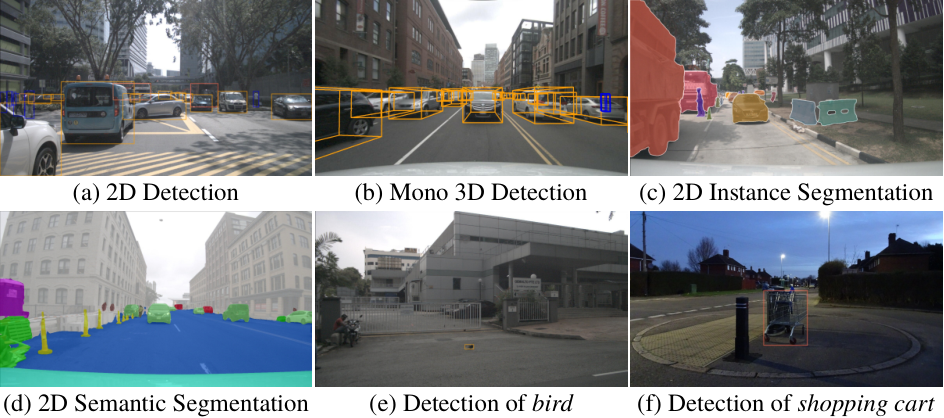
论文强调 PV 感知在拥挤场景、长距离、小目标下的稳定性和开放词汇能力——这正是 VLM 系检测器最常翻车的三类场景。
BEV 感知效果(图 8)

轨迹规划效果(图 9)
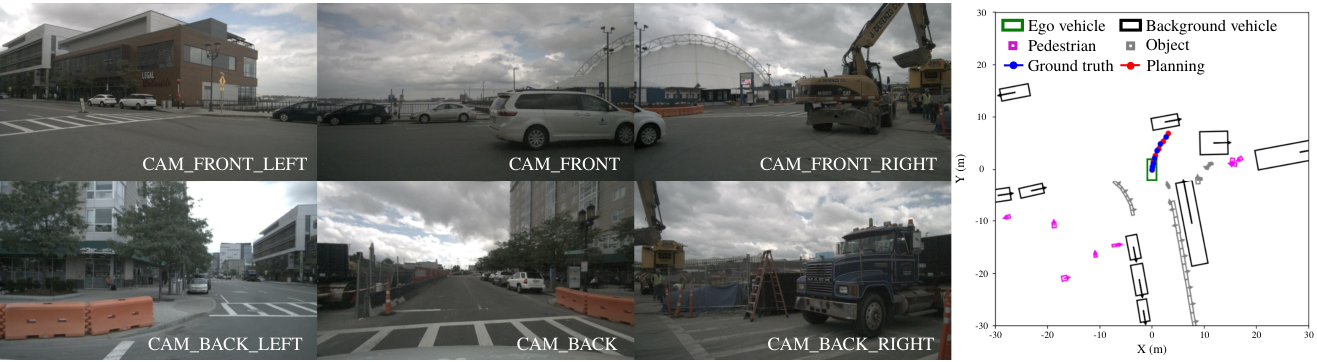
🎯 效果图的叙事逻辑:图 7 证明"看得清"(感知),图 8 证明"看得全"(3D 空间),图 9 证明"开得好"(规划)——三张图连起来正好是 World-Awareness-Action 的完整链路。
⚖️ 与 BrainWAM、SimWAM 的横向对比(WAM 系列三足鼎立)
这三篇是 2025-2026 年 WAM(World Action Model) 系列的三个代表,但"加强"的侧重点完全不同。先把 WAM 的特点讲清楚,再对比三者的差异。
先复习:WAM 到底是什么?
WAM(World-Action Model)= 世界模型(World Model)+ 动作(Action)。和纯 WM 的区别是:WM 只预测未来(不输出动作),WAM 把"未来预测"和"动作生成"焊在一起——通常用视频/未来状态作为动作预测的监督信号,让动作"懂物理"。
三家加强的重点完全不同
| 维度 | Percept-WAM | SimWAM | BrainWAM |
|---|---|---|---|
| arXiv | 2511.19221 | 2608.07468 | 2608.12854 |
| 时间 | 2025-11 | 2026-08 | 2026-08 |
| 会议 | CVPR 2026 | arXiv preprint | arXiv preprint |
| 要解决的问题 | VLM 空间感知弱 → 感知不稳拖垮规划 | 训练时视频监督 + 推理时删视频的 gap | VLA 语义和 WAM 预测"融合打架" |
| 加强的模块 | 感知(World-PV/World-BEV token) | 训练(Flow-GRPO 强化) | 协调(CAB/CIF 动作空间融合) |
| 世界建模方式 | 无显式视频生成(感知即世界) | 视频生成(Wan2.2)监督动作 | 视频生成(Wan2.2)预测通路 |
| 语义/语言先验 | ✅ VLM 本体(InternVL2-8B) | ❌ 无 | ✅ 独立 VLA 通路(Qwen3-VL-4B) |
| 轨迹解码 | 四组 query 并行 + MLP | rectified-flow DiT | rectified-flow action expert |
| 是否 RL | ❌(未来计划) | ✅ Flow-GRPO | ❌ |
| NAVSIM v1 | 90.2 PDMS | 91.5 PDMS | 89.5 PDMS |
| 推理时延 | 707ms(流式) | ~100ms(删视频) | 475ms(1步视频) |
三家对比:核心差异一句话
- Percept-WAM:感知派——“规划要稳,先让模型把世界’看’清楚”。它不给模型加视频生成或 RL,而是把 2D/3D 感知直接长进 VLM(World token),用更强的空间表示喂规划。世界模型的理解是"感知即世界"(没有显式未来生成)。
- SimWAM:训练派——“模型结构是死的,训练方法是活的”。它用 Flow-GRPO(强化学习) 在 NAVSIM 场景上直接优化轨迹质量,配合训练期视频监督,训练完把视频分支删掉换推理效率。91.5 PDMS 是目前 NAVSIM v1 的天花板。
- BrainWAM:协调派——“单打独斗不如协同作战”。它保留 VLA 语义通路 + WAM 预测通路两条特化通路,通过 CAB(动作空间桥)+ CIF(意图融合) 在动作层协调,既保留语义先验又保留预测动态。89.5 PDMS / 89.6 EPDMS 双榜 SOTA。
一句话总结 WAM 系列的演进脉络
WAM 系列三篇的演进脉络(增强手段不同,方向互补):
- Percept-WAM(CVPR'26,感知增强):世界状态(World token)内嵌,让规划吃到更好的感知;
- SimWAM(2026-08,训练增强):Flow-GRPO 强化,直接优化轨迹质量,拿到 NAVSIM v1 91.5 的天花板;
- BrainWAM(2026-08,结构增强):双通路 + 动作空间协调,让语义和预测互补,双榜 SOTA。
三个方向恰好代表 WAM 设计的三大杠杆:
- 输入侧(Percept-WAM):让模型"看得更好"——世界状态建模;
- 目标侧(SimWAM):让模型"学得更狠"——RL 直接优化驾驶质量;
- 结构侧(BrainWAM):让模型"配合得更好"——多通路动作空间协调。
三者不冲突,未来大概率是组合拳:Percept-WAM 的世界 token + SimWAM 的 RL + BrainWAM 的动作空间协调,可能才是完整形态。
⚠️ 优势与局限
✅ 优势
- 感知-规划真正共享骨架:2D/3D 感知和轨迹预测在同一个 VLM 里联合优化,感知精度提升直接传导到规划(表 3 里 Percept-WAM* 比单阶段 +1.6 PDMS);
- 置信度校准创新扎实:IoU-aware 置信度解决了 LLM 检测系统性过度自信的问题,可视化(图 6)和消融(表 5)双重验证;
- 四组 query 的分组注意力对齐:Q_pv/Q_bev/Q_ego/Q_full 避免轨迹过度依赖单一模态,同时保留综合裁决;
- 工程可落地:流式推理 707ms、MLP 并行 16× 加速,距离"上车"很近;
- 开放词汇:分类走文本 token,天然支持开放词汇检测/分割,长尾鲁棒。
❌ 局限
- 没有显式未来生成:Percept-WAM 的"世界"是感知出来的当前世界,不是预测出来的未来世界——这跟 SimWAM/BrainWAM 的"视频生成"路线是两码事,缺少对"未来动态"的显式建模;
- 没有 RL:轨迹质量完全依赖模仿学习,论文自己也说未来要用 RL(离线/在线)联合优化感知和规划;
- 数值对比的微妙点:NAVSIM 90.2 是 v1 的 PDMS,且论文用的是"从静态轨迹词表打分选优"(借鉴 Hydra-MDP),和端到端逐帧生成的对比口径要小心;
- 感知是"手段",但感知本身仍有天花板:BEV 3D 检测 58.9 mAP 仍低于 BEVFusion(68.5),论文承认"不追求每项感知 SOTA,只为增强 3D 理解";
- 模型体量:InternVL2-8B + 多任务联合训练,显存和训练成本不低。
📝 个人思考
这篇的价值在于把"感知"重新放回了 WAM 讨论的中心。2026 年的 WAM 热潮基本被"视频生成 + 动作"主导(SimWAM、BrainWAM 都在谈未来帧),而 Percept-WAM 提醒我们:世界动作模型,动作靠的首先是"对世界的准确感知"。VLM 的空间感不行,再好的生成式规划器也是空中楼阁。
三个让我眼前一亮的点:
“World token” 这个概念很本质。把感知输出(检测框、分割 mask)从"一次性模块输出"升级成"可定位、可复用、带置信度的世界状态 token",并且和动作 token 在同一个注意力空间对齐——这比传统的"感知头 → 向量 → 传入规划器"干净得多,还支持 KV cache 复用(流式)。感知不是插件,是模型世界观的一部分。
IoU 校准置信度解决了"训练-推理不一致"这个隐蔽问题。MLLM 检测的假阳性往往不是"检测错了",而是"置信度不可信"。用模型自己预测的 IoU 分布来做监督数据(而不是从 GT 扰动),这个细节非常工程——真实分布比构造分布重要。
四组 query 的分组掩码 = 隐式 Mixture-of-Experts。Q_pv/Q_bev/Q_ego 各自只看自己模态,Q_full 综合裁决——本质上是用注意力掩码实现"模态路由",和 MoE 的"专家路由"哲学同源。作者在局限里也说未来要上显式 MoE。
下一步最值得关注:①Percept-WAM + SimWAM 的 Flow-GRPO(感知增强的世界 token 做 RL 状态,探索空间更大);②Percept-WAM + BrainWAM 的"未来生成"(感知当前世界 + 预测未来世界一起喂轨迹);③感知精度对闭环(Bench2Drive 反应式)的影响量化——NAVSIM 非反应式协议下感知误差不传导,闭环才是真正的考场。
关联阅读:这篇和 BrainWAM 精读(双通路动作协调)、SimWAM 精读(Flow-GRPO 强化)正好构成 WAM 系列的"三驾马车",分别代表感知增强、训练增强、结构增强三个方向。往前追溯还能串起 Metis 精读(非对称注意力掩码解耦)、DiffusionDrive 精读(NAVSIM 的直接对手)、以及 UniAD-端到端自动驾驶框架精读(planning-oriented 感知的思想源头)。
📖 论文精读系列。Percept-WAM(arXiv:2511.19221,CVPR 2026,引望智能 × 复旦大学)是"感知增强型 WAM"的代表作——与 SimWAM(训练增强,arXiv:2608.07468)、BrainWAM(结构增强,arXiv:2608.12854)对照阅读,可以看清 2026 年 WAM 设计的三大杠杆:让模型看得更好、学得更狠、配合得更好。