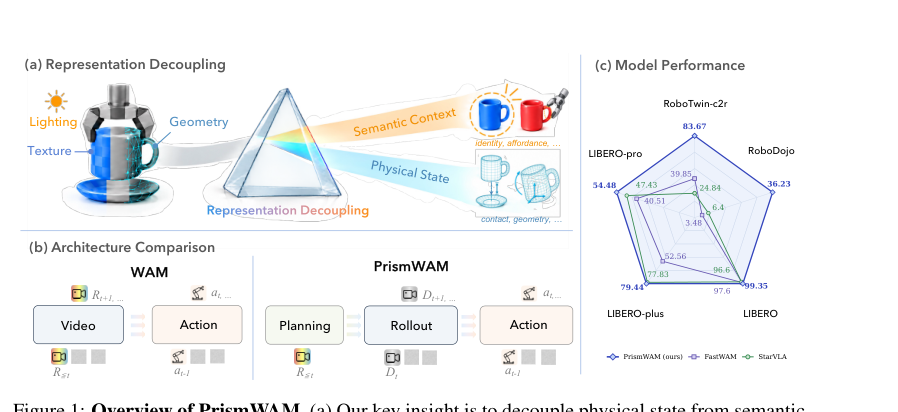
配图说明:本文收录论文全部 6 张插图(Figure 1 ~ Figure 6),放在站内 /images/prismwam/,逐张讲解,文末附图表总索引表。论文来自清华大学与 NVIDIA,arXiv 2610.26564(2026-10-19),项目页 prism-wam.github.io。这是一篇「提一个表征原则 + 认真做消融」的论文:单点主张(状态表示要解耦)非常清晰,五个仿真基准 + 真机 + 鲁棒性实验都围绕它展开。
📄 论文信息
- 标题:PrismWAM: Decoupling State Representations in World Action Models
- 机构:清华大学、NVIDIA
- 时间:2026-10-19(arXiv 2610.26564 v1)
- 关键词:世界行动模型(WAM)、状态表征解耦、语义规划、深度物理推演(physical rollout)、Mixture-of-Transformers、链式注意力(chain attention)、数据效率
- 一句话总结:视频 latent 不是 WAM 的好状态。它把「外观/纹理/颜色」(动作不变量、纯语义)和「几何/位姿/占据/接触」(动作可直接改变的物理量)揉成一团。PrismWAM 让 RGB 流做语义规划(训练期预测一张目标图当老师),深度流做物理推演(细粒度几何演化),动作塔只吃深度 rollout——「做什么 → 世界怎么变 → 怎么动」三层链条,各司其职。
🎯 一句话版本:核心数字
| 基准 | PrismWAM(5B) | PrismWAM*(15B) | 无预训练基线最好 | 有动作预训练最好 |
|---|---|---|---|---|
| RoboTwin-C2R(成功率) | 70.57% | 83.67% | FastWAM 39.85% | OpenWAM-α 69.05% |
| RoboDojo(得分/SR) | 25.10 / 18.55% | 36.23 / 29.30% | starVLA 6.40 | InternW0-Δ 30.77 |
| LIBERO(成功率) | 99.35% | – | 4D-WAM 98.60% | OpenWAM-α 99.30% |
| LIBERO-Plus(扰动版) | 79.44% | – | – | π0.5 84.76% |
| LIBERO-Pro(反记忆版) | 54.48% | – | FastWAM 40.51% | π0.5 57.16% |
| 真机三任务(ID / OOD) | 88.9% / 68.6% | – | – | OpenWAM-α 74.1% / 48.6% |
两个 Sony 式的注脚:其一,没有任何动作预训练——PrismWAM/PrismWAM* 的动作预训练小时数是 0 h,对照的 OpenWAM-α ≈ 6,400 h、Xiaomi-Robotics-1 100,000+ h、π0.5 10,000+ h;二是物理侧也只用约 2,300 小时深度数据(AgiRobotWorld-Beta 深度 + RoboTwin 仿真深度)训练了一个深度 VAE。
🧭 读前 5 分钟:五个概念
- 视频 latent 的纠缠。现有 WAM(OpenWAM、Cosmos 系、DreamZero 等)普遍用预训练视频生成模型的 latent 表示世界状态。它同时编码「外观」(颜色、纹理、光照——抓取这些动作基本改不了)与「物理状态」(几何、位姿、接触、占据——唯一能被动作改变的量)。动作生成被迫在这个纠缠空间里同时解两道题。
- 语义规划(semantic planning):从 RGB 历史帧推断「这一串动作做完后世界应该是什么样」。PrismWAM 用单一远期目标帧 r_F(clean 版 t+32、LIBERO 版 t+16)做监督,而且只在训练期存在——推理时 RGB 流只编码历史帧、缓存语义特征,不生成任何未来 RGB。
- 物理推演(physical rollout):以当前深度 d0 为起点,预测未来深度序列 d1:F。深度编码距离而非外观,天然对光照/纹理不敏感,且与 RGB 空间对齐、容易采集。
- 链式注意力(chain attention):信息只单向流——动作塔只读深度(观测+未来),不许直接看 RGB;深度流只读观测到的 RGB,不许读未来 RGB;RGB 不读深度也不读动作。这是「解耦」在架构层的落点:动作不可能走捷径抄语义信息。
- MoT 架构(Mixture-of-Transformers):RGB 流、深度流、动作塔各自有独立参数的投影/条件/输出头,视觉两流共享 Transformer 块,动作塔独立参数化,任务文本/本体状态经 T5/线性层变成上下文 C 供三流交叉注意。
🔍 问题:单一视频 latent 承担了两个不相容的职责
回到 Figure 1,这次看细节:
(a) 表征解耦:同一个场景被拆成两条轴——「光照/纹理/外观 → 语义语境」(identity、affordance,动作不变量)与「几何/接触 → 物理状态」(动作-induced 的量)。注意论文的措辞:这不是「有用 vs 无用」,而是**「动作改变不了的信息 vs 帮助理解动作对象的信息」**。
(b) 架构对比:传统 WAM 是 视频 R≤t → Action,一个 latent 空间既出视频又出动作;PrismWAM 是 Planning(R≤t) → Rollout(Dt) → Action——语义把「做什么」交给深度推演,深度把「世界如何回应」交给动作。
(c) 五基准雷达:RoboTwin-c2r 47.43 / RoboDojo 3.4 / LIBERO-pro 41.01 / LIBERO-plus 77.83 / LIBERO 99.35 这几根尖刺(PrismWAM* 更高),同图对比 starVLA 与 FastWAM 两个无动作预训练基线,轮廓差距一目了然。
问题的具体危害(论文没画,但贯穿全文):RGB 里物体的身份/颜色对预测动作没直接贡献,却占据了带宽;真正需要的位姿/接触得从外观变化里反推——外观不变而位姿变(遮挡)、外观变而位姿没变(光照)都会误导。这就是后面 LIBERO-Plus 上「Layout 扰动」和 RoboDojo「Precision 类」差距来源。
🛠️ 方法:三层链条 + 稀疏/密集双时间监督
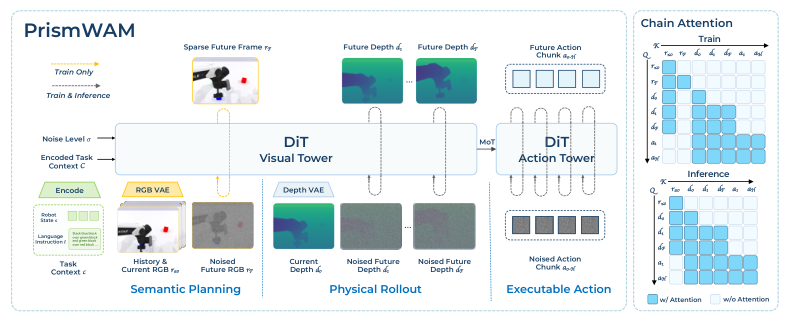
Figure 2 左半是训练视图,右半是 train / inference 两套注意力 mask。
稀疏–密集的时间不对称
- RGB 流(语义规划):历史 r≤0 打包成一个 causal clip,目标只有一张未来帧 r_F(一张 latent 帧)。风险集中在语义对,噪声集中在目标帧;
- 深度流(物理推演):当前 d0(干净)+ 未来 d1:F(加噪,9 帧深度 clip / LIBERO 用 5 帧)。这是逐帧监督的稠密目标,中间几何状态全部可学;
- 动作塔:归一化动作块 a1:H(RoboTwin 14 维绝对关节角 / LIBERO 7 维 EE 增量 / RoboDojo 14 维绝对关节),每步一个 token,独立参数化的动作块,噪声水平 σ_A 单独给;
- 三条流共享 MoT 结构但各自有 σ_R、σ_D、σ_A 的噪声嵌入,flow matching 损失 L = L_R + L_D + L_A 逐模态加权求平均(w(σ) 按 exp[−2(σ−1/2)²] 加权)。
链式注意力(右图)
| Token 组 | 能读 | 不能读 |
|---|---|---|
| RGB 流 | 观测 RGB(自读 + 互读)+ 上下文 C | 未来 RGB(观测→未来单向) |
| 深度流 | 观测 RGB 特征 + 自身 + C | 未来 RGB / 动作 |
| 动作塔 | 深度(观测 + 未来 rollout)+ C | 任何 RGB(含观测与未来) |
推理时(右下):RGB 流编码 r≤0 一次缓存特征,不再生成未来 RGB;深度/动作从与此同时高斯噪声开始联合去噪;深度 latent 可以解出来看,但动作生成用的是中间 rollout 特征,不需要解码深度图。执行前缀 24/32 后再规划。
训练两段式
- 深度适配段:把 Wan2.2-5B 骨干调到深度空间——只用「当前深度 + 语言 → 深度序列」的深度预测损失训练 15k 步;
- 联合训练段:RGB + 深度 + 动作同时训练 15k(RoboDojo 40k)步,全局 batch 256(RoboDojo 1024)。VAE(深度 VAE 从 Wan VAE 初始化,2,300 小时深度语料预训练,frozen)与 T5 全程冻结。
一句话:语义用手把手带物理,物理推着动作;推理时老师退场。
🧪 实验一:五个仿真基准
1. RoboTwin-C2R:clean 训练,clean+random 评估
50 任务 × 100 episodes,clean-only 训练后评估(Table 1):
| 方法 | 动作预训练 | Clean | Rand. | Avg. |
|---|---|---|---|---|
| starVLA | 0 h | 46.52 | 3.16 | 24.84 |
| FastWAM | 0 h | 77.80 | 1.90 | 39.85 |
| π0.5 | 10,000+ h | 70.70 | 46.00 | 58.35 |
| OpenWAM-α | ≈6,400 h | 89.40 | 48.70 | 69.05 |
| X-WAM | – | 70.00 | 25.80 | 47.90 |
| Spatial-Forcing | – | 77.20 | 26.74 | 51.97 |
| 4D-WAM | – | 81.50 | 41.80 | 61.65 |
| ME-Dex-1.0(排行榜) | – | – | – | 81.0 |
| PrismWAM | 0 h | 87.98 | 53.16 | 70.57 |
| PrismWAM* | 0 h | 91.84 | 75.50 | 83.67 |
关键读法三行:
- 随机化鲁棒性:FastWAM 77.80→1.90 崩得残忍;π0.5/OpenWAM-α 掉一半;PrismWAM 只掉 34.8 个点、PrismWAM* 掉 16.3 个点。
- 打败预训练:无预训练的 PrismWAM 均值 70.57% > OpenWAM-α 69.05%;PrismWAM* 83.67% 超过 RoboTwin 官方榜首 ME-Dex-1.0(81.0)。
- 光谱信息帮了谁:X-WAM/Spatial-Forcing/4D-WAM 这些「把几何塞进输入或拉平」的方法(47.9–61.7%)都不如「把几何当独立流 + 解耦」(PrismWAM)。
2. RoboDojo:五类综合得分
42 个 canonical 任务(54 entries)、5 个类别平均三 seed(Table 1):
| 类别 | PrismWAM 得分/SR | PrismWAM* 得分/SR | OpenWAM-α |
|---|---|---|---|
| Generalization | 27.01 / 19.56% | 36.71 / 29.33% | 20.71 / 14.83% |
| Precision | 28.70 / 19.50% | 39.82 / 31.08% | 18.45 / 9.25% |
| Long-horizon | 37.39 / 22.08% | 48.67 / 31.00% | 34.93 / 25.33% |
| Memory | 30.46 / 30.11% | 50.96 / 50.67% | 10.41 / 9.11% |
| Open | 1.92 / 1.50% | 4.98 / 4.42% | 1.41 / 1.08% |
| Overall | 25.10 / 18.55% | 36.23 / 29.30% | 17.18 / 11.92% |
Precision 上 PrismWAM* 的 SR 31.08% vs OpenWAM-α 9.25%——差 21.8 个点;这一类全是拧螺丝、放硬币、插钥匙级别的精细活,正是深度空间表达接触几何的优势所在。Open 类(自然语言组合泛化)大家都在泥潭里,PrismWAM* 也只有 4.98。
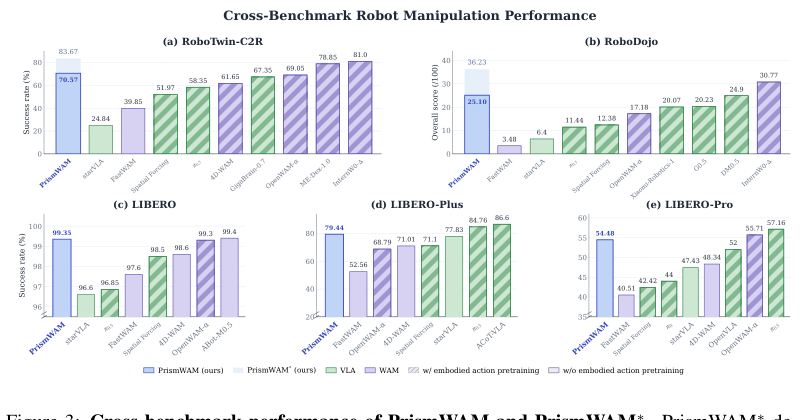
Figure 3 五张柱状图交叉验证:斜纹条 = 用了具身动作预训练的模型。LIBERO-Plus 值得注意——PrismWAM 79.44 其实低于 π0.5 84.76 和 ACoT-VLA 86.6(论文内文与雷达图中都承认),亮明它的强项是「随机化场景 + 精细任务」而非「哲学/语义类扰动」的对抗;LIBERO-Pro 里 Object 属性扰动 88.65% 是第一,Position 扰动(6.55%)与 Sem(23.45%)是短板。
3. LIBERO 三件套
| 基准 | PrismWAM | π0.5 | OpenWAM-α | starVLA | 4D-WAM |
|---|---|---|---|---|---|
| LIBERO 四套件 Overall | 99.35% | 96.85% | 99.30% | 96.60% | 98.60% |
| LIBERO-Plus Overall | 79.44% | 84.76% | 68.79% | 77.83% | 71.01% |
| LIBERO-Pro Overall | 54.48% | 57.16% | 55.71% | 47.43% | 48.34% |
LIBERO 本体四套件几乎拉满(Object 100.00%、Long 99.80%);LIBERO-Plus / LIBERO-Pro 两处「反记忆化」基准上则以 π0.5 为先,PrismWAM 在 Object 扰动(88.65%)单项领先、在 Position(6.55%)与 Sem(23.45%)两项上失守——语义理解不是深度流能补的短板。
🔬 鲁棒性与消融
4. 深度被污染会怎样(RQ2)
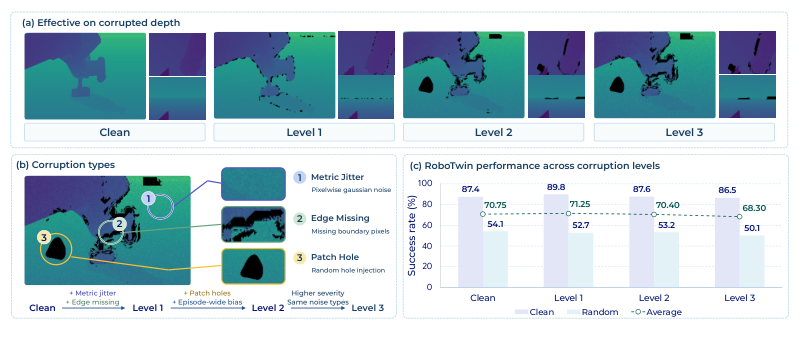
真实深度相机有两类毛病:距离相关的测距噪声 + 深度不连续处的边缘缺失 + 随机洞。作者按 Orbbec Gemini 335 / RealSense D435 的参数设计三级腐蚀(顶部图给出可视化,左下是腐蚀配方):
| 级别 | 度量抖动 σ0/σ1 (mm) | 整段偏移 (mm) | 边缘缺失半径 | Clean / Random / Avg |
|---|---|---|---|---|
| Clean(无腐蚀) | 0/0 | 0 | – | 87.40 / 54.10 / 70.75 |
| 无腐蚀均值 | – | – | – | 70.75 / 71.25 / 70.40 / 68.30 |
| Level 3(最重) | 36/60 | [−50, 50] | 7px | 86.50 / 50.10 / 68.30 |
平均只从 70.75 掉到 68.30(−2.45 pp)。Level 1 下 Clean 甚至升到 89.8——轻微噪声反而像正则。深度确实不是娇贵模态。
5. 六组消融(RQ3)
50 RoboTwin 任务、每格 20 episodes(Table 3 / A.3 完整版):
| 消融 | Clean | Random | Avg. | Δ (pp) |
|---|---|---|---|---|
| PrismWAM(全) | 87.40 | 54.10 | 70.75 | – |
| w/o RGB 流 | 79.10 | 40.10 | 59.60 | −11.15 |
| w/o depth 流 | 83.00 | 2.40 | 42.70 | −28.05 |
| 观测 RGB → 动作(直连) | 89.10 | 40.30 | 64.70 | −6.05 |
| 未来 RGB → 深度(旁路) | 87.00 | 50.00 | 68.50 | −2.25 |
| w/o 未来 RGB 监督 | 81.60 | 51.40 | 66.50 | −4.25 |
| w/o 深度适配段 | 89.30 | 24.70 | 57.00 | −13.75 |
几个值得咀嚼的模式:
- w/o depth 流最惨(−28.05),Random 只剩 2.4%——没有物理推演,随机化场景直接趴窝,验证「深度 = 动作变量的载体」;
- w/o RGB 流也掉 11 点——没有语义规划,clean 还行(79.10)但泛化下滑,两条流都必要;
- 动作直连 RGB(−6.05)与未来 RGB 旁路(−2.25)说明链式路径(语义 → 物理 → 动作)比「动作抄近道」更能泛化——纯 clean 好成绩是过拟合假象;
- w/o 深度适配段 −13.75、Random 剩 24.7%:先把骨干调到深度空间这个「预热」很重要。
🧪 实验二:真机
6. 真机谱系定位
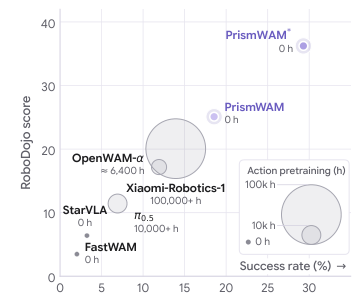
Figure 5 是一张漂亮的「数据效率」图:横轴 RoboDojo 成功率、纵轴综合得分,气泡大小 = 具身动作预训练小时数(10k h、100k h、≈6.4k h、0 h 的图例在右下角)。π0.5、OpenWAM-α、Xiaomi-Robotics-1 都带着大气泡落在左下,PrismWAM 与 PrismWAM* 两个 0 h 小气泡飘在右上——0 小时动作预训练压过 10 万小时级对手,佐证「结构设计可以换算成数据效率」。
7. Piper-X 真机三任务
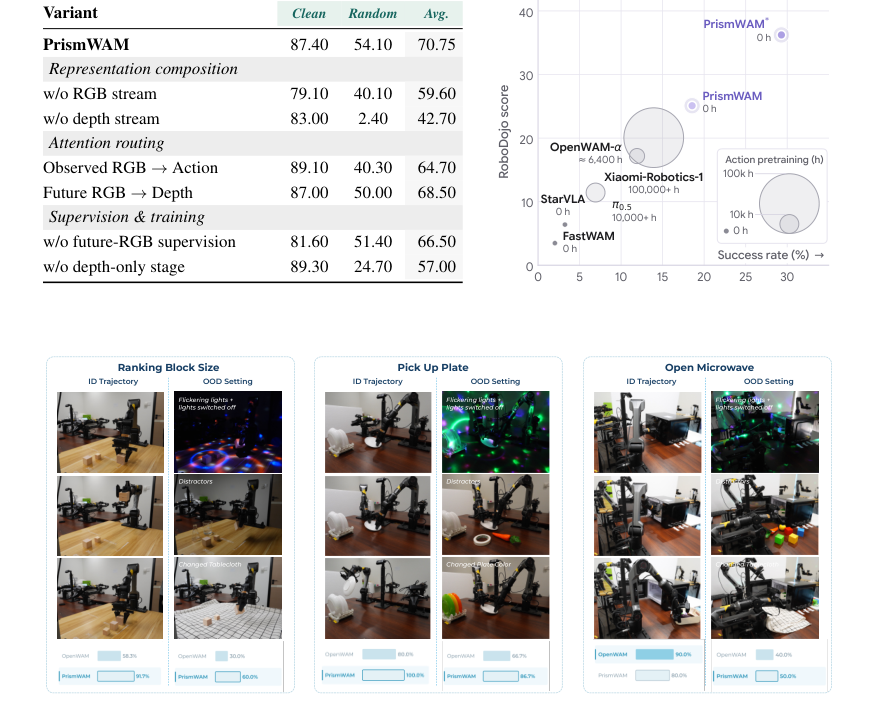
单臂 + 双臂 Piper-X + 头部单目 RGB-D(Orbbec Gemini 335;无腕部深度时用单独训练的头部深度 VAE)。三个任务:Pick Up Plate(双臂端盘子上架)、Ranking Block Size(把大中小方块按远近排序)、Open Microwave(开门 + 把篮子端出来)。OOD 扰动 = 频闪 + 关灯 + 换桌布/盘色 + 加干扰物(Figure 6 上排三个任务的 ID/OOD 对照,底部是 OpenWAM vs PrismWAM 的 SR 条形)。
| 任务 | OpenWAM-α ID | OpenWAM-α OOD | PrismWAM ID | PrismWAM OOD |
|---|---|---|---|---|
| Pick Up Plate | 4/5 (80.0%) | 10/15 (66.7%) | 5/5 (100.0%) | 13/15 (86.7%) |
| Ranking Block Size | 7/12 (58.3%) | 3/10 (30.0%) | 11/12 (91.7%) | 6/10 (60.0%) |
| Open Microwave | 9/10 (90.0%) | 4/10 (40.0%) | 8/10 (80.0%) | 5/10 (50.0%) |
| Pooled | 20/27 (74.1%) | 17/35 (48.6%) | 24/27 (88.9%) | 24/35 (68.6%) |
ID +14.8 / OOD +20.0 个点的双侧胜利;唯一例外是 ID 下 Open Microwave(OpenWAM 90.0% > 80.0%)——开门 + 拿篮子多步时序活,OpenWAM-α 的 EE 目标表示更顺手。拓宽 OOD 场景光照/干扰时深度流不吃光照那条优势被兑现。
💡 评析:一个原则,三个亮点,四条边界
三个最妙的地方
- 决定 SOTA 的是「状态该怎么定义」而不是「数据堆多少」。全文最贵的一个点是把「video latent = world state」这个社区默认拆成两个流——直接说服力在于 RoboDojo 0 h 气泡落点(Figure 5):不是蒸馏、不是缩放,而是『模型在非纠缠空间里学习用更少的输入把物理搞准』。
- 链式注意力是「解耦」在架构上的肌肉。消融里「观测 RGB → 动作直连」clean 反而更好(89.10)但 Random 掉到 40.3——直连抄近道带来过拟合;链式 mask 吃掉这个小聪明换 30.5 的 Random 提升,这是一个非常漂亮的 mask-vs-overfit 案例。
- 鲁棒性证明得体。深度腐蚀三级实验(−2.45 pp)回答了「深度是娇贵模态」这个最自然的质疑;真机 OOD +20 pp 把仿真里的库改光照鲁棒性落地。
四条边界
- LIBERO-Plus / LIBERO-Pro 不是冠军(π0.5 与 ACoT-VLA 更高):语义/语言类扰动依然是 VLA 的主场,PrismWAM 的深度流在「指令纠偏」上帮不上忙;
- Open 类几乎零分(4.98):开放式自然语言组合任务上这一代 WAM 有共同天花板,与表征选择无关;
- 真机深度接入有前提:头部单 RGB-D 相机换成「头部或者说腕部」都要重新拿深度 VAE,部署依赖多传感器的可用性;当深度是合成或估出来的时候这条优势会缩水;
- 两个「SOTA」要分开读:PrismWAM 主模型是 5B、PrismWAM* 是 15B + video-only 预训练。跨模型比数字(83.67 vs 69.05)要记住「*」意味着额外算力投入。
🗺️ 在 WAM 表征谱系里的位置
| 路线 | 代表 | 对状态的假设 | 代价/风格 |
|---|---|---|---|
| RGB-only 世界模型 | OpenWAM、Cosmos 系 | latent 里自含物理 | 外观主导,Masking 重要 |
| 空间信息「混入」 | 4D-WAM、X-WAM、Spatial-Forcing | 给输入/latent 加几何辅助 | 与语义纠缠不解耦 |
| 状态解耦(本文) | PrismWAM | 语义/物理分属两个流 | 需要深度传感器/深度 VAE |
| 放弃显式视频 | Fast-WAM / GigaWorld-Policy | 未来预测仅作训练信号 | 推理时不产视频 |
| 评测基准 | X2Real、WorldOracle | 把「动作→世界」的预测质量本身拿去测 | 服务其他 WAM 的标尺 |
站内延伸:《WorldOracle 精读》(怎么测「动作-世界」预测质量)、《UniWAM 精读》(多本体统一训练)、《LoopWAM 精读》(闭环强化)、《Flash-WAM 精读》(推理加速)、《X2Real 精读》(仿真评测基准)、《WAM 世界行动模型全景分析》。
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 解耦原则 + 架构对比 + 五基准雷达 | 开篇、问题 |
| Fig 2 | MoT 双流架构与链式注意力(train/inference mask) | 方法 |
| Fig 3 | 五基准主结果柱状图(含 PrismWAM*) | 实验 1–3 |
| Fig 4 | 深度腐蚀类型 / 等级 + RoboTwin 性能曲线 | 鲁棒性 4 |
| Fig 5 | RoboDojo 得分-成功率气泡图(预训练时长 vs 性能) | 实验 6 |
| Fig 6 | 真机三任务 ID/OOD setting 与成功率 | 真机 7 |
表格:Table 1 RoboTwin-C2R + RoboDojo(实验 1–2)、Table 2 LIBERO 三件套(实验 3)、Table 3 消融(消融 5)、Table 4 真机(真机 7)、Table 5 训练配置(附录 A.1)、Table 8 深度腐蚀参数与成功率(鲁棒性 4)、Table 12 RoboTwin per-task、Table 13–14 RoboDojo per-task。
❓ 自测 Q&A
Q1:为什么说视频 latent 是「纠缠」的状态? A:它同时编码动作不变量(纹理、颜色、光照——动作改变不了)和动作可变量(位姿、接触、占据——动作唯一能改变的)。动作生成在这一团里要自己分家:既要抑制语义噪声、又要从外观变化里反推物理变化。PrismWAM 的主张是干脆让两个流分家。
Q2:语义规划的产出(未来 RGB r_F)推理时用到了吗? A:没有。RGB 流只用于训练:未来帧监督让老师学到「目标画面」的表征;推理时 RGB 流只编码历史帧并缓存特征作语义引导,不生成未来 RGB,省掉了视频生成这一整条耗时链。
Q3:动作塔为什么不许直接看 RGB? A:链式注意力强制「,动作 ← 深度 ← 观测 RGB」。消融证明取消这条链的「动作直连 RGB」版 clean 更高(89.10)但 Random 掉到 40.30;「未来 RGB → 深度」旁路也掉 2.25。直连是过拟合捷径,链式 mask 保泛化。
Q4:PrismWAM 用了多大的深度数据?为什么说它数据高效? A:策略训练用各基准演示(2,000–3,500 条);物理侧额外成本是一个 2,300 小时深度语料(AgiBotWorld-Beta 0.75 + RoboTwin 0.25)训练的深度 VAE。对照的具身动作预训练量级:OpenWAM-α ≈ 6,400 h、π0.5 10,000+ h、Xiaomi-Robotics-1 100,000+ h,而 PrismWAM 动作预训练是 0 h。
Q5:深度被腐蚀时性能掉多少?哪个腐蚀类型最伤? A:Level 3(最重)平均只掉 2.45 个点(70.75→68.30);Random 低 4 个点。度量抖动/边缘缺失/随机洞三类腐蚀中,Clean 条件下 Level 1 反而+2.4 个点——轻微噪声像正则。
Q6:这篇工作对「下一步 WAM 怎么做」给出了什么路线图? A:把「物理状态」从一个假想的丰富模态变成一等公民:占据、光流、触觉、本体感觉都可以替代深度当物理载体。作者明说这是 WAM 从「怎么长什么样」转向「对动作怎么回应」的第一步。
📚 资源与延伸
- 论文:arXiv 2610.26564
- 项目页:prism-wam.github.io
- 关键前作:Wan 2.2(arXiv 2503.20314)、OpenWAM(arXiv 2609.07398)、Fast-WAM(arXiv 2603.16666)、starVLA(arXiv 2604.05014)、AgiBot World(arXiv 2503.06669)、RoboTwin 2.0(arXiv 2506.18088)、RoboDojo(arXiv 2607.04434)、DepthVLA(arXiv 2510.13375)
- 站内延伸:《WorldOracle 精读》、《UniWAM 精读》、《LoopWAM 精读》、《HexaShell 精读》、《X2Real 精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》