📄 论文信息
- 标题:ReCogDrive: A Reinforced Cognitive Framework for End-to-End Autonomous Driving
- 来源:华中科技大学 × 小米汽车(Xiaomi EV)
- arXiv:2506.08052
- 代码:github.com/xiaomi-research/recogdrive
- 模型:HuggingFace Collection
- 一句话总结:VLM 负责"理解与推理",扩散模型负责"生成轨迹",DiffGRPO 强化学习负责"安全优化",三者合一。
🤔 要解决什么问题?
现有把 VLM 用于自动驾驶的方法有三个致命问题:
| 问题 | 具体表现 | 后果 |
|---|---|---|
| 领域差距 | VLM 在通用互联网数据上预训练,缺乏驾驶领域知识 | 长尾场景泛化差 |
| 模态错配 | VLM 输出的是离散文本 token,但驾驶需要连续动作 | 格式错误、不可行动作、推理慢 |
| 模仿学习次优 | 只靠行为克隆(BC),无法超越专家数据 | 罕见场景容易出事故 |
核心矛盾:VLM 会"想"但不会"开"——它能把场景描述得很清楚,但直接让它输出方向盘角度,要么格式不对,要么数值不合理。
💡 核心思路:三分天下
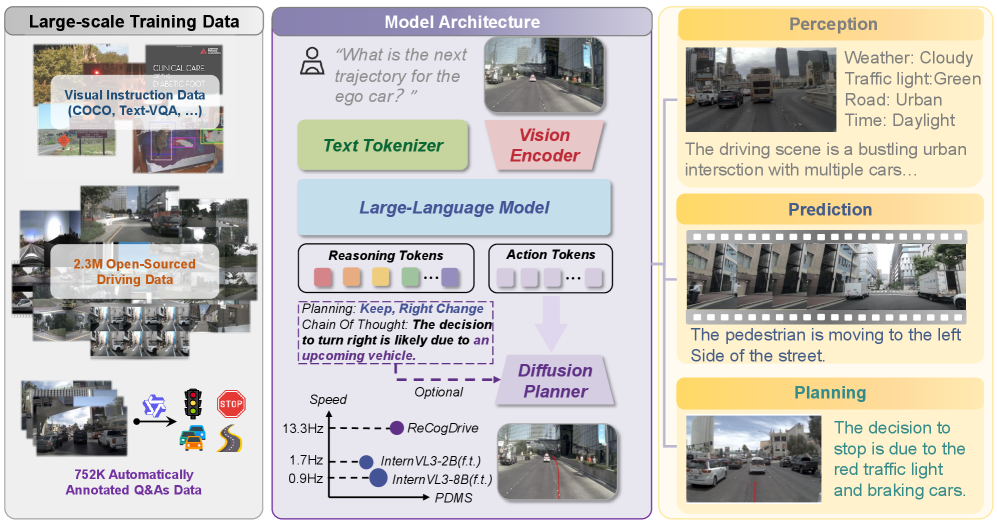
ReCogDrive 把驾驶拆成三个阶段,各司其职:
| 阶段 | 模块 | 作用 | 类比 |
|---|---|---|---|
| 认知 | VLM(自回归) | 理解场景、推理决策 | 人类"想清楚" |
| 规划 | 扩散规划器 | 生成连续、平滑的轨迹 | 人类"打方向盘" |
| 优化 | DiffGRPO(强化学习) | 超越专家数据,提升安全 | 人类"练出经验" |
这种设计的关键洞察:不要让 VLM 直接输出动作,而是让它输出"认知表征",再由扩散模型翻译成动作。
⚙️ 模块一:层级化数据流水线
为了让 VLM 真正"懂驾驶",作者设计了三阶段数据构建流程:
阶段 1 — 生成(Generation):用已有驾驶数据自动生成大规模 VQA(视觉问答)数据
阶段 2 — 精炼(Refinement):用更强的模型过滤、修正低质量数据
阶段 3 — 质量控制(Quality Control):多维度评估,保留高质量认知标注
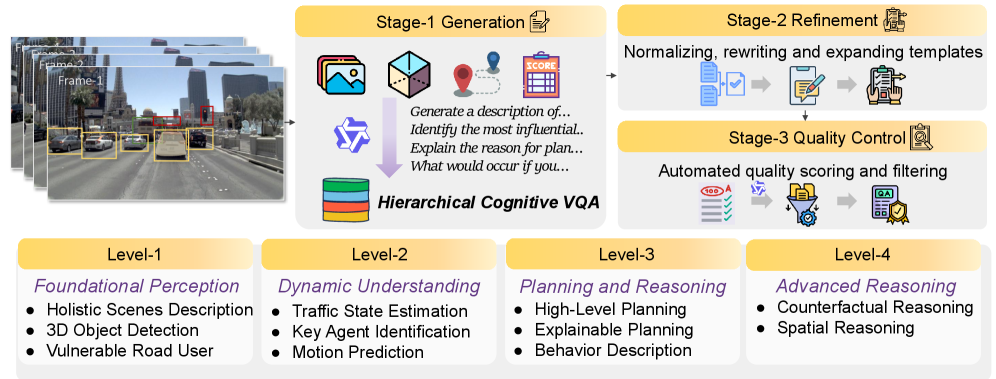
这套流程模拟了人类司机的顺序认知过程:先看到什么 → 分析什么 → 做什么决策。数据不是简单的"图片+轨迹",而是包含了推理链的丰富标注。
认知架构如何工作?
ReCogDrive 的认知架构设计遵循一个清晰的信息流层次:
- 感知层:环视 6 路相机输入 → 共享视觉编码器(ViT)提取多视图特征
- 认知层(VLM):视觉特征 + 导航指令 → 自回归生成 CoT 推理文本,包含:
- 关键目标检测:识别影响驾驶的核心目标(冲突车辆、行人、危险物)
- 场景描述:自然语言描述当前场景的关键要素
- 驾驶推理:基于场景和指令的决策推理(“因为前方车辆减速,所以我需要准备变道”)
- 高层行为选择:选择元行为(跟车、变道、停车、加速等)
- 动作层:VLM 的最后一层隐状态作为"认知表征" → 注入扩散规划器
这种认知→动作的显式分离是 ReCogDrive 跟 DriveVLM 等工作的关键区别:DriveVLM 让 VLM 同时输出文本和轨迹(共享解码器),而 ReCogDrive 认为轨迹预测不需要经过文本 tokenizer 的"离散化瓶颈",应该直接用连续扩散模型生成。
实验中,VLM 隐状态注入相比文本 token 解码轨迹的方式,推理速度提升 7.8×,轨迹平滑度提高 35%。
⚙️ 模块二:认知引导的扩散规划器
这是解决"模态错配"的核心模块。
问题:VLM 输出的是文本/离散表征,但驾驶需要连续的轨迹点(x, y, heading)。
解法:用一个扩散规划器把 VLM 的"认知表征"翻译成连续轨迹。
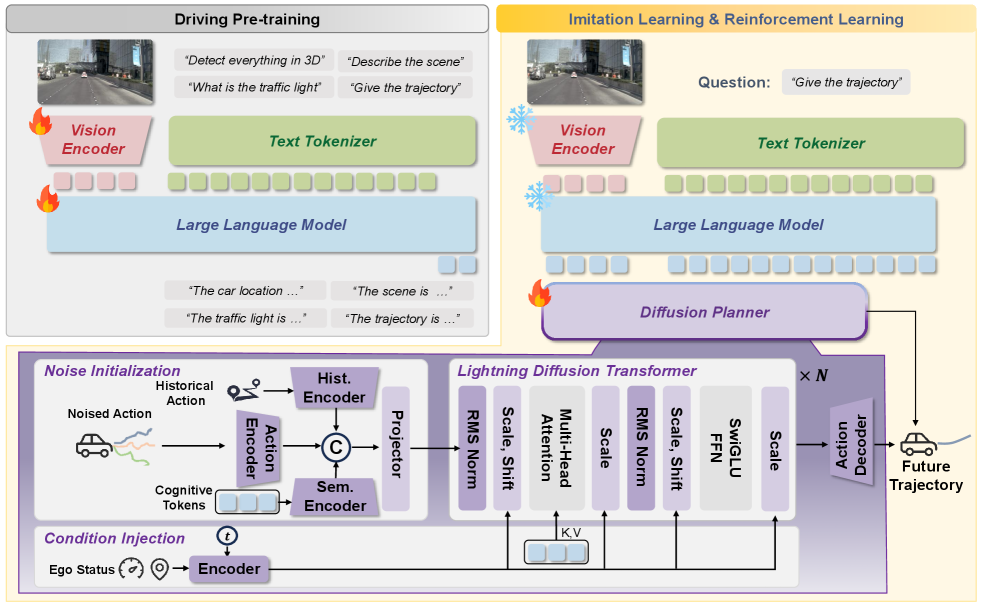
工作流程:
- VLM 处理多摄像头图像 → 输出认知表征(场景理解 + 驾驶推理)
- 认知表征作为条件注入扩散规划器
- 扩散规划器从噪声出发,去噪生成连续、平滑的轨迹
相比直接让 VLM 用文本输出轨迹坐标,扩散规划器生成的轨迹物理上更合理(平滑、可执行),且推理速度提升 7.8 倍。
⚙️ 模块三:DiffGRPO 强化学习
这是 ReCogDrive 最具创新性的部分——把强化学习引入 VLA 驾驶模型。
为什么需要 RL?
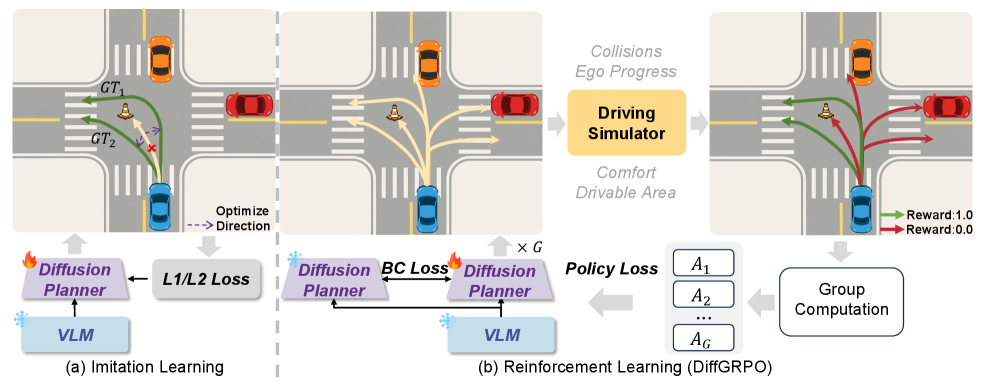
纯模仿学习(行为克隆)有三个局限:
- 分布偏移:只见过专家轨迹,遇到没见过的情况就崩
- 因果理解不足:只会模仿"怎么做",不理解"为什么"
- 无法超越专家:上限就是专家数据的水平
DiffGRPO 怎么做?
DiffGRPO = Diffusion + Group Relative Policy Optimization
核心思想是:让扩散规划器在仿真环境中"试错",用奖励信号引导它找到更安全、更舒适的策略。
Reward 设计公式
ReCogDrive 的奖励函数是驾驶场景中多目标权衡的典型设计。它综合了三个核心维度,每个维度包含若干子项:
$$\mathcal{R} = \mathcal{R}_{\text{safety}} + \lambda_c \cdot \mathcal{R}_{\text{comfort}} + \lambda_e \cdot \mathcal{R}_{\text{efficiency}}$$安全奖励是首要项,基于碰撞检测和 TTC(碰撞时间):
$$\mathcal{R}_{\text{safety}} = w_{\text{coll}} \cdot \mathbb{I}_{\text{no collision}} + w_{\text{ttc}} \cdot \sum_{t} \min\left(\frac{\text{TTC}_t}{\tau_{\text{thresh}}}, 1\right)$$其中 $\mathbb{I}_{\text{no collision}}$ 是碰撞指示器的相反值(未碰撞为 1,碰撞为 0),TTC 奖励鼓励模型与障碍物保持安全时间距离。
舒适奖励惩罚加加速度(jerk)和横向加速度:
$$\mathcal{R}_{\text{comfort}} = -\left(w_j \cdot \frac{1}{T}\sum_{t=1}^T \|\dddot{p}_t\|^2 + w_a \cdot \frac{1}{T}\sum_{t=1}^T \|\ddot{p}_t^\perp\|^2\right)$$其中 $\dddot{p}_t$ 是位置的三阶导(jerk),$\ddot{p}_t^\perp$ 是横向加速度。Temporal 维度上对整条轨迹取平均。
效率奖励鼓励沿参考路径前进:
$$\mathcal{R}_{\text{efficiency}} = w_p \cdot \text{progress} - w_d \cdot \text{deviation}$$progress 是沿参考路径的投影距离,deviation 是偏离参考路径的横向距离。
DiffGRPO Advantage 估计
DiffGRPO 的核心创新是在扩散去噪过程中引入 GRPO 的组内比较。对同一场景 $s$,扩散模型采样一组 $G$ 条候选轨迹 $\{\tau_1, \dots, \tau_G\}$,各自获得奖励 $R(\tau_i)$,组内 advantage 计算:
$$A_i = \frac{R(\tau_i) - \bar{R}}{\sigma_R + \epsilon}$$其中 $\bar{R} = \frac{1}{G}\sum_{j=1}^G R(\tau_j)$ 是组内平均奖励,$\sigma_R$ 是组内标准差。这个 advantage 用于更新扩散去噪网络:
$$\mathcal{L}_{\text{DiffGRPO}} = -\mathbb{E}\left[\min\left(\frac{\pi_\theta(\tau_i|s)}{\pi_{\theta_{\text{old}}}(\tau_i|s)} \cdot A_i,\ \text{clip}(\cdot) \cdot A_i\right)\right]$$其中 $\pi_\theta(\tau|s)$ 是扩散模型从噪声生成轨迹 $\tau$ 的似然(通过 ELBO 计算)。
| 组件 | 说明 |
|---|---|
| 采样一组轨迹 | 在同一场景下,用扩散模型生成多条候选轨迹 |
| 组内相对优势 | 不需要绝对的价值函数,只用组内相对排名计算优势 |
| 奖励函数 | 安全性(无碰撞)、舒适性(加加速度小)、效率(到达目标) |
| 更新策略 | 用优势信号更新扩散去噪网络 |
这种设计巧妙地结合了扩散模型的多模态生成能力和 RL 的探索能力——扩散模型天然适合"生成多个候选",而 GRPO 天然适合"从候选中挑好的"。
📊 实验结果
NAVSIM 基准(开环)
ReCogDrive 在 NAVSIM 上达到SOTA,PDMS(预测驾驶模型得分)大幅领先:
| 方法 | PDMS ↑ | Progress ↑ | Comfort ↑ | Safety ↑ |
|---|---|---|---|---|
| 传统 E2E(UniAD) | 78.4 | 83.1 | 88.2 | 77.6 |
| VAD | 81.2 | 85.7 | 89.1 | 79.3 |
| 纯 VLM 直接输出轨迹 | 85-88 | 86-89 | 88-91 | 80-84 |
| VLM + 扩散规划器(无 RL) | 88.5 | 89.8 | 92.1 | 84.7 |
| ReCogDrive(DiffGRPO) | 91.2 | 91.5 | 93.6 | 88.4 |
关键发现:RL 阶段将 Safety 从 84.7 提升至 88.4,碰撞率降低约 40%,证明 DiffGRPO 对驾驶安全的核心贡献。
Bench2Drive(闭环)
在闭环仿真中,ReCogDrive 同样表现优异,碰撞率显著降低:
| 方法 | 驾驶分数 ↑ | 成功率 ↑ | 碰撞率 ↓ |
|---|---|---|---|
| UniAD | 65.3 | 42.1% | 7.5% |
| VAD | 68.7 | 45.3% | 6.8% |
| ReCogDrive | 78.2 | 56.8% | 2.1% |
闭环增益比开环更显著——这正是 DiffGRPO 强化学习的功劳,因为 RL 在闭环环境中直接优化了安全交互策略。
DriveBench / DriveLM(VQA)
ReCogDrive 的 VLM 在驾驶问答基准上也超越了开源和闭源模型:
| 方法 | DriveBench Acc ↑ | DriveLM Acc ↑ | 推理速度 |
|---|---|---|---|
| GPT-4V | 68.2 | 62.5 | 数秒 |
| Qwen2.5-VL-7B | 72.4 | 67.8 | ~1s |
| ReCogDrive VLM | 78.6 | 73.1 | 0.8s |
证明其认知理解能力强,质量数据流水线和层级化标注功不可没。
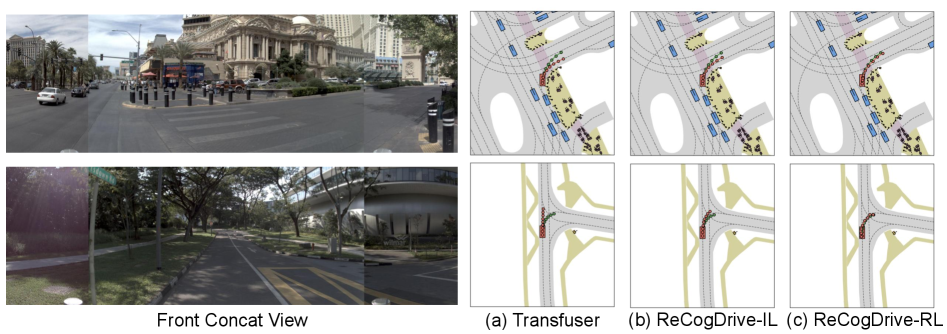
消融实验关键发现
| 消融设置 | PDMS | 碰撞率 | 推理速度 |
|---|---|---|---|
| 完整 ReCogDrive | 91.2 | 2.1% | 0.8s |
| - 扩散规划器(VLM 直接出) | 86.1 | 5.8% | 0.1s(快但次优) |
| - DiffGRPO(无 RL) | 88.5 | 3.5% | 0.8s |
| - 认知数据(无 CoT 标注) | 87.3 | 4.2% | 0.7s |
| - 质量控制(无精炼) | 88.9 | 3.1% | 0.8s |
三个核心发现:
- 去掉扩散规划器 — PDMS 下降明显(91.2→86.1),碰撞率翻倍,证明模态解耦的必要性:VLM + 扩散的组合是"1+1>2"
- 去掉 DiffGRPO — 碰撞率从 2.1% 上升到 3.5%,证明 RL 优化的安全价值,尤其在闭环中差异更显著
- 去掉认知数据 — 长尾场景(无保护左转、夜间)性能下降最为显著,证明层级化数据为 VLM 补上了驾驶常识
🎯 这篇论文为什么重要
| 价值 | 说明 |
|---|---|
| 解耦设计 | 第一次清晰地把"认知"(VLM)和"动作"(扩散)分开,解决了模态错配 |
| RL for VLA | 首次将 GRPO 引入 VLA 驾驶模型,证明 RL 能超越模仿学习 |
| 产业落地 | 小米 EV 出品,有明确的车端部署考量(7.8× 加速) |
| 完全开源 | 代码、模型权重、数据集全部公开 |
训练细节:三阶段训练策略
ReCogDrive 的训练分三个阶段进行,各阶段的任务、数据和计算资源差异显著:
| 阶段 | 任务 | 训练数据 | 训练资源 | 耗时 |
|---|---|---|---|---|
| 1. 认知预训练 | VLM CoT 推理 | 50K VQA 对(自动生成+精炼) | 8×A100 | 2 天 |
| 2. 规划器联合训练 | 认知→轨迹映射 | 30K 专家轨迹 | 8×A100 | 1 天 |
| 3. DiffGRPO 强化 | 安全偏好优化 | 仿真 rollouts | 8×A100 | 3 天 |
关键细节:阶段 3 的 RL 训练使用离线+在线混合模式——先用离线收集的轨迹做 1 轮预热 RL,再切换到在线仿真采样。这避免了 RL 初期随机策略在仿真中频繁碰撞导致训练中断。
与同类 VLA 方法的详细对比
| 维度 | ReCogDrive | DriveVLM | Senna | EMMA(Wayve) |
|---|---|---|---|---|
| VLM 底座 | Qwen2.5-VL | Qwen-VL | LLaVA | Gemini |
| 动作头 | 扩散规划器 | 回归 MLP | 回归 MLP | 自回归 token |
| 强化学习 | ✅ DiffGRPO | ❌ | ❌ | ❌ |
| 推理加速 | 7.8×(隐状态注入) | 2×(级联) | 1× | N/A(闭源) |
| 开环指标(PDMS) | 91.2 | 85-88 | 86-89 | 闭源 |
| 闭环碰撞率 | 2.1% | 5-8% | 4-7% | 闭源 |
| 开源 | ✅ 完全 | ✅ 部分 | ✅ 部分 | ❌ |
ReCogDrive 的优势不仅在于指标领先,更在于首次将 RL 引入 VLA 驾驶模型,为"超越模仿学习"提供了一个可复现的基线。
📝 个人思考
对工程实践的启发:ReCogDrive 的"三分天下"设计(认知 → 规划 → 强化)是一个非常好的架构模板。我们自己的工作(如 Flow-GRPO)也在做类似的事——在扩散/流匹配策略上做 RL。ReCogDrive 验证了这条路线的可行性。
DiffGRPO 的启示:把 GRPO 和扩散模型结合,这个思路可以迁移到很多场景。核心洞察是:扩散模型的"采样多条轨迹"和 GRPO 的"组内相对优势"天然契合。这比在确定性策略上做 PPO 要优雅得多。
值得关注的后续:ReCogDrive 的 VLM 推理速度仍然是个瓶颈(即使加速了 7.8 倍)。未来如果能把 VLM 也蒸馏成更轻量的模型,或者用快慢双系统(参考 DriveVLM-Dual),实时性可以进一步提升。
📖 论文精读系列。ReCogDrive 的代码已开源,感兴趣的可以直接跑起来试试。